推理驱动视觉编辑:RISEBench++ 基准与 RISE-Agent 智能体框架 Reasoning-Informed Visual Editing
提出推理编辑基准 RISEBench++(1000例双语)与免训练智能体 RISE-Agent。
前置知识
大型多模态模型(LMM)
同时处理文本与图像等多种模态的大规模神经网络,如 GPT-4o、Gemini、Qwen-VL 等。它们通过统一的表征空间将视觉编码与语言推理结合,可执行视觉问答、图像描述、图文推理乃至直接生成或编辑图像。本文的编辑模型、评测裁判(judge)和智能体组件都构建在这类模型之上。
论文的研究对象是 LMM 的视觉编辑能力,评测流水线本身也依赖 LMM 充当裁判,读懂全文必须先理解这类模型的角色与能力边界。
指令引导图像编辑
给定输入图像和自然语言指令,模型输出修改后的图像。主流实现包括基于扩散模型的编辑器(如 FLUX.1 Kontext、Step1X-Edit)和统一多模态模型(如 BAGEL、OmniGen2、HunyuanImage),后者把理解与生成放进同一框架。编辑要求只改动指令涉及的区域,保持其余像素的外观一致。
本文研究的推理驱动编辑是该任务的升级版:指令不再显式描述操作,而是要求模型先推理出目标状态再执行编辑,理解传统编辑有助于把握推理带来的增量难度。
LMM-as-a-Judge 评测范式
用强大的多模态模型代替人工给生成结果打分。裁判模型按预设评分细则(rubric)对输出图像逐维度评分,其可靠性通过与人类标注的 MAE(平均绝对误差)和 Spearman 相关系数来校准。优点是可规模化,缺点是继承裁判模型自身的偏差。
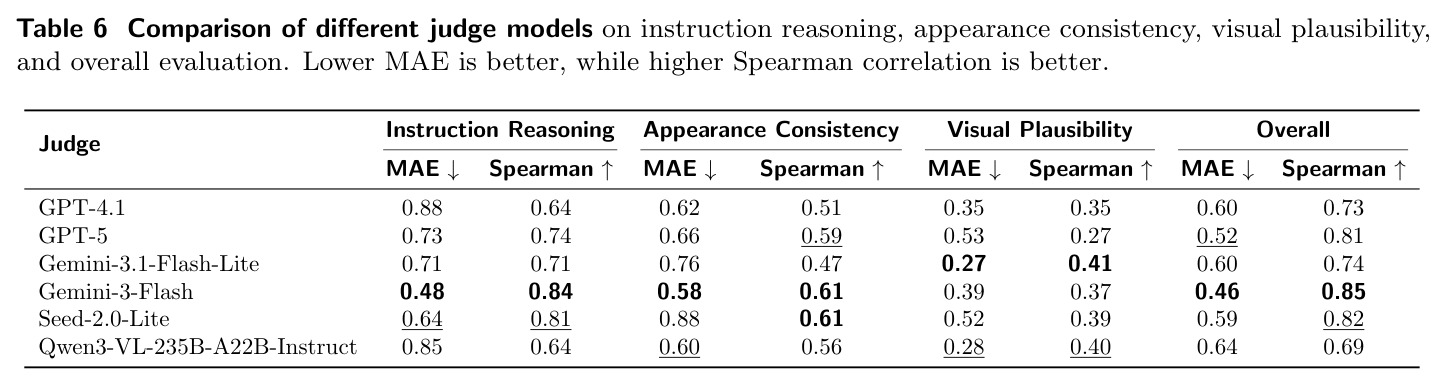
论文的核心评测机制:三个维度分别由 Gemini-3-Flash 和 Gemini-3.1-Flash-Lite 打分,并用 200 个样本、4 名标注者的人工对照实验验证裁判与人类判断的一致性(如指令推理维度 MAE 0.48、Spearman 0.84)。
反事实推理
在明确假设与已知世界规律冲突时进行推理:既要用现实知识构造连贯的推演,又要主动违反某些规律。例如'假设斜坡上的汽车摩擦力消失,画出场景变化'或'画出方轮胎的摩托车'。它要求模型区分'物理上不可能但语义上自洽'的画面与单纯的错误输出。
反事实推理是 RISEBench++ 六大维度之一(100 例),其特殊之处在于评测时只考察感知质量、不惩罚物理不合理,是理解评测细则设计的关键概念。
Agentic(智能体)框架
让大模型扮演一个或多个具备分工的角色(规划器、执行器、验证器),通过调用外部工具、迭代反馈形成闭环来完成任务,而非一次性直接生成答案。规划-执行-验证的解耦让每个环节都能被检查和重试,从而提高复杂任务的可靠性,且通常无需额外训练。
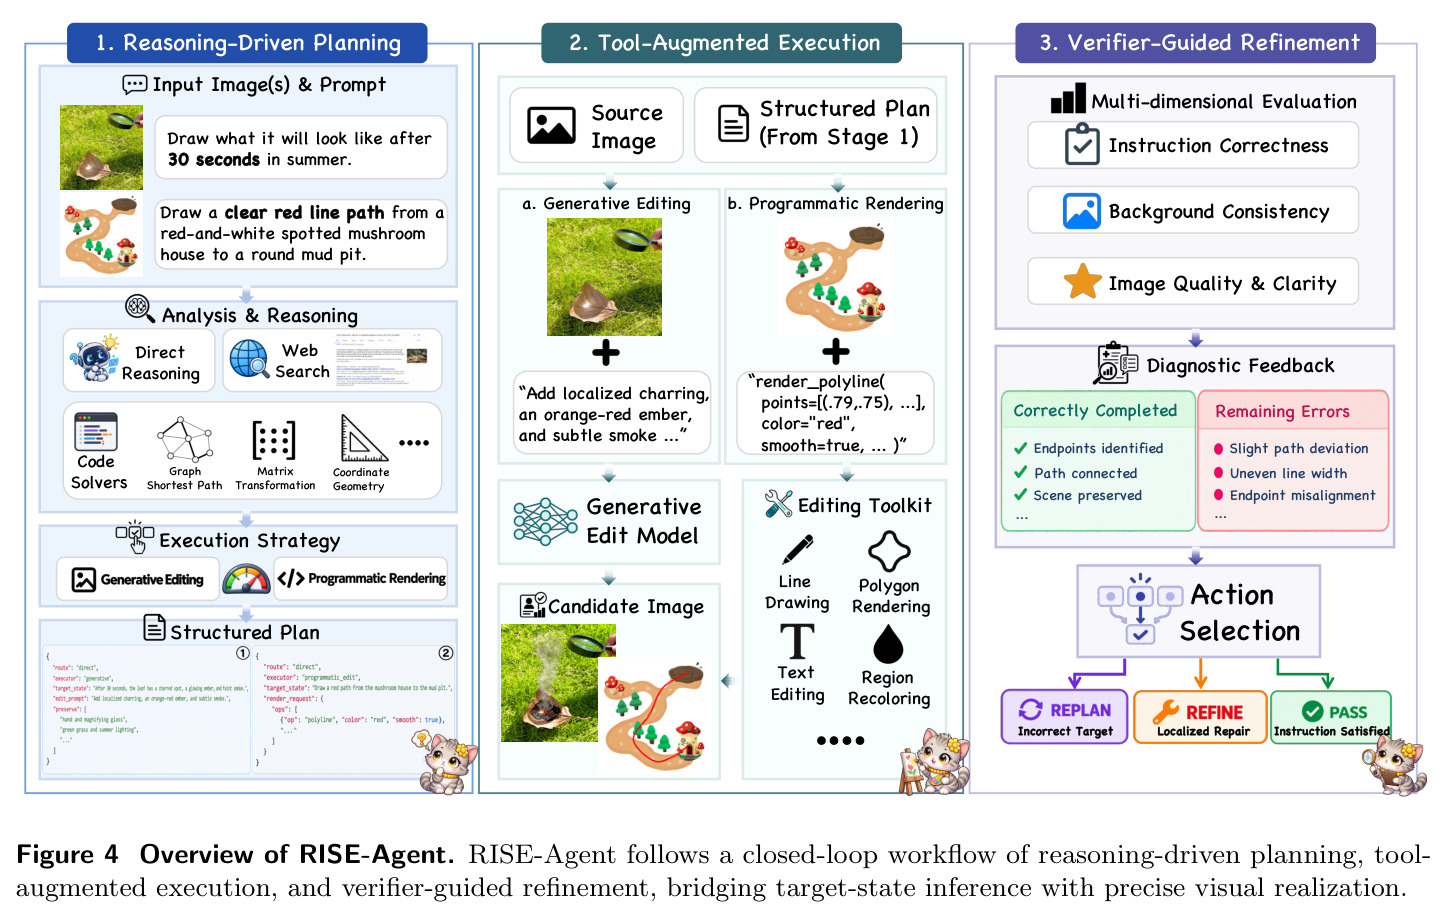
本文的方法贡献 RISE-Agent 正是典型的免训练智能体框架:planner 推理目标状态并调用 7 种求解器工具,executor 用生成模型加 12 种程序化操作执行,verifier 决定通过、精修或重规划,理解这一范式是读懂方法部分的钥匙。
研究动机
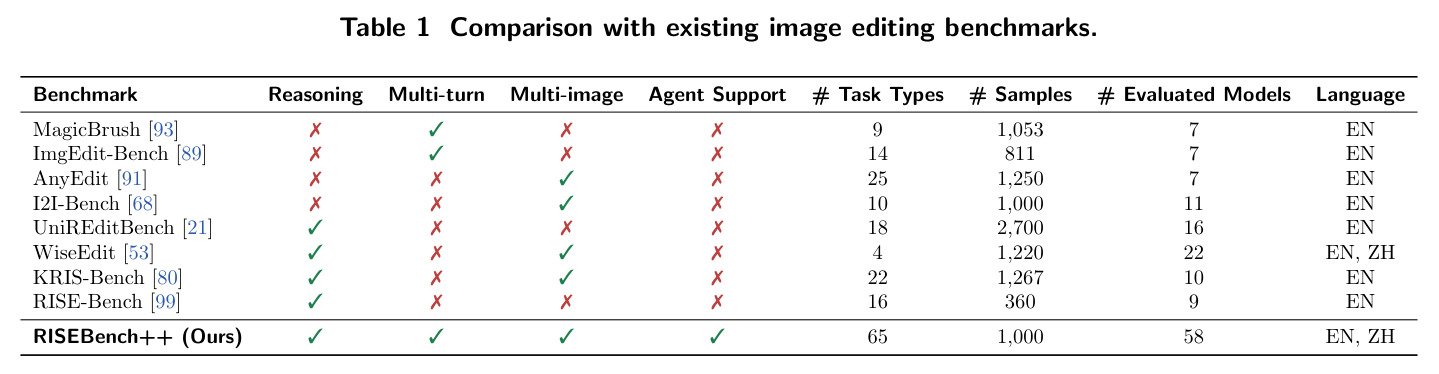
当前图像编辑能力呈明显的断层。早期开源模型(BAGEL、Step1X-Edit、FLUX、Emu2、OmniGen 等)在通用视觉编辑上存在三大缺陷:难以准确遵循复杂编辑指令、编辑时无法保持原图外观一致性、不支持灵活的输入格式(如单图与多图混合配自然语言指令)。与此同时,GPT-Image 系列和 Nano Banana 系列等专有模型展现出一种新能力——推理驱动视觉编辑(RISE):模型能基于上下文理解和逻辑推理做出智能修改,例如根据场景推断一天中某时刻的光照、将氧化硬币放入溶液十分钟后画出其反应后的样子、根据地图在第一人称视角图中标出相机位置。但这类能力此前没有系统性的评测基准:MagicBrush、ImgEdit-Bench、AnyEdit、I2I-Bench 等既有基准依赖显式、简单的编辑指令,推理不是考察重点;少数初步涉及推理的基准(KRIS-Bench、WiseEdit、UniREditBench)在任务类型数(最多 22 种)、评测维度(均不支持多轮编辑或 agent 支持)、评测模型数量(最多 22 个)上都很有限。开发者无法量化回答:现有模型推理编辑到底有多差?差在哪种推理上?瓶颈是'想不出'还是'画不准'?
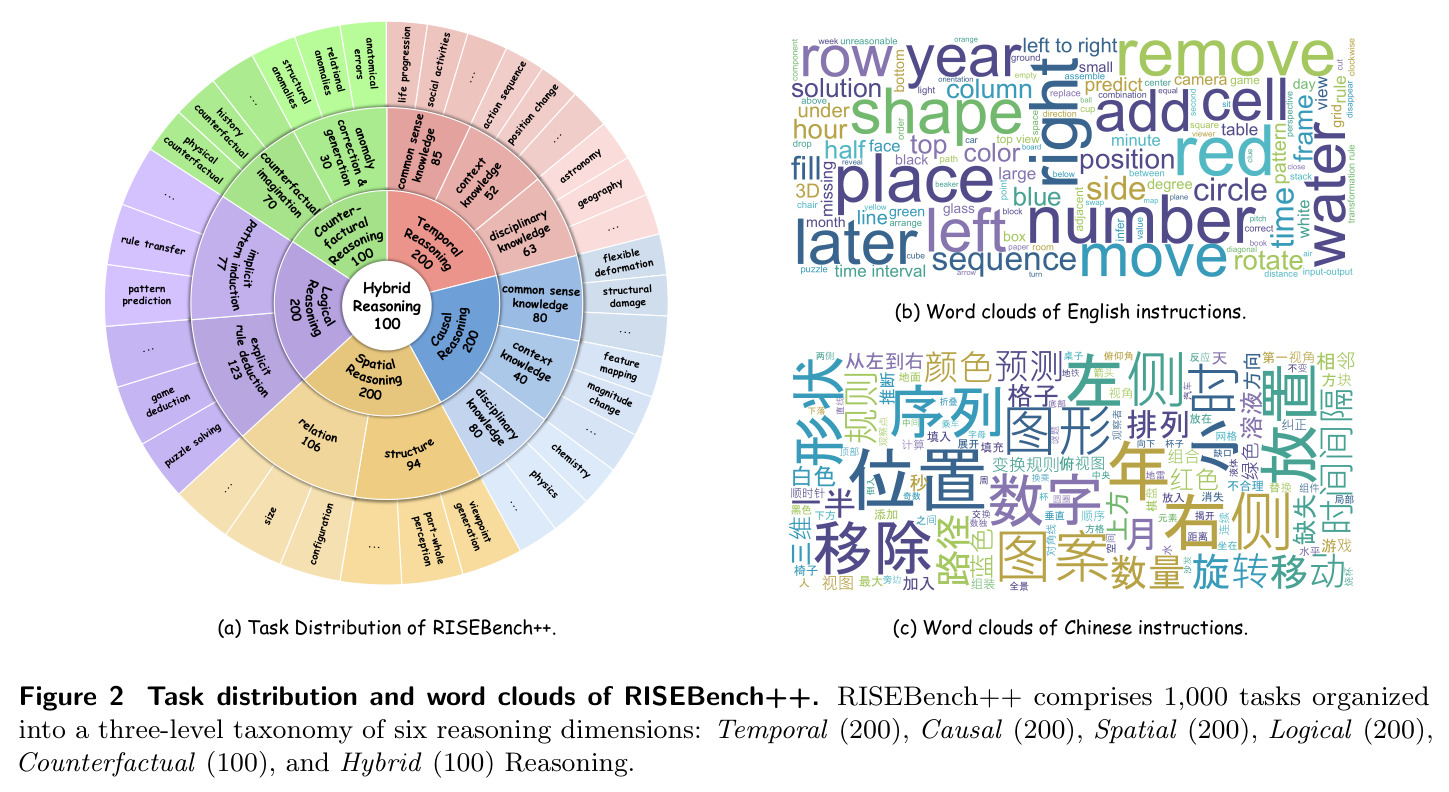
本文的目标是本文要建立推理驱动视觉编辑(RISE)的系统评测基础设施,并探索可行的方法路线。具体目标有四层:其一,把前身工作 RISEBench(NeurIPS 2025 D&B Oral,仅 4 个推理维度、360 例、9 个模型、单图单轮英文)扩展为 RISEBench++:6 个推理维度、12 个子类别、65 种细粒度任务类型,1000 个人工标注的双语(英文/中文)测试用例,覆盖单图、多图与多轮编辑。其二,构建可靠且可校准的 LMM-as-a-Judge 评测框架,沿指令推理(Instruction Reasoning)、外观一致性(Appearance Consistency)、视觉合理性(Visual Plausibility)三个维度评分,并用人类对照实验验证裁判与专家判断的一致性。其三,超越纯基准测试,提出免训练的 RISE-Agent 智能体框架,验证'推理-执行-验证'闭环能否缓解当前模型的短板。其四,对 58 个代表性方法(19 个闭源模型、34 个开源模型、5 个智能体方法)做系统评测与细粒度失败分析,为社区指明改进方向。
与已有工作不同的是,本文的独特切入角度体现在三个层面。认知层面:作者提出把推理驱动编辑的失败归因从'图像合成能力'转移到'目标状态推断'——即很多编辑失败不是因为模型画不好,而是因为它没想清楚该画什么;这一判断直接催生了把'推断目标状态'与'精确视觉实现'解耦的智能体设计。分类层面:作者按推理需求的本质把六个维度归为三类——时间与因果推理是知识驱动(有相关知识即可直接推出目标状态),空间与逻辑推理是感知驱动(须先从视觉观察中归纳出潜在结构或规则再推理),反事实推理是想象驱动(要调用真实知识又主动违反它构造物理上不可能但自洽的状态),混合推理则跨轮次整合多种推理,考察长视野一致性。这种'知识/感知/想象'三分法是区别于其他推理编辑基准(如 KRIS-Bench 按知识类型划分)的核心组织逻辑。方法层面:不同于已有智能体编辑方法(IntentEdit、ImAgent、Mind-Brush)单纯依赖生成模型的感知-行动循环,RISE-Agent 引入形式化求解器工具与确定性程序化编辑,用'精确工具做精确事'的思路补足生成模型的细粒度控制缺陷。
核心方法
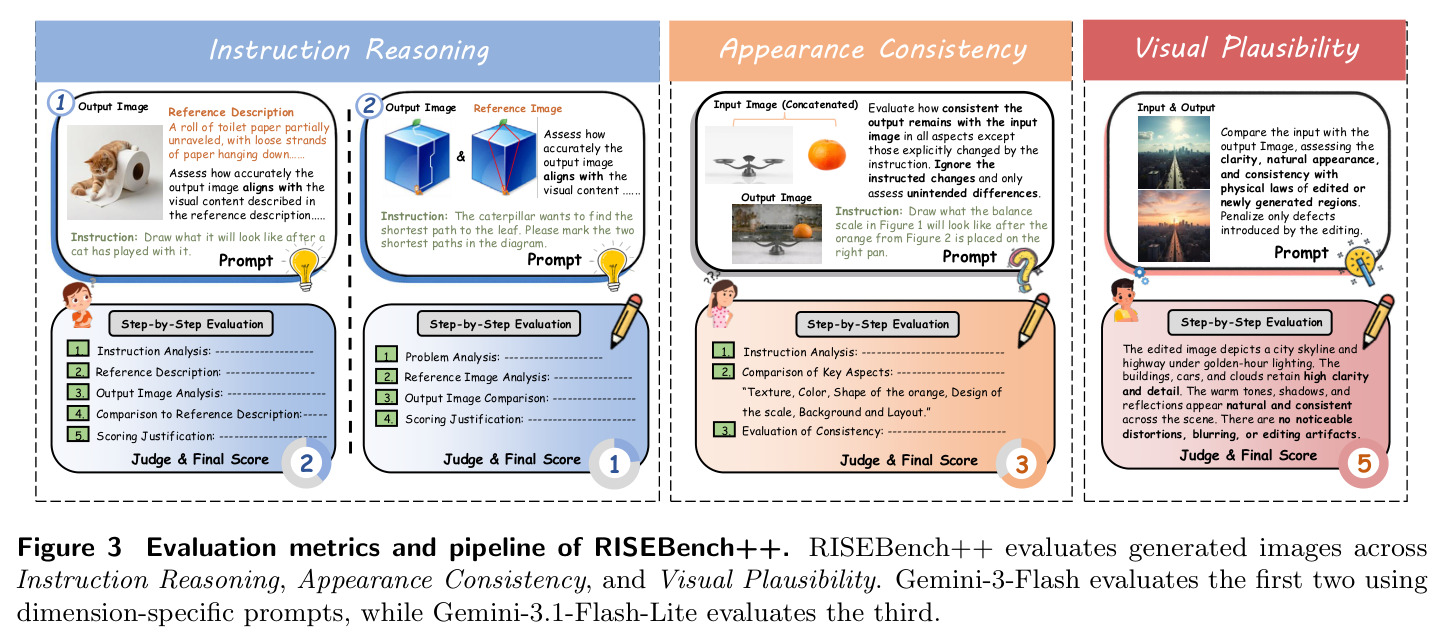
直觉上,让模型'画出一个氧化硬币泡在溶液里十分钟后的样子'需要两步:先推断目标状态(硬币表面变成什么颜色、质地如何),再把推断结果视觉化。作者的诊断是:当前模型的第一步普遍失败,第二步在指令显式时其实已相当可靠。因此整体思路是先建立能分别暴露这两类失败的基准与评测体系,再用智能体架构把两步解耦。技术路线分三块:(1)基准构建——按三层级分类法(6 维度→12 子类别→65 任务类型)人工策划 1000 个双语测试用例,其中时间、因果、空间、逻辑推理各 200 例,反事实与混合推理各 100 例,支持单图、多图(输入 2 张图联合推理)与多轮(3-5 条指令的序列编辑)三种输入设置;(2)评测流水线——每个样本沿指令推理、外观一致性、视觉合理性三个维度按 1-5 分打分,归一化后换算为百分制,仅当三个维度都拿到满分 5 分才记为'解出',准确率定义为解出样本占比乘以 100,即 $\text{Accuracy} = \frac{1}{N}\sum_{i=1}^{N}\mathbb{1}[s_i^{\text{inst}}=5 \wedge s_i^{\text{cons}}=5 \wedge s_i^{\text{plaus}}=5]\times 100\%$;裁判模型用 Gemini-3-Flash(前两维)和 Gemini-3.1-Flash-Lite(第三维),选型经人类对照实验校准;(3)RISE-Agent——免训练闭环框架,由规划器(GPT-5.1)、执行器(开源 FLUX.2 Klein 9B 加程序化工具包)、验证器(Gemini-3-Flash)构成。
核心创新有三点,本质都围绕'把不确定的推理与精确的执行分开'。第一,评测端:已有基准给一句指令打一个总分,本文把评测拆成三个正交维度,并为指令推理维度设计了'维度特定证据'机制——简单场景配参考文本(裁判模型对照文字描述核对输出),复杂场景(尤其逻辑与空间推理中难以用文字描述的网格、图形)配一张完全符合要求的参考图像(裁判对照图像核对)。评分细则按维度定制:外观一致性只惩罚指令未要求却被改动的部分,视觉合理性只评估被修改区域的缺陷且不惩罚继承自原图的特性,反事实任务不惩罚物理不合理。这使裁判判断既可靠又可校准。第二,方法端:planner 在生成任何像素之前先用三种方式确定目标状态——直接多模态推理、web search 补充领域知识、或调用 7 个代码级求解器(算术、日期计算、网格/图最短路、数独、坐标几何、矩阵变换)获得形式化问题的可靠中间结果;executor 拥有两条互补的实现通道,生成式编辑负责需要内容合成的任务,12 个确定性程序化操作(画线、多边形渲染、文本编辑、区域重着色、内容搬移等)负责需要像素级精确的任务——程序化操作直接作用在选定画布上,未触碰的像素保证不变。第三,验证器输出诊断性反馈并三分支决策:pass(通过)、refine(给出局部修正指令,可指定用生成式或程序化方式执行)、replan(目标状态推断错了,带着失败结果和诊断回到规划器重来),并以'全程最优候选'作为最终输出。
方法步骤详情
基准构建与评测的完整流程如下。第一步,构建分类法:先确定 6 个推理维度,再细分为 12 个子类别——时间推理分常识知识(生命进程、材料变化、物理老化、城市演变等)、情境知识(时钟日历解读、多图序列推断前后帧)、学科知识(物理化学生物天文地理历史医学计算机)三类;因果推理同样三分(物理状态转变、结构损坏、柔性变形;幅度变化、读数偏移、顺序关系、特征映射;学科定律);空间推理分关系(邻接、方向、朝向、投影、距离、大小、构型、观察尺度、定位)与结构(部分-整体感知、几何规律、视点生成、环境结构、自我中心场景重建)两类;逻辑推理分显式规则演绎(路径搜索、数学推导、游戏推理、解谜)与隐式模式归纳(模式预测、视觉异类检测、规则迁移)两类;反事实推理分反事实想象与异常修正/生成两类。第二步,逐任务类型人工策划并标注测试用例,每例提供中英双语指令、输入图像、参考描述或参考图像。第三步,对待测模型推理得到编辑结果,闭源模型走官方 API。第四步,裁判评分:指令推理维度由 Gemini-3-Flash 按参考文本或参考图像对照输出打 1-5 分;外观一致性把输出与输入(多图则拼接)对比打 1-5 分,逻辑类极简图形用二值评分(完全保留为 5,明显偏差为 1);视觉合理性由 Gemini-3.1-Flash-Lite 只针对修改区域评估清晰度、真实感与无伪影程度。RISE-Agent 的运行流程为:规划器两阶段工作——先分析图像与指令推断意图(必要时检索或调求解器),再把分析结果与工具输出整合成显式目标状态,输出独立生成式 prompt 或声明式编辑程序;执行器据此调用 FLUX.2 Klein 9B 或程序化工具包;验证器从指令正确性、背景一致性、图像质量三方面评估并列出'已完成项/遗留错误',在最多 1 次重规划与 2 次精修预算内迭代;混合推理的多轮任务被分解为单轮序列,上一轮输出作为下一轮输入。
技术新颖性
与最接近的已有工作相比,新颖性体现在四方面。对比前身 RISEBench(NeurIPS 2025 Oral):分类法从 4 维度重组为 6 维度、12 子类别、65 任务类型的三层结构,规模从 360 例扩到 1000 例,新增多图、多轮、双语三种设置,评测方法加入更强裁判、维度特定证据与定制细则,评测对象从 8 个扩到 58 个方法,并从纯基准扩展出 RISE-Agent 方法贡献。对比其他推理编辑基准(KRIS-Bench、WiseEdit、UniREditBench):本文是唯一同时支持推理、多轮、多图、agent 四种设置的基准(Table 1),任务类型数 65 远超最多的 22,评测模型数 58 远超最多的 22,且是少数双语基准之一。对比智能体编辑方法:IntentEdit、ImAgent 做意图分解与感知-行动迭代,Mind-Brush 引入外部知识检索,但它们的执行端都只有生成模型;RISE-Agent 的差异化在于(a)形式化求解器让最短路、数独、日期计算这类可验证问题获得确定性正确答案而非概率性生成,(b)程序化编辑工具解决'生成模型画网格差一个像素就全错'的细粒度控制难题,(c)verifier 的 refine 分支支持混合修复(部分程序化部分生成)而非简单重试。对比评测方法论:裁判选型不是拍脑袋——用 100 个均匀采样用例 × 2 个模型 × 4 名标注者做人工对照,以 MAE 和 Spearman 相关系数双指标在 6 个候选裁判中选型,这一校准流程本身对同类工作有方法论价值。
实验结果
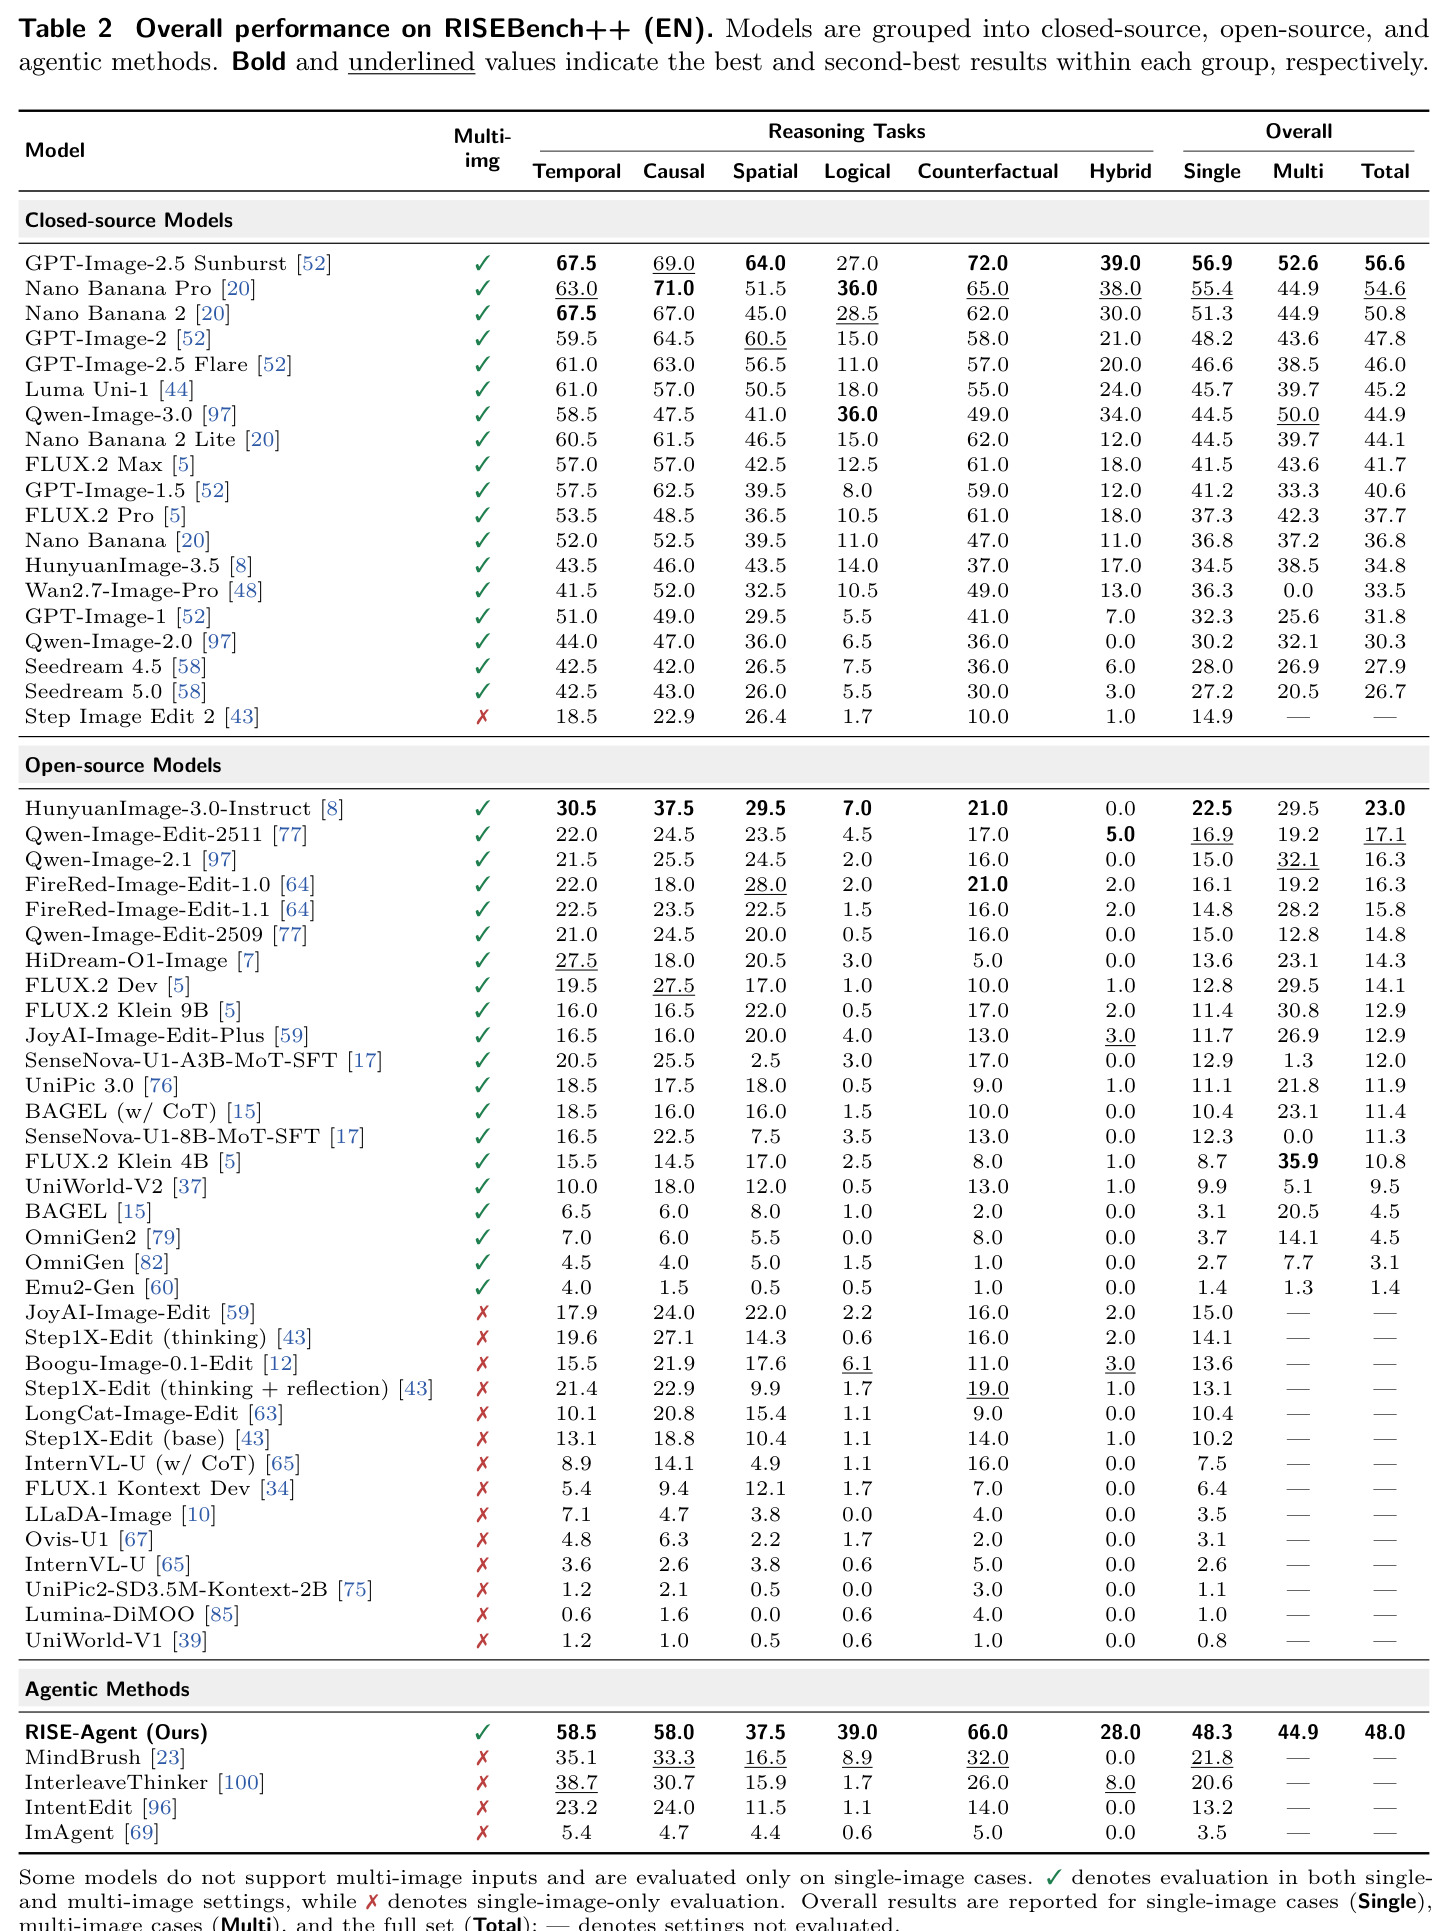
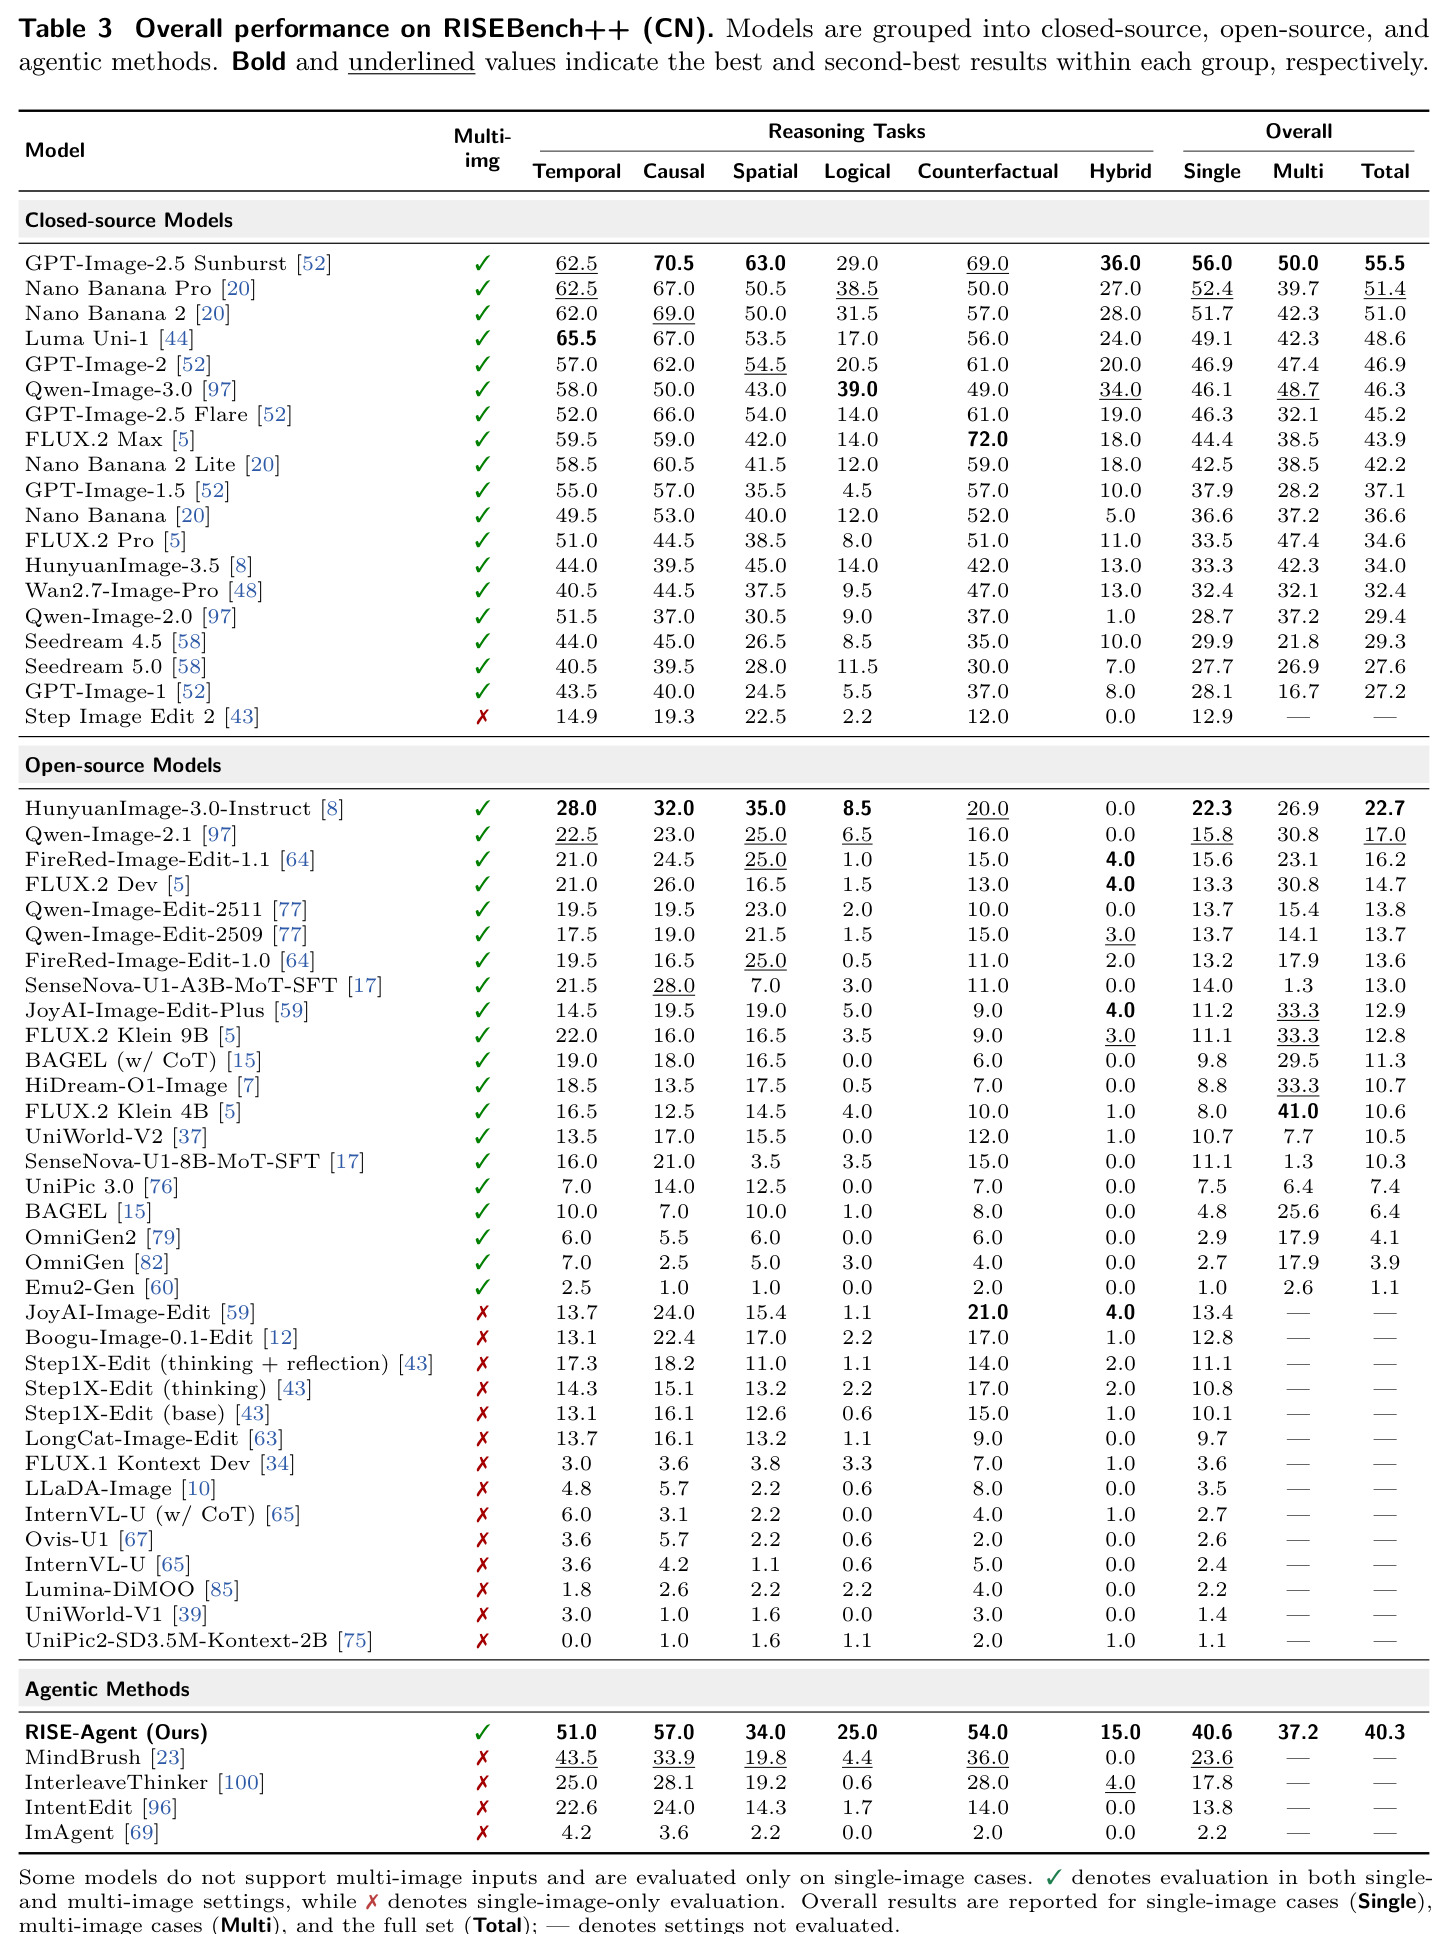
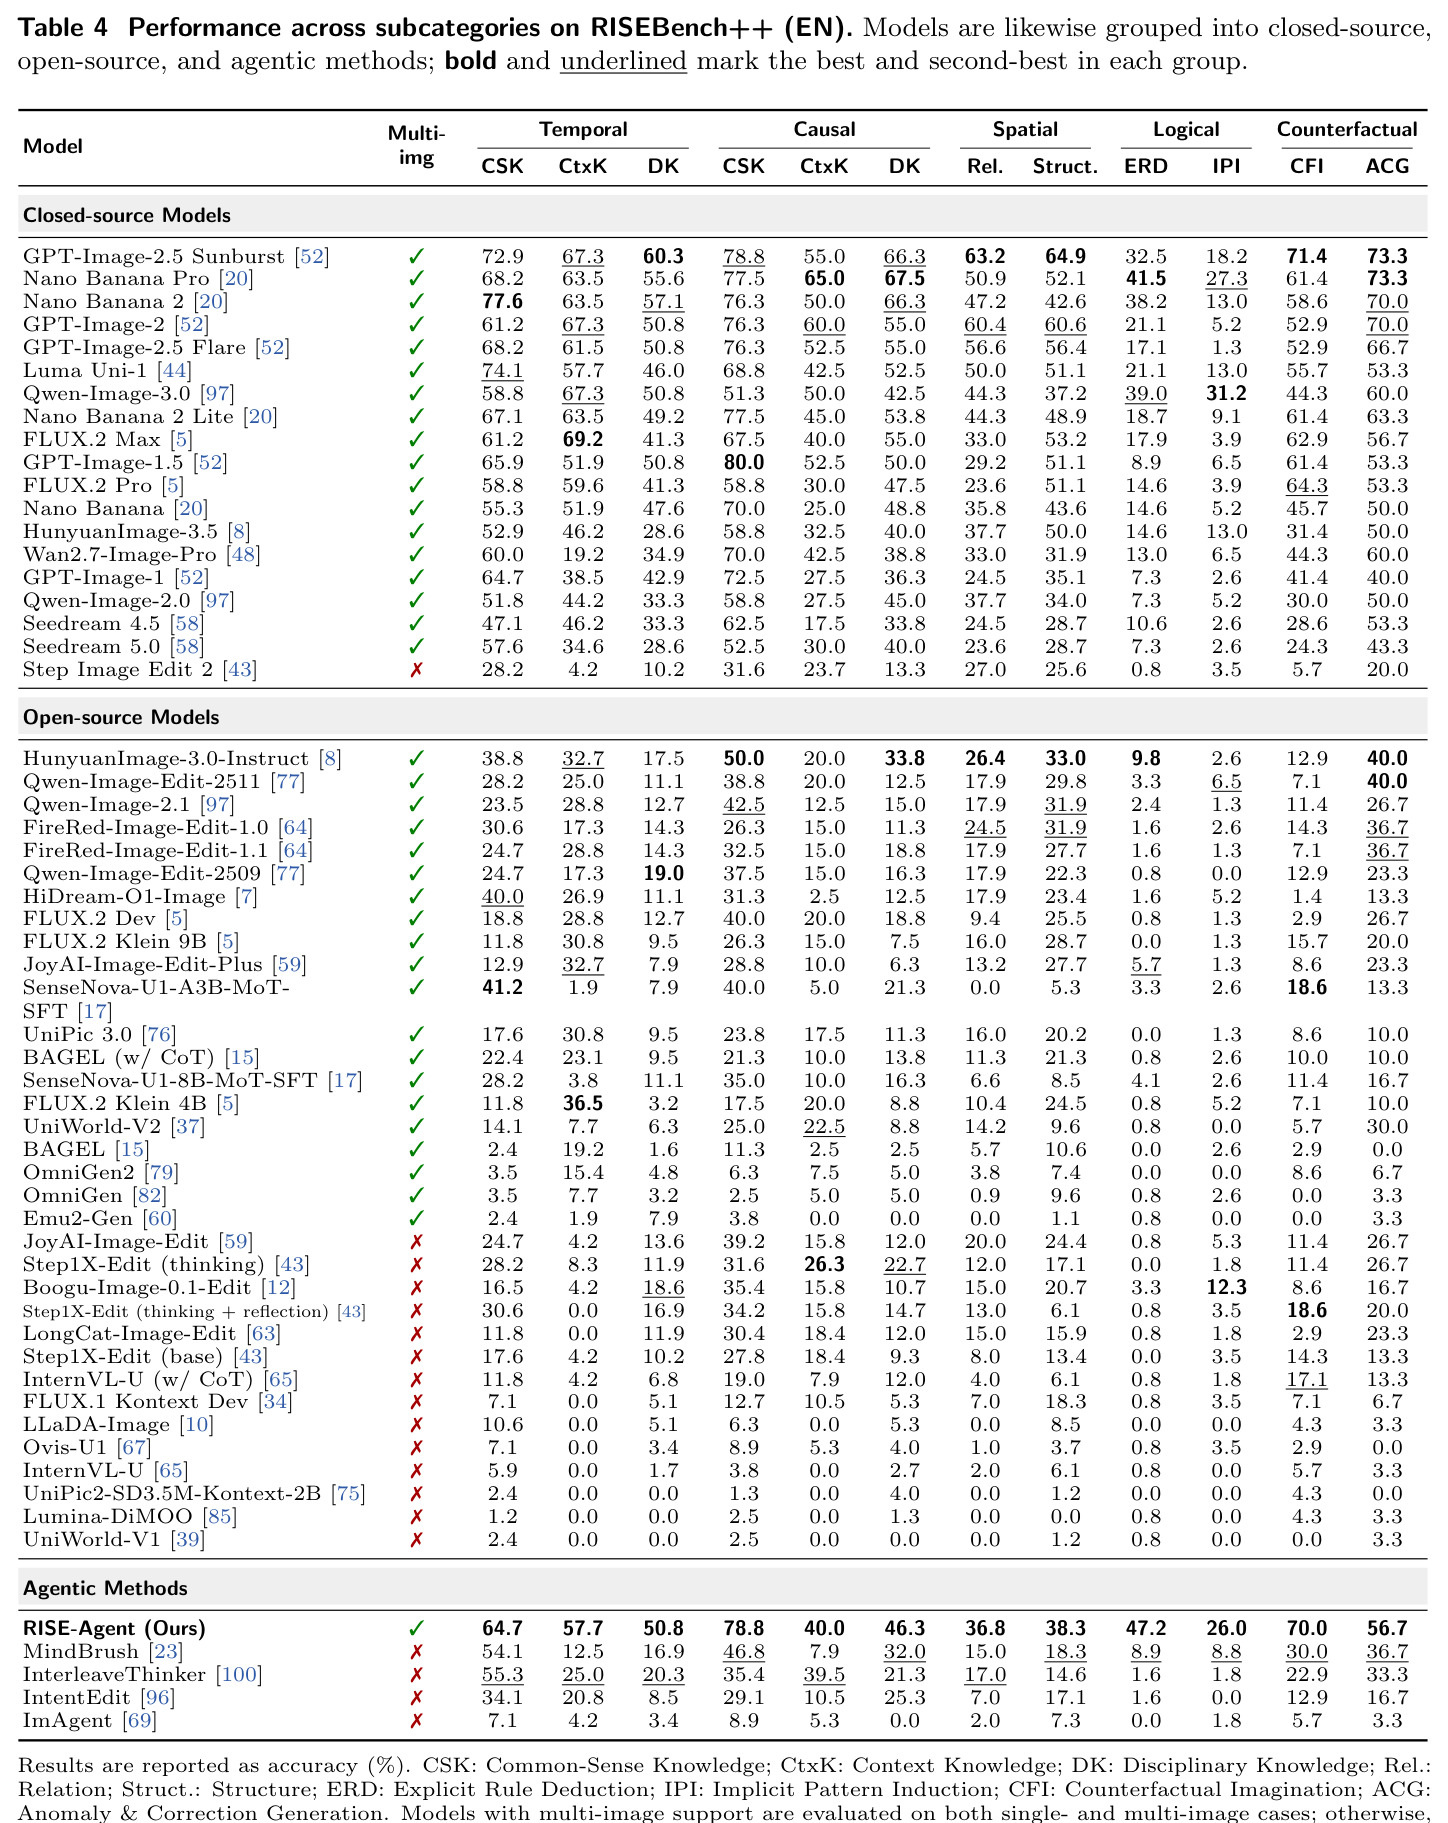
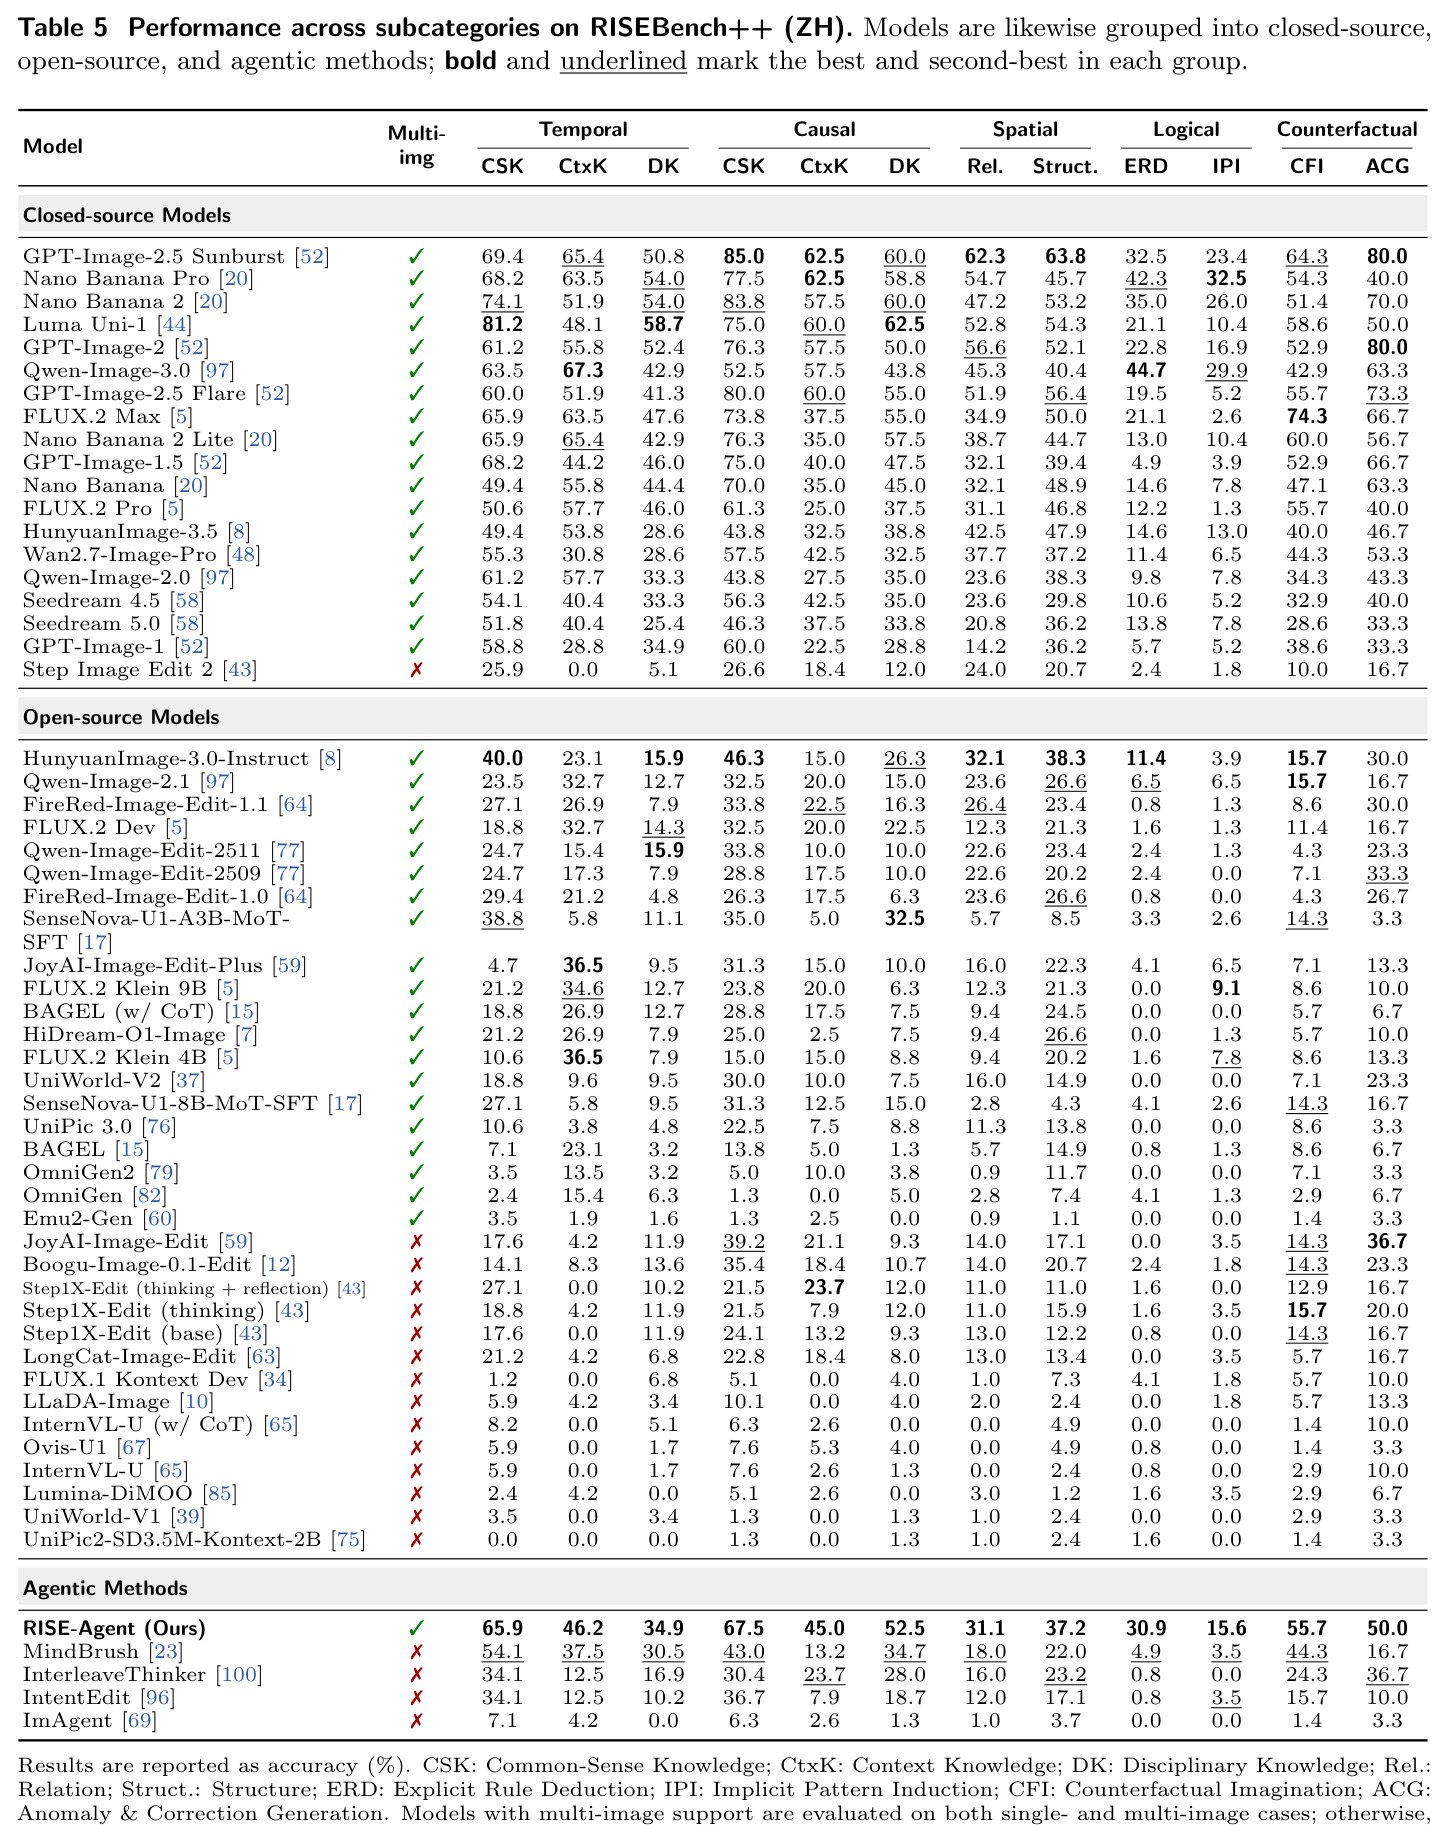
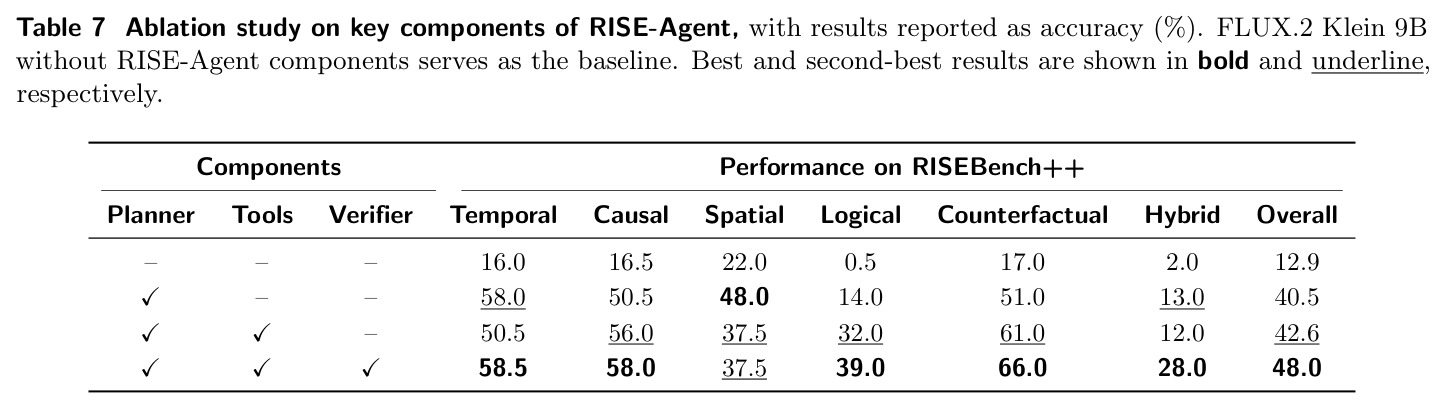
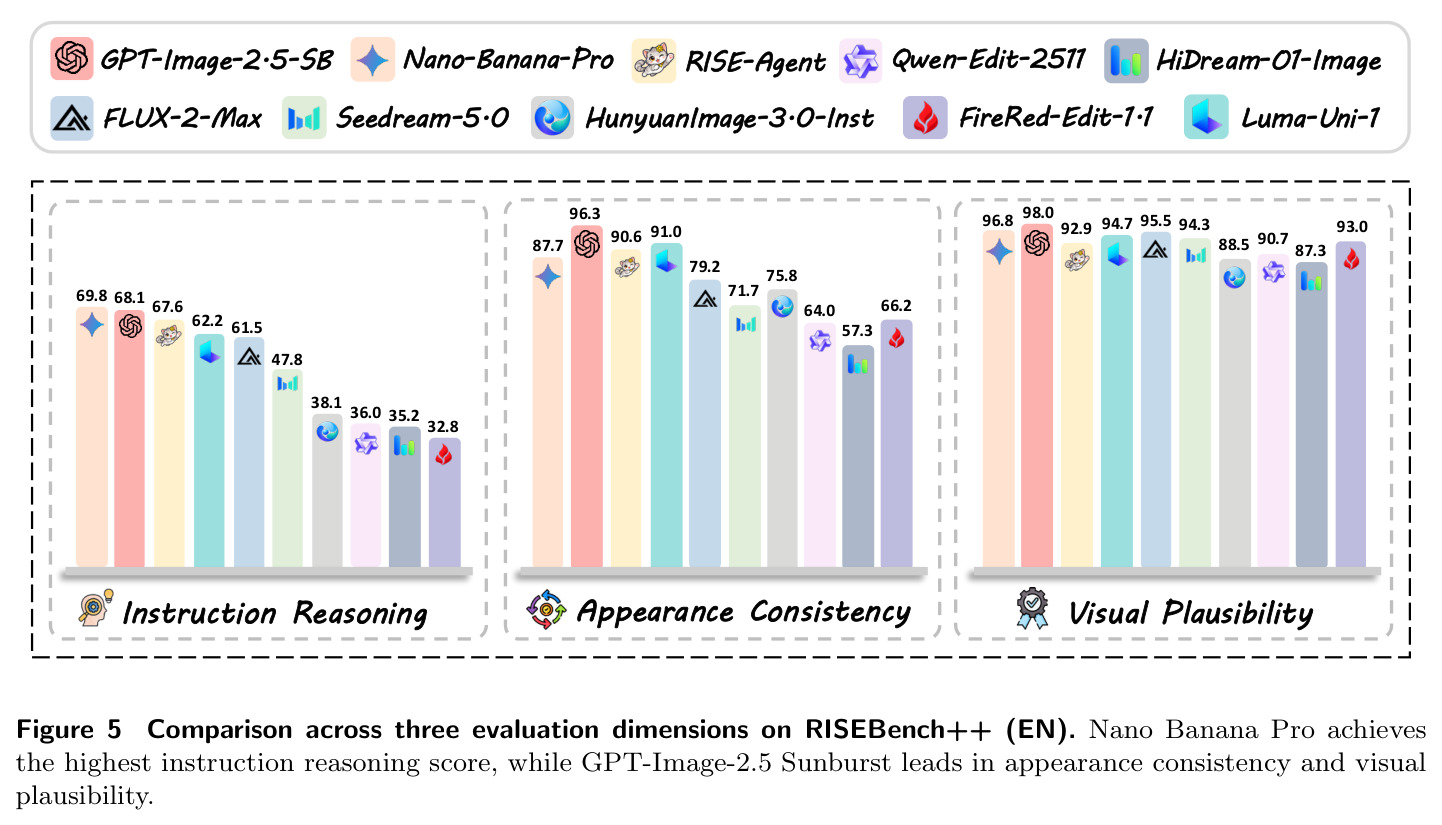
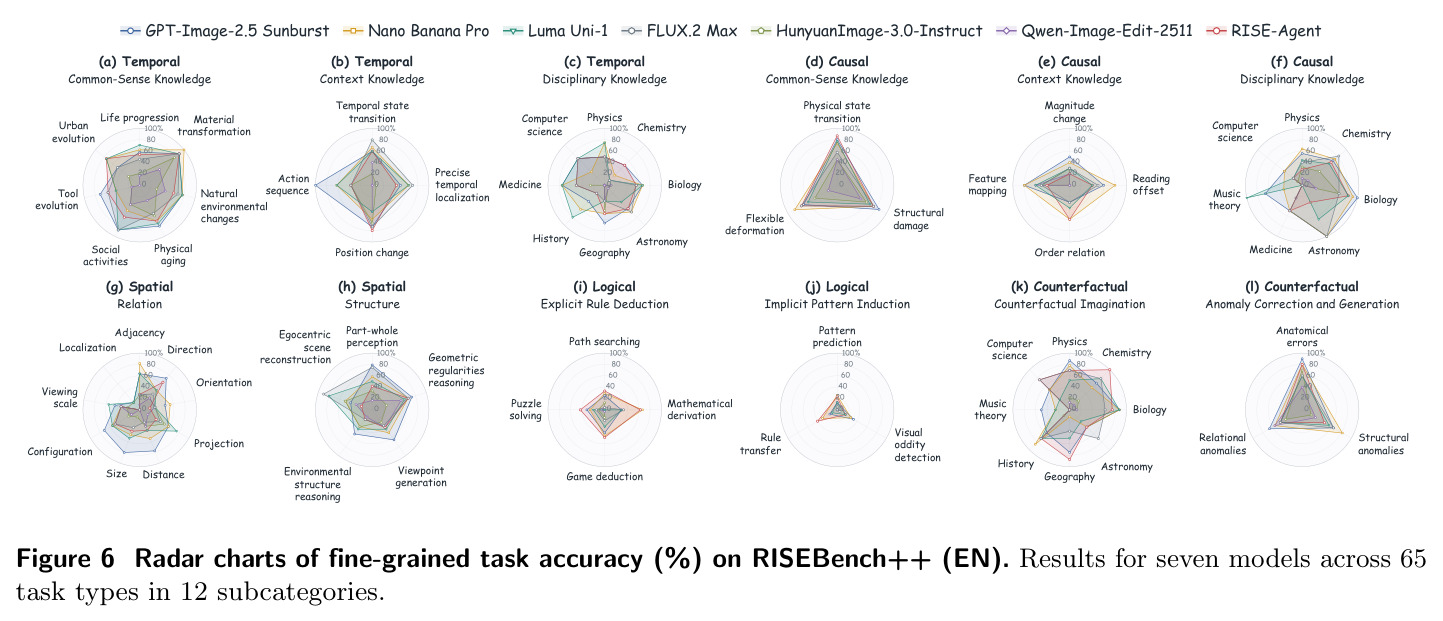
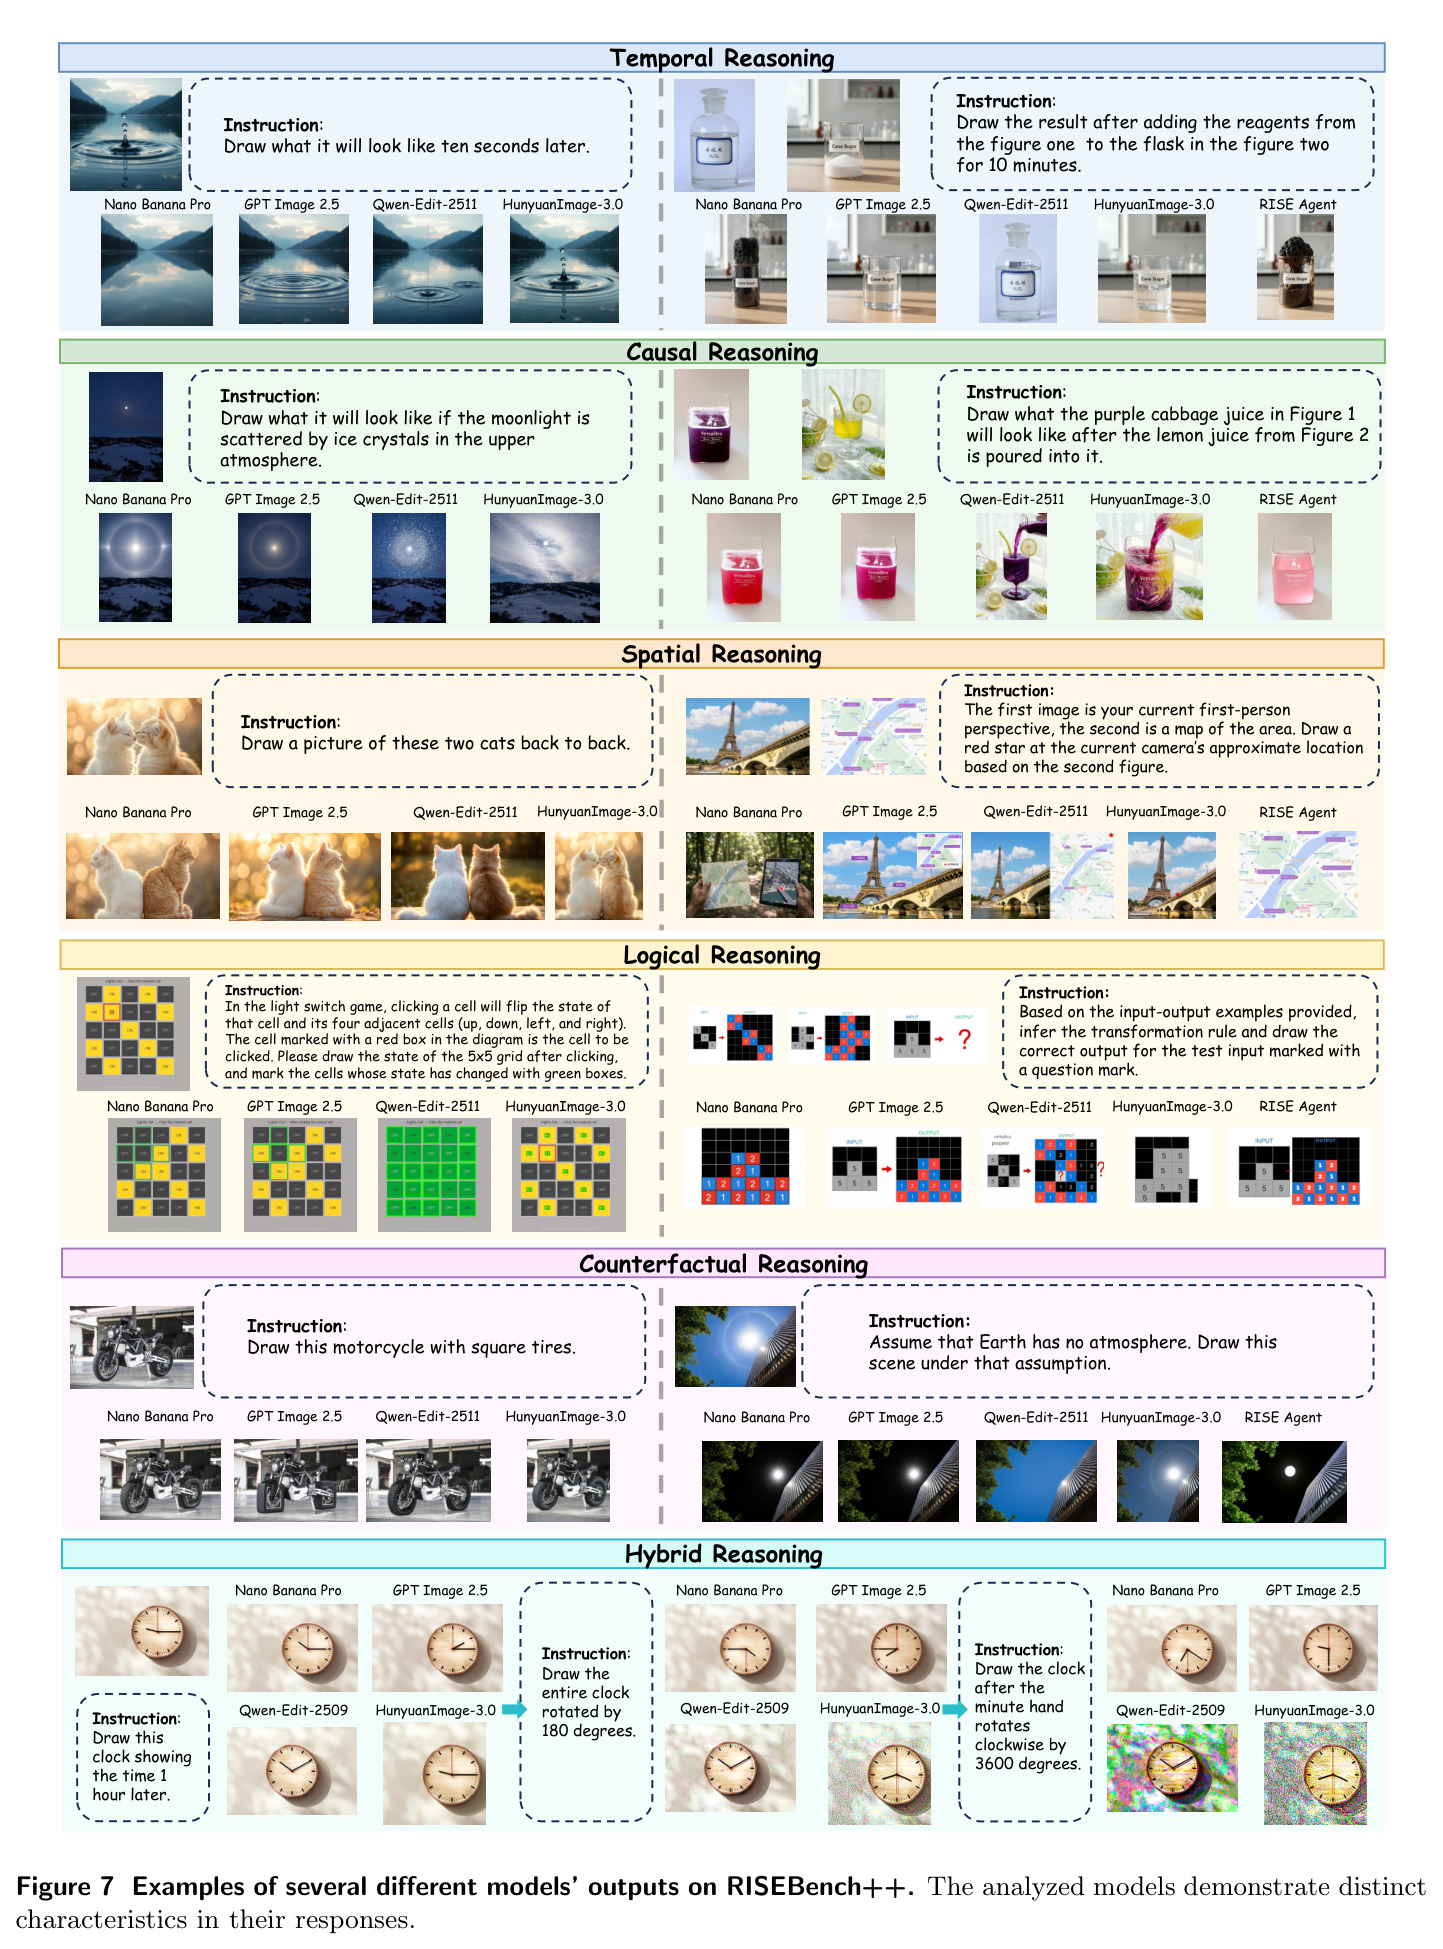
主实验在英文指令下评测 58 个方法的准确率(Table 2)。闭源梯队:GPT-Image-2.5 Sunburst 以 56.6% 居首(时间 67.5、因果 69.0、空间 64.0、逻辑 27.0、反事实 72.0、混合 39.0),没有任何模型超过 60%;Nano Banana Pro 54.6%、Nano Banana 2 50.8% 分列二三,GPT-Image-2(47.8%)、GPT-Image-2.5 Flare(46.0%)、Luma Uni-1(45.2%)、Qwen-Image-3.0(44.9%)处于第二梯队。开源与闭源差距显著:开源最佳 HunyuanImage-3.0-Instruct 仅 23.0%,其后 Qwen-Image-Edit-2511 17.1%、Qwen-Image-2.1 与 FireRed-Image-Edit-1.0 各 16.3%,与闭源最佳相差 33.6 个百分点;显式推理机制帮助有限——BAGEL 加 CoT 从 4.5% 升到 11.4%,Step1X-Edit 的 thinking/rethinking 变体从 10.2% 升到 14.1%,但仍远低于闭源。智能体方法中 RISE-Agent 达 48.0%,在逻辑推理上拿到 39.0%,超过除 Nano Banana Pro(36.0%)之外需注意其甚至超过大多数闭源模型,且远超其他智能体方法(MindBrush 21.8%、InterleaveThinker 20.6%、IntentEdit 13.2%、ImAgent 3.5%)。维度级分析(Figure 5)揭示关键结论:顶级模型的视觉合理性已达 96.8、外观一致性 93.0(GPT-Image-2.5 Sunburst),而指令推理最高仅 67.6——瓶颈已从'画得好看'转移到'想得正确'。子类别层面(Table 4):常识知识普遍较强(Nano Banana 2 时间常识 77.6%,GPT-Image-1.5 因果常识 80.0%),情境与学科知识明显更弱;空间推理可达 60% 以上但逻辑推理中隐式模式归纳全场最高仅 31.2%(Qwen-Image-3.0),细粒度上 pattern prediction 七个被分析模型全部不超过 25.6%;反事实维度表现意外地好(GPT-Image-2.5 Sunburst 反事实想象 71.4%、异常修正 73.3%)。RISE-Agent 在显式规则演绎上达 47.2%,超过全部闭源模型。消融实验(Table 7):FLUX.2 Klein 9B 裸跑 12.9%,加 planner 跃升至 40.5%(证明多数失败源于目标状态推断),加工具 42.6%(逻辑从 14.0 升至 32.0,但时间/空间略降因程序化操作不适合自然图像),加 verifier 达 48.0%(六类中五类最佳)。裁判校准(Table 6):Gemini-3-Flash 在指令推理上与人类 MAE 0.48、Spearman 0.84,被选为前两维裁判;Gemini-3.1-Flash-Lite 在视觉合理性上 MAE 0.27、Spearman 0.41,兼顾质量与成本。中文评测(Table 3)趋势一致:GPT-Image-2.5 Sunburst 55.5%,强模型跨语言稳定(Nano Banana 2 为 50.8%/51.0%),弱模型差距较大(GPT-Image-1 从 31.8% 降到 27.2%)。定性分析(Fig. 7)还发现多轮编辑中 Qwen-Image-Edit-2509 和 HunyuanImage-3.0 出现累积性视觉退化,后期输出逐渐失去结构完整性。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RISE 总体准确率(英文指令) | Accuracy(三维度全满分计为解出,%) | 最佳模型 GPT-Image-2.5 Sunburst 56.6;本文方法 RISE-Agent 48.0 | 开源最佳 HunyuanImage-3.0-Instruct 23.0;早期开源模型 BAGEL 4.5 | 闭源最佳超开源最佳 33.6 个百分点;RISE-Agent 较其执行器基线 FLUX.2 Klein 9B(12.9)提升 35.1 个百分点 |
| 逻辑推理(含显式规则演绎与隐式模式归纳) | Accuracy(%) | 闭源最佳 Nano Banana Pro 36.0;RISE-Agent 39.0(显式规则演绎 47.2,超全部闭源) | GPT-Image-2.5 Sunburst 仅 27.0;隐式模式归纳全场最高仅 31.2(Qwen-Image-3.0) | RISE-Agent 较执行器基线(逻辑 0.5)提升 38.5 个百分点,验证工具+验证闭环对形式化推理的价值 |
| 指令推理维度评分(最佳模型) | 1-5 分制换算百分制 | GPT-Image-2.5 Sunburst 67.6(全场最高) | 同模型外观一致性 93.0、视觉合理性 96.8 | 暴露核心瓶颈:视觉质量已接近满分,正确理解推理指令仍是最大短板(差距约 26-29 分) |
| LMM 裁判与人类一致性(指令推理) | MAE ↓ / Spearman ↑ | Gemini-3-Flash:MAE 0.48,Spearman 0.84 | GPT-4.1:MAE 0.88,Spearman 0.64 | MAE 降低 0.40,Spearman 提高 0.20,支撑裁判选型的可靠性 |
| 与既有基准的能力覆盖 | 支持设置数(推理/多轮/多图/Agent)与任务类型数 | RISEBench++:四项全支持,65 种任务类型,1000 例双语,评测 58 个模型 | MagicBrush/ImgEdit/AnyEdit 等均不支持推理与 Agent,任务类型 9-25 种,评测模型 7-22 个 | 任务类型数提升约 2-7 倍,评测模型数提升约 3-8 倍 |
局限与改进
作者明确承认的局限包括:其一,评测依赖 LMM 裁判,尽管做了人类校准(总体 MAE 仍为 0.46,非零误差),裁判自身的能力偏差(尤其在空间理解上)会传导到评测结果——消融中空间任务增益有限就被归因于 verifier 的空间理解能力不足;其二,为指令推理维度制作参考文本与参考图像增加了标注成本,复杂场景必须人工绘制参考图;其三,verifier 在空间类任务上的诊断与修复能力有限,制约了 RISE-Agent 的上限。我自己的观察补充几点:第一,'三维度全满分才算解出'的标准非常严格,一个维度得 4 分的样本即判失败,可能系统性低估模型的真实可用性,且三个维度的错误不能互相补偿;第二,各维度样本量不均衡(反事实与混合各仅 100 例,细分到 11 个任务类型后每类不足 10 例),子类别数字的统计噪声较大;第三,RISE-Agent 虽号称免训练,但其 planner(GPT-5.1)与 verifier(Gemini-3-Flash)都是闭源前沿模型,方法的有效性部分依赖这两个模型的推理能力,开源复现的完整性能存疑;第四,基准只覆盖静态图像的单/多图输入,视频编辑、3D 场景、更高分辨率细粒度文本编辑均未涉及;第五,闭源模型的输出经 API 获取,存在版本漂移风险,且部分模型(如 Wan2.7-Image-Pro 多图 0.0 分)疑似接口限制而非能力问题,可能污染对比;第六,评测指标未考虑编辑效率与推理成本,RISE-Agent 每例最多 1 次重规划加 2 次精修,开销远高于单步模型。
独立分析的弱点
独立分析本文工作(基准与方法)的弱点及改进方向如下。弱点一:逻辑与混合推理是最大洼地——最强闭源模型逻辑仅 27.0-36.0%,隐式模式归纳全场最高 31.2%,pattern prediction 不超过 25.6%,错误集中在符号位置与朝向。改进方向:在统一模型训练中引入可验证奖励的强化学习(类比数学推理的 RLVR),把'编辑结果是否满足规则'作为奖励信号;或架构上让编辑器显式消费符号推理模块的输出(如以程序化中间表示为条件)。弱点二:多轮编辑的累积视觉退化——Fig. 7 显示 Qwen-Image-Edit-2509 和 HunyuanImage-3.0 在时钟三轮操作中后期输出逐渐崩坏,说明每轮重生成都会累积漂移。改进方向:引入锚定原图的局部修复机制(只重绘变化区域)、跨轮一致性约束损失、或基于状态缓存的增量编辑而非全图重生成。弱点三:程序化工具与生成式编辑的路由决策依赖 planner 判断,消融显示加工具反而让时间/空间任务略降(48.0→50.5 的空间下降至 37.5),说明不合适的程序化操作会引入伪影或定位错误。改进方向:训练一个轻量路由器或在工具选择时引入不确定性估计,失败时自动回退生成式通道。弱点四:RISE-Agent 空间任务仅 37.5%,远低于 GPT-Image-2.5 Sunburst 的 64.0%。改进方向:为 executor 增加深度估计、语义分割、位姿估计等感知工具,让空间定位类编辑有几何依据。弱点五:评测端,二值化的外观一致性(逻辑类任务非 5 即 1)丢失细粒度信息,且 1000 例对 65 个任务类型来说平均每类约 15 例,支撑不了强统计结论。改进方向:扩充每类样本至 30+,或采用分层抽样报告置信区间。
未来方向
作者在结论中指出:推进视觉编辑不仅需要更强的生成能力,还需要鲁棒的视觉感知、精细的多模态推理与精确的执行;隐式视觉规则的归纳、推理相关变换的精确执行、多轮编辑的一致性是三大关键瓶颈。由此可延伸的具体方向包括:(1)端到端蒸馏——用 RISE-Agent 的成功轨迹(planner 推理链 + 工具调用 + 修正记录)作为监督信号微调统一多模态模型,把智能体能力内化,消除对闭源 API 的依赖;(2)可验证奖励强化学习——RISEBench++ 的参考图像/文本天然构成验证器,适合做 RLVR 式的编辑器训练,尤其针对显式规则演绎这类可形式化检验的任务;(3)长视野一致性——将混合推理的多轮设置扩展为更长的交互序列,研究记忆机制与场景状态跟踪;(4)多模态扩展——把推理驱动编辑推广到视频(作者团队已有 RISE-Video 相关工作)、3D 与文档编辑;(5)裁判改进——当前 Spearman 最高 0.85,可通过多裁判集成、pairwise 比较、按维度微调专用裁判模型进一步压缩人机差距;(6)隐式模式归纳专项——pattern prediction 全场不及 25.6%,可借鉴 ARC 类抽象推理的研究成果,设计从少样本示例中归纳视觉规则的专门模块;(7)成本感知评测——在准确率之外报告推理开销-准确率帕累托前沿,帮助实践者权衡单步模型与智能体框架。
复现评估
复现条件总体较好。数据方面:RISEBench++ 的 1000 个双语测试用例在 HuggingFace 集合(VisionXLab/rise)公开,每个用例含输入图像、双语指令、参考描述或参考图像;代码在 GitHub(VisionXLab/RISEBench)开源。复现主实验的门槛主要是 API 成本:19 个闭源模型需调用各官方 API(GPT-Image、Nano Banana、Luma、FLUX.2 Pro/Max、Seedream 等),按 1000 例 × 2 种语言计,费用估计在数百至数千美元量级;裁判模型 Gemini-3-Flash 与 Gemini-3.1-Flash-Lite 是成本敏感的轻量型号,评测开销可控。复现 RISE-Agent:执行器 FLUX.2 Klein 9B 开源可下载,单张消费级 GPU(约 24GB 显存)即可推理;但 planner(GPT-5.1)和 verifier(Gemini-3-Flash)依赖闭源 API,且论文提及的 7 个求解器与 12 个程序化编辑操作的实现细节需查阅开源代码与补充材料;免训练设计意味着无需 GPU 训练集群,这是相对友好的一点。复现人类校准实验(Table 6)需要 4 名标注者对 200 个样本按统一 rubric 打分,组织成本中等。总体评估:复现评测排行榜为中等难度(主要为 API 费用与工程整合),复现 RISE-Agent 为中等难度(依赖闭源 API 但无需训练),完全独立复现(含裁判换用开源模型)则需接受性能下降,因为开源裁判的 Spearman 明显更低(如 Qwen3-VL-235B 仅 0.69)。
论文图表
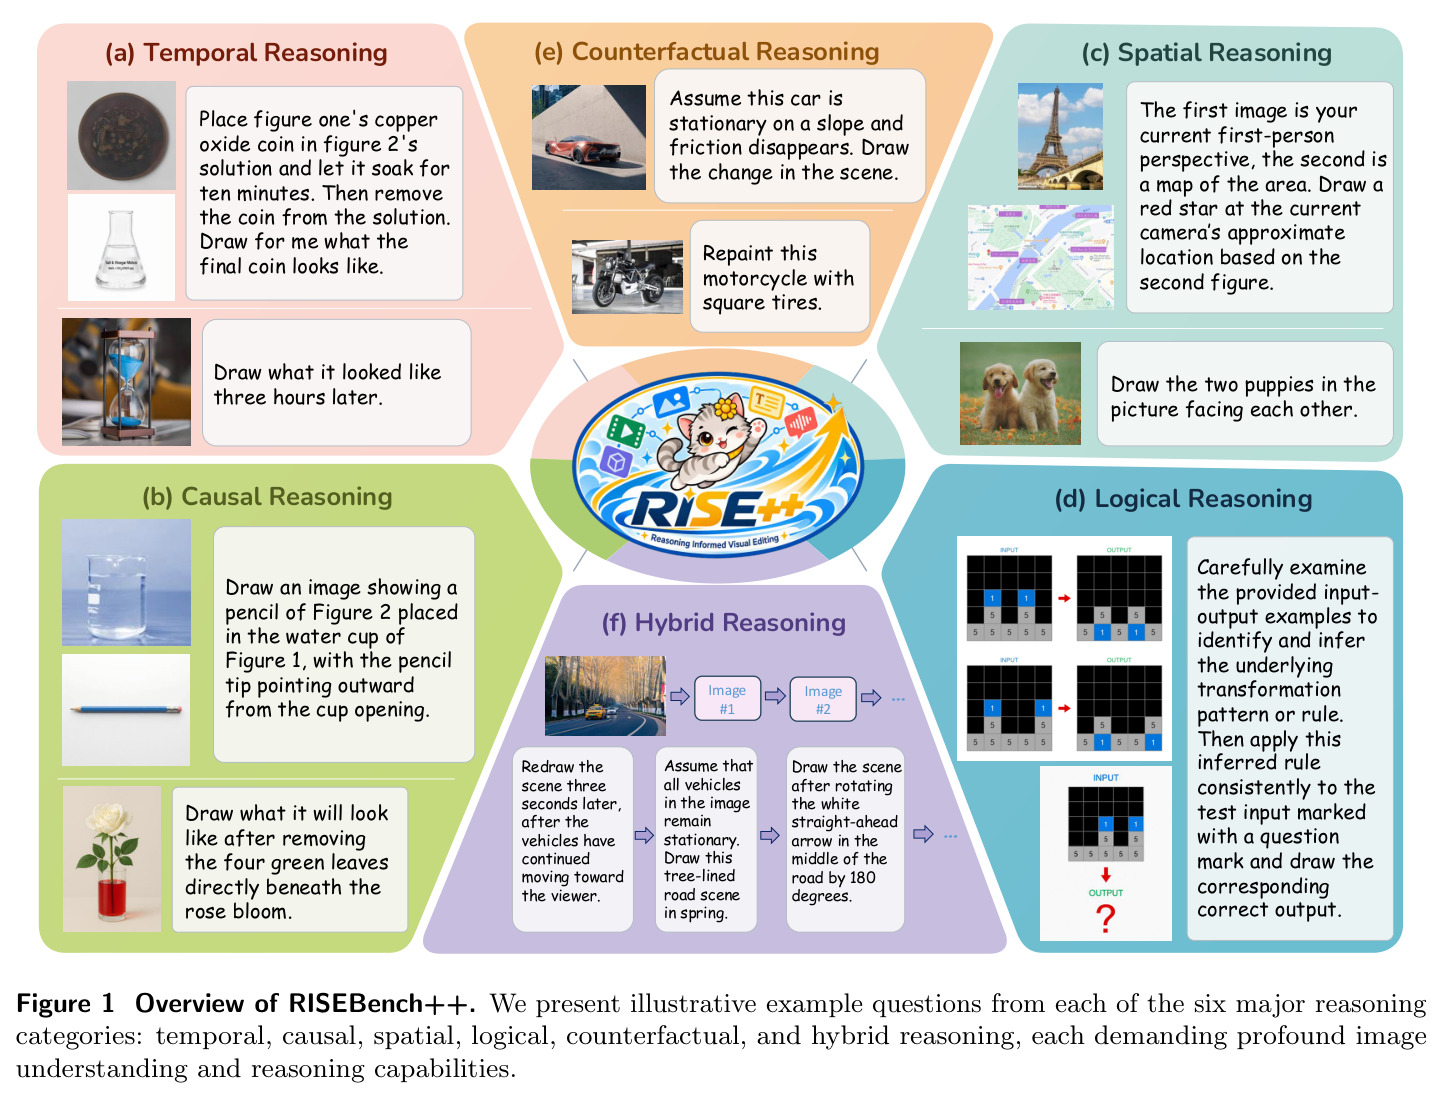
用六个真实测试用例直观展示六大推理维度:(a) 时间推理——画出氧化硬币在溶液中浸泡十分钟并取出后的样子;(b) 因果推理——画出移除玫瑰花朵下方四片绿叶后的样子、推断输入输出变换规则并应用到带问号的测试输入;(c) 空间推理——结合第一人称视角图与地图在相机大概位置画红星、画出三小时后的场景;(d) 逻辑推理——画出铅笔尖朝杯口外侧插入水杯后的样子、假设图中所有车辆静止画出场景;(e) 反事实推理——假设斜坡上的汽车摩擦力消失画出场景变化、把摩托车重绘为方轮胎;(f) 混合推理——多轮指令组合编辑。每个例子都同时要求深度图像理解与推理。
这是理解整篇论文研究对象的入口:仅凭定义无法体会'推理驱动编辑'与传统编辑的本质区别,这张图用具体例子展示了指令如何隐含世界知识(氧化反应、月晕成因)、空间归纳(地图定位)与规则推理(输入输出模式),是 motivation 部分最有说服力的材料。