审视智能体式黑盒优化:面向LLM智能体的黑盒优化基准(AgenticBBO-Bench) A Closer Look at Agentic BBO: Benchmarking LLM Agents for Black-Box Optimization
提出跨五域的AgenticBBO-Bench基准,系统剖析LLM智能体做黑盒优化时工具、信息与控制权的价值。
前置知识
黑盒优化(Black-Box Optimization, BBO)
目标函数只能通过“提交输入、查询返回数值”的方式评估,拿不到解析表达式和梯度,且每次评估往往昂贵(训练一个模型、跑一次仿真、做一次实验)。优化器在有限评估预算 $B$ 内,基于历史观测 $H_{t-1}=\{(x_i,y_i)\}_{i=1}^{t-1}$ 逐轮选择下一个候选点 $x_t$,观察 $y_t=f(x_t)$ 直到预算耗尽。
整篇论文的舞台就是有限预算下的序列黑盒优化:五个任务族、统一协议、计分方式与所有对比方法都围绕这个形式化定义展开,不理解它就无法理解“预算只算真实评估”等关键设计。
贝叶斯优化(Bayesian Optimization, BO)
经典 BBO 方法:先用高斯过程(GP)等代理模型拟合已观测的 $(x,y)$ 数据,再优化采集函数(EI、UCB、LogEI 等)在“利用当前最优附近”与“探索高不确定性区域”之间权衡,选出下一个评估点。TuRBO 在其上加信任域机制,TPE、CMA-ES 则是同类的启发式数值优化器。
GP-BO、TuRBO 既是论文的数值基线,其参考终点还被用作分数归一化的锚点;“给智能体配 GP 工具是否有用”“把搜索移交给 TuRBO 效果如何”等核心消融全部以 BO 为参照物。
LLM 智能体与 Agent Harness
LLM 智能体指在循环中自主决定下一步动作的语言模型系统:读任务文档、写代码、调用工具、观察输出后再决策,直到完成目标。Harness 是管理模型与环境交互的脚手架(如 Codex CLI),负责工作区状态、工具接入与消息流转。同一个模型换 harness,行为可能显著不同。
论文的核心立场是:评估对象是“模型 × harness × 任务信息 × 工具”构成的完整系统,而非孤立的模型本身,这直接决定了基准的协议设计和所有实验结论的适用范围。
Anytime 评估与归一化计分
不只看搜索结束时的最终解,而是记录整个过程的 best-so-far 轨迹,归一化后聚合,使任意预算截断点上的表现都被计入。本文定义综合分 $S = 0.7A + 0.3F$,其中 $A=\frac{1}{B}\sum_{j=1}^{B} q(y_j^\star)$ 是归一化轨迹均值,$F=q(y_B^\star)$ 是终点质量,$q(\cdot)$ 把不同量纲的目标值映射到统一尺度。
这是 AgenticBBO-Bench 的统一计分协议,论文所有表格里的数字(0.460、0.661 等)都是这个分数,读懂它是理解一切实验结果的前提。
研究动机
黑盒优化广泛存在于化工设计、材料优化、芯片设计等每次评估都很昂贵的场景。近年 LLM 为 BBO 打开了利用任务语义与领域知识的新通道,但已有工作分裂为两类且彼此割裂:一类把 LLM 当作流水线中的固定组件——每轮由外层算法调用它执行一个预定义操作(如 OPRO 直接生成候选点),其余流程全部预先写死;另一类新兴的 agentic 研究(如 Sara、纯智能体驱动的生物设计)让 LLM 自主组织搜索过程,却各自采用不同的任务域、工具集、信息暴露方式与 harness,并通常只在单一领域内评估——例如只在超参数优化或只在分子设计上报告结果。后果是不同论文的数字无法横向比较:一个系统在某域领先,可能源于模型更强、任务信息更丰富,也可能只是 harness 或评估口径的差异,任何单个设计选择的贡献都无从分离。
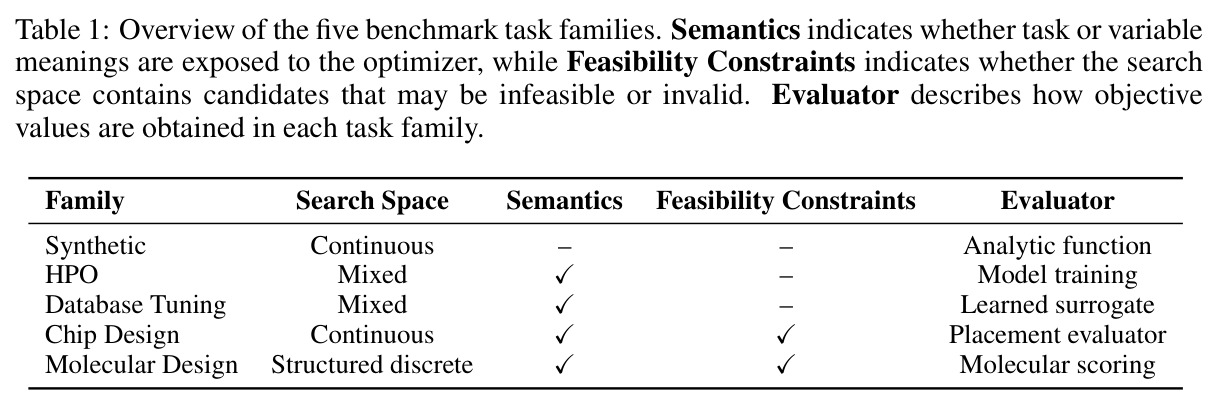
本文的目标是本文要建一个跨领域、可公平比较、支持受控归因的 agentic BBO 评测基础设施,共三点:其一,把合成函数(BBOB)、超参数优化(Bayesmark)、数据库调参(DBTune)、芯片宏布局(BBOPlace-Bench)、分子设计(GuacaMol)五个成熟任务族放进统一的有限预算协议,覆盖连续、混合与结构化搜索空间以及不同的语义丰富度和可行性约束;其二,在同一协议下做受控消融,量化三类因素——数值优化工具、任务信息与先验知识、LLM 在优化回路中的参与程度——对性能的贡献;其三,从每个域各取一个代表任务构成紧凑的五任务前沿挑战赛,作为衡量未来通用优化智能体与前沿模型的标准化榜单,并引入 token 成本维度。
与已有工作不同的是,独特切入在于把“评估对象”从单个模型或单个算法换成完整的智能体系统,并把经典数值优化器降格为智能体可选用(也可以不用)的工具。作者先形式化 Agentic BBO:每次昂贵评估前存在由 LLM 在线决定的可变动作序列 $(H_{t-1}, \mathcal{I}) \to a_{t,1} \to \cdots \to a_{t,K_t} \to x_t \to y_t$。基于这个视角,他们不问“哪种优化器最好”,而问“工具、信息、控制权分别放在哪里最值”,从而得出一系列与直觉相反的结论——更多数值工具并不必然有益、LLM 不必全程在线、详细先验可能不如正确先验。这种以受控变量实验为核心的跨域 benchmark 研究在 agentic BBO 领域尚属首次。
核心方法
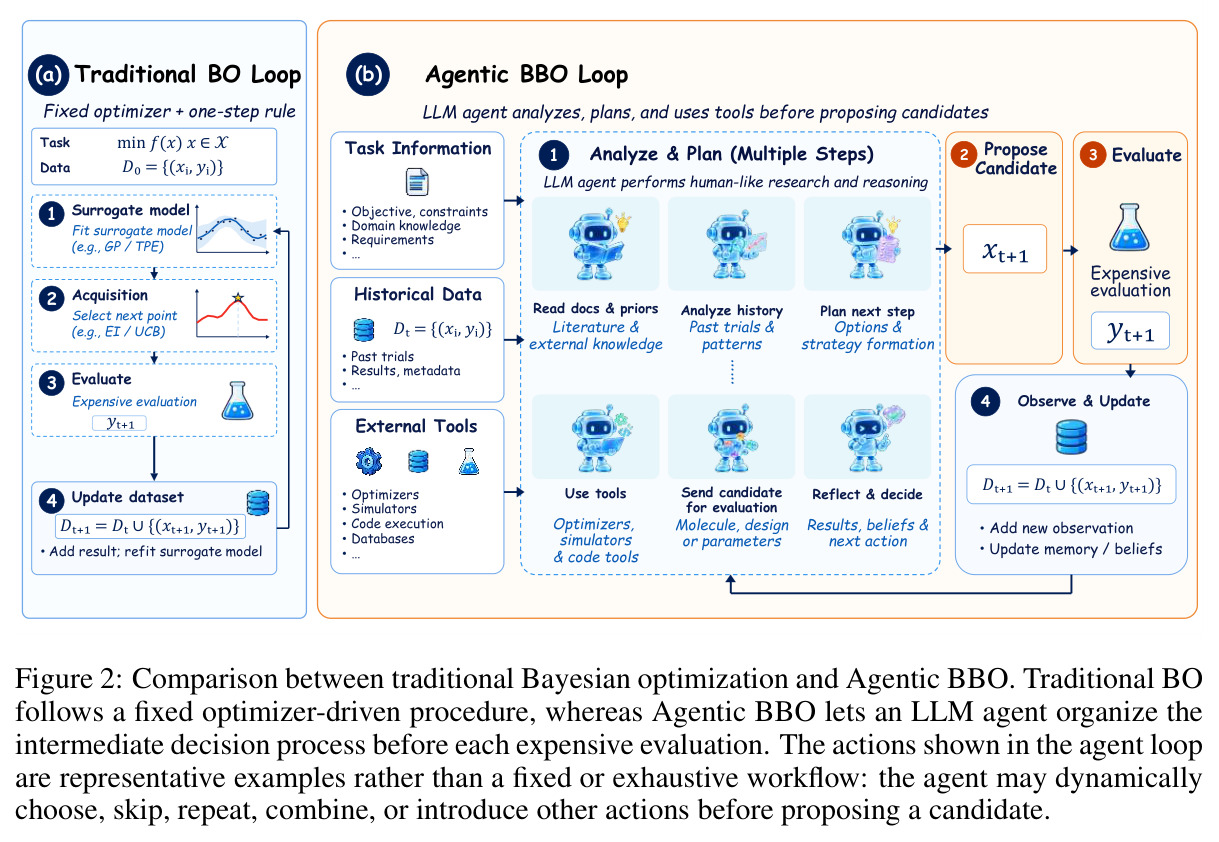
整体思路是“统一外循环、可控内变量”。外循环是所有方法共享的黑盒交互协议:每个任务与种子下,各方法拿到相同的初始观测和相同的新评估预算,只有宿主机对合法候选的真实评估计入预算,模型推理、代码执行、工具调用、非法候选校验均不计费。计分采用 anytime 协议:先把每步 best-so-far 值归一化为 $q(\cdot)$,取轨迹均值 $A$,再加 30% 权重的终点质量 $F$,即 $S = 0.7A + 0.3F$。归一化用匹配 GP 参考终点 $r$ 作中间锚($q(b)=0$,$q(r)=0.6$,超出后以 $1-0.4\exp(-1.5\frac{y-r}{r-b})$ 光滑逼近 1);BBOB 等已知最优值 $u$ 的任务用解析上界,分子任务用 $\min(1, \frac{y-b}{u-b})$。默认骨干是 DeepSeek V4.1 Flash 加 Codex harness(高推理档),对比 Direct(任务描述与历史直接进上下文、结构化输出候选)与 Agentic(持久工作区 + Bash/Python + 六类接口)两种配置。
核心概念创新是 Agentic BBO 的形式化:经典 BO 把“历史 → 下一候选”写死为“拟合代理模型 + 优化采集函数”的固定映射,而 agentic 设定允许在每次昂贵评估前插入任意长的中间动作序列——读任务卡与先验、分析历史轨迹、写 Python 拟合自定义代理、调用数值优化器、反思后再决策——动作的种类、顺序、重复次数完全由 LLM 在线决定。与已有 LLM-for-BO 方法(LLM 提候选、LLM 建模目标函数、LLM 初始化下游优化器)的本质区别是:LLM 不再扮演某个预定义算子,而是决定整个决策流程的组织方式;数值优化器只是它工具箱里的一个选项,甚至可以弃之不用、自建任务特定分析。由此评估也必须面向“模型 × harness × 信息 × 工具”的整个系统。
方法步骤详情
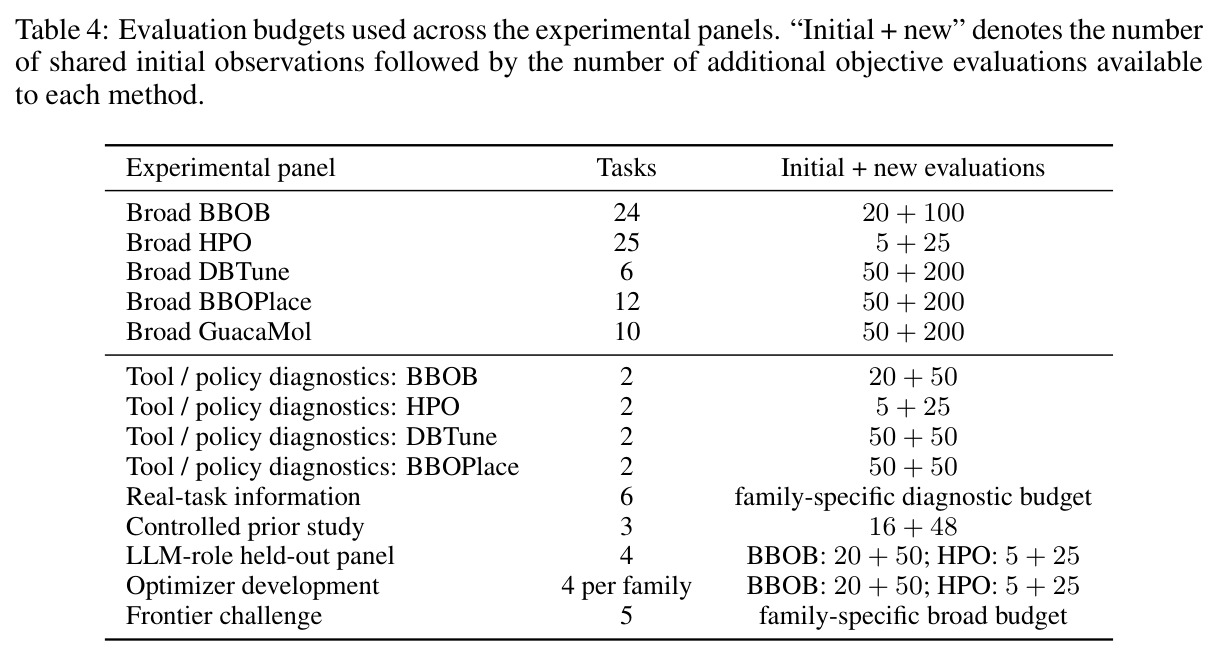
构建分四步。选任务:五域共 77 个任务——BBOB 24 个(不暴露函数语义)、Bayesmark HPO 25 个、DBTune 数据库调参 6 个、BBOPlace 32 宏布局 12 个、GuacaMol 分子 10 个,预算(初始+新评估)分别为 20+100、5+25、50+200、50+200、50+200。搭环境:每次运行跑在隔离 Docker 容器,工作区含 task.md 任务卡与 instructions.md,经 bbo_tool.py 桥接六个宿主接口(取任务上下文/搜索空间/历史/incumbent、写草稿、提交候选),评估器与隐藏状态留在宿主侧。定协议:每轮须提交通过校验的合法候选才结束,非法提交退回修改、不扣预算,新观测回注会话且上下文跨轮保留。定归因实验:工具消融对比 base / +GP Suggest / +GP Tools;信息消融对比匿名 I0 / 语义 I1 / 语义+先验 I2,另在三个 12 维解析任务上分解先验内容;角色消融对比全程 Agentic、GP 策略控制、热身后 handoff(16/8 次评估后移交 GP/TuRBO/局部搜索且共享同一智能体前缀)、以及离线开发可复用优化器后部署到留出任务。
技术新颖性
技术新颖性有三。第一,首个跨五域的 agentic BBO 基准:此前 AgentHPOBench 等只标准化单一设置,本文首次让 TuRBO、TPE、CMA-ES、Graph-GA 等专用优化器与通用智能体在同一计分规则下同台竞技。第二,归一化协议设计:用匹配 GP 参考终点作 0.6 锚、已知最优值任务用解析上界、分子任务用固定参考(Median1 上界 0.58),并明确规定被比较智能体的结果不得参与定标,避免循环偏置,使跨任务聚合有了公认尺度。第三,受控归因方法论:通过只改暴露接口(GP 工具)、只改任务卡内容(匿名化但重编码同一初始点)、只改决策权(策略控制 vs 坐标提交 vs 共享同一智能体前缀的 handoff)的成对设计,把每个因素的因果贡献从端到端分数中剥离出来;这种实验设计在 BBO 文献中少见,也让“更多工具不等于更好”这类反直觉结论有了可信的证据链。
实验结果
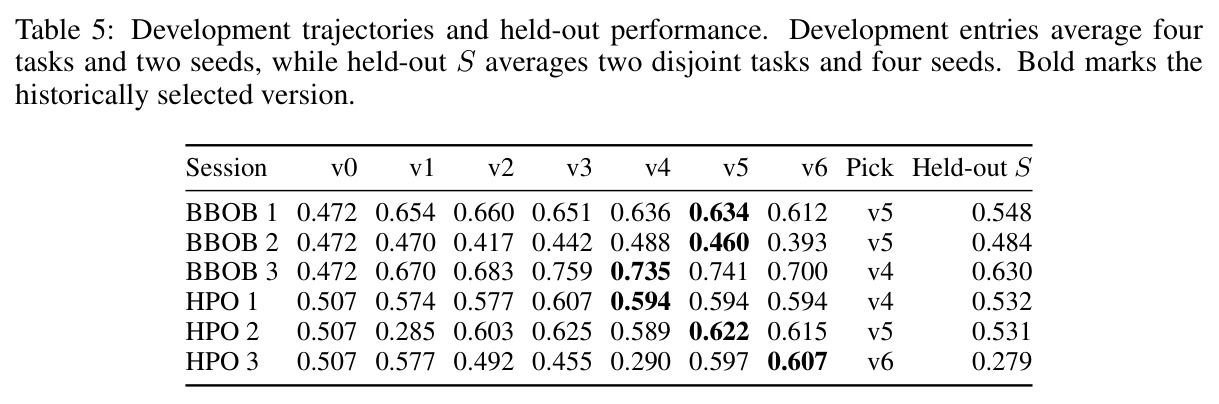
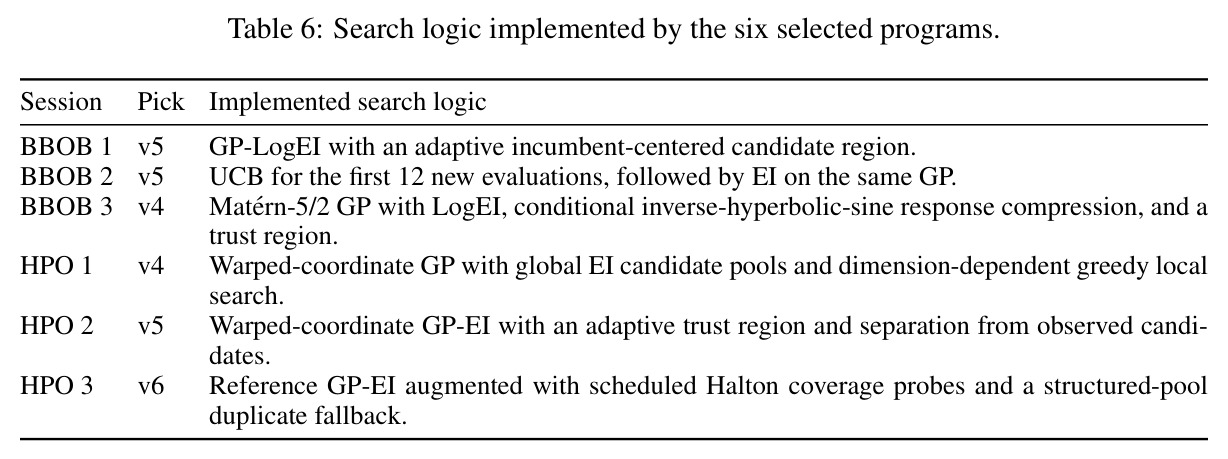
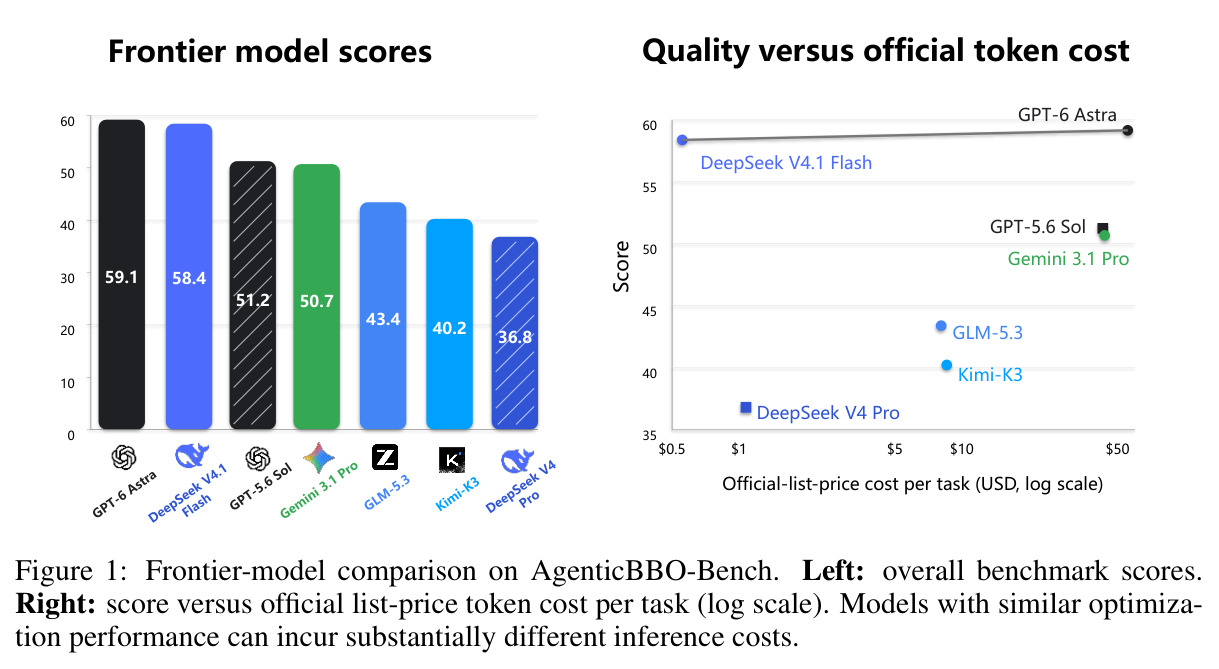
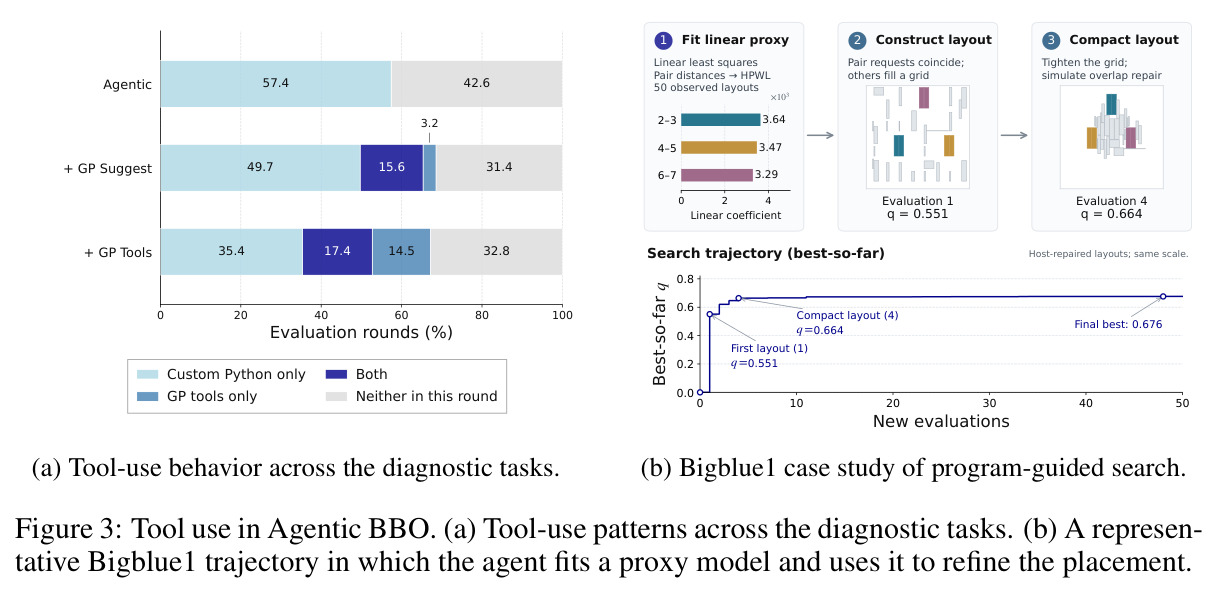
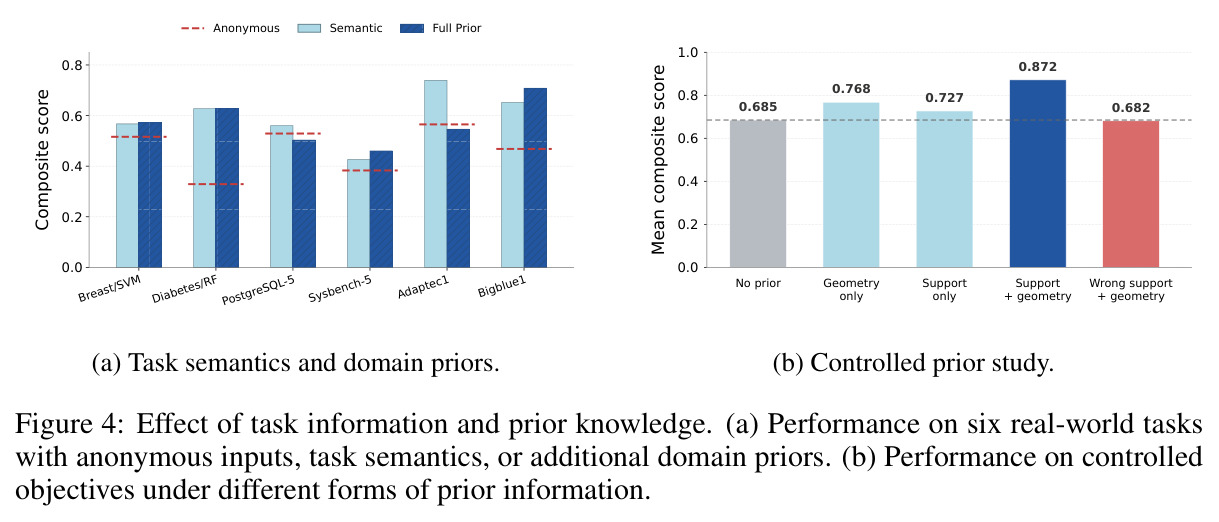
主实验(Table 2a):Agentic 在五域全胜 Direct,平均相对提升 30.3%——BBOB 0.460→0.661(+43.7%)、GuacaMol 0.565→0.840(+48.7%)、DBTune 0.388→0.525、BBOPlace 0.465→0.544、HPO 0.519→0.554,并在四域超过最强数值优化器,仅 DBTune 由 TuRBO 的 0.660 领先。工具消融(八任务均值):Agentic 0.589 优于 +GP Suggest 0.574 与 +GP Tools 0.538,且后者仍有 35.4% 轮次只用自写 Python。信息消融:语义把六真实任务均值从 0.465 提到 0.595,叠加先验反降至 0.569;受控 12 维任务中“正确支持集+几何”从 0.685 提到 0.872,错误支持集跌回 0.682。角色消融:GP 策略控制 0.516 低于全程 Agentic 0.569;热身后移交 TuRBO 得 0.570,远超冷启动的 0.475;LLM 开发的优化器留出均值 0.501 高于固定 GP 0.451 但方差极大(HPO 组开发 0.607、留出仅 0.279)。前沿赛:GPT-6 Astra 均分 0.591 居首,DeepSeek V4.1 Flash 0.584 紧随,无一模型全域占优(后者 GuacaMol 0.823 却 DBTune 仅 0.299),性能与 token 价格弱相关,二者构成 Pareto 前沿。
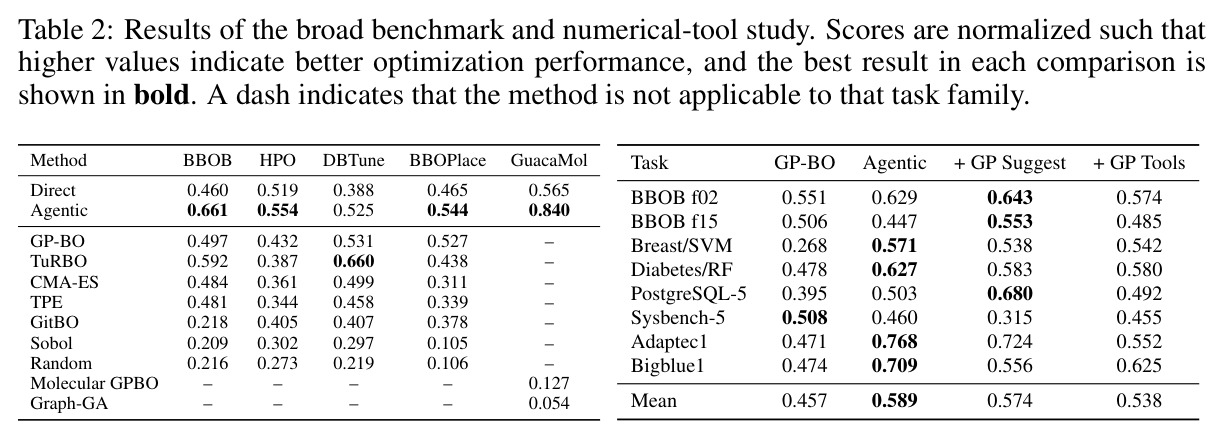
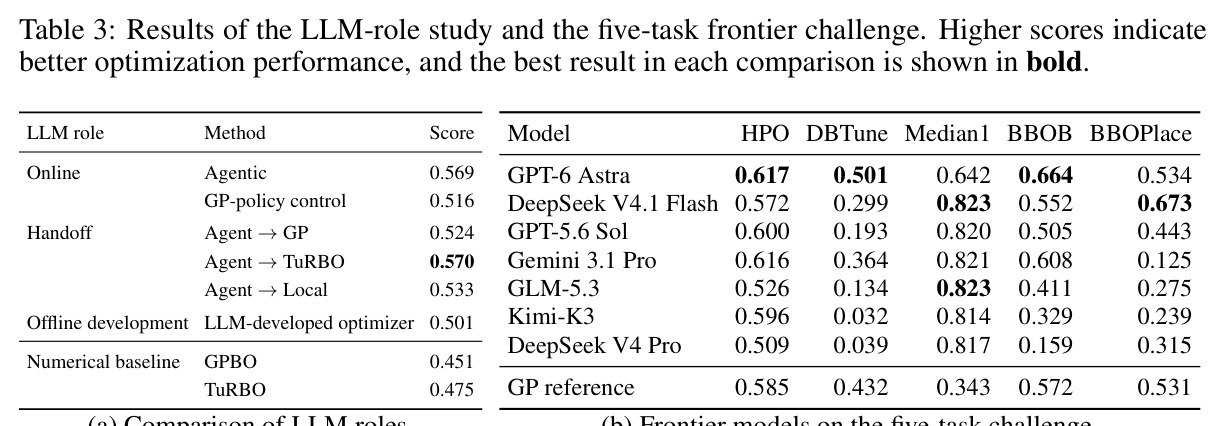
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 连续合成优化(BBOB,24 函数) | 归一化综合分 $S$(20+100 次评估) | Agentic 0.661 | Direct 0.460;最强数值基线 TuRBO 0.592 | 较 Direct +43.7%,且超过所有数值基线 |
| 超参数优化(Bayesmark,25 任务) | 归一化综合分 $S$(5+25 次评估) | Agentic 0.554 | Direct 0.519;GP-BO 0.432;TPE 0.344 | 较 Direct +6.7%,超过全部数值基线 |
| 数据库调参(DBTune,6 任务) | 归一化综合分 $S$(50+200 次评估) | Agentic 0.525 | Direct 0.388;TuRBO 0.660(该域最强) | 较 Direct +35.3%,但未超过 TuRBO |
| 芯片宏布局(BBOPlace,12 任务) | 归一化综合分 $S$(50+200 次评估) | Agentic 0.544 | Direct 0.465;GP-BO 0.527 | 较 Direct +17.0%,超过全部数值基线 |
| 分子设计(GuacaMol,10 目标) | 归一化综合分 $S$(50+200 次评估) | Agentic 0.840 | Direct 0.565;分子 GPBO 0.127;Graph-GA 0.054 | 较 Direct +48.7%,大幅超过专用分子优化器 |
| 数值工具消融(8 个诊断任务) | 任务平均分 $S$ | base Agentic 0.589 | +GP Suggest 0.574;+GP Tools 0.538 | 增加 GP 工具反而平均下降,未带来一致收益 |
| 五任务前沿挑战赛(每域 1 任务 × 7 模型) | 平均分 $S$(每配置 1 次运行) | GPT-6 Astra 0.591(成本高) | DeepSeek V4.1 Flash 0.584(成本低一个量级);GP 参考均值约 0.493 | 两者构成性能-成本 Pareto 前沿;尾部模型 Kimi-K3 0.402、DeepSeek V4 Pro 0.368 |
局限与改进
作者承认的限制:广义基准每任务仅 2 次独立运行、诊断消融 4 次、前沿赛每模型每任务仅 1 次运行,全文未报告方差与显著性检验;各诊断面板复用部分任务而非独立扩容,结果应视为互补的诊断视角;DBTune 用学习到的代理模型而非真实数据库评估,结论对真实系统的可迁移性存疑;五任务挑战赛刻意紧凑,单任务噪声可能放大模型间差异。我自己的观察:其一,归一化以 GP 参考终点为 0.6 锚,虽已排除被比较智能体的结果参与定标,但锚点本身仍可能对行为与 GP 相近的方法更友好;其二,前沿赛七个模型全部跑在同一个 Codex harness 下,模型排名与 harness 耦合,换用其他 harness 可能洗牌;其三,工具消融只覆盖 GP 一族后端,无法回答“配对的工具是否会更好”;其四,分子任务被排除在所有消融之外,而它恰好是 Agentic 提升最大的域(0.840),结论的跨域完整性有缺口;其五,token 成本按官方牌价计算,实际采购价差异可能改变 Pareto 前沿的形状。
独立分析的弱点
独立分析的弱点:其一,统计功效不足——前沿赛单次运行下,Kimi-K3 在 DBTune 的 0.032 与 GLM-5.3 的 0.134 这类巨大差距可能掺杂大量任务级随机性,改进方向是每配置至少 3–5 个种子并报告 bootstrap 置信区间;其二,评分对 GP 锚点存在依赖——若某任务上 GP 表现异常,所有方法的相对位置都会被这一个锚点扭曲,可改用多参考聚合或敏感性分析;其三,harness 单一——Codex 的持久工作区风格天然偏爱擅长写代码的模型,应在 2–3 个 harness 上重复榜单以解耦模型与脚手架效应;其四,工具生态单薄——只有 GP 工具无法证明“对的工具”也无益,应补充 CMA-ES、TuRBO、TabPFN 类工具箱的对照;其五,先验研究仅在 12 维合成函数上进行,真实任务中“正确且可执行”的先验如何自动获取、如何验证正确性仍完全空白;其六,分子设计缺席消融,而它是 Agentic 收益最大的域,缺少对该域工具与信息作用的认识。
未来方向
作者在附录 C 提出六个方向:从固定工具走向任务自适应工具组合——提供互补优化器组合,让智能体按任务与搜索状态选择或混搭;从给定先验走向先验发现——主动识别重要变量、交互与有希望的区域;从全程在线走向成本感知路由——判断何时 LLM 推理值得其开销,直接呼应 handoff 实验的结果;从任务定制搜索走向可泛化算法发现——构造代表性开发集、鼓励可复用策略而非过拟合小任务集,连接 Meta-BBO 与自动化算法发现;从固定 harness 走向可演化的智能体系统——联合自适应工具、优化器接口与控制策略;从孤立优化走向可复用经验——建立优化经验库,为新任务检索相关策略、工具与先验并规避负迁移。基于其成果还可延伸:把代理评估器换成真实数据库 / EDA 流程验证迁移性;扩展到多目标与强约束优化;研究极小预算(<20 次评估)下智能体是否仍优于数值方法;以及把五任务挑战赛扩展为带统计检验的持续 leaderboard。
复现评估
复现评估:代码开源于 github.com/lamda-bbo/agentic-bbo,五个任务族全部来自公开基准(COCO/BBOB、Bayesmark、DBTune、BBOPlace-Bench、GuacaMol),交互协议、提示模板、任务卡、六类接口定义、归一化公式(附录 A.3 逐段给出)与各消融条件的提示词均完整列出,工程上以 Docker 隔离、宿主侧持有评估器。算力门槛主要在 LLM 推理:默认配置需 DeepSeek V4.1 Flash API(高推理档),前沿赛需 GPT-6 Astra 等 7 个前沿模型 API;单任务真实评估不超过 250 次,但每轮伴随大量 token 消耗(Figure 1 显示每任务成本约 $0.5–$50 量级),77 任务 × 2 次运行的总开销对实验室可承受、对个人偏高。难度中等:协议细节多(非法提交不扣预算、宿主隔离、锚点归一化、handoff 共享前缀),认真对照附录实现约需数天;最大不确定因素是闭源模型行为可能随版本漂移,长期榜单需固定模型版本号。
论文图表