DistScene:面向3D场景生成的物体到场景蒸馏 DistScene: Object-to-Scene Distillation for 3D Scene Generation
单图联合生成环境与可分解物体,自蒸馏数据引擎训练场景级3D生成器。
前置知识
稀疏体素3D生成(Sparse Voxel Generation)
把3D资产表示为规则网格上被激活的体素集合,每个活跃体素携带几何与材质特征。稀疏VAE(用稀疏卷积网络搭建)将其压缩到紧凑潜空间,其上用图像条件的流匹配生成器(通常为稀疏DiT)做生成。生成按阶段进行:先预测稀疏占据结构,再在活跃体素内生成几何潜变量,最后合成外观。
DistScene的全部三个模块(场景帧生成、物体精修、纹理生成都建立在这一表征之上, TRELLIS.2就是这种范式的代表,理解它是读懂方法部分的前提。
结构化潜变量(Structured Latents, SLAT)
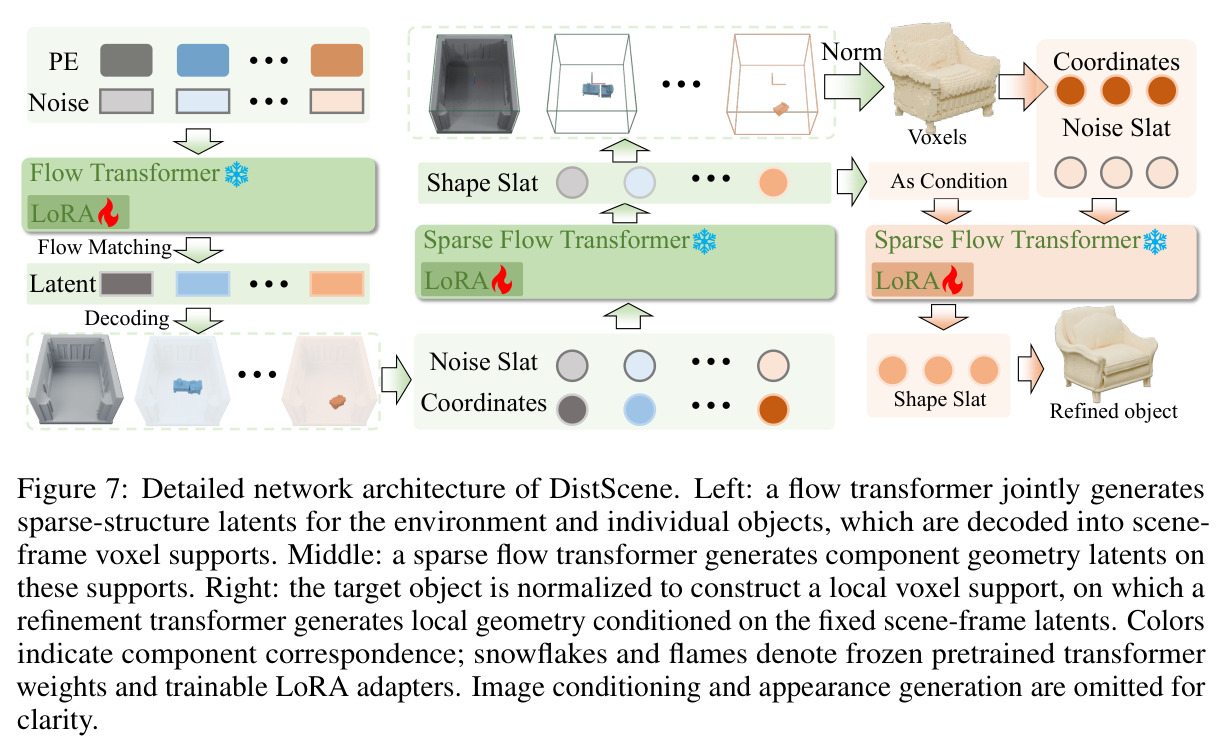
TRELLIS系列提出的表征:给稀疏支撑(一组活跃体素坐标)上的每个体素分配一个学习到的特征向量。形状SLAT编码用于解码网格的几何特征,纹理SLAT在几何条件下编码外观与材质。支撑描述组件的空间范围,SLAT描述其几何与外观细节。
论文中每个场景组件(环境与物体)都有独立的支撑与形状/纹理SLAT,场景帧与物体局部帧各一套,是理解监督目标构造与精修流程的关键。
流匹配(Flow Matching)
一种连续归一化流的训练目标:网络$v_\theta(z^t, t)$学习从噪声$z^0$到数据$z^1$的速度场,损失为$\mathbb{E}\|v_\theta(z^t,t)-(z^1-z^0)\|^2$,推理时沿预测速度场积分采样。相比DDPM式扩散,训练更稳定、采样路径更直接。
本文场景生成损失$\mathcal{L}_{\text{scene}}$与精修损失$\mathcal{L}_{\text{refine}}$都是流匹配目标,只是作用在不同的潜变量集合与条件上。
LoRA(低秩适配微调)
冻结预训练权重,只在旁边注入低秩矩阵$BA$(秩$r\ll d$)作为可训练参数,使微调大模型只需极少量参数与显存,同时保留预训练先验。
DistScene不从头训练场景生成器,而是用秩32的LoRA把TRELLIS.2的物体生成先验适配到组合场景任务,这是其'蒸馏'思想在网络层面的落地。
组合式3D场景生成(Compositional Scene Generation)
从单张图像恢复多个独立3D组件(物体及其环境)并保持其空间组织关系的任务,区别于只输出一整块不可编辑网格的整体重建。评估既看场景级几何(CD、F-score),也看物体级几何与包围盒IoU(摆放是否正确)。
理解该任务的评估协议(场景级与物体级指标并重)才能明白论文各表格中CD-S/CD-O/FSS/FSO/IoU分别衡量什么。
Chamfer Distance与F-score
CD衡量两个点集间双向最近邻距离的均值/积分,越小几何越吻合;F-score是在给定距离阈值下精度与召回的调和平均,越高越好。论文室外用CD-L1与F@0.05,室内用CD与阈值0.1的F-score(百分比)。
论文所有定量结论(如MIDI-test场景CD从0.1295降到0.0877)都以这两个指标表述,是解读实验部分的通用语言。
研究动机
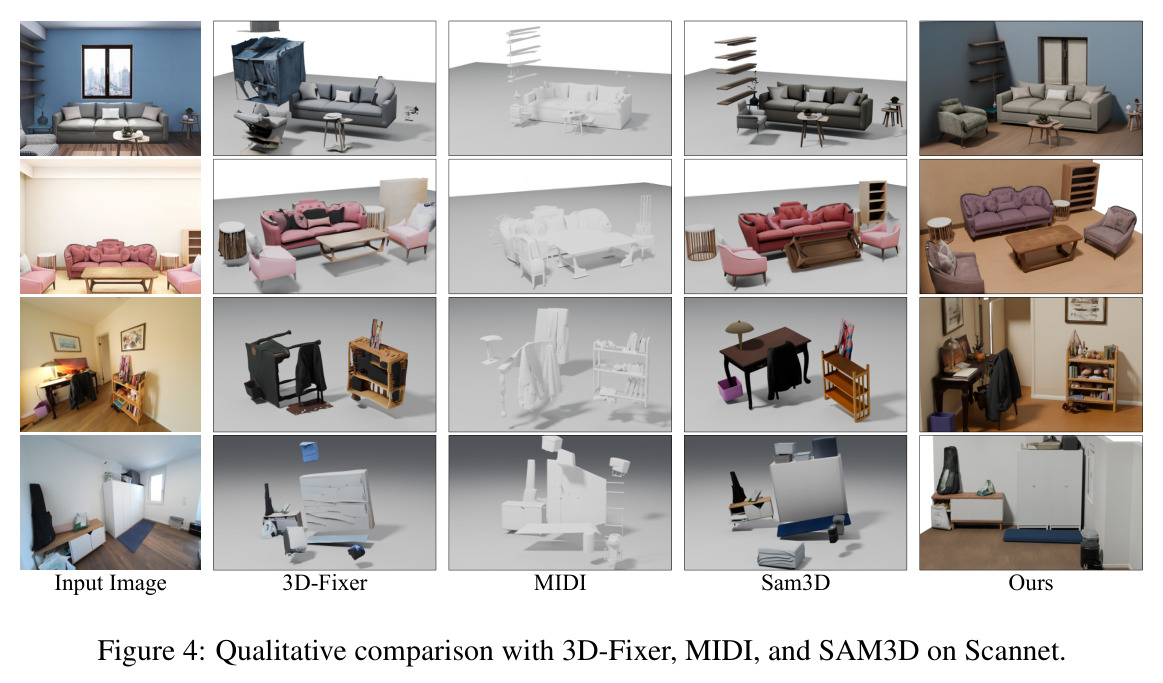
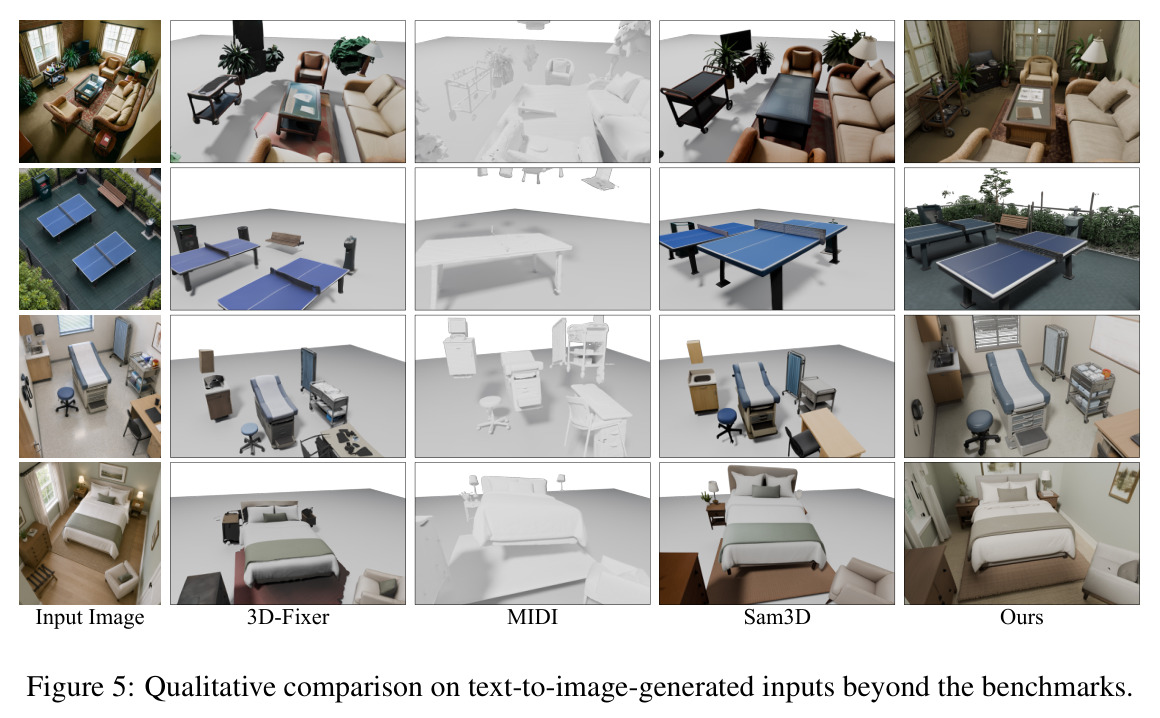
单图组合式3D场景生成要求从一张图像同时恢复环境与多个独立物体,现有两条路线各有硬伤。模块化级联方法(如3D-Fixer、SAM3D、CAST)先用SAM 3等模型做分割、用MoGe/Depth Anything等做深度或布局估计,再用物体级生成器补全几何,各阶段误差逐级传播,常导致物体几何残缺、空间关系错位。前馈方法(MIDI、SceneGen)虽在单一网络内同时生成多实例及其排布,但把场景仅表示为物体实例的集合,不显式建模周围环境,物体的摆放缺乏环境几何的直接约束,难以产生全局一致的场景布局。此外训练数据瓶颈严重:3D-FUTURE等现成场景数据集在规模与物体多样性上都有限,严重制约场景生成模型的泛化能力。
本文的目标是本文目标是构建一个从单张图像直接生成可分解3D场景的框架:输出由一个环境组件加N个独立物体组成,每个组件都有完整网格与材质,可单独编辑导出;整体布局须与输入图像的空间关系和支撑关系(物体落在地面、桌面上等)一致;物体细节不因场景级生成稀释有效分辨率而损失;训练完全不依赖人工标注或现成场景数据集,能以可扩展方式自动合成组件对齐的监督信号。最终要在室内(MIDI-test、Gen3DSR-test)与室外(UrbanScene3D)基准上同时超越级联与前馈两类现有方法。
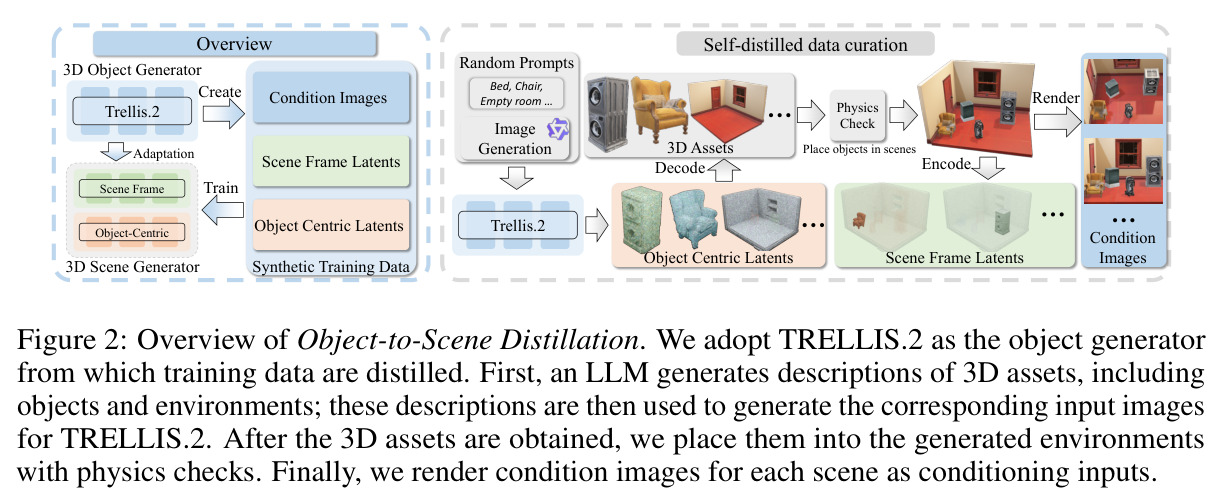
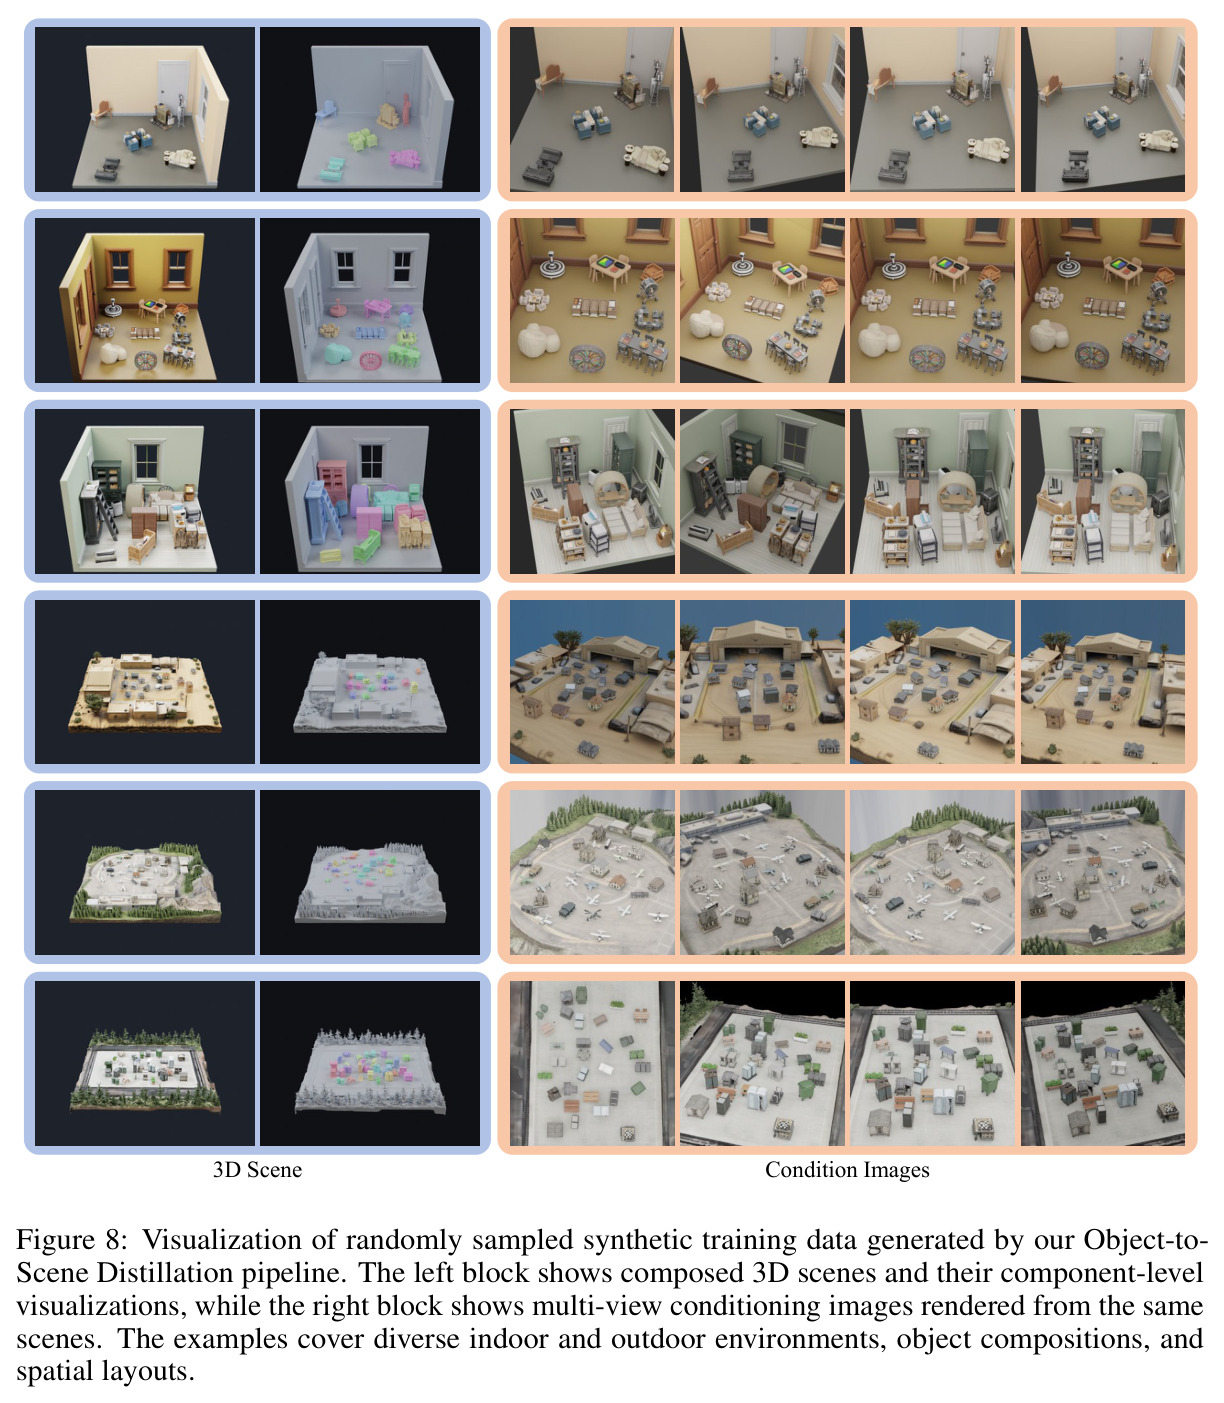
与已有工作不同的是,本文的独特切入是把环境当作一等公民。此前前馈方法的潜变量只描述物体本身,DistScene为环境单独分配一个潜变量槽位,让它在共享场景坐标系中充当锚点,编码并约束所有物体的空间交互。第二个差异是自蒸馏数据引擎:不收集真实场景,而是让同一个预训练物体生成器(TRELLIS.2)既生成物体也生成环境资产,用物理检查程序自动摆放组合成约125k个场景,把物体级生成先验蒸馏为场景级监督,无需任何场景数据集或人工标注。第三是在共享帧联合生成之后引入场景条件化的物体中心精修,用局部高分辨率恢复细节,兼顾全局布局一致与局部几何保真。
核心方法
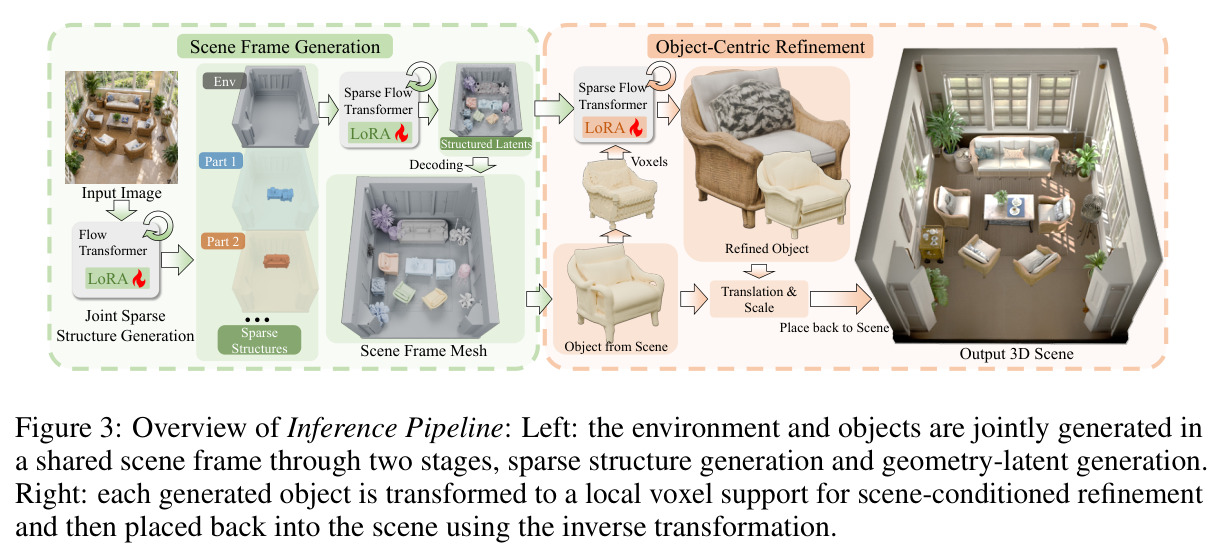
直觉上,物体放在哪、有多大,取决于地板、墙面等环境几何;如果生成时就能看见环境,摆放自然更一致。DistScene以稀疏体素为统一表征,把场景表示为N+1个组件(N个物体加1个环境),每个组件有独立的结构潜变量与形状/纹理SLAT。推理分两步:先做场景帧生成——把N+1个组件的潜变量token拼接,加可学习类型嵌入后由LoRA微调的稀疏DiT做联合自注意力去噪,在共享场景坐标系中按结构生成、几何潜变量生成、外观合成三阶段产出全部组件;再做物体中心精修——把每个物体平移缩放到规范局部空间,在高有效分辨率下以输入图像与场景潜变量为条件恢复细节,再用逆变换放回原位。整体流程即$S=\mathcal{G}(I)=\{O_1,\dots,O_N,E\}$与$S'=\mathcal{R}(\mathcal{G}(I))$。训练所需的全部场景数据由自蒸馏数据引擎自动合成,无需真实场景库。
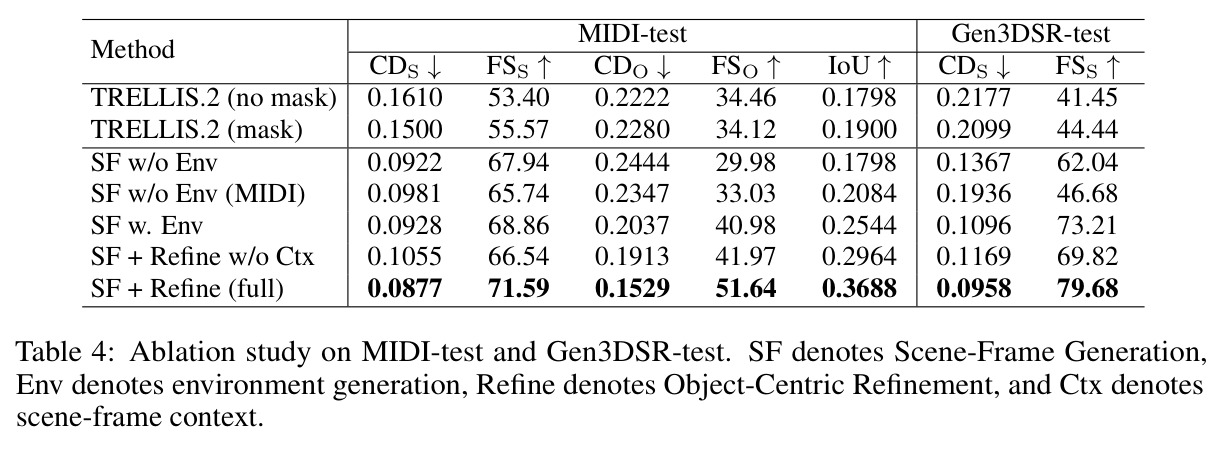
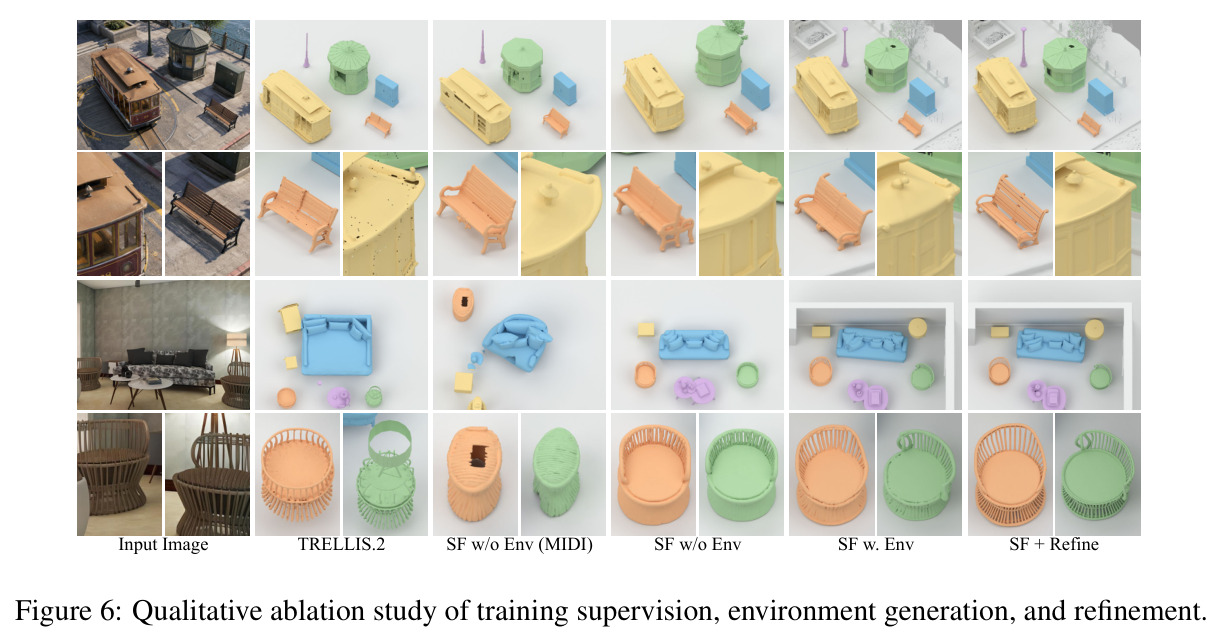
核心创新有三。其一,Scene-Frame Generation:环境潜变量是连接所有物体潜变量的桥梁,通过联合自注意力让N+1个组件在去噪中交换信息,物体的位置、尺度与相互关系被环境的共享空间上下文直接约束——这与MIDI/SceneGen只建模物体集合有本质区别,消融显示显式加入环境使MIDI-test物体F-score从29.98升至40.98、IoU从0.1798升至0.2544。其二,Object-Centric Refinement:场景帧中每个物体只占稀疏网格一小部分,有效分辨率远低于表征上限;精修阶段把物体变换到局部规范空间,用可学习嵌入$e_i$标记其在场景潜变量中对应的区域,以$\hat{O}_i=\mathcal{R}(O_i\mid I,\{x_j\},e_i)$在高分辨率下重生成几何后放回。其三,Object-to-Scene Distillation:同一物体生成器既造物体又造环境,物理检查$C(S)=1$保证无穿插且接触合理,从根上绕开场景数据稀缺。
方法步骤详情
第一步数据合成:LLM生成场景结构化描述,文生图得到条件图像,TRELLIS.2分别生成环境与各物体的完整网格(含形状、纹理SLAT);随机采样尺度与平移放置物体,经AABB相交测试与网格级检查调整或丢弃不合理摆放,要求物理合理$C(S)=1$;通过的场景渲染多视角条件图(仅保留所有物体可见的视图),并在共享场景帧重新编码得到监督目标。共合成约125k场景,含106k室内与18k室外。第二步场景帧生成:初始化噪声潜变量$Z=[z_1;\dots;z_{N+1}]$,加类型嵌入后由LoRA微调的稀疏DiT按流匹配损失$\mathcal{L}_{\text{scene}}$分三阶段训练(结构、形状SLAT、纹理),LoRA秩32、学习率$1\times10^{-4}$、batch 64。第三步物体精修:把高质量潜变量下采样-重编码-上采样构造粗细训练对,以流匹配损失$\mathcal{L}_{\text{refine}}$从粗潜变量恢复细节,完成后逆变换放回原位。推理默认20个组件槽位,空槽位丢弃。
技术新颖性
新颖性体现在三个层面。表征层面:把环境从背景板升级为显式生成组件,环境潜变量与物体潜变量在同一token序列中联合去噪,这是对稀疏体素单资产生成范式(论文式(1))从单物体到组合场景的自然扩展,但此前组合生成工作均未做到。数据层面:区别于收集真实扫描或人工搭建场景,自蒸馏引擎用物体生成器自身造数据,物体先验与场景监督同源、几何风格分布一致且零标注;作者在相同架构上分别用自蒸馏数据与MIDI训练集训练,后者在域内MIDI-test尚有物体级优势,但自蒸馏数据把域外Gen3DSR-test的场景CD从0.1936降到0.1367、F-score从46.68提到62.04,证明其泛化优势。条件化层面:精修并非孤立超分,而以场景帧潜变量加标记嵌入为条件,消融中去掉场景上下文后MIDI-test场景CD从0.0877恶化到0.1055,说明组件对应关系是恢复正确局部几何的关键。
实验结果
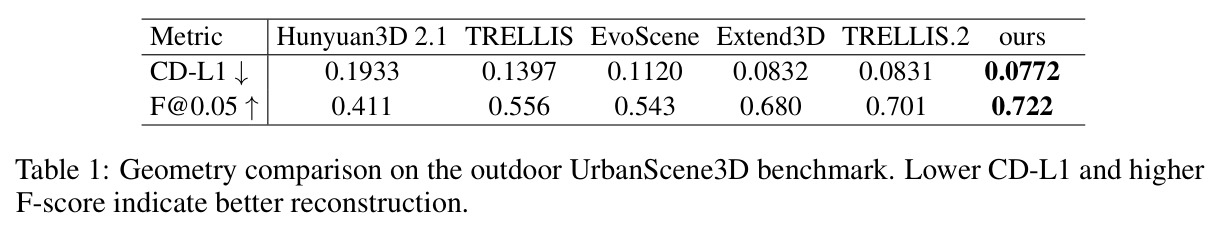
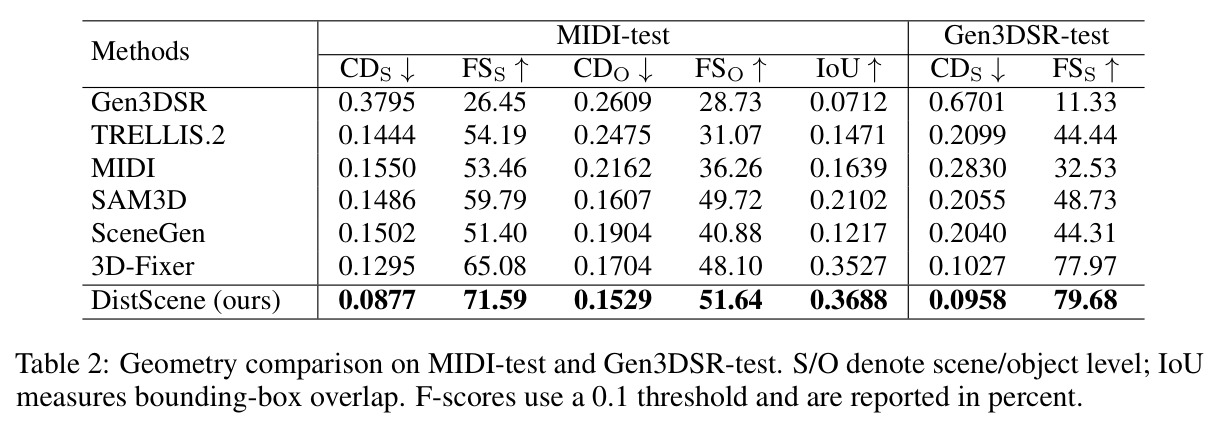
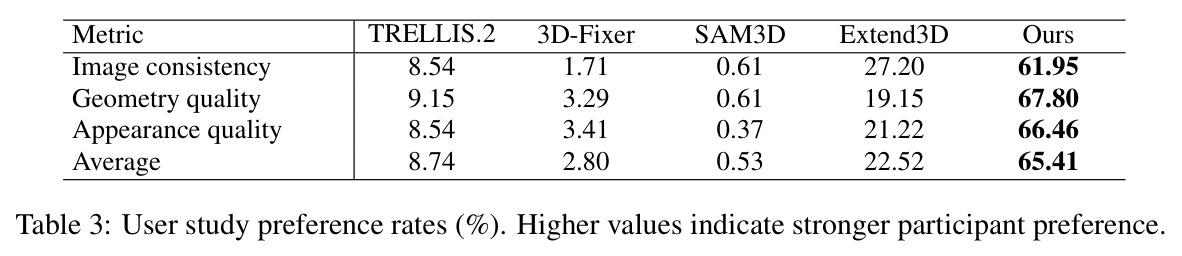
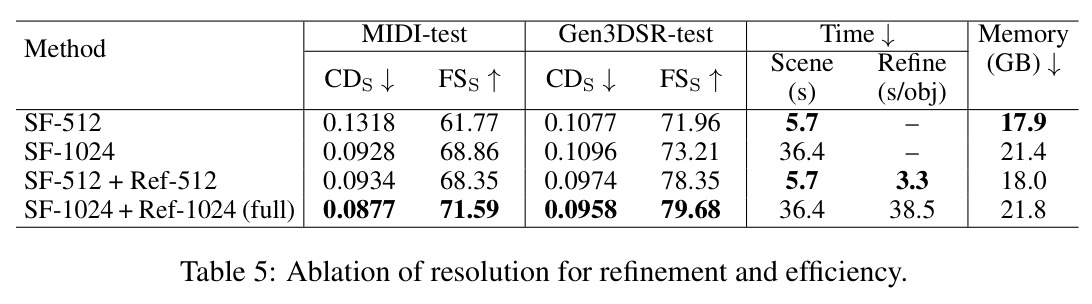
室外(Table 1):CD-L1 0.0772、F@0.05 0.722,优于Extend3D的0.0832/0.680。室内(Table 2):MIDI-test场景CD 0.0877、F 71.59,较3D-Fixer(0.1295/65.08)降低32.2%、F提升6.51点;物体级CD 0.1529、F 51.64、IoU 0.3688全部第一。Gen3DSR-test场景CD 0.0958、F 79.68%(3D-Fixer:0.1027/77.97%)。用户研究(Table 3):三项偏好率61.95%/67.80%/66.46%,平均65.41%,远超第二名Extend3D的22.52%。消融(Table 4):环境组件使物体F从29.98升至40.98、IoU从0.1798升至0.2544;自蒸馏数据使Gen3DSR场景CD从0.1936降至0.1367;精修使物体CD降至0.1529、F升至51.64,去掉场景上下文则回退。效率(Table 5):512配置生成5.7秒、精修3.3秒/物体、18.0GB;1024全配置36.4秒加38.5秒、21.8GB。
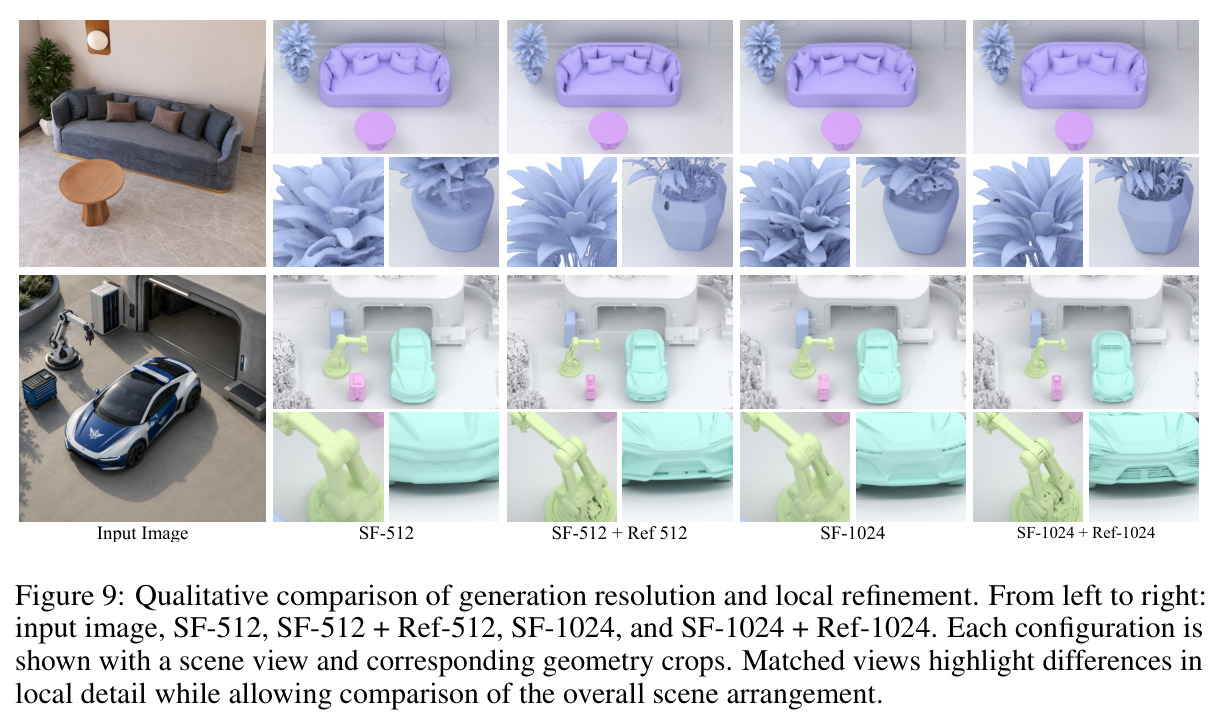
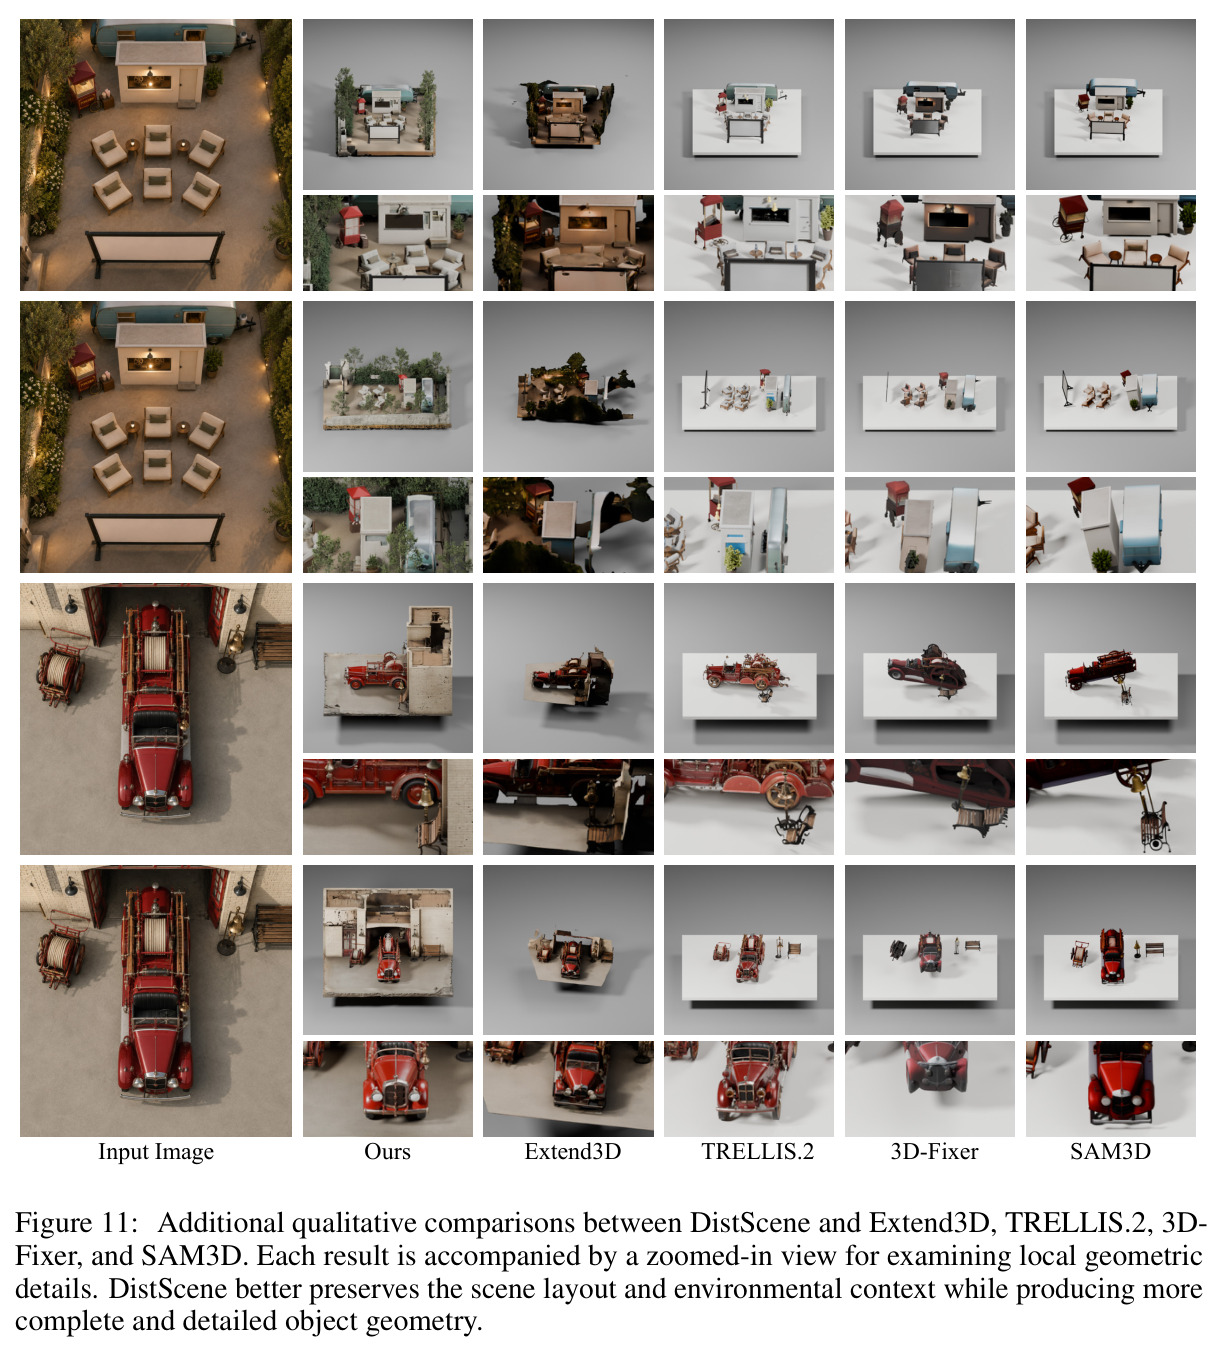
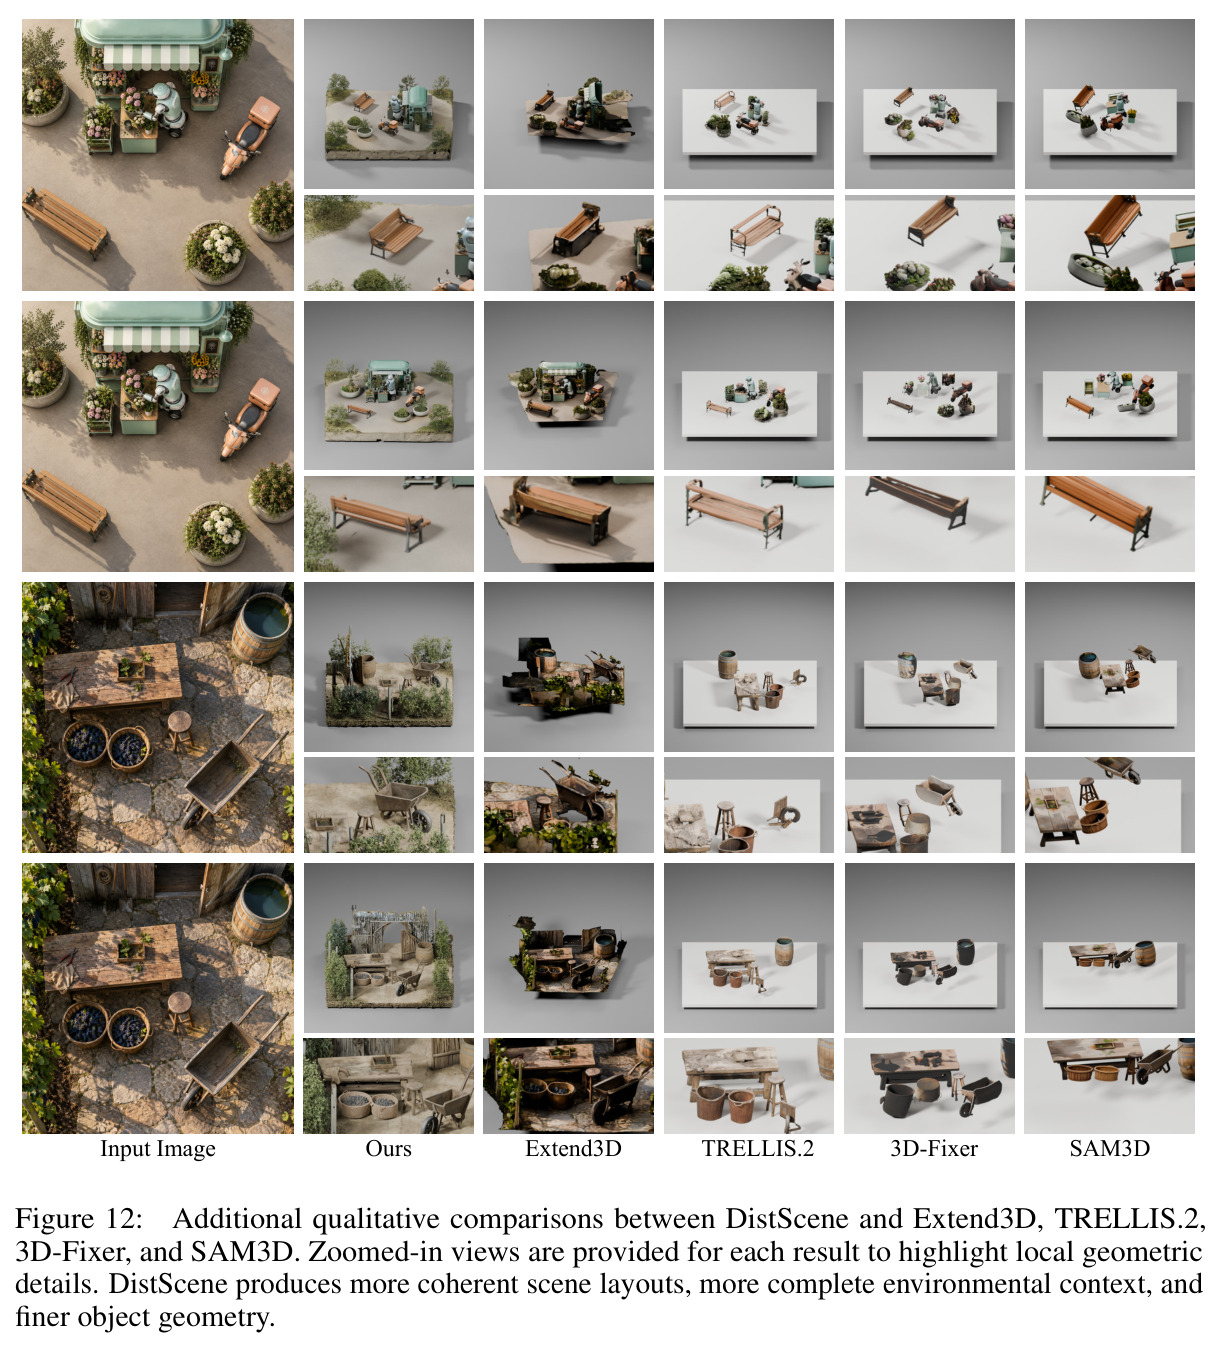
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 室外场景几何重建(UrbanScene3D) | CD-L1 ↓ | 0.0772 | Extend3D 0.0832 / TRELLIS.2 0.1397 | 相对Extend3D降低约7.2% |
| 室外场景几何重建(UrbanScene3D) | F@0.05 ↑ | 0.722 | Extend3D 0.680 / TRELLIS.2 0.556 | +4.2个百分点 |
| 室内场景生成(MIDI-test) | 场景级 CD ↓ | 0.0877 | 3D-Fixer 0.1295 / SAM3D 0.1486 / MIDI 0.1550 | 相对3D-Fixer降低32.2% |
| 室内场景生成(MIDI-test) | 场景级 F-score@0.1 ↑ | 71.59% | 3D-Fixer 65.08% / SAM3D 59.79% | +6.51个百分点 |
| 室内场景生成(MIDI-test) | 物体级 CD ↓ / 包围盒 IoU ↑ | 0.1529 / 0.3688 | 3D-Fixer 0.1704 / 0.3527 | CD降低约10.3%,IoU提升0.0161 |
| 室内场景生成(Gen3DSR-test) | 场景级 CD ↓ / F-score ↑ | 0.0958 / 79.68% | 3D-Fixer 0.1027 / 77.97% | CD降低6.7%,F提升1.71个百分点 |
| 用户研究(43人×20输入×5方法盲评) | 平均偏好率 ↑ | 65.41% | Extend3D 22.52% / TRELLIS.2 8.74% | 约为第二名的2.9倍 |
| 消融:精修与场景上下文(MIDI-test物体级) | 物体 CD ↓ / F-score ↑ | 0.1529 / 51.64(完整模型) | 无精修 0.2037/40.98;无场景上下文精修 0.1913/41.97 | F提升10.66个百分点 |
局限与改进
作者承认两点局限:室内训练用的环境资产普遍缺天花板——因为从预训练物体生成器很难得到完全封闭的空房间,导致部分重建在输入为封闭室内时输出开顶房间;室外场景空间跨度大,有限的场景帧体素摊在大区域上,大而复杂的环境中会出现空洞与细节丢失,且室外训练集(18k)远小于室内(106k)。我的补充观察:其一,布局只靠几何物理检查(AABB加接触测试),没有台灯应放桌上之类的语义约束;其二,训练上限30个组件、推理20个槽位,物体更多的拥挤场景无法表达;其三,框架强依赖TRELLIS.2先验,其偏差会被继承;其四,MIDI-test输入是用GT几何重渲染的完整场景图,改变了原基准的输入分布,与其他文献数字不完全可比;其五,精修逐物体串行,物体数多时推理时间线性增长,1024配置精修达38.5秒。
独立分析的弱点
第一,环境生成质量是整个系统的天花板:数据引擎造不出封闭房间,直接限制室内完整性,改进方向是为环境分支引入封闭结构先验(如房间布局参数化表示)或用真实室内扫描做混合微调。第二,物理检查过于粗糙:仅AABB与接触测试,缺少语义级布局先验(画挂墙上、台灯在床头柜上),可引入LLM布局规划或学习到的物体间关系先验来过滤不合理组合。第三,组件槽位固定:训练随机补空槽至最多30个、推理20个,超出即无法表达,可改为动态槽位分配或层级化生成(房间到家具到部件逐级细化)。第四,室外分辨率不足:可探索分层稀疏表征,即大范围低分辨率加局部八叉树高分辨率细化,并扩充室外语料。第五,精修串行且每物体独立执行,1024配置38.5秒的耗时可用批处理或按需精修缓解。第六,评估协议上,重渲染MIDI-test虽对齐了各方法的输入需求,但偏离原始基准,应补充原始输入上的对比实验以增强说服力。
未来方向
作者明确提出的方向:改进大规模场景表征以保留室外细节,扩充室外训练语料(当前18k远少于室内106k)。基于本文成果可自然延伸:一是把环境从静态几何扩展为可交互、可模拟的场景图,服务论文动机中的自动驾驶、机器人仿真与VR应用;二是用物理仿真替代启发式摆放与检查,产生更真实的支撑、堆叠与重力关系;三是结合部件级生成(如PartCrafter)构建物体-部件-场景三级组合体系;四是把蒸馏思路迁移到4D动态场景或场景编辑任务,例如换家具、改布局时保持环境与其他物体一致;五是研究被遮挡物体的不可见部分补全,减少对输入可见区域的过拟合;六是将合成数据与真实扫描混合训练,并研究合成-真实差距的量化与缩小;七是探索纹理与几何的联合场景级生成而非分离阶段,避免外观与几何错位。
复现评估
复现难度中等偏高。有利条件:项目页https://coolbeam.github.io/DistScene/提供结果可视化;方法完全建立在公开的TRELLIS.2与稀疏体素范式之上,超参披露完整——LoRA秩32、AdamW学习率$1\times10^{-4}$、全局batch 64、每个适配模块2万步、512分辨率训练、1024分辨率推理、训练上限30组件、推理20槽位;数据引擎各环节(LLM生成描述、文生图、TRELLIS.2资产生成、AABB与网格级物理检查、多视角渲染)均可独立实现。不利条件:论文未提及代码或数据开源;合成125k个训练场景需要大量GPU时长(每场景含多次3D生成与渲染);评测需按论文方式重渲染MIDI-test并复现3D-Fixer、MIDI、SAM3D等基线;推理峰值显存已达18至21.8GB,LoRA训练预计需要A100/H100级GPU。若代码开源,一个拥有4至8张高端GPU的小团队应在数周内可复现核心结果。
论文图表
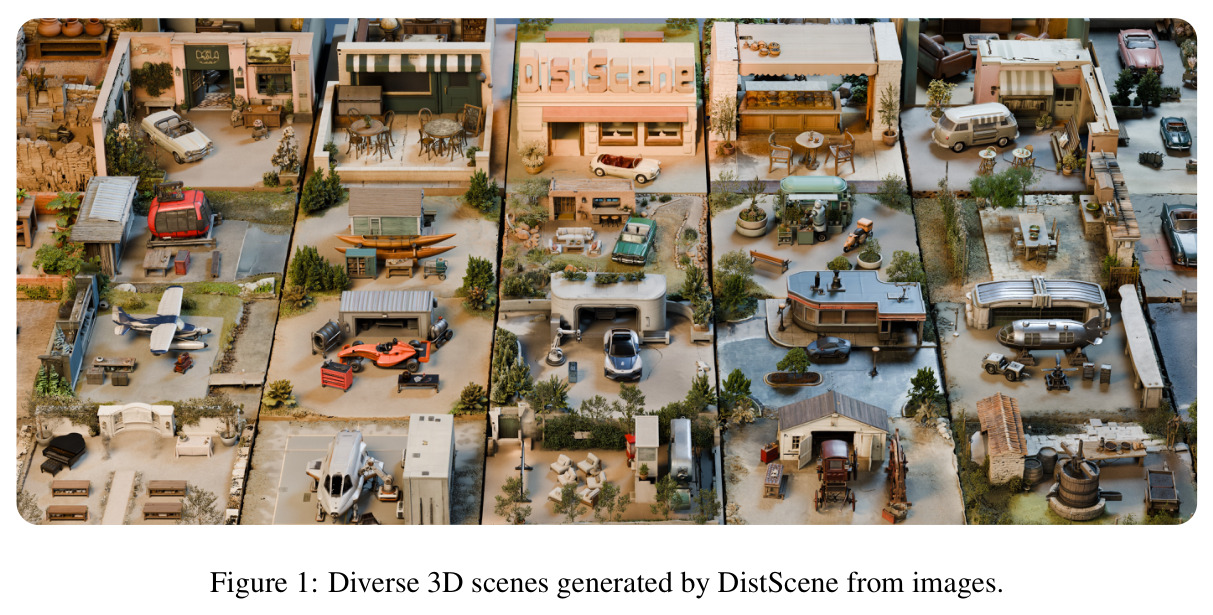
展示DistScene从单张输入图像生成的多样化3D场景,覆盖室内外多种环境类型与物体组合,每个场景均可分解为环境与独立物体组件。
作为开篇总览,直观呈现任务的输入输出形态与最终效果,帮助读者建立对可分解场景生成的整体印象。
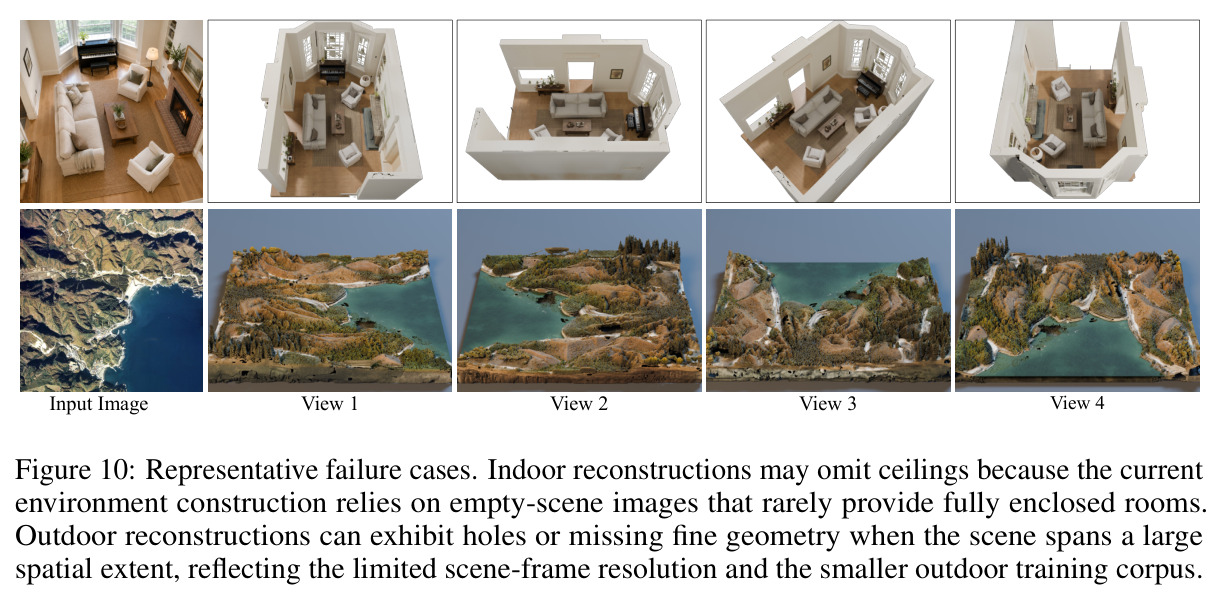
代表性失败案例:室内重建可能缺失天花板(环境构造依赖的空场景图很少提供全封闭房间);室外重建在大空间跨度下出现空洞或细几何丢失,反映场景帧分辨率限制与较小的室外训练集。
作者坦诚展示失败模式,是理解本文局限性(环境资产缺陷与室外表征不足)的最直接材料。