面向通用灵巧操作的异构触觉表征学习 Learning Heterogeneous Tactile Representation for General Dexterous Manipulation
单一编码器统一压阻/磁/视触觉表征,免训练迁移至未见传感器,全面提升模仿、VLA 与强化学习策略。
前置知识
JEPA(联合嵌入预测架构)
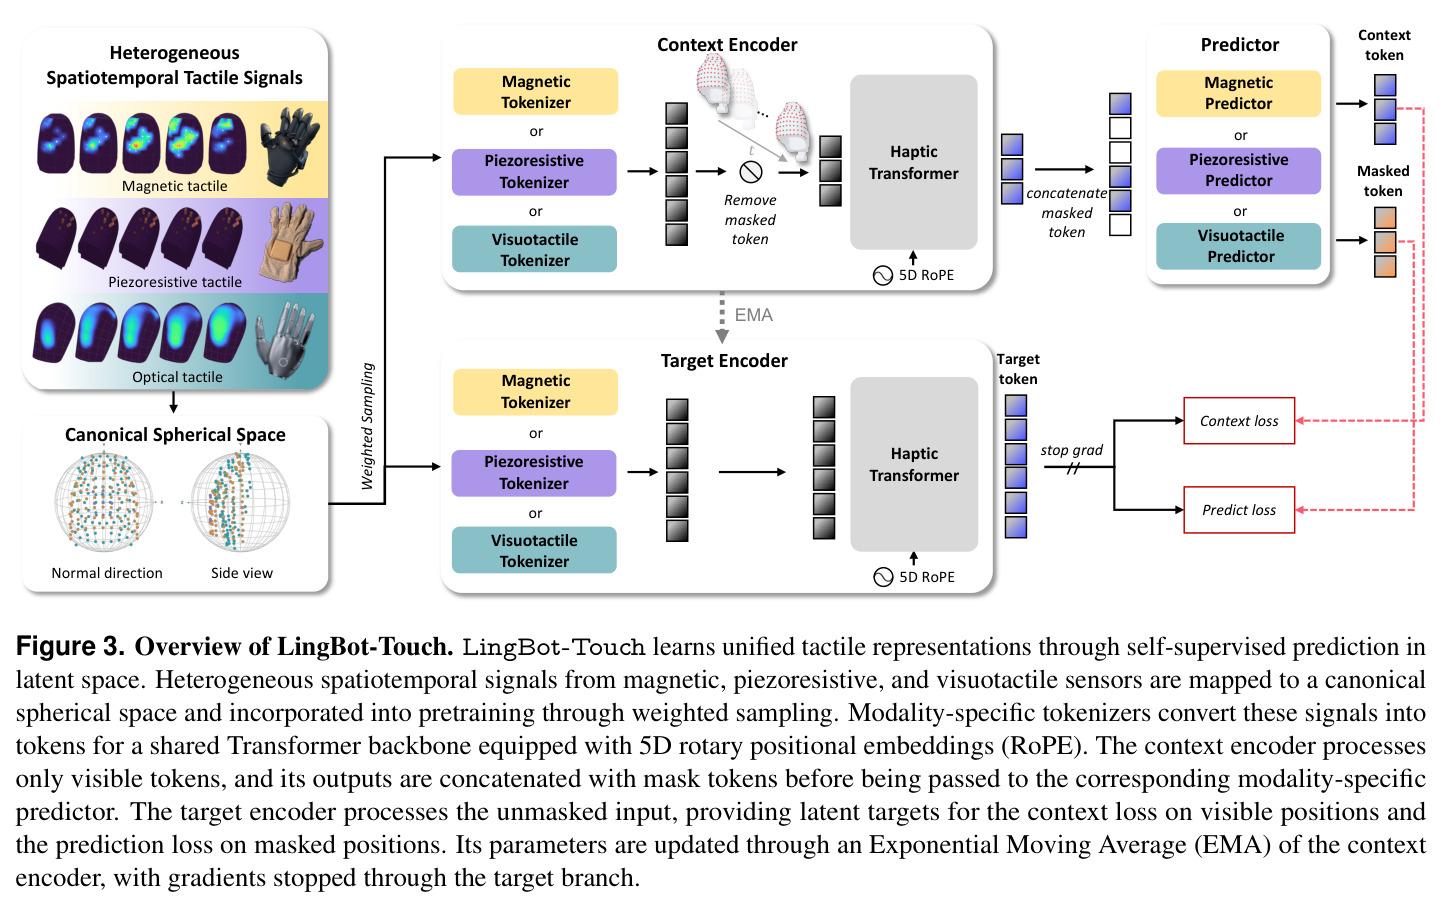
一种自监督范式:模型只看到部分输入(context),要在潜空间(表征空间)中预测被遮掩部分的完整表征,而不是重建原始信号。目标表征由一个参数通过 EMA(指数滑动平均)缓慢更新的 target encoder 给出并施加 stop-gradient,从而避免表征塌缩。V-JEPA 系列将其扩展到视频,用多层级特征做监督。
LingBot-Touch 的训练目标 Tactile-JEPA 直接继承 I-JEPA/V-JEPA 2.1 的多层级潜预测框架,理解掩码、EMA 目标、context loss 等设计都需要这一背景。
Taxel(触觉素)
tactile element 的缩写,是触觉传感器的最小感知单元,类比图像的像素。不同传感器的 taxel 数量与排布差异巨大:压阻手套每指仅 9~16 个,磁传感器每指 96~124 个,视触觉传感器每指原生 240×240 变形图。taxel 的空间几何排布(layout)决定了触觉信号的空间结构。
本文的核心难题就是不同传感器 taxel 几何、分辨率、通道完全异构,如何让一个模型同时读懂它们是全文的主线。
RoPE(旋转位置编码)
Rotary Position Embedding,通过对 attention 的 query/key 按位置信息做旋转变换注入相对位置关系。只需把连续位置值代入对应频率的正余弦函数,天然支持任意长度序列和连续坐标,无需为每个位置学一个 embedding 表。
本文把 RoPE 扩展成五轴版本:时间窗、手指身份、三维坐标各占一个轴,使共享 Transformer 能处理任意传感器布局,是免训练迁移到新传感器的关键机制。
VLA(视觉-语言-动作模型)
Vision-Language-Action 模型,在互联网级视觉语言数据上预训练后,将观察映射为机器人动作,如 π0.5、LingBot-VLA。通常以视觉和本体感觉为输入,通过流匹配或自回归方式输出动作序列,是当前机器人操作的主流范式。
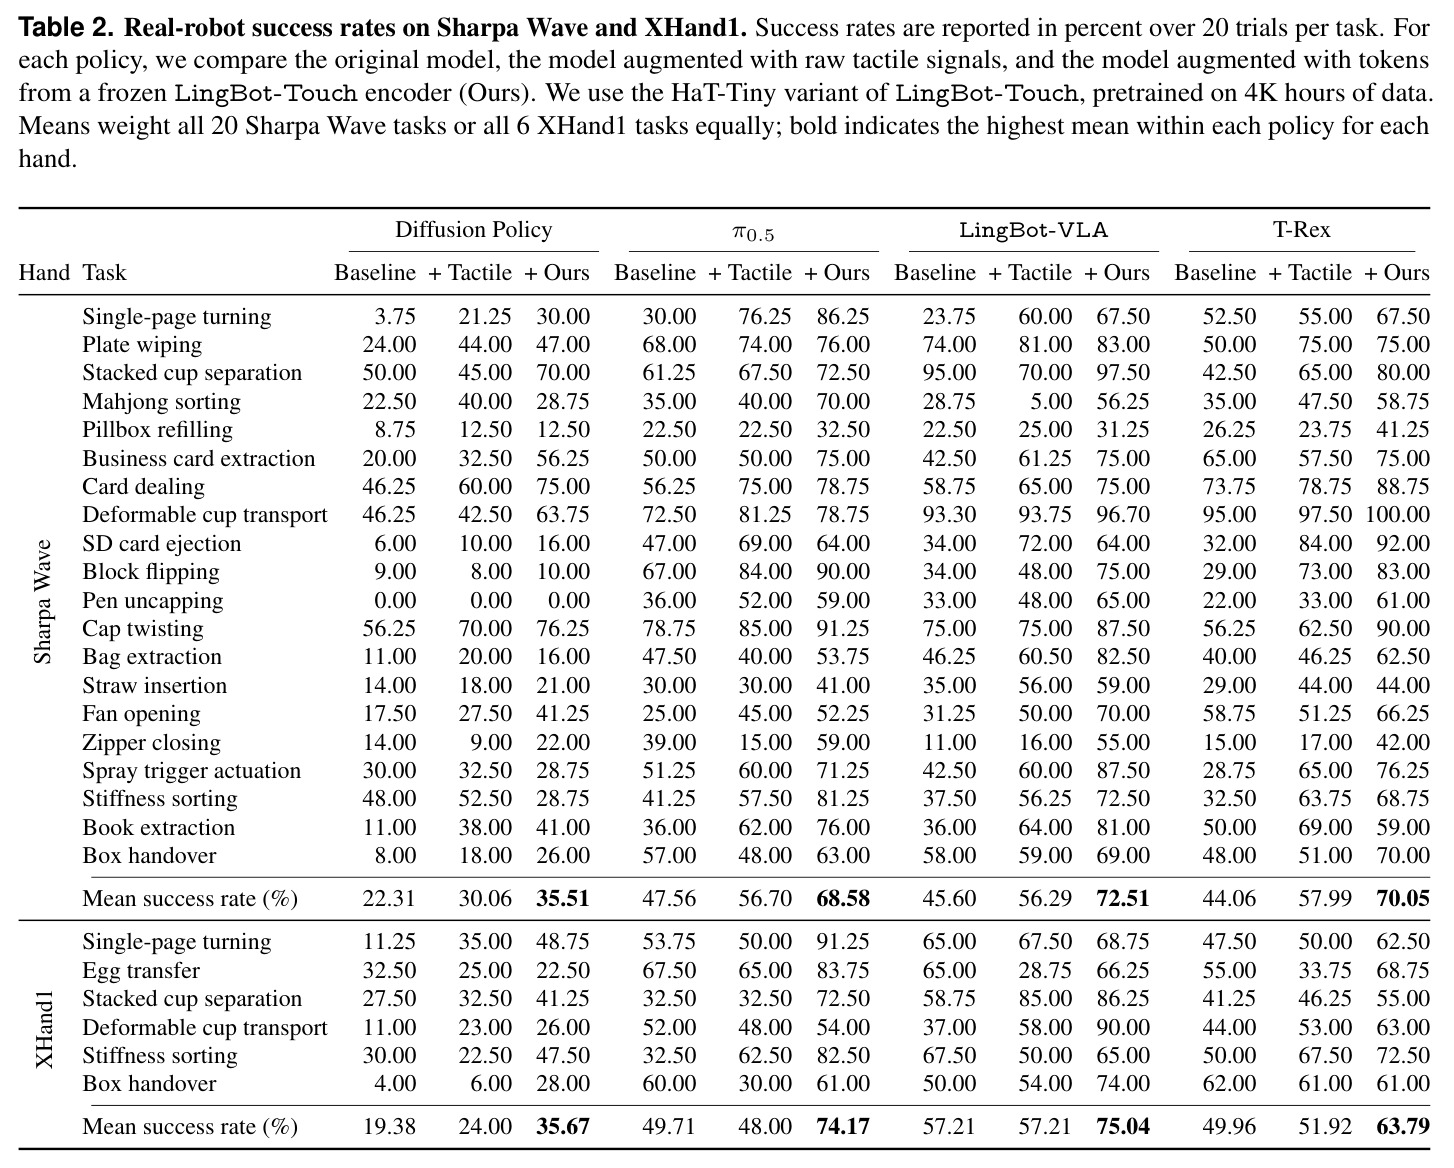
本文证明触觉 token 可以即插即用地接入 π0.5、LingBot-VLA、T-Rex 等 VLA,把成功率提升 21.8~24.8 个百分点,这是其实用价值的核心证据。
Diffusion Policy 与模仿学习
Diffusion Policy 用扩散模型对动作轨迹去噪来生成机器人动作,是模仿学习的代表性策略。训练只需示教数据(本文每任务 200 条示教),不依赖奖励设计,但对输入模态的表征质量敏感——200 条示教不足以让策略从零学会解读新的原始传感器信号。
真机实验用 Diffusion Policy 作模仿学习基线,与三种 VLA 一起验证『给策略的是表征而非原始模态』这一核心论点。
研究动机
触觉是接触密集型灵巧操作不可或缺的模态:人类被遮住指尖触觉后,即使视觉完好,连划火柴、扣扣子这样的简单动作都很困难;而机器人操作几乎完全依赖视觉,视觉无法告诉它按压力道多大、抓取是否在打滑、被手指遮挡的接触面下发生了什么。传感器并非瓶颈——压阻(如 STAG 手套)、磁(如 ReSkin、AnySkin、PaXini)、视触觉(如 GelSight、DIGIT、Sharpa Wave 指尖)均已商用,但触觉仍是缺乏规模化三要素的早期模态:第一,没有统一输入格式,每种传感器自定义通道语义、taxel 布局、分辨率和采样率,一个传感器的读数对另一个传感器训练的模型毫无意义;第二,没有大规模语料,因为不同传感器的数据无法合并池化,且每一小时数据都需要一只带传感器的手真实接触世界来物理采集;第三,没有成熟配方,触觉有益于机器人学习的证据散落在各传感器专属的研究和孤立任务中,缺少可比较的共享表征。
本文的目标是本文的目标是构建触觉基础模型 LingBot-Touch,把触觉理解从传感器专属物理中解放出来,让具身模型能有效利用异构触觉数据。具体追求三个性质:其一,用一个编码器对压阻、磁、视触觉三类主流传感原理产生统一表征,并且无需重训练即可扩展到新传感器型号;其二,输出的触觉 token 是即插即用的,能无缝接入从 Diffusion Policy 到 π0.5、LingBot-VLA 等不同范式的策略模型,且冻结使用、不改动策略本身;其三,通过覆盖仿真与真机、多硬件平台的广泛实验,证明该表征在显著提升复杂操作能力的同时保持强计算效率——Tiny 版仅 5.46M 参数,给策略增加的参数量不到 0.2%。
与已有工作不同的是,本文的独特切入点是一个物理洞察:触觉数据与产生它的传感器物理绑定,但接触事件本身不是——『指尖压在一个边缘上』这一事件,无论被磁力计、电阻阵列还是凝胶后的相机记录,都是同一个事件,所以只要从输入中剥离传感器专属物理,接触表征就可以被共享。由此引出三个环环相扣的设计决策:把所有传感器的 taxel 映射进统一的规范指尖坐标系(canonical fingertip space),让模型看到的是手指上的位置而非传感器数组里的索引;用联合嵌入预测架构(Tactile-JEPA)在潜空间预测被掩码 taxel 的表征,契合稀疏、无标签的触觉信号;组装 5,000 小时的多源语料——三分之二来自人戴触觉手套(无需机器人、采集成本低),三分之一来自后续要部署的遥操作机器手,行为对齐而硬件不对齐,这正是让共享编码器学到不属于任何单一传感器的接触规律的前提。
核心方法
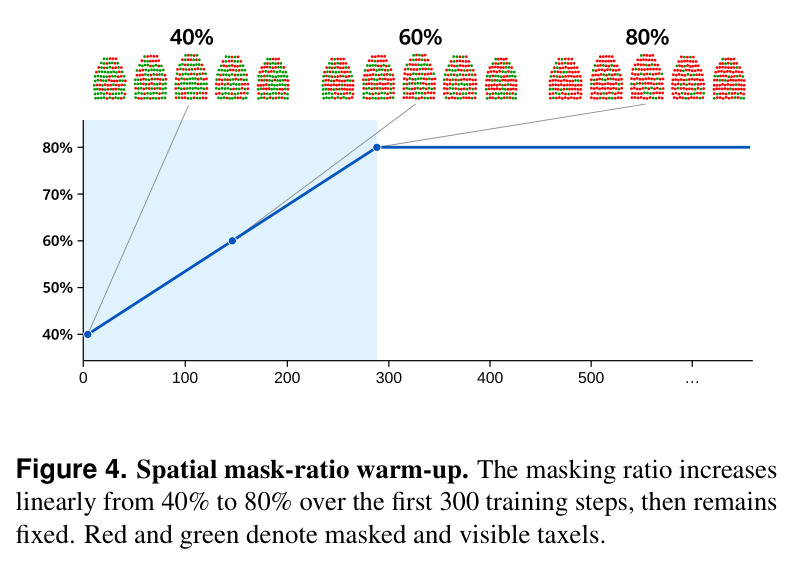
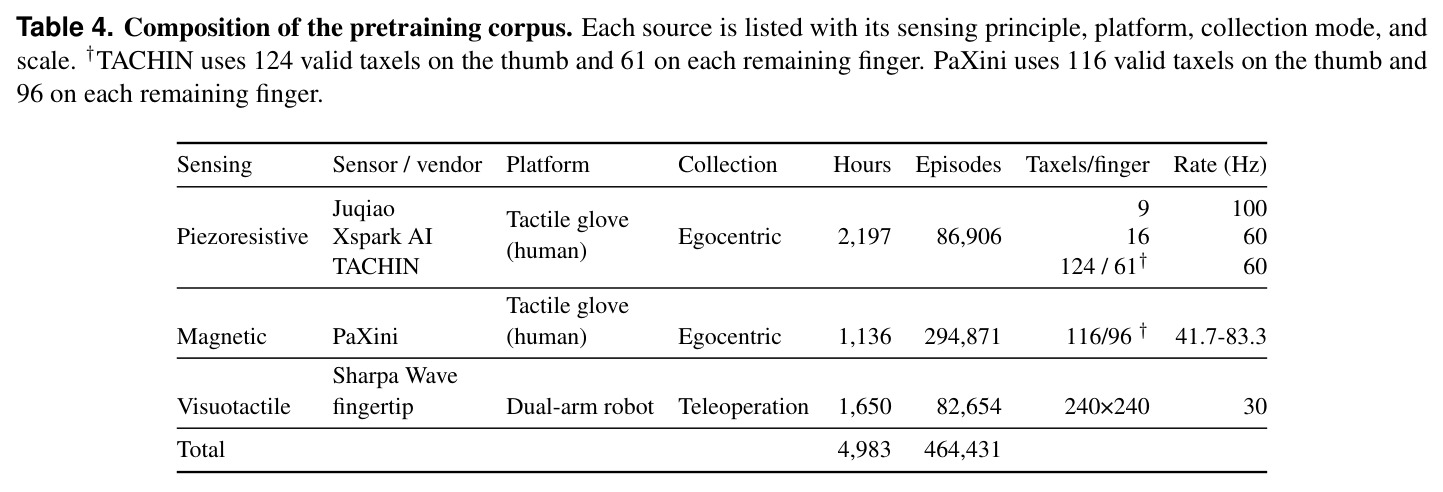
方法的直觉是先把异构信号变成同构输入,再用一个共享骨干学统一表征,训练目标只关心接触语义而非信号重建。技术路线上,输入被归一化为 $X \in \mathbb{R}^{T \times N \times 3}$($T$ 帧乘 $N$ 个有效 taxel 乘 3 通道,单通道信号零填充到 3 通道)。第一步几何规范化:按式 $p_i = \alpha \tilde{p}_i + b$ 把每个传感器的 taxel 位置对齐、缩放、平移进单位半径的参考指尖坐标系,其中 $\alpha, b$ 按各传感器-手指模板离线固定(如 PaXini/XHand 取最小包围球参数)。第二步每个有效 token 获得五维地址 $a_i = (t_i, f_i, p_i) \in \mathbb{R}^5$(时间窗、手指、三维坐标),只通过五轴 RoPE 进入注意力。第三步模态专属 tokenizers(各为两层 MLP,把单个 taxel 连续两帧共 6 个数嵌入一个 token)把信号转成 token,送入共享的 Haptic Transformer(HaT)主干;Tiny/Small 两个规格分别为 5.46M/21.76M 参数、12 层、维度 192/384,共预训练 200,000 步。第四步 Tactile-JEPA 训练:80% 空间掩码配合 300 步的掩码比例预热,潜空间预测目标,EMA 目标编码器。第五步布局增强防记忆:多分辨率重采样加 taxel 位置扰动。语料共 4,983 小时、464,431 条 episode、13.3 亿帧、24 类任务。
核心创新是与既有方法的三个本质区别。第一,布局无关的几何接口:不像 T3/FTP-1 为每个传感器配专属编码器或适配器(FTP-1 迁移到新传感器需为新传感器训练输入适配器),本文把 taxel 的位置连续化为三维坐标加手指身份,经五轴 RoPE 注入共享骨干,使新传感器只需一次几何标定即可直接使用,彻底消除了 per-sensor 训练。第二,潜空间预测而非信号重建:MAE/VAE 类目标在几乎全零的稀疏触觉信号上会把容量浪费在建模背景上(实验中 VAE 数据越多越差),Tactile-JEPA 只在潜空间对齐表征,从不把零背景当目标;针对稀疏性还设计了掩码预热——均匀 80% 掩码会以约 $0.8^k$ 的概率把涉及 $k$ 个 taxel 的接触证据全部抹掉,导致梯度爆炸,故前 300 步把掩码比例从 40% 线性升到 80%。第三,把布局当作 nuisance 变量随机化:预训练只见过三种布局,RoPE 又给了精确坐标,模型可能背下三个点集,因此用多采样密度(磁传感器重采样为每指 24/32/48/64/76/96 taxel 视图,视触觉聚合为 32/96/200 个虚拟 taxel)和位置扰动 $p'_i = p_i + \delta_i$(约束 $\|\delta_i\|_2 \le 0.5 d_i$,$d_i$ 为最近邻 taxel 距离)逼模型放弃坐标模板记忆。
方法步骤详情
流程分六步。第一步,数据采集:操作员戴压阻与磁触觉手套以自我中心视角采集约 3,333 小时,双臂 Sharpa Wave 机器人遥操作采集视触觉 1,650 小时;每个 episode 只标注 24 类任务之一,clip 级没有任何力、位置或时间标签;训练时三个数据源等概率采样。第二步,几何规范化:按各传感器模板离线固定的 $\alpha, b$ 把 taxel 位置变换到单位半径的规范指尖空间,幅度按固定响应界归一到 $[0,1]$ 或 $[-1,1]$,形成与传感器无关的无量纲输入。第三步,token 化:每个模态专属 tokenizer(两层 MLP)把单个 taxel 连续两帧共 6 个数嵌入一个 token,$T$ 帧 clip 得到 $L = NT/2$ 个 token,经五轴 RoPE 进入共享 Haptic Transformer。第四步,Tactile-JEPA 训练:随机选 80% 有效 taxel 施加贯穿整段 clip 的空间掩码(前 300 步掩码比例从 40% 线性升至 80%);context encoder 只见可见 token,EMA 更新且梯度截断的 target encoder 处理完整 clip 并从四个深度各自归一化后拼接成目标 $\bar{z}$;predictor 输出 $\hat{z} = P_\phi^{(g)}(E_\theta^{(g)}(X_C; A_C), \Delta_M; A)$,损失 $\mathcal{L} = \frac{1}{|M|D}\sum_{i\in M}\|\hat{z}_i - \mathrm{sg}(\bar{z}_i)\|_1 + \frac{\lambda}{|C|D}\sum_{i\in C}\|\hat{z}_i - \mathrm{sg}(\bar{z}_i)\|_1$,$\lambda = 0.5$。第五步,布局增强贯穿训练:磁信号重采样为每指 24/32/48/64/76/96 taxel 视图,视触觉聚合为 32/96/200 虚拟 taxel,并对坐标加扰动 $\|\delta_i\|_2 \le 0.5 d_i$。第六步,下游使用:冻结 EMA target tokenizer 与编码器,取四层特征分别 layer-norm 后拼接;策略侧用可训练交叉注意力 readout 聚合为每手 40 个 token,线性投影到各策略的条件维度,作为视觉与本体感觉之外的附加输入。
技术新颖性
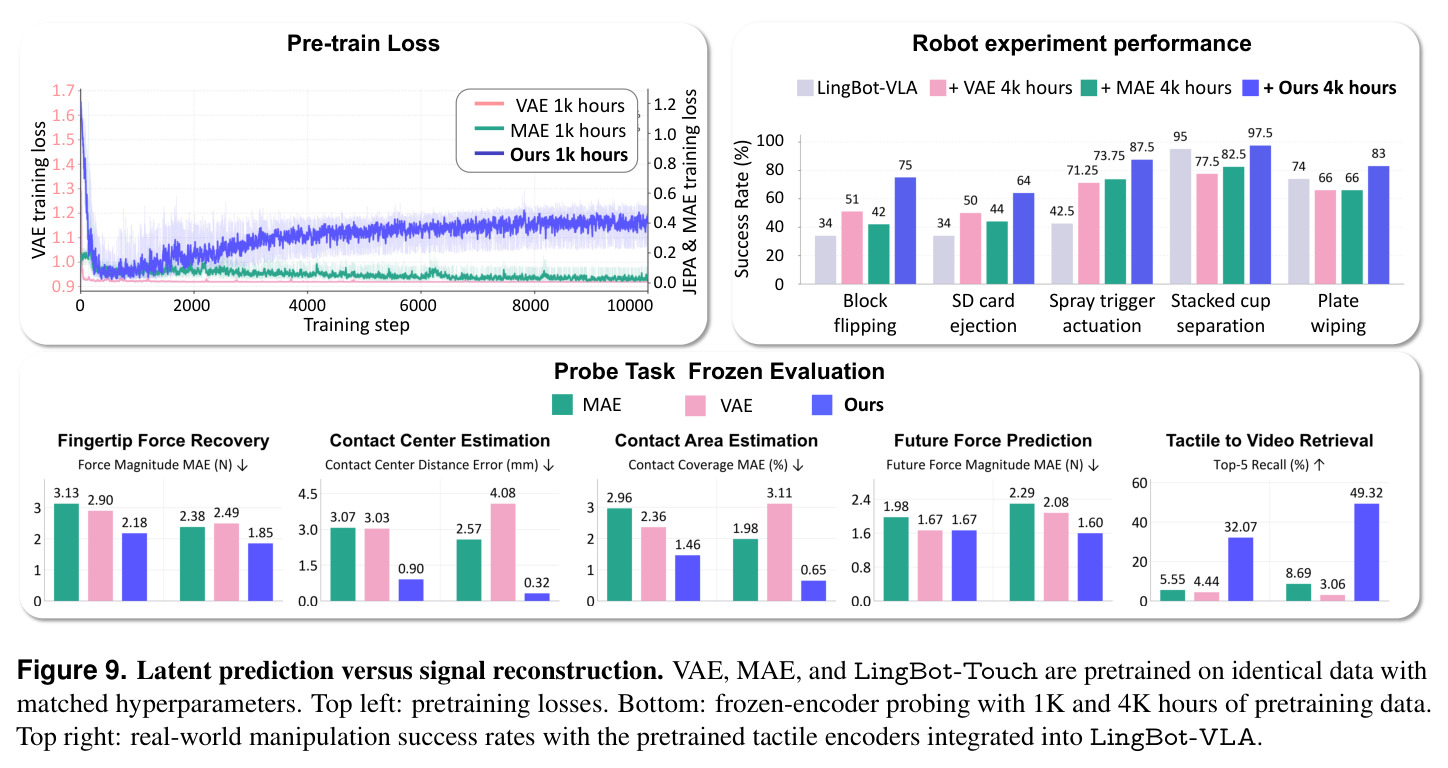
技术新颖性体现在五点。其一,首次用一个编码器覆盖压阻、磁、视触觉三类传感原理并免训练迁移到未见传感器型号:现有工作要么局限于光学传感器(T3、Sparsh、UniTouch、AnyTouch 系列),要么依赖成对传感器做对齐监督(HTT),要么需要 sensor-specific 适配器(FTP-1),而 LingBot-Touch 在 XHand1 上零参数更新即超越带适配器的 FTP-1。其二,五轴 RoPE 将时间、手指、三维空间统一进位置编码,无需固定 token 数或传感器专属位置表,这是布局无关性的架构基础。其三,掩码预热机制是对稀疏信号下 JEPA 训练动力学的针对性发明,$0.8^k$ 的接触消失概率分析说明了为什么视觉中直接可行的 80% 掩码在触觉上会训练崩溃。其四,5,000 小时语料是首个让触觉表征学习成为可能的规模,且『手套为主、遥操作为辅、行为对齐而硬件不对齐』的采集策略本身就是贡献。其五,训练动力学观察独到:JEPA 损失先降后升到非零平台(EMA 目标持续移动的标志),而 VAE 损失迅速降到低位平台却对应糟糕的表征,揭示损失值与表征质量在潜预测范式中是脱钩的。
实验结果
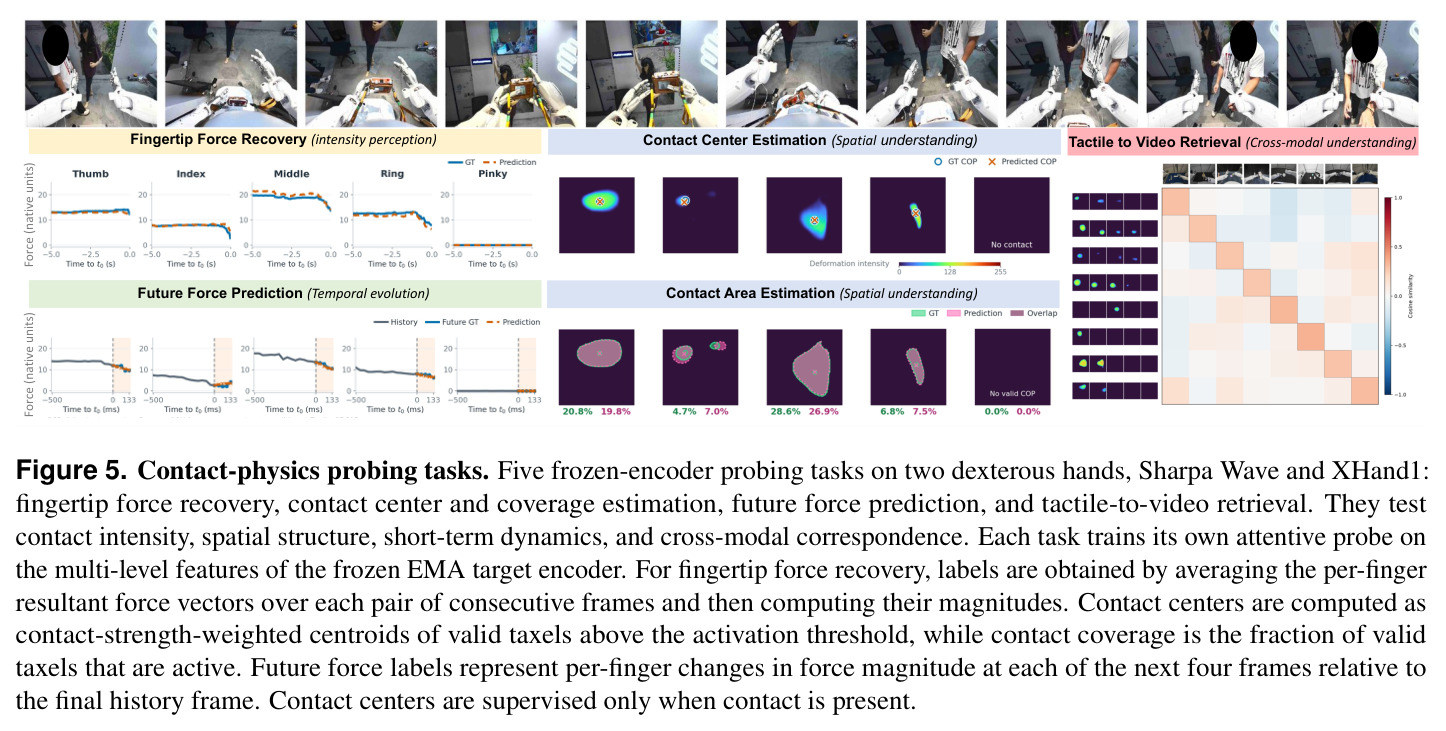
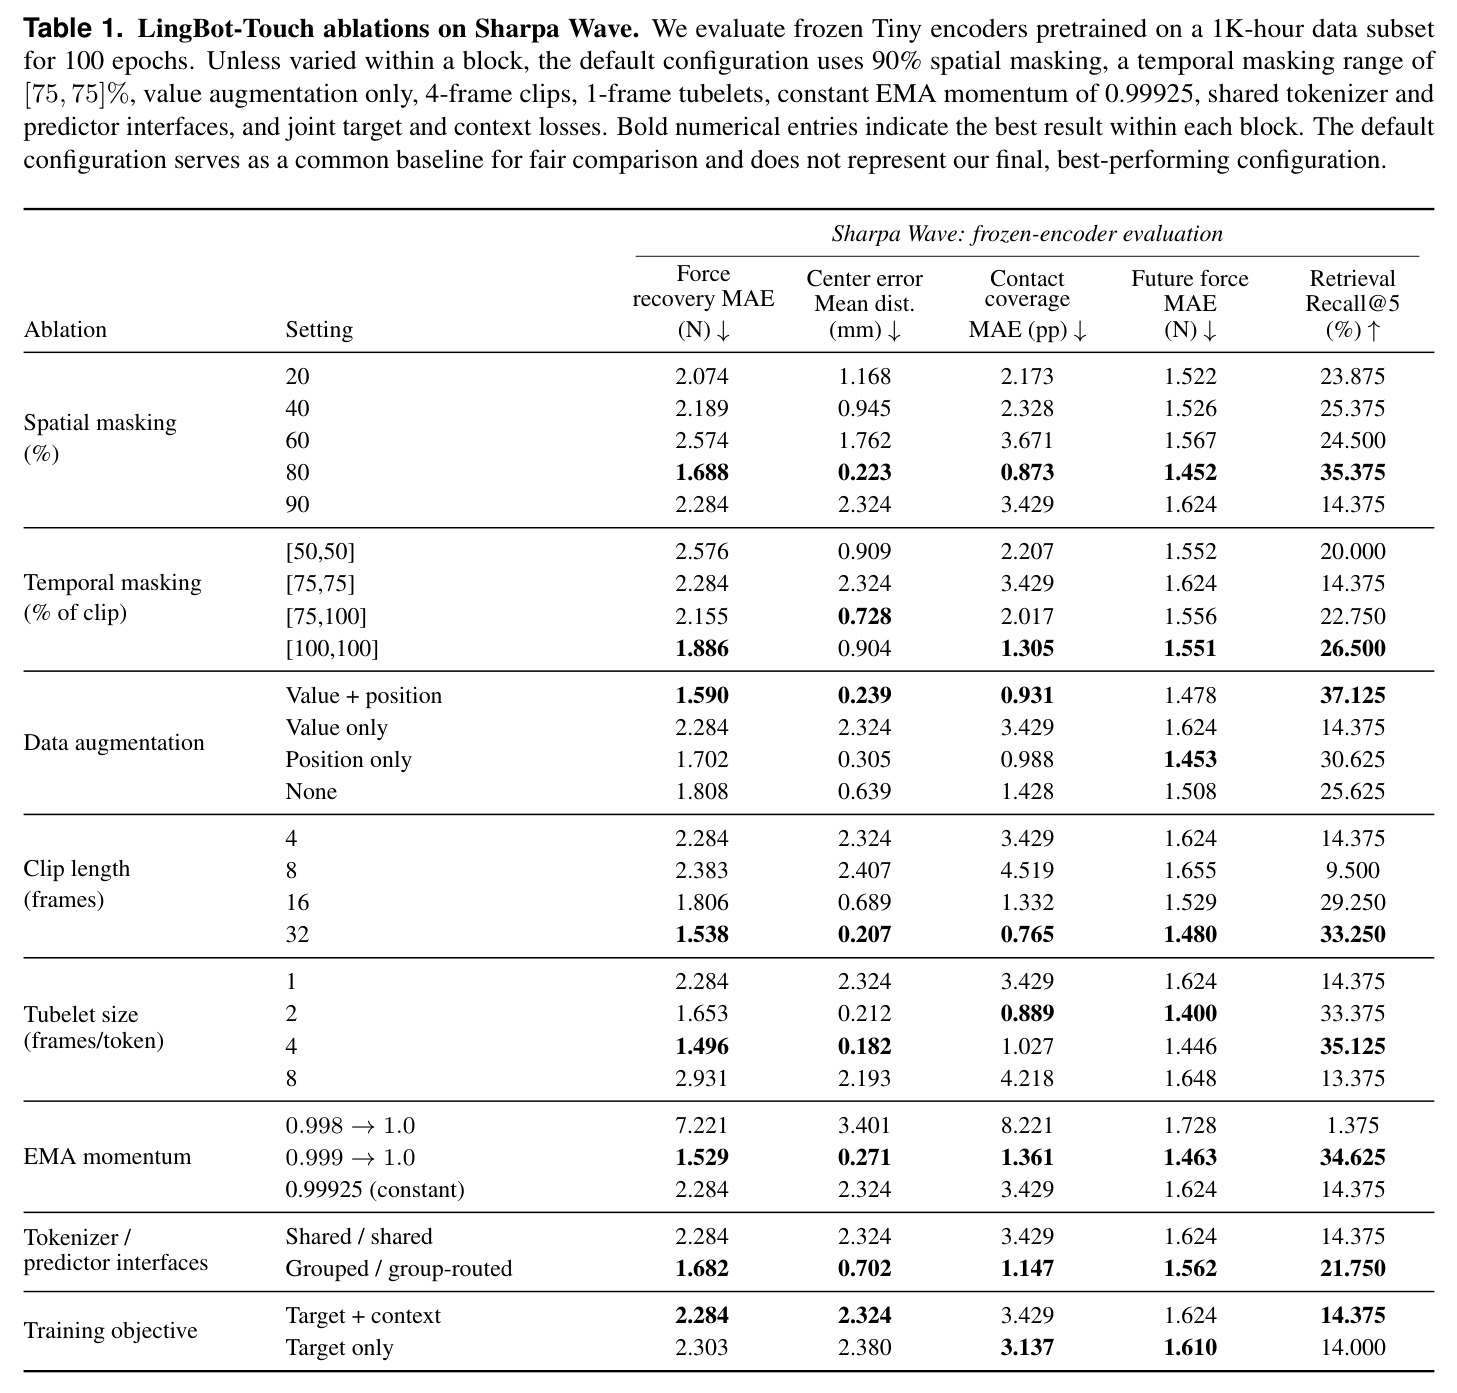
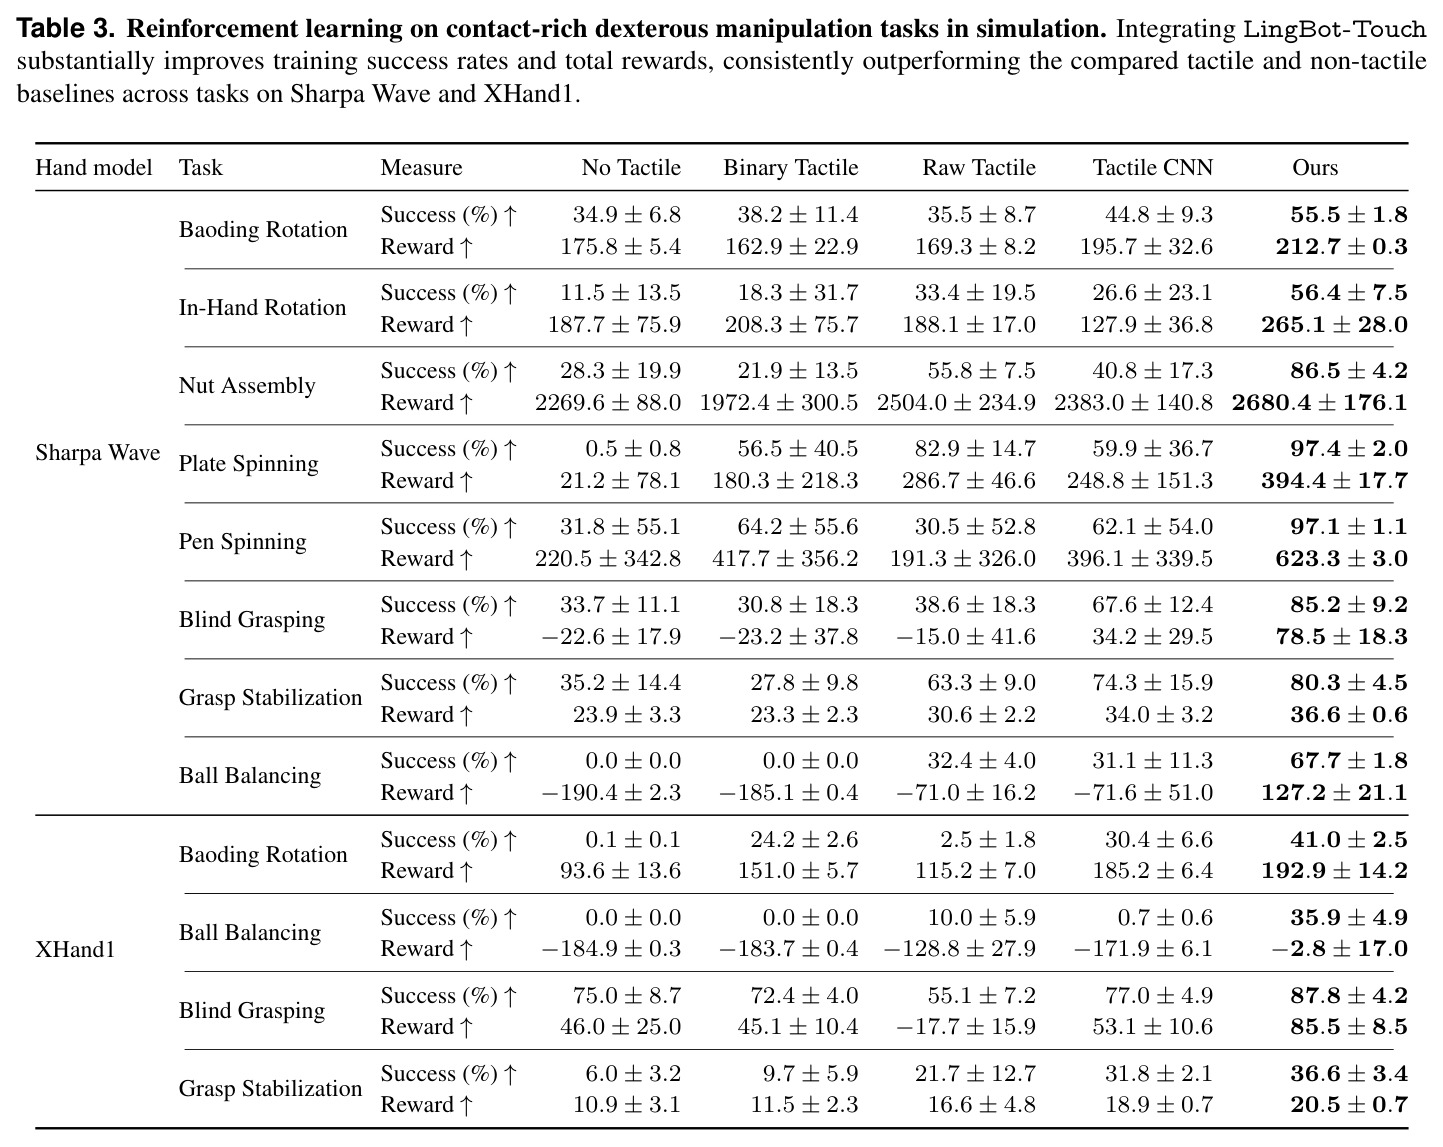
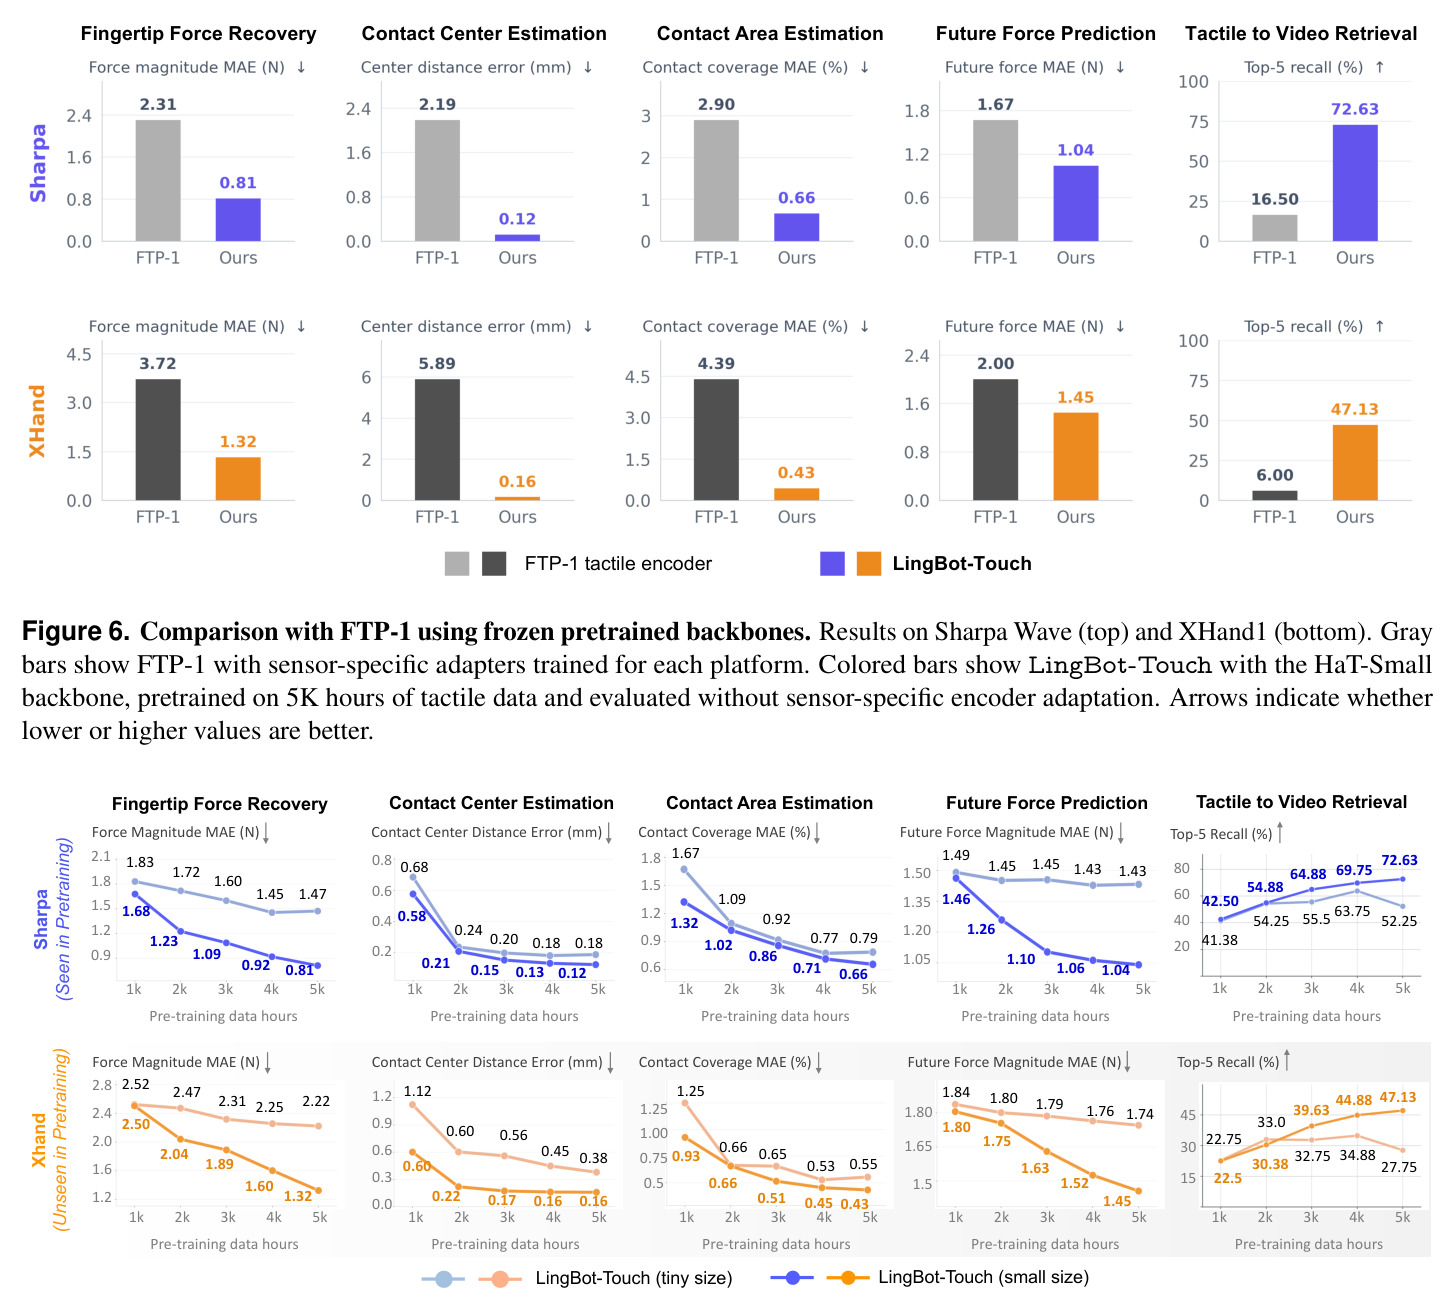
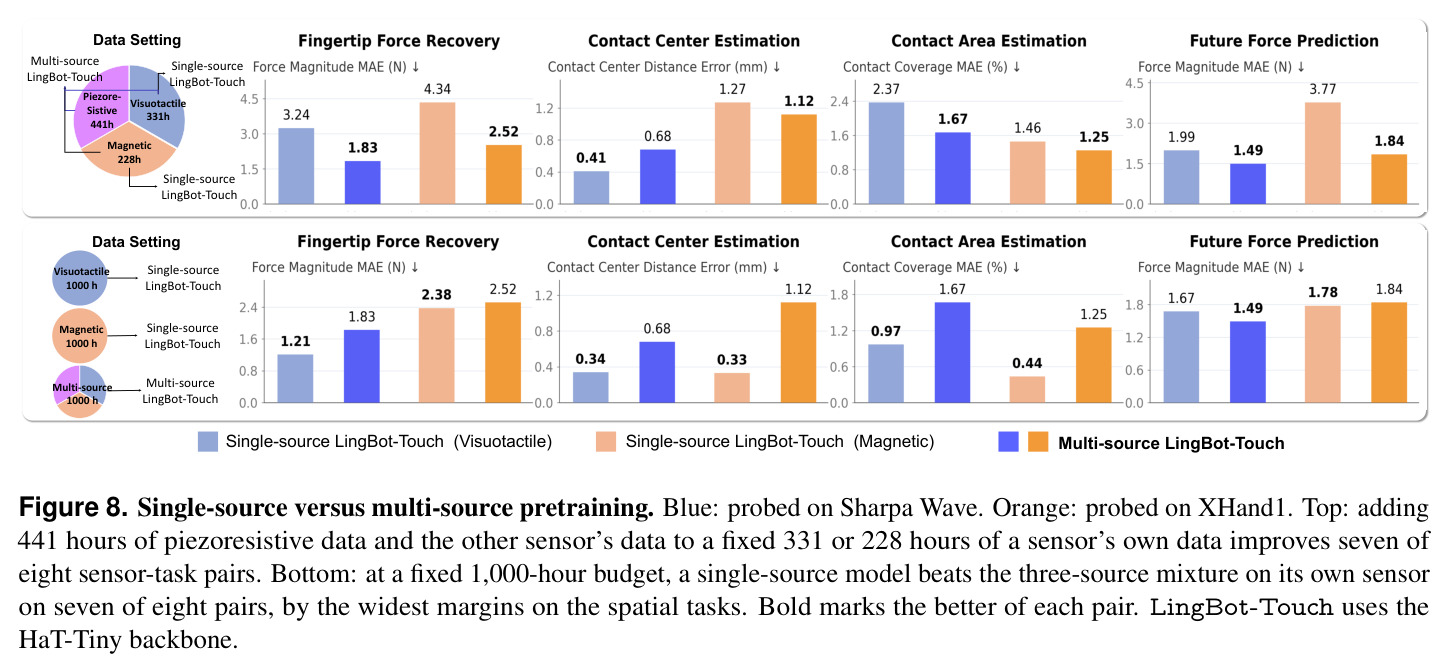
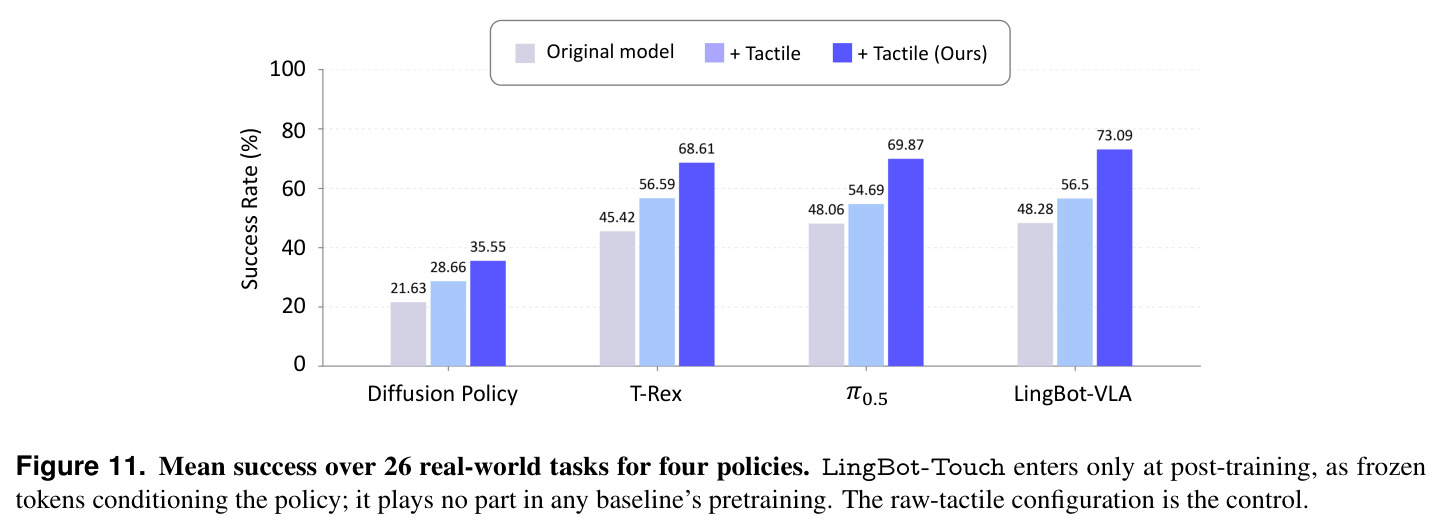
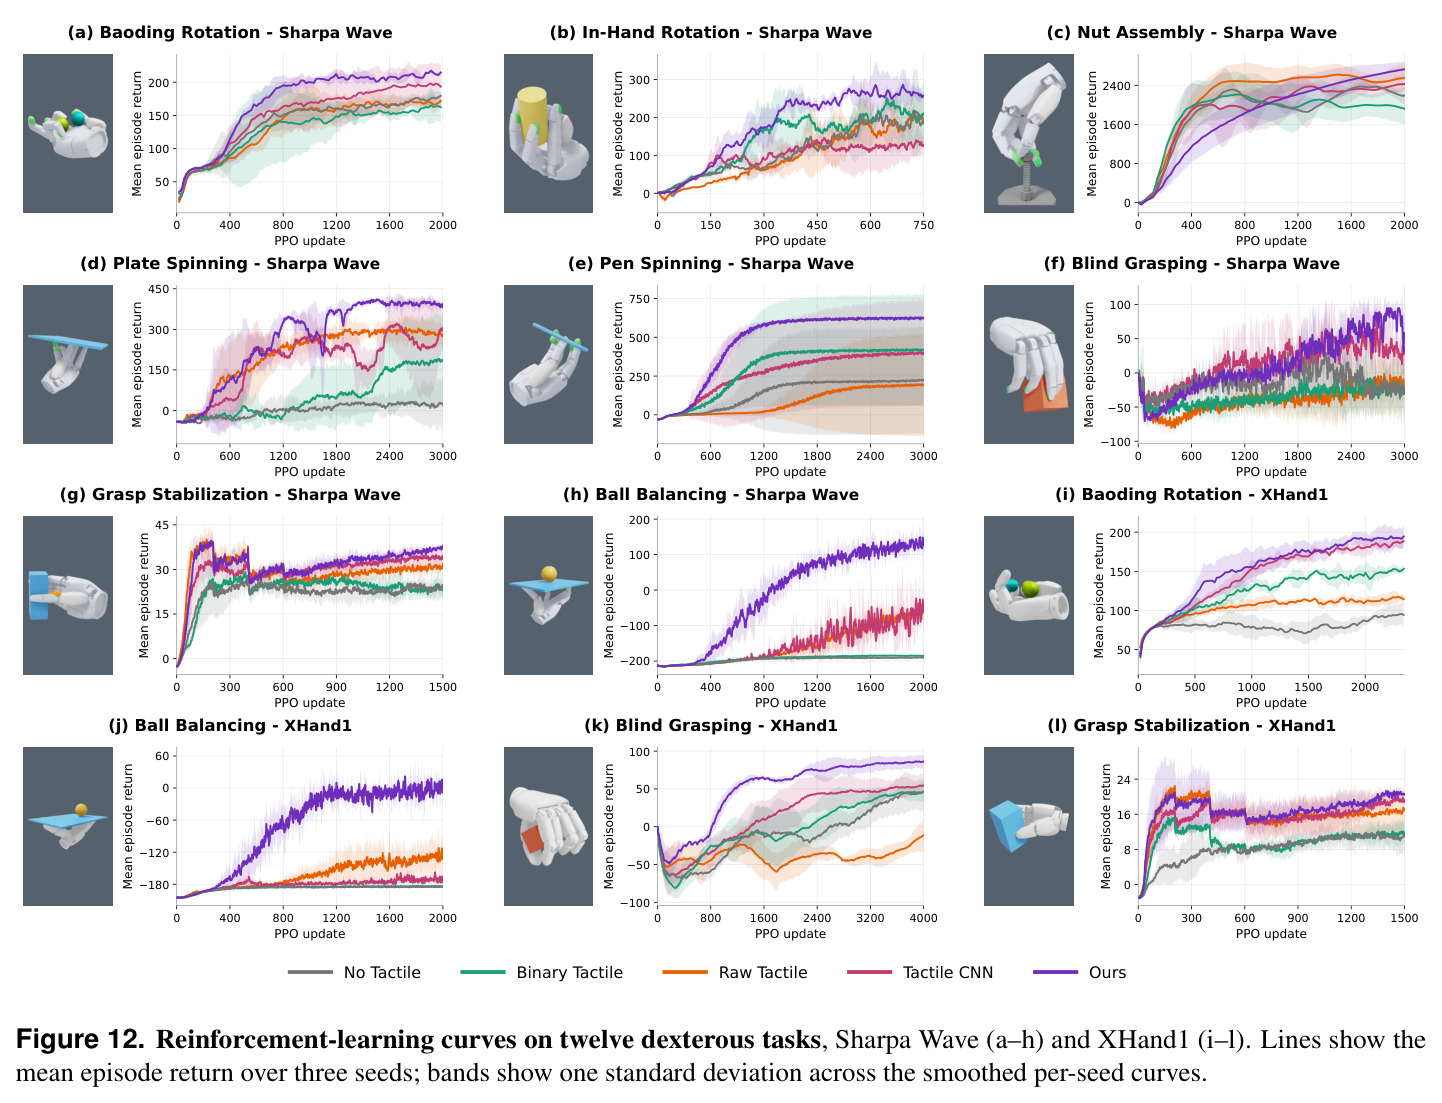
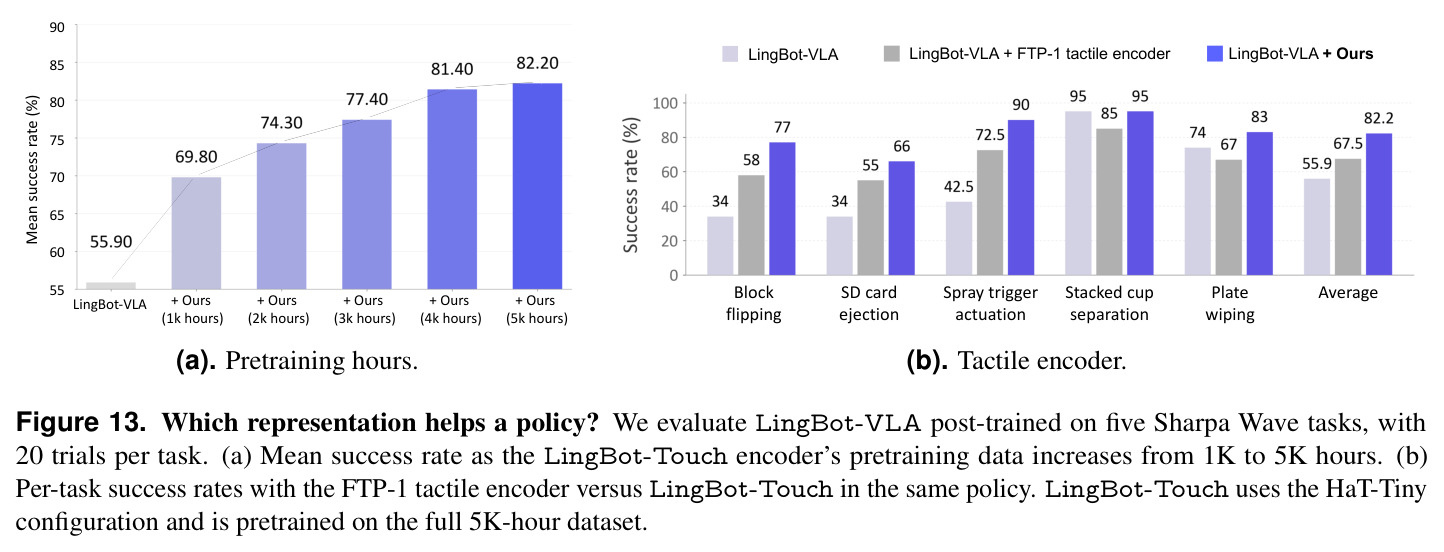
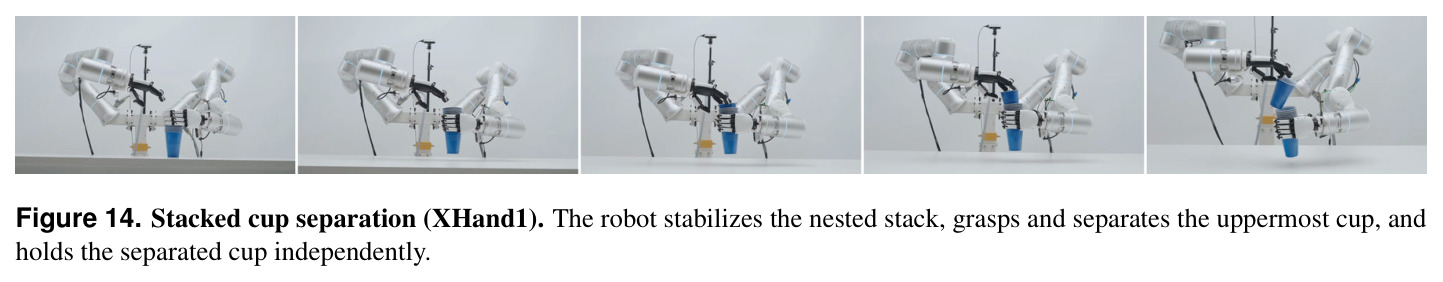
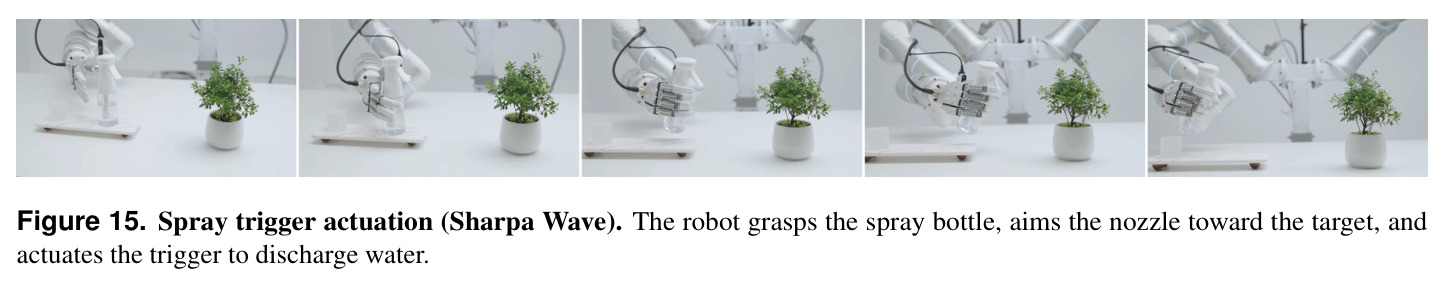
证据覆盖四个层面。冻结探测(Fig. 6):见过的 Sharpa Wave 上力恢复 0.81N 对 FTP-1 的 2.31N,接触中心 0.12mm 对 2.19mm,覆盖率 0.66pp 对 2.90pp,未来力 1.04N 对 1.67N,触觉-视频检索 top-5 召回 72.6% 对 16.5%;未见过的 XHand1 上零适配达 1.32N/0.16mm/0.43pp/1.45N/47.1%,FTP-1 配专属适配器也只有 3.72N/5.89mm/4.39pp/2.00N/6.0%。数据规模(Fig. 7):Small 从 1K 到 5K 小时每项任务单调提升(力误差 1.68→0.81N,检索 42.5%→72.6%),Tiny 约 4K 小时饱和且 5K 时检索下降。多源(Fig. 8):固定自身数据加其他传感器后 8 对 sensor-task 中 7 对改善(磁侧力误差 4.34→2.52N);固定 1K 小时预算时单源在自家传感器上 7/8 胜出(中心 0.34 对 0.68mm),说明强度与动力学跨传感器迁移、空间精度依赖自家布局。目标函数(Fig. 9):1K 小时下 JEPA 中心误差 0.90mm 对 VAE 3.03/MAE 3.07mm,检索 32.1% 对 4.4%/5.6%;4K 小时 VAE 反而退化(3.03→4.08mm)。消融(Tab. 1):80% 掩码最优,全 clip 时序掩码 4/5 占优,值+位置增强把检索从 25.6% 提到 37.1%,EMA 动量 0.998→1.0 完全塌溃(7.2N、召回 1.4%),分组接口优于全共享(0.70 对 2.32mm)。真机(Tab. 2/Fig. 11):26 个双臂任务上冻结 Tiny token 使 Diffusion Policy 21.6%→35.6%、π0.5 48.1%→69.9%、LingBot-VLA 48.3%→73.1%、T-Rex 45.4%→68.6%(增益 13.9/21.8/24.8/23.2pp),原始信号最多 +11.2pp 且在 22/104 对中有害(mahjong sorting 28.8%→5.0%);XHand1 上原始信号近乎无用(-1.7~+4.6pp),token 带来 +13.8~+24.5pp;最大增益出现在视觉无法判定的瞬间(拉链 11%→55%、喷雾扳机 42.5%→87.5%、发牌 32%→92%)。强化学习(Tab. 3):12 个仿真任务平均成功率 69.0%,对触觉 CNN 45.6%、原始信号 38.5%、二值接触 30.3%、无触觉 21.4%,转盘 97.4%、转笔 97.1%、球平衡 35.9% 对 10.0%,种子方差均值 3.9 对基线最高 55。策略侧缩放(Fig. 13):1K→5K 小时使 LingBot-VLA 五任务均值 69.8%→82.2%,换 FTP-1 只有 67.5%。仿真探测(Fig. 16):Dice 0.708、面积 MAE 1.089pp、力 MAE 3.264N、未来力 MAE 0.459N。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 触觉-视频检索(Sharpa Wave,预训练见过的传感器) | Top-5 召回率 (%) | 72.6 | FTP-1(带传感器专属适配器)16.5 | +56.1 个百分点(约 4.4 倍) |
| 接触中心估计(XHand1,预训练未见过的传感器) | 距离误差 (mm),越低越好 | 0.16 | FTP-1 + XHand1 专属适配器 5.89 | 误差缩小约 37 倍,且本文无需任何适配器训练 |
| 指尖力恢复(Sharpa Wave) | 力幅值 MAE (N),越低越好 | 0.81 | FTP-1 2.31 | 误差降低约 65% |
| 真机双臂操作 26 任务(LingBot-VLA 后训练) | 平均成功率 (%),每任务 20 次试验 | 73.1 | 原始策略 48.3(加原始触觉信号 56.3) | +24.8 个百分点,约为原始信号增益(8.2pp)的 3 倍 |
| 仿真强化学习 12 个灵巧任务(PPO,3 seeds) | 平均成功率 (%) | 69.0 | 无触觉 21.4;策略内训练的触觉 CNN 45.6 | +23.4pp(对最强基线),种子标准差均值 3.9 对基线最高 55 |
| 触觉表征对比(1K 小时预训练,HaT-Tiny) | 接触中心估计误差 (mm) | 0.90(Tactile-JEPA) | VAE 3.03;MAE 3.07 | 误差不到重构目标的 1/3;4K 小时 VAE 退化至 4.08 而本文降至 0.32 |
局限与改进
作者承认三点局限:真机与仿真实验需要更多样的手部本体(embodiment),目前只验证了 Sharpa Wave 和 XHand1 两种;传感器覆盖可继续扩展,电容传感器因现有录音质量不达标而缺席预训练;规范几何与预训练布局聚焦于指尖,手掌和手指其他部位的接触欠代表,扩展到全手覆盖是重要下一步。我的补充观察:真机评估每任务仅 20 次连续试验,对 10-20% 量级的差异统计功效有限;真机实验统一使用 4K 小时预训练的 Tiny,而探测实验主结果用 5K 小时 Small,两处设定不一致可能掩盖不同配置下的差异;LingBot-Touch 并非全面占优——在 104 个任务-策略对中有 9 对低于原始信号配置(其中 5 对是 Diffusion Policy)、5 对低于原始策略(如 stiffness sorting 从 48.0% 跌到 28.75%),说明冻结通用 token 在某些需要原始精细纹理的任务上可能丢信息;仿真触觉由几何穿透深度渲染而非真实传感物理,导致仿真力恢复 MAE 高达 3.264N,sim-to-real 通路仍粗糙;规范指尖空间依赖每个传感器-手指模板离线标定固定参数(甚至出现 Tachin 的 0.999 经验系数),面对大量新传感器型号时工程成本不可忽视;预训练语料全部来自厂商自家传感器,跨厂商泛化证据仅基于一个未见磁传感器;作者也承认 32 帧 clip、2-4 帧 tubelet 等超参绑定 30Hz 采样率,不能按帧数直接迁移到其他采样率的传感器。
独立分析的弱点
第一,传感器注册仍有手工环节:式 (1) 的缩放与平移参数、接触中心锚点均按传感器-手指模板离线设定,且各传感器规则不统一(PaXini 用最小包围球,Tachin 用最大各向同性拟合加 0.999 系数,Sharpa Wave 需额外深度平移),扩展到几十上百种传感器时这是工程瓶颈,改进方向是从 CAD 模型或指尖扫描自动估计规范化参数,或学习一个从任意几何到规范空间的回归器。第二,固定预算下多源训练稀释空间精度:单源在自家传感器上接触中心 0.34 对多源 0.68mm(磁侧 0.33 对 1.12mm),改进方向是给骨干加传感器条件化的轻量旁路(如 layout-specific LoRA),或对自家传感器数据上采样。第三,时间分辨率受 token 化限制:两帧合一 token、16 帧 clip 在 30Hz 下窗口有限,对滑动前兆、振动等高频瞬态(恰恰是防滑最需要的信号)可能欠采样,改进方向是流式/因果编码器与更高帧率传感器上的自适应 tubelet。第四,评估统计强度:每任务 20 次试验对 ±10-20% 的差异置信度不足,且 9/104 对中输给原始信号的现象值得逐例归因而非只在附录分析;改进方向是增加试验次数并报告置信区间。第五,跨厂商泛化验证单薄:仅一个未见磁型号(XHand1)验证零迁移,未见电容或光学竞品型号未测;改进方向是建立公开的『未见传感器』基准测试集。第六,检索任务用冻结的 V-JEPA 2 ViT-L 作视觉锚,72.6% 的召回可能部分反映视觉特征质量而非触觉语义本身,应加入换用其他视觉编码器的消融。
未来方向
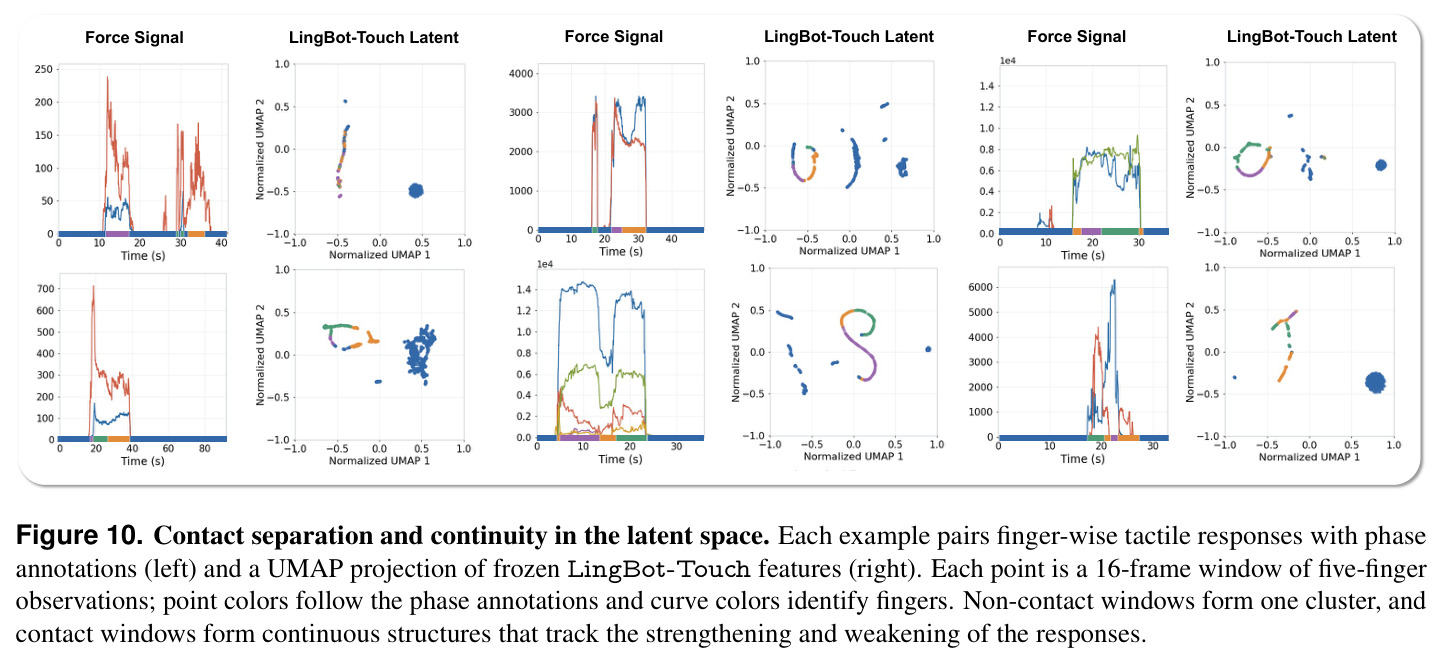
作者指出的方向包括:扩展到更多手部本体、纳入电容等更多传感原理、把布局覆盖从指尖扩展到全手(手掌、指身)。基于其成果可自然延伸的研究有:其一,把触觉 token 纳入 VLA 预训练而非仅后训练——本文的触觉只在后训练阶段进入策略,若在 VLA 预训练阶段就联合建模触觉-视觉-语言,可能得到更强的多模态具身基础模型;其二,基于潜空间的接触相结构(Fig. 10 显示接触强化/减弱形成连续轨迹)构建接触事件分割与滑移预测头,作为安全监控层;其三,改善仿真触觉的真实感——本文仿真力 MAE 3.264N 说明几何穿透渲染与真实传感物理差距大,可用真实数据校准仿真触觉渲染器以打通 sim-to-real;其四,数据采集飞轮优化:既然强度与动力学跨传感器迁移,可系统研究『能力-采集成本』帕累托前沿,决定该为哪种传感器扩充数据(本文论证了答案是易采集的手套而非高端指尖);其五,测试时布局插值或元学习,让空间精度损失(0.34 对 0.68mm)也消失;其六,用表征驱动触觉世界模型,预测未来接触序列以支持规划;其七,把 Tiny 编码器蒸馏进策略主干本身,消除额外推理开销。
复现评估
开源情况:官网、GitHub(robbyant/lingbot-touch)与 HuggingFace checkpoint 集合均已列出,承诺发布推理代码、少量示例触觉录音和 Tiny/Small 两个在约 5,000 小时数据上预训练的检查点,这对下游集成非常友好——冻结编码器加一个交叉注意力 readout 即可接入现有策略。但复现预训练很难:5,000 小时完整语料未计划公开,且其采集依赖定制触觉手套、PaXini 传感器、Sharpa Wave 灵巧手与双臂遥操作平台,个人或小实验室无法复制;规范指尖空间还需要各传感器的几何资产(taxel 三维坐标、参考指尖模型)作为离线标定输入。算力方面模型本身很小(Tiny 5.46M、Small 21.76M,均为 12 层,200K 优化步),探测探针每任务 100 epochs、8 GPU,微调门槛低;真正的资源壁垒在真机数据——26 个任务每任务 200 条示教(双手任务 500 条)、每任务 20 次评估试验,以及 12 个仿真任务各 3 个种子的 PPO 训练。综合评估:用官方 checkpoint 做下游任务集成与探测复现的难度为低到中,重头预训练的难度为极高(数据是唯一但致命的壁垒);好消息是论文证明了 1K 小时已能得到尚可的表征(力误差低于 2N、检索 41%+),自建小规模同构语料做预训练是一条可行的降级路线。
论文图表
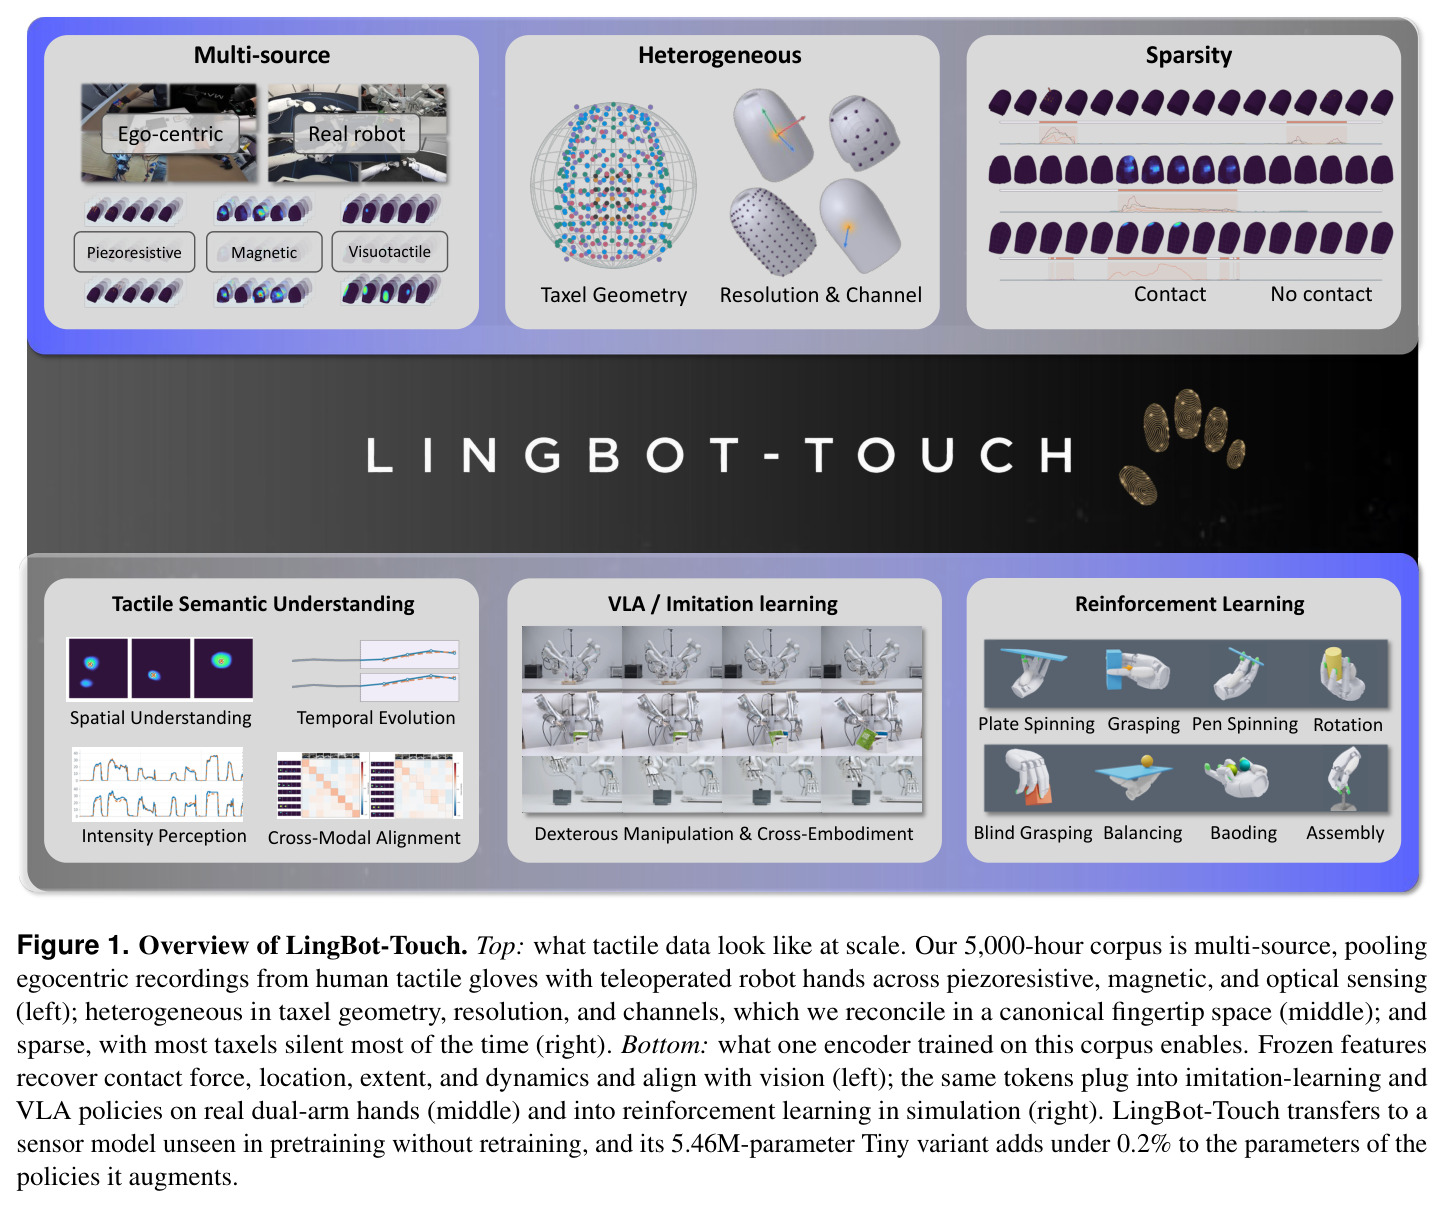
上方展示 5,000 小时语料的三个特性:多来源(人类触觉手套自我中心视角 + 遥操作机器手,覆盖压阻/磁/视触觉)、异构(taxel 几何、分辨率与通道各不相同,被统一到规范指尖空间)、稀疏(大部分 taxel 大部分时间无信号)。下方展示一个编码器使能的三类应用:冻结特征恢复接触力/位置/范围/动力学并与视觉对齐;同一 token 接入模仿学习、VLA 与强化学习策略;迁移到预训练未见的传感器型号无需重训练。Tiny 版仅 5.46M 参数,给所增强策略增加的参数不到 0.2%。
一图总览全文的问题空间(数据三特性)与贡献版图(理解、策略、RL 三线验证),是读者建立全局图景的入口。
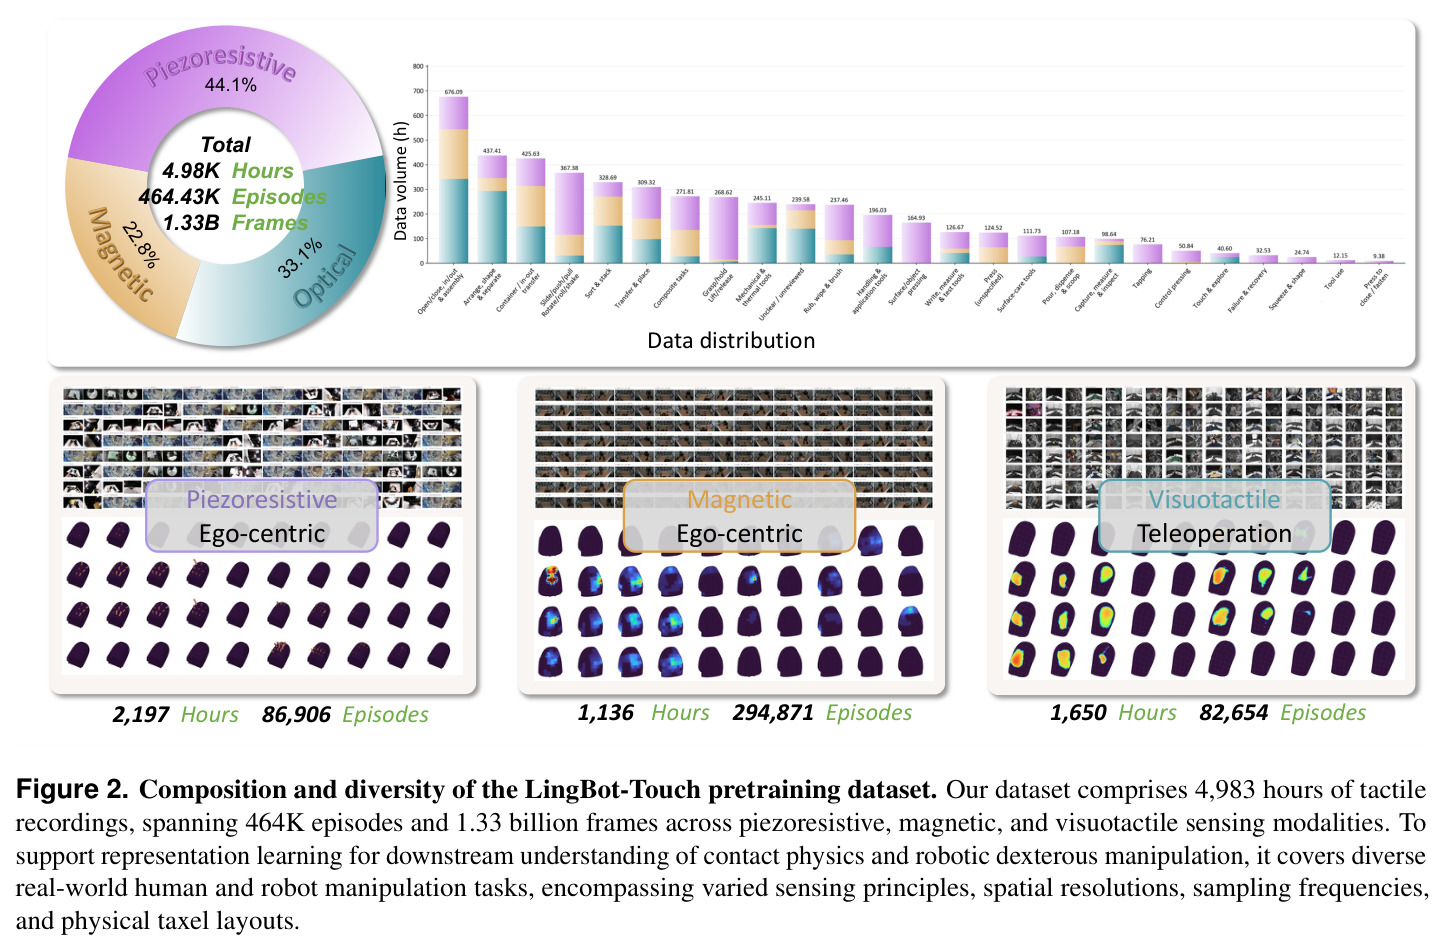
展示预训练数据集构成:共 4,983 小时、464K episodes、13.3 亿帧,覆盖压阻(2,197 小时/86,906 episodes,手套自我中心采集)、磁(1,136 小时/294,871 episodes,手套自我中心采集)、视触觉(1,650 小时/82,654 episodes,遥操作)三种模态,以及 24 类真实操作任务的分布。
语料规模与构成是本文所有结论的地基,这张图量化了『首个让触觉表征学习成为可能的规模』这一贡献。