UniSkill:为演化中的策略学习与执行者对齐的技能提议 UniSkill: Learning Actor-Aligned Skill Proposals for an Evolving Policy
共享策略同时学执行与提技能,用既有轨迹的动作似然对比免额外rollout评估技能
前置知识
GRPO(Group Relative Policy Optimization,组相对策略优化)
一种免 critic 的 LLM 强化学习算法:对同一任务采样一组(group)轨迹,用组内奖励的均值 $\mu_q$ 和标准差 $\sigma_q$ 归一化得到相对优势 $\hat{A}_j = (R_j - \mu_q)/(\sigma_q + \epsilon)$,再套用 PPO 式的比率裁剪目标与 KL 正则更新策略。它省去了价值网络、显著降低算力开销,自 DeepSeekMath 起成为 LLM Agent RL 的主流基线。
UniSkill 的 actor 正是用 GRPO 加环境奖励训练的,论文公式 3-4 的组归一化优势是执行学习的核心;而且组内轨迹结构(同任务、同技能、多成败结果)正是后面对比动作反馈得以成立的前提。
REINFORCE++
对经典 REINFORCE 的工程化改进:在全局 batch 上做奖励归一化得到优势,并引入 PPO 式的重要性采样裁剪与 KL 正则,以降低梯度方差、稳定训练。它同样不需要 critic,适合奖励稀疏、每条样本只产生一个标量奖励的场景。
UniSkill 用它训练技能提议器:每条技能提议合成一个标量奖励 $r_{\text{prop}}$,做全局批归一化后作为该提议所有生成 token 的优势(公式 11-12)——正是这种提议级优势引出了后文操作塌缩与支持正则化的问题。
技能库(skillbank)与技能增强智能体
把交互轨迹蒸馏成可复用的自然语言技能,存入外部技能库;执行新任务时用嵌入检索器(如 Qwen3-Embedding-0.6B 取 top-1)挑出相关技能拼进 prompt 指导行为。技能可以在完全不更新模型参数的情况下跨任务迁移经验,是 ReasoningBank、ACE、SkillRL 等一系列工作的基础机制。
本文的全部目标就是学习'如何维护这个技能库':每次交互后决定 ADD(新增)、UPDATE(修订)还是 NO EDIT(不动),并让技能库随策略共同演化;理解技能库的检索-注入-更新循环是读懂方法设计的前提。
动作对数似然(action log-likelihood)
策略模型对一段已记录动作序列打出的 $\log \pi_\theta(a_t \mid q, s, H_t)$,衡量'在给定任务、技能和历史条件下,模型认为这个动作有多合理'。逐 token 按动作长度归一化再取平均,得到轨迹级分数 $J(\tau;s)$。同一批动作在不同技能条件下的似然差,可以量化技能对模型行为倾向的影响。
本文的对比动作反馈 $R_{\text{align}}$ 完全建立在这个量上:冻结动作只换条件技能,观察成功/失败参考轨迹似然差的变化——这是全文最核心的技术构件,不理解似然就无法理解方法的评估通道。
联合训练中的信用分配(credit assignment)难题
当 actor 和技能提议器同时训练时,技能的真实价值取决于使用它的那个 actor,而 actor 又在不断被更新。到技能被复用时 actor 可能已变强,任务成功未必是技能的功劳——'技能收益'与'actor 自身进步'混在一起,这就是联合训练的信用分配问题。
这是论文动机的核心:$R_{\text{align}}$ 的设计目的就是在 actor 更新之前、用冻结的当前 actor 给技能提议打分,把技能贡献和策略进步干净地分开;Evolving-RL 等前作的缺陷也正出在这里。
ALFWorld 与 WebShop 基准
ALFWorld 是文本化的具身家庭任务基准,含 6 类任务(Pick/Look/Clean/Heat/Cool/Pick2,如'把物体放到台灯下检查'),单回合上限 50 步,报告分类型与总体成功率;WebShop 是模拟电商网站,智能体需搜索、浏览并购买符合自然语言指令的商品,报告归一化任务得分(0-100)与成功率。两者都是 LLM Agent RL 的标准多轮交互测试床。
论文全部主实验、消融与案例研究都在这两个环境上进行;理解任务形态(比如技能内容是'先去梳妆台找台灯、找不到再找边桌'这类可复用搜索策略)才能体会技能库在其中的实际作用。
研究动机
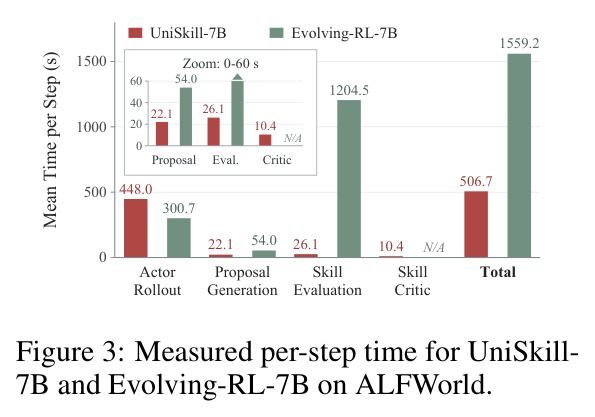
LLM 智能体越来越倾向于把过往交互蒸馏成可复用的文本技能存入技能库(skillbank),执行时检索相关技能注入 prompt,从而跨任务积累经验(ReasoningBank、ACE、SkillRL 等)。这条路线的核心未解问题是:新提出的技能应该接受什么样的学习反馈?现有方案分两类,各有硬伤。第一类(RetroAgent、Skill1)用任务结果预测准确率或提取轨迹自身的回报来奖励技能生成,但这类信号从不检验'当前 actor 拿到这个技能后行为是否真的变好';第二类(Complementary RL、ReSkill)用技能在后续交互中的复现效果打分,但联合训练时 actor 在技能被复用前已被更新——技能毫无帮助任务也可能照样成功,收益无法归因给技能本身,MASA 的工作也证明技能有效性高度依赖具体骨干模型。若坚持在 actor 更新前直接评估候选技能,就必须像 Evolving-RL 那样为每个候选技能跑额外的环境 rollout:论文实测其每步总耗时约 1559.2 秒,且延续训练超过约 100 步后性能崩溃(图 1a),训练又慢又不稳。
本文的目标是本文要构建一个策略与技能库真正共同演化的单一框架:让一个共享策略 $\pi_\theta$ 同时扮演 actor(检索技能执行任务、以环境奖励加 GRPO 学习)和 skill proposer(对比同任务的成败轨迹、提出 ADD/UPDATE/NO EDIT 三种技能库编辑),并且不跑任何额外 rollout 地为每个技能提议提供'对当前 actor 是否有用'的学习信号;同时保证三种编辑操作在 250 步联合训练中不塌缩到单一操作、训练全程稳定,最终在 ALFWorld 上把总体成功率推向 98% 以上、在 WebShop 上超过既有技能增强 RL 方法,并验证该框架在 3B 小模型上依然有效。
与已有工作不同的是,本文的独特切入是把技能评估的通道从'环境'搬进'策略内部'。作者问的不是'技能是否让任务成功',而是'把检索技能 $s$ 换成提议技能 $\tilde{s}$ 后,当前 actor 在同一任务的一组成功/失败参考轨迹上的动作对数似然差如何变化'。由于预更新策略、已记录的历史与动作全部冻结、只有条件技能在变,一次技能评估退化成两次似然前向,可完全复用 GRPO 组内本来就存在的轨迹——零额外 rollout,且信号天然绑定当前 actor。与四类前作的对照非常鲜明:结果预测类(RetroAgent/Skill1)不评估 actor 行为;复用效果类(Complementary RL/ReSkill)被后续策略更新污染;rollout 评估类(Evolving-RL)昂贵且训练不稳;MASA 只诊断了问题没给方案。此外,论文还进一步发现并修复了'提议级奖励会抑制编辑操作探索'这一训练动力学层面的塌缩效应,是此前工作没有触及的角度。
核心方法
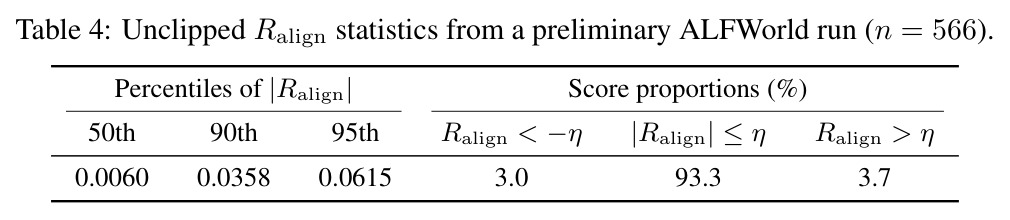
直觉上,一条技能好不好,取决于它是否让当前策略'更像成功者、更不像失败者'。UniSkill 维护一个技能库 $\mathcal{S}$,共享策略 $\pi_\theta$ 承担两个角色:作为 actor,检索器(Qwen3-Embedding-0.6B,top-1)为任务 $q$ 选出技能 $s$,每轮按 $a_t \sim \pi_\theta(\cdot \mid q, s, H_t)$ 生成动作;作为 skill proposer,读入同任务、同技能下的源轨迹 $\tau$ 与反结果轨迹 $\tau_{\text{opposite}}$,生成结构化提议 $(op, \tilde{s})$,$op \in \{\text{NO EDIT}, \text{ADD}, \text{UPDATE}\}$。训练侧双轨并行:actor 用 GRPO(组内 $G=8$ 条轨迹、环境奖励)学习;proposer 用 REINFORCE++ 学习,奖励为 $r_{\text{prop}} = r_{\text{fmt}} + r_{\text{op}} + r_{\text{skill}}$——格式奖励直接检查;冻结的 DeepSeek-V4-Pro critic 判操作是否适当($r_{\text{op}} = \pm\eta$)与内容是否被轨迹支持($r_{\text{skill}}$);内容被支持时 $r_{\text{skill}} = \text{clip}(R_{\text{align}}, -\eta, \eta)$($\eta=0.05$),否则 $-\eta$,NO EDIT 取 0。两路损失按 $\mathcal{L}_{\text{UniSkill}} = \mathcal{L}_{\text{actor}} + \lambda_{\text{prop}}\mathcal{L}_{\text{proposer}}$($\lambda_{\text{prop}}=0.5$)联合更新同一组参数;只有通过 critic 双重检查且满足 $\Delta^+>0$、$R_{\text{align}}>0$ 的编辑才会写回技能库。
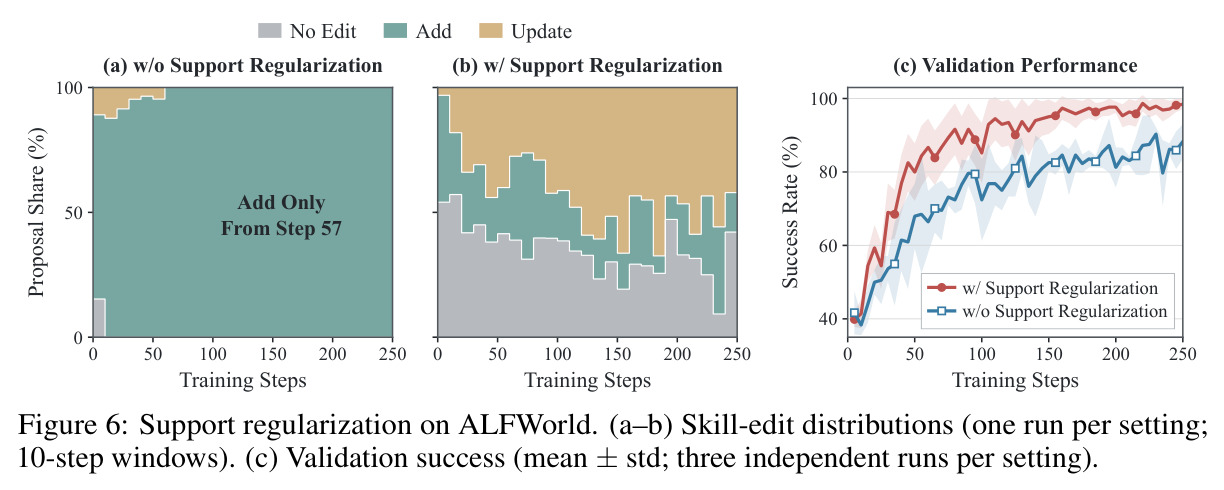
核心创新一是对比动作反馈 $R_{\text{align}}$(actor alignment 的免 rollout 代理)。对同任务、同检索技能、同一 actor 的组内轨迹,剔除提议器输入后采样一条成功参考 $\tau^+$ 与一条失败参考 $\tau^-$;冻结策略与已记录动作,仅把条件技能换成 $\tilde{s}$,计算逐 token 归一化的平均动作对数似然 $J(\tau;s) = \frac{1}{T}\sum_{t=1}^{T}\frac{1}{|a_t|}\log \pi_\theta(a_t \mid q, s, H_t)$,得 $\Delta^{\pm} = J(\tau^{\pm};\tilde{s}) - J(\tau^{\pm};s)$,反馈为 $R_{\text{align}} = \Delta^+ - \Delta^-$。$R_{\text{align}}>0$ 表示提议技能拉大了成败参考之间的似然差。本质区别在评估通道:结果预测类奖励不涉及 actor 行为,复用效果类被后续更新污染,Evolving-RL 每个提议要加跑环境 rollout,而 UniSkill 只需两次似然前向——实测每步 300.7 秒 vs 1559.2 秒(约 5.2 倍),且信号天然对齐'当前'actor。核心创新二是 skill-edit 支持正则化:提议级优势同时作用于操作词和内容 token,内容差会连累恰当的操作被反复抑制直至不再被采样;$\mathcal{L}_{\text{sup}} = \mathbb{E}_x\big[\frac{1}{|\mathcal{O}(s)|}\sum_{op \in \mathcal{O}(s)}\left[\max(0, \log p_{\min} - \log p_\theta(op \mid x))\right]^2\big]$($p_{\min}=0.1$,$\lambda_{\text{sup}}=0.01$)只惩罚概率跌破下限的操作,保住探索而不强求均匀分布。
方法步骤详情
按 Algorithm 1,每个训练步依次执行:(1) 采样 16 个任务,从技能库检索 top-1 技能,旧策略 $\pi_{\text{old}}$ 对每任务跑 $G=8$ 条轨迹(ALFWorld 单回合上限 50 步,WebShop 15 步);(2) 由组内奖励统计量得优势 $\hat{A}_j = \frac{R_j - \mu_q}{\sigma_q + \epsilon}$,写入带 $\epsilon=0.2$ 裁剪与 KL 正则($\beta=0.01$)的 actor GRPO 损失;(3) 对合格源轨迹配一条反结果轨迹送入提议器生成 $(op, \tilde{s})$(前 3 步仅用格式奖励预热);(4) 从组内剔除提议器输入后采样 $\tau^+ \sim \mathcal{T}_q^+ \setminus \{\tau, \tau_{\text{opposite}}\}$、$\tau^- \sim \mathcal{T}_q^- \setminus \{\tau, \tau_{\text{opposite}}\}$(要求两参考集非空,否则丢弃该轨迹);(5) 做格式检查并由冻结 critic 给出 $d_{\text{op}}$(操作是否适当)与 $d_{\text{skill}}$(内容是否被轨迹支持),再计算 $\Delta^+$、$\Delta^-$、$R_{\text{align}}$;(6) 合成 $r_{\text{prop}}$ 并做全局批归一化得 $\hat{A}_{\text{prop}}$,用 REINFORCE++(KL 系数 $\beta_{\text{prop}}=0.02$)叠加 $\lambda_{\text{sup}}\mathcal{L}_{\text{sup}}$ 更新提议器;(7) 两路梯度累积后一次 AdamW 更新(学习率 $10^{-6}$,最大输入 16384 token,提议最长 1024 token);(8) 入库采用严格门槛:critic 双通过且 $\Delta^+>0$ 且 $R_{\text{align}}>0$ 的 ADD/UPDATE 才提交,同一 UPDATE 目标只取 $R_{\text{align}}$ 最高的提议,更新后的技能库用于下一轮检索,形成共同演化闭环。
技术新颖性
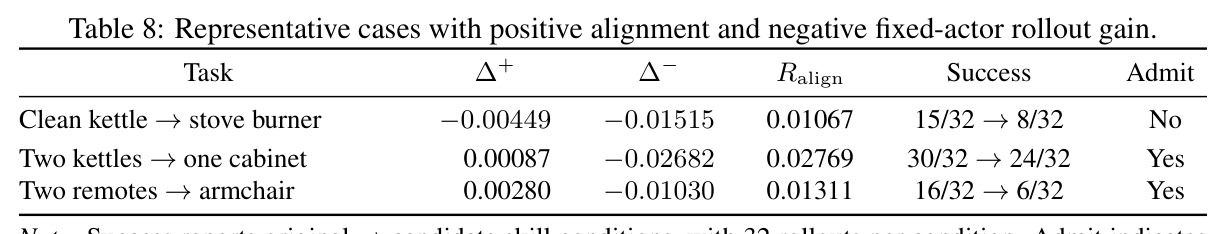
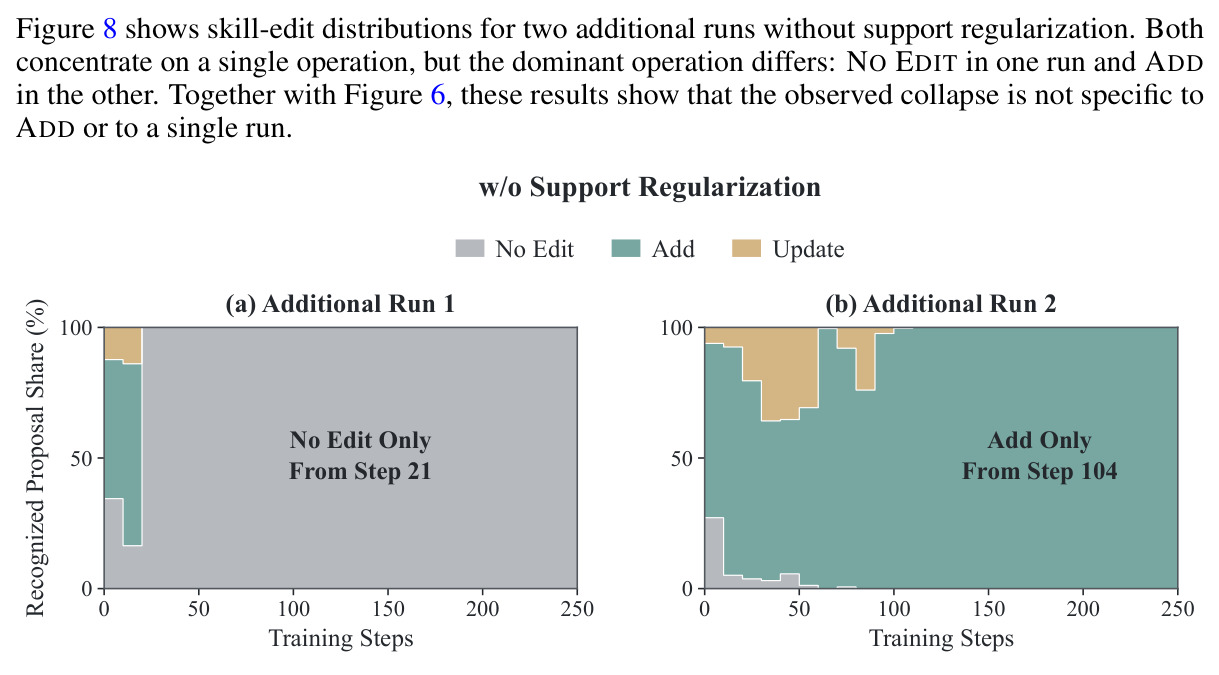
新颖性一:把技能信用分配的指标从环境级(成功率/回报)置换为策略级(动作似然差)。这一置换一举解决两个问题——信号绑定当前 actor(似然由当前策略算出),成本从'每提议若干次环境交互'降为'每提议两次前向'。新颖性二:对比式构造抵消了技能文本自身的似然偏置。绝对似然受技能长度与措辞影响(长技能系统性压低所有动作似然),成败参考对的差值聚焦'行为区分度'本身。新颖性三:首次诊断并修复联合训练中提议级奖励导致的操作塌缩——消融显示无正则时三次独立运行分别在第 57、21、104 步塌缩到单一操作(ADD only / NO EDIT only),且 $p_{\min}$ 有显式推导(按 $G=8$、至少 50% 概率出现一次得 $p \geq 1 - 0.5^{1/8} \approx 0.083$,取整 0.1)。新颖性四:双门槛入库设计。$R_{\text{align}}>0$ 可能来自成败似然同降(如案例中 $\Delta^+=-0.00449$、$\Delta^-=-0.01515$ 仍得正分),附加 $\Delta^+>0$ 保证成功参考不被伤害,表 8 的 Case 1 展示该防线确实拦下了一个实测有害(成功率 15/32 降到 8/32)的技能。
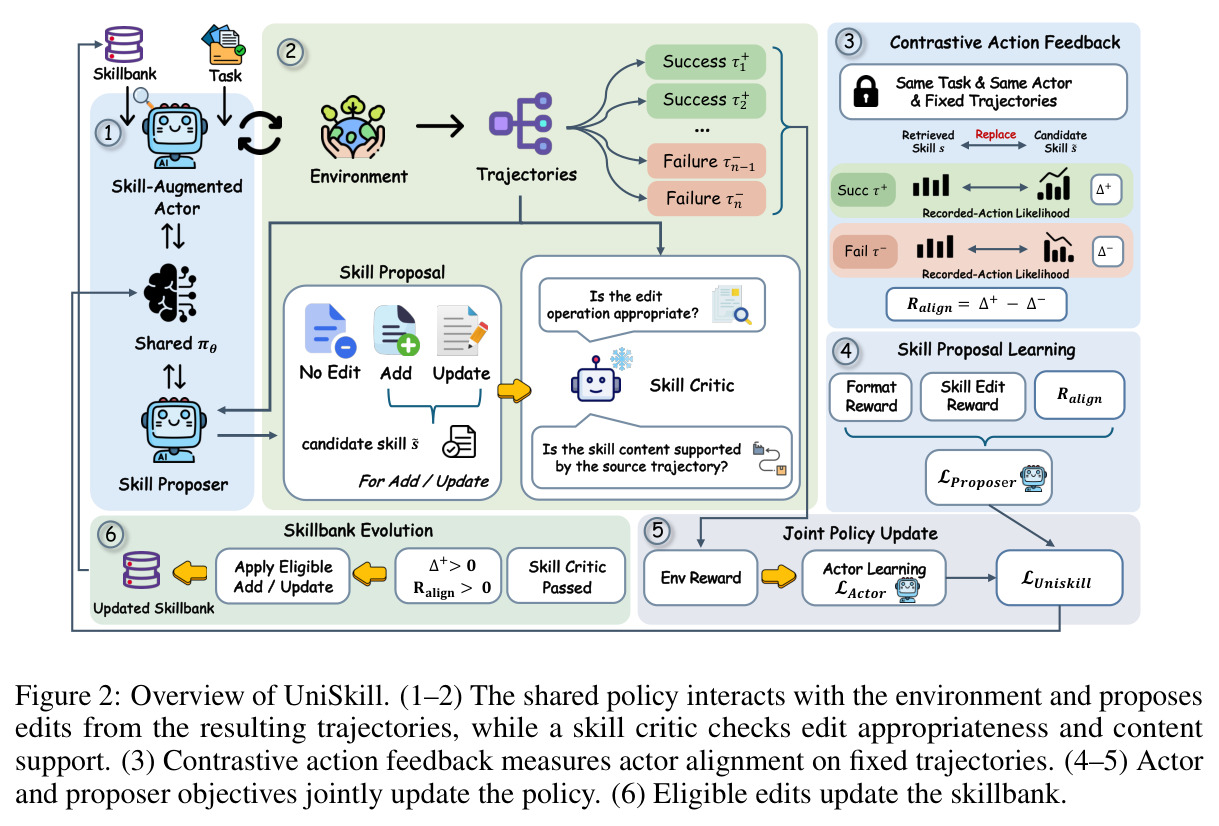
实验结果
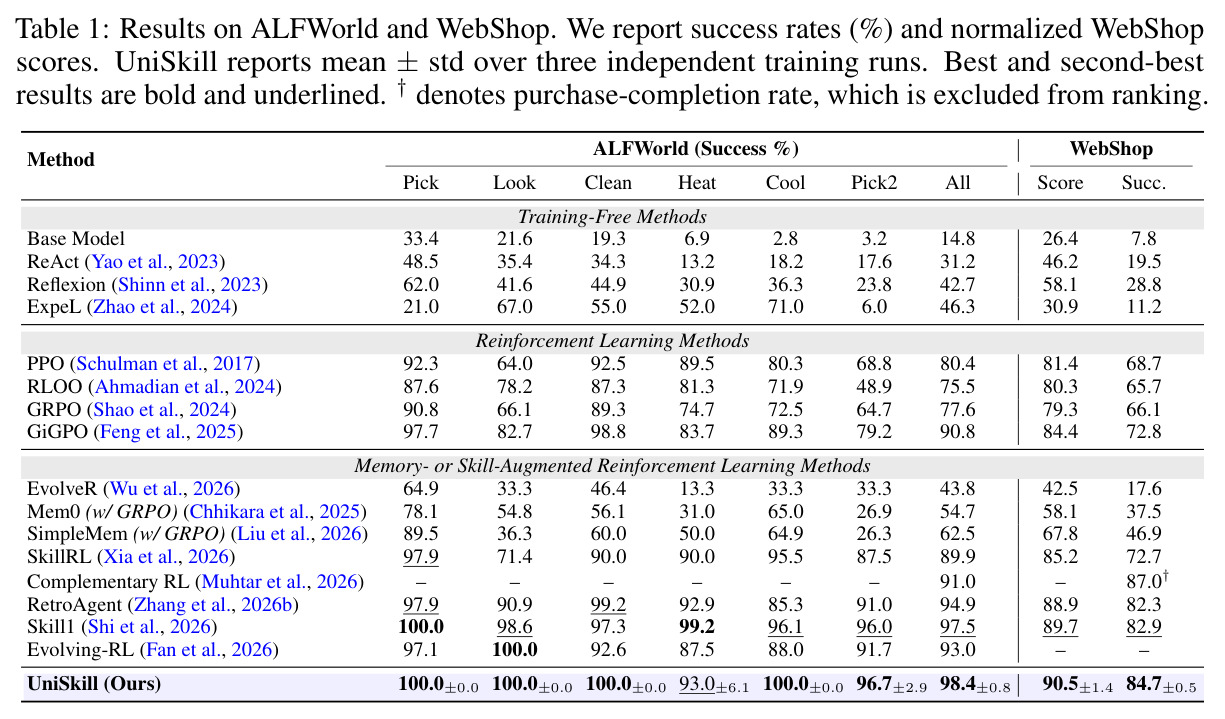
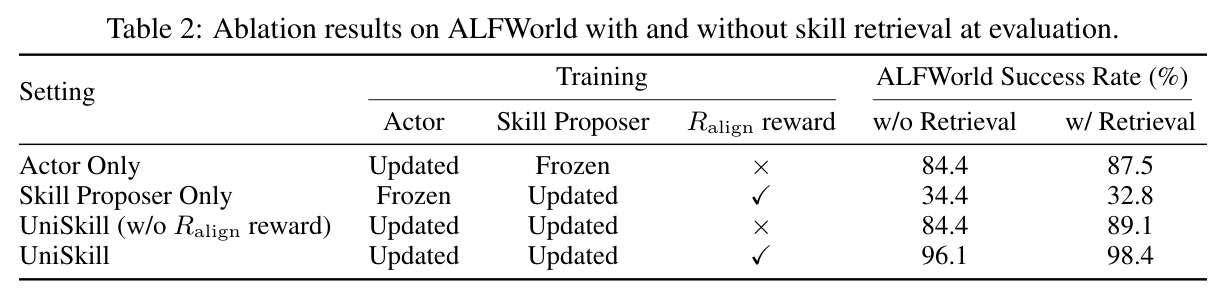
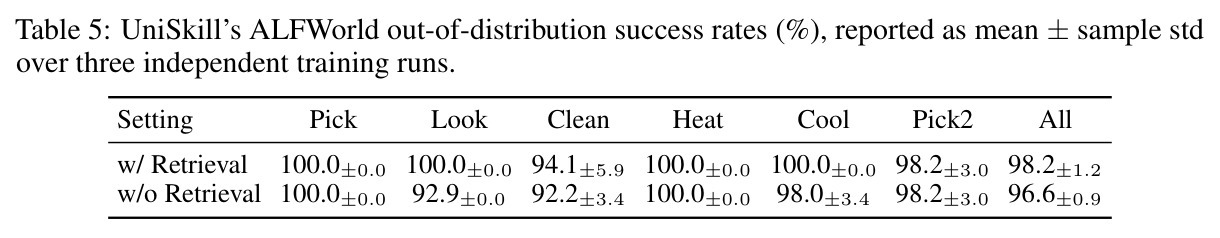
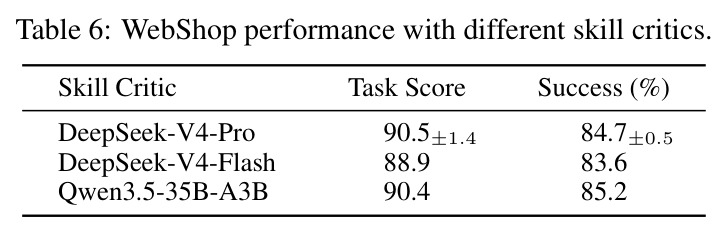
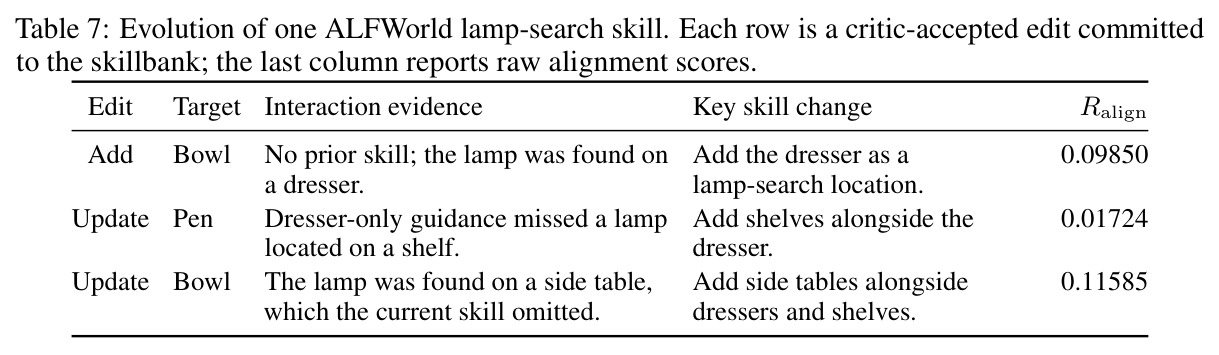
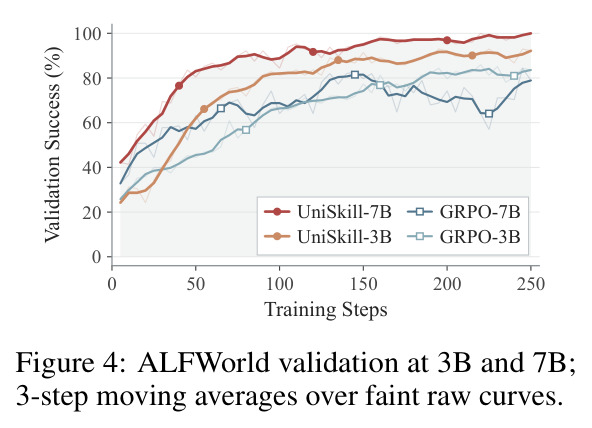
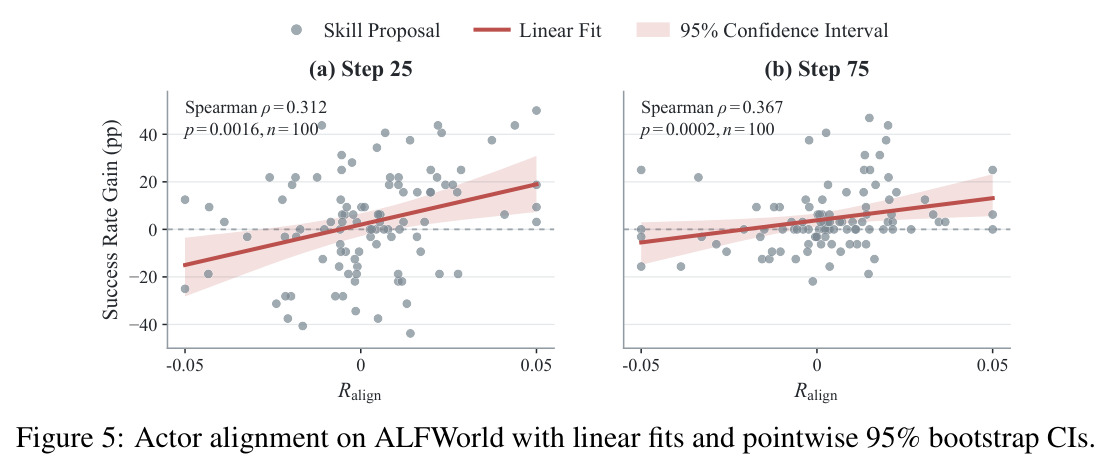
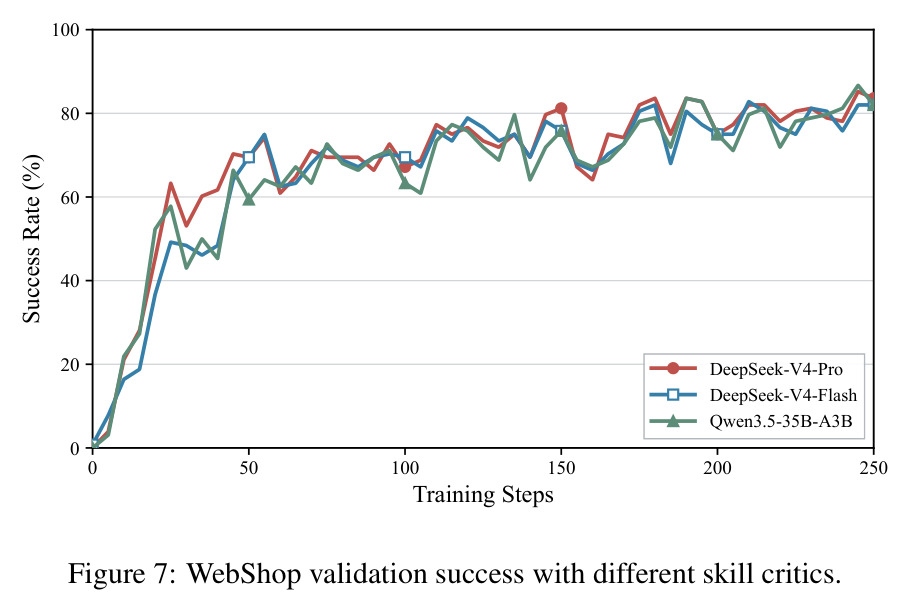
主结果(表 1,Qwen2.5-7B-Instruct,三次独立训练取均值±标准差):ALFWorld 总成功率 98.4%±0.8,其中 Pick/Look/Clean/Cool 四类均达 100.0%,Heat 93.0±6.1、Pick2 96.7±2.9;WebShop 归一化得分 90.5±1.4、成功率 84.7%±0.5。横向对比:比 GRPO、GiGPO 在 ALFWorld 上分别高 20.8 与 7.6 个百分点;比 SkillRL 在 WebShop 成功率上高 12.0 pp;比此前最强基线 Skill1 高 0.9 pp(ALFWorld)与 1.8 pp(WebShop 成功率);比联合训练基线 Evolving-RL 高 5.4 pp。训练动力学(图 1):Evolving-RL 前期猛涨但约 100 步后崩溃(与其作者公开说明一致),UniSkill 稳定训练 250 步且后期持续上升;技能库早期快速扩张、后期转为少量 ADD/UPDATE 持续精修。效率(图 3):每步总耗时 300.7 秒 vs Evolving-RL 1559.2 秒。模型规模(图 4):UniSkill-3B 后期突破 90% 且最终高于 GRPO-7B,说明共同演化不依赖大骨干。消融(表 2):完整版无检索 96.1%/有检索 98.4%;去掉 $R_{\text{align}}$ 掉到 84.4%/89.1%;只训 actor 84.4%/87.5%;只训提议器仅 34.4%/32.8%——$R_{\text{align}}$ 对 actor 无检索性能贡献 +11.7 pp,说明它塑造的是 actor 本身而非仅技能库。代理有效性(图 5):$R_{\text{align}}$ 与固定 actor 32-rollout 实测增益的 Spearman 相关在 25/75 步分别为 $\rho=0.312$(p=0.0016)与 $\rho=0.367$(p=0.0002),正分提议平均增益 +8.4/+7.2 pp、负分提议 -3.4/-0.5 pp,但 24.5%/15.6% 的正分提议实测为负增益。正则消融(图 6、8):无正则的三次运行分别在第 57、21、104 步塌缩到单一操作;有正则则三操作共存、前期更快后期更高。鲁棒性:ALFWorld valid unseen 上有检索 98.2%±1.2、无检索 96.6%±0.9(表 5);换 critic 后 WebShop 成功率仍在 83.6–85.2% 区间(表 6)。案例研究:水壶技能 UPDATE 后同任务实例从 6/8 成功、平均 28.25 步提升到 8/8、16.75 步;台灯技能经三次编辑($R_{\text{align}}$ 0.09850→0.01724→0.11585)迁移到目标物不同的雕像/铅笔任务均 8/8 成功。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld 整体(6 类家庭任务,valid seen) | 成功率 (%) | 98.4±0.8 | Skill1 97.5;Evolving-RL 93.0;GiGPO 90.8;GRPO 77.6 | +0.9 pp(vs Skill1);+5.4 pp(vs Evolving-RL);+20.8 pp(vs GRPO) |
| WebShop | 归一化任务得分(0-100) | 90.5±1.4 | Skill1 89.7;GiGPO 84.4;PPO 81.4 | +0.8(vs Skill1) |
| WebShop | 成功率 (%) | 84.7±0.5 | Skill1 82.9;GiGPO 72.8;SkillRL 72.7 | +1.8 pp(vs Skill1);约 +12.0 pp(vs SkillRL) |
| ALFWorld 训练效率(每步总耗时) | 秒/步 | 300.7 | Evolving-RL 1559.2 | 约 5.2 倍加速(降低 80.7%) |
| ALFWorld OOD(valid unseen) | 成功率 (%) | 98.2±1.2(有检索);96.6±0.9(无检索) | 自身消融对比(无外部基线) | 技能检索额外带来 +1.6 pp |
局限与改进
作者承认的局限:(1) $R_{\text{align}}$ 只是代理指标——正分提议中仍有 24.5%(25 步)和 15.6%(75 步)实测产生负增益,论文用 $\Delta^+>0$ 入库门槛与案例分析坦承了这一缺口;(2) 实验仅覆盖 ALFWorld 与 WebShop 两个文本交互环境,未涉及真实具身、长程或更开放的任务分布;(3) 依赖外部冻结 critic(DeepSeek-V4-Pro),虽然表 6 显示换用其他 critic 影响不大,但引入了闭源模型依赖与每步调用开销(10.4 秒);(4) 只训练 250 步,更长周期下技能库质量漂移未验证。我的补充观察:(1) 似然代理有系统性盲区——$J(\tau;s)$ 只衡量'参考动作是否被当前策略认可',若技能的价值在于诱导全新动作(而非认可旧动作),会被低估,表 8 的 Case 2/3 失败模式部分源于此;(2) 参考对要求同组内同时存在成功与失败轨迹(剔除输入后各自非空),部分轨迹被直接丢弃,样本效率受组结构制约;(3) 评估时策略与技能库全部冻结,未研究持续部署下技能库的去重、淘汰与冲突合并(UPDATE 每目标只取 $R_{\text{align}}$ 最高者,策略较粗糙);(4) WebShop 上 Complementary RL 报告的 87.0% 是'购买完成率'口径,与本文 84.7% 的成功率并非严格可比(论文以†标注并排除排名,读者需留意)。
独立分析的弱点
独立分析的弱点与改进方向:(1) 代理指标假阳性不可忽略——约 15-25% 的正分提议实际有害,可引入轻量在线校准:对入库候选做小批量抽样验证,或用历史 (Ralign, 实测增益) 对做保形校准(conformal calibration)给出入库置信区间;也可将单对参考扩展为多对参考取均值/中位数以压噪。(2) 似然只反映'认可度'不反映'执行可行性'——案例 3 中技能缺一步'先放置再搜索'的显式约束导致 actor 执行走样;可让提议器在生成技能时附带可执行检查清单,或把同一技能下多条轨迹的似然方差作为'行为一致性'附加信号。(3) critic 是黑盒外部模型——可蒸馏小型本地 critic,或用 $R_{\text{align}}$ 的统计性质(表 4 显示 93.3% 落在 ±η 内)替代部分判断,降低 API 依赖。(4) 无参考对的轨迹被丢弃——可跨组或从历史轨迹池构造参考对,或为 NO EDIT 提议设计独立反馈通道。(5) 技能库只增不删——250 步内增速放缓但无去重与过时清理,长训练可能引入检索噪声,应建立基于使用率与 Ralign 的技能生命周期管理。(6) 两个基准都是动作空间小、奖励较稠密的文本环境;在稀疏奖励、部分可观测更强的场景(真实网页、仓库级代码任务)中 $R_{\text{align}}$ 的信噪比有待检验。
未来方向
作者未设专门的 future work 章节,结论指向跨模型规模的共同演化与长期训练稳定性(3B 实验是初步验证)。基于成果可延伸的方向:(1) 把 $R_{\text{align}}$ 推广为'策略间对齐'——用参考 actor 池而非单一 actor,系统研究技能的跨模型可迁移性(呼应 MASA 的发现);(2) 技能库结构化——与 SkillGraph 结合,把 ADD/UPDATE 扩展为 LINK/MERGE/DELETE 等图操作,支持技能依赖与组合复用;(3) 将对比动作反馈作为通用的'经验信用分配'信号,推广到反思生成、workflow 蒸馏与上下文/记忆编辑(ACE、Dynamic Cheatsheet 类方法都可受益于这个免 rollout 信号);(4) 在线部署场景——技能库随用户流量持续更新,研究技能污染的检测、隔离与回滚机制;(5) 理论层面——分析动作似然差与期望回报提升之间的关系(类似策略改进 surrogate 的保证),给出 $R_{\text{align}}>0$ 蕴含任务效用提升的充分/必要条件;(6) 迁移到 rollout 更昂贵的领域——如 VLA/机器人技能库,用似然对比替代真实环境评估的收益会更大。
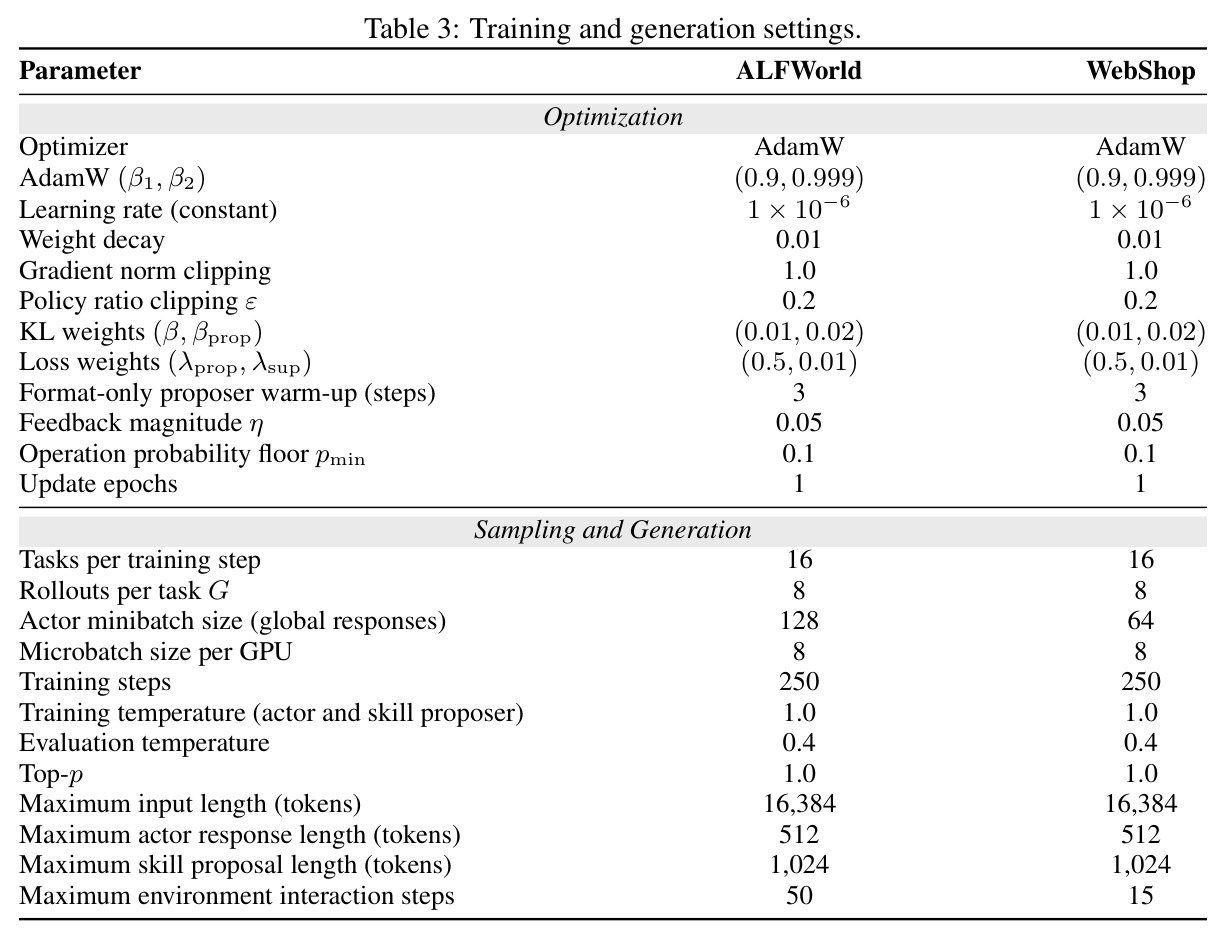
复现评估
复现条件较好。代码承诺开源(GitHub:LimOkii/UniSKill,论文已给出链接);实现基于 VERL 与 VERL-AGENT,基线协议沿用其官方流水线,评估采用 ALFWorld 官方 valid seen/unseen 划分。训练配置完整披露(表 3):Qwen2.5-7B-Instruct、每步 16 任务 × 8 轨迹、250 步、学习率 $10^{-6}$、AdamW、$\lambda_{\text{prop}}=0.5$、$\lambda_{\text{sup}}=0.01$、$\eta=0.05$、$p_{\min}=0.1$、最大输入 16384 token;actor/proposer/critic 的 prompt 全文在附录 A,训练伪代码在附录 C,$\eta$ 与 $p_{\min}$ 的选择依据在附录 B($\eta$ 基于 $n=566$ 的 $R_{\text{align}}$ 分布统计,$p_{\min}$ 有显式概率推导)。算力:论文未披露 GPU 数量,但按 VERL-AGENT 的 7B 模型、每步 128 个 actor 响应的配置估计,单节点 8×A100/H100 量级可行;外部依赖为 DeepSeek-V4-Pro critic API(可用开源模型替换,表 6 证明 Qwen3.5-35B-A3B 同样可行,得分 90.4/成功率 85.2)与开源的 Qwen3-Embedding-0.6B。难度评估:中等偏上——方法组件多(GRPO + REINFORCE++ + critic + 支持正则 + 双门槛入库),联合训练的调试成本高;但消融完整、伪代码清晰、三次独立运行报告均值±标准差(ALFWorld ±0.8、WebShop ±0.5/±1.4),方差小、结果可信,Evolving-RL 的复现对照也有其仓库公开说明支持。
论文图表
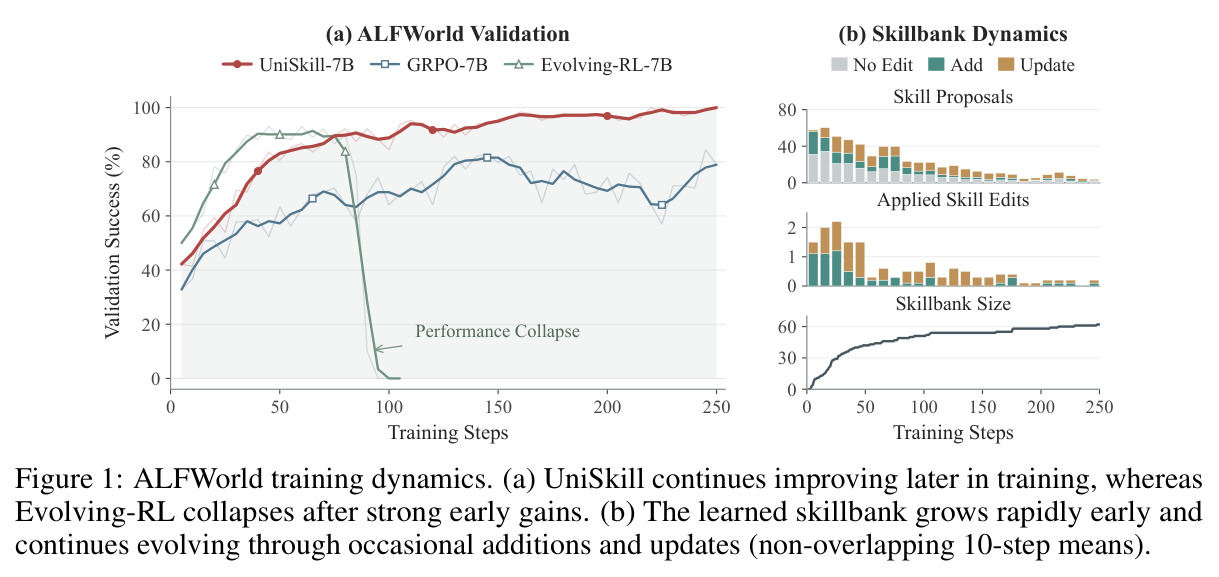
两个子图:(a) 展示 UniSkill-7B、GRPO-7B、Evolving-RL-7B 在 ALFWorld 验证集上的成功率随训练步数(0-250 步)的变化——Evolving-RL 前期收益强劲但随后崩溃,UniSkill 持续上升并在后期继续改进;(b) 展示技能提议操作分布(No Edit/Add/Update)与技能库规模的演化——技能库早期快速增长,随后放缓但仍通过偶发的 ADD 和 UPDATE 持续演化。
一张图同时呈现了论文的双重卖点:联合训练的稳定性(对手崩溃 vs 本文持续改进)和技能库的真实演化动态,是理解'为什么需要 UniSkill'以及'共同演化是否真的发生'的最直观证据。