SkillForge:基于动态技能生命周期的技能与智能体协同进化 SkillForge: Co-Evolving Skills and Agents via Dynamic Skill Lifecycles
用适应度驱动的技能生命周期让技能库与RL策略协同进化,退役过时技能并变异重塑中等技能
前置知识
GRPO(组相对策略优化)
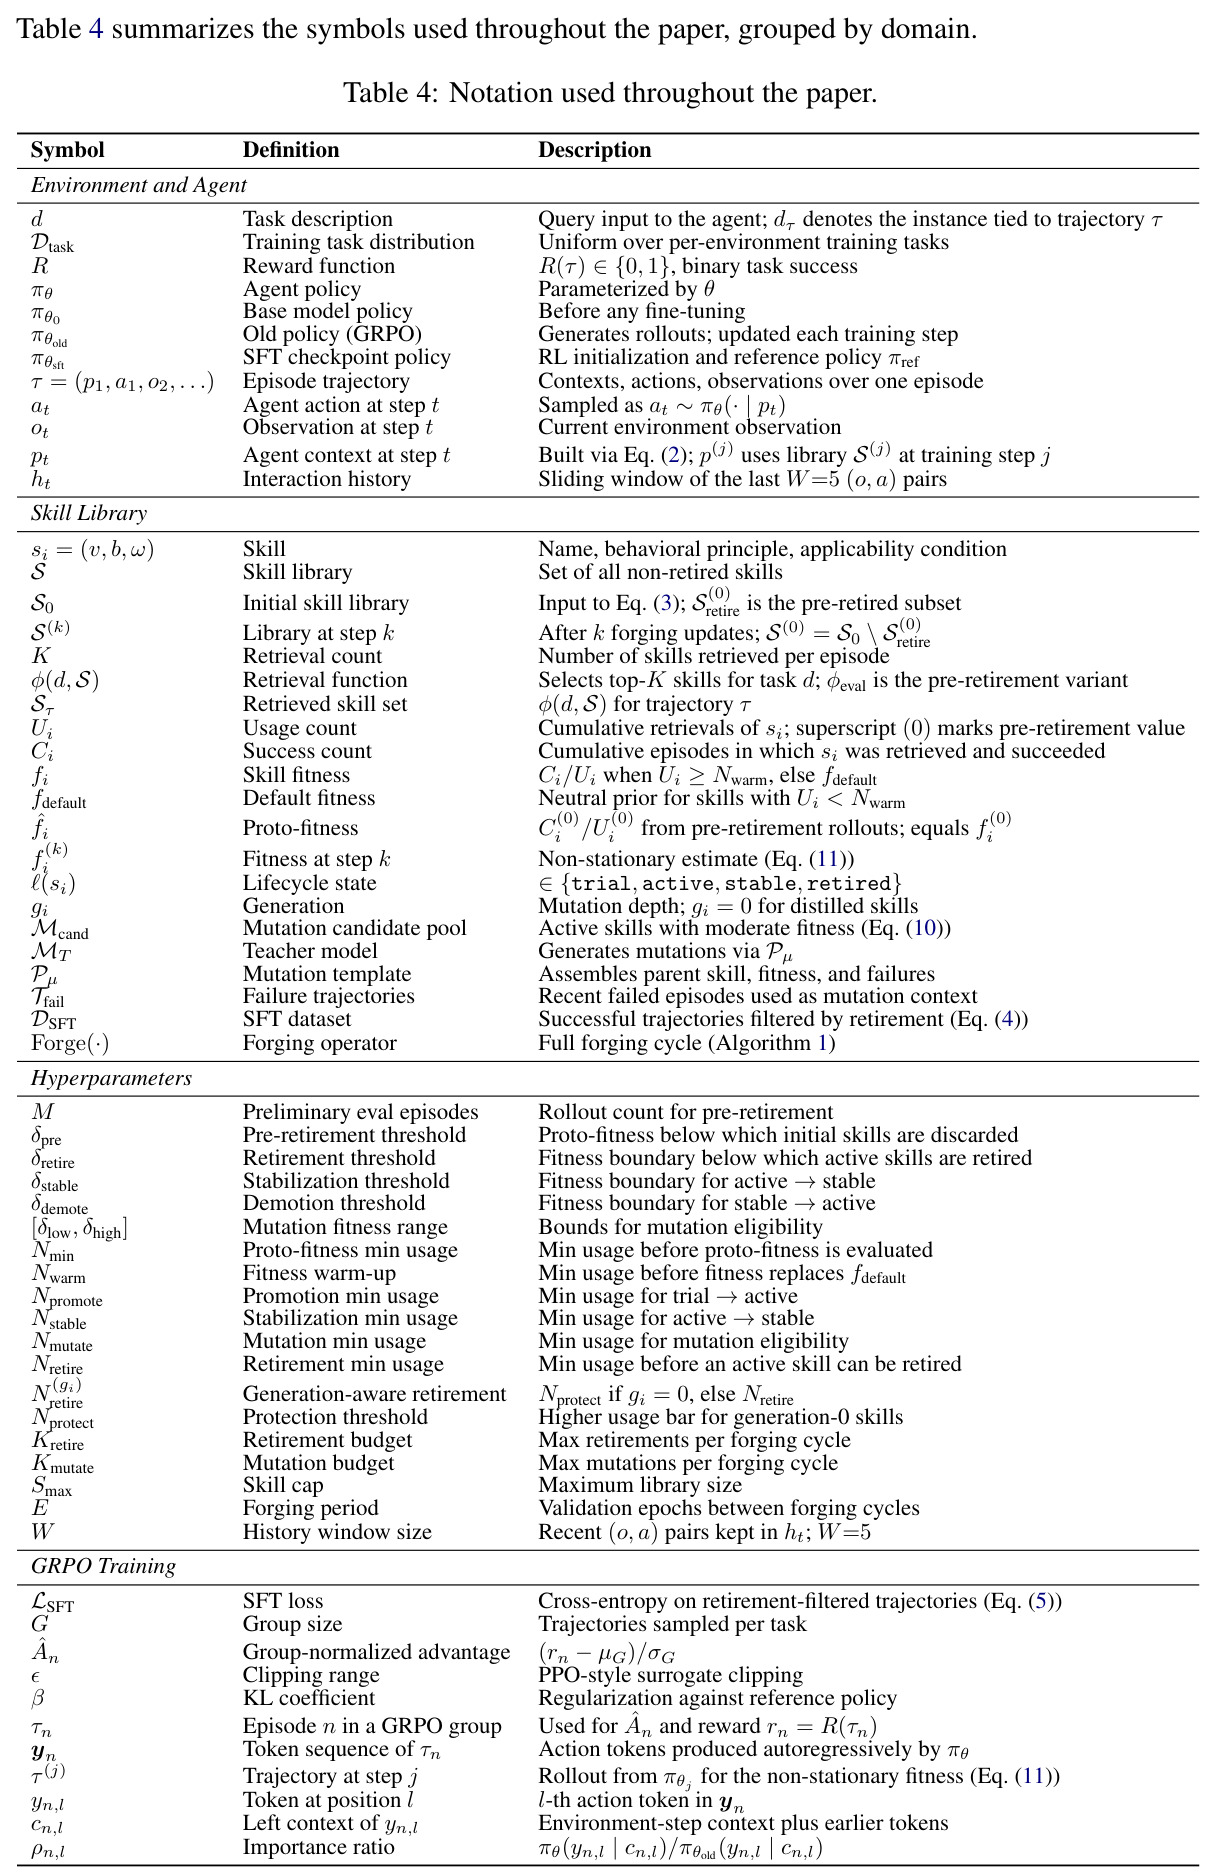
一种无需独立价值函数网络的 RL 算法:对每个任务从当前策略采样 $G$ 条轨迹,用组内奖励的均值和标准差归一化得到优势 $\hat{A}_n = (r_n - \mu_G)/\sigma_G$,再通过带裁剪的重要性比 $\rho_{n,l}$ 与对参考策略的 KL 惩罚更新参数,适合稀疏二值奖励的智能体任务。
SkillForge 的 RL 阶段完全构建在 GRPO 之上,技能在每次 rollout 中被拼入上下文 $p_t$,理解策略更新与技能库如何耦合必须先懂 GRPO。
技能库(Skill Library)
技能是智能体的一种程序性记忆单元,形式化为三元组 $s = (v, b, \omega)$:名称、行为原则、适用条件。检索函数 $\phi(d, \mathcal{S})$ 按任务类型的条件匹配取出 top-K 条技能,拼接到智能体上下文中按需注入。技能库可从历史轨迹蒸馏或自主发现而来。
本文的研究对象就是技能库的质量管理:库中条目的优劣、数量与更新时机直接决定检索增强的效果。
技能增强 RL(SkillRL)
把技能库与 GRPO 训练结合的代表方法:技能用 o3 从轨迹蒸馏,先做 SFT 冷启动得到 $\pi_{\theta}^{sft}$ 兼作 RL 初始化与参考策略 $\pi_{ref}$,训练中每次 rollout 都检索技能注入上下文。但它的库是只增不删的(append-only),条目一旦入库就永久存在。
SkillForge 的直接基线与出发点,其 append-only 缺陷正是本文要解决的延迟过时问题的来源。
技能适应度(Fitness)
衡量技能当前效用的运行时统计量:$f_i = C_i / U_i$,即技能 $s_i$ 被检索到的回合中任务成功的比例($U_i$ 为使用次数、$C_i$ 为成功次数);使用次数不足 $N_{warm}$ 时回退到中性先验 $f_{default}$。信用在回合级分配,同一回合检索到的全部技能共享二值奖励。
整个技能生命周期(晋升、稳定、降级、退役、变异选择)都由适应度与阈值 $\delta_{retire} < \delta_{demote} < \delta_{stable}$ 的比较驱动。
LLM 引导的进化优化
源自 population-based training 的 evaluate-select-mutate 模板:维护一个候选解种群,按适应度选择、用 LLM 作为变异算子重写生成新个体,如指令进化、quality-diversity 搜索等。传统用法针对静态文本产物在固定离线指标上离线迭代。
SkillForge 的变异算子借自这一脉络,但首次把它搬进在线 RL:被进化实体是动态注入上下文的技能,适应度随策略演化而非平稳。
研究动机
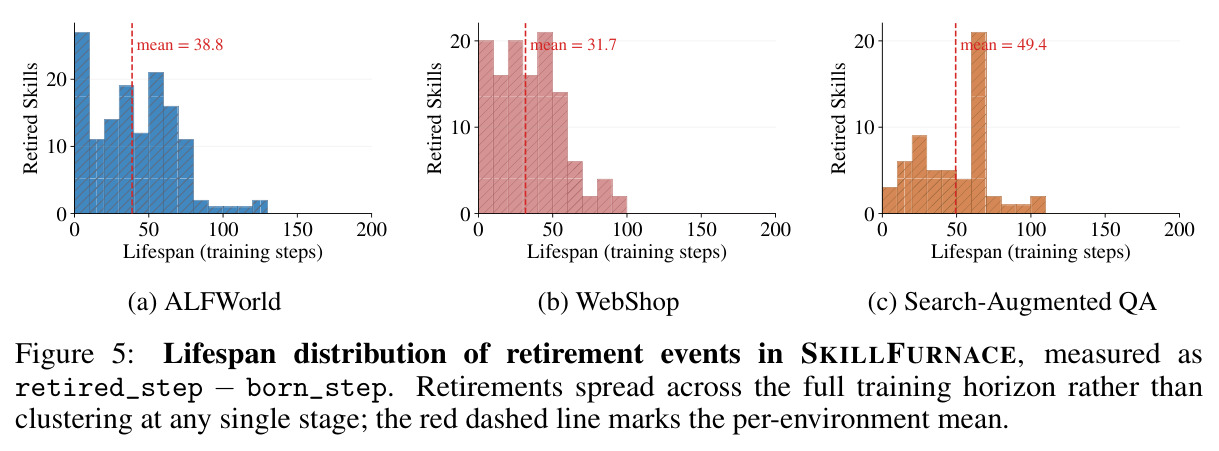
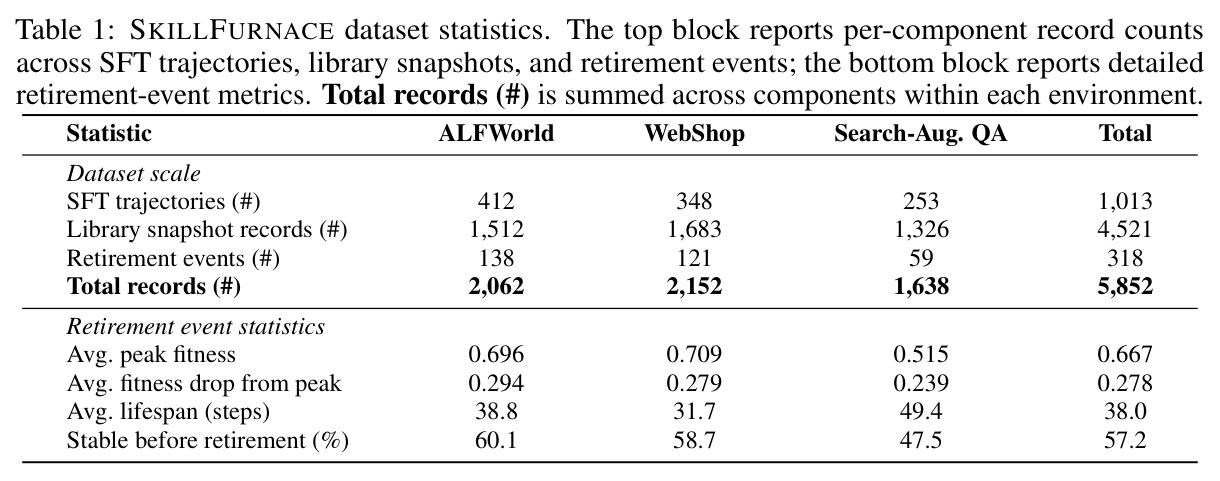
记忆增强强化学习提升了 LLM 智能体解决长程任务的能力,技能是其中一种记忆形式,把指令与适用条件配对、按需检索进上下文。但现有技能增强方法(如 SkillRL)把技能库当作只增不减的仓库:随着策略变强,检索 top-k 返回的上下文越来越嘈杂,过时技能挤占高质量技能的检索位置,许多条目已不匹配智能体当前能力。Li et al. (2026a) 实证确认:即使人工筛选的库中也含伤害性能的技能,且库越大收益递减。最隐蔽的失败模式是作者命名的延迟过时(delayed obsolescence):一个技能曾达到稳定态、但随着策略成熟其适应度跌破退役阈值,从助力变成干扰。作者用 SKILLFURNACE 数据量化了该现象:退役技能平均峰值适应度 0.67、紧贴稳定阈值 $\delta_{stable}=0.7$,到退役时平均下跌 0.28,且 57.2% 的退役技能曾先到达稳定态——先证明有用、后证明有害,append-only 机制对此无能为力。
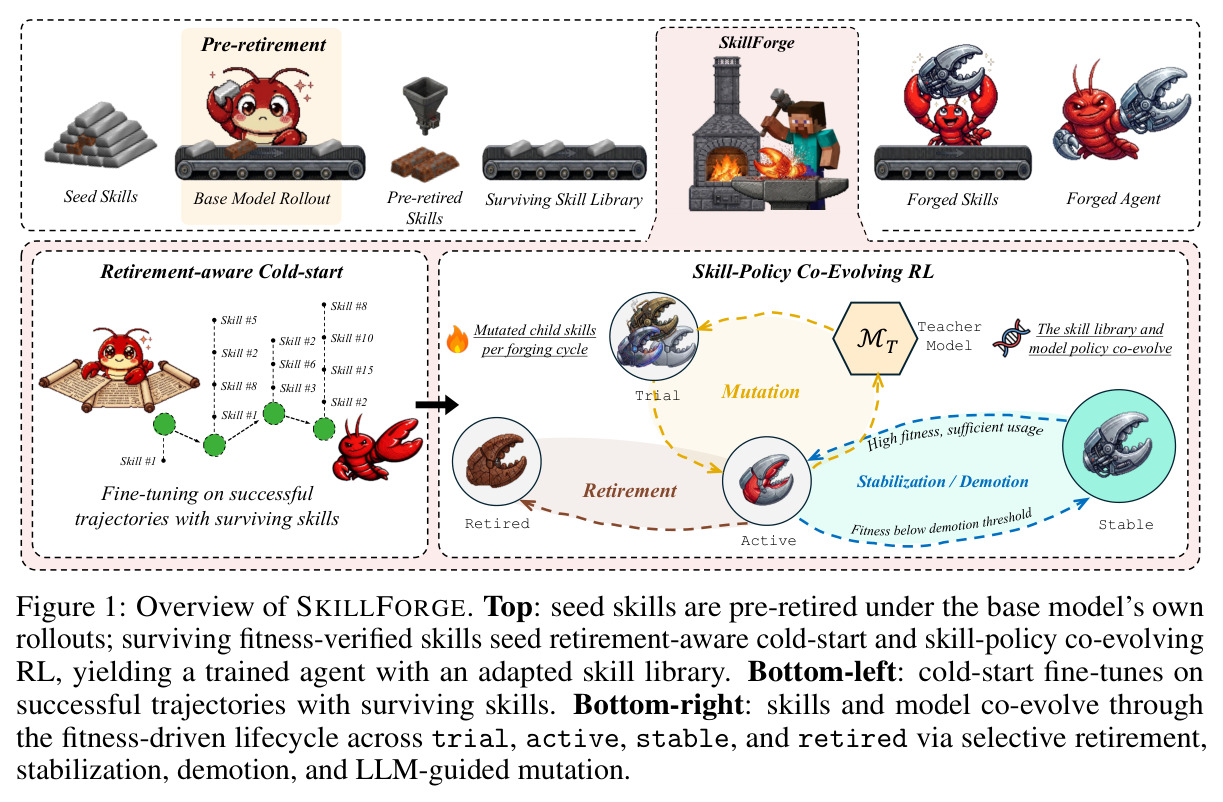
本文的目标是本文的目标是把技能库管理从被动累积改造为主动锻造(forging):让技能与模型在整个训练过程中协同进化。具体来说,提出 SKILLFORGE——一个带适应度驱动技能生命周期(trial、active、stable、retired 四态流转)的 agentic RL 方法。流程上分三步:先利用基座模型自己的 rollout 在 RL 之前预退役低适应度种子技能,得到经适应度验证的精简库;用它筛选的成功轨迹做退役感知冷启动 SFT;再切换到 RL,每个迭代周期执行选择性退役、稳定化与 LLM 引导变异,使活跃技能集始终保持紧凑并与策略当前能力对齐。量化目标是在 ALFWorld、WebShop、Search-Augmented QA 三个交互式基准上全面超越最强记忆增强 RL 基线 SkillRL(最高相对提升 7.8%),同时把库规模约束在 $S_{max}$ 内,并发布 5k+ 条标注记录的 SKILLFURNACE 数据集支持技能质量与生命周期管理研究。
与已有工作不同的是,两条已有技术路线各自留有缺口。技能库与经验记忆方法(ExpeL、MemP、SimpleMem、SkillRL 等)把仓库视为单调集合:条目一旦加入便持久存在,无法随策略演化被纠正,导致上下文被低质量技能污染、规模无界膨胀。LLM 引导的进化优化(population-based training、指令进化、quality-diversity 搜索)虽有完整的评估-选择-变异闭环,但优化的都是静态文本产物,对照固定的留出指标在离线循环中迭代。SkillForge 的独特切入是把适应度选择与变异真正搬进在线 agentic RL:被进化的实体是训练中实时注入智能体上下文的技能,技能适应度因此天然非平稳——式 (11) 把它形式化为依赖策略轨迹 $\pi_{\theta_j}$ 的运行时统计量。非平稳性意味着技能价值会随训练漂移,这正是必须设计带迟滞的完整生命周期、而非简单阈值删除的根本原因。
核心方法
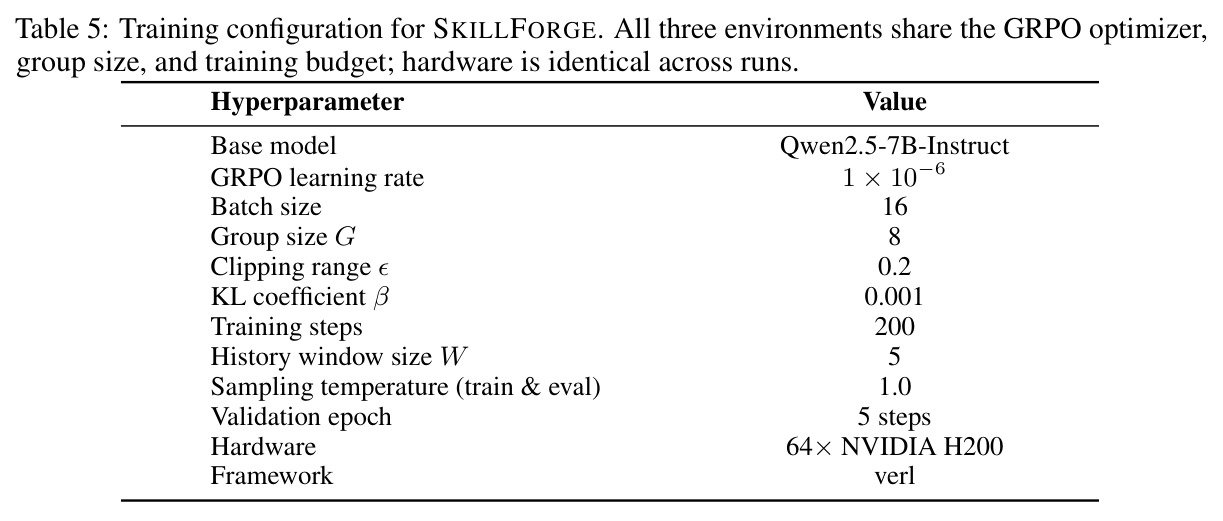
直觉上,技能像一个种群,策略变强会持续改变对技能的选择压力,库必须像育种一样被持续评估、选择和改造,而非无限囤积。方法分三阶段。第一阶段预退役评估:用基座模型 $\pi_{\theta_0}$ 带种子库做 $M$ 次 rollout,proto-fitness $\hat{f}_i = C_i^{(0)}/U_i^{(0)}$ 低于保守阈值 $\delta_{pre}$ 且使用至少 $N_{min}$ 次的技能被淘汰(式 3)。第二阶段退役感知冷启动:只用不依赖被退役技能的成功轨迹构造 $\mathcal{D}_{SFT}$(式 4),交叉熵微调(式 5)得 $\pi_{\theta}^{sft}$,兼作 RL 初始化与参考策略 $\pi_{ref}$。第三阶段协同进化 RL:以 GRPO 为优化器,每隔 $E=10$ 步运行一次锻造周期,按适应度推动技能在 trial、active、stable、retired 四态间流转,并对中等适应度技能执行 LLM 引导变异,策略与库交替更新(式 12)。实验基于 verl 框架,基座 Qwen2.5-7B-Instruct,训练 200 步。
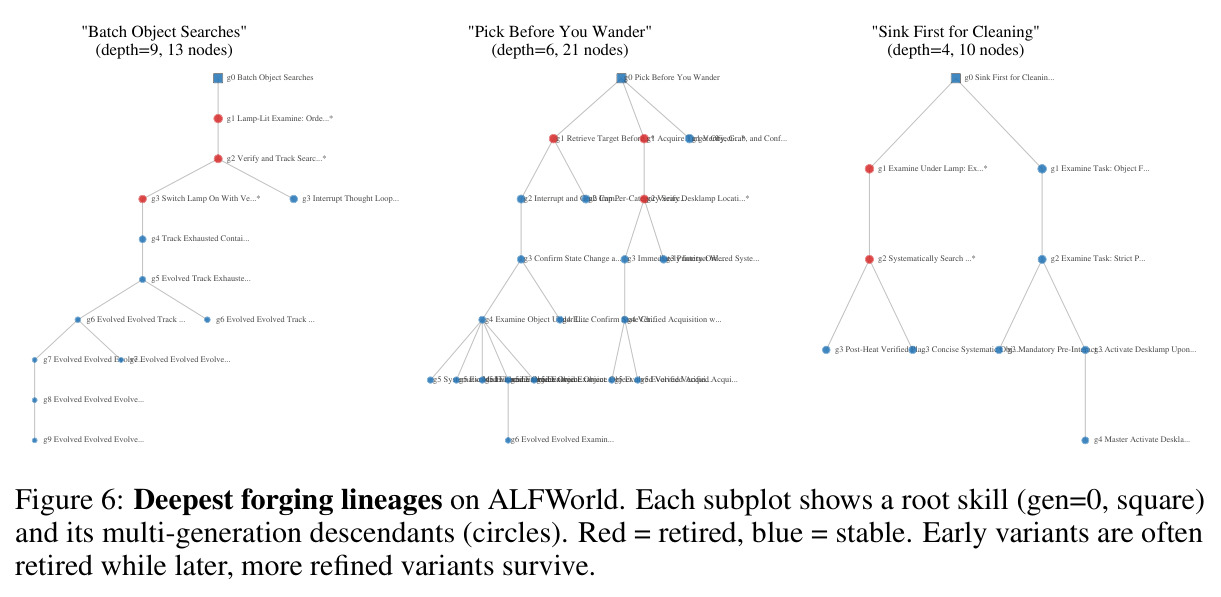
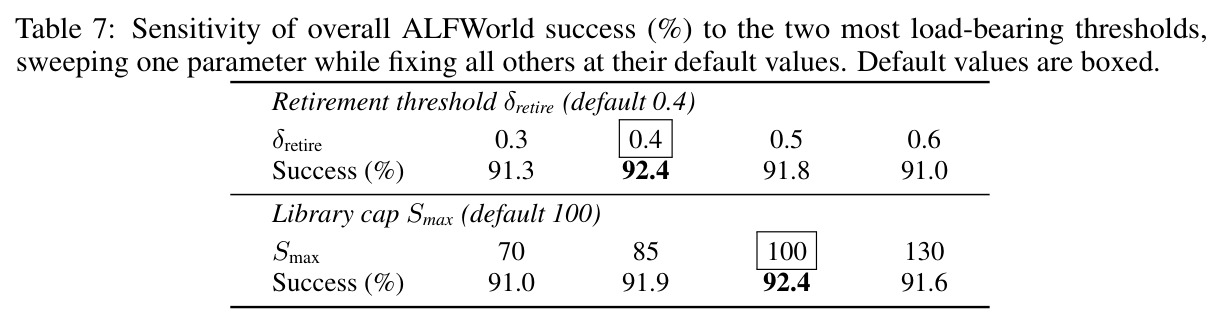
核心创新是把技能库视为受适应度选择支配的动态种群,用完整生命周期取代 append-only 累积。生命周期由阈值 $\delta_{retire} < \delta_{demote} < \delta_{stable}$ 构成迟滞:stable 技能适应度下滑必须先降级到 active 才有资格退役,防止瞬态波动误杀;配合两道闸门——trial 新技能须积累 $N_{promote}$ 次使用才能转正,且只有 active 可被退役,避免新生儿过早死亡。退役门槛按代数区分(式 8):蒸馏技能($g_i=0$)需更高使用门槛 $N_{protect}$,变异后代用常规门槛。变异只作用于适应度落在 $[\delta_{low}, \delta_{high}]$ 且使用达标的 active 技能,按逆适应度加权 $P(s_i) \propto 1 - f_i$ 选父本,把父技能内容、适应度统计与失败轨迹打包成模板交教师模型生成子技能;子技能以 trial 态进入、代数加一。库规模上限 $S_{max}$ 通过淘汰最低适应度 active 技能强制执行。延迟过时被形式化为存在 $k_1 < k_2$ 使 $f_i^{(k_1)} \ge \delta_{stable}$ 且 $f_i^{(k_2)} < \delta_{retire}$。
方法步骤详情
流程五步。第一步预退役(式 3):输入种子库 $\mathcal{S}_0$,基座模型 rollout $M$ 回合,淘汰 $\hat{f}_i < \delta_{pre}$ 且 $U_i^{(0)} \ge N_{min}$ 的技能,输出幸存库 $\mathcal{S}^{(0)}$。第二步构造 SFT 数据(式 4-5):保留成功轨迹的上下文-动作对 $(p_t, a_t)$、剔除依赖被退役技能的轨迹,交叉熵训练得 $\pi_{\theta}^{sft}$。第三步适应度跟踪(式 6-7):$f_i = C_i/U_i$($U_i \ge N_{warm}$ 时,否则取 $f_{default}$);回合计信用——回合检索到的全部技能共享二值奖励;计数器从预评估继承。第四步锻造周期(Algorithm 1,每 $E=10$ 步):晋升 trial→active、降级 stable→active、按最低适应度退役至多 $K_{retire}=3$ 个、稳定化达标者、从变异池逆适应度加权选至多 $K_{mutate}=5$ 个父本交教师模型变异,子技能以 trial 入库、代数加一;若超 $S_{max}$ 则淘汰最低适应度 active 技能。第五步训练整合(式 11-12):策略以当前库为条件做 GRPO 更新,库由 Forge 算子更新,交替协同进化。变异教师选用异族 Kimi-K2.5。
技术新颖性
新颖性有三层。对象层面:首次在在线 agentic RL 内部对技能库执行 evaluate-select-mutate——以往进化优化处理的是离线静态文本与固定指标,这里技能在训练中实时进入上下文,适应度非平稳、由策略轨迹定义(式 11 中 $\tau^{(j)} \sim \pi_{\theta_j}$),on-policy 计数避免离线替代方案的 exposure bias。机制层面:四态生命周期加迟滞阈值,同时解决新技能过早死亡与成熟技能被瞬态噪声误杀这两个对立问题;代数感知退役门槛(式 8)区分蒸馏源技能与变异后代,属文献未见的设计;延迟过时从直觉升格为可检验的形式化定义。变异算子层面:教师特意选异族——用 Kimi-K2.5 训练 Qwen2.5-7B 策略,依据是 Li et al. (2026a) 报告自生成技能相对外部编写技能收益可忽略甚至为负;父本按逆适应度加权采样,偏向最有改进空间者又不集中于单一离群点,且变异模板包含失败轨迹 $\mathcal{T}_{fail}$,让重写有据可依。
实验结果
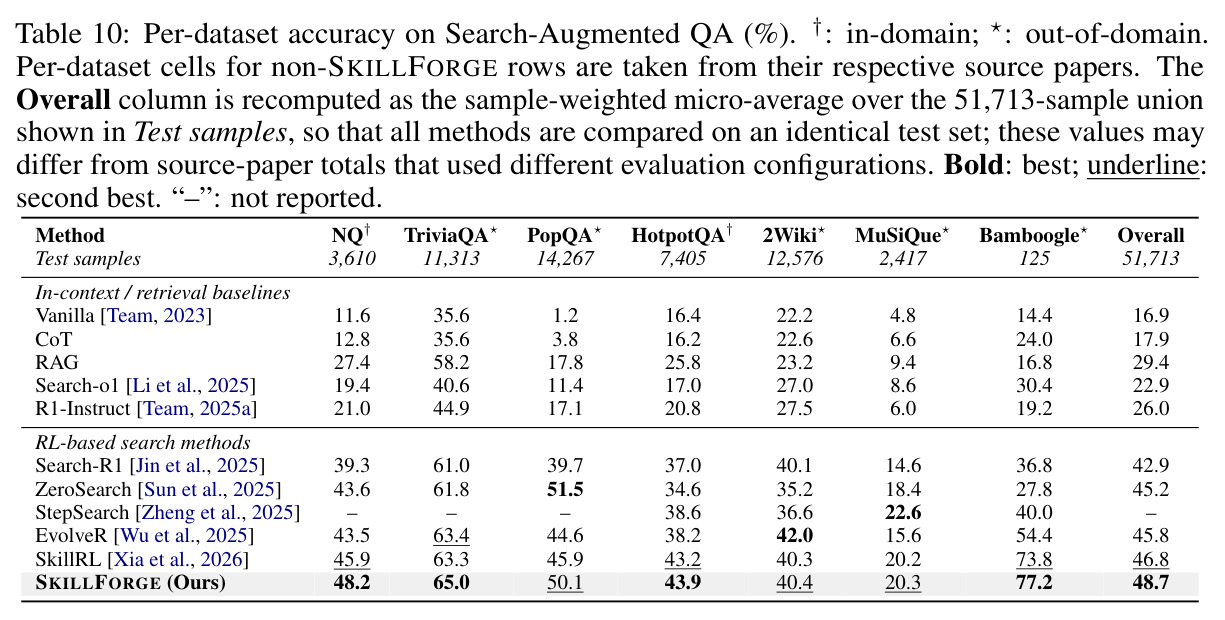
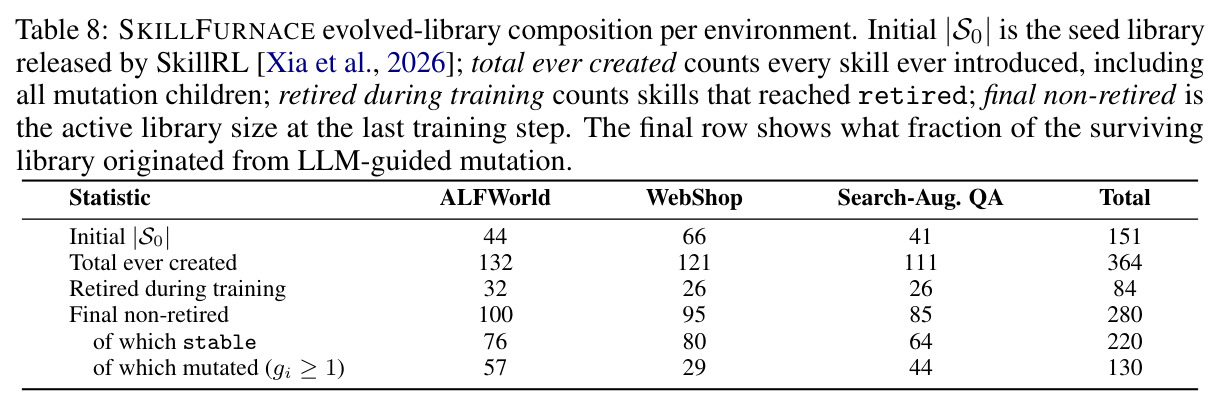
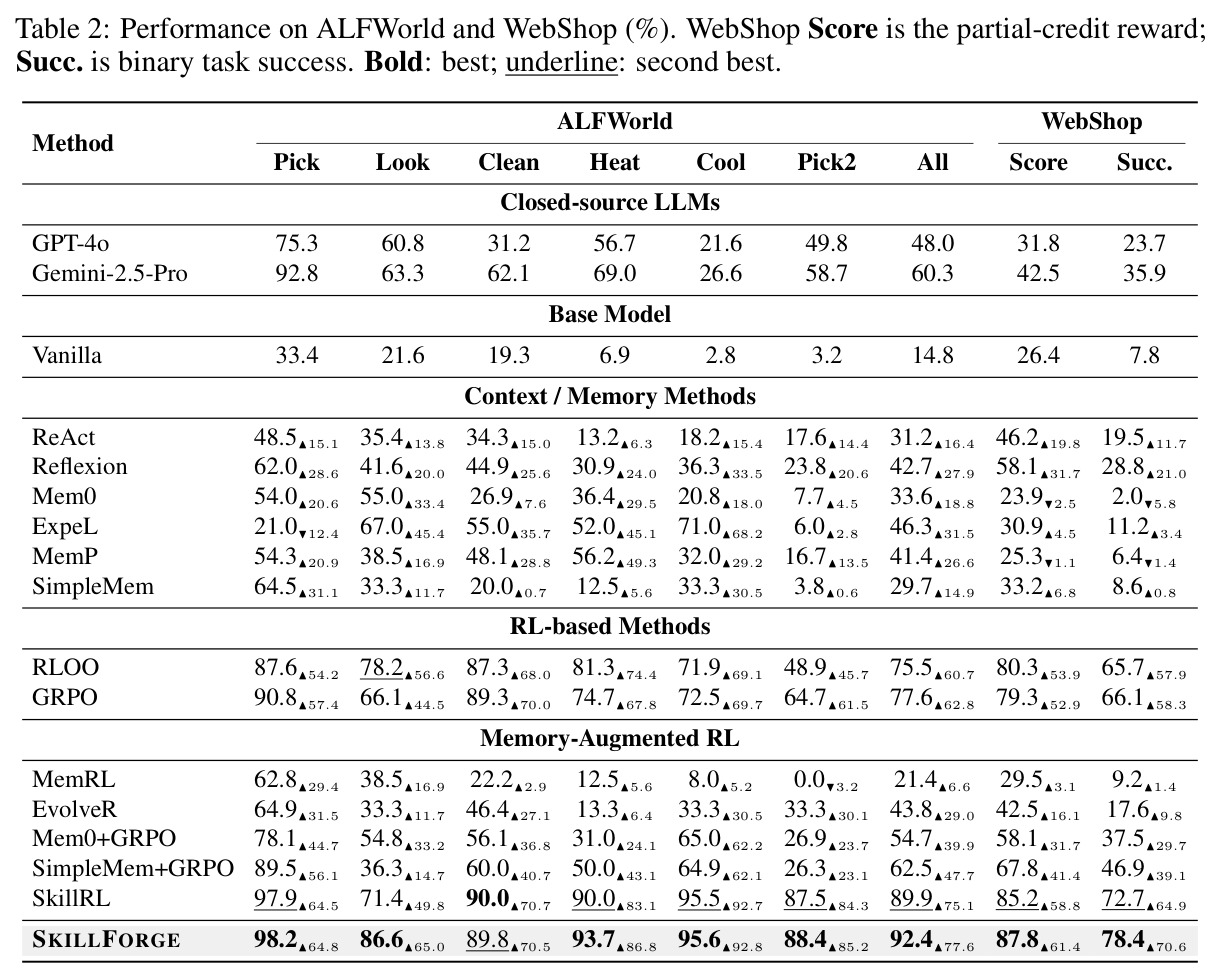
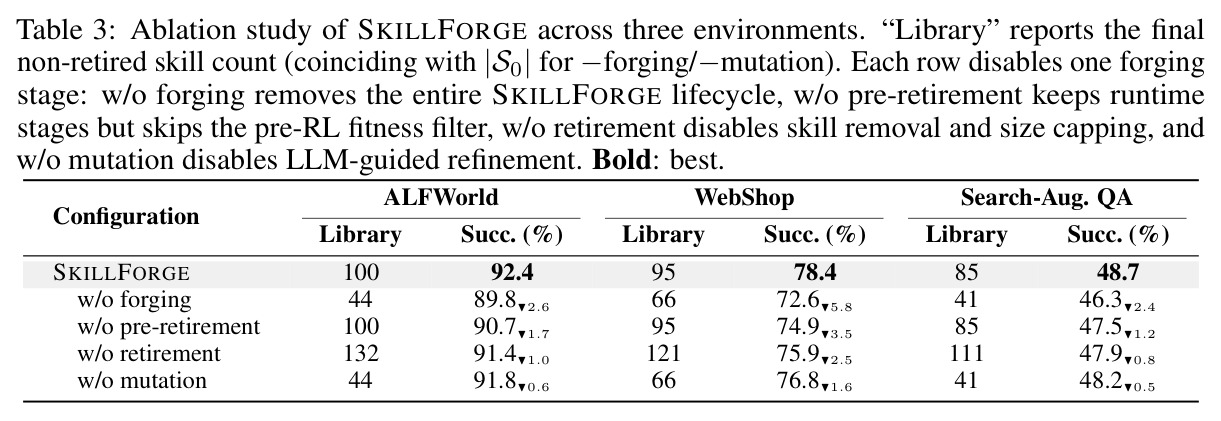
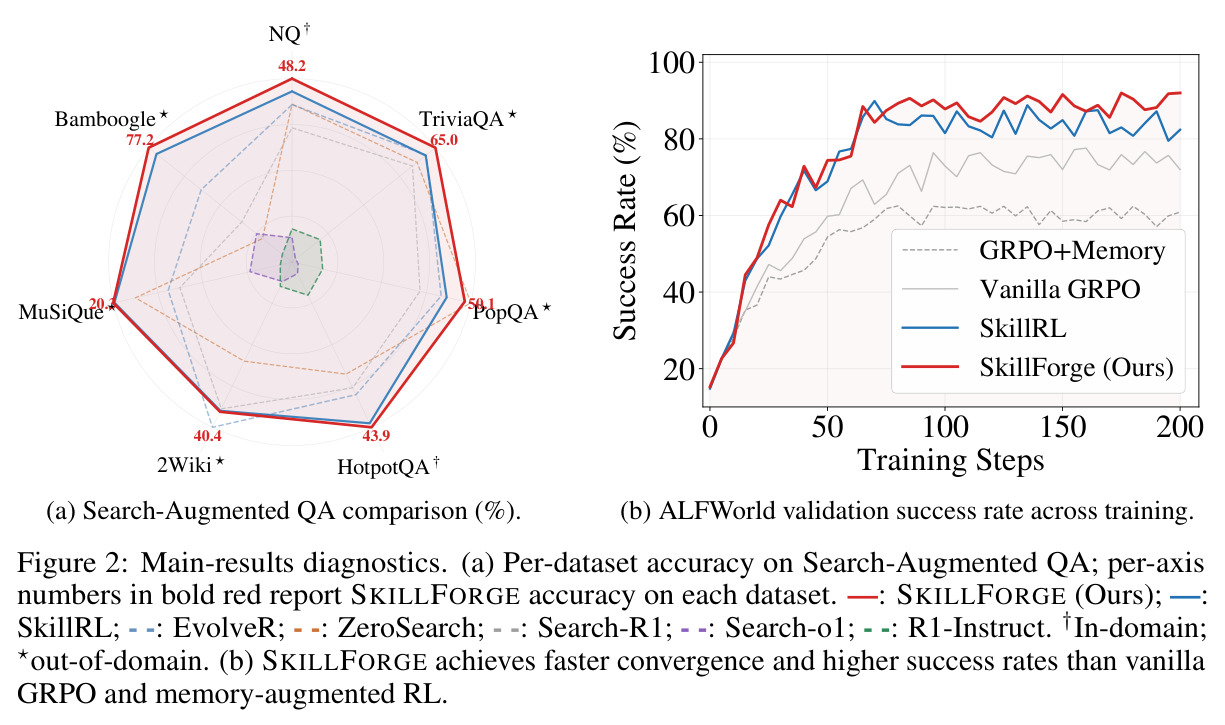
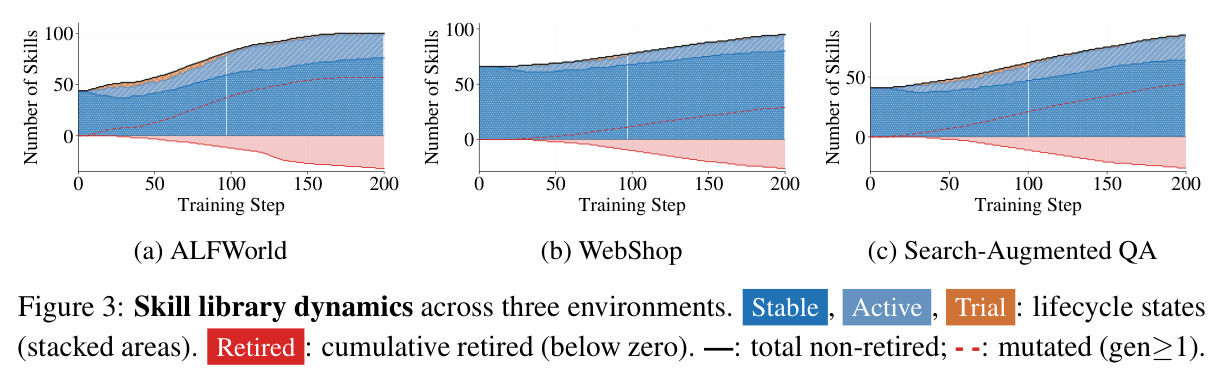
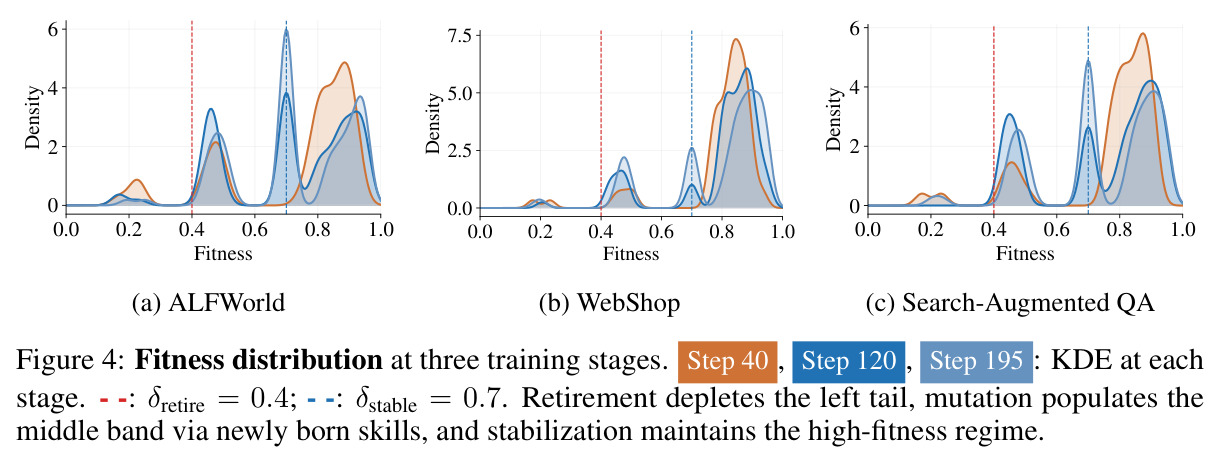
主实验(Table 2、Figure 2)全面领先。ALFWorld 成功率 92.4%,超 SkillRL 的 89.9%(相对 +2.8%),远超 GRPO 77.6%、GPT-4o 48.0%、Gemini-2.5-Pro 60.3%;Look 子任务相对提升最大(71.4%→86.6%,相对 21.3%),Clean 与 SkillRL 差距 0.2% 以内属噪声。WebShop 成功率 78.4% 对 72.7%,相对 +7.8% 为全文最大,Score 87.8 对 85.2。Search-Augmented QA 微平均 48.7%±0.3%,在含 Search-R1、ZeroSearch 等专门搜索 RL 方法中居首。训练曲线(Figure 2b):step 50-65 两者同从约 60% 升至约 70%,step 75 后锻造生效,SkillForge 达约 90%,SkillRL 在 80-88% 震荡。消融(Table 3):去掉锻造 WebShop 相对降 7.4%;预退役影响最大(-1.8%/-4.5%/-2.5%);去掉退役库膨胀到 132 个反而降至 91.4%,证明质量而非规模驱动收益。动力学(Figure 3-4):ALFWorld 新建 132、退役 32、终态 100 个(76 stable),step 170 后触顶平衡;低适应度尾部从 7.5% 缩至 2.0%,中间带 18.9%→22.0%,平均适应度约 0.73。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld(具身家居任务) | 总成功率(%) | 92.4 | SkillRL 89.9(次优);GRPO 77.6;GPT-4o 48.0 | 相对 SkillRL +2.8%,Look 子任务相对提升 21.3% |
| WebShop(网页购物导航) | 成功率(%)/Score | 78.4 / 87.8 | SkillRL 72.7 / 85.2;GRPO 66.1 / 79.3 | 成功率相对 +7.8%(全文最大相对提升),Score +2.6 |
| Search-Augmented QA(7 个问答数据集) | 微平均准确率(%) | 48.7±0.3 | 所有对比方法中最强的搜索 RL 基线(Search-R1、ZeroSearch、StepSearch 等) | 全部方法中最高 |
| 消融:去除完整锻造生命周期(WebShop) | 成功率(%) | 78.4(完整版) | w/o forging 72.6;w/o pre-retirement 74.9;w/o retirement 75.9(库 121 个);w/o mutation 76.8(库 66 个) | 完整版相对 w/o forging +7.4%,单组件下降之和大于联合下降,呈亚可加交互 |
局限与改进
作者承认的局限:消融中单组件下降之和大于整体去除锻造的下降,说明三个组件间存在亚可加交互,机制尚未完全解耦;ALFWorld 的 Clean 子任务与 SkillRL 差距在 0.2% 以内,并非所有子任务都改善;文中未系统报告多随机种子的方差(仅 Search QA 给 ±0.3%)。我观察到的额外局限:其一,回合级信用分配粗糙——同一回合检索到的全部 $K$ 个技能共享同一二值奖励,好技能可能被同伴拖累而误退役,坏技能可能搭成功便车而错误稳定;其二,变异质量完全依赖外部教师模型 Kimi-K2.5,引入推理成本与对另一前沿模型的依赖,若教师能力不足变异收益会塌缩;其三,奖励为二值任务成功,方法与可验证奖励场景强绑定,主观或稀疏奖励任务未验证;其四,超参数族群庞大($\delta$ 家族、$N$ 家族、$K$、$S_{max}$、$E$),附录 B 虽给出数值但缺乏跨环境迁移准则;其五,仅验证 Qwen2.5-7B 一个规模与三个基准,规模扩展性未探。
独立分析的弱点
弱点一:回合级信用分配噪声大。技能 $s_i$ 的成功计数在回合级累加,同一回合检索的全部技能共享奖励,好技能可能被同伴拖累误退役,坏技能可能搭便车被错误稳定。改进:引入反事实估计(遮蔽技能重 rollout 以成功率差作信用)或用过程奖励模型做步级打分。弱点二:变异无前置质量闸门,低质量子技能仅靠 trial 期 $N_{promote}$ 被动筛选,仍消耗检索位置与预算。改进:生成后先做一致性校验或教师自评过滤再入库。弱点三:退役是硬删除,bottom-$m$ 淘汰不可恢复,任务分布漂移后旧技能无法召回。改进:设冷冻库并定期低成本重评估,允许复活。弱点四:$S_{max}$ 触顶后直接删最低适应度 active 技能,规则武断且可能误删刚出生、尚无统计的技能。改进:按适应度置信下界排序淘汰,把容量压力并入生命周期。弱点五:适应度是宽置信区间的经验频率,低使用量时方差大,缺乏贝叶斯收缩或 UCB 处理。改进:用 Beta 先验平滑或按使用量动态调整阈值。
未来方向
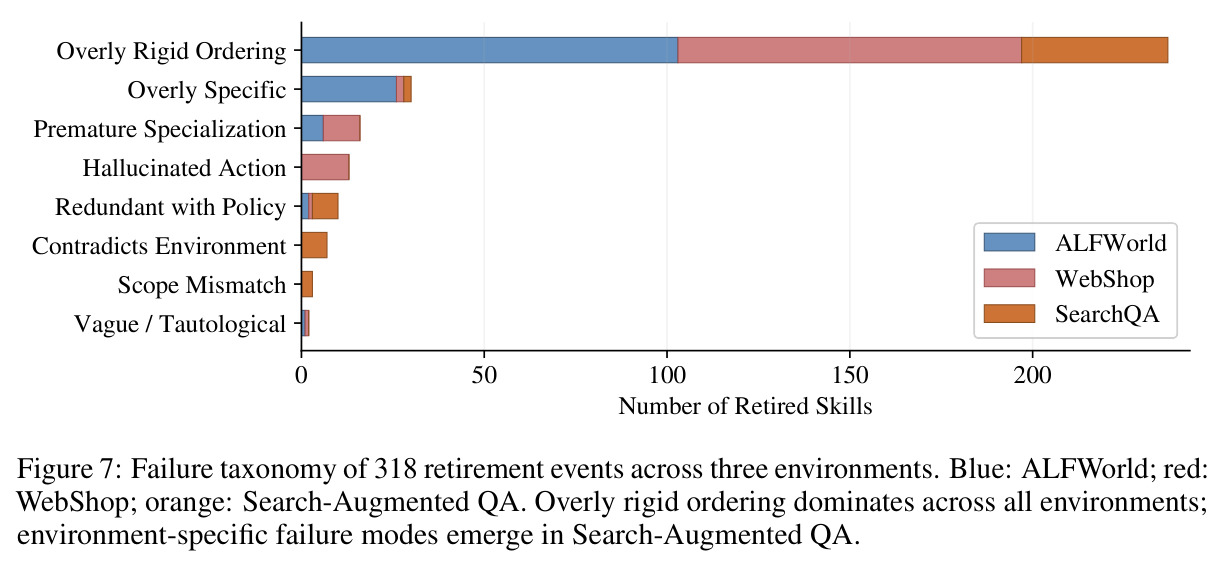
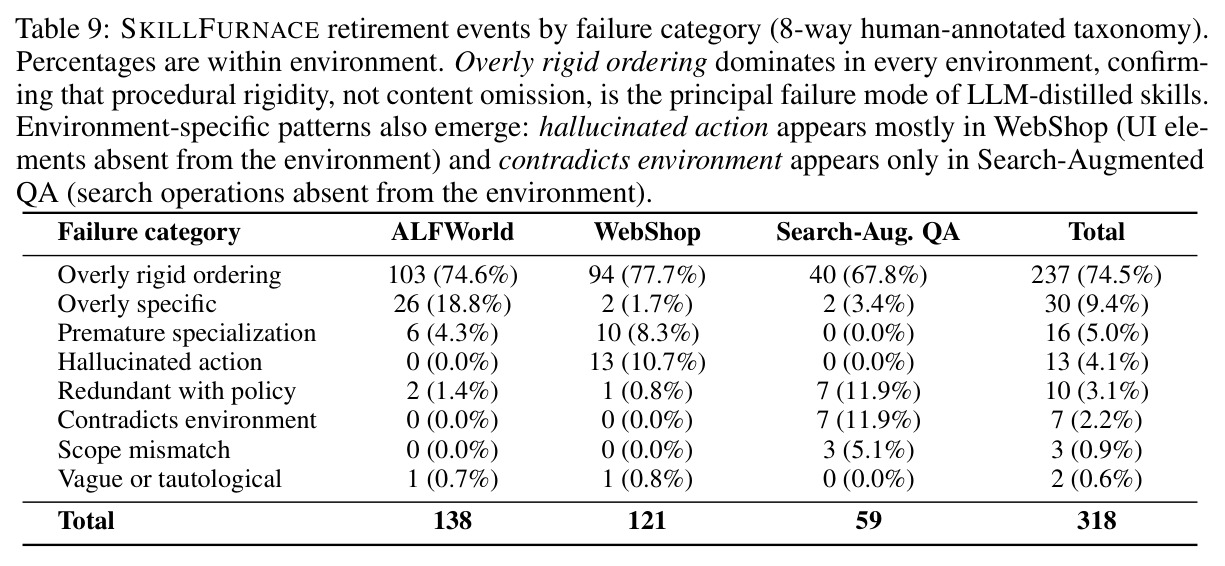
作者提出的方向:SKILLFURNACE 数据集(含带人类标注失败类别的退役事件)用于支撑技能质量与生命周期管理研究;数据表明程序刚性是技能失效的主导模式,可据此设计抗僵化的针对性变异算子。基于成果可延伸的方向:其一,跨环境技能迁移——当前每个环境独立锻造,可研究通用技能库与分布漂移下的适应度重估;其二,步级或反事实信用分配,提升生命周期决策的统计功效;其三,把延迟过时检测改造成在线变更点检测(如 CUSUM 检验),为退役决策给出统计显著性保证;其四,多智能体场景的技能共享与联邦锻造,多个智能体共同维护一个库并交叉验证适应度;其五,技能组合与层级化——从原子技能自动构建宏技能,研究变异在层级间的传播;其六,与过程奖励模型结合,摆脱二值回合奖励的限制,让技能信用更细粒度;其七,在真实生产级 agent 系统(如编码助手工作流)中检验技能生命周期管理的工程价值。
复现评估
复现条件总体较好。开源与数据:作者承诺发布 SKILLFURNACE 数据集,共 5,852 条标注记录——1,013 条 SFT 轨迹、4,521 条库快照、318 条带人类标注失败类别的退役事件,覆盖三环境;训练基于开源 verl 框架,基座 Qwen2.5-7B-Instruct 公开可得。超参完整:学习率 $1 \times 10^{-6}$、裁剪 $\epsilon=0.2$、KL 系数 $\beta=0.001$、组大小 $G=8$、温度 1.0、训练 200 步、每 10 步一个锻造周期、每周期 $K_{mutate}=5$、$K_{retire}=3$,完整锻造阈值与硬件细节在附录 B。主要障碍:变异教师为 Kimi-K2.5,需 API 权限与预算;预退役需基座模型 $M$ 次 rollout 的额外算力;三环境 RL 训练对个人成本不低,但 7B 规模尚可承受;方差报告有限(仅 Search QA 给 ±0.3%),精确复现表格数字或需多种子平均。总体难度中等偏高,需 RL 训练经验与非平凡算力,但无需自建环境或标注。
论文图表