AdSpark:面向以商品为中心的广告视频生成的大规模数据集与基准 AdSpark: A Large-Scale Dataset and Benchmark for Product-Centric Advertisement Video Generation
首个商品广告视频生成数据集与基准:30万条三元组、六维诊断评测体系
前置知识
参考图到视频生成(Reference-to-Video)
给定一张商品参考图和文本提示,模型生成一段视频,且视频中商品的外观(形状、颜色、Logo、包装文字、材质)必须与参考图保持一致。与普通图生视频不同,它强调“身份保持”——商品在跨帧、跨镜头时都不能变形、变色或漂移,通常通过参考图编码注入扩散模型的注意力层实现。
AdSpark 的核心任务 PC-AVG 就建立在这一范式上,评测中的 Product Fidelity 维度、对比的 18 个基线模型以及 LTX-AdSpark 微调实验全部围绕参考图条件生成展开。
视频扩散模型与 LoRA 微调
主流视频生成模型(如本文的基座 LTX-2)是基于扩散 Transformer 的生成模型,通过逐步去噪视频潜在表示来合成视频。LoRA 是低秩适配微调方法:冻结原模型权重,仅在注意力投影层(to_q、to_k、to_v)注入低秩分解矩阵,用极少量参数让基座学会新任务或新数据分布。
论文用 LoRA(rank 64)在 8 张 NVIDIA B200 上对 LTX-2 微调 30K 步得到 LTX-AdSpark,这是验证 AdSpark-300K 数据有效性的关键实验,不懂 LoRA 就无法理解其实验设置。
多镜头视频结构与镜头感知评测
广告视频由多个镜头(shot)通过剪辑组合而成,镜头间存在刻意转场。TransNetV2 等镜头边界检测网络可将视频切分为有序镜头序列;时序交并比 $tIoU(s_g^i, s_p^j) = |s_g^i \cap s_p^j| / |s_g^i \cup s_p^j|$ 用于把检测到的镜头与创作计划中的镜头做贪心匹配。若直接对整段多镜头视频算时序指标,会把设计好的转场误判为时间伪影。
AdSpark-Bench 的核心设计是“镜头感知评测”:先切分、再按 tIoU 匹配、最后逐镜头打分,论文六大维度中的结构对齐、执行对齐、跨镜头一致性、转场自然度都依赖这套协议。
嵌入相似度与文字对齐指标
用预训练编码器把图像/文本/音频映射为向量,用余弦相似度衡量语义一致性:DINOv3 特征衡量商品外观一致性,LAION-CLAP 衡量背景音与文字描述的一致性,gme-Qwen2-VL 衡量视频-提示词全局对齐;文字层面则用 RapidOCR 识别加 Levenshtein 编辑距离 $S_{text} = 1 - d_{edit}(y, \hat{y})/|y|$ 衡量包装文字是否可辨识。
Product Fidelity、Audio Alignment、GmeScore 等评测维度全部由这些指标构成,是读懂 Table 3 数字含义的前提。
VLM 数据构建与 LLM-as-Judge
用 Qwen3-VL-235B、GPT-5.5 等多模态大模型对视频做质量过滤、结构化标注和广告创意规划,再用另一个大模型(Gemini-3.1-Pro-Preview)作为独立评审迭代修订,最后由人工抽检兜底。评测侧则让 LLM 扮演“潜在顾客”对吸引力、创意、叙事连贯打 Likert 分。
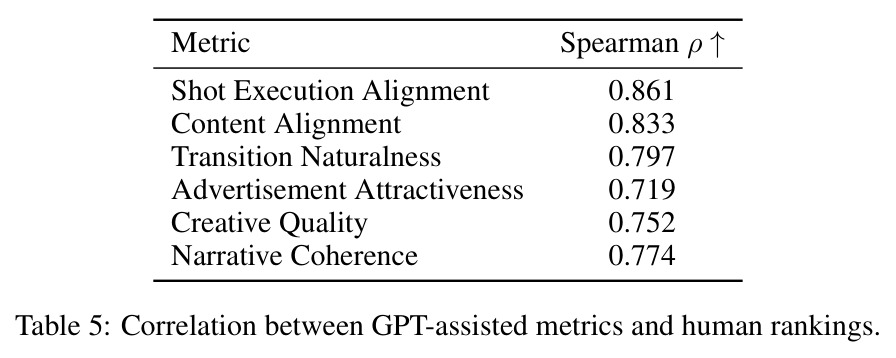
AdSpark-300K 的 20 万条合成数据完全由这条“规划-评审-生成-质检”流水线产出,AdSpark-Bench 的多个维度也依赖 GPT-5.5 打分(与人类排序的 Spearman 相关达 0.719–0.861),理解这一点才能评估数据的可靠性与评测的公信力。
研究动机
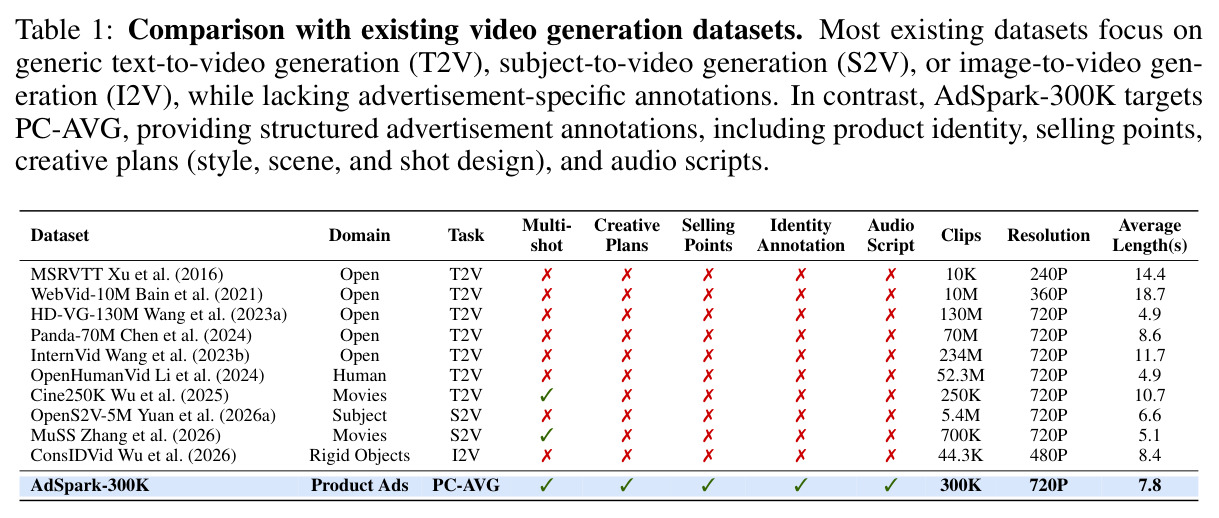
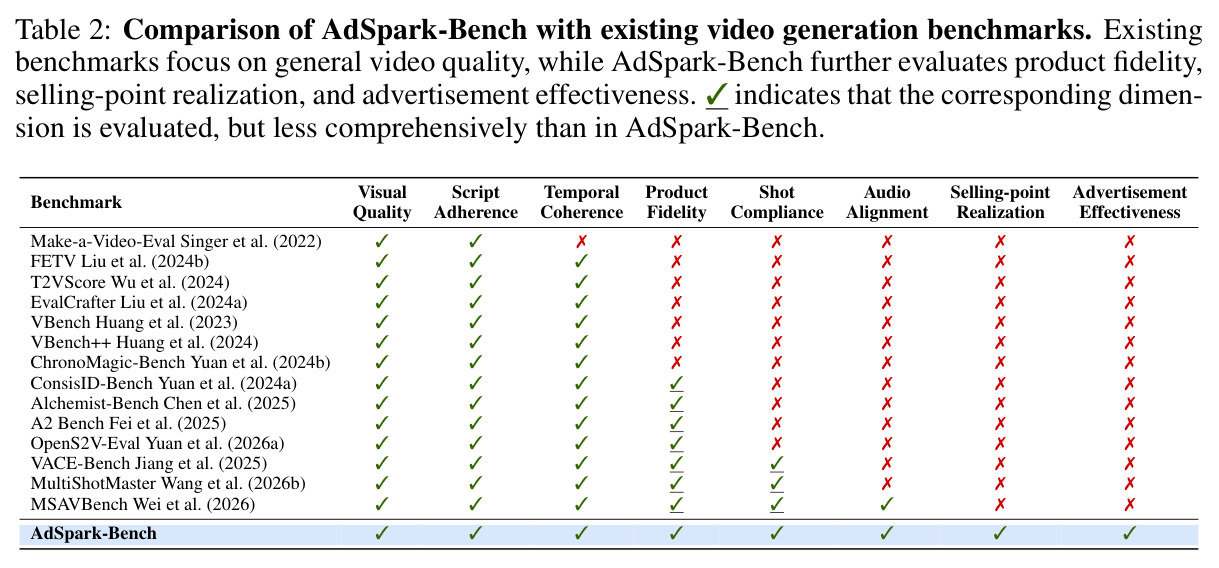
广告视频是电商和短视频平台的核心营销资产,传统制作依赖专业设计与拍摄,费时费钱。现有视频生成模型(Sora 类文生视频、各类主体一致性模型)主要面向通用视觉内容,追求视觉质量、语义对齐和时间连贯,但商品广告视频有两条额外硬约束:一是精细保持商品身份——Logo、包装文字、配色材质在复杂运动(手部交互、特写、运镜)中不能模糊、畸变或漂移;二是通过连贯的多镜头叙事把卖点“演出来”,还要配合旁白与音效。当前模型在这两方面都表现很差。更根本的瓶颈是数据与评测双重缺失:数据侧,WebVid-10M(1000 万条、360P)、Panda-70M、InternVid(2.34 亿条)等开放域数据集只有粗粒度视频-文本对,没有商品身份、卖点、创意分镜、音频脚本等广告特有标注;Cine250K、MuSS 等多镜头数据集面向电影叙事而非商业广告。评测侧,VBench++、OpenS2V-Eval 等基准覆盖视觉质量与主体一致性,却没有一个评估卖点呈现和广告效果。Table 1 显示,没有任何已有数据集同时具备多镜头、创意计划、卖点、身份标注、音频脚本五项要素。
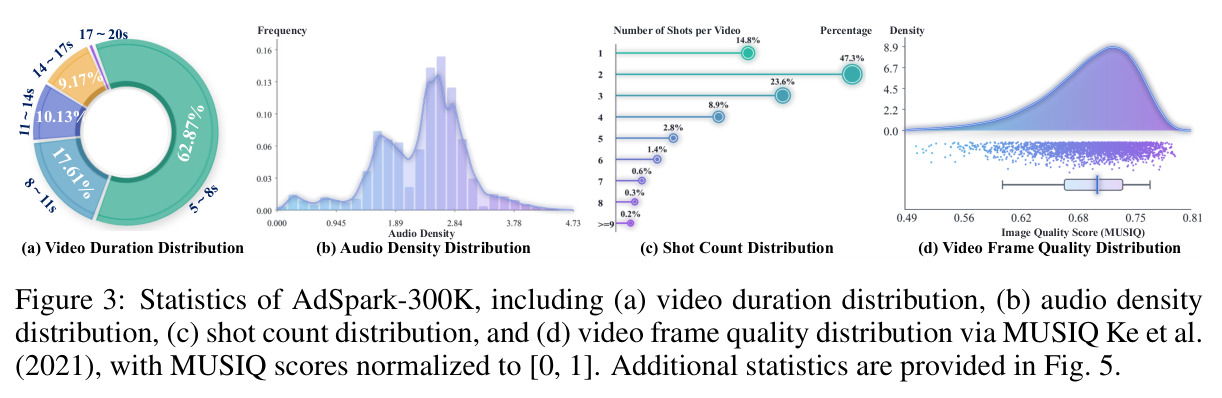
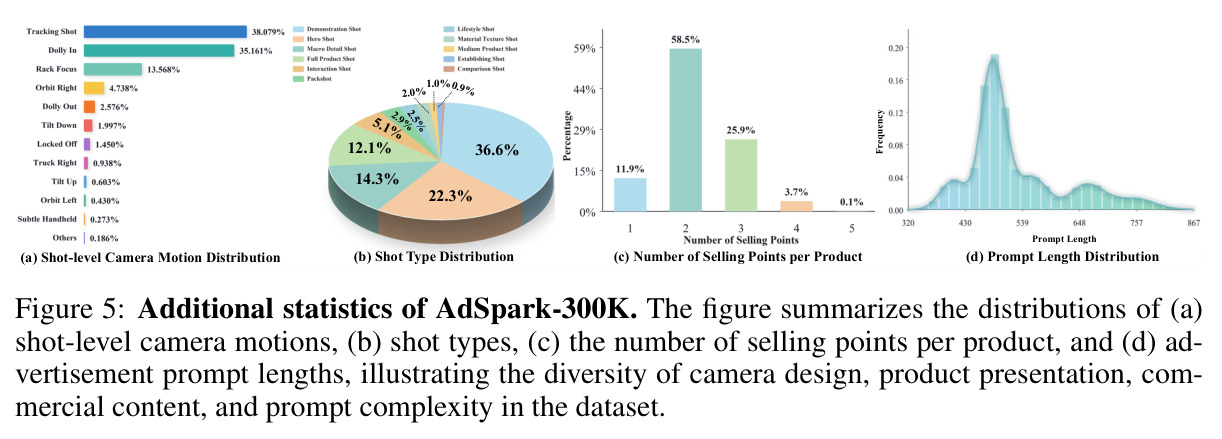
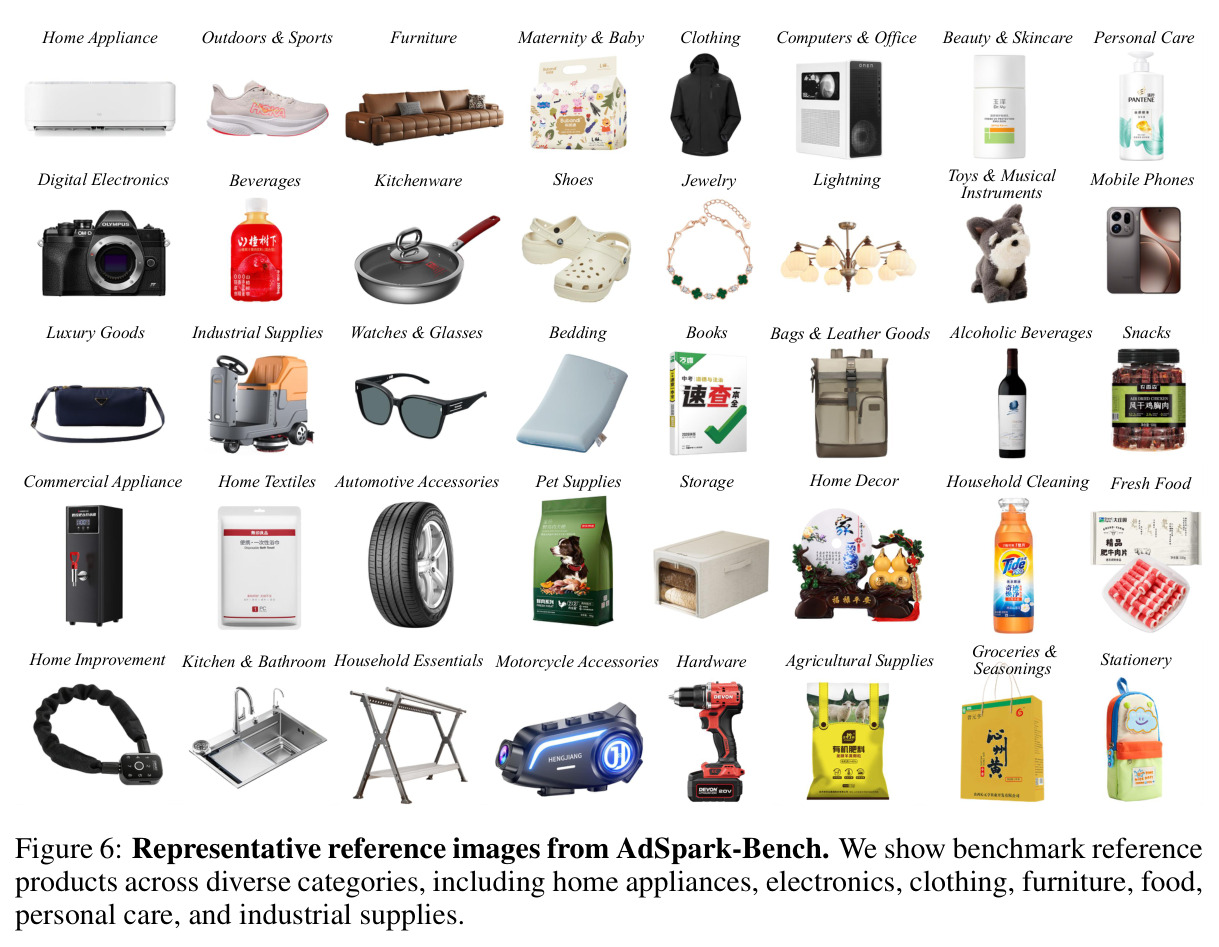
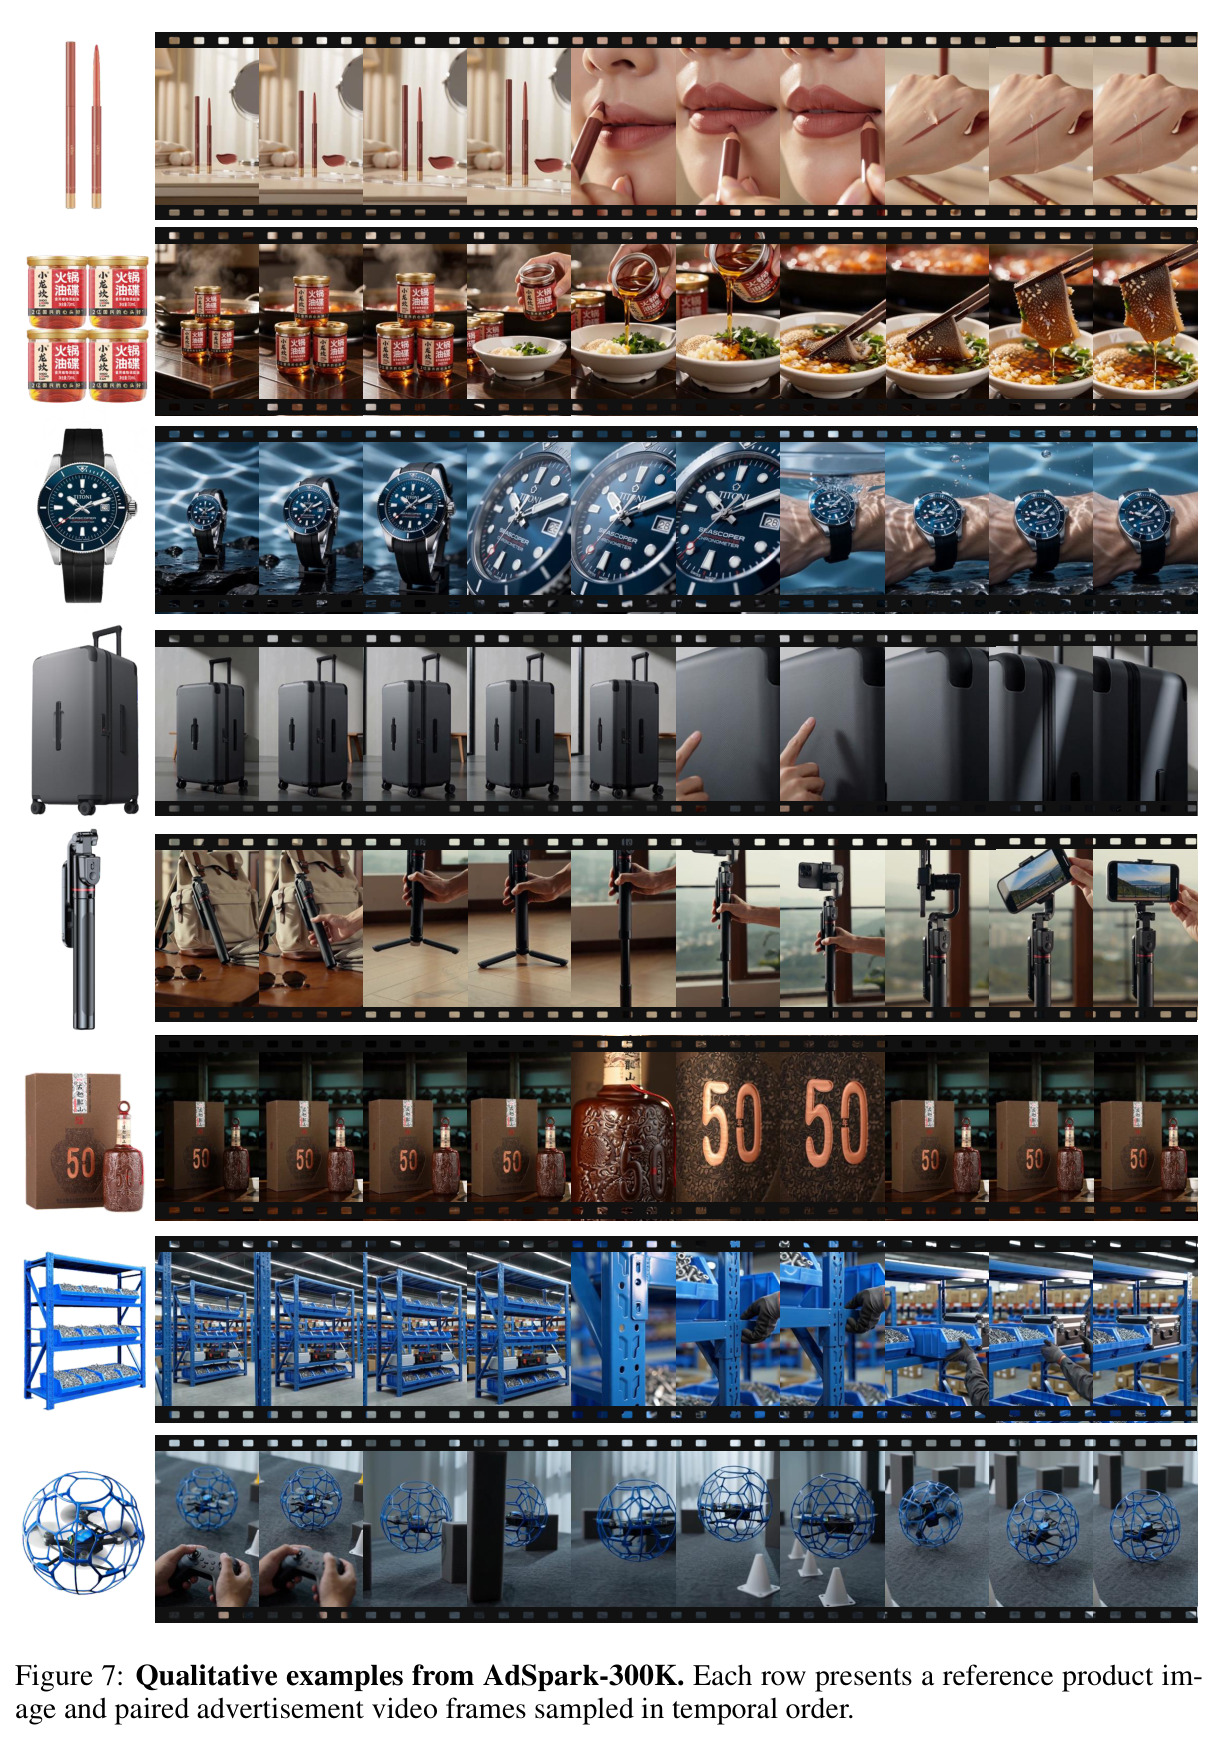
本文的目标是本文要为“以商品为中心的广告视频生成”(PC-AVG)这一新兴任务建立完整的基础设施,具体拆成三件事:其一,构建首个大规模 PC-AVG 数据集 AdSpark-300K,包含约 30 万条“参考图-提示词-视频”三元组(10 万条真实电商广告 + 20 万条合成广告),覆盖 40 个大类、3000+ 子类、总计 651 小时、720P 分辨率、平均时长 7.8 秒,每条样本带统一的结构化标注(商品身份、卖点、创意计划、对齐的音频脚本);其二,提出诊断型基准 AdSpark-Bench,包含 220 个与训练集 SKU 严格隔离的测试案例(45 个单镜头、131 个双镜头、44 个三镜头),从视觉质量、商品保真、指令遵循、时序连贯、音频对齐、广告效果六个维度系统评估模型;其三,用该数据集微调 LTX-2 得到 LTX-AdSpark,验证数据对广告生成能力的实际提升作用。
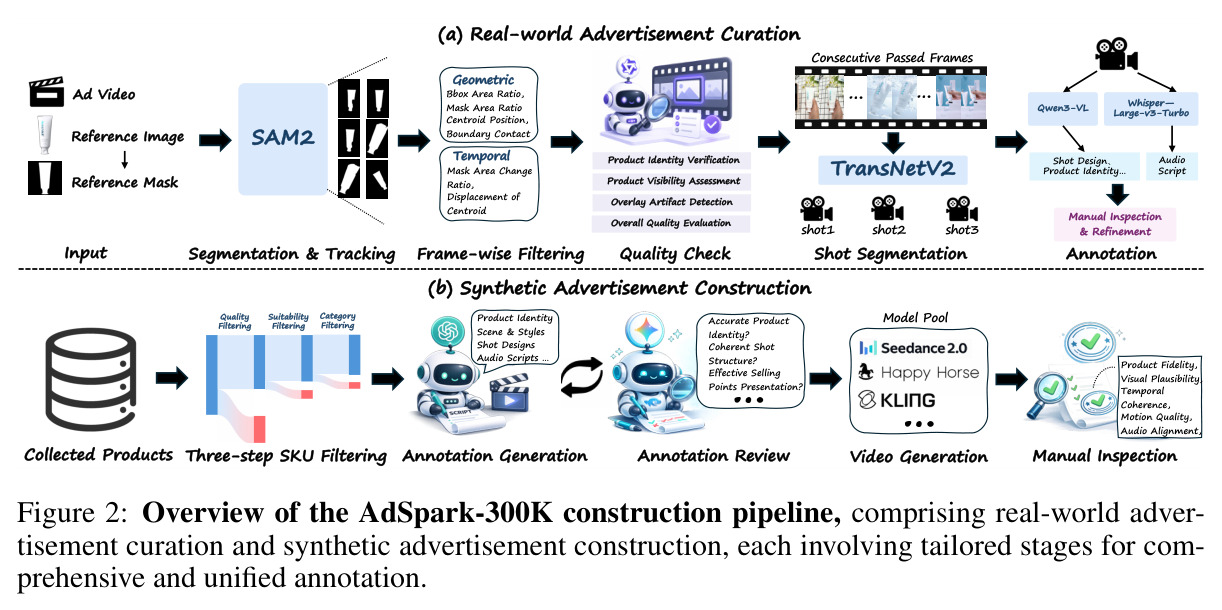
与已有工作不同的是,本文的独特切入有三点。第一,把“广告”当作一等公民而非普通视频:卖点不是一句文案,而被翻译成“可视觉化的动作 + 可验证的视觉成功标准”,创意计划细化到逐镜头的景别、运镜、时间区间和卖点索引,使商业意图变成可生成、可评测的结构化对象。第二,真实+合成双轨数据工厂:真实子集从电商平台约 60 万按点击量排名的 SKU 中授权获取,经 SAM2 追踪与 VLM 质检精筛;合成子集用 GPT-5.5 做广告规划、Gemini-3.1-Pro 做独立评审(至多 5 轮修订)、Seedance 2.0/HappyHorse/Kling 三个模型混合生成,规避单一模型偏置,最终人工五项质检。第三,评测协议创新:提出镜头感知评测(TransNetV2 切分 + tIoU 贪心匹配 + 逐镜头评分,且不使用真值边界以防泄漏),并把商品保真从整帧比较细化到关键区域(Logo、包装文字)与跨镜头切换稳定性,首次引入“广告效果”维度(吸引力、创意质量、叙事连贯),由 GPT-5.5 扮演潜在顾客打分。
核心方法
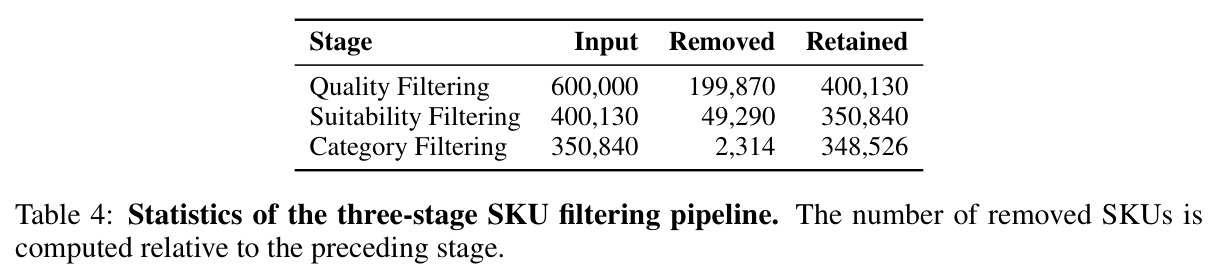
AdSpark 由数据集和基准两部分组成,整体思路是“先直觉后技术”:广告的本质是设计好的多镜头叙事,所以数据表示必须结构化、评测必须镜头感知。真实子集流水线:从平台按 2026 年 4 月 15 日点击统计选出约 60 万头部 SKU,筛出同时具备广告视频(10–1000 秒、24/25fps)、透明底参考图和商品元数据的 192,077 个 SKU(共 218,837 条视频);用 SAM2.1-Hiera-Large 以参考图 alpha 通道掩码初始化追踪商品,做帧级几何/时间过滤(掩码占帧 <5% 或 >80%、距边界 2% 以内、相邻帧面积比 >3.0、归一化质心位移 >0.35 的帧全部剔除),把连续有效帧组成 5–20 秒候选片段;Qwen3-VL-235B 参照参考图对每片段做身份一致性、可见性、覆盖水印质检;TransNetV2 切分镜头后由 Qwen3-VL-235B 标注身份/卖点/创意计划,Whisper-Large-v3-Turbo 转写音频并按时间戳对齐到镜头;20 名 trained 标注员人工复核修正,产出 10 万条。合成子集:60 万 SKU 经三阶段过滤(质量 600,000→400,130、适宜性→350,840、类目→348,526),GPT-5.5 生成结构化广告规划,Gemini-3.1-Pro-Preview 独立评审至多 5 轮,三个视频模型生成 9:16、720P、5–15 秒带音频视频,人工质检后得 20 万条。基准侧从 350 个隔离 SKU 精选 220 例,套用六维层级化指标。
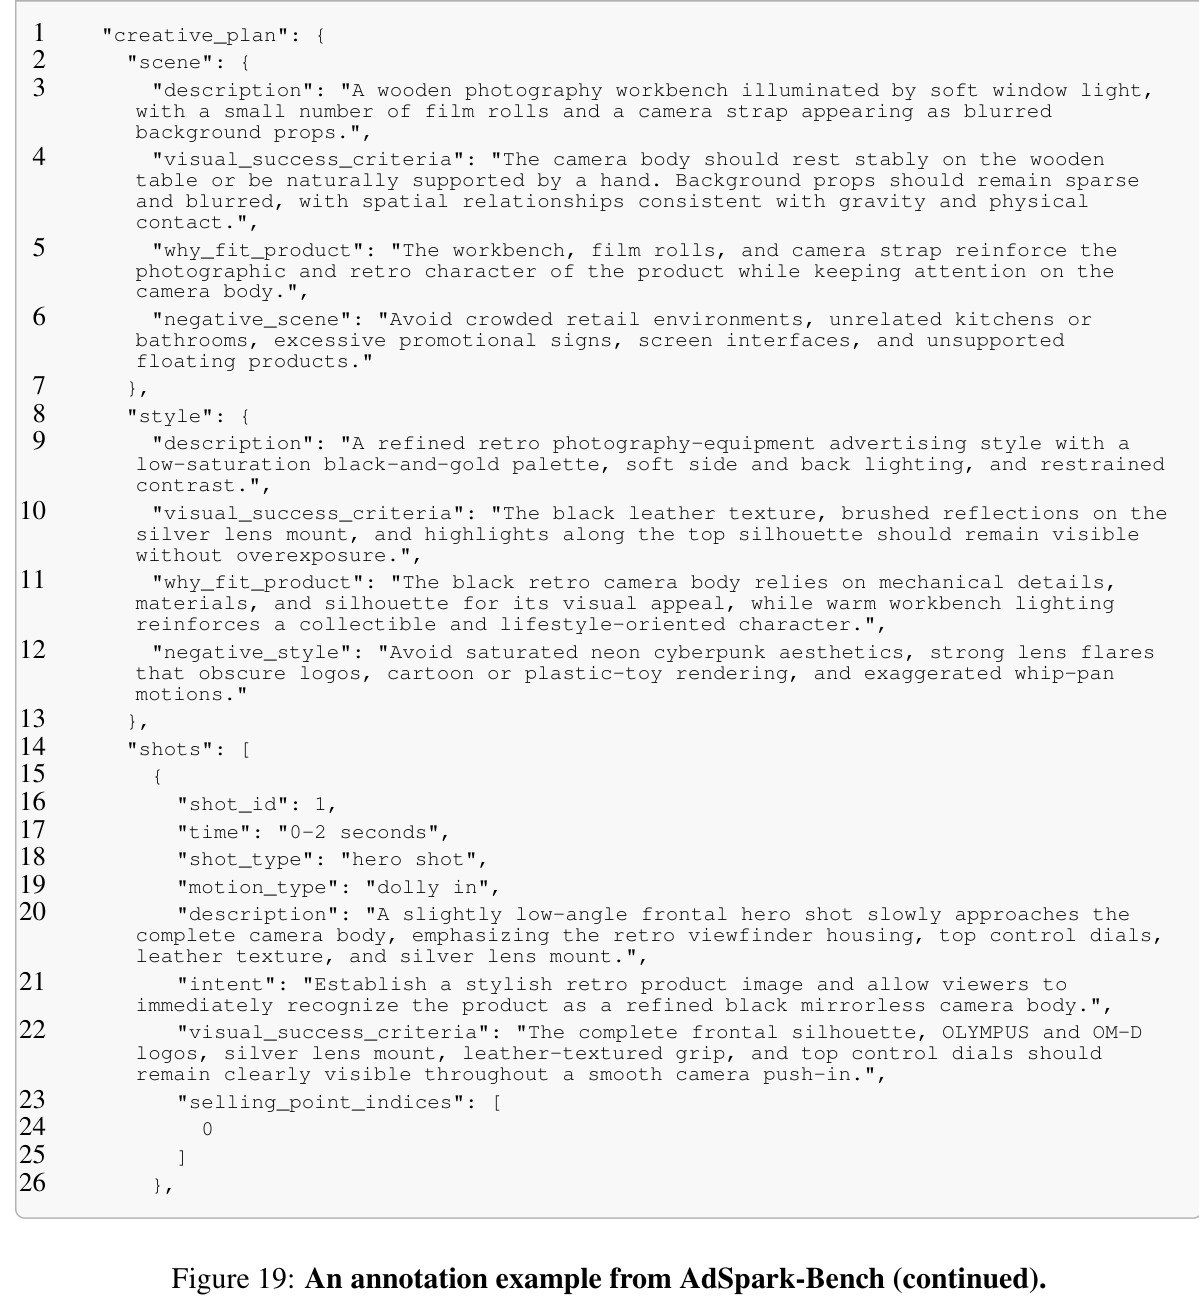
核心创新是把“结构化广告标注”当作连接数据生成与评测的中间表示。与通用视频数据集的“视频-文本对”有本质区别:每条 AdSpark 样本包含五部分——(1) 商品身份:类目/品牌/品名加视觉身份(主色、材质、形状、key_regions 身份关键区域、ocr_targets 需保持可读的包装文字、must_keep 必保元素);(2) 卖点:每条含 point(商业特性)、visualization(如何通过产品交互/功能演示/可见效果呈现)、visual_success_criteria(可从画面验证的成功标准),把“描述卖点”升级为“演示卖点”;(3) 创意计划:场景与风格各带可观测成功标准,分镜序列中每个镜头带唯一 ID、时间区间、景别、运镜、视觉描述、意图和 selling_point_indices 卖点索引;(4) 逐镜头对齐的音频脚本(背景音 + 旁白);(5) 可直接执行的音视频生成提示词。这让训练信号从“模仿一段视频”升级为“理解广告设计”。评测侧的对称创新是层级化镜头感知协议:检测镜头与计划镜头经 tIoU 贪心匹配后,同一组对应关系共享给镜头结构、镜头执行、跨镜头一致性三类指标;商品保真不比较整帧,而是用 GroundingDINO+SAM2 提取全商品、关键区域、包装文字三种粒度分别打分。
方法步骤详情
完整流程分四步。第一步(真实数据):SAM2.1 追踪并过滤出 5–20 秒干净片段(输入为视频+透明底掩码,输出为通过质检的候选片段);Qwen3-VL-235B 以参考图加至多 10 帧抽样判断身份一致、可见完整、无浮层水印,任一帧不合格即整段丢弃;TransNetV2 切镜头,Qwen3-VL-235B 结合参考图、代表帧和商品元数据生成结构化标注;Whisper-Large-v3-Turbo 转写旁白并按时间戳挂到镜头;人工复核后入库。第二步(合成数据):三阶段 SKU 过滤(质量:参考图 ≥800×800 且有透明通道;适宜性:Qwen3-VL 判定主体 ≤4 个、可见物品 ≤4 个、无水印/人物/场景残留;类目:剔除虚拟商品、处方相关、二手、收藏投资品等);GPT-5.5 基于参考图+属性生成规划,显式禁止编造功能、数字宣称与产品属性,卖点被翻译成镜头级动作与成功标准;Gemini-3.1-Pro-Preview 独立评审身份准确、卖点有效、分镜连贯、物理合理、音画对齐,不过则 GPT-5.5 按反馈修订,至多 5 轮,仍不过则弃用该 SKU;Seedance 2.0 为主(占多数)、HappyHorse 与 Kling 补充生成 5–15 秒 9:16 720P 带音频视频;标注员按商品保真、视觉合理、运动时序、卖点实现、音频五项一票否决质检。第三步(统一表示):两路数据归一到同一 JSON schema(Fig.14),校验字段完整、镜头有序不重叠且覆盖全时长、卖点引用一致。第四步(基准评测):对生成视频先 TransNetV2 检测镜头并与计划镜头按 tIoU 匹配,再在六个维度分别计算指标,例如镜头结构对齐 $S_{struct} = 0.4 S_{count} + 0.6 S_{bound}$(边界容差 $\delta = 0.5s$),内容对齐 $S_{content} = 0.3 S_{scene} + 0.3 S_{style} + 0.4 S_{sell}$,文字保真 $S_{text} = 1 - d_{edit}(y, \hat{y})/|y|$。
技术新颖性
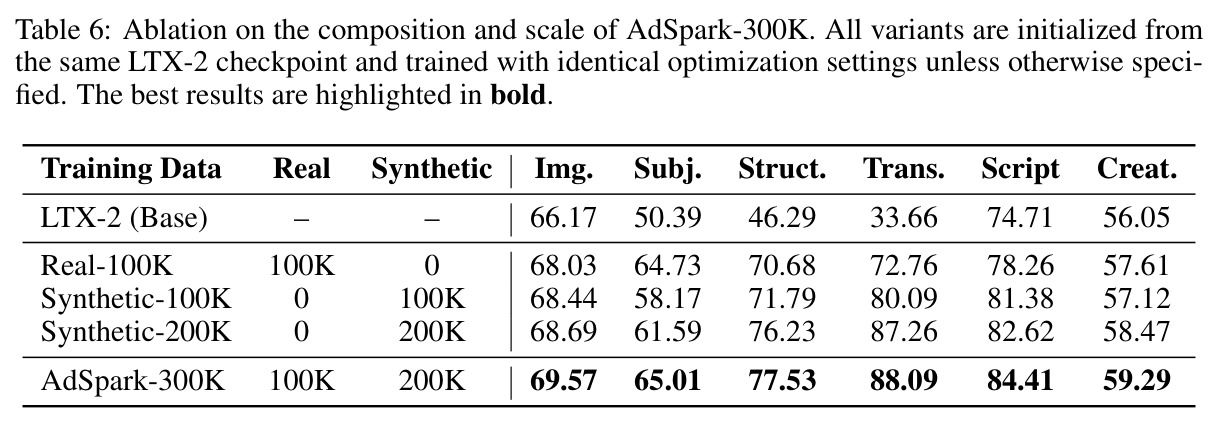
技术新颖性体现在三个层面。任务定义层面:首次把 PC-AVG 系统化,将广告从“一段视频”拆解为可验证的结构化设计,“卖点-视觉化-成功标准”三元组使“广告效果”这一主观概念第一次变得可计算、可回归验证。数据层面:首创真实+合成互补的大规模广告数据范式,合成侧的“LLM 规划 + 独立 LLM 评审(至多 5 轮)+ 多模型混合生成 + 人工五项质检”构成可复用的数据工厂;消融实验证明两种数据互补——同规模下真实数据主体一致性更高(64.73 vs 58.17),合成数据在结构类指标更强(转场自然度 80.09 vs 72.76),合并后全面最优。评测层面:商品保真指标从传统的整帧-DINO 特征比较细化到三个新粒度——关键区域相似度(Logo、品牌标识)、包装文字保真(OCR+编辑距离)、跨镜头商品一致性(切换前后商品裁剪的 DINOv3 特征余弦相似度),能捕捉整帧平均所掩盖的突变;同时用 GmeScore 补充全局视频-文本对齐。指标公信力经过独立验证:在 100 个 held-out 商品、19 个模型、6 名人类评分者的设置下,六个 GPT 辅助指标的 Spearman 相关介于 0.719(广告吸引力)到 0.861(镜头执行对齐)之间,说明 LLM-as-Judge 在广告评测上与人类偏好高度一致。
实验结果
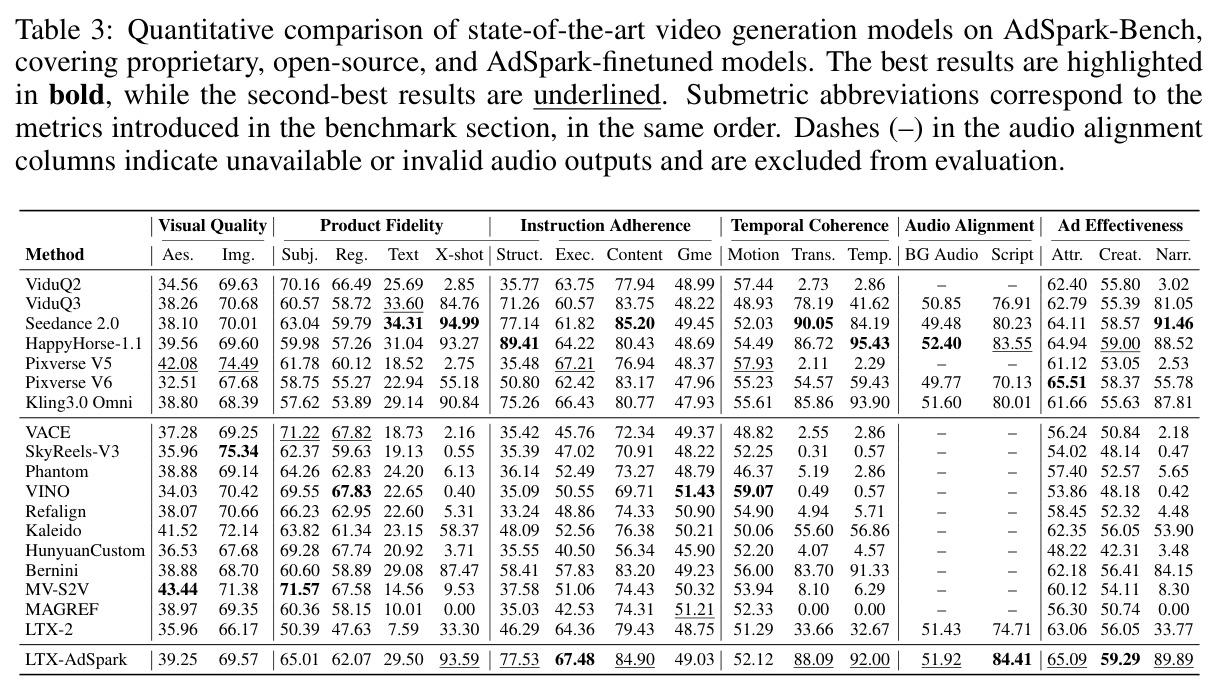
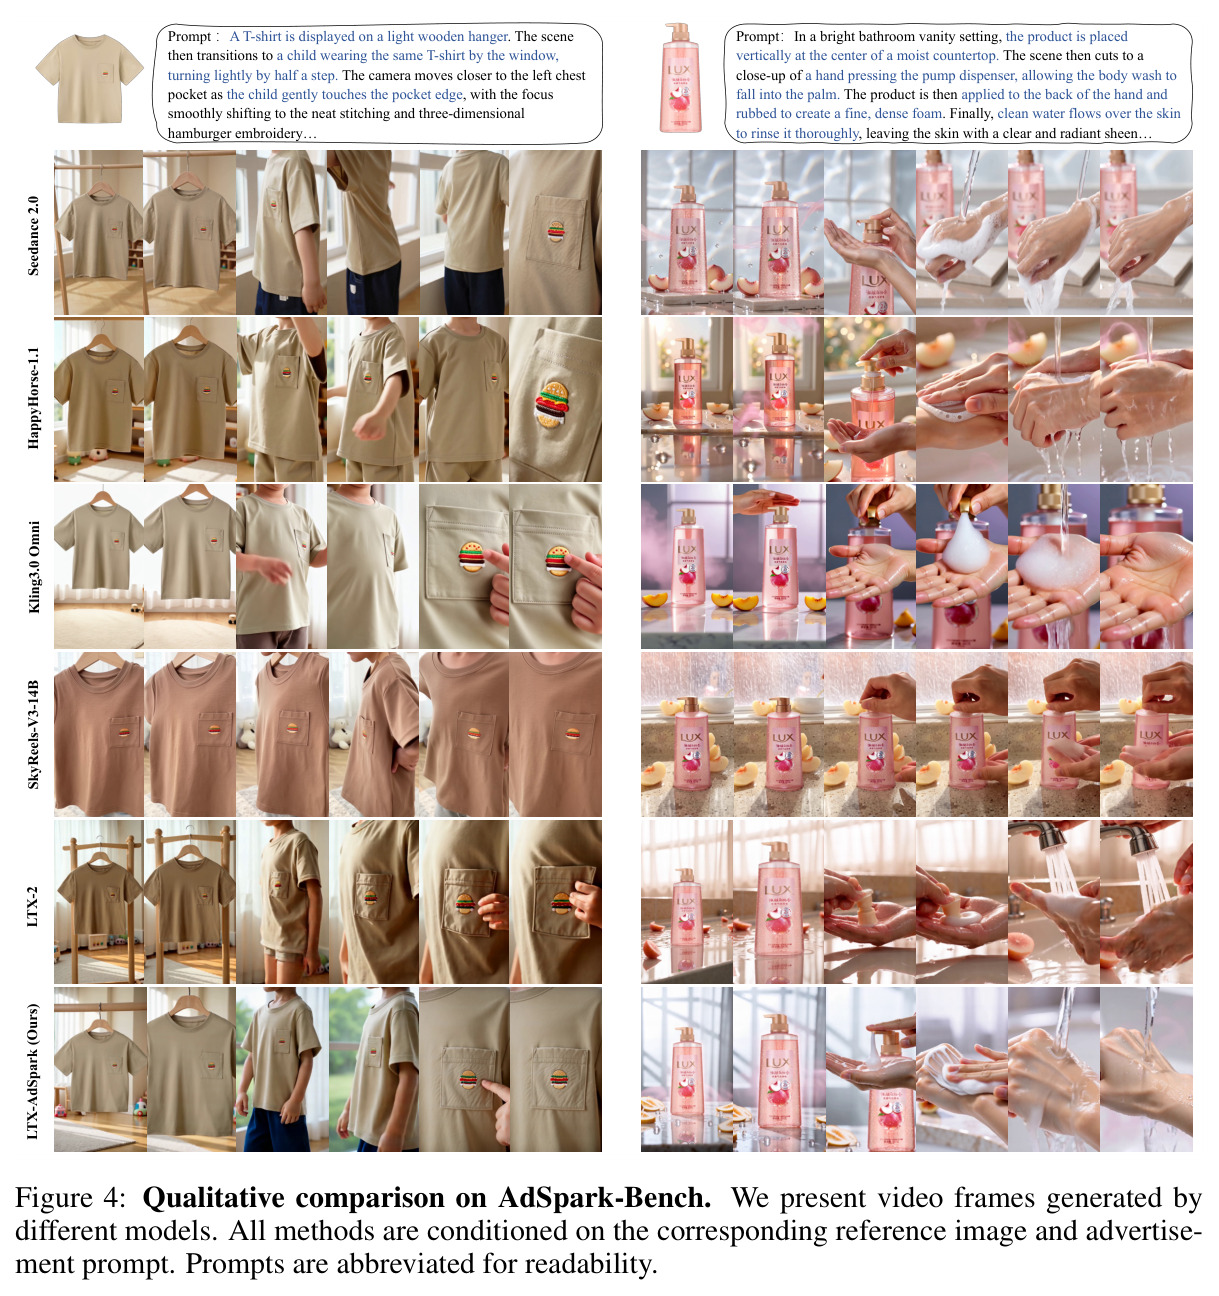
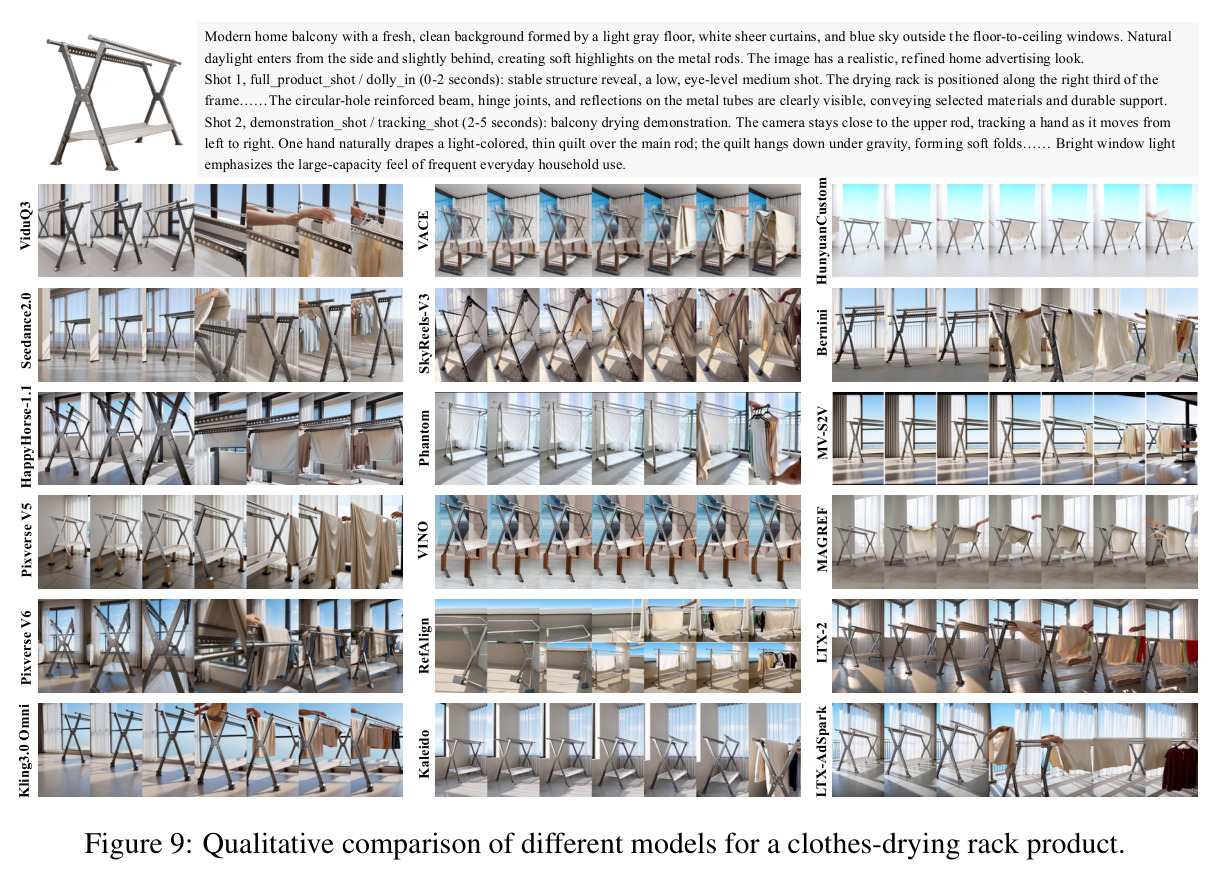
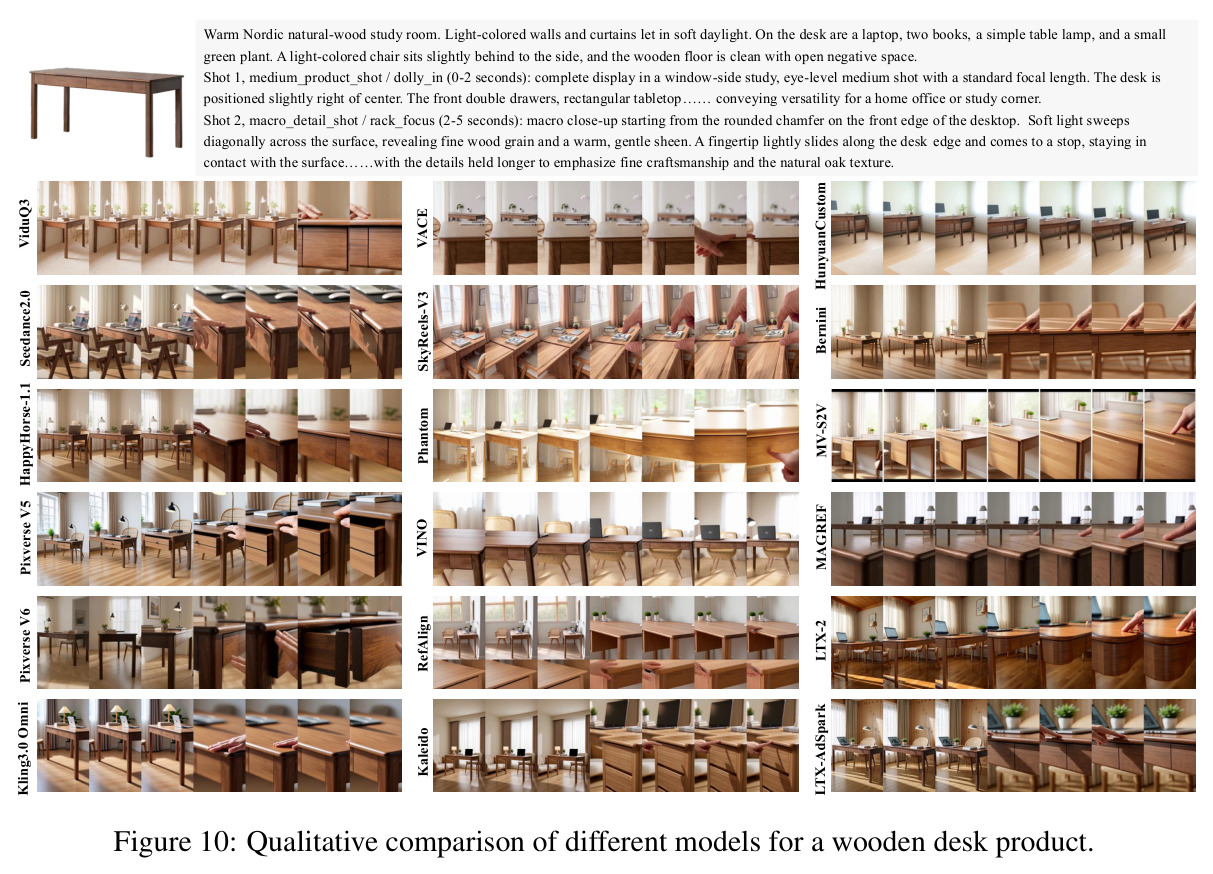
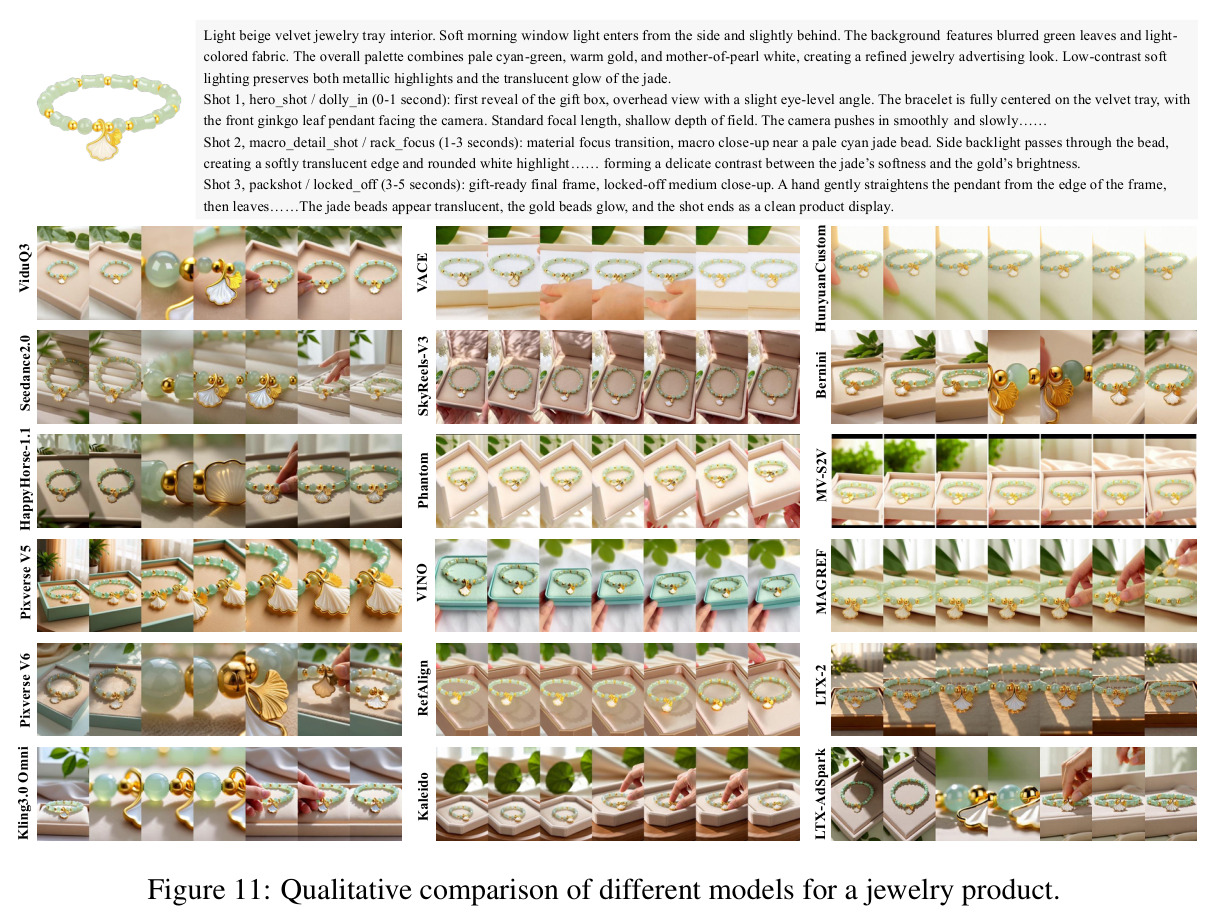
作者在 AdSpark-Bench 的 220 个案例上评测了 18 个模型(7 个闭源:ViduQ2/Q3、Seedance 2.0、HappyHorse-1.1、Pixverse V5/V6、Kling 3.0 Omni;11 个开源:VACE-14B、SkyReels-V3-14B、Phantom-14B、VINO-13B、Refalign-14B、Kaleido-14B、HunyuanCustom-13B、Bernini-14B、MV-S2V-14B、MAGREF-14B、LTX-2-14B),得到三大发现。发现一:闭源模型整体领先但商品保真仍是普遍痛点。Seedance 2.0 表现最均衡——跨镜头一致性 94.99、转场自然度 90.05、叙事连贯 91.46;HappyHorse-1.1 在镜头结构对齐(89.41)和时序一致性(95.43)上最佳;但在复杂运动下运动模糊、形变与漂移拉低了关键区域相似度(各家集中在 47–68)和文字保真(闭源最高的 Seedance 仅 34.31,Pixverse V5 只有 18.52),说明包装文字在生成中极易被破坏。发现二:开源模型在广告特有能力上差距悬殊。多数开源模型跨镜头一致性低于 10(VINO 0.40、SkyReels-V3 0.55、MAGREF 0.00),多镜头叙事连贯接近 0,基本无法按计划生成多镜头;MV-S2V 美学分全场最高(43.44)但跨镜头仅 9.53,印证“好看”不等于“能当广告”。发现三:微调收益巨大。LTX-AdSpark(LoRA rank 64、8×B200、30K 步)相对基座 LTX-2:跨镜头一致性 33.30→93.59、镜头结构对齐 46.29→77.53、叙事连贯 33.77→89.89、转场自然度 33.66→88.09、文字保真 7.59→29.50、主体一致性 50.39→65.01,多项指标比肩最强闭源模型。消融(Table 6)进一步表明:真实数据强化身份监督,合成数据强化结构与音画对齐,规模从 100K 到 200K 合成数据继续全面涨分,两者合并最优(如主体一致性 61.59→65.01)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨镜头商品一致性(175 个多镜头案例) | Cross-shot Product Consistency(DINOv3 特征余弦相似度) | 93.59(LTX-AdSpark) | 33.30(基座 LTX-2);闭源最佳 Seedance 2.0 为 94.99 | 较基座 +60.29,逼近闭源最佳 |
| 镜头结构对齐 | Shot Structure Alignment(镜头数准确率 0.4 + 边界准确率 0.6) | 77.53(LTX-AdSpark) | 46.29(LTX-2);闭源最佳 HappyHorse-1.1 为 89.41 | 较基座 +31.24 |
| 多镜头叙事连贯性 | Narrative Coherence(GPT-5.5 评审,与人类排序 Spearman 0.774) | 89.89(LTX-AdSpark) | 33.77(LTX-2);闭源最佳 Seedance 2.0 为 91.46 | 较基座 +56.12 |
| 转场自然度 | Transition Naturalness(GPT-5.5 评审) | 88.09(LTX-AdSpark) | 33.66(LTX-2);闭源最佳 Seedance 2.0 为 90.05 | 较基座 +54.43 |
| 包装文字保真(72 例文字子集) | Text Fidelity(RapidOCR + 编辑距离) | 29.50(LTX-AdSpark) | 7.59(LTX-2);全场最佳 Seedance 2.0 仅 34.31 | 较基座 +21.91,但绝对值显示该能力整体薄弱 |
| 商品主体一致性 | Subject Consistency(全商品裁剪 DINOv3 余弦相似度) | 65.01(LTX-AdSpark) | 50.39(LTX-2);开源最佳 MV-S2V 71.57 | 较基座 +14.62 |
局限与改进
作者承认的局限:数据仅来自单一电商平台,广告风格和品类分布受限;SKU 按 CTR 排序筛选,偏向头部热门商品,长尾和冷门品类覆盖不足。我的补充观察:其一,GPT-5.5 既负责合成数据的广告规划,又担任部分评测指标的评审,虽然作者论证了两者输入与角色不同(规划是纯语言创作、评审基于生成的视觉证据),但训练 prompt 与评测 judge 同源,可能存在系统性的风格亲和使用 LTX-AdSpark 得分偏高的风险;其二,音频对齐维度只对有音频输出的模型计算(Table 3 中 7 个闭源模型里 Pixverse、ViduQ2 等仍缺失),维度间可比性打折;其三,合成数据以 Seedance 2.0 为主力生成器,可能引入该模型的运动与美学偏置;其四,“广告效果”由 LLM 模拟顾客评分,没有与真实投放的点击率/转化率数据挂钩,商业效度未经验证;其五,基准仅 220 例、产品演示子集仅 20 例,子集上的指标方差可能较大。
独立分析的弱点
独立分析以下几个弱点并给出改进方向。(1) 卖点可视化评测依赖 GPT-5.5 对抽样帧打分,但功能演示常常只占 1–2 秒,均匀+密集采样仍可能漏掉关键动作帧,导致卖点实现被低估——可引入基于动作检测/事件定位模型的定点采样,或要求模型输出带时间戳的功能演示区间再核验。(2) 商品保真全链路依赖 GroundingDINO+SAM2 的检测分割质量,生成商品严重畸变时检测器可能失效,指标随之不可靠——可发布检测置信度分布并辅以人工校验子集。(3) 真实数据标注由 VLM 自动生成、每样本仅一名标注员复核,论文未报告标注错误率或标注者间一致性,结构化标注(尤其卖点归纳)的噪声水平是黑箱——建议发布抽样双标的一致性指标。(4) LTX-AdSpark 推理固定为 704×1280、121 帧(约 5 秒),而数据集平均 7.8 秒、真实片段最长 20 秒,模型在长广告、更多镜头数(>3)下的能力完全未验证——应补充 10 秒以上多镜头生成实验。(5) 广告效果维度缺少与真实商业指标(CTR/CVR)的相关性分析,这是“广告”任务区别于普通视频生成的核心效度问题——可与平台 A/B 测试数据联动验证。
未来方向
作者明确提出两个方向:扩展数据源到更多平台、市场和广告风格;突破 CTR 导向的选品偏差,覆盖长尾商品与低频品类。基于本文成果还可延伸:(1) 把“创意计划生成”独立成模块,用 AdSpark 训练专门的广告策划器,与生成器解耦,形成“策划-生成-评测-修订”闭环,支持商人可编辑的分镜级控制;(2) 以 AdSpark-Bench 六维指标为 reward 做强化学习或 DPO 后训练,直接优化商品保真与卖点实现,而不只是模仿数据分布;(3) 将真实投放效果数据(点击率、转化率、完播率)接入广告效果评测,构建具有商业效度的下一代基准;(4) 扩展到更难的广告形态:多商品同框、人物深度交互、可拖拽/多视角互动广告与直播切片;(5) 研究旁白与画面的细粒度时间同步评测(当前 CER 只衡量文字内容,不衡量“说到做到”的时刻对齐);(6) 探索跨镜头商品一致性的生成端方案,如以 key_regions 为条件的区域级身份锁定。
复现评估
复现友好度整体较高,但存在明确的成本门槛。数据与基准:论文承诺接收后开源数据集,标注 schema(Fig.14)和全部提示词模板(Fig.12–26)在附录完整公开,合成数据的构造逻辑可以照搬;但合成数据构建依赖闭源商业模型(GPT-5.5 规划、Gemini-3.1-Pro-Preview 评审、Seedance 2.0/HappyHorse/Kling 生成),其中 HappyHorse 无公开 API,完整复现 20 万条合成数据需要可观的调用费用,且电商侧数据需平台授权(外部研究者无法获得同源真实数据)。评测管道:底层组件全部开源(SAM2、TransNetV2、GroundingDINO、DINOv3、MUSIQ、RapidOCR、LAION-CLAP、Whisper-Large-v3-Turbo、gme-Qwen2-VL-7B),唯一闭源依赖是 GPT-5.5 评审指标,调用成本可控;归一化规则(Aesthetic Score 以 4.0–7.0 线性裁剪、MUSIQ 除以 100、Likert 按 $(s-1)/4$ 映射)和聚合公式(式 30–33)写得足够细,逐条可复现。训练:LoRA rank 64、30K 步、8×B200、bf16,属于中等算力门槛,机构实验室可承受;推理设置(704×1280、121 帧、30 步、guidance 4.0、STG 1.0、seed 42)完全固定,数值结果可复现。总体判断:这是数据/基准类论文中复现文档做得相当规范的一篇,主要障碍在闭源模型费用与电商数据授权。
论文图表
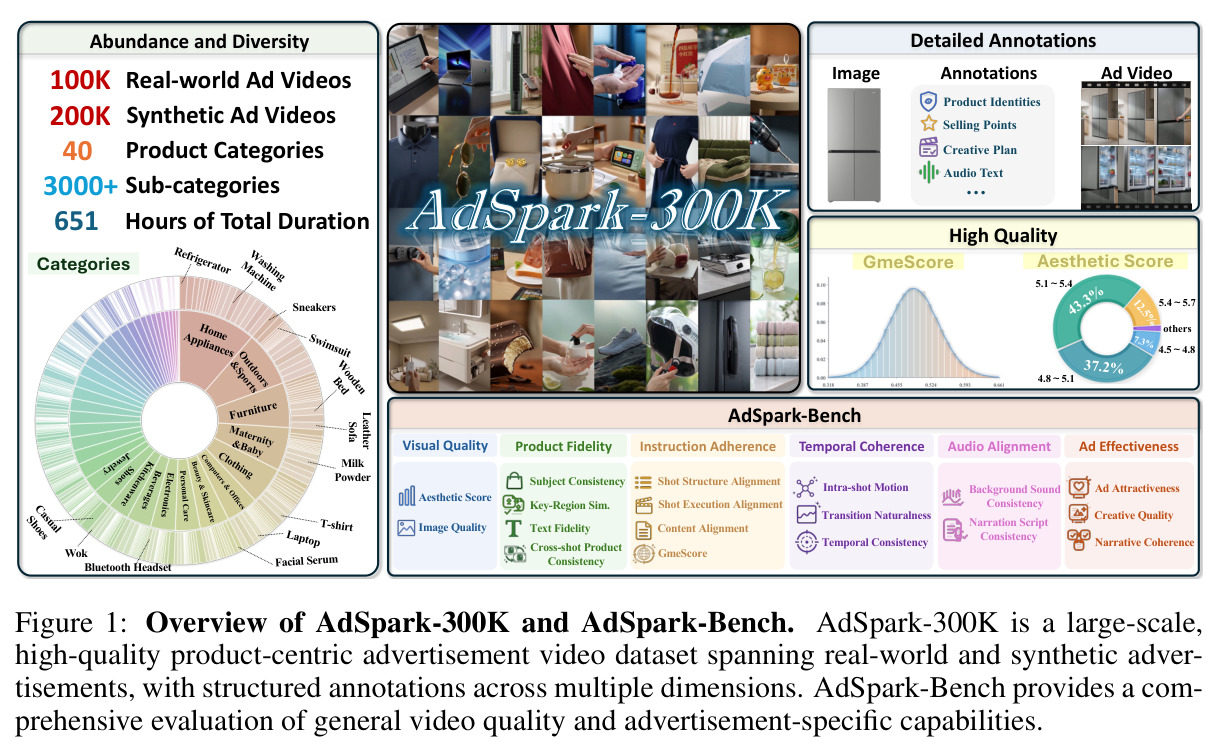
总览图。左侧展示 AdSpark-300K 的规模与多样性:10 万条真实广告视频 + 20 万条合成广告视频、40 个品类、3000+ 子类、总时长 651 小时、MUSIQ 质量分布,以及品类构成(家电、服饰、家具、美妆等);右侧展示统一标注结构(参考图-标注-广告视频,含卖点、商品身份、创意计划、音频脚本)与 AdSpark-Bench 的六大评测维度及其子指标(主体一致性、关键区域相似度、文字保真、镜头结构对齐、转场自然度、旁白脚本一致性、广告吸引力等)。
一图读懂本文两大贡献的全貌:数据集的规模、标注维度与基准的评测维度设计,是论文的“地图”。