OmniVBench:全参照视频生成基准与大规模训练数据集 OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
构建覆盖7大任务族的R2V基准与34万样本训练集,用因子级清单实现细粒度评测
前置知识
R2V(Reference-to-Video)生成
指以图像或视频作为参照输入来控制视频生成的技术范式:模型接收一张或多张参照图/参照视频片段,外加文本指令,生成保留参照中特定信息(如人物身份、动作、风格、空间结构、故事线)的新视频。它正从早期单一参照的专用模型,发展为支持异质参照与多参照组合的通用范式,即本文所称的 omni R2V。
全文围绕 R2V 的评测与训练数据展开,7 大任务族分类、18 个子任务与评测维度都建立在理解各类参照输入(内容/运动/风格/结构/叙事)语义差异的基础上。
参照因子解耦与路由(factor disentanglement & routing)
指模型从参照中只提取该用的因子(如动作、花纹、镜头轨迹),剥离其原始载体信息(如参照里的人物身份、背景、道具),并在多参照时把每个因子正确绑定到输出的目标实体上。例如『把图2背包的花纹用到人物背心上』要求提取花纹而忽略背包本身、也不能贴到其他物体上。这是本文 IRDR 评测子维度的核心。
论文的核心论点是现有基准只测整体相似度,而 omni R2V 的真正难点正是解耦与路由;不掌握这一概念就无法理解其评测协议为何这样设计、实验发现的模型短板意味着什么。
VLM 裁判与清单式评测(VLM-as-a-judge / checklist evaluation)
用多模态大模型代替人工为生成结果打分。清单式评测把一个测试样例拆解为若干原子问题(如『视频中的雨伞与参照图3是同一把吗』),逐项按量规打分后再层级聚合,比让裁判直接给一个整体分更细粒度、更可诊断、也更抗噪声。本文用 Gemini-3.1-Pro 充当裁判并完整公开了激活 prompt 与评分量规。
OmniVBench 的 12,172 条 checklist 及 RF/IR 打分机制完全基于这一范式,正文评测协议与附录 A.4/A.5 的细则都以此为基础展开。
条件注入与反向构造(conditioning & inverse construction)
视频生成模型通过 VACE、Animate 类控制模块把参照图/视频作为条件注入去噪过程,实现身份或运动控制。反向构造则是数据构建技巧:从目标视频出发,用提取(线稿、深度、关键帧)或生成工具(Wan-Animate 驱动、图像编辑模型)反推得到参照,使参照—目标天然满足任务所需的关系,绕开昂贵的跨视频人工采集。
Omni-R2V 数据集的流水线大量依赖这两类技术:动作参照用 Wan-Animate 造、灰盒用 Wan2.2-VACE-Fun-A14B 造、线稿用 12 种边缘提取器造,理解它们是读懂第 4 章与附录 A.1 的前提。
研究动机
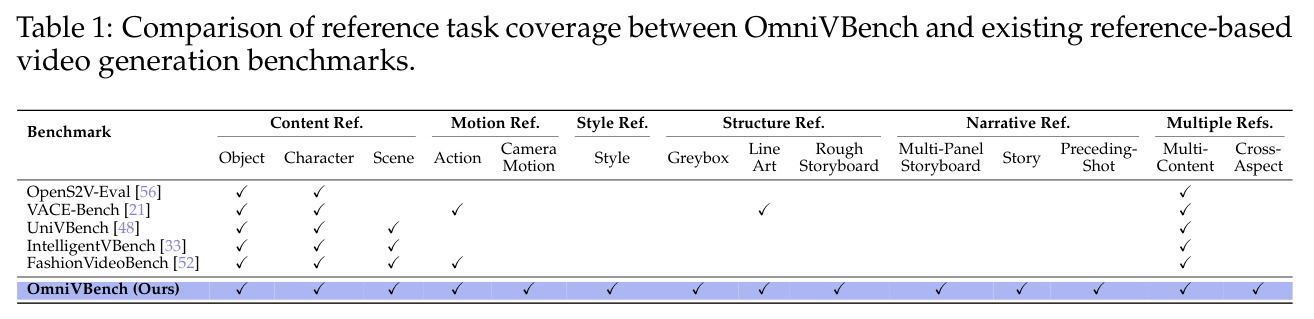
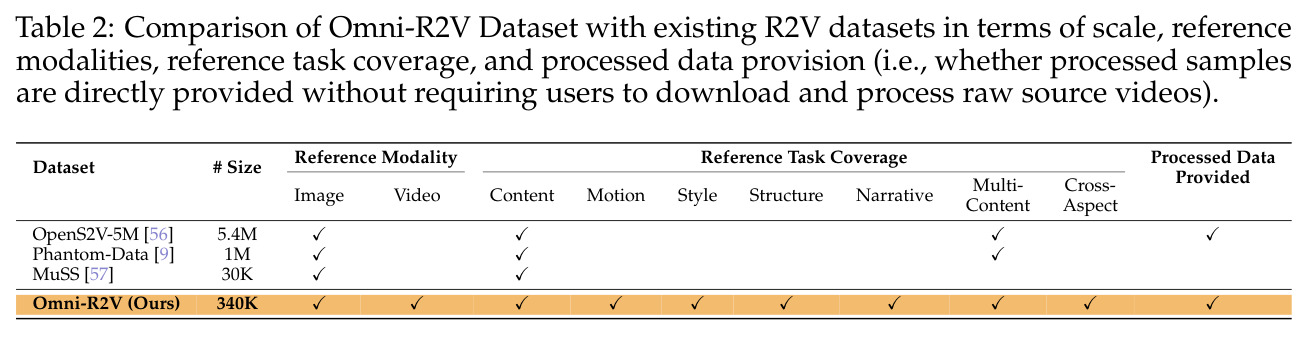
参考驱动的视频生成(R2V)正从单一参照的专用生成走向支持多参照、组合控制的 omni 范式,但现有评测与数据资源明显滞后。评测方面,如表 1 所示,OpenS2V-Eval、VACE-Bench、UniVBench、IntelligentVBench、FashionVideoBench 等基准的测试用例高度集中在内容参照(物体/角色/场景),对动作与镜头运动这类运动参照、灰盒/线稿/粗分镜这类结构参照、故事与前镜头这类叙事参照,以及多参照组合几乎空白。同时其评测协议大多用固定相似度指标或 VLM 的整体性判断来评估『参照一致性』,无法区分模型是否正确保留了应保留的因子、修改了应修改的因子、并把多个参照的因子路由到正确的目标上——而这恰恰是实际创作工作流中的核心能力。数据方面,如表 2 所示,OpenS2V-5M(540 万)、Phantom-Data(100 万)、MuSS(3 万)等数据集都围绕内容参照构建,覆盖碎片化,部分资源只给原始视频而不提供处理好的参照—目标对,训练 omni R2V 模型缺乏合适资源。
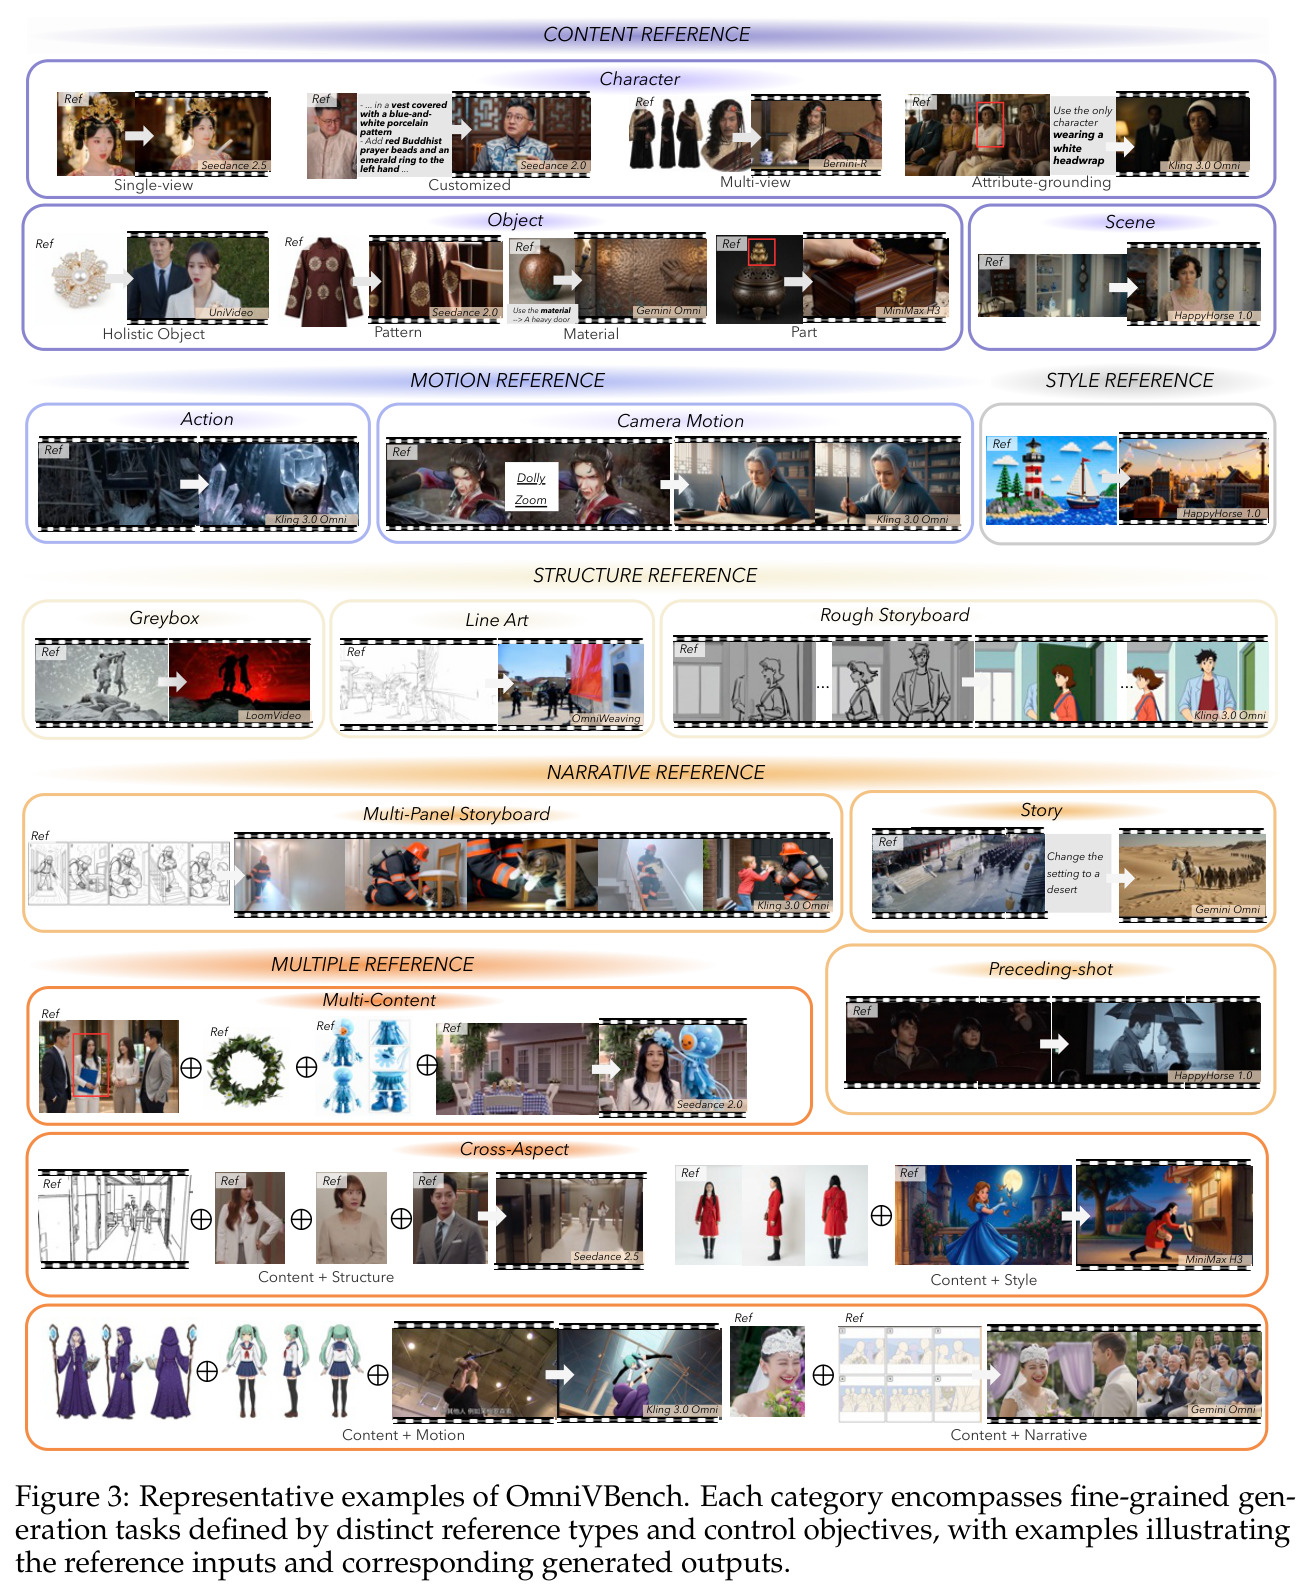
本文的目标是本文的目标是为 omni R2V 建立评测与训练的公共地基,具体交付三件事。其一,构建 OmniVBench:把 R2V 任务空间组织为内容、运动、风格、结构、叙事五个单参照维度,并扩展出多内容与跨维度两类多参照设置,形成 7 个任务族、18 个细粒度子任务、813 个评测用例,全部经三重人工审核。其二,提出因子锚定(factor-grounded)的评测协议:把每个用例分解为与其参照和指令绑定的原子清单项,共 12,172 条,显式评估参照因子是否被忠实保留、正确解耦并路由到目标、按指令正确实现。其三,构建并发布 Omni-R2V 数据集:约 34 万条(339,570)处理好的训练样本,覆盖同样 7 个任务族,并公开任务特定的配对流水线配方。最后用该基准对 6 个闭源与 5 个开源模型进行系统评测,定位当前能力边界。
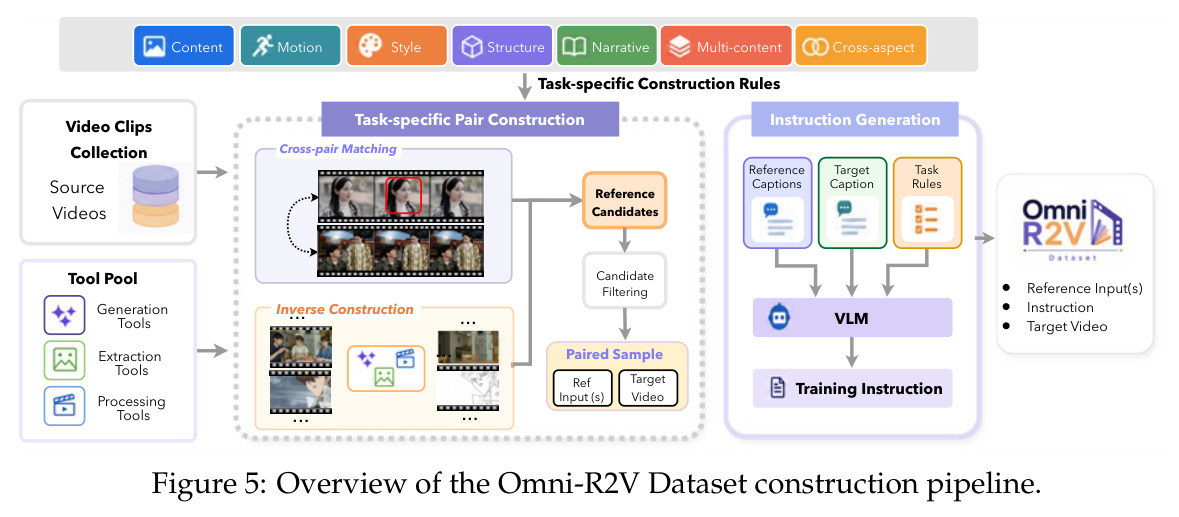
与已有工作不同的是,本文的独特切入点是『因子级』视角:不再把参照当成一个需要整体模仿的图像块,而是把每个用例拆解为『哪个参照的哪个因子应被保留/修改/抑制、应绑定到输出的哪个目标』的命题集合。评测上,这体现为逐用例的清单生成与标准激活机制——只有该样例真正涉及的标准才会被实例化为问题,指令明确要求的改动不计为保真错误,从而把『保真』『遵从』『路由』三类能力干净地分开。数据上,这体现为任务特定的参照—目标配对:跨对匹配保证『不同片段、同一因子』(如同角色不同镜头),反向构造从目标出发用提取或生成工具造出『只含目标因子』的参照(如从目标动作造出一个新角色的动作参照),二者结合绕开了大规模人工采集的成本。同一配方既生产了 813 个精修评测用例,也以自动化方式生产了 34 万条训练样本。
核心方法
直觉上,这篇论文把驾照考试从『看整体开得像不像』改成了『逐科目考试』:omni R2V 模型需要在内容、运动、风格、结构、叙事等异质维度上分别可控,整体相似度分数会掩盖单点短板。技术上,论文交付两件配套资产。第一是 OmniVBench 基准:按 5 个单参照维度加 2 个多参照设置组织 18 个子任务、813 个用例;评测沿三个 L1 维度——参照保真度 RF(含内容/结构/运动/风格/叙事 5 个 L2 子维度,1–5 分)、指令实现 IR(含解耦路由 IRDR 与目标遵从 IRTC 两个 L2 子维度,1–3 分)、视频质量 VQ(技术/美学/物理,分别用 DOVER++ 技术分支、Aesthetic Predictor V2.5、UnifiedReward 2.0 计算)。第二是 Omni-R2V 数据集:34 万条参照—目标—指令三元组,由『片段收集过滤→跨对匹配/反向构造配对→任务特定过滤→指令生成』流水线生产。评测时 VLM 裁判按清单逐项打分,再层级等权聚合成百分制。
核心创新是因子锚定的清单评测(factor-grounded checklist evaluation)。与以往『一个样例一个总分』的整体式评测不同,每个用例先由一个标准激活器(VLM)根据指令和参照清单,从固定候选标准集中选出该样例真正涉及的标准(如 RF-C01 实体身份、I-D05 条件-槽位对应、I-E07 物体操作),再实例化成原子问题;指令明确要求的修改被显式排除在保真扣分之外。最关键的新维度是 IRDR(参照因子解耦与路由):它单独检查模型是否『拿了该拿的、扔了该扔的、把多个条件接到正确的槽位』——例如『把图 2 背包的花纹应用到背心上』会检查输出中不能残留背包本身、花纹不能贴到雨伞或雨伞以外的物体上。这一维度在现有基准中完全缺失,而实验证明它恰是当前模型(包括顶级闭源模型)的系统性弱点。聚合公式 $S_d^i = \frac{1}{|G_d^i|}\sum_{g \in G_d^i}\frac{1}{|A_{i,g}|}\sum_{c \in A_{i,g}} z_{i,c}$ 保证每个激活的 L2 子维度等权,避免清单条目多的维度淹没其他维度。
方法步骤详情
基准构建分四步。(1)素材构造:从有版权的内部视频库选源视频,按任务通过跨片段匹配(同角色/同风格的不同片段)或任务特定工具构造参照(如物体/场景/多视角参照由 GPT Image 2.0 生成、属性锚定参照混入 2–4 个干扰角色);指令从目标字幕改写并刻意隐去应从参照推断的信息以防文本泄漏;每例经 3 名标注员审核。(2)评测执行:标准激活器按附录 A.4 规则选出适用标准并实例化清单,裁判对 RF(1–5)与 IR(1–3)分别打分;证据呈现有讲究——非时间对齐参照按 2 FPS 采 8–20 帧,时间对齐参照(灰盒/线稿/运动)取 10 对相同相对时刻的帧对。(3)聚合:清单分→标准内平均→映射到百分制→按 $S_d^i = \frac{1}{|G_d^i|}\sum_{g \in G_d^i}\frac{1}{|A_{i,g}|}\sum_{c \in A_{i,g}} z_{i,c}$ 逐层等权聚合,总分取 RF/IR/VQ 均分。(4)数据集流水线:动作参照用 Wan-Animate 把检索到的兼容角色按目标运动驱动,镜头运动参照来自 Unreal 合成、位姿估计检索与内部可控模型,线稿用 4 族 12 种提取器,灰盒用 Wan2.2-VACE-Fun-A14B,粗分镜用 Qwen-Image-Edit 转素描并经 Gemini 验证,前镜头用 TransNetV2 切镜;最后 Gemini-3.1-Pro 打字幕、DeepSeek-V4-Pro 生成显式声明参照角色的训练指令。
技术新颖性
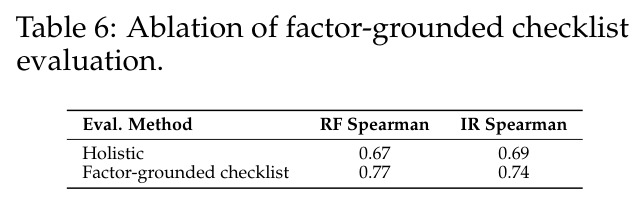
与已有工作相比,新颖性有四点。第一,任务空间首次系统化:18 个子任务中灰盒、粗分镜、多格分镜、故事、前镜头、跨维度组合在既有 R2V 基准中均无覆盖(表 1),这套任务分类学本身即是贡献。第二,IRDR 是全新的评测能力:此前所有基准只测『像不像』与『听不听话』,本文首次把『因子是否从载体中剥离、是否路由到正确目标』设为独立分数,实验显示它解释了模型间的显著分化。第三,数据工程贡献:现有 R2V 数据集要么只覆盖内容参照,要么不提供处理后样本,Omni-R2V 的 339,570 条样本全部附带处理好的参照与指令,且每类任务有明确可复用的配对配方(附录 A.1.1 细化到具体工具与筛选规则),这在公开数据集中没有先例。第四,协议有效性有实证支撑:消融显示清单式评测与人判的 Spearman 相关比整体式评测高 0.10(RF:0.77 对 0.67)和 0.05(IR:0.74 对 0.69),避免了『新协议自说自话』的常见质疑;同时基准与数据集互不重叠,保证评测纯净。
实验结果
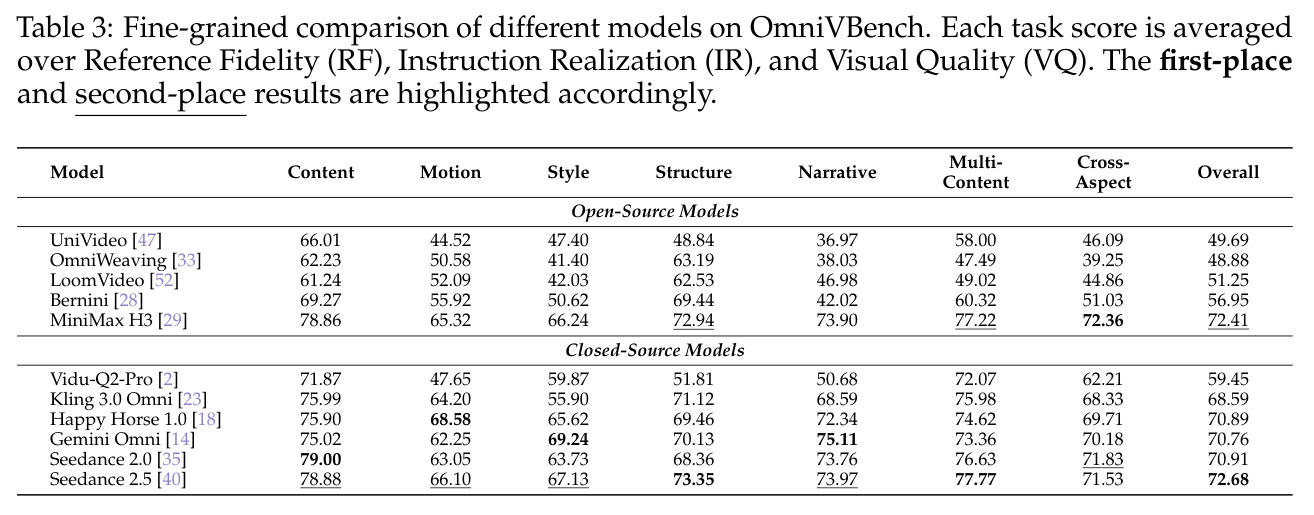
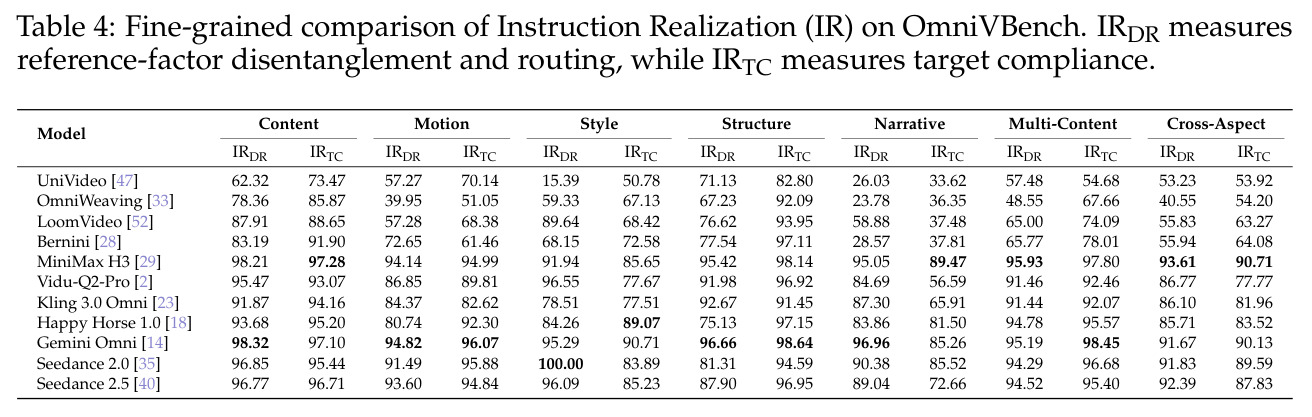
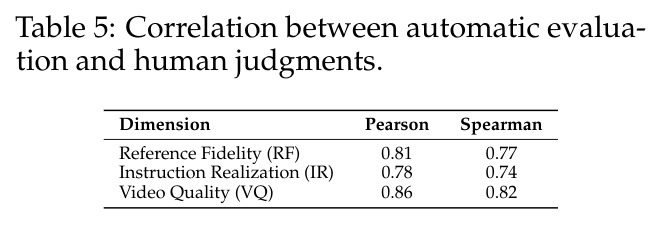
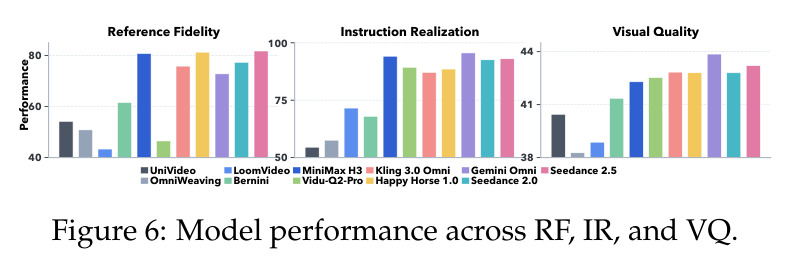
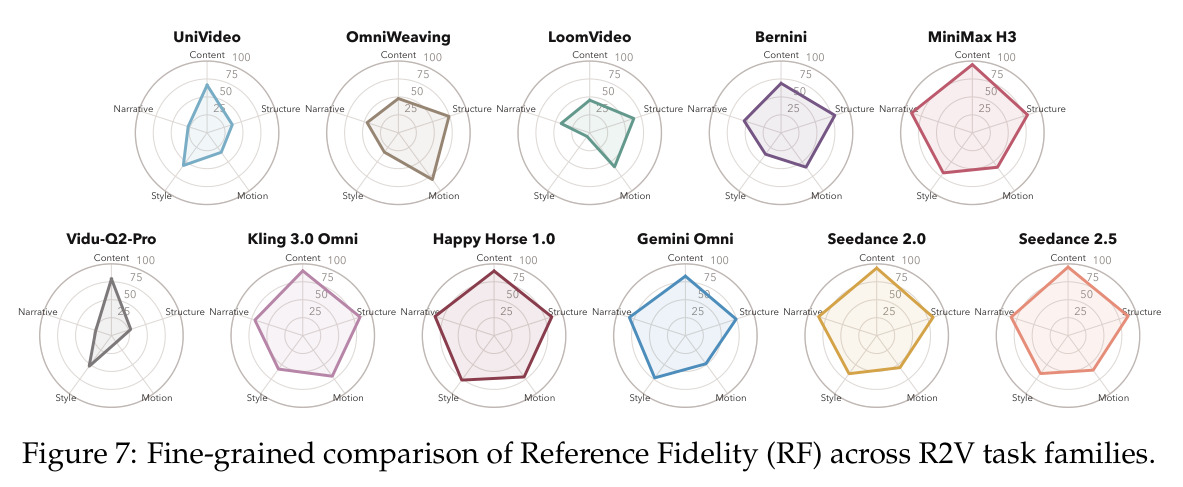
主实验(表 3)评测了 11 个模型。综合榜 Seedance 2.5 以 72.68 居首,开源 MiniMax H3 以 72.41 紧随其后,开源闭源差距已大幅缩小;闭源 Seedance 2.0(70.91)、Happy Horse 1.0(70.89)、Gemini Omni(70.76)、Kling 3.0 Omni(68.59)、Vidu-Q2-Pro(59.45)与开源 Bernini(56.95)、LoomVideo(51.25)、UniVideo(49.69)、OmniWeaving(48.88)依次排列。分族看:内容参照最容易(61–79 分),叙事最难——UniVideo 仅 36.97、OmniWeaving 38.03,而 Gemini Omni 达 75.11;且无模型全面领先(Seedance 2.0 内容第一 79.00,Happy Horse 运动与跨维度第一 68.58/69.71,Seedance 2.5 结构与多内容第一 73.35/77.77),说明单一参照上的进步不会自动迁移。图 6 显示 IR 分数普遍远低于 RF/VQ;表 4 拆解出典型病灶是路由失败:UniVideo 风格任务 IRDR 仅 15.39 而 IRTC 50.78。协议验证(表 5):100 用例、965 个输出、3 名标注员,自动评测与人判 Pearson 相关 RF 0.81/IR 0.78/VQ 0.86;消融(表 6)显示因子清单比整体评测人判相关性更高(RF Spearman 0.77 对 0.67)。数据人评(表 A.6):平均通过率 95.5%,运动族最低(89.7%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Omni R2V 综合(7 任务族均分) | Overall(RF/IR/VQ 均分,百分制) | Seedance 2.5:72.68(全场第一);开源 MiniMax H3:72.41 | 最强传统开源 Bernini:56.95;最弱 OmniWeaving:48.88 | MiniMax H3 较 Bernini 高 15.5 分,几乎抹平与最强闭源的差距(仅差 0.27) |
| 叙事参照(Narrative) | 任务族均分(百分制) | Gemini Omni:75.11 | UniVideo:36.97(OmniWeaving 38.03) | 最高与最低相差 38.1 分,叙事理解是当前模型最大短板 |
| 内容参照(Content) | 任务族均分(百分制) | Seedance 2.0:79.00(闭源第一) | OmniWeaving:62.23 | 全模型区间 61–79,为最成熟任务族;MiniMax H3 作为开源已达 78.86 |
| 指令实现拆解(IRDR vs IRTC) | IRDR/IRTC(百分制,风格任务族) | UniVideo:IRDR 15.39 / IRTC 50.78 | Gemini Omni:IRDR 95.29 / IRTC 90.71 | 量化揭示『能按指令生成却错误复制参照载体/绑错因子』的系统性缺陷 |
| 评测协议有效性 | 与人判的 Pearson / Spearman 相关 | 因子清单:RF 0.81/0.77,IR 0.78/0.74,VQ 0.86/0.82(965 个输出) | 整体式评测:RF Spearman 0.67,IR 0.69 | 清单式使 RF/IR 人机相关性分别提升 0.10 与 0.05 |
局限与改进
作者承认的局限:评测素材来自内部视频库(虽已获研究与公开发布授权),基准规模 813 用例不算大;裁判依赖单一 VLM。我的补充观察:其一,裁判自偏好风险——裁判用 Gemini-3.1-Pro,被测模型中恰有 Gemini Omni,且后者在叙事(75.11)与风格保真(69.24)上领先,难以完全排除家族偏袒。其二,子任务样本量悬殊:灰盒仅 19 例、场景 25 例、风格 43 例,而跨维度有 223 例,小样本子任务排名对个别用例敏感。其三,VQ 三个组件(DOVER++/美学预测器/UnifiedReward 2.0)均非为 R2V 设计,与参照因子无关。其四,证据呈现按 2 FPS 或 10 对帧采样,快速运动与细微手部动作可能在采样中丢失,影响运动保真打分。其五,数据集分布失衡:叙事参照 167,881 条(约 49%)而风格仅 8,842 条(约 2.6%),运动族人评通过率最低(89.7%)提示配对噪声更大。其六,论文未用 Omni-R2V 训练任何模型验证其训练价值,34 万样本的实际效用仍是未验证假设。
独立分析的弱点
弱点一:评测闭环深度依赖专有前沿模型——数据构建用 GPT Image 2.0、Gemini-3.1-Pro、DeepSeek-V4-Pro,打分也用 Gemini-3.1-Pro,API 变更或涨价都会波及复现与维护;改进方向是蒸馏开源中立裁判或集成多裁判并公开分歧率。弱点二:清单打分本质仍是 VLM 自由判断,论文未报告裁判间一致性(如 Kappa),风格相似、同一性等主观标准的打分方差未知;改进方向是抽样双裁判并公布一致性指标。弱点三:部分子任务样本量过小(灰盒 19、场景 25),难以支撑子任务级显著结论;改进方向是扩充基准或报告置信区间。弱点四:缺少训练侧验证——没有『用 Omni-R2V 训练后各任务族提升多少』的实验,投入产出不明;改进方向是发布用十分之一数据训练的小型基线作参照点。弱点五:跨维度只覆盖『内容+X』四种组合,无运动+风格、结构+叙事等组合,组合空间只是抽样;改进方向是补全组合矩阵并加入三重组合。弱点六:相当比例评测参照由 GPT Image 2.0 生成,合成伪影可能干扰保真判定。
未来方向
作者提出的方向是把 OmniVBench 与 Omni-R2V 作为互补资源,推动更通用、更可控的 R2V 生成。基于其成果还可延伸:(1)训练侧验证——用该数据集训练或继续预训练一个开源 R2V 模型,按 7 个任务族做数据配比消融,量化每类参照数据的边际收益,同时检验叙事占 49% 的配比是否最优;(2)把 12,172 条清单协议蒸馏成奖励模型,用于 R2V 模型的 RLHF/GRPO 训练,让『解耦与路由』成为可优化目标而不仅是评测指标;(3)评测侧引入更密集的时间证据(直接视频输入或高帧率关键帧),检验运动与镜头运动保真打分是否改善;(4)扩展到音频参照(配音、音效驱动)与分钟级长视频叙事;(5)构建交互式多轮 R2V 评测,测量连续编辑中因子保持的累积误差;(6)利用清单结构做失败模式自动归因,为每个模型输出因子级错误画像与公开能力雷达,指导后续研发。
复现评估
复现难度中等偏上,但工程路径清晰。项目主页 https://wxliii.github.io/OmniVBench/ 提供入口,论文承诺发布基准(813 用例)与 Omni-R2V 数据集(339,570 条处理后样本,含参照与指令),数据以『处理后』形式提供,无需自行加工原始视频。评测复现的主要成本是 VLM 裁判 API:813 用例 × 11 模型 × 平均十余条清单 × RF/IR 分开调用,另加标准激活调用;附录 A.4–A.5 完整给出激活 prompt、候选标准、评分量规与证据呈现规则,可逐字复刻。数据构建复现门槛更高:流水线依赖 Gemini-3.1-Pro、DeepSeek-V4-Pro、GPT Image 2.0、Wan-Animate、Wan2.2-VACE-Fun-A14B、Qwen-Image-Edit、TransNetV2 等工具(多数可公开获取),但源视频主要来自腾讯内部版权库,内部相机可控模型也未公开——即『配方』可复用,『原料』不可完全复得。务实建议:直接使用发布的处理后数据做训练,按附录复刻评测协议;处理 2160p、20 秒级视频需 TB 级存储。
论文图表
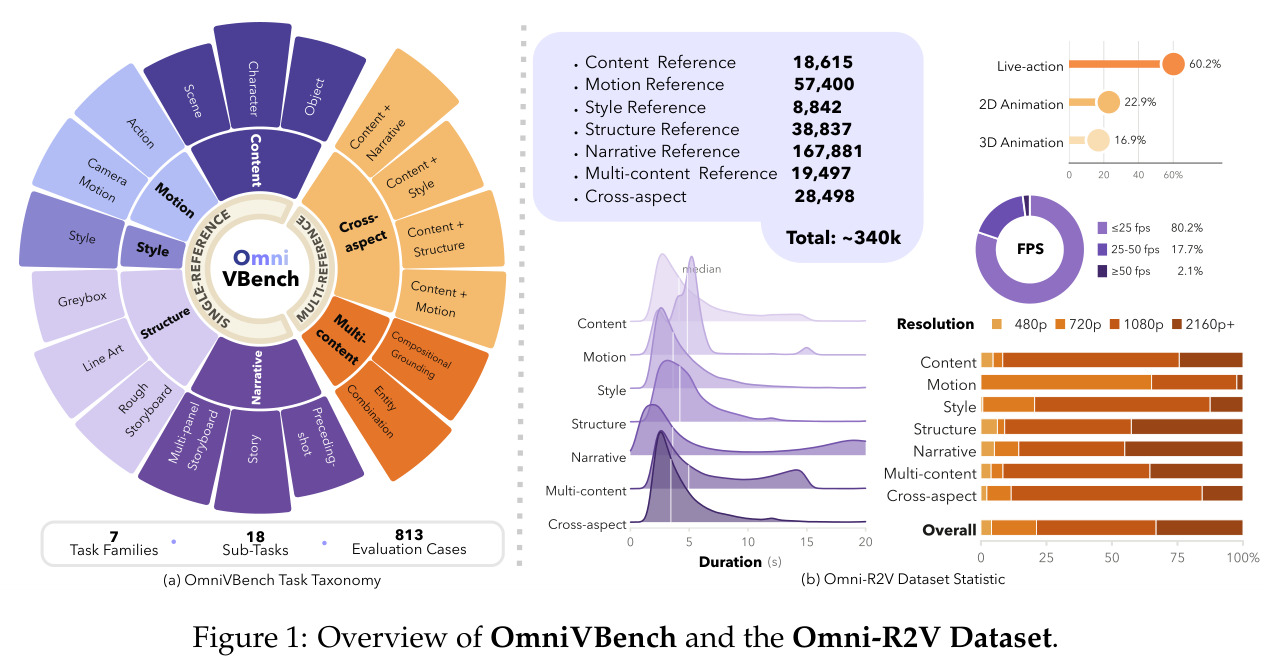
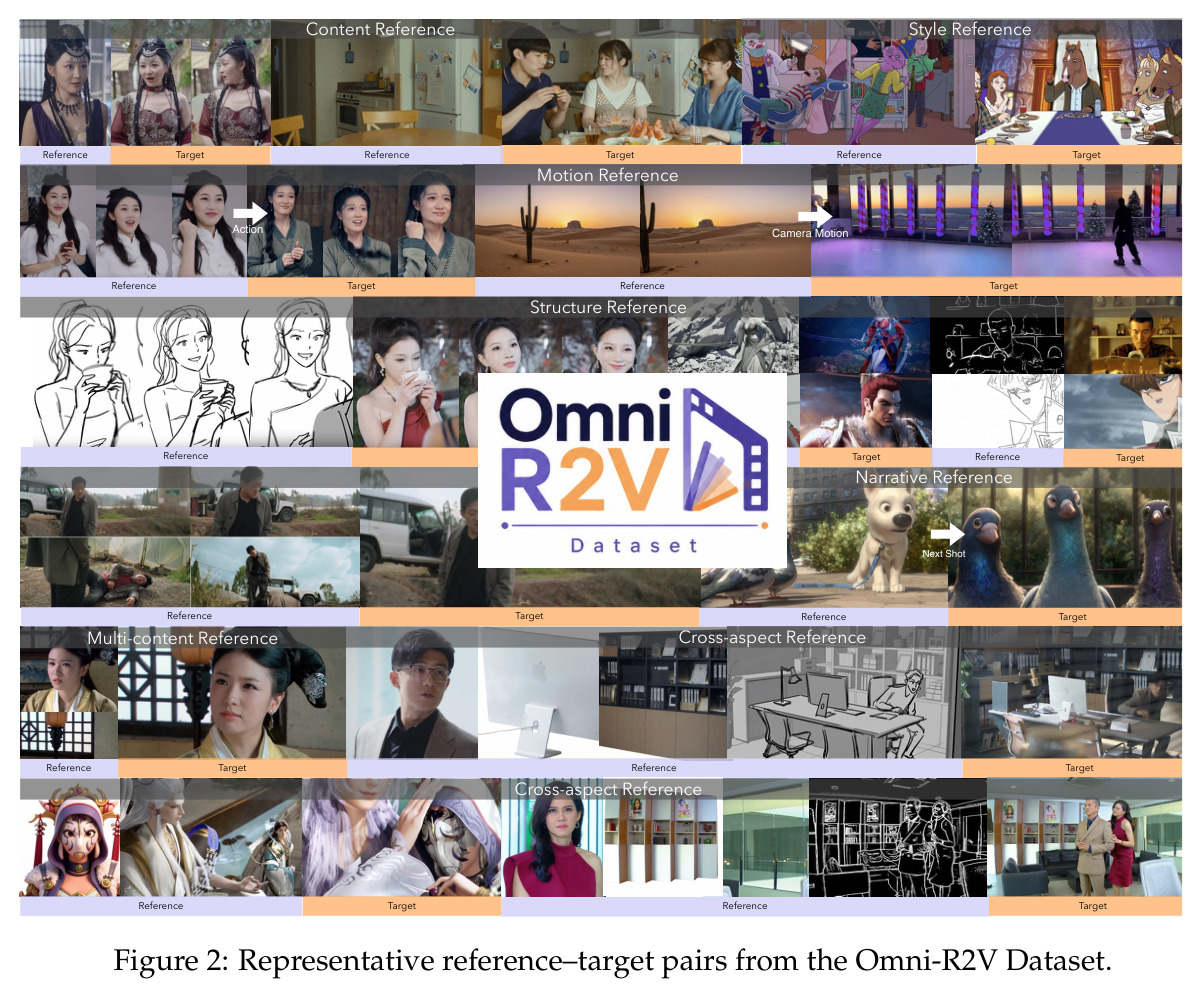
左侧展示 OmniVBench 任务分类树:7 个任务族、18 个子任务、813 个评测用例;右侧展示 Omni-R2V 数据集统计:叙事参照 167,881、运动参照 57,400、结构参照 38,837、跨维度 28,498、多内容 19,497、内容 18,615、风格 8,842,合计约 34 万样本,并附时长、帧率与分辨率分布。
一张图总览论文两大贡献(基准与数据集)的规模和构成,是快速把握全文体量的入口。
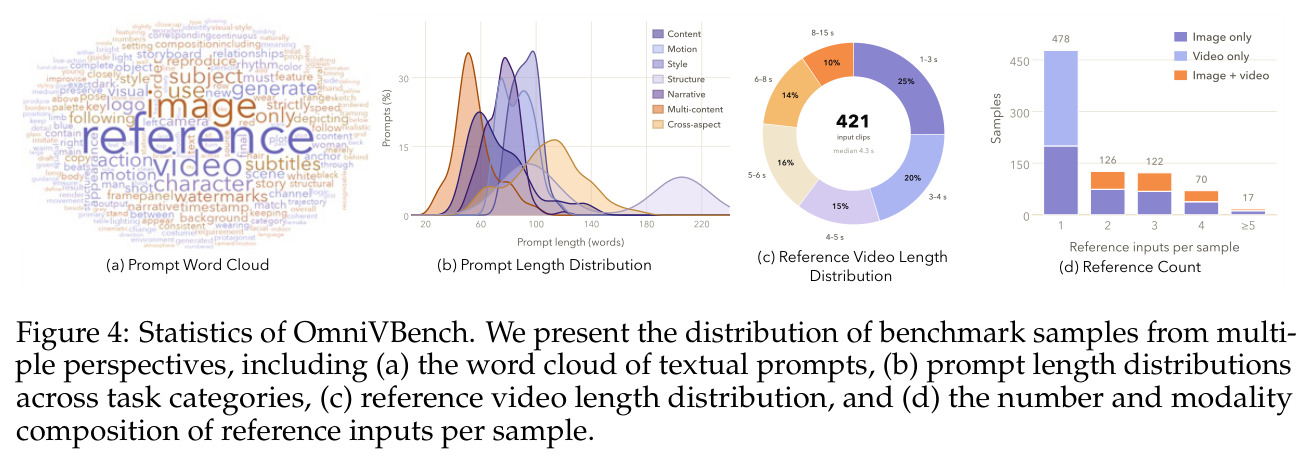
四个子图分别展示:评测提示词的词云、各任务类别的提示词长度分布、参照视频时长分布、每个样例的参照输入数量与图像/视频模态构成。
证明基准在指令复杂度、参照时长与参照数量上的多样性设计,支撑其『覆盖真实创作工作流』的主张。
列出 18 个子任务的评测用例数:内容 112(物体 33/角色 54/场景 25)、运动 95(动作 47/镜头运动 48)、风格 43、结构 108(灰盒 19/线稿 44/粗分镜 45)、叙事 120(多格分镜 45/故事 50/前镜头 25)、多参照 335(多内容 112/跨维度 223),总计 813。
给出基准的精确构成,便于研究者评估各子任务结论的统计强度并按需使用子集。
展示一个 4 参照输入的多参照用例的完整清单:RF 部分含实体/场景身份、表面(花纹)保真等问题,IR 部分含因子-载体分离(不得出现参照中其他人物、背包本身)、保留/修改分区、条件-槽位对应、动作实现等,并给出 11 个模型得分(UniVideo RF 33.2/IR 14.8 至 Seedance 2.5 双 100)。
清单评测从抽象协议到具体问题的最完整展示,理解 IRDR 如何落地的最佳材料。
每个任务族抽约 100 条训练样本、双标注员独立判定通过率:参照可用性均值 95.4%、参照—目标一致性 97.0%、指令正确性 94.2%,总均值 95.5%;运动族最低(89.7%),风格族最高(98.2%)。
34 万训练样本质量的量化背书,同时暴露运动族配对噪声更大的短板,对想用该数据训练的人最实用。