模型冻结、专长进化:面向多模态医疗AI的模型无关部署经验学习 Frozen Models, Evolving Expertise: Model-Agnostic Learning from Deployment Experience for Multimodal Medical AI
让冻结的LLM/VLM用技能、知识记忆与多模态知识库从部署经验中持续进化
前置知识
冻结模型与部署后学习
LLM/VLM 部署后参数固定,不再从实际服务的病例中学习。传统更新方式是微调或强化学习,但它们需要访问模型权重、承担训练成本,且对闭源模型(如 GPT-4o-mini)完全不可行。参数无关方法则把学到的经验(反思、技能文档、事实)存放在模型外部,通过提示词或工具调用注入,使任何模型无需改权重即可受益。
本文的核心设定就是'参数冻结、只动外部专长',理解这一约束才能明白为什么作者选择技能文档、知识记忆和多模态知识库这三种外部载体,而不是直接微调。
固定验证集过拟合(自适应数据分析)
如果反复在同一批验证样例上挑选更新,系统会逐渐'记住'这些样例的特殊性,选出的更新看似有效却无法泛化到新数据,这就是 Dwork 等人指出的自适应数据分析风险。EvoSkill、SkillOpt 等方法都用固定验证集挑选技能更新,因此存在此隐患。解决办法是在新到达的数据上测试,同时用滚动缓冲区代表历史数据防止遗忘。
本文验证策略的全部动机就在于绕开固定验证集:每次更新必须在未见的新病例上带来正增益,且不能拉低历史缓冲区表现,这是全文区别于 ACE/SkillOpt 的关键。
多模态知识库与相似度检索
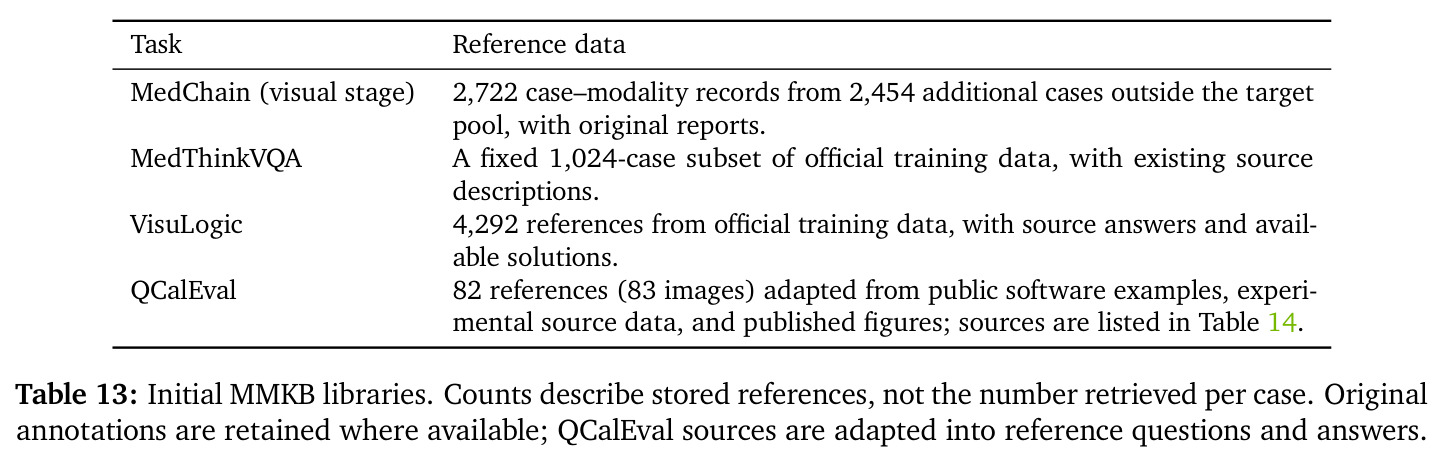
MMKB 保存原始图像、问题/上下文、源答案与已有解释,用固定的多模态编码器把图像和问题文本联合编码为向量,通过余弦相似度检索相关参考病例。检索时会排除当前病例本身、其来源组病例及重复图像,防止'自己检索自己'造成的数据泄露。它与 RAG 的区别在于:不仅提供参考内容,还指导模型如何使用这些参考。
MMKB 是本文三大组件中最具新意的一个,医学影像任务的增益几乎全部来自它(消融中去掉 MMKB 后 QCalEval 掉 14.0%),不掌握多模态检索机制就读不懂实验设计。
技能文档与整体重写
Skill 是一份自然语言文档,描述解题步骤、适用条件和何时无需额外动作,例如'对咳嗽发热患者,当生命体征或肺部查体异常时才开胸片'。每个 batch 后优化器基于得分轨迹重写整份文档而非追加:追加会让文档越来越长并留下冲突规则(上下文膨胀、规则矛盾都会损害性能),重写则合并、删减、收紧规则并受长度上限约束。
'重写而非追加'是本文相对 ACE 这类只增不减方法的明确设计决策,消融显示去掉 Skill 后 MedChain 掉 12.1%,是文本类任务最大的增益来源。
研究动机
LLM 和 VLM 部署后参数通常被冻结,模型解决了病例却不会从中学习。这在医学中尤其危险:新的临床证据、更新的指南和新疗法会不断改变既有诊疗规范(Shojania 等,2007),一个无法积累经验的模型遇到相似病例时只能从零开始,甚至重复犯同样的错误。现有更新路径各有硬伤:微调和强化学习需要访问模型权重并承担训练成本,对闭源模型根本不可行,且质量依赖训练数据;EvoSkill、SkillOpt 等参数无关方法虽然不训练,但依赖固定验证集来挑选技能文档更新,反复在同一组验证病例上选择会造成过拟合(Dwork 等,2016 指出的自适应数据分析问题),损害对新病例的泛化;Reflexion、ExpeL、ACE 等方法把经验以纯文本形式存回上下文,会丢失关键的视觉细节;而仅从交互轨迹中提取的经验,又可能缺乏新病例所需的可靠领域知识。
本文的目标是本文要构建一个模型无关的学习框架,让冻结参数的 LLM 和 VLM 在在线部署过程中,通过积累和更新'外部专长'持续变强,且完全不触碰模型权重。框架需要同时覆盖三类医学共性需求:可复用的诊断与工具使用流程(Skill)、有证据支撑的可靠医学事实、以及可参照的视觉病例模式。同时必须设计一套验证机制,保证每一条被接受的更新在未见过的病例上有效、且不损害历史病例表现,从而把部署经验转化为真正可复用的专长,而非对已见病例的修正。
与已有工作不同的是,本文的独特切入是三点组合:其一,用'新病例 + 滚动历史缓冲区'的双重验证取代固定验证集,直接针对 EvoSkill/SkillOpt 的过拟合隐患——候选更新只有在 $F_t$ 上平均增益为正且胜场不少于败场、同时在缓冲区 $B_t$ 上不退步才被接受;其二,引入多模态知识库 MMKB,保留图像、源答案和解释这一原始证据链,而此前方法(Reflexion、ExpeL、ACE)均以文本保存经验;其三,MMKB 不只是检索上下文,还指导模型审查每个参考病例的证据如何支持其源答案、再与当前病例比较异同,这与 Med-RAG 等只做检索供给的系统有本质区别。由于专长完全外置,它还能零成本迁移到其他模型。
核心方法
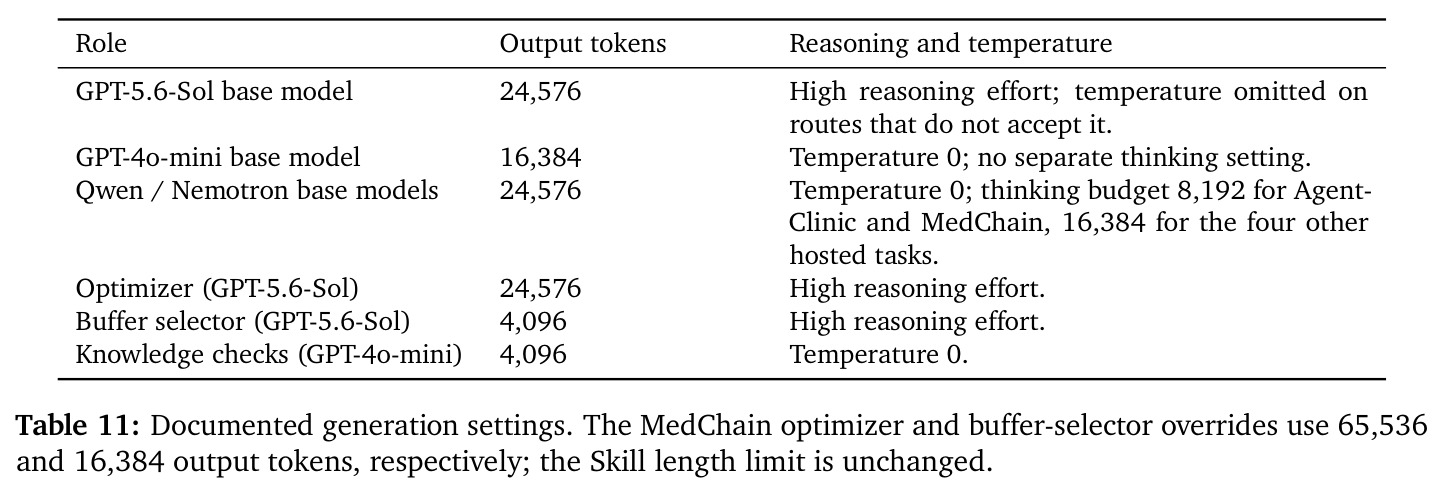
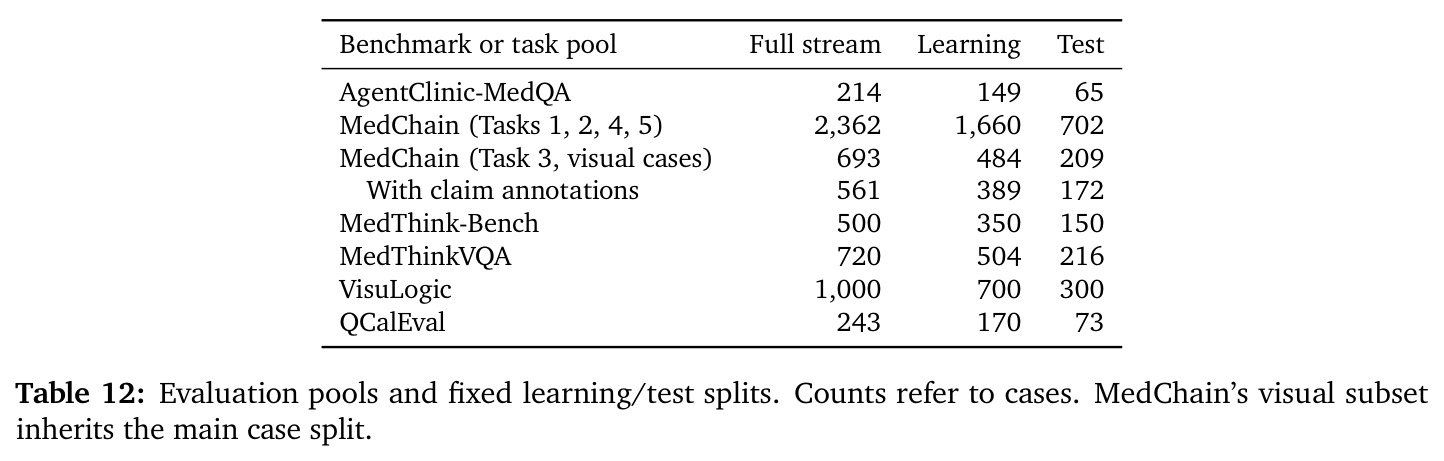
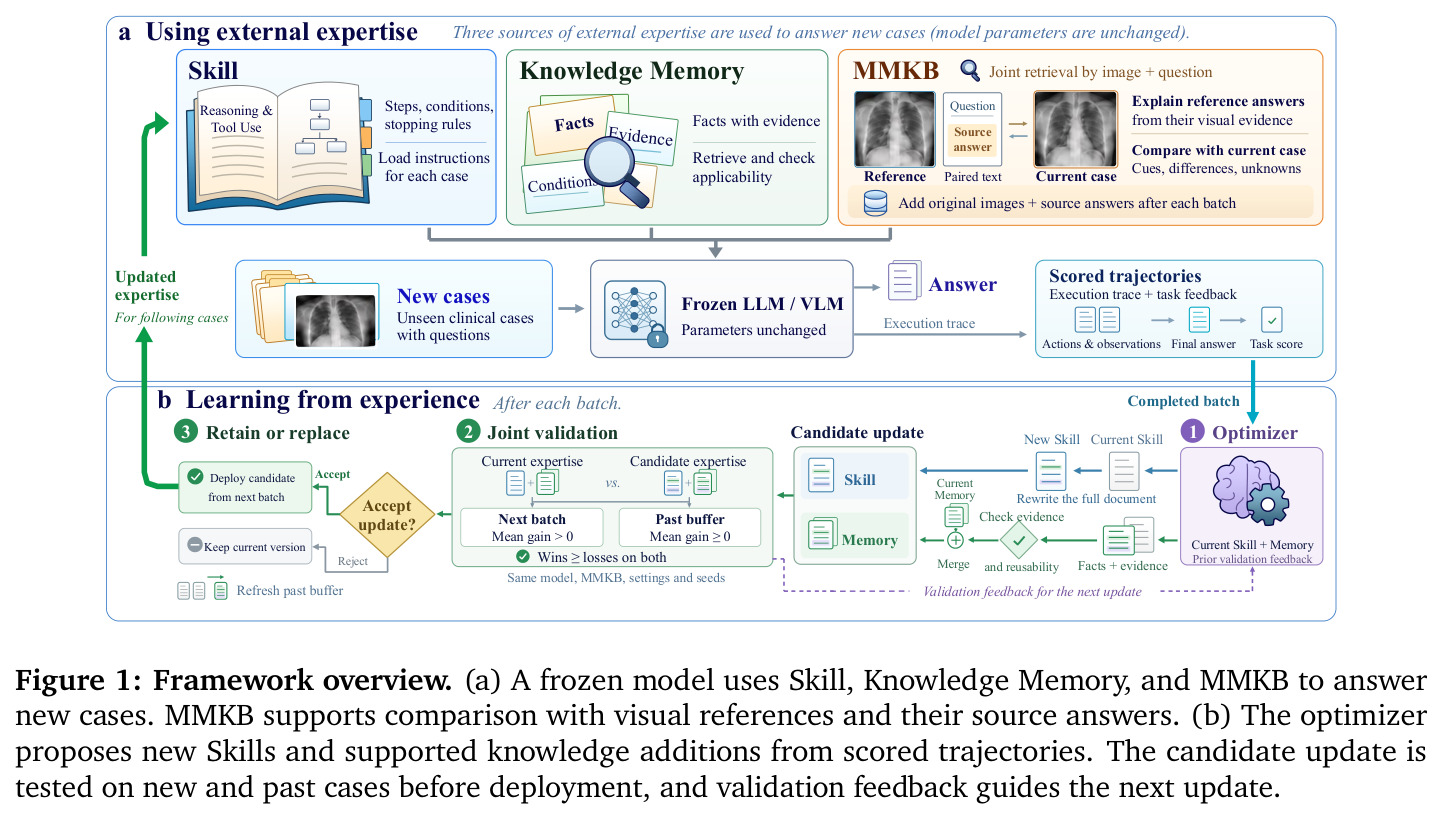
直觉上,这个框架把'经验'拆成三种外部资产:怎么做(Skill)、知道什么(Knowledge Memory)、见过什么(MMKB)。技术路线是流式批处理:冻结模型依次处理病例批 $F_1, F_2, \ldots$,第 $t$ 批使用的专长记为 $\mathcal{E}_t = (S_t, K_t, V_t)$。模型先带着当前专长回答整批病例,之后数据集才释放任务得分和源答案(此时病例才算'已验证'),因此反馈只会影响后续批次。每个 batch 结束后,优化器(GPT-5.6-Sol)审查当前 Skill、Memory、已打分的执行轨迹以及上一轮候选的验证反馈,重写整份 Skill 并提出有证据支撑的知识增补;候选更新 $(\tilde{S}_t, \tilde{K}_t)$ 先在与 $\mathcal{E}_t$ 相同的模型、MMKB、设置和随机种子下,分别在新批 $F_t$ 和历史缓冲区 $B_t$ 上回放对比,通过验收条件才部署为 $\mathcal{E}_{t+1}$。与此同时,$F_t$ 中所有带图像且有源答案的病例被存入 MMKB,形成 $V_{t+1}$。实验中每批 32 个病例,随机种子固定为 42。
核心创新有三层。第一,验证策略:候选更新必须在全新病例 $F_t$ 上满足 $\Delta_{F_t} > 0$ 且 $W_{F_t} \geq L_{F_t}$(增益均值和胜负场双重标准),同时在历史缓冲区 $B_t$ 上满足 $\Delta_{B_t} \geq 0$ 且 $W_{B_t} \geq L_{B_t}$,其中 $\Delta_D = \frac{1}{|D|}\sum_{i \in D}\left[s_i(\tilde{\mathcal{E}}_t) - s_i(\mathcal{E}_t)\right]$。连续分数任务上加胜负条件是为了拒绝'少数病例大幅提升、多数病例下降'的候选。这与 ACE '来者不拒'式积累和 SkillOpt '固定验证集反复挑选'形成鲜明对比——消融中去掉验证机制后六个基准全部掉到 Base 之下。第二,MMKB 引导参考病例的'用法'而非仅'选法':要求模型先解释参考病例的图像证据如何支持其源答案,再识别哪些观察和条件适用于当前病例,并考虑差异与矛盾后才作答。第三,Skill 采用整体重写而非追加,控制上下文长度并消除规则冲突。
方法步骤详情
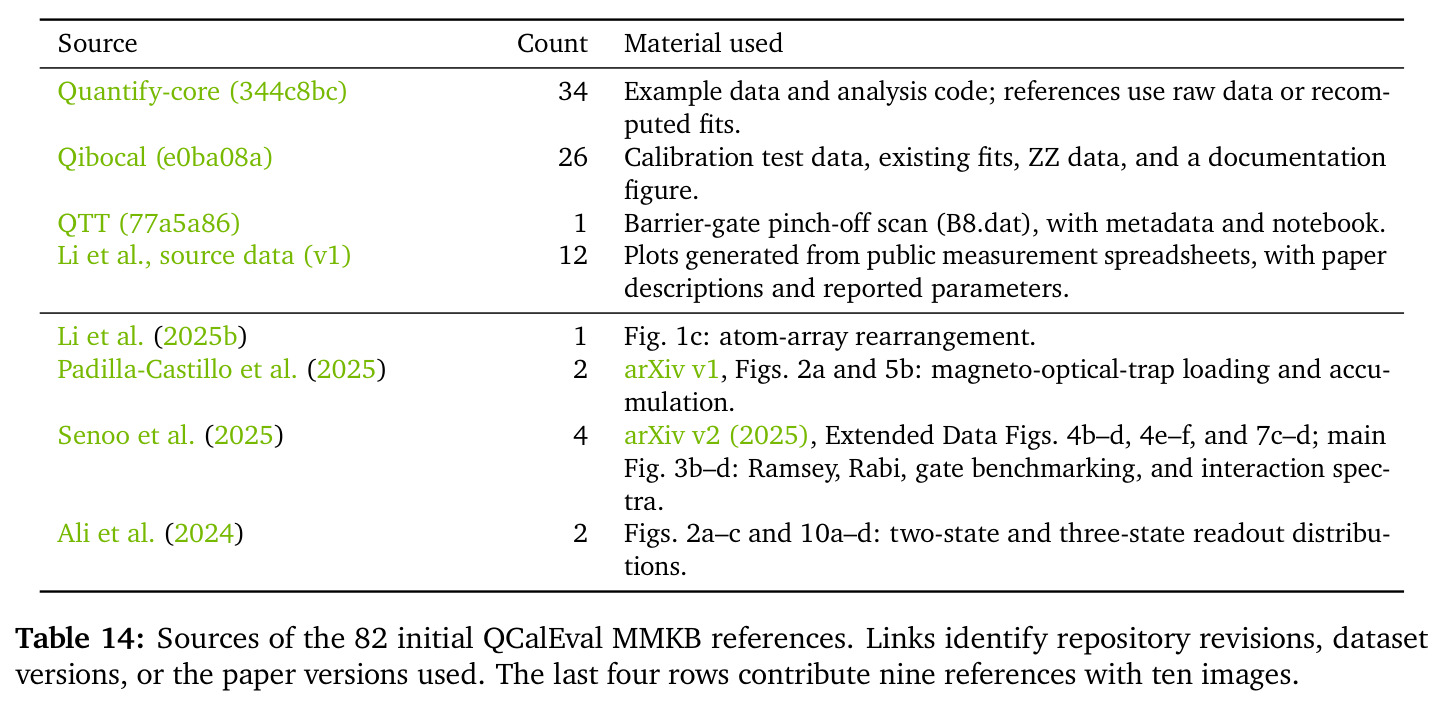
第一步,答题:模型接收 Skill $S_t$ 作为任务指令的一部分,通过工具调用查询 Knowledge Memory(文本检索找到候选条目后,由独立模型检查是否直接回答问题且适用于当前病例,无合适条目则检索 PubMed 等可信外部源),视觉任务上用固定多模态编码器对图像+问题做联合余弦相似度检索 MMKB 参考(排除当前病例、来源组病例和重复图像)。第二步,反馈释放:整批答完后任务得分和源答案才公布。第三步,优化器提案:GPT-5.6-Sol 综合当前专长、打分轨迹和上一轮验证反馈,重写完整 Skill(增补缺失步骤、修订过宽规则、删除无益指导、控制长度,且被禁止包含病例标识符或答案键),并从已完成病例中提炼知识候选——基于病例的提案必须引用支撑轨迹并摘录证据,通常需多个病例支撑,单个病例仅在可信外部源直接佐证时才可接受,患者特异性观察和答案键被排除。第四步,联合验证:候选与当前版本在相同模型、MMKB、设置和种子下分别作答 $F_t$ 与缓冲区 $B_t$,按上述条件决定接受或保留原版;重放缓冲区病例时把该病例自己的 MMKB 条目从检索中剔除。第五步,缓冲区刷新与回滚检查:LLM 仅依据任务目标和问题文本(不看不看答案与分数)刷新缓冲区使其覆盖问题分布;周期性地将当前版本与更早的保留版本在缓冲区上比较,表现更差则回滚。第六步,MMKB 生长:$F_t$ 中有图像且有源答案的病例连同源答案和已有解释(而非模型自己的预测)存入 $V_{t+1}$,即使答错的病例也能成为有用参考,且这些参考不随 Skill/Memory 更新被拒而回滚。
技术新颖性
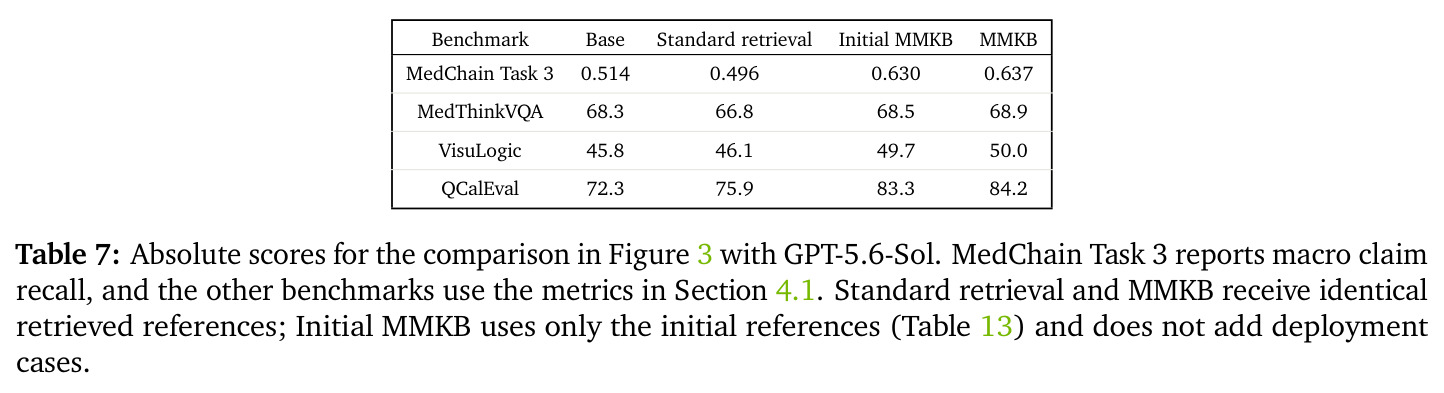
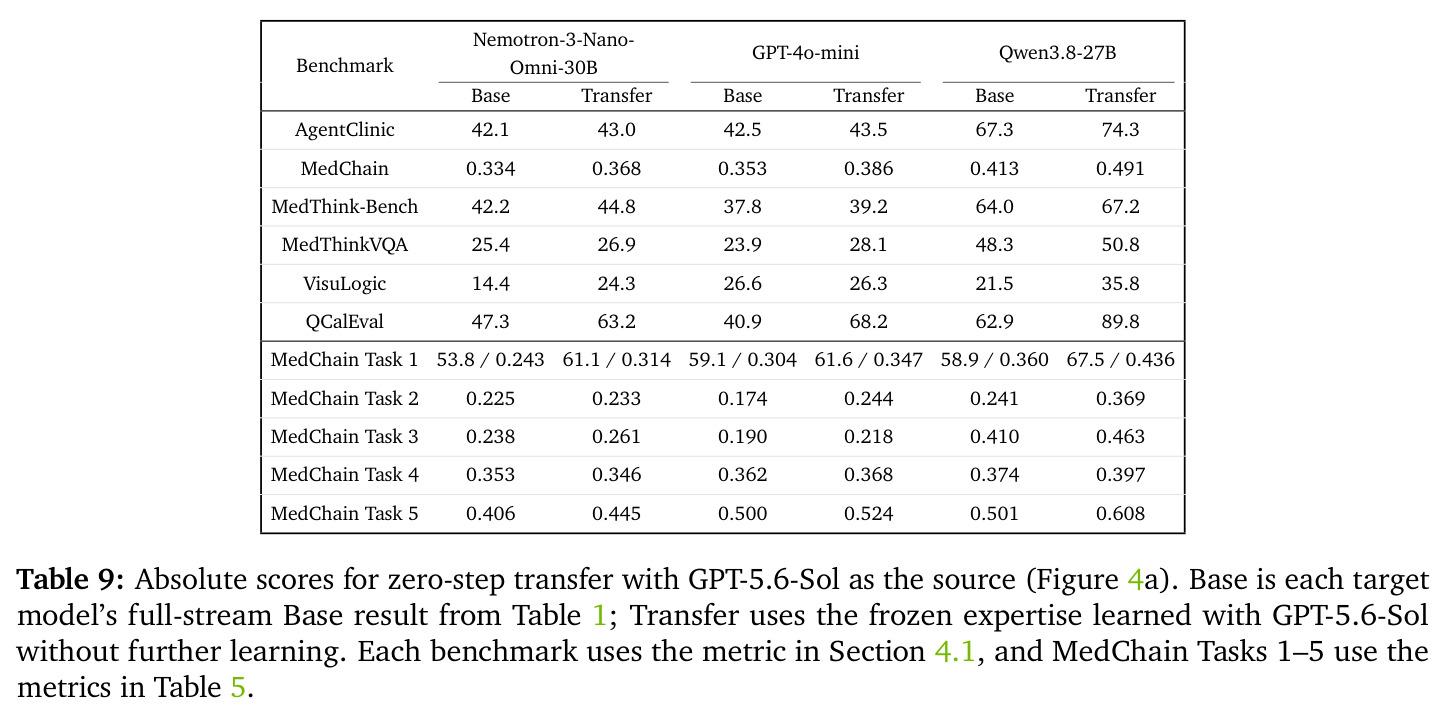
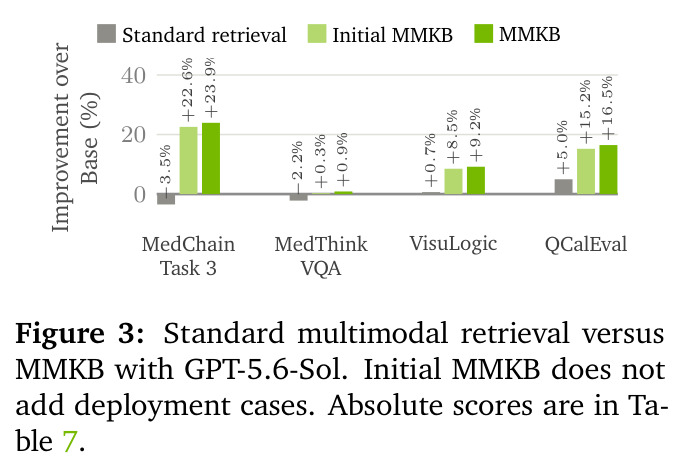
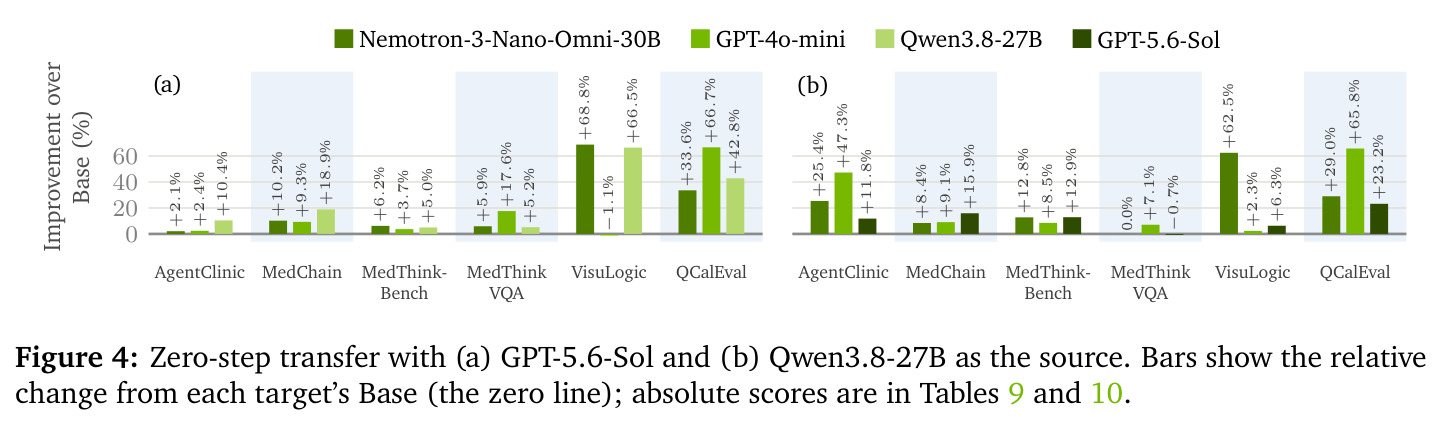
从技术新颖性看:本文不是又一个经验积累方法,而是把'经验的质量控制'作为一等公民——通过新批与缓冲区的双面验收加周期性版本回滚,系统性压制验证集过拟合,这在参数无关学习文献中是新的;比较对象 ACE 平均增益 5.6% 且在 7 个基准-模型组合上低于 Base,正是缺乏这种检查的直接后果。其次,MMKB 的贡献不在存储而在使用协议:图 3 显示在检索内容完全相同的前提下,标准多模态检索相对 Base 变化为 -3.5% 到 +5.0%,甚至在一些任务上为负,而 MMKB 凭借'先解释参考证据、再对比当前病例'的指导把同样内容变成高达 +23.9%(MedChain Task 3)的增益,说明多模态 RAG 的瓶颈在于参考的使用方式。最后,专长与模型解耦带来零步跨模型迁移能力:开源 Qwen3.8-27B 学到的专长可直接提升闭源 GPT-5.6-Sol,这是微调路线在结构上无法做到的。
实验结果
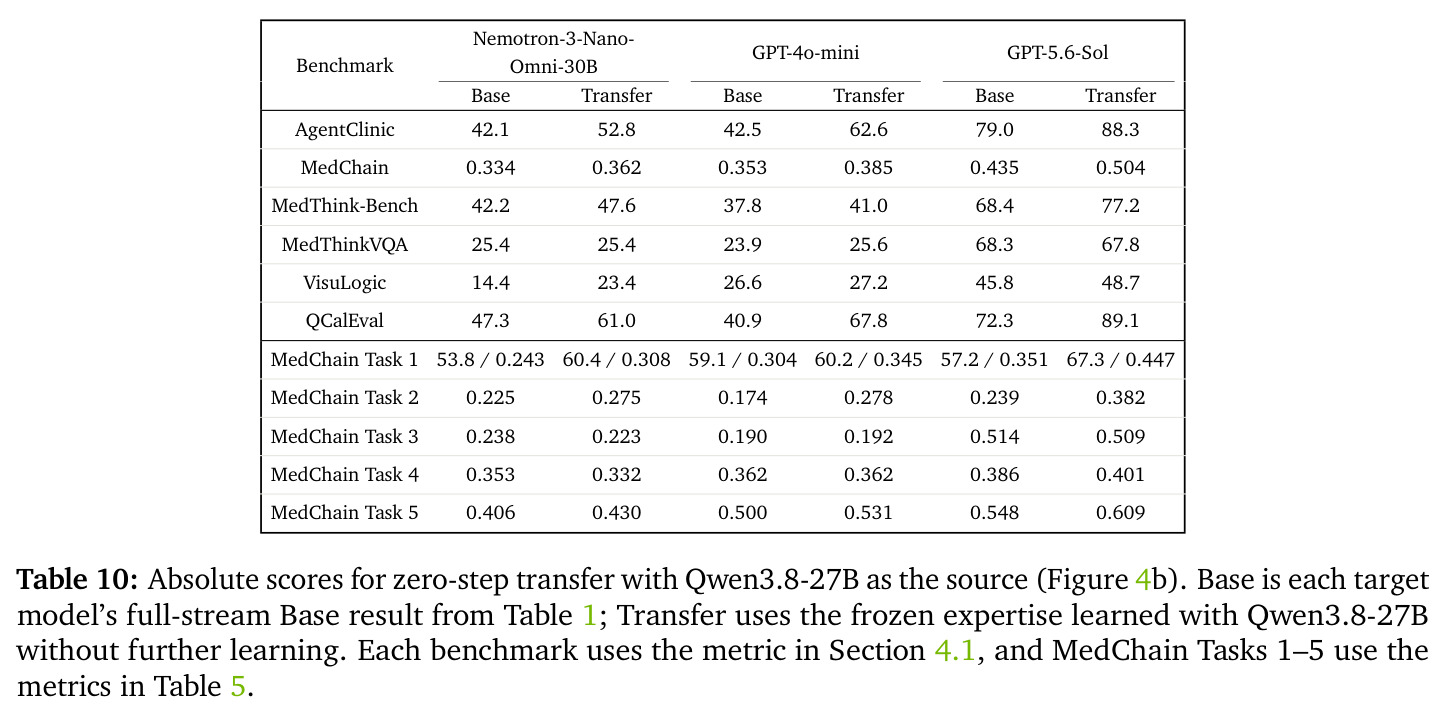
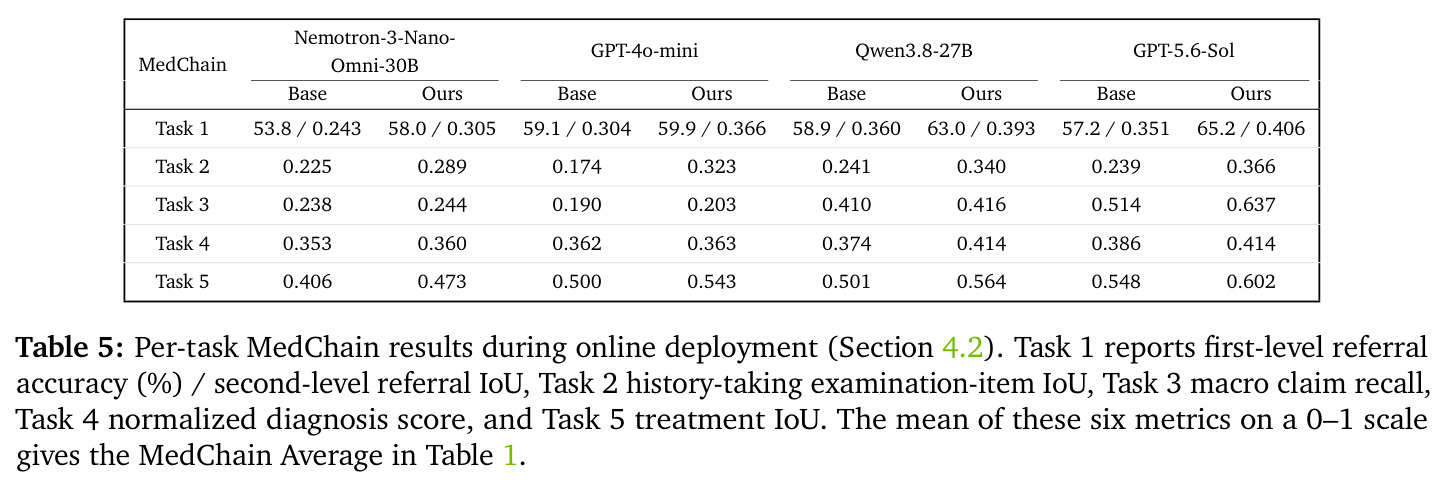
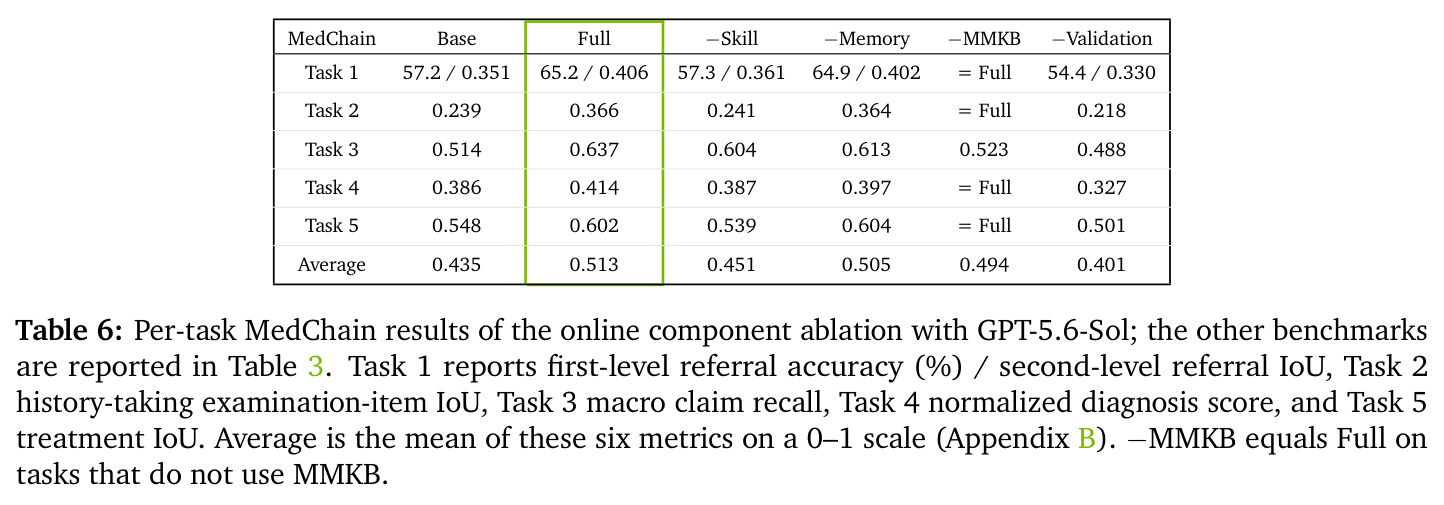
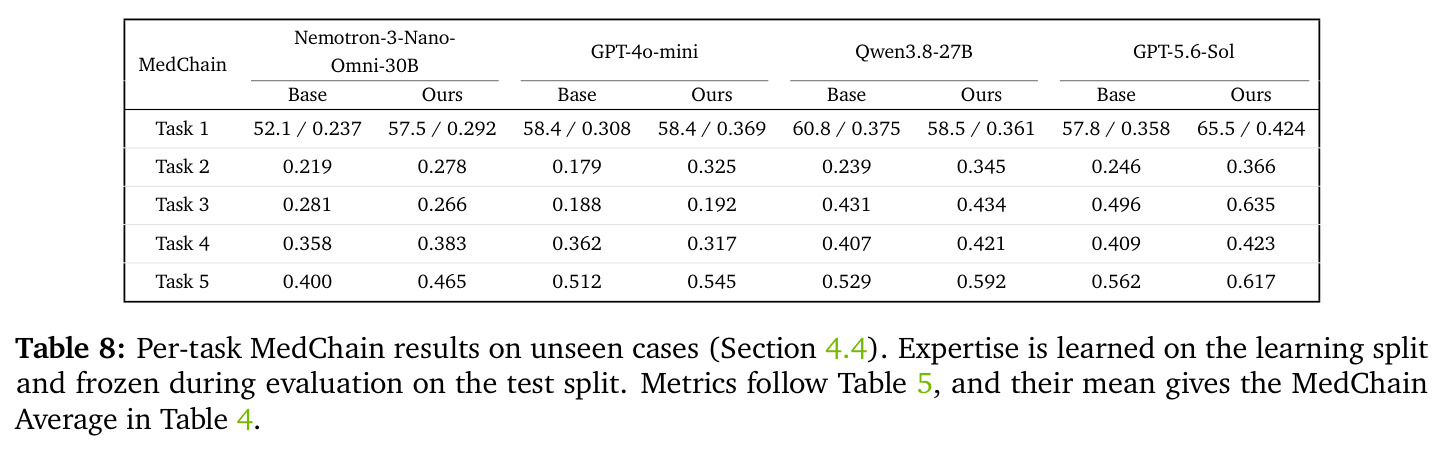
在线协议(Table 1):四个基座模型 × 六个基准共 24 个组合,本文方法全部高于 Base、其中 22 个取得最佳,相对 Base 平均增益 17.6%,而 ACE 仅 5.6% 且有 7 个组合低于 Base。最大增益出现在流程可复用性强的任务上:AgentClinic 用 Nemotron-3-Nano-Omni-30B 达 +34.2%(42.1→56.5),VisuLogic 用 Qwen3.8-27B 达 +81.9%(21.5→39.1),QCalEval 用 GPT-4o-mini 达 +43.0%(40.9→58.5);GPT-5.6-Sol 上 QCalEval 72.3→84.2(+16.5%)、MedChain 0.435→0.513(+17.9%)。独立问题型基准增益较小(MedThink-Bench 0.4%–5.0%,MedThinkVQA 0.4%–2.8%)。鲁棒性(Table 2):五个随机病例顺序下 AgentClinic 为 83.8±0.9 对 Base 79.3±0.7,QCalEval 为 83.1±1.5 对 71.3±1.8,差距至少是最大标准差的五倍。消融(Table 3):去 Skill 使 MedChain 掉 12.1%、AgentClinic 掉 5.5%(回落到 Base 水平);去 MMKB 使 QCalEval 掉 14.0%(84.2→72.4)、VisuLogic 掉 8.2%,视觉增益几乎全部来自 MMKB;去 Memory 影响较小,最大为 MedThink-Bench 的 2.5%;去掉验证机制则六个基准相对 Full 掉 21.8%–37.8%,且全部低于 Base。MMKB 与标准检索对比(Figure 3):相同检索内容下,MMKB 在全部四个图像任务上为正,最高 MedChain Task 3 +23.9%;只用初始参考(Initial MMKB)已达 +22.6%。冻结泛化(Table 4):用流的前约 70% 学习后冻结、在其余病例上评估,本文 21/24 组合高于 Base、19 个最佳,平均 +20.7%,远超 SkillOpt 的 8.3% 和 ACE 的 1.9%,且本文仅在 1 个组合上低于 Base(Nemotron 的 MedThinkVQA,-3.6%),而 SkillOpt 有 7 个、ACE 有 12 个。零步迁移(Figure 4):36 个迁移结果中 33 个改善,平均 +20.0%;开源 Qwen3.8-27B 学到的专长让闭源 GPT-5.6-Sol 在 AgentClinic 提升 11.8%、QCalEval 提升 23.2%,让较弱的 GPT-4o-mini 在 AgentClinic 猛增 47.3%。
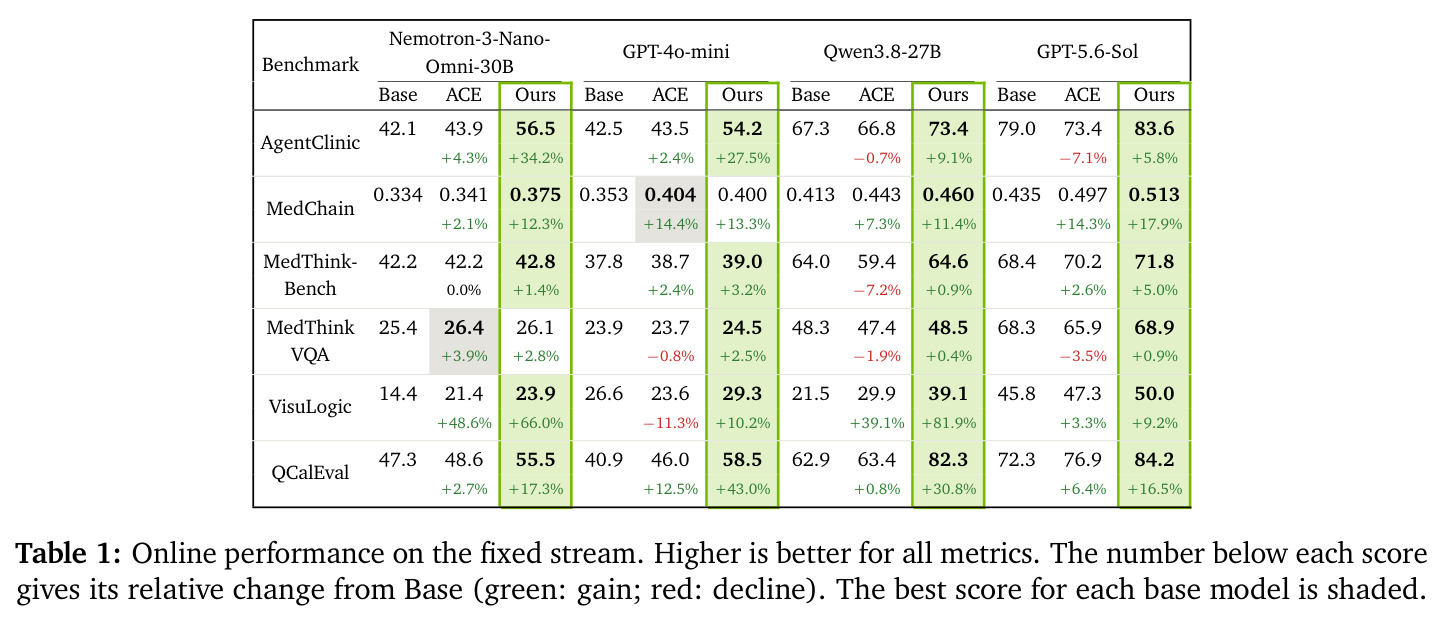
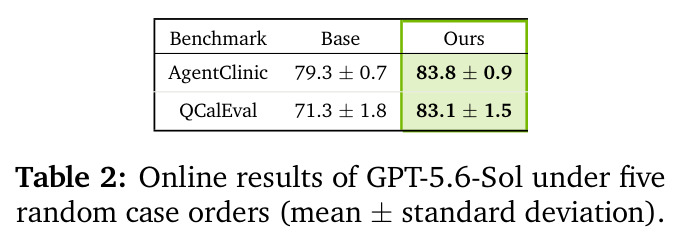
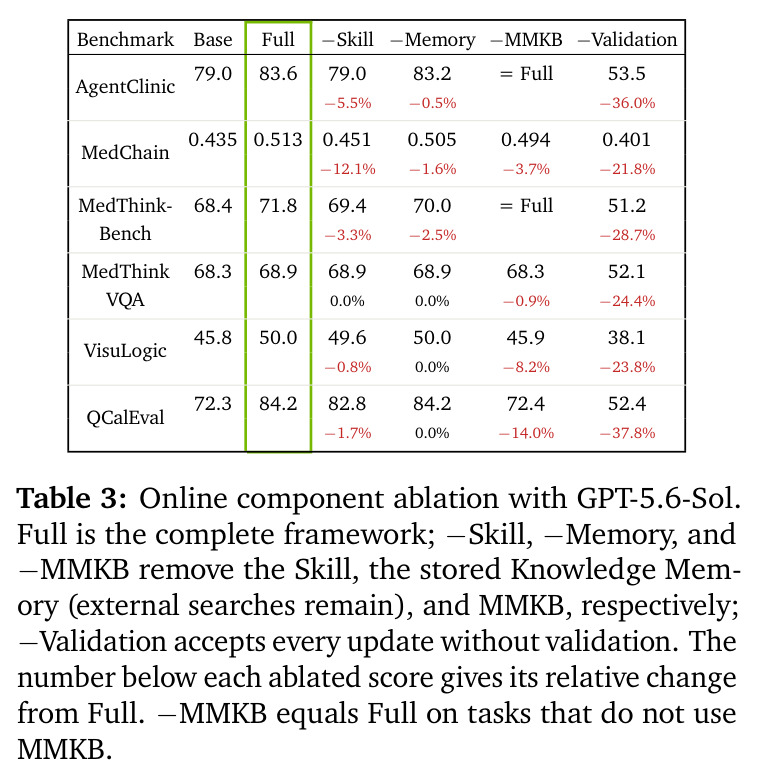
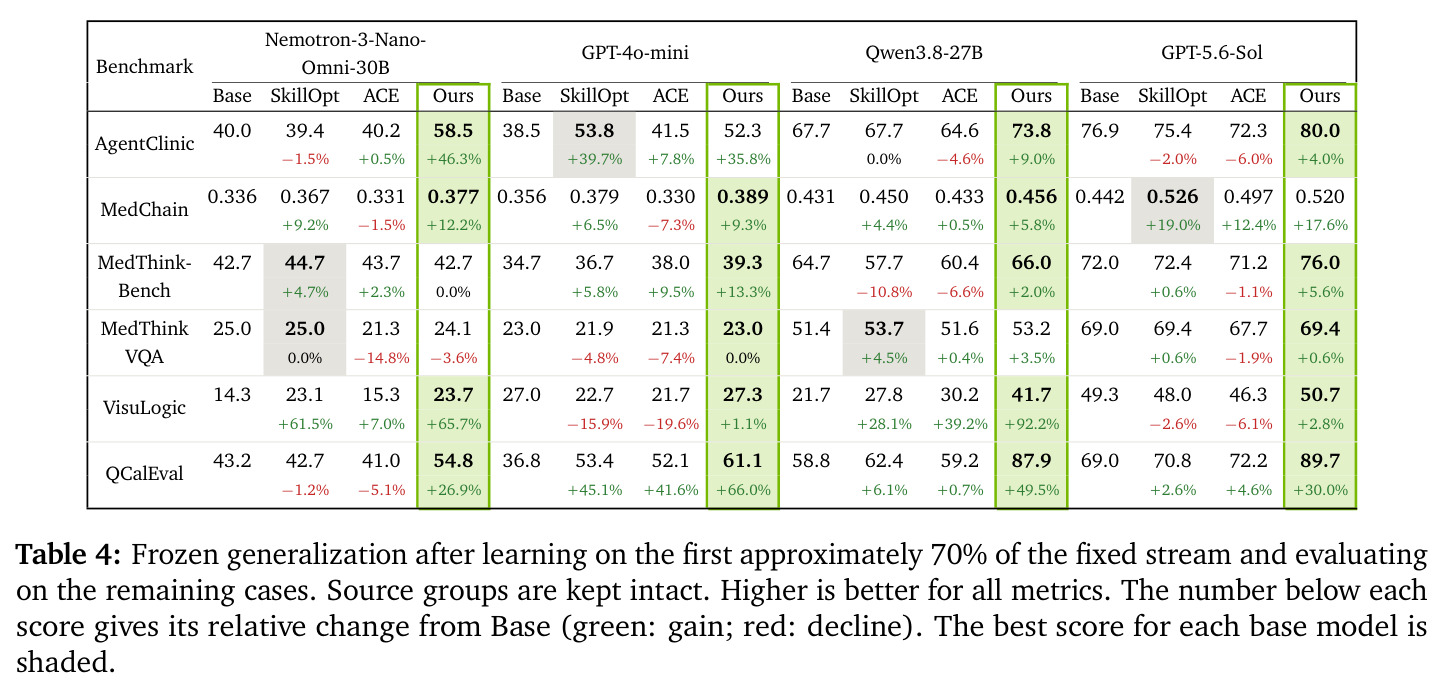
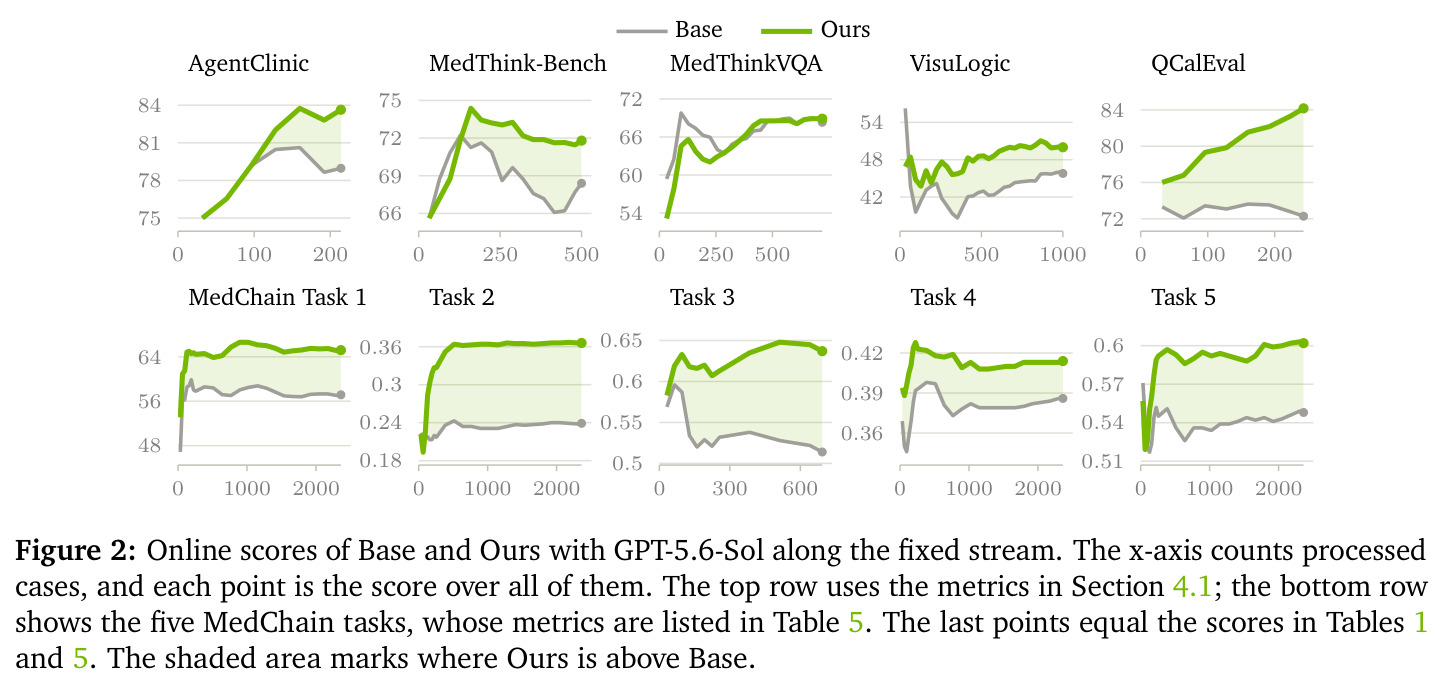
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AgentClinic-MedQA(交互式临床诊断,Nemotron-3-Nano-Omni-30B) | 诊断准确率 (%) | 56.5 | Base 42.1 / ACE 43.9 | +34.2%(相对 Base),ACE 仅 +4.3% |
| VisuLogic(视觉逻辑推理,Qwen3.8-27B) | 答案准确率 (%) | 39.1 | Base 21.5 / ACE 29.9 | +81.9%(相对 Base),ACE +39.1% |
| QCalEval(量子校准推理,GPT-4o-mini) | 官方总分 | 58.5 | Base 40.9 / ACE 46.0 | +43.0%(相对 Base),ACE +12.5% |
| MedChain(多阶段临床工作流,GPT-5.6-Sol) | 五任务六指标 Average (0–1) | 0.513 | Base 0.435 / ACE 0.497 | +17.9%(相对 Base),ACE +14.3% |
| 冻结泛化(学习前 70% 后在未见病例上评估,24 组平均) | 相对 Base 平均相对提升 (%) | +20.7%(21/24 组合优于 Base) | SkillOpt +8.3% / ACE +1.9% | 约为 SkillOpt 的 2.5 倍、ACE 的 11 倍 |
| 零步跨模型迁移(36 个迁移组合) | 相对目标模型 Base 平均提升 (%) | +20.0%(33/36 改善;Qwen→GPT-4o-mini 的 AgentClinic 达 +47.3%) | 各目标模型自身 Base | 开源模型所学专长可无损迁移至闭源模型 |
局限与改进
作者承认的局限:框架依赖病例的源答案最终可用(病例需被验证才能转化为经验和 MMKB 条目),反馈只能影响后续批次;对独立问题型基准(MedThink-Bench、MedThinkVQA,增益仅 0.4%–5.0%)帮助有限,因为这类任务更依赖模型自身的医学知识而非可复用流程;MedThinkVQA 在 Nemotron 的冻结评估中出现唯一一次低于 Base(-3.6%)。我的补充观察:第一,优化器本身是 GPT-5.6-Sol,这意味着框架效果部分受制于优化器能力,且每批的优化器调用、候选回放(每个新病例被额外作答一次、缓冲区反复重放)带来可观的推理成本,论文未报告开销数字;第二,MMKB 无限期保留所有已完成病例的图像和源答案,在真实临床部署中涉及 PHI 隐私、存储与合规问题,论文未讨论遗忘或淘汰机制;第三,验收规则(增益>0、胜场≥败场)虽直观,但在小批次 32 例上统计功效有限,可能漏掉真有用或放进噪声更新,缺乏理论保证;第四,六个基准得分依赖各基准官方评分方式(部分含 LLM 评分),经验可能向评分器偏好过拟合。
独立分析的弱点
弱点一:验证的推理开销被低估。每个批次中,候选专长需要在 $F_t$ 和缓冲区 $B_t$ 上额外完整作答一遍,缓冲区还会周期性重放和做版本回滚比较,总推理调用量数倍于纯部署;在真实医院流水中,这意味着每诊断 32 个病例就要多花数倍算力。改进方向:用轻量代理指标(如检索命中率、中间步骤质量)预筛候选,只对通过初筛的候选做完整回放,或对缓冲区采用分层采样而非全量重放。弱点二:知识增长无遗忘管理。MMKB 只进不出,长期部署后检索空间膨胀、旧参考可能过时(医学指南会更新),论文没有条目过期或冲突消解机制。改进方向:引入基于时间戳和外部证据版本的知识条目生命周期管理,允许带证据的降级和归档。弱点三:优化器单点依赖。所有 Skill 重写和知识提炼都由 GPT-5.6-Sol 完成,优化器偏误会系统性注入专长,且论文未测优化器换挡的敏感性。改进方向:报告不同优化器下的方差,或用多个优化器提案再由验证机制择优。弱点四:批次验收粒度粗。整个候选包(Skill+Memory)一起接受或拒绝,无法保留其中有益的一半。改进方向:对知识条目做逐条消融式验收,Skill 用规则级 diff 验证。
未来方向
作者方向:论文结论指出该框架已验证可跨医学与非医学域工作,自然延伸是把部署经验积累做成跨机构共享的专长库(不同医院各持私有病例流,共享脱敏后的 Skill/Memory/MMKB);以及研究专长随时间漂移的处理——医学指南更新后旧知识条目需要被证据驱动地修订。基于成果可延伸的方向:其一,把外置专长蒸馏回权重——外部专长迁移免费但推理时仍需检索开销,可周期性用积累的病例与专长对开源模型做微调,压缩检索依赖;其二,验收规则的理论化——将其与自适应数据分析、差分隐私中的复用界联系,给出泛化保证;其三,主动学习式病例选择——当前被动接受批次顺序,可让系统主动请求对不确定病例的专家标注以加速专长积累;其四,MMKB 检索器的持续适配——目前编码器固定,可研究在不破坏证据链的前提下微调检索表示;其五,将 MMKB 的'先解释参考证据再对比当前病例'协议推广到其他多模态 RAG 场景(遥感、工业质检),检验其领域无关性。
复现评估
复现难度中等偏高。有利条件:六个基准全部为公开数据集(AgentClinic-MedQA、MedChain、MedThink-Bench、MedThinkVQA、VisuLogic、QCalEval),均有官方评分协议;四个基座中 Qwen3.8-27B 和 Nemotron-3-Nano-Omni-30B 是开放权重模型,可本地部署;论文附录 B 给出关键设置(数据集规模、检索设置、输入限制),附录 C 提供提示词模板,验收条件的数学定义完整(式 1、2),每批 32 例、种子 42 的协议也写明了。不利条件:优化器和两个基座(GPT-5.6-Sol、GPT-4o-mini)为闭源 API,随时间可能变更或下线,结果不可精确复现;论文正文未明确承诺开源代码,MMKB 初始参考数据的具体构成放在附录 Table 13,需自行核对;完整复现需要承担大量优化器与双重作答的 API/推理费用(尤其 VisuLogic 约 1000 例规模、MedChain 约 2000 例规模的在线流),粗估单次完整在线实验需数万次模型调用。建议复现策略:先用开源基座+开源优化器在小基准(如 VisuLogic)上跑通骨架,再评估是否值得复现闭源结果。
论文图表