从给定证据到主动收集证据:面向纵向医疗推理的智能体学习 From Given to Gathered Evidence: Agentic Learning for Longitudinal Medical Reasoning
把纵向医疗推理重构为证据搜寻任务,8B智能体经两阶段后训练准确率超越GPT-5
前置知识
GRPO(组相对策略优化)
无需价值网络的策略梯度算法:对同一提示采样 $G$ 条轨迹,用组内均值 $\bar R$ 和标准差归一化回报得到优势 $A_j$,该轨迹的所有助手 token 共享此优势,再以 PPO 式裁剪目标更新。本文每题采 8 条轨迹、批 16 提示,全参数训练视觉-语言模型。
CASE 的 RL 主干就是 GRPO,OPSD 惩罚与量规奖励都通过修改回报 $R_j$、在组归一化之前进入优势计算。不理解 GRPO 就无法理解为什么一个轨迹级的惩罚能反向塑造证据采集行为。
RSFT(拒绝采样微调)
先用强教师模型生成大量完整轨迹,再用质量过滤器筛选后对学生做监督微调。本文要求轨迹至少含一次工具调用,且由 Kimi K2.6 按量规打分满足 $s^{offd}\ge 0.4$ 才保留;SFT 损失只在助手 span 上算交叉熵(公式 (4)),工具返回的文本和图像仅作为条件上下文而非预测目标。
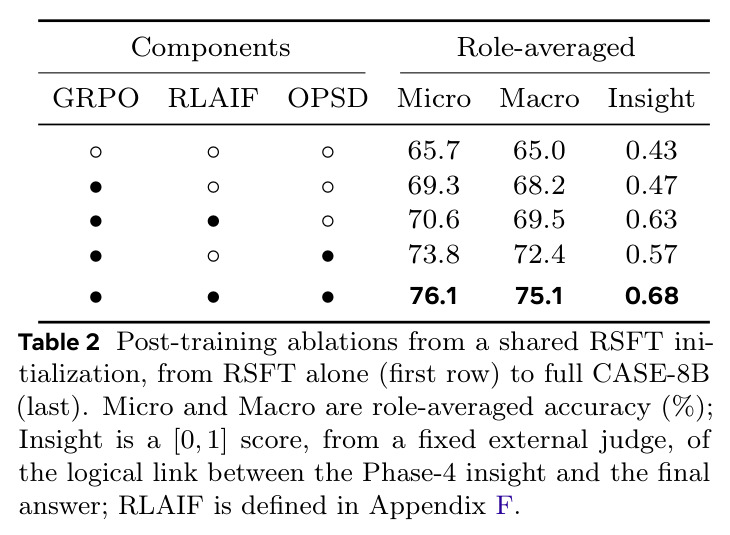
RSFT 是两阶段训练的冷启动:先让 8B 学生学会'会调工具、会按五阶段格式作答'。理解它才能读懂消融里 RSFT-only 65.7% 到完整 CASE 76.1% 的差距来自哪里。
反向 KL 散度与特权蒸馏
$D_{KL}(q\|p)=\sum_v q(v)\log\frac{q(v)}{p(v)}$ 以学生分布 $q$ 加权,惩罚学生在教师低概率事件上放质量。特权蒸馏指训练时构造带不可见信息(如参考答案)的'特权视角',再把普通视角与之对齐;本文将其用作冻结快照双前向的轨迹级奖励惩罚而非可微损失。
OPSD 是全文最核心的创新,其数学形式、top-128 分桶近似(覆盖约 98% 概率质量)和'进入组归一化之前'的插入位置全部建立在反向 KL 的性质与界(命题 2)之上。
UK Biobank 与纵向影像访视
约 50 万人的英国队列(10 万人有影像);Instance 2(基线)与 Instance 3(随访)间隔中位 2.26 年,采集心、脑、胰、肝与全身 Dixon 等 MRI,诊断以 ICD-10 编码。本文按 MD5 哈希划分参与者,测试集 455 人、4,850 题,训练/测试互不相交。
基准的每个问题都锚定在真实诊断标签上,环境是参与者级的长程多模态影像;不了解 UKB 的访视结构与数据治理,就看不懂证据环境设计、标签来源和防泄漏措施。
智能体工具调用循环
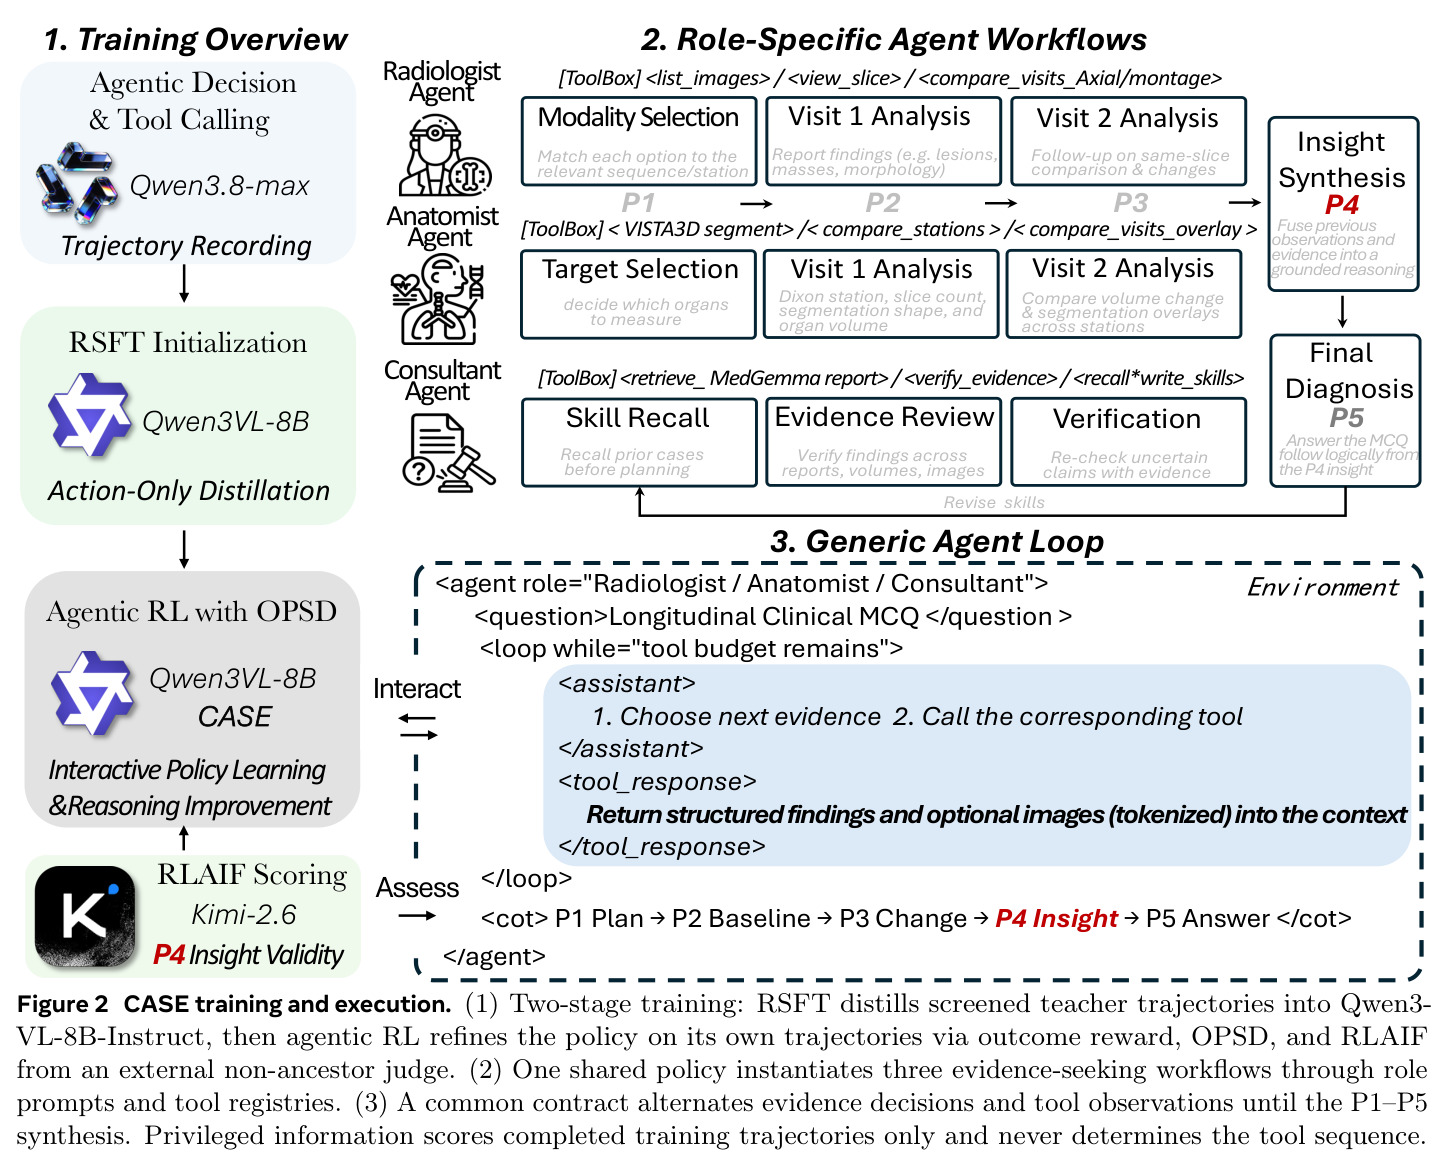
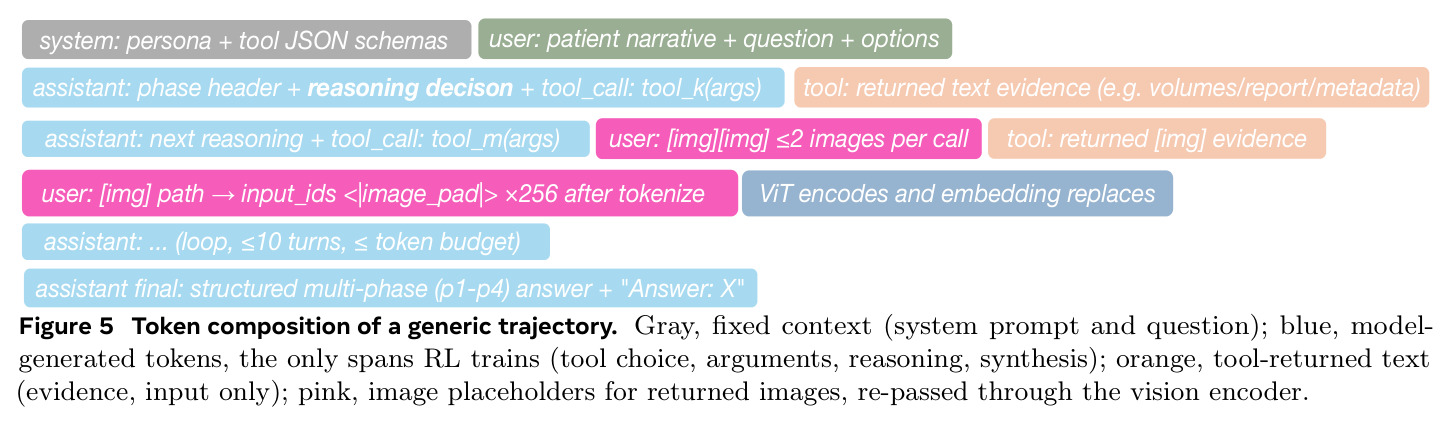
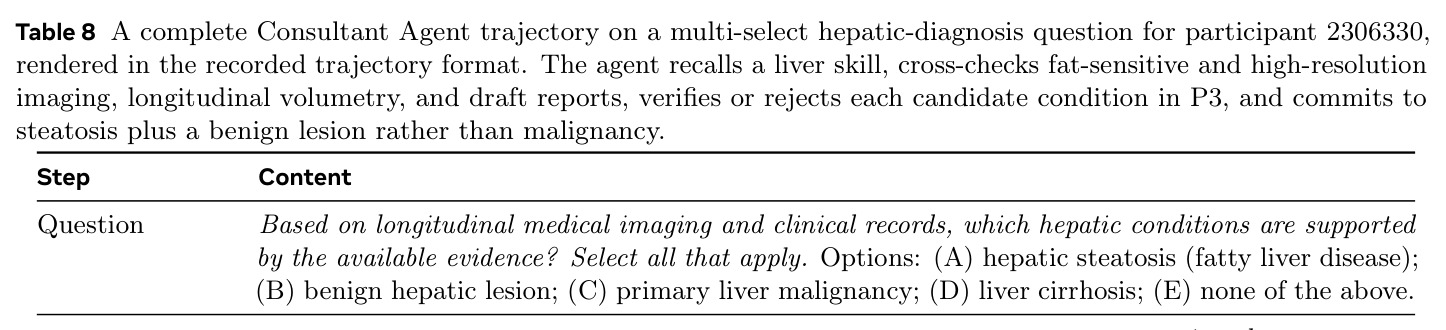
策略在多轮交互中交替生成推理与工具调用,工具返回的文本与图像拼入上下文后再决策,直到给出最终答案。本文统一契约是五阶段终答:P1 计划→P2 多源审查→P3 对比验证→P4 关键洞察→P5 答案;RL 用 verl AgentLoop,评测用 LangGraph,两者共享工具名、提示与缓存。
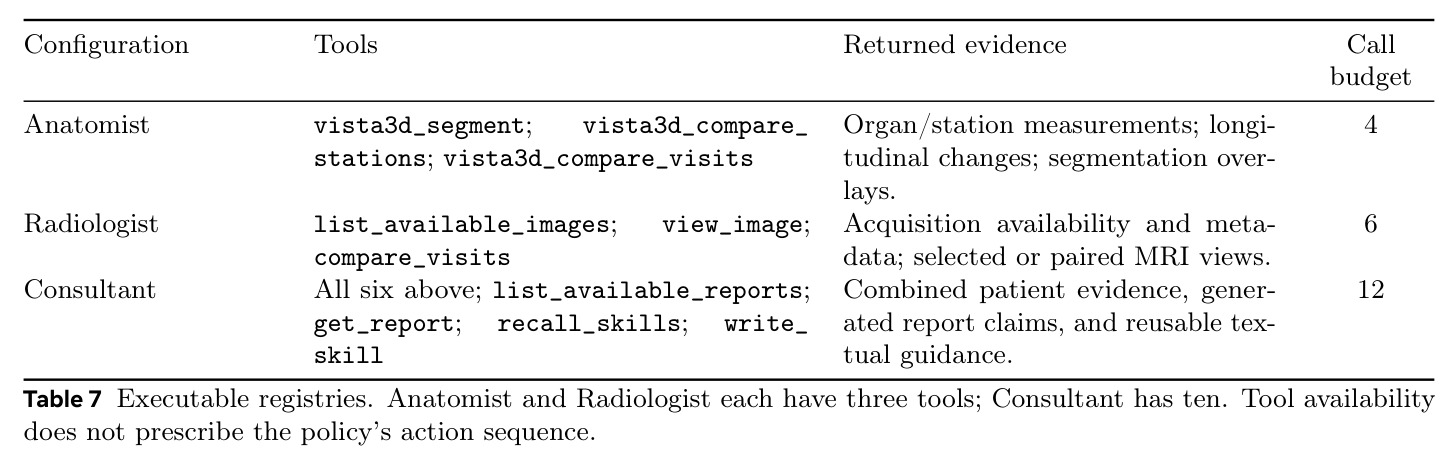
任务形态、轨迹录制、奖励设计与评测协议都定义在这个循环上;三个角色(Anatomist/Radiologist/Consultant)的差异只在角色提示与工具注册表,而非独立模型。
RLAIF 与量规评分
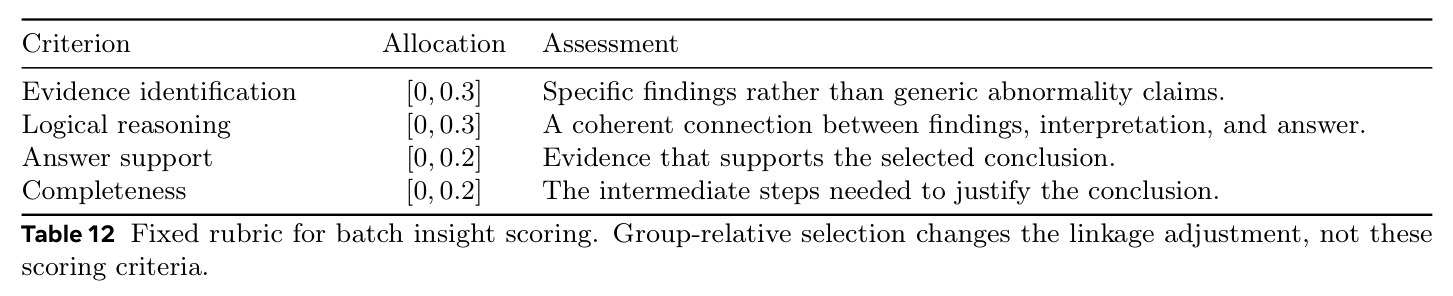
用外部 LLM(此处 Kimi K2.6)按固定评分细则对生成内容打分作为奖励:证据识别 0.3、逻辑推进 0.3、答案支持 0.2、完整性 0.2,输出 $s_j\in[0,1]$;配合'仅当答案正确时组内 top-2 高分洞察 +0.5、答错扣 0.3'的联动项,防止'流畅但无据'的洞察骗分。
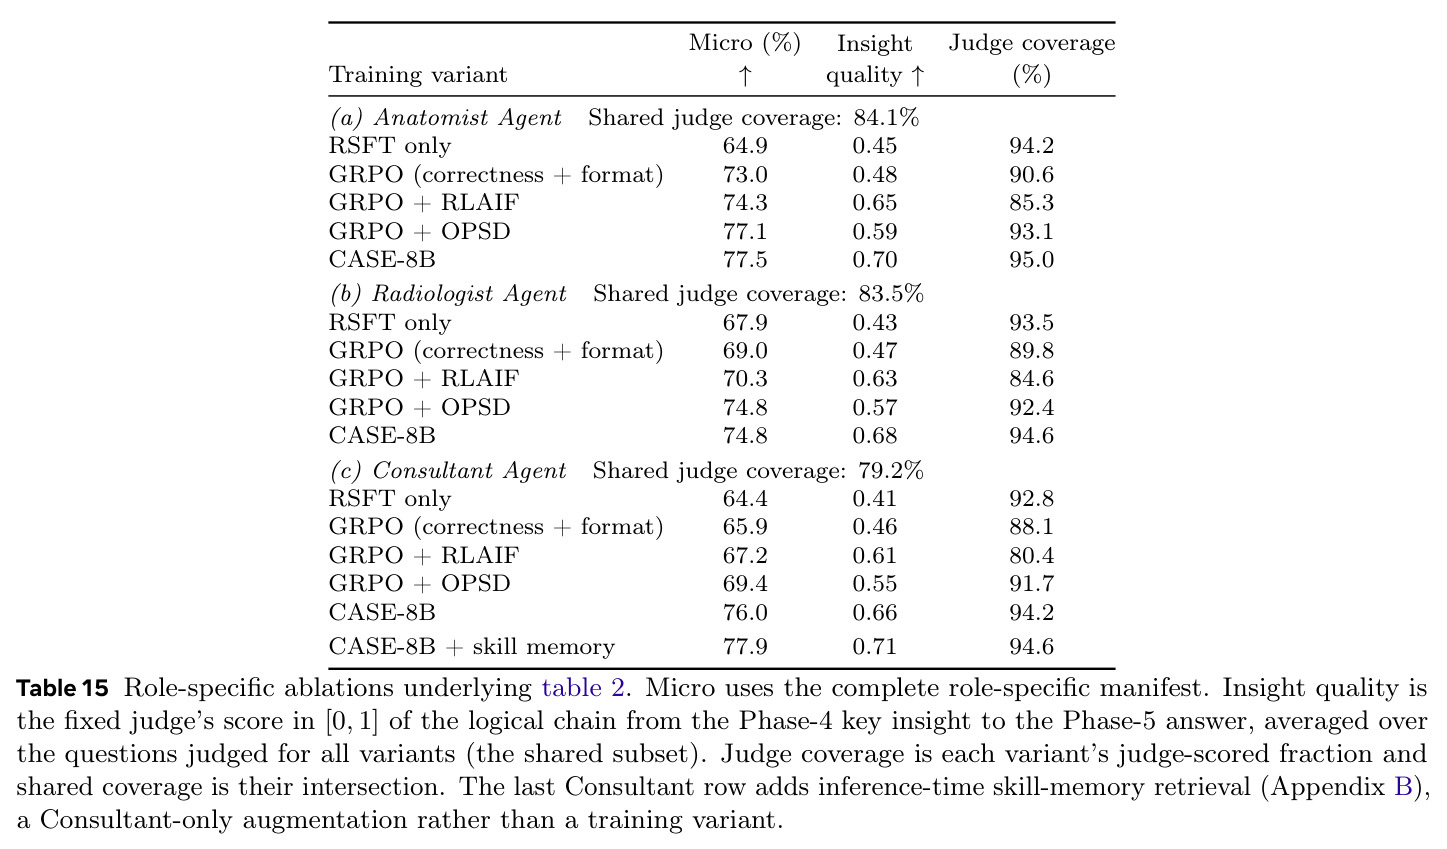
消融显示量规项把洞察分从 0.43 提到 0.68、准确率从 69.3% 提到 76.1%(与 OPSD 协同),是 CASE 超越单纯正确率奖励的关键组件,也是理解 RLAIF 部分的必要背景。
研究动机
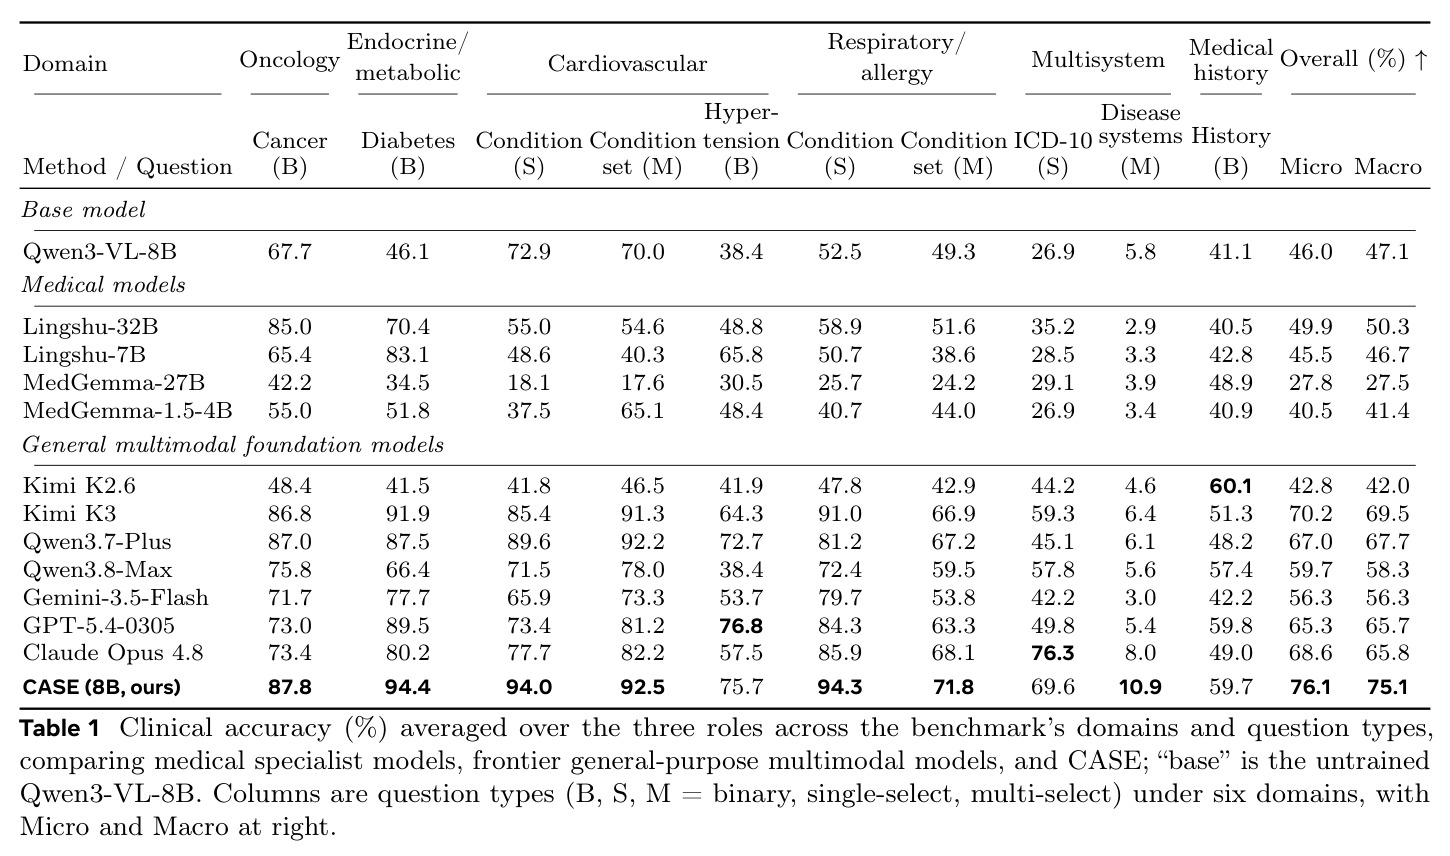
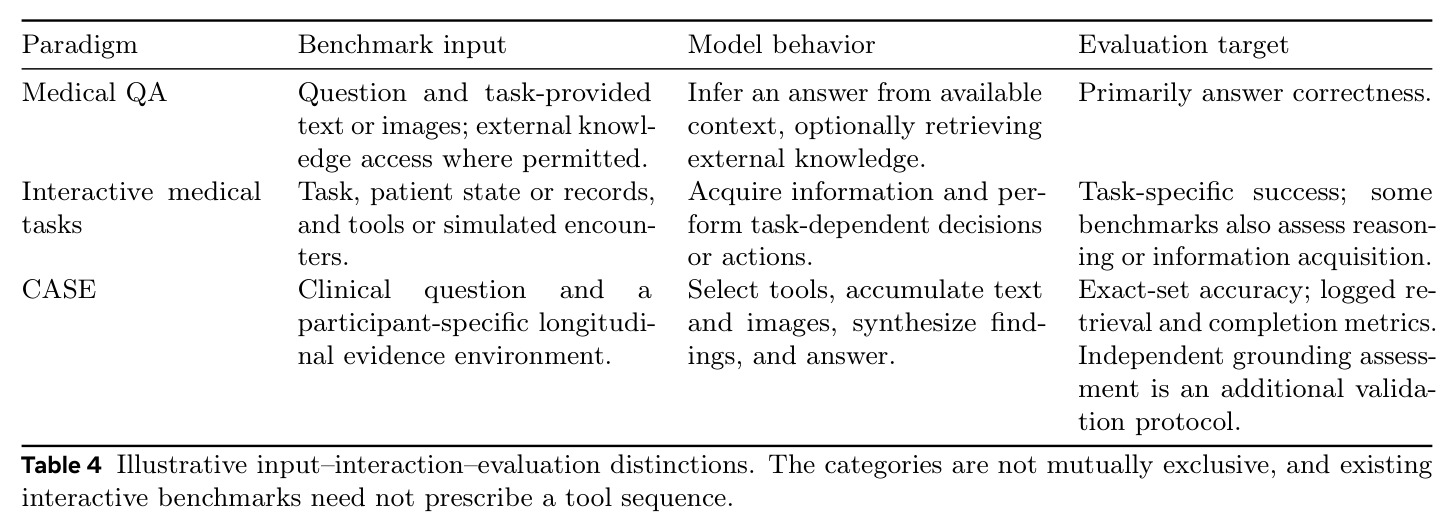
现有医疗评测几乎都在'给定证据'的前提下考察推理:静态医疗 QA 把文本或图像直接放进上下文,模型只需解读预先选好的信息,而不需要决定'该看什么'。但真实的纵向临床推理中,证据分散在临床记录、多序列 MRI、测量值和随访访视里——UK Biobank 一位参与者两次影像访视间隔中位 2.26 年,覆盖心脏、脑、胰腺、肝脏与全身五个部位、七个子模态,多数人只有两三个器官组(3,566 人有 3 组、929 人 2 组、244 人 1 组),必须先决定检查哪些访视、器官、序列和层面才能下结论。互动式基准虽有信息搜寻,却少有把跨访视影像对比与真实诊断标签绑定的标准化任务。缺口在本基准上非常直观:MedGemma-27B 仅 27.8% Micro 准确率,未训练的 Qwen3-VL-8B 基座 46.0%,最强前沿模型 Kimi K3 也只有 70.2%;只模仿教师轨迹的 SFT(65.7%)继承的是'教师选好的路径',无法保证学生在自己选择的证据组合上可靠推理。核心问题因此聚焦为:紧凑模型能否从前沿模型轨迹起步,通过自主交互超越模仿,学会主动搜寻证据并基于所得推理。
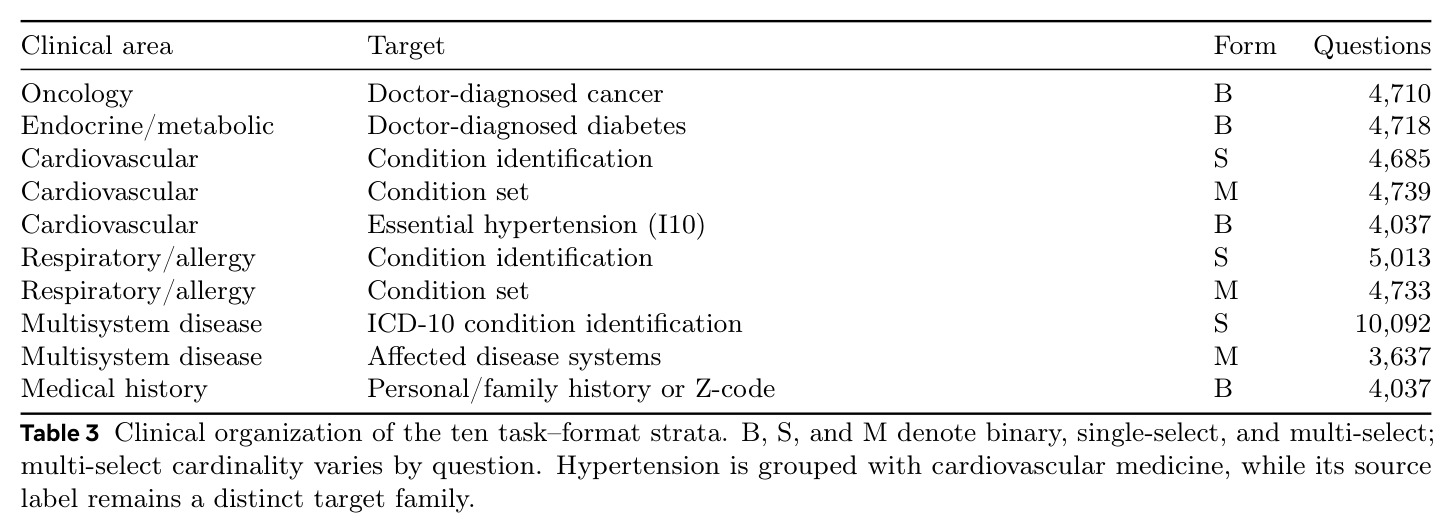
本文的目标是本文目标是构建一个把'证据获取本身变成任务'的完整体系,并训练出超越前沿模型的紧凑临床智能体,分三件事。其一,基于 UK Biobank 建立纵向多模态基准:从 4,739 名参与者的真实 ICD-10 诊断构造 50,401 道选择题(含 455 人、4,850 题留出测试),每题绑定含基线与随访 MRI、Vista3D 衍生测量和 MedGemma 报告的患者专属环境,答案必须在环境里寻找而非从问题推断。其二,设计 CASE 角色专属证据搜寻智能体(Anatomist/Radiologist/Consultant)与统一工具调用协议,使证据路径完全由策略自主决定。其三,提出面向 Qwen3-VL-8B 的两阶段后训练:先用约 14.7 万条 Qwen3.8-Max 录制轨迹做拒绝采样微调,再用智能体强化学习结合结果奖励、量规 LLM 反馈(RLAIF)与特权在策略自蒸馏(OPSD)精炼'证据到结论'的推理;最终达到 76.1% Micro / 75.1% Macro,相对 GPT-5.4 提升 16% 以上、相对 Claude Opus 4.8 提升 10% 以上。
与已有工作不同的是,本文的独特切入有三层。任务层:把纵向医疗推理从'读给定证据'重构为'在患者专属环境中自主搜寻证据',用真实医生诊断而非人工标注定义答案,使答案永远不是问题的直接函数,策略必须真的去找决定性证据——这填补了静态 QA 与互动基准之间'跨访视影像对比+真实标签'的空白。学习层:不从答案出发监督中间步骤,而是先从行动级教师轨迹做 SFT,再完全在学生自己的环境交互上做 RL;关键创新是 OPSD——把同一冻结策略在普通视角与答案特权视角下的分布分歧(两次前向在 Phase-4 洞察区的反向 KL)变成一个分离的、轨迹级的奖励惩罚,在组归一化之前进入回报,从而按综合质量重排整条轨迹;这与 OCSD/SSPO/PBSD/ADRS 只调制 token、步或轮级权重而不重排整条轨迹的做法有本质区别,也不需要可微蒸馏损失或工具级信用分配,且特权教师随策略演化不断刷新。反馈层:量规奖励与结果奖励联动(高分洞察只有答案也对才加分、答错反扣),专门抑制'流畅但无据'的综合,弥合'猜对答案'与'论证正确'之间的监督空白——这是单纯结果奖励或文本量规都无法做到的。
核心方法
直觉上,CASE 想让一个 8B 模型先'照着会做',再'自己做对'。第一阶段 RSFT:Qwen3.8-Max 在 LangGraph 环境中以三种角色录制轨迹(参考答案保密),共 147,434 条原始记录;按'至少一次工具调用且量规分 $s^{offd}\ge0.4$'筛出约 14 万条,序列化为 48,464 个多模态样本,在助手 span 上做掩码交叉熵训练一个 epoch(学习率 $3\times10^{-6}$),学会调用工具、交替证据决策与观察、按 P1 计划→P2 审查→P3 对比→P4 洞察→P5 答案五阶段输出。第二阶段智能体 RL:在 verl AgentLoop 上用 GRPO(每提示 $G=8$ 条轨迹、16 提示/批、温度 0.7),环境采用'可回放证据'设计——只有 Vista3D 分割和 MedGemma-27B 报告离线预计算一次,其余观察由策略自己的请求即时确定,mock 工具按键回放缓存,训练不再跑 GPU 推理。两阶段全参数训练,单节点 8×H100-80GB 约 2,000 GPU 小时,RL 一个 epoch 1,912 步收敛。
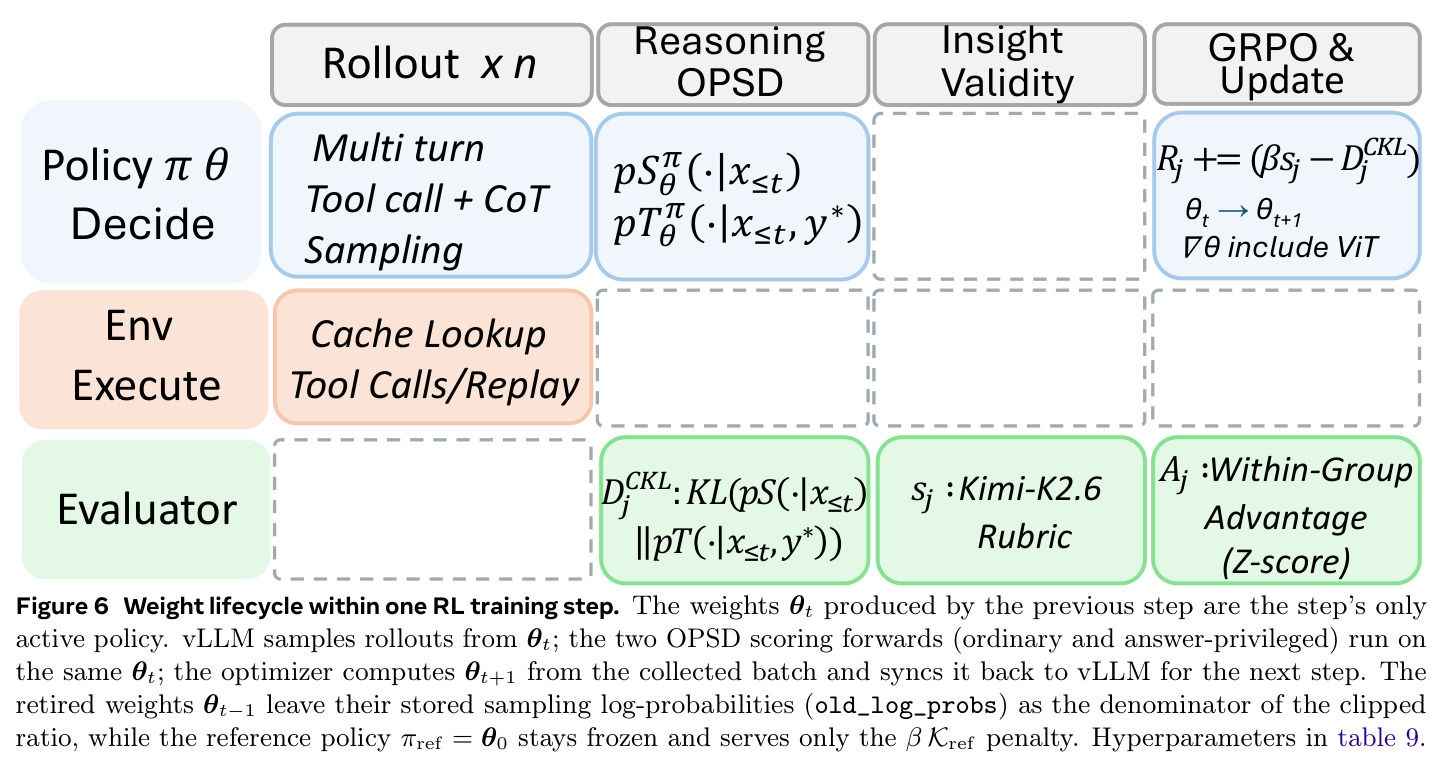
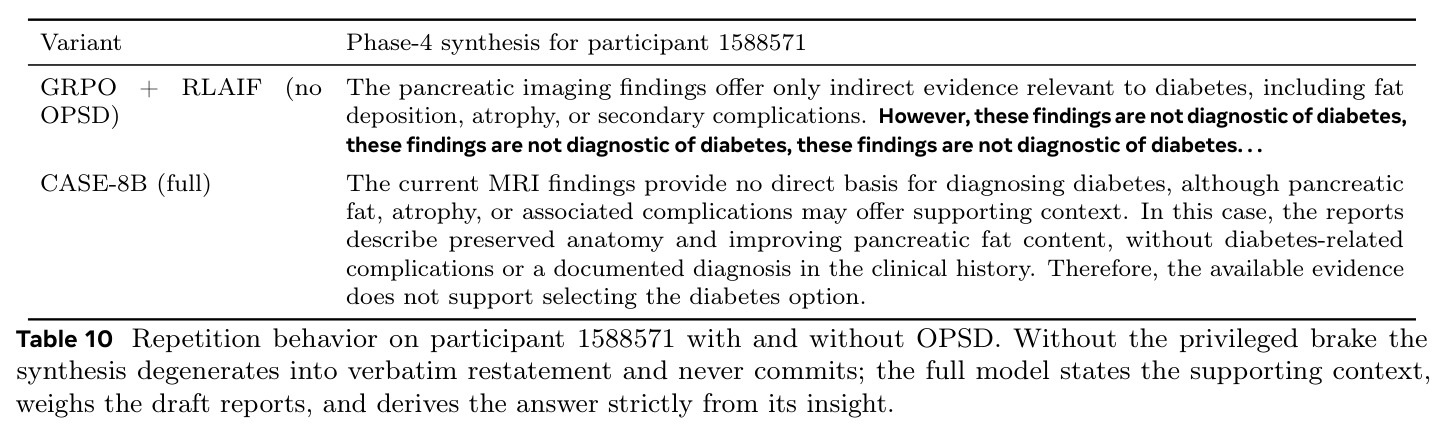
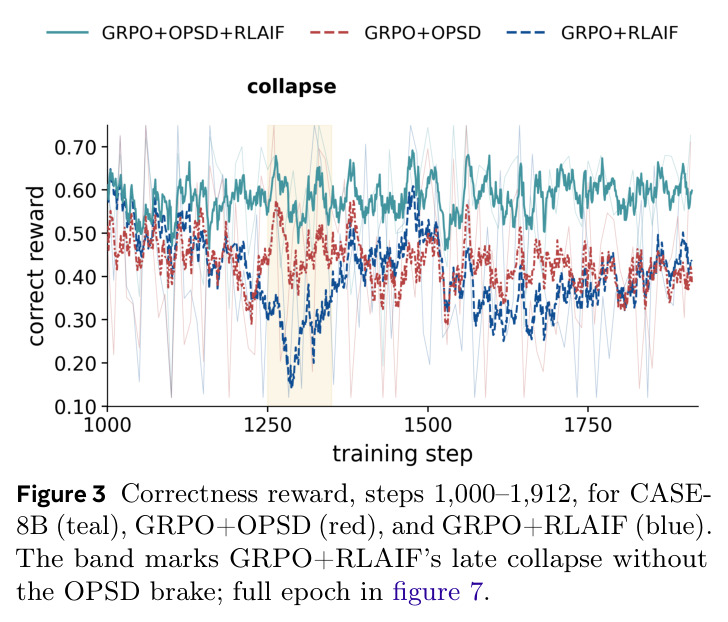
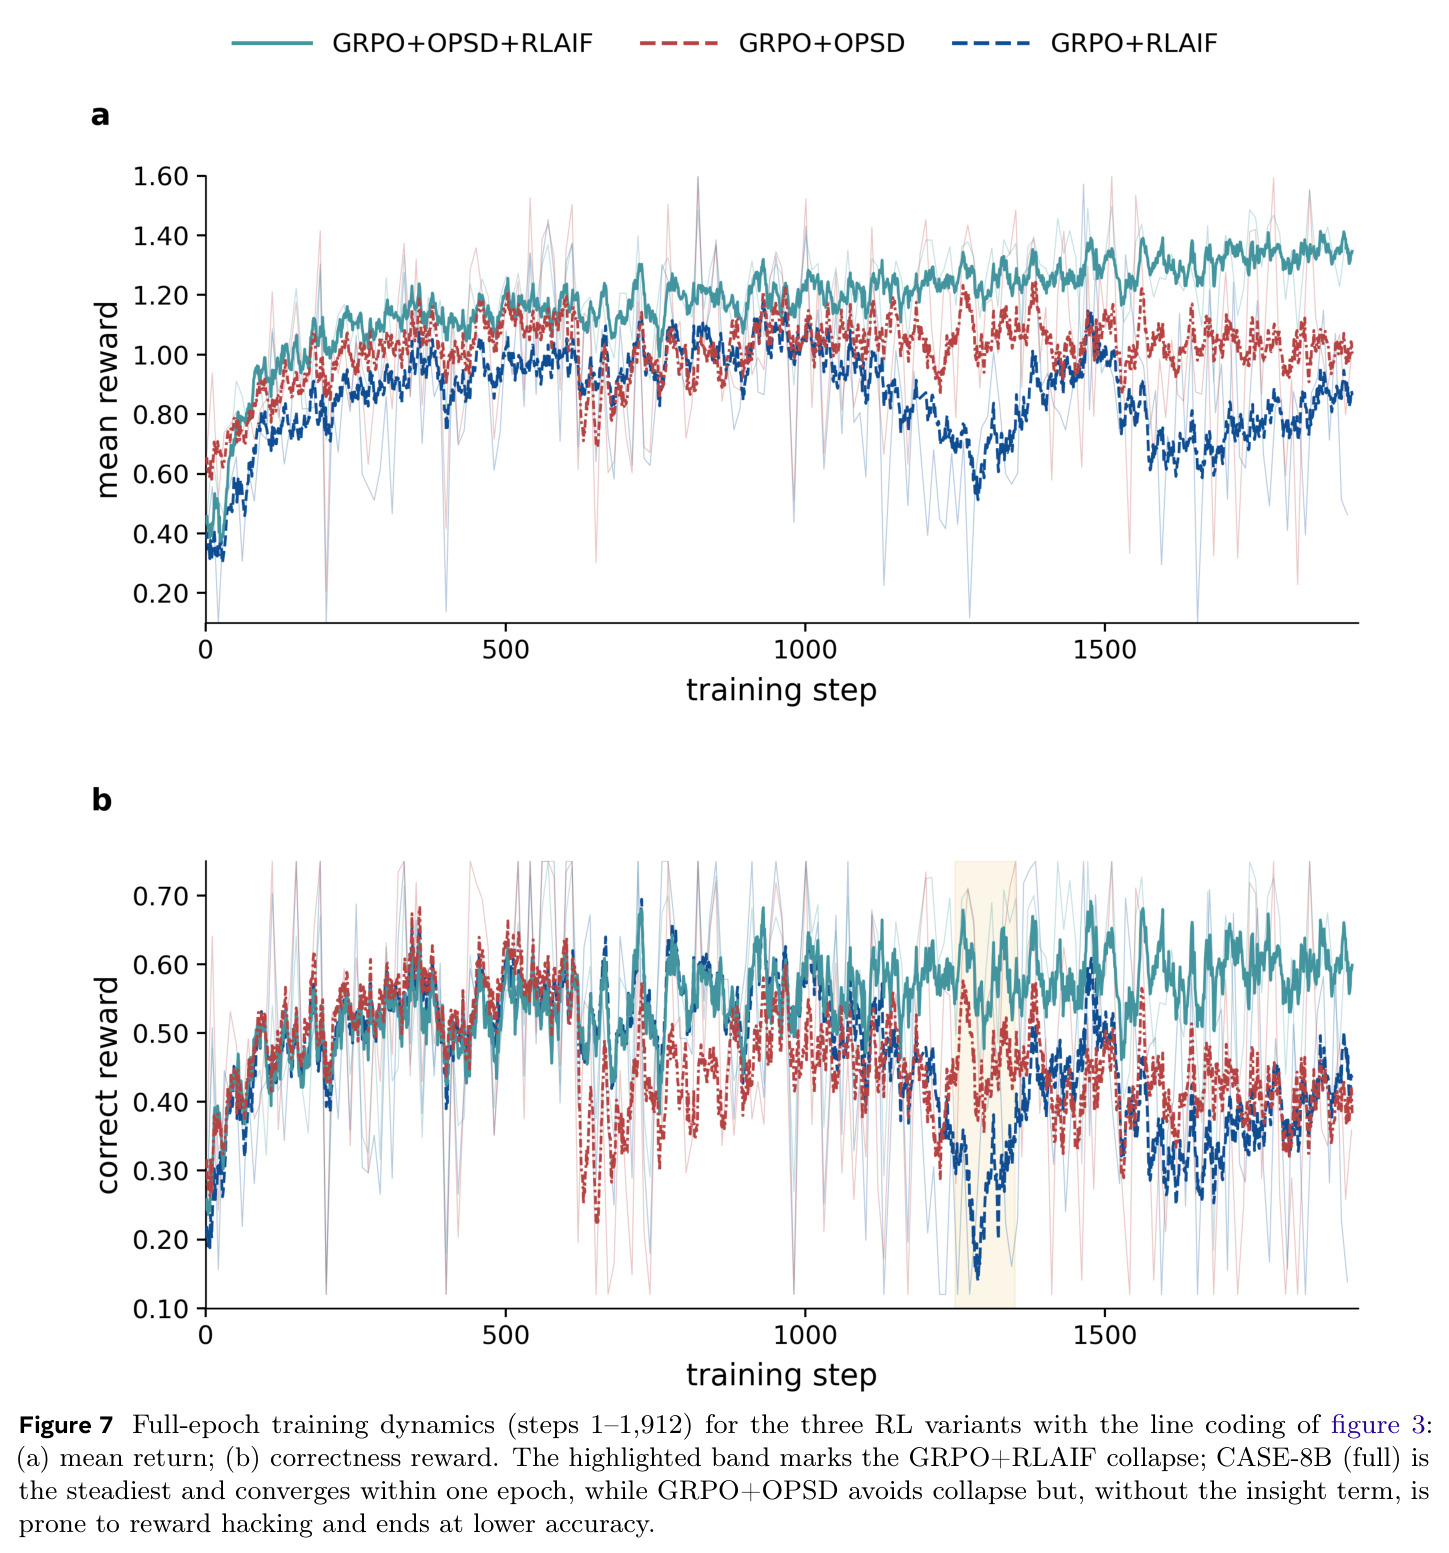
核心创新是 OPSD(特权在策略自蒸馏)与'洞察-答案联动'的组合。RL 中后期策略会停滞在重复模式:Phase-4 反复复述已说过的发现而不下结论,并伴随正确率奖励突然崩塌(附录有逐字循环案例)。机理是紧凑模型先学会解释的表面形式、后学会解决答案:残余不确定性下复述是最廉价的延续。对策是:对策略生成的轨迹 $u_j$,用同一冻结快照 $\bar\theta_n$ 做两次前向——普通输入 $[x;u_j]$ 与特权视角 $[x;z^\star_j;u_j]$(插入参考答案与可选教师洞察)——在 Phase-4 区域计算学生视角反向 KL $D^{CKL}_{n,j}$(top-128 分桶覆盖约 98% 质量),以系数 2.0 从回报中减去:$R_{n,j}=\mathrm{sg}[B_j-2.0D^{CKL}_{n,j}]$。特权视角把概率质量从'继续复述'移向'推进/结束',对齐两者即抑制循环而不规定内容。配套地,量规 top-2 洞察只有答案正确才 +0.5、答错 −0.3,堵住'流畅但无据'的投机路径。与一阶蒸馏损失的本质区别:这是 detach 的轨迹级排序信号。
方法步骤详情
流程六步。①基准构造:从 UKB 诊断构造七类家庭、十层任务,干扰项排除本人诊断,共 50,401 题;按 MD5 哈希划分 40/50/10。②证据准备:Vista3D 对全身 Dixon 的 6 个站离线分割,器官体积按体素计数 $V_\ell=10^{-3}s_xs_ys_zN_\ell$;MedGemma-27B 产出 42,717 份报告并遮蔽 ICD 串防泄漏。③录制:Qwen3.8-Max 三角色盲答,得 147,434 条轨迹。④RSFT:保留 $n_{tool}\ge1$ 且 $s^{offd}\ge0.4$ 的轨迹,48,464 样本训 1 epoch。⑤RL 交互:每批 16 提示 × 8 轨迹,10 轮、6,144 续写 token;调用上限 4/6/12;mock 工具按键回放缓存。⑥优化:$B_j=r^{ans}_j+0.01r^{fmt}_j+0.6s_j+L_j$(答案 +1/−1/−2,联动 top-2 +0.5/−0.3),减 $2.0D^{CKL}$ 后组归一化,GRPO 裁剪 $\eta=0.2$,加 0.05 参考 KL,共 1,912 步。
技术新颖性
新颖性有四点。第一,把特权自蒸馏从'可微损失'改成'分离的轨迹级奖励':GKD/TRACE/SSOPD 等在学生序列上直接回传蒸馏梯度,而 CASE 只在冻结快照上做两次前向打分,把均值反向 KL 塞进回报、在组归一化之前减掉,因此能改变整条轨迹的相对优势符号,让综合质量反馈反向塑造采集行为,且不需要工具级信用分配;与 OCSD/SSPO/PBSD/ADRS 的 token/步/轮级调制不同,它能重排整条轨迹(表 11 的机制对比明确了这一点)。第二,自教师随策略刷新:特权参考不是固定教师,而是当前策略自己的答案知情视角,快照每步更新,并有配套的重复延续条件界。第三,证据-洞察-答案三段联动的反馈设计:文本-only 量规看不出下一 token 只是复述前缀,联动项用正确性给洞察'验伪',消融证实两组件存在非加性协同。第四,环境工程:可回放证据环境把两次源模型推理与策略交互解耦,使 RL 无 GPU 等待;基准本身是首批基于 UKB 真实 ICD-10 诊断、跨访视影像、策略受控证据路径、支持录制回放分析的可执行医疗评测之一。
实验结果
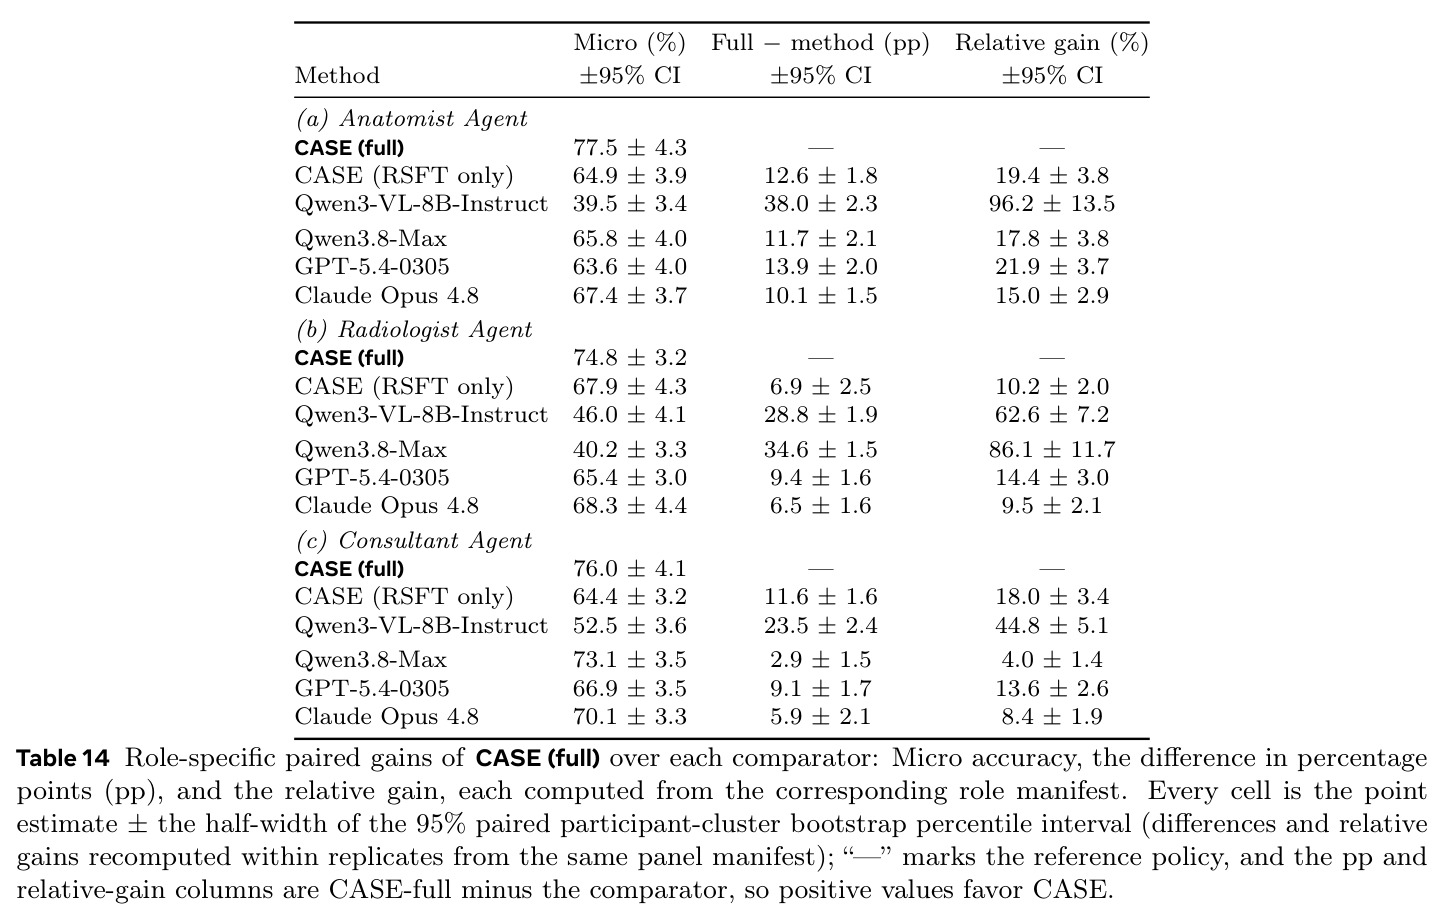
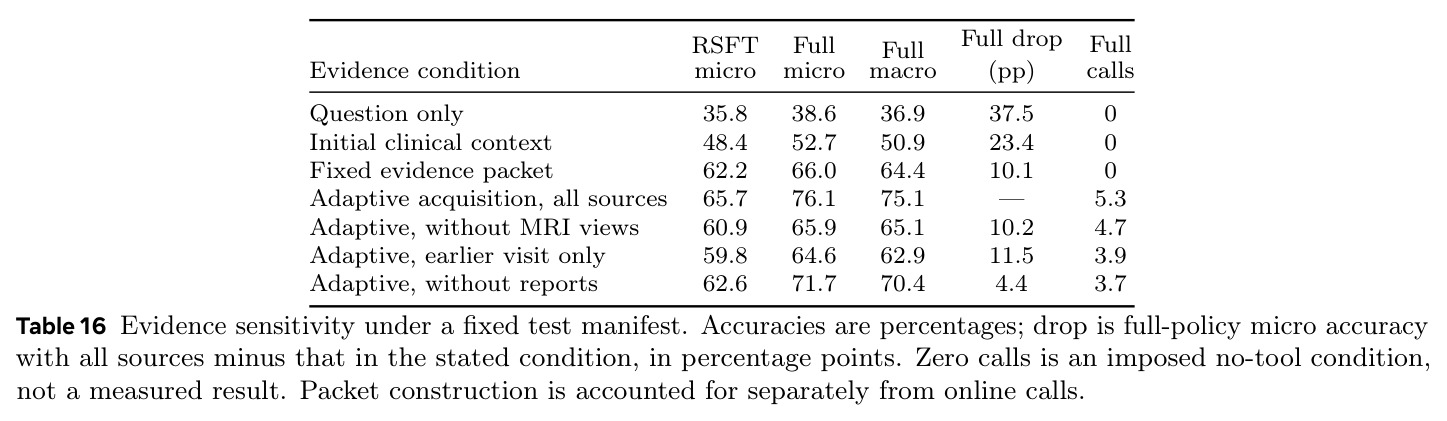
主实验(表 1):CASE-8B 达 76.1% Micro / 75.1% Macro,全面领先——最强基线 Kimi K3 仅 70.2/69.5,GPT-5.4/Claude 4.8/教师/基座分别为 65.3/68.6/59.7/46.0(Micro);相对 GPT-5.4 提升 16.5%、相对 Claude 提升 10.9%。逐角色:Anatomist 77.5、Radiologist 74.8、Consultant 76.0,对教师配对增益 +11.7/+34.6/+2.9pp,对 GPT-5.4 +13.9/+9.4/+9.1pp。消融(表 2):RSFT 65.7 → +GRPO 69.3 → +RLAIF 70.6 → +OPSD 73.8 → 完整 76.1;无 OPSD 时 RLAIF 变体末段崩塌。证据依赖(表 16):仅问题 38.6 / 仅叙述 52.7 / 固定包 66.0 / 自主获取 76.1;去 MRI −10.2pp、仅基线 −11.5pp、去报告 −4.4pp。效率(表 17):5.1 次调用/题、失败率 2.6%(基座 21.4%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 纵向临床问答(三角色平均,跨 10 层 6 域) | 首过精确答案集准确率 Micro (%) | 76.1 | GPT-5.4-0305 65.3 | +10.8pp(相对 +16.5%) |
| 纵向临床问答(三角色平均) | Macro 准确率 (%) | 75.1 | Kimi K3 69.5 | +5.6pp(相对 +8.1%) |
| Anatomist 面板 | Micro 准确率 (%) | 77.5 | 教师 Qwen3.8-Max 65.8 | +11.7pp(相对 +17.8%) |
| Radiologist 面板 | Micro 准确率 (%) | 74.8 | 教师 Qwen3.8-Max 40.2 | +34.6pp(相对 +86.1%) |
| Consultant 面板 | Micro 准确率 (%) | 76.0 | Claude Opus 4.8 70.1 | +5.9pp(相对 +8.4%) |
| 组件消融(RSFT-only → 完整 CASE) | 三角色平均 Micro (%) | 76.1 | RSFT-only 65.7 | +10.4pp(相对 +15.8%) |
| 交互可靠性(Consultant,每题) | 失败率 (%) | 2.6 | Qwen3-VL-8B 基座 21.4 | −18.8pp |
局限与改进
作者承认:临床标签可能从现有影像不可观测(如癌症状态取自 Instance 3 问卷),生成证据(Vista3D 分割、MedGemma 报告)和裁判模型都可能出错;超越该队列的效用、泛化与效率尚待验证。我的补充:其一,Macro 对小层极敏感,CASE 在最难的 ICD 疾病系统多选层也只有 69.6%,长尾多选仍是弱点。其二,附录 G 显示同一预测在不同打分约定下为 77.36% vs 76.35%,附录 H 承认 Phase-4 评分掩码只是字符近似、报告适配器 base64 返回的解码尚未端到端验证,工程口径未完全收敛。其三,Anatomist 因部分参与者缺全身 MRI 只覆盖 4,435/4,850 题(418/455 人),跨角色比较只能算描述性。其四,裁判故障回退赋 0.5 分、回退频率未报告,RLAIF 信号可能被污染。其五,测试时技能记忆 run 内活跃,给 Consultant 带来同轮非参数增益(77.9 vs 76.0)。其六,全部结论来自 UKB 45–85 岁队列而非真实临床患者流,约 2,000 H100 小时成本也偏高。
独立分析的弱点
独立分析的弱点:①标签-证据错位——答案锚定医生诊断(问卷+ICD-10),影像不必然可判定(如原发性高血压 I10),存在'用叙事先验而非影像答题'的捷径;表 16 的移源实验部分缓解了担忧(去 MRI 视图掉 10.2pp),但缺少反事实检验(同一环境人为改标签观察敏感度),改进方向是构造影像可判定的替代标签或专家一致性子集。②轨迹级共享优势无法指出'哪次检索导致了好综合'(作者亦承认),可引入层级信用分配或把 $D^{CKL}$ 惩罚分解到各工具调用之后的前缀。③特权视角可能学到'答案条件下的风格'而非内容——低散度也可能来自'无视特权'或'合理化已知答案',论文反复强调但未给出区分实验,应补做长度匹配中性提示与答案打乱对照(附录 F 仅提出设计)。④三角色证据资格与预算不同(4/6/12 次调用),跨角色结论不可直接比较,且技能记忆只有 Consultant 独享。⑤量规裁判是黑盒 API,三个裁判趋势一致仍不等于独立临床验证,缺乏医生盲评。⑥可回放缓存使策略被锁死在预计算证据的键空间内,RL 无法发现缓存之外的工具用法(如新的后处理组合),限制了策略的创造性。
未来方向
作者提出的方向:把同一评测/训练范式实例化到更广工具集与专科诊断路径(只需指定可用证据、工具和决策契约);在队列外验证泛化与效率;建立超越该队列的临床效用。基于本文成果可延伸的:其一,把 OPSD 的'答案特权'推广为粒度可调的'检查特权'(特权提示只给关键发现而非最终诊断),系统研究特权强度对采集行为的塑造;其二,结合过程级信用分配,把 $D^{CKL}$ 分解到每次工具调用之后,训练更长、更可归因的证据链;其三,把技能记忆从 Consultant 扩展到全部角色,并研究跨 run 持久化记忆与遗忘机制;其四,向真实 EHR/院内环境做 sim-to-real 迁移,检验可回放环境学到的策略是否保真(与 ClinEnv 类平台对接);其五,补齐多 seed 方差与协同效应的正式检验(交互对比 $A_{11}-A_{10}-A_{01}+A_{00}$ 目前只有框架);其六,下沉到 4B 级学生或非 VLM 骨干检验框架的规模鲁棒性;其七,把'首过精确匹配+固定裁判洞察分+失败率'三元组推广为医疗智能体的标准化评测准则。
复现评估
开源情况:作者承诺发布实现代码、录制轨迹、基准构造与评测代码、提示词和训练配置(HuggingFace + GitHub);基准将按协议返还 UK Biobank,经 UKB-RAP 返回数据集目录向获批研究者提供(申请号 603483);但参与者级数据不可再分发,外部复现必须自行申请 UKB 访问并重跑证据准备。数据与算力:48,464 条 SFT 样本 + 30,604 条 RL 提示行;单节点 8×H100-80GB 约 2,000 GPU 小时(RSFT 1 epoch + RL 1,912 步);top-128 分桶把 KL 中间量压缩约 $10^3$ 倍,是 paired 打分塞进单节点的关键。超参在表 9 完整给出。难度评估:代码与配置层面的复现路径清晰,但有缺口——附录 C 自述筛选脚本、接受清单与原始响应未包含在当前快照中,候选/保留计数无法从缓存推断;历史 pilot(77.36%)的原始预测不可核验、已排除出对照;加上 UKB 审批周期与多模态 RL 工程复杂度,独立完整复现属'高难度但可行',预计需一个 8×H100 节点与数周数据准备。
论文图表
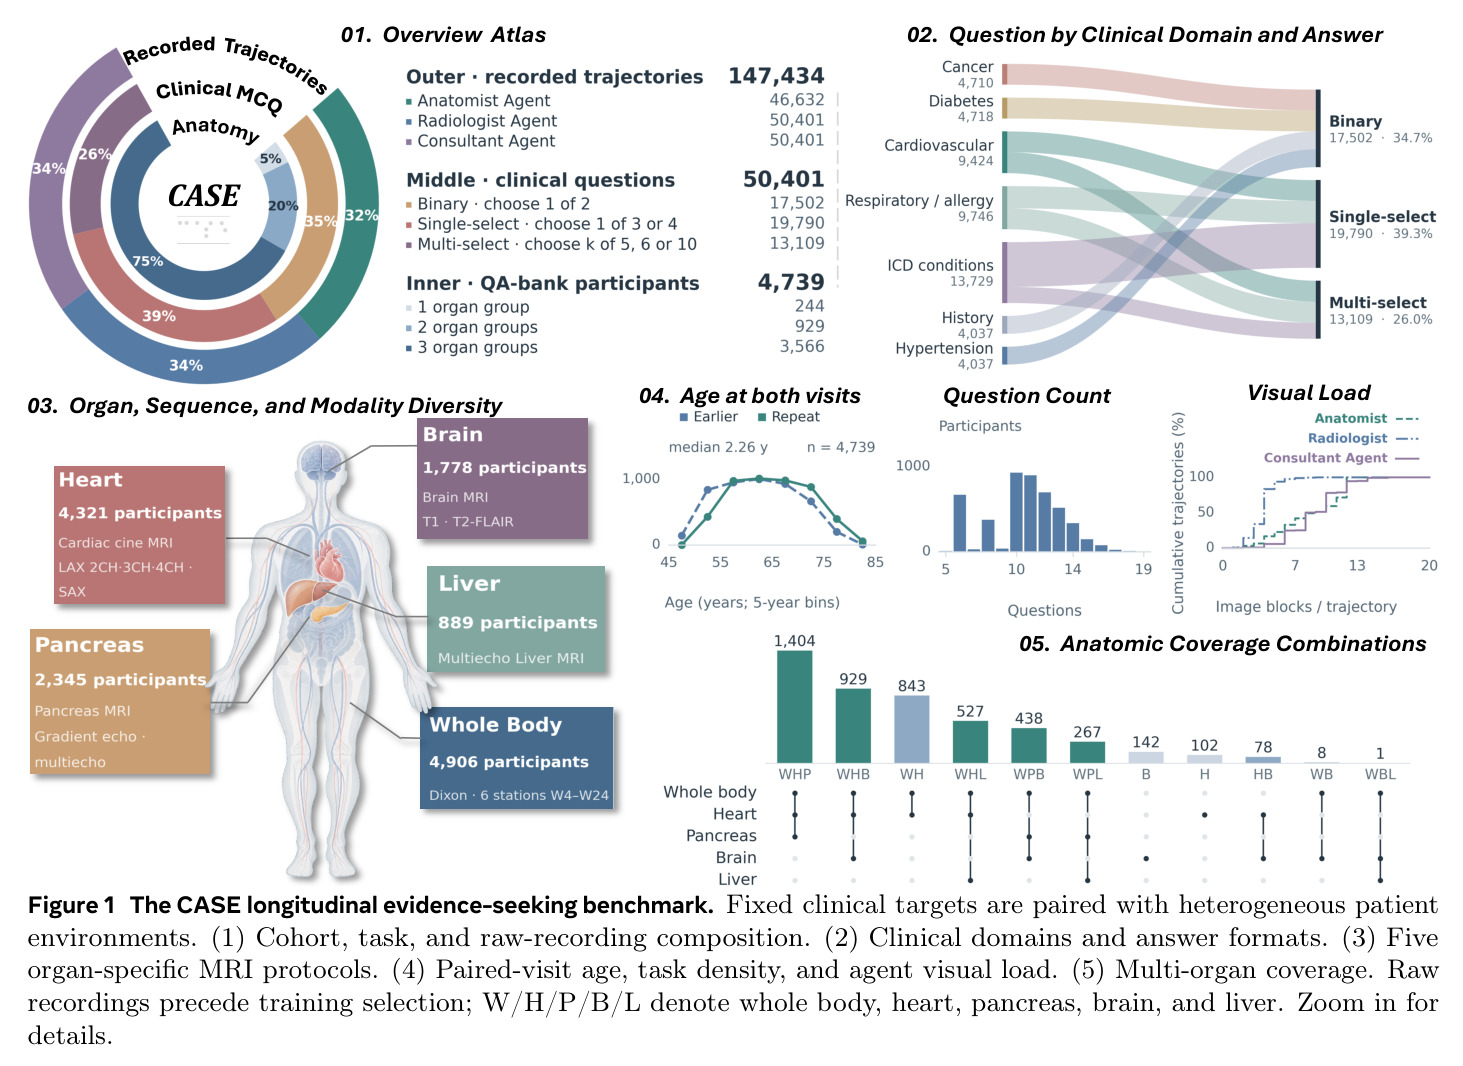
五联图总览基准:(1) 队列、任务与原始录制构成;(2) 50,401 题按七个临床家庭流向三种答案格式(二选一 34.7%、单选 39.3%、多选 26.0%);(3) 五个器官 MRI 协议(全身 W、心脏 H、胰腺 P、脑 B、肝脏 L);(4) 配对访视年龄、任务密度(人均约 10 题、每轨迹约 8 图)与智能体视觉负载;(5) 11 种互斥的解剖覆盖组合(WHP 1,404 人最多,WBL 仅 1 人)。
一张图讲清基准的规模、异质性与难度来源:跨访视、多器官、稀缺影像正是'证据搜寻'任务的物理基础,也是理解后续所有实验设计的入口。
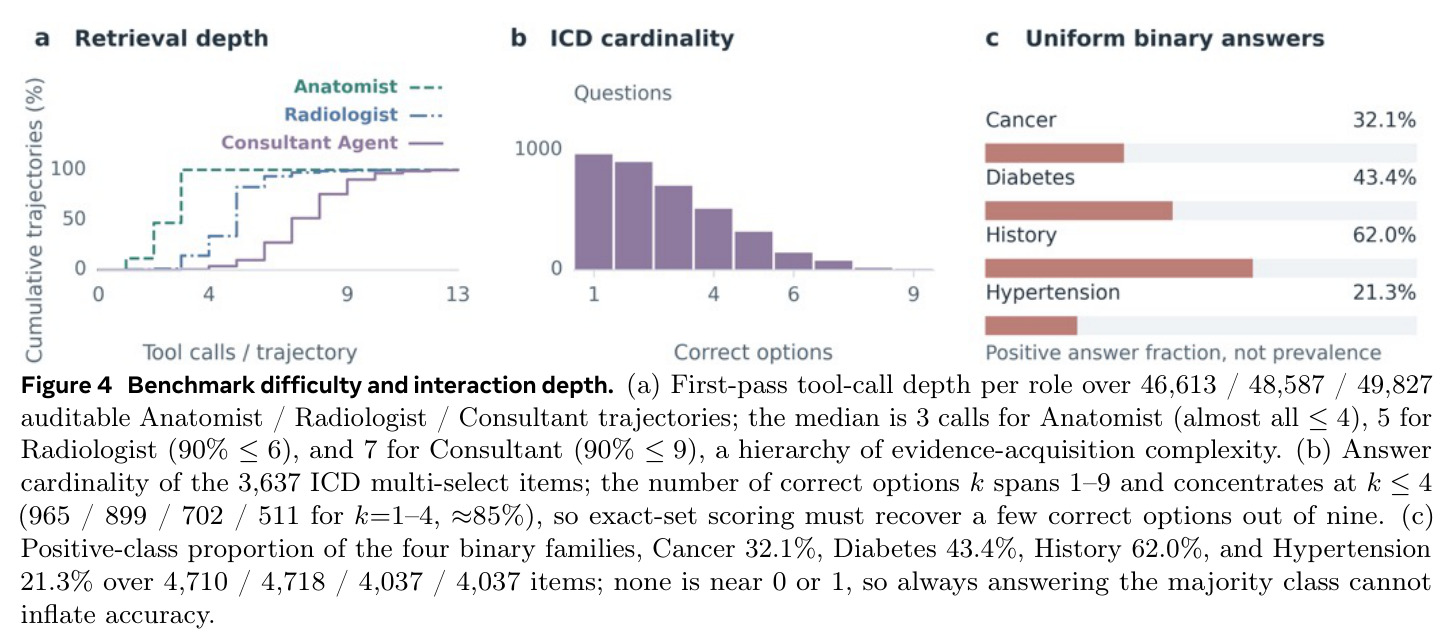
三幅子图:(a) 三角色首过工具调用深度(中位数 Anatomist 3、Radiologist 5、Consultant 7,90% 分位 ≤4/≤6/≤9),呈证据获取复杂度层级;(b) 3,637 道 ICD 多选题的正确选项数 $k$ 分布 1–9、约 85% 集中在 $k\le4$;(c) 四个二选一层的正类比例(癌症 32.1%、糖尿病 43.4%、病史 62.0%、高血压 21.3%),均远离 0/1,防多数类作弊。
量化基准的难度与防泄漏设计,说明 76% 的准确率是在'九选几'的精确集合匹配下取得,含金量高。
用三个裁判(Kimi K2.6、Qwen3.7-Plus、DeepSeek V4-Flash)重跑训练期诊断:(a) 普通/特权综合之间的 Causal-KL 在整个 1,912 步内对每个裁判都稳定下降;(b) 评分的洞察分在三者下都持续上升(绝对水平因严格度不同而异)。
回应'收益是否只是迎合单一裁判'的质疑,是 RLAIF 组件可信度的关键稳健性检验。
(a) 768 个位置的平均排序 next-token 分布(log-log):前 128 名占 97.9%、129–2000 名再加 2.1%、其余 >15 万词条合计 <0.4%;(b) 累积覆盖率在 $k=128$ 处饱和($C(64)=96.9\%$、$C(128)=97.9\%$、$C(1024)=99.4\%$)。
为 OPSD 的 top-128+残差分桶近似提供实证依据,解释了为什么 paired 打分能塞进单节点而近似近乎无损。