EMHO:基于经验轨迹的具身智能体框架自进化优化 EMHO: EMbodied Agent Harness Optimization via Experience Traces
冻结具身模型,让外围框架从交互轨迹中自我进化,成功率最高提升33.3%
前置知识
Agent Harness(智能体框架)
harness 是包裹在底层模型外围、组织智能体与环境的全部系统逻辑,包括观察与上下文构建、记忆管理、规划、工具选择、动作生成、输出校验和失败恢复。它通常由提示词文件(如 planner.md)和运行时代码(如 planner.py、tool_orchestrator.py)组成。模型只负责单步决策,而 harness 决定模型看到什么、以什么形式看到、以及失败后如何补救。
本文的核心主张就是:不动模型、只进化 harness 也能大幅提升具身智能体表现,理解 harness 的边界是理解全文的前提。
经验轨迹(Experience Trace)
一局任务的完整执行记录,形式为 $T_e=(x_e,\{(o_t,p_t,z_t,a_t,f_t)\}_{t=1}^{T_e},y_e)$:$x_e$ 是任务指令,$y_e$ 是最终成败,每步记录观察 $o_t$、生成的计划 $p_t$、可选工具交互 $z_t$、执行的动作 $a_t$ 和环境反馈 $f_t$。它是优化器诊断失败原因的原始证据。
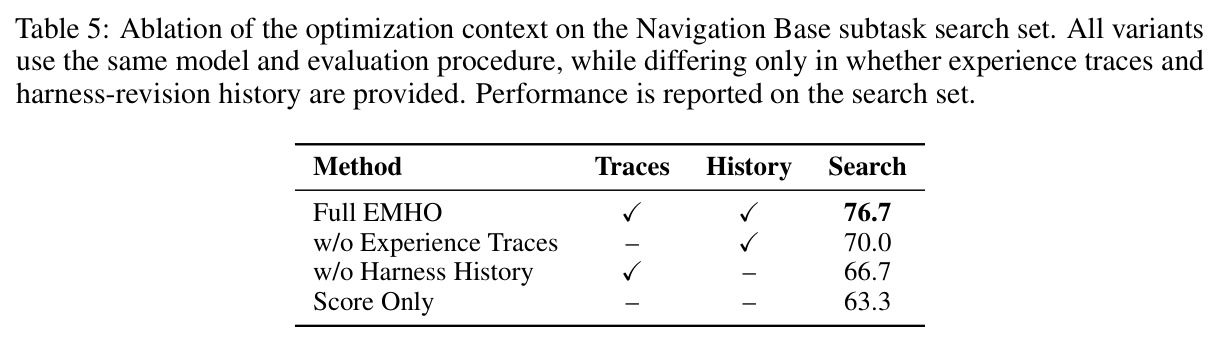
EMHO 的整个外循环都建立在对这些轨迹的分析上,消融实验证明去掉轨迹后性能从 76.7% 掉到 70.0%。
稀疏且弱诊断性的环境反馈
具身环境(如 EmbodiedBench)每步只给动作级结果:导航返回 valid/invalid/blocked,操作返回 -1/0/1 的标量奖励加是否持握物体的状态信号。这些信号能告诉你动作是否执行成功,但不告诉你失败的根因;整局结束才有一个延迟的成功/失败标签。
这正是本文与编程智能体自改进(有失败测试、异常栈等强信号)的本质差异,也是问题更难的原因。
EmbodiedBench 基准
一个评测多模态大模型作为视觉驱动具身智能体的基准(ICML 2025),覆盖导航任务(Base/Common/Complex/Visual/Long 五个子任务)和操作任务(Base/Common/Complex/Visual/Spatial 五个子任务),每步要求模型输出可执行的动作计划,配合深度估计、分割等视觉工具使用。
本文所有定量结果都在它上面测得,划分搜索集/留出集的方式也直接影响对泛化结论的解读。
内外双循环自进化
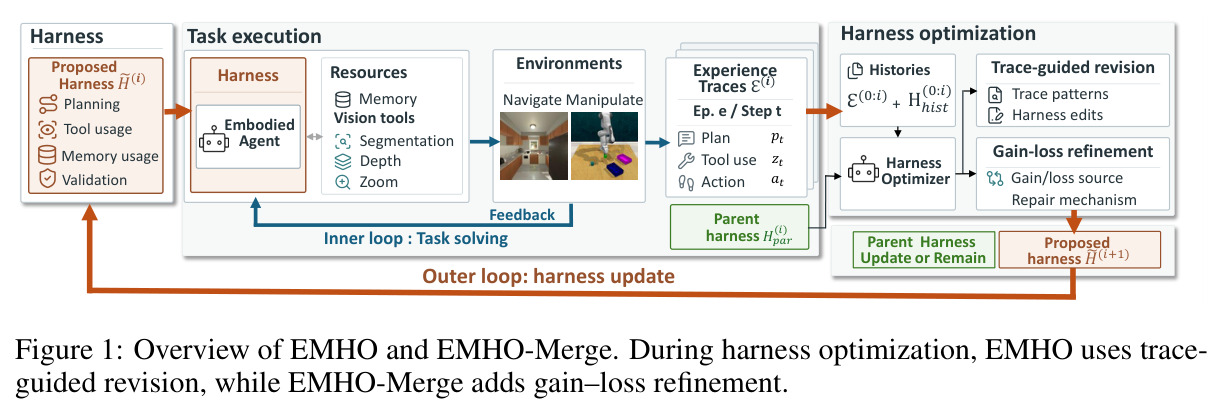
内循环是任务求解:当前 harness 在环境里执行任务并记录轨迹;外循环是框架更新:一个优化器智能体阅读轨迹和历史修改记录,提出新的 harness 候选,评估后按贪心规则决定是否替换父代。模型在整个过程中完全冻结。
这是 EMHO 及其同类工作(Meta-Harness、Self-Harness)的通用范式,理解两个循环的信息流才能看懂方法设计。
视觉工具链(Depth Anything 3 / SAM 3)
智能体可调用外部视觉工具增强感知:Depth Anything 3 提供深度估计用于障碍与距离推理,SAM 3 做目标分割用于视觉落地,zoom 用于查看局部细节。harness 负责决定何时调用哪个工具、如何把工具输出融入规划。
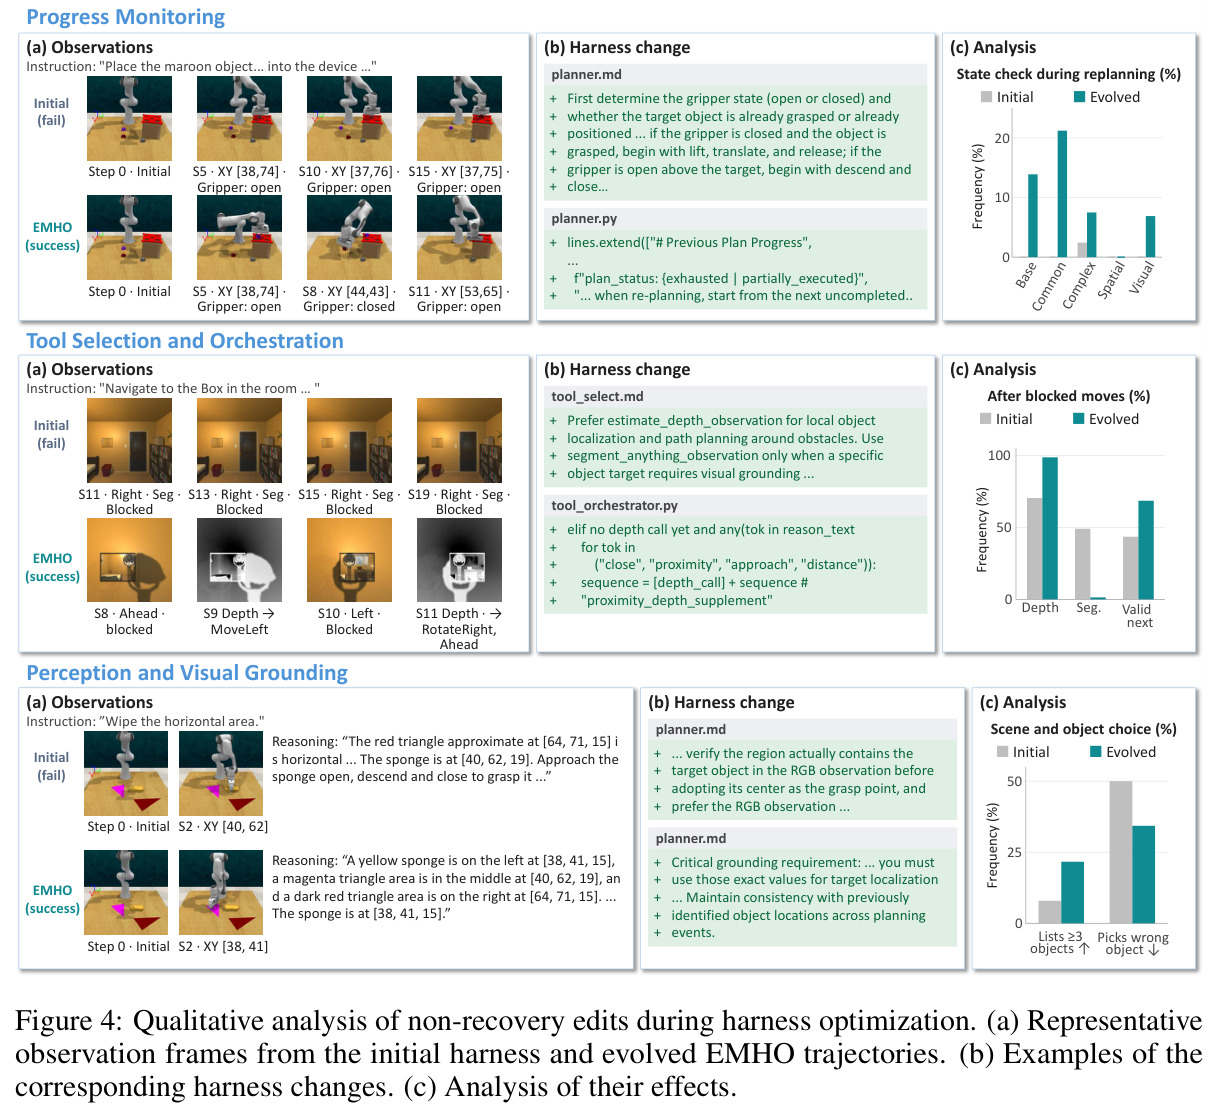
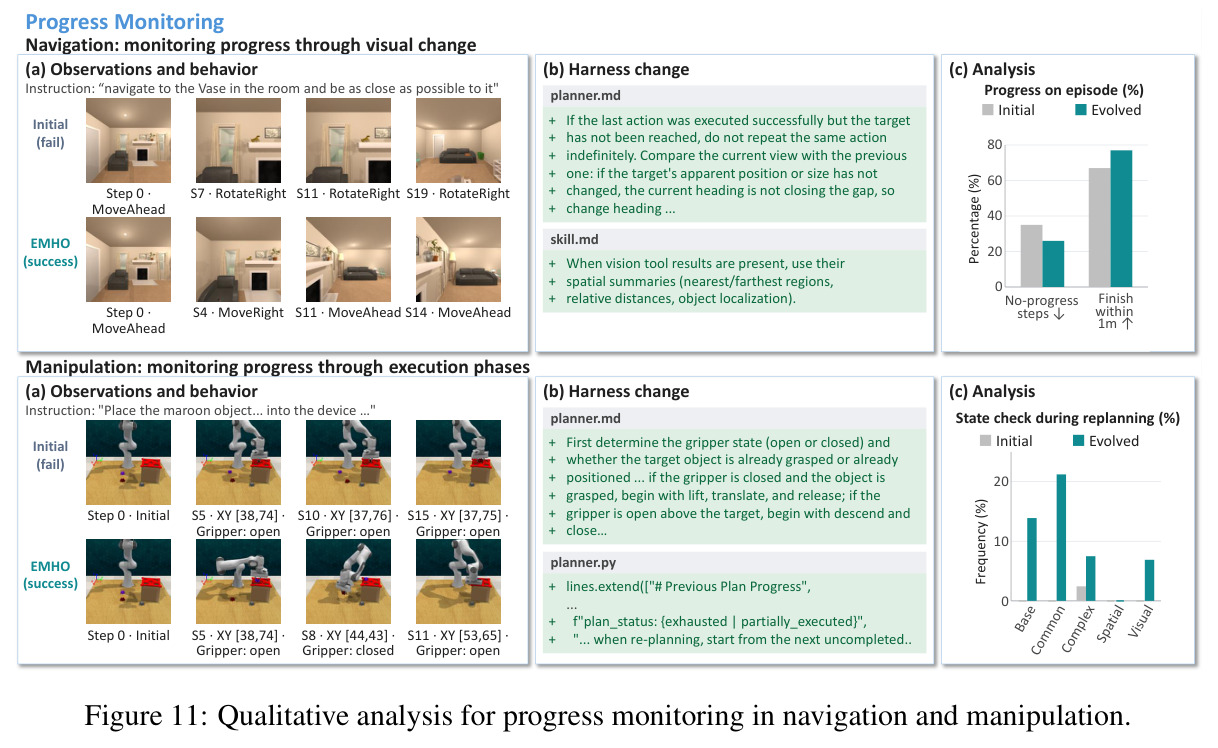
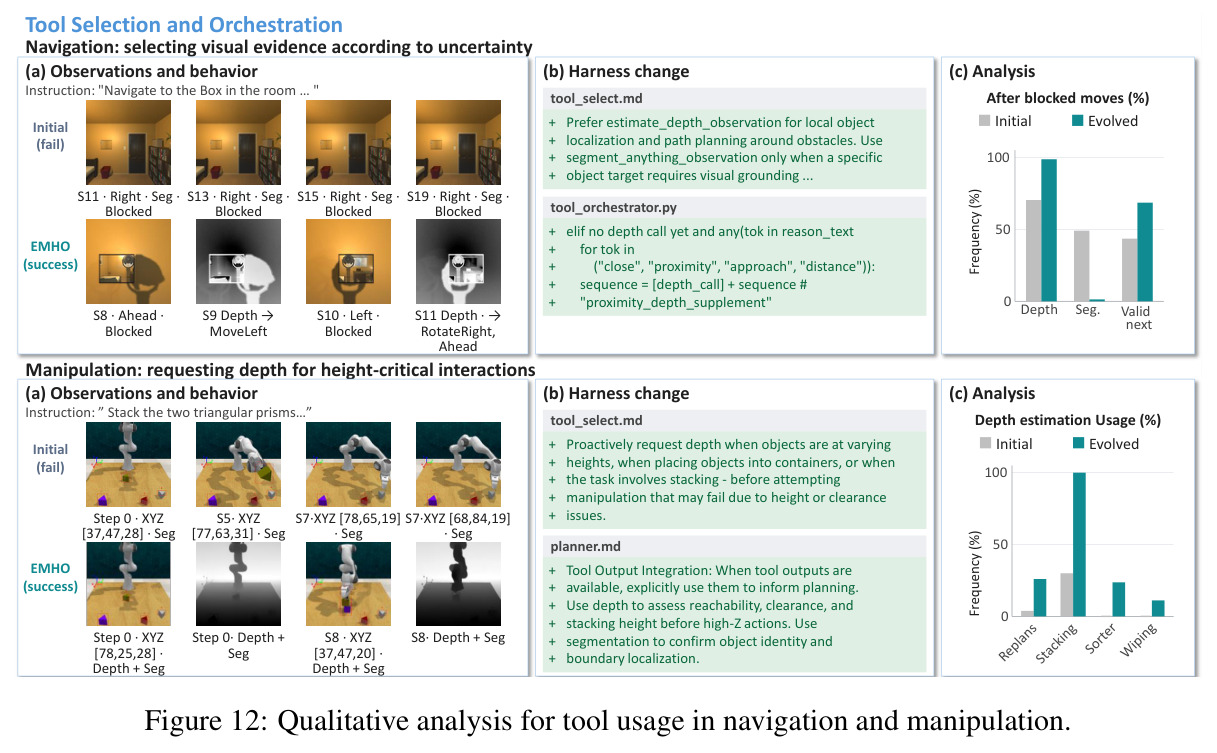
EMHO 进化出的非恢复类编辑中很大一部分就是工具编排策略,例如阻挡后深度工具使用率从约 70% 升至近 100%。
研究动机
具身智能体的改进大多集中在底层视觉语言模型的训练上,而围绕模型的智能体框架(harness:负责规划、上下文与记忆构建、工具选择、观察呈现和失败恢复的逻辑)主要靠人工工程。手工设计 harness 很难做好,因为具身环境中的失败难以从交互轨迹中诊断:一局任务可能包含几十个观察、计划、动作和工具调用,而环境最终只给出一个延迟的、稀疏的成功/失败信号(导航中只有 valid/invalid/blocked,操作中只有 -1/0/1 的奖励),无法指出是哪个早期决策导致了失败。这与编程智能体形成鲜明对比——后者可以直接利用失败的测试、异常或局部执行错误来指导自我改进。结果是初始 harness 表现很差:在 EmbodiedBench 上,Qwen3.5-9B 配初始 harness 的操作任务平均成功率仅 9.7%(搜索集),导航平均也只有 50.0%,大量失败源于重复无效动作、被阻挡后原地打转、错误选择目标物体等本可避免的行为缺陷。
本文的目标是本文的具体目标是:在完全冻结底层模型 $M$ 的前提下,让智能体框架 $H$ 直接从自身交互经验中进化,形式化为寻找 $H^\star=\arg\max_{H\in\mathcal{H}}\mathbb{E}_{e\sim D}[y_e(M,H)]$,其中 $y_e\in\{0,1\}$ 为回合最终成败。包含三点:(1) 提出 EMHO,用内外双循环迭代地分析执行轨迹与历史 harness 修改记录,自动提出并验证 harness 修改,优化范围覆盖进度监控、视觉工具使用、观察落地与失败恢复等全部机制而非仅限技能或恢复提示;(2) 提出 EMHO-Merge,研究单一共享 harness 能否跨多个子任务联合优化,用回合级增益与损失引导证据支持的修复以缓解子任务间的行为冲突;(3) 在 EmbodiedBench 的导航与操作任务上用 9B 和 27B 两个模型量化验证,并定性分析进化后的 harness 究竟如何改变了智能体感知与行动的方式。
与已有工作不同的是,本文的独特切入角度在于把「整个 harness」而非某个局部组件作为进化对象。已有的具身自改进工作都聚焦单一组件:EmbodiSkill 通过轨迹反思修订可复用技能,VASO 用验证与反例引导技能进化,ASPIRE 迭代进化任务专用代码并积累成功修复为技能,Zetta 进化运行时批评器与恢复行为——当问题根源出在规划、上下文构建或工具编排时,这些方法无能为力。另一条线是编程智能体的 harness 优化(Meta-Harness、Self-Harness、AutoSaddler),但它们依赖显式诊断信号(失败测试、异常),难以迁移到只有稀疏动作级反馈和延迟成败信号的具身环境。EMHO 首次证明:在这种弱诊断反馈下,让优化器同时阅读完整经验轨迹(诊断为什么失败)和 harness 修改历史(避免重复无效修改),就能可靠地驱动 harness 整体进化,且进化会自然地从失败恢复扩展到非恢复类的进度监控、工具编排与感知落地机制。
核心方法
直觉上,EMHO 把 harness 当成可以不断改代码的软件项目,让一个优化器智能体扮演工程师:读交互日志找出反复出现的行为缺陷,参考以前的修改记录,提出有证据支撑的修改,实测后只有提高成功率才采纳。技术上,框架在冻结模型 $M$ 上交替执行两阶段。内循环(经验轨迹收集):第 $i$ 轮用父代 $H^{(i)}_{\text{par}}$ 在搜索集 $\mathcal{D}_{\text{search}}$ 执行任务,记录轨迹 $T_e=(x_e,\{(o_t,p_t,z_t,a_t,f_t)\}_{t=1}^{T_e},y_e)$,即观察、计划、工具交互、动作与环境反馈的完整序列加最终成败 $y_e$。外循环(历史感知精炼):优化器 $\mathcal{O}$ 综合截至当前的全部经验 $E^{(0:i)}$ 与 harness 历史 $H^{(0:i)}_{\text{hist}}$,提出候选 $\tilde{H}^{(i+1)}=\mathcal{O}(H^{(i)}_{\text{par}},E^{(0:i)},H^{(0:i)}_{\text{hist}})$,按贪心规则更新:仅当候选的搜索集成功率 $s(H)=\frac{1}{|\mathcal{D}_{\text{search}}|}\sum_{e}y_e(M,H)$ 高于父代时才替换父代。每个任务迭代 10 轮。
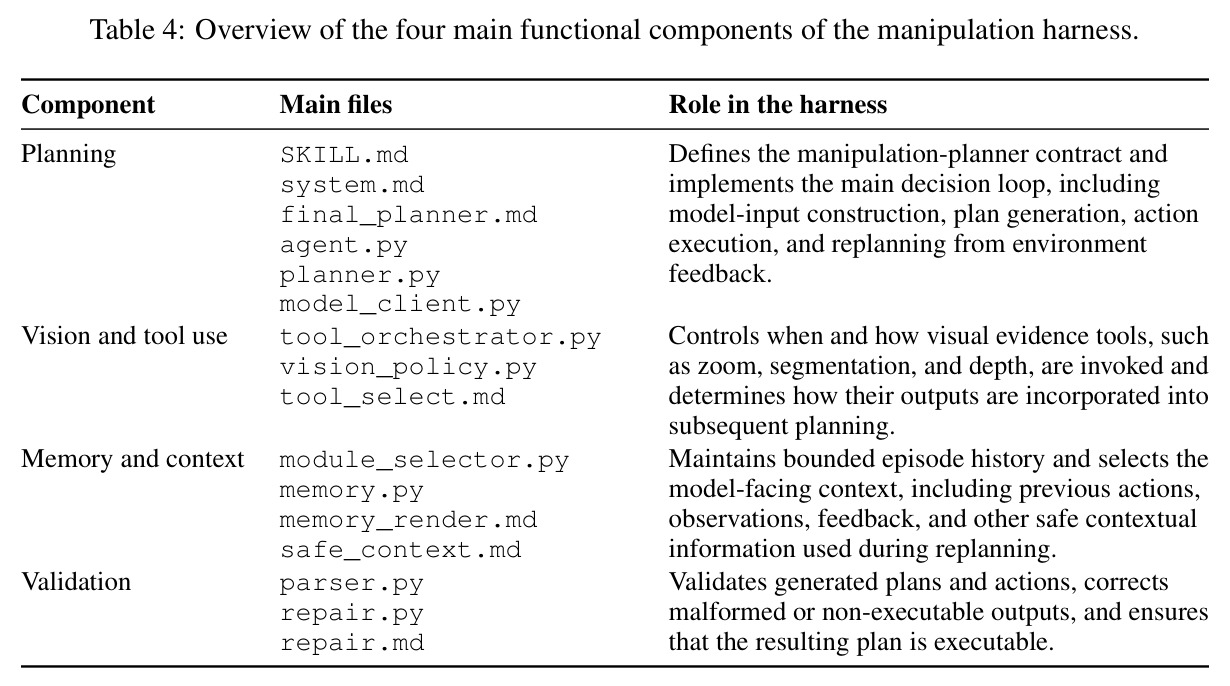
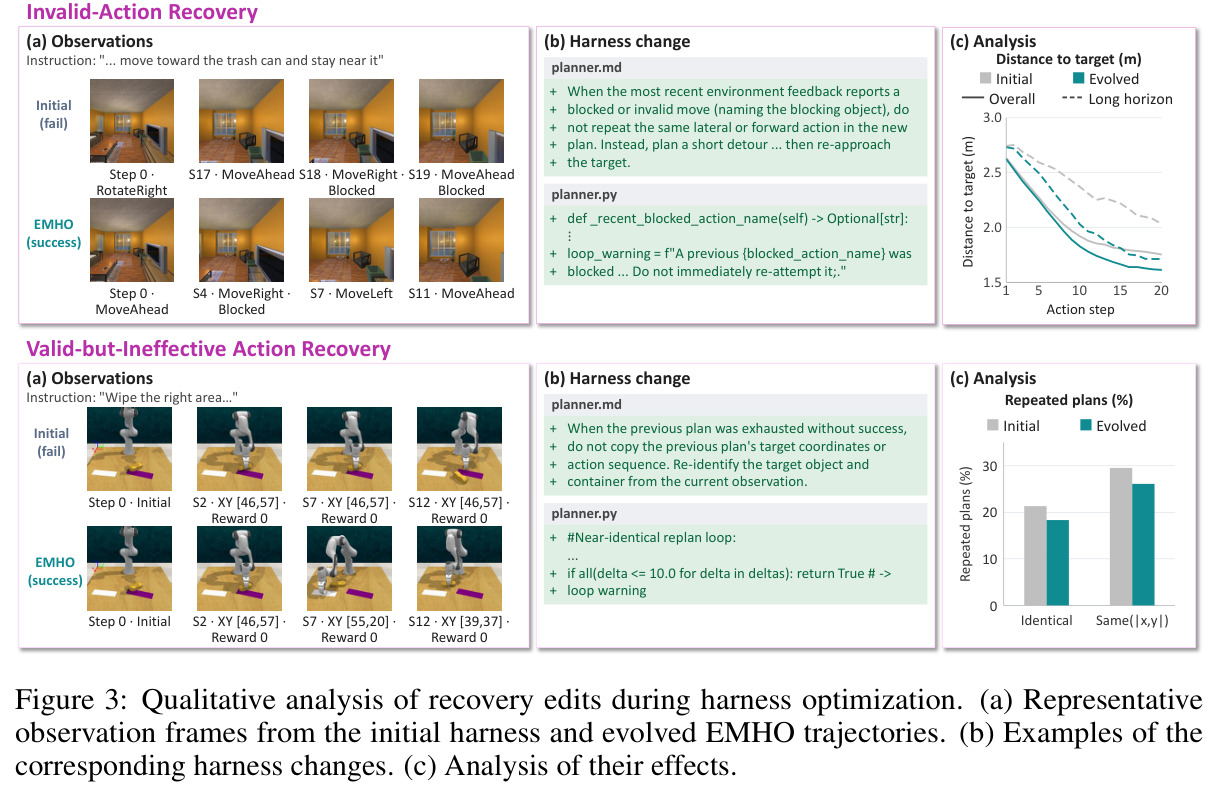
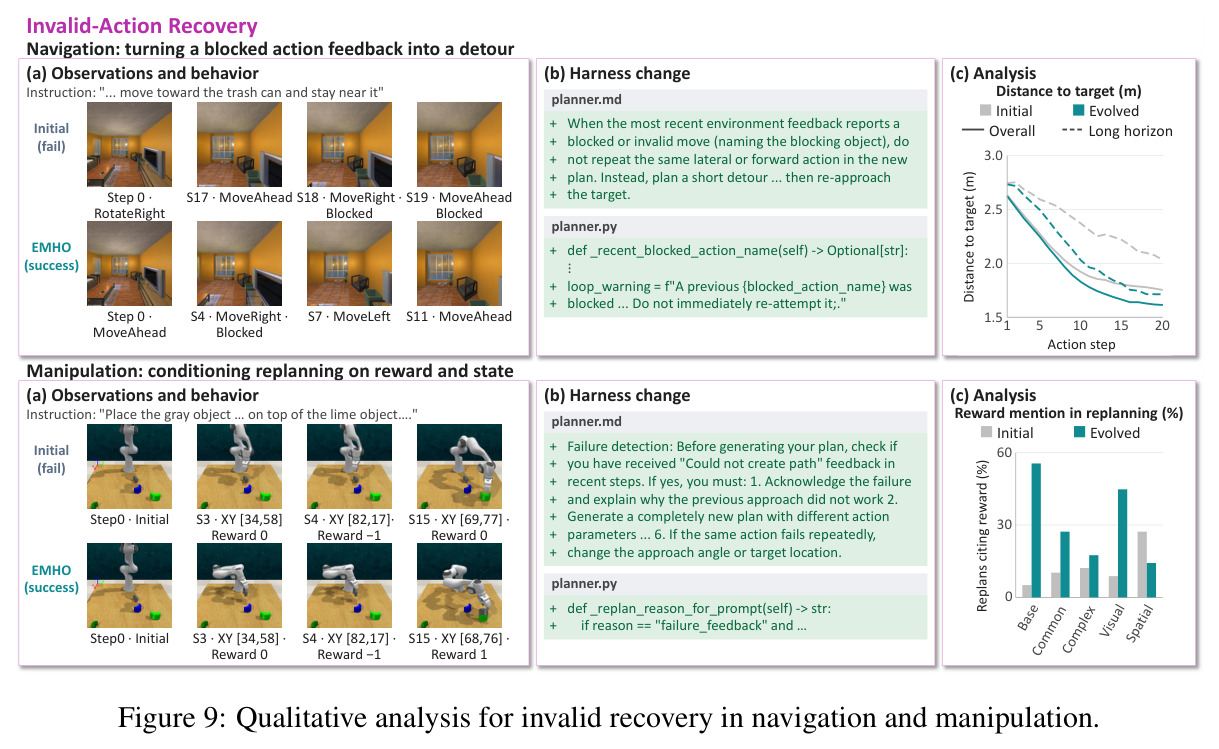
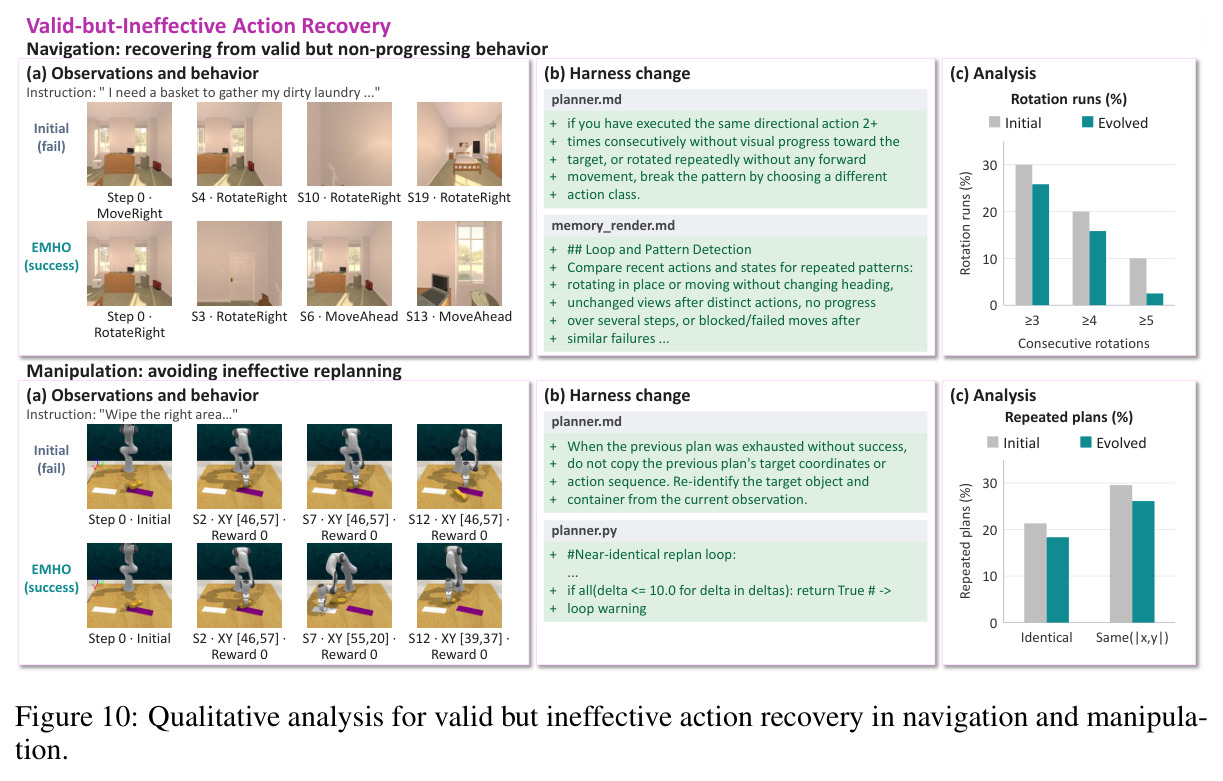
核心创新是「让框架优化框架」。与技能库积累(EmbodiSkill)或恢复提示进化(Zetta)不同,EMHO 的优化器可直接编辑 harness 的四类运行时组件——规划、视觉与工具使用、记忆与上下文、输出校验——因此修改可以是代码级机制而非纯文字建议,例如新增 `_recent_blocked_action_name()` 把阻挡信息持久化进上下文、检测近重复重规划(连续计划坐标差 $\le 10$ 判为循环)。第二个关键设计是双历史上下文:经验轨迹提供「为什么失败」的行为证据,修改历史提供「什么已试过、效果如何」的回归证据,消融显示缺一不可(导航 Base:完整 76.7%,去轨迹 70.0%,去历史 66.7%,仅分数 63.3%)。第三个创新是 EMHO-Merge 的增益-损失修复:当一次修改让部分回合由败转胜($G^{(i)}$)、另一些由胜转败($L^{(i)}$)时,优化器必须对比修改前后的配对轨迹,找出区分行为有益与有害的可观察条件,然后收窄触发条件而非另起炉灶,且每个机制仅允许一次被评估的修复,$r^{(i)}=\mathbb{I}[|G^{(i)}|>0\wedge|L^{(i)}|>0\wedge\text{repair unused}]$。
方法步骤详情
流程五步。第一步初始化:以 EmbodiedBench 官方实现为初始 harness(规划、视觉工具、记忆、校验四组件),每个子任务均分为不相交的搜索集与留出集,智能体配备 Depth Anything 3、SAM 3 与 zoom 工具。第二步内循环执行:当前 harness 在搜索集跑完所有回合,环境只反馈动作级结果(导航 valid/invalid/blocked,操作 $-1/0/1$ 奖励加持握状态),完整轨迹落盘为经验。第三步诊断与修改:优化器(与执行体同一个 Qwen 模型)读取搜索证据文件与 frontier.json,识别重复失败模式,在允许编辑的文件白名单内做连贯修改——修改必须通用、非回合特定,禁止使用留出数据、隐藏模拟器状态或最短路径,理由必须引用 event_id 等证据;并执行回归感知编辑:低分子代添加过的规则不要原样重复,除非证据表明新版本能避开回退。第四步评估与贪心更新:候选分数高于父代才替换 $H_{\text{par}}$,被拒候选的轨迹仍进入经验池供后续参考。第五步 EMHO-Merge 联合优化:合并三个子任务的搜索集优化单一共享 harness,每次评估后计算增益集 $G^{(i)}$ 与损失集 $L^{(i)}$,两者均非空且修复未用则进入 repair_or_new 模式——核查增/失回合的父代与候选配对轨迹,找到区分条件后才收窄触发条件修复,否则提出真正不同的新机制。每任务迭代 10 轮。
技术新颖性
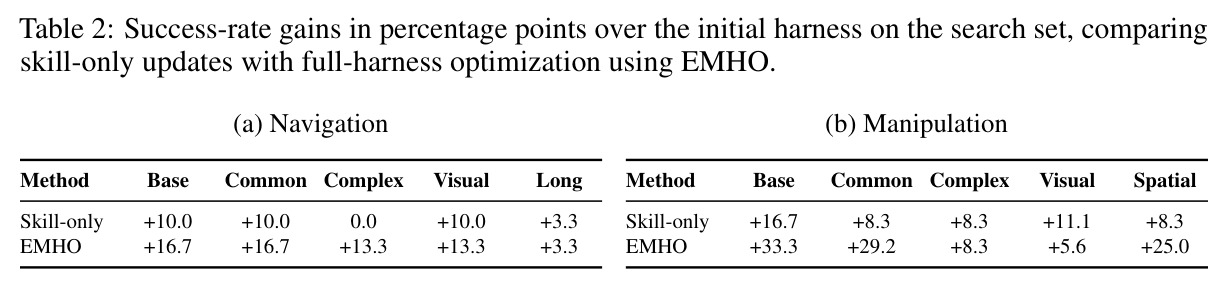
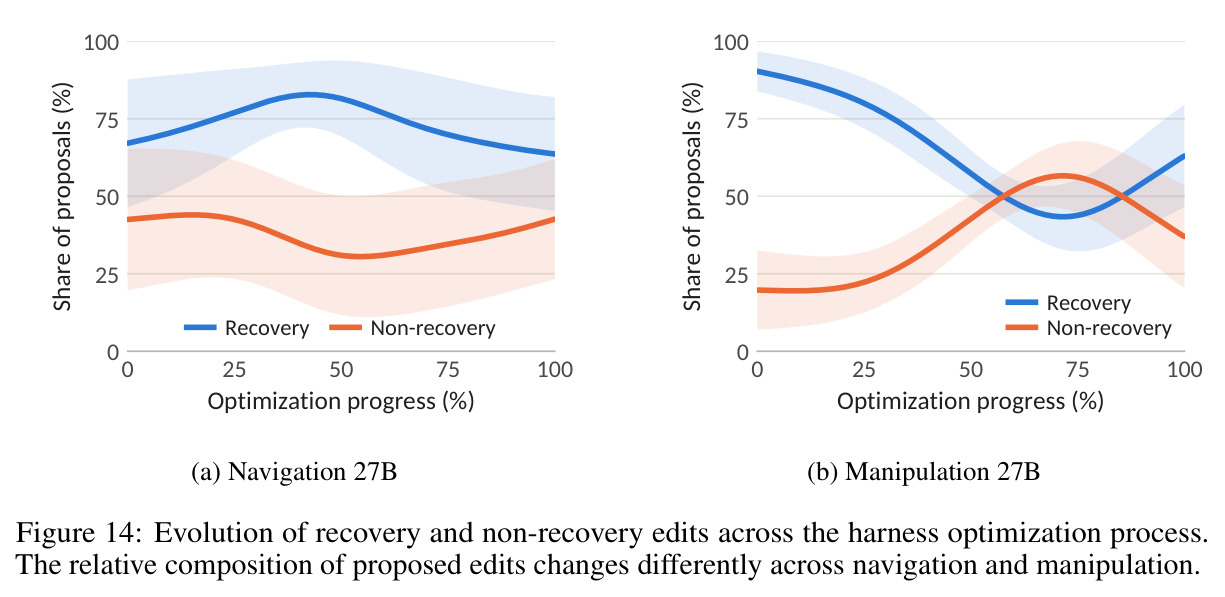
新颖性有四层。其一,优化对象从「组件」上升到「系统」:已有方法只动技能或恢复组件,EMHO 的搜索空间覆盖进度监控、工具编排、感知落地等此前无人触达的机制,Table 2 证明其增益显著更大(操作 Base +33.3 对 skill-only +16.7 个百分点)。其二,稀疏反馈下的可诊断性:编程 harness 优化依赖失败测试等强信号,EMHO 靠轨迹+修改历史双上下文弥补信号缺失,消融直接验证(76.7% 对仅分数反馈 63.3%)。其三,EMHO-Merge 把多任务联合优化建模为「增益-损失」配对分析,用一次性的、证据强制的修复缓解共享 harness 的行为冲突,而非简单混合经验池——纯 Combined 确实引入冲突:被阻挡后先侧移再前进的规则在 Base 导航有效,却在长视野任务反复触发、把智能体导进附近障碍物。其四,揭示进化的时间结构:恢复类编辑主导早期,非恢复类编辑在系统具备失败响应后才涌现,且规则随代际细化(从「不要重复被阻挡动作」到「按阻挡方向、目标朝向和清障距离选择响应」),说明优化器在把通用建议转化为上下文相关的具体策略。
实验结果
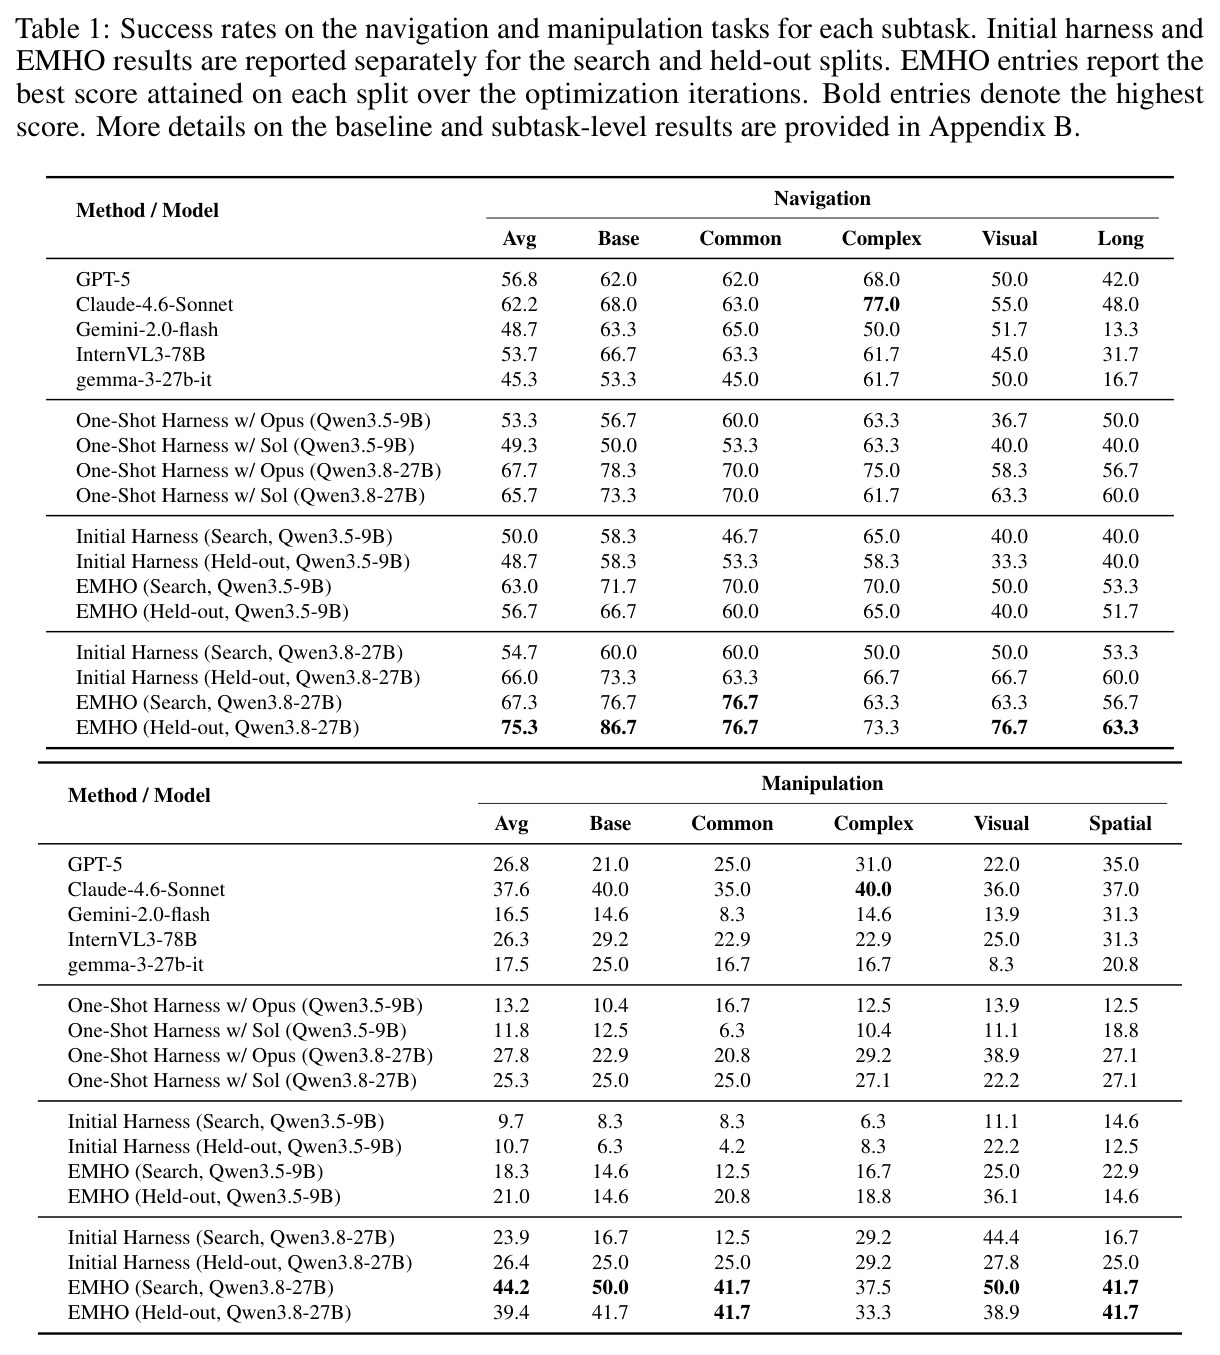
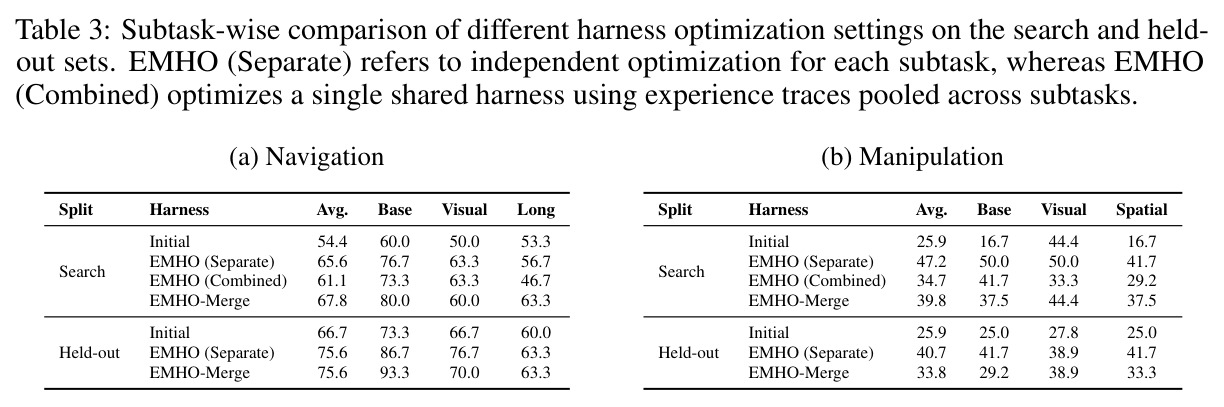
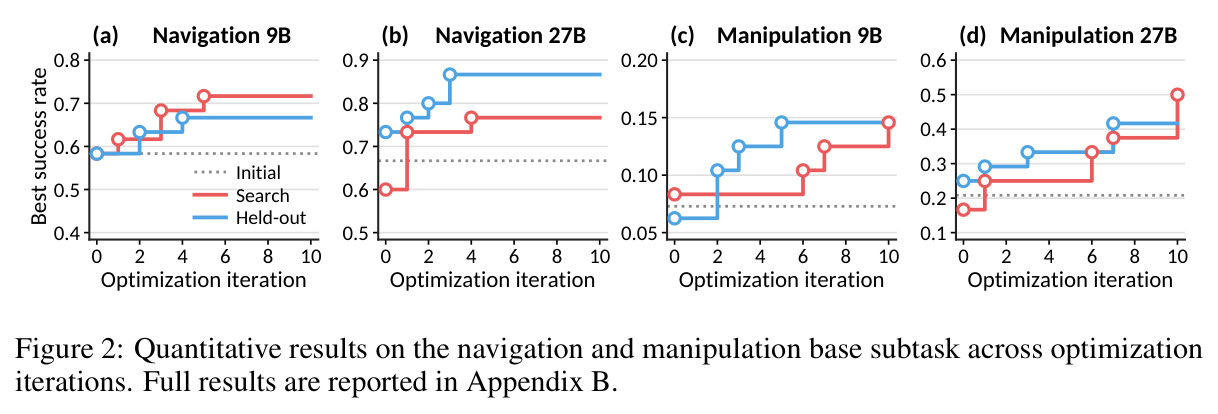
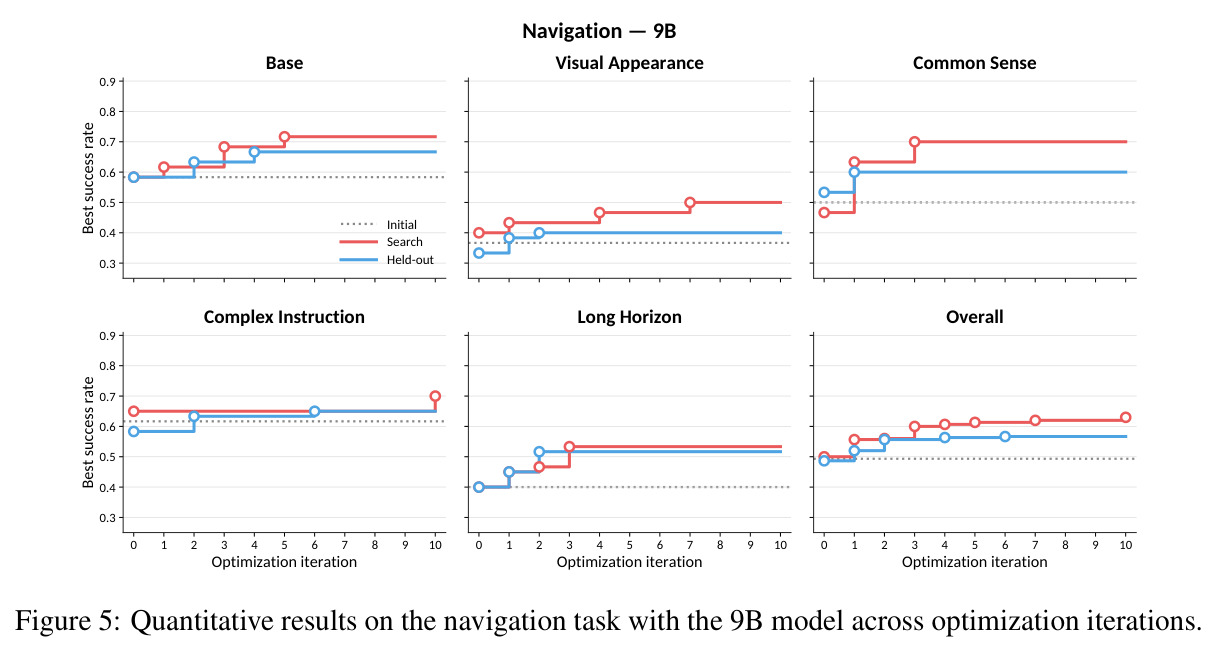
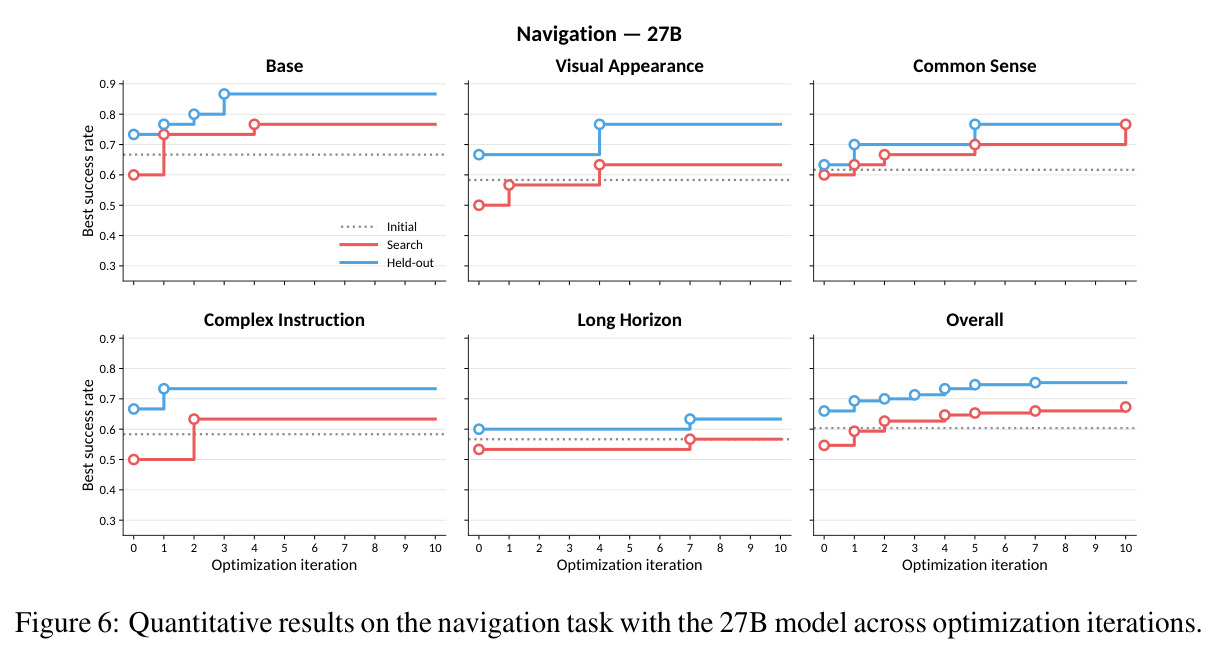
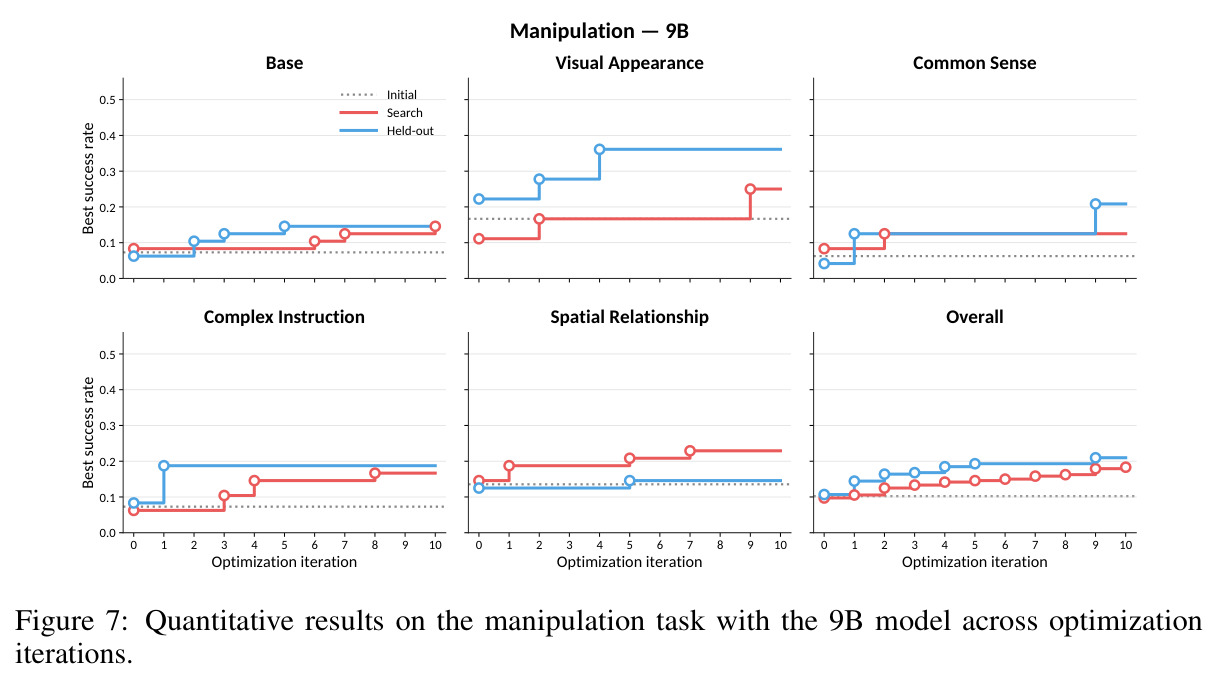
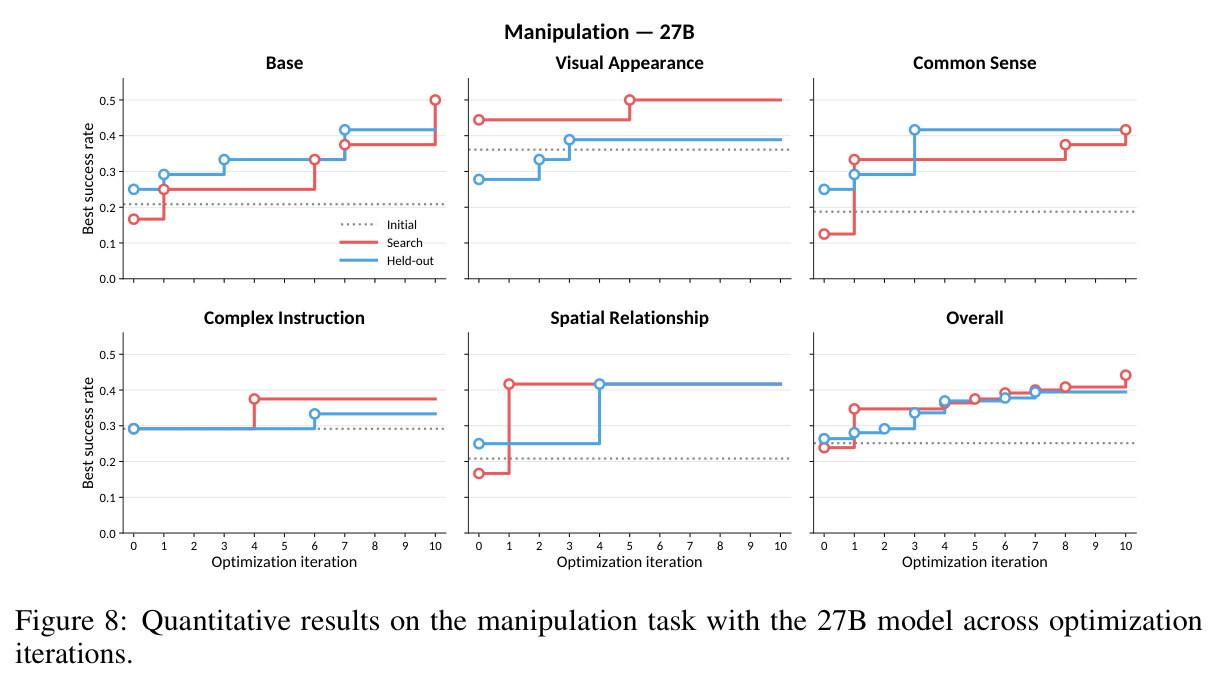
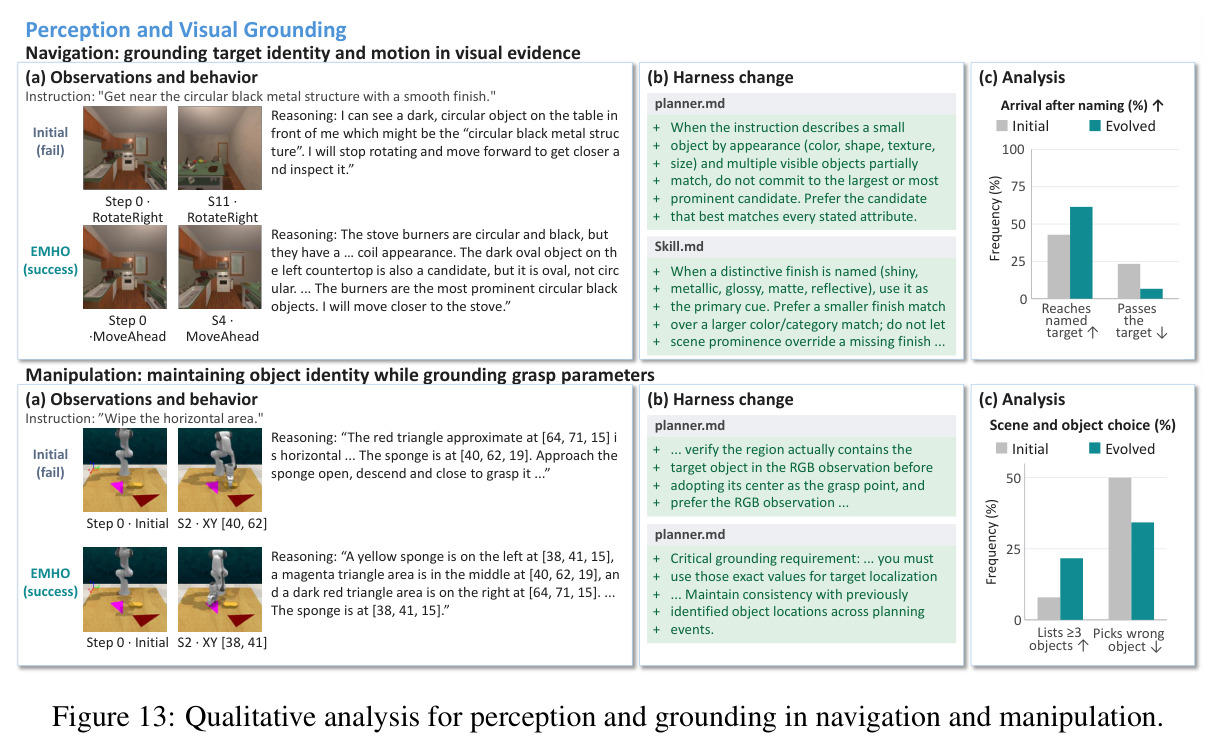
主结果(Table 1):EMHO 在两个模型、两个域上一致提升成功率。导航 27B:搜索集 54.7→67.3,留出集 66.0→75.3;导航 9B:搜索集 50.0→63.0,留出集 48.7→56.7,9B 进化后已可与 GPT-5(56.8)、InternVL3-78B(53.7)竞争。操作提升更大:27B 搜索集 23.9→44.2(Base 16.7→50.0),留出集 26.4→39.4;9B 搜索集 9.7→18.3。最大单项增益为导航 +23.3、操作 +33.3 个百分点。与前沿一次性修订对比:Claude Opus-5 修订的 9B 导航平均 53.3,低于 EMHO 的 63.0;且 one-shot 只给宽泛建议(遇到循环换策略),EMHO 生成具体操作条件(被阻挡时终止剩余计划、不重试同方向、从新观察重规划)。与 skill-only 对比(Table 2):全 harness 优化在导航 Complex +13.3 对 0.0、操作 Base +33.3 对 +16.7,说明价值在于改变系统使规则能被检测、触发和执行。EMHO-Merge(Table 3):导航搜索集 67.8 高于 Separate 65.6 与 Combined 61.1;操作搜索集 39.8 高于 Combined 34.7 但低于 Separate 47.2。消融(Table 5):完整 76.7% > 去轨迹 70.0% > 去历史 66.7% > 仅分数 63.3%。行为级验证:阻挡后深度工具调用 70%→近 100%、后续有效动作 44%→68%;命名目标后到达率 43%→62%;连转 ≥5 次比例 10%→3%;场景描述列 ≥3 物体 8%→22%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 具身导航(Qwen3.8-27B,留出集平均,5 个子任务) | 任务成功率 (%) | 75.3 | 66.0(初始 harness) | +9.3 个百分点 |
| 具身导航(Qwen3.5-9B,搜索集平均) | 任务成功率 (%) | 63.0 | 50.0(初始 harness);GPT-5 为 56.8 | +13.0 个百分点,超过 GPT-5 与 InternVL3-78B(53.7) |
| 具身操作(Qwen3.8-27B,搜索集平均) | 任务成功率 (%) | 44.2 | 23.9(初始 harness);Claude-4.6-Sonnet 为 37.6 | +20.3 个百分点,超过所有公开大模型基线 |
| 具身操作(Qwen3.5-9B,留出集平均) | 任务成功率 (%) | 21.0 | 10.7(初始 harness) | +10.3 个百分点 |
| 导航(Qwen3.5-9B)对比前沿模型一次性 harness 修订 | 搜索集平均成功率 (%) | 63.0(EMHO) | 53.3(One-Shot w/ Claude Opus-5)、49.3(One-Shot w/ GPT-5.6 Sol) | +9.7 / +13.7 个百分点 |
| 全框架优化 vs 仅技能优化(操作 Base 子任务,搜索集) | 相对初始 harness 的成功率增益(百分点) | +33.3(EMHO) | +16.7(skill-only) | 增益翻倍,说明 harness 级修改(监控/工具/落地)不可替代 |
| EMHO-Merge 共享 harness(导航三子任务合并,搜索集) | 平均成功率 (%) | 67.8 | 61.1(EMHO Combined,池化经验)、65.6(EMHO Separate,分任务优化) | 对 Combined +6.7 个百分点,甚至超过分任务优化 |
| 消融:优化上下文(导航 Base 子任务,搜索集) | 成功率 (%) | 76.7(完整:经验轨迹+harness 历史) | 70.0(去轨迹)/ 66.7(去历史)/ 63.3(仅标量分数) | +6.7 ~ +13.4 个百分点,证明两类历史信息互补且缺一不可 |
局限与改进
作者承认的局限:第一,搜索集最优的 harness 未必是留出集最优的,多次运行中出现后期迭代搜索性能继续提高而留出性能停滞甚至下降的过拟合模式;且论文明确说明留出集数字是「回溯性候选最大值」而非单一选中 harness 的泛化估计,Table 1 的留出集对比应谨慎解读。第二,每次优化仅 10 轮迭代、每个机制只允许一次修复,搜索预算很小。第三,实验局限于 EmbodiedBench 仿真与两个 Qwen 模型,未涉及真实机器人或跨环境迁移。我自己的观察:其一,优化器与执行体是同一个模型,进化质量强依赖该模型作为「工程师」的能力,缺少用更强 frontier 模型当优化器的系统对比;其二,每轮候选都需在搜索集完整评估,计算成本不低,论文未报告 token 或时间开销;其三,EMHO-Merge 在操作留出集低于 Separate(33.8 对 40.7),增益-损失修复未完全解决难任务上的权衡;其四,行为级指标多为 post-hoc 统计且部分样本量小(如重规划重复 21%→18%),未报告统计显著性。
独立分析的弱点
独立分析发现以下弱点。第一,选择机制脆弱:父代更新仅按搜索集分数贪心保留,没有早停或验证机制,过拟合时会持续采纳搜索集特化的修改——改进方向是把留出集的一部分转为验证集用于迭代选择,或对修改的复杂度(规则数量、代码行数)施加正则。第二,样本效率低:每轮候选需全搜索集评估,10 轮最多约 10 次完整评估,若子任务更多或回合更长成本线性膨胀——可引入廉价的代理筛选(如小子集预评估)或并行候选提议。第三,修复机制过于保守:每机制仅一次修复机会、且要求优化器从配对轨迹中人工找出区分条件,在复杂权衡下可能需要多次修复才能收敛——可改为预算制多次修复或自动条件搜索。第四,对「有效但无效」行为的检测依赖启发式(如连续计划坐标差 ≤10 判为循环),容易漏检语义重复而误报数值巧合——改进方向是在 harness 中内置更丰富的可计算进度探针(目标距离、场景变化度量)供优化器直接使用。第五,跨模型/跨环境迁移未验证:为 27B 进化的 harness 对 9B 或其他模型家族是否仍有效未知,而这些机制(循环检测、工具编排规则)按理是相当模型无关的——这是走向通用 harness 的重要缺口,也应是下一个实验。
未来方向
作者提出的方向:应对搜索-留出发散的过拟合,需要在候选选择中显式考虑泛化,而不是只看搜索集分数。基于本文成果可延伸的研究:第一,泛化感知的 harness 选择与融合——用独立验证信号挑选稳健版本,或对多个高分候选 harness 做行为级集成;第二,harness 的可迁移性——同一进化 harness 能否零改动服务不同规模/家族的模型、不同仿真器乃至真实机器人,「模型无关的 harness 中间表示」是自然下一步;第三,与底层模型训练结合——进化过程中积累的失败模式统计可作为 SFT/RL 数据筛选或课程设计的信号,形成 harness 与权重的协同进化;第四,扩展优化预算与子任务规模,研究 10 轮之外收益曲线是否继续上升,以及 EMHO-Merge 的修复机制能否推广到几十个子任务的联合优化;第五,把优化器与执行体解耦——用强 frontier 模型优化弱开源模型的 harness,研究这种「师生框架优化」的收益边界。
复现评估
复现评估:论文声明代码将开源(正文写 “The code can be found here”,arXiv 文本中链接为占位,需关注仓库正式发布)。基准 EmbodiedBench 公开可用(ICML 2025),外部基线数字取自其论文与 Embodied Tool Protocol;Depth Anything 3、SAM 3 均有公开实现。算力需求:需本地部署 Qwen3.5-9B 与 Qwen3.8-27B-FP8 推理(27B 为 FP8 量化,80GB 级单卡或少量多卡可行),每任务 10 轮迭代、每轮需在约 30 个搜索回合上完整评估候选并运行优化器。工程细节披露较充分:优化器提示词在附录 A 完整给出(含回归感知约束与 repair_or_new 工作流),harness 四组件结构在 Table 4 说明,进化后 harness 的完整 diff 在附录 E 展示。总体难度中等偏上:主要工程量在于搭建候选评估循环、证据文件格式与文件白名单机制;模拟器评估随机性、搜索集是否每次重跑等影响比较公平性的细节论文未详述,复现时需自行确认。
论文图表