DAEDALUS:从自生成任务中自举智能体程序性记忆 DAEDALUS: Bootstrapping Agent Memory from Self-Generated Tasks
让智能体自出练习题,把失败翻转为反复成功后才入库的启发式记忆,免训练提升成功率15.9点
前置知识
LLM 智能体(Agent)
以大语言模型为大脑、在环境中循环执行「观察—推理—行动」的系统。它通过调用 API、执行代码或函数调用与环境交互,按步推进直到完成任务或达到步数上限。性能常用成功率(MSR)和平均轮数衡量。
本文的一切都围绕智能体展开:Explorer、Solver、Judge 等都是承担不同角色的 LLM 智能体,基座智能体则是记忆的最终使用者。
程序性记忆(Procedural Memory)
智能体从过往尝试中沉淀下来的「怎么做」知识,通常以自然语言洞察、指南或技能库形式存在,在测试时注入上下文,不改动模型权重。与之相对的声明性记忆存「是什么」,程序性记忆存操作规程和环境惯例。
DAEDALUS 的产出物就是一个启发式记忆库;理解它与技能库、工作流记忆的区别(无需验证器、无需训练)是把握论文定位的关键。
$\text{pass}^k$ 指标
$\tau$-bench 提出的可靠性指标:同一任务独立跑 $k$ 次,只有 $k$ 次全部成功才算通过。它衡量智能体的稳定性而非平均能力,通常远低于单次成功率,例如本文 AppWorld 基线的 MSR 为 44.3% 但 $\text{pass}^5$ 仅 14.9%。
论文主表同时报告 MSR 和 $\text{pass}^5$,后者提升 1.7-2.2 倍是「记忆让智能体更稳定」这一结论的核心证据。
AppWorld / τ²-bench / AutomationBench
三个智能体基准:AppWorld 模拟 9 个 App 的代码级自动化(168 个测试任务);τ²-bench 是对话式客服(本文只用 retail 域 40 个任务);AutomationBench 是 SaaS 业务工作流(Operations 划分 70 个测试任务)。任务由官方验证器判定成功。
所有实验都在这三个环境上进行,划分(如 AppWorld 90 训练/168 测试)、成本和难度差异直接决定结论的适用范围。
自博弈与自动课程(Self-play / Curriculum)
让一个模型同时扮演出题者和解题者,奖励「有挑战但可验证」的任务,使训练信号始终落在能力边缘。此前这类方法(SPICE、SPADE 等)都用生成的任务更新模型权重。
DAEDALUS 借用了 proposer-solver 课程思想,但目标是构建上下文记忆而非更新权重,且任务难度由 Solver 循环的成败反馈来校准。
Reflexion 式言语强化学习
智能体失败后不更新参数,而是由 LLM 反思失败轨迹、生成文字教训并在重试时放入上下文,相当于用自然语言做「策略梯度」。ExpeL、ERL、ReasoningBank 都属这一谱系。
DAEDALUS 的 Extractor 正是从失败轨迹写启发式,但它额外要求启发式经受住后续 $N_s=3$ 次连续成功的实证检验,这是与 Reflexion 谱系的本质分野。
Kendall $\tau$ 与 Cohen $\kappa$
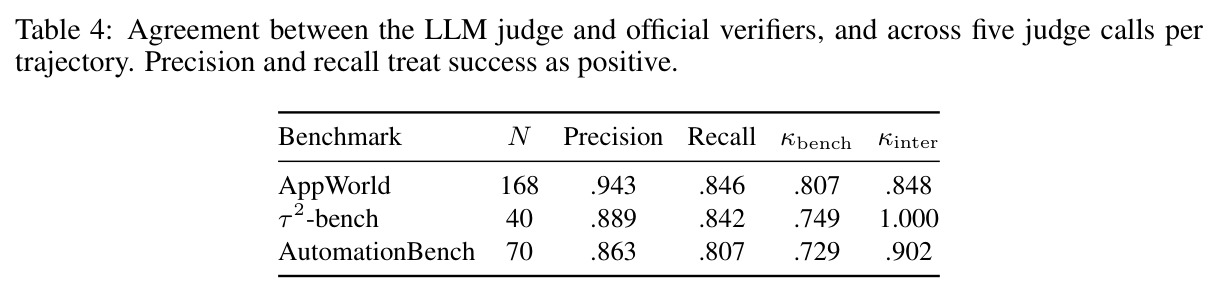
$\tau$ 度量两个排序的一致性(1 为完全一致);$\kappa$ 度量两次分类判定在剔除随机吻合后的一致性,0.6-0.8 为显著一致、0.8 以上为高度一致。文中 $\kappa_{\text{bench}}$ 是 LLM Judge 与官方验证器的一致性,$\kappa_{\text{inter}}$ 是 Judge 多次判定之间的一致性。
Judge 是 DAEDALUS 唯一的成功信号,评测代理实验靠 $\tau=0.89$ 立论,读懂这两个系数才能判断这些声明有多可靠。
研究动机
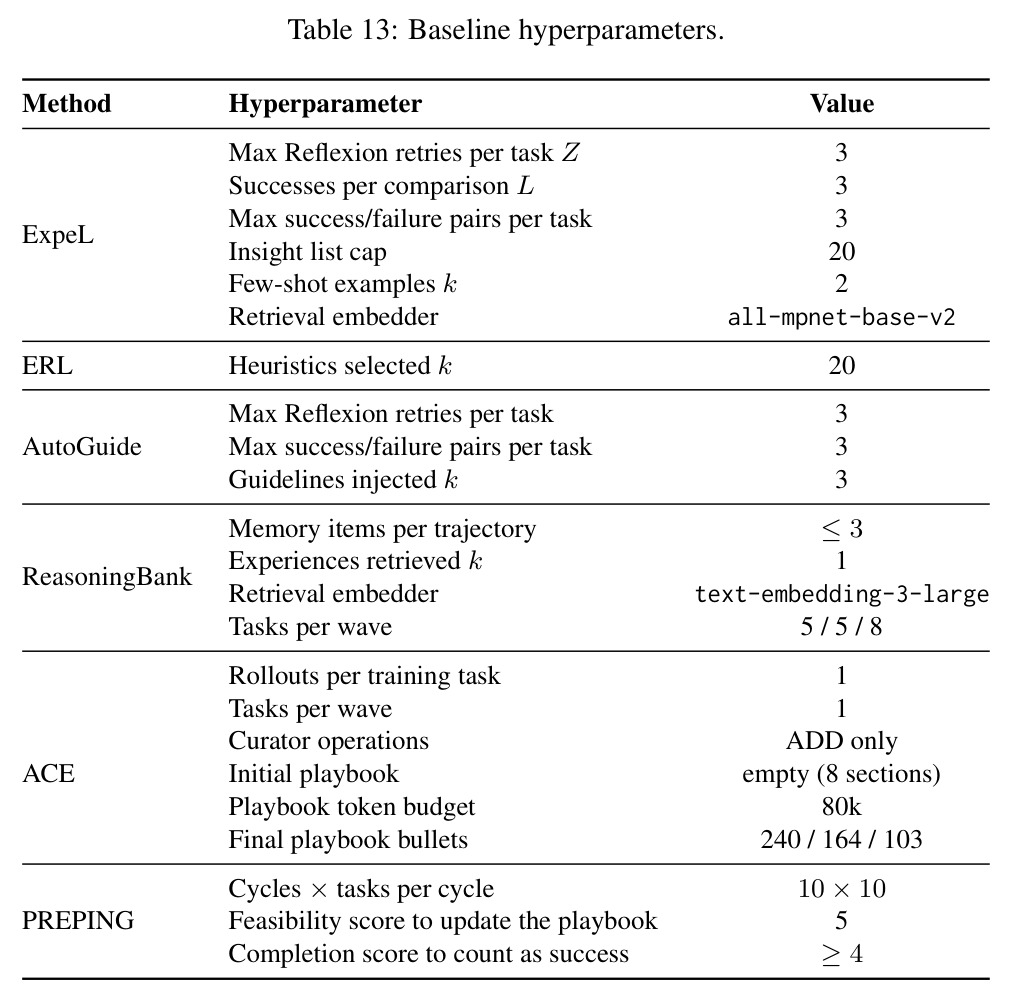
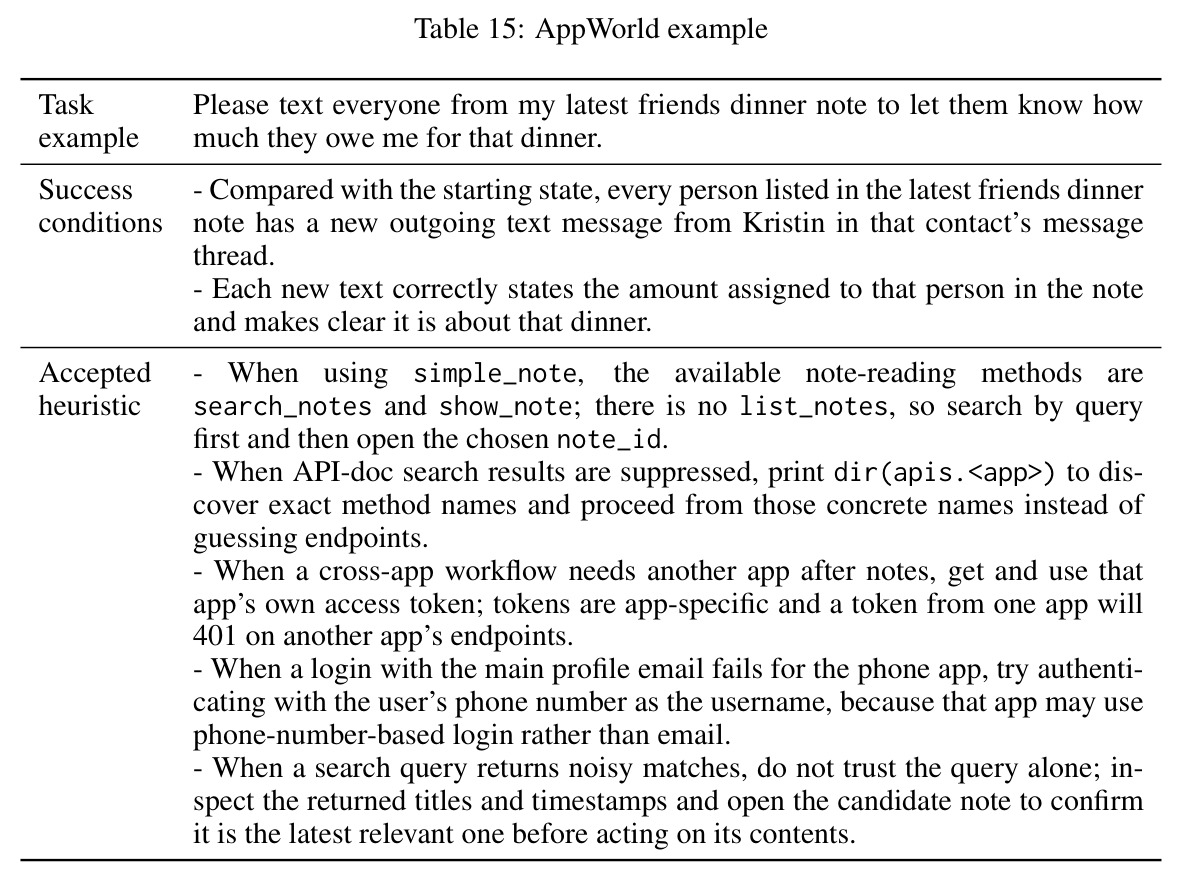
LLM 智能体进入新环境时缺少「操作知识」:不知道 simple_note 应用只有 search_notes 而没有 list_notes、不知道访问令牌按应用隔离(拿 Spotify 的令牌调 Venmo 会 401)、不知道某些 App 要用手机号而非邮箱登录。没有程序性记忆时,它会在任务间重复踩同样的坑,导致失败更多、轨迹更长、成本更高。现有补救都要求预先监督:一是人工撰写指南,费时费力;二是从训练任务集中挖掘记忆(ExpeL、AutoGuide、ERL、ReasoningBank、ACE),但这要求存在一批来自目标分布的标注任务和 oracle 验证器——构建 AppWorld 这样的基准本身就需要大量人力,对绝大多数环境不可得,尤其是如今大量智能体环境由程序自动生成、根本没有人工任务集;三是在测试时从在线任务中积累经验(ReasoningBank 的另一用法),但智能体接手的头一批任务只能「裸奔」,必须先失败才能变强。经验只能来自「它本该服务的任务」,这个依赖是所有现有方法的共同软肋。
本文的目标是本文目标是:在不更新模型权重、不需要任何人工任务集、也不依赖 oracle 验证器的前提下,让智能体对一个新环境进行自主练习,自举出一个可复用的文本启发式记忆库,测试时注入上下文即可提升成功率(MSR)和跨运行稳定性($\text{pass}^5$ 提升 1.7-2.2 倍),同时推理成本不高于无记忆基线。方法还需满足三个派生目标:记忆能跨模型家族迁移(用 A 家模型生成、给 B 家模型用);增益在小探索预算下即可兑现(几个 session 就有用);生成的任务能附带充当评测代理,在没有测试集的环境中为不同模型排序。
与已有工作不同的是,独特切入有二。其一,任务生成的目标函数不同:PREPING 等自生成任务方法偏爱「可行」或「扩大覆盖面」的任务,而 DAEDALUS 刻意把任务校准到求解者能力的边缘——只有「智能体会先失败、但带着正确启发式就能反复成功」的任务才产生学习信号,太简单说明无教训可学,太难说明救不回来,两者都会被 Explorer 改题。其二,记忆验收标准不同:ExpeL、AutoGuide、ERL 等依据「生成这条洞察的轨迹本身成功了没有」来决定去留,这是事后归因;DAEDALUS 把每条启发式当作待检验假设,只有当它真的把一次失败翻转成 $N_s=3$ 次连续成功时才入库,这是对记忆条目本身的前瞻实验。两个设计叠加,形成了不依赖任何外部监督的「出题—做题—验证」记忆质量闭环。
核心方法
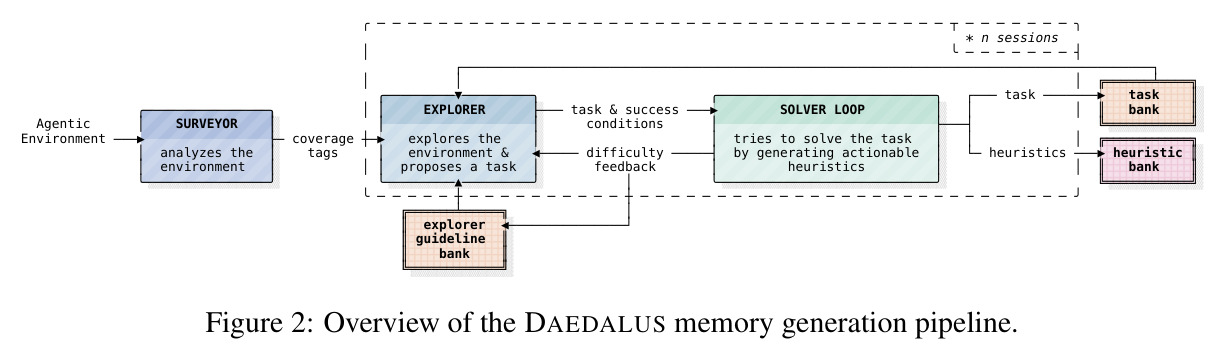
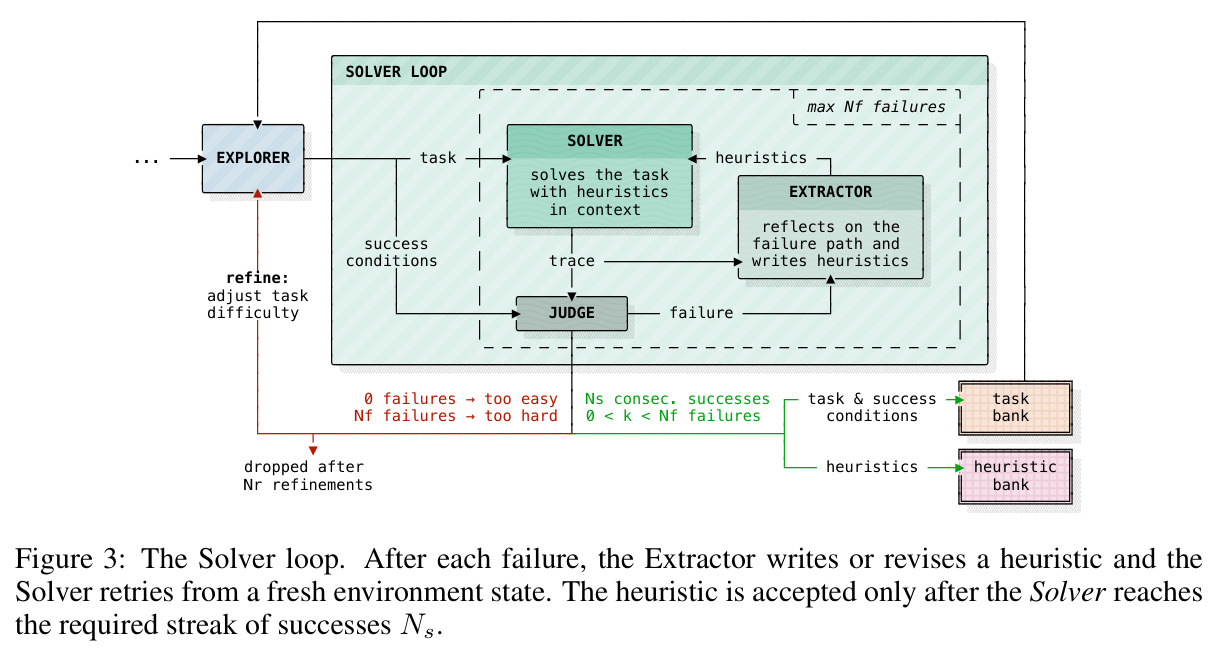
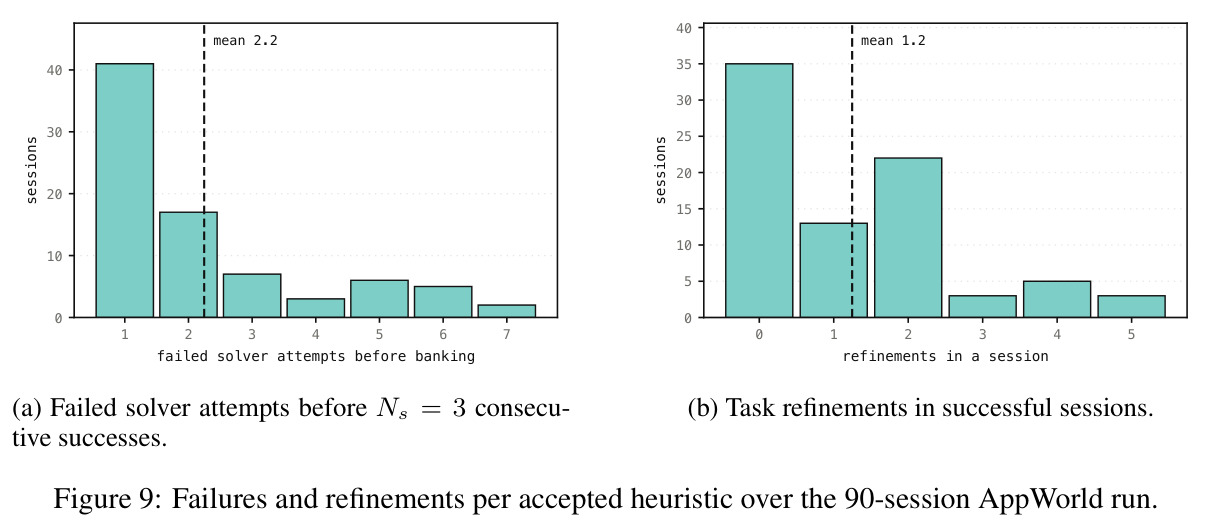
直觉上,DAEDALUS 让智能体像学徒一样刷题:先摸清环境,给自己出难度恰好的题,做错了总结教训,教训灵不灵要看下次是否真做对,最后把验证过的教训装订成手册带进考场。技术路线是花费一次性的 $n$ 个练习 session(AppWorld 上 $n=90$,对应 90 个训练任务以保证与基线公平),每个 session 嵌套两个循环:外层 Explorer 循环负责出题与调难度,内层 Solver 循环负责做题与提炼教训。具体地,Surveyor 先对环境做一次勘察,输出覆盖各区域的目标任务分布;Explorer 与环境交互,提出任务 $\tau=(u,\sigma)$(自然语言指令 $u$ 加显式成功条件 $\sigma$),并亲自完成一次以证明可行;随后 Solver 在重置的环境中尝试,LLM Judge 对照 $\sigma$ 判卷,失败时 Extractor 从指令与失败轨迹写出或修订一条启发式,Solver 带着它在上下文中重试;任务太简单或太难时 Explorer 收到反馈并修改任务(至多 $N_r=5$ 次)。全部 session 结束后,Consolidator 用一次 LLM 调用合并所有被接受的启发式,冻结成 65 条的记忆库,测试时在任务开始前一次性注入基座智能体。
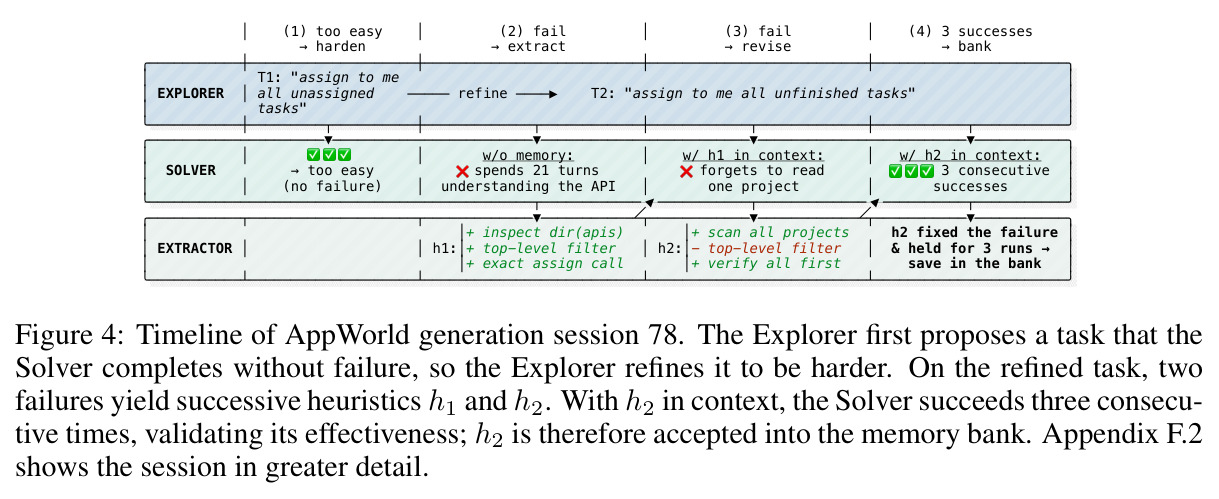
核心创新是「失败到成功的启发式验证」配「以能力边缘为目标的任务校准」。与已有方法的本质区别在验收环节:ExpeL、AutoGuide、ERL、ReasoningBank 依据来源轨迹的结果保留洞察,PREPING 依据任务可行性和完成度更新 playbook,都是对记忆质量的间接代理;DAEDALUS 直接对启发式做对照实验——它必须让 Solver 在曾经失败的任务上取得 $N_s=3$ 次连续成功才能入库,连续多次成功的要求显著降低了启发式靠运气过关的概率(附录 C 用反事实重放证实被接受启发式把 Solver 在自身任务上的 MSR 从 66.7% 提到 77.0%)。另一个关键约束是 Extractor 只看指令与失败轨迹、看不到具体漏掉了哪些成功条件,这逼它写出可泛化的环境经验而非针对判分条件打补丁。任务校准则把 Solver 循环的结果当免费难度信号:从未失败→加难,$N_f=8$ 次全败→降难,使出题始终悬在「会失败但可挽救」的边缘。
方法步骤详情
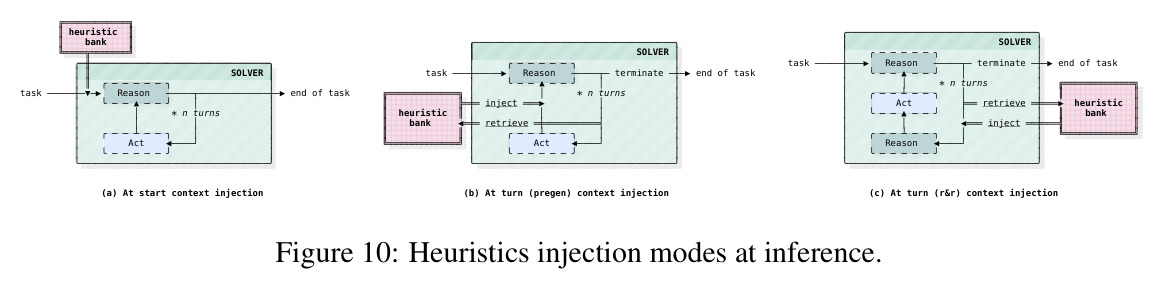
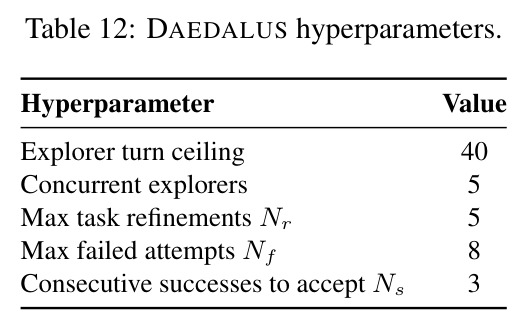
第一步,Surveyor 对环境做一次勘察(40 轮内),产出任务分布目标 $S$ 与覆盖状态 $C$。第二步,Explorer(并发 5 个)在 40 轮预算内与环境交互,提出任务与成功条件,并亲自解出以确认可行。第三步,Solver 循环:Solver 从重置环境尝试任务;Judge 将最终轨迹与成功条件 $\sigma$ 比对判卷;失败则 Extractor 写出(或修订)一条启发式 $h$,Solver 携带 $h$ 重试;终止条件为 $N_s=3$ 次连续成功或累计 $N_f=8$ 次失败,且此前至少失败过一次的启发式被接受,从未失败的任务标记太简单,全败任务标记太难。第四步,任务校准:Explorer 结合原题与循环结果改题至多 $N_r=5$ 次,改到合度才重新进入 Solver 循环;用尽改题次数的 session 无产出。第五步,需要改题的 session 结束后,其改题历史被浓缩为出题指南存入指南库 $G$,供后续 session 更快校准难度。第六步,Consolidator 以单次 LLM 调用合并全部被接受启发式(90 session 产出 88 条中的 65 条去重后入库),冻结为 $H^\star$;测试时采用 ALL@START 策略,任务开始前一次性注入基座智能体上下文。三个超参 $N_s=3, N_f=8, N_r=5$ 仅在 AppWorld 的少量预实验中设定,之后原样用于另外两个基准。
技术新颖性
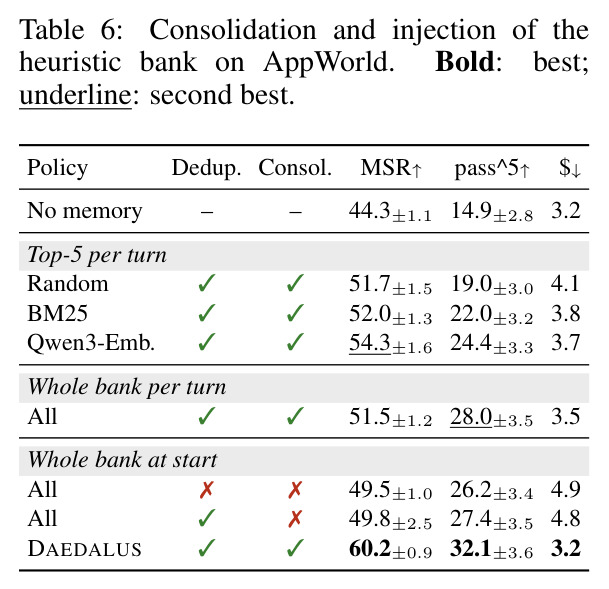
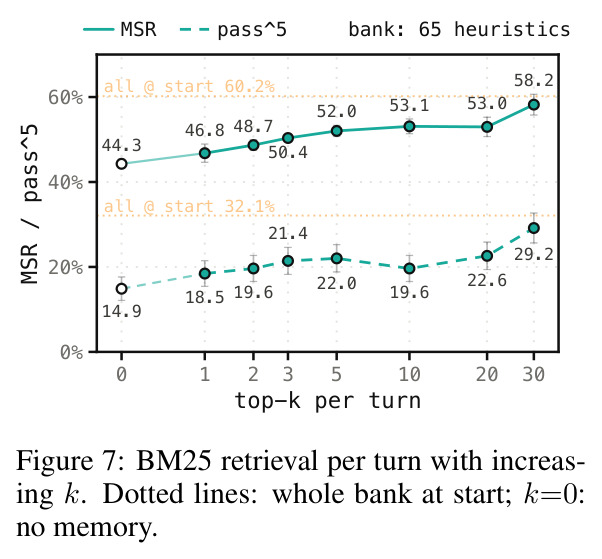
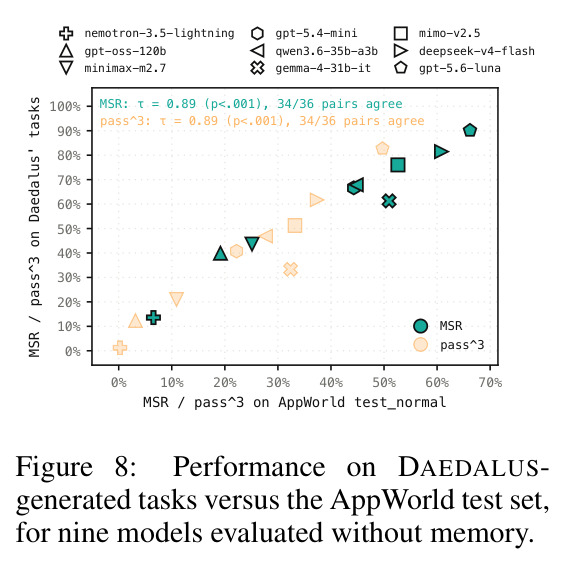
技术新颖性有五点。(1) 问题设定本身:这是首个在不给训练任务、不给 oracle 验证器的约束下,与「使用训练任务的方法」打平的记忆自举方法,同设定的唯一对手 PREPING 全面落于下风。(2) 验收协议:把记忆接受从「事后归因」升级为「前瞻对照实验」,$N_s$ 次连续成功对随机求解器有明确统计意义,这是与 Reflexion 谱系所有方法的本质差异。(3) 信号设计:隐藏漏判条件抑制过拟合,改题历史变指南提升生成效率(成本降 12%)。(4) 系统性结论:该规模下「整库合并+开局注入」以 60.2% MSR 显著胜过未合并注入的 49.5%,且 BM25、稠密检索、随机抽取在 $k=5$ 时无显著差异,作者据此提出记忆检索本质是「斜查询」(oblique retrieval)问题——有用的启发式与当前步骤在语义上未必相似。(5) 副产品价值:自生成任务给 9 个模型排序与官方测试集高度一致(Kendall $\tau=0.89$,36 对模型中 34 对次序相同),为无测试集环境提供了评测代理。
实验结果
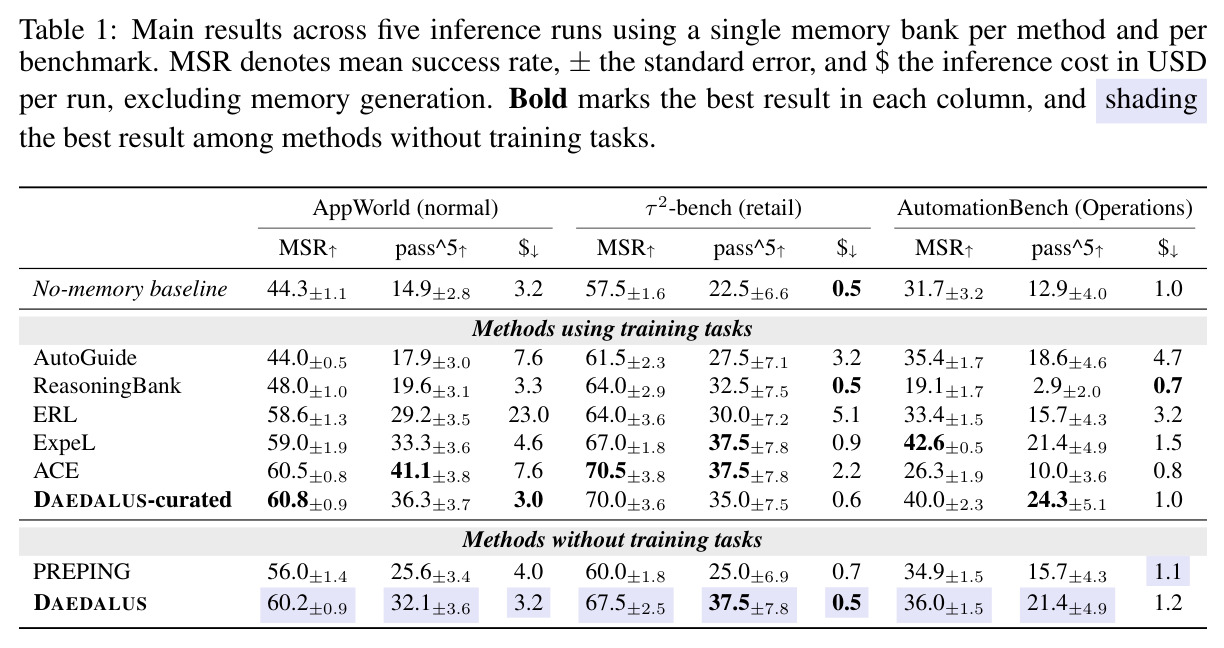
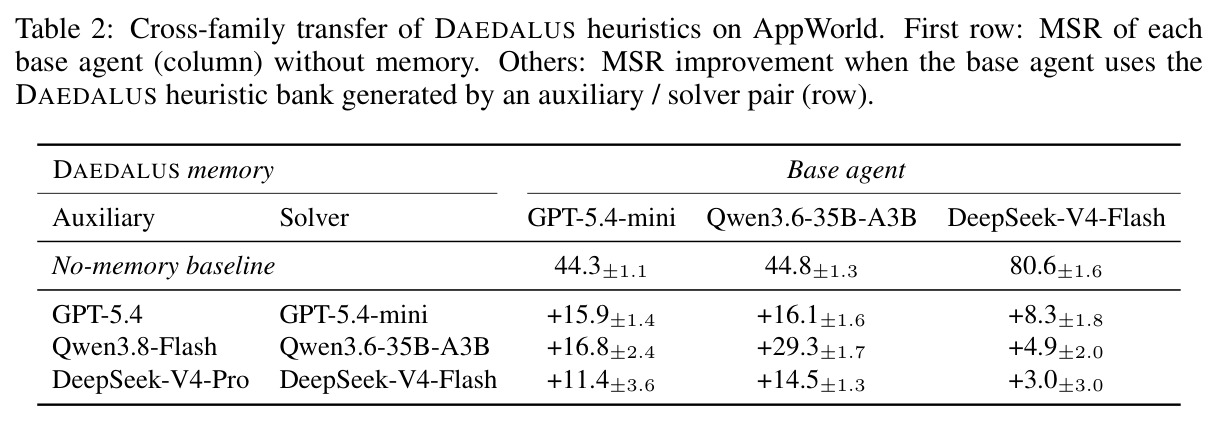
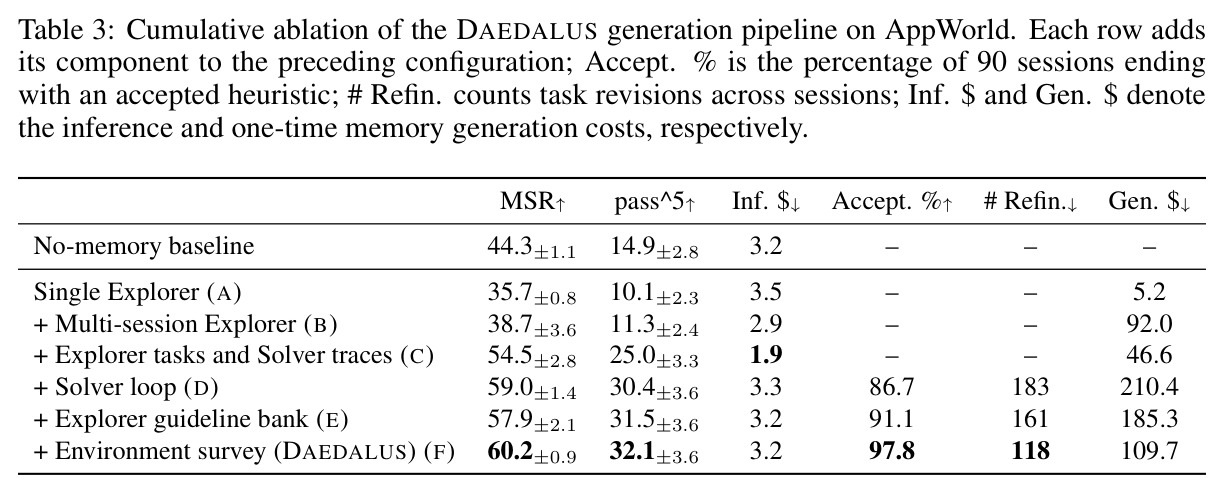
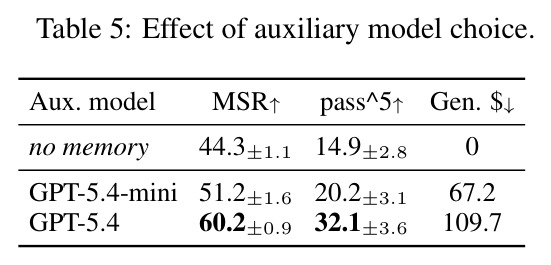
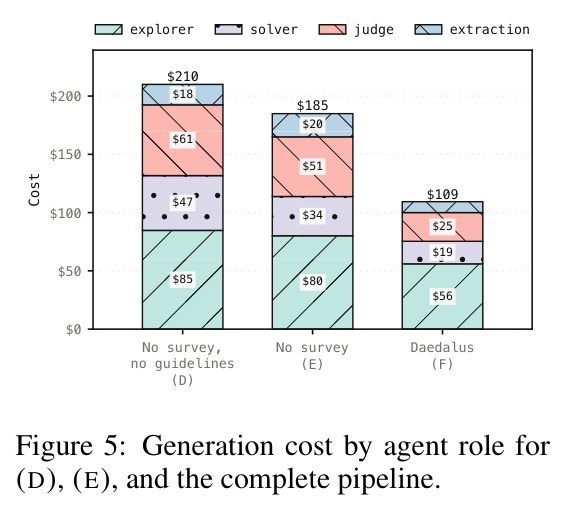
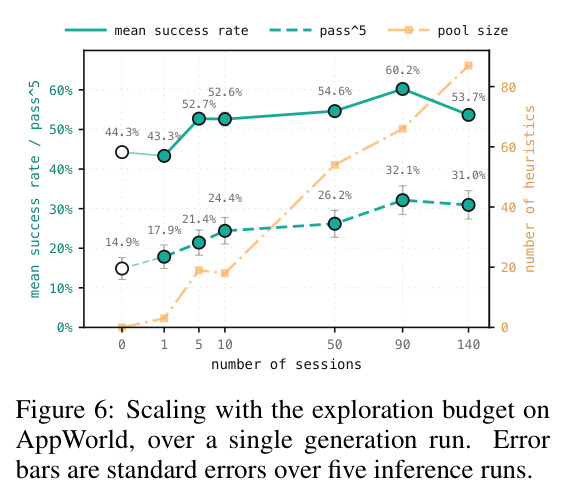
主实验(Table 1):DAEDALUS 把 GPT-5.4-mini 基座智能体的 MSR 在 AppWorld、τ²-bench retail、AutomationBench Operations 上分别提升 15.9、10.0、4.3 个百分点(44.3→60.2、57.5→67.5、31.7→36.0),$\text{pass}^5$ 提升 1.7-2.2 倍(AppWorld 14.9→32.1),且在 AppWorld 和 τ²-bench 上推理成本与基线持平($3.2 与 $0.5),因为记忆让智能体用更少轮数完成任务。它全面超过同设定的 PREPING,并在六个 MSR/$\text{pass}^5$ 列中的四列与使用训练任务的最强方法处于误差范围内;给定相同训练任务时,DAEDALUS-curated 在所有基准上误差范围内排第一。跨家族迁移(Table 2):九个「记忆库×基座」组合全部为正增益,GPT-5.4-mini 用 Qwen 库获益 +16.8 甚至略高于自家库的 +15.9;Qwen3.6-35B-A3B 自家库增益高达 +29.3;DeepSeek-V4-Flash 基线已 80.6%,仅余 +3.0 到 +8.3 空间。图 1 显示 7 个模型家族增益 +1.7 到 +26.3 点且轮数普遍下降。消融(Table 3):仅从 Explorer 探索轨迹提取启发式反而有害(35.7,低于基线 44.3);加入 Solver 轨迹使 MSR 跳升 +15.8 至 54.5,再加失败修订与连续成功验证再 +4.5 至 59.0,证明「基于求解失败的启发式+实证验证」是性能主源,而出题指南与环境勘察主要提升效率——接受率从 86.7% 升至 97.8%,生成成本从 $210.4 降到 $109.7(-48%)。Judge 校验(Table 4):与官方验证器 $\kappa_{\text{bench}}$ 为 0.729-0.807,多次判定 $\kappa_{\text{inter}}>0.8$,且精确率(0.863-0.943)高于召回率,倾向拒真而非纳伪,对启发式验收是安全方向。预算缩放(图 6):5 个 session 即达到 90-session 峰值增益的一半以上,但 140 session 时 MSR 反降至 53.7,层级合并不能挽回。推理策略(Table 6、图 7):合并整库开局注入 60.2%,远超未合并 49.5%;BM25/稠密/随机检索 $k=5$ 无显著差异,BM25 增至 $k=30$ 仍只有 58.2%。辅助模型(Table 5):全部用 GPT-5.4-mini 时增益减半(51.2,+6.9)。评测代理(图 8):9 个模型在 81 个自生成任务上的 MSR 和 $\text{pass}^3$ 排序与官方测试集 Kendall $\tau=0.89$($p<.001$),36 对中 34 对一致。
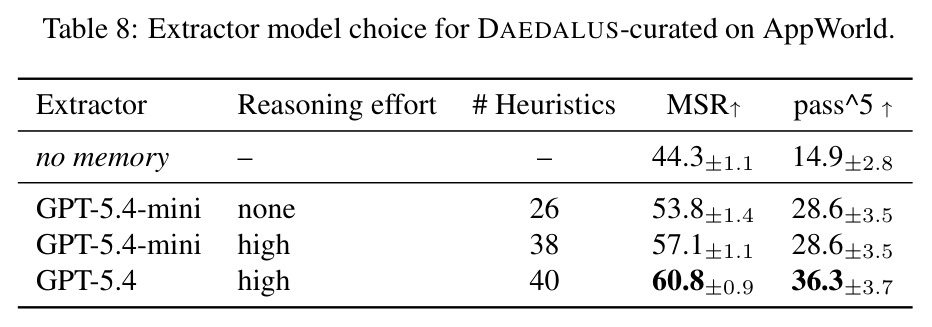
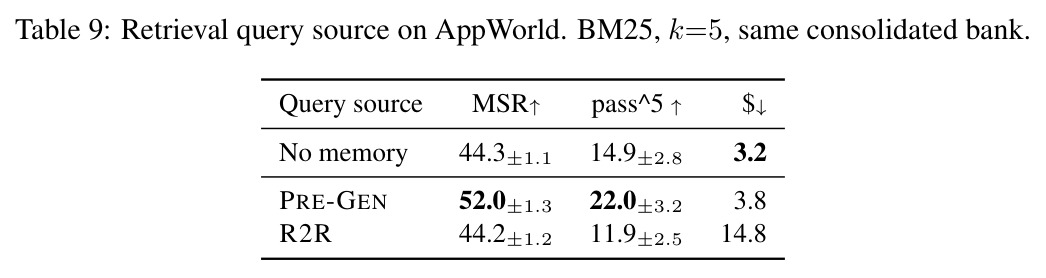
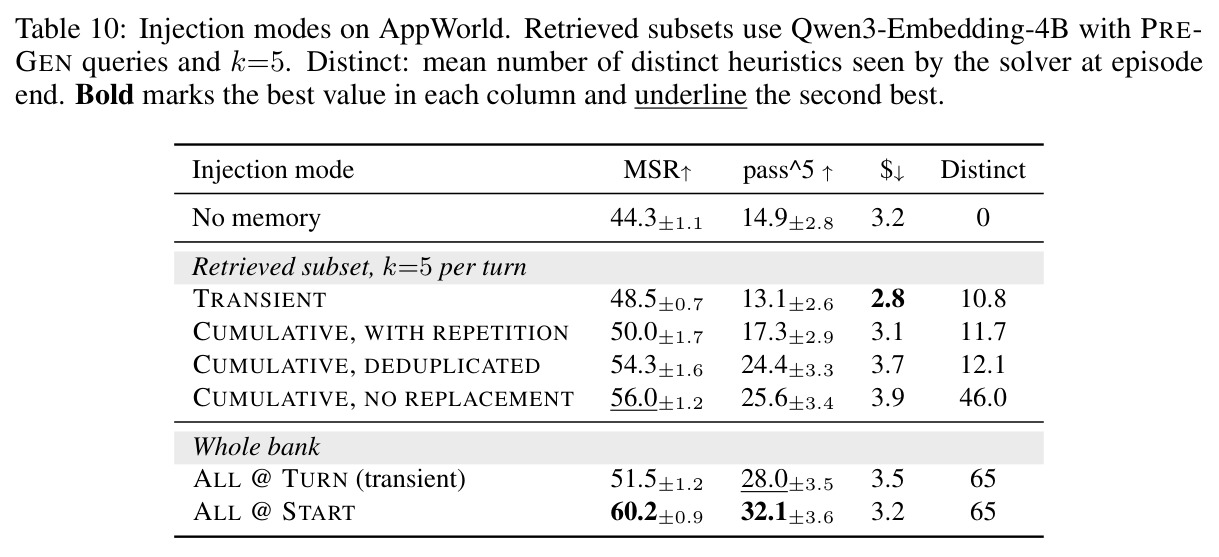
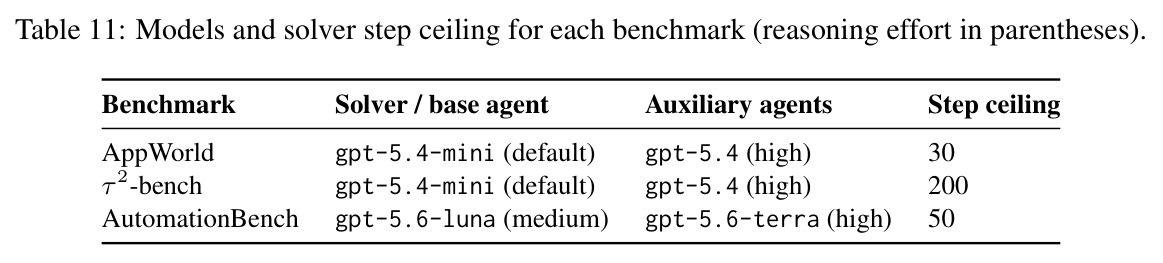
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AppWorld(normal 划分)代码级 App 自动化 | MSR(5 次运行均值成功率) | 60.2±0.9 | 无记忆基线 44.3±1.1 | +15.9 点,成本持平($3.2/次) |
| AppWorld(normal 划分) | pass^5(5 次全对率) | 32.1±3.6 | 无记忆基线 14.9±2.8 | 2.2 倍 |
| τ²-bench(retail 域)对话式客服 | MSR | 67.5±2.5 | 无记忆基线 57.5±1.6 | +10.0 点,pass^5 提升 1.7 倍(22.5→37.5) |
| AutomationBench(Operations)SaaS 工作流 | MSR | 36.0±1.5 | 无记忆基线 31.7±3.2 | +4.3 点,pass^5 提升 1.7 倍(12.9→21.4) |
| AppWorld:与同设定(无训练任务)方法对比 | MSR | 60.2±0.9 | PREPING 56.0±1.4 | +4.2 点,且推理成本更低($3.2 vs $4.0) |
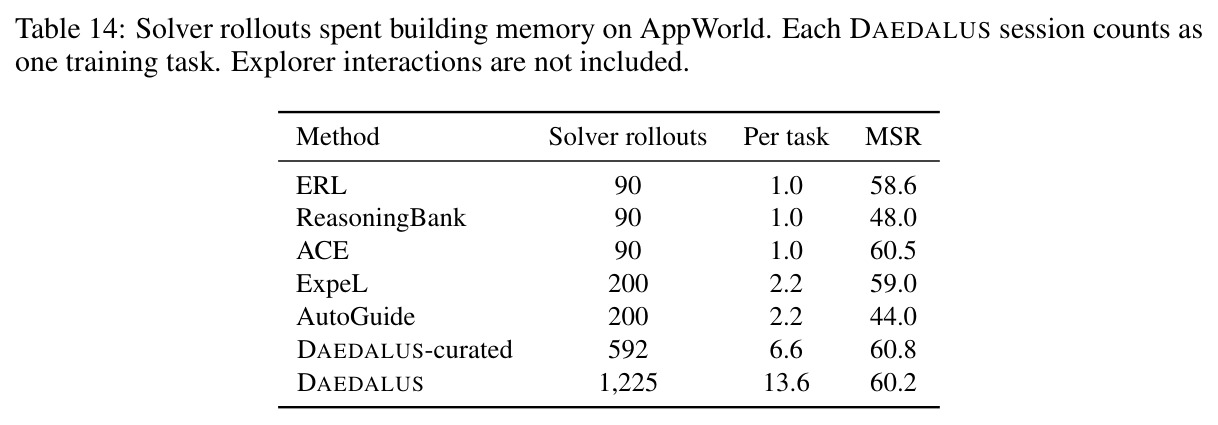
| AppWorld:与使用训练任务的最强方法对比 | MSR | 60.2±0.9(不用任何训练任务) | ACE 60.5±0.8、ExpeL 59.0±1.9(使用 90 个训练任务) | 误差范围内打平;DAEDALUS-curated 用相同任务时 60.8 全场第一 |
| AppWorld 跨家族迁移:GPT-5.4-mini 基座 + Qwen3.8-Flash/Qwen3.6-35B-A3B 生成的记忆库 | MSR 提升 | +16.8±2.4 | 自家 GPT 库 +15.9±1.4 | 外族库甚至略优于本族库,9 个组合全部正增益 |
| 评测代理:81 个自生成任务 vs 官方 test_normal,9 个模型 | Kendall τ(排序一致性) | 0.89(p<.001),36 对模型 34 对一致 | 官方 AppWorld 测试集排序 | MSR 与 pass^3 两种指标下一致 |
| AppWorld:反事实重放(81 个已接受任务,带/不带对应启发式) | Solver MSR | 77.0%(带启发式) | 66.7%(不带) | +10.3 点,配对 bootstrap 95% CI [2.1, 18.5],pass^3 CI [1.2, 28.4] |
局限与改进
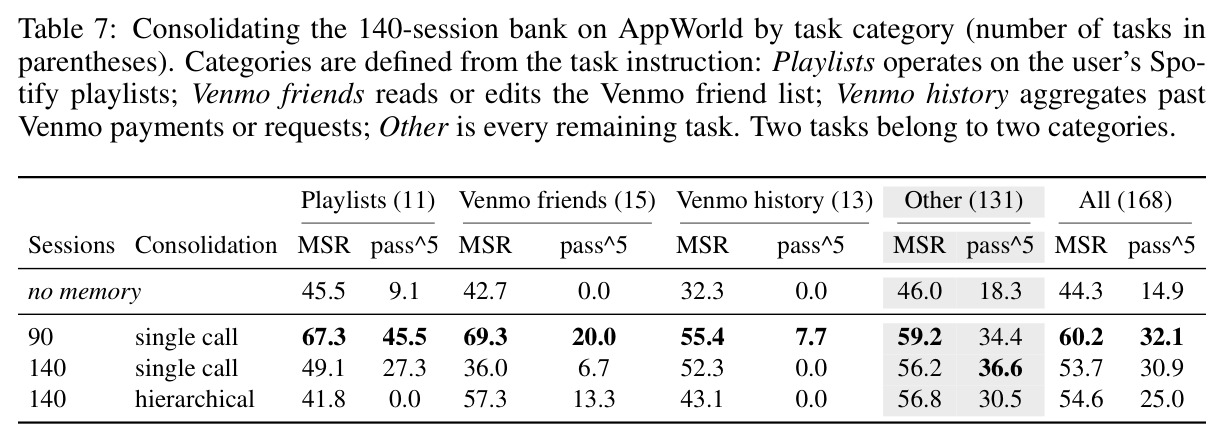
作者承认的局限:记忆库一次性构建、部署后冻结,初步尝试的测试时迭代更新方案未带来稳定收益;要求可重置的单控环境,τ²-bench telecom 这类需要模拟用户侧工具的双控场景不支持;依赖不完美的 LLM Judge($\kappa_{\text{bench}}$ 0.73-0.81),误判可能误导改题或验证不可靠启发式;超过 90 session 后性能下滑(60.2→53.7),层级合并不能挽回(54.6),原因是合并调用歪曲了部分启发式的适用范围(如把「公共播放列表」的注意事项扩大成「任何 is_public=True 的播放列表」,导致找不到私有列表)。我的补充观察:测试集很小(168/40/70 个任务)且 $\text{pass}^5$ 标准误很大(τ²-bench ±6.6),多条「无显著差异」的结论统计功效有限;一次性生成成本 $110-210 不算低,且消耗 1225 次 Solver rollout(约为单次方法的 14 倍、ExpeL 的 6 倍);记忆按 GPT-5.4-mini 的能力校准,对更强的 DeepSeek-V4-Flash(基线 80.6%)增益明显缩水,说明记忆与模型能力耦合;AppWorld 主结果还用了一个未纳入正式方法的「早期实验过滤器」剔除 7 个近似重复的已接受任务;任务分布由 Surveyor 一次性勘察决定,无覆盖率保证,可能系统性偏离真实用户任务分布。
独立分析的弱点
弱点一:LLM Judge 是单点故障。精确率 0.863-0.943 意味着仍有约 6-14% 的假成功判定,假接受会让无效启发式污染记忆库且部署后无从纠正。改进方向:代码类环境用可执行验证器替代或补充 Judge,通用环境采用多种子、多模型 Judge 投票并要求判定一致性达标(论文也把多 Judge 列为下一步)。弱点二:记忆不可更新、无遗忘机制。140-session 时播放列表类任务 MSR 从 67.3 跌到 49.1-41.8,暴露出静态合并无法随库增长维护条目边界。改进方向:按任务类别给启发式标注作用域分层存储,引入使用频率与反事实增益统计做淘汰与合并,允许测试时低频更新。弱点三:整库开局注入不可扩展。65 条启发式约 3.1k token 尚可整库注入,但库到数百条时上下文将爆炸,而 BM25 检索到 $k=30$(约半库)仍落后 2 个点,「斜查询」检索问题未解决。改进方向:训练专用检索器(用「启发式是否改变了轨迹结果」做监督信号而非文本相似度),或把记忆做成智能体可主动查询的工具。弱点四:依赖强辅助模型。全用 GPT-5.4-mini 时增益从 +15.9 减半到 +6.9,对小预算团队不友好。改进方向:把出题与提取能力蒸馏到小模型,或只对 Judge/Extractor 用强模型。弱点五:覆盖无保证。Surveyor 的一次勘察决定任务分布,关键但低频的工作流可能从未被练到,记忆对长尾任务无效。
未来方向
作者明确提出的方向:记忆生命周期管理——部署后继续从真实流量更新记忆,例如 DAEDALUS session 与测试时反思交替进行;开发更可靠的多 Judge 验证方案以替代单一 LLM 判定;研究银行组成与覆盖如何随环境和规模变化、大规模启发式如何合并、以及何种检索机制能在推理时最好地利用大记忆库。基于其成果可自然延伸的研究:把自生成任务正式化为「环境体检工具」,用于模型选型、能力回归测试和新环境验收($\tau=0.89$ 的排序一致性是基础);将验证过的失败轨迹作为 RL 奖励信号,与自博弈权重训练(SPICE/SPADE 一类)结合,打通「上下文记忆→参数化记忆」的路径;把 Solver 循环的对照实验协议推广到技能库与工作流记忆的验收;支持双控环境(模拟用户侧)和计算机操作类非可重置环境;研究记忆的跨环境复用与分层组织(环境无关的通用层加环境特定层);用反事实重放置信区间给每条启发式附上可信度分数,指导库内冲突消解与检索排序。
复现评估
复现条件非常好。开源情况:代码、全部提示词、生成的任务、启发式库、所有智能体轨迹(含生成与推理)均在 github.com/illuin-tech/daedalus 发布,附录提供五个算法的伪代码和每个方法的完整配置(模型、划分、超参,Table 11-13)。数据:三个公开基准,AppWorld/τ²-bench 用官方划分(90/168 与 74/40),AutomationBench 按服务数分层 30/70 划分,记忆生成不接触任何测试实例。算力:无需训练,只需 API 调用——AppWorld 一次性生成约 $110(GPT-5.4 high 作辅助、GPT-5.4-mini 作 Solver),单次评测推理约 $3.2;即便复现全部消融(含 140-session 缩放实验),预算在数百美元量级,远低于任何 RL 训练。难度评估:中等。超参极少($N_s=3, N_f=8, N_r=5$)且跨基准零调参,是复现友好的设计;主要工程量在于搭建三个基准环境并重实现 ExpeL、AutoGuide、ERL、ReasoningBank、ACE 五个基线(作者已提供其实现)。注意事项:主结果依赖 OpenAI API 专有模型(gpt-5.4/5.4-mini、gpt-5.6 Terra/Luna),换模型需重验;90-session 库曾用未写入正式方法的早期过滤器剔除 7 个任务;$\text{pass}^5$ 方差大,结论需 5 次以上独立运行支撑。
论文图表
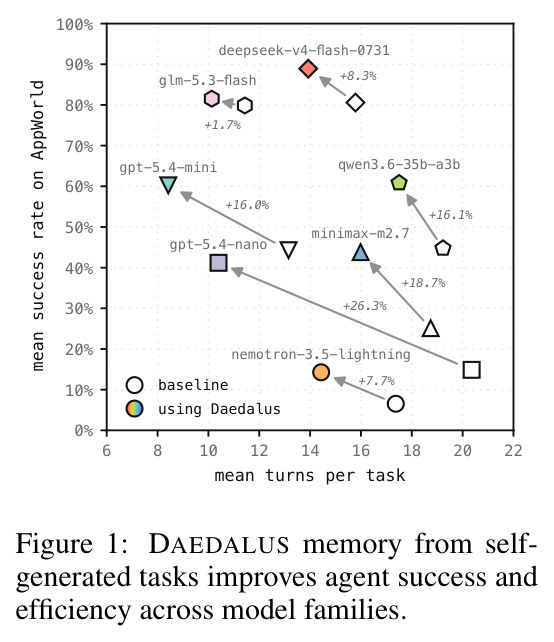
散点图:横轴为各模型在 AppWorld 上的平均每任务轮数,纵轴为平均成功率;7 个模型(glm-5.3-flash、deepseek-v4-flash、qwen3.6-35b-a3b、gpt-5.4-mini、minimax-m2.7、gpt-5.4-nano、nemotron-3.5-lightning)各有一条从空心点(无记忆基线)到实心点(使用 DAEDALUS 记忆)的连线,增益从 +1.7% 到 +26.3%,且多数模型轮数同时减少。
一图总览核心卖点:自生成任务的记忆同时提升成功率和效率,并横跨 7 个模型家族成立,是论文结论的直觉入口。
附录中 session 78 的部分轨迹截图,展示 Explorer 与环境交互、提出任务、Solver 尝试与 Extractor 提炼的原始对话片段。
让读者直接检视生成过程的真实行为,配合 Figure 4 的时间线帮助判断任务与启发式的质量。