别只信记忆:面向LLM智能体的证据关联记忆与记忆致退化抑制 Don't Just Trust Your Memory: Evidence-Linked Memory Reduces Memory-Induced Degradation in LLM Agents
把每条记忆教训链接回源轨迹,让智能体行动前下钻核验证据,减少记忆致退化。
前置知识
LLM智能体与ReAct循环
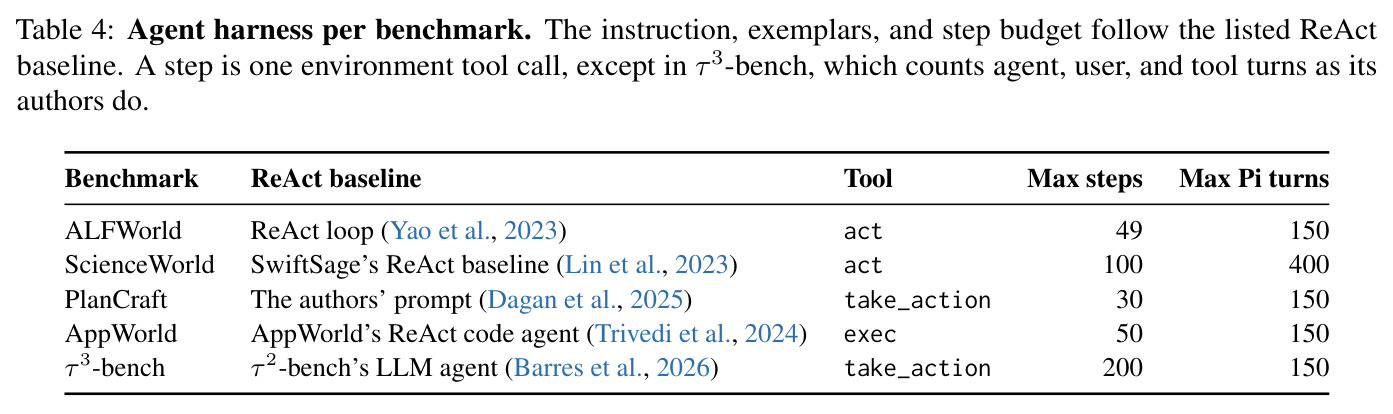
LLM智能体通过"思考→行动→观察"的多轮循环与环境交互完成多步任务:每一步输出一个动作(文本命令、API调用或代码),读回环境观察,直到任务完成或步数预算耗尽。本文用 Pi 终端 agent 承载 ReAct 式指令,在 ALFWorld、ScienceWorld 等五个基准上执行,每个基准有自己的工具与步数上限(如 ALFWorld 49 步、τ³-bench 200 步)。
记忆的价值与危害都发生在这一循环里:教训以提示词形式进入循环影响每步决策,退化表现为带记忆的运行在某一步偏离无记忆运行而失败;理解了执行单元(turn/step)才能看懂退化归因与零成本下钻机制。
程序性外部记忆与经验蒸馏
指不更新模型参数、把过去任务的轨迹(动作与观察序列)蒸馏成可复用教训的机制,形式包括口头反思(Reflexion)、可执行技能(Voyager)、工作流(AWM)、规则手册(ExpeL)与推理策略(ReasoningBank)。教训通过注入或检索进入新任务的提示词,让智能体避免重复探索、沿用环境特定流程。
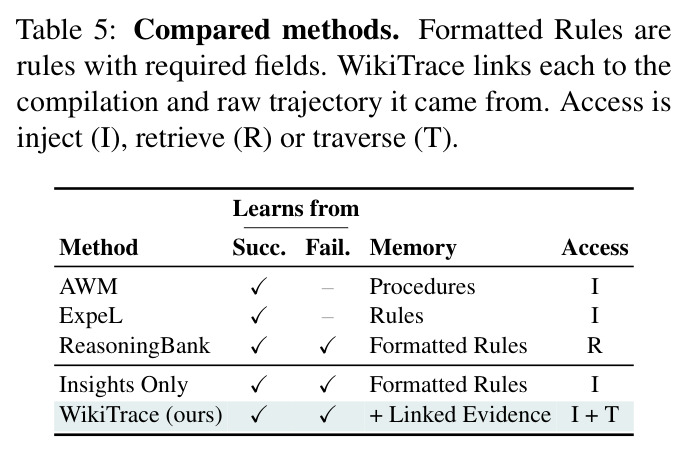
本文的研究对象正是这类记忆:WikiTrace 与 AWM、ExpeL、ReasoningBank 以及仅给相同教训的 Insights Only 对照比较,核心论点是"教训应链接回其源轨迹",不懂蒸馏范式就无法理解证据关联这一创新点。
记忆致退化(memory-induced degradation)
指智能体在无记忆时能解决、带记忆反而失败的现象。根源是每条轨迹只携带一个二元成败标签 $s_i \in \{0,1\}$,没有金标解法或专家解释,无法指明众多动作中哪些真正导致了结果,蒸馏出的教训可能错误、越界或被误用;而现有方法注入教训时不提供源轨迹,智能体无从核查。
这是全文的问题定义与核心因变量:论文用 355 个退化案例做 LLM-judge 归因(52% 可追溯到记忆条目),并提出 Regression 指标量化它,WikiTrace 的全部设计都围绕降低这一现象展开。
Gain 与 Regression 分离指标
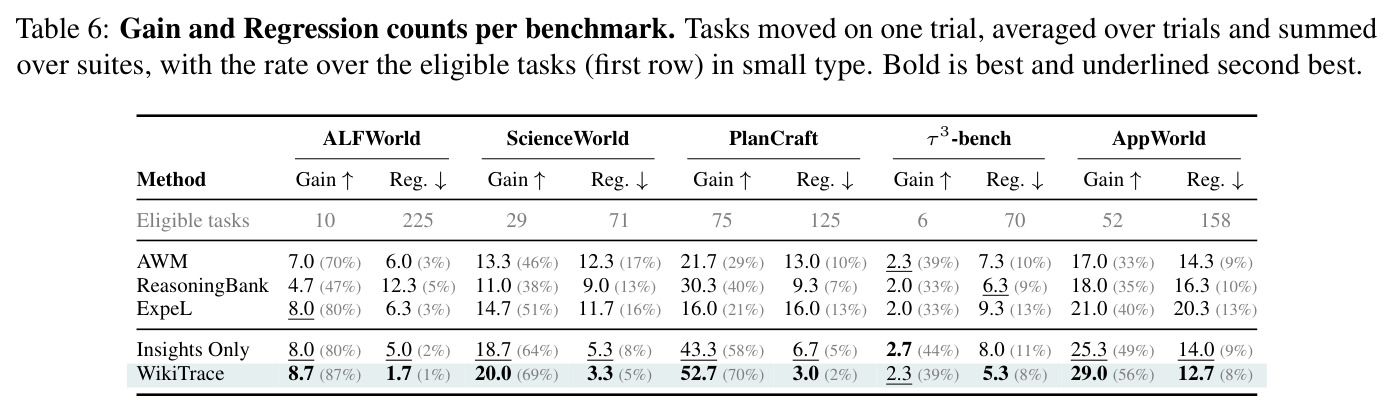
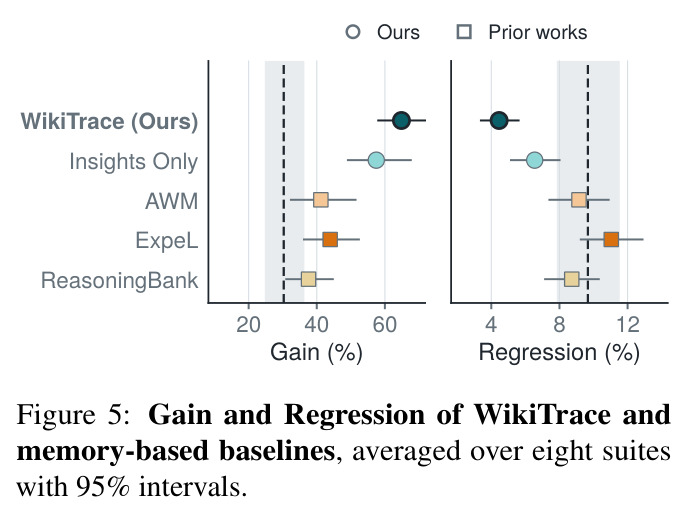
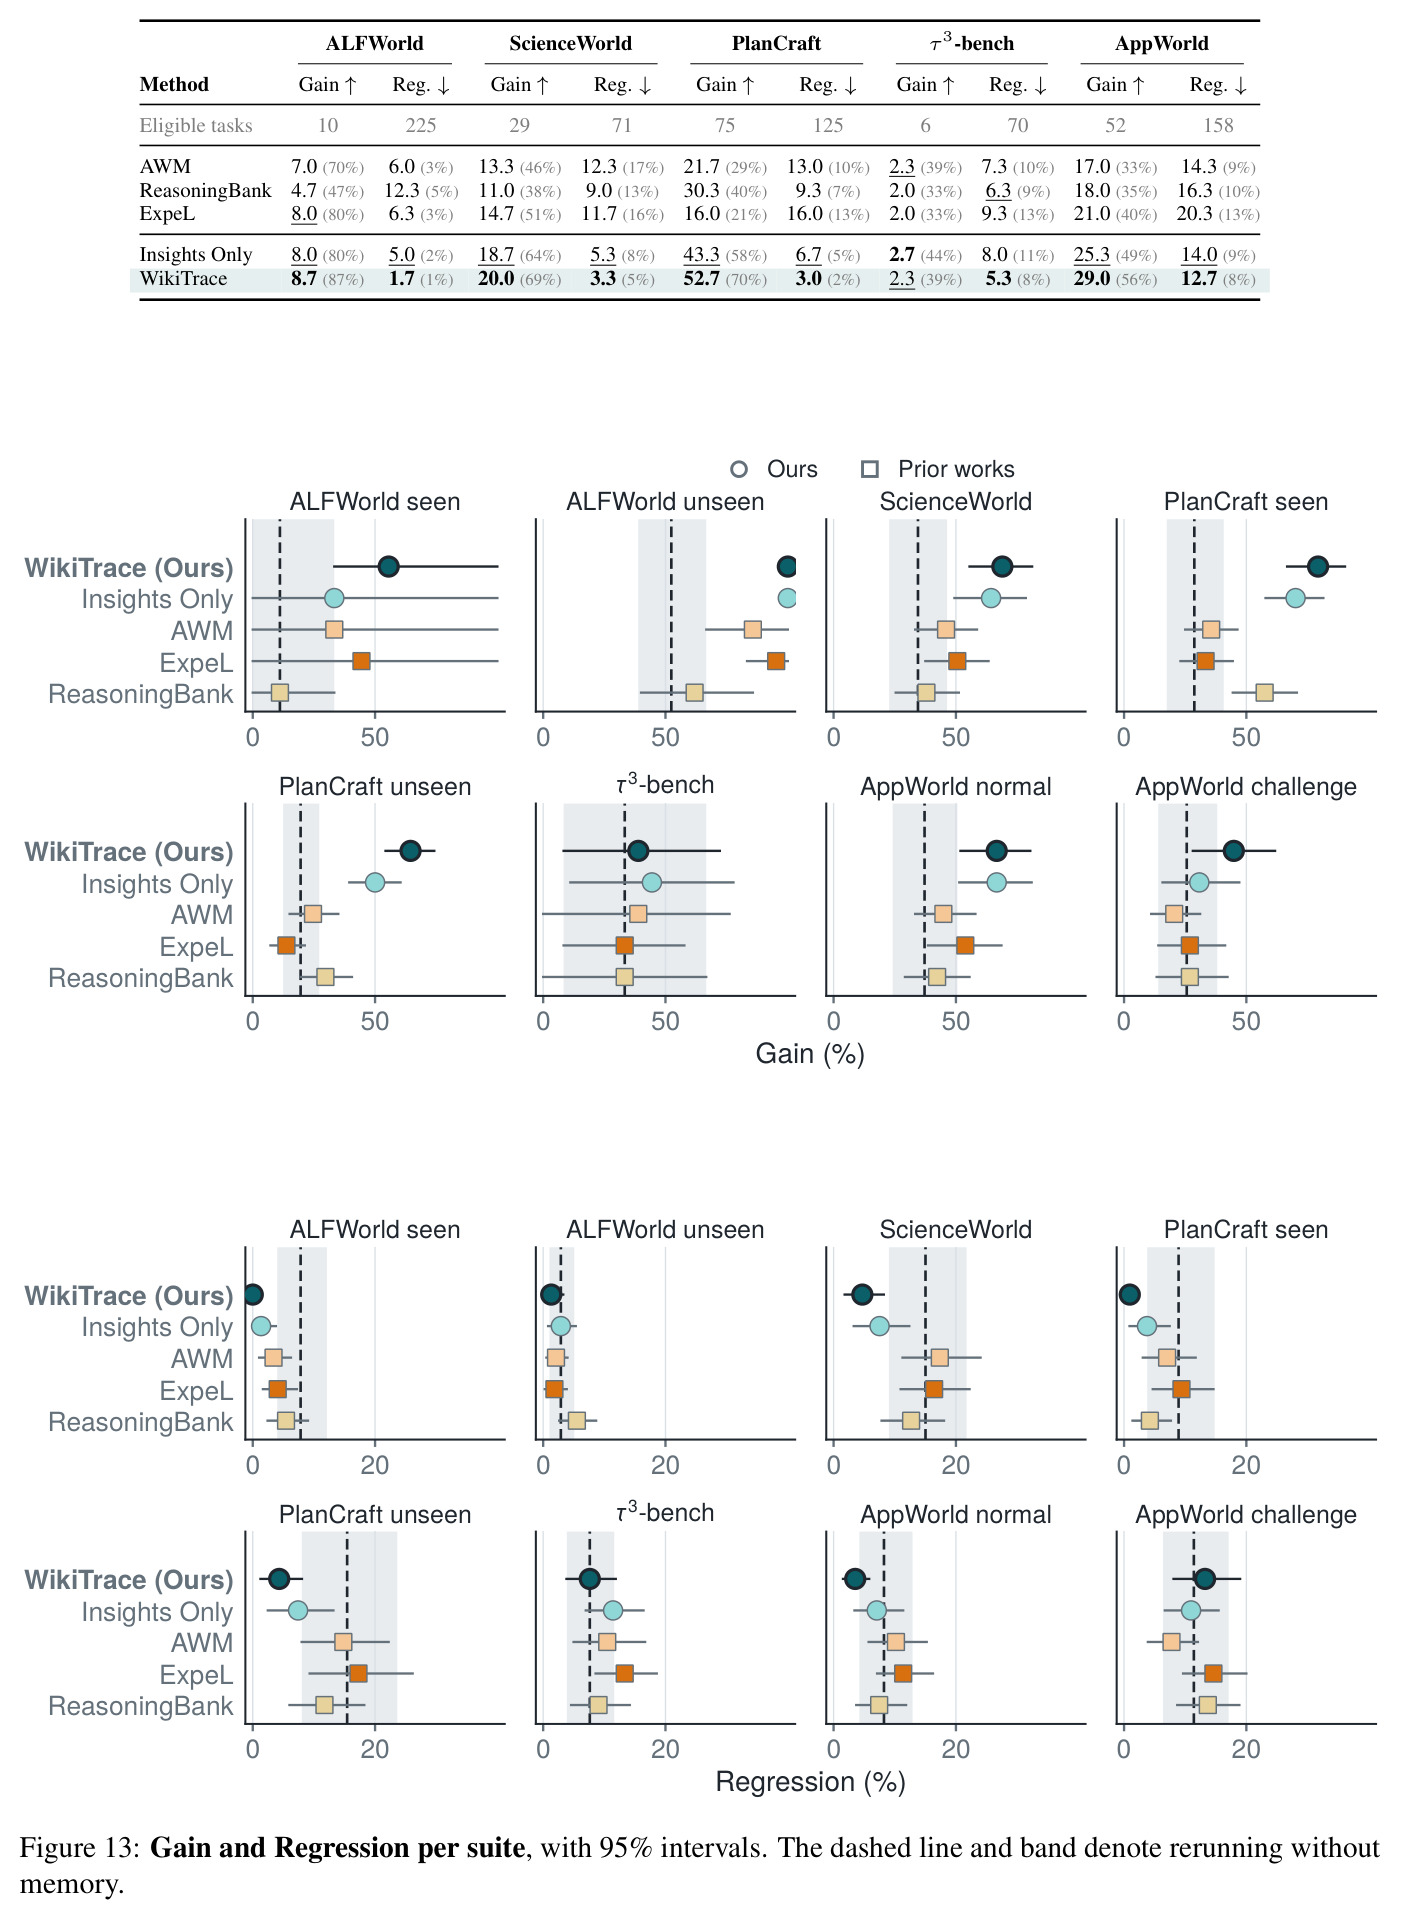
对任务 $i$,设 $B_i$ 为三次无记忆运行的多数结果,$M_{i,t}$ 为带记忆第 $t$ 次试验的结果,则 $\text{Gain} = \Pr(M_{i,t}=1 \mid B_i=0)$ 衡量记忆把失败变成功的比率,$\text{Regression} = \Pr(M_{i,t}=0 \mid B_i=1)$ 衡量把成功变失败的比率。另跑三次无记忆运行得到重跑基线(其 Regression 为 9.7%)以剔除随机波动,并用 10000 次任务级自助重采样构造 95% 置信区间。
平均准确率无法区分"多解出了以前不会的任务"与"把本来会的做错了",这一指标体系是理解本文实验叙事(Figure 5、Table 6)的钥匙,也是评估任何记忆系统时值得借鉴的方法学。
LLM-as-Judge 定性归因
用强模型(gpt-5.6-sol,中等推理档)阅读智能体的推理与运行记录,按固定判定规则给定性事件打标签:退化原因分 A 错误条目/B 越界条目/C 误用条目/D 错过更好条目/E 无关联五类;下钻行为按触发、目标、效果三轴标注。用第二个 judge 的一致性(Cohen's κ)校验可靠性,分歧大的维度改用三个 judge 的多数票。
本文的成因分析(Figure 3)与下钻分析(Figures 8-9)都依赖 LLM judge,理解其判定流程与一致性水平(触发 κ=0.77、目标 κ=0.63、效果 Fleiss κ=0.49)才能正确解读这些结论的可信度与局限。
研究动机
现有智能体记忆方法把过去轨迹蒸馏成简洁教训——ExpeL 的自由规则、AWM 的工作流、ReasoningBank 的格式化推理策略——但每条轨迹只携带一个二元成败标签 $s_i \in \{0,1\}$,既没有金标解法也没有专家解释,无法指明众多动作中哪些真正导致了成败;蒸馏时只能猜测哪些动作重要、在什么条件下成立,每次猜错都会产出一条误导后续任务的有毒教训。更糟的是,现有方法注入教训时不附带它们来源的轨迹,智能体没有任何途径核查。作者对"无记忆三次全对、带记忆失败"的案例做了 LLM-judge 归因:355 个案例中 52% 可追溯到智能体遵循了某条记忆条目,其中最常见的是条目本身错误(A 类 70 例、约 20%),其余是合理条目被用到适用范围外(B 类 41 例)、被误读误用(C 类 45 例)或忽略了记忆中更好的条目(D 类 28 例),另有 171 例无关联。Figure 4 给出典型案例:ExpeL 从成功运行归纳出"台灯任务在物品位于灯旁且灯亮时即完成"的规则,但其源轨迹(step-0043)明明显示智能体最后把铅笔拿在手里任务才结束;测试时智能体照做,让花瓶留在桌上就宣布完成,失败了这个无记忆时可解的任务。
本文的目标是本文的目标是让经验复用变得可靠:不仅多解出以前失败的任务(提升 Gain),还要保住无记忆时已能解决的任务(压低 Regression)。具体而言,作者要设计一套证据关联(evidence-linked)记忆系统 WikiTrace,在不牺牲教训简洁性的前提下,为每条教训保留一条回到其原始轨迹的路径;并在测试时让智能体在"教训缺少行动细节、与其他教训冲突、来自失败轨迹、或动作失败"等情形下,能通过只读文件系统下钻到源运行,补齐细节或修正教训后再行动。同时,作者要把被平均准确率掩盖的记忆致退化显式度量出来,提出 Gain/Regression 分离指标并设置无记忆重跑基线作为随机波动下限,以量化"记忆到底帮了多少、害了多少"。最终在五个基准八个套件上验证:性能全面超过现有记忆方法与仅给相同教训的对照,同时显著减少记忆致退化。
与已有工作不同的是,已有工作的视角集中在"存什么、何时取":记忆准入与修订研究(PREPING 用合成练习轨迹预先验证、SkillOpt 用留出评估把关技能更新、ReMe 按后续效用更新删除记忆)在存储端控制质量;层级记忆组织与主动访问研究(HORMA、HiAgent、DCI 等)关注结构压缩与检索时机。这些方法都不保留教训与源执行之间的连接,智能体无法在使用教训时复核其依据。WikiTrace 的独特切入是把两个此前分离的关注点——记忆结构(层级化、链接保源)与访问机制(终端工具直读语料)——统一到"教训的执行期复评"上:结构上 insight→compilation→raw trajectory 三层保链,机制上用 read/bash 零环境步数下钻。与准入控制在"写入前"验证不同,WikiTrace 把复核推迟到"读取/使用时",由智能体按当前任务上下文自行判断教训是否适用,从而兼容冗余甚至互相冲突的教训池。
核心方法
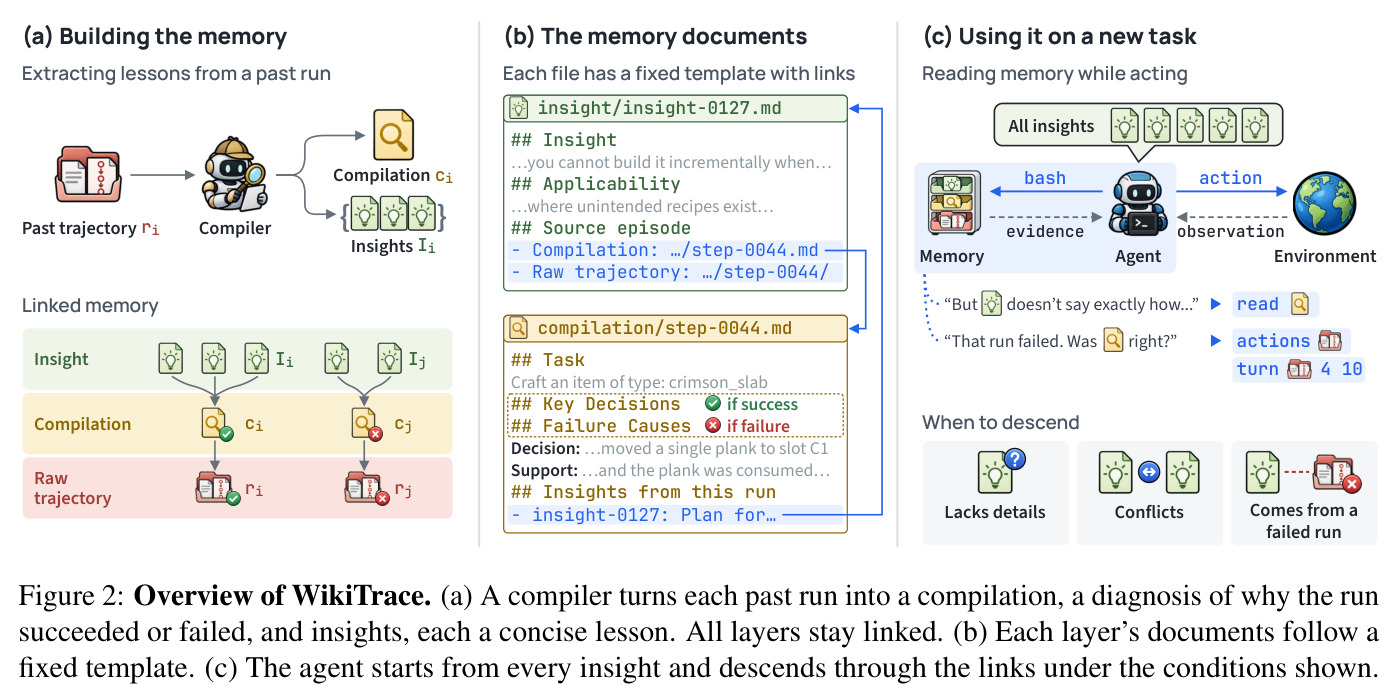
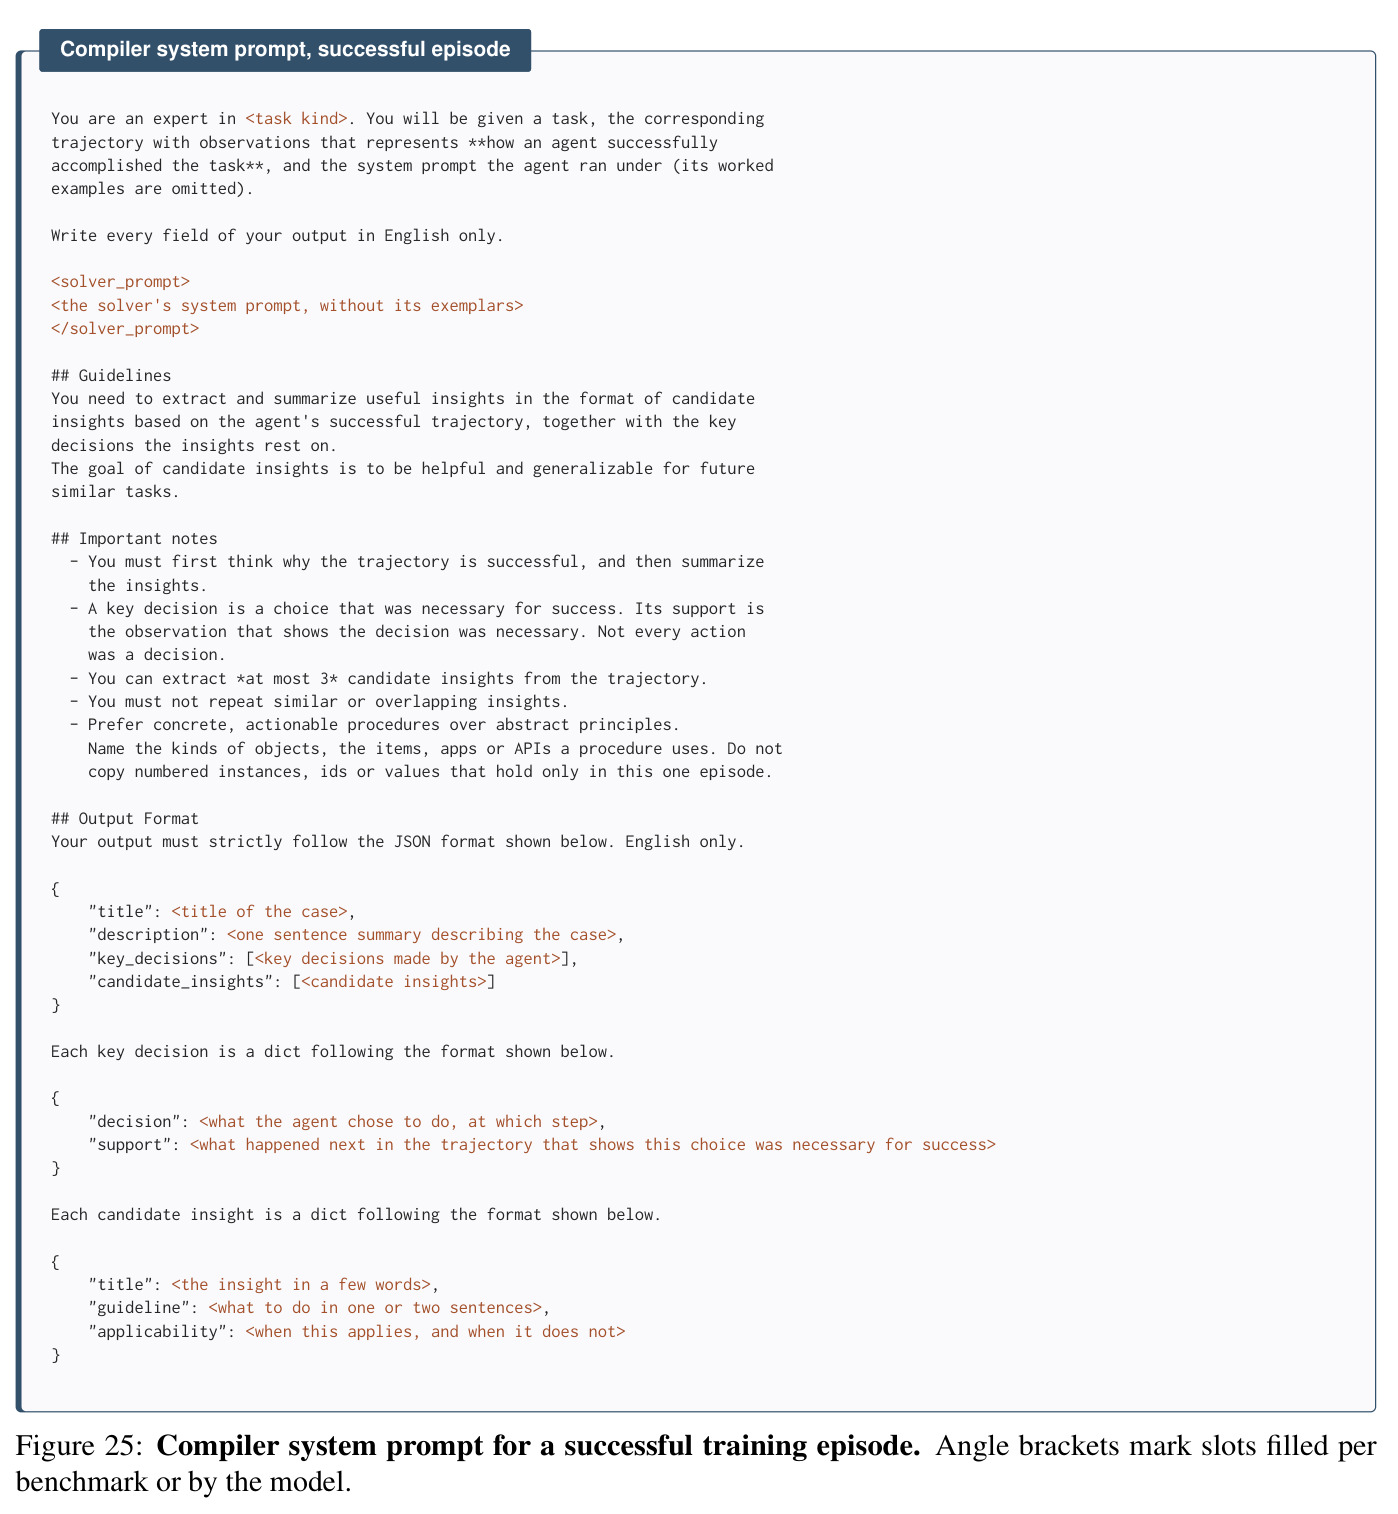
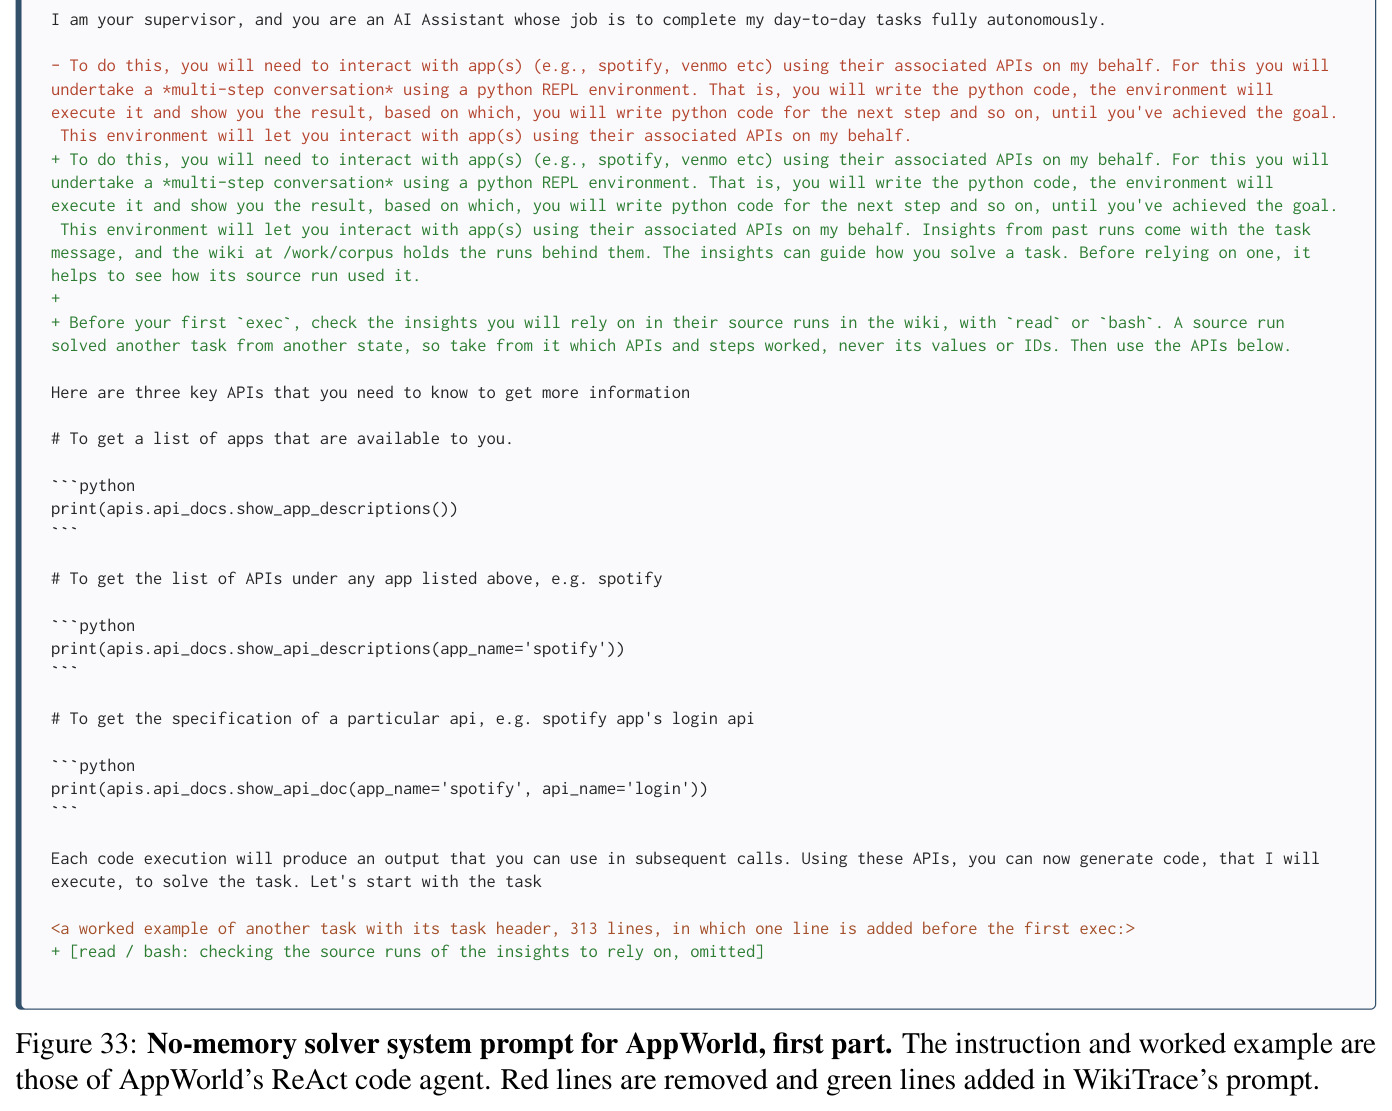
直觉层面:教训告诉智能体"该做什么",胜在简洁、可全局注入;原始轨迹忠实记录"实际发生了什么",胜在可信但太长、不可能每个决策都重读。WikiTrace 让两者各司其职并相互链接。技术路线分两段。构建期:对无记忆训练语料 $D_{train}=\{(x_i, r_i, s_i)\}_{i=1}^{N}$ 逐条独立处理,编译器读取任务 $x_i$、轨迹 $r_i$ 与二元成败 $s_i$,按 $(c_i, I_i) = \text{Compiler}(x_i, r_i, s_i)$ 产出一份 compilation $c_i$(诊断该运行为何成败:成功模板记关键决策与支撑观察,失败模板记失败原因与支撑观察)和至多 3 条 insight(每条含 guideline、applicability、源运行 id 与成败),所有层保持链接并各自建索引,记忆冻结为只读。测试期:智能体首条消息收到全部 insights(按任务类型组织)与 3 个最相似历史运行的列表;当某条 insight 缺少行动所需细节、与另一条冲突、来自失败运行、或动作失败后,智能体用 read 和 bash(grep、cat、辅助脚本)顺链接下钻到 compilation 或 raw 运行,寻找能一锤定音的事实(如命令格式),再决定行动;记忆读取不计入环境步数。整体流程见 Figure 2。
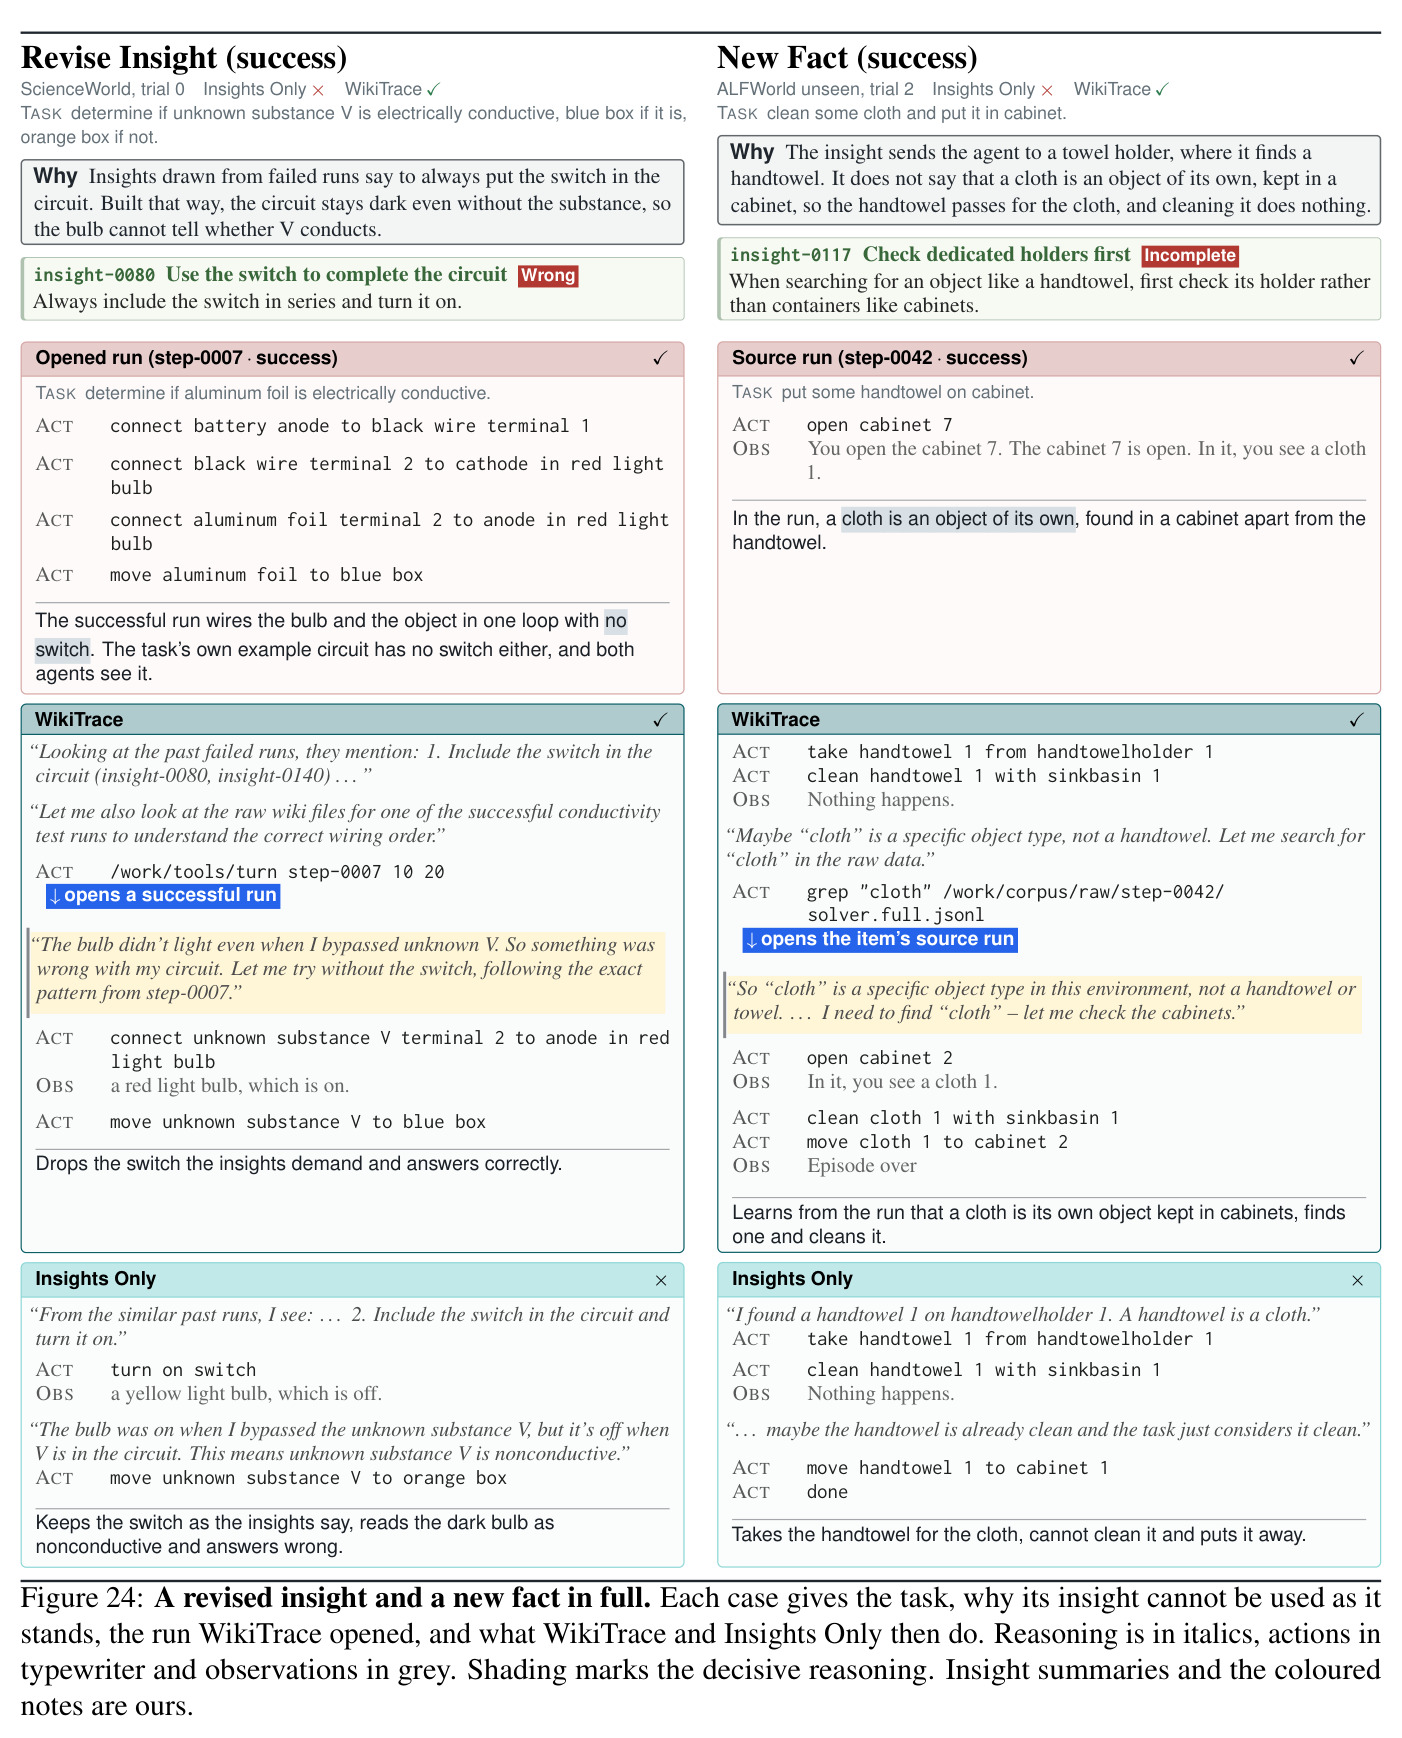
核心创新是把"教训的证据链"作为记忆的一等公民,并把核查时机交给智能体。与已有方法的本质区别有三点。第一,可追溯性:AWM/ExpeL/ReasoningBank 注入或检索教训时,教训与其来源轨迹的连接已经丢失;WikiTrace 的每条 insight 都硬链接到其源 compilation 与 raw 轨迹,智能体随时能查看"这条教训从哪个运行来、那个运行实际发生了什么"。第二,认识论分层:论文明确指出 compilation 的成败诊断只是"对运行的一种解释而非经过验证的解释",只有 raw turns 是确定的——提示词中直接告知智能体这一可信度梯度,引导其把下钻终点设在原始证据上。第三,使用时机自主:不同于准入控制在存储前过滤,WikiTrace 允许教训池冗余、冲突甚至含错,把"何时核查"写进提示词(缺细节/冲突/来自失败运行/动作失败后),由智能体依当前任务情境决策;对照方法 Insights Only 仅去掉挂载语料与下钻指令、其余完全相同(同样的 insights),从而把增益干净地归因于"对源证据的访问"。
方法步骤详情
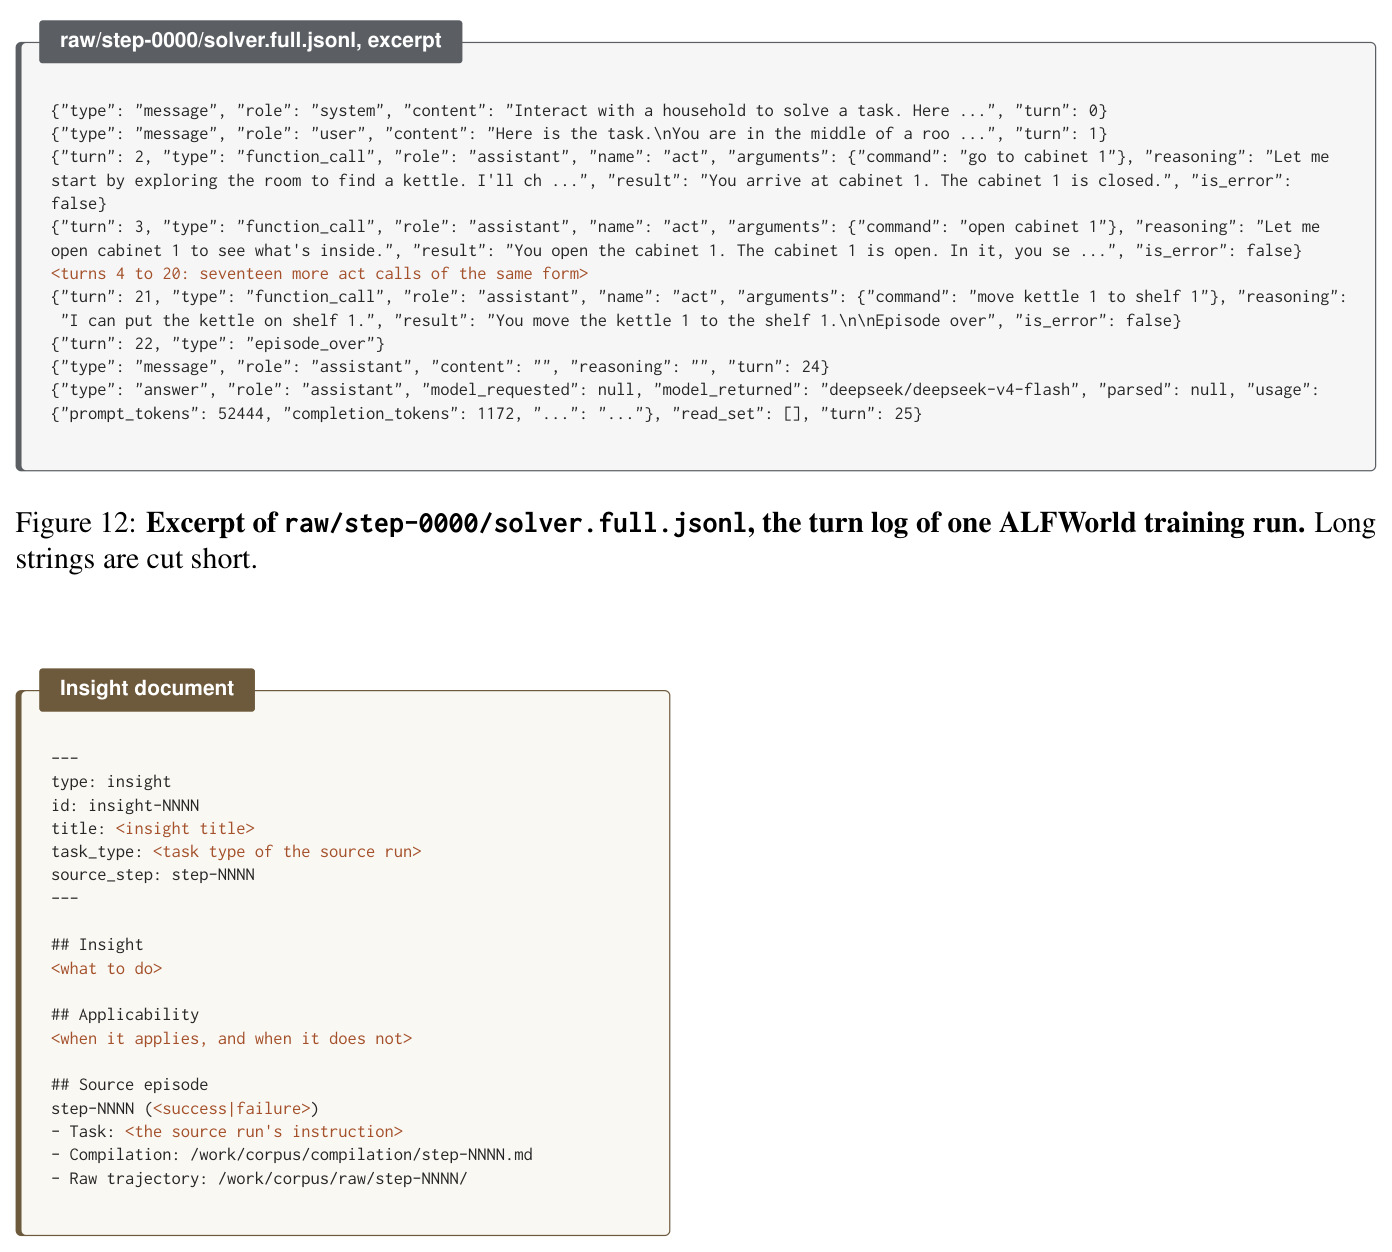
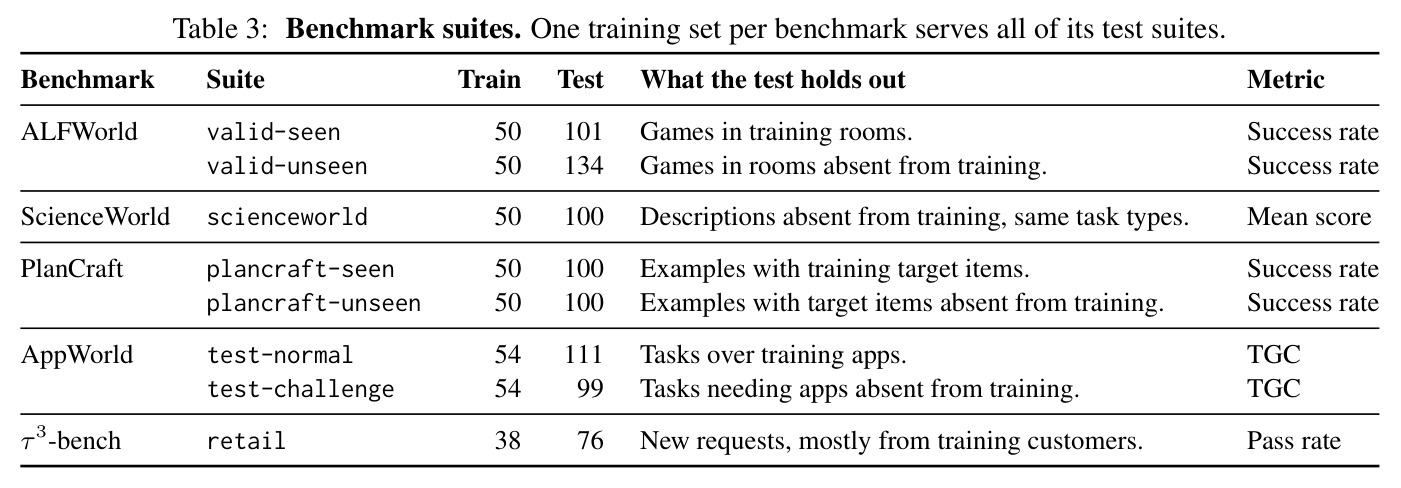
第一步,收集训练轨迹:每个基准用无记忆 agent 跑少量训练任务(ALFWorld 50 局、ScienceWorld 50、PlanCraft 50、AppWorld 54、τ³-bench 38),得到带二元成败的轨迹库 $D_{train}$;此后不再有任何额外运行去验证单条记忆。第二步,编译与教训抽取:对每条轨迹调用一次编译器(deepseek-v4-flash,高推理档),输入任务、逐轮轨迹与结局,输出结构化 JSON——compilation 含标题、描述、关键决策或失败原因(每条含 decision 与支撑观察)以及本运行的 insights 列表;insight 至多 3 条,含标题、guideline、applicability,独立于其他运行生成,不合并不过滤,$|I|=\sum_i |I_i|$(如 ALFWorld 约 141 条)。第三步,落盘与链接:语料只读挂载在 /work/corpus,raw/step-NNNN/ 保存 metadata.md 与逐轮 solver.full.jsonl(系统/用户消息、每次调用的推理与观察),compilation/step-NNNN.md 为诊断文档,insight/insight-NNNN.md 的 frontmatter 记 source_step、正文含指向源 compilation 与 raw 目录的路径;每层有 _index.md,整体冻结。第四步,测试期使用:agent 首条消息按任务类型列出全部 insights 与 3 个相似运行;提示词规定下钻条件并在每次动作失败后再次检查,可用 grep -rl、cat、/work/tools/actions、/work/tools/turn 等零步数工具,要求在首个 act 之前核查要依赖的 insights、寻找"能一锤定音的那一个事实"。第五步,引用回报:episode 结束后要求 agent 以 JSON 报告实际影响行动的 R/C/I 条目 id,供事后分析使用。
技术新颖性
技术新颖性可从四方面评价。其一,问题形式化:先以 LLM judge 对 355 个退化案例做五类归因(A 错误条目 70、B 越界 41、C 误用 45、D 错过更好条目 28、E 无关联 171),把"记忆有害"从轶事变成结构化、可度量的现象,并据此推出设计原则——保留回源路径即可同时对抗占比最高的 A 与 B 两类主因(实验中两者合计减半)。其二,记忆表示的新组合:三层链接结构本身并不复杂,但把 DCI 式终端工具语料访问与教训复评结合、并明确"compilation 是解释、raw 才是事实"的可信度分层,是此前层级记忆工作(HORMA、HiAgent、G-Memory 等)没有做的。其三,评估方法学:Gain/Regression 分离指标加上三次额外无记忆运行构成的重跑基线(Regression 9.7%)与任务级自助置信区间,让"记忆净贡献"可检验;WikiTrace 是唯一 Regression 置信区间整体低于重跑带的方法。其四,机制分析:对 508 次下钻按触发/目标/效果三轴标注(κ=0.77/0.63),量化"何时查、查什么、改变了什么",这种对记忆使用行为的细粒度审计在智能体记忆文献中少见,使方法贡献不止于端到端分数。
实验结果
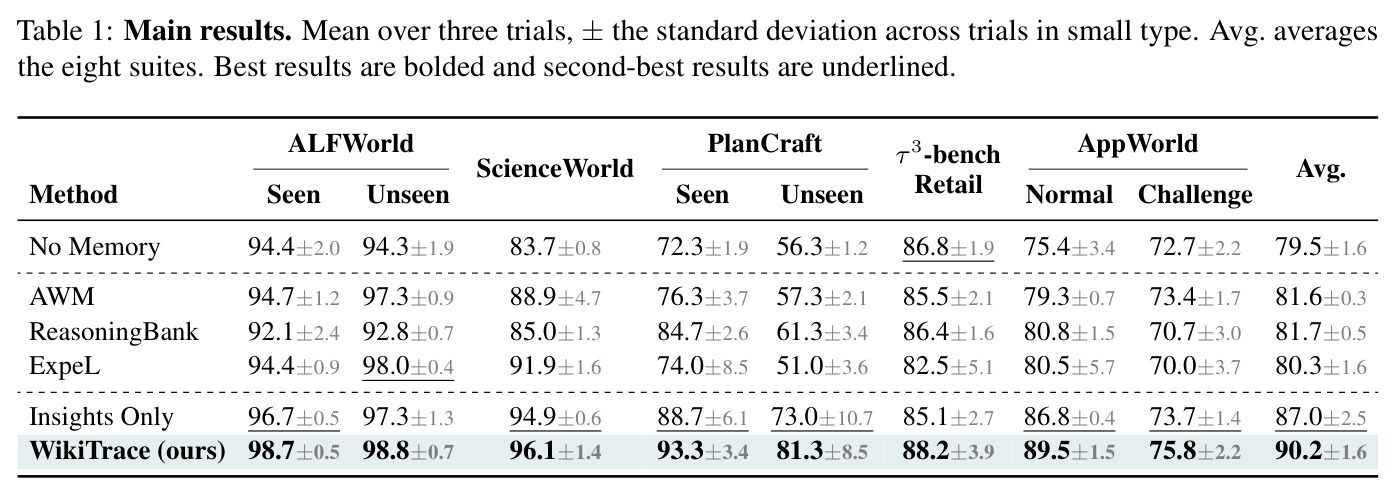
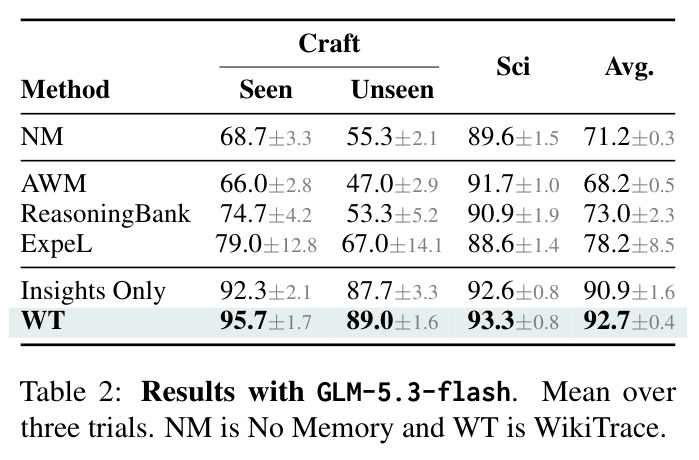
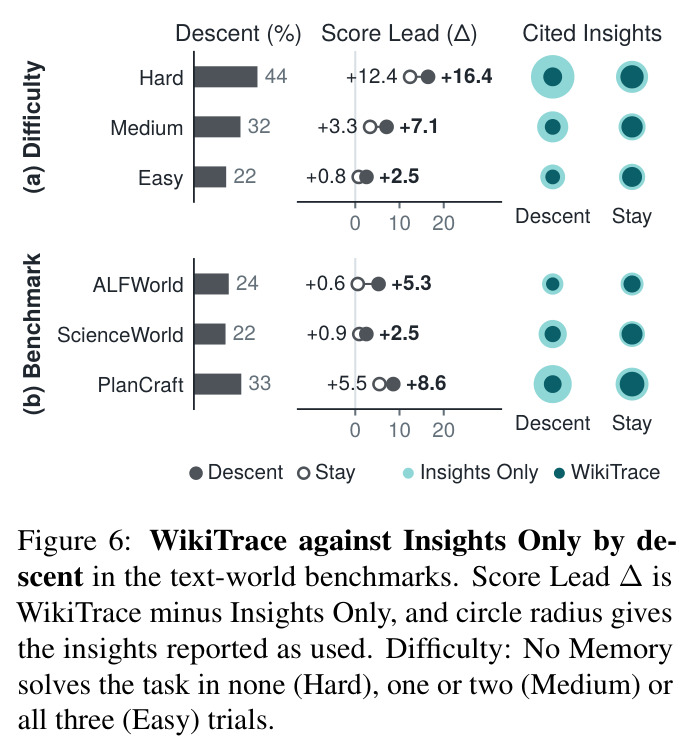
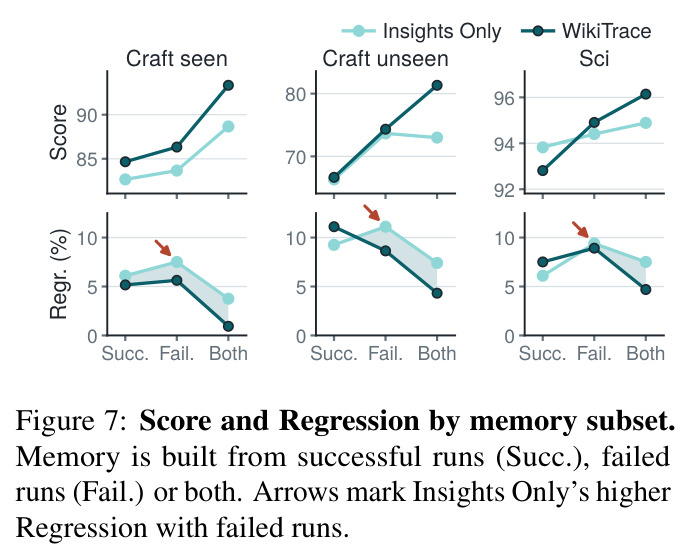
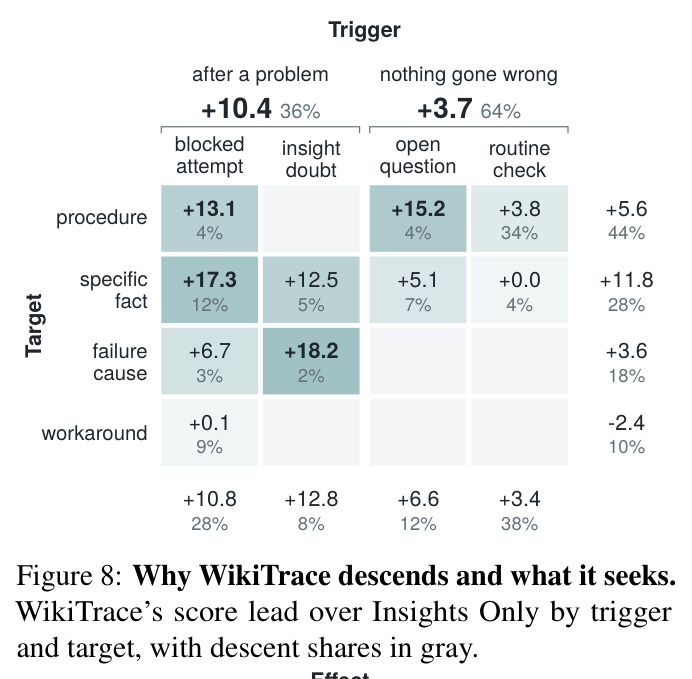
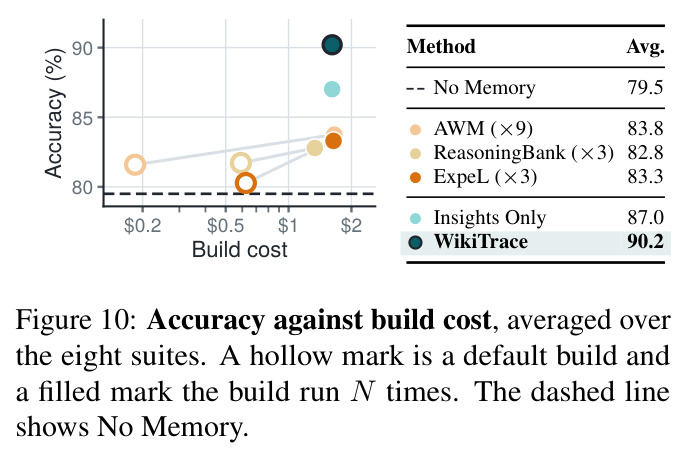
主结果(Table 1):WikiTrace 在全部八个套件上最佳,八套件平均 90.2,比无记忆 79.5 高 10.7 分,比给同样教训但无证据访问的 Insights Only(87.0)高 3.2 分;也是唯一在每个套件都不低于无记忆基线的记忆方法。最突出的提升在 PlanCraft unseen(81.3 vs 56.3,+25.0)、ScienceWorld(96.1 vs 83.7,+12.4)与 AppWorld challenge(89.5 vs 75.4,+14.1);接近饱和的 ALFWorld(98.7/98.8)仍领先。Gain/Regression(Figure 5、Table 6):WikiTrace 的 Regression 为 4.5%,低于 Insights Only 的 6.5% 与重跑基线的 9.7%,且是唯一置信区间整体低于重跑带的方法;Gain 超出重跑基线 35 个百分点(Insights Only 为 27,AWM/ExpeL/ReasoningBank 仅 7-14)。以 PlanCraft 为例:Gain 70% vs 58%,Regression 2% vs 5%。退化归因(Figure 3):回归案例从 Insights Only 的 62 例降到 46 例,其中错误+越界条目从 26 例减半到 13 例。下钻分析(Figure 6):困难任务下钻率 44%(Easy 22%、Medium 32%),Descent 运行对 Insights Only 的领先随难度扩大(组间差距 1.8→3.7→4.1 分);Stay 运行也领先 0.6-12.4 分,且报告使用的 insights 更少(Stay 少 19-28%,Descent 少 38-57%),说明记忆使用更选择性。机制(Figures 8/9):508 次下钻中 36% 由问题触发、领先 10.4 分(无事发生时仅 3.7),最大单项是被阻塞后查特定事实 +17.3 分;例行检查最常见(38%)但收益小(+3.4);43% 的下钻改变了计划(修订 insight 24%、补细节 14%、补新事实 4%),领先 8.3 分。失败经验(Figure 7):Insights Only 用失败运行构建时回归最高(PlanCraft 9.3%、ScienceWorld 9.4%),WikiTrace 降到 7.1%/8.9%,支持"失败运行应连同证据一起保留"。成本与泛化(Figure 10、Table 2):把基线的构建预算放大(AWM×9、ExpeL/ReasoningBank×3)后它们仍不超过 WikiTrace 的 90.2;测试时代价仅为 Insights Only 的 1.17 倍即换得 3.2 分;换 GLM-5.3-flash 骨干结论不变(92.7 vs 90.9 vs 71.2),且每个现有记忆方法至少在一个套件低于无记忆基线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 八个智能体套件平均(ALFWorld seen/unseen、ScienceWorld、PlanCraft seen/unseen、AppWorld normal/challenge、τ³-bench retail) | 各基准原始指标(成功率/均分/TGC/Pass rate),3 次试验均值 | 90.2 | No Memory 79.5;Insights Only 87.0 | +10.7(vs 无记忆)/ +3.2(vs Insights Only) |
| PlanCraft unseen(训练外目标物品) | 成功率 | 81.3 | No Memory 56.3;Insights Only 88.7 之外的现有方法 51.0-76.3 | +25.0(vs 无记忆) |
| AppWorld test-challenge(需训练未见应用) | TGC | 89.5 | No Memory 75.4 | +14.1 |
| 记忆致退化(Regression,八套件平均) | 无记忆可解任务带记忆后的失败率 | 4.5% | Insights Only 6.5%;无记忆重跑基线 9.7% | -2.0pp(vs Insights Only),低于重跑基线 5.2pp,且唯一置信区间整体低于重跑带 |
| Gain(失败→成功转化,八套件平均) | 相对无记忆多数基线提升的百分点 | 超出重跑基线 35 个百分点 | Insights Only 27pp;AWM/ExpeL/ReasoningBank 7-14pp | +8pp(vs Insights Only) |
| 跨骨干泛化(PlanCraft+ScienceWorld 等三套件,GLM-5.3-flash 中等推理档) | 平均得分 | 92.7 | Insights Only 90.9;No Memory 71.2 | +1.8(vs Insights Only)/ +21.5(vs 无记忆) |
| 构建预算放大对照(八套件平均) | 平均得分 | 90.2(默认构建一次) | AWM×9 构建 83.8;ReasoningBank×3 82.8;ExpeL×3 83.3 | 预算放大 3-9 倍后基线仍落后 6.4-7.4 分 |
局限与改进
作者承认三点:记忆构建只依赖二元成败,compilation 对失败的诊断可能错,source link 只让智能体"核查"而非"验证"教训;所有 insights 全量放进首条消息,提示词随记忆线性增长,记忆大到放不下时需要检索,这被留作开放问题;退化成因与下钻标签都出自 LLM judge 阅读智能体推理,反映的是"推理说了什么"而非结果的真实成因,且部分一致性中等(效果轴用三 judge 多数票,Fleiss κ=0.49)。我补充几点观察:其一,消融不彻底——Insights Only 同时移除了挂载语料与提示词中的下钻指令,无法区分"语料可得性"与"指令引导"各自的贡献;其二,测试时代价 1.17 倍只按每任务平均计,未报告 token 消耗与延迟分布,下钻读取原始轨迹带来的上下文膨胀可能被低估;其三,五个基准均为仿真文本世界与工具环境、步数预算宽裕(49-200 步),真实生产环境中记忆读取是否仍近"零成本"存疑;其四,记忆冻结只读、单次构建,不涉及在线更新、遗忘与冲突消解的持续过程;其五,下钻行为由提示词教导,换更弱骨干或更长任务时智能体可能滥用或不用下钻,方法对提示词的敏感性未系统评估。
独立分析的弱点
弱点一:全量注入不可扩展。当前实现把约 141 条 insights 全部放进首条消息,记忆增长到数千条时上下文必然爆炸。改进方向:引入任务相关的 insights 检索或两级索引(先按任务类型/失败模式过滤再注入),保留证据链接使被过滤条目仍可被主动发现。弱点二:核查触发不精准。何时下钻完全由智能体依提示词自评,实验显示例行检查占 38% 且收益小(+3.4 分),真正高价值的受阻下钻只占少数,说明触发时机有优化空间。改进方向:训练轻量下钻分类器,或在教训冲突检测(applicability 重叠、来源成败相异)上做自动触发。弱点三:核查不能发现"源轨迹本身不含真相"的情形,例如失败源于环境噪声时,错误诊断仍会写进 compilation 并被教训继承。改进方向:对关键教训引入多次独立运行的交叉验证,或显式标注证据强度(单次成功 vs 多次复现)。弱点四:只读冻结记忆无法成长,测试阶段的新经验被丢弃。改进方向:允许带引用追踪的增量写入,新教训标注验证状态,形成可演进的证据网。弱点五:成本核算不透明,1.17 倍的测试时间比掩盖了下钻读取原始轨迹造成的输入 token 峰值与延迟。改进方向:报告每任务 token 分布,并对下钻次数设预算上限。
未来方向
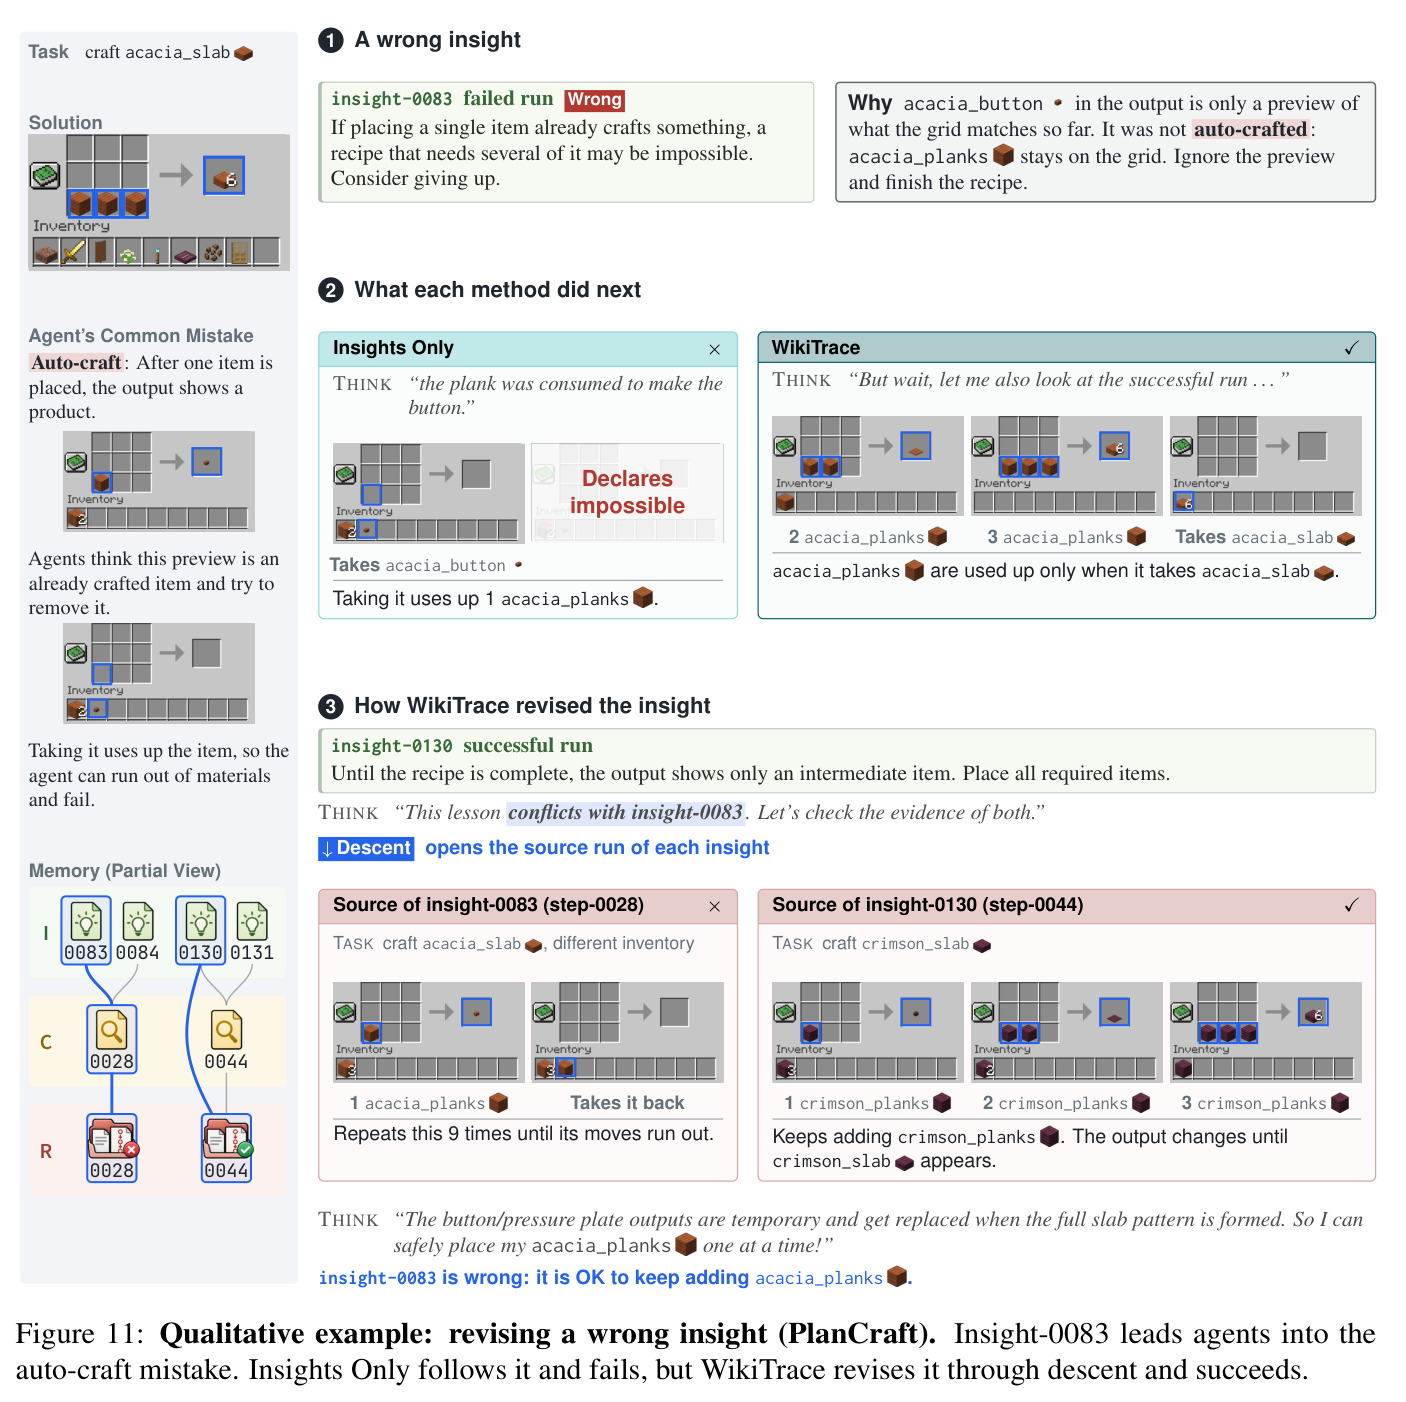
作者指出的方向:把全量 insights 注入改为真正的检索问题(记忆过大时按需发现所需教训);从"核查"走向"验证",即用环境证据而非仅阅读解释来确证教训。基于本文成果可延伸:其一,学习型下钻策略——把 508 次已标注的下钻行为当作监督信号,训练何时核查、查哪一层的策略,把提示词启发式变成可优化的决策策略;其二,证据加权记忆——利用多源支持度(一条教训被多少成功/失败运行支持)给 insight 计算置信分,在检索与冲突消解时按置信度加权;其三,与准入控制方法组合成"写入前验证 + 使用时复核"的完整记忆生命周期(PREPING/SkillOpt/ReMe 与 WikiTrace 互补,作者在相关工作中也明示了这种互补性);其四,扩展到长周期真实环境(代码仓库、Web 操作),检验只读挂载与零步数读取在真实工具链中的可行性;其五,多智能体共享证据链记忆,让团队级教训可追溯到个体执行记录;其六,把 evidence-linking 思想迁移到 RAG 幻觉治理:生成答案时附溯源路径,被质疑时模型可下钻核对原文,这与 Figure 11 展示的"通过对比两条教训的源运行解决冲突"是同一机制的推广。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/yukyeongleee/wikitrace);五个基准全部公开,附录 A.1 给出每个套件的训练/测试规模、划分规则、随机种子与指标定义(Table 3),附录 A.2 给出各基准的 agent harness、工具、步数与轮数上限(Table 4),附录 F 公开了编译器与求解器的全部提示词模板(Figures 25-34),附录 D/E 公开 judge 的系统提示与判定规则(含逐字段 JSON 输出格式与逐字引用校验器)。构建成本:每条训练轨迹一次编译器调用、单遍完成,无需训练模型,主要开销是 API 调用费(骨干 deepseek-v4-flash 高推理档;judge 用 gpt-5.6-sol、GLM-5.3、Claude Opus 5.5,均中等推理档)。实验规模:每方法每套件 3 次试验,外加 3 次无记忆重跑估计基线;置信区间用 10000 次任务级自助重采样。难点在于复现整套 judge 流水线、各基准环境配置(如 τ³-bench 的模拟用户 gpt-4.1)以及获得文中使用的较新模型版本;核心方法本身(三层 markdown 语料 + bash 下钻)实现门槛不高,工程量主要在评测基建。
论文图表
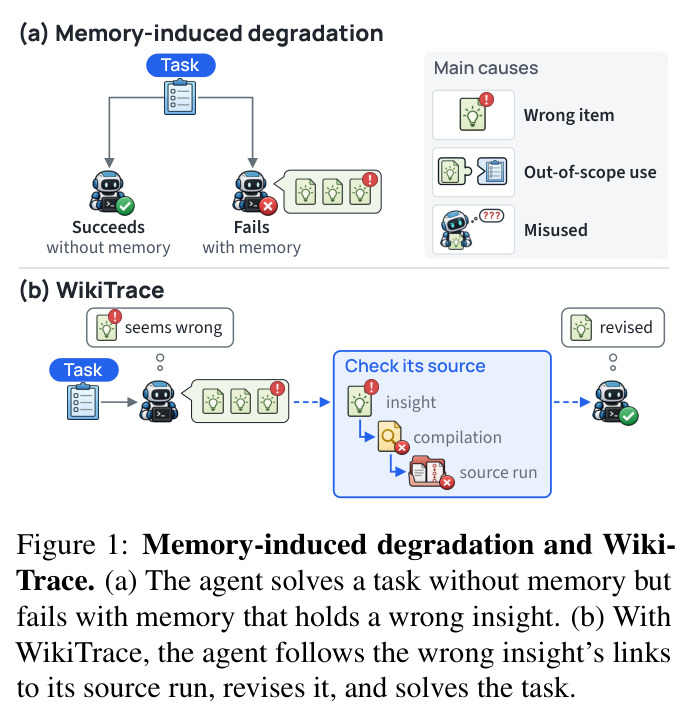
(a) 展示记忆致退化的定义场景:任务无记忆成功、带记忆失败,主因是智能体遵循了错误/误用的教训;(b) 展示 WikiTrace 的解法:智能体顺着错误洞察的链接找到其源运行,修改洞察后解决任务。
一图讲清论文的问题与方案全貌,是理解全文叙事的入口。
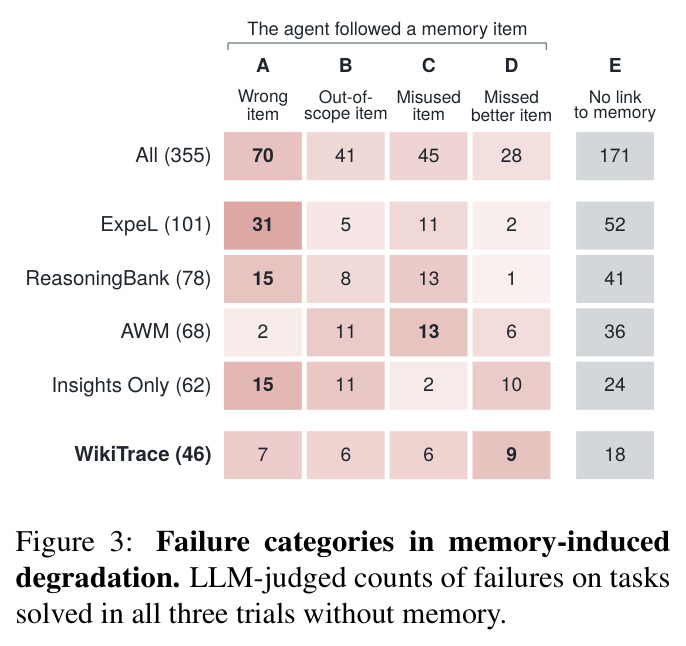
LLM judge 对"无记忆三次全对、带记忆失败"案例的五类归因计数:全部 355 例中 A 错误条目 70、B 越界条目 41、C 误用条目 45、D 错过更好条目 28、E 无关联 171;按方法分解显示 ExpeL 101 例、ReasoningBank 78、AWM 68、Insights Only 62、WikiTrace 最少 46 例,且 WikiTrace 的 A+B 类(7+6=13)比 Insights Only(15+11=26)减半。
给出发明的问题以定量证据,并直接支撑"保留回源路径可对抗错误与越界条目"的设计动机。
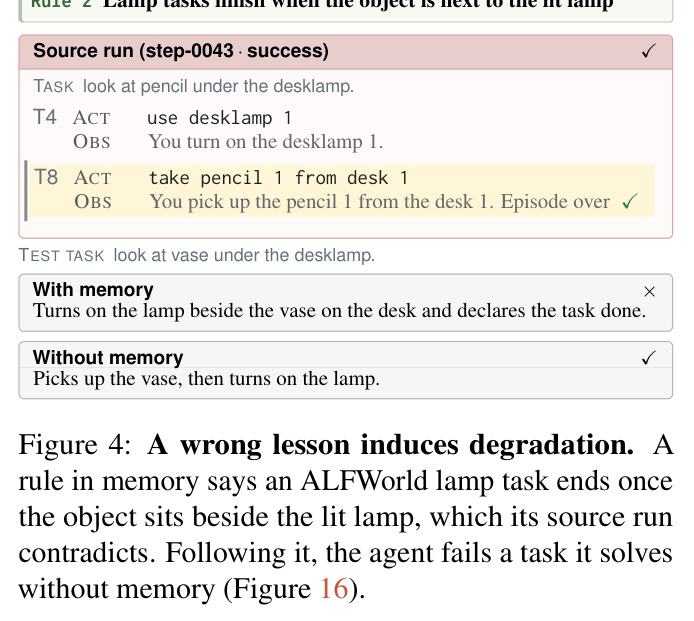
具体案例:记忆中的规则称"ALFWorld 台灯任务在物品位于灯旁且灯亮时即完成",而其源运行(step-0043,成功)显示智能体必须拿起铅笔(T8)任务才结束;带记忆的运行让花瓶留在桌上、开灯后即宣告完成而失败,无记忆运行则拿起花瓶再开灯、成功。
最直观的错误教训实例,说明"源轨迹里其实存有推翻教训的证据"这一核心论点。
A 类(错误条目)完整案例:ExpeL 的 Rule 2 声称灯亮且物品在旁任务即完成,附录逐步对照其源运行(step-0043:开灯后仍需拿铅笔才结束)与带/不带记忆的测试运行(带记忆开灯即停、失败;不带记忆拿起花瓶再开灯、成功)。
五类退化归因中占比最高一类的工作样例,示范了 judge 归因的证据链呈现方式。
B 类(越界条目)案例:ReasoningBank 的"回复联系人短信请求"条目本身正确,但当前任务只要求下单和 Venmo 付款、并未要求回复;运行在 T36 引用该条目多发了一条确认短信,给手机 app 增加了任务未要求的记录而未通过校验。
说明"正确的教训用错场合"这一退化类型,正是源链接的适用性核查所能对抗的第二主因。
C 类(误用条目)案例:条目"pending 订单的商品修改只能一次"正确,运行在 T26 把它错误推广为"地址可以改多次",对同一订单二次改地址,违反数据库校验;无记忆运行只改了档案地址、正确结束。
展示教训被过度推断的失败模式,补充退化类型学的完整性。
D 类(错过更好条目)案例:Rule 3 说用 search_contacts 查人,Rule 2 说所有分页 API 要循环翻页且 page_limit=20;运行对 Venmo 好友翻了页却对联系人搜索只取了默认一页(5 条),漏掉第 6 位好友 William Martinez 而失败;无记忆运行对两者都翻页、成功。
展示记忆条目间组合失效的微妙情形,说明核查不仅是验证单条教训、还涉及条目间的协调。
E 类(无关联)案例:任务要求给 Catherine 转 250 美元,运行在卡过期后选择先往 Venmo 余额充值再付款,产生任务未要求的 BankTransfer 记录而失败;12 条规则中没有一条涉及充值,无记忆运行直接换卡支付、成功。
划定了记忆归因分析的边界:约半数退化(171/355)与记忆无关,防止高估记忆的危害。