VisionWeave:将弹性视觉表示编织为多模态大模型的内生能力 VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
让MLLM自主学习每个图像块用细还是粗的视觉表示,平均省43% token仅损1.1%性能
前置知识
视觉 Token 序列
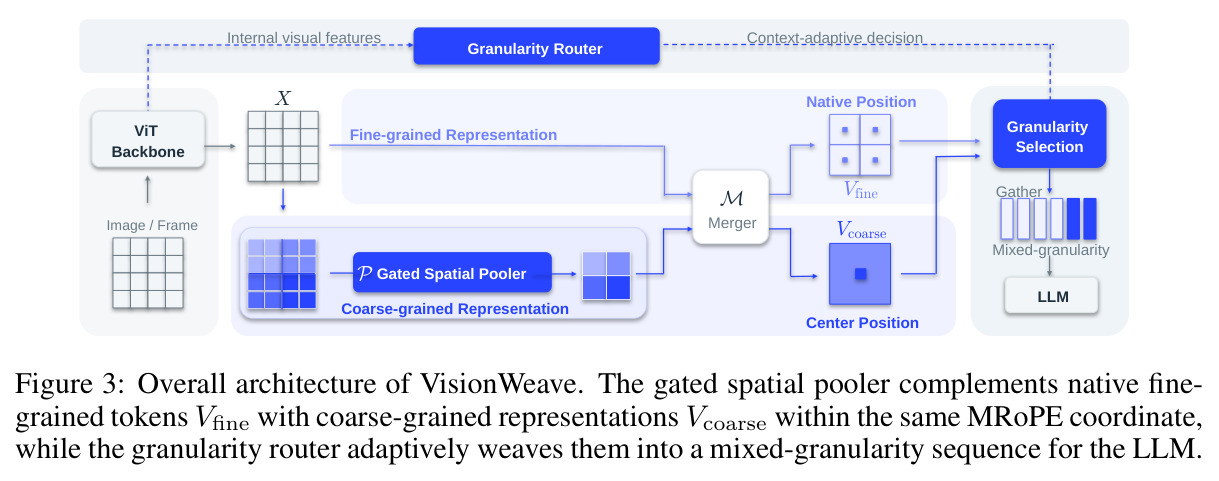
MLLM 先用 ViT 把图像切成固定大小 patch 并编码为特征 $X \in \mathbb{R}^{H\times W\times d}$,再由原生 merger 把每个 $2\times2$ 邻域拼接过 MLP,得到 LLM 侧的细粒度视觉 token $V_{\text{fine}} \in \mathbb{R}^{H/2\times W/2\times D}$。Qwen 系列采用 native-resolution 处理,网格大小随输入分辨率动态变化,典型预算为每张图或每帧 512 个 token。
本文的细粒度/粗粒度两种表示都定义在这个 token 网格之上:粗粒度 token 恰好是把 4×4 个 patch 压成 1 个。不懂 token 化的层级结构,就无法理解粒度编织的决策单元和 token 节省比例从何而来。
MRoPE(多模态旋转位置编码)
MRoPE 给每个 token 分配三维坐标 $\pi_{ij}=(\tau,i,j)$,分别对应时间 $\tau$ 与空间行列索引,并通过旋转位置编码注入注意力计算,使 LLM 能同时感知视频帧间与图像内的相对位置,是 Qwen-VL 等模型的标准位置编码方案。
VisionWeave 的关键技巧是把粗粒度 token 放在其覆盖的四个细粒度 token 的几何中心坐标 $\pi_{IJ}=(\tau,2I+\tfrac12,2J+\tfrac12)$ 上,靠 MRoPE 的统一坐标系实现混合粒度序列的无缝编织;SGLang 部署时还专门要支持这种半整数坐标。
输出分布自蒸馏
用模型自身的原生前向作为教师:对教师生成的回答 $y$,在每个位置上最小化学生与教师输出分布的前向 KL 散度,仅在教师 top-512 词表条目上重归一化计算,$\mathcal{L}_{\text{distill}}=\frac{1}{|y|}\sum_t \mathrm{KL}\big(\bar p_{\bar\theta}(\cdot|y_{<t},c,V_{\text{fine}})\,\big|\big|\,p_\theta(\cdot|y_{<t},c,V_{\text{student}})\big)$,全程不需要人工标注。
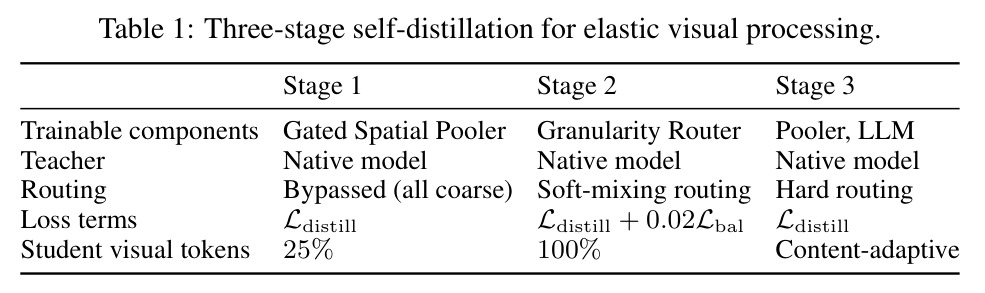
VisionWeave 完全靠自蒸馏把弹性视觉处理植入基座模型,三个训练阶段的监督信号都来自这一个损失(蒸馏为 off-policy,温度 1)。理解它才能理解整个三阶段训练流程。
视觉 token 剪枝与合并(FastV、VisionZip)
FastV 依据注意力权重在 LLM 浅层之后剪掉低重要性 token,代表剪枝路线;VisionZip 在视觉编码器输出端做 token 合并与筛选,代表合并路线。两者都需预设压缩率(如固定 50%),且直接丢弃 token 会在空间覆盖上留下空洞;对注意力权重的依赖(FlashAttention 内核不暴露)和在 LLM 内部剪枝的设计也使其难以接入 SGLang/vLLM。
它们是本文的核心对照基线。论文反复用它们在固定 50% 节省下的崩溃(Qwen3.8-27B 上 ScreenSpotV2 各跌约 47.5%/47.9%、DocVQA 跌 16.68%/17.80%)来论证换粒度优于丢 token。
MoE 负载均衡损失
混合专家训练中防止路由塌缩到少数专家的辅助损失。本文借用其形式:$\mathcal{L}_{\text{bal}}=F/\rho+(1-F)/(1-\rho)$,其中 $F$ 是样本内被判为粗粒度的块比例,$\rho=0.8$ 是目标粗路由比例;采用逐样本统计以避免大图主导梯度、批平均掩盖输入级不均衡,以 0.02 的权重加进 Stage 2。
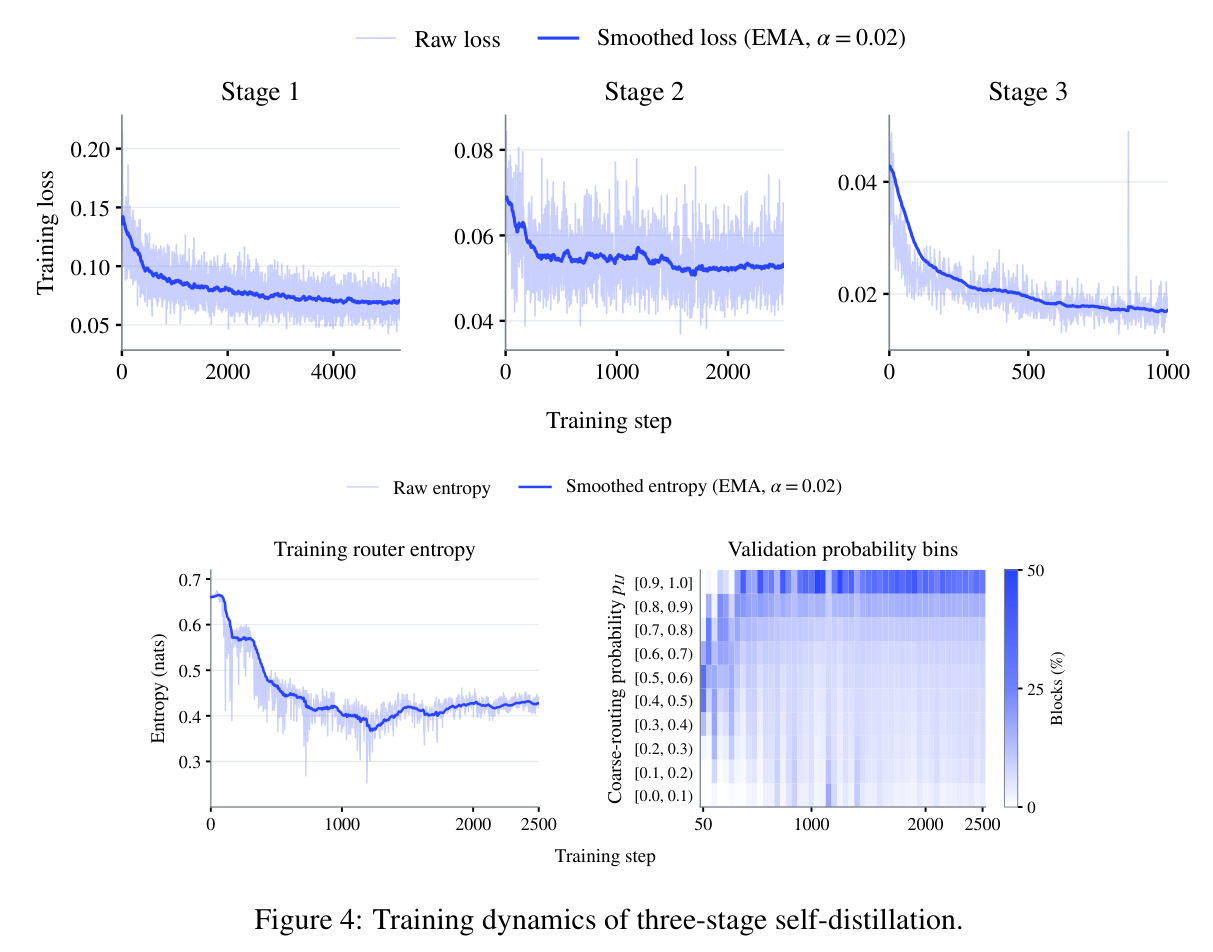
Stage 2 训练路由器时靠它把粗粒度比例拉向目标,理解它才能看懂路由分布如何从犹豫变得果断:路由熵从 0.658 降到 0.427 nats,$p_{IJ}\in[0.4,0.6)$ 的块占比从 64.8% 降到 14.6%。
TTFT 与 TPOT
TTFT(Time To First Token)是从发出请求到收到首个输出 token 的延迟,主要由 prefill 阶段决定;TPOT(Time Per Output Token)是解码阶段平均每个输出 token 的耗时。视觉 token 越多,prefill 计算量与 KV cache 越大,TTFT 越高,长视频输入场景尤其严重。
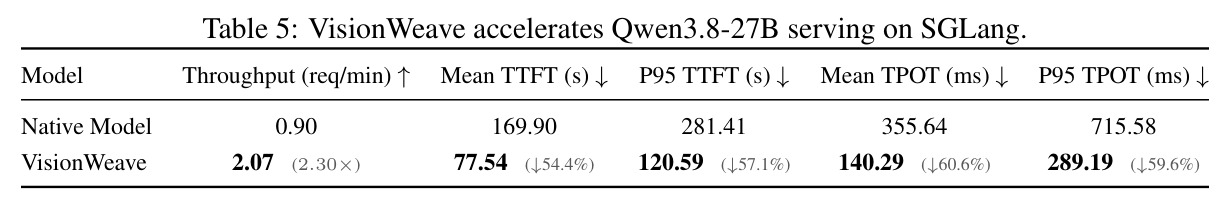
论文的最终价值主张落在服务指标上:SGLang 实测吞吐 2.30×、TTFT 均值降 54.4%、TPOT 均值降 60.6%。不理解这两个指标,就无法评估 token 节省是否转化为真实部署收益。
研究动机
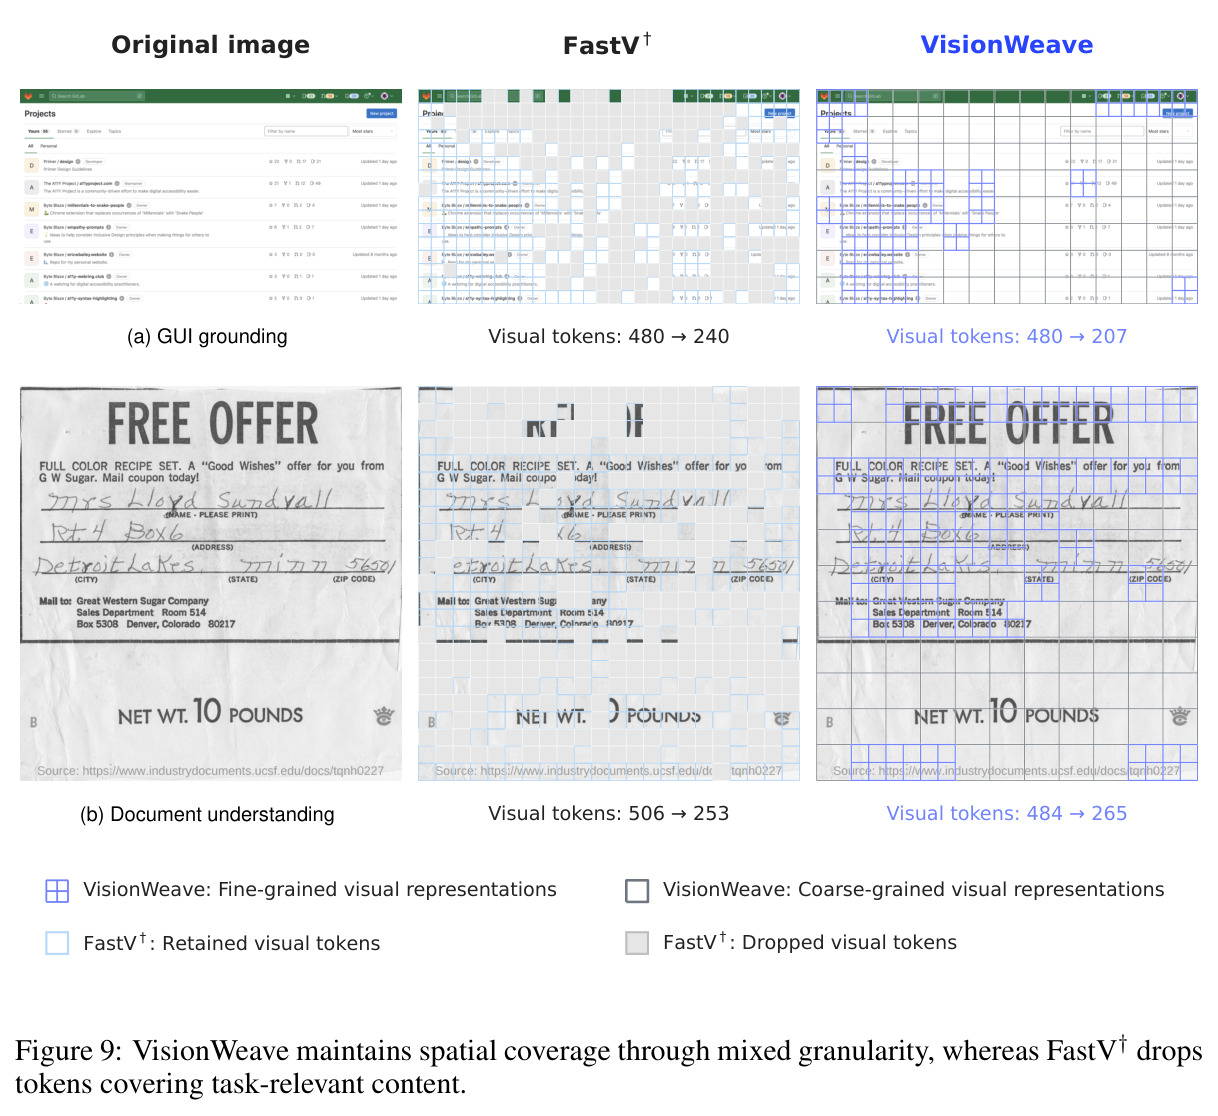
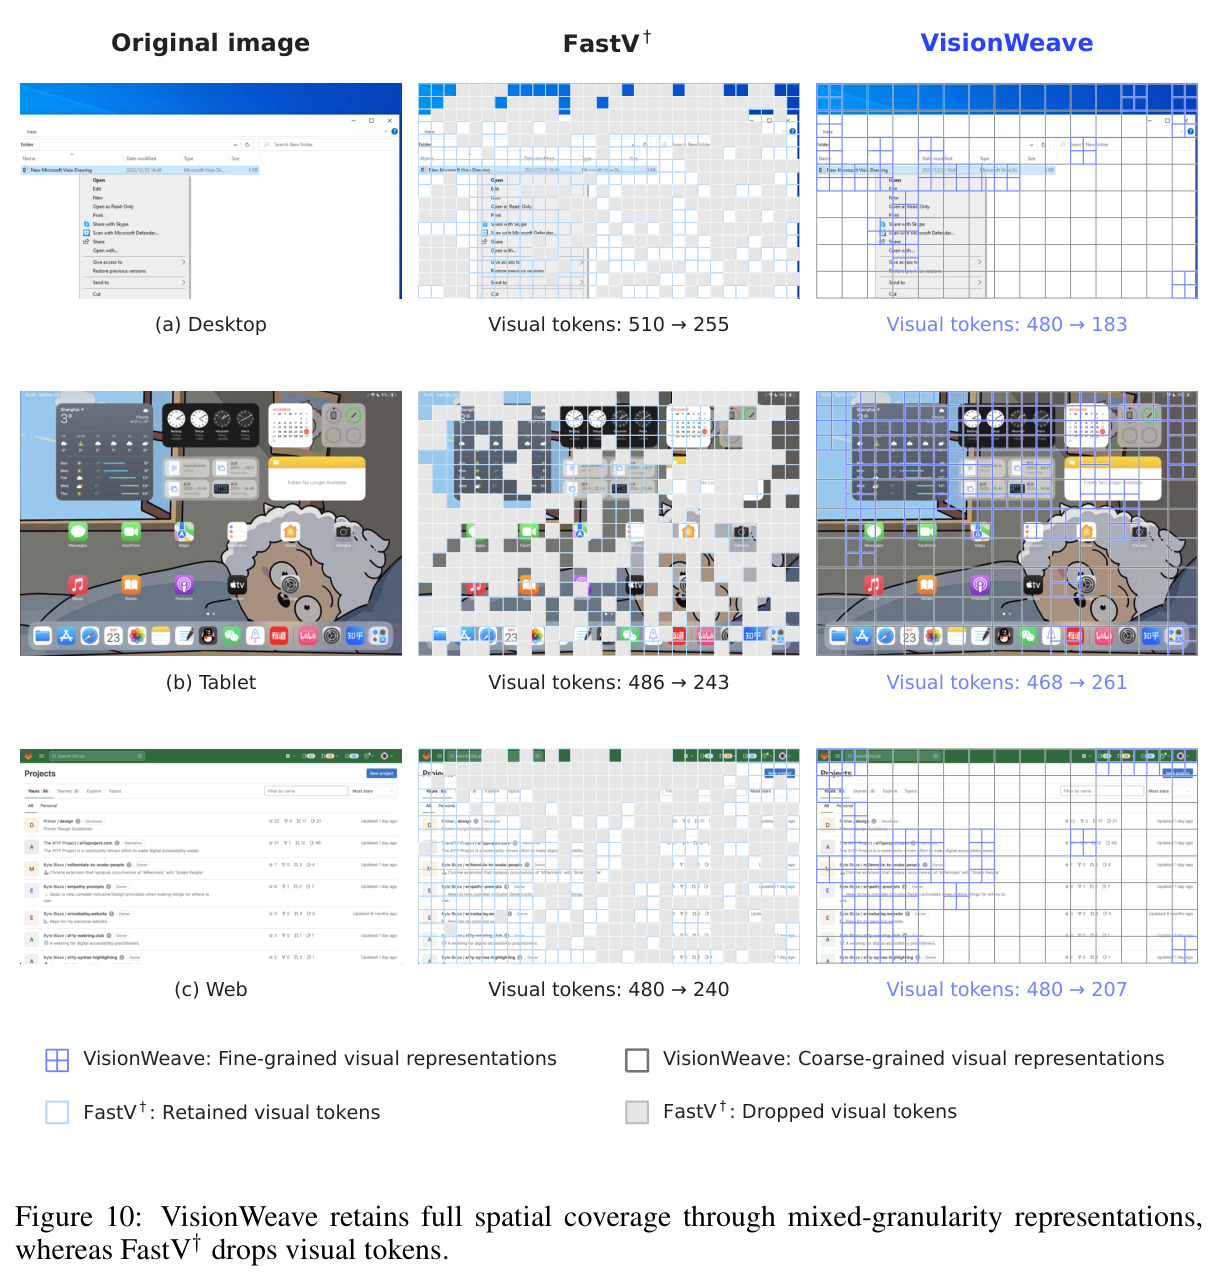
多模态大模型把图像和视频帧切成固定 patch、编码为稠密 token 序列,Qwen3.8-27B 这类模型的典型输入预算是每图或每帧 512 个视觉 token,视频最多采样 64 帧,一次输入动辄上万甚至数万视觉 token,prefill 计算量与 KV cache 显存随之暴涨,成为扩展多模态能力的核心瓶颈。但视觉信息分布极不均匀:文字、图表、按钮等区域需要细粒度细节,天空、墙面等大面积背景用紧凑表示即可。现有方案各有硬伤:直接下采样会无差别牺牲细节;token 剪枝/合并方法在固定 50% 压缩率下于信息密集与定位任务上严重退化——在 Qwen3.8-27B 上 VisionZip 在 ScreenSpotV2 从 94.42 跌至 49.21(↓47.88%)、DocVQA 跌 17.80%,FastV† 分别跌 47.54% 和 16.68%,而视频任务上损失却很小,说明固定预算完全不适配内容差异。此外,这些方法依赖显式注意力权重(FlashAttention 内核不暴露)或在 LLM 内部剪枝,与 SGLang/vLLM 的动态 batching、chunked prefill 冲突,导致工程落地稀少、实际效率收益缺乏验证。
本文的目标是本文要把弹性视觉表示编织(elastic visual representation weaving)确立为前沿 MLLM 的一种内生能力:让模型端到端地学会在哪里保留细粒度、在哪里以及以何种程度使用紧凑的粗粒度表示,并满足三个要求——其一,自主进行内容自适应的 token 节省而不牺牲任务质量;其二,在自然图像、文档、信息图、GUI 定位、视觉幻觉、视频理解等多样任务以及不同输入分辨率、不同视频帧数预算下,始终保持优于简单下采样的效率-质量折中;其三,兼容 Qwen、Kimi 这类 native-resolution 前沿架构与现代 SGLang 服务基础设施,把 token 节省真正转化为吞吐和延迟收益。落地路径是先在 Qwen3.5-4B 上验证方法可行性,再以超过 3 万 A100 GPU 小时的大规模训练把该能力扩展到 Qwen3.8-27B 旗舰模型。
与已有工作不同的是,已有自适应粒度工作留下两层空白。ViT 层面按边缘密度、熵等低层图像统计量调整 patch 大小的方法主要面向独立视觉任务,其粒度判据并未针对下游多模态目标优化。MLLM 层面最接近的 ViCO 虽然能给每个图像 tile 自适应分配 token 分辨率(每 tile 256 或 64 个 token),但其 tile 级设计难以直接移植到 Qwen、Kimi 等采用 native-resolution 视觉处理的前沿模型;而且细节丰富区域与低信息背景常常犬牙交错,一个 tile 只给一种分辨率的空间粒度太粗。VisionWeave 的独特切入在于三点:把分配粒度细化到 native-resolution 管线内部的 4×4 patch 块级(4 个细 token 或 1 个粗 token);路由决策由任务输出分布的自蒸馏驱动而非低层统计启发式;并且训练与推理使用完全相同的硬路由构造,最后把半整数 RoPE 坐标与混合粒度序列支持做进 SGLang,打通从研究方法到生产部署的最后一公里。
核心方法
直觉上,与其问哪些 token 可以扔掉,不如问每个区域该用多细的表示。VisionWeave 把每个覆盖 4×4 个 patch 的空间块视为决策单元:块内要么保留 4 个原生细粒度 token,要么压缩成 1 个可学习的粗粒度 token;粗 token 通过位置插值放进共享 MRoPE 坐标系的块中心位置,空间覆盖不留任何空洞,只是局部变粗。技术路线分三步:第一步,用门控空间池化器 $P$ 把每个 2×2 patch 邻域池化为单特征,再经原生 merger 得到与细粒度 token 同嵌入空间的粗粒度表示 $V_{\text{coarse}}=M(P(X))\in\mathbb{R}^{H/4\times W/4\times D}$;第二步,用粒度路由器在 ViT 的多个深度上探测特征,为每个块输出使用粗表示的概率 $p_{IJ}$,按阈值 $t=0.5$ 在粗细两种表示间二选一;第三步,通过三阶段自蒸馏(先训池化器、再训路由器、最后联训池化器与 LLM)把这套机制作为原生能力植入 Qwen3.5-4B 和 Qwen3.8-27B,教师始终是模型自身的原生前向,蒸馏为 off-policy、温度 1、对教师 top-512 词表计算前向 KL。
核心创新是范式转换:从丢 token 到换粒度。FastV/VisionZip 删除 token 后在空间覆盖上留下空洞,GUI 点击目标或文字一旦被删信息就彻底丢失;VisionWeave 中每个区域永远有表示,只是粒度不同——粗 token 位于 $\pi_{IJ}=(\tau,2I+\tfrac12,2J+\tfrac12)$ 的块中心,细粗 token 在同一 MRoPE 框架内按原生栅格顺序无缝混合。第二个本质区别是路由由任务损失驱动:路由器用可学习查询从 ViT 浅层提取低层细节、深层提取语义信息,多深度探测后输出块级决策,训练信号来自输出分布蒸馏而非边缘密度等低层启发式,因此在 ScreenSpotV2 上能省 55.1% token 只损 3.17%,而固定 50% 目标的基线损失约 48%。第三点是把这套机制定位为基础模型的原生能力:仅靠自蒸馏(无任何人工标注)在 3 万余 A100 卡时内植入 27B 旗舰模型,且通过坐标加倍、频率减半的 RoPE 重标定真正集成进 SGLang,实现 2.30× 端到端吞吐提升。
方法步骤详情
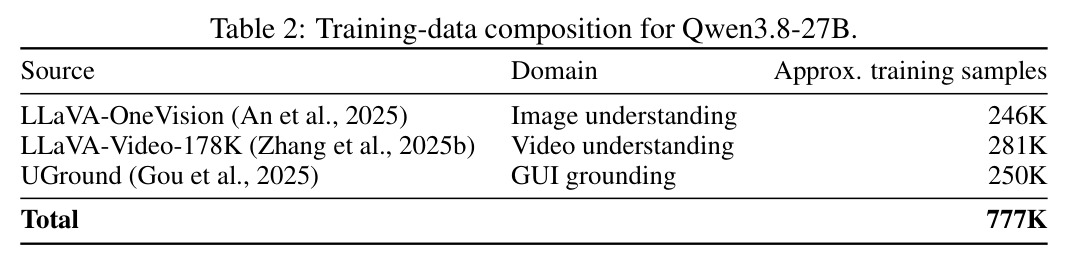
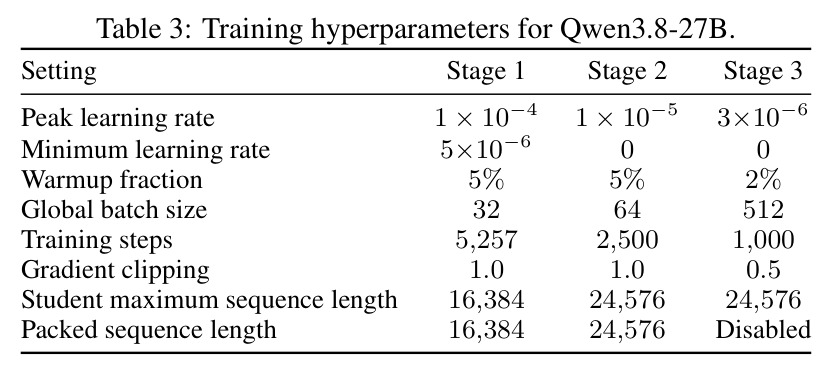
完整流程如下。构建粗表示:池化器 $P$ 对每个 2×2 邻域的四个 patch 特征先做可学习 LayerNorm 得 $u_k$,聚合全局上下文 $g_k=f_{\text{glb}}[u_1;u_2;u_3;u_4]+b_k$($b_k$ 为可学习位置偏置),门控按通道对四个空间位置做 softmax $\alpha_k=\text{softmax}(f_{\text{gate}}[u_k;g_k])$,值网络残差细化 $v_k=u_k+f_{\text{val}}[u_k;g_k]$,输出 $\sum_k\alpha_k\odot v_k$;零初始化 $f_{\text{gate}}$、$f_{\text{val}}$ 末端即退化为归一化均值池化,提供良好起点。路由:每块初始化一个共享查询状态 $h_{IJ}$,用块中心 RoPE 坐标定位,依次在 ViT 深度 $\ell=0,13,27$ 上做局部块内交叉注意力(只看自己的 4×4 patch)加全局全帧交叉注意力,共六个独立参数化块,线性头输出 $p_{IJ}$;$p_{IJ}>t$ 取粗 token,否则保留四个细 token,按原生栅格顺序聚成混合粒度序列送入 LLM。训练三阶段(Table 1):Stage 1 绕过路由、全 coarse,只训池化器(学习率 $10^{-4}$,5,257 步);Stage 2 用方向与幅度分离插值的软混合替代硬路由,加均衡损失 $\mathcal{L}_{\text{distill}}+0.02\mathcal{L}_{\text{bal}}$,只训路由器($10^{-5}$,2,500 步);Stage 3 用与推理一致的硬路由,训池化器与 LLM,路由器冻结并带离线校准的标量粗路由偏置($3\times10^{-6}$,1,000 步)。训练数据 77.7 万样本:图像理解 246K(LLaVA-OneVision)、视频理解 281K(LLaVA-Video-178K)、GUI 定位 250K(UGround),图像预算 4,096 token、视频 512 token/帧、最多 64 帧。
技术新颖性
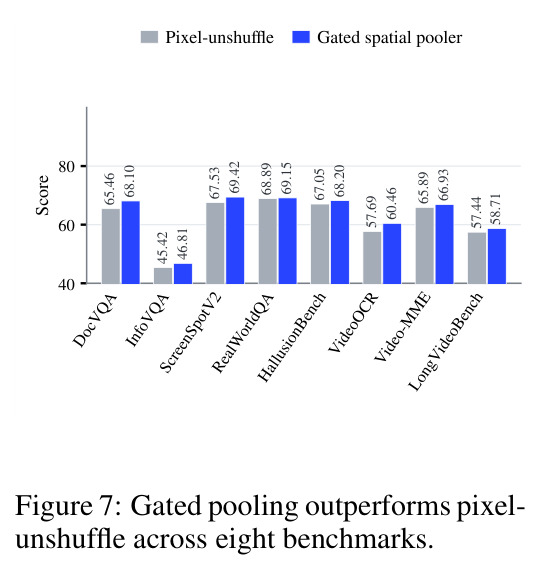
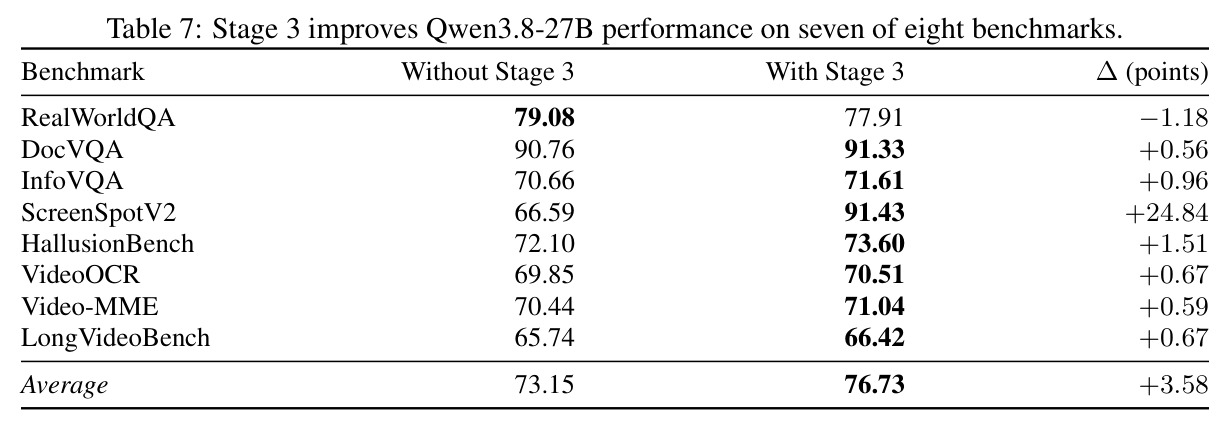
技术新颖性有四点。其一,块级弹性粒度是新的:相比 ViCO 的 tile 级分配(每 tile 256 或 64 个 token),VisionWeave 在 native-resolution 管线内以 4×4 patch 为单位做 4 细 token 或 1 粗 token 的决策,空间粒度细一个量级,能处理细节与背景交错的场景。其二,门控空间池化器是均值池化的可学习推广:通道级、内容相关的门控加值网络残差,且零初始化即等价于归一化均值池化;消融显示它在全部 8 个基准上稳定优于常用的 pixel-unshuffle 投影(DocVQA +2.64、VideoOCR +2.77)。其三,蒸馏设计细致:软混合时把特征方向与幅度分开插值,避免范数差异偏置方向混合;路由分布的训练动态清晰收敛——熵从 0.658 降至 0.427 nats,犹豫块($p_{IJ}\in[0.4,0.6)$)占比从 64.8% 降到 14.6%,$p_{IJ}\ge0.9$ 的块达 28.3%;Stage 3 在硬路由序列上继续蒸馏带来 +3.58 平均分。其四,工程闭环:通过把所有位置坐标加倍、旋转频率减半以保持旋转相位,让半整数块中心坐标跑在 SGLang 整数索引的 RoPE 缓存上,并用布局元数据扩展 encoder 分离调度,保住动态 batching、KV cache 管理与 CUDA-graph 解码——这是同类视觉 token 压缩工作极少做到的。
实验结果
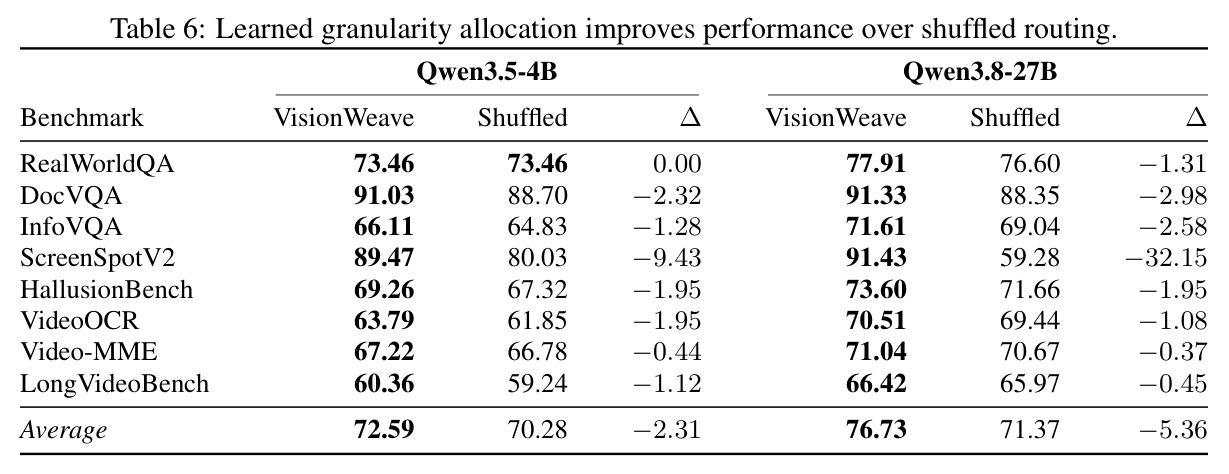
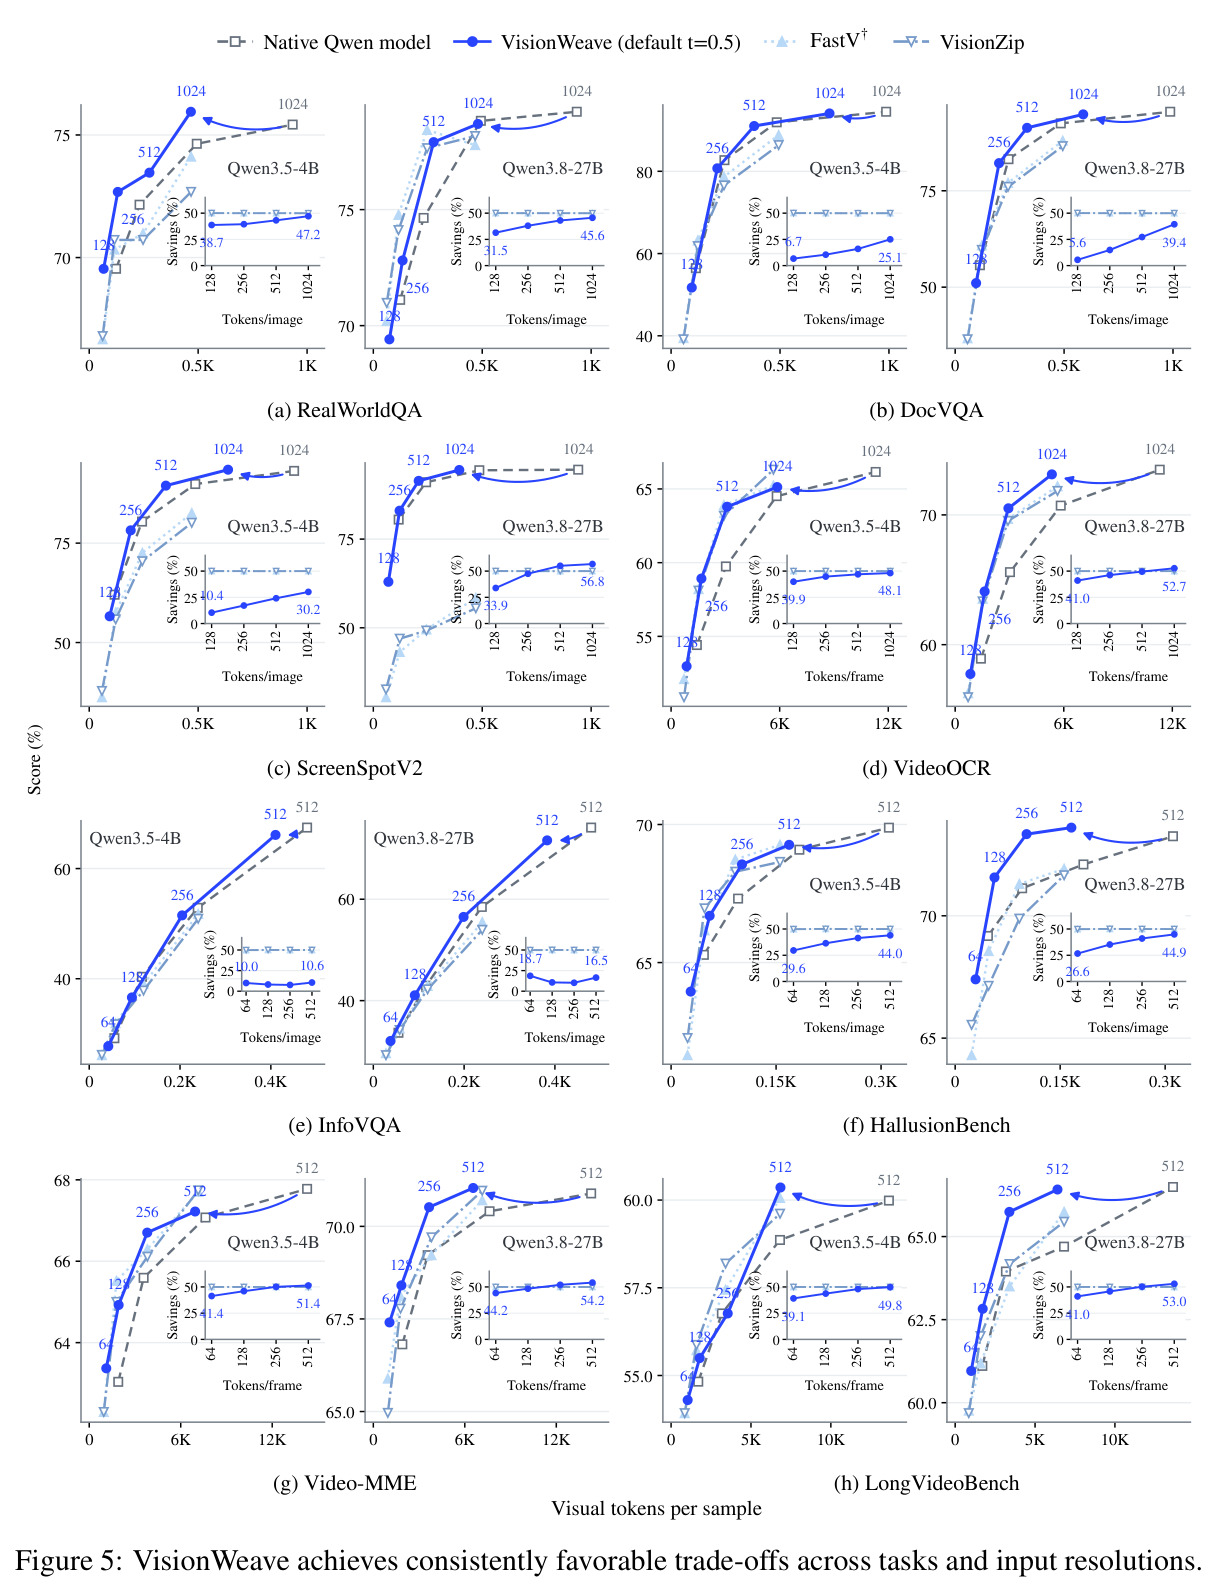
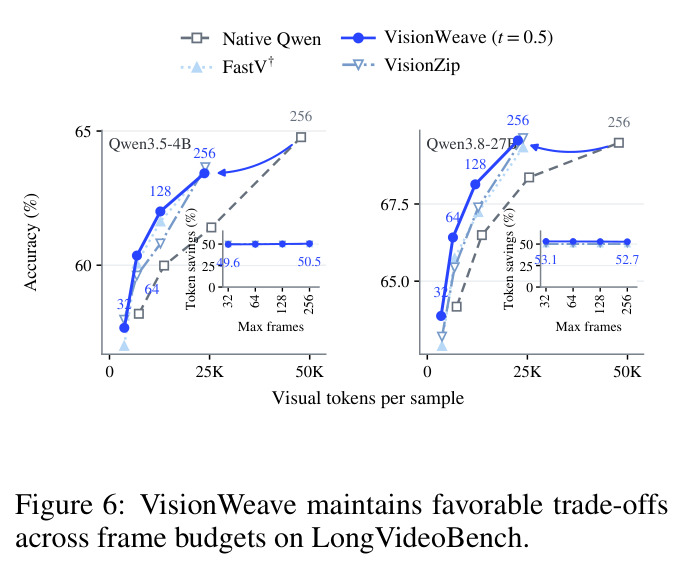
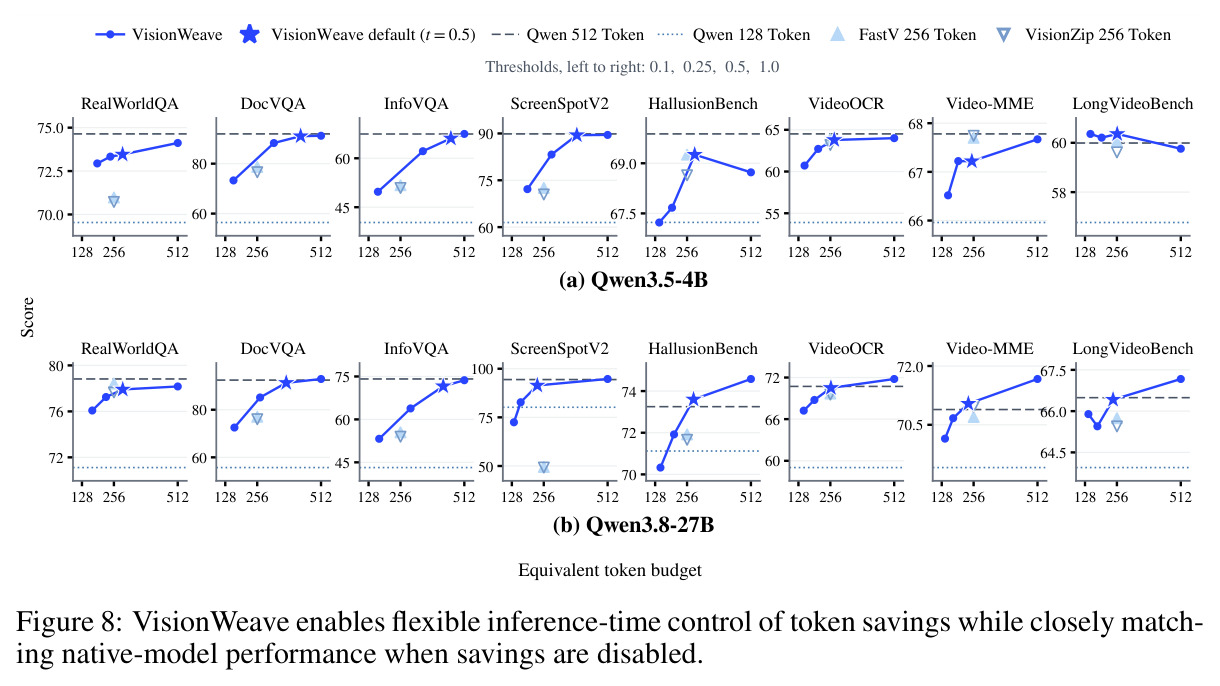
主结果(Table 4,512 token 输入预算,$t=0.5$):Qwen3.8-27B 上 VisionWeave 在八个基准平均省 43.0% 视觉 token(各任务 16.5%–55.1%),平均性能仅降 1.08%(原生 77.65→76.73,保留 98.9%);作为对比,固定 50% 节省的 FastV† 和 VisionZip 平均分别降 11.82% 和 12.46%。逐任务看:ScreenSpotV2 省 55.1% token 只降 3.17%(91.43 vs 原生 94.42),而 FastV†/VisionZip 崩到 49.53/49.21;DocVQA 自适应地只省 27.3%,损失仅 1.23%(91.33 vs 92.47);InfoVQA 省 16.5%、降 3.40%;三个视频基准省 49.6%–54.2% 而损失不超过 0.30%,HallusionBench 甚至 +0.48%。Qwen3.5-4B 平均降 0.90%、省 35.8%。即使给基线匹配 VisionWeave 的数据集级节省率(Appendix E.3),27B 平均仍是 76.73 vs 70.10/70.33。分辨率与帧数扫描(Figure 5/6)显示 128–1024 token/图全区间一致优于下采样;256 帧上限的 VisionWeave 在 LongVideoBench 上比 128 帧的原生模型高 1.20 分且 token 更少。SGLang 实测(Table 5):吞吐 0.90→2.07 req/min(2.30×),TTFT 均值降 54.4%、P95 降 57.1%,TPOT 均值降 60.6%、P95 降 59.6%。消融证实各组件必要性:门控池化器全线优于 pixel-unshuffle;打乱路由(保持节省量、破坏空间对齐)使 27B 平均掉 5.36 分、ScreenSpotV2 掉 32.15 分,证明学到哪里省比省多少更重要;去掉 Stage 3 平均从 76.73 跌到 73.15,ScreenSpotV2 从 91.43 崩到 66.59。阈值 $t$ 提供免训练调控:从 0.5 降到 0.25,Video-MME 节省 54.2%→66.0% 仅损 0.37 分,4B 上 51.4%→62.1% 而分数保持 67.22。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GUI 定位 ScreenSpotV2(Qwen3.8-27B) | 任务得分(0-100) | 91.43(自适应节省 55.1% token) | 原生模型 94.42;FastV† 49.53、VisionZip 49.21(固定 50% 节省) | 仅比原生降 3.17%,比 VisionZip 高 42.22 分 |
| 文档理解 DocVQA(Qwen3.8-27B) | ANLS | 91.33(节省 27.3%) | 原生 92.47;FastV† 77.05、VisionZip 76.01 | 仅降 1.23%,两个基线分别降 16.68% 和 17.80% |
| 信息图理解 InfoVQA(Qwen3.8-27B) | ANLS | 71.61(节省 16.5%) | 原生 74.13;VisionZip 53.96、FastV† 55.49 | 仅降 3.40%,VisionZip 降 27.21% |
| 视频理解 Video-MME(Qwen3.8-27B) | 任务得分(0-100) | 71.04(节省 54.2%) | 原生模型 70.89 | 反超原生 0.21 分,同时省一半以上 token |
| 八基准平均(Qwen3.8-27B) | 平均得分 / 平均 token 节省 | 76.73(−1.08%),节省 43.0% | 原生 77.65;FastV† 67.32(−11.82%)、VisionZip 66.81(−12.46%) | 保留 98.9% 原生性能,基线仅保留约 88% |
| SGLang 端到端服务(27B,256 帧长视频负载) | 吞吐 / TTFT / TPOT | 2.07 req/min;TTFT 77.54 s;TPOT 140.29 ms | 原生模型 0.90 req/min;TTFT 169.90 s;TPOT 355.64 ms | 吞吐 2.30×,TTFT 均值 ↓54.4%,TPOT 均值 ↓60.6% |
局限与改进
作者承认的局限:受训练算力限制,路由器架构等设计选择未能更充分地探索;目前只有粗细两级粒度,作者预期扩展到更丰富的多尺度表示会带来进一步收益;能力靠后训练自蒸馏植入,长期应把弹性视觉编织前移到基座模型预训练阶段。我自己的观察:其一,自适应节省意味着计算成本不可预测——InfoVQA 只省 16.5% 而 Video-MME 省 54.2%,同一模型在混合负载下延迟方差大,对容量规划和 SLO 保障是现实挑战(可用预算约束路由缓解,但论文未做);其二,文档/信息密集任务即使把节省降到 27.3% 仍损 1.23%–3.40%,说明固定 4:1 的两级压缩对密集小字仍不够细,缺少中间粒度档位;其三,蒸馏的天花板是教师本身——粗表示不可能超越原生模型,若原生模型在某任务上本来就弱,弹性化无济于事;其四,只在 Qwen 家族两个模型上验证,对 InternVL、Kimi 等其他架构以及医疗、遥感等域外数据未验证泛化;其五,路由器虽小,但需要一次多深度特征读取与六个交叉注意力块的计算,论文未单独报告其开销占端到端成本的比例。
独立分析的弱点
弱点一:粒度只有两级、压缩比固定 4:1,对密集小字文档过粗(InfoVQA 仅省 16.5%),对平缓视频又可能不够省;改进方向是引入多级或连续粒度(如 2×2、4×4、8×8 池化并存),把路由改成多类分类或级联决策。弱点二:节省量内容自适应但总量不可控,生产环境往往需要给定 token 预算;可以把目标节省率 $\rho$ 作为条件输入路由器,或对 $p_{IJ}$ 做预算约束下的 top-k 选择,实现给定预算、输出对应质量的可控推理。弱点三:路由器只读冻结 ViT 的特征,粒度决策无法感知 LLM 内部的任务状态(如已生成的部分回答),也无法随下游任务定制;可让路由在 LLM 浅层表征条件下二次修正,或用轻量 RL 以任务奖励直接微调路由。弱点四:GUI 定位对像素级精度敏感,块级 coarse 即便有表示也可能损失小尺寸可点击图标的位置精度(ScreenSpotV2 仍降 3.17%);可对高熵块在保留细粒度的同时叠加边界框先验或更高密度的定位头。弱点五:评测集中于理解类基准,未覆盖以视觉为中心的生成任务(OCR 长文转写、图表重绘等),这类任务中细粒度信息的作用可能被系统性低估。
未来方向
作者提出的方向:突破当前两级设计走向更丰富的多尺度弹性表示;探索更多路由器架构;把弹性视觉编织从后训练前移到基座模型预训练,让视觉理解与计算效率联合演化,长期形成按信息含量原生调节计算量的新一代多模态基础模型。基于本文成果可延伸的:一是与 KV-cache 压缩正交组合——视觉 token 减少同时降低 prefill 计算与 cache 体量,再叠加 DeepSeek-V4 式的学习型 KV 压缩可进一步压低显存占用;二是把内容自适应思想扩展到时间维(视频帧级粒度路由:关键帧细、过渡帧粗)和音频模态;三是把路由概率 $p_{IJ}$ 用作不确定性信号做 coarse-to-fine 级联推理,低置信区域触发二次细粒度前向;四是在服务层把阈值 $t$ 暴露为请求级 QoS 参数,按延迟/成本档位动态调节质量-成本曲线;五是把硬路由蒸馏与视觉 RL(如 GUI agent 的点击成功奖励)结合,让粒度决策直接优化下游任务回报而非仅模仿教师分布。
复现评估
复现条件较为苛刻但有据可依。开源情况:论文承诺在 https://github.com/FFY0/VisionWeave 公开 SGLang 集成代码与细节(正文标注 will be available,属于代码即将释放状态);基座模型 Qwen3.5-4B、Qwen3.8-27B 为开源权重;训练数据全部公开(LLaVA-OneVision 246K、LLaVA-Video-178K 281K、UGround 250K,共 77.7 万样本)。算力方面:27B 三阶段训练超过 3 万 A100 GPU 小时,学术实验室基本无法完整复现 27B 结果;4B 版本算力需求按规模估计低一个数量级左右,单机 8×A100 量级有希望完成。工程细节披露充分:Table 3 给出全部超参(三阶段学习率 $10^{-4}/10^{-5}/3\times10^{-6}$、batch 32/64/512、步数 5,257/2,500/1,000、序列长度与梯度裁剪),蒸馏细节(top-512 KL、温度 1、离线校准的路由偏置)与 SGLang 配置(E.4:TP=2、chunked prefill、CUDA-graph 设置等)完整列出,复现确定性较高。主要风险是基座模型版本迭代与内部基础设施(sequence packing、优化器实现)差异带来的偏差。总体评估:4B 复现为中等偏难,27B 全量复现为难。
论文图表
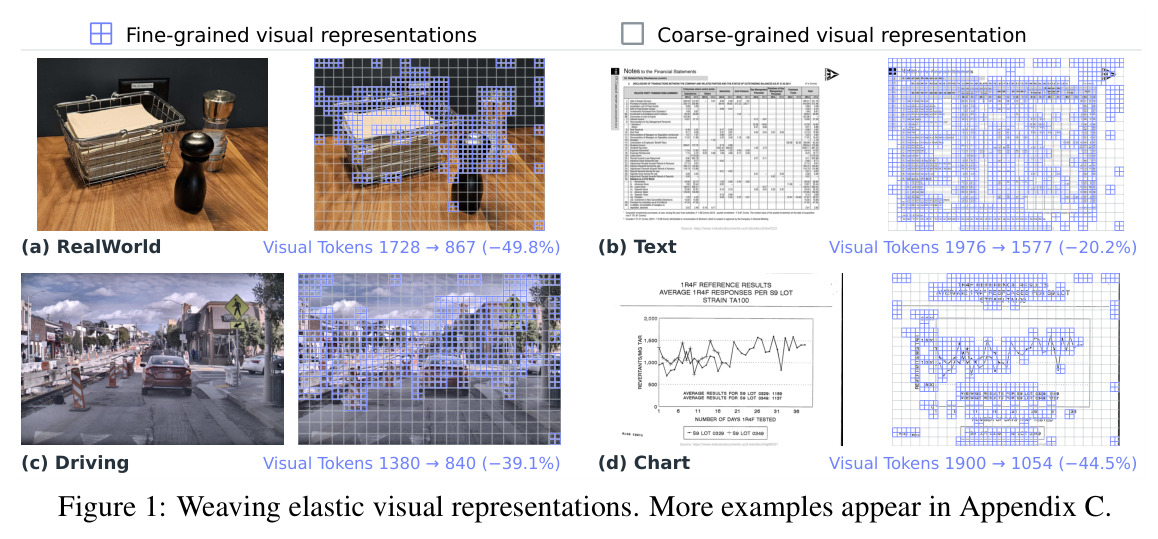
四个典型场景的弹性编织可视化:真实世界图像、文本文档、驾驶场景、图表,蓝格为细粒度表示、灰格为粗粒度表示,并标注各例的 token 节省——RealWorld 1728→867(−49.8%)、Text 1976→1577(−20.2%)、Driving 1380→840(−39.1%)、Chart 1900→1054(−44.5%)。
一图看懂论文核心概念的直观效果:同一张图内细粗粒度交错分布、节省率随内容大幅变化,是理解弹性编织的最快入口。
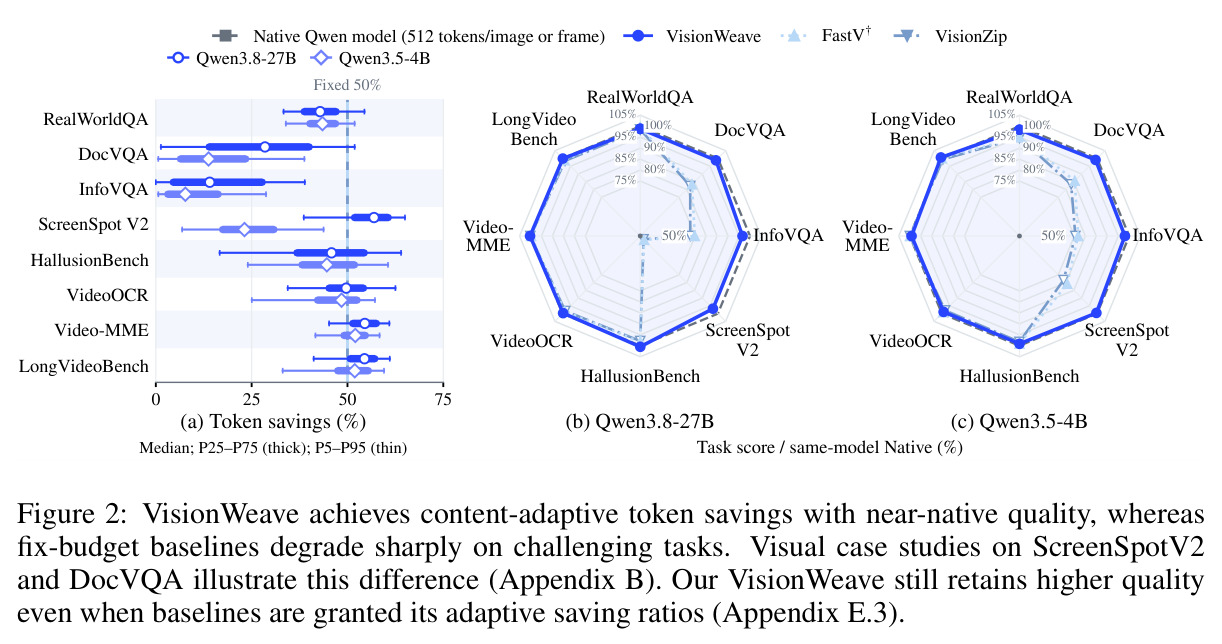
三联图:(a) 各基准 token 节省率箱线图(中位数、P25–P75、P5–P95)显示内容自适应的节省分布;(b)(c) 分别在 Qwen3.8-27B 与 Qwen3.5-4B 上对比原生模型、VisionWeave、FastV†、VisionZip 的质量-节省散点,VisionWeave 位于高节省高质量区域,固定预算基线在 ScreenSpotV2、DocVQA 等难任务上大幅掉分。
以全景视角呈现论文的核心主张——内容自适应节省 + 近原生质量,以及与基线的系统性差距,是理解实验故事主线的关键图。
主实验表:Qwen3.5-4B 与 Qwen3.8-27B 在八基准上对比原生模型、下采样、FastV†、VisionZip(固定 50% 节省)与 VisionWeave(自适应节省)。27B 上 VisionWeave 平均 76.73(−1.08%)、节省 43.0%;ScreenSpotV2 省 55.1% 仅降 3.17%,而 FastV†/VisionZip 降约 47.5%/47.9%;基线在 DocVQA、InfoVQA 上降 16.68%–27.21%。
论文最重要的结果表,所有核心量化主张(98.9% 性能保留、43.0% 节省、基线崩溃)均出自此表。
匹配节省率对比:给 FastV† 和 VisionZip 分配 VisionWeave 在各数据集上观测到的节省率后再比较。27B 平均 VisionWeave 76.73 vs FastV† 70.10、VisionZip 70.33;排除 ScreenSpotV2 后仍为 74.63 vs 73.86/73.85。
排除节省率差异这一混淆变量,证明即便预算相同,混合粒度表示仍优于剪枝/合并,是对公平性质疑的有力回应。
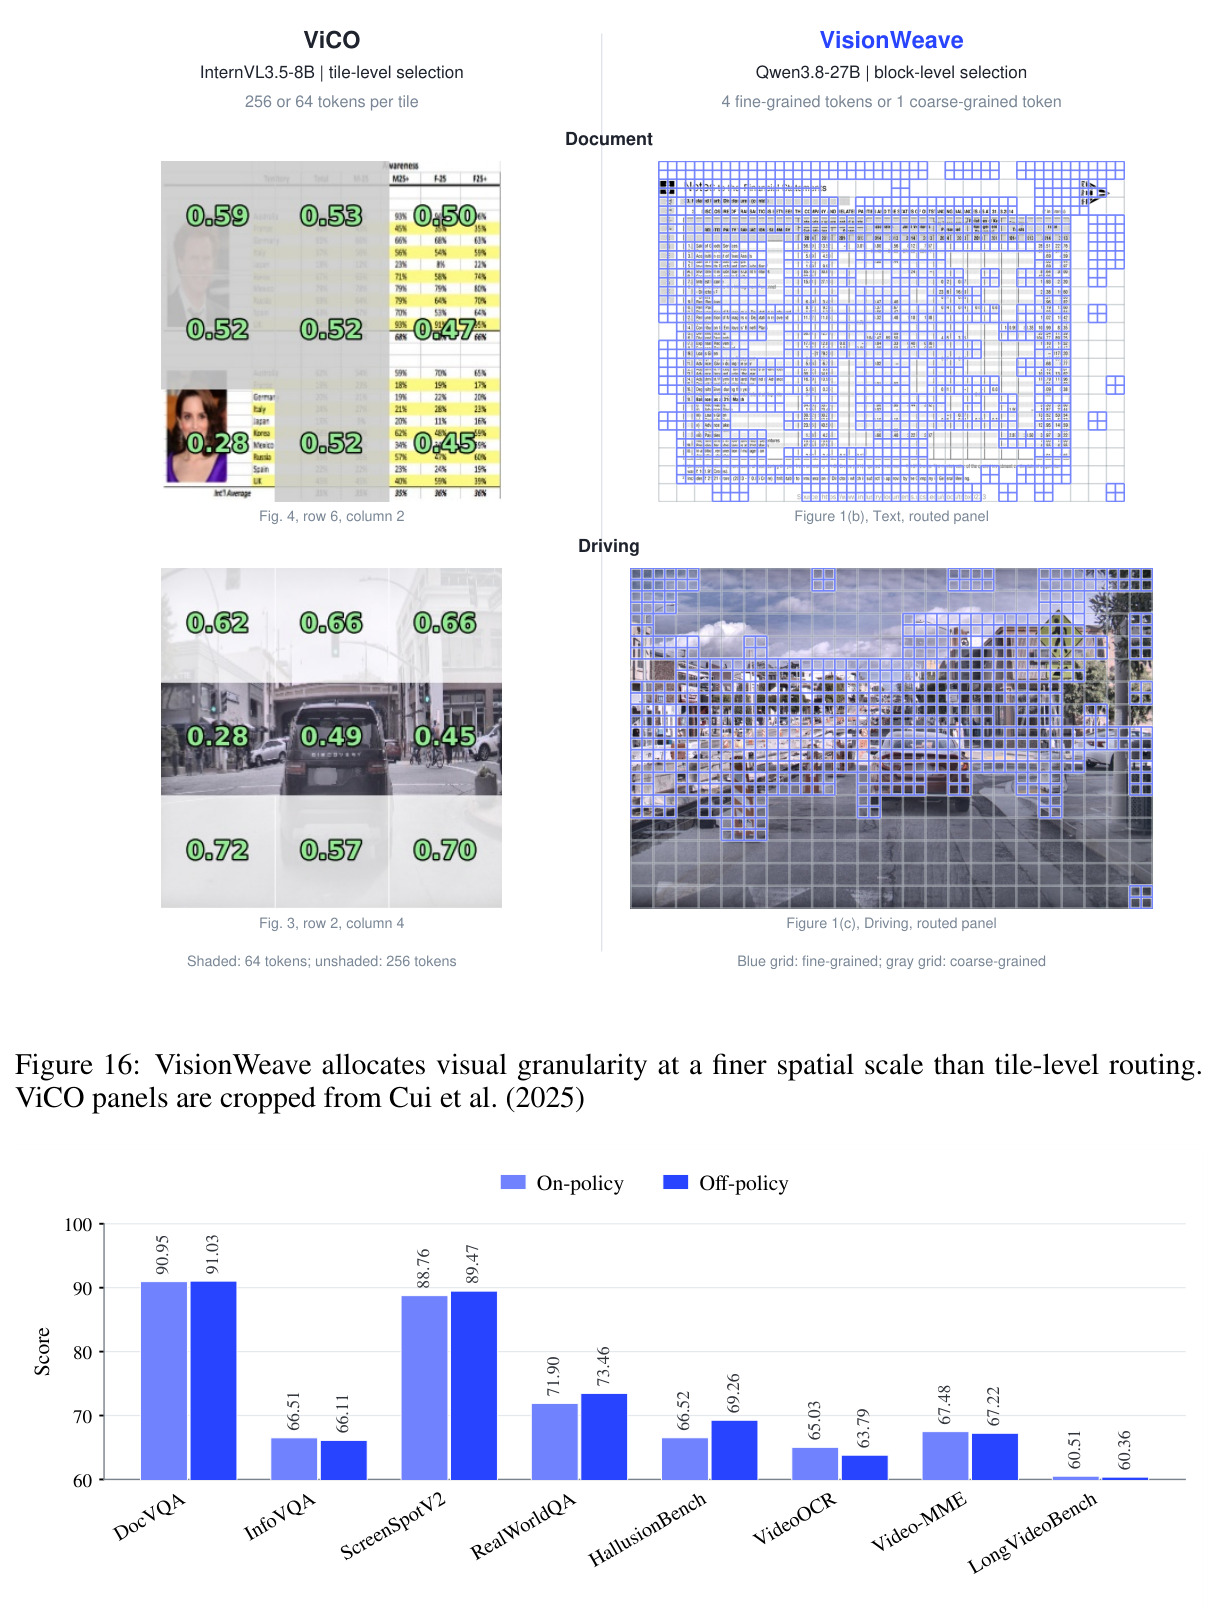
与 ViCO 的可视化对比:ViCO(InternVL3.5-8B,tile 级选择,每 tile 256 或 64 token)在文档、图表、驾驶场景中整块区域只能统一变粗;VisionWeave(Qwen3.8-27B)以块级(4 细 token 或 1 粗 token)在相同场景中交错分配,边界更细腻。
直观展示与最相关先前工作 ViCO 的粒度差异,理解本文空间分配优势的最佳对比材料。