WOVEN:将视觉世界建模编织进多模态大语言模型 WOVEN: Weaving Visual World Modeling into Multimodal LLMs
用视频生成模型批量构造可控$(s,a,s')$转换监督,证明视觉转换推理是可跨任务迁移的共享训练原语
前置知识
MLLM(多模态大语言模型)
在大语言模型主干上接入视觉编码器(通常是 ViT)与模态投影层,使模型能同时接收图像/视频和文本输入并统一进行推理的模型,代表如 GPT-5.4、Qwen2.5-VL、Llama-4-Maverick。它们一般经过视觉-语言对齐预训练和指令微调,擅长识别与图文问答,但对动态变化的推理能力有限。
本文的被诊断和被改造对象就是 MLLM:所有关于'视觉转换推理缺陷'与'训练后迁移收益'的结论都建立在 38 个 MLLM 的评测和 Qwen2.5-VL/Gemma-3 的后训练实验之上。
视觉转换推理与 $(s,a,s')$ 三元组
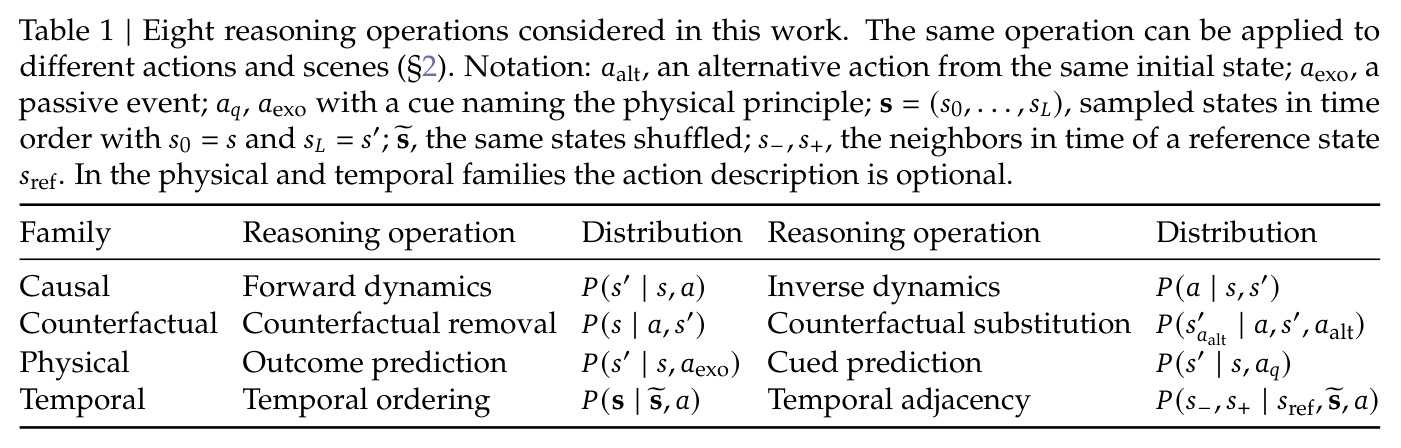
把场景的视觉变化抽象为'初始状态 $s$ 经动作 $a$ 变为结果状态 $s''。已知其中两个成分推断第三个就是一次转换推理:前向动力学 $P(s'|s,a)$ 预测结果,逆动力学 $P(a|s,s')$ 反推动作,还有反事实替换、时序排序等 8 种操作、4 个家族。作者假设这是空间/具身/物理/时间推理共同的地基。
这是全文的核心假设与统一表示:WOVEN 的数据组织、8 种推理操作的定义、以及'推理操作决定迁移方向'的配方,全部围绕这个三元组展开。
反事实推理
在保持初始状态和背景条件不变的前提下,设想'如果当初采取另一个动作会怎样'。对应 Pearl 因果阶梯的最高层(观察→干预→反事实),数学上需要建模 $P(s'^{a_{alt}} \mid a, s', a_{alt})$ 这类条件分布,即给定事实动作和真实结局作为证据,推断替代动作的结果。
反事实是 WOVEN 四大推理族之一,也是实验中最难的部分(GPT-5.4 在 counterfactual removal 上仅 64.5%);它还是区分'背答案'与'真正建模世界'的关键测试。
视频生成模型(I2V)作为数据引擎
图像到视频(Image-to-Video)生成模型(本文用 Wan2.2-I2V-A14B)以首帧图像和文本动作为条件生成后续视频。由于生成过程隐含学到的物理与时间规律,从同一首帧在不同动作描述下可以生成多条'世界线',天然提供动作已知、结局已知、还能给出替代结局的受控转换数据。
WOVEN 全部 36,076 条数据都由这条路线合成(约 7 小时视频)。理解'世界模型隔离'与'反事实 rollout'两条构造原则,才能理解数据为何可控、又有哪些来自生成模型的偏差风险。
SFT 与 GRPO
SFT(监督微调)直接在问答对上最大化答案的条件似然;GRPO(Group Relative Policy Optimization)是一种强化学习算法,对同一问题采样一组回答,用组内相对奖励作为优势估计做策略梯度更新,无需训练独立的价值网络,常用于强化模型的推理与答题行为。
论文所有训练实验都遵循统一的两阶段协议:全量数据用 SFT,11 个受控子集用'SFT + GRPO'。表格中'WOVEN SFT'与'WOVEN GRPO'两行的差异直接说明 RL 阶段对迁移增益的贡献。
LoRA(低秩适配)
参数高效微调方法:冻结原模型权重,只训练注入到注意力和投影层的低秩增量矩阵 $\Delta W = BA$(秩 $r$ 远小于维度 $d$)。本文配置为 $r=16, \alpha=4$,作用于 q/k/v/o 投影,配合 AdamW、学习率 $10^{-4}$、3 个 epoch、fp16。
复现论文训练几乎必须照抄这套协议;附录 G.1 还给出选项排列增强(每题 4 种选项顺序)等细节,这些都是结论可复现性的组成部分。
研究动机
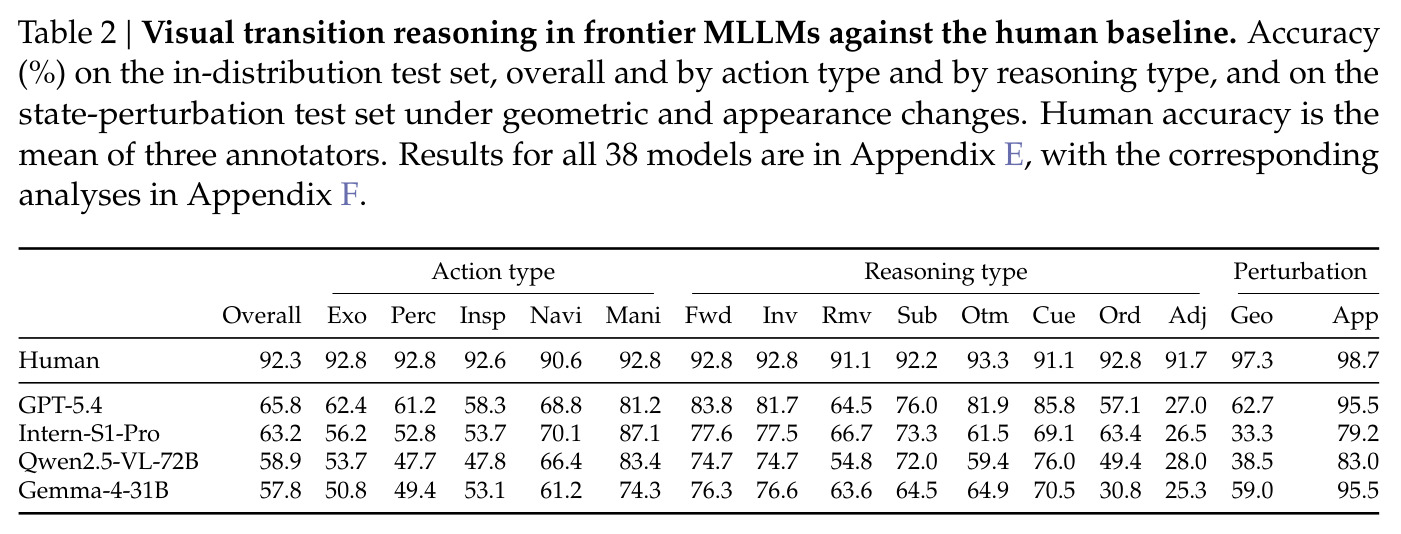
多模态大语言模型(MLLM)在静态感知和语言条件推理上已经很强,但在一切涉及'视觉会变化'的任务上系统性失灵:判错相机旋转方向、预测违反物理约束的结果、给出与任务目标冲突的动作建议、打乱视频帧顺序。作者对 38 个前沿模型(GPT-5.4、Qwen3-VL-235B-A22B、Llama-4-Maverick、Intern-S1-Pro、Gemma-4-31B 等)做了受控诊断:最强的 GPT-5.4 也只有 65.8% 准确率,而人类基线是 92.3%;时间邻接任务上主流模型落在 25.3%–28.0%(四选一随机是 25%),几何扰动下最高掉到 33.3%。外部基准也早已分别记录了这些缺陷:MindCube 上模型在视角变换和'如果相机移动会看到什么'的问题上接近随机,IntPhys 2 上 SOTA 视觉模型在违反期望测试中徘徊在 50%,CausalVQA、WM-ABench 记录了反事实失败,TOMATO、TemporalBench 记录了时序失败。但问题在于:这些基准各测一个侧面,动作内容、场景分布、推理要求全部混在一起,既不能比较'哪一维的监督更有价值',也不知道这些失败是否同根同源,更无法指导'训练什么数据能同时改善多个任务'。
本文的目标是作者想验证一个更大的命题:空间、具身、物理、时间这四类看似不同的推理失败,是否共享同一个底层缺陷——'动作条件下视觉转换推理'(action-conditioned visual transition reasoning)能力不足;以及这个能力能否作为一个共享训练原语(shared training primitive)被集中训练、被不同模型从不同监督来源习得、再被不同下游任务复用。具体拆成四个问题:(1) 转换推理缺陷是否跨模型家族一致、有多严重;(2) 它能否通过转换监督学到,收益能否超出训练任务;(3) 收益究竟来自各数据子集各管各的任务,还是来自一个共同习得的共享能力;(4) 根本问题——决定迁移方向的到底是什么:动作相似、场景相似、领域相似,还是对 $(s,a,s')$ 施加的推理操作本身。最终要产出一个可前瞻验证的视觉世界模型训练配方,而不只是又一个基准。
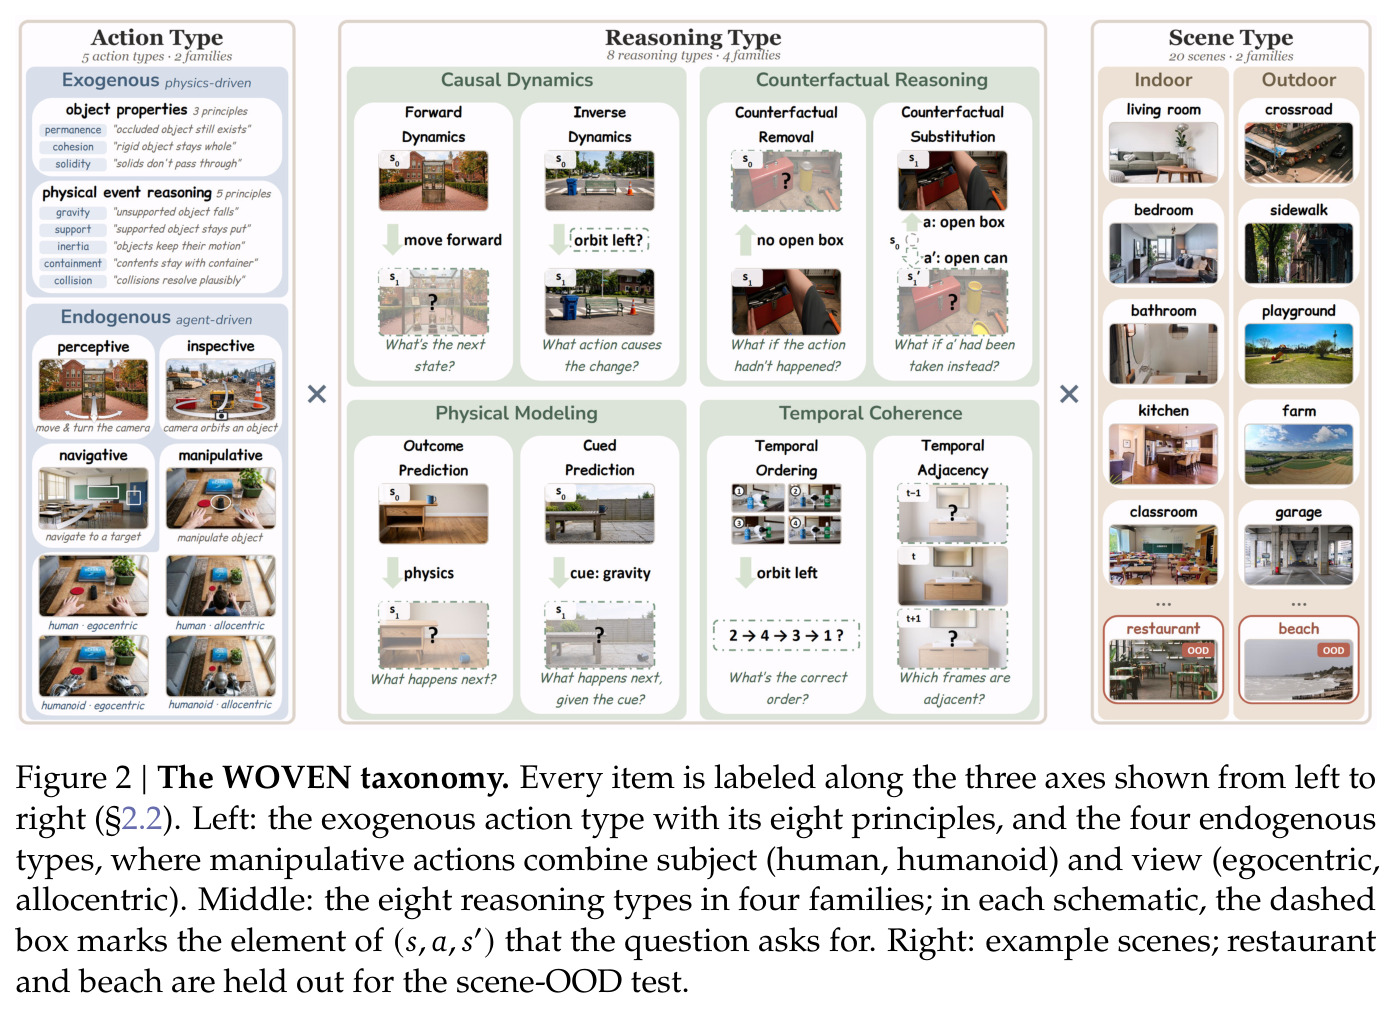
与已有工作不同的是,本文最独特的切入是'用生成式视频模型作为受控世界模型引擎'。真实视频给不出已知动作标注,更给不出'同一初始状态换个动作会怎样'的替代结局;机器人模拟器可控但缺乏真实感和场景多样性。视频生成模型的 rollout 先验恰好补上这个空缺:它能从指定首帧和动作生成结果与中间状态(作者称之为'世界模型隔离'原则,结果状态由 rollout 产生而非提示词规定),还能从同一初始状态在不同动作下独立生成多条 rollout('反事实 rollout'原则),从而一次性提供前向、逆向、反事实、时序四种监督。第二个独特之处是因子化实验设计:把所有任务统一到 $(s,a,s')$ 表示上,沿场景(20 类)、动作(5 类)、推理(8 种操作×4 家族)三个轴独立控制,训练 11 个各约 2,000 条的受控子集,第一次把'推理操作'和'动作/场景内容'作为分离的变量来研究迁移——这是以往任何单一任务基准或聚合式世界模型评测都做不到的。
核心方法
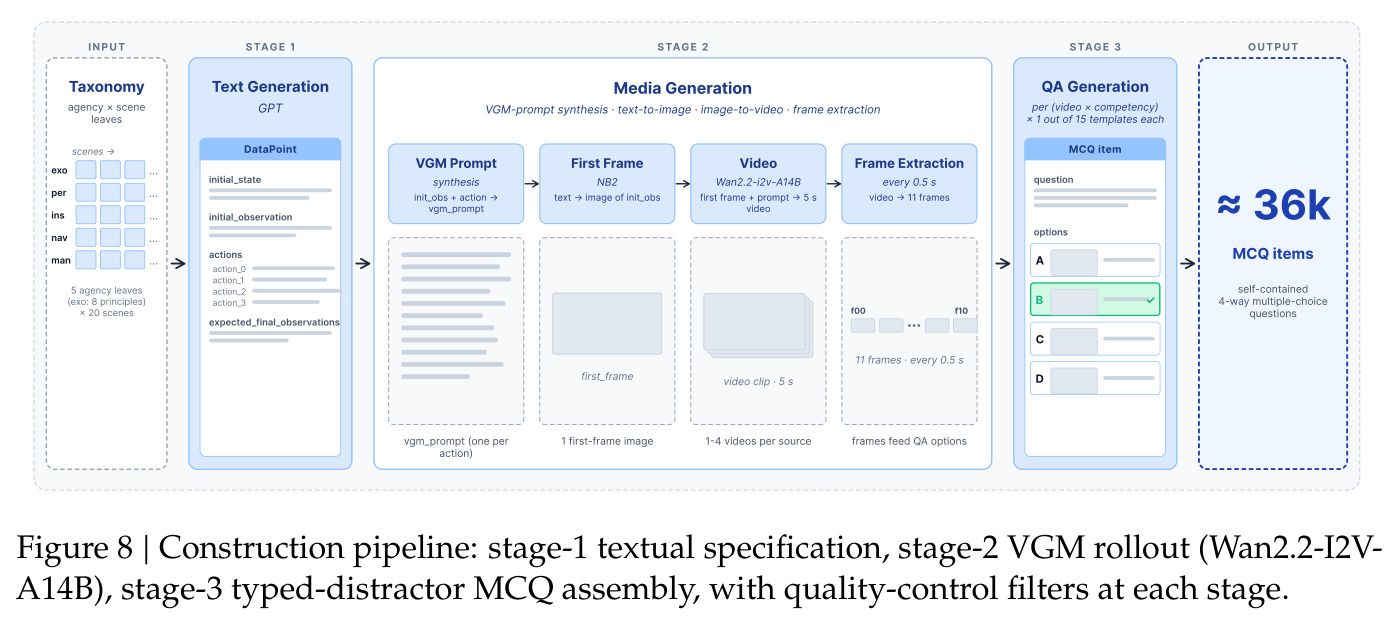
直觉上,如果四类任务失败共享'不会推演视觉状态如何随动作变化'这一个根源,那么集中训练这一种能力就应该处处受益——本文就是把这句话做成可控实验。技术上分四步走。第一步形式化:视觉转换推理定义为从 $(s,a,s')$ 中已知部分推断未知部分,8 种推理操作写成条件分布(如 $P(s'|s,a)$ 前向、$P(a|s,s')$ 逆向),按因果深度、推断方向、时间粒度三个结构性质组织成 4 家族×2 操作。第二步数据合成:三阶段流水线——先为每个(动作类型×场景)生成文本规范(初始观察、带确定性标识符的动作描述、预期后状态);再用图像模型合成首帧,Wan2.2-I2V-A14B 以 $(s_t, a)$ 为条件生成 5 秒 24fps 的动作后视频,均匀抽取 11 帧 $f_{00}$ 到 $f_{10}$($f_{00}=s_t$,$f_{10}=s_{t+1}$),中间帧留给时序推理;同源不同动作的 rollout 互为反事实素材。第三步组装监督:按推理操作把帧组装成四选一选择题,问题用 30 个模板随机措辞,三个干扰项取自共享同一初始状态的其他 rollout 且各带错误类型标签(如'方向反转''违反重力'),支持细粒度错误归因。第四步训练与评测:全量训练集做 SFT,11 个受控子集(每种动作类型×推理族约 2,000 条)做 SFT+GRPO,在 3 个内部测试集和 26 个外部基准上零样本评测迁移。
核心创新有三层。第一层是表示统一:把空间、具身、物理、时间等庞杂下游任务全部还原为对同一个 $(s,a,s')$ 三元组的不同推断方向,8 种操作就是 8 个条件分布——这把'不同任务'变成了'同一能力的不同查询',为共享原语假说提供了可操作的定义。第二层是数据来源:用视频生成模型的过渡先验制造受控反事实数据。真实视频没有受控动作和替代结局,模拟器缺真实感,而 Wan2.2 这类 VGM 恰好同时具备'指定初始状态+指定动作+多条独立世界线'的生成能力,并配两条构造原则:P1 世界模型隔离(结局必须由 rollout 产生,不许写进提示词,保证监督来自学到的动力学而非文本泄漏)和 P2 反事实 rollout(同一首帧多个动作独立采样)。第三层也是最区别于前人的:因子化训练比较。训练集天然切成 11 个'动作类型×推理族'的受控子集(perc_causal、mani_cf、exo_physical 等),每轴可以单独变化而固定其他两轴,于是'迁移由什么决定'第一次成为一个可以干预实验回答的科学问题,而不是相关性观察。论文还进一步用数据替换实验(固定 2,000 条预算,把任务自身数据的 30–50% 换成 WOVEN)做因果性验证,以及用 8 个种子的前瞻实验在推导配方时完全未见过的基准上验证配方。
方法步骤详情
完整流程如下。(1) 文本规范生成:对每个(动作类型,场景)组合生成包含初始环境状态与第一人称观察、一至多个带确定性标识符的动作描述、预期后动作状态的文本;动作词表按类型固定——外生事件从 8 条认知科学原理(重力、支撑、惯性、容纳、碰撞及 3 条物体属性)中抽取,感知类用 4 种固定相机平移/旋转,检视类用 3 种相机环绕,导航类 4 个场景内目标,操作类 4 种物体交互。(2) 媒体合成:图像模型从初始观察文本合成首帧;Wan2.2-I2V-A14B 以(首帧,动作)为条件生成 5 秒 24fps 视频;每条视频抽 11 帧;每个源在同初始状态下按不同动作生成 1–4 条视频。(3) 质量控制:规则与模型过滤器逐动作类型做物理合理性检查,扰动类数据另加编辑保真、场景一致、无伪影检查(只过滤媒体,不过滤问题)。(4) 监督组装:按 8 种推理操作把帧组装成四选一 MCQ,30 个问题模板随机选用;干扰项来自同初始状态的其他 rollout,带错误类型标签;物理建模题的干扰项由图像编辑器生成,正确选项也过同一编辑器(空编辑)以消除伪影泄漏,控制实验证实无泄漏。(5) 数据划分:共 36,076 条——训练集 22,728、验证集 2,508、同分布测试集 6,228(训练用过的 18 个场景的新转换)、场景 OOD 测试集 3,496(餐厅和海滩两个 held-out 场景)、状态扰动测试集 1,116(对同分布题的初始状态做几何或外观单因素扰动,动作和问题不变)。(6) 训练:LoRA r=16、α=4、dropout 0.05、q/k/v/o 投影,3 epochs、batch 32、AdamW lr 1e-4、cosine 调度、5% warmup、fp16;WOVEN-only 训练每题做 4 种选项排列;子集训练在 SFT 后接 GRPO。主模型 Qwen2.5-VL-3B-Instruct,规模实验到 7B/32B,跨家族实验用 Gemma-3-4B-it。(7) 评测:3 个内部测试集 + 26 个外部基准零样本(22 个涉及视觉转换:空间、具身、物理、时序等;4 个静态感知/通用视频 QA 作特异性对照),增益超过 2 个百分点才算'改善'。
技术新颖性
与已有工作的本质区别可以从四个方向看。对任务特定基准(SAT、IntPhys 2、CausalVQA、TOMATO、ActionEQA 等):它们各自固定一条轴、混掉另一条轴,WOVEN 用统一的 $(s,a,s')$ 网格把它们变成同一空间里的散点,使任何基准都能映射到明确的(动作类型,推理类型)细胞上,失败归因从'模型不行'变成'哪个细胞不行'。对世界模型预训练(Orca 等视频 SSL 中训练):Orca 在同一 Qwen3.5-4B 骨干上用 12.5 万小时视频做潜空间下一状态预测中训练,3DSRBench 上只涨 +4.0;WOVEN 用约 7 小时生成视频、约 10.7 万条 QA 做纯后训练就涨 +6.7——说明'转换推理'这种认知原语可以用极少量的受控监督注入,不需要海量无标注视频。对状态转移预训练(GUI agent 的 forward/inverse dynamics、干预式世界状态数据):那些方法把转换监督当作特定领域的训练手段,本文第一次把它当作跨领域共享原语来研究'谁迁移给谁、为什么'。对以往合成数据工作(合成空间推理数据、规则游戏迁移等):它们验证了'合成数据有用',但没有受控轴,无法回答'哪一部分有用、监督该怎么选'。此外,错误类型化干扰项、状态扰动对比集、同编辑器空编辑对照等设计,都是针对'合成数据会教出捷径'这一常见质疑的系统性防御,方法论上相当扎实。
实验结果
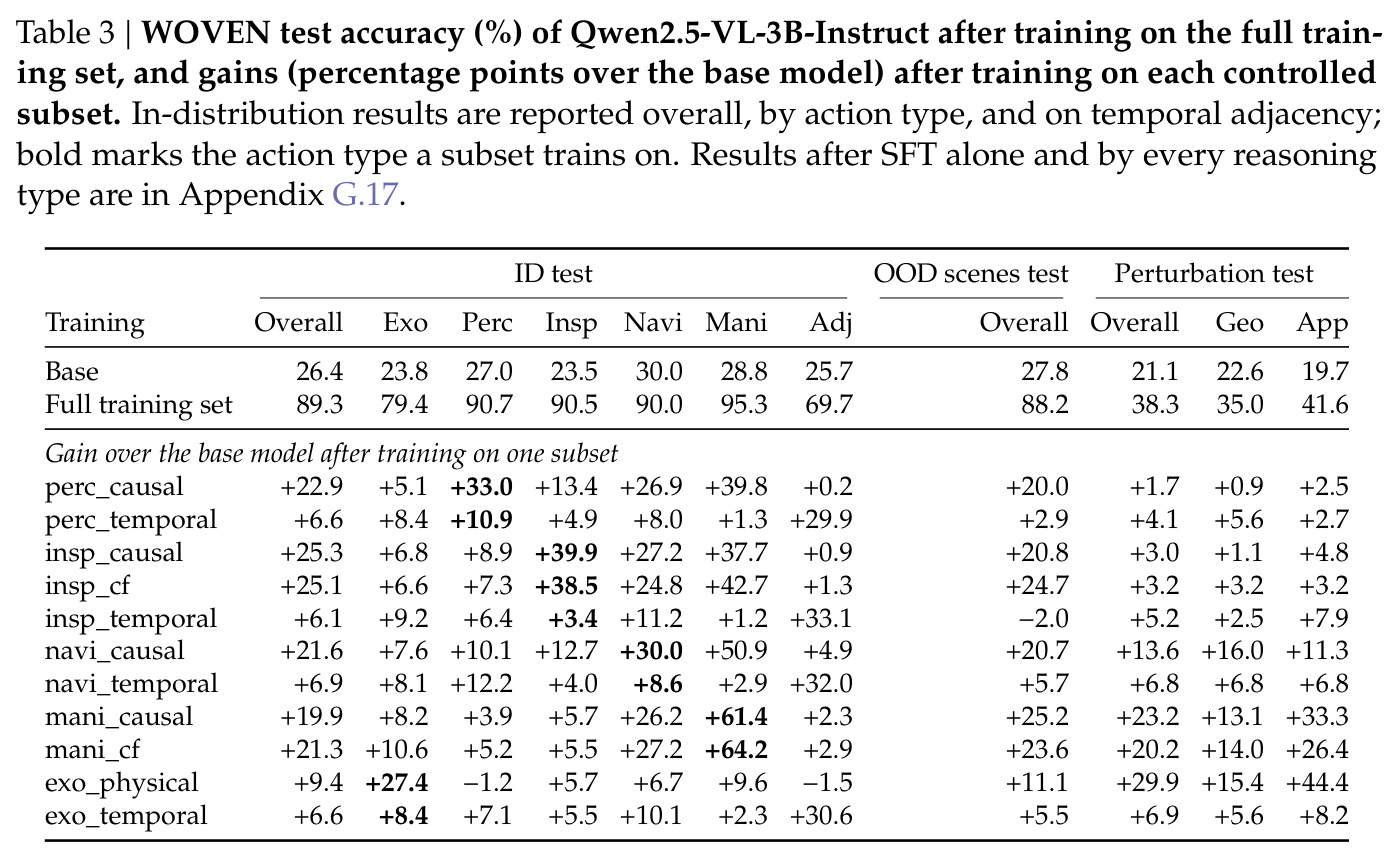
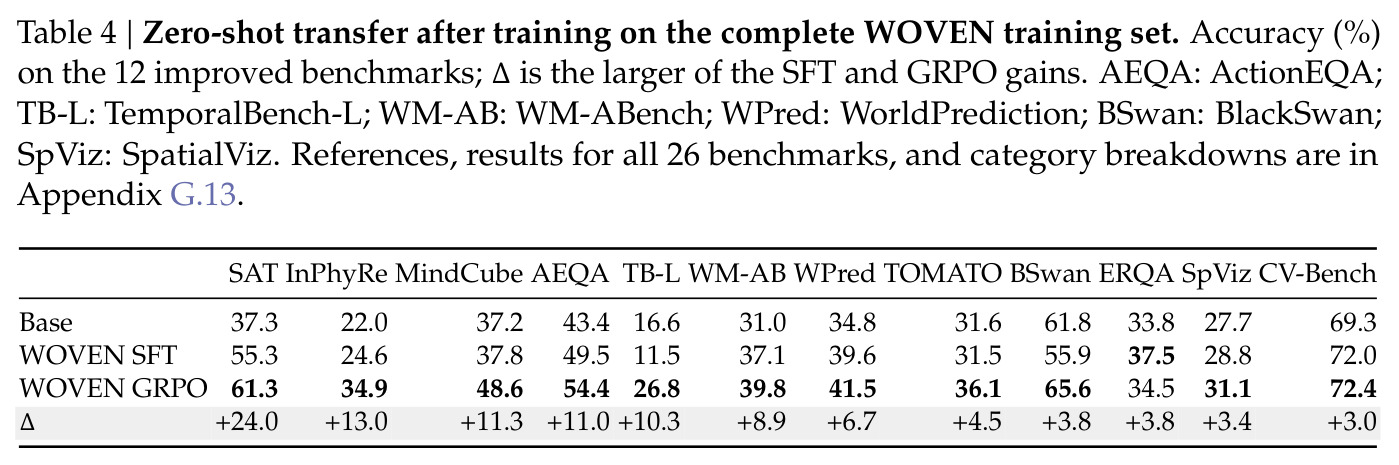
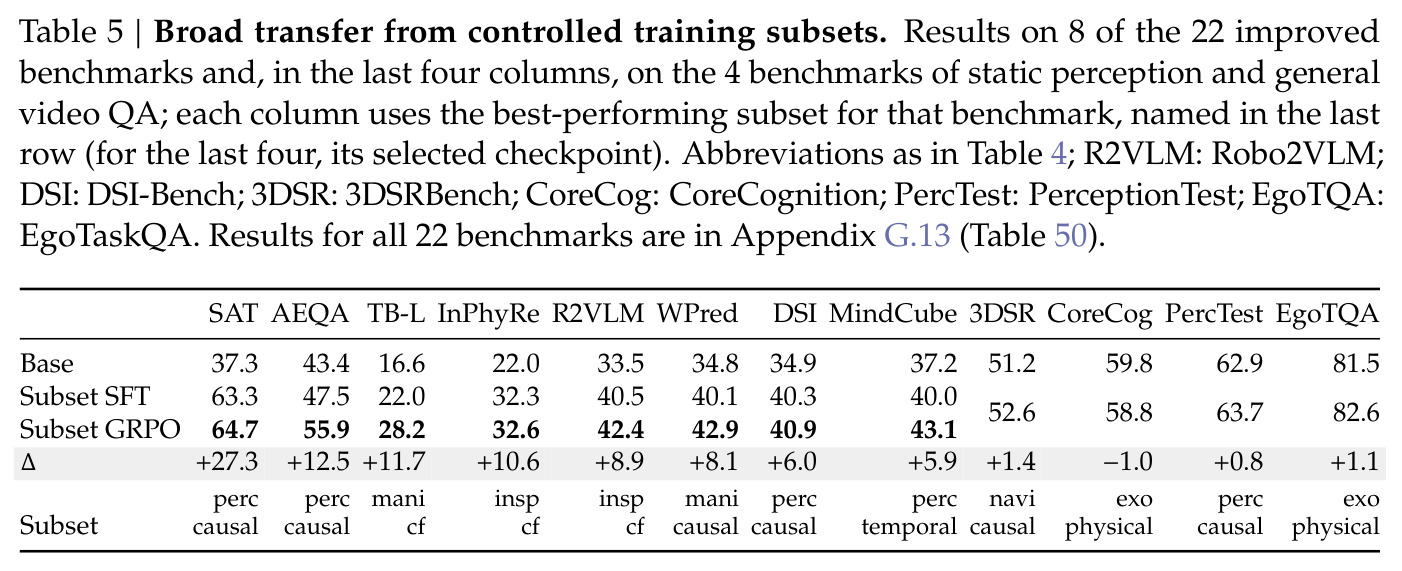
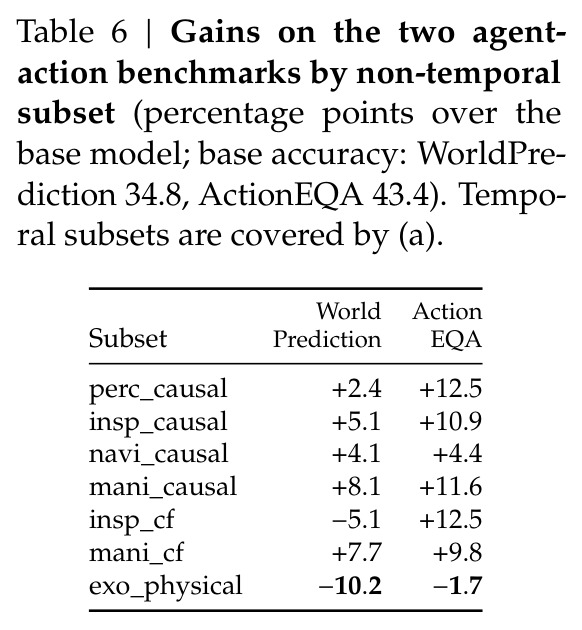
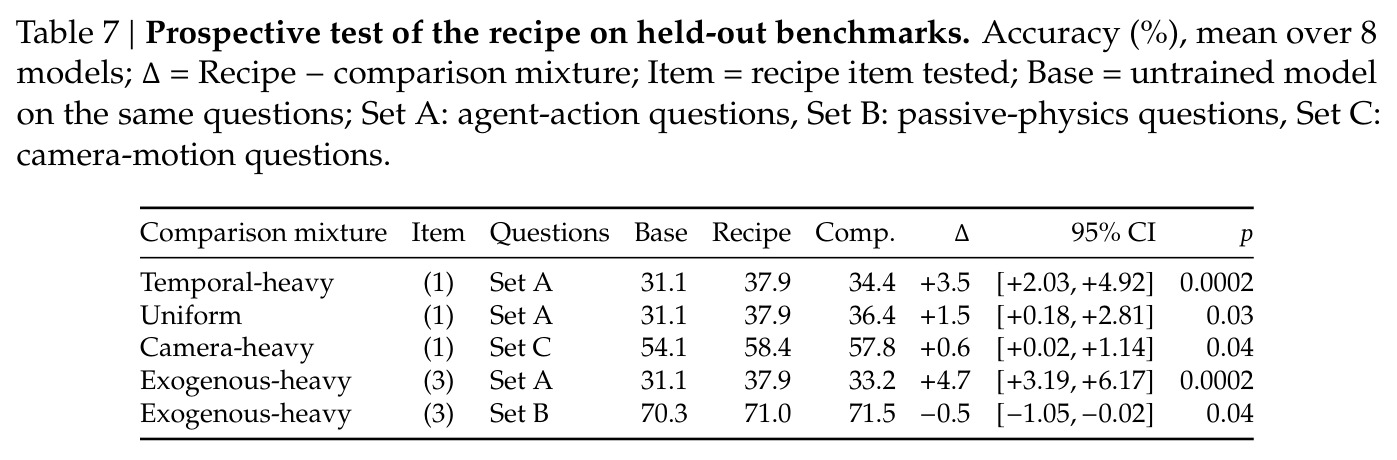
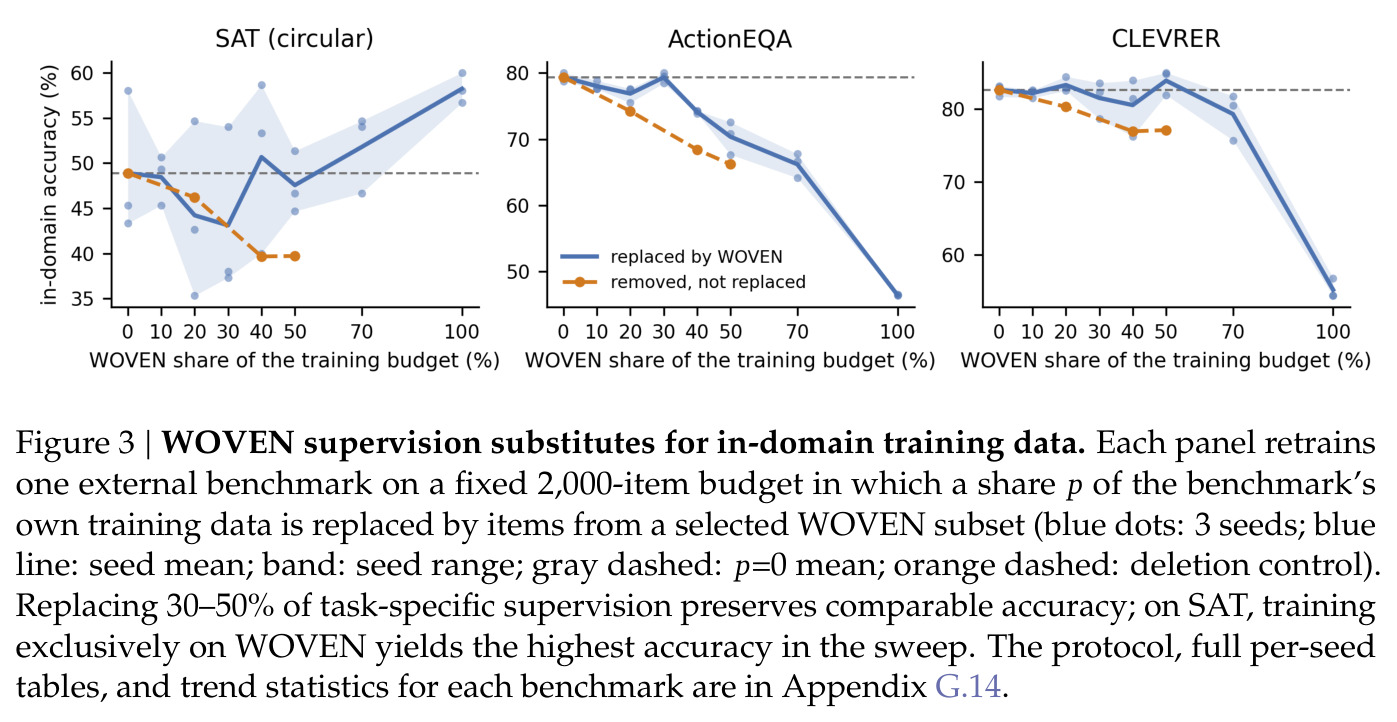
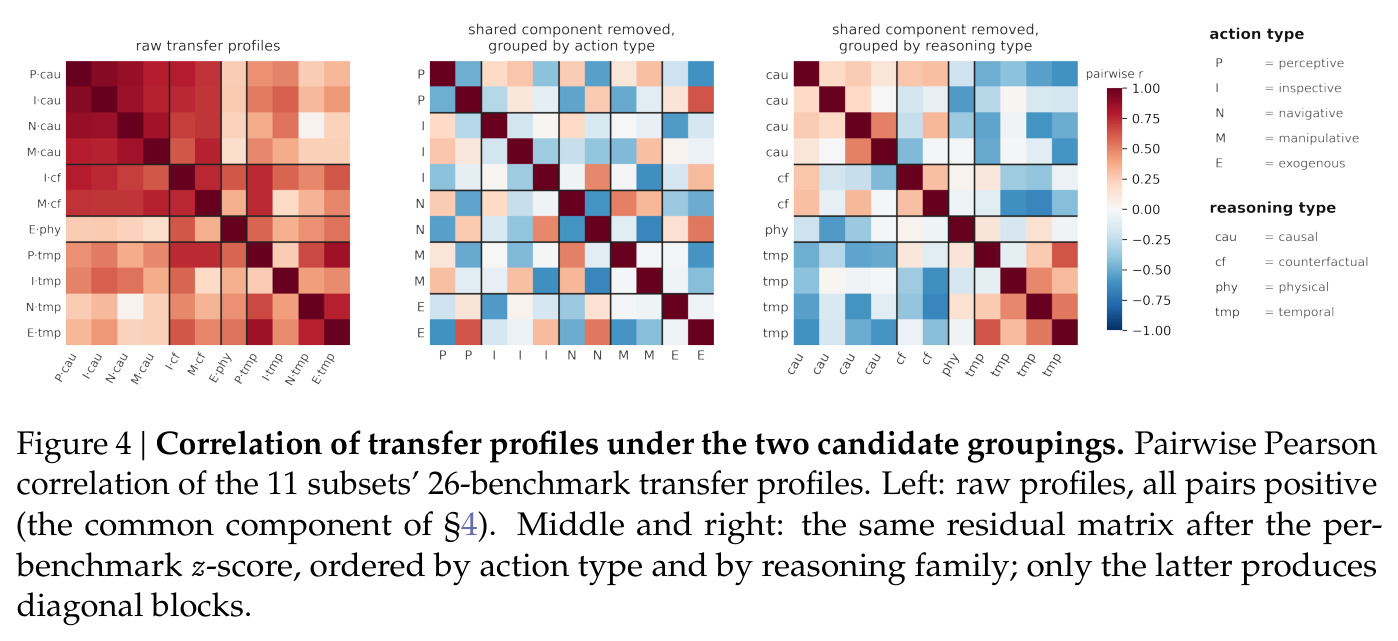
实验回答了四个递进的问题。(1) 缺陷是系统性的:38 个前沿模型中最好的 GPT-5.4 在同分布测试上只有 65.8%(人类 92.3%),随后三名在 57.8%–63.2%;且失败模式跨家族一致——所有模型都是时间邻接(25.3%–28.0%)难于时序排序(30.8%–63.4%),反事实移除(54.8%–66.7%)难于反事实替换(64.5%–76.0%),几何扰动(33.3%–62.7%)比外观扰动(79.2%–95.5%)伤害大得多;缩放关不掉这个缺口。附带发现:视频生成器引擎只在时序类上强(53.1/56.2),V-JEPA 2 编码器只在动作条件类上强(前向 70.7、逆向 75.4),两者互补且都远低于人类。(2) 能力可学:Qwen2.5-VL-3B 全量 SFT 后同分布从 26.4% 升到 89.3%,held-out 场景 88.2%,扰动测试 21.1%→38.3%(几何 22.6%→35.0%,外观 19.7%→41.6%);11 个受控子集各自也能提升 WOVEN 准确率 +6.1 到 +25.3 个百分点,且能迁移到自己没训练过的动作类型上(如 mani_cf 对 Navi +27.2)。(3) 迁移广泛且共享:全量训练改善 26 个外部基准中的 12 个,SAT 从 37.3 到 61.3(GRPO,+24.0);按基准择优选子集后覆盖升到 22/26——即所有涉及视觉转换的基准——最高 +27.3 个百分点;子集对 WOVEN 提升越多,外部平均增益越大($r=0.86$);固定 2,000 条预算下用 WOVEN 替换任务自身数据 30–50%,精度不降且高于'直接删掉'的对照,SAT 上甚至全用 WOVEN 最高;置换/镜像转换的同格式对照不产生收益,排除了格式捷径。(4) 迁移由推理操作决定,且可前瞻预测:同一推理族的子集残差迁移轮廓平均相关 +0.32,只共享动作类型的是 −0.22(与毫不相关的 −0.23 无异);鲁棒性随训练中状态变化幅度单调上升(相机运动 +1.7 → 检视 +3.0 → 导航 +13.6 → 操作 +23.2 → 被动物理事件 +29.9);时序族与被动-主动边界不可穿越(时序子集把时间邻接从 25.7% 提到 55.6–58.7%,其余七个子集几乎无效;exo_physical 反而让 WorldPrediction −10.2);前瞻实验在 8 个从未参与配方推导的基准上、8 个种子下,5 组比较全部按配方预测方向显著(+3.5、+1.5、+0.6、+4.7,被动物理题上外生混合占优 −0.5,$p \le 0.04$)。效应还跨规模(7B SAT +20.0,32B +22.67)和跨家族(Gemma-3-4B-it 上复现)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| WOVEN 同分布诊断(视觉转换推理) | 四选一准确率 (%) | 训练后 Qwen2.5-VL-3B 89.3 | 训练前 26.4(随机 25) | +62.9 pp;人类 92.3,GPT-5.4 仅 65.8 |
| SAT(空间心理推演,circular 评测) | 准确率 (%) | 64.7(perc_causal 子集 GRPO)/ 61.3(全量 GRPO) | Qwen2.5-VL-3B base 37.3 | +27.3 pp(子集)/ +24.0 pp(全量) |
| ActionEQA(具身问答) | 准确率 (%) | 55.9(perc_causal 子集) | base 43.4 | +12.5 pp |
| TemporalBench-L(长视频时序,双序二元) | 准确率 (%) | 28.2(mani_cf 子集) | base 16.6 | +11.7 pp |
| InPhyRe(直觉物理归纳) | 准确率 (%) | 32.6(insp_cf 子集) | base 22.0 | +10.6 pp |
| WorldPrediction(程序性世界模型) | 准确率 (%) | 42.9(mani_causal 子集) | base 34.8 | +8.1 pp(对照:exo_physical 子集为 −10.2) |
| Robo2VLM(机器人视频问答) | 准确率 (%) | 42.4(insp_cf 子集) | base 33.5 | +8.9 pp |
| DSI-Bench(动态场景推断) | 准确率 (%) | 40.9(perc_causal 子集) | base 34.9 | +6.0 pp |
| MindCube(空间心理模型) | 准确率 (%) | 43.1(perc_temporal 子集) | base 37.2 | +5.9 pp |
| 数据替换(SAT/ActionEQA/CLEVRER) | 固定 2,000 条训练预算下的域内准确率 | 用 WOVEN 替换 30–50% 任务自身数据后精度持平 | 100% 任务自身数据(p=0) | 等效节省 30–50% 任务数据;SAT 全用 WOVEN 反而最高 |
| 3DSRBench(与 Orca-4B 同骨干对比) | 准确率增益 (pp) | WOVEN 后训练 +6.7(约 7 小时生成视频) | Orca-4B 视频中训练 +4.0(125K 小时视频) | 视频用量少 4 个数量级,增益反超 |
| 前瞻配方验证(MMSI/VLM4D/PhysBench/SPAR/MVBench/IntPhys2/CameraBench 抽题) | 准确率差 Δ = Recipe − 对照混合 (pp) | 5 组比较全部显著:+3.5 vs Temporal-heavy、+1.5 vs Uniform、+0.6 vs Camera-heavy、+4.7 vs Exogenous-heavy;被动物理题 −0.5(配方正确预测该组会让位) | 按动作/领域匹配的无配方混合(8 种子均值) | p ≤ 0.04,全部方向符合配方预测 |
局限与改进
作者在附录 K 中承认的边界:WOVEN 刻意限定在'单步、视觉接地、动作条件'的 $(s_t, a, s_{t+1})$ 世界建模上,不直接覆盖长程程序性规划、符号环境动力学推断、纯潜空间预测表征这三条世界模型研究线——它们的状态空间和评价尺不同。我的补充观察有五点。第一,评测全部是四选一选择题,与真实部署中的开放生成、连续预测(如机器人控制需要的精确状态估计)有相当距离,'MCQ 上的迁移'未必等于'能力迁移',尽管作者做了选项排列和字母平衡控制。第二,全部数据来自 Wan2.2-I2V 的生成视频:生成模型自身的物理偏差会进入监督(作者自己的对照显示视频生成器在前向预测上只有 19.8%,甚至低于随机),即'用一个不完美世界模型教另一个',数据里可能埋着系统性错误物理。第三,场景 OOD 只用了 2 个 held-out 场景(餐厅、海滩),对真实世界分布偏移的覆盖偏窄。第四,训练后 3B 模型在同分布达 89.3%,但扰动测试仍只有 38.3%,距人类 97.3 还有巨大差距,说明学到的是任务分布内的转换规则而非真正鲁棒的世界模型。第五,迁移评测是零-shot 问答,没有验证到具身决策环路(规划、策略学习)中,'原语'对下游 agent 的实际价值仍需端到端确认。
独立分析的弱点
第一,选择题监督的语义瓶颈:四选一 MCQ 只要求'选出正确帧/顺序',不要求模型显式生成未来状态,模型可能学到的是判别式捷径而非生成式世界模型;扰动测试 38.3% 的上限也印证了这一点。改进方向:加入'从当前帧+动作生成/编辑出未来帧'或文字化状态描述的生成式监督,与 MCQ 混合训练。第二,教师本身有物理偏差:Wan2.2 在前向预测类上只有 19.8%,其 rollout 中违反重力和穿透的帧虽经质检过滤,但能过滤的只是显性错误,隐性偏差(摩擦、弹性、流体)无从校验。改进方向:用物理引擎(Isaac/Genesis)渲染的对照子集做交叉验证,或用违反期望检测器给每条 rollout 打物理置信分并加权训练。第三,家族边界不迁移暴露表示碎片化:时序族与因果/反事实族互不迁移、被动物理不迁移到 agent 任务,说明模型学到的可能是'按题型分策略'而非统一动力学表征。改进方向:引入统一的状态轨迹表示(如共享的潜空间 rollout 头)做多任务训练,测试能否抹平边界。第四,单步限制:真实具身任务需要多步组合动作与长视野信用分配,WOVEN 的单步转换无法直接覆盖。改进方向:把 (s,a,s') 链成序列并配以强化学习 rollout,用 WOVEN 初始化后再做长视野微调。第五,OOD 测试薄弱:仅 2 个 held-out 场景且同属照片级室内/室外,未测风格迁移、对抗纹理、跨文化场景。改进方向:扩充 held-out 集并引入真实视频(Ego4D 等)做分布外探测。
未来方向
作者明确提出的是把'细胞级统计归因'方法扩展到三条未覆盖的世界模型研究线:长程程序性规划(如 WorldPrediction 类任务)、符号环境动力学推断、以及以潜空间预测表征(V-JEPA 类)为核心的、通过下游控制评价的世界模型——即把这套受控三轴+受控子集+前瞻验证的实验范式迁移到新的状态空间上。基于本文成果还可以自然延伸出几个方向:(1) 把 WOVEN 作为强化学习的环境或奖励来源——前向动力学恰好定义了'动作→预期观测'的判分器,可用于训练具身 agent 的想象与规划能力;(2) 数据引擎自动化:既然 7 小时生成视频就能超过 12.5 万小时视频 SSL 的迁移效果,可以构建'按配方自动定向合成监督'的闭环——诊断下游任务缺哪种推理操作,就定向生成哪种子集,实现按需数据制造;(3) 规模定律研究:目前只测到 32B,转换推理收益随模型规模的曲线(是衰减还是保持)决定了该原语在 frontier 模型时代的价值;(4) 与真机结合:把 mani/navi 子集的收益验证到真实机器人策略微调上,检验'共享原语'能否兑现为控制性能;(5) 时序与反事实边界的理论解释——为什么这两类监督不可互相替代,可能涉及 Transformer 中的表征组织方式,值得可解释性研究跟进。
复现评估
复现条件总体友好。数据侧:论文首页标注了 Website、Code、Dataset 三个开源入口,36,076 条数据带完整元数据(taxonomy 路径、逐帧路径、干扰项错误类型标签),协议细节极其完备——三阶段流水线、质量控制过滤器、30 个问题模板、划分方式(22,728/2,508/6,228/3,496/1,116)全部写在附录 B;但要重建数据需要运行 Wan2.2-I2V-A14B(14B 视频扩散模型)和图像生成模型合成约 7 小时视频,视频生成算力是最大成本项,若直接用发布的数据集则可完全跳过。训练侧:基座是开源的 Qwen2.5-VL-3B/7B/32B-Instruct 和 Gemma-3-4B-it,LoRA r=16、lr 1e-4、3 epochs、batch 32、fp16,3B 模型单张到几张 A100/H100 即可完成,GRPO 阶段需要额外的采样开销但均为标准开源实现;每题 4 种选项排列增强等细节都已公开。评测侧:26 个外部基准全部公开,附录给出每个基准的评测单元数与打分方式(如 SAT 用 circular 评测、TemporalBench-L 用双序二元),并报告了 3–8 个种子的方差与显著性检验(95% CI、p 值),统计方法有专章(附录 D)。综合评估:用官方发布数据 + 开源基座复现核心训练与迁移结论属于中等难度,主要工程量在外部基准评测管线;从零重建数据合成管线则难度较高,需要视频生成集群。
论文图表
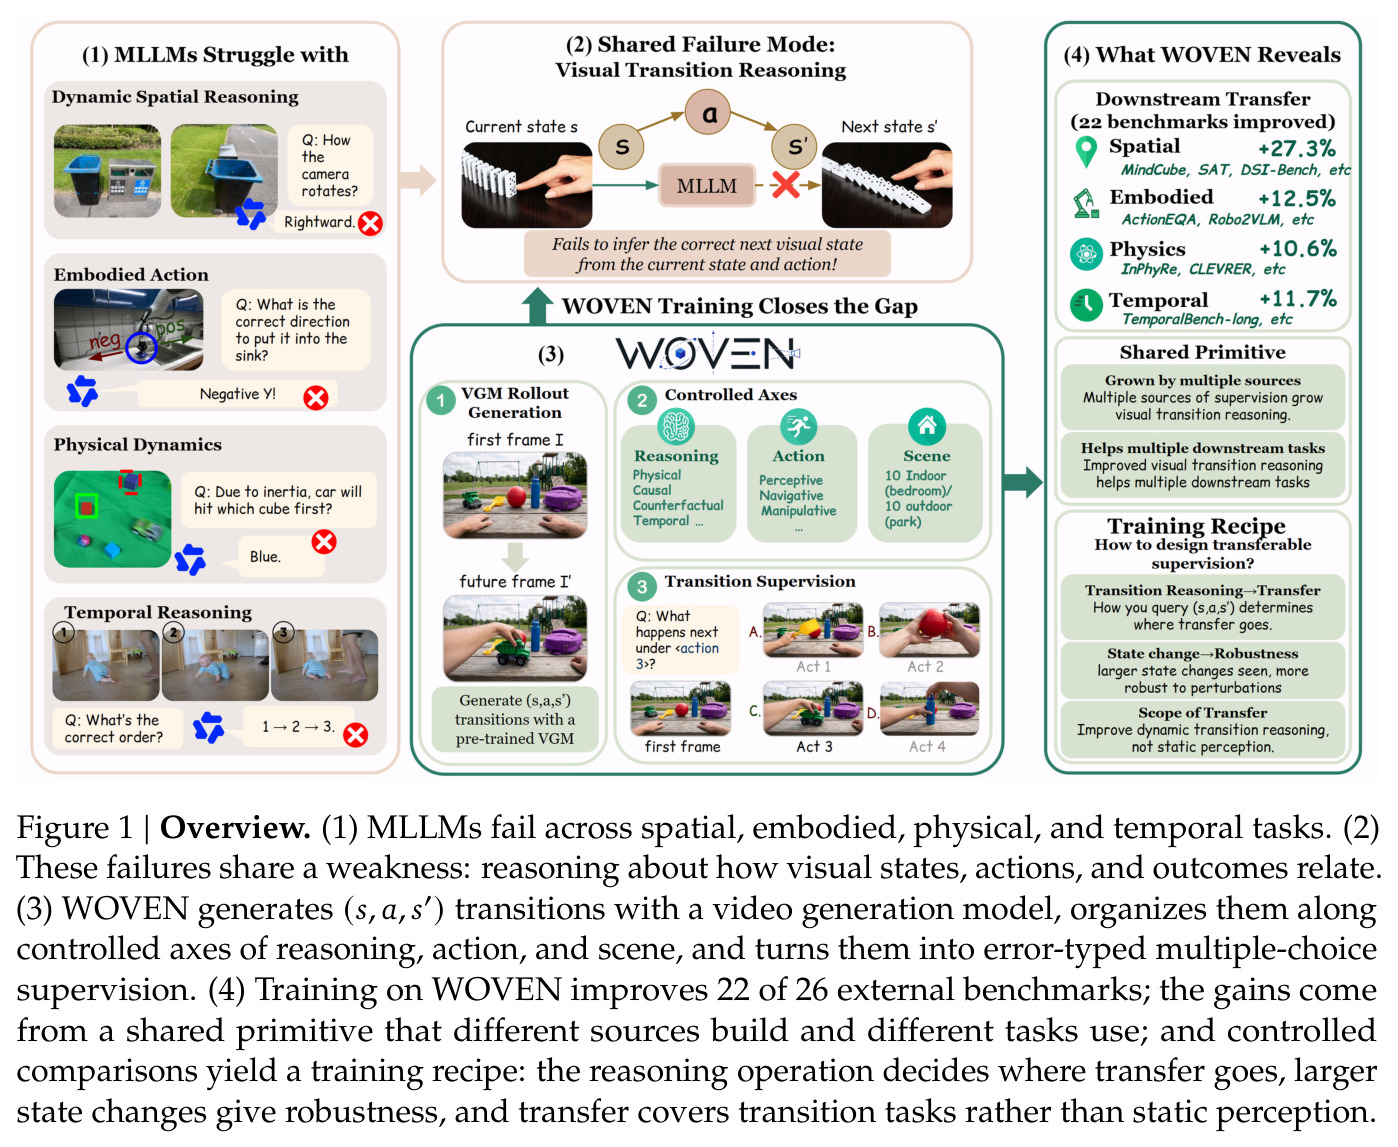
全文总览图,四联结构:(1) 展示 MLLM 在空间/具身/物理/时间任务上的代表性失败;(2) 指出这些失败共享同一弱点——不会推理视觉状态、动作与结果之间的关系,即 $(s,a,s')$ 结构;(3) 展示 WOVEN 如何用视频生成模型生成转换、沿推理/动作/场景三个受控轴组织、并转化为带错误类型的四选一监督;(4) 总结训练结果(26 个外部基准中 22 个提升)与四条训练配方。
这是理解整篇论文逻辑的地图:问题→统一假设→数据方案→训练结论→配方,一图串起全部核心主张,先读懂它再看细节事半功倍。