动态门控通路:跨全部ViT与LLM层的多模态大模型视觉连接机制 Where to Connect? Boosting MLLMs via Dynamic Gated Pathways across ALL ViT and LLM Layers
让每个LLM层按自身语义状态动态门控选择全部ViT层视觉信息,实现自适应全层连接
前置知识
MLLM(多模态大语言模型)
由预训练视觉编码器(如 CLIP-ViT)、投影适配器(projector)和 LLM 三部分组成:编码器把图像切成 patch token,adapter 将其投影到语言空间,LLM 对图文拼接序列做自回归生成。代表架构包括 LLaVA、Qwen-VL、InternVL 等 projector 型设计,以及 Flamingo 等交叉注意力型设计。
本文全部改动发生在「视觉 token 如何接入 LLM 内部各层」这一接口上,必须先理解标准 MLLM 只在输入处一次性注入视觉特征的默认范式,才能理解论文要改进什么。
ViT 层级化表示与视觉粒度
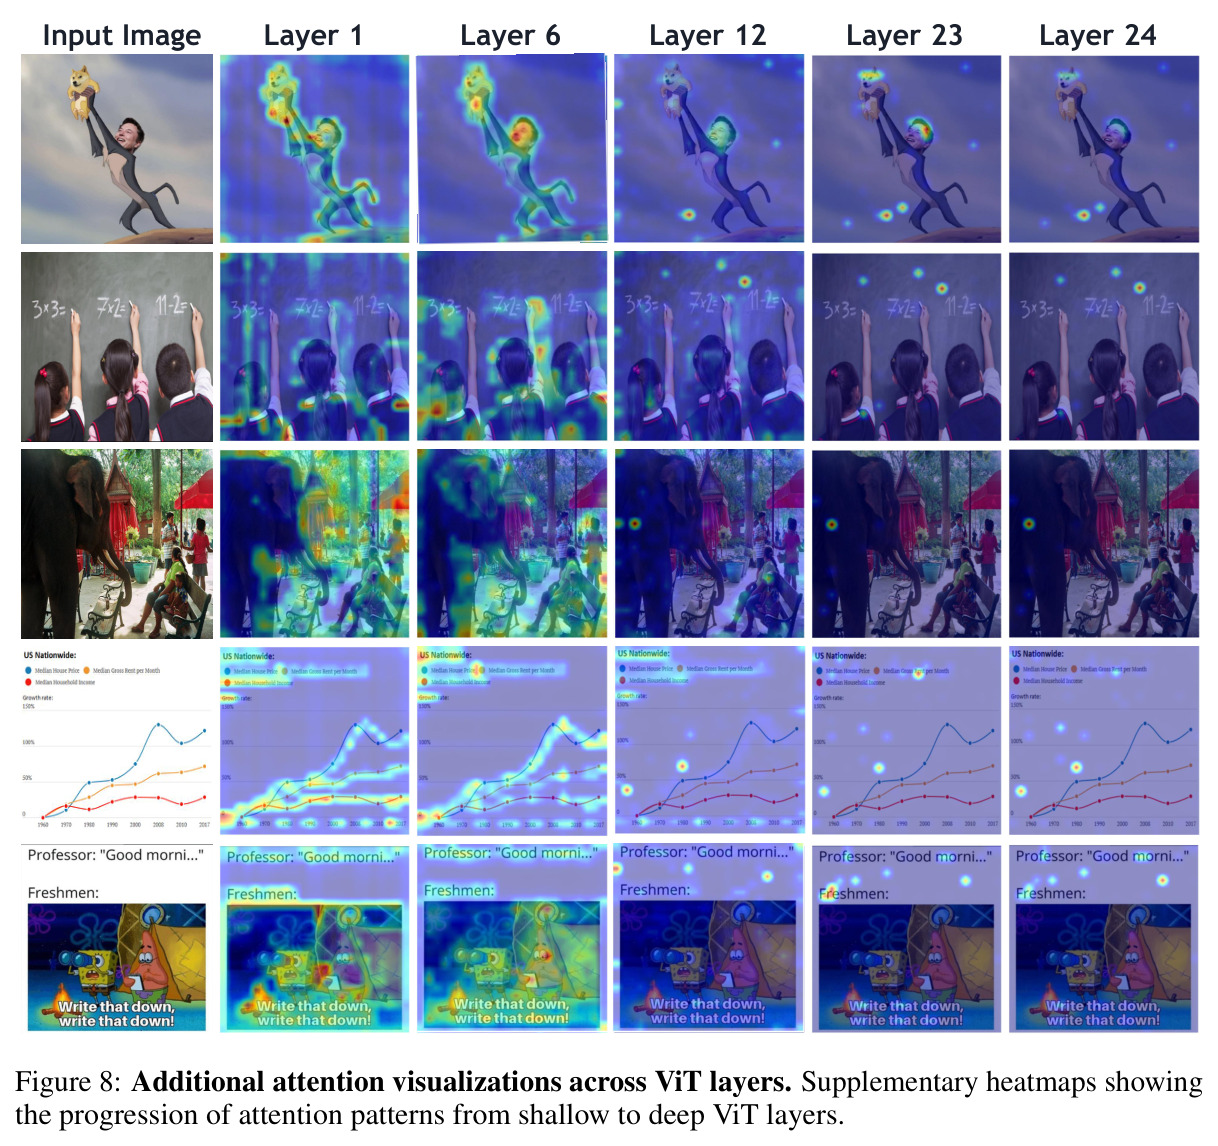
ViT 各层编码不同抽象级别:浅层保留边缘、纹理和局部空间细节,中层编码物体结构,深层聚焦少数高层语义锚点。论文 Figure 1 用注意力图直观展示了这一现象:第 1 层注意力分散覆盖边缘纹理,第 24 层收缩到语义要害区域。
论文的核心主张是「不同 LLM 层需要不同视觉粒度」,理解粒度差异是理解 where to connect 问题的前提,也是读懂路由可视化分析的钥匙。
交叉注意力
一种注意力机制:Query 来自一个序列,Key/Value 来自另一个序列,用于建模两个模态或两组表示间的对齐关系;多头版本(MHA)在多个子空间并行计算后拼接。Flamingo 等模型用它融合视觉与语言信息。
DGP 的权重生成器用「跨层共享的多头交叉注意力」计算语言层状态与全部 ViT 层摘要的交互,是路由机制的核心算子,不懂交叉注意力就读不懂 Eq.(4) 中的 $\mathrm{MHA}_{shared}$。
门控残差连接
在残差分支上乘一个可学习的标量门 $\gamma_l = \sigma(a_l)$(sigmoid 输出介于 0 与 1 之间),控制新信息注入主干隐状态的强度。门初始化为较小值(本文 0.3)可保证训练初期不破坏预训练模型的行为。
DGP 用逐层门控决定每个 LLM 层接收多少路由融合后的视觉信息(Eq.(7) 的 $\tilde{H}_v^{(l)} = H_v^{(l)} + \gamma_l \tilde{Z}^{(l)}$),是端到端联合训练 32 层注入模块仍能稳定收敛的关键设计。
熵正则化
在损失中加入鼓励分布更均匀的负熵项,熵定义为 $\mathcal{H}(p) = -\sum_k p_k \log p_k$。本文对每个 LLM 层的批平均路由分布 $\bar{\omega}^{(l)}$ 做熵最大化,防止路由塌缩到少数几个 ViT 层;预训练阶段 $\lambda = 0.01$,指令微调阶段关闭。
没有它路由可能早期退化为只用单一 ViT 层;Table 4 的消融显示加熵正则能再带来额外增益(如 LLaVAW 63.6→66.5),理解它才能看懂完整训练目标。
LLaVA-1.5 训练配方
两阶段训练:预训练(PT)在 LLaVA-558K 数据上对齐视觉-语言接口,指令微调(SFT)在 LLaVA-mixed-665K 上训练;使用 AdamW + cosine 调度(warmup 0.03),PT 学习率 1e-3、batch 256,SFT 学习率 2e-5、batch 128。是多层视觉特征利用方法的标准对比平台。
DGP 及其主要基线(DenseConnector、Sparse Shortcuts、IGVA、TGIF)都严格遵循该配方训练,保证同骨架(Vicuna)同数据下的公平比较。
Glimpse token
一个可学习的特殊 token,插入在每个多模态训练样本的首个答案 token 之前。由于因果自回归注意力结构,它能 attend 到之前全部视觉与文本上下文,其隐状态因此成为「当前解码深度所见内容」的紧凑查询信号。
DGP 用 glimpse token 在各 LLM 层的隐状态 $h_g^{(l)}$ 作为路由查询 $Q^{(l)}$,是实现「语言层状态驱动视觉路由」的载体,没有它路由就失去了条件化信号。
研究动机
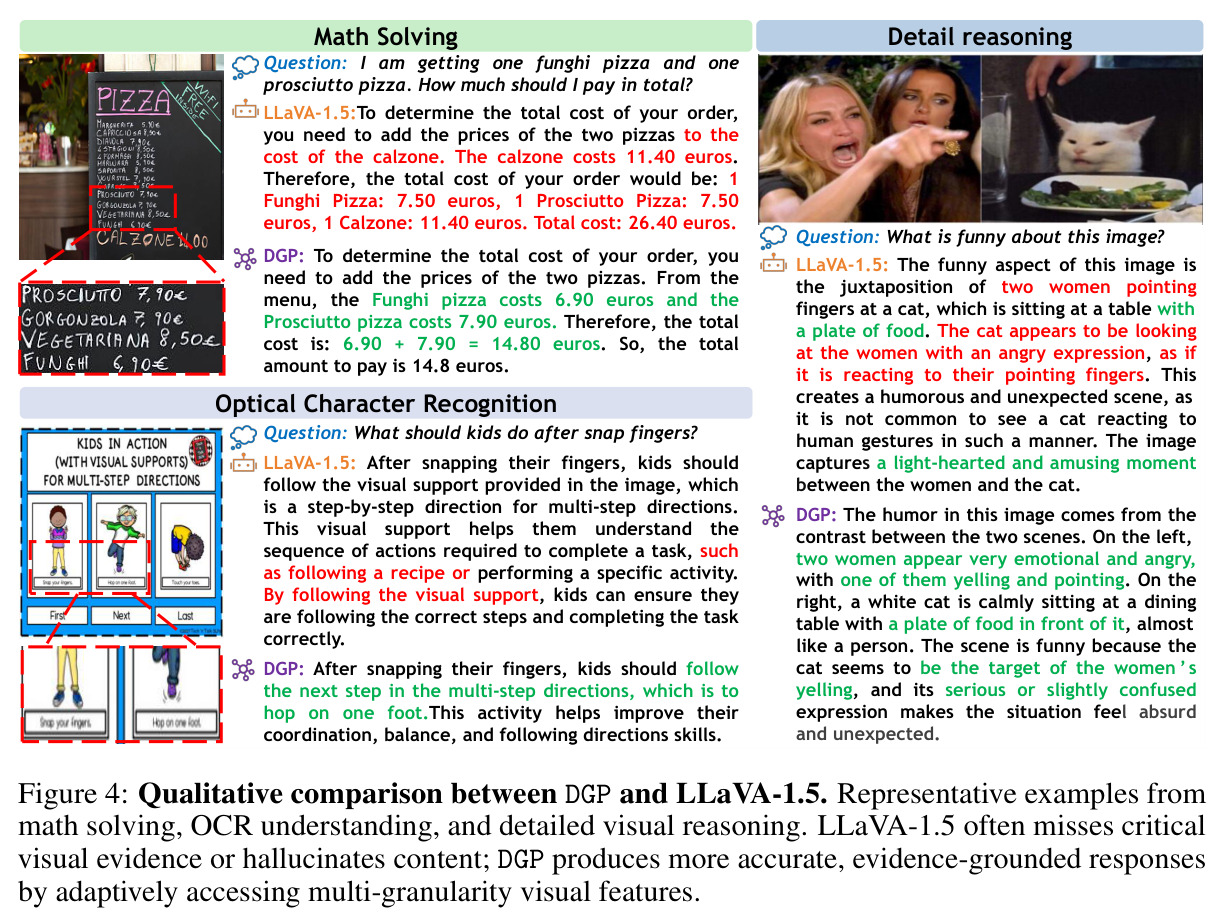
主流 MLLM(LLaVA-1.5、Qwen-VL、InternVL 等)通常只取 ViT 最后一层或倒数第二层的特征,经 adapter 一次性注入 LLM,把所有 LLM 层当作同一个消费者。但 ViT 各层的注意力模式差异显著:浅层注意力分散在边缘、纹理等局部细节上,深层则聚焦少数语义锚点。固定单层注入把整幅图像坍缩成单一粒度的语义表示,浅层与中层线索被直接丢弃,LLM 的各层语义也无法与完整视觉层级交互。这个代价在细粒度任务上尤为明显:论文 Figure 4 中,LLaVA-1.5 在菜单算账题里把 6.90 欧元的 Funghi 披萨读成 7.50,还幻觉出菜单上根本不存在的 calzone(11.40 欧元),把总价错误地算成 26.40 欧元;OCR 理解题里也无法读出图中「hop on one foot」的具体动作指示,只能泛泛而谈。
本文的目标是论文要回答的核心问题是 where to connect:来自层级化视觉编码器的信息应如何接入 LLM 的逐层语义。具体目标是设计一个路由机制,让每个 LLM 层都能根据自身当前的语义状态,动态地从全部 ViT 层中按需挑选并融合所需粒度的视觉证据,再通过门控残差安全注入;同时该机制必须轻量(仅增加约 5% 参数)、可端到端训练且路由分布稳定不塌缩。验证标准是:在标准 LLaVA-1.5-7B/13B 配方上同时超越基线和现有多层融合方法(DenseConnector、Sparse Shortcuts、IGVA、TGIF 等),并能迁移到 Qwen3-VL-2B(SigLIP2 + Qwen3)与 LLaVA-NeXT(AnyRes 分辨率策略)等差异很大的架构上。
与已有工作不同的是,已有两类方案都未真正回答这个问题。其一是 encoder 侧融合:DenseConnector 沿 token 或通道维拼接多层特征,MMFuser 用深层特征做查询拉取浅层细粒度信息,IGVA/TGIF 按指令调整 ViT 层权重——但全部融合发生在进入 LLM 之前,动态性被消耗在编码器内部,LLM 各层在解码过程中仍收到同一份同质化输入,无法「回头」访问视觉层级。其二是预定义稀疏/层级连接:DeepStack 按固定调度把视觉 token 分布到不同解码深度,Sparse Shortcuts 用手工连接模式接线,EVLM 把多层特征送入指定的门控交叉注意力层;CLI 虽引入按当前 LLM 状态的自适应门控,但只在采样的 ViT 层与指定的 LLM 注入点之间操作。没有方法同时做到(i)全对全跨层连通、(ii)由当前 LLM 层状态驱动的路由权重、(iii)路由分布稳定的端到端训练——这正是 DGP 补上的设计点。其灵感还来自视觉神经科学的预测编码理论:感知不是单向前馈,而是跨层持续调制的层级反馈回路。
核心方法
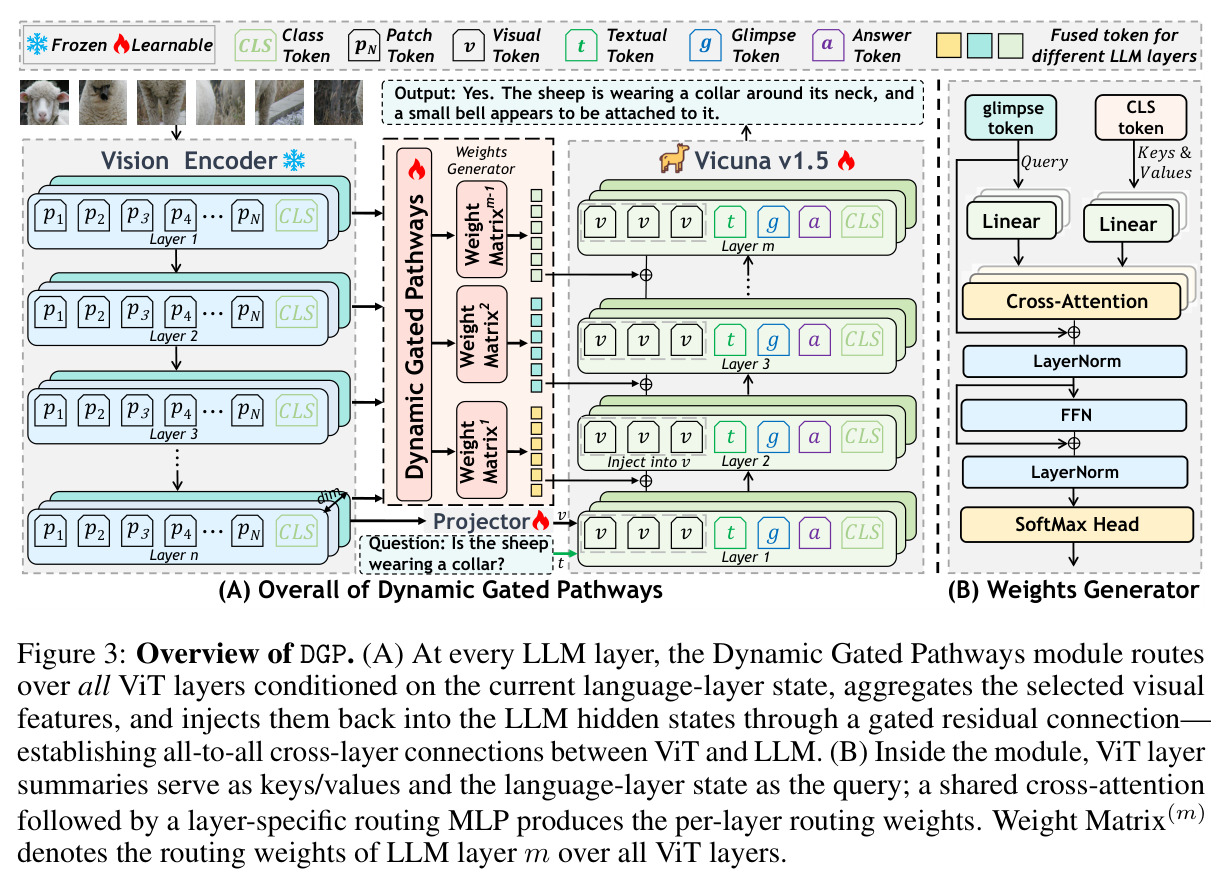
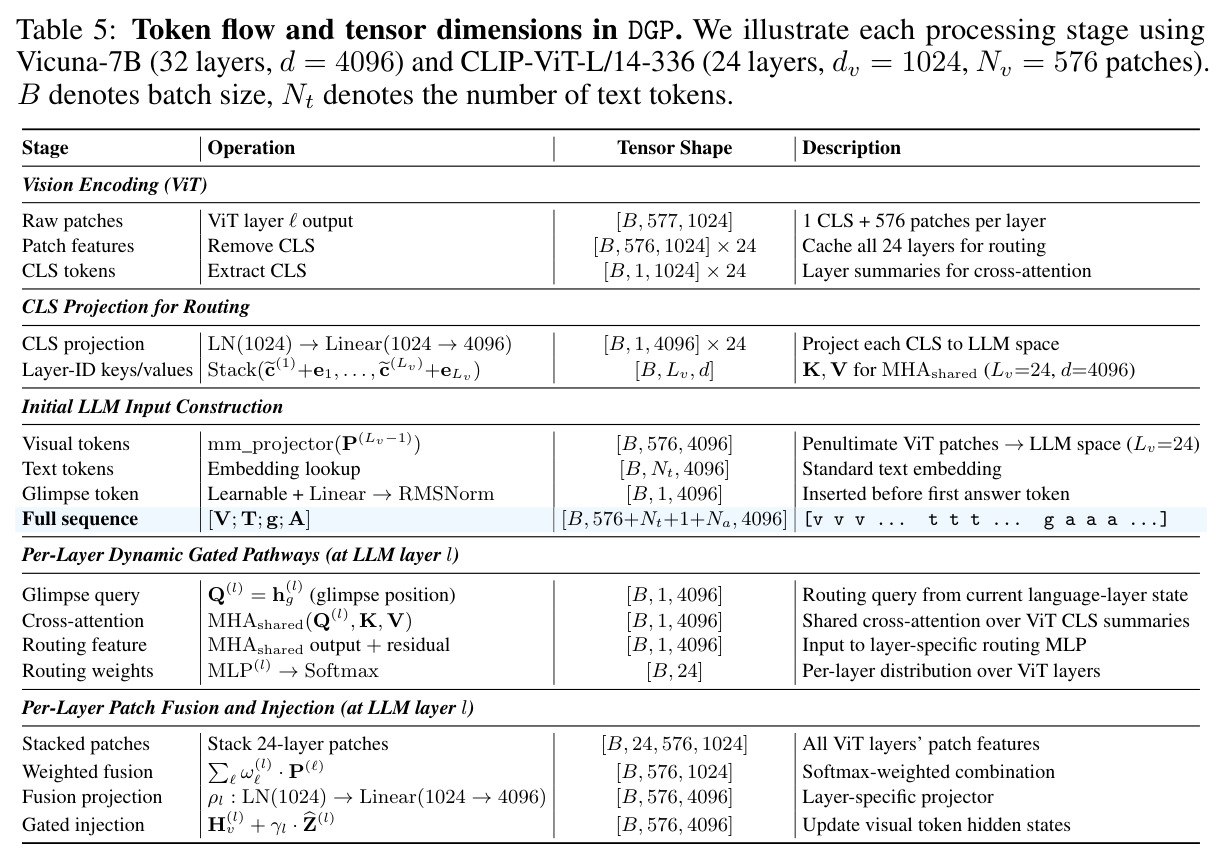
直觉上,视觉证据不应通过固定通路一次性送达 LLM,而应在解码全程持续参与表示更新——需要细节时取浅层特征,需要语义时取深层特征。技术上,DGP 为每一对 (ViT 层, LLM 层) 建立可学习的动态门控连接:冻结的 CLIP-ViT-L/14-336 输出全部 24 层特征,每层取 [CLS] 向量作为该层粒度的紧凑摘要;LLM 每层以 glimpse token 的隐状态为查询 $Q^{(l)}$,经一个跨所有 LLM 层共享的多头交叉注意力和一个层专属的路由 MLP,生成对 24 个 ViT 层的路由分布 $\omega^{(l)}$;再逐位置加权融合各层 patch 特征,经层专属投影后通过可学习门控残差写回该层的视觉隐状态段 $\tilde{H}_v^{(l)} = H_v^{(l)} + \gamma_l \tilde{Z}^{(l)}$。训练完全沿用 LLaVA-1.5 两阶段配方(LLaVA-558K 预训练 + 665K 指令微调,各 1 epoch),两阶段都联合优化 LLM 与 DGP 模块,视觉编码器全程冻结。
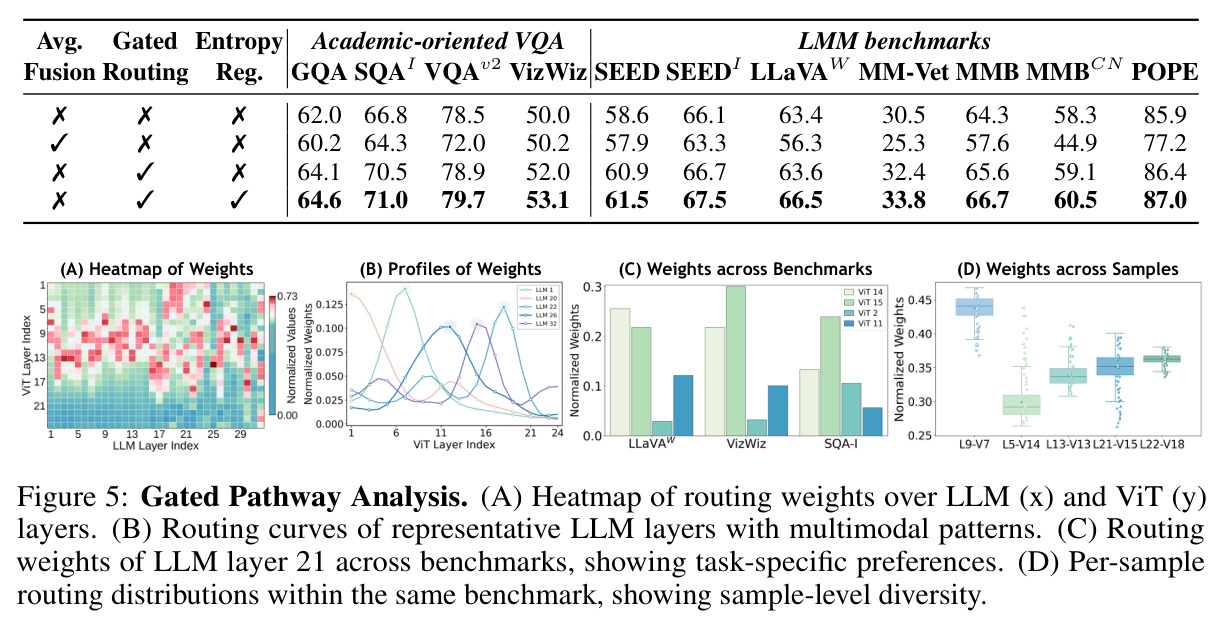
核心创新是把融合决策点从编码器端搬进每个 LLM 层内部,并用语言层状态驱动全对全路由。与 encoder 侧融合的本质区别:不同 LLM 层得到的是各不相同的融合视觉表示 $\tilde{Z}^{(l)}$,而非共享一份输入,融合随解码深度演化;与预定义稀疏连接的本质区别:连接强度不是手工设定或固定映射,而是逐层、逐样本动态生成。设计上有两个关键解耦:共享的 MHA 让所有 LLM 层面对同一套 ViT 层摘要(保证跨层比较公平),层专属 routing MLP 则让每层表达自己的偏好;可学习门 $\gamma_l = \sigma(a_l)$(初始化 0.3)控制注入强度,训练初期不破坏预训练行为。为防止路由塌缩,PT 阶段对批平均路由分布加熵最大化正则($\lambda = 0.01$),SFT 阶段关闭以允许任务特化。消融证明增益来自动态选择本身而非「用了更多层」:把 24 层均匀平均反而大幅掉点(GQA 62.0→60.2,MM-Vet 30.5→25.3,POPE 85.9→77.2)。
方法步骤详情
第一步(视觉编码):图像 $I$ 经 ViT 得到 $\{X_v^{(\ell)}\}_{\ell=1}^{24}$,每层含 [CLS] 向量 $c^{(\ell)}$ 与 patch 矩阵 $P^{(\ell)} \in \mathbb{R}^{N_v \times d_v}$。第二步(路由查询):在每个样本首个答案 token 前插入可学习 glimpse token $g$,取其第 $l$ 层隐状态 $h_g^{(l)}$ 作为查询 $Q^{(l)}$。第三步(权重生成):把 24 个 $c^{(\ell)}$ 投影到 LLM 隐空间堆叠为共享的 $K = V$,计算路由特征 $r^{(l)} = \mathrm{MHA}_{shared}(Q^{(l)}, K, V) + Q^{(l)}$;随后经层专属 MLP 得到路由分布 $\omega^{(l)} = \mathrm{Softmax}(W_2^{(l)}\,\mathrm{Dropout}(\mathrm{GELU}(W_1^{(l)}\mathrm{LN}(r^{(l)}) + b_1^{(l)})) + b_2^{(l)}) \in \mathbb{R}^{24}$,各分量非负且和为 1(隐层维度 1024)。第四步(Token 融合):逐位置加权 $\tilde{p}_i^{(l)} = \sum_k \omega_k^{(l)} p_i^{(k)}$,经层专属投影 $\rho_l$ 得 $\tilde{Z}^{(l)} \in \mathbb{R}^{N_v \times d}$。第五步(门控注入):$\tilde{H}_v^{(l)} = H_v^{(l)} + \gamma_l \tilde{Z}^{(l)}$,$\gamma_l = \sigma(a_l)$,$a_l$ 初始化 0.3。第六步(训练):总损失 $$\mathcal{L}_{total} = -\frac{1}{|\mathcal{M}|}\sum_{t \in \mathcal{M}} \log p_\theta(x_t \mid x_{<t}, \{\tilde{Z}^{(l)}\}) - \lambda \sum_{l=1}^{L} \mathcal{H}(\bar{\omega}^{(l)})$$ 其中 $\lambda = 0.01$(PT)/ 0(SFT);AdamW + cosine(warmup 0.03),PT/SFT 学习率 1e-3/2e-5、batch 256/128,各训练 1 epoch。
技术新颖性
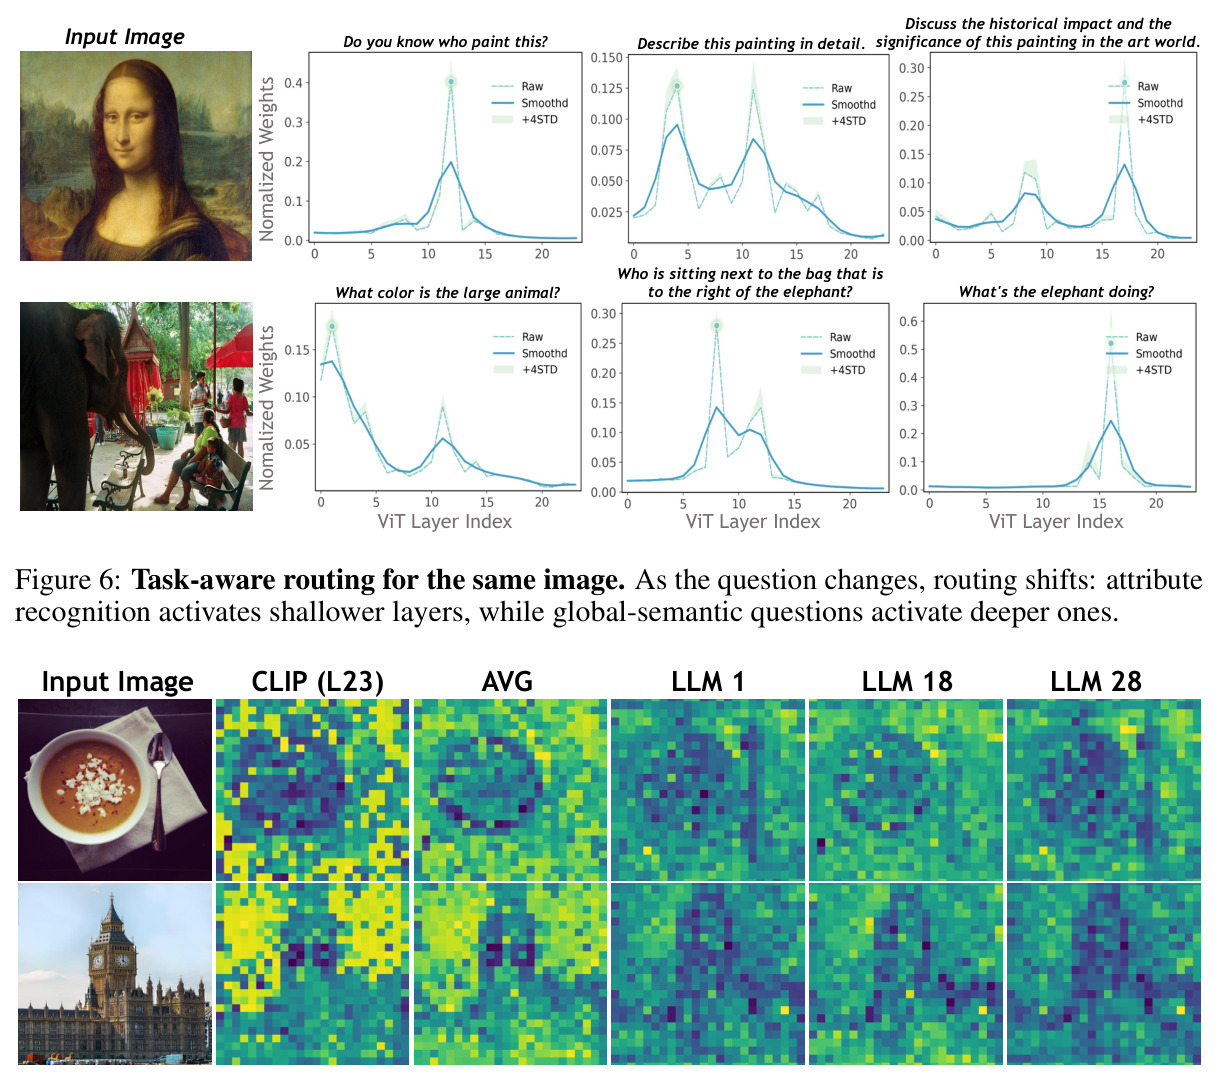
新颖性体现在四点。其一,连接拓扑:首次把 ViT-LLM 的全对全(24×32)连接做成端到端可学习的动态门控,而非 DeepStack/Sparse Shortcuts 式的手工稀疏模式或固定层级映射。其二,条件化信号:路由权重由 glimpse token 隐状态驱动,实现了「当前语言层语义状态 → 视觉粒度偏好」的逐层条件化,是对 CLI 只在采样层做自适应的推广与完备化。其三,工程轻量:路由模块仅增加 5.29%(7B)/4.27%(13B)参数,FLOPs 只增 4.07%(7B),13B 上甚至为 −0.07%,峰值显存 7B 反而 −0.13%,收益/代价比优于多数多层融合方法。其四,可解释性:路由权重天然可视化,论文借此证明不同 LLM 层确实偏好不同 ViT 层(中间层最常被激活,LLM 第 1 层偏浅中层、第 32 层偏深层),且路由随任务(LLaVAW/VizWiz 偏中层、SQAI 额外激活浅层 2)与同图不同问题而变化——这是固定连接方法无法提供的分析维度。
实验结果
在 LLaVA-1.5-7B 上 DGP 全面超越基线:SQAI +4.2(71.0 vs 66.8)、MM-Vet +3.3(33.8 vs 30.5)、LLaVAW +3.1(66.5 vs 63.4)、VizWiz +3.1(53.1 vs 50.0)、SEED +2.9(61.5 vs 58.6)、GQA +2.6(64.6 vs 62.0)、MMB +2.4(66.7)、MMBCN +2.2(60.5)、SEEDI +1.4(67.5)、VQAv2 +1.2(79.7)、POPE +1.1(87.0),并在 GQA、SQAI、SEED、LLaVAW、MM-Vet、MMBCN 六项上领先 DenseConnector、SparseCut、IGVA 等全部多层基线。13B 同样占优:GQA 65.5(+2.2)、VizWiz 57.4(+3.8)、MM-Vet 37.5(+2.1)、MMB 70.1(+2.4)、MMBCN 65.4(+1.8)、POPE 87.6(+1.7),仅 LLaVAW 微降 0.7。泛化性:Qwen3-VL-2B 上 GQA 63.9→65.4、SQAI 85.3→86.9、MMB 76.4→77.4、MM-Vet 49.8→50.9;LLaVA-NeXT 上 GQA 64.0→64.8、SQAI 69.5→72.3、MMB 66.5→68.7、MM-Vet 33.1→34.6。消融显示均匀平均 24 层严重掉点(GQA 60.2、VQAv2 72.0、MM-Vet 25.3、POPE 77.2),门控路由单独使用已超基线(GQA 64.1、SQAI 70.5),加熵正则后进一步提升至完整 DGP(SQAI 71.0、LLaVAW 63.6→66.5、MM-Vet 32.4→33.8),证明收益来自状态驱动的动态路由而非更多层。定性上 DGP 修正了读数幻觉:正确读出 6.90 与 7.90 欧元并算出总价 14.80。效率:7B 参数 +5.29%、FLOPs +4.07%、显存 −0.13%;13B 参数 +4.27%、FLOPs −0.07%、显存 +4.13%。
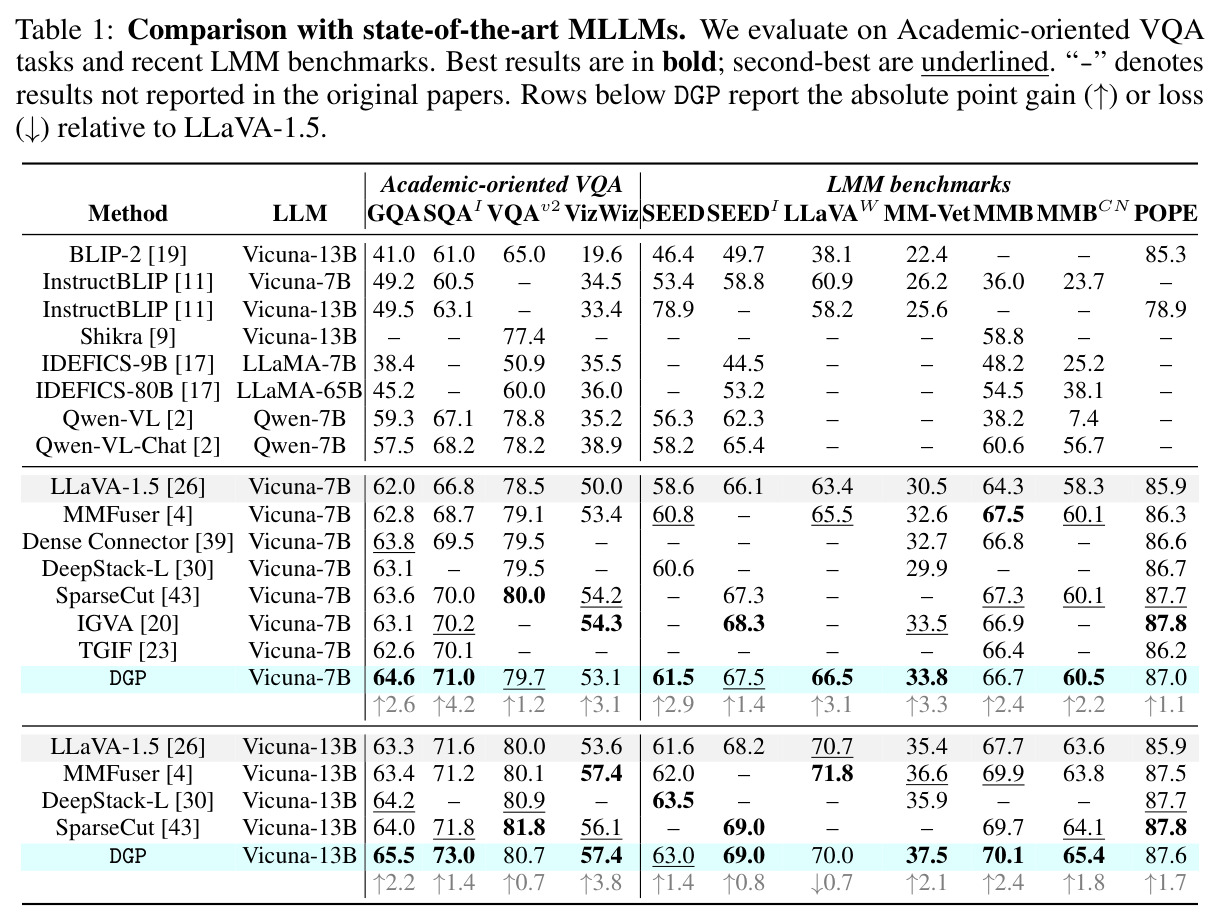
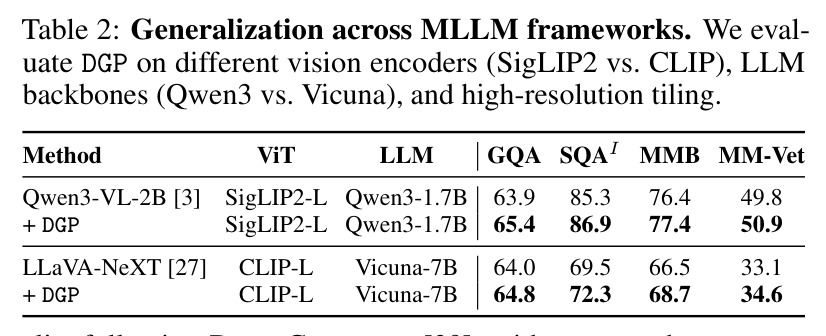
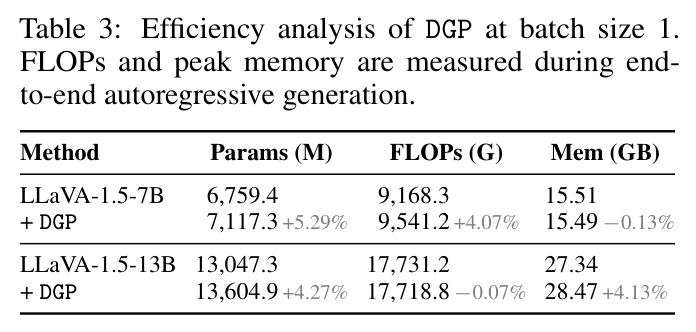
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ScienceQA-IMG(学术VQA,7B) | 准确率 | 71.0 | LLaVA-1.5-7B 66.8 | +4.2 |
| MM-Vet(综合指令跟随,7B) | 得分 | 33.8 | LLaVA-1.5-7B 30.5 | +3.3 |
| LLaVA-Wild(指令跟随,7B) | 得分 | 66.5 | LLaVA-1.5-7B 63.4 | +3.1 |
| VizWiz(真实场景VQA,7B) | 准确率 | 53.1 | LLaVA-1.5-7B 50.0 | +3.1 |
| GQA(学术VQA,7B) | 准确率 | 64.6 | LLaVA-1.5-7B 62.0 | +2.6 |
| POPE(幻觉抵抗,7B) | 准确率 | 87.0 | LLaVA-1.5-7B 85.9 | +1.1 |
| GQA(13B) | 准确率 | 65.5 | LLaVA-1.5-13B 63.3 | +2.2 |
| VizWiz(13B) | 准确率 | 57.4 | LLaVA-1.5-13B 53.6 | +3.8 |
| GQA(Qwen3-VL-2B 泛化) | 准确率 | 65.4 | Qwen3-VL-2B 63.9 | +1.5 |
| ScienceQA-IMG(LLaVA-NeXT 泛化) | 准确率 | 72.3 | LLaVA-NeXT 69.5 | +2.8 |
局限与改进
作者承认的局限:13B 上 LLaVAW 下降 0.7(70.0 vs 70.7),说明开域指令任务并非总能受益;VizWiz 7B(53.1)略低于 SparseCut(54.2)与 IGVA(54.3);13B 显存开销 +4.13%。我补充的观察:(1) 路由仅以每层 [CLS] 向量为摘要,patch 级空间结构差异无法参与路由判断,对需要精确空间定位的决策可能不够充分;(2) 前向过程需缓存全部 24 层 ViT 激活供各 LLM 层取用,层数更多或分辨率更高时训练显存压力会放大,论文未详细报告实现细节;(3) 仅在 ≤13B 模型上验证,路由模式是否随规模迁移未知;(4) SFT 阶段关闭熵正则后路由是否发生塌缩,论文只给了可视化而未给出量化指标;(5) 对比基线限于 Vicuna 骨架 2024 年前后的方法,未与更新的原生多模态架构直接比较;(6) glimpse token 改变了序列结构,与 KV cache 复用等推理加速技术的兼容性有待验证。
独立分析的弱点
独立分析三点弱点。第一,[CLS]-only 路由的信息瓶颈:路由决策完全依赖每层一个 [CLS] 向量,而 patch 级空间细节(如小物体的位置分布)无法参与路由打分,在需要精细空间选择的任务上可能欠佳。改进方向:用层内平均池化或对每层采样少量 patch 参与路由打分,代价可控。第二,全层激活缓存的工程负担:端到端推理需保留全部 ViT 层特征供各 LLM 层随时取用,内存随编码器深度线性增长,对高分辨率/深编码器不友好。改进方向:引入 top-k 稀疏路由,仅为高频选中的层保留缓存,或先在编码器侧做轻量粗筛。第三,可解释性证据是相关性而非因果性:Figure 5/6 展示的路由-任务相关性不能证明「该层特征因果地支撑了答案」;改进方向:设计干预实验(强制固定或扰动路由分布)量化各层特征的因果贡献。此外,13B LLaVAW 的回退提示门控可能在某些任务上注入了冗余视觉信息干扰语言推理,可考虑任务自适应的正则项或层间路由一致性约束。
未来方向
作者在结论中展望:将 DGP 推广到更大规模模型与更多架构,并以预测编码理论为指引探索真正的双向反馈机制——目前 DGP 只有 ViT→LLM 单向通路,尚未实现 LLM→ViT 的反馈调制。基于本文成果可延伸的方向:(1) 稀疏化与蒸馏——top-k 路由加层蒸馏,把 24×32 全连接压成稀疏子图,降低推理与缓存开销;(2) 把路由分布当作诊断工具——定位模型在哪些解码深度丢失了视觉证据,辅助失败案例分析与数据针对性补强;(3) 扩展到视频时序、音频等具有自身层级的模态,实现多模态联合路由;(4) 与 KV cache 压缩、early-exit 等效率技术协同设计,因为路由权重天然提供了各层视觉信息重要性的先验;(5) 训练动力学研究——熵正则系数 $\lambda$ 目前固定为 0.01→0 的两阶段策略,可探索自适应调度,并分析路由分布在 PT/SFT 之间的演化规律。
复现评估
复现条件良好。代码已在 GitHub 开源(YingyingYan1/DGP);训练数据全部公开(LLaVA-558K 预训练 + LLaVA-mixed-665K 指令微调,各 1 epoch);关键超参完整给出:AdamW + cosine(warmup 0.03)、PT/SFT 学习率 1e-3/2e-5、batch 256/128、路由 MLP 隐层 1024 维、残差门初始化 0.3、熵正则 $\lambda = 0.01$(PT)/ 0(SFT);基座模型公开(CLIP-ViT-L/14-336、Vicuna-7B/13B、Qwen3-VL-2B)。算力需求与复现 LLaVA-1.5 相当:7B 两阶段联合训练在 8×A100 量级可行,评估覆盖 11 个标准 benchmark、协议成熟、结果可对照。主要工程难点在于把 DGP 模块 hook 进 HuggingFace 模型的每个 decoder 层、缓存 ViT 全部层激活、以及 glimpse token 的序列插入逻辑,需要对模型内部结构较熟悉的改动;整体属于中等难度,无隐藏数据或配置依赖。
论文图表
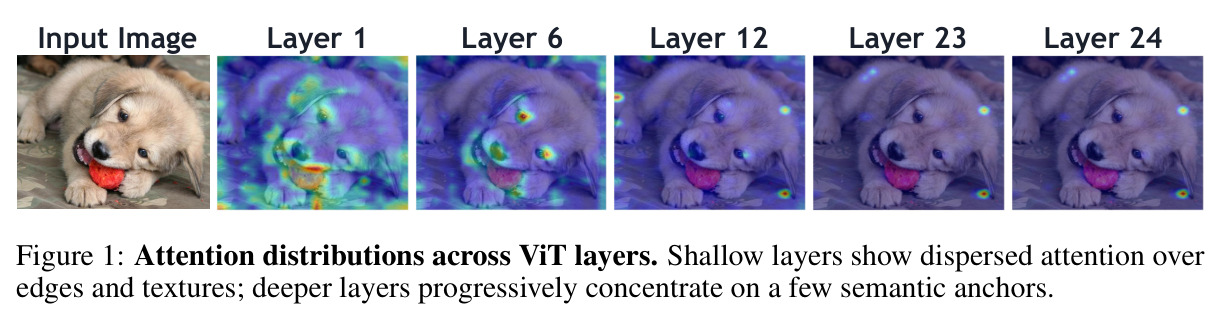
展示同一输入图像在 ViT 第 1/6/12/23/24 层的注意力分布可视化:浅层注意力分散覆盖边缘、纹理等局部细节,随深度增加注意力逐渐收敛到少数语义锚点区域。
直观呈现「不同 ViT 层携带不同粒度信息」这一全文立论基础,是理解为什么单一深层特征不够、需要多层连接的前提。
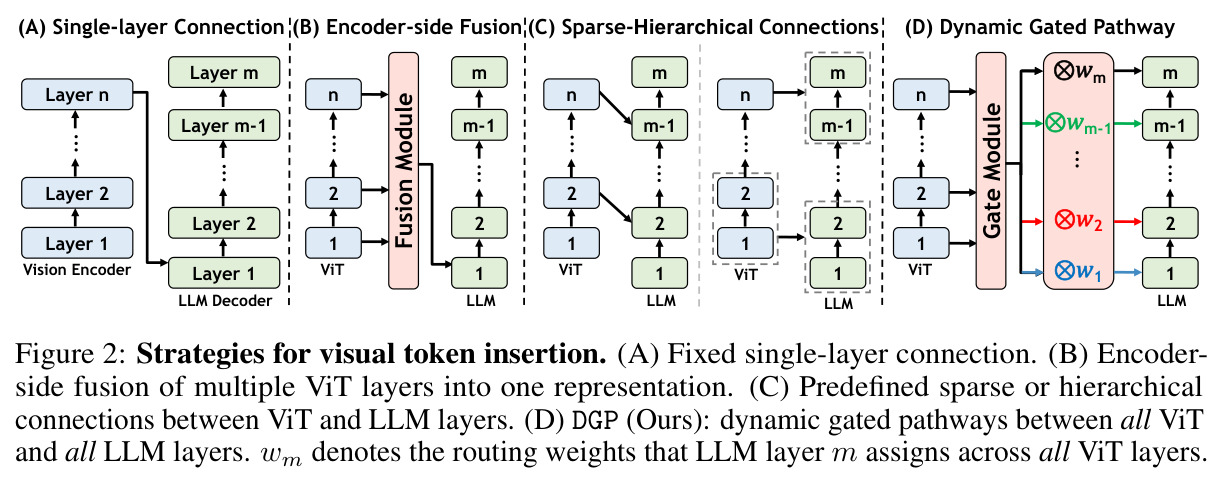
对比四类视觉 token 注入策略的连接拓扑:(A) 固定单层连接;(B) encoder 侧把多层融合为一份表示;(C) 预定义稀疏/层级连接;(D) 本文 DGP 的全对全动态门控通路,图中标注 LLM 层 m 对全部 ViT 层的路由权重 $w_m$。
一张图看懂 DGP 与三类已有方法的本质区别,是定位论文贡献点(连接拓扑层面的创新)的核心示意图。