EmbodiedSmith:在仿真中通过递归自我改进飞轮扩展具身数据 EmbodiedSmith: Scaling Embodied Data through Recursive Self-Improvement Flywheel in Simulation
场景与任务生成互相反馈迭代,规模化产出高质量机器人仿真训练数据。
前置知识
递归自我改进(RSI, Recursive Self-Improvement)
指系统利用自身产生的输出与反馈来持续改进自身能力的机制。在机器人数据合成语境下,生成器产出的任务执行失败信息被回灌给场景与规划模块,触发定向修复,再重新执行验证,形成数据质量随迭代轮次上升的“飞轮”。与单次前向生成不同,RSI 把失败当作改进信号而非废料。
本文的整个框架就是 RSI 的具身版:场景生成与任务生成互相提供反馈、循环细化,理解这一概念才能抓住“飞轮”二字的方法论本质。
VLA 模型
视觉-语言-动作(Vision-Language-Action)模型,接收图像与语言指令、直接输出机器人动作,是当前机器人基础模型的主流形态,典型代表有 π0、π0.5、RT-2 等,通常先在大规模演示数据上预训练再针对目标场景微调。
本文生成的仿真演示数据最终用于微调 π0.5 与 FastWAM 两类模型,实验结论(数据多样性提升泛化)正是围绕这类模型的成功率展开的。
Skill DAG(技能有向无环图)
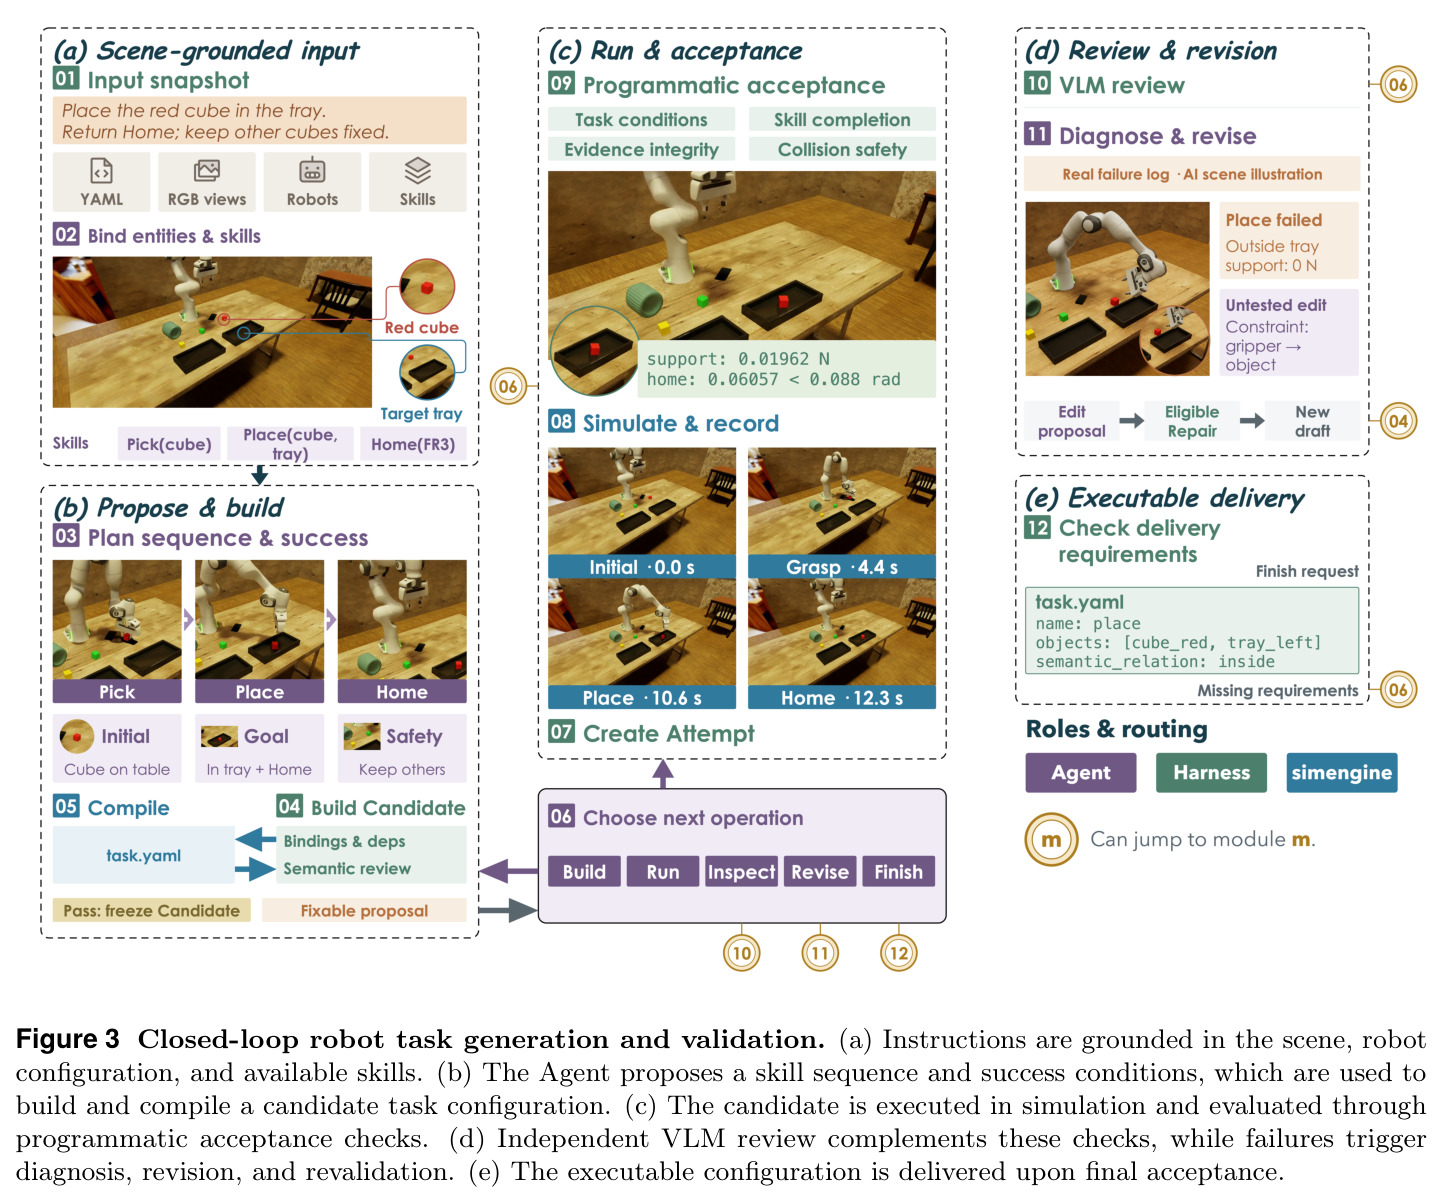
把任务拆解为带依赖关系的原子技能节点(pick、place、open、navigate、pour_water 等)组成的有向无环图。每个节点绑定目标实体、执行资源与目标参数,边表示执行顺序约束,系统按拓扑序执行并逐节点记录事件,便于精确定位失败环节。
EmbodiedSmith 的任务规划 agent 输出的就是 Skill DAG,其编译(build)、执行(run)、验收与修复(revise)全部围绕这一结构进行。
Sim-ready 资产与凸分解碰撞体
可直接放入物理仿真器的 3D 资产:需具备统一尺度与坐标系、语义标注、物理参数,以及通过自适应凸分解生成的简化碰撞几何,使刚体接触与抓取检测既快速又足够精确。铰接体还带关节结构,可变形体带材质属性。
资产质量直接决定仿真数据的物理真实性,本文专门设计了资产生成与三段式验证流水线,这是理解其环境构造模块的基础。
域随机化(Domain Randomization)
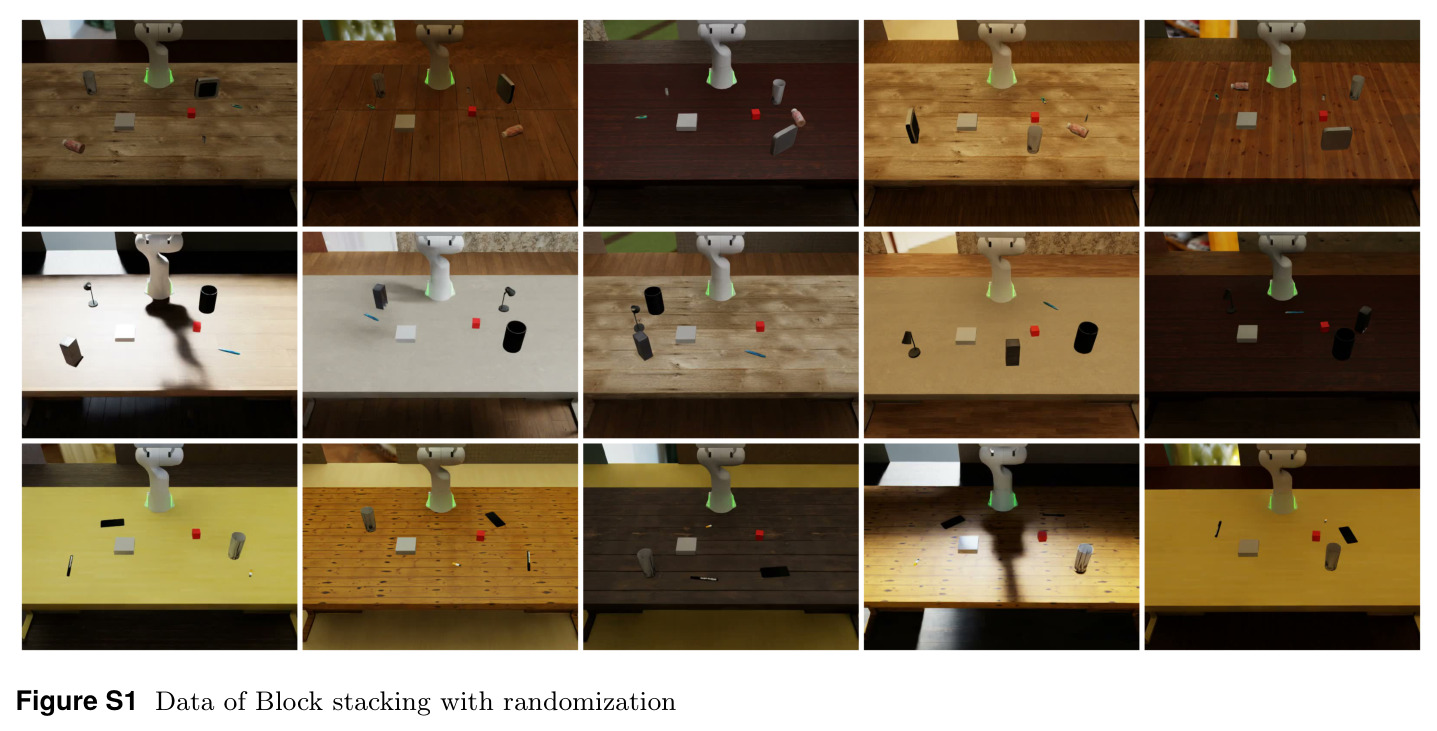
在收集训练数据时系统性地随机扰动环境参数(物体位置朝向、干扰物组合、光照、纹理、初始状态等),迫使策略学习对任务本质敏感而非记忆特定场景,从而提升对未见配置的泛化能力。
论文 4.3 节在资产、布局、观测三个层次做分层随机化构造 mixed 数据集,实验证明随机化带来的多样性是泛化跃升的关键。
CuRobo 运动规划
NVIDIA 开发的 GPU 加速机器人运动规划库,基于并行化优化求解器,可在毫秒级为高自由度机械臂规划无碰撞轨迹,是 Isaac Sim 生态中操作任务执行的事实标准组件。
本文用 CuRobo 在场景布局阶段验证机器人可达性、在执行阶段规划机械臂轨迹,是场景可行性检查与轨迹生成的底层依赖。
研究动机
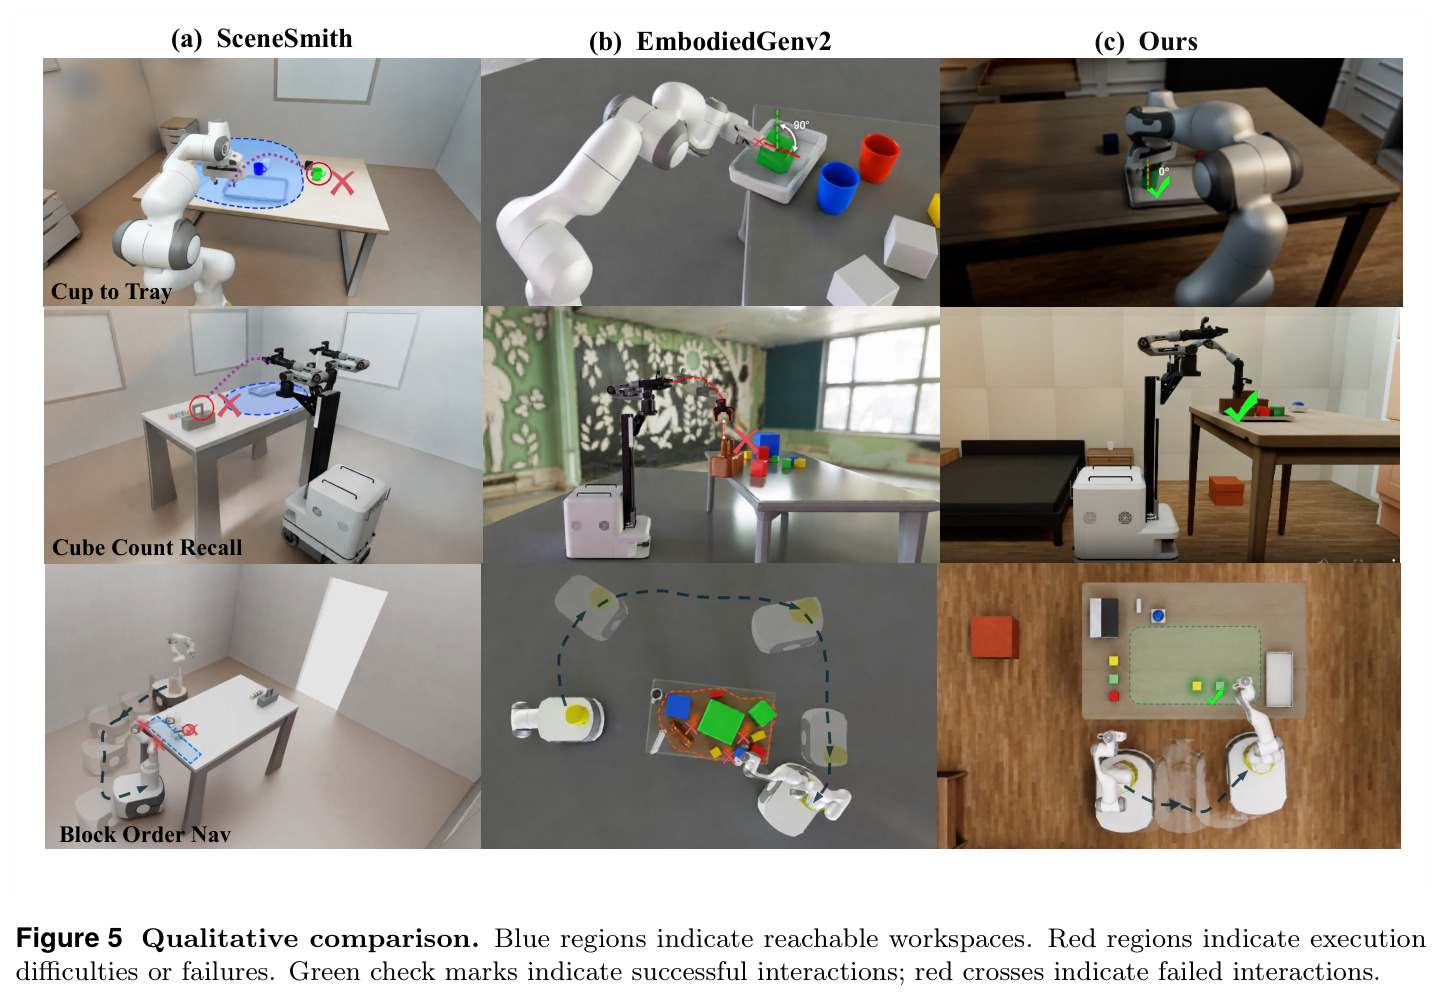
机器人基础模型的进步正被训练数据的规模与多样性卡住脖子:真机遥操作数据与目标硬件匹配度高但成本高、多样性低;自我中心视频数据多样却缺乏动作标签。仿真本是兼顾两者的理想数据源,但现有仿真数据生成管线存在四大具体缺陷。其一,多样性与可定制性受限——场景与资产基本来自预定义库,技能多为人工编写或规则化(如 RoboCasa、GenSim 一类系统的任务集合受限于手工资产)。其二,物理真实性不足,对可变形物体与流体的支持普遍缺失,而倒水、擦拭这类涉及形变与液体的行为恰恰是日常操作的重要组成。其三,任务执行成功率低:场景生成与任务生成彼此解耦,规划出的动作从未被验证过可行性,且问题随任务变长而急剧恶化——基线 SceneSmith 在 16 个任务上的平均生成成功率仅 17%,EmbodiedGen V2 为 21%,长程记忆类任务(如记住方块顺序后复现)成功率普遍跌至 0%–7%,SceneSmith 在 Open Cabinet 上烧掉约 71 万 token 仍颗粒无收。其四,对移动操作臂、人形、灵巧手等复杂本体的支持匮乏,而这些本体恰恰是获取人类级灵巧行为的必经之路。
本文的目标是本文要构建一个统一的具身仿真数据引擎 EmbodiedSmith,把资产生成、场景生成、任务生成整合进一条支持自主创建与语言驱动定制的流水线,并以递归自我改进(RSI)飞轮让场景与任务互相打磨,从而稳定产出高质量、可执行的机器人演示数据。具体目标分解为四点:一是数据多样性,能生成任意新物体、布局与场景,并让 agent 自主创建与组合技能完成多样任务生成;二是物理丰富性,支持可变形体与流体等复杂物理现象的资产与任务,缩小仿真与真实世界的差距;三是高生成成功率,让场景生成预判任务需求、任务生成反向定向编辑场景,使引擎即使面对长程任务也维持高成功率;四是人类级灵巧性,把任务生成扩展到移动操作臂、Unitree G1 人形与 Sharpa Wave 灵巧手。最终该引擎要一鱼两吃:既当机器人预训练的数据源,也当低成本、可复现的大规模评估环境,支撑对任务/环境/本体多样性与模型泛化之间关系的系统研究。
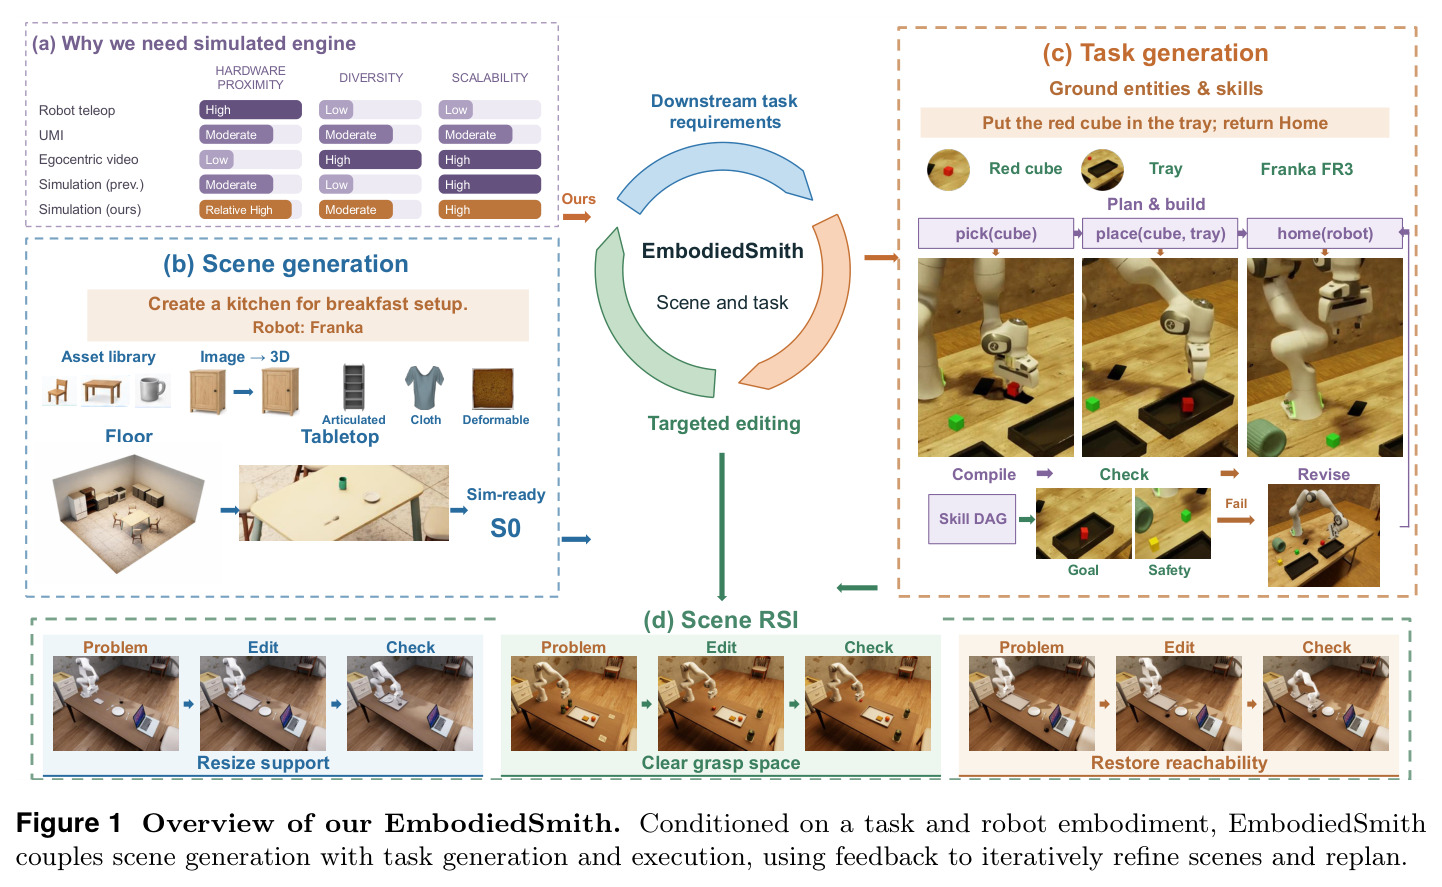
与已有工作不同的是,已有工作要么专注场景生成(Holodeck、LayoutVLM、SAGE、EmbodiedGen V2、SceneSmith 分别用扩散模型、程序化语法、VLM 排布等手段造房间),要么专注示教合成(HumanoidGen、HumanoidMimicGen 依赖精心策划的任务套件、标注的操作原语或源演示),两条线互不咬合:场景再好看也无法保证可执行,任务失败后也不知道该改场景还是改计划——正是这个「生成-执行脱节」留下了解耦式方法的成功率天花板。EmbodiedSmith 的独特切入点是把二者耦合进同一个 agentic 精化回路:场景生成端在布局求解时就纳入机器人工作空间、间隙与 CuRobo 可达性约束,提前为任务铺路;任务生成端执行失败后不是盲目重试,而是通过 schema 约束的定向场景编辑(增删任务对象、替换、缩放、可达性感知重定位)修改环境本身,再重验证、重规划、重执行。这种「环境为任务让路、任务为环境把关」的双向递归细化,是先前单向流水线所没有的,也是长程任务成功率从个位数跃升到 80% 以上的关键。
核心方法
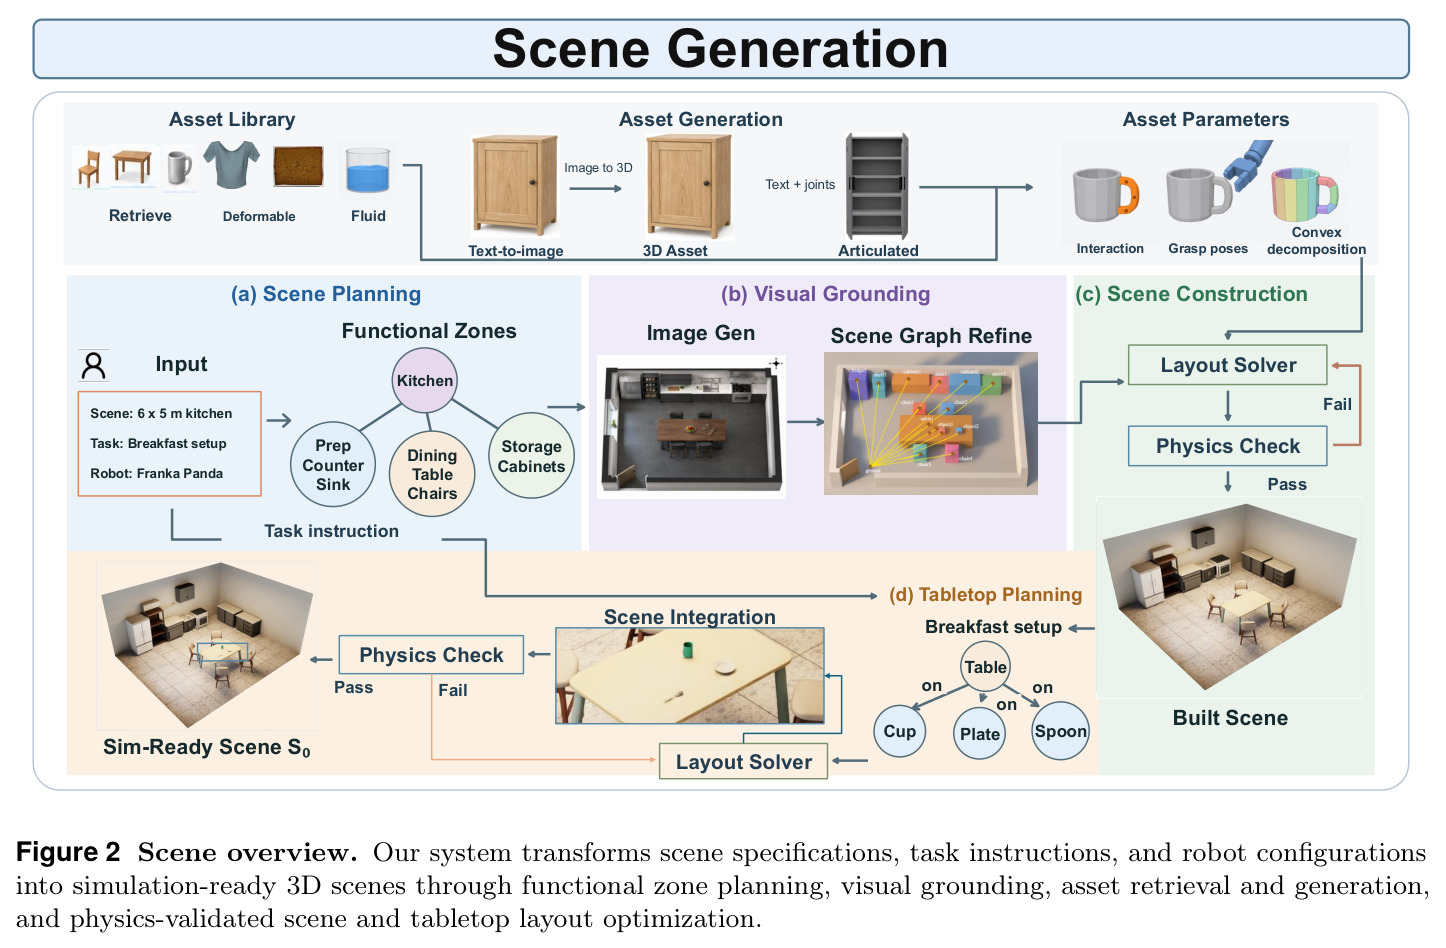
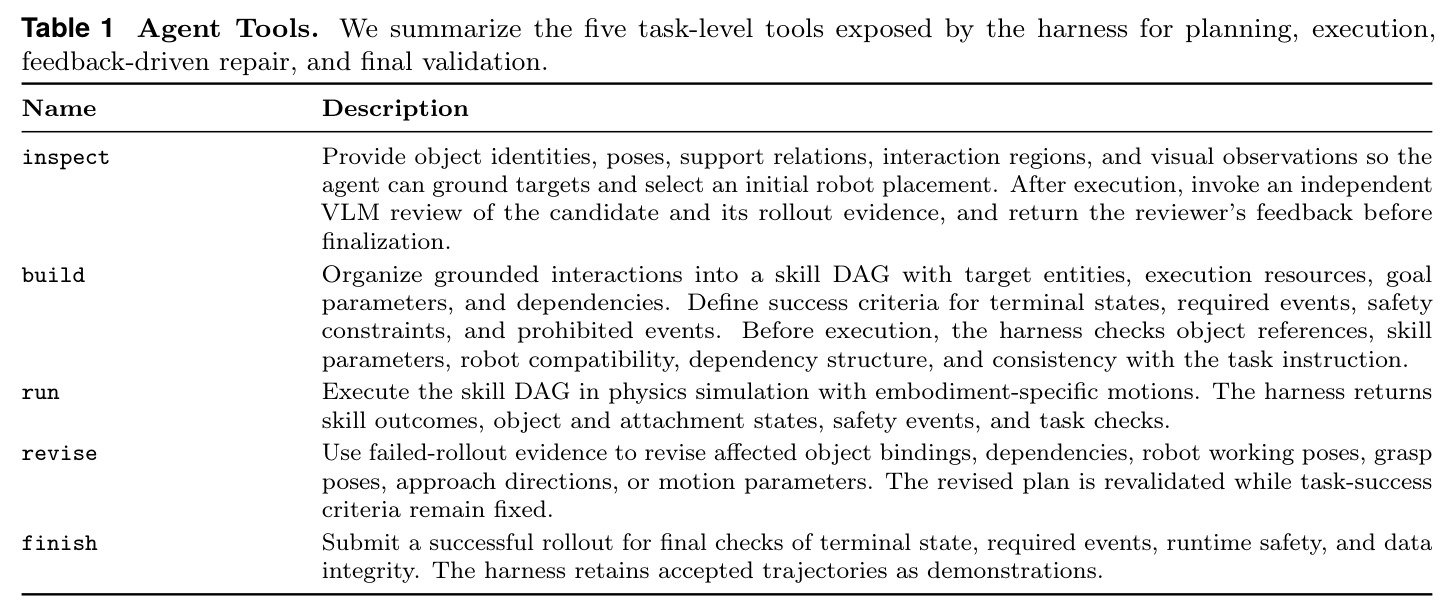
直觉上,数据生成的失败很少是单点问题:场景再好看,机器人够不着抽屉就是零数据。EmbodiedSmith 把「造环境」与「造任务」设计成互相校准的循环而非串联模块,分三块。环境构造:维护持续扩展的资产池——VLM 规范化的开源资产加上检索失败时用 SAM3D 从精修参考图生成的新资产,统一配凸分解碰撞体与物理参数,仿真测试后入库;场景生成器把文本 $T$ 与本体配置 $E$ 合成为经几何与可达性验证的初始场景 $S_0 = (G, O, X, Q)$,$G$ 为房间边界、$O$ 为物体实例、$X$ 为 6-DoF 位姿、$Q$ 为支撑与交互约束。轨迹生成:Task Plan Agent 把任务接地到实体与原子技能,形成 Skill DAG 与可程序化检查的成功条件,经 build/run/inspect/finish/revise 五个工具与 Harness、simengine 构成闭环。本体适配:在共享 Skill DAG 之下放执行 adapter,让人形与灵巧手复用同一套上层技能。任何一环失败都触发 Scene Edit 或计划修订,飞轮转动直至产出通过验收的演示。
核心创新是场景生成与任务生成的双向耦合精化回路,与已有方法的本质区别在信息流方向与闭环完整性:传统管线里场景生成器交付后即失联,任务生成器只能在一个可能根本不可行的环境里硬着头皮规划;EmbodiedSmith 让场景生成提前预判下游需求(布局优化强制边界、避碰、间隙、连通性与工作空间约束,并用 CuRobo 验证可达性),任务失败后又把执行证据送回场景端,由场景 agent 施加 schema 约束的定向编辑——只动与失败相关的元素:支撑面高度不当就调整桌面、抓取空间被侵占就清空、可达性丧失就重定位任务对象;每次编辑可预览,并生成可追溯修订记录标明需复验的检查。任务端同样环环设卡:Agent 先调 build 让 Harness 检查实体引用、参数、机器人绑定与需求覆盖,编译通过后冻结为 Candidate;run 在仿真中执行并程序化验收;通过后不急于 finish,而是调 inspect 触发独立 VLM 复审;失败则调 revise 基于原始 rollout 证据修订机器人摆放、动作参数或抓取位姿。关键纪律是:任务成功标准全程锁定不变,修复只改计划与场景、绝不「改考卷」。
方法步骤详情
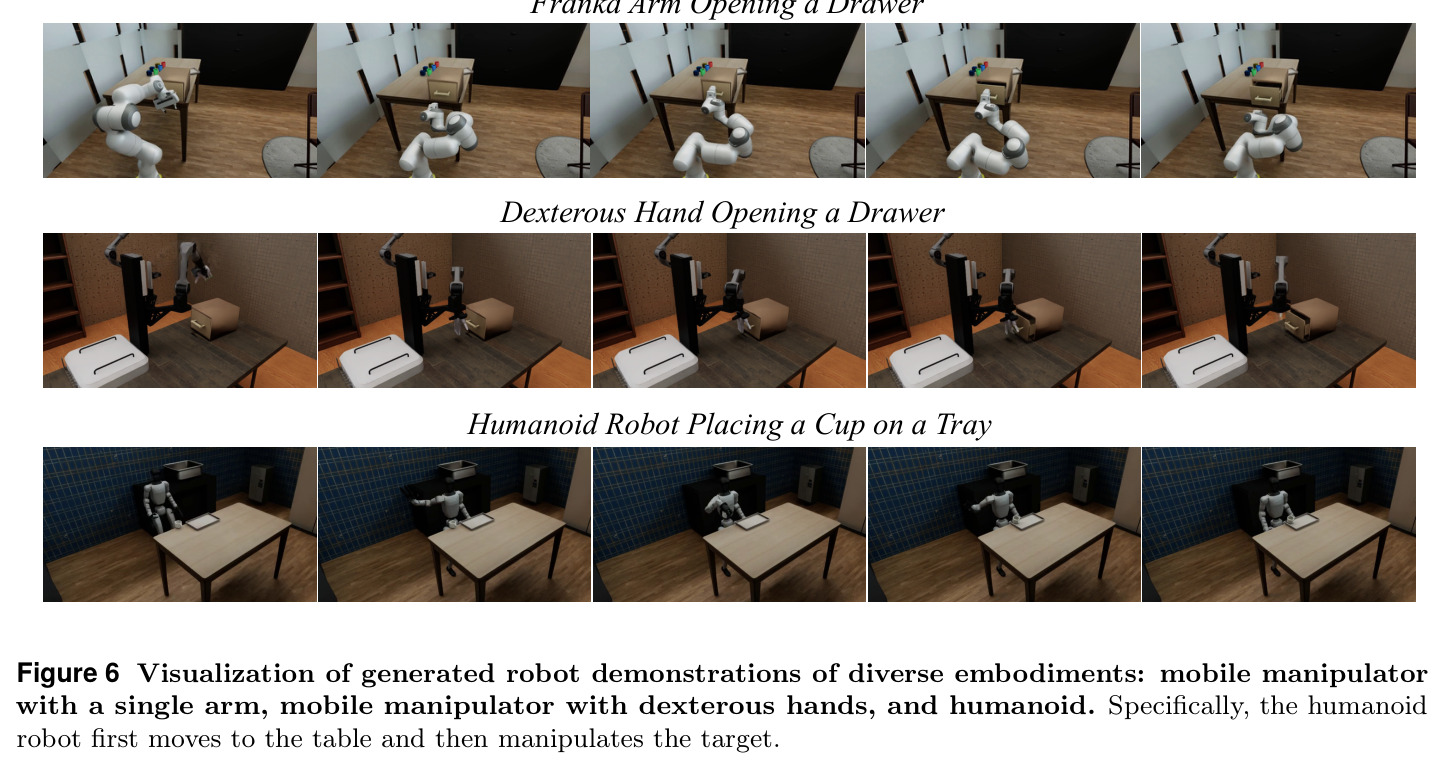
流程七步。①资产:检索失败时精修参考图,SAM3D 重建带纹理 3D 资产,凸分解生成碰撞体,VLM 赋物理参数,仿真测试合格后入池;铰接资产走 Articraft 循环,LLM 按 SDK 反馈迭代。②场景生成:VLM 把输入解析为类型化关系图(功能分区、朝向、支撑面),布局分层求解——地面装置先组局部构图以 Beam-DFS 联合优化,再放墙面装置与任务对象,CuRobo 验证可达性,输出 $S_0$。③任务规划:Harness 冻结输入快照,Agent 绑定实体与原子技能、定摆放与执行顺序,形成 Skill DAG 和可检查的成功条件。④构建:调 build,经 simengine 编译,通过则冻结 Candidate。⑤执行验证:调 run 按种子仿真,程序化验收后调 inspect 触发独立 VLM 复审,无误才调 finish。⑥修复:失败时调 revise,改完重新 build-run,上限 30 轮。⑦多本体:G1 人形 adapter 以 50 Hz 合并下肢与手臂命令为 29-DoF 动作;灵巧手编译带力门槛的 fail-closed 手部契约。
技术新颖性
新颖性有四层。其一,RSI 飞轮的工程化落地:把抽象的「自我改进」落实为场景编辑算子与任务修复工具构成的可执行回路——消融(Table 4)证明去掉执行反馈后四个任务类别的 ASR 从 69.4%/71.6%/70.0%/54.0% 崩至 4.0%/0%/0%/0%,说明性能来源是闭环反馈而非单点模块。其二,评估协议:Candidate 冻结机制配合 10 个生成阶段未见过的 held-out 种子验收,杜绝「在自己调参过的场景上自欺欺人」的评估污染,同类系统论文中少见。其三,统一技能接口下的本体解耦:Table S1 的 22 种原子技能(从 pick 到 pour_water)不感知本体形态,差异全收进 adapter 层,使同一任务 DAG 可跨 Franka、移动臂、G1 人形与灵巧手执行——这是 HumanoidGen 等绑定本体的工作所不具备的。其四,物理资产三段式门控:构建→物理验证(铰接体查惯性与关节、可变形体与流体做形变/流动探针)→任务验证(CuRobo 先评无碰撞可行性,失败由独立角色诊断责任),未奏效的修改一律回滚。这套验证纪律本身就是贡献。
实验结果
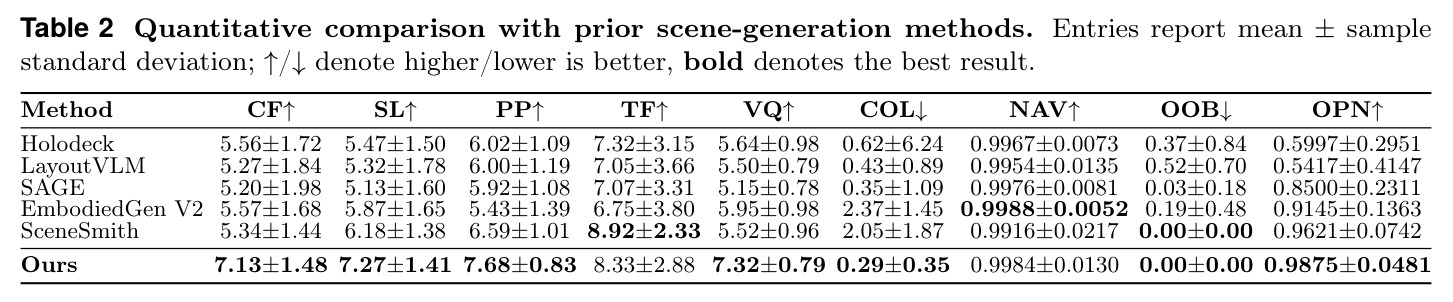
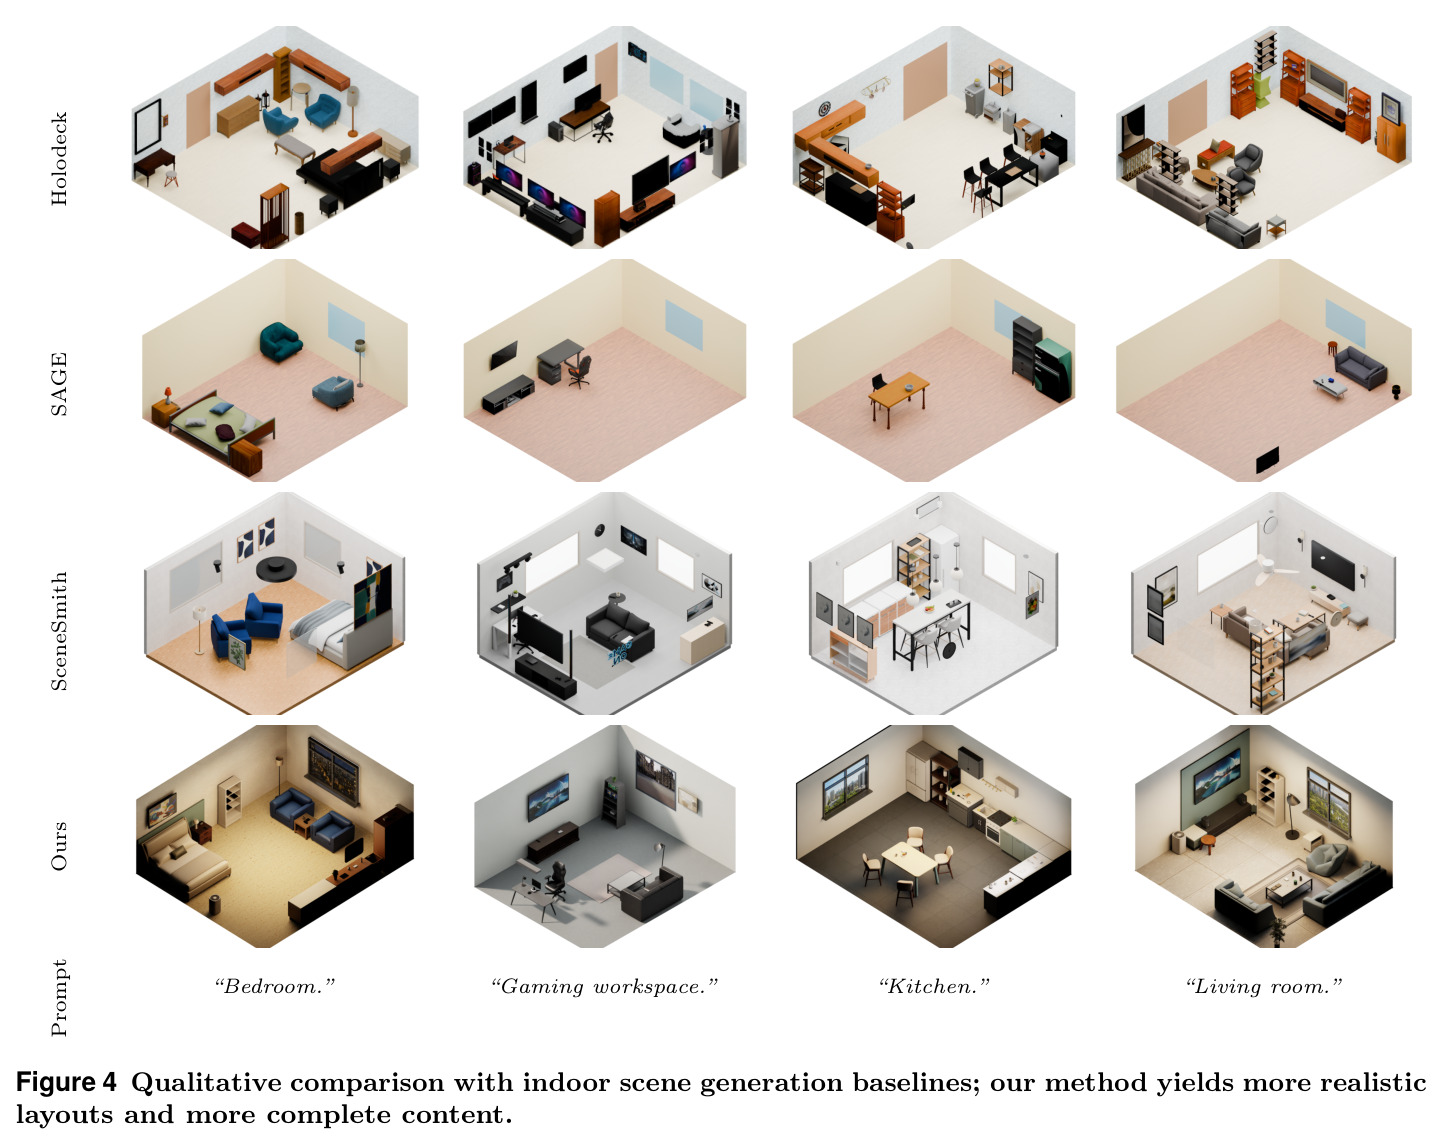
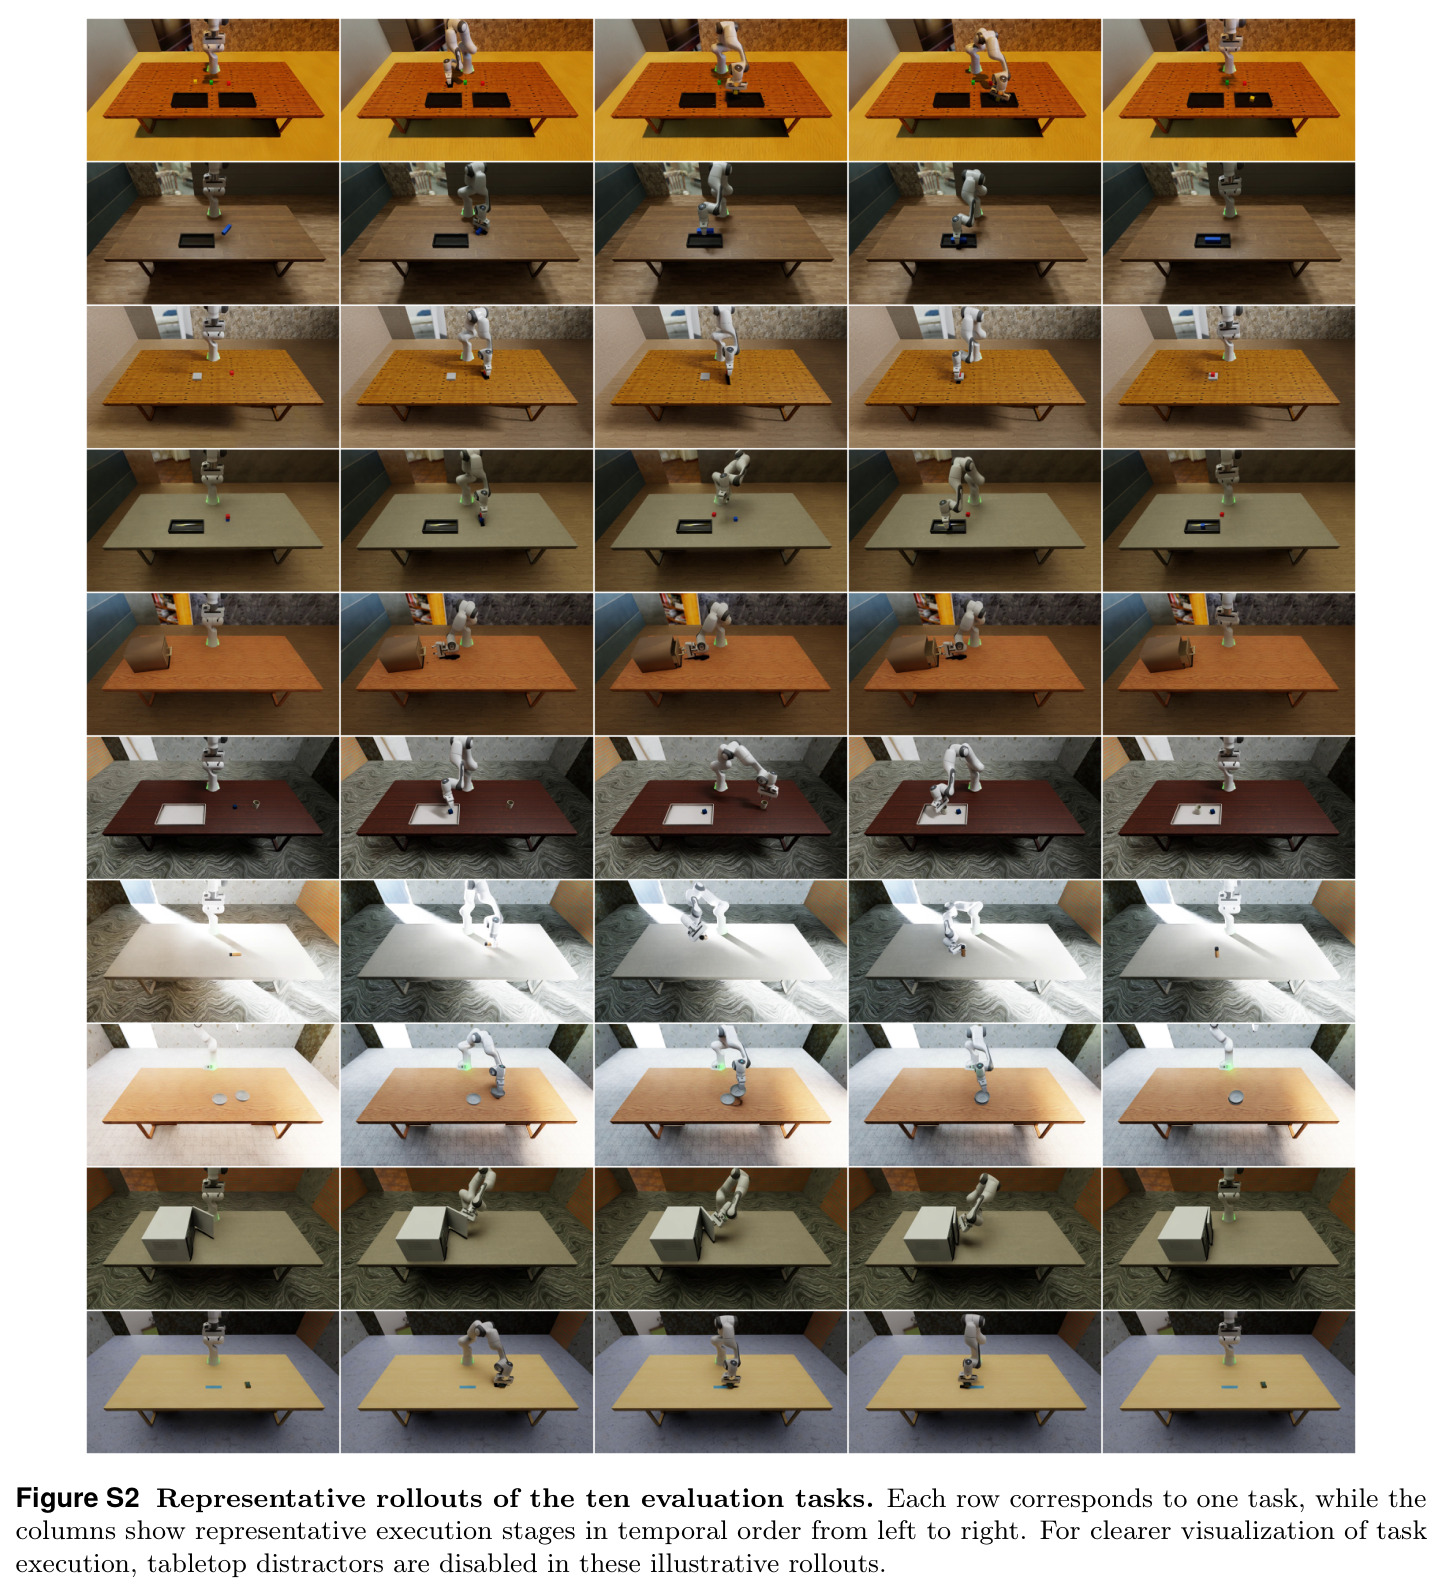
实验回答三问。其一,环境质量:20 场景×3 次生成、GPT-5.5 打分,本文 CF 7.13±1.48 较最强基线 5.57 提升 28.0%,SL/PP/VQ 分别领先 17.6%/16.5%/23.0%,仅 TF 8.33 逊于 SceneSmith;COL 0.29 最低、OOB 为 0、NAV 0.9984、OPN 0.9875。其二,演示生成:16 个任务、10 个 held-out 种子评估,平均 ASR 67%;长程记忆任务优势最大,Cube Count 79% 对 3%/0%、Block Order 83% 对 7%/0%。消融显示:去掉执行反馈 ASR 几乎归零,去掉摆放验证则固定基座长程任务从 71.6% 跌至 13.2%。其三,策略训练:两场景各 5 任务、零人工调试收集 20 小时,clean 与 mixed 等时长对比;π0.5 在 simple 设置 clean 更高(61.2% 对 50.8%),但 random 下 mixed 达 40.2% 对 7.2%,FastWAM random 从 1.0% 升至 10.2%。可见随机化才真正带来布局泛化。
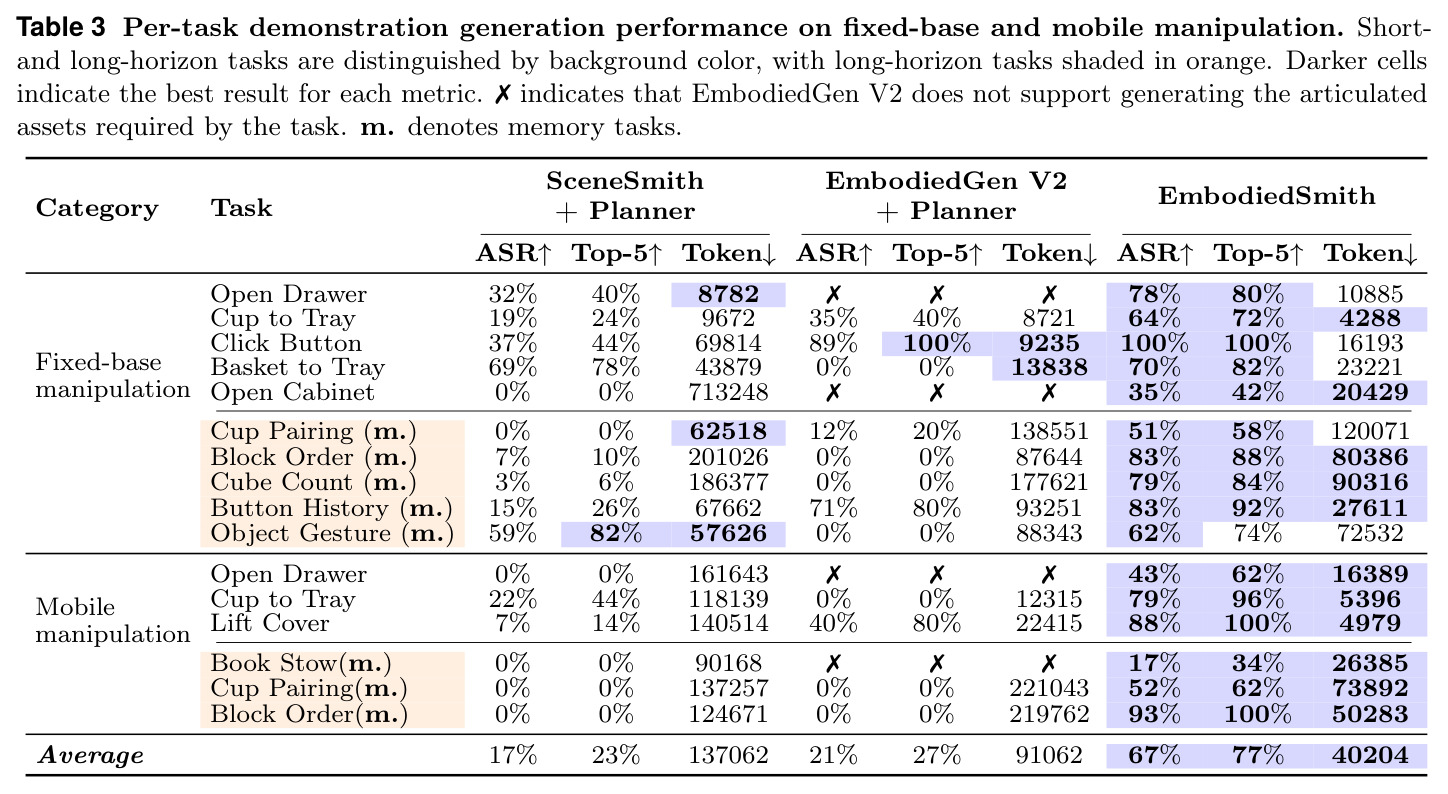
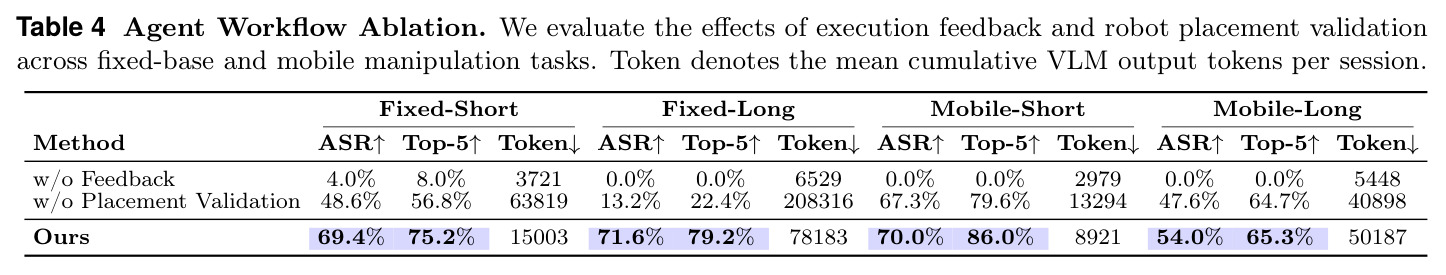
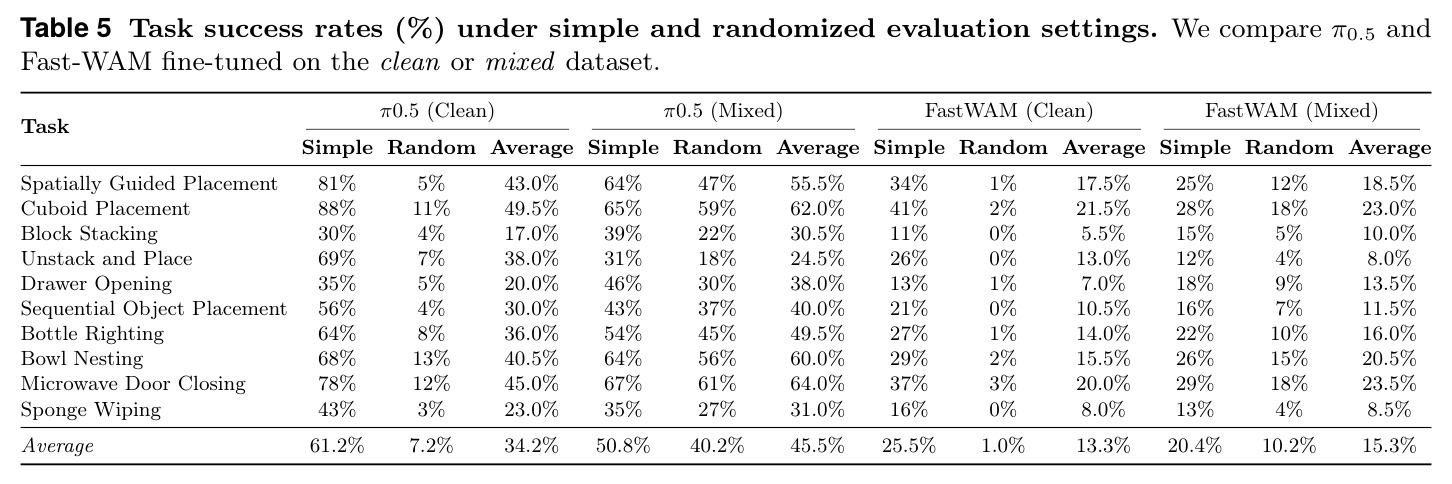
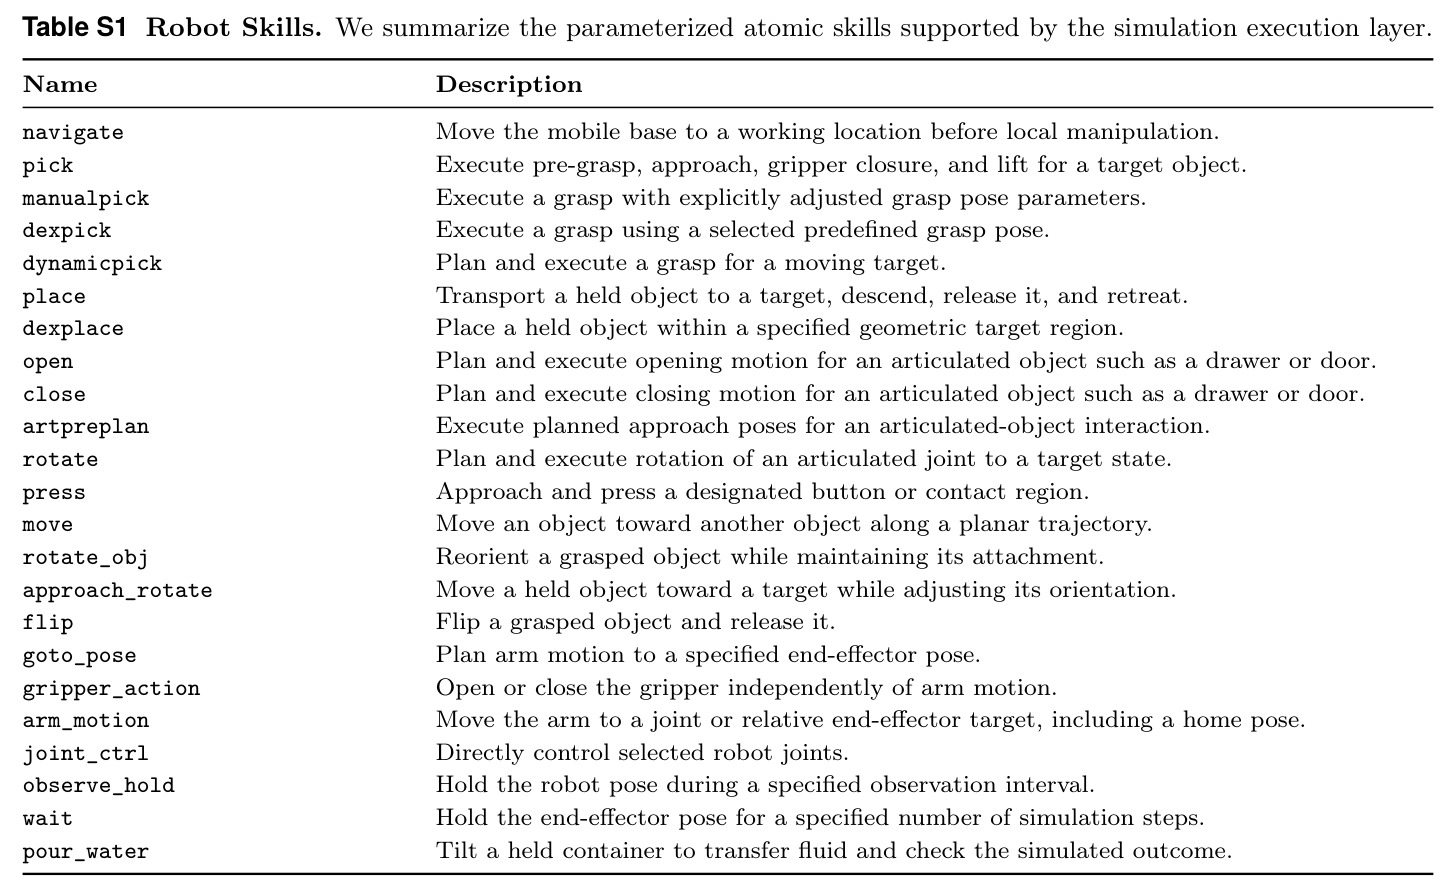
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 室内场景生成·内容/功能完整性 | CF(GPT-5.5 评分,1–10) | 7.13±1.48 | EmbodiedGen V2 5.57±1.68(最强基线) | +28.0%(相对提升) |
| 机器人演示生成·16 任务平均 | ASR(held-out 种子成功率) | 67% | SceneSmith 17% / EmbodiedGen V2 21% | +50 个百分点(约 3.9 倍) |
| 长程记忆任务 Block Order(固定基座) | ASR | 83% | SceneSmith 7% / EmbodiedGen V2 0% | +76 个百分点 |
| 演示生成效率 | 平均 VLM 输出 token/会话 | 40204 | SceneSmith 137062 / EmbodiedGen V2 91062 | 较 SceneSmith 降低 70.7% |
| π0.5 随机布局泛化(10 任务平均) | Random 设置成功率 | 40.2%(mixed 数据) | 7.2%(clean 数据) | +33.0 个百分点(约 5.6 倍) |
| FastWAM 随机布局泛化(10 任务平均) | Random 设置成功率 | 10.2%(mixed 数据) | 1.0%(clean 数据) | +9.2 个百分点 |
| 消融:移除执行反馈(固定基座短程) | ASR | 69.4%(完整方法) | 4.0%(w/o Feedback) | 反馈回路贡献 +65.4 个百分点 |
| 消融:移除摆放验证(固定基座长程) | ASR | 71.6%(完整方法) | 13.2%(w/o Placement Validation) | 摆放验证贡献 +58.4 个百分点 |
局限与改进
作者承认的局限:可变形资产用简化程序化表示与均匀材质,「释放后恢复不完整」仅记为已知限制;物理资产生成尚未集成进场景生成器;TF 8.33 不敌 SceneSmith 的 8.92。我的观察:其一,流水线深度绑定闭源大模型(评估 GPT-5.5、生成 gpt-5.6-sol),API 成本与版本漂移影响可复现性,长程记忆任务单会话 token 达 8 万–12 万,规模化成本可观。其二,实验全在 Isaac Sim 内,无任何 sim-to-real 真机验证,「扩展具身数据」的最终价值未经真机检验。其三,策略实验规模小(2 场景、10 任务、20 小时),且 mixed 数据在 simple 设置反而下降(π0.5 61.2%→50.8%),精度-泛化权衡未深入讨论;FastWAM 绝对成功率整体偏低(平均 13%–15%)。其四,若干任务仍困难:移动 Open Drawer 43% 远低于固定基座的 78%,Book Stow 仅 17%,关节约束动作与多阶段移动长程任务依旧脆弱。其五,感知指标依赖 VLM 主观打分,「场景好看」与「利于策略学习」的关联缺直接证据。
独立分析的弱点
弱点与改进方向。弱点一:闭环修复依赖超强闭源 LLM/VLM,token 成本高且无法本地部署;改进方向是把成功修复案例蒸馏为小型开源 agent,或建「失败模式→修复算子」检索库降低推理深度。弱点二:成功判定虽有程序化验收加独立 VLM 复审双保险,但 VLM 仍可能放过「达标但动作无意义」的伪成功轨迹,混入数据集会毒害策略训练;改进方向是引入因果干预检查(随机化初始状态重放验证)与人工抽检。弱点三:可变形体与流体仍属演示性质——均匀材质、恢复不完整,海绵擦拭、倒水之外的真实接触行为难以覆盖;改进方向是接入 MPM/FEM 求解器并用真实物体扫描标定材质。弱点四:随机化-精度权衡未被处理,mixed 数据损害固定布局性能(π0.5 simple 61.2%→50.8%);改进方向是课程式数据配比或两阶段训练。弱点五:场景编辑只支持任务对象级的增删/替换/缩放/重定位,不能改房间结构,失败根源在建筑布局时飞轮只能认输;改进方向是把房间边界 $G$ 纳入可编辑模式。弱点六:评估全在仿真内;改进方向是选子集做 real2sim 校准后真机微调,量化 sim-to-real gap。
未来方向
作者提出的后续方向:把铰接、可变形、流体等物理资产生成完整集成进场景生成器;完善可变形资产的释放后恢复行为。基于本文成果可自然延伸的方向:其一,把 RSI 飞轮的反馈源从仿真扩展到真机——真实执行失败同样可以驱动 Scene Edit 与计划修订,形成 sim-real 双飞轮,让引擎随部署持续进化。其二,目前被拒收的失败 rollout「仅用于诊断」,可以拿它们做负样本学习:RL 微调、DAgger 式纠正、失败预测器训练,榨取失败数据的价值。其三,数据多样性实验只扫了布局一个维度,资产组合、光照纹理、本体混杂度对预训练收益的 scaling law 值得系统测绘,这直接回答「预训练数据该怎么配」。其四,任务生成端可引入自动课程:按当前策略的弱项反向定制新任务与随机化范围,让数据引擎从被动生成变成主动学习者。其五,扩展到双足-双手、四足-机械臂等更多本体乃至多机器人协作任务,检验 adapter 解耦设计的上限。其六,把引擎连同 held-out 种子、冻结 Candidate 的评估协议开源为标准化具身 benchmark——这套防污染协议本身就是对社区的贡献。
复现评估
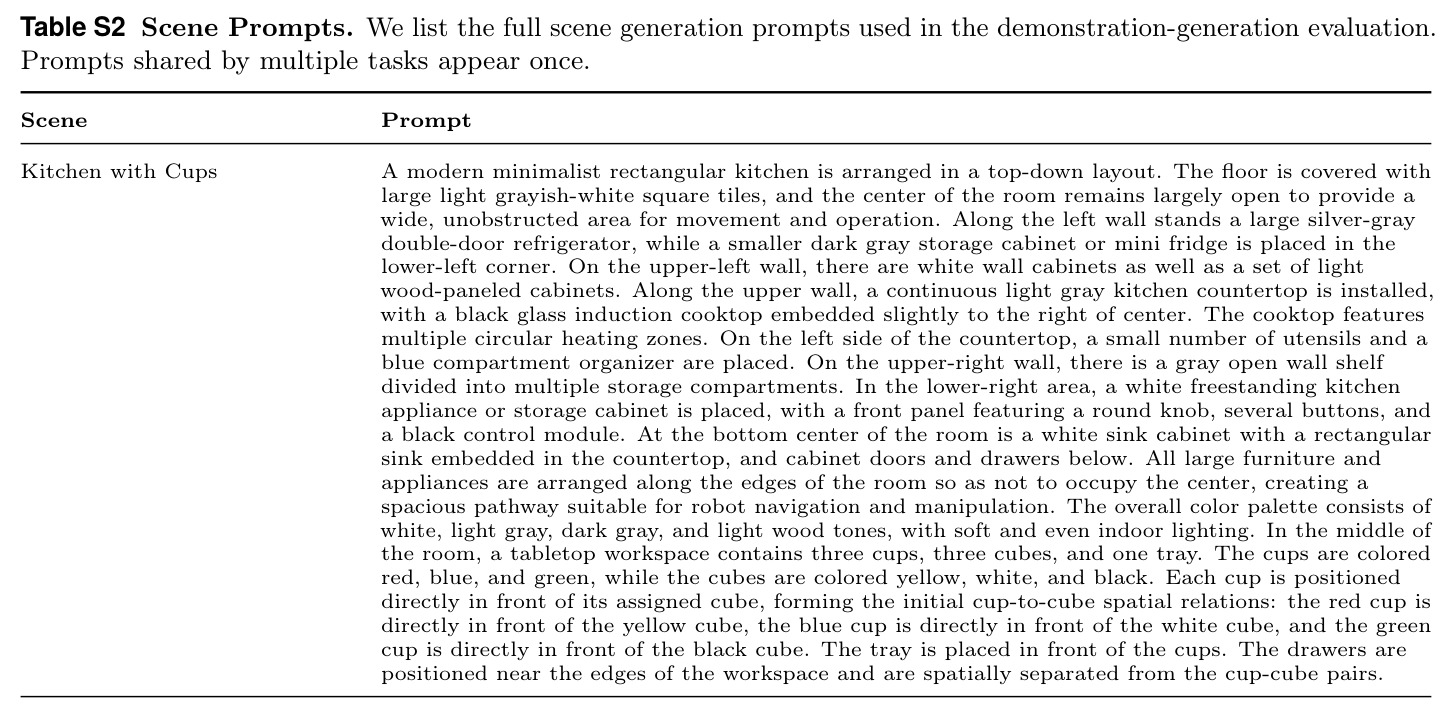
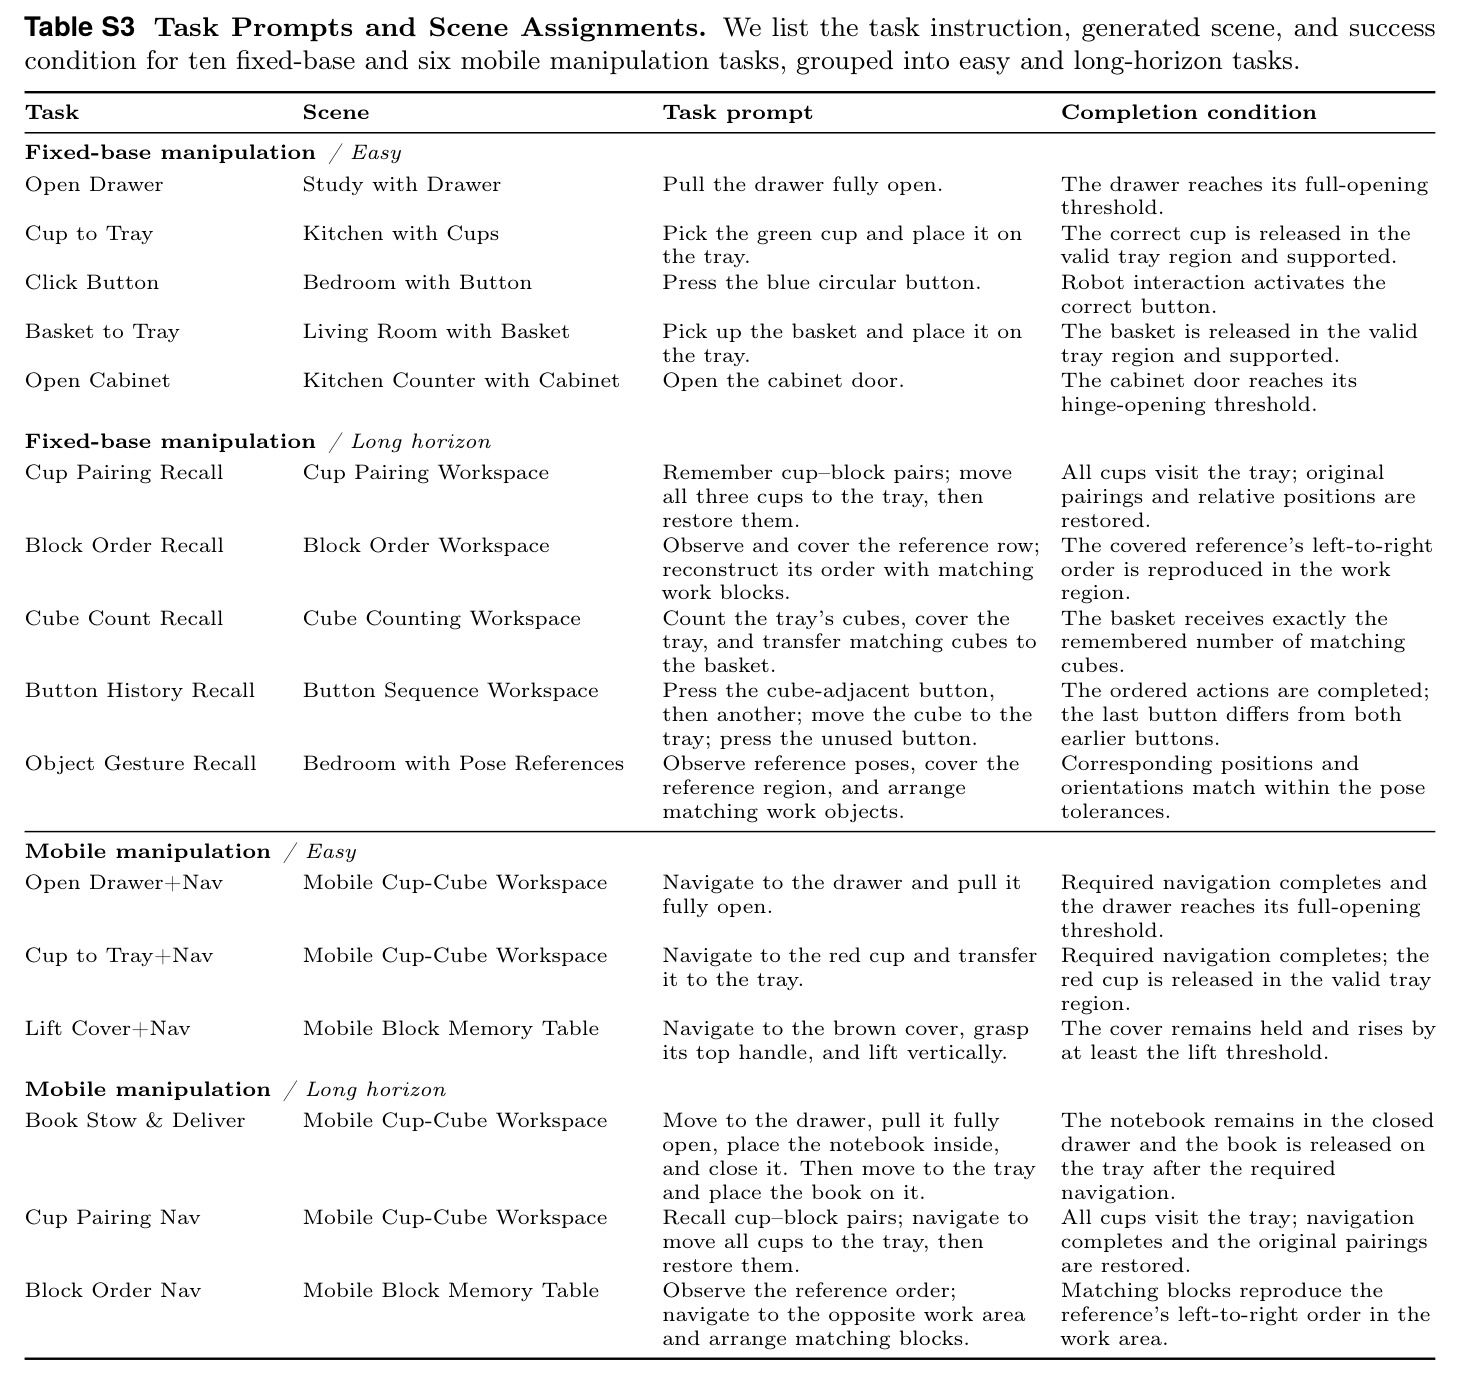
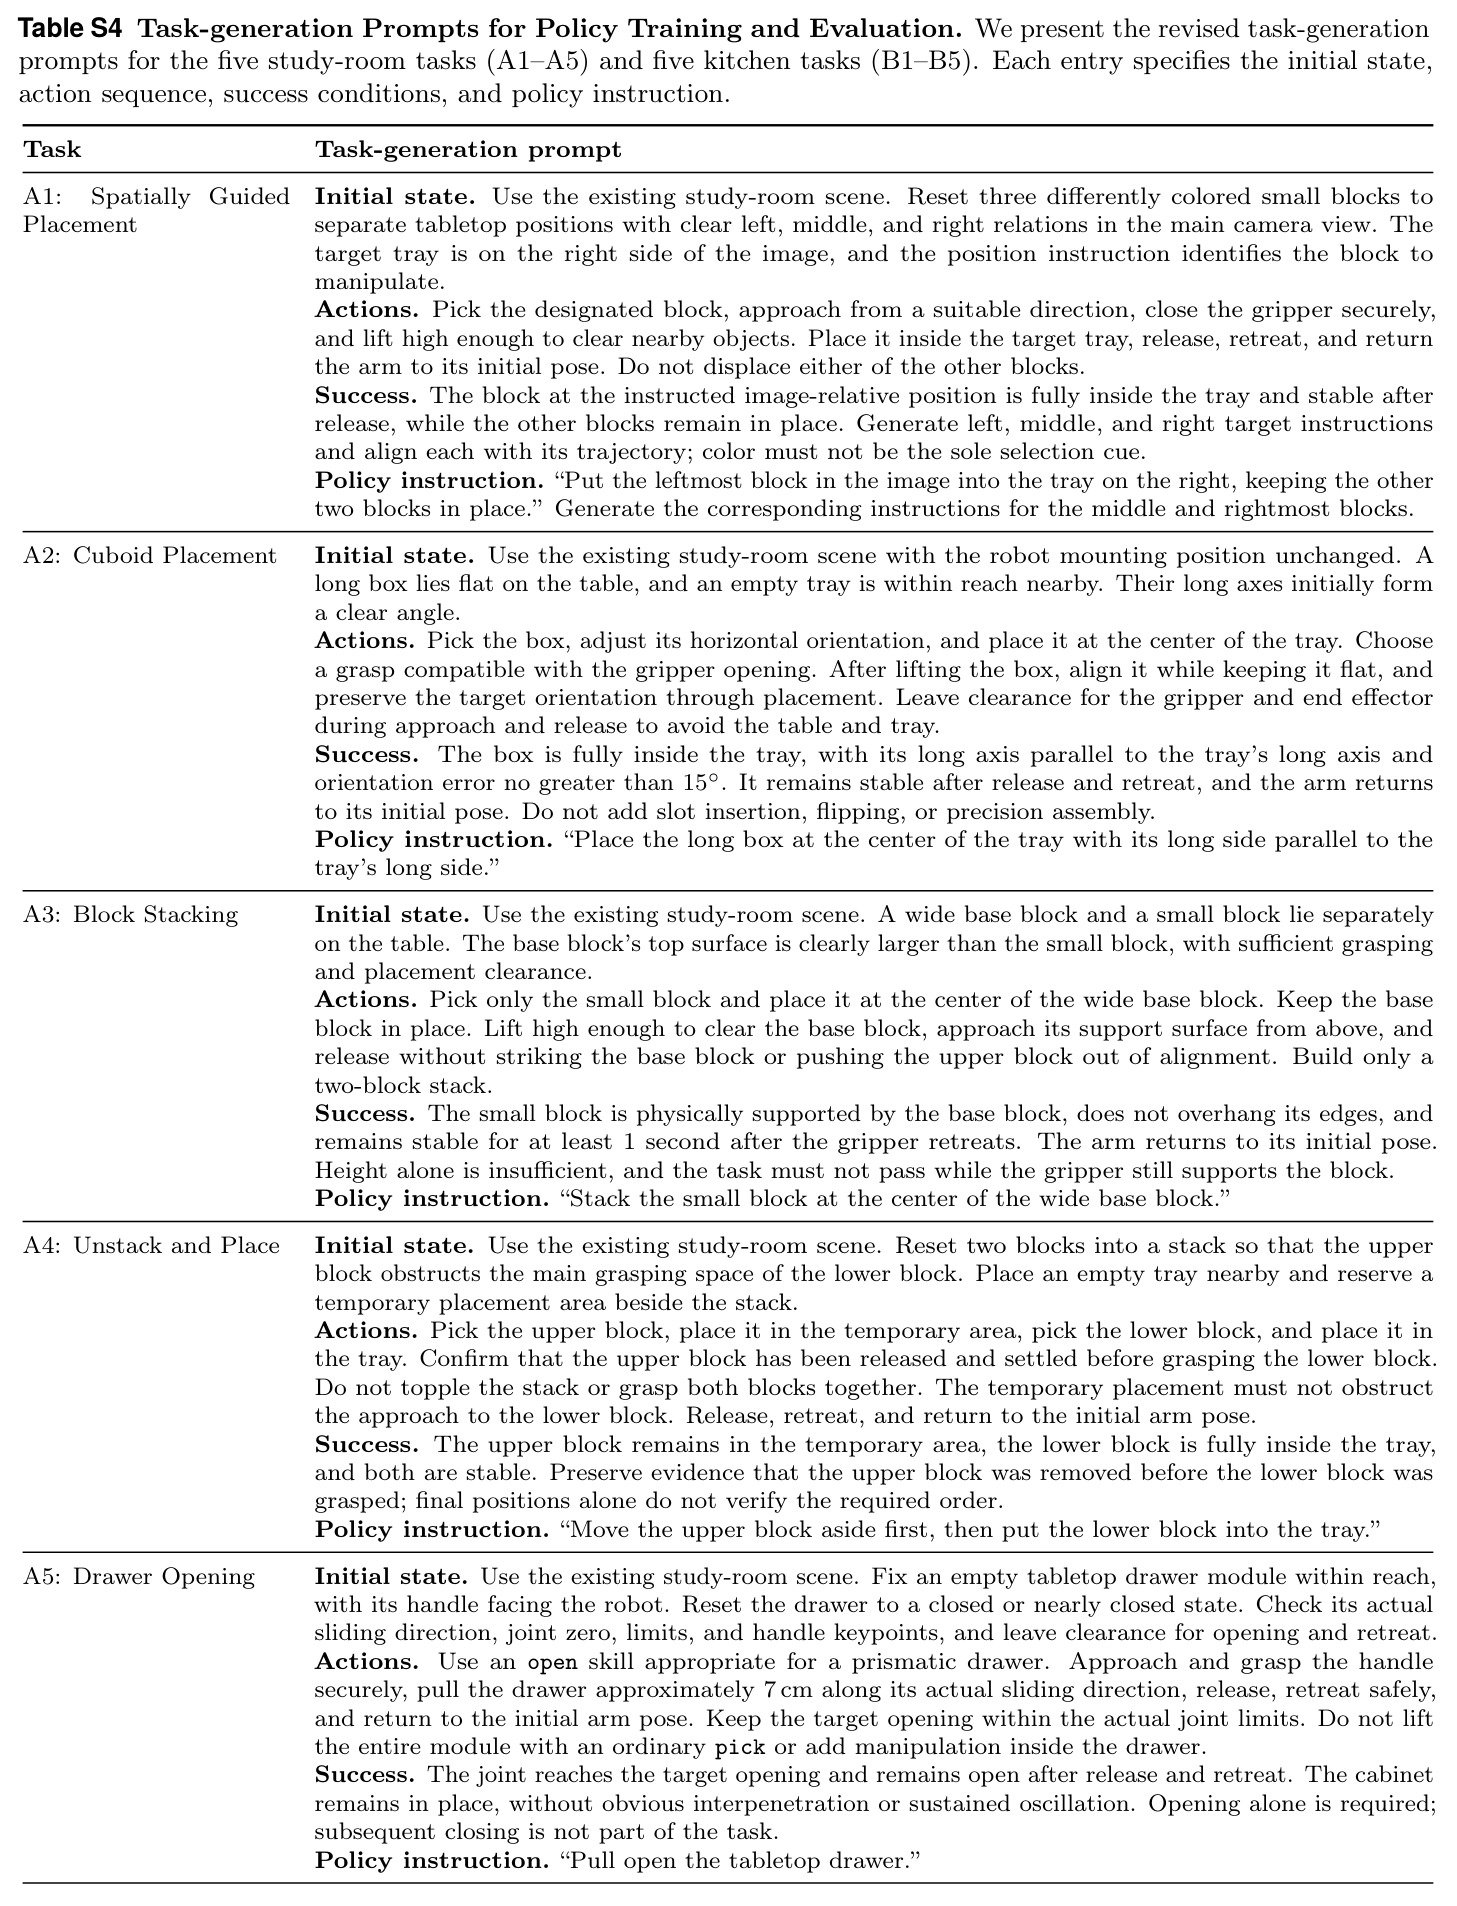
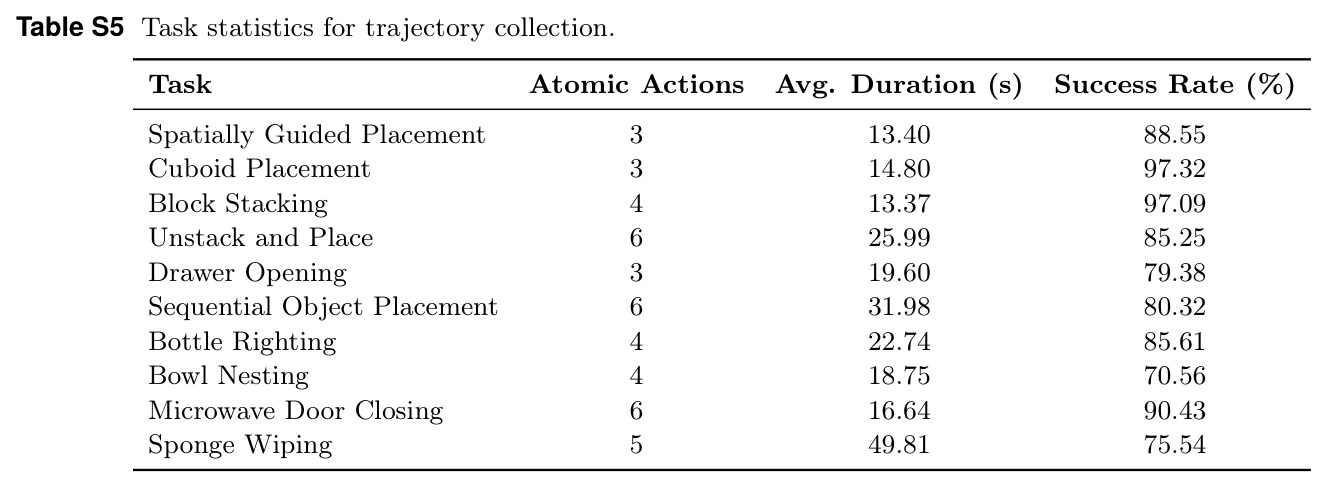
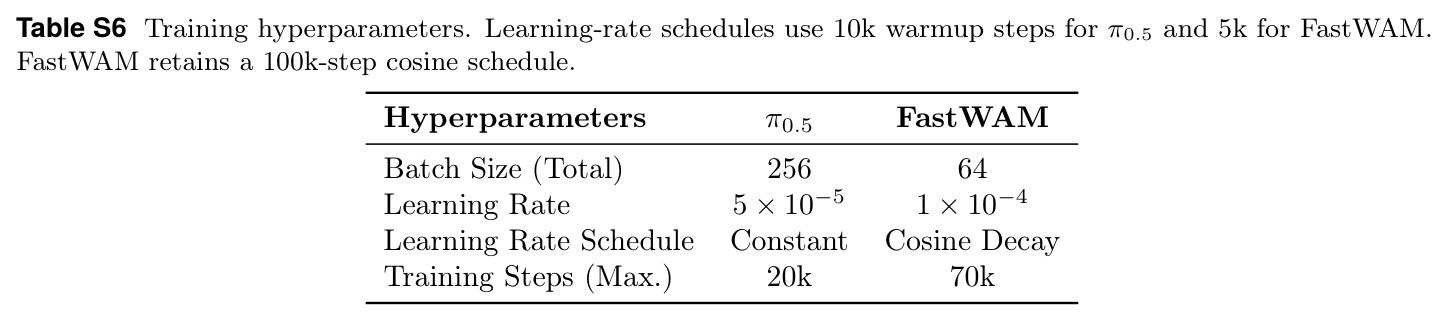
复现评估:论文未声明开源代码或资产库(无代码链接),是最大障碍。有利因素是附录异常详尽:Table S2 给出全部场景 prompt,S3 列出 16 个评估任务的指令与完成条件,S4 给出策略任务生成 prompt,S5/S6 给出收集统计与超参(π0.5:batch 256、lr $5\times10^{-5}$、20k 步;FastWAM:batch 64、lr $1\times10^{-4}$、cosine 70k 步);Isaac Sim、CuRobo、SAM3D、Articraft 公开可得。不利因素:agent 依赖 gpt-5.6-sol、评估依赖 GPT-5.5,均为闭源付费 API 且随版本漂移;资产池、场景规格、随机化配置未公开;每会话平均 4 万 token,16 任务 × 10 会话的 API 开销不菲。算力门槛不高:生成以 API 调用加仿真时间为主,微调单节点多卡即可。综合判断:架构思想可借鉴,但逐位复现定量结果难度高,估计需资深工程师投入数周外加数百至上千美元 API 费用。复现难度:高。
论文图表