基于负策略采样序列的在线策略蒸馏 On-Policy Distillation with Negative-Policy Rollouts
在rollout阶段混入更弱负策略的序列,不改蒸馏奖励即为OPD补上负向信号并全面提升
前置知识
在线策略蒸馏(OPD)
OPD是一种LLM后训练方法:让学生模型 $\pi_\theta$ 对每个问题 $x$ 自己生成序列(rollout),教师在相同前缀 $(x, y_{<t})$ 下逐token给出监督,通过RL式更新把学生拉向教师分布。与在教师生成序列上做SFT的SeqKD不同,OPD在学生自己的分布上训练,减少训练-推理失配、保留学生既有能力,近年被证明可以替代RLVR做推理后训练。
本文的全部改动都建立在OPD框架之上——只有先理解rollout与token级监督这两个要素,才能看懂负策略是从哪个环节被注入的。
token级蒸馏奖励
OPD把蒸馏写成RL形式的逐token奖励 $R^{OPD}_t=\log\pi^*(y_t|x,y_{<t})-\log\pi_\theta(y_t|x,y_{<t})$,即教师与学生对该token对数概率之差:学生采到教师也喜欢的token得正奖励,反之得负奖励,整体梯度以该奖励加权策略梯度。ExOPD、OPD2等近期变体都是在改造这个 $R_t$。
NP-OPD的核心证明是:负策略token的期望 $R^{OPD}_t<0$,因此不动奖励、只换采样来源就能产生'推离'效果;不看懂这个量就无法理解3.2节的推导。
Rollout与rollout策略
Rollout指模型对一个问题自回归采样出的完整回答序列;rollout策略即产生这些序列的模型。OPD中rollout策略就是学生自己(on-policy);本文把它推广为混合分布:以概率 $1-\alpha$ 用学生、概率 $\alpha$ 用负策略 $\pi_n$ 采样。rollout来源决定了训练序列的分布,进而决定哪些token会被教师打分。
这正是本文唯一改动的地方——'负信号从rollout阶段进入'是全文区别于以往奖励层面改进的根本点。
DPO与负样本
直接偏好优化(DPO)利用成对回答 $(y^+, y^-)$,通过 $-\mathbb{E}\log\sigma\big(\beta[\log\tfrac{\pi_\theta(y^+)}{\pi_{ref}(y^+)}-\log\tfrac{\pi_\theta(y^-)}{\pi_{ref}(y^-)}]\big)$ 同时学习'靠近preferred'与'远离rejected'两个方向,其中被拒绝回答常由更弱模型采样得到。负样本提供了显式的'该避免什么'信号。
NP-OPD的负策略概念直接类比DPO中的rejected回答,理解这一对应关系才能明白'负'的确切含义与设计动机。
KL散度
KL散度 $D_{KL}(p\|q)=\mathbb{E}_{y\sim p}[\log p(y)-\log q(y)]$ 衡量两个分布的差异且方向不对称。本文用它刻画三个模型的两两距离:负策略离教师更远、离学生更近,即 $D_{KL}(\pi_n\|\pi^*)>D_{KL}(\pi_n\|\pi_\theta)$,这一假设保证了负策略token的期望蒸馏奖励为负。
3.2节的核心论证(式12)本质上就是一次KL散度的代数变形,是'为什么只换采样就能产生负信号'的数学根据。
GRPO组相对优势
GRPO对每个问题采样一组回答,用组内奖励归一化得到优势 $A_i$,正优势回答被强化、负优势被抑制,天然同时包含正负两种信号,是基于可验证奖励的推理RL的主流算法。
论文用GRPO做结构对比:RL类方法天然拥有负信号,OPD没有——这正是NP-OPD要填补的空缺,也是理解论文动机的关键参照。
研究动机
在线策略蒸馏(OPD)让学生在自己生成的序列上接受更强教师的逐token监督,已成为替代RL后训练的热门方案,但现有OPD的蒸馏目标始终只有一个方向——'模仿教师':教师是唯一的正向参照,训练信号从不显式告诉学生'应该远离什么'。当教师与学生能力差距过大、分布重叠有限时,这种纯正向引导的监督会变得稀薄——在学生与教师分布低重叠的区域,教师信号难以提供足够的学习梯度,先前研究已多次观察到这一现象。例如用Qwen3-30B级教师蒸馏1.7B学生时,大量token位置上教师与学生的偏好几乎不相交,蒸馏信号利用不足。相比之下,DPO通过成对的preferred/rejected回答同时提供'靠近'与'远离'两个方向,GRPO也通过正负优势同时强化正确回答、抑制错误回答,而OPD在结构上缺失了整个负半边。
本文的目标是本文的目标是在完全不修改蒸馏奖励公式的前提下,为OPD补上缺失的负向学习信号。具体包括四点:其一,引入一个能力低于学生的'负策略'模型,把它的生成序列混入训练批次并同样施加教师监督,使其扮演DPO中rejected回答的角色,为学生提供明确的'远离方向';其二,保留OPD原有的教师正向监督与token级奖励,保证方法与现有OPD变体(ExOPD、OPD2等)即插即用地兼容;其三,通过NSP、NOR等可测量的诊断指标验证负信号确实按预期作用——即抑制'负策略比教师更偏好'的token、拉大学生与负策略的分布距离;其四,利用负rollout可离线预生成的特性,顺带降低训练的rollout生成成本。
与已有工作不同的是,现有OPD改进几乎全部集中在修改token级奖励:ExOPD引入参考模型(教师的基座模型)做奖励外推,OPD2利用教师与其预训练基座之间的概率差作为delta信号,另有不确定性加权等方案;另一条线虽修改训练轨迹但目的仍是提升监督质量或效率,如Lightning OPD离线预计算教师信号、Relay-OPD让教师接管失败的学生前缀。这些工作都没有把'采样来源'当作传递负信号的通道。本文的独特切入在于:负信号不必通过奖励设计注入,而可以通过更换rollout策略注入——把一部分序列换成弱模型的生成,让OPD奖励在统计上自然对这些序列给出负期望回报,从而把学生推离负策略。这重新定义了rollout策略在OPD中的角色,且与所有奖励层面的改进正交、可自由叠加。
核心方法
直觉上,OPD像只告诉学生'向老师看齐'却从不说'别学坏榜样';NP-OPD给训练加了一个'反面教材':从同家族容量更小的弱模型(如Qwen3-0.6B之于1.7B学生)采样一部分序列,让教师在同一条序列上逐token打分。由于弱模型的token在教师看来普遍较差,OPD奖励对这些序列的期望值为负,学生便在统计上被推离负策略的生成模式,而教师偏好的token仍会被增强,正向监督不丢失。技术路线上方法极简:保持token级奖励 $R^{OPD}_t=\log\pi^*(y_t|x,y_{<t})-\log\pi_\theta(y_t|x,y_{<t})$ 完全不变,仅把式(1)中学生自己采样改为混合rollout分布 $\pi_{z_x}$:以概率 $1-\alpha$ 从学生采样、以 $z_x\sim\mathrm{Bernoulli}(\alpha)$ 决定的概率从负策略 $\pi_n$ 采样,再沿用RL式策略梯度更新 $\nabla_\theta J^{NP}(\theta)$。$\alpha=0$ 退化为标准OPD,$\alpha=1$ 完全使用负策略序列。全部改动只发生在'序列从哪来'这一处。
核心创新是把负信号的注入点从'奖励'挪到'rollout分布'。作者通过期望梯度分解证明这一改动的效果:$g^{NP}-g^{OPD}=\alpha\big(\prod_{i\le t}\pi_n(y_i|x,y_{D_{KL}(\pi_n\|\pi_\theta)$(负策略离教师比离学生更远,选更弱模型即自然满足),则有 $\mathbb{E}_{y_t\sim\pi_n}R^{OPD}_t=-D_{KL}(\pi_n\|\pi^*)+D_{KL}(\pi_n\|\pi_\theta)<0$,负策略token平均收到负奖励、被抑制。关键在于这是'选择性抑制':token级奖励仍是OPD奖励,凡教师偏好的token即使负策略也偏好照样被增强,因此不破坏OPD原有训练动力学;且负token期望奖励为负的论证对ExOPD、OPD2等新奖励同样近似成立,使方法无需改动任何奖励函数即可叠加。
方法步骤详情
第一步,选定负策略:取与同学族、容量更小、推理更弱的模型——Qwen3-1.7B/4B/8B学生分别配Qwen3-0.6B/1.7B/4B作为负策略,Gemma-4-E4B学生配Gemma-4-E2B;教师按规模与模式选择:思考模式下1.7B学生用Qwen3-8B教师、4B/8B用Qwen3-30B-A3B-Thinking,非思考模式用对应Instruct版。第二步,构造混合批次:每条问题按 $z_x\sim\mathrm{Bernoulli}(\alpha)$ 决定序列由学生(比例 $1-\alpha$)或负策略(比例 $\alpha$)以温度1.0生成,rollout上限16k token,训练集为Math/Science/Code三来源各三分之一共3万题。第三步,对两种来源的序列统一计算蒸馏奖励(OPD、ExOPD或OPD2公式)并施加RL式更新;优化用AdamW、学习率 $5\times10^{-6}$、余弦衰减、warmup 0.1、梯度裁剪1.0、bf16+ZeRO-3,全局batch 256,训练100步。第四步,机制验证:用NSP(式13)统计被抑制token中'负策略比教师更偏好'的比例,用NOR(式14)度量学生在教师与负策略首token分歧点上向教师侧偏移的程度。第五步,效率优化:负策略rollout可离线预生成并全程复用,$\alpha=1$ 时学生侧无需rollout生成。
技术新颖性
技术新颖性体现在三点。其一,注入位置新:首次系统地把rollout来源当作负信号的传递通道,与所有奖励层面的OPD改进(ExOPD、OPD2、不确定性加权等)正交,实验证明叠加后仍有一致增益(如Qwen3-4B思考模式OPD2上再+2.10点),而既有轨迹修改类工作(Lightning OPD、Relay-OPD)从未把rollout用作负参照。其二,机制刻画新:给出式(10)-(12)的梯度分解与KL论证,说明'只换采样、不改奖励'即可产生推离负策略的期望更新,并定义NSP、NOR两个可复用的诊断指标,把'负信号是否生效'从玄学变成可测量量。其三,视角新:作者发现ExOPD与OPD2在on-policy下本身就有更高的NSP,提示近期OPD变体的成功可能部分源于经由教师基座模型引入的隐式负信号,为理解OPD文献提供了统一解释;同时负rollout可预生成复用带来最高2.61×(思考)/4.14×(非思考)的训练加速,兼具新颖性与工程实用性。
实验结果
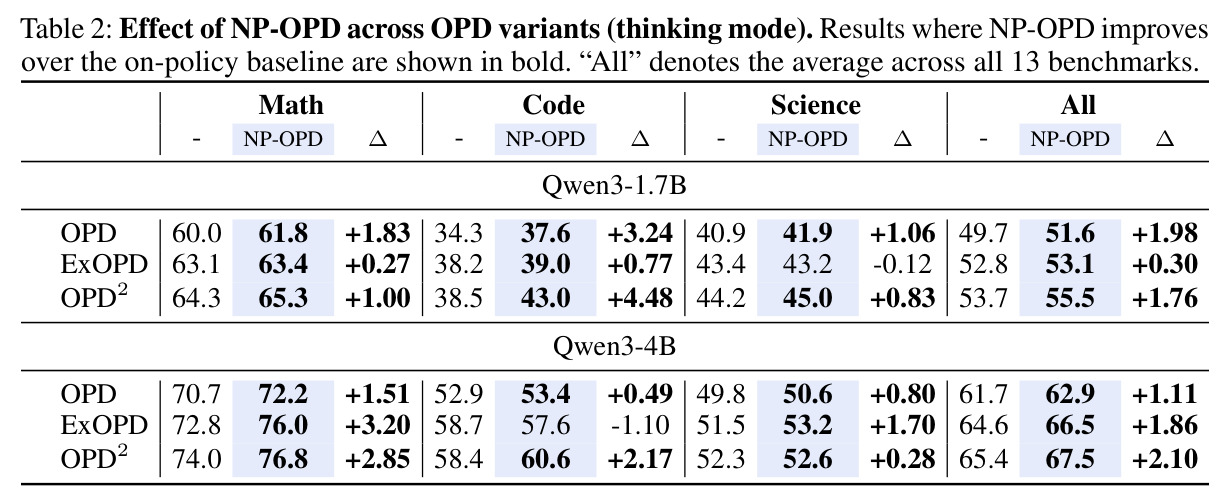
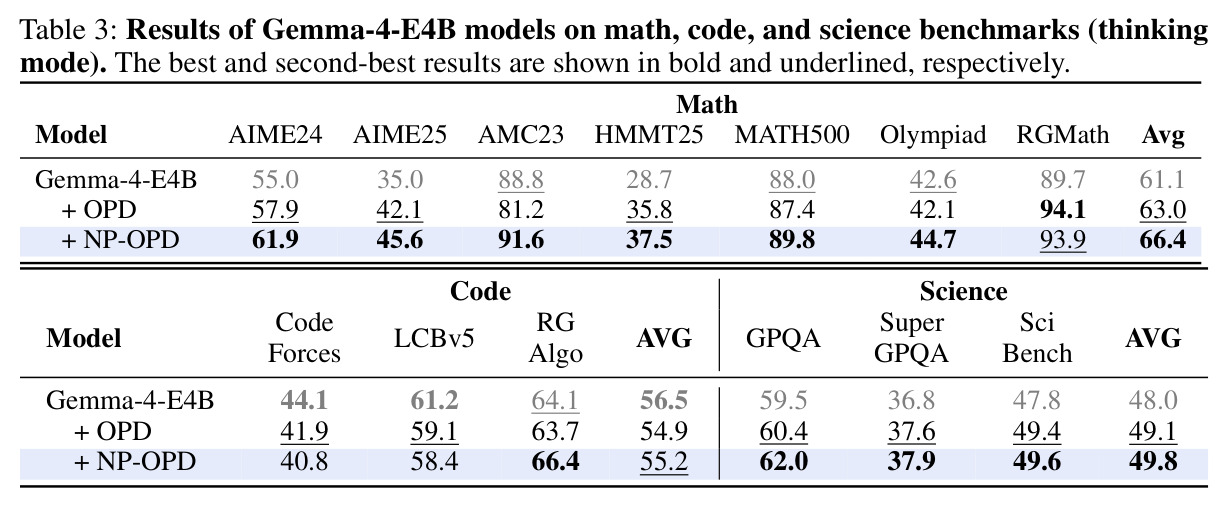
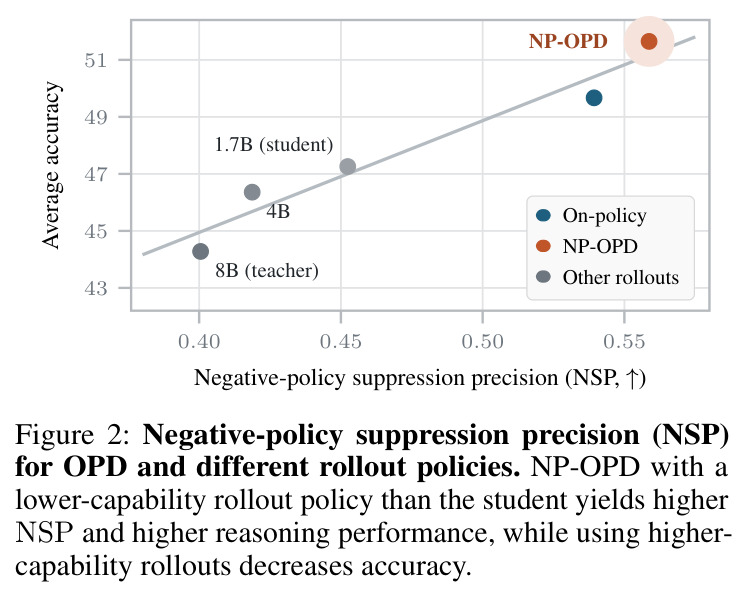
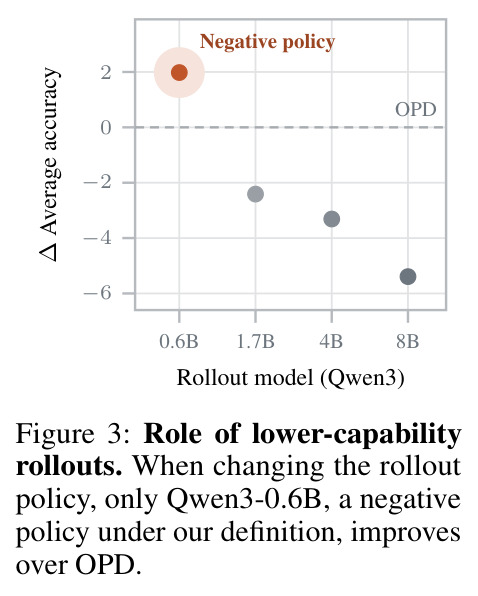
主结果覆盖3个Qwen3学生、思考/非思考两模式、13个基准(数学7、代码3、科学3)。非思考模式(Table 1,$\alpha=1$):Qwen3-1.7B数学均分48.3→56.3、代码27.2→31.1、科学37.2→41.5;Qwen3-4B数学62.2→70.5(AIME24单点53.8→67.9,HMMT25 26.2→43.8)、代码40.2→51.1、科学47.8→51.2;Qwen3-8B数学65.1→69.4。思考模式(Table 2):NP-OPD对三种奖励公式全部有效,1.7B总体均分+1.98(OPD)/+0.30(ExOPD)/+1.76(OPD2),4B分别+1.11/+1.86/+2.10;8B上OPD2均分75.0→77.1(AIME24 73.8→81.7)。跨家族验证(Table 3):Gemma-4-E4B数学63.0→66.4、科学49.1→49.8,但代码54.9→55.2虽略升仍低于未训练基座的56.5。效率上,负rollout复用使1.7B思考模式训练时间9h19m→3h34m(2.61×)、非思考5h15m→1h16m(4.14×)。机制分析(Figure 2-4):NP-OPD的NSP显著高于OPD且与平均准确率强相关;换成1.7B/4B/8B(含教师)做rollout时准确率反而下降,仅0.6B负策略有效;NOR均值NP-OPD 0.019对OPD 0.005,教师rollout为−0.030,held-out提示上0.016对−0.000,方向一致。消融(Table 4):高温1.5、小学生persona、去3层等'自劣化'rollout仅带来+0.9/+1.0/−0.8(均分42.9→43.8/43.9/42.1),远小于独立负策略的+3.4(46.3)。模型合并 $\alpha=0\oplus1$ 在8B ExOPD上数学74.2→76.3、OPD2 75.0→77.4;生成长度方面NP-OPD使4B/8B变短、1.7B略增。
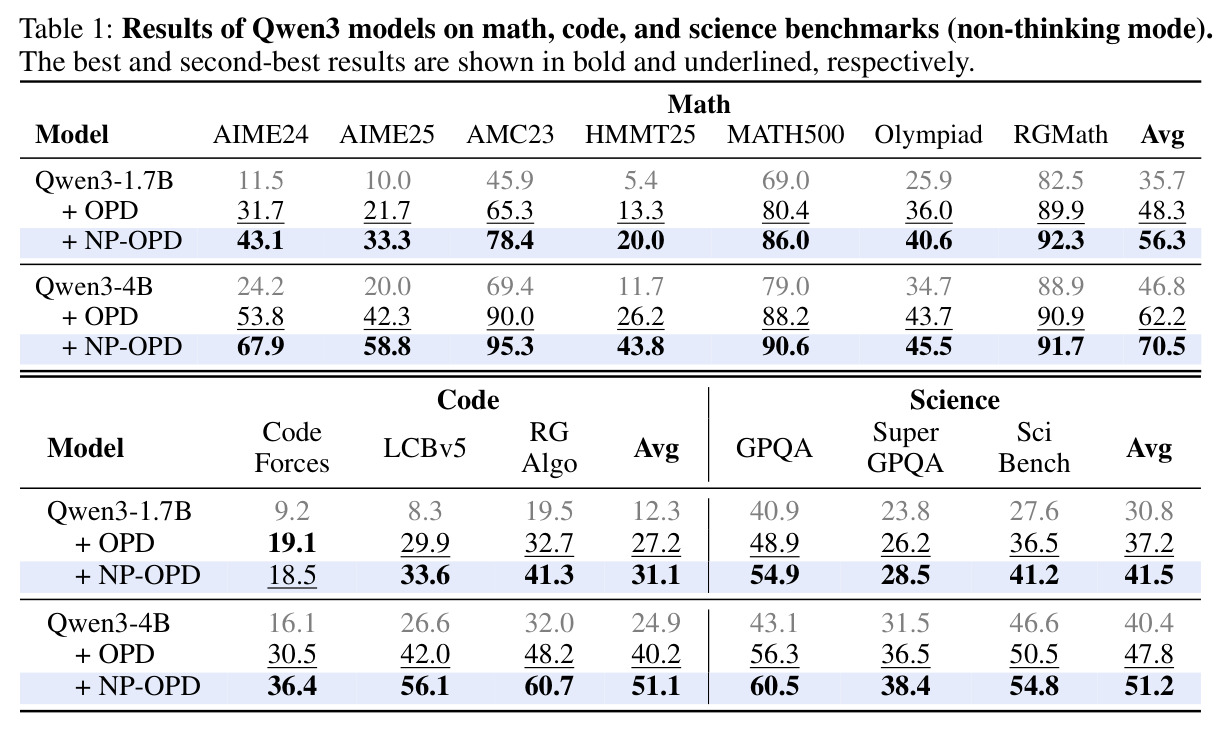
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(Qwen3-1.7B,非思考,α=1) | 7个数学基准平均分 | 56.3 | 48.3(OPD) | +8.0 |
| 数学推理(Qwen3-4B,非思考,α=1) | 7个数学基准平均分 | 70.5 | 62.2(OPD) | +8.3 |
| AIME24(Qwen3-4B,非思考,α=1) | avg@16 准确率 | 67.9 | 53.8(OPD) | +14.1 |
| 代码推理(Qwen3-4B,非思考,α=1) | 3个代码基准平均分 | 51.1 | 40.2(OPD) | +10.9 |
| 13基准总体(Qwen3-1.7B,思考,OPD奖励) | All平均分 | 51.6 | 49.7(OPD) | +1.98 |
| 13基准总体(Qwen3-4B,思考,OPD2奖励) | All平均分 | 67.5 | 65.4(OPD2) | +2.10 |
| 数学推理(Gemma-4-E4B,思考,α=1) | 7个数学基准平均分 | 66.4 | 63.0(OPD) | +3.4 |
| 训练耗时(Qwen3-1.7B,思考模式,α=1) | 单节点8×H100墙钟时间 | 3h34m | 9h19m(OPD) | 2.61×加速 |
局限与改进
作者承认的局限:一是并非所有设置都提升——例如Qwen3-8B非思考α=1时代码均分50.1→48.9、GPQA 60.4→56.8出现下降;Gemma代码两种方法均低于未训练基座(56.5),说明负信号在部分域会挤出正向监督。二是α需要按设置挑选,论文报告的是'在三个域均不差于基线的候选中选总体最高'的代表α,实际使用存在调参成本,且Math/Science偏好α=1而Code偏好中间值。三是思考模式的增益(约+1~2点)明显小于非思考模式(+4~8点)。我自己的观察:其一,负rollout预生成后全程静态复用,随学生进步,负策略的'负性'与学生-负策略重叠度会漂移,α=1时训练本质上是离线的,可能限制更长日程的训练;其二,负策略选择停留在'同学族小一号'的启发式,未探索跨家族弱模型、学生历史checkpoint或EMA学生等更灵活的负参考;其三,核心假设 $D_{KL}(\pi_n\|\pi^*)>D_{KL}(\pi_n\|\pi_\theta)$ 在学生快速变强后可能反转,届时负token期望奖励转正、机制失效,但论文未监测训练中假设的成立情况;其四,主实验未与RLVR(如GRPO)在相同数据与算力下对比,NP-OPD相对强化学习的性价比位置仍不清楚;其五,NSP/NOR机制分析集中在1.7B学生上,更大模型的机制行为未验证,且各设置仅单次训练,方差信息有限。
独立分析的弱点
独立分析的弱点与改进方向:(1) 静态负rollout的陈旧化——预生成序列反映训练初期负策略与学生状态,训练后期分布失配,α=1时学生完全不在自己的分布上训练;改进方向是周期性重采样负rollout,或用学生早期checkpoint/EMA权重在线充当'会成长的负策略'。(2) 域间增益不均——代码域多处下降(8B非思考α=1代码50.1→48.9,Gemma代码低于基座),可能与负策略代码能力过弱、序列噪声过大有关;改进方向是按域设置不同α,或以在线NSP为门控信号动态调节负样本比例。(3) 假设不可见则不可保障——建议训练中持续估计 $D_{KL}(\pi_n\|\pi_\theta)$,当其接近 $D_{KL}(\pi_n\|\pi^*)$ 时自动下调α或更换更弱负策略,形成负参考难度的课程化调度。(4) 缺RL对照——应在同数据同算力下与GRPO等RLVR比较,并测试NP-OPD与RLVR混合的互补性。(5) 实验稳健性——每个配置仅报告单次训练结果,α敏感性结论(大α常更好)在不同学生/模式间并不完全一致,需多seed与更多α网格确认。(6) 负策略仅有'更弱'这一个定义维度,'负'与'错'(如仅在某能力维度弱)之间的关系值得更细致解耦。
未来方向
作者提出的方向:开源代码与预生成负rollout;以'隐式负信号'视角统一解释ExOPD、OPD2等近期OPD变体并指导新奖励设计。基于本文成果可延伸的方向:(1) 动态/可学习负策略——用EMA学生、早期checkpoint或多负策略池(不同弱度)按课程难度调度,把负参考强度变成训练进程的函数;(2) 与RLVR混合——在可验证奖励的RL中混入负策略rollout,检验奖励稀疏场景下负信号的互补价值;(3) 把NSP/NOR从诊断指标升级为训练监控、早停信号乃至直接优化的正则项;(4) 扩展到推理之外的后训练目标,如安全对齐(负策略=越狱倾向模型)与指令跟随;(5) 与Relay-OPD等轨迹修复方法结合,研究'教师修复后的负样本'是否仍保留负信号;(6) 理论上刻画rollout分布形状与蒸馏梯度的关系,例如推导最优混合比例 $\alpha$ 的闭式解或随训练动态调整的调度律;(7) 探索负策略与学生能力差距的最优区间——0.6B对1.7B有效,但差距过大(如0.5B对70B)是否仍有效尚属空白。
复现评估
复现条件较好。代码承诺开源于 github.com/naver-ai/np-opd,并计划一并发布预生成的负策略rollout;所有模型均为公开权重(学生Qwen3-1.7B/4B/8B、教师Qwen3-8B与Qwen3-30B-A3B-Thinking/Instruct、负策略Qwen3-0.6B/1.7B/4B,以及Gemma-4-E4B/E2B/12B);训练数据为3万个公开题目(Math/Science/Code三来源1:1:1混合),无私有数据。算力门槛中等:Qwen实验为单节点8×H100(vLLM并发采样,8B用张量并行TP=4),Gemma用两节点;训练仅100步、全局batch 256、学习率 $5\times10^{-6}$、bf16+ZeRO-3。附录C.1完整给出优化器、warmup、梯度裁剪、KL正则系数(Qwen为0、Gemma为0.04)与评测协议(Evalchemy与lm-evaluation-harness,AIME24/25取avg@16、AMC23/HMMT25/MATH500/GPQA取avg@8、其余avg@3)。主要难点是多奖励变体×多α的完整消融矩阵算力开销大(附录跑了30余组训练);若只复现主结论(单一学生、标准OPD奖励、α=1),一到两个8×H100节点日内可完成;NSP/NOR机制分析只需推理即可复现,额外成本很低。
论文图表
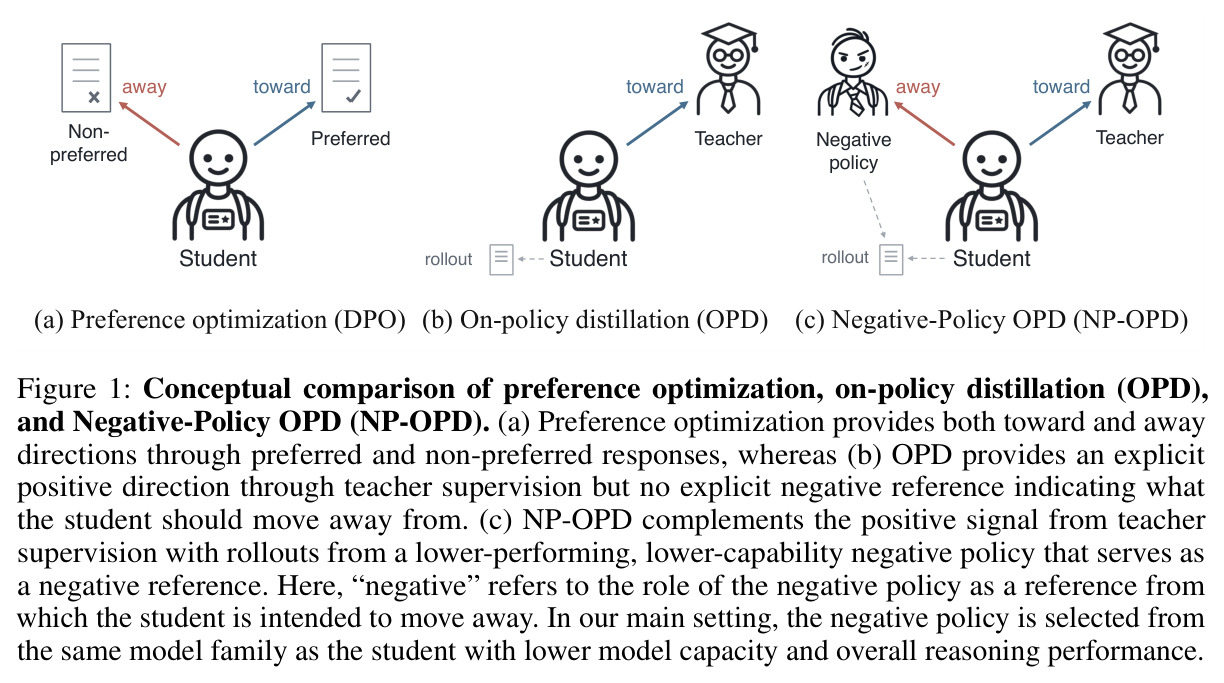
三栏概念对比图:(a) DPO通过preferred与非preferred回答同时提供'toward(靠近)'与'away(远离)'两个方向;(b) OPD只有教师监督提供的正向方向,没有显式的负参照;(c) NP-OPD在保留教师正向信号的同时,混入低能力负策略的rollout作为负参照,学生被引导远离负策略的生成模式。
一张图讲清论文的动机与定位:OPD在结构上缺失负信号、NP-OPD如何在rollout层面补上它,是与DPO/OPD对比的最佳入口。
轨迹级NOR散点图,每点比较OPD(y轴)与替代rollout(x轴)下的重叠削减:(a)负rollout训练时大多数点位于对角线下方,NP-OPD均值0.019对OPD的0.005;(b)教师rollout均值−0.030反而低于OPD,效果相反。
从分布重叠角度证实学生确实被推离负策略、靠近教师,且教师rollout会产生反向效果,是机制论证的核心证据。
三种奖励公式(OPD/ExOPD/OPD2)在on-policy训练与NP-OPD下的NSP对比:ExOPD与OPD2本身的NSP已高于标准OPD,叠加NP-OPD后NSP进一步升高,且平均准确率随之继续提升。
支撑第5节的统一视角——近期OPD变体的成功可能部分源于经由教师基座模型引入的隐式负信号,是论文最具启发性的分析。
对比学生'自劣化'rollout方案(Qwen3-1.7B学生、Qwen3-8B教师、思考模式):温度升至1.5、小学生persona提示、去掉最后3层分别使均分42.9→43.8/43.9/42.1(+0.9/+1.0/−0.8),而独立负策略(NP-OPD)达46.3(+3.4)。
回答'能否不引入额外模型、靠劣化学生自己制造负样本':简单劣化部分有效但远不够,凸显独立低能力负策略的必要性。
不同负rollout比例α下的墙钟训练时间:α从0增至1时,思考模式9h19m→3h34m(2.61×加速),非思考模式5h15m→1h16m(4.14×),训练时间随α增加单调下降。
量化NP-OPD独有的工程红利——负rollout可离线预生成并复用,这是相对其他OPD奖励改进的额外实用优势。
把Figure 4的NOR分析扩展到0.6B/1.7B/4B/8B四个rollout模型:均值NOR从0.019(0.6B负策略)单调降至−0.014(1.7B)、−0.023(4B)、−0.030(8B教师),仅0.6B高于OPD基线的0.005。
补充证据链:负参照效应随rollout模型能力增强而单调消失,与Figure 3的性能趋势互相印证,说明效应确实来自'负性'而非换采样本身。
在300条从未参与训练的held-out提示(取自AIME、GPQA、CodeForces等9个基准)上重复NOR分析:负rollout均值0.016对OPD的−0.000,教师rollout为−0.034,趋势与训练提示上完全一致。
说明'推离负策略'的效应泛化到未见样本,不是对训练提示的过拟合,加强了机制结论的外部有效性。