何时需要在线策略蒸馏:基于离线学生轨迹的蒸馏往往更优 When Do We Need On-Policy Distillation? Distilling on Offline Student Rollouts Is Often Better
提出Semi-OPD,用初始学生的离线轨迹蒸馏,14/17组师生对上胜过在线蒸馏并提速至11.4倍
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
一种向小模型迁移大模型能力的后训练方法:每个训练步都由当前学生自己采样生成回答(rollout),教师模型在这些学生自生成的 token 上提供逐 token 密集监督(如师生概率比)。因训练数据始终来自学生自身的访问分布,它与强化学习的在线策略采样同源,接近模仿学习中的 DAgger 思想。
本文的全部问题都围绕 OPD 展开:它是否总是必要、何时失效、为什么失效。不理解 OPD 的训练循环(采样—打分—更新)就无法理解 Semi-OPD 改掉了哪个环节。
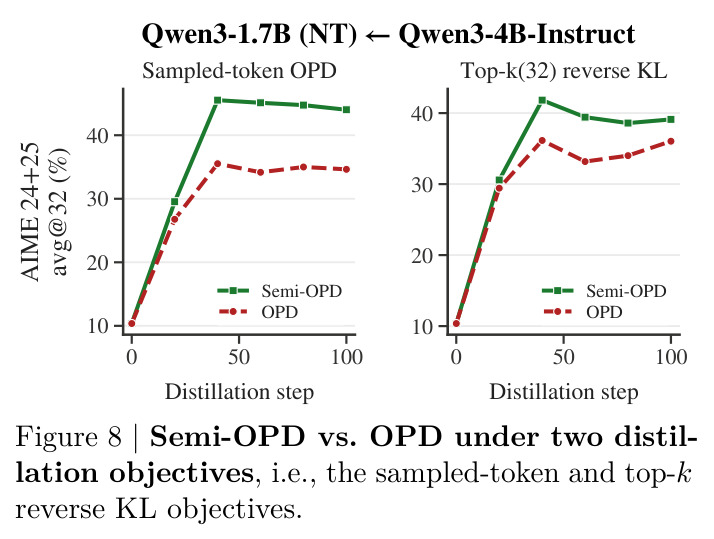
采样 token 反向 KL 目标(Sampled-token Reverse KL)
序列级蒸馏要最小化师生反向 KL,但全词表计算太贵;实用做法是只在学生采样的 token 上算局部目标 $\sum_t -A_t\log\pi_\theta(y_t|s_t)$,优势 $A_t=\log\pi_T-\log\pi_\theta$ 视为常数。
Semi-OPD 的训练目标与 OPD 完全相同,唯一区别是采样 $y\sim\pi_\theta$ 变成了 $y\sim\pi_0$(初始学生)。明确目标函数才能看清两者只差在数据来源上。
曝光偏差(Exposure Bias)
传统离线蒸馏用教师生成的固定数据训练学生,但推理时学生要面对自己生成的历史,一旦生成出训练分布之外的前缀,后续预测容易雪崩式出错。OPD 通过在学生自己的 rollout 上训练来消除这种训练—推理分布失配,这是它被认为优于离线蒸馏的核心理由。
本文的关键论点是:消除曝光偏差(学生侧在线性)只是有效蒸馏的必要条件之一,还必须保证监督信号贴近教师分布(教师侧在线性)。Semi-OPD 正是在两者间做交换。
初始 top-K 输出 token 重叠率
衡量师生初始对齐度:在初始学生 rollout 每个位置 $t$,取学生与教师的 top-$K$ token 集合 $S_K(t)$、$T_K(t)$,计算 $|S_K(t)\cap T_K(t)|/K$ 并对响应 token 加权平均,默认 $K=64$。完全一致则为 1,不相交则为 0。
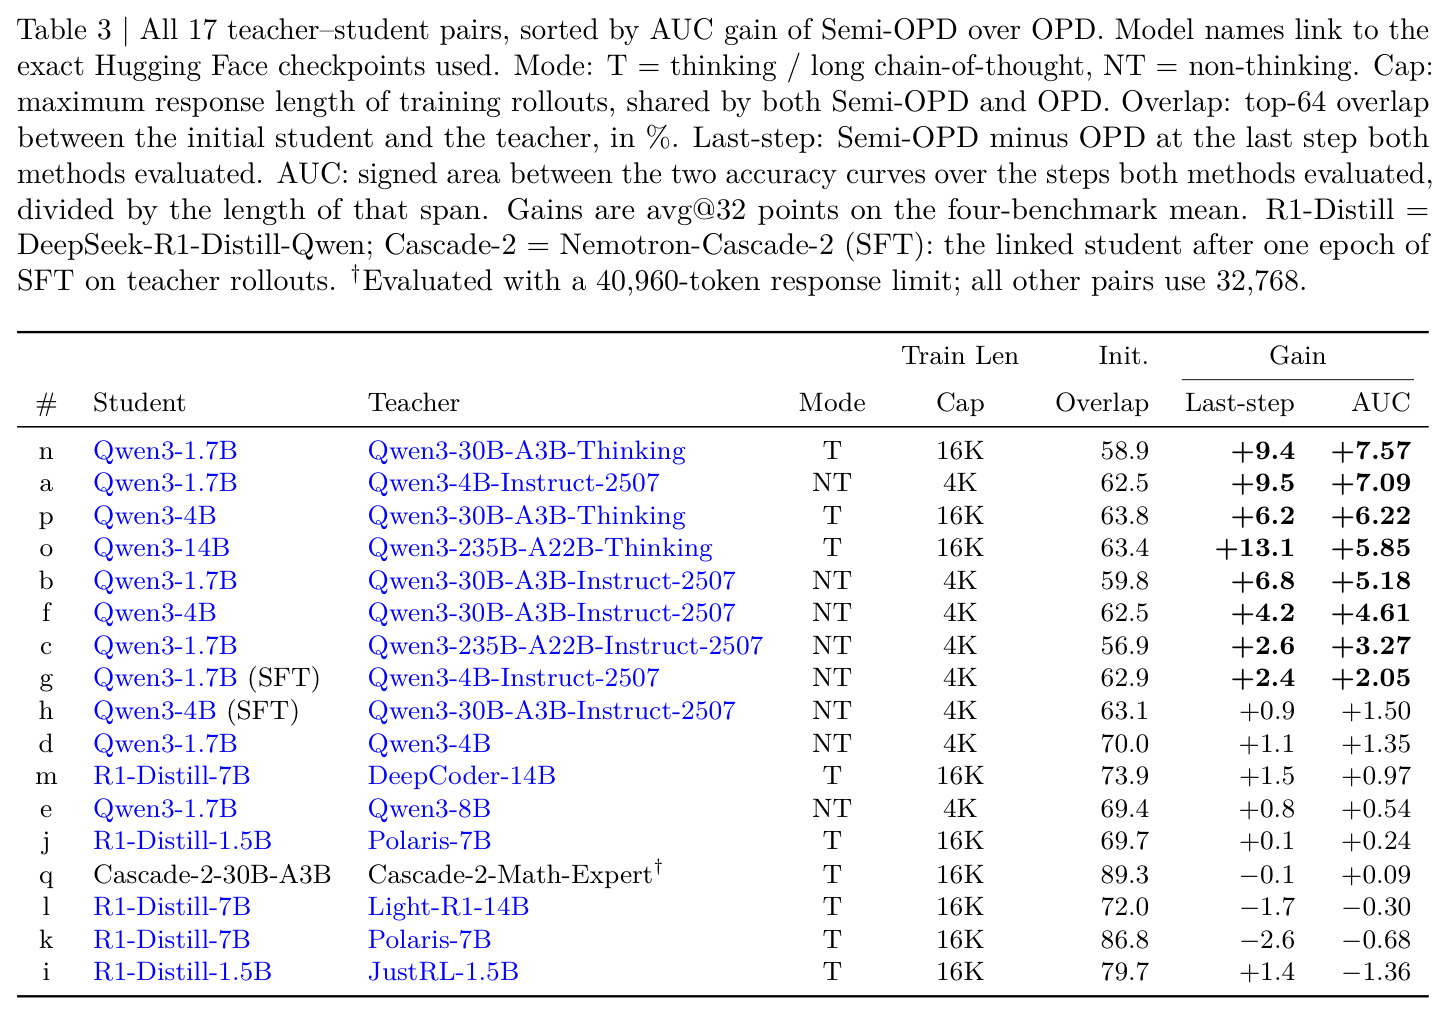
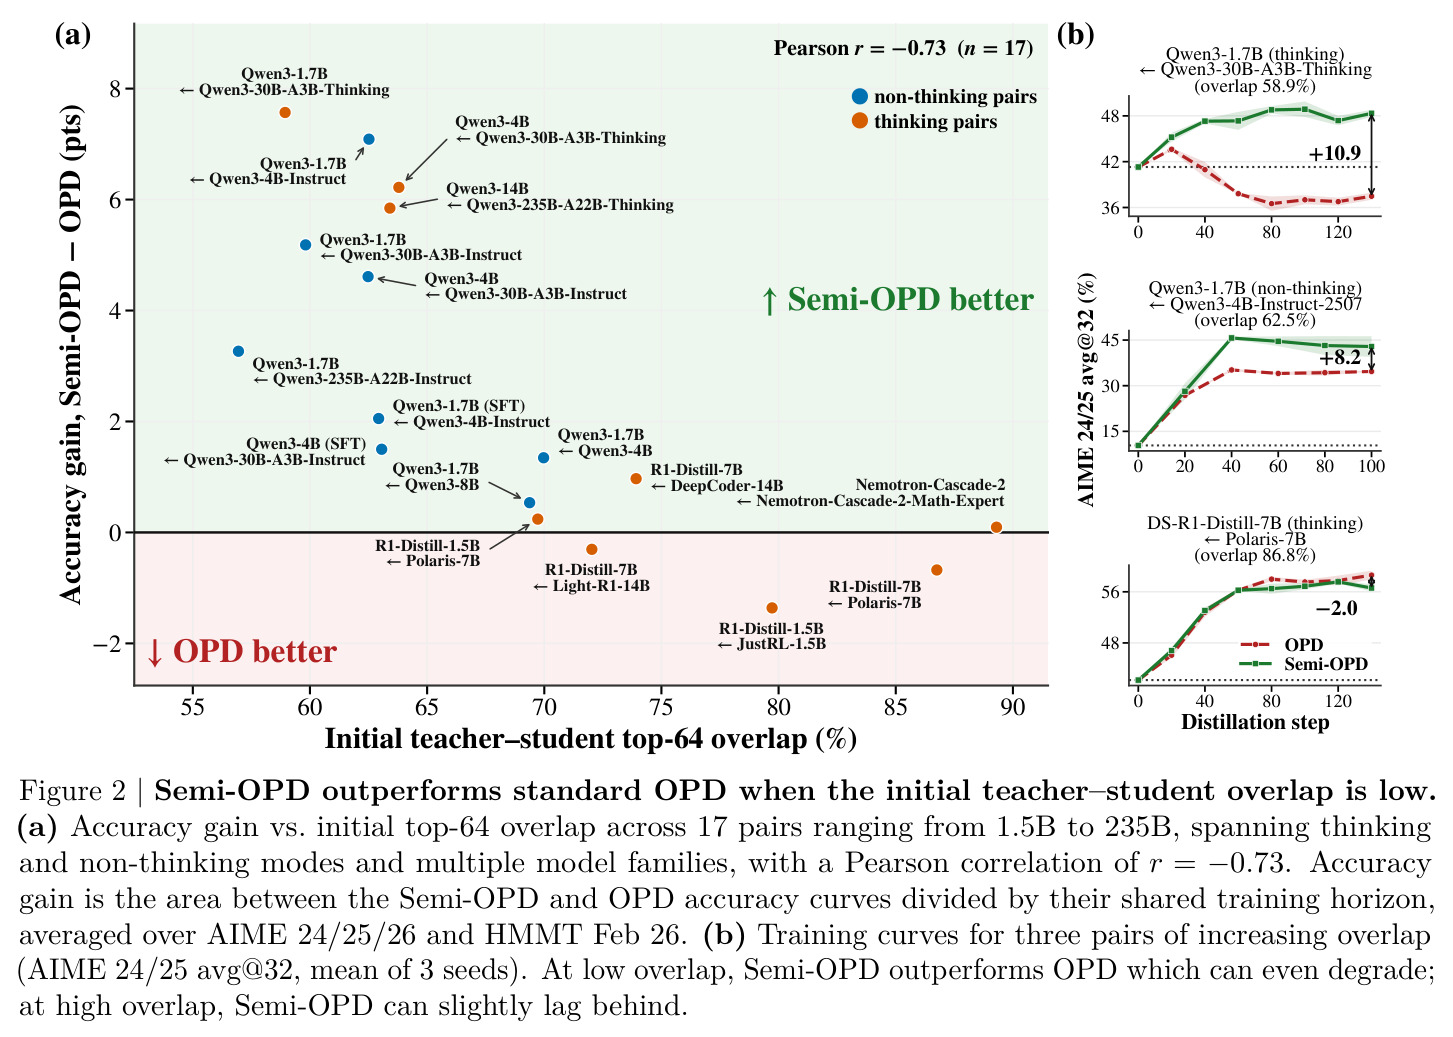
这是全文的选型判据:17 组实验证明该指标与 Semi-OPD 相对 OPD 的增益呈强负相关(Pearson $r=-0.73$),可以在训练前用一次前向就预测该用哪种方法。
avg@k 评测协议
竞赛级数学基准(如 AIME、HMMT)单次采样方差极大,因此对每道题用温度 1.0 独立采样 $k$ 次(本文 $k=32$),取平均正确率作为该题得分,再对所有题求平均。响应长度上限设为 32k token(Nemotron 对为 40k)。
论文所有精度结论都以 AIME 2024/2025/2026 与 HMMT February 2026 四个基准的 avg@32 均值报告,理解该指标才能正确解读表中数字的含金量。
研究动机
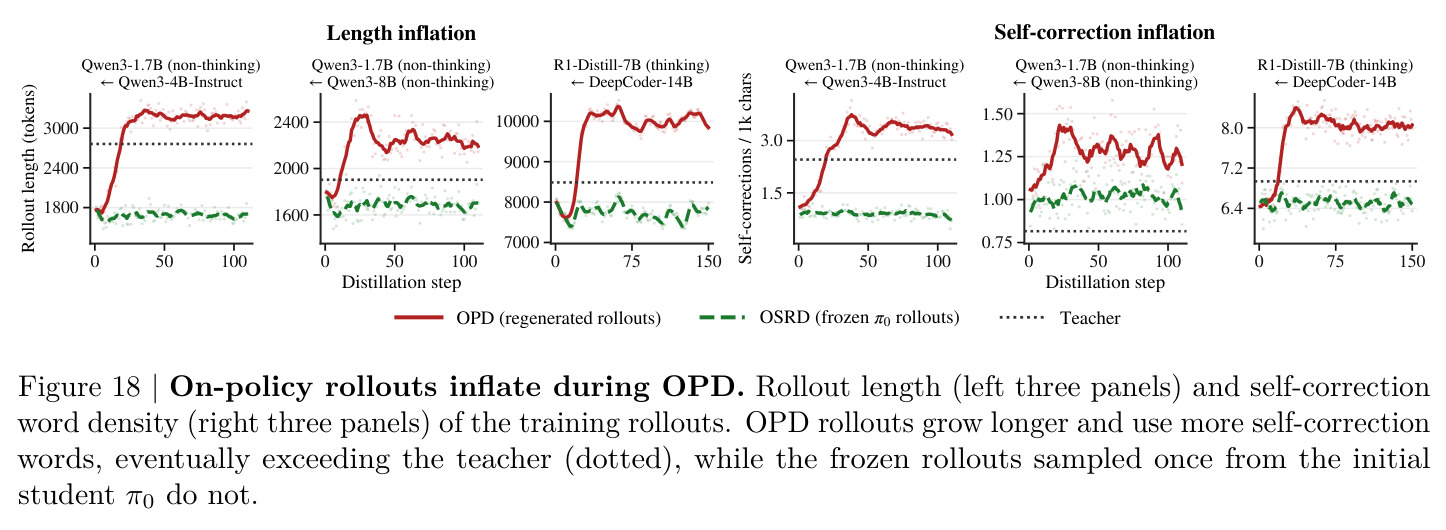
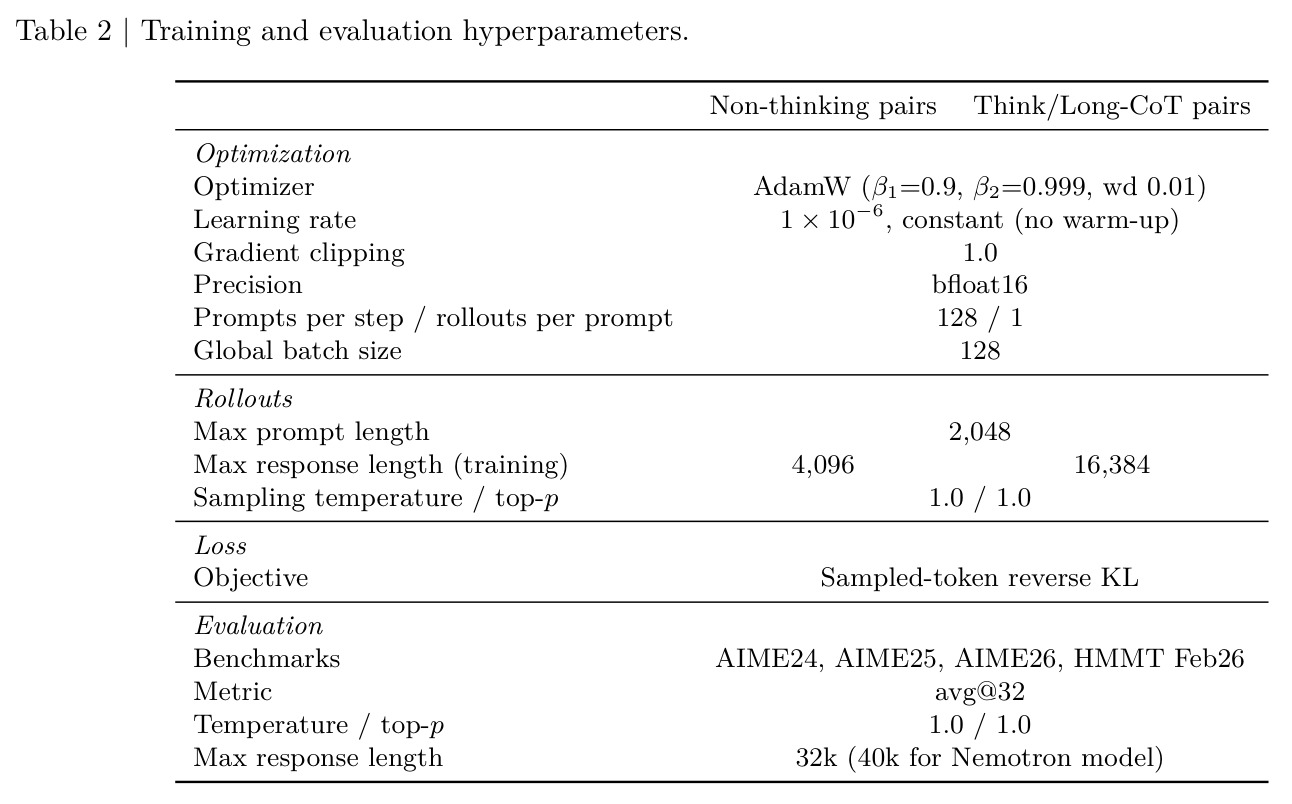
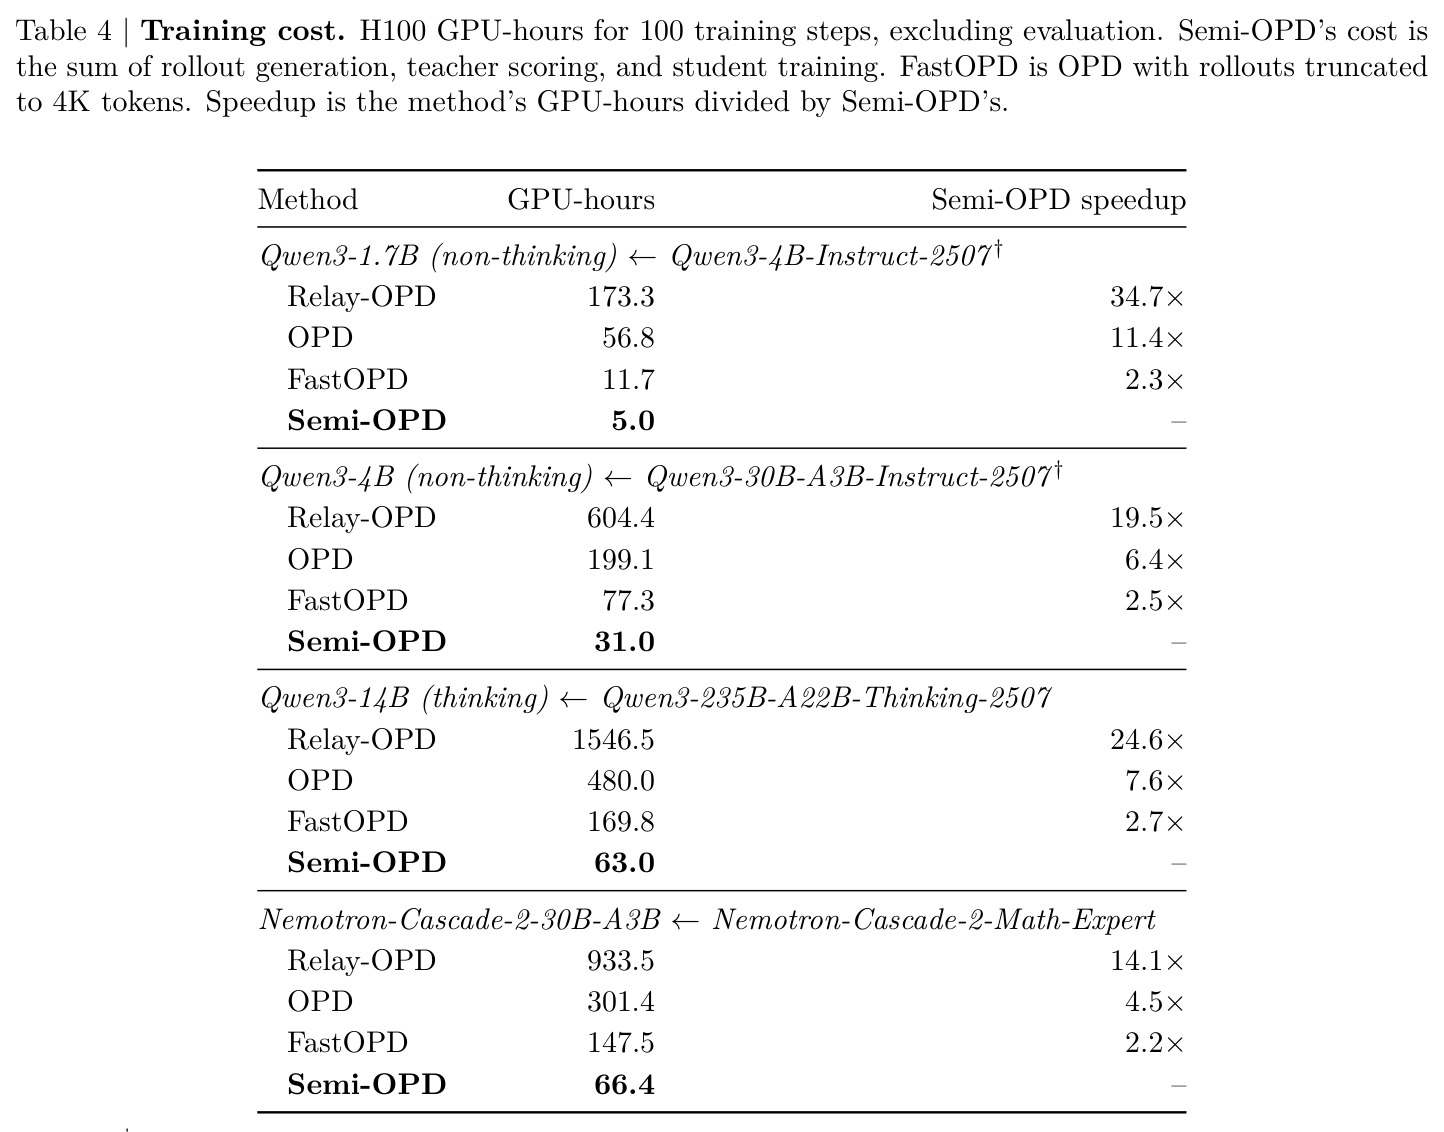
在线策略蒸馏(OPD)虽被视为向学生模型迁移教师能力的有效范式,但近年研究暴露出一系列顽疾:学生自生成的 rollout 在训练中不断变长、陷入“wait—自我纠正”的死循环,直到耗尽生成长度都不输出 EOS 终止符;而且一旦学生在推理早期走错方向,后续 token 上来自教师的监督信号就变得不可靠甚至有害,已有工作发现对后段 token 的监督常常无益、只训前缀就够。既有修补手段(截断 rollout、教师生成中插手、教师数据 SFT 热启动)都只在少数模型对上验证。更关键的是,几乎所有工作都默认“在线采样必然有益”:一次 100 步的 OPD 训练,1.7B 学生需要 56.8 个 H100 GPU 时,14B 学生蒸馏自 235B 教师更高达 480 GPU 时,其中大量算力花在反复重生成 rollout 和教师前向上。社区始终缺少对“到底何时才需要在线采样”的系统性回答。
本文的目标是本文想回答一个直白但被长期忽视的问题:对任意教师—学生组合,在线采样是否总是有益?具体目标有三层。其一,构造一个尽可能简单、且训练目标与 OPD 完全一致的替代方案 Semi-OPD:训练开始前从初始学生一次性采样全部 rollout 并全程复用,使 rollout 生成与教师打分都变成离线步骤,训练循环里只剩学生更新。其二,在 17 组覆盖真实使用场景的教师—学生对(1.5B 到 235B 参数、thinking 与 non-thinking 两种模式、Qwen3/R1-Distill/Nemotron-Cascade-2 三个模型家族)上系统对比两者的精度与效率。其三,给出一个可操作的选型判据,告诉实践者何时该用 OPD、何时 Semi-OPD 更优,并从机制上解释差异为何出现,呼吁社区在 OPD 研究中认真挑选手头可用的师生对。
与已有工作不同的是,本文的独特切入是把“对学生的在线性”和“对教师的在线性”拆成两个独立维度来分析:有效蒸馏要求训练数据既贴近学生自身分布(避免曝光偏差),又落在教师自信、偏好的高概率区域(保证监督有效),而 OPD 只优化了前者、却可能牺牲后者。作者引入初始 top-64 输出 token 重叠率作为对齐度量,用 17 个模型对证明它与学生 rollout 动态何时失效强相关(Pearson $r=-0.73$)。与 Lightning OPD 把固定 rollout 纯粹当工程加速不同,本文证明冻结 rollout 在低重叠场景下还能提升精度;与 Relay-OPD、Speculative KD 在生成时交错师生不同,Semi-OPD 干脆取消一切在线生成,是形式上最简单的“半在线”方案,并附带给出 SFT 热启动有害、轨迹全程覆盖必要等一系列机制性证据。
核心方法
直觉上,Semi-OPD 把“数据从哪来”和“信号怎么算”解耦:数据只采一次、全程不变,但每个训练步上教师和学生的逐 token 对数概率都用当前参数重新计算,因此监督信号仍随训练演化,并非退化为普通离线 SFT。形式化地,先用初始学生 $\pi_0$ 对每个提示采一条回答构成固定数据集 $\mathcal{D}_0=\{(x_i,y_i)\}$,$y_i\sim\pi_0(\cdot|x_i)$,再最小化与 OPD 完全相同的目标 $$\mathcal{L}=\mathbb{E}_{(x,y)\sim\mathcal{D}_0}\big[\textstyle\sum_t -A_t\log\pi_\theta(y_t|s_t)\big],$$ 其中优势 $A_t=\log\pi_T(y_t|s_t)-\log\pi_\theta(y_t|s_t)$ 在梯度中视为常数。流程解耦为 rollout 生成、教师打分、学生训练三个独立阶段,每阶段可占满整个 GPU 集群,无需像 OPD 那样在在线生成、教师服务与训练间切分资源。
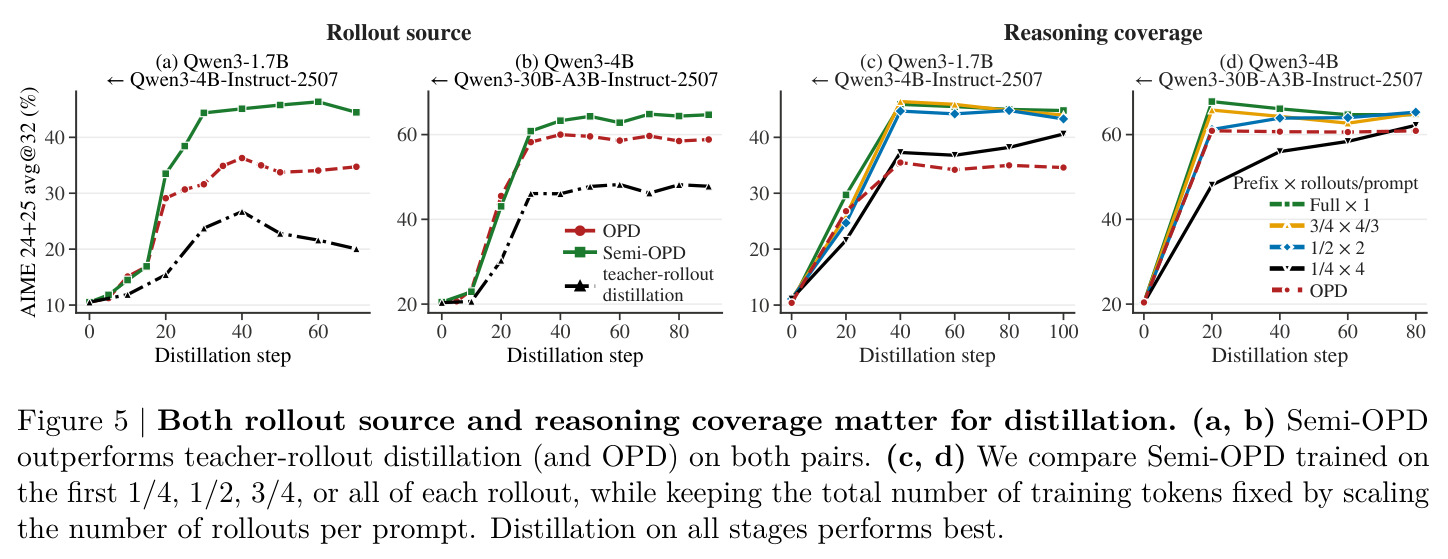
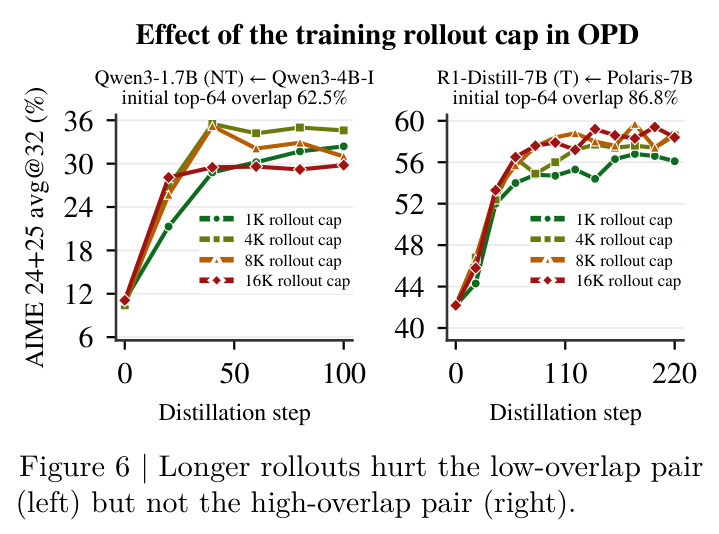
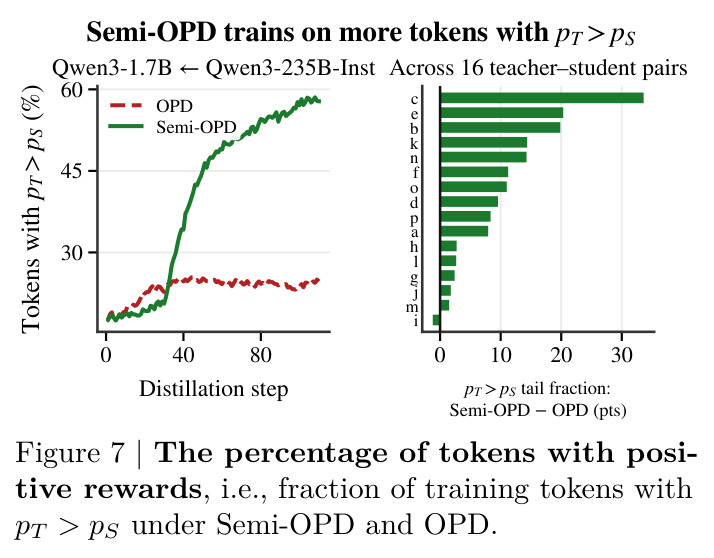
核心创新是把“在线策略”从默认配置变成一个需要论证的设计选择。OPD 每步从当前学生 $\pi_\theta$ 重新采样,Semi-OPD 则冻结初始学生的 rollout,从而牺牲一部分学生侧在线性,换取更强的教师侧在线性:在低重叠(师生差异大)场景下,OPD 中学生自生成的轨迹随上下文变长会越来越偏离教师分布,教师在这些后段 token 上的监督低效甚至有害;而初始学生的 rollout 更短、且完整覆盖从起点到终点的全部推理阶段,天然更贴近教师偏好。作者进一步证明这一权衡可被初始 top-64 重叠率定量预测:重叠高的对(如 Nemotron-Cascade-2 的 89.3%)OPD 才有增量价值;重叠低时 Semi-OPD 又快又好。这把方法选型从经验摸索变成一次可在训练前完成的低成本测量。配套的消融(教师 rollout 蒸馏更差、只训前 1/4 轨迹收敛更慢、加长 rollout cap 伤害低重叠对)共同支撑了这个“双在线性”理论。
方法步骤详情
流程分四步。第一步,对齐度量:在初始学生 rollout 上逐位置计算 $\mathrm{Overlap}@K(t)=|S_K(t)\cap T_K(t)|/K$($K=64$),按 token 加权平均得到初始重叠率,据此选型。第二步,离线生成:用初始学生在 DAPO-Math-17K 的 14,116 条去重提示上每条采一条回答(128 条/步、约 110 步一个 epoch),non-thinking 对训练响应上限 4K token、thinking 对 16K,温度 1.0。第三步,教师离线打分:对冻结 rollout 一次性算出教师逐 token 对数概率。第四步,训练学生:AdamW、恒定学习率 $1\times10^{-6}$、全局 batch 128、bfloat16,目标为采样 token 反向 KL;评测在 AIME 24/25/26 与 HMMT Feb 26 上做 avg@32。OPD 基线按相同顺序读相同提示,保证两法每步提示一致。工程上用 NeMo-RL 训练、vLLM 生成。
技术新颖性
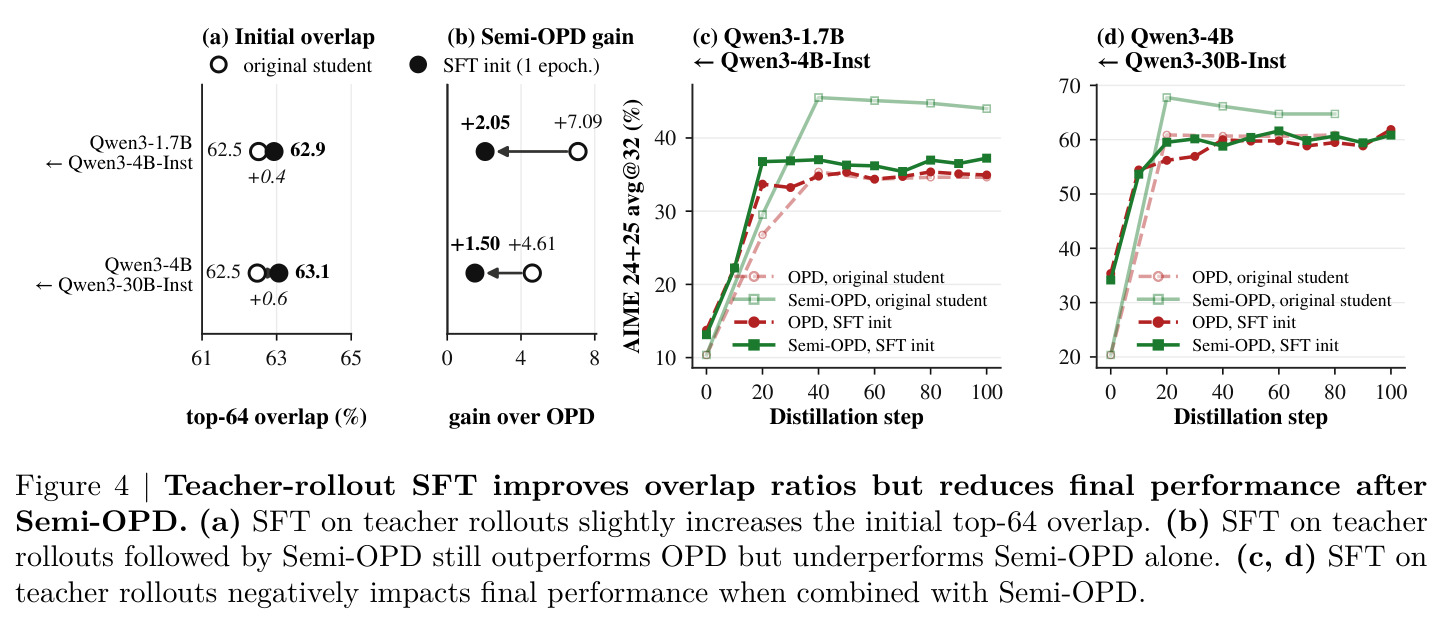
相比已有方案的差异非常清晰。Lightning OPD 同样离线化 rollout,但它从 base 模型出发,必须先在教师 rollout 上做一 epoch SFT 才能获得可用的初始策略;本文从指令微调学生出发,并实证表明这层 SFT 会轻微提高重叠率(62.5%→62.9%/63.1%)却显著降低最终收益(Semi-OPD 增益从 +7.09/+4.61 掉到 +2.05/+1.50),因此应当去掉。FastOPD 用截断到 4K 前缀的方式压制长轨迹问题,但本文的截断消融显示在固定 token 预算下只训前 1/4 轨迹收敛最慢、峰值最低,覆盖全部推理阶段的监督不可省。Relay-OPD 与 Speculative KD 靠训练中交错师生生成拉近分布,代价高昂(比 Semi-OPD 慢 14.1–34.7 倍)。此外,“重叠率决定选型”与“OPD 收敛到由 rollout 分布决定的均衡”这两个发现本身就是对 OPD 机制研究的新贡献,而非单纯提效。
实验结果
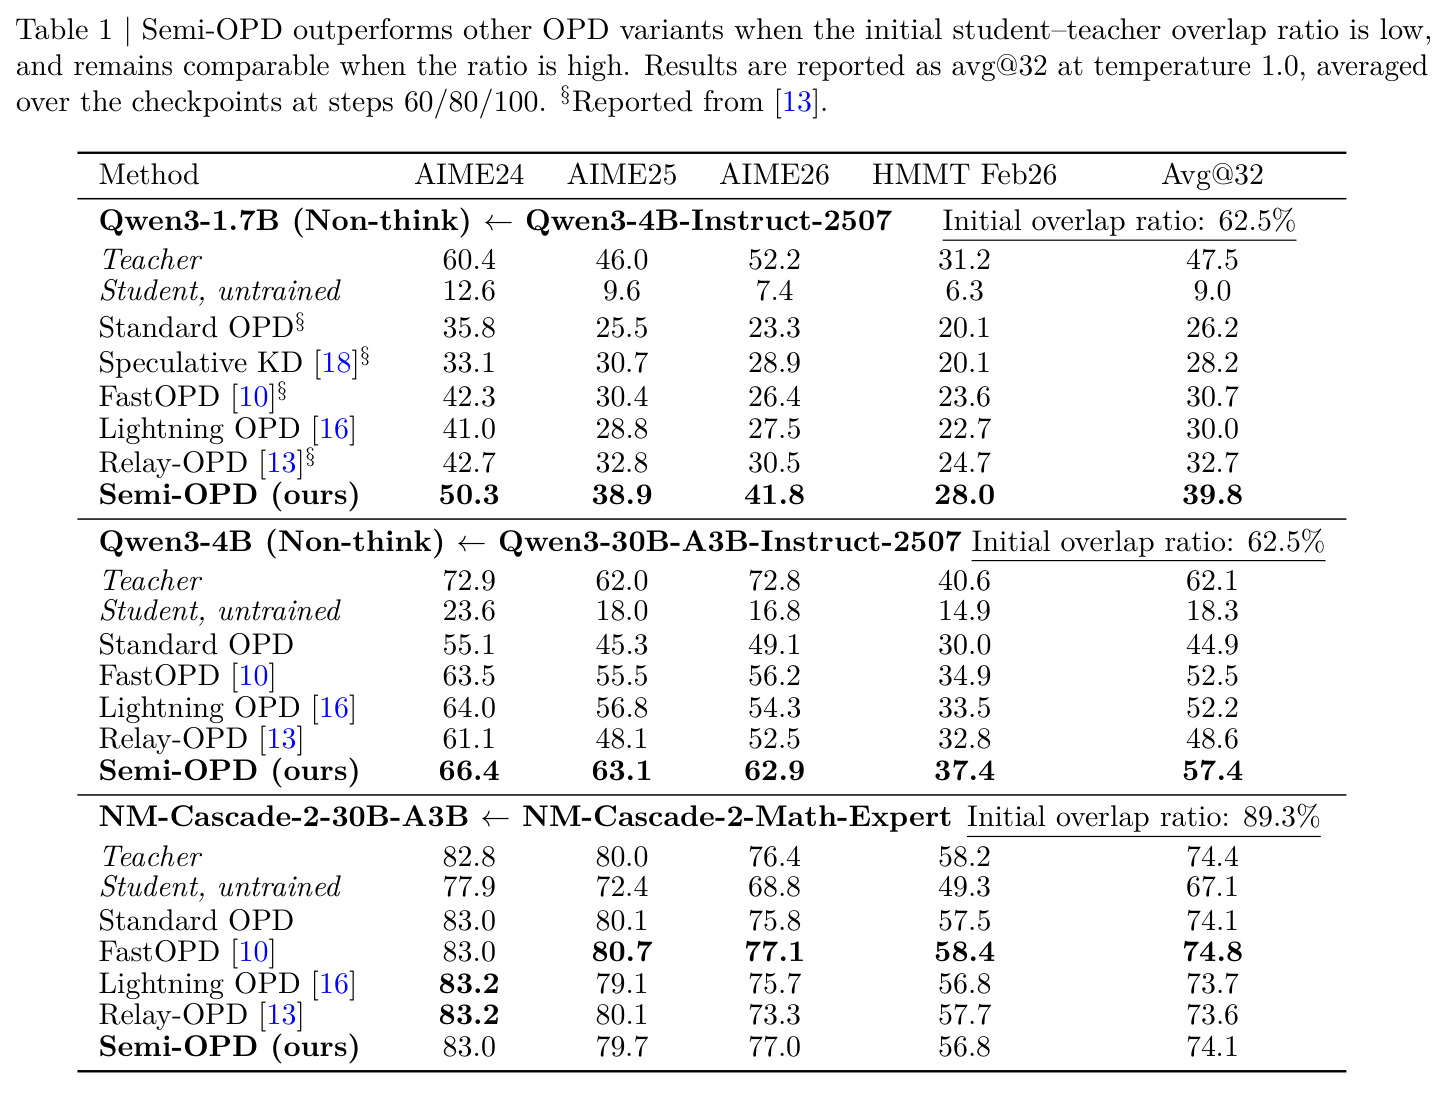
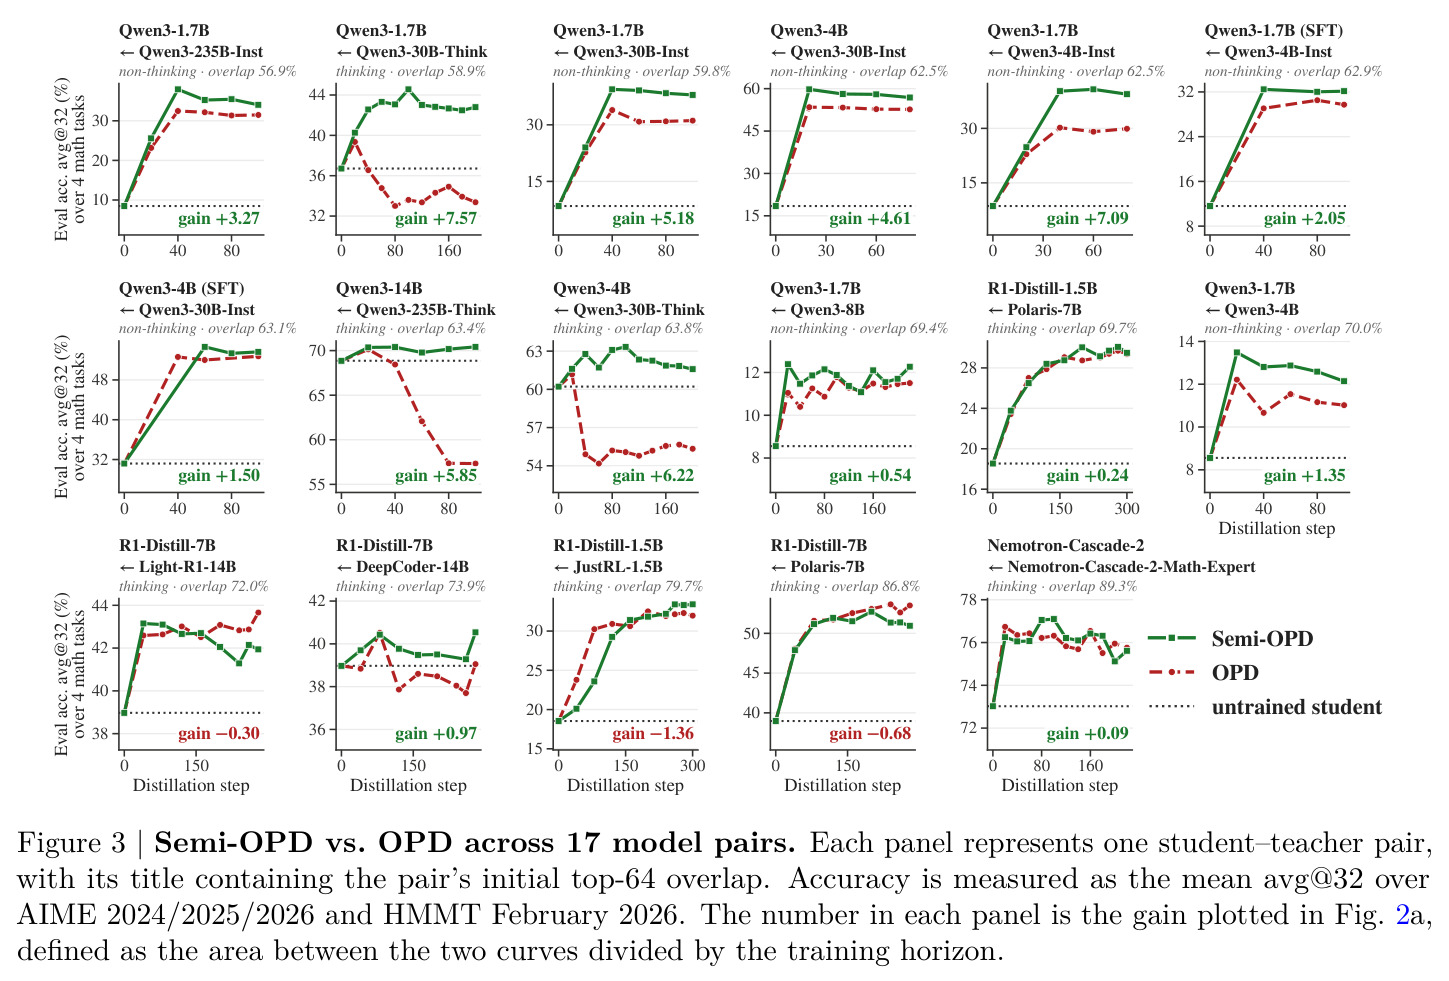
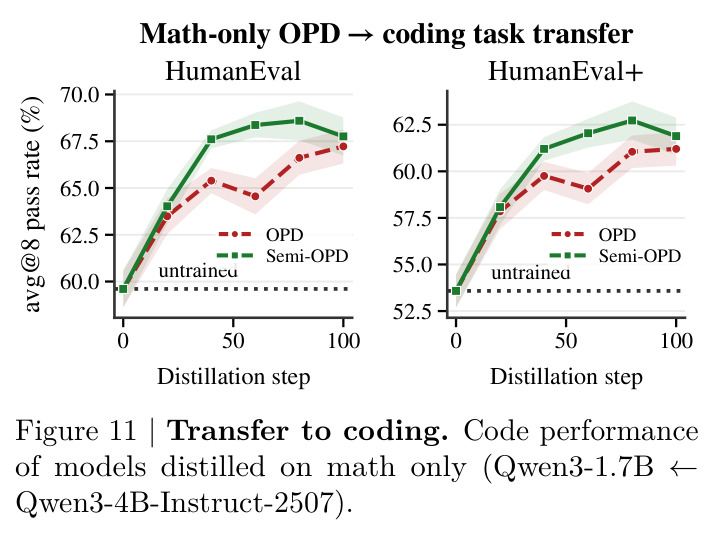
主实验覆盖 17 组师生对:Semi-OPD 在 14 组上胜过 OPD,AUC 增益最大 +7.57;其余 3 组差距仅 0.1–2.6 点。Table 1 中:Qwen3-1.7B←Qwen3-4B-Instruct-2507 上 Semi-OPD 达 39.8,超 OPD 26.2 达 +13.6 点、超最强基线 Relay-OPD 32.7 达 +7.1;Qwen3-4B←Qwen3-30B-A3B-Instruct 上 57.4,领先 OPD 44.9 与 FastOPD 52.5;高重叠(89.3%)的 Nemotron 对上 74.1,仅比最佳基线低 0.7 但快 2.2 倍。效率上相对 OPD/Relay-OPD/FastOPD 分别提速 4.5–11.4×/14.1–34.7×/2.2–2.7×。增益与初始 top-64 重叠率强负相关($r=-0.73$)。消融证明:换教师 rollout 更差、只训前 1/4 轨迹最差、加长 rollout cap 伤害低重叠对,且数学训练增益可迁移到 HumanEval(+)。
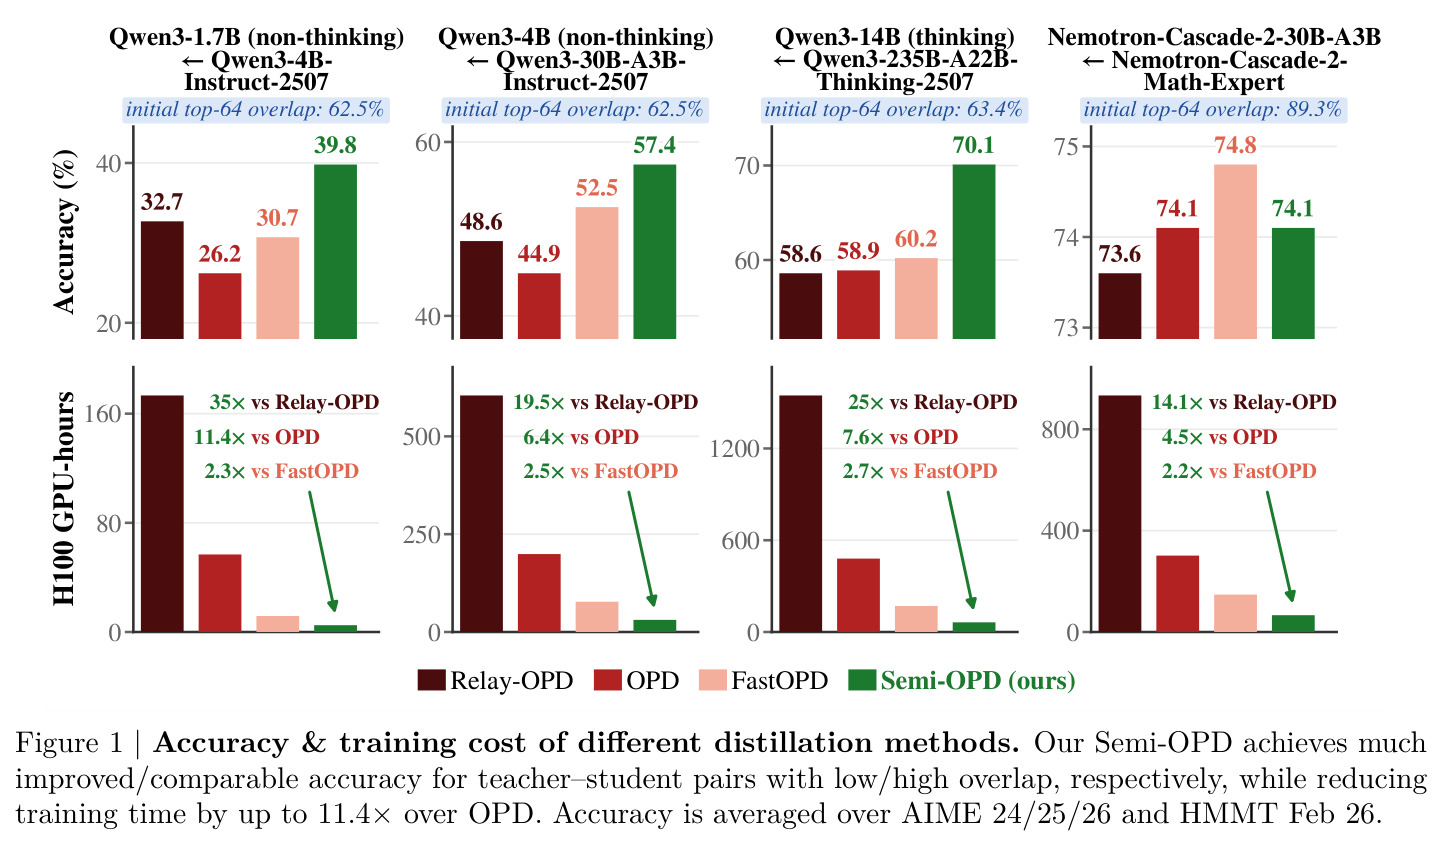
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(Qwen3-1.7B non-thinking ← Qwen3-4B-Instruct-2507,重叠 62.5%) | avg@32(AIME24/25/26+HMMT Feb26 四基准均值) | 39.8(Semi-OPD) | 标准 OPD 26.2;最强基线 Relay-OPD 32.7 | +13.6 点 vs OPD,+7.1 点 vs 最强基线 |
| 数学推理(Qwen3-4B non-thinking ← Qwen3-30B-A3B-Instruct-2507,重叠 62.5%) | avg@32 | 57.4(Semi-OPD) | 标准 OPD 44.9;FastOPD 52.5;Lightning OPD 52.2 | +12.5 点 vs OPD,+4.9 点 vs FastOPD |
| 数学推理(Nemotron-Cascade-2-30B-A3B ← Math-Expert,高重叠 89.3%) | avg@32 | 74.1(Semi-OPD) | 标准 OPD 74.1;最佳基线 FastOPD 74.8 | 与 OPD 持平,落后最佳基线 0.7 点,但训练快 2.2–4.5× |
| 训练效率(Qwen3-14B thinking ← Qwen3-235B-A22B-Thinking-2507) | H100 GPU 时 / 100 训练步(不含评测) | 63.0(Semi-OPD) | OPD 480.0;Relay-OPD 1546.5;FastOPD 169.8 | 7.6× vs OPD,24.6× vs Relay-OPD,2.7× vs FastOPD |
| 选型判据(17 组师生对汇总) | Semi-OPD 相对 OPD 的 AUC 增益与初始 top-64 重叠率的 Pearson 相关 | r = −0.73 | 无(首次系统量化) | 证明低重叠对收益最大、只有高重叠对才真正需要 OPD |
局限与改进
作者承认并可进一步观察到的局限包括:主实验几乎全部集中在数学推理(训练只用 DAPO-Math-17K),代码能力只作为迁移评测出现,指令遵循、安全、多语言等维度均未验证。Semi-OPD 的前提是初始学生已能产出有意义的轨迹——在 Qwen3-1.7B-Base 上(重叠率 55.2%)它完全失效并落后于 OPD,而“从 base 模型开始蒸馏”在真实场景很常见。选型判据只给出强负相关($r=-0.73$)和大致 70% 的经验分界,没有因果验证或精确阈值;重叠率本身需要先做一次师生前向测量,且 $K=64$ 的选择缺少敏感性分析。训练时每条提示只采 1 条 rollout,缓存多样性有限,长周期训练下是否需要部分刷新未探讨。高重叠结论主要依赖 Nemotron 一组样本。“OPD 收敛到 rollout 决定的均衡”只有经验观察、缺乏理论刻画。此外论文正文未提及代码开源。
独立分析的弱点
第一,冻结缓存可能损失多样性:每条提示仅 1 条初始 rollout,训练后期学生可能过拟合这批固定轨迹的风格与偶然错误,改进方向是低频率、小比例的缓存刷新,或按重叠漂移自适应刷新。第二,判据是静态的:初始重叠率无法反映训练中对齐关系的动态变化(Fig. 17 显示重叠会随训练上升),可设计滚动测量的在线决策器,在 Semi-OPD 与 OPD 之间自动切换,类似课程学习。第三,base 模型场景未被解决:可用极少量教师数据做轻量 SFT,或用教师 rollout 与学生 rollout 混合缓存来兜底。第四,机制解释仍偏相关性:“学生 rollout 随长度增长系统性偏离教师分布”这条因果链可用受控实验(固定长度、逐步拼接前缀测教师熵)进一步夯实。第五,评测集中于竞赛数学,高重叠区间的结论仅由 Nemotron 一组(89.3%)支撑,需要更多领域与模型对来标定边界;自我纠正的度量也只用了 wait/but/hmm 等词面密度,是间接代理指标。
未来方向
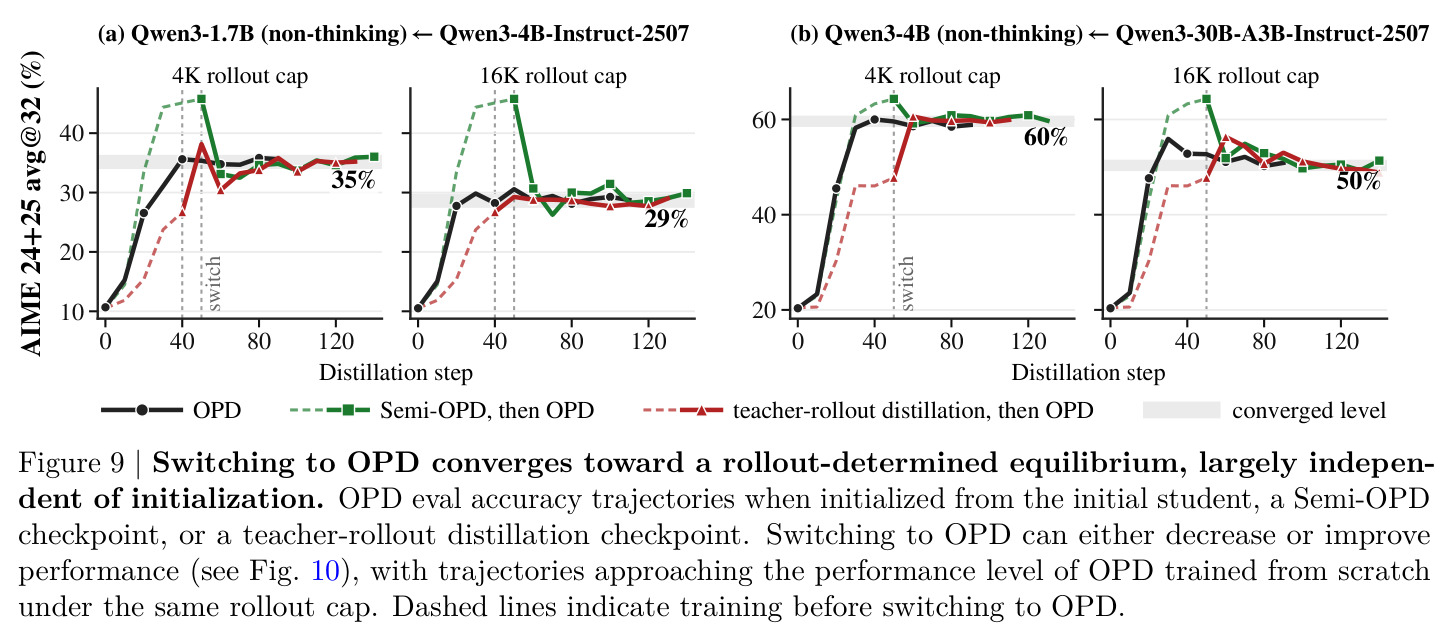
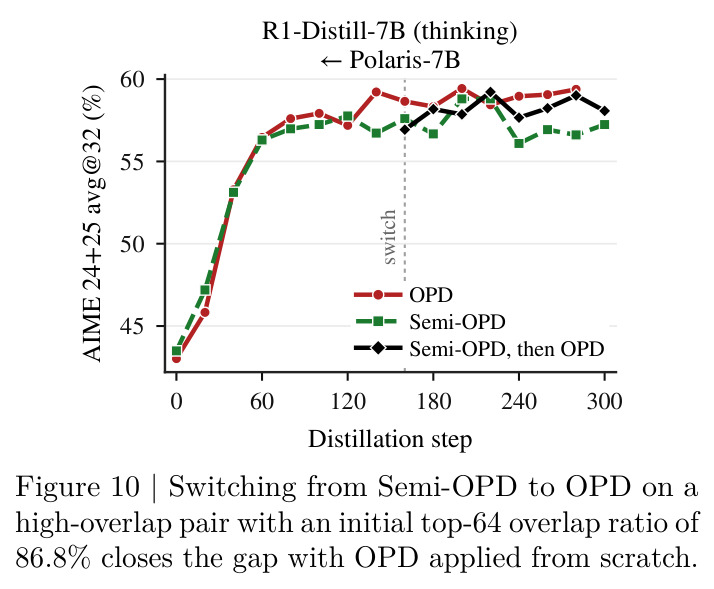
作者明确呼吁:未来 OPD 研究应精心挑选“有意义的”师生对作为实验设置,避免在低重叠对上得出误导性结论;并刻画 OPD 收敛到的“rollout 决定的均衡”——Fig. 9 显示低重叠对上无论从初始学生、Semi-OPD 还是教师蒸馏检查点热启动,最终都收敛到由 rollout cap 决定的同一水平,Fig. 10 显示高重叠对上先 Semi-OPD 再切 OPD 能追平从头 OPD。基于本文成果还可延伸出多条路线:把重叠率用于教师选择与数据配比(同一份学生缓存可低成本复算多个教师的分数,从而批量筛选教师);设计混合课表,如先 Semi-OPD 预热、再按重叠漂移切换 OPD;将该分析推广到代码、智能体、多模态等域;以及从理论上解释为何长上下文会让学生 rollout 系统性偏离教师分布,进而设计显式补偿教师侧在线性的新目标。
复现评估
复现材料基本齐备:17 组师生对在 Table 3 中全部链接了具体 HuggingFace 检查点(Qwen3、DeepSeek-R1-Distill、Nemotron-Cascade-2 及 JustRL/Polaris/Light-R1/DeepCoder 系列),训练数据 DAPO-Math-17K 公开,超参完整给出(AdamW、lr $1\times10^{-6}$、全局 batch 128、4K/16K 训练 rollout cap、温度 1.0、avg@32 评测等),基础设施为 NeMo-RL(DTensor 后端)+ vLLM。方法本身实现极简(核心只是“采样一次并冻结”),小规模复刻(如 1.7B 学生、non-thinking、4K cap)约需单节点、Semi-OPD 每 100 步仅 5 个 H100 GPU 时,难度中等;但完整复刻 17 组对(含 235B 教师、多种子)需要 1–8 个 8×H100 节点,属于大规模工程。论文正文未提及开源训练代码,需自行基于 NeMo-RL 或同类框架实现,评测管线用 vLLM 搭建即可。
论文图表
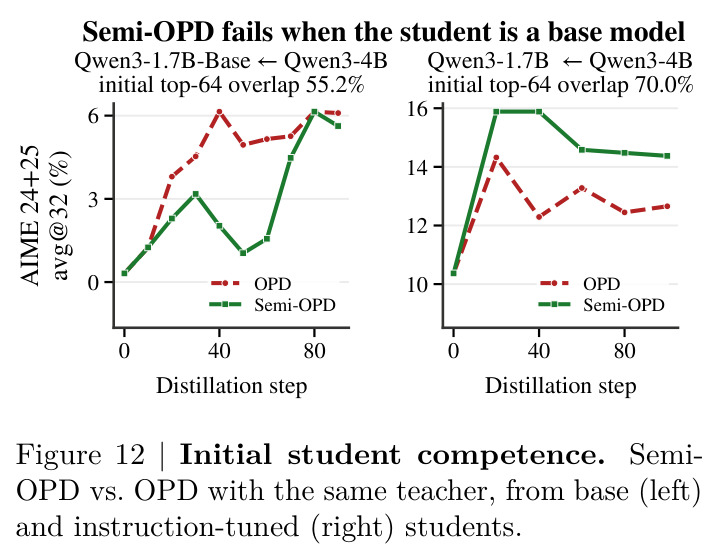
同一教师下对比 base 学生(Qwen3-1.7B-Base,重叠率 55.2%)与指令微调学生(重叠率 70.0%):base 学生上 Semi-OPD 落后于 OPD,指令微调学生上 Semi-OPD 恢复优势。
明确方法的适用边界——初始学生必须能产出有意义的轨迹,是实践中最重要的风险提示。