干将:面向X射线衍射分析的自学习科学智能体 A self-learning scientific agent for X-ray diffraction
干将智能体把衍射分析经验固化为可验证的技能,物相鉴定与精修全面领先基准
前置知识
粉末X射线衍射(PXRD)
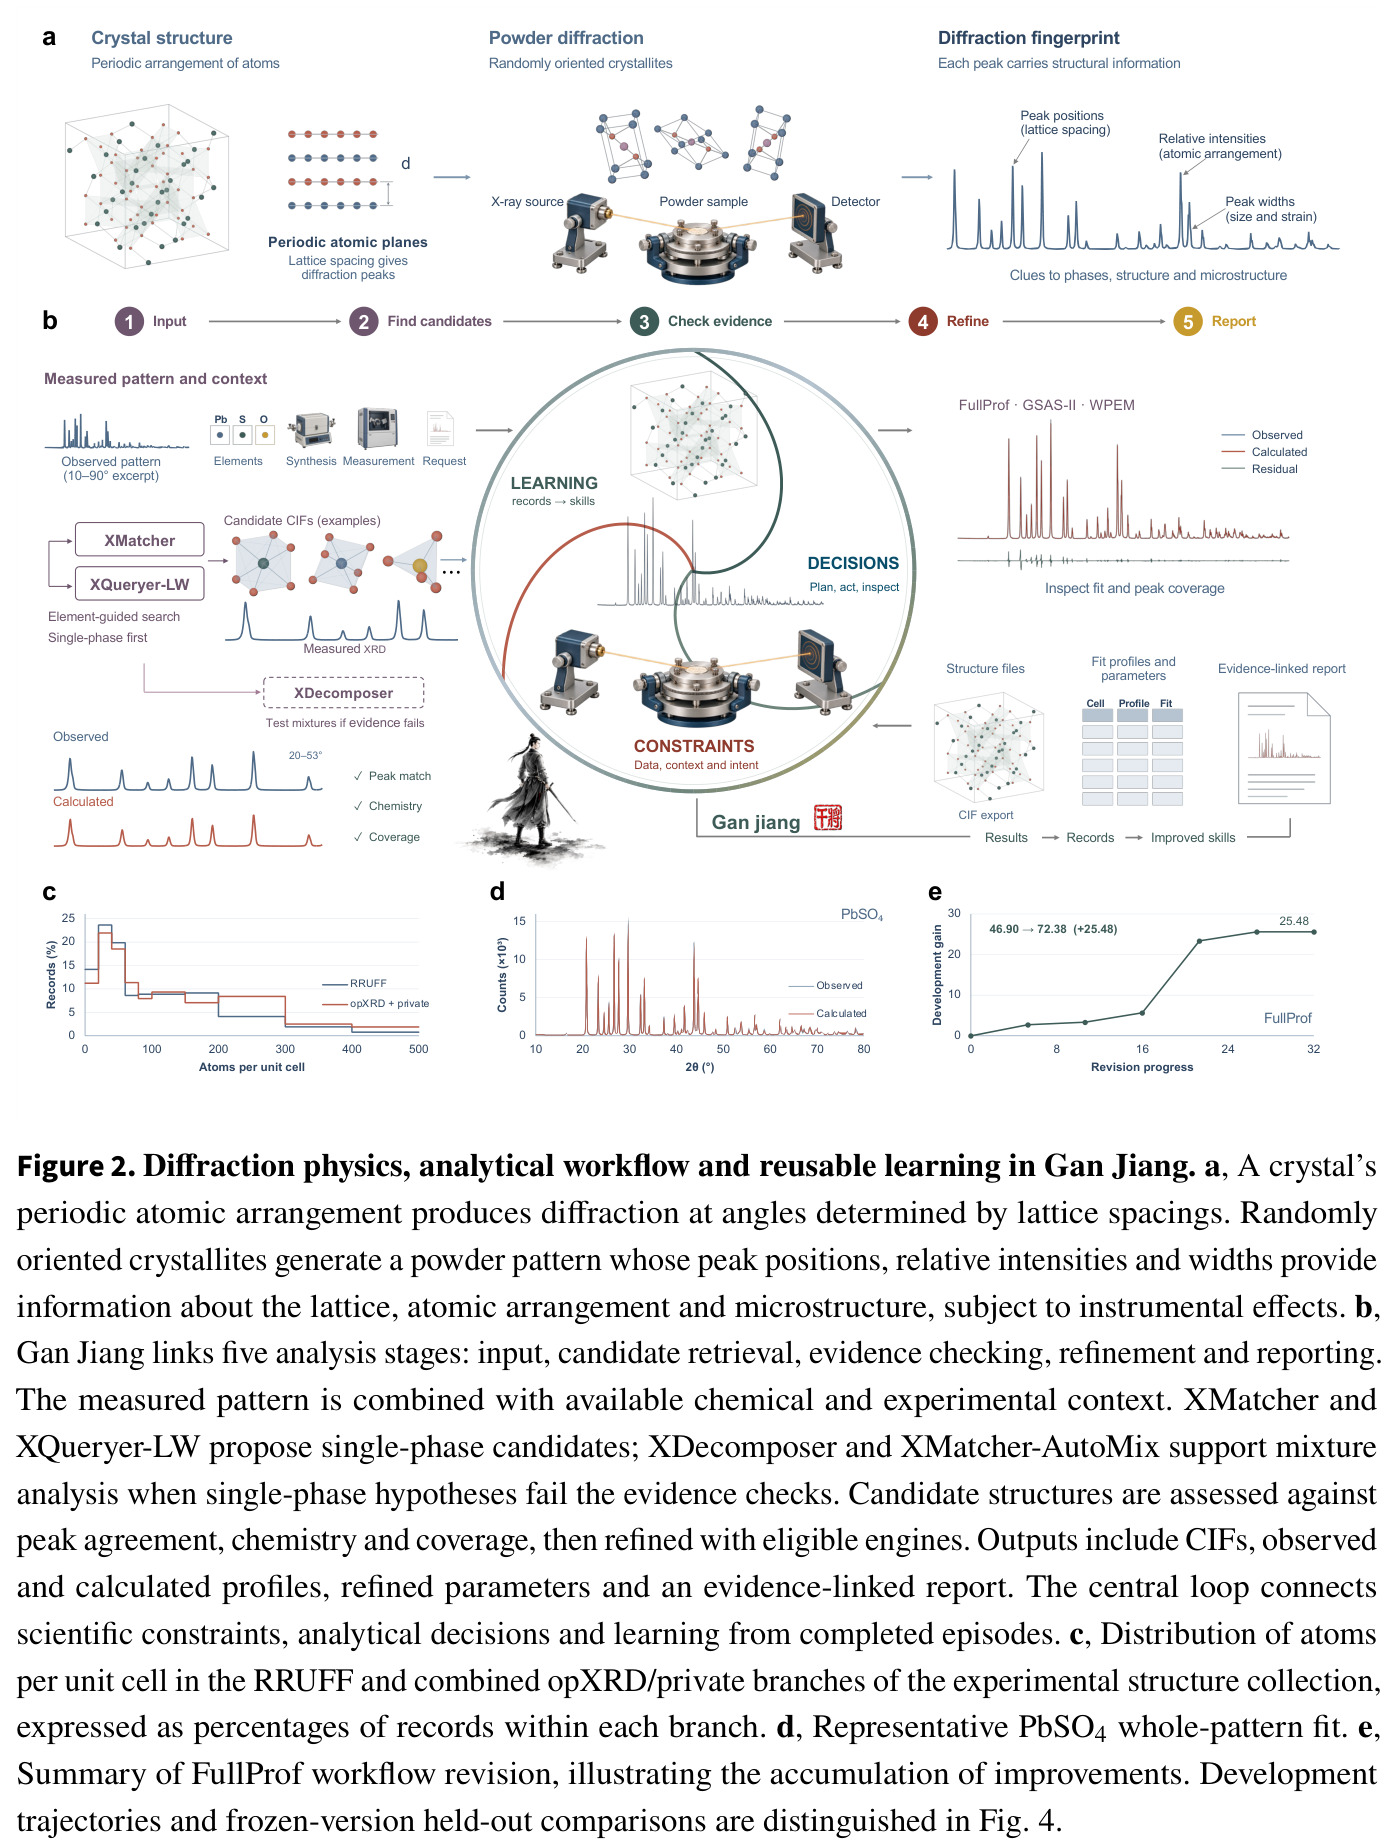
多晶样品中无数随机取向的晶粒同时散射X射线,把三维倒易空间压缩成一维强度-角度谱。峰位由晶面间距决定(Bragg 定律 $2d\sin\theta=n\lambda$),相对强度反映原子排布与物相丰度,峰宽携带晶粒尺寸、应变与仪器效应的信息,是连接合成材料与原子结构的核心表征手段。
本文的全部任务——物相鉴定、多相分解、全谱精修——都建立在对 PXRD 谱图物理含义的理解之上,不懂峰位/强度/峰宽各自编码什么,就无法理解证据门控设计。
Rietveld 全谱精修
以候选晶体结构计算理论衍射谱,通过最小化观测谱与计算谱的加权残差,同时精修晶格常数、峰形参数、背景与物相分数;用 $R_p$、$R_{wp}$ 等指标评估,其中 $R_{wp}$ 对大残差加权更敏感,是判断结构模型能否成立的金标准。
干将的技能学习以精修分数为奖励信号,留出集精修分的提升(如 FullProf 46.90→72.38)直接由这类指标度量,是理解自改进实验的前提。
物相鉴定与 search–match
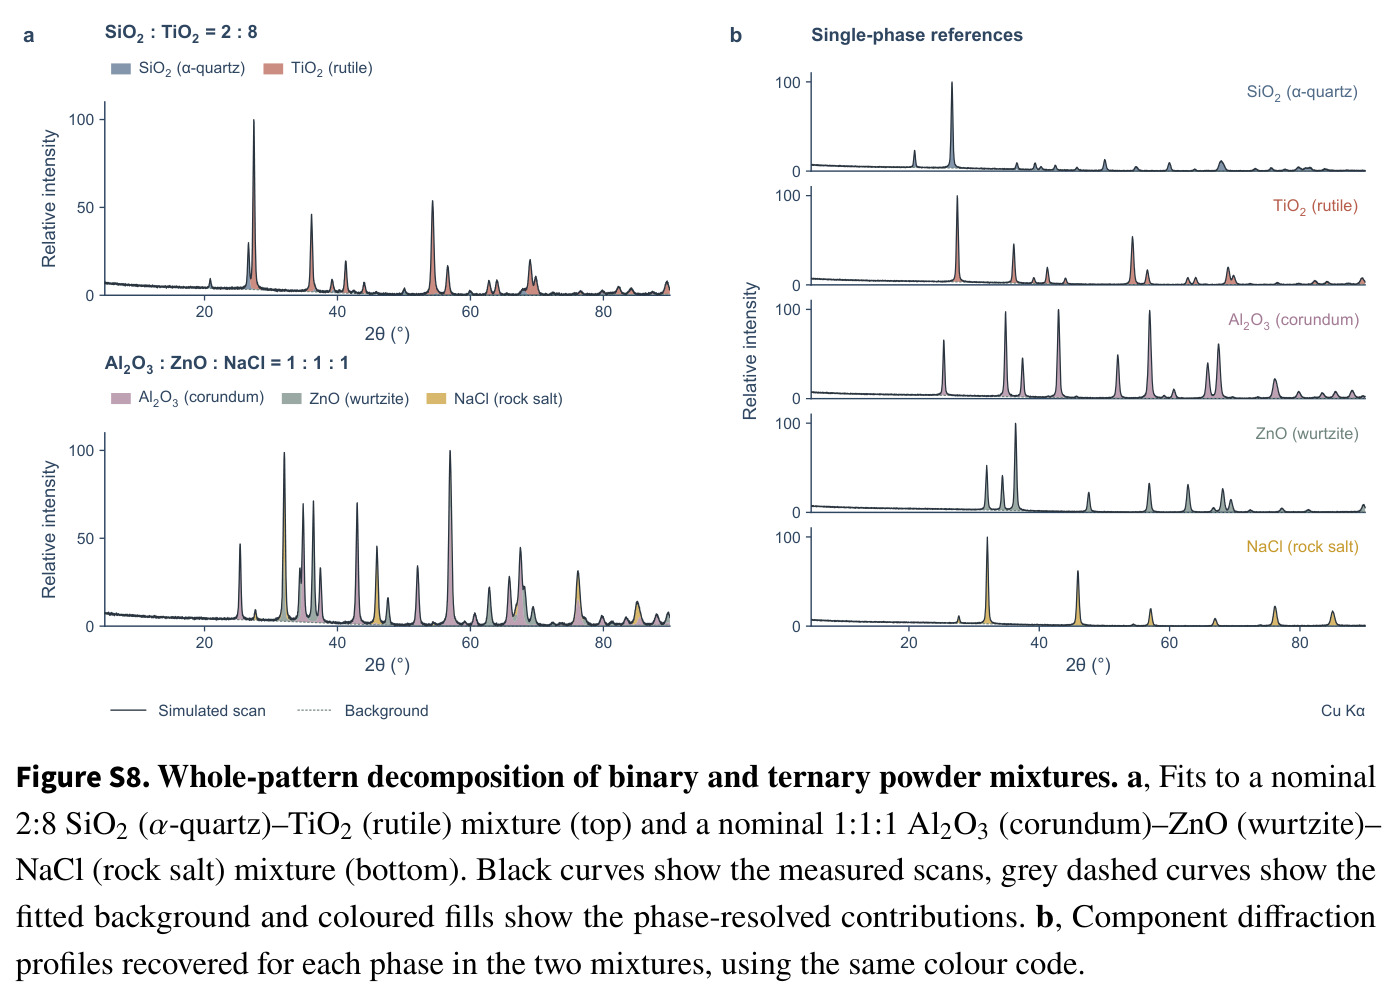
从实测峰位与强度出发,在晶体结构数据库中检索能解释全部观测峰的候选相:先做峰检测,再构建理论峰库,按峰位与相对强度的匹配质量打分排序;多相样品则需要组合多个相共同覆盖谱图,并惩罚多余相。
XMatcher、AutoXRD、AutoAnalyzer 等方法均属此类,理解其打分与排序逻辑,才能看懂 Table 1/2 中对比实验的设计与差异。
LLM 智能体与技能库(skill library)
以语言模型为规划器、外部工具为执行器的系统;技能库把'怎么做'存成指令+提示+可执行代码的外部记忆,由路由器按任务检索。模型参数可保持冻结,经验通过修改技能而非微调模型来积累,修订可版本化并做回归测试。
干将采用读写式反思学习:执行轨迹驱动技能修订。理解'经验存在技能层而非模型层'是把握全文创新点与自学习实验设计的关键。
WPEM 统计全谱分解
把扣背景后的谱表示为 pseudo-Voigt 峰形函数的非负混合,用期望最大化(EM)算法估计软分量责任;布拉格位置与峰形约束把统计混合与晶体学模型耦合,软分配允许重叠反射共享观测强度而不产生负峰,专为强重叠信号设计。
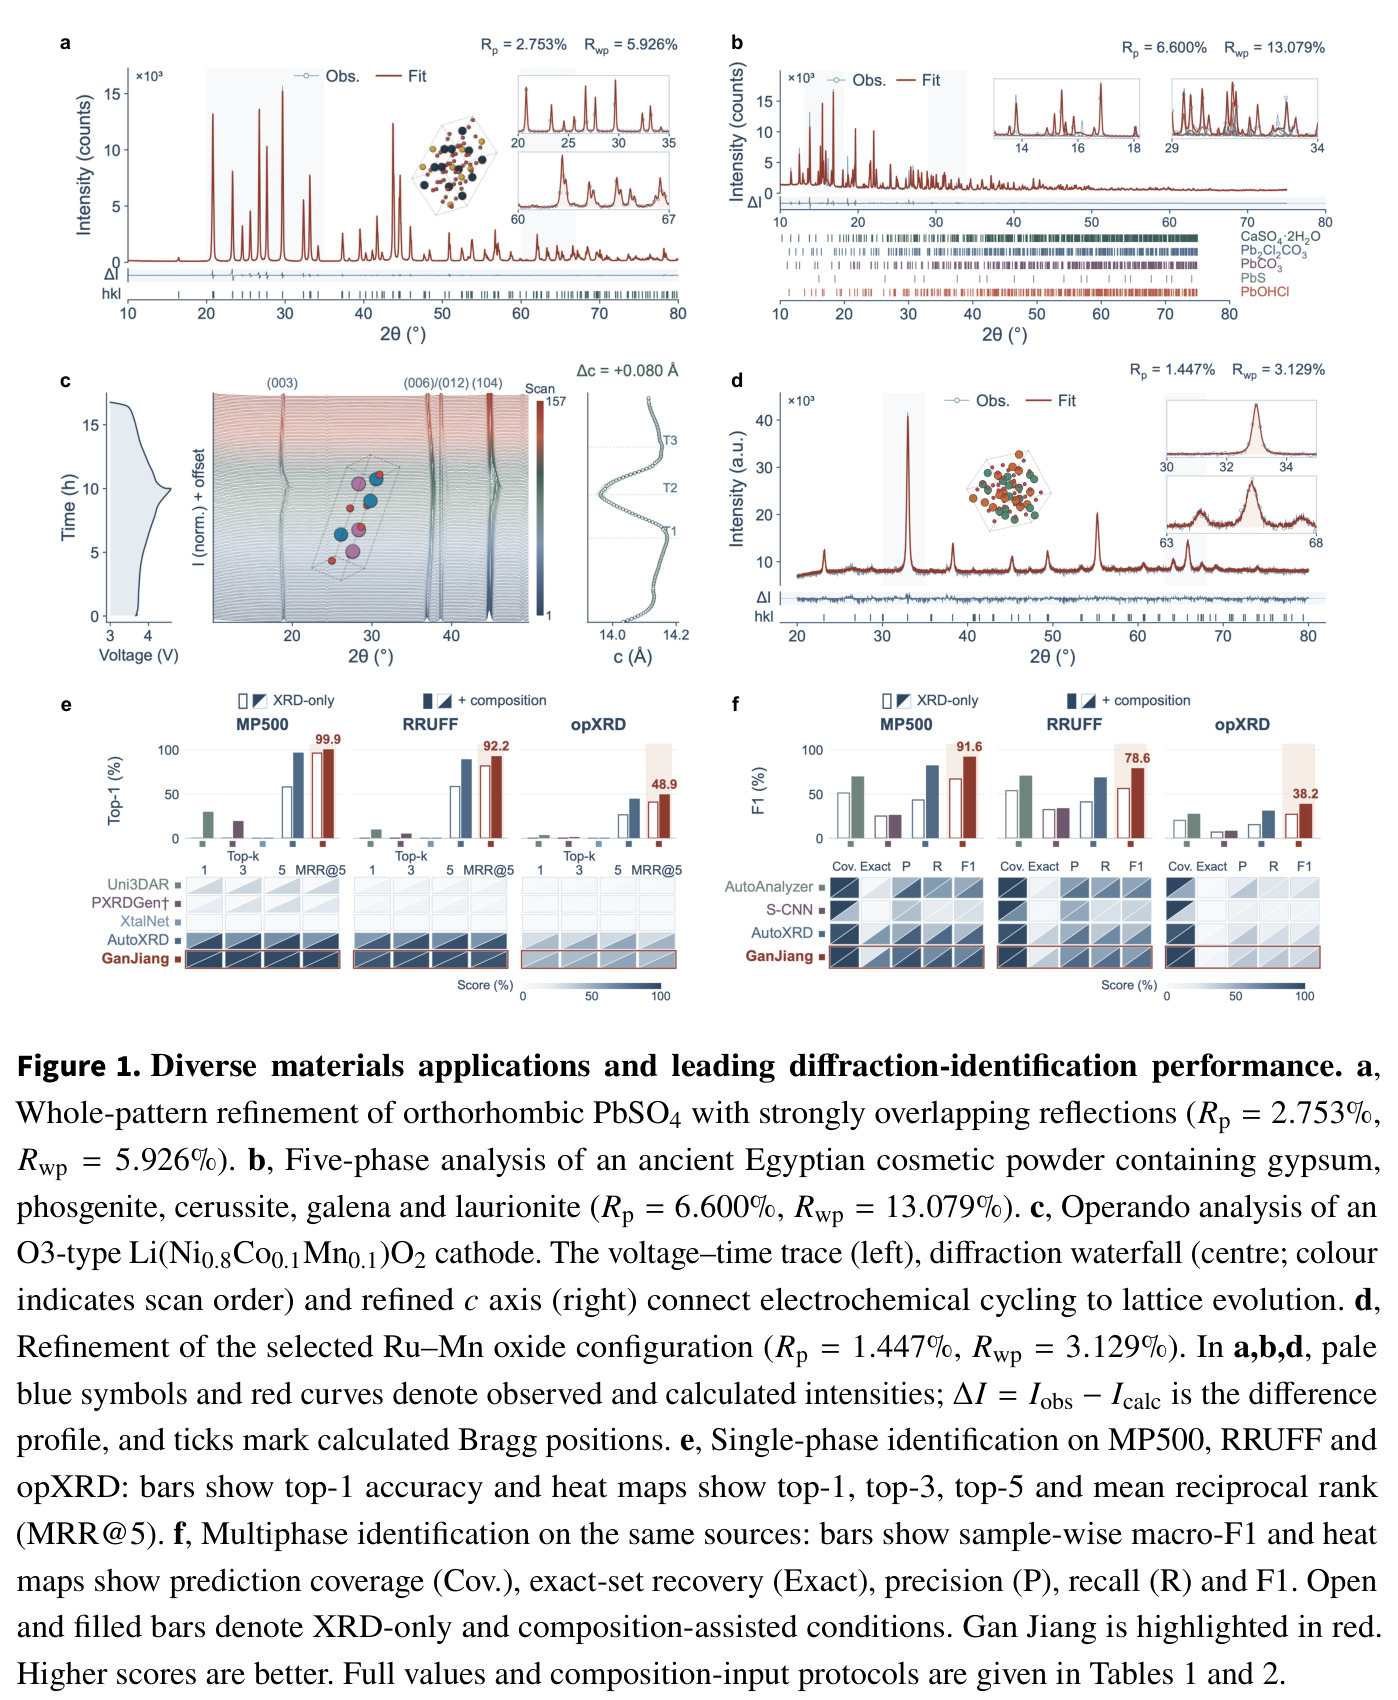
PyWPEM 是干将处理 PbSO$_4$ 等 383 对重叠反射体系时的物理引擎,理解 EM 软分配才能明白它与普通逐峰拟合的本质差别。
Top-k / MRR@5 / 宏平均 F1
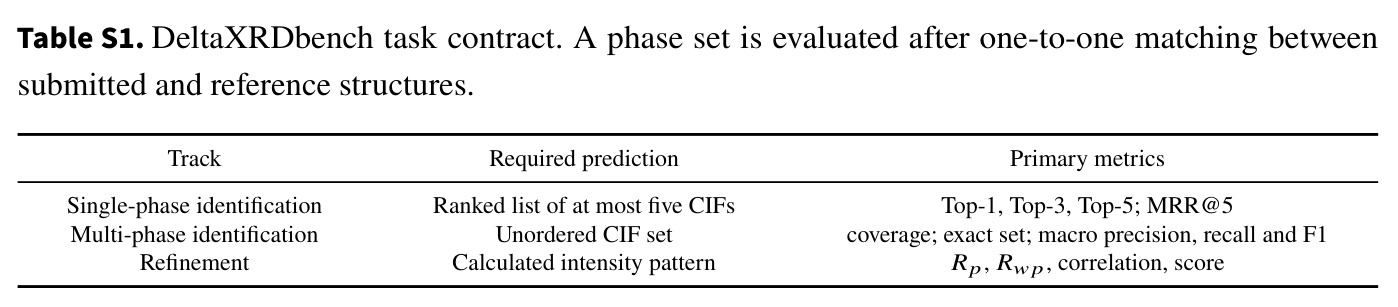
排序与集合预测指标:Top-$k$ 是正确答案出现在前 $k$ 的比例,$\mathrm{MRR@5}=\frac{100}{N}\sum_i 1/r_i$;多相预测经一对一结构匹配得匹配数 $m_i$,宏精确率 $P_i=m_i/p_i$、召回率 $R_i=m_i/t_i$、$F_{1i}=2m_i/(p_i+t_i)$,精确集合恢复要求 $m_i=p_i=t_i$。
Table 1/2 的所有数字都由这些指标定义;理解'缺失预测计零、覆盖率 $100|V|/N$ 只作分子不作分母'的约定,才能正确比较各方法成绩。
研究动机
粉末X射线衍射(PXRD)把多晶样品的散射压缩成一维谱图:峰位约束晶格间距、强度反映原子排布与物相丰度、峰形携带微结构信息,但从中反推结构是一个病态逆问题——衍射峰重叠、晶体无序、择优取向和测量不完整都会让不同模型难以区分。例如论文中的正交 PbSO$_4$ 样品在 Cu K$_\alpha$ 辐射下就有 383 对布拉格反射两两重叠,孤立指峰根本不可靠,可靠解释需要一连串关于候选结构、精修参数和未解释残差的决策。高通量测量与自主实验室又把这类判断需求成倍放大。现有机器学习方法能分类物相、检索结构、直接生成结构候选,自动精修程序和新兴智能体也能把预测接到数值验证,但闭环止于单次分析:某次失败的精修、专家的手工纠错、成功恢复的策略并没有被系统性地转化为可复用且经过检验的知识,下一个样品的分析不会因此变得更好。
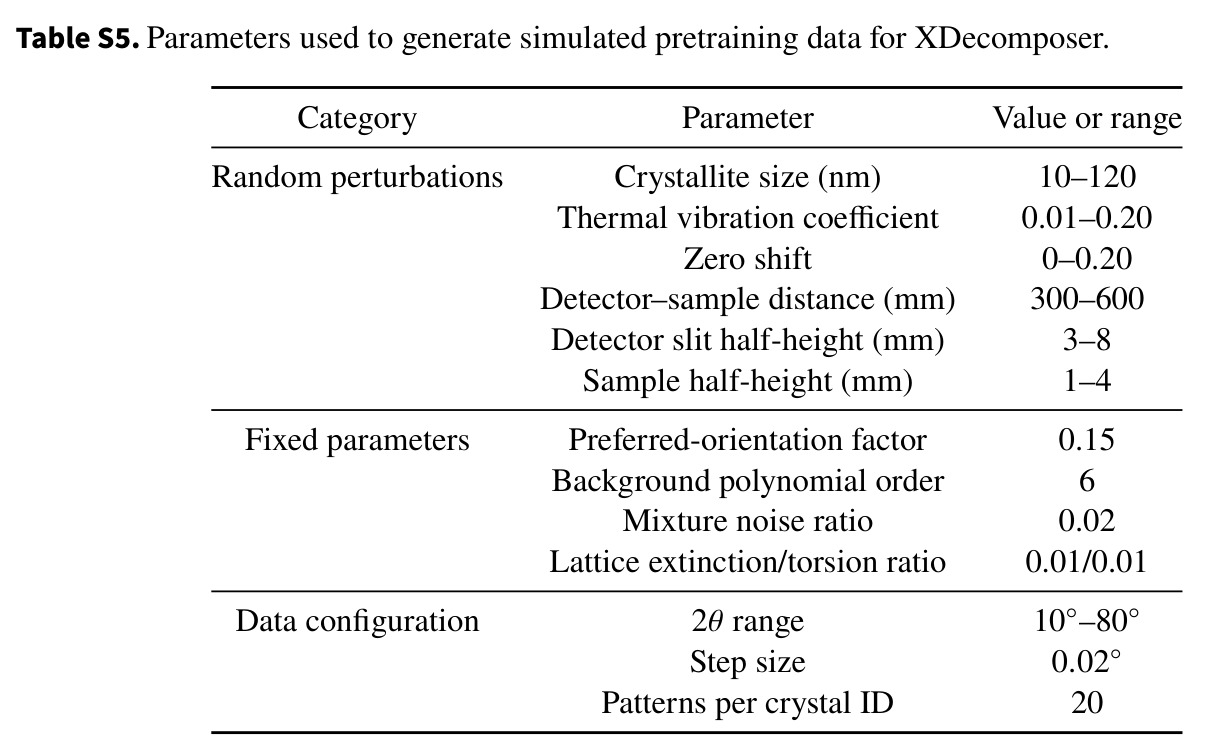
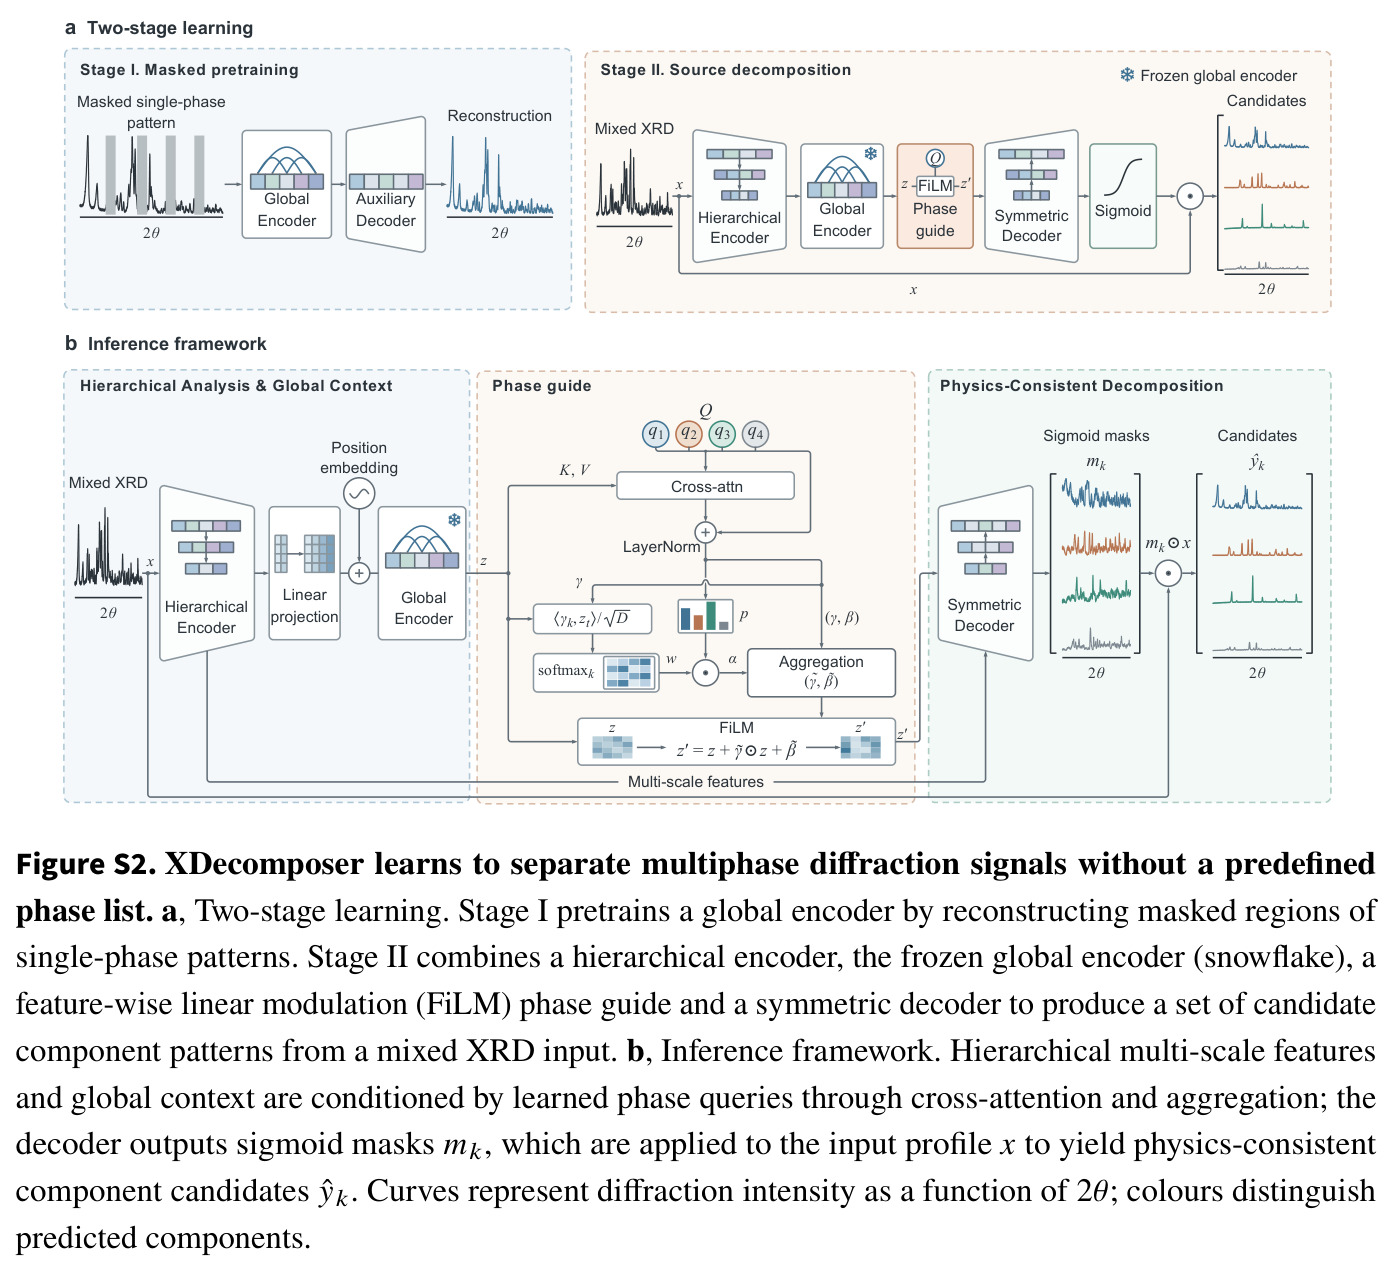
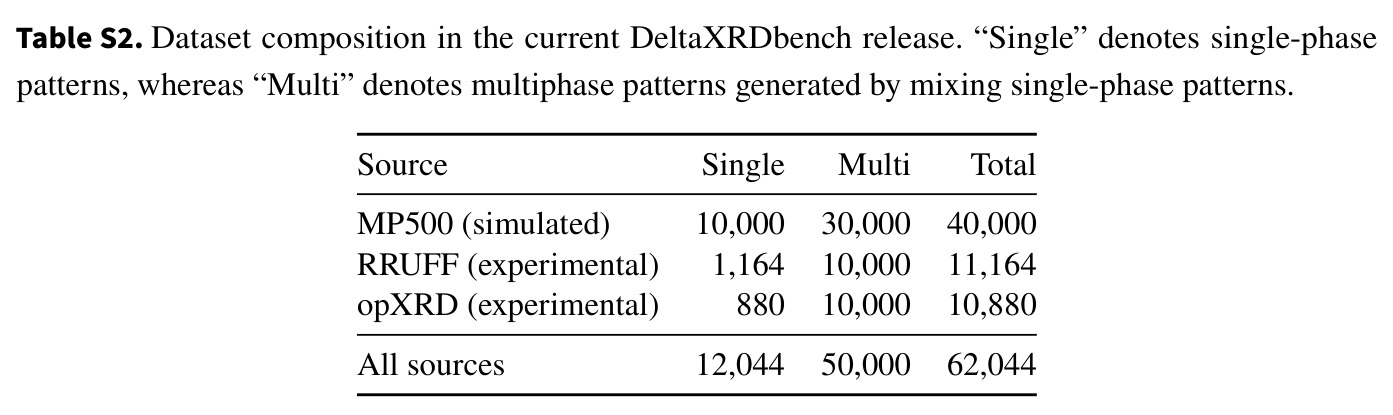
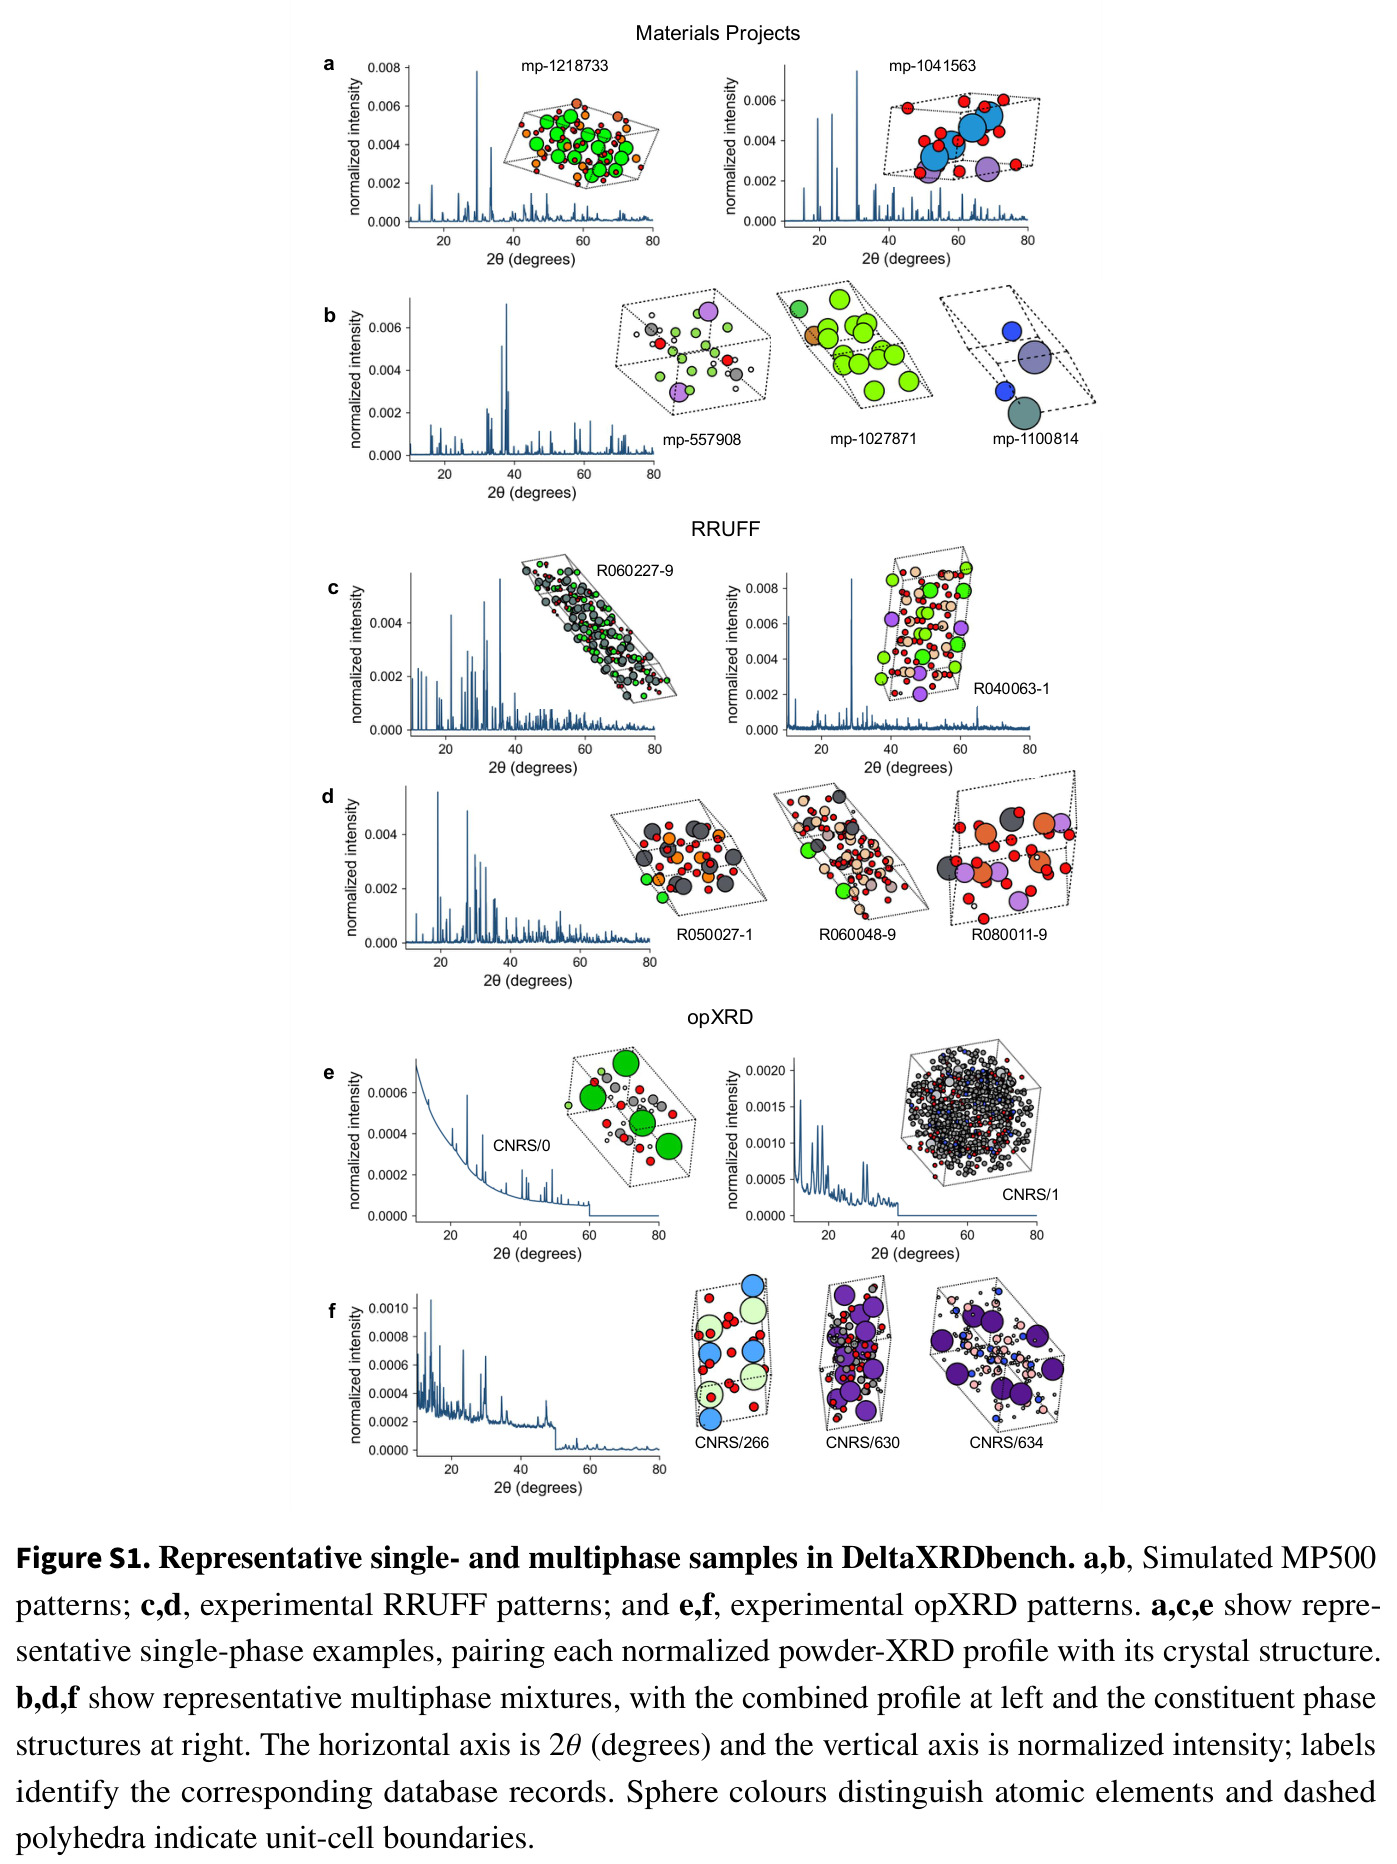
本文的目标是本文要构建名为干将(Gan Jiang)的自学习X射线衍射分析智能体,让'把测量变成结构结论'的整套流程本身成为可学习的对象。具体目标有三层:其一,把作者自研的衍射分析工具生态——XMatcher(可解释 search–match)、XQueryer-LW(元素引导的神经检索)、XDecomposer(多相分解)与 WPEM/PyWPEM(物理约束全谱建模),加上 FullProf 与 GSAS-II 两条成熟精修分支——整合成统一的分析框架;其二,在不重训语言模型、不改动底层物理模型的前提下,把分析经验固化为可执行技能,并用冻结版本在留出样本上验证这些技能真能迁移;其三,构建并发布 DeltaXRDbench 基准(62,044 张谱图,覆盖模拟与实验数据),在单相与多相物相鉴定两条赛道上与其他方法做可控、可复现的对比。
与已有工作不同的是,已有工作要么把智能体当作'单样本分析器',闭环只在一个样品内完成;要么用固定候选库分类器(AutoXRD)或依赖元素预测器的生成式模型(Uni3DAR、PXRDGen-Flow、XtalNet)直接预测结构。本文的独特切入是把'分析流程'本身当作一等公民的可学习对象:采用读写式反思学习,技能以'指令+提示+可执行代码'的形式存于外部记忆,反思环节把衍射残差、执行结果和精修物理合理性绑定到具体修订;候选修订先经成对开发集检验,再冻结后在留出集上与初始专家流程对比,从而在操作层面区分'这一个样品上把晶格参数调好'(样本级优化)与'下一次分析该按什么步骤做'(技能级学习)。这种'经验→经过验证的技能'的显式转化机制,正是该领域此前缺失的一环。
核心方法
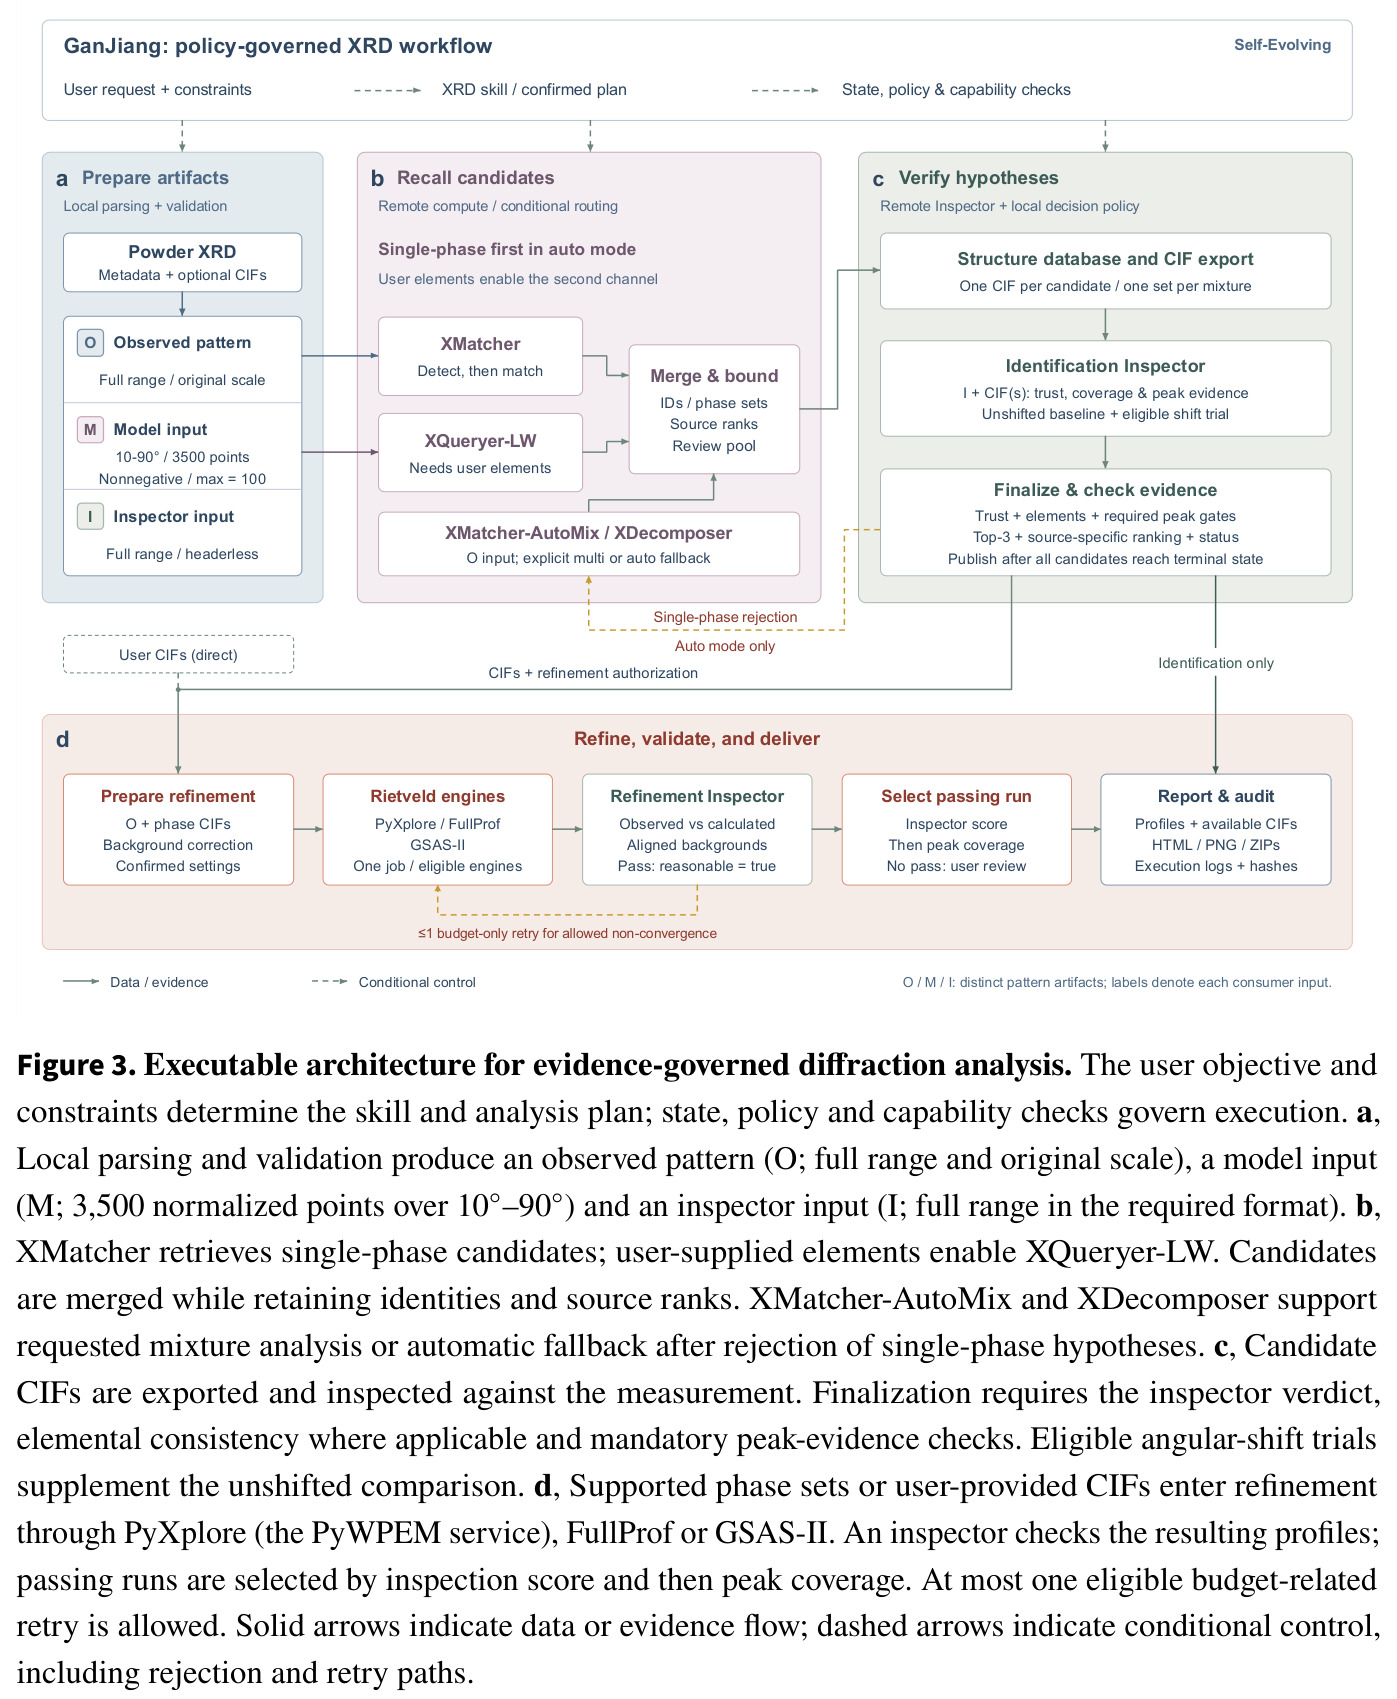
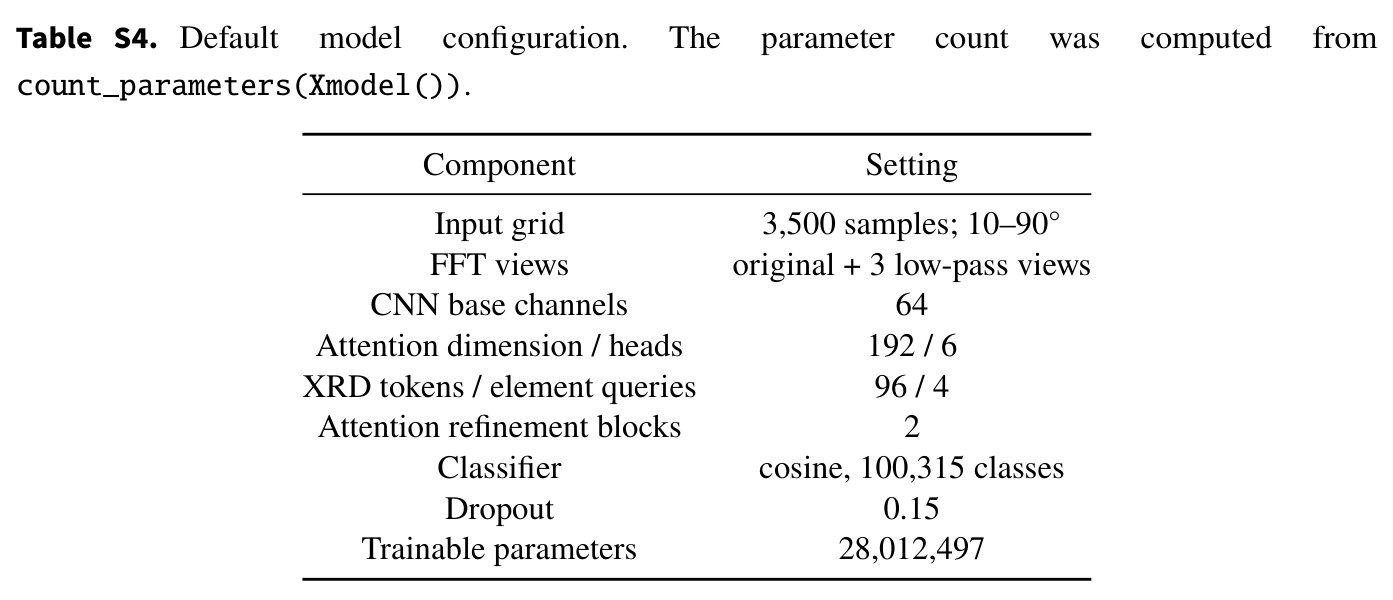
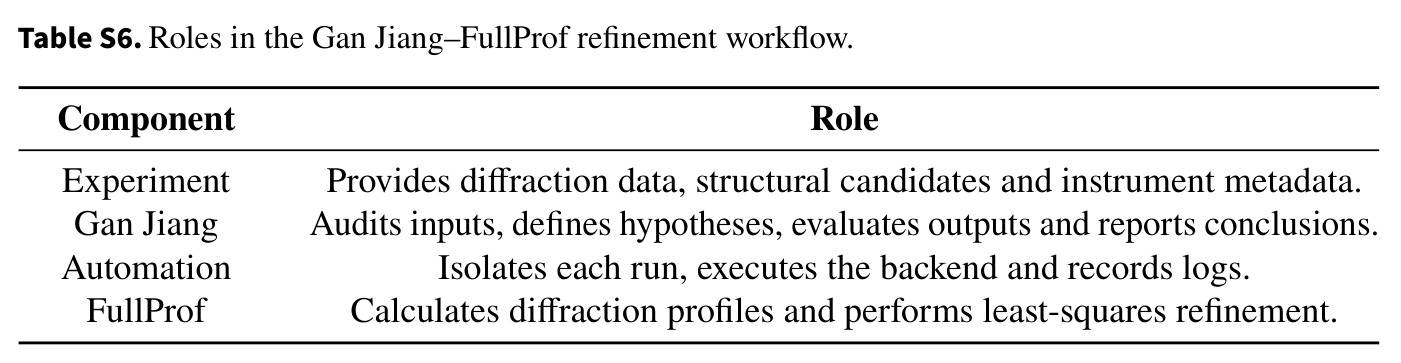
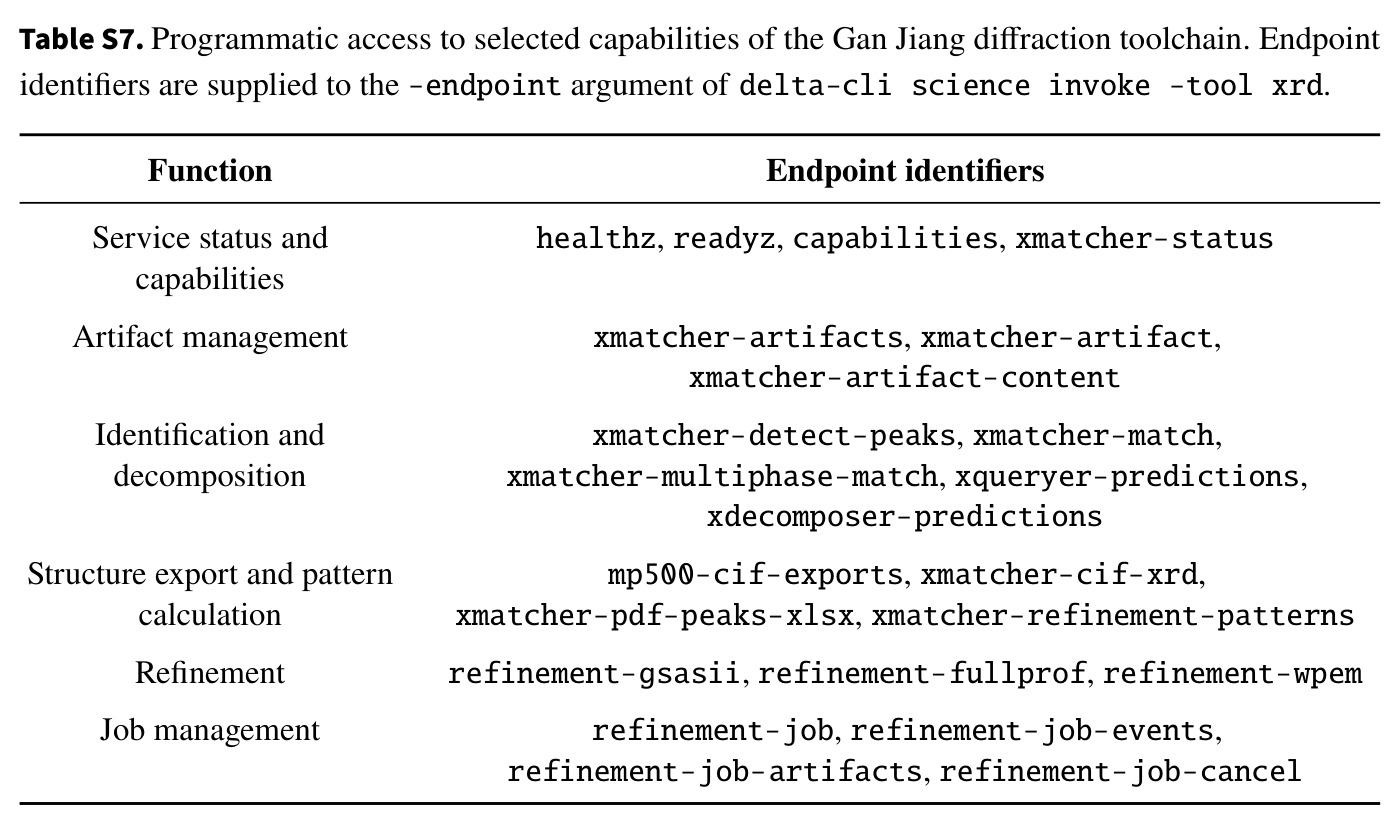
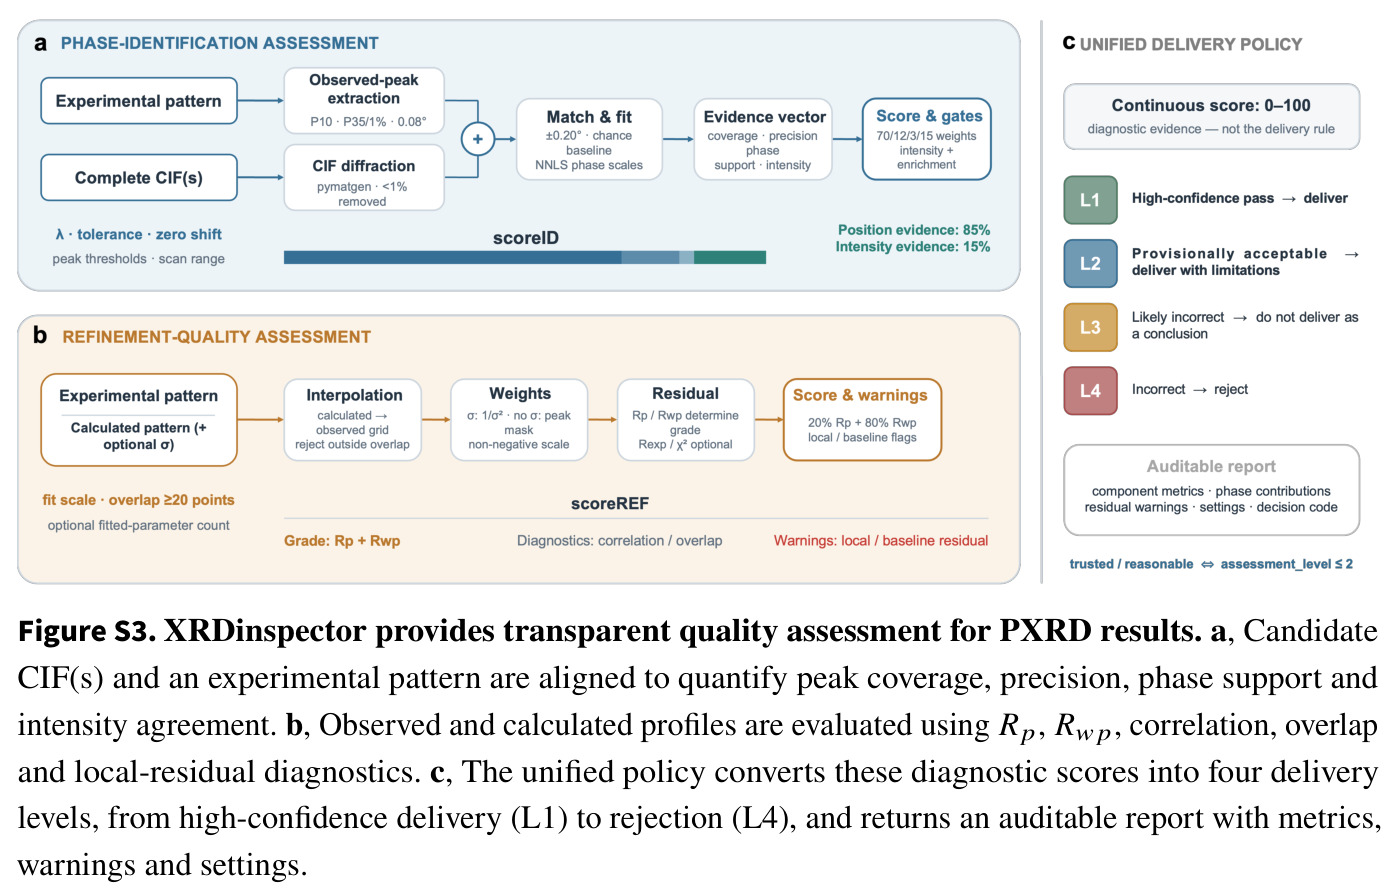
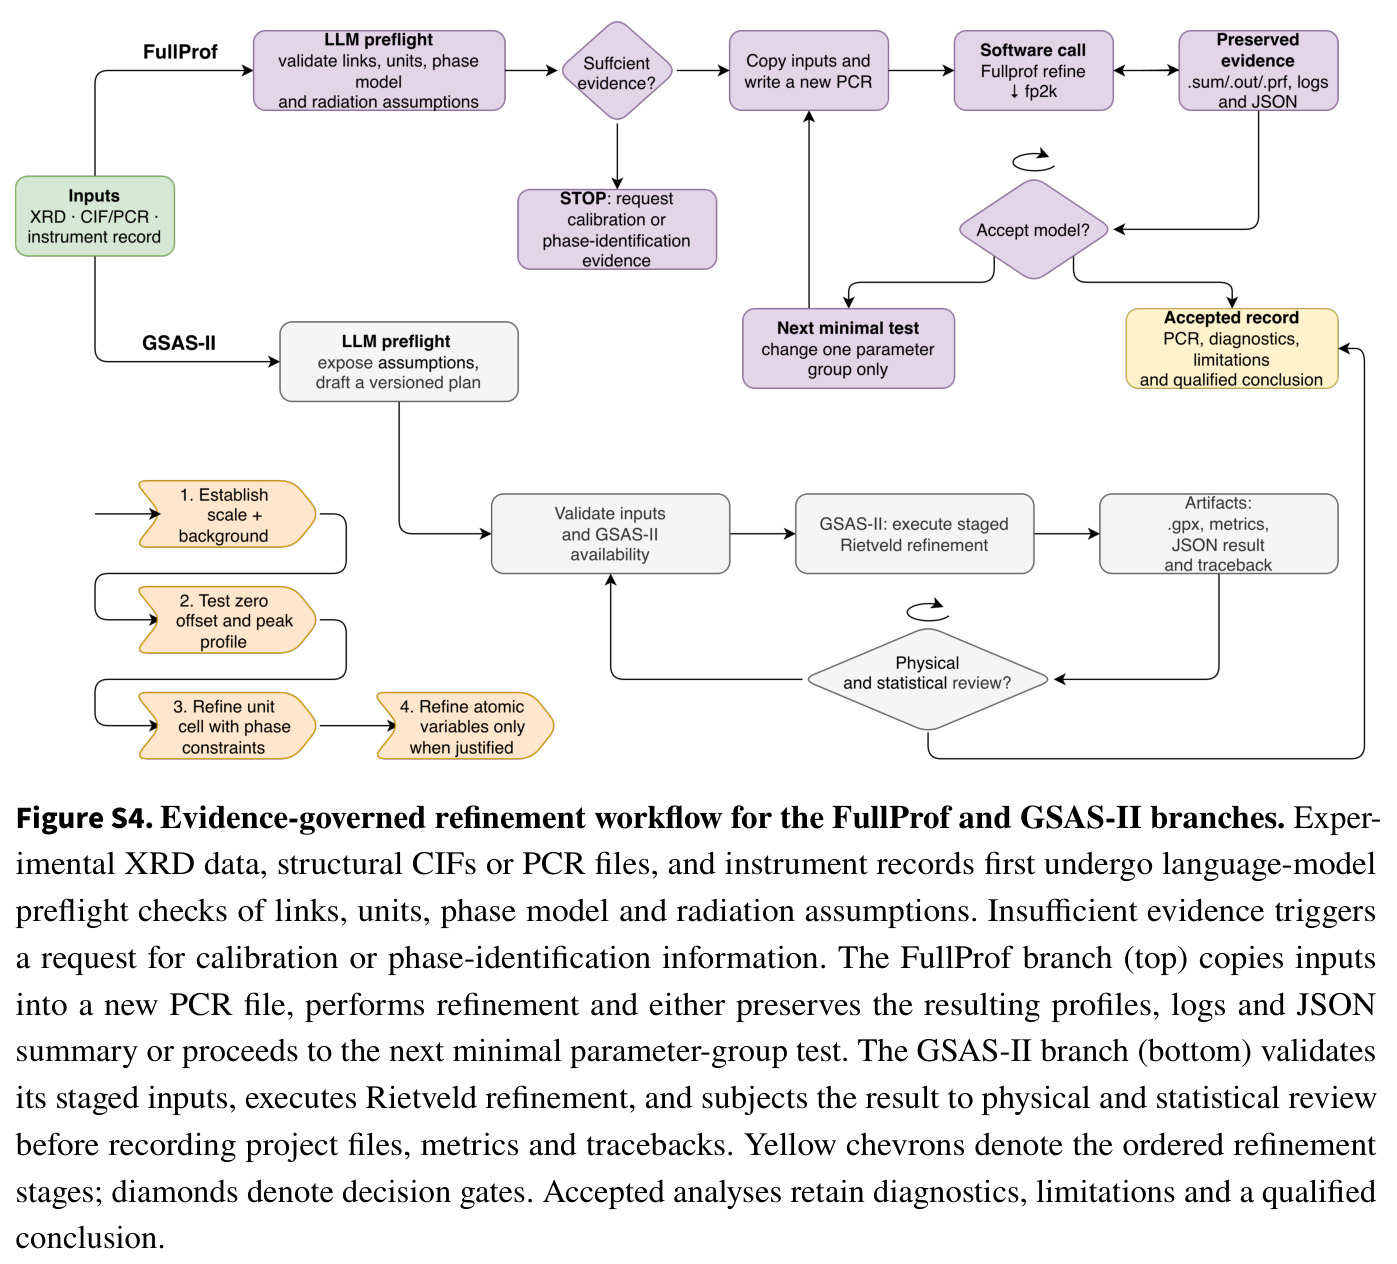
干将把一次衍射分析组织为五个阶段:接收谱图与上下文、检索候选结构、检验证据、精修受支持模型、输出报告。输入层刻意保留三种表示:观测谱 O(全角度范围、原始标度)用于峰分析与检验;模型输入 M(10°–90°重采样 3,500 点、归一化)专供 XQueryer-LW;检验输入 I 供检查器使用,防止面向检索的预处理污染实验证据。候选生成由 XMatcher 峰位匹配与 XQueryer-LW(需用户提供元素)双通道完成,按材料同一性合并并保留来源排名;混合物在自动模式下由单相假设被完整否决后触发 XMatcher-AutoMix 或 XDecomposer 进入多相分支。XRDinspector 对候选 CIF 实施'检验器判定+元素一致+必过峰证据门'的验收。精修走 PyWPEM、FullProf 或 GSAS-II,精修检查器按检验分与峰覆盖率排序,至多允许一次预算性重试。学习层面,读写式反思学习让每条执行轨迹驱动技能修订,Bragg 定律 $2d\sin\theta=n\lambda$ 等物理约束保留在底层引擎中,语言模型参数全程冻结。
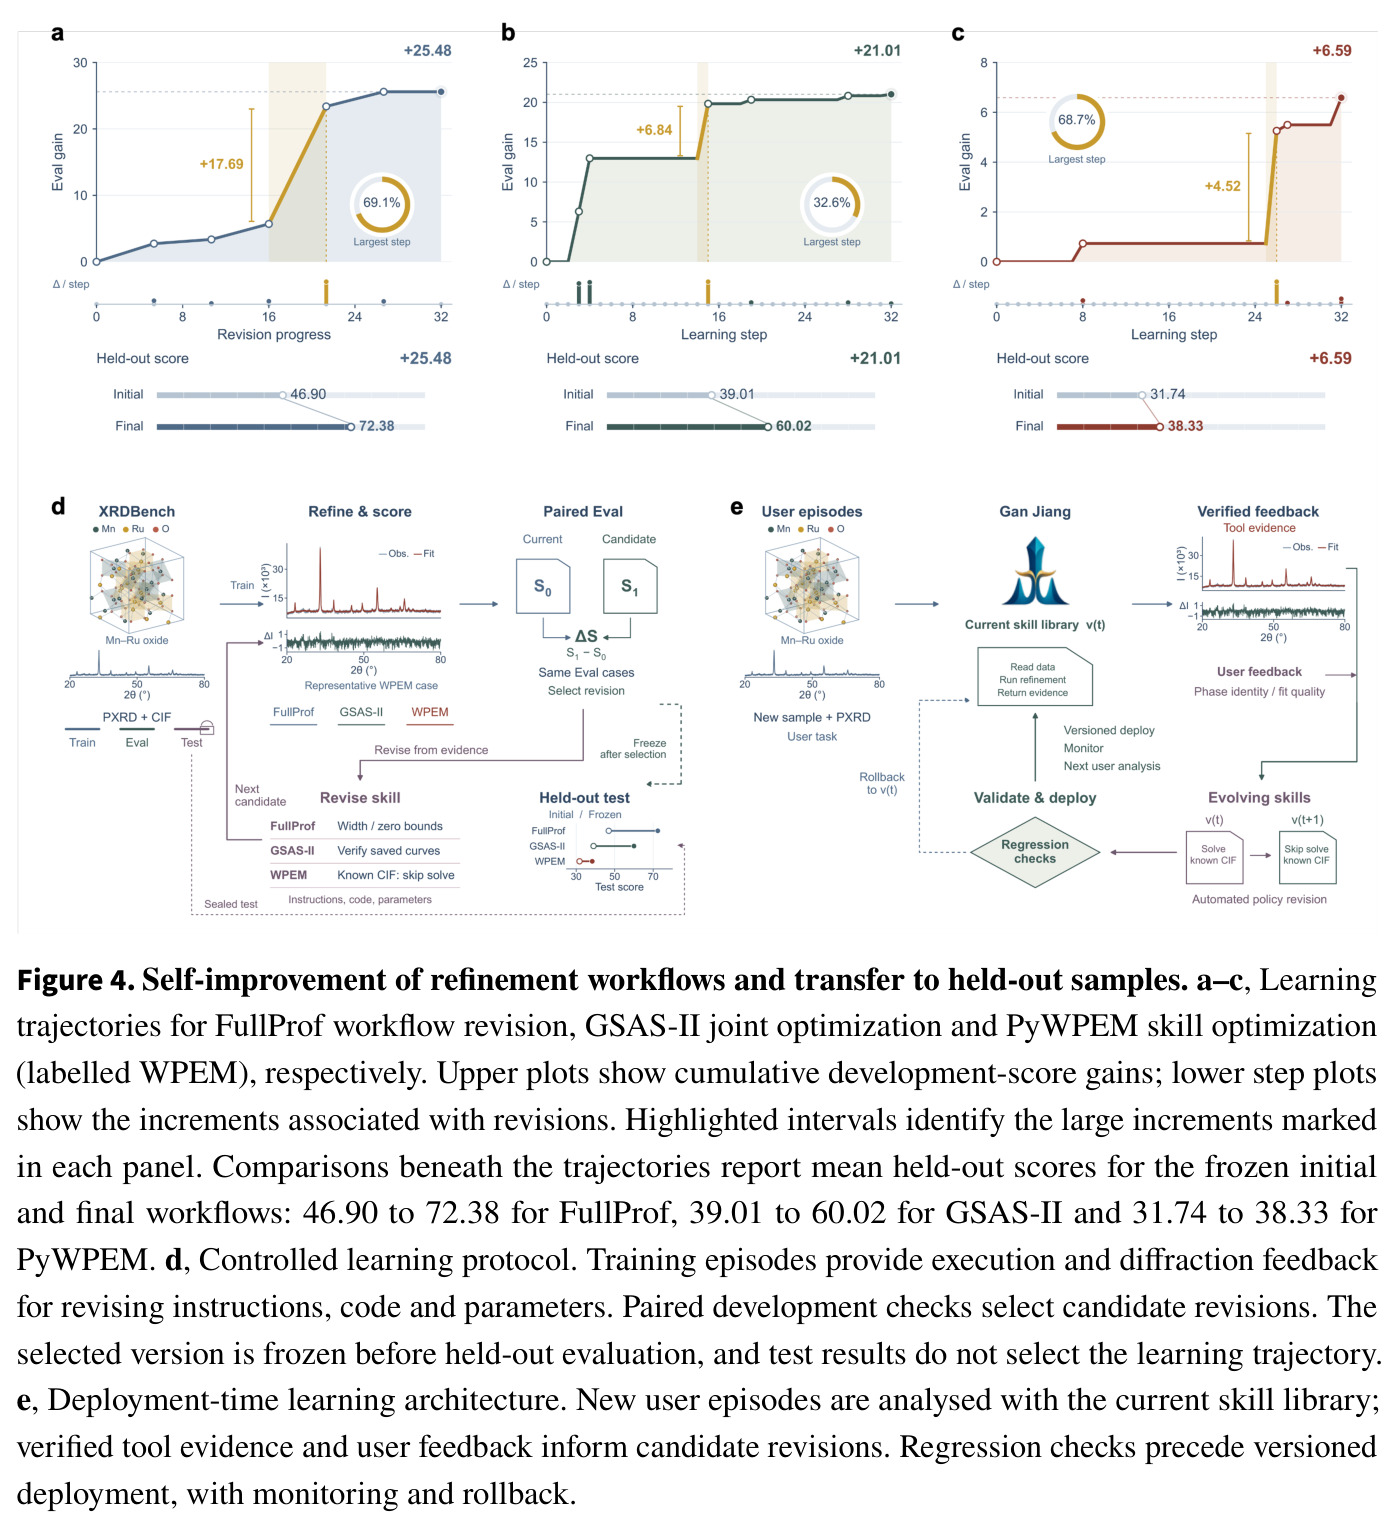
核心创新是'可执行技能 + 证据门控 + 冻结模型下反思修订'的三位一体。与把经验写进提示词或微调模型不同,干将的持久记忆是可执行技能:每条技能规定了做什么、何时做、如何评估结果,包含指令、提示与支撑代码,修订发生在技能层而非模型层,输入输出接口保持不变以便新旧版本直接对比。与常见智能体把工具报错当作'继续尝试'信号不同,干将显式区分计算失败与科学证据——一次工具调用失败不能证明样品是多相的,多相分支只在单相假设被证据完整否决后才启动。与一般'自我改进'的模糊说法不同,本文把改进做成可检验命题:训练片段产生候选修订,成对开发评估决定去留,随后冻结版本在留出样本上与初始专家流程对比(FullProf 46.90→72.38 等数字即来自这种受控比较),保证增益来自技能本身而非对开发数据的过拟合。
方法步骤详情
完整流程如下。第一步,本地解析并校验输入,产出 O/M/I 三种谱图工件与元数据。第二步候选召回:XMatcher 从观测峰构建理论峰库,做有界全局峰移搜索,用结合峰位与相对强度差异的代价函数做一一指派,按匹配精确率、理论峰召回率、强度覆盖与平均指派质量排名;用户提供元素时 XQueryer-LW 作为第二通道(原始谱加三个低通傅里叶重构输入深度可分离一维卷积编码器,元素引导查询经归一化余弦分类器输出排序)。第三步证据检验:导出候选 CIF,检查器报告强度加权观测覆盖率、预测峰精确率、各相支持度与混合物非负强度一致性,接受需通过全部峰证据门,允许有界角度偏移试探但不视为仪器校准。第四步精修:受支持相集或用户 CIF 进入 PyXplore/FullProf/GSAS-II,检查器对比对齐后的观测-计算谱,按检验分与峰覆盖率选出通过者,收敛或迭代预算问题至多重试一次,无法解释的峰则回到假设修正。第五步报告:输出 CIF、剖面图、诊断与含哈希的审计记录。第六步学习:从执行轨迹归因失败,提出指令/支撑代码/精修设置的修订,经成对开发评估择优保留,冻结后与初始流程在留出集上比较。
技术新颖性
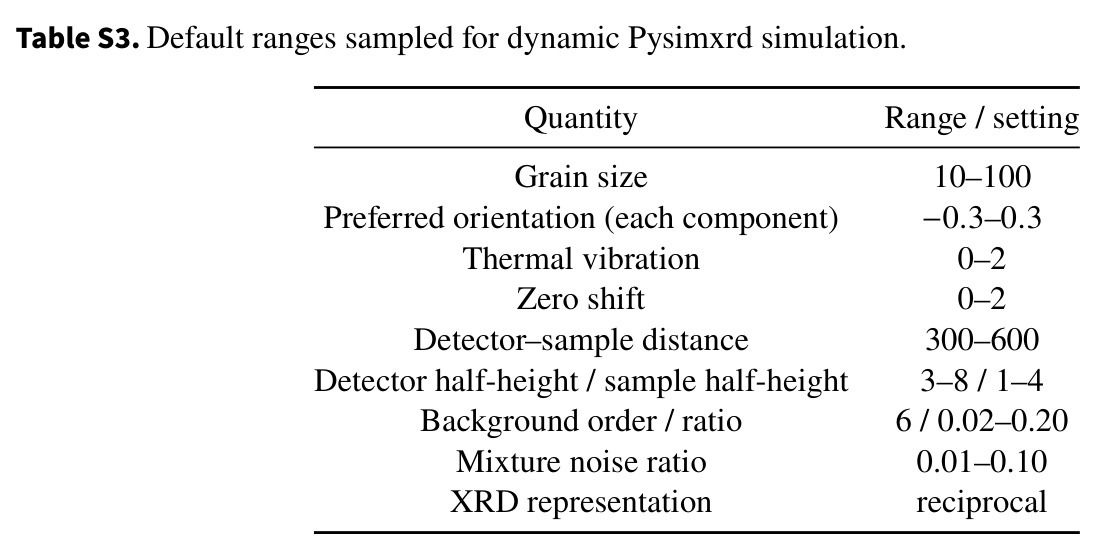
技术新颖性体现在四点。第一,生态整合:XMatcher、XQueryer-LW、XDecomposer、PyWPEM、FullProf、GSAS-II 各司其职,而现有基线要么只用固定候选库分类(AutoXRD),要么是依赖元素预测器的生成式管线(Uni3DAR、PXRDGen-Flow、XtalNet),要么是可重训的 CNN/组合管线(AutoAnalyzer、S-CNN),没有一个同时覆盖检索、分解、物理约束精修与证据检验。第二,把反思学习用于科学仪器工作流:失败归因指向具体流程环节,修订与衍射残差和精修物理合理性绑定,例如 GSAS-II 技能新增显式参数传递与保存输出校验,防止'请求被静默忽略'或诊断与存储结果不符。第三,评测方法学本身可复用:DeltaXRDbench 以提交 CIF 的结构匹配代替数据库 ID,单相排序列表与多相集合预测分离评估,覆盖率 $100|V|/N$ 只作分子不作分母,缺失预测一律计零留在分母。第四,技能版本化与回归检查为部署期持续学习提供了工程范式。
实验结果
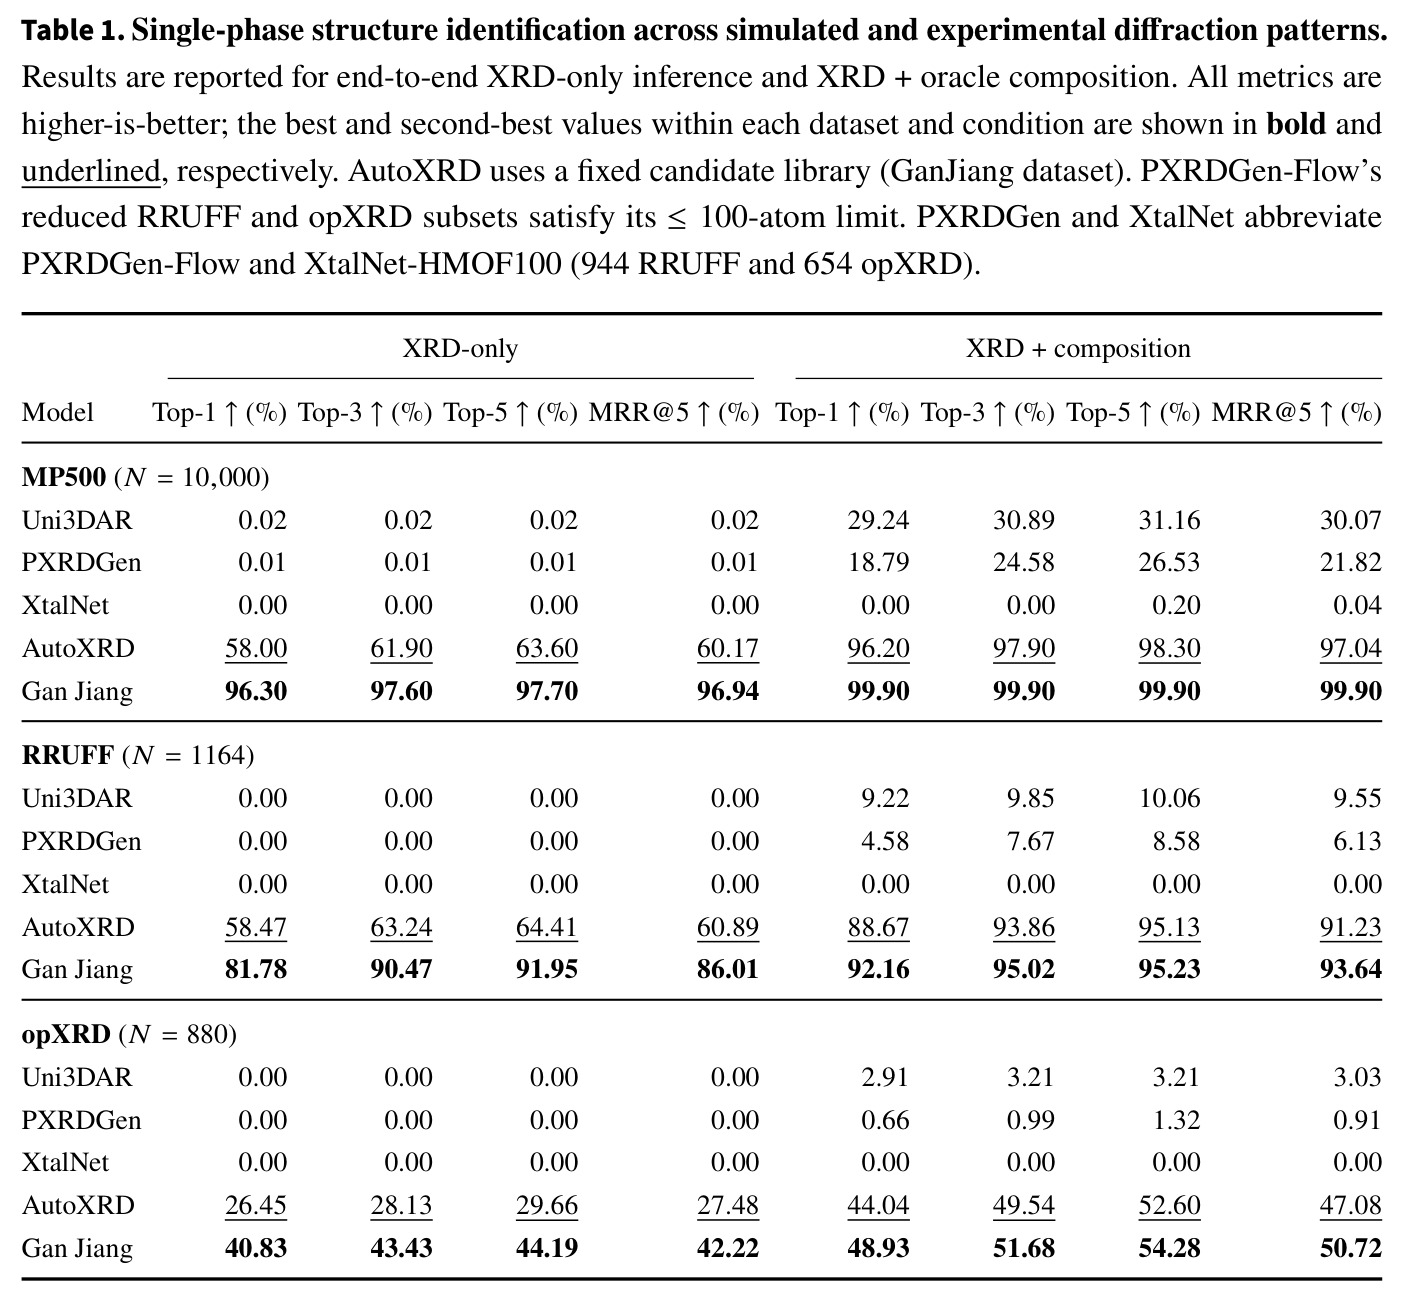
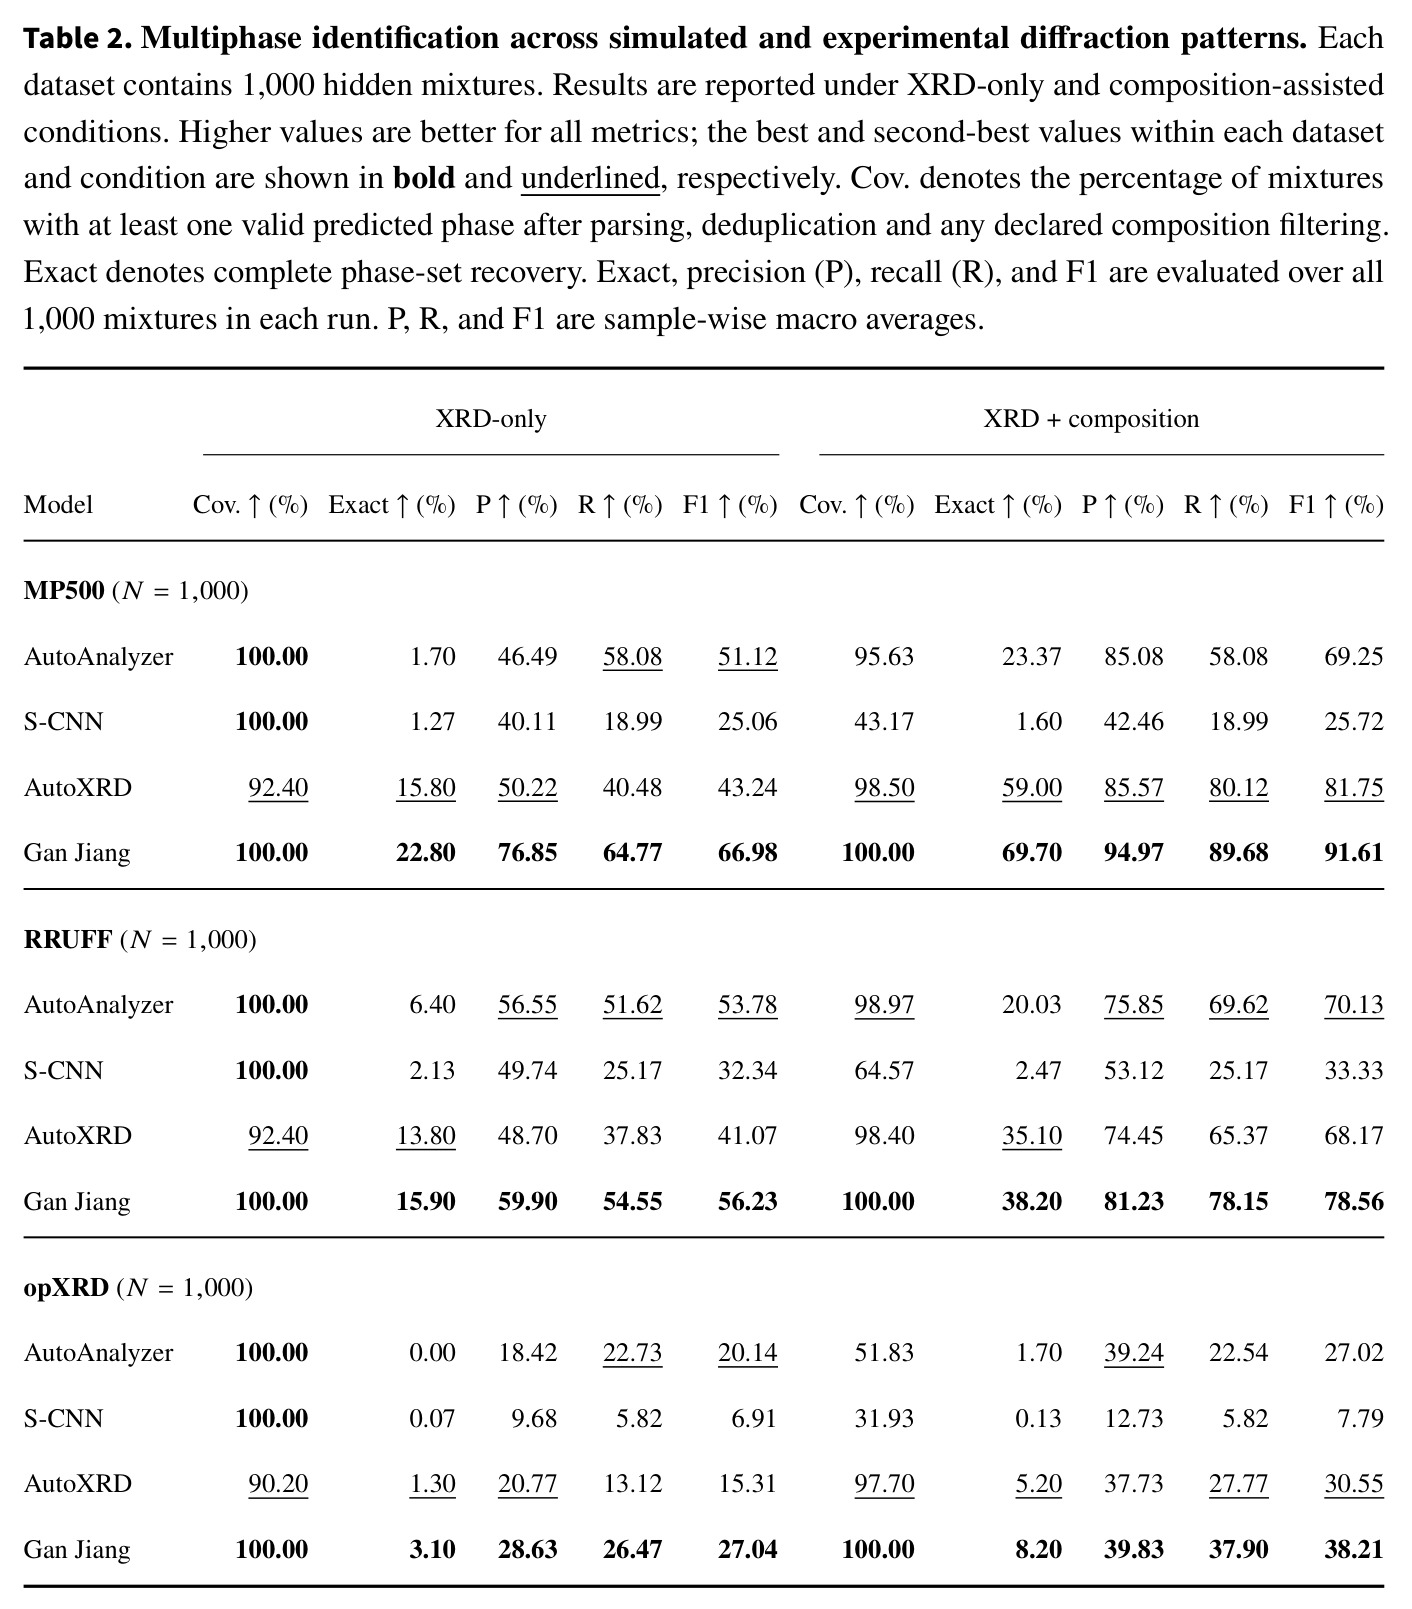
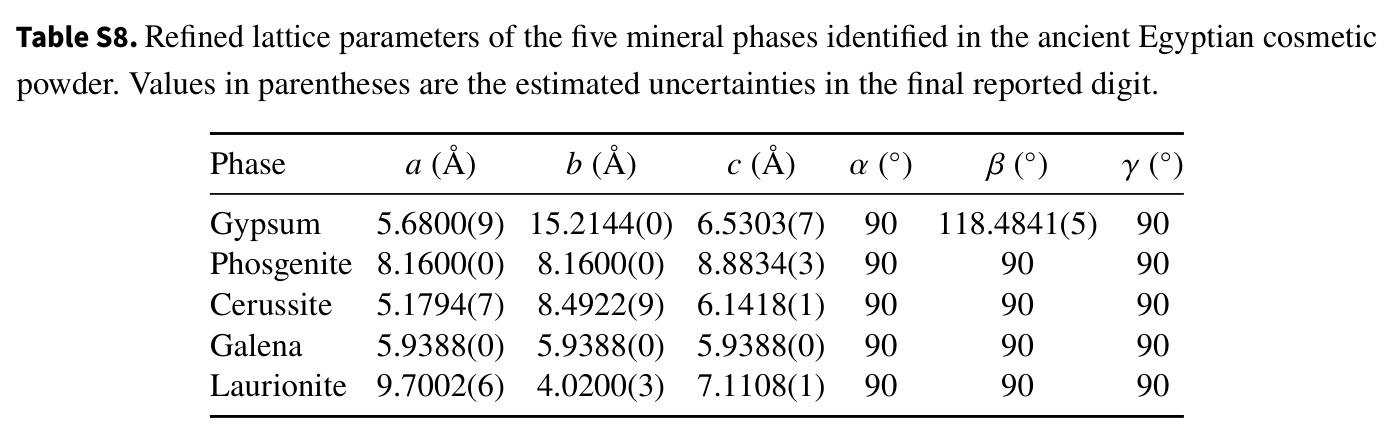
论文用三条证据链支撑结论。应用层面:正交 PbSO$_4$ 全谱精修达 $R_p=2.753\%$、$R_{wp}=5.926\%$;古埃及化妆品五相定量为石膏 12.53%、磷氯铅矿 18.53%、白铅矿 32.02%、方铅矿 9.69%、氯羟铅矿 27.23%($R_{wp}=13.079\%$);Ru–Mn 氧化物构型筛选精修 $R_p=1.447\%$、$R_{wp}=3.129\%$(CCDC 2530452)。技能迁移:留出集平均精修分 FullProf 46.90→72.38、GSAS-II 39.01→60.02、PyWPEM 31.74→38.33。单相基准(XRD-only top-1):MP500 96.30% 对 AutoXRD 58.00%、RRUFF 81.78% 对 58.47%、opXRD 40.83% 对 26.45%;加组成后升至 99.90%、92.16%、48.93%,MRR@5 达 96.94%、86.01%、42.22%。多相基准(各 1,000 混样、三种子):XRD-only 宏 F1 66.98%、56.23%、27.04% 全面领先,Exact 22.80%、15.90%、3.10%;加组成后 F1 91.61%、78.56%、38.21%,覆盖率恒为 100%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 单相物相鉴定(模拟数据 MP500,N=10,000) | Top-1 准确率(XRD-only) | 96.30% | AutoXRD 58.00%(Uni3DAR/PXRDGen/XtalNet 均≈0) | +38.30 个百分点 |
| 单相物相鉴定(实验矿物 RRUFF,N=1,164) | Top-1 准确率(XRD-only) | 81.78% | AutoXRD 58.47% | +23.31 个百分点 |
| 单相物相鉴定(实验 opXRD,N=880) | Top-1 准确率(XRD-only) | 40.83% | AutoXRD 26.45% | +14.38 个百分点 |
| 单相物相鉴定(MP500) | MRR@5(XRD-only) | 96.94% | AutoXRD 60.17% | +36.77 个百分点 |
| 多相物相鉴定(MP500,1,000 混样×3 种子) | 样本级宏 F1(XRD-only) | 66.98% | AutoAnalyzer 51.12%(AutoXRD 43.24%) | +15.86 个百分点 |
| 多相物相鉴定(RRUFF,1,000 混样×3 种子) | 精确集合恢复率 Exact(XRD-only) | 15.90% | AutoXRD 13.80%(AutoAnalyzer 6.40%) | +2.10 个百分点 |
| 多相物相鉴定(opXRD,1,000 混样×3 种子) | 样本级宏 F1(XRD-only) | 27.04% | AutoAnalyzer 20.14% | +6.90 个百分点 |
| 多相物相鉴定(MP500,组成辅助) | Exact / 宏 F1 | 69.70% / 91.61% | AutoXRD 59.00% / 81.75% | +10.70 / +9.86 个百分点 |
| 精修工作流自改进(FullProf 分支) | 留出集平均精修分(冻结版本对比) | 72.38(技能修订后) | 46.90(初始专家流程) | +25.48 |
| 精修工作流自改进(GSAS-II 分支) | 留出集平均精修分(冻结版本对比) | 60.02(技能+设置联合优化后) | 39.01(初始专家流程) | +21.01 |
| 精修工作流自改进(PyWPEM 分支) | 留出集平均精修分(冻结版本对比) | 38.33(技能优化后) | 31.74(初始专家流程) | +6.59 |
局限与改进
作者明确承认的局限:其一,opXRD 谱图常覆盖不全的角度范围,单相 top-1 只有 40.83%,说明结构歧义可能源于'从未测量到区分性信息';其二,即使有组成辅助,多相精确集合恢复仍很困难(opXRD 上仅 8.20%),且 DeltaXRDbench 的混合谱是源谱叠加生成,不能复现物理混合样品的全部效应;其三,PyWPEM 分支增益较小(31.74→38.33),收益依赖初始工作流、引擎与允许的修订范围,冻结版本对比评估的是整体迁移而非单个编辑的贡献;其四,当前实验证明的是'受控修订后的迁移',而非部署期开放式改进的纵向证据。我的补充观察:XQueryer-LW 被训练为元素感知模型,XRD-only 条件下神经检索通道缺失,无元素场景的能力未被单独验证;语言模型的身份、规模与调用成本在正文未披露;技能学习的训练片段规模与开发/留出集划分细节也主要放在补充材料。
独立分析的弱点
独立分析几个弱点。第一,元素依赖不对称:XQueryer-LW 需要用户提供元素才能启用,XRD-only 时检索只剩 XMatcher 一条腿,面对成分完全未知的新材料发现场景系统会退化,改进方向是训练元素无关版本的 XQueryer 或用生成式结构先验补位。第二,多相触发逻辑保守:自动模式必须等单相假设被完整拒绝才进入混合分支,在明显多相的工业样品上会浪费大量单相检索与检验预算,可引入谱图复杂度先验提前路由。第三,基准与现实差距:混合谱由源谱叠加生成,缺少吸收、微吸收、择优取向等真实混合效应,真实样品上的成绩可能低于表中数字,建议增加物理混合的第三方验证集。第四,技能学习收益不均衡:PyWPEM 仅提升 6.59 分,提示反思修订空间受引擎接口与参数自由度限制,可扩展允许的修订类别(如背景模型选择、数据分段策略)。第五,部署期学习(图 4e)只有架构设想没有实验支撑,回归检查阈值与回滚触发条件都需要工程化落地并验证。第六,100% 的覆盖率在 opXRD 上对应仅 27.04% 的 F1,'必有输出'与'输出可信'之间的落差需要在报告中更醒目地提示用户。
未来方向
作者提出的核心方向是把学习从'解释测量'延伸到'决定测量':当智能体识别出区分竞争假设所缺失的衍射特征时,可直接指挥衍射仪补测目标区间,重新评估解释并把经验写入技能库,前瞻性实验将检验这种分析—实验闭环能否提升测量效率与结构推断质量。基于本文成果还可延伸:把读写式反思学习迁移到其他表征手段(TEM、NMR、红外光谱),形成通用的科学分析技能库;利用 DeltaXRDbench 的结构匹配指标做主动学习,挑选高不确定性谱图扩充训练数据;把版本化技能库与共享仓库结合,实现跨实验室的流程知识沉淀与复用;针对 opXRD 低准确率问题,融合成分、光谱等多模态信息缓解测量不完整带来的歧义;把基准扩展到四相以上混合物、更宽角度网格与含噪声仿真,推动物相鉴定走向真实工业样品;以及用消融实验量化各引擎与技能修订类别的独立贡献。
复现评估
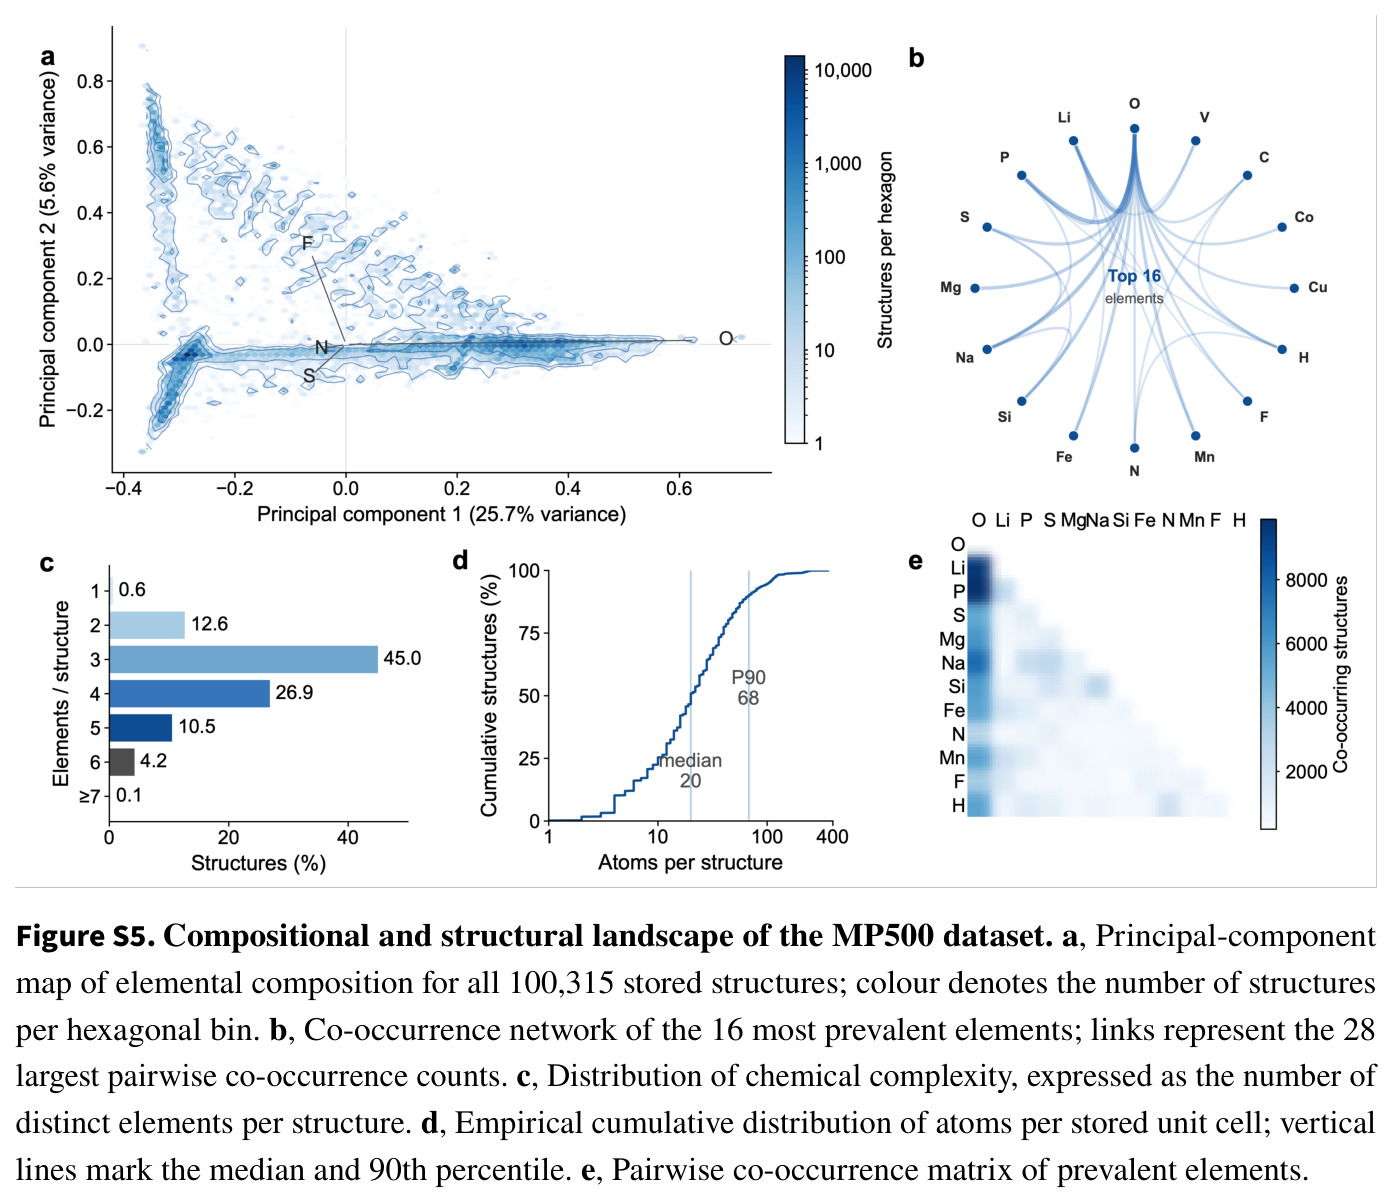
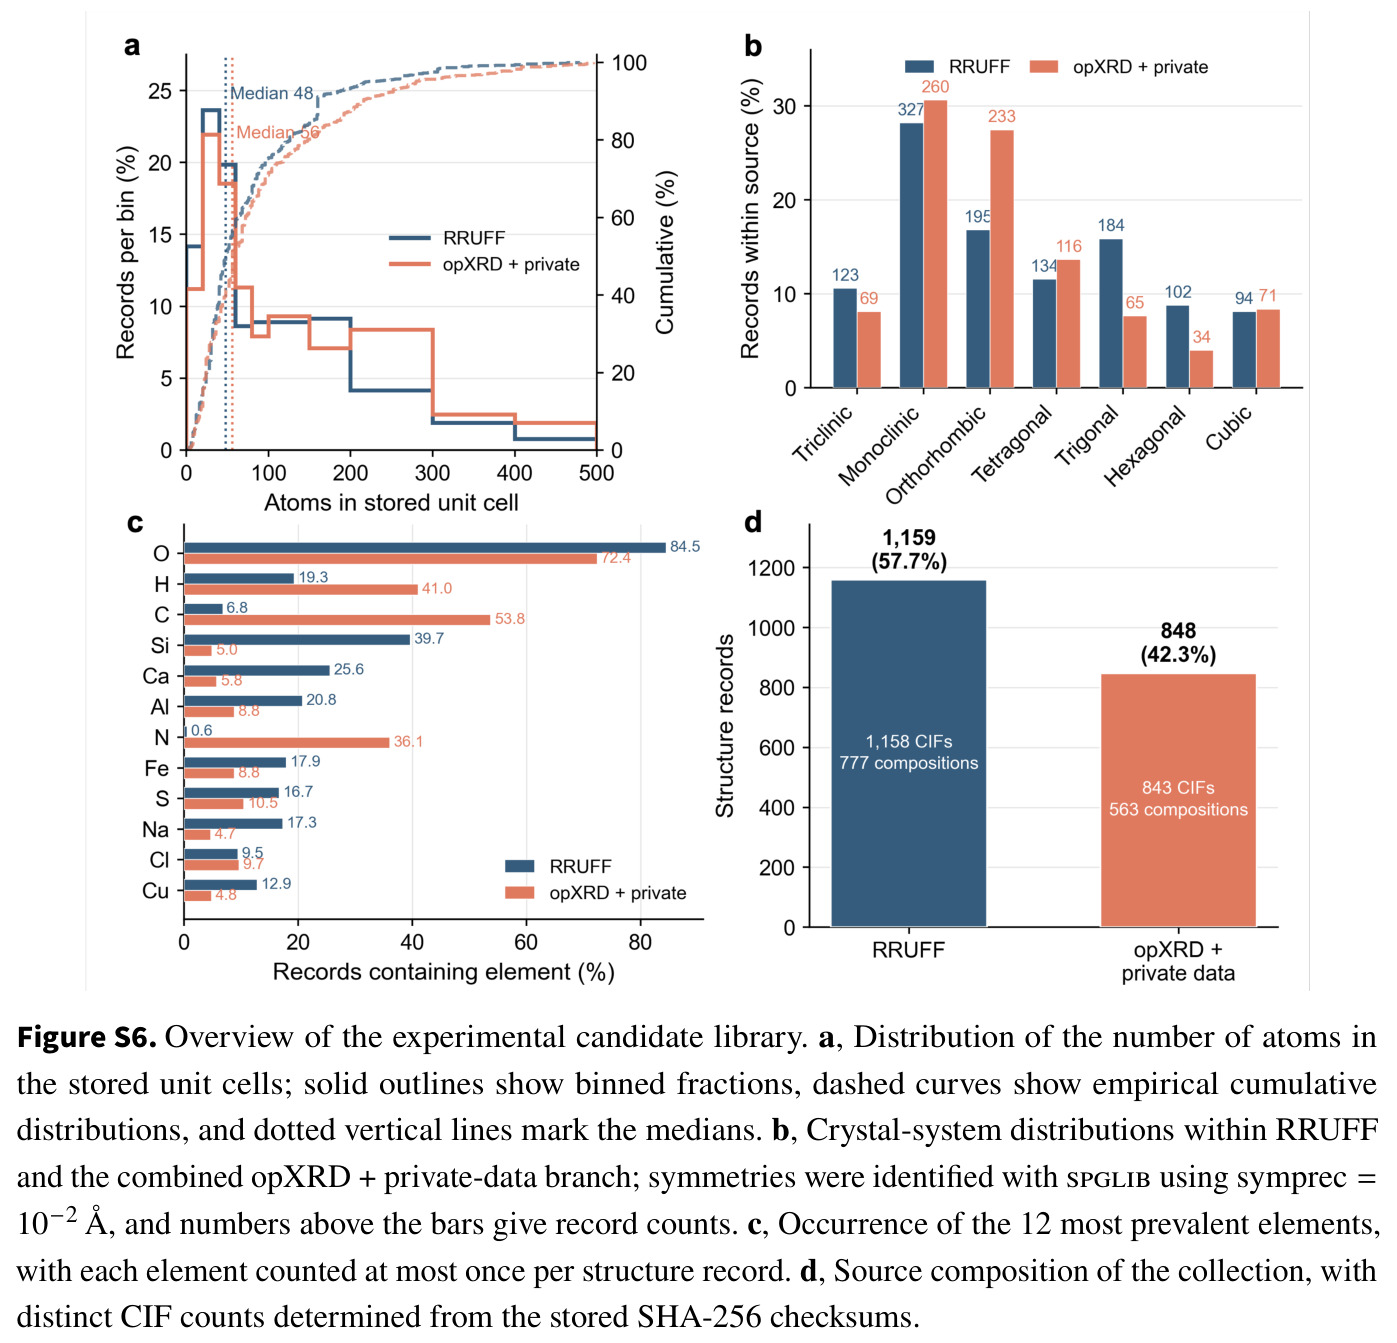
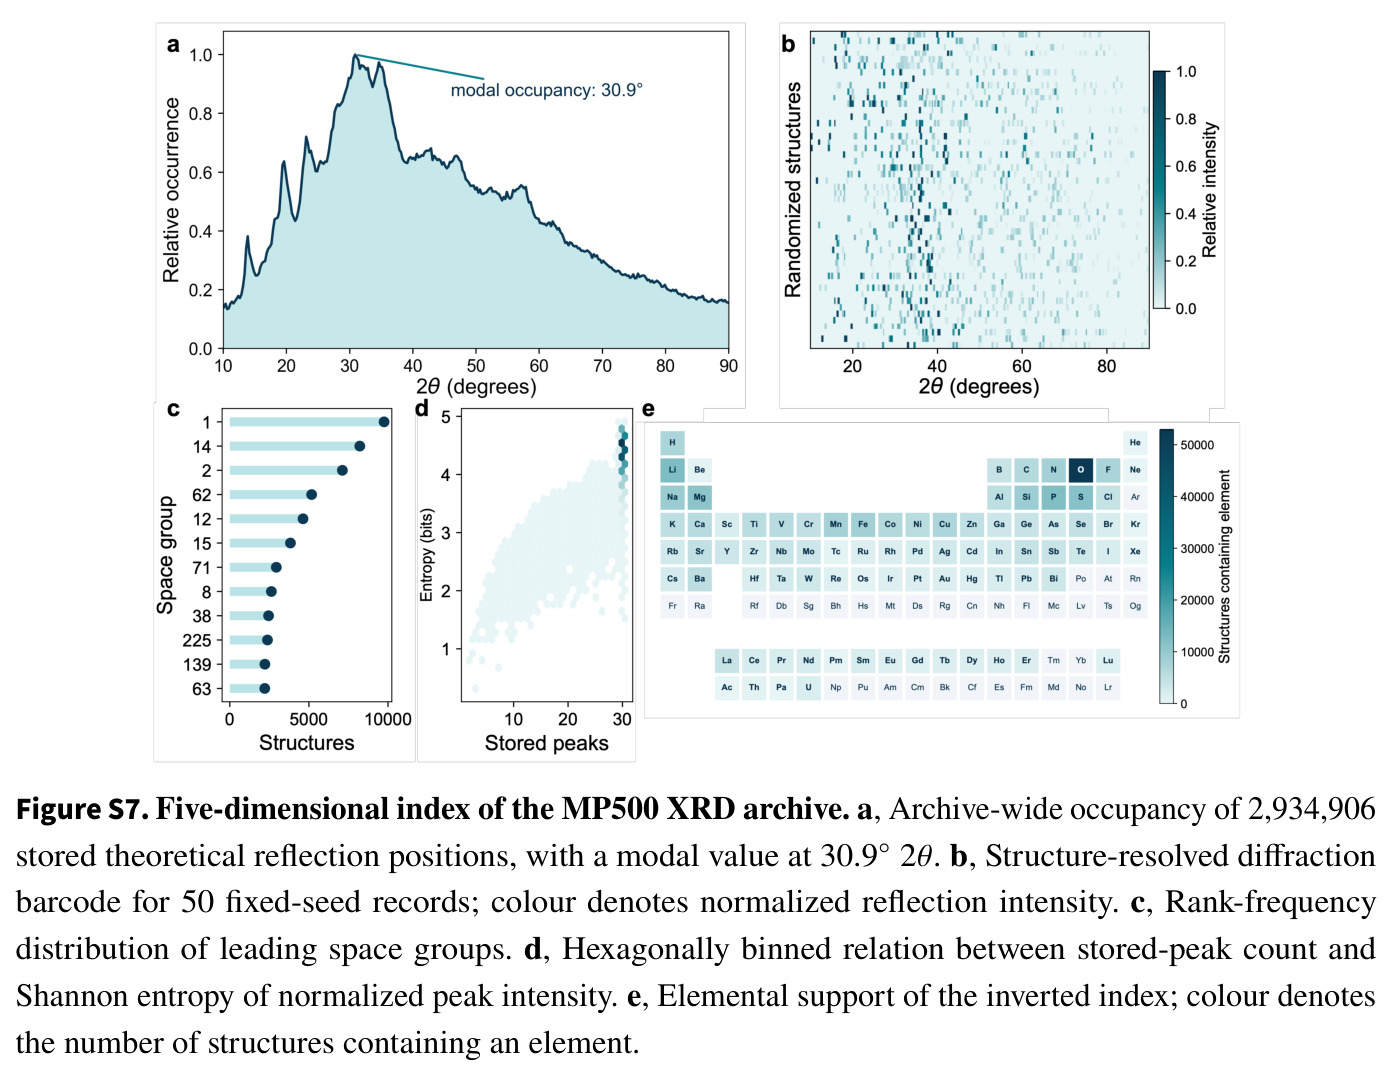
复现条件属中等偏难。开源情况:DeltaXRDbench 的数据资源与评测工具在 github.com/DeltaGanjiang/deltaxrdbench 公开,代码公开部分在 github.com/DeltaGanjiang,智能体架构与技能学习细节主要在补充方法中描述。数据方面:候选库为 100,315 个 MP500 结构(1–360 原子/胞,中位数 20)加 2,007 个实验结构(RRUFF 1,159 个、opXRD 与私有分支共 848 个),带源标识与 SHA-256 校验,但私有分支不可完全获取,严格复现 opXRD 全部数字会有缺口。评测协议确定性好:统一 10°–80°、0.01° 网格,三固定种子且不跨种子池化,覆盖率、Top-$k$、MRR@5、宏 F1、精确集合恢复均在 Methods 中给出公式。算力门槛在于训练或加载 XQueryer-LW 与 XDecomposer 的检查点、部署 PyXplore/FullProf/GSAS-II 三条精修分支,语言模型后端的规格与调用开销未在正文说明,技能学习的开发评估轮次也需依赖补充材料。
论文图表