Attacca:状态连续性下长时程具身智能体的目标导向控制 Attacca: Goal-Directed Control under State Continuity for Long-Horizon Embodied Agents
用异世界目标图像加目标定位与阶段监督训练单一策略,弥合长时程任务的技能交接鸿沟
前置知识
视觉目标条件策略
一类以视觉目标(目标图像或视频)为条件的低层控制策略:策略 $\pi_\theta(a_t \mid o_{1:t}, g_k, c_k)$ 每步接收自我中心 RGB 观测历史、目标图像与交互类型,输出鼠标键盘等底层动作。与文本指令相比,目标图像能直接展示"目标长什么样"而无需命名;此类策略通常用模仿学习训练。代表工作包括 STEVE-1、GROOT、ROCKET-1/2 等 Minecraft 智能体。
Attacca 本质上就是一个视觉目标条件策略,论文的全部设计(目标采样方式、辅助监督头、消融实验)都围绕如何训练这样一个策略展开,理解它是读懂方法与实验的前提。
行为克隆(BC)
最直接的模仿学习范式:给定专家演示 $(o_t, a_t)$ 序列,用监督学习最小化负对数似然 $\mathcal{L}_{BC} = -\sum_t \log p(a_t \mid o_{1:t}, g)$,让策略逐帧复现专家动作。它不需要奖励函数、训练稳定,但只对动作提供监督,对"目标在哪里、是否可见"等中间量没有任何直接约束,泛化完全依赖观测与目标中的统计相关性。
Attacca 的主干损失就是行为克隆,论文的核心论点之一是 BC 的动作监督隐式学不到目标定位与阶段切换,因此必须额外引入 grounding 和 phase 两个辅助损失,理解 BC 的局限才能理解这些设计的必要性。
后见之明目标重标注
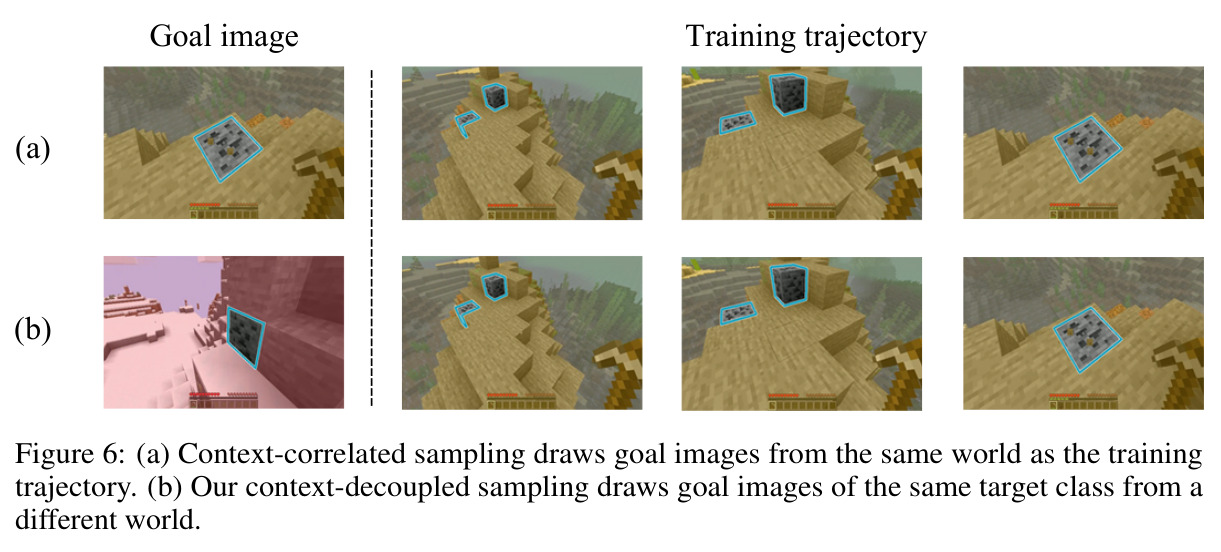
从演示轨迹自身构造训练目标的技术:检测到一次交互事件后,回看事件前目标可见的帧,把该帧及其目标掩码作为这条轨迹的"目标"。这样无需人工指定目标就能把任意轨迹变成目标条件数据,被 STEVE-1、ROCKET-2 等广泛使用。缺点是目标图像与轨迹来自同一个世界,目标图与观测共享场景背景和地形。
正是这种同世界采样让策略学会"复现目标视角"的捷径而非追逐目标本身,是本文实验中揭示的核心失败模式;Attacca 的 context-decoupled goal sampling 就是为打破它而设计,是全文动机的靶点。
FiLM 特征调制
Feature-wise Linear Modulation:用一个条件向量对特征做逐通道仿射变换 $z' = \gamma \odot z + \beta$,其中 $\gamma, \beta$ 由条件经线性映射(本文记为 $W_\gamma, W_\beta$)得到。它是一种轻量级条件化手段,让低维条件信号(如本文的行为阶段分布 $q_t$)以特征缩放和平移的方式影响网络表征,广泛用于视觉问答与条件生成。
Attacca 用 FiLM 把预测的行为阶段注入时序读出向量 $z_t$ 实现阶段自适应控制,并配合 stop-gradient 保证阶段头只被阶段监督训练而不被动作梯度污染,是方法第三组件的关键机制。
技能交接鸿沟(skill hand-off gap)
分层具身智能体中,高层规划器把复杂目标拆成子任务序列交给低层策略执行;但每个子任务开始时的状态是由上一个子任务留下的——位置朝向改变、世界被修改、下一个目标可能不在视野内。低层策略若只在"目标已在视野内"的孤立交互上训练,就无法从这种继承状态继续执行。论文把这一困难正式命名为 skill hand-off gap。
这是论文提出并要解决的核心问题,实验中的长时程任务链专门保留任务间状态(不传送、不对齐相机)来度量它;理解它才能明白为何短时程表现尚可的强基线在长时程链上几乎全军覆没。
Dice 损失
分割任务常用的重叠度量损失:Dice 系数为 $2|P \cap G|/(|P|+|G|)$,衡量预测掩码 $P$ 与真值 $G$ 的重叠比例,Dice 损失取 $1-\text{Dice}$。相比逐像素交叉熵,它对前景/背景比例失衡更鲁棒,鼓励整体空间重叠而非逐点分类正确,实践中常与 BCE 联用以兼顾局部与整体。
Attacca 的目标定位损失 $\mathcal{L}_{target}$ 正是逐 patch BCE 加软 Dice 的组合,理解它有助于把握 dense grounding 头如何同时获得局部监督与空间重叠约束。
研究动机
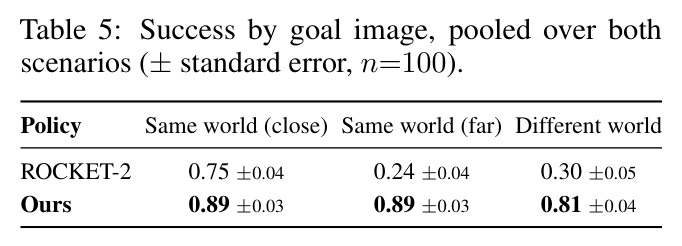
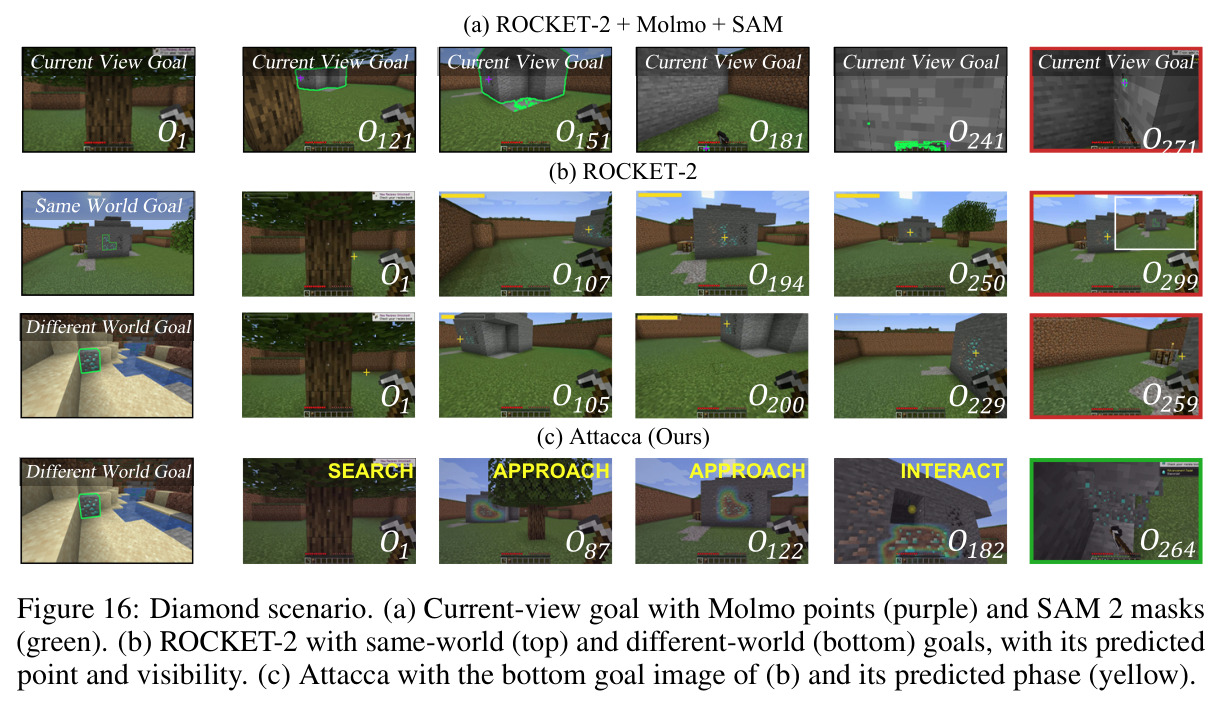
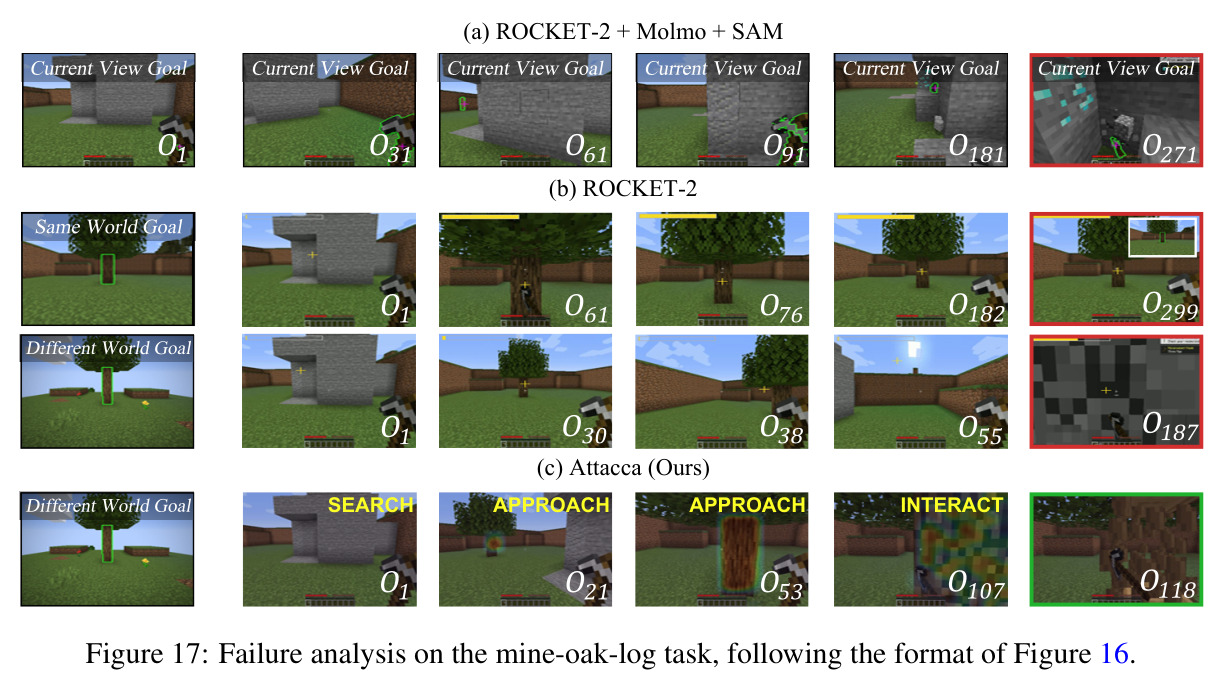
现有视觉目标条件策略几乎都在"目标已经出现在视野内"的孤立交互上训练和评测。ROCKET-1/2 这类 masked-goal 管线依赖 VLM(Molmo2)在当前观测中指向目标、再用 SAM 2 分割来在线构造目标掩码——一旦目标在视野外,Molmo 要么不返回点要么指错位置,目标根本无法构造,导致这些管线在 Mine 和 Place 上成功率不超过 5%,只有 Hunt 因动物会自己走进视野才升到 18–20%。更隐蔽的问题在训练目标的构造方式:以往工作用后见之明重标注从演示轨迹自身取目标帧,目标图与执行观测来自同一个世界,策略可以靠背景场景捷径"对齐视角"蒙混过关——实验显示微调后的 ROCKET-2 在"同世界近距离目标"下成功率 0.75,换成"同世界远距离"跌到 0.24,"异世界目标"仅 0.30,它会走到视野能复现目标图的地方就停下而不去交互。与此同时,DEPS、JARVIS-1、Optimus-1 等分层 Minecraft 智能体都把低层控制器列为高难度任务的主要失败来源。长时程执行中每个任务都从前一个任务留下的状态开始:位置朝向改变、世界被修改、下一个目标很可能不在视野内,论文将其概括为技能交接鸿沟。
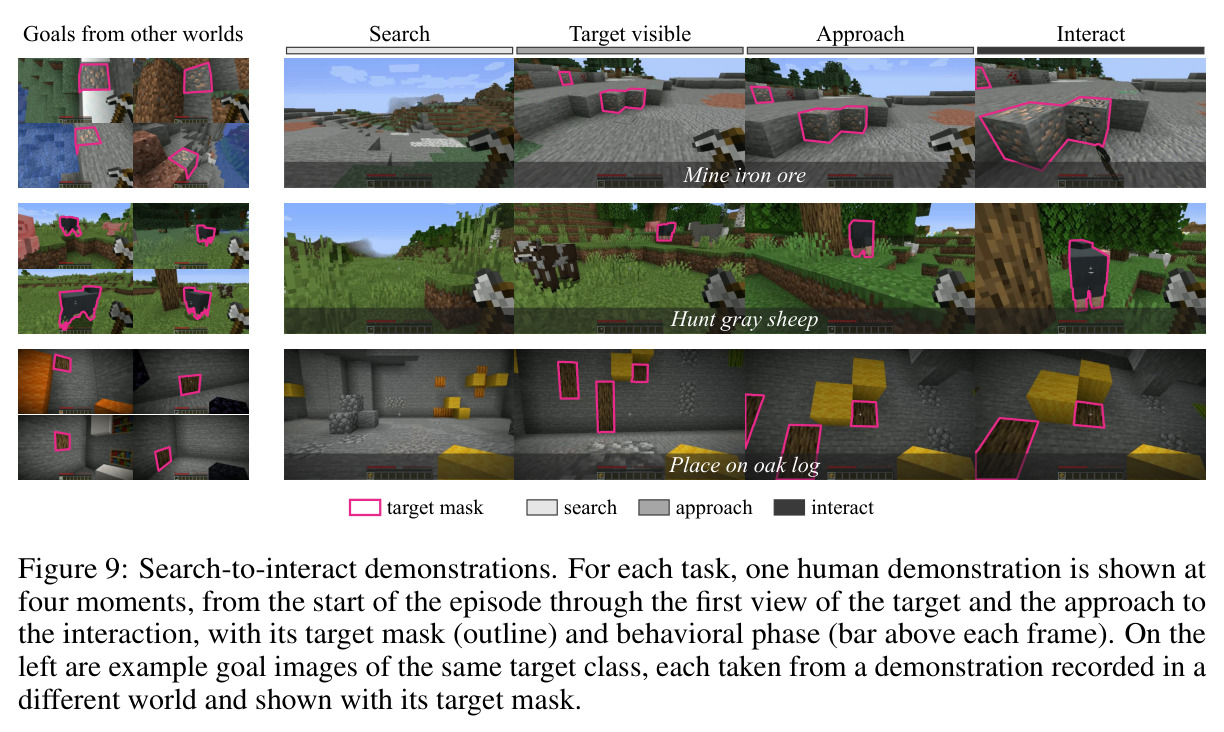
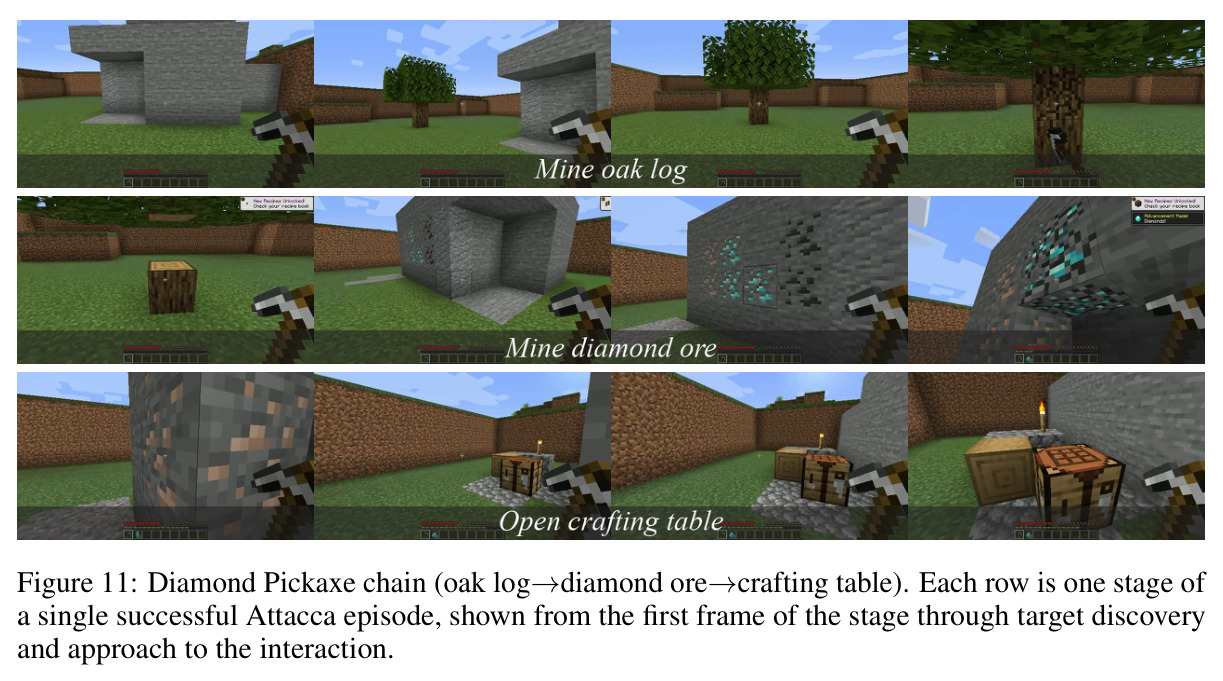
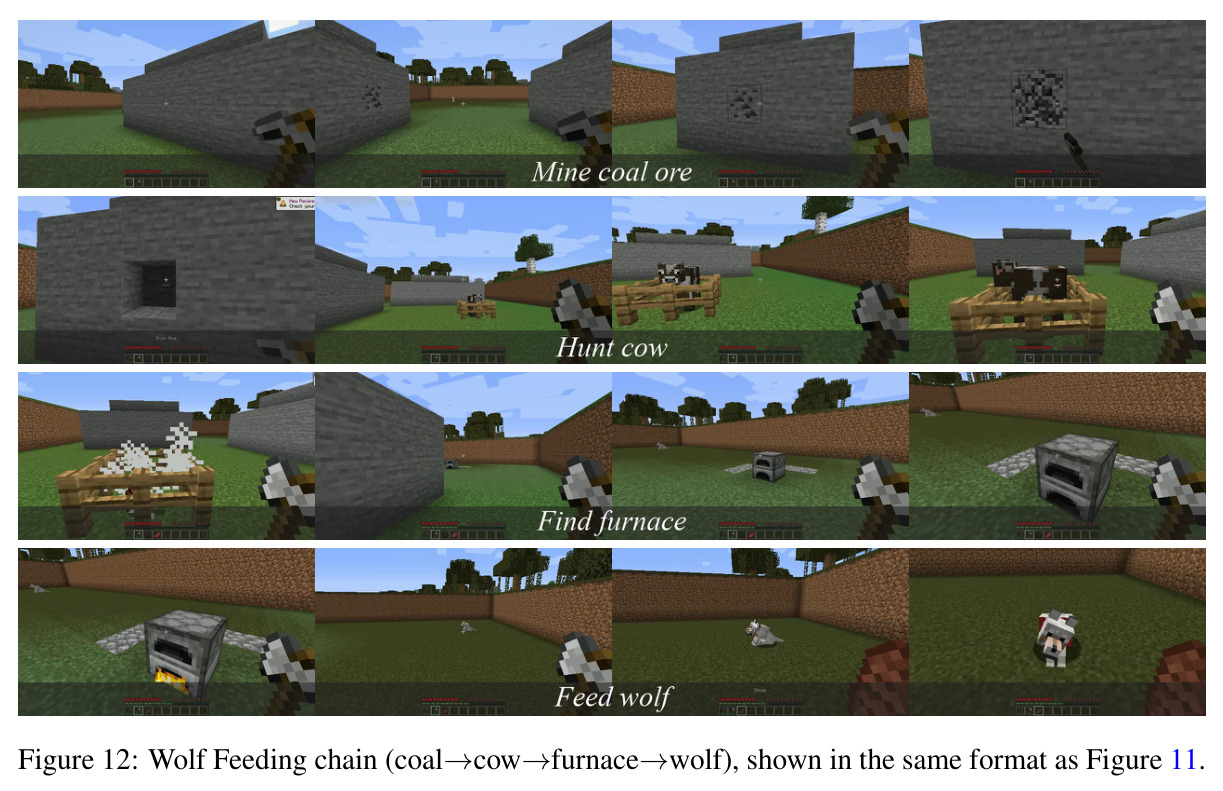
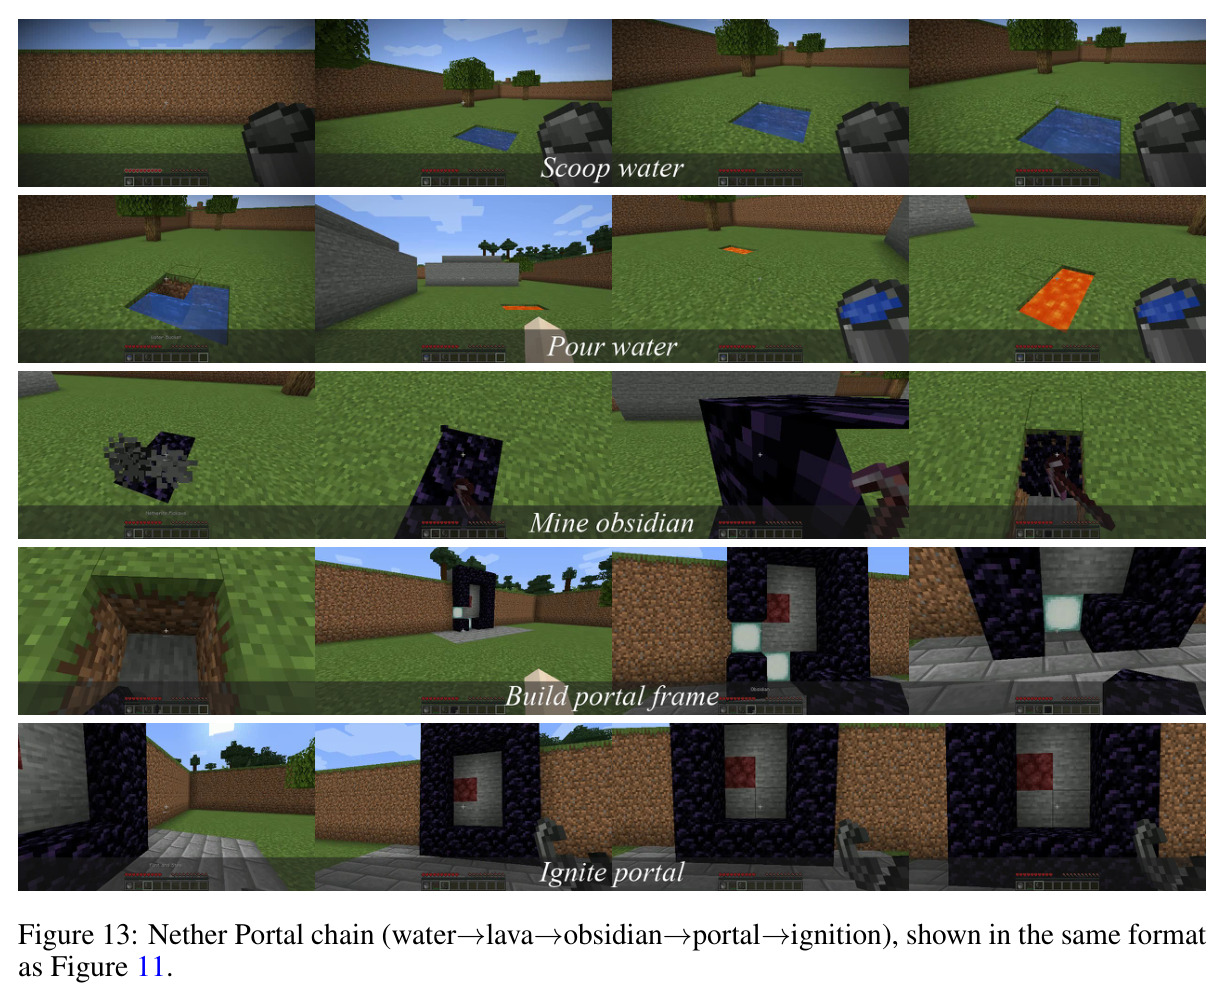
本文的目标是本文目标是训练一个单一低层策略:给定一张来自任意世界的掩码目标图像 $g_k=(o^g_k, m^g_k)$ 和交互类型 $c_k$,策略只凭自我中心视觉观测流完成完整的"搜索—接近—交互"流程——目标不在视野时主动搜索,发现后接近,够到后执行挖掘/狩猎/放置等交互,全程不依赖目标坐标、模拟器状态、外部定位或导航模块。评测设定专门考察状态连续性:单任务设定下目标初始就在视野外,需要完整搜索到交互的推进;长时程设定下多个任务连续执行,世界、位置、相机在阶段间完全继承,不传送也不强制对齐相机。同时在每个任务的 7 个训练见过的类别和 3 个留出(OOD)类别上验证泛化,并在三条状态保持的长时程任务链上量化交接能力。
与已有工作不同的是,本文的独特切入角度有三点。第一,问题定位新颖:不去改进规划器,而是研究低层策略内部的任务间交接,在保留继承状态的任务链上直接度量——这不同于 Voyager 用模拟器方块查询、Plan4MC 用激光雷达观测找目标的外挂式方案,后者绕开了视觉搜索问题本身。第二,目标构造反直觉:不是让目标图尽量贴近执行环境,而是刻意从另一个世界采样同类别目标的掩码图像,即 $w(g) \neq w(\tau)$ 且 $y(g)=y(\tau)$,从训练分布源头切断场景捷径,强迫策略学会类别级的视觉匹配。第三,监督信号更丰富:在动作模仿之外增加当前视野内的稠密目标掩码监督(含目标缺席帧的全零掩码)和行为阶段(Search/Approach/Interact)监督,把"找没找到、在哪里、现在该干什么"变成显式训练信号,而不是指望行为克隆隐式学出。
核心方法
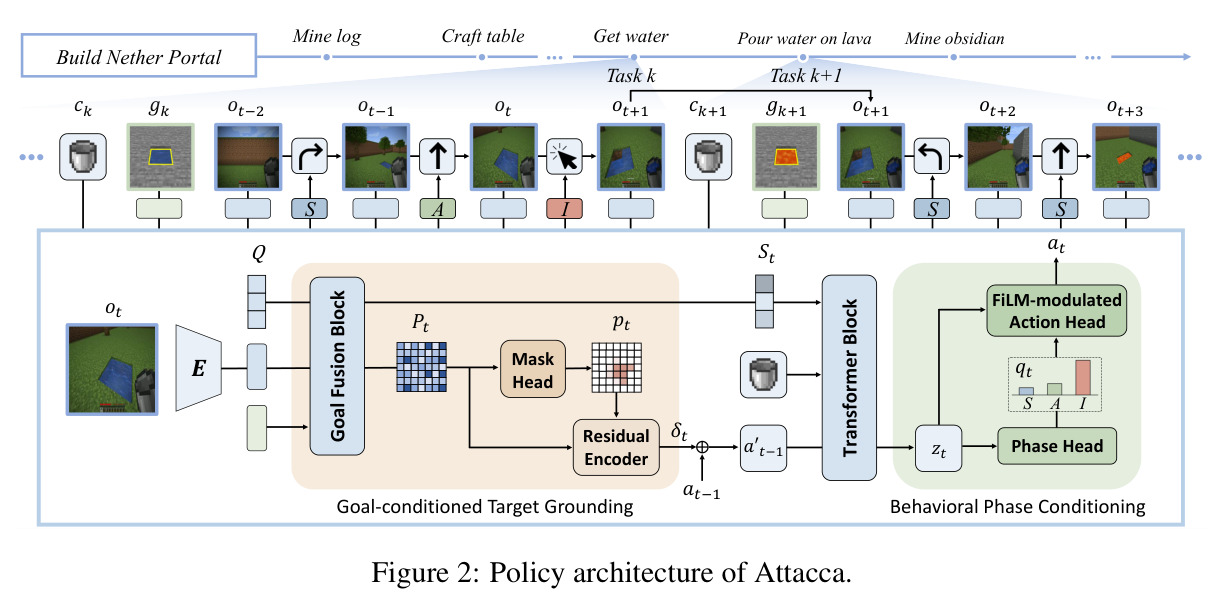
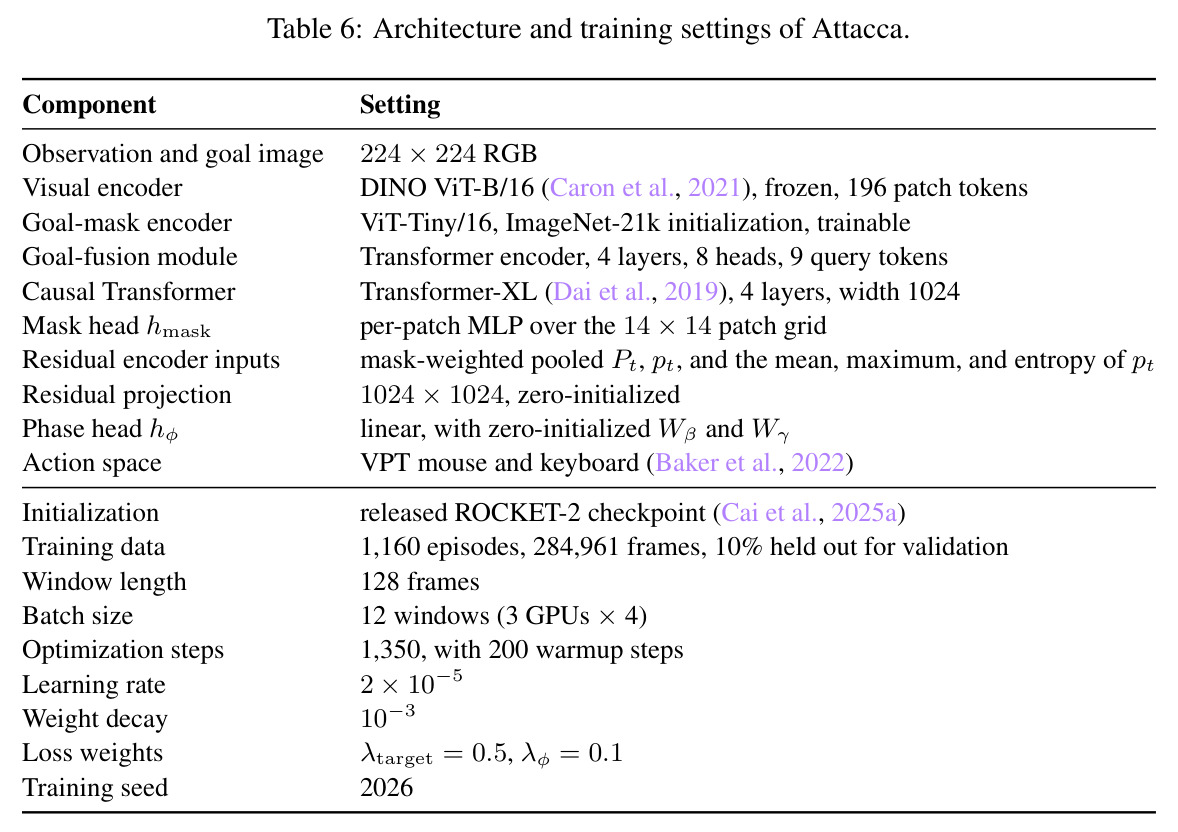
直觉上,要在继承状态下可靠交接,策略必须回答三个问题:目标长什么样(与目标图拍摄地无关)、它现在是否可见以及在哪里、当前处于哪个行为阶段。Attacca 用三个组件分别对应这三问。架构上:冻结的 DINO ViT-B/16 视觉编码器每个任务编码一次目标图像、每个时间步编码一次当前观测(196 个 patch token);可训练的 ViT-Tiny/16 编码目标掩码;目标融合模块(4 层 8 头 Transformer 编码器,9 个查询 token)计算 $[P_t, S_t] = \text{GoalFusion}(\hat{o}_t, \hat{g}_k, Q)$,得到目标条件观测特征 $P_t \in \mathbb{R}^{N \times d}$;因果 Transformer-XL(4 层,宽度 1024)结合交互类型 $c_k$ 与上一动作 $a_{t-1}$ 建模时序,并在上一动作 token 处读出 $z_t$;掩码预测经残差编码器压缩成向量 $\delta_t$ 加到读出 token 上;阶段分布 $q_t$ 经 FiLM 调制得到 $z'_t$;最后动作头输出 VPT 鼠标键盘动作。总损失为 $\mathcal{L} = \mathcal{L}_{BC} + \lambda_{target}\mathcal{L}_{target} + \lambda_\phi \mathcal{L}_\phi$,从 ROCKET-2 公开权重初始化。
核心创新是 context-decoupled goal sampling:每次采样训练轨迹时,随机抽另一条来自不同世界、但目标类别相同的演示,选一帧目标可见的画面连同其掩码作为目标图,即 $w(g) \neq w(\tau)$ 且 $y(g) = y(\tau)$,且每次重采样都换一张新图。这从分布层面消灭了"复现目标视角"这一捷径——目标图的地形与观测毫无交集,目标外观成为唯一可用线索,策略被迫学会类别级匹配。这与后见之明重标注(目标与轨迹同世界)有本质区别:后者在目标图恰好近距离拍到目标时可以靠场景对齐得分,一旦部署时目标来自陌生环境就崩溃(Table 5 中成功率 0.75 跌至 0.24/0.30)。在此基础上配合两个辅助监督:mask 头在当前观测 patch 上预测目标的可见支撑区域,目标不在时用全零掩码,教会策略"目标可见性"本身;phase 头区分 Search/Approach/Interact。二者把搜索到交互的全过程变成显式可学的结构,而非只靠动作模仿隐式覆盖。
方法步骤详情
方法步骤如下。(1)数据构建:在 1,160 个不同世界收集资深玩家的 search-to-interact 演示共 284,961 帧(Mine 822 段 209,593 帧、Hunt 198 段 47,991 帧、Place 140 段 27,377 帧,各含 7 个训练类别,10% 留作验证);渲染器通过深度缓冲反投影逐帧生成目标掩码,35% 帧目标不可见记全零掩码;阶段按规则标注:对目标有 attack/use 事件为 Interact(占 20%),目标可见或曾见且暂离视野为 Approach(47%),否则 Search(33%)。(2)目标采样:每加载一条轨迹,从另一世界的同类别演示中抽一帧目标可见的 RGB+掩码,缩放到 224×224 作为目标输入。(3)前向计算:DINO 编码观测与目标,融合模块产生 $P_t$ 与摘要 token;mask 头逐 patch 预测 $p_{t,i} = \sigma(h_{mask}(P_{t,i}))$;残差编码器(输入已 detach)汇总掩码加权池化的 $P_t$、$p_t$ 及 $p_t$ 的均值/最大值/熵为 $\delta_t$,经零初始化 1024×1024 投影加到读出 token;phase 头输出 $q_t = \text{softmax}(h_\phi(z_t))$,经 FiLM($W_\beta, W_\gamma$ 零初始化、stop-gradient)得 $z'_t$;动作头输出动作。(4)联合优化:$\mathcal{L}_{target} = \frac{1}{N}\sum_i \text{BCE}(p_{t,i}, \bar{m}_{t,i}) + \text{Dice}(p_t, \bar{m}_t)$,$\mathcal{L}_\phi = -\frac{1}{T}\sum_t \log q_{t,y_t}$,$\lambda_{target}=0.5$、$\lambda_\phi=0.1$,128 帧窗口、batch 12(3 GPU × 4)、1,350 步、学习率 $2\times10^{-5}$。(5)推理:不使用任何真值掩码、阶段标注或外部模块,仅靠观测流+目标图+交互类型。
技术新颖性
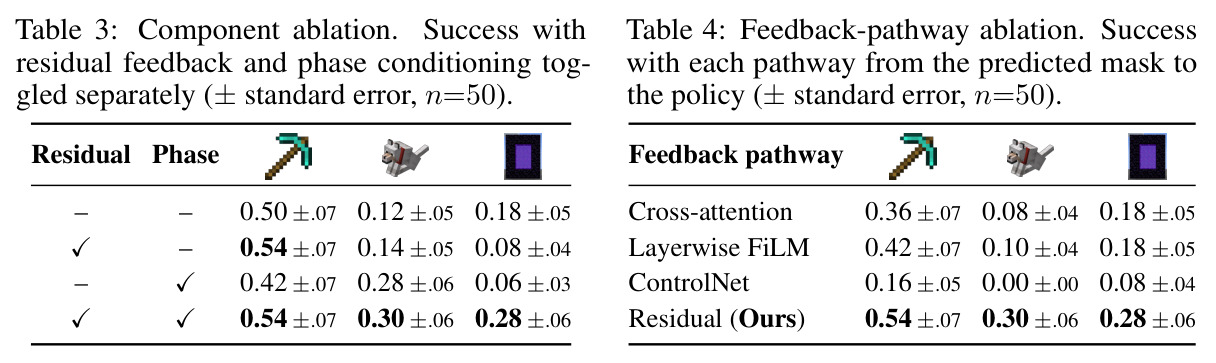
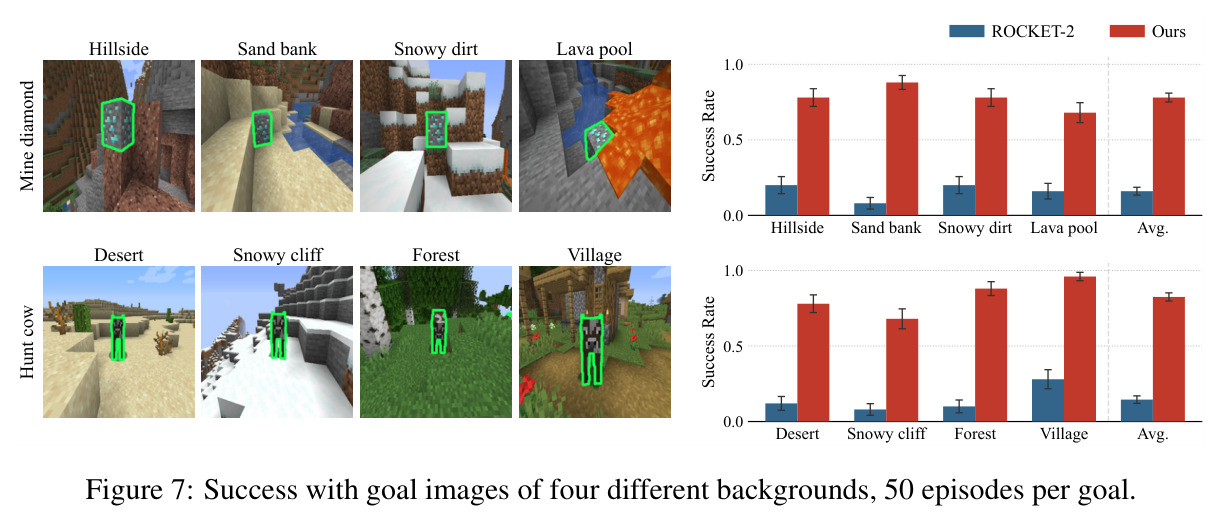
技术新颖性体现在三处。其一,训练时目标解耦是一个简单但被忽视的分布设计:现有目标条件工作都用同世界目标(后见之明重标注),本文证明仅改变目标图的采样来源就能消除视角复现捷径,且消融显示换用山丘/沙地/雪地/熔岩池四种背景的目标图性能稳定(0.68–0.96)。其二,辅助监督的接入方式经过仔细设计:mask 和 phase 头都通过 stop-gradient 与主干解耦,只被各自监督训练,避免辅助梯度污染动作策略;掩码信息以单个残差向量在读出 token 处注入——消融(Table 4)显示这一选择优于 cross-attention(0.36/0.08/0.18)、layerwise FiLM(0.42/0.10/0.18)和 ControlNet(0.16/0.00/0.08),本文残差通路达 0.54/0.30/0.28,作者推测单一向量让策略更容易吸收不同行为阶段间掩码出现/消失的大幅波动。其三,组件协同而非堆叠:Table 3 显示残差反馈与阶段条件单独使用都不稳定(如仅残差使 Nether Portal 从 0.18 降到 0.08,仅阶段使 Diamond Pickaxe 从 0.50 降到 0.42),合用才在三条链上分别提升 +0.04/+0.18/+0.10——阶段告诉策略"何时"从搜索切换到接近,残差告诉它目标"在哪里"。
实验结果
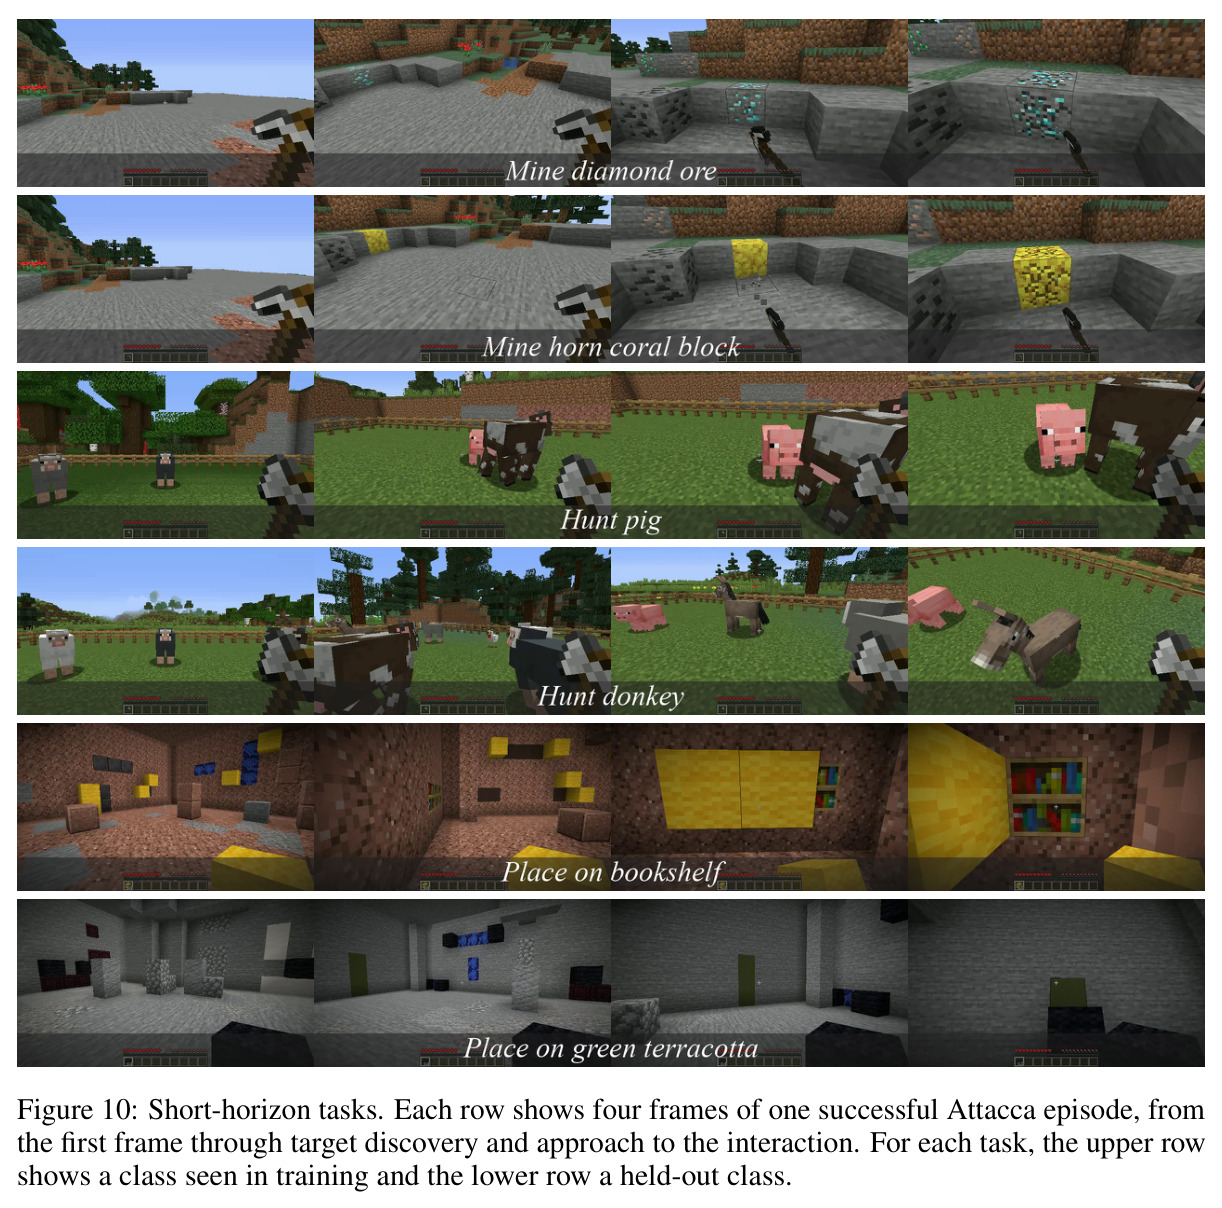
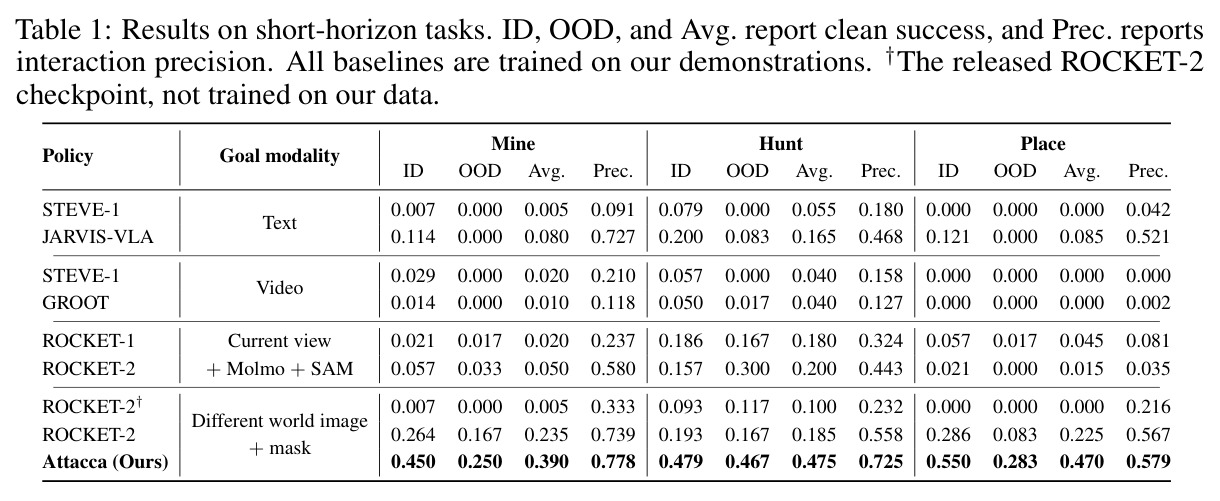
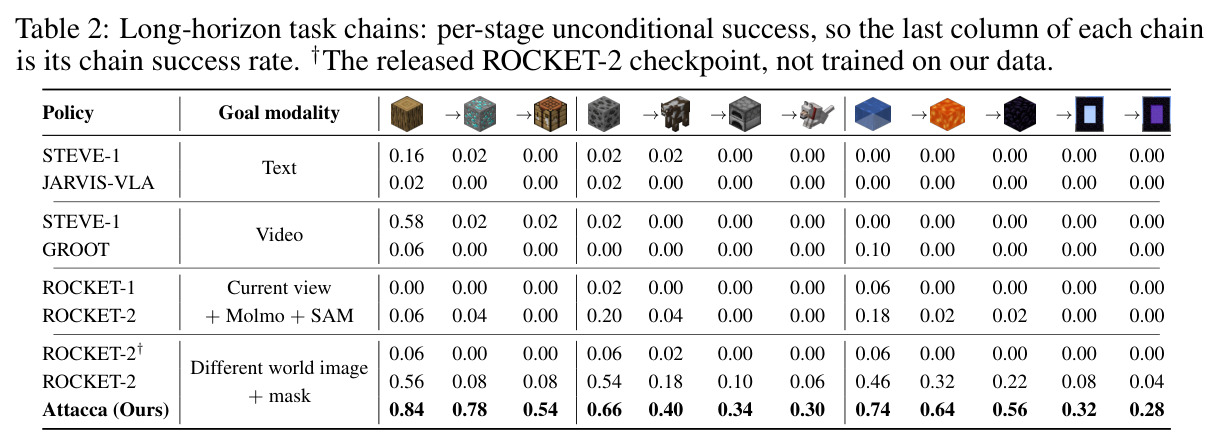
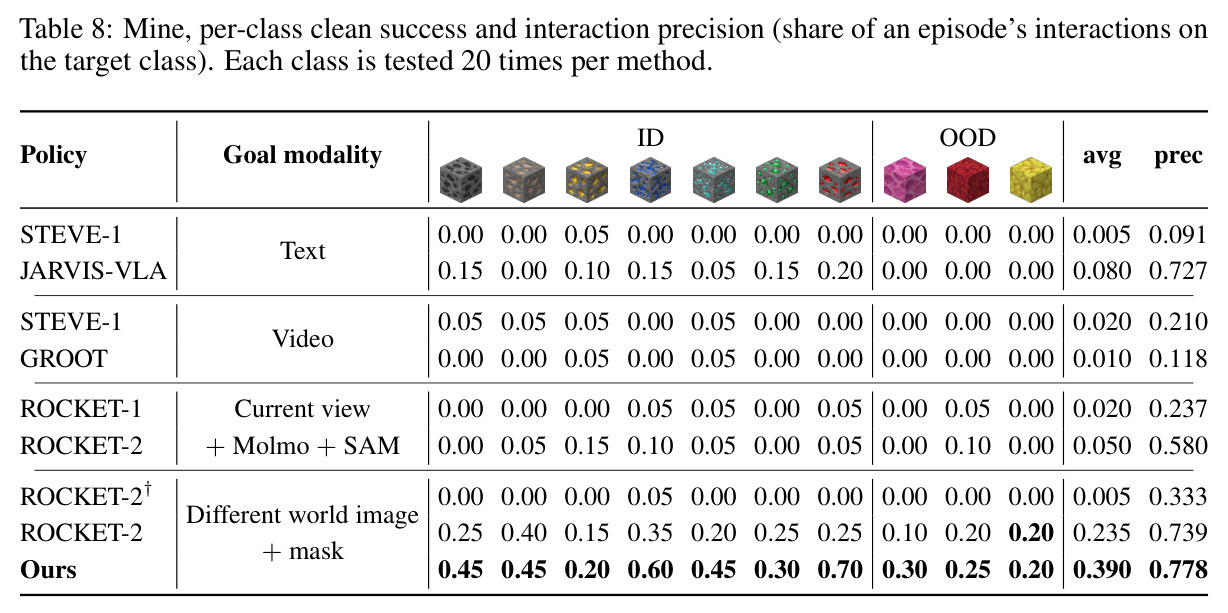
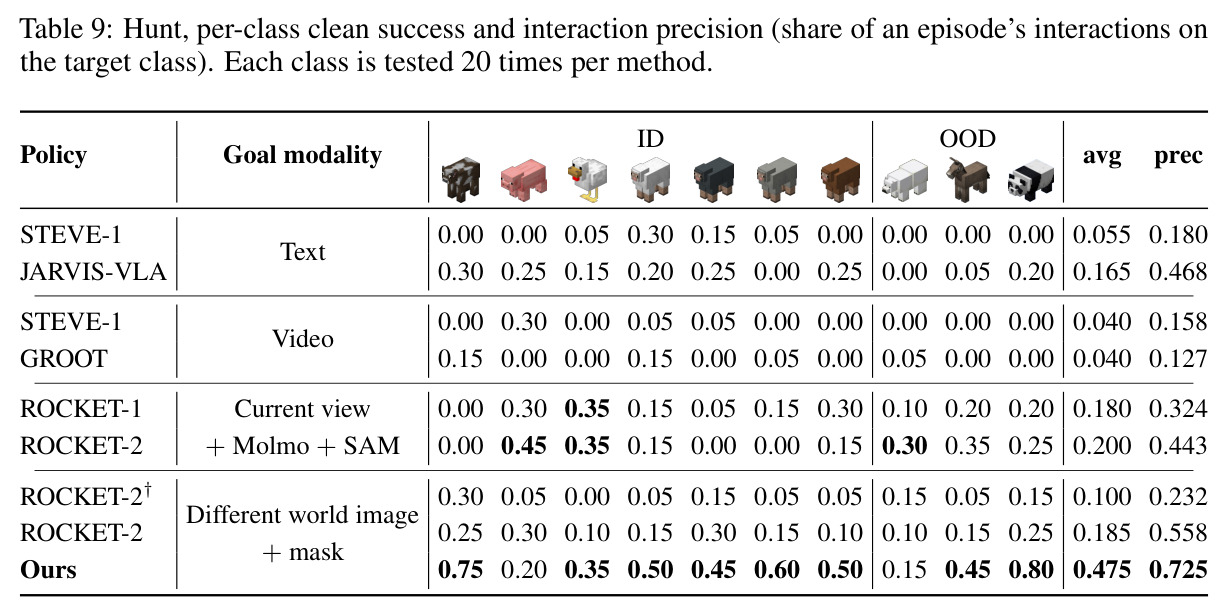
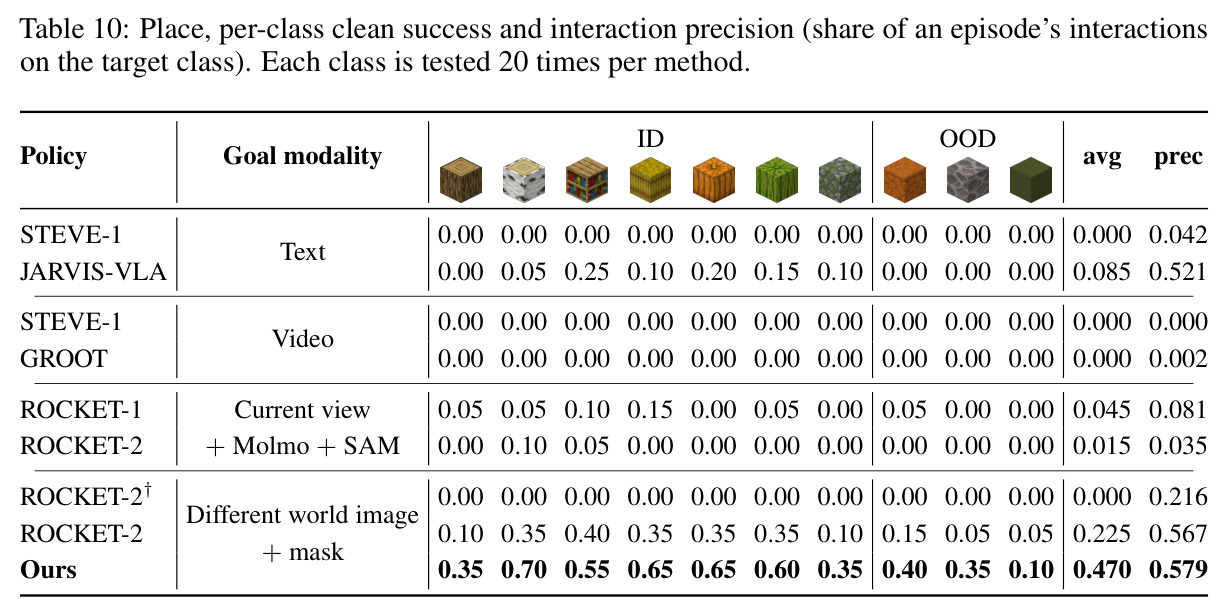
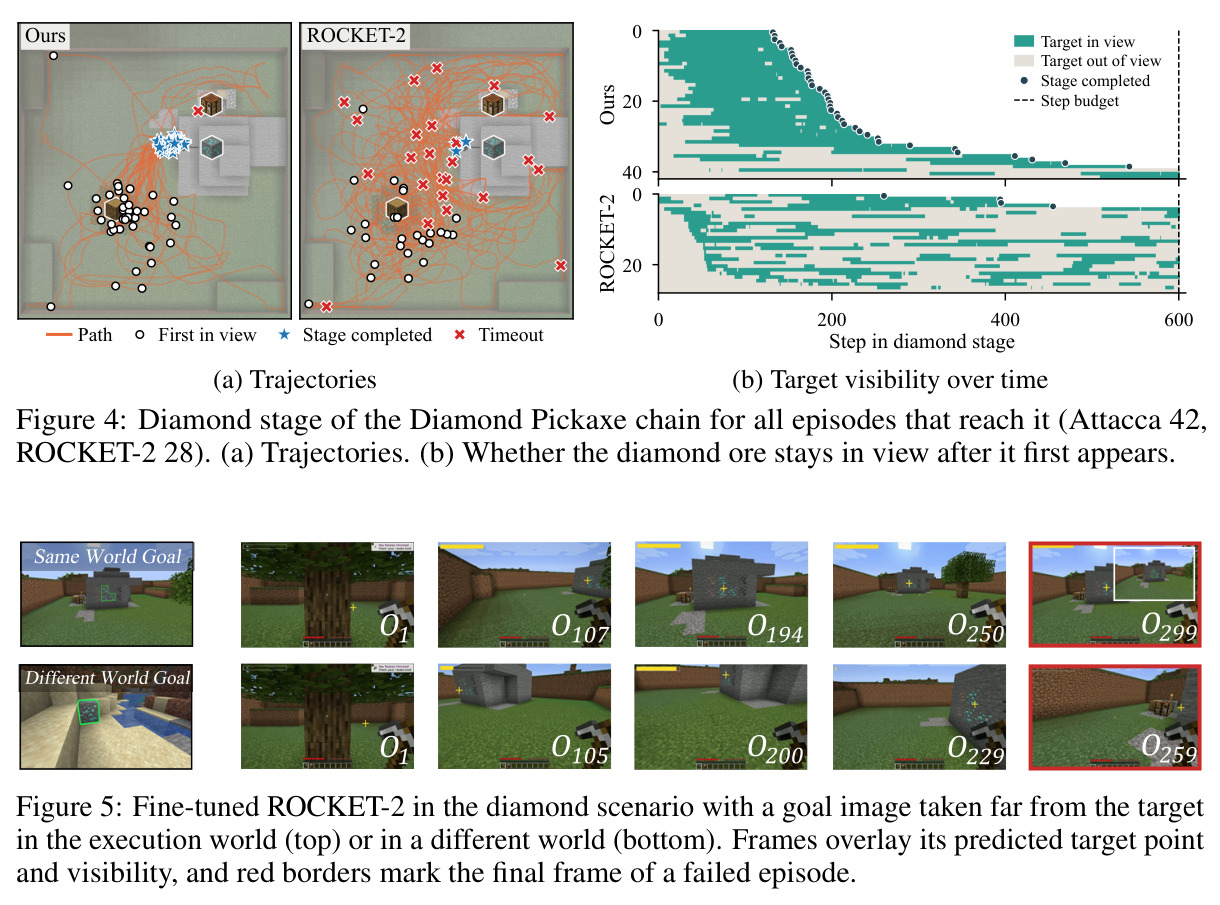
短时程任务(Table 1,每方法 200 回合,每任务 10 类目标含 3 个 OOD):Attacca 在 Mine/Hunt/Place 上平均 clean success 分别为 0.390/0.475/0.470,交互精度 0.778/0.725/0.579;对比基线中最强的是用相同数据与异世界目标图微调的 ROCKET-2(Mine 0.235、Place 0.225)与 ROCKET-2+Molmo+SAM(Hunt 0.200),即提升 1.7×/2.4×/2.1×。文本与视频目标基线接近全灭:STEVE-1 文本目标 Mine 0.005、Place 0.000;GROOT 视频 Place 0.000;JARVIS-VLA 最好也只有 Hunt 0.165。这说明 masked goal image 是更合适的目标接口,而 Attacca 在同数据同初始化下凭三个组件进一步拉开差距。长时程任务链(Table 2,每链 50 个配对策略种子):Attacca 整链成功率为 Diamond Pickaxe 0.54、Wolf Feeding 0.30、Nether Portal 0.28,对最强基线的 0.08/0.06/0.04 达到 5–7×;Attacca 每条链完成 14–27/50 回合,所有基线无一超过 4。阶段间"下一步完成率"在多数转换点保持 85–93%;最大差距出现在挖完橡木后:Attacca 几乎所有成功回合都继续找到钻石矿,微调 ROCKET-2 仅约七分之一。定性分析(Fig.4/5 与 Table 5):ROCKET-2 的 28 个到达钻石阶段的回合中 27 个目标进过视野,却只完成 4 个——失败发生在找到之后,目标反复离开视野、路径散开直至 600 步超时;Attacca 则 39/42 完成。目标背景鲁棒性(Fig.7):四种背景下 Attacca 成功率 0.68–0.96,ROCKET-2 仅 0.08–0.28。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Mine(短时程,10 类含 3 OOD,200 回合) | 平均 clean success | 0.390(ID 0.450 / OOD 0.250,精度 0.778) | 微调 ROCKET-2(异世界目标图):0.235 | 1.7× |
| Hunt(短时程,10 类含 3 OOD,200 回合) | 平均 clean success | 0.475(ID 0.479 / OOD 0.467,精度 0.725) | ROCKET-2+Molmo+SAM(当前视野目标):0.200 | 2.4× |
| Place(短时程,10 类含 3 OOD,200 回合) | 平均 clean success | 0.470(ID 0.550 / OOD 0.283,精度 0.579) | 微调 ROCKET-2(异世界目标图):0.225 | 2.1× |
| Diamond Pickaxe 链(橡木→钻石矿→工作台,50 种子) | 整链成功率(末阶段无条件成功) | 0.54 | 微调 ROCKET-2:0.08 | 约 6.75× |
| Wolf Feeding 链(煤→牛→熔炉→狼,50 种子) | 整链成功率 | 0.30 | 微调 ROCKET-2:0.06 | 5× |
| Nether Portal 链(水→岩浆→黑曜石→传送门→点火,50 种子) | 整链成功率 | 0.28 | 微调 ROCKET-2:0.04 | 7× |
| 钻石/橡木场景按目标图类型细分(n=100) | 成功率 | 同世界近 0.89 / 同世界远 0.89 / 异世界 0.81 | 微调 ROCKET-2:0.75 / 0.24 / 0.30 | 远距离与异世界目标下约 3–3.7× |
局限与改进
作者承认的局限(Sec. H):本工作只解决低层策略,长时程评测依赖脚本化的阶段控制器(负责下发目标图、判定阶段完成)和辅助宏(合成台合成木棍、熔炉烹饪、把熟牛肉放进快捷栏、阶段切换时装备正确物品);全部实验仅在 Minecraft 中进行;尚未与学习型规划器集成验证。我自己的观察:绝对成功率仍远未饱和(短时程最好 47.5%);Mine OOD 0.250、Place OOD 0.283 显示留出类别上有明显泛化缺口,个别 OOD 类(如绿色珊瑚块)仅 0.10;Hunt 精度 0.725 意味着约四分之一交互打在错误类别上,误杀旁观动物的风险真实存在;阶段标签与掩码分别依赖人工标注规则和渲染器深度缓冲,迁移到真实世界缺乏这种特权监督;目标图无法编码数量(挖 3 个钻石矿需控制器下发配额),目标类别必须存在于目标图库中;长时程链最长仅 5 个阶段且每链单一固定世界,更长组合与动态世界未验证;此外熔炉/合成台等 GUI 交互由宏代劳,策略本身并未学会物品管理。
独立分析的弱点
独立分析的弱点与改进方向:(1) 标注管线依赖模拟器特权——掩码来自深度缓冲反投影、阶段来自人工事件规则,真实机器人没有渲染器真值,这是走向实体的最大障碍;可改用开放词表分割模型(如 SAM 系列)自动产生伪掩码,配合基于接触/交互事件的自动阶段标注,或引入可见性的自监督信号。(2) 单残差向量注入是刻意的信息瓶颈:消融显示 patch 级 cross-attention 反而更差,说明粗粒度注入有利于吸收掩码波动,但也意味着空间精度有上限,接近阶段的精细对准仍完全依赖动作模仿;可尝试按阶段门控的注入强度或"输入残差+浅层轻量注意力"的双通路折中。(3) 缺乏显式记忆:Approach 阶段允许"目标暂时离开视野",但这完全依赖训练分布覆盖;若目标长时间丢失,策略没有显式的回退搜索机制,可引入记录上次掩码位置与相位的循环记忆,并在丢失超时时强制回退 Search。(4) OOD 类别缺口大(Place ID 0.550 vs OOD 0.283),部分类别近乎失败;可通过扩充类别多样性、目标图增广或测试时目标图重采样缓解。(5) 交互类型仅 Mine/Hunt/Place 三类,合成与装备由宏代劳,阶段头也只有三态;扩展动作库并让阶段语义覆盖更多子阶段(如"打开容器""切换物品")是自然延伸。(6) 冻结的 DINO 编码器面向自然图像,Minecraft 域差距未量化,域自适应微调编码器值得一试。
未来方向
作者提出的方向:把 Attacca 接入学习型规划器——由于目标图训练自异世界,规划器只需把语言子目标转成掩码目标图,可从固定目标图库检索、或用分割模型分割任何包含该目标的图像来构造,作者明确说明这种集成系统尚未评测;以及扩展到机器人导航与操作等其他具身领域。基于本文成果可延伸的方向:(1) 更长的任务链与动态世界(生物迁移、玩家改造地形)下检验交接优势的累积性是否保持;(2) 让目标表示携带数量与属性信息("挖 3 个钻石矿"),或在策略内学习停止条件,减少对控制器配额的依赖;(3) 将异世界目标图与文本、视频目标联合条件化,统一搜索型与利用型技能;(4) 在真实机器人上用网络视频构建异世界目标库,验证 context-decoupled 训练的可迁移性;(5) 把阶段条件化与分层强化学习的选项(options)框架结合,做阶段级奖励塑形或课程学习;(6) 结合世界模型让 Search 阶段具备主动探索规划而非反应式游走。
复现评估
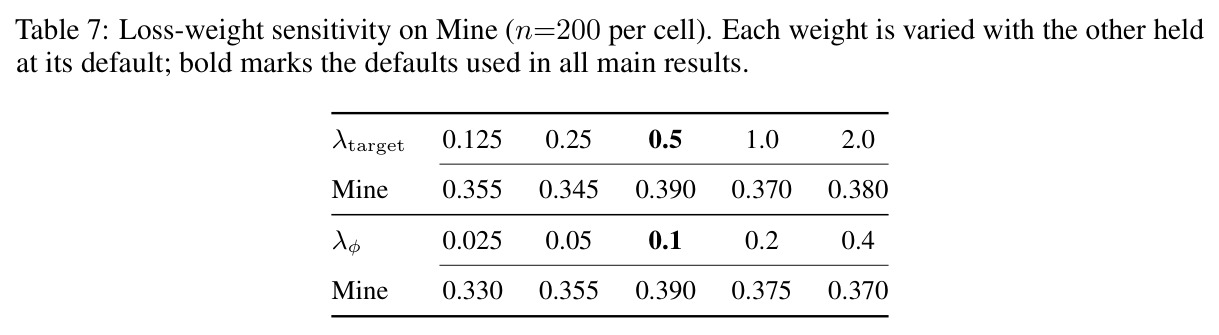
复现评估:方法完全建立在公开组件上——MineStudio 环境、VPT 动作空间、冻结 DINO ViT-B/16、ViT-Tiny/16、ROCKET-2 公开权重初始化;基线 STEVE-1/GROOT/JARVIS-VLA/ROCKET-1/2、Molmo2-4B、SAM 2 均有公开检查点;项目主页 attacca-project.github.io 已存在,但论文正文未明确承诺代码与 HumanPlay 数据集开源,这是复现的最大不确定点。算力门槛低:训练仅 1,350 步、batch 12 个 128 帧窗口(3 张 GPU × 4),学习率 $2\times10^{-5}$,属于轻量微调;损失权重在 16× 范围内波动仅引起 Mine 成功率 ±4.5/6.0 个百分点变化(n=200 时 95% 置信区间 ±6.7 个百分点),超参不敏感。主要瓶颈是数据:1,160 段、28.5 万帧的资深玩家演示需要大量人力采集,且掩码与阶段标注依赖 Minecraft 渲染器深度缓冲与标注规则——仿真内可完全复现,真实世界则需替代标注方案。评测规模为每方法 200 个短时程回合加 3 条链各 50 个配对种子,总体属于中等复现难度。
论文图表
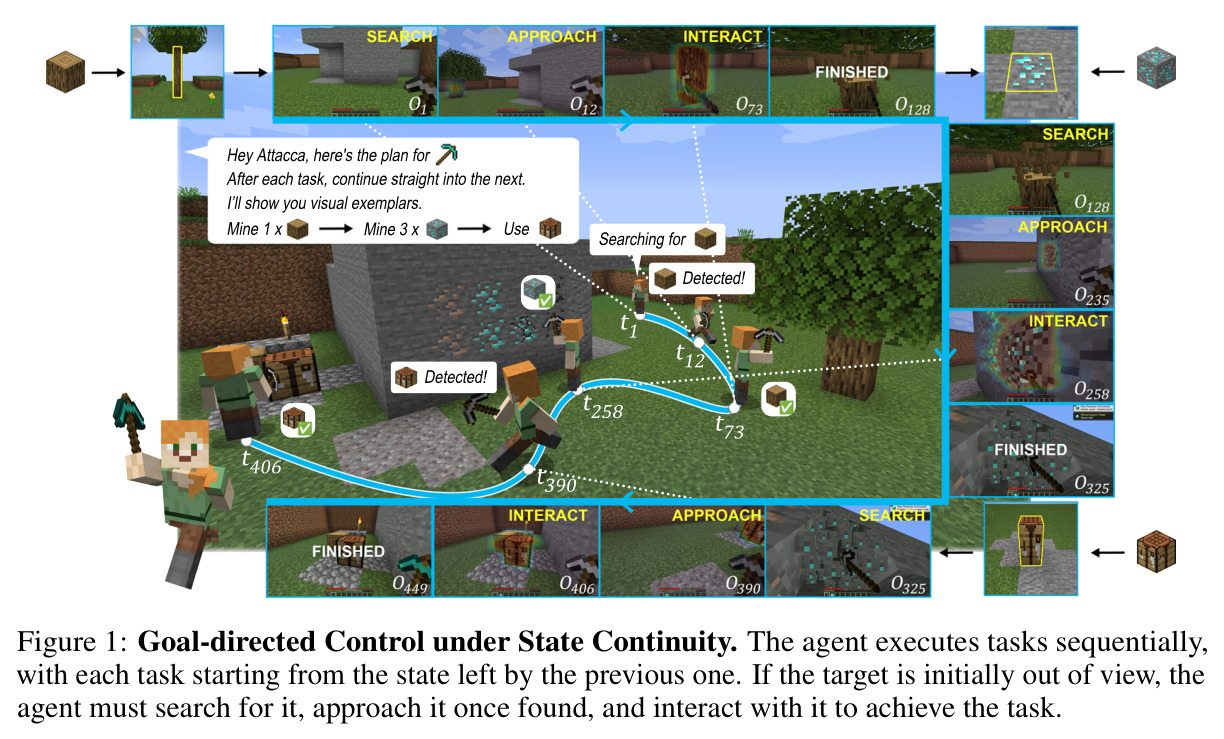
展示智能体顺序执行多个任务时,每个任务都从前一个任务留下的状态开始:若下一个目标初始不在视野内,智能体必须先搜索(Search),发现后接近(Approach),够到后再交互(Interact),图中以 Mine log→Craft table→Get water→Pour water on lava→Mine obsidian→Build Nether Portal 的任务序列和对应阶段标记说明这一流程。
这张图直观定义了全文研究的核心设定"状态连续性"和 Search-Approach-Interact 三阶段框架,是理解问题域的入口。
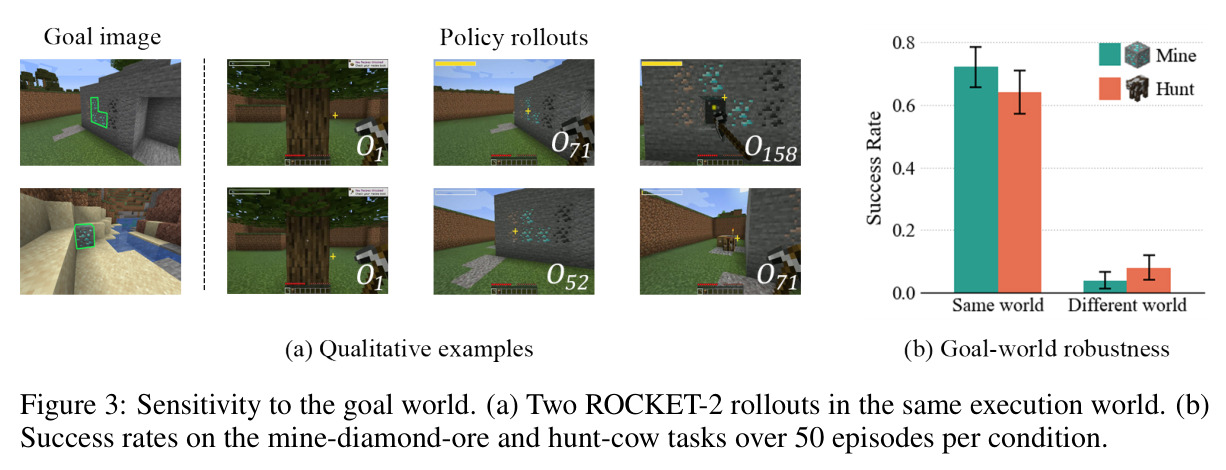
(a) 展示微调 ROCKET-2 在同一执行世界中两个回合的轨迹对比,揭示其对目标图来源世界的敏感性;(b) 给出 mine-diamond-ore 与 hunt-cow 两个任务在不同目标条件(同世界近/同世界远/异世界)下各 50 回合的成功率。
这是动机部分的关键证据:证明现有 masked-goal 策略依赖目标图与执行世界的场景对应关系,为 context-decoupled goal sampling 提供直接的实验依据。
(a) 对比两个策略在钻石阶段所有到达回合的轨迹:Attacca 的路径收敛到目标,ROCKET-2 的路径在场地中散开直至超时;(b) 时间轴展示钻石矿首次进入视野后是否持续保持在视野内(Attacca 几乎连续在视,ROCKET-2 反复丢失)。
它把"找到目标之后"的失败模式可视化,证明 ROCKET-2 的问题不在搜索而在目标跟踪(27 个回合中 27 次看到目标却只完成 4 次),从而支撑 Attacca 的 grounding 有效的结论。
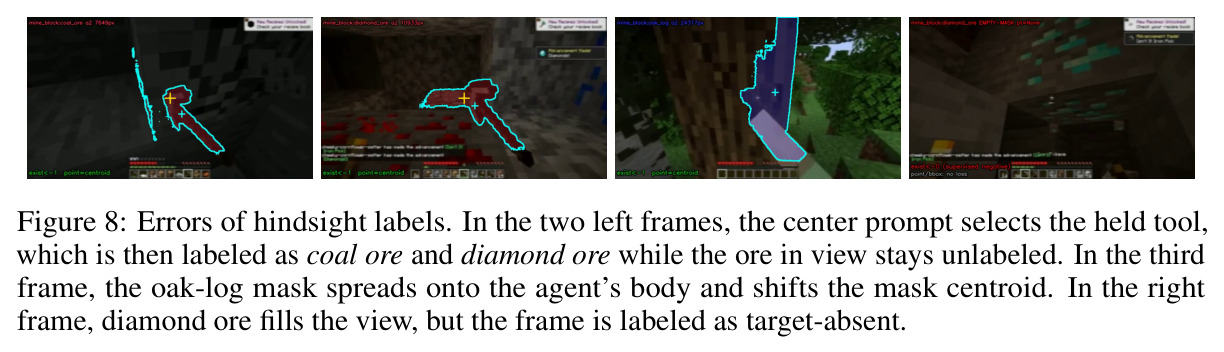
展示后见之明标注的典型错误:左两帧中中心提示选中的是手持工具却被标为煤矿石和钻石矿石;第三帧橡木掩码蔓延到玩家手臂并使掩码质心偏移;右帧钻石矿充满视野却被标为目标缺席。
论证了为什么本文要重新采集带渲染器真值掩码与人工阶段标注的数据集——现有 hindsight 标注的噪声使可见性与定位监督不可靠,这是方法成立的数据前提。
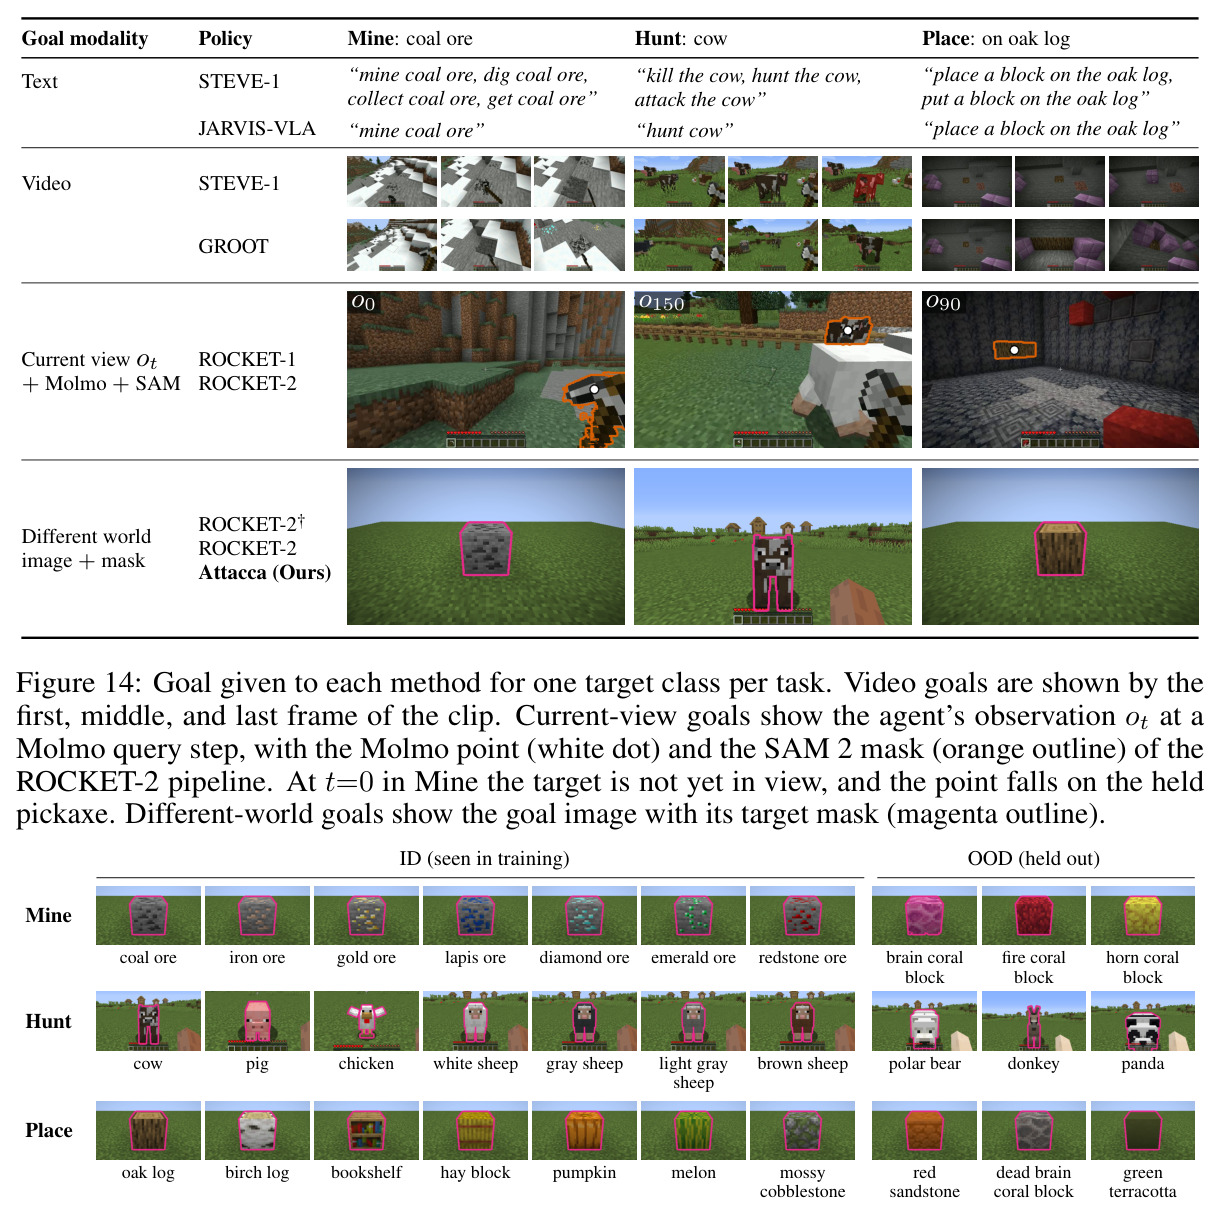
短时程三个任务全部 10 类目标(各 7 个 ID + 3 个 OOD)的目标图集:Mine 的矿石与珊瑚块、Hunt 的各种动物、Place 的方块,均裁剪至目标附近并以品红轮廓标出掩码。
明确评测类别空间与 OOD 划分(如 brain coral block、panda、green terracotta 等留出类),是核对逐类结果表(Tables 8–10)的图例。
掩码注入通路消融:残差通路(本文)0.54/0.30/0.28 全面最优;cross-attention 0.36/0.08/0.18;layerwise FiLM 0.42/0.10/0.18;ControlNet 0.16/0.00/0.08。
证明"在因果 Transformer 输入处注入单一接地向量"这一看似简单的设计选择显著优于更花哨的注入方式,对后续工作有直接的方法论参考价值。