迈向大语言模型全流水线 FP8 强化学习 Towards Full Pipeline FP8 Reinforcement Learning for LLMs
发现FP8强化学习全流程的过裁剪失稳根因,提出校准裁剪恢复BF16性能并提速1.5倍
前置知识
PPO 裁剪与信任域
PPO 用重要性比率 $r_t(\theta) = \pi_\theta(y_t|h_t) / \pi_{old}(y_t|h_t)$ 衡量新旧策略差异,目标函数取 $\min(r_t A_t, \text{clip}(r_t, 1-\epsilon, 1+\epsilon) A_t)$。当比率超出 $[1-\epsilon, 1+\epsilon]$(通常 $\epsilon=0.2$)时对应 token 的梯度被置零,形成信任域以防单步更新过猛:正优势 token 在超过上界时被裁剪,负优势 token 在跌破下界时被裁剪。
本文全部分析都围绕裁剪边界展开:FP8 噪声如何扭曲比率分布、如何造成"过裁剪",以及如何重新校准边界 $[L, H]$,读懂裁剪机制是理解全文因果链的前提。
GRPO 与组内优势估计
GRPO 去掉了 PPO 中的价值网络(critic),对同一提示采样一组 $G$ 个回答,用组内奖励归一化直接估计优势:$A_i = (R_i - \text{mean}(\{R_1,\dots,R_G\})) / \text{std}(\{R_1,\dots,R_G\})$。省去 critic 的显存与计算开销后,它成为 DeepSeek-R1 等推理模型 RL 训练的主流算法。
本文实验全部基于 GRPO 与 DAPO。负优势回答(如乱码输出)应经组内归一化后被压低概率,理解"优势符号与裁剪边界的对应关系"(负优势对应下界裁剪)是理解故障机理的关键。
FP8 量化与缩放粒度
FP8 是 8 位浮点格式(如 E4M3),可表示的范围与精度远小于 BF16。量化时先按缩放因子 $S_X = \max(|X|)/F_{max}$ 缩放张量,除以 $S_X$ 后舍入到 FP8 可表示集合再乘回。按 $\max(|X|)$ 的计算范围分为 tensorwise(整张量一个因子)、rowwise(每行一个)、blockwise(如 128×128 子块一个)三种策略,粒度越细数值保真度越高但核实现越复杂。
论文的故障分析和"校准裁剪"方法都建立在 FP8 前向传播引入量化噪声这一事实上,且实验横跨三种缩放粒度,需要理解粒度与噪声大小、吞吐收益之间的权衡。
截断重要性采样(TIS)
当 rollout 用 FP8 推理引擎、训练用另一套精度时,采样策略 $\pi^{sampler}$ 与学习器的旧策略 $\pi_{old}$ 不一致,破坏 on-policy 假设。TIS 在 token 级引入截断修正权重 $w^{TIS}_t = \min(\pi_{old}/\pi^{sampler}, C)$(截断阈值 $C$ 通常取 2),以纠正 rollout 与训练之间的分布偏差。
这是 FP8 RL 此前工作的主线(解决 train–rollout mismatch)。本文正是站在 TIS 之上发现"即使修好 mismatch,全 FP8 流水线仍会崩溃"这一新问题,并在对照实验中比较了 CISPO、BAPO 等裁剪改进方法。
研究动机
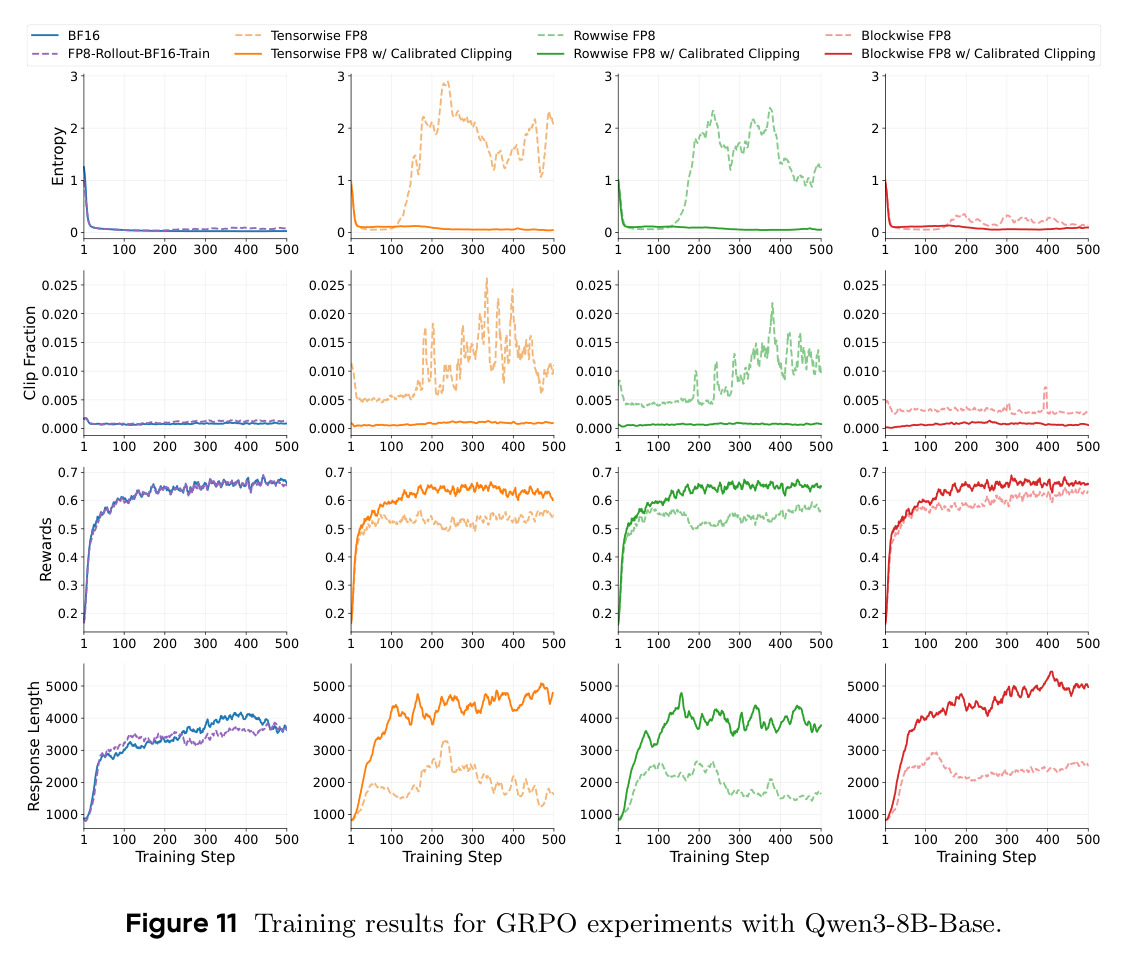
此前 FP8 RL 工作主要解决 rollout(FP8 推理引擎生成)与训练之间的 train–inference mismatch,用 TIS 等修正后看似可以稳定训练;更近的 Jet-RL、Unified FP8 干脆把 rollout 和训练都放进 FP8 以缩小精度差。但作者在 Qwen3-8B-Base + DeepScaleR 数据集 + GRPO(16K 上下文,500 步)的对照实验中发现:只要训练后端是 FP8——无论 tensorwise、rowwise 还是 blockwise 缩放——训练约 100 步后响应熵会异常飙升,同时出现大量乱码、碎片化回答,下游评测精度大幅落后 BF16 基线 3.5~11.5 分;即便最细粒度的 blockwise 缩放也无法幸免。熵激增并非全局漂移,而是由极少数熵大于 1.0 的病态样本快速增殖驱动,这些样本中只有 6.64% 获得正优势,本应被负优势惩罚压制,但其占比却持续增长,说明惩罚机制失效了。
本文的目标是本文的目标是从机理上解释并修复"全 FP8 流水线 RL 训练中途熵激增、性能崩溃"这一失稳现象:先定位此前被忽视的根因,再提出一个开销可忽略、超参鲁棒、可与 GRPO/DAPO 及任意 FP8 缩放粒度即插即用的裁剪校准方法,使 FP8 训练在消除熵激增的同时恢复 BF16 级性能,并兑现 FP8 的效率收益——训练阶段相对 BF16 最高 1.5 倍吞吐,叠加 FP8 rollout 约 30% 的生成加速,为大规模 RL 训练降本增效提供一条完整可行路径。
与已有工作不同的是,此前工作把 FP8 RL 的不稳定一律归因于 rollout 与训练的精度不一致,解法都是"修正分布偏差"。本文换了一个诊断视角:用 BF16 影子前向做受控测量,发现单个概率的量化误差(NMAE 本身很小)会在重要性比率运算中被复合放大 1.7 倍到 2.9 倍,从而系统性抬高 PPO 裁剪触发频率(比 BF16 高近 4 倍);且约 70% 的过裁剪发生在下界 $1-\epsilon$,其中近 90% 来自高熵病态回答——即负优势样本的惩罚梯度被误裁为零。这个"量化噪声 × 裁剪机制"的故障回路是全新发现,与 TIS(修正采样偏差)、CISPO(保留被裁梯度)、BAPO(固定贡献目标调界)的切入角度有本质区别。
核心方法
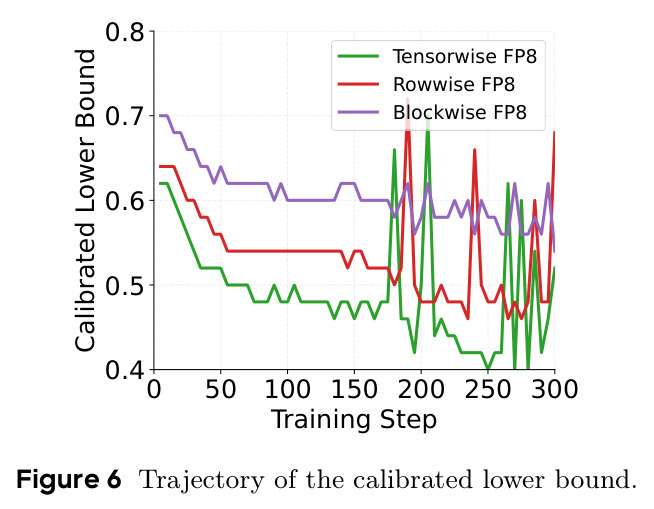
直觉上:FP8 噪声把重要性比率分布整体"弄脏"了,固定的裁剪边界 $[1-\epsilon, 1+\epsilon]$ 在 FP8 空间里切的位置就不对了,那就在 FP8 空间里重新找两个边界,使被裁 token 的比例和正负更新配比都与 BF16 一致。技术路线分两步:第一步下界对齐——用 BF16 影子前向算出负优势 token 在 $1-\epsilon$ 处的目标裁剪分位数 $\alpha_{low} = F_{BF16,-}(1-\epsilon)$,再在 FP8 比率分布上取逆 CDF 得到校准下界 $L = F^{-1}_{FP8,-}(\alpha_{low})$,使两个精度下被下界裁掉的负优势 token 数量相等;第二步上界再平衡——给定 $L$,搜索上界 $H$ 使正负更新贡献比 $\rho$(公式 5,含 TIS 权重与指示函数)匹配 BF16 参考值 $\rho_{BF16}$,避免只放松下界导致的过惩罚。考虑开销,每 20 步才校准一次,并以有界平滑更新防止边界跳变。
核心创新是把"信任域"的语义从"固定的数值区间"还原为两个统计不变量:负优势 token 的裁剪分位数 + 正负更新贡献配比,并用 BF16 高精度参考作为锚点在量化空间里重建它们。这与已有方法的本质区别在于:DAPO 是启发式地放宽上界鼓励探索,GSPO 把信任域搬到序列级,CISPO 保留被裁 token 的梯度但不动边界,BAPO 虽然动态调界却依赖一个固定的正贡献阈值目标。本文的下界由 BF16 参考分布的分位数匹配直接导出,上界由配比匹配反解,二者都有明确的高精度 ground truth。对照实验证明了这一差异的分量:CISPO 在 rowwise FP8 下约 300 步崩溃,BAPO 约 90 步失稳且边界漂移到 $[0.9, 3.0]$ 后奖励归零——固定贡献目标在 FP8 噪声下并不可靠。
方法步骤详情
完整流程见算法 1,输入包括批次优势 $A$、TIS 权重 $w^{TIS}$、两种精度的比率 $r^{BF16}$ 与 $r^{FP8}$ 等。第一步(参考统计):对 $A_t<0$ 的 token 计算目标分位数 $\alpha_{low} = F_{BF16,-}(c^{ref}_{low})$;按公式 5 在 BF16 比率上算参考配比 $\rho_{BF16}$,这需要两次仅前向的 BF16 影子传播(用主权重评估 $\pi^{BF16}_{\theta}$ 与 $\pi^{BF16}_{old}$)。第二步(边界搜索):在 $I_L=[0.5,0.9]$、$I_H=[1.2,2.0]$ 内以步长 $\Delta=0.02$ 网格搜索——$L^*$ 最小化 $|F_{FP8,-}(L^*) - \alpha_{low}|$,$H^*$ 最小化 $|\rho_{FP8}(L^*, H^*) - \rho_{BF16}|$。第三步(平滑更新):$b_{new} = b + \text{clip}((b^*-b)/2, -\delta, \delta)$,$\delta_L=0.05$、$\delta_H=0.1$;边界初始化为 $[0.6, 1.8]$,每 20 步校准一次。校准后的 $[L, H]$ 直接替换 PPO 目标中的 $[1-\epsilon, 1+\epsilon]$ 参与正常训练。
技术新颖性
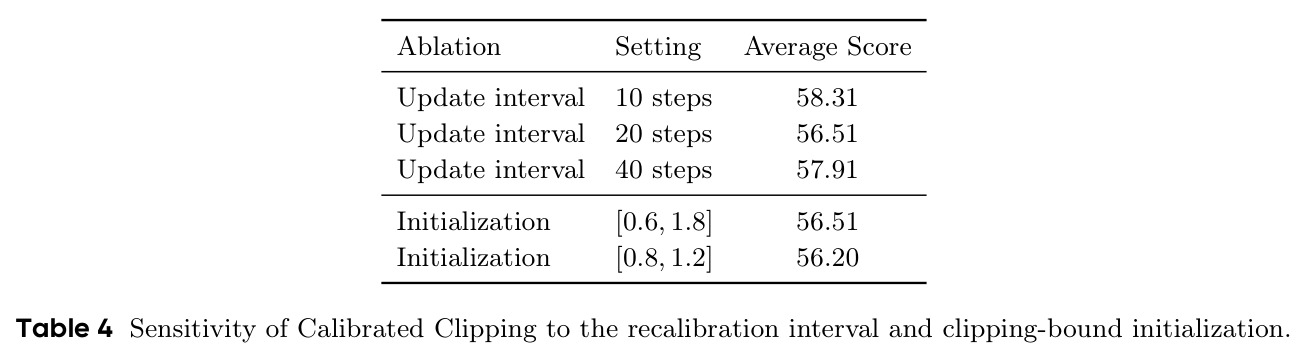
技术新颖性有三点。其一,首次定义并量化"过裁剪"(over-clipping)这一故障模式,给出严格判据(如 $A_t<0$、$r^{BF16}_t > 1-\epsilon$ 且 $r^{FP8}_t \le 1-\epsilon$ 即为下界过裁剪),并用 NMAE 放大倍数(1.7×~2.9×)与裁剪占比(近 4 倍于 BF16)把完整因果链钉死,属于对 FP8 RL 失败模式的机理级刻画。其二,"分位数匹配 + 配比匹配"的双锚点校准设计:把高精度参考分布作为量化空间信任域的 ground truth,这一思想此前多见于量化感知训练,用于 RL 信任域重建是新的。其三,工程上的周期性校准加有界平滑更新,把 BF16 影子前向的开销摊薄到可忽略——作者验证了更新间隔(10/20/40 步得分 58.31/56.51/57.91)与初始化($[0.6,1.8]$ vs $[0.8,1.2]$ 得 56.51/56.20)均不敏感,且超参未经精调即在所有设置下鲁棒。
实验结果
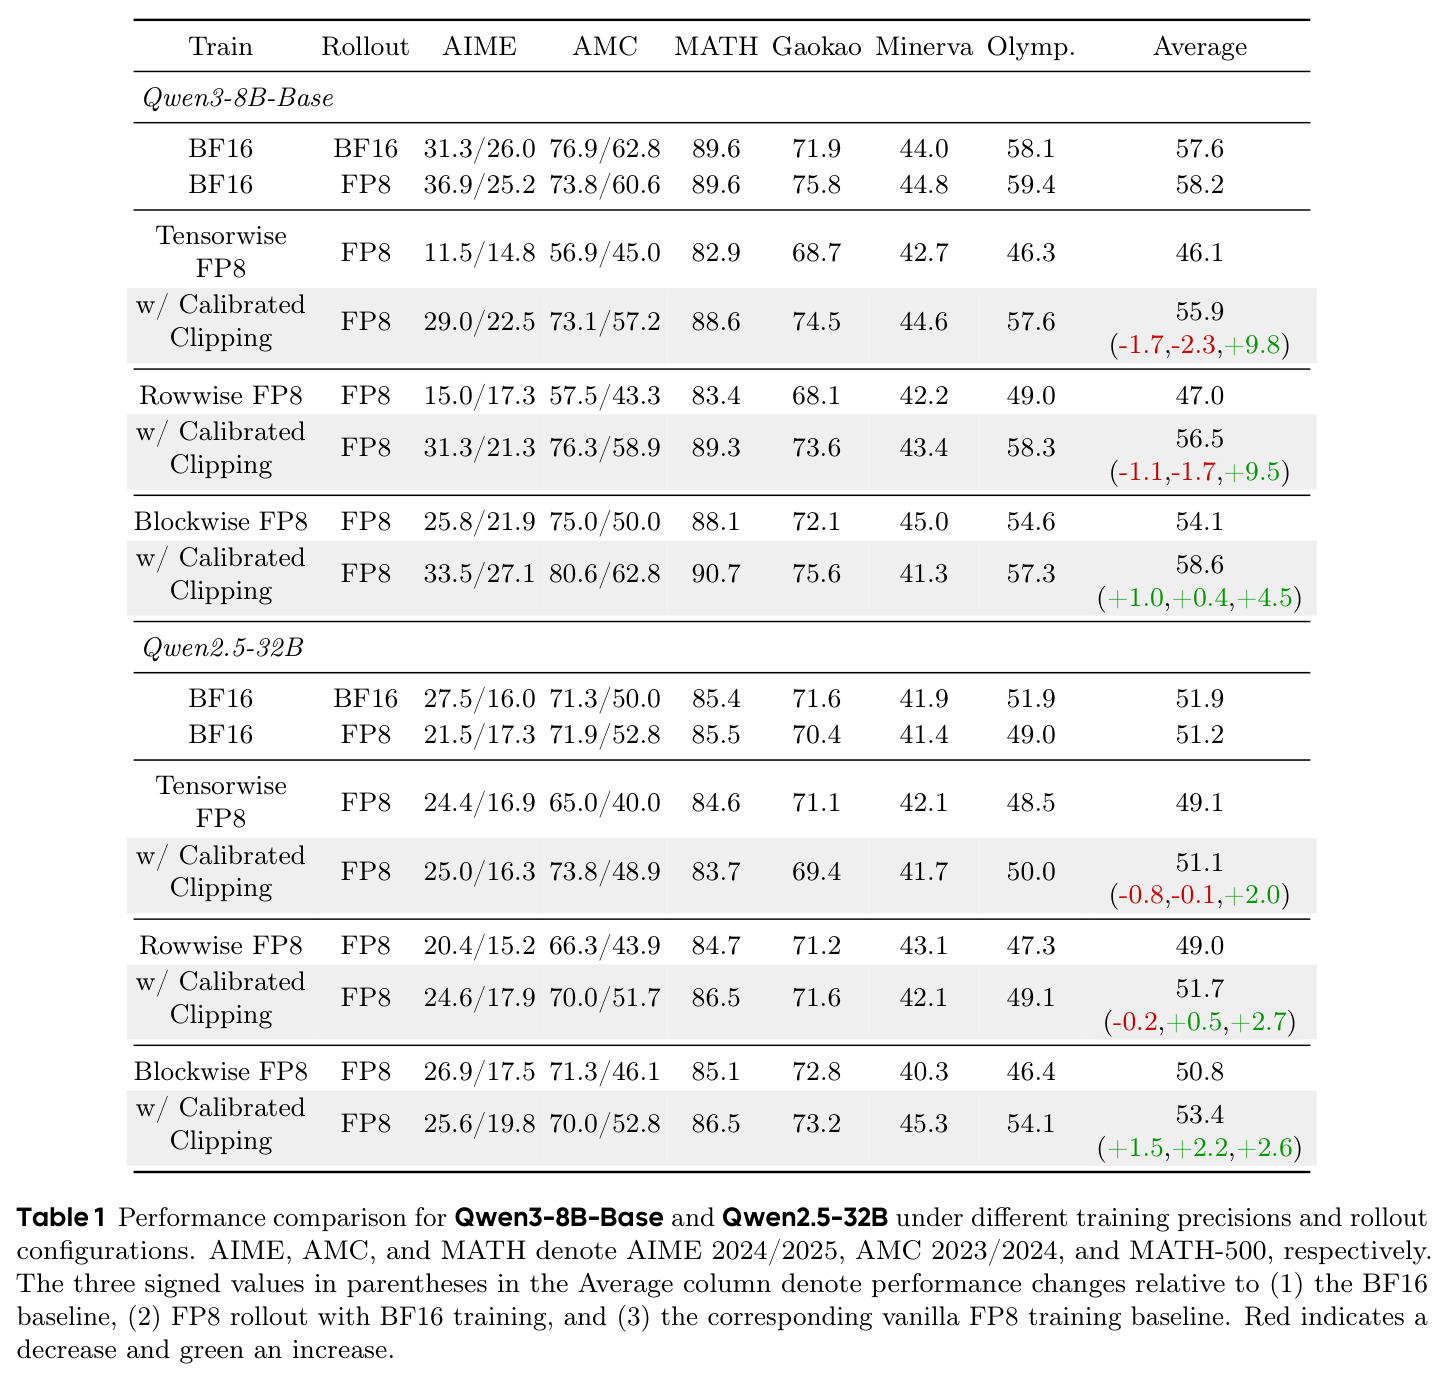
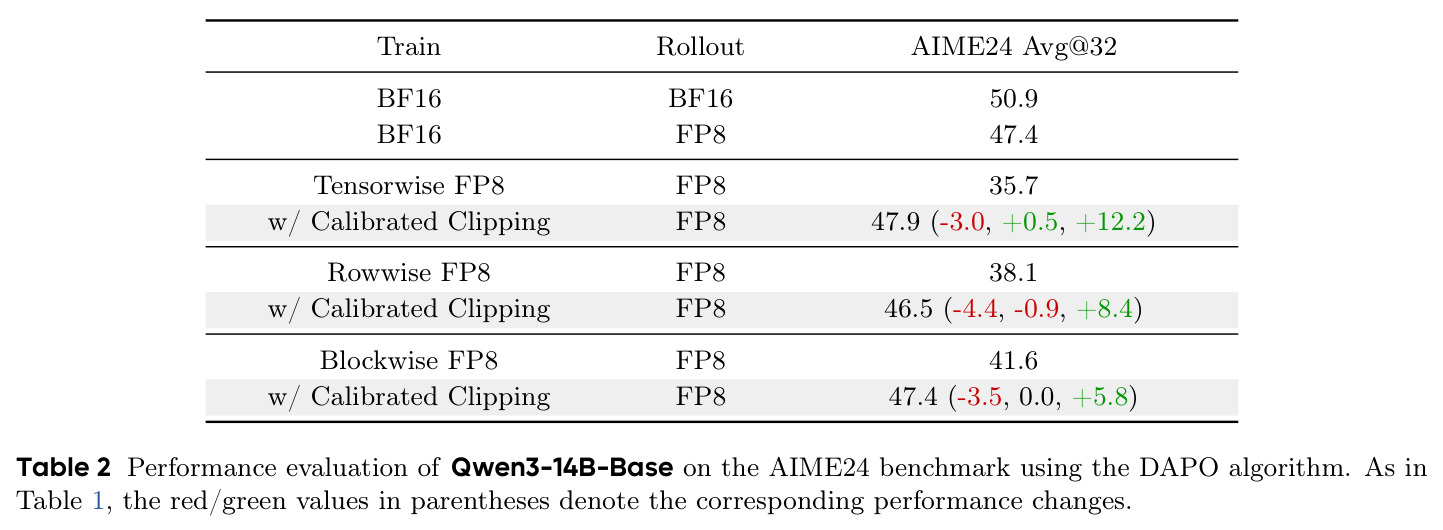
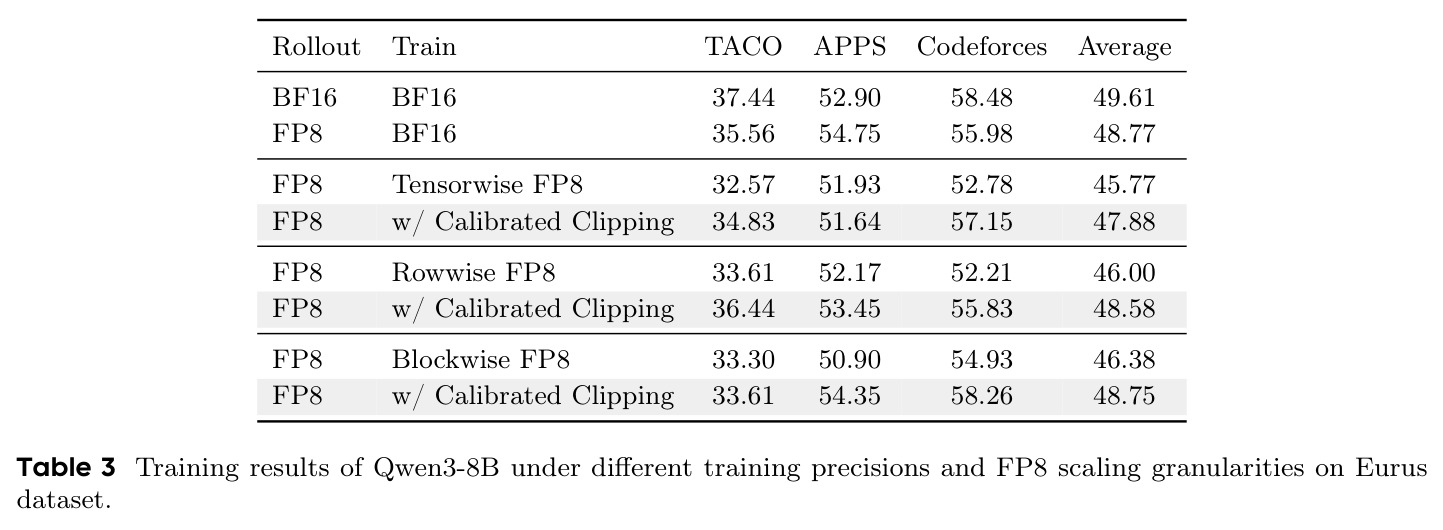
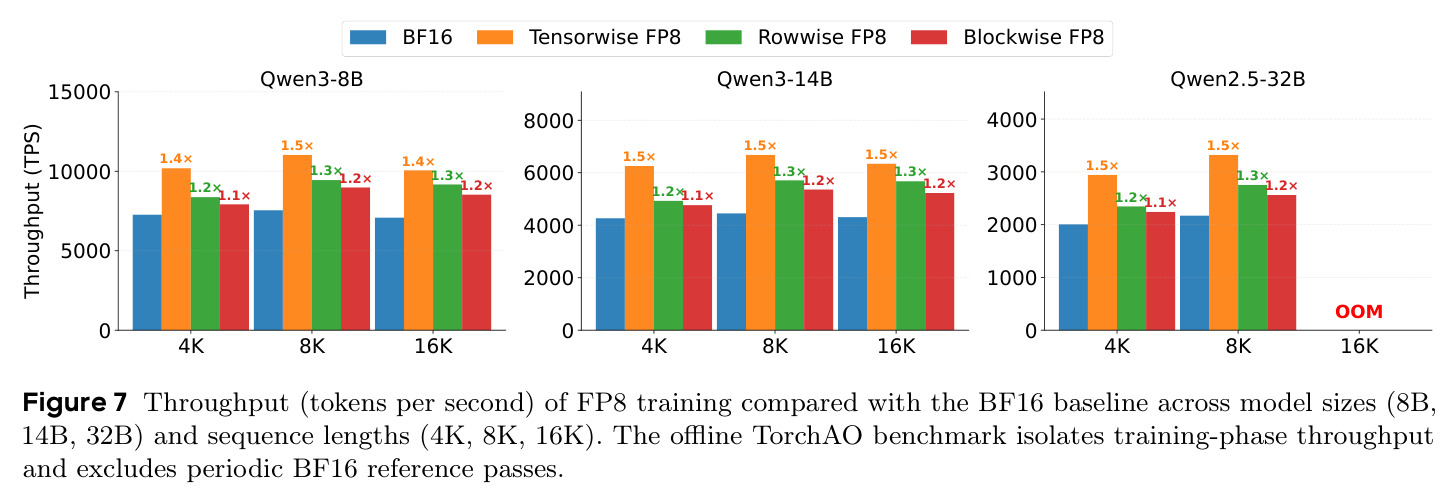
核心发现:(1) GRPO + Qwen3-8B-Base(DeepScaleR,500 步,八数学基准):BF16 平均 57.6,朴素 FP8 崩至 tensorwise 46.1、rowwise 47.0、blockwise 54.1;校准裁剪后回升至 55.9、56.5、58.6,blockwise 反超 BF16 +1.0,rowwise/tensorwise 相对朴素 FP8 提升 +9.5/+9.8。(2) Qwen2.5-32B:BF16 为 51.9,校准后 blockwise 达 53.4(+1.5),三种粒度全部恢复到基线水平。(3) DAPO + Qwen3-14B-Base(AIME24 Avg@32):BF16 为 50.9,朴素 FP8 为 35.7/38.1/41.6,校准后 47.9/46.5/47.4,tensorwise 提升 +12.2。(4) Eurus 代码数据集同样全面回升,rowwise 从 46.00 到 48.58,逼近 BF16 的 49.61。(5) 吞吐:tensorwise 训练最高 1.5× BF16,blockwise 10%~20%,叠加 FP8 rollout 约 30% 生成加速;熵激增完全消除,裁剪占比回到 BF16 水平。(6) 消融:更新间隔 10/20/40 步得 58.31/56.51/57.91,初始化 [0.6,1.8] 与 [0.8,1.2] 得 56.51/56.20,全部远优于朴素 rowwise FP8 的 47.0,超参鲁棒。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GRPO 数学推理(Qwen3-8B-Base,DeepScaleR,8 个基准最佳检查点平均) | 8 基准平均准确率 | blockwise FP8 + 校准裁剪 58.6 | BF16 训练 + BF16 rollout 为 57.6;朴素 blockwise FP8 为 54.1 | 反超 BF16 基线 +1.0;相对朴素 FP8 +4.5 |
| GRPO rowwise 配置(Qwen3-8B-Base) | 8 基准平均准确率 | 56.5 | 朴素 rowwise FP8 为 47.0 | +9.5,距 BF16 基线 57.6 仅差 1.1 |
| GRPO(Qwen2.5-32B) | 8 基准平均准确率 | blockwise FP8 + 校准裁剪 53.4 | BF16 为 51.9;朴素 blockwise FP8 为 50.8 | 反超 BF16 +1.5;相对朴素 FP8 +2.6 |
| DAPO(Qwen3-14B-Base,DAPO-Math-17K) | AIME24 Avg@32 | tensorwise FP8 + 校准裁剪 47.9 | BF16 为 50.9;朴素 tensorwise FP8 为 35.7 | 较朴素 FP8 +12.2,距 BF16 仅 -3.0 |
| FP8 训练吞吐(8B/14B/32B 模型 × 4K/8K/16K 序列) | 相对 BF16 训练吞吐(TPS) | tensorwise 最高 1.5×,blockwise 约 1.1×~1.2× | BF16 为 1.0× | 训练阶段最高 +50%,叠加 FP8 rollout 约 30% 生成加速 |
局限与改进
作者承认的局限:分析聚焦 token 级裁剪(GRPO/DAPO),序列级(GSPO 类)聚合比率下的校准留作未来工作;校准需要 BF16 影子前向,论文只说摊薄后开销可忽略,未给出端到端 wall-clock 损耗的精确数字。我自己的观察:其一,方法隐含"BF16 参考分布是正确锚点"的假设,若奖励设计或数据本身使 BF16 训练也熵失控,校准只是忠实复刻一个坏参考,不提供额外保护;其二,熵激增的早期检测与触发式校准未被探索——图 6 显示熵激增时校准下界会偏离稳态,本可用作预警信号;其三,实验集中于数学与代码的 RLVR 任务,未覆盖 agentic、多轮长程等稀疏奖励场景,而这类场景中负优势样本占比与长度分布都更极端;其四,未与 M2PO、DPPO 等非裁剪类稳定化方法正面对比,无法判断校准裁剪是否为最优路线;其五,消融仅在 Qwen3-8B + rowwise 一个设置上进行,跨架构泛化证据不足。
独立分析的弱点
弱点一:强依赖 BF16 影子前向,训练框架需同时维护 FP8 与 BF16 两套权重路径,在 32B 以上或显存紧张场景并不免费,论文未报告影子前向的显存开销与实际时间占比;改进方向是用 EMA 或低频快照权重代替主权重做参考,甚至用上一次校准的分布外推。弱点二:分位数匹配只针对负优势 token 的下界,正优势 token 的上界过裁剪虽在判据中定义但未单独量化分析,只通过配比间接调节;改进方向是对上界做对称的 CDF 校准后再叠加配比约束,形成双分布对齐。弱点三:边界搜索是步长 $\Delta=0.02$ 的网格离散搜索,区间虽小、开销虽低,但下界原则上可由分位数函数解析求得;改进方向是采用流式/近似分位数算法连续估计,消除网格分辨率限制。弱点四:全部结论来自数学与代码 RLVR 任务的 dense-reward 场景,对稀疏奖励、长 horizon 任务(奖励全 0 或全 1 的组内归一化退化)未验证;改进方向是在 agentic 基准上补充实验。弱点五:论文未开源代码(截至阅读时),FlashRL 补丁的可用性成为复现的最大不确定点。
未来方向
作者明确提出:把校准扩展到序列级裁剪(GSPO 类方法)以及 agentic RL 场景。基于本文成果可自然延伸的方向:其一,与量化感知训练结合,让模型在预训练阶段就适应 FP8 前向,从源头减少比率噪声,而非训练时打补丁;其二,把"以高精度参考分布校准低精度训练"的思想推广到 FP4 乃至更低比特,或用于低精度优化器状态与梯度的稳定性保障;其三,在线崩溃预警——利用校准边界在熵激增前的漂移作为前兆信号,联动 checkpoint 回滚实现自动救火;其四,理论层面分析比率噪声对 TIS/MIS 修正项本身的影响,统一"采样修正"与"裁剪校准"两个维度的误差预算;其五,在 100B+ MoE 模型上验证方法的规模化行为,并开源 VeRL/TorchAO/vLLM 的完整复现配方以推动社区检验。
复现评估
复现评估:论文未提供官方开源代码(正文仅给出通讯邮箱),复现难度中等偏上,但透明度很高。有利条件:算法 1 给出伪代码与全部超参——搜索区间 $I_L=[0.5,0.9]$、$I_H=[1.2,2.0]$、步长 $\Delta=0.02$、平滑系数 $\delta_L=0.05$、$\delta_H=0.1$、初始化 $[0.6,1.8]$、每 20 步校准;实验栈全是公开组件(VeRL + vLLM + TorchAO + FlashRL 补丁),数据集(DeepScaleR、DAPO-Math-17K、Eurus-2-RL-Data)与评测设置(温度 1.0、top-p 0.7)也交代完整。不利条件:算力门槛高——8B 训练 500 步、batch 256、16K 上下文,另有 14B/32B 实验,需多卡 A100/H100 集群,单机只能复现 8B 档;最大不确定性在 FlashRL 补丁与 TorchAO 引擎的兼容性,以及 BF16 影子前向需自行接入 VeRL。
论文图表
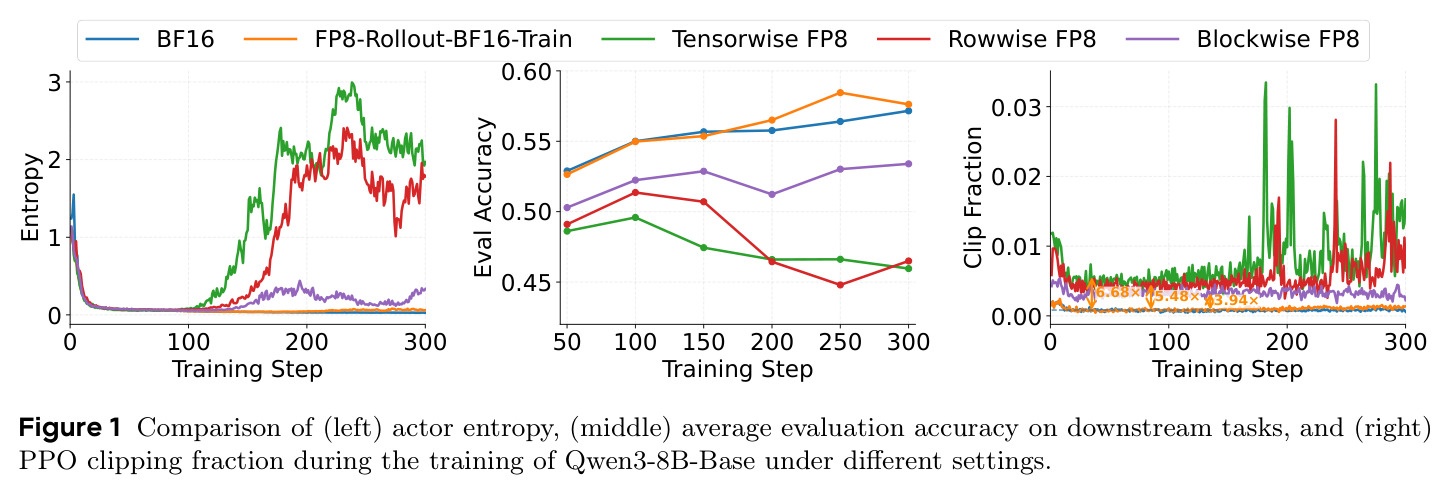
在 Qwen3-8B-Base 上对比五种设置(BF16、FP8-rollout+BF16-训练、tensorwise/rowwise/blockwise FP8)的 actor 熵、下游评测精度与 PPO 裁剪占比:三种 FP8 训练在约 100 步后熵激增、精度大跌,裁剪占比分别高达 BF16 的 6.68×、5.48×、3.94×。
全文的问题起点:一张图同时呈现"熵激增"现象、性能落差与"裁剪占比异常"三条线索,直接引出过裁剪假说,是理解论文动机的钥匙。
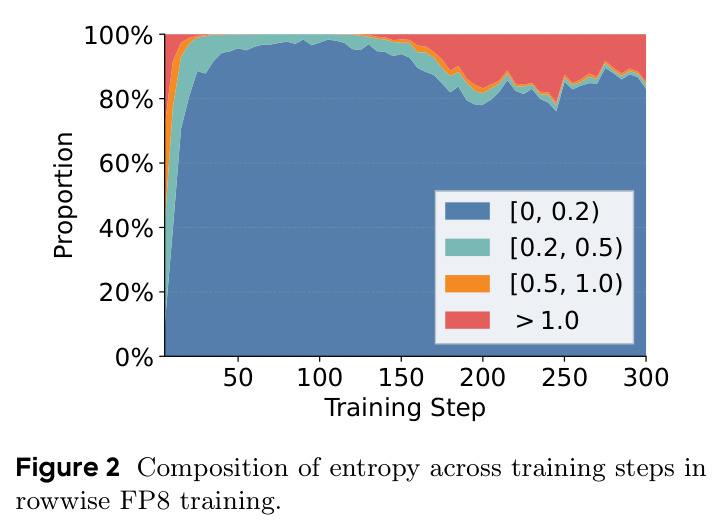
把 rowwise FP8 训练的回答熵划分为 [0,0.2)、[0.2,0.5)、[0.5,1.0)、大于 1.0 四档并统计各档占比随训练步的变化:绝大多数回答熵保持健康(小于 0.5),激增由熵大于 1.0 的病态样本在 100 步后快速增殖驱动。
揭示故障形态是"少数样本失控"而非"整体漂移",自然引出关键疑问:这些只占 6.64% 正优势的病态输出为何没被负优势惩罚压制。
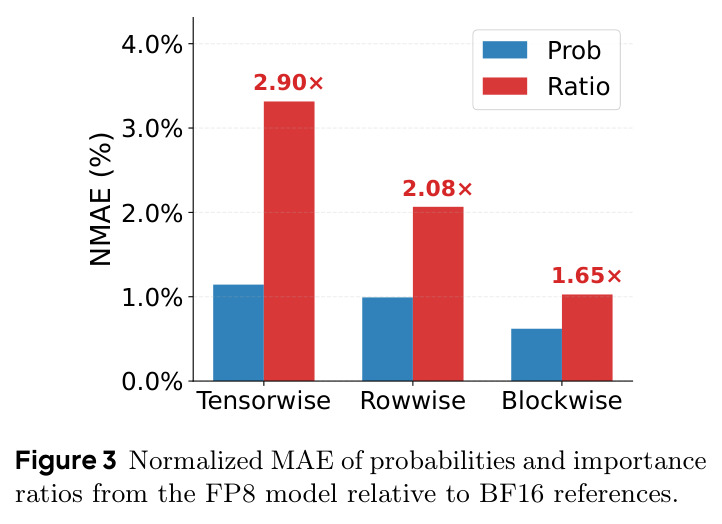
用 BF16 影子前向测得:FP8 诱导概率相对高精度参考的 NMAE 本身很小,但经重要性比率运算后误差被复合放大——tensorwise 2.90×、rowwise 2.08×、blockwise 1.65×。
这是"复合噪声"论点的直接量化证据,说明比率运算是量化误差的放大器,是整条因果链(噪声到过裁剪到熵激增)的核心一环。
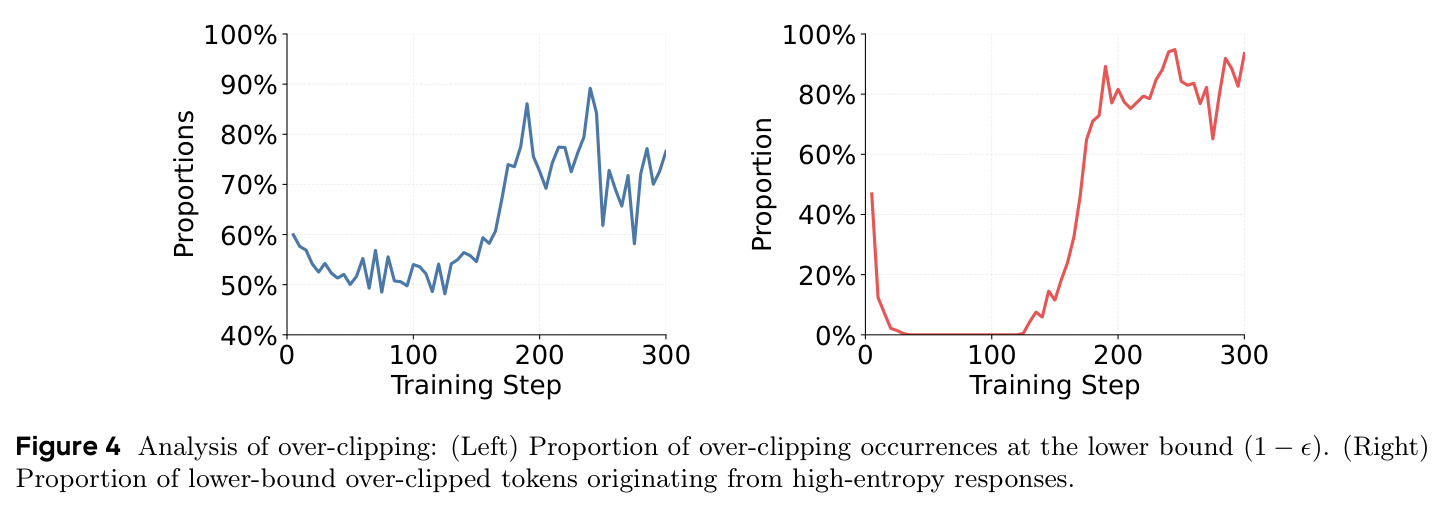
左图显示训练后期约 70% 的过裁剪事件发生在下界 $1-\epsilon$ 处;右图显示这些下界过裁剪 token 中近 90% 来自图 2 识别出的高熵病态回答,且两条占比曲线都随训练推进而上升。
把"哪些 token 被误裁"落到具体数字上,坐实了"负优势惩罚梯度被错误置零、病态输出得以累积"的故障回路,是机理分析的决定性证据。
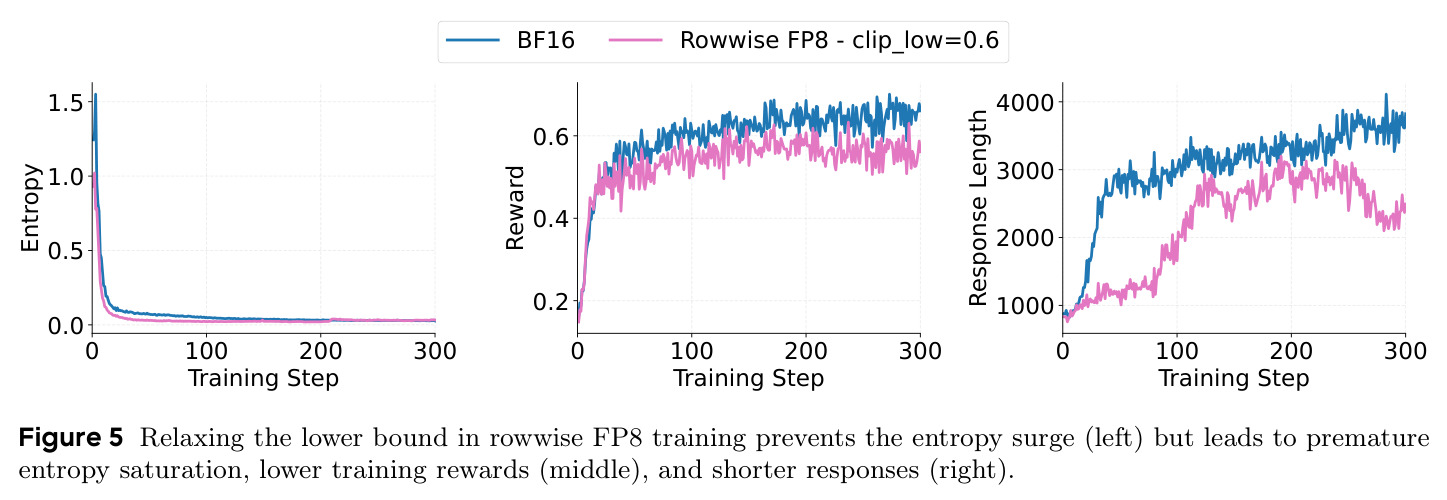
把 rowwise FP8 的下界从 0.8 放宽到 0.6 后熵激增消失,但熵提前饱和、训练奖励持续低于 BF16、回答长度明显更短,说明模型变得过度保守、性能仍然受损。
关键对照:证明"只放松下界"会引入过惩罚的新问题,从而论证必须上下界联动校准,这是方法设计动机的直接消融证据。
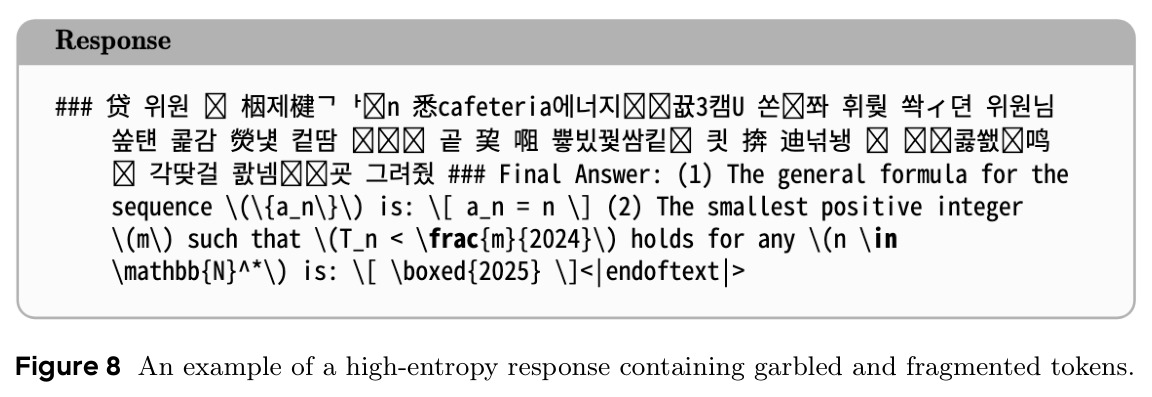
附录中展示一条高熵病态回答的实际文本样例,其中包含大量乱码与碎片化 token,直观呈现模型解码状态的崩溃形态。
把"熵激增"从抽象曲线变成可感知的具体失败样例,帮助读者理解被误保护的病态输出长什么样。
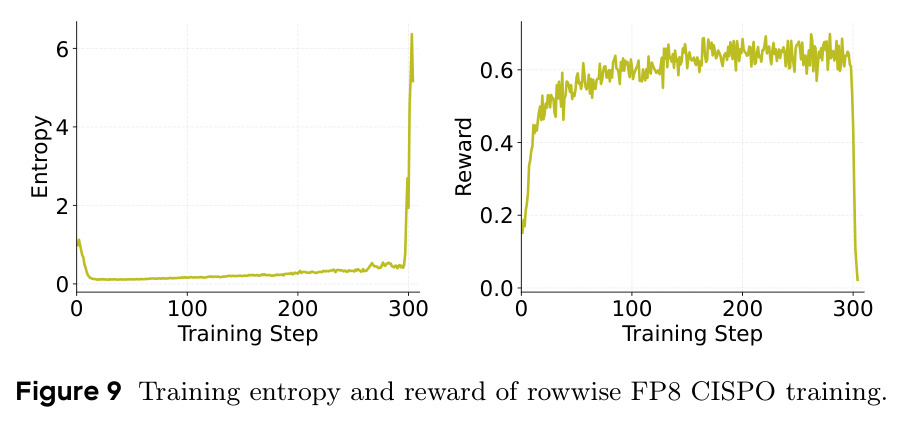
在与 GRPO 实验完全相同的 Qwen3-8B rowwise FP8 设置下运行 CISPO:约 300 步后熵急剧飙升、奖励跌至零,训练彻底崩溃。
关键对照实验:证明"保留被裁 token 的梯度"(CISPO 的思路)不足以对抗 FP8 过裁剪,从反面凸显按高精度参考校准边界的必要性。
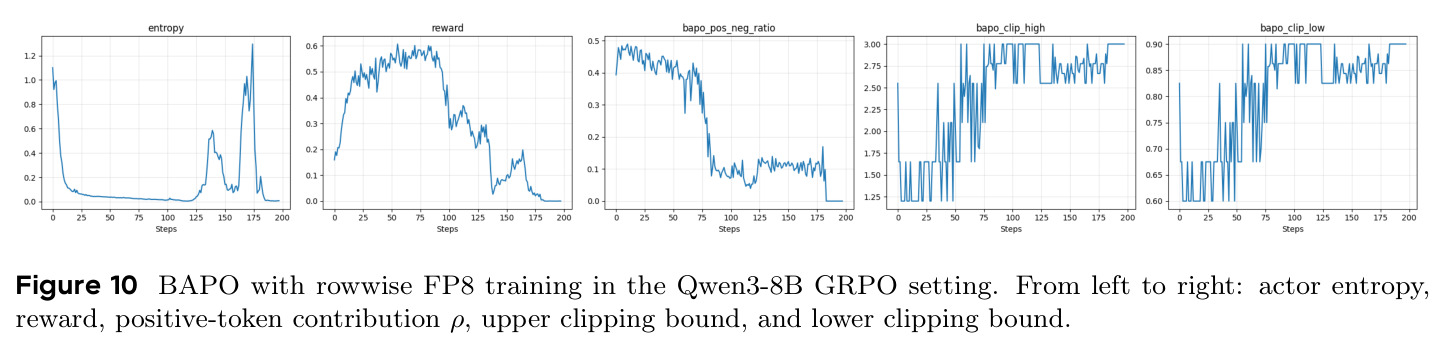
BAPO(默认配置:目标正贡献 $\rho_0=0.4$)在同一设置下约 90 步后正贡献跌破目标,上、下裁剪边界持续漂移至 3.0 与 0.9,随后训练失稳、奖励最终归零。
与本文最相近的动态调界方法的正面对比失败案例,论证"固定贡献目标在 FP8 噪声下不可靠",突出本文以 BF16 分布为锚点这一设计差异的价值。