LiFT:循环流Transformer(深度上循环,时间上流动) LiFT: Loop Flow Transformers
共享DiT核循环展开,每循环沿校正路径各管一段,推理加深无需重训即可提升质量。
前置知识
流匹配(Flow Matching)
一类生成建模方法:从噪声分布 $\rho_0=\mathcal{N}(0,I)$ 到数据分布 $\rho_1$ 学习一个时间相关速度场。最常用线性插值路径 $x_t=(1-t)x_0+t x_1$,其速度目标就是 $u^\star=x_1-x_0$,训练用 MSE 回归 $\mathcal{L}_{FM}=\mathbb{E}\frac{1}{d}\|v_\theta(x_t,t)-u^\star\|^2$,无需模拟 ODE。推理时从噪声出发积分学到的速度场 $dX_t/dt=v_\theta$ 到 $t=1$ 即生成样本。
LiFT 的训练目标、锚点路径和推理采样全部建立在流匹配框架上,读懂数学记号 $x_0,x_1,x_t,u^\star,t$ 是理解正文的前提。
扩散Transformer(DiT)
用 Transformer 主干参数化扩散/流生成模型的架构:把图像或 VAE latent 切成 patch token,经多层注意力+MLP 块处理,生成时间 $t$ 和类别等条件通过 adaLN-zero 式自适应归一化与门控残差注入,最后由预测头输出速度或噪声。原版 DiT-XL/2 是本文的稠密基线,规模记号 B/2、L/2、XL/2 表示宽度和深度。
本文所有的稠密基线与 LiFT 共享同一套 DiT 块设计(RMSNorm、2D RoPE、adaLN-zero),实验对比(FID、参数量、FLOPs)都围绕 B/2、L/2、XL/2 三个规模展开。
循环Transformer与prelude–core–coda结构
普通 Transformer 每层有独立参数;循环Transformer 把一组共享块反复应用 K 次,执行深度 $L_{exec}=L_P+K L_R+L_D$ 随 K 增长而参数量 $L_{unique}=L_P+L_R+L_D$ 不变。常见三段式分解:prelude 嵌入输入一次,core 带边界算子(归一化+输入再注入)循环 K 次,coda 把任意状态读出为预测。核心还可接收循环索引/计算深度的条件嵌入。
LiFT 的架构就是这个三段结构,其'执行深度与参数量解耦'正是推理时能自由加深、参数不增的机制基础。
神经ODE与Euler采样步数 T
流模型推理即数值积分一个由神经网络定义的 ODE。最简单的 Euler 格式把 $[0,1]$ 均分为 T 步,每步调用一次网络:$x_{t+\Delta t}=x_t+\Delta t\,v_\theta(x_t,t)$,$\Delta t=1/T$。步数越多积分误差越小,但每步的上限受制于网络对速度的估计精度,超过一定程度后质量饱和。
本文把'步数 T'(沿生成时间轴走多细)与'循环数 K'(每次速度估计算得多准)区分成两条正交的推理算力轴,这是全文叙事和方法命名的核心。
FID(Fréchet Inception Distance)
衡量生成图像分布与真实图像分布距离的标准指标:用 Inception 网络提取特征,把两组特征拟合成高斯后计算 Fréchet 距离,越低越好。通常配合 sFID(空间 FID)和 IS(Inception Score)一起报告。本文用官方 ADM 评估器,每设置生成 5 万张图、固定噪声与类别配对。
论文所有结论(深度外推、等算力对比、预算分配)都以 FID 为主指标,且数字对比非常密集,需要知道 FID 降低 3 点左右在 ImageNet 256×256 上是显著提升。
研究动机
DiT 已成为图像、视频与科学生成的主流架构,但其质量提升高度绑定参数规模,扩容几乎成了唯一手段。循环Transformer 本提供了另一条路:重复应用同一组共享层增加有效深度、参数不变,从而在流生成中把额外推理算力花在'把单步速度估得更准'上,与'多走几步积分'互补。但实践中这条路一直走不通。一方面,不做专门训练的循环扩散Transformer 只在训练深度处产生合格图像(ELT 的观察):ImageNet 上推理循环数一超过训练深度 FID 就开始恶化,视频生成质量在 1.5 倍训练深度处见顶;即便加上中间监督,超出训练深度很快弊大于利。另一方面,即使能外推,额外循环也未必划算:LoopDiT 在 DiT-B/4 上用 MeanFlow 训练,等算力下没有跑赢稠密模型,且加采样步数比加循环更划算。根源在于这些方法把每个中间预测都训练成完整输出,没有任何一次循环被赋予独立的职责。
本文的目标是本文要设计一族循环生成模型,让共享核心的每次循环承担同一次速度预测中不同的一段校正,使推理循环数成为训练后可自由选择的计算轴:无需重训、无需早退机制,模型在远超训练深度的循环数下持续变好,并在 L/2 与 XL/2 规模上以更少参数、更少推理 FLOPs 战胜更大的稠密 DiT。量化目标有三:(1) 训练深度不是推理上限——XL/2 检查点训练 2 循环,推理 16 循环(8 倍)时 FID 应继续下降;(2) 固定训练 token 预算 $D=3.2768\times10^{10}$ 个 latent patch token 时,LiFT-L/2 相对稠密 DiT-XL/2 基线 FID 降低 3.34 点;(3) 同时省下约 60% 参数、32% 训练 FLOPs 与 52% 推理 FLOPs。
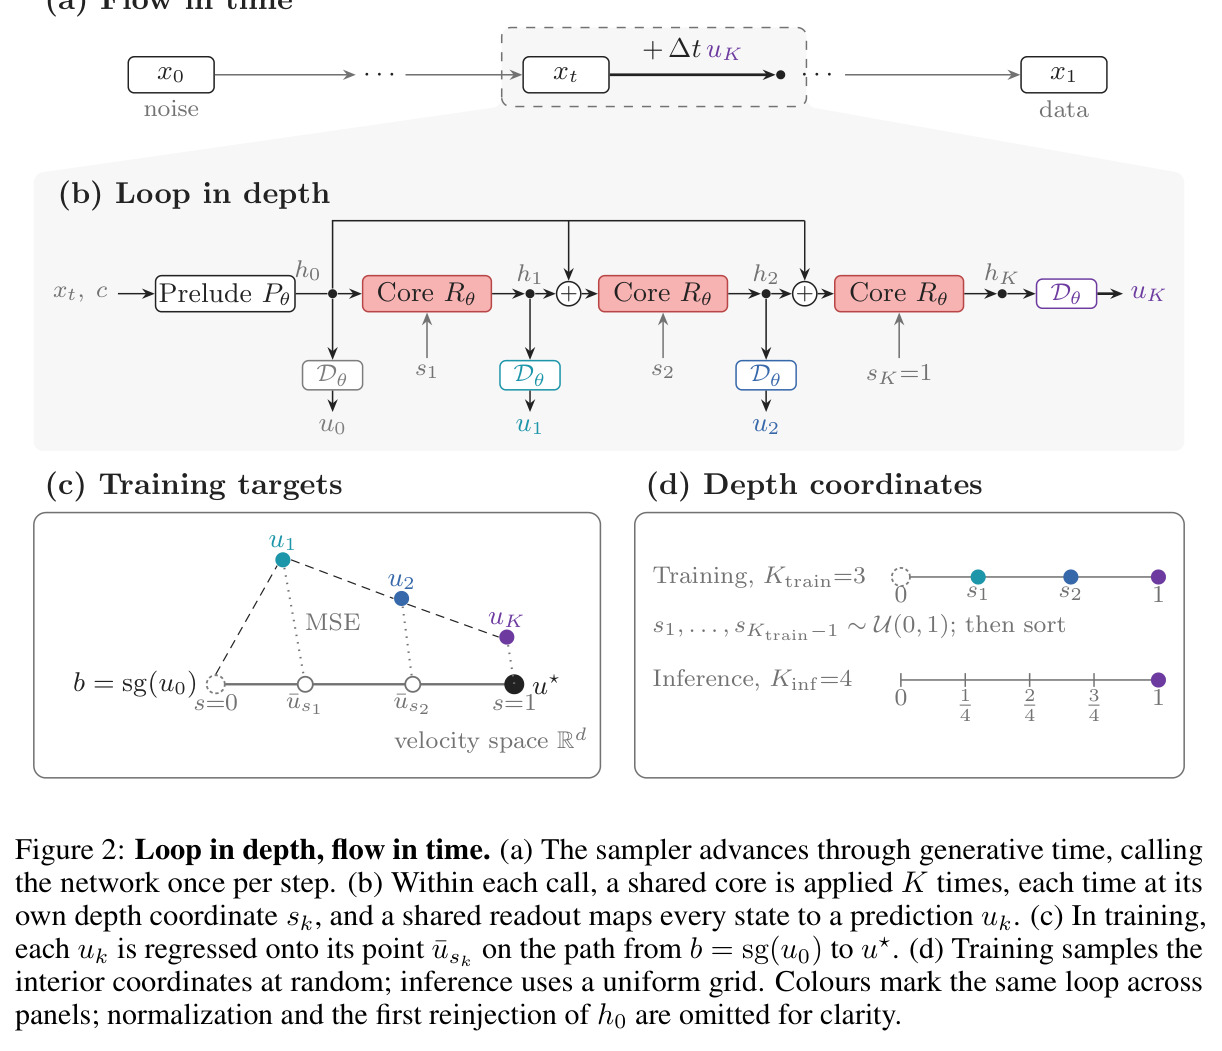
与已有工作不同的是,相邻工作各有切入角度但都未解决'每循环各司其职':ELT 在采样的中间退出点做监督并用 detach 的全深度预测自蒸馏;DeepFlow 研究流匹配的中间监督与速度对齐;R-MDM 研究循环输出间的生成损失分配;LoopDiT 共享 prelude–core–输出布局但用 MeanFlow 训练最终预测、短计算保留训练条件调度的前缀;LoopFormer 用归一化轨迹对不同计算预算做端点对齐;RIN、Thinking with Looped Flows 把递归状态跨生成步携带;平衡类方法(FDM、GET、CoFRe)对隐状态施加不动点方程。LiFT 的独特做法是在预测空间构造一条从模型自身初始估计 $b$ 到流匹配目标 $u^\star$ 的直线路径,用连续坐标 $s\in[0,1]$ 索引路径位置,让每次循环只负责一部分校正,并把'计算深度'与'生成时间'彻底解耦:循环决定校正路径走得多细,积分步数决定沿流走得多远——'Loop in depth, flow in time'。
核心方法
直觉上,一次速度评估就是一个回归任务:模型先给出粗略初估,再反复精化。LiFT 不要求每次循环一步到位,而是让循环沿一条直线校正路径接力前进。技术路线采用 prelude–core–coda 三段结构:4 层 prelude 把带噪 latent $x_t$ 与条件 $c=e_t(t)+e_y(y)$ 嵌入为初始状态 $h_0$;共享核心 $R_\theta$ 循环 K 次,每次输入 RMSNorm 后的上一状态加 $h_0$ 再注入(保证始终看得见输入),并以深度嵌入 $e_s(s_k)$ 经自适应归一化和门控残差调制当前循环;coda 不含 transformer 块、只有共享预测头,把任意状态读出为速度预测。训练时为每个样本随机采 $K_{train}-1$ 个中间深度坐标并排序,端点固定为 $s_0=0,s_{K_{train}}=1$,每个循环的读出被监督到参考路径上的对应点。推理时换成均匀网格 $s_k=k/K_{inf}$,端点 $s=1$ 不变,因此循环数可以在训练后任意选择;外层仍是标准 Euler 积分 $x_{t+\Delta t}=x_t+\Delta t\,u_\theta^{(K_{inf})}(x_t,t)$,每个积分步重新初始化递归状态。
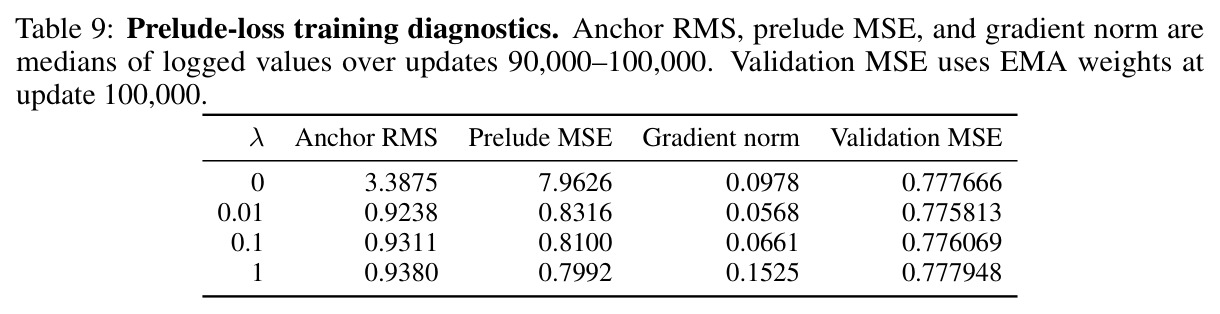
核心创新是轨迹目标(trajectory objective):令锚点 $b=\mathrm{sg}(u_0)$ 为 prelude 单独给出的初始预测(stop-gradient),构造参考路径 $$\bar{u}_s=(1-s)b+s\,u^\star,\quad s\in[0,1],$$ 其中 $u^\star=x_1-x_0$ 是流匹配速度目标。第 $k$ 次循环在坐标 $s_k$ 处被监督到路径上的对应点,损失为 $\mathcal{L}_{LiFT}=\mathbb{E}\sum_{k=1}^{K_{train}}\frac{1}{d}\|u_k-((1-s_k)b+s_k u^\star)\|^2$。由于固定 $b(z)$ 时路径的条件均值为 $\mathbb{E}[\bar{u}_s|z]=(1-s)b(z)+s\,v^\star(z)$,每个坐标都定义一个良定的回归任务,剩余校正量满足 $u^\star-\bar{u}_s=(1-s)(u^\star-b)$,末循环仍面对完整流匹配目标。这与以往'所有中间预测都回归完整输出'有本质区别:预测任务被沿深度分布,循环数只决定路径被遍历得多细,完全类比积分步数之于生成时间。锚点每次前向重算但在构造目标时 detach,预测侧梯度仍贯穿整个递归展开(含 prelude);另加辅助损失 $\mathcal{L}_{train}=\mathcal{L}_{LiFT}+\lambda\mathcal{L}_{prelude}$($\mathcal{L}_{prelude}=\|u_0-u^\star\|^2/d$,$\lambda=0.01$ 且置于循环平均之外)防止锚点尺度漂移。
方法步骤详情
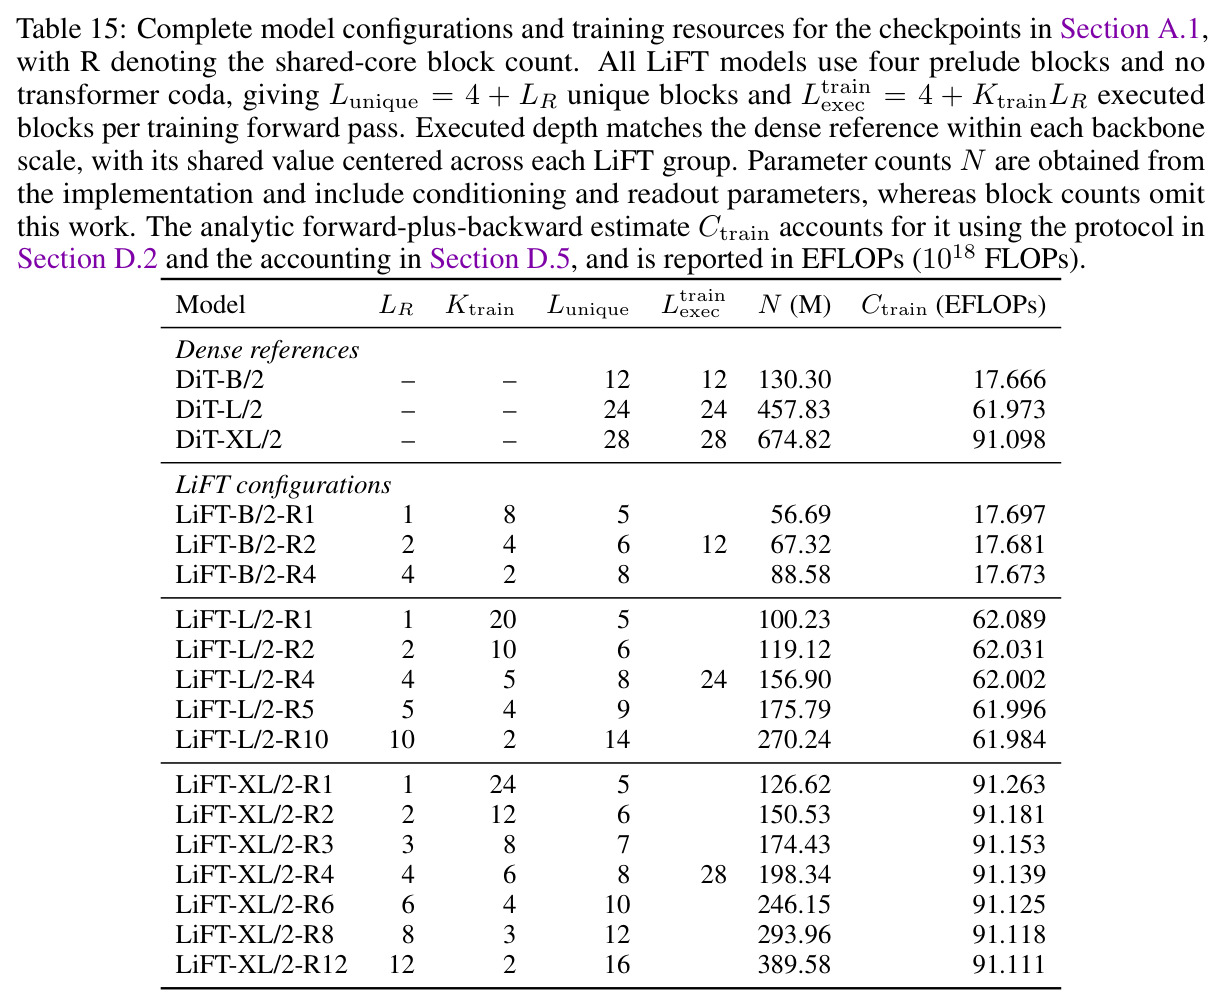
训练(Algorithm 1):(1) 每样本采 $x_0\sim\mathcal{N}(0,I)$、$t\sim U(0,1)$,算 $x_t=(1-t)x_0+t x_1$ 与目标 $u^\star=x_1-x_0$;(2) 独立采 $K_{train}-1$ 个 $U(0,1)$ 深度坐标,排序并补端点得 $s_0=0<s_1<\cdots<s_{K_{train}}=1$;(3) prelude 计算 $h_0=P_\theta(x_t,c)$,coda 读出 $u_0$,取锚点 $b=\mathrm{sg}(u_0)$;(4) 逐循环 $h_k=R_\theta(\mathrm{RMSNorm}(h_{k-1})+h_0,\ c+e_s(s_k))$、$u_k=D_\theta(h_k,c)$,对每个 $k$ 用 MSE 回归 $(1-s_k)b+s_k u^\star$,损失在 $K_{train}$ 个读出上取平均;(5) 加 $\lambda\mathcal{L}_{prelude}$($\lambda=0.01$);(6) 反向传播贯穿全部预测与递归状态,AdamW、lr $10^{-4}$、全局 batch 256、50 万步、BF16、4×H100。架构上每尺度固定执行深度 $4+K_{train}L_R$ 等于稠密参考(B/2:12、L/2:24、XL/2:28 层)。推理:每个 Euler 步重新初始化 prelude 状态,用均匀网格 $s_k=k/K_{inf}$ 跑 $K_{inf}$ 次核心,只有最终读出 $u_{K_{inf}}$ 驱动更新 $x_{t+\Delta t}=x_t+\Delta t\,u_\theta^{(K_{inf})}(x_t,t)$,中间读出仅在训练时需要;采样用 EMA 权重、无 classifier-free guidance。
技术新颖性
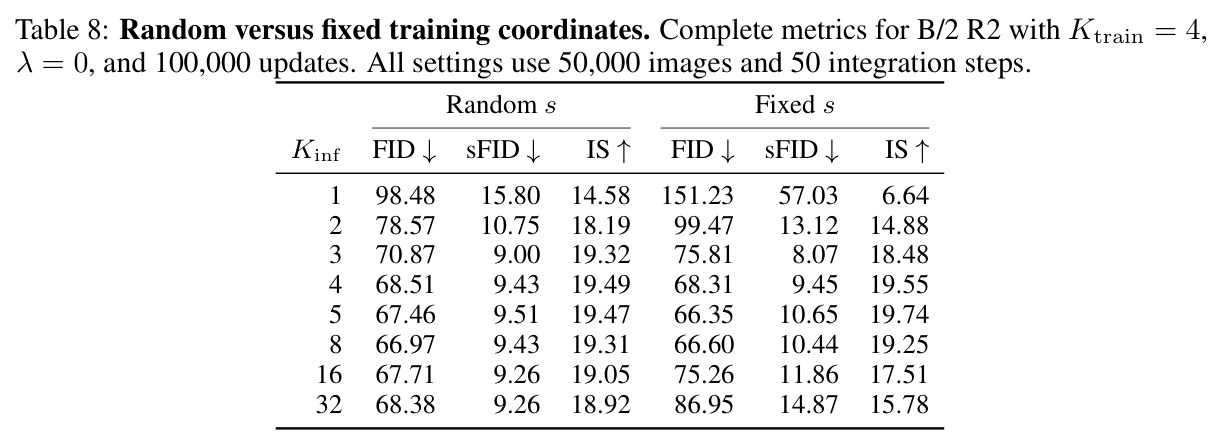
与最近邻工作的本质差异:LoopDiT 布局相似但训练目标(MeanFlow 只教最终预测)和短计算分配(保留训练条件调度前缀)不同,LiFT 监督中间速度读出且让所有预算都到达 $s=1$;ELT/DeepFlow/R-MDM 虽做中间监督,但目标是完整输出,或需全深度教师自蒸馏,LiFT 用 detach 的初始预测作路径起点、给每个读出不同的校正份额,无需教师;LoopFormer 对齐不同预算的轨迹端点,LiFT 指定中间预测在路径上的分位点;平衡类方法要求隐状态收敛到不动点,LiFT 保持有限的深度条件化 rollout,不对隐状态施加平衡方程。工程巧思:零 transformer 块的 coda 把轨迹训练重复读出的开销压到稠密参考的 0.2% 以内;训练网格随机化让模型见过任意坐标组合(消融显示 32 循环时 FID 68.38 对固定网格的 86.95);深度嵌入只进核心、prelude/coda 只用固定条件,避免条件泄漏。理论上附录 C 证明了路径回归的条件最优解、detach 锚点下的梯度流,以及高斯/Fisher/KL 视角下的解释。
实验结果
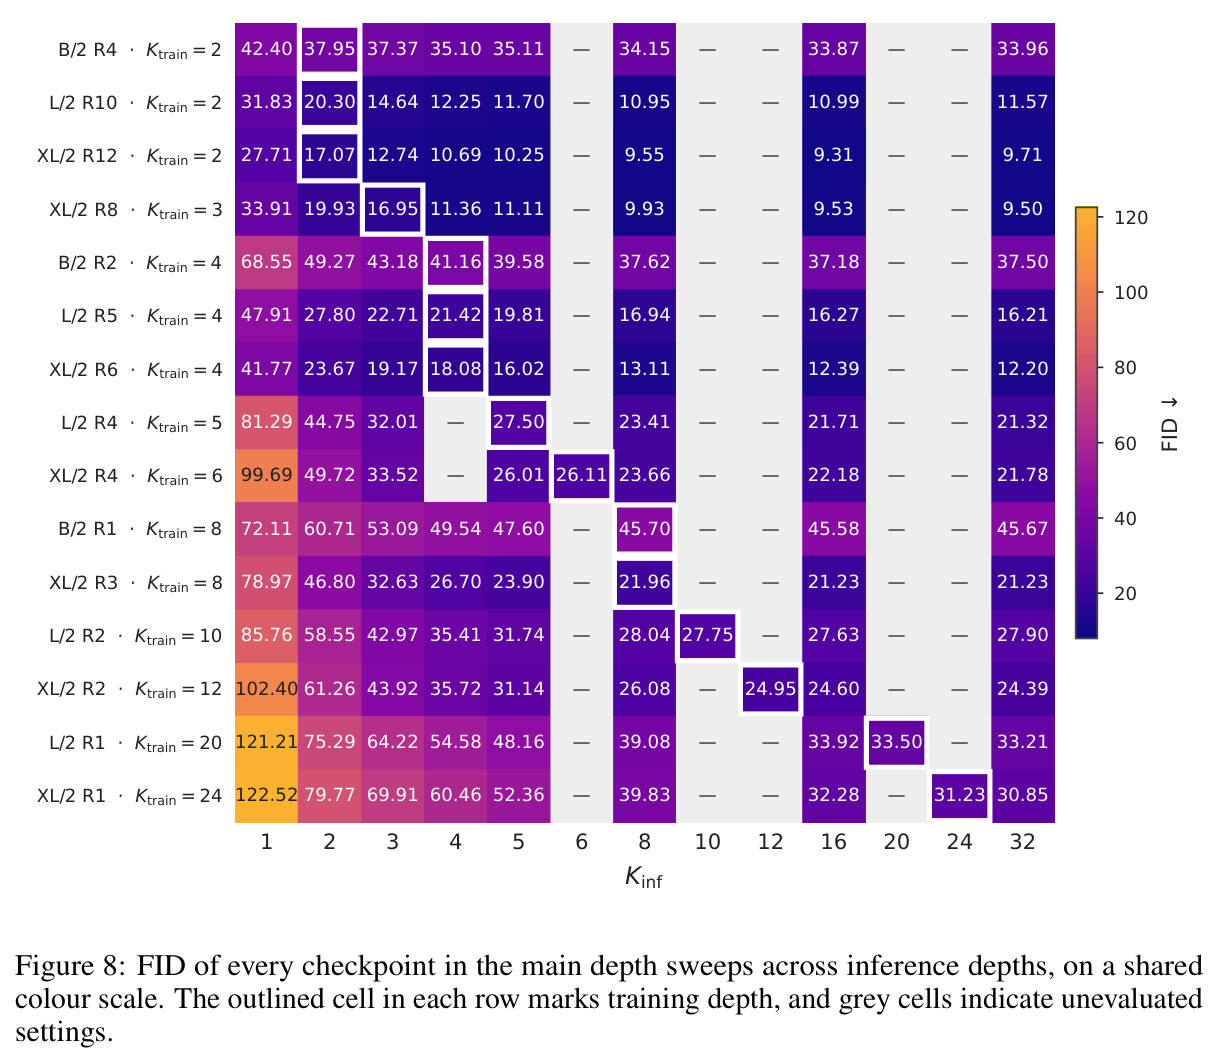
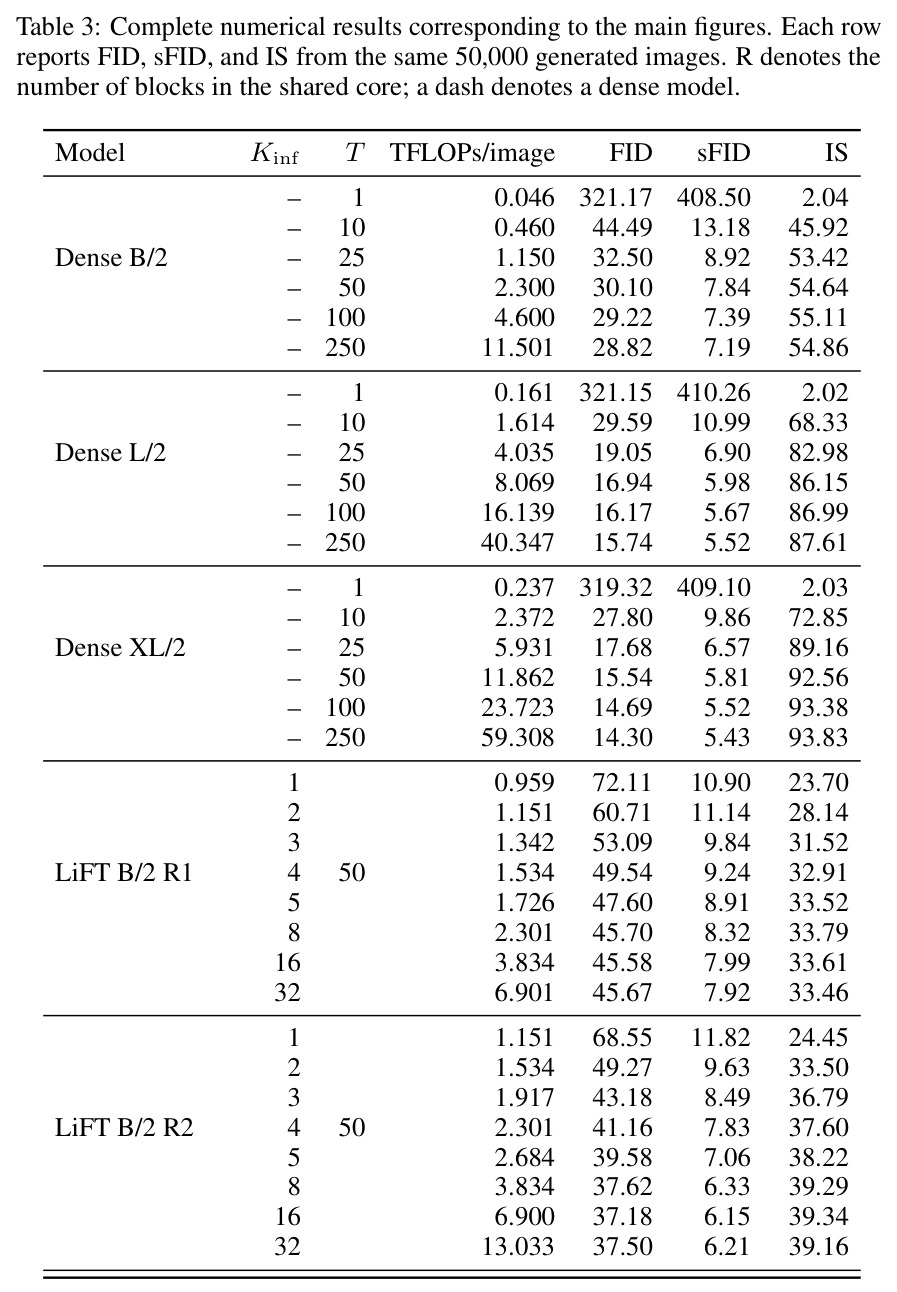
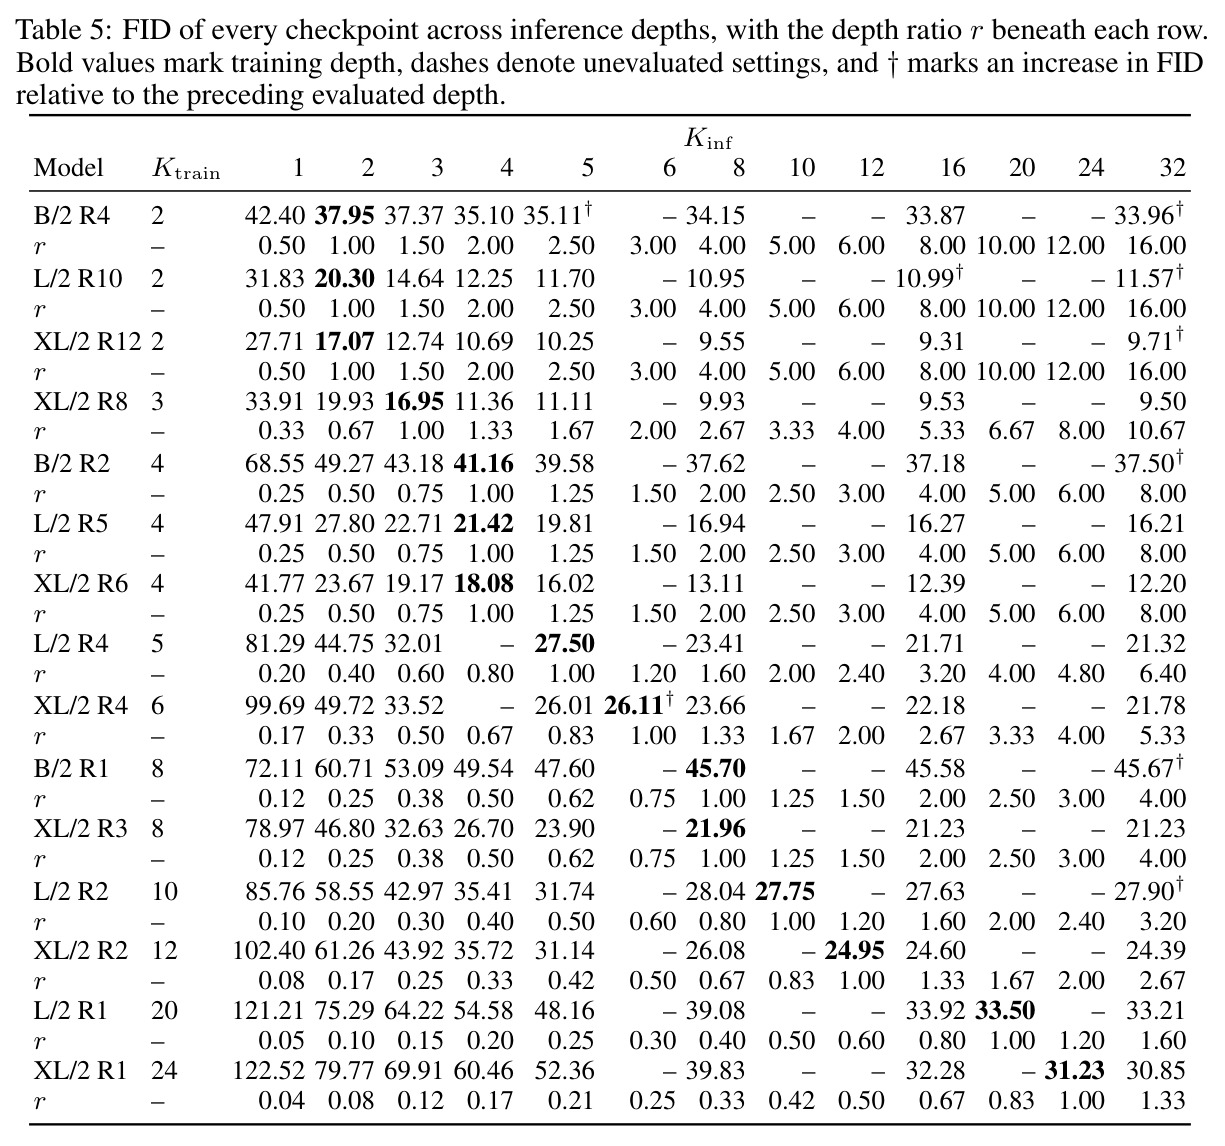
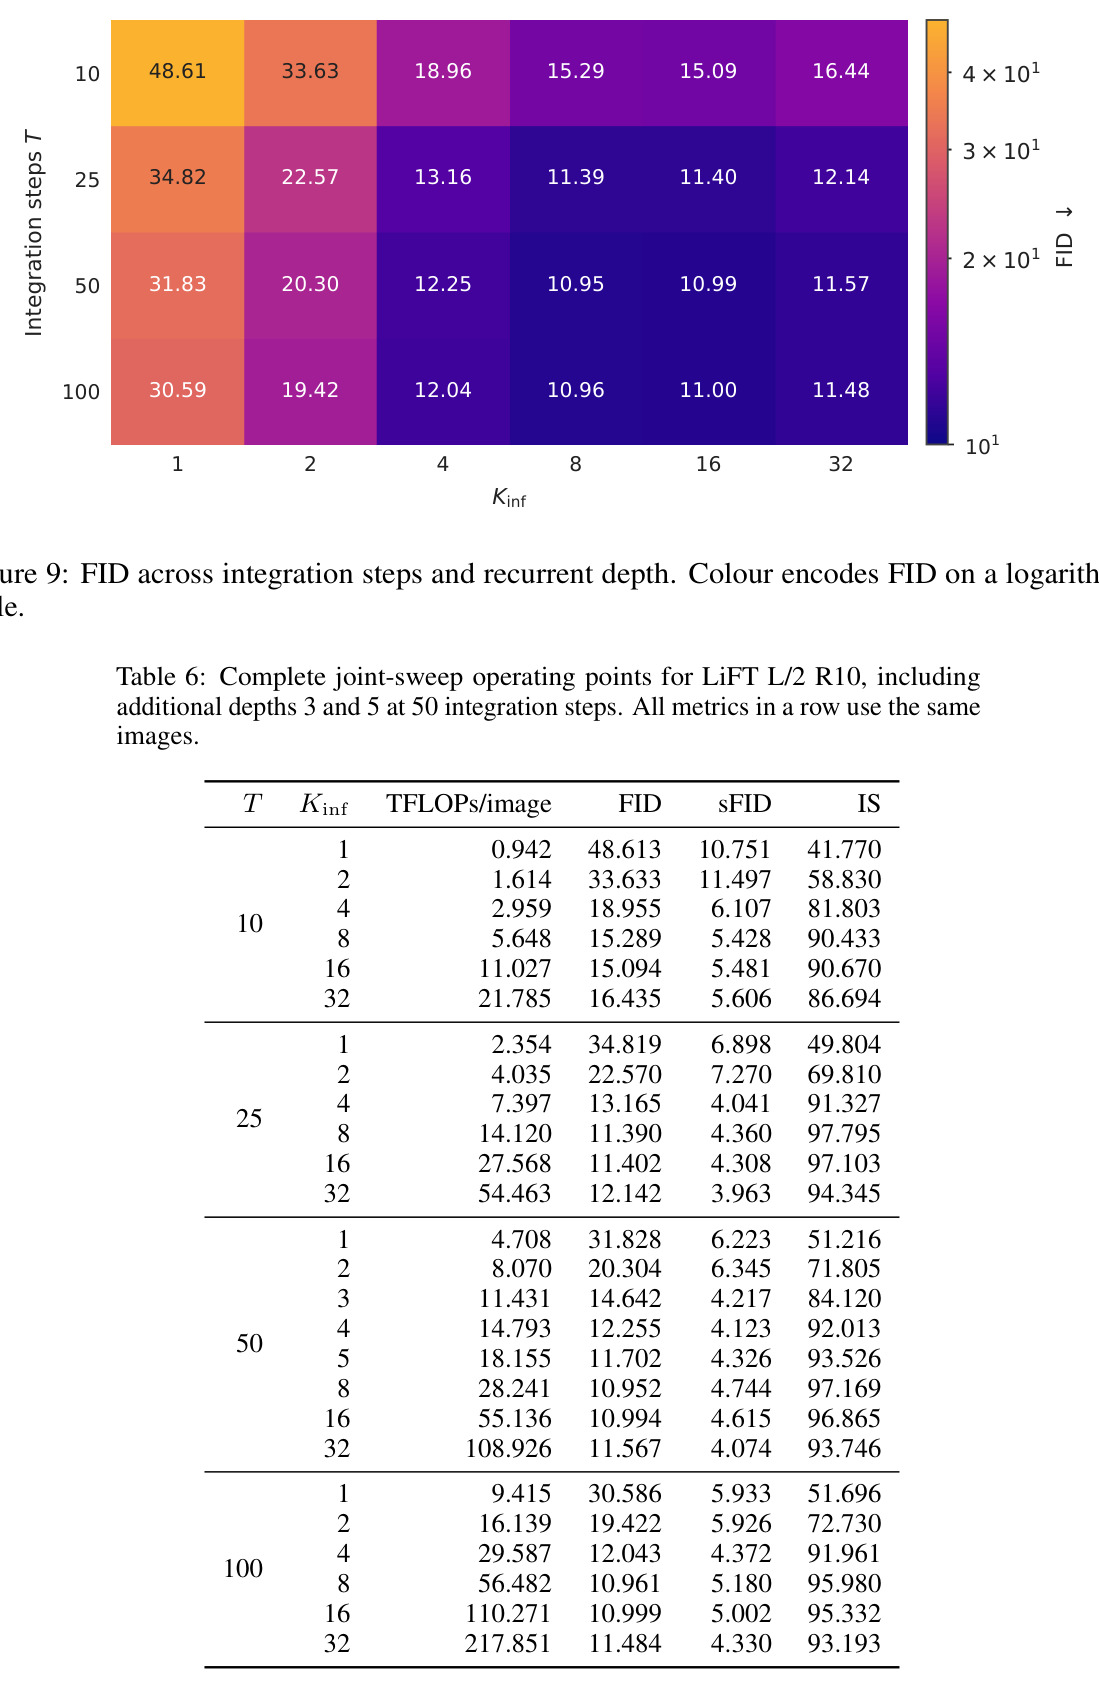
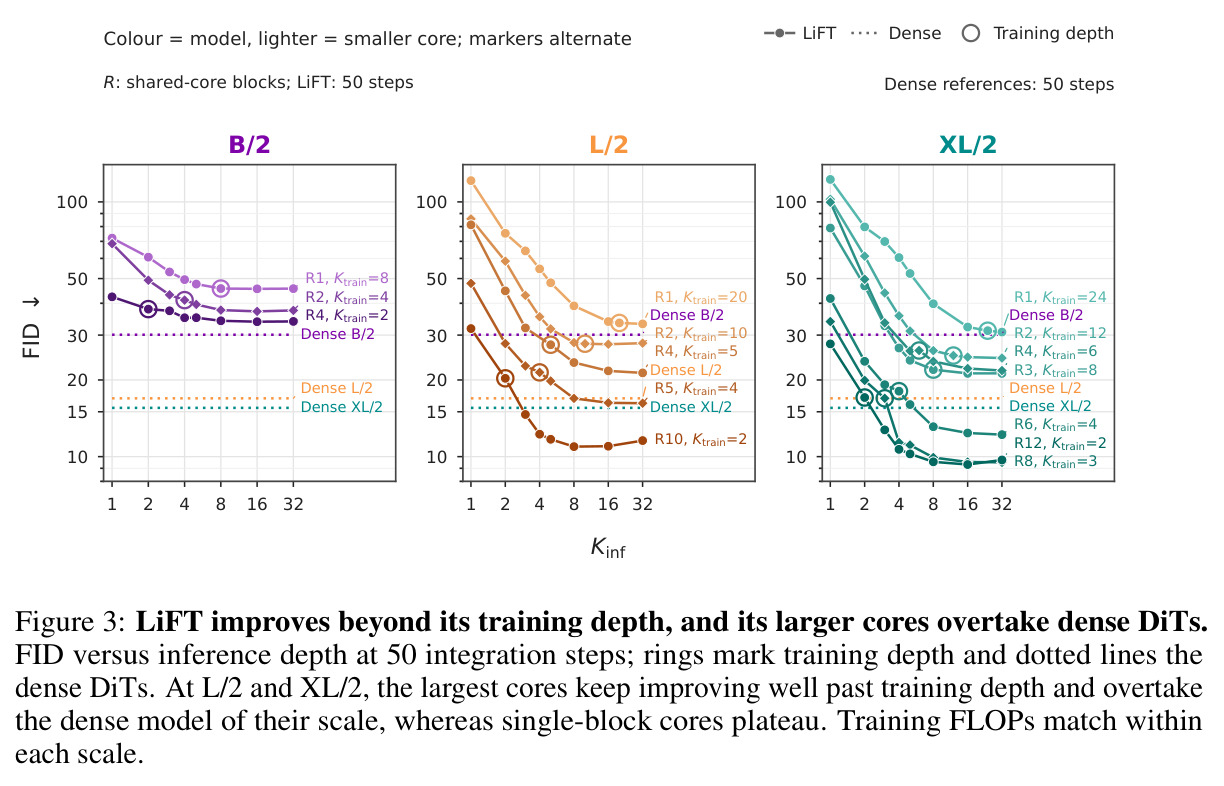
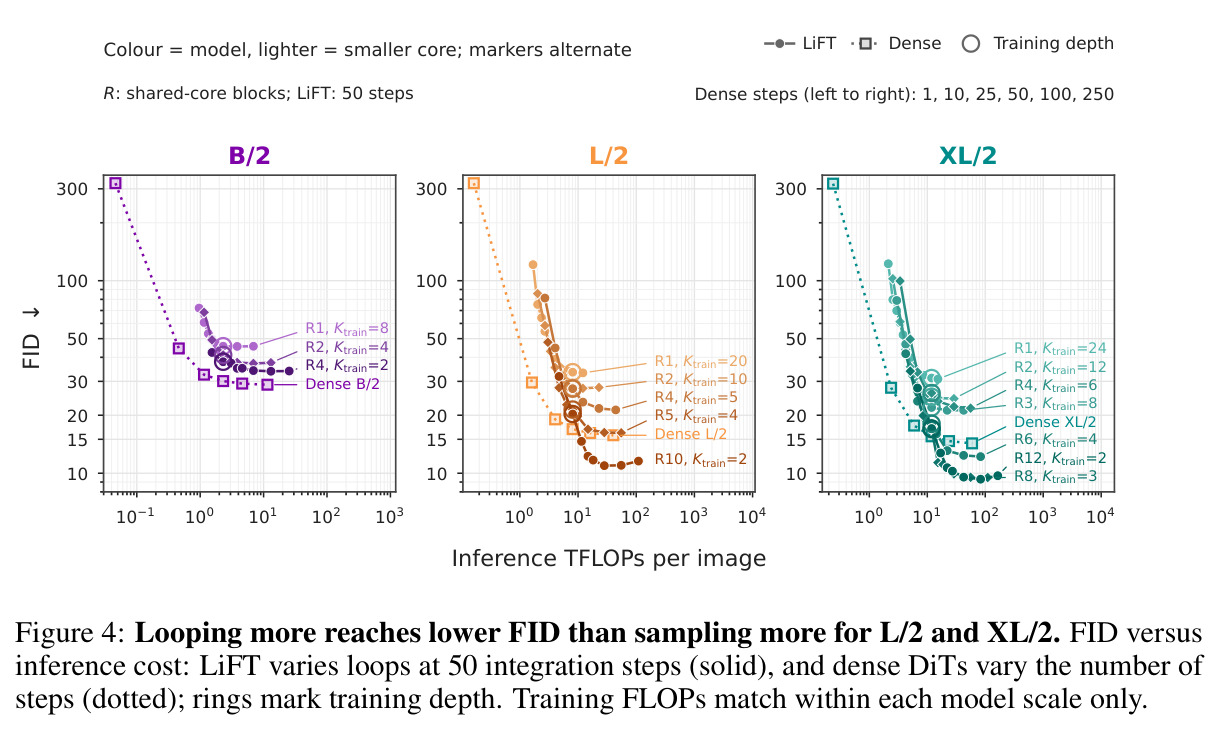
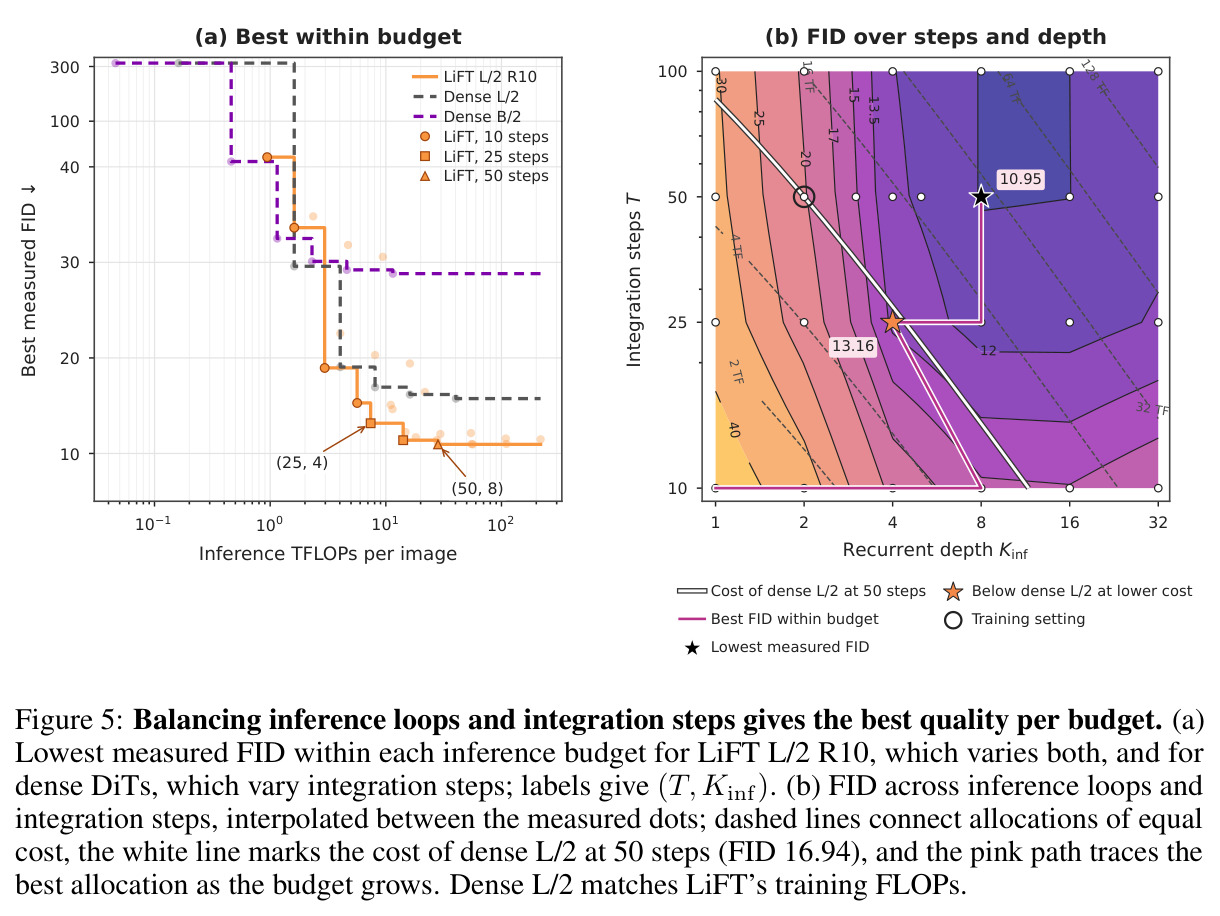
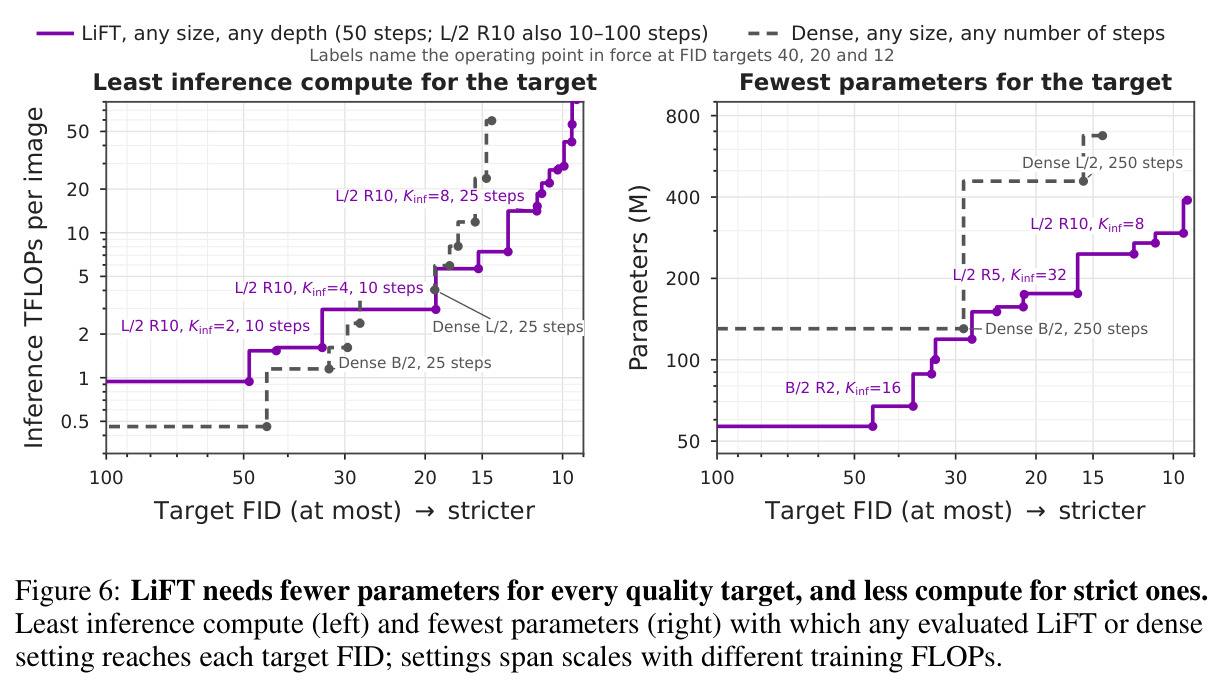
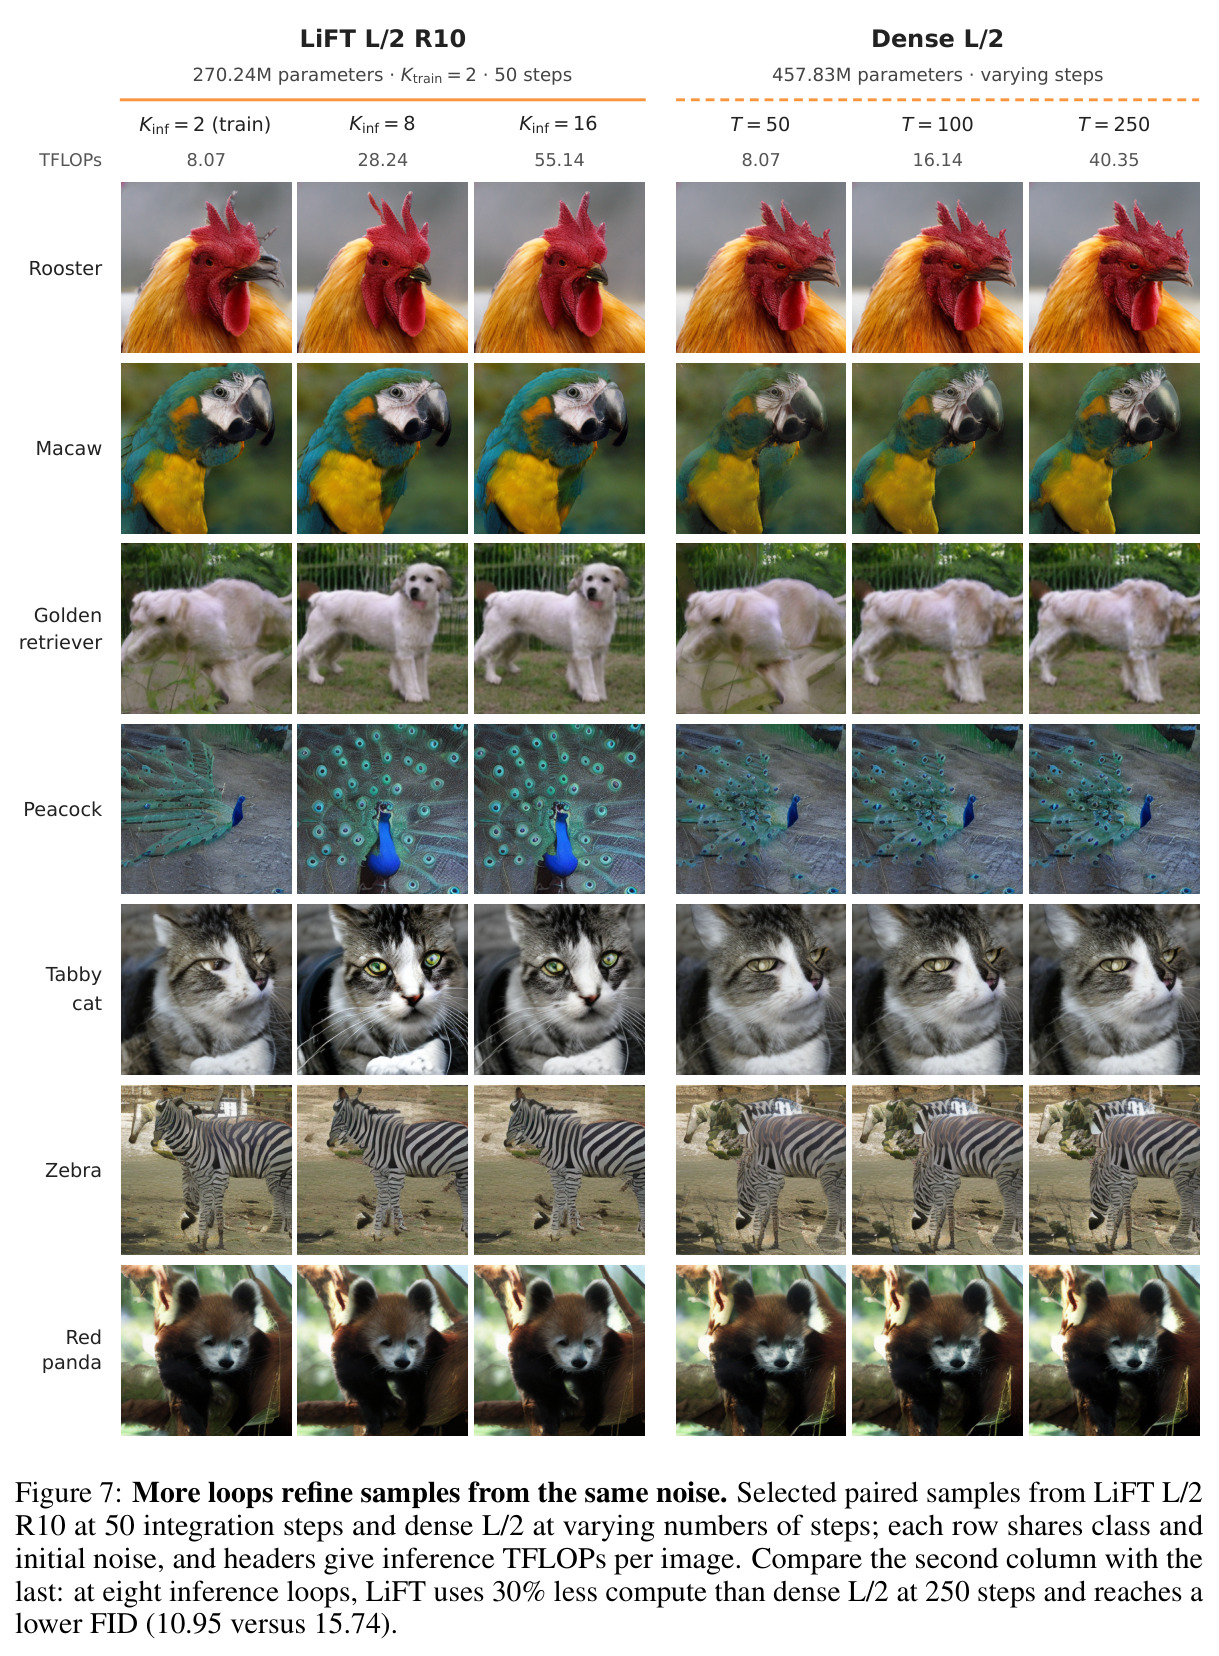
Q1(深度外推,50 步固定):XL/2 R12($K_{train}=2$)FID 从训练深度的 17.07 降到 16 循环的 9.31(8 倍深度);L/2 R10 从 20.30 降到 8 循环的 10.95;XL/2 R8 从 16.95(3 循环)降到 32 循环的 9.50(10.67 倍);训练深度较大的 L/2 R5 增益较小(21.42→16.21),单块核心停滞。L/2 R10 仅 3 个推理循环就以 FID 14.64(11.43 TFLOPs)超过稠密 XL/2 的 15.54(11.86 TFLOPs),参数少 60%。Q2(等算力):L/2 R10 四循环 FID 12.25@14.79 TFLOPs,稠密 L/2 要 100 步、16.14 TFLOPs 才到 16.17;XL/2 R8 四循环 11.36@15.25 TFLOPs,稠密 XL/2 为 14.69@23.72 TFLOPs(参数分别少 41% 和 56%)。旗舰结论:L/2 R10 八循环 FID 10.95@28.24 TFLOPs,比稠密 XL/2 250 步的 14.30@59.31 TFLOPs 低 3.34 点,参数约少 60%、推理 FLOPs 少 52%、训练 FLOPs 少 32%(61.98 对 91.10 EFLOPs)。但 B/2 上稠密全程更强(LiFT 最好 33.87 对稠密 32.50)。Q3(联合分配):25 步+4 循环 FID 13.16@7.397 TFLOPs 优于稠密 L/2 50 步的 16.94@8.069;16 循环+10 步反而 15.09@11.027 更差更贵;8 循环下步数 50→100 FID 几乎不动(10.95→10.96),加深到 32 循环开始回升。Q4:目标 FID 20 时最少算力选 L/2 R10(10 步 4 循环,2.96 TFLOPs),最少参数选 L/2 R5(176M)。消融:随机对固定训练坐标,32 循环 FID 68.38 对 86.95;$\lambda=0$ 时锚点 RMS 漂移到 3.39(目标约 1.30),$\lambda=0.01$ 稳在 0.93 且 FID 最优 64.81。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ImageNet 256×256 类条件生成(旗舰对比) | FID ↓ | LiFT-L/2-R10,50 步 + 8 循环:10.95(28.24 TFLOPs/图) | 稠密 DiT-XL/2,250 步:14.30(59.31 TFLOPs/图) | FID 降低 3.34 点,参数约 −60%,推理 FLOPs −52%,训练 FLOPs −32%(61.98 vs 91.10 EFLOPs) |
| 深度外推(50 步,K_inf 超过 K_train) | FID ↓ | LiFT-XL/2-R12:训练 2 循环 17.07 → 16 循环 9.31;LiFT-XL/2-R8:16.95 → 32 循环 9.50 | 各自训练深度处;稠密 XL/2(50 步)为 14.69 | 8–10.67 倍于训练深度仍持续提升,并反超同规模稠密模型 |
| 匹配执行深度的同规模对比 | FID ↓ @ 50 步 | LiFT-L/2-R10(K_inf=2,即训练深度):20.30 | 稠密 DiT-L/2:16.94 | +3.36(LiFT 在训练深度处落后,优势需靠加深循环兑现) |
| 等推理算力对比(L/2 规模) | FID ↓ | LiFT-L/2-R10,25 步 + 4 循环:13.16(7.397 TFLOPs/图) | 稠密 DiT-L/2,50 步:16.94(8.069 TFLOPs/图) | FID −3.78,推理算力 −8%,参数 −41% |
| B/2 规模对比(反例) | FID ↓ | LiFT-B/2-R4 最优(16 循环):33.87 | 稠密 DiT-B/2,25 步:32.50(1.150 TFLOPs) | +1.37(小容量下稠密全程更强,循环无法弥补容量缺口) |
| 训练坐标消融(B/2 R2,K_train=4) | FID ↓ @ 32 循环 | 随机深度坐标:68.38(sFID 9.26,IS 18.92) | 固定均匀坐标:86.95(sFID 14.87,IS 15.78) | FID −18.57,随机网格显著改善深度鲁棒性 |
局限与改进
作者承认的局限:评测仅限类条件 ImageNet 256×256、无 classifier-free guidance,其他模态与引导采样下的深度扩展行为未知;优势依赖规模与工作点——B/2 上稠密模型在所有评测算力点都更强,且每个 LiFT 在训练深度处都落后同规模稠密参考;所有结果来自单次训练运行与单一 5 万张样本集;只报告参数量与解析 FLOPs 估计,未测设备级延迟、能耗与峰值显存;推理深度是人工指定的网格而非自适应选择,联合分配研究只覆盖 L/2 R10 一个检查点的有限网格。我的补充观察:外层仍需 50 步左右积分,少步/蒸馏场景未验证;因不用 CFG,绝对 FID 无法与 SOTA 数字(如 DiT-XL/2+CFG 的 2.27)直接比较;多数检查点在 8–16 循环后收益饱和甚至轻微回升(如 XL/2 R12 在 32 循环回升到 9.71),'无限加深'并不成立;要覆盖 15 种配置需分别训练 15 个检查点,权重不能跨 $K_{train}$ 复用;锚点仅来自 4 层 prelude,其质量可能限制极深循环下路径的有效性。
独立分析的弱点
第一,小容量失效:B/2 核心最多 89M 参数却面对 32.8B token 的数据预算,任何循环数都无法弥补容量缺口(最好 33.87 对稠密 32.50),部署前需要做容量–数据–循环的联合搜索,论文未给出选型法则。第二,等执行深度处 LiFT 一律落后(L/2 R10 训练配置 20.30 对稠密 16.94),它必须靠超出训练深度的额外推理算力才能翻盘;引用的 iso-depth 定律称一个共享块约值半个独立块,改进方向是让核心内部混入少量独立层,或把单核换成多核轮换以提升每循环的 expressive power。第三,FLOPs 低不等于延迟低:循环是严格串行的,无法像稠密深层那样并行,硬件上未必更快,需要算子融合、CUDA graph 或编译优化的实测验证。第四,缺少自适应深度:不同样本、不同积分步需要的校正量不同,可引入逐步或置信度驱动的提前停机(ACT 类机制),目前所有深度都是统一均匀网格。第五,评测缺 CFG 与文生图,深度外推在引导采样下是否保持完全未知。第六,参考路径是欧氏直线弦,虽然附录 C 给出了 Fisher/KL 解释,但学习式或测地式路径可能进一步对齐预测几何,值得探索。
未来方向
作者提出的方向:把可调循环深度作为推理轴推广到视频与生成动力学模型;预算感知生成;自适应深度选择;内外层(循环数与积分步数)计算预算的联合优化;以及面向显存受限边缘设备的部署评估。基于本文成果还可延伸:(1) 与 MeanFlow/一致性蒸馏结合,用循环精化换取 1–4 步少步生成,打通两条推理算力轴;(2) 为每个积分步动态分配循环数(噪声大时多循环、接近数据时少循环),形成时间–深度联合调度器,这是对 Q3 网格研究的自然推广;(3) 把参考路径从直线换成学习式或最优传输式路径,检验深度外推对路径形状的敏感性;(4) 在文本引导的大规模文生图(SD3/Flux 级别)与视频 DiT 上验证,并与 CFG、量化、蒸馏等部署技术正交组合;(5) 理论上刻画循环数–质量曲线的饱和点与容量下界,解释 B/2 失败而 L/XL 成功的相变现象;(6) 系统方向:实测循环核的延迟、能耗与显存,给出'参数受限 vs 算力受限'场景的选型指南。
复现评估
论文未提及公开代码(arXiv 首页有 Coming Soon 占位),但复现信息异常完备:架构基于开源 SpeedrunDiT 的块设计(RMSNorm、per-head QK 归一化、2D RoPE、GELU MLP、adaLN-zero);数据为 ImageNet-1k 经 SD-VAE 缓存的 4×32×32 FP16 latent(缩放 0.18215),预处理遵循 ADM/DiT 惯例;超参完整给出(AdamW lr $10^{-4}$、全局 batch 256、50 万步、500 步 warmup、EMA 0.999、BF16 计算/FP32 累加、全局范数裁剪 1、seed 42);Table 15 列出全部 15 个配置的参数量与解析训练 EFLOPs,附录 D.3 提供训练与采样伪代码,D.5 给出逐项 FLOPs 解析公式。评测可精确复刻:每设置 5 万张、每类 50 张、噪声种子 $200042+i$、EMA 权重、无 CFG、官方 ADM 评估器、初始噪声与类别跨配置配对。算力门槛较高:主实验每模型用 4×H100 训练,训练预算 62–91 EFLOPs(约 1.28 亿次图像呈现),XL 规模复现需数周;但消融规模(B/2 R2、10 万步)可在单节点较快验证。总体难度中高:算法本身简单、协议披露充分,主要成本在算力与多配置训练。
论文图表
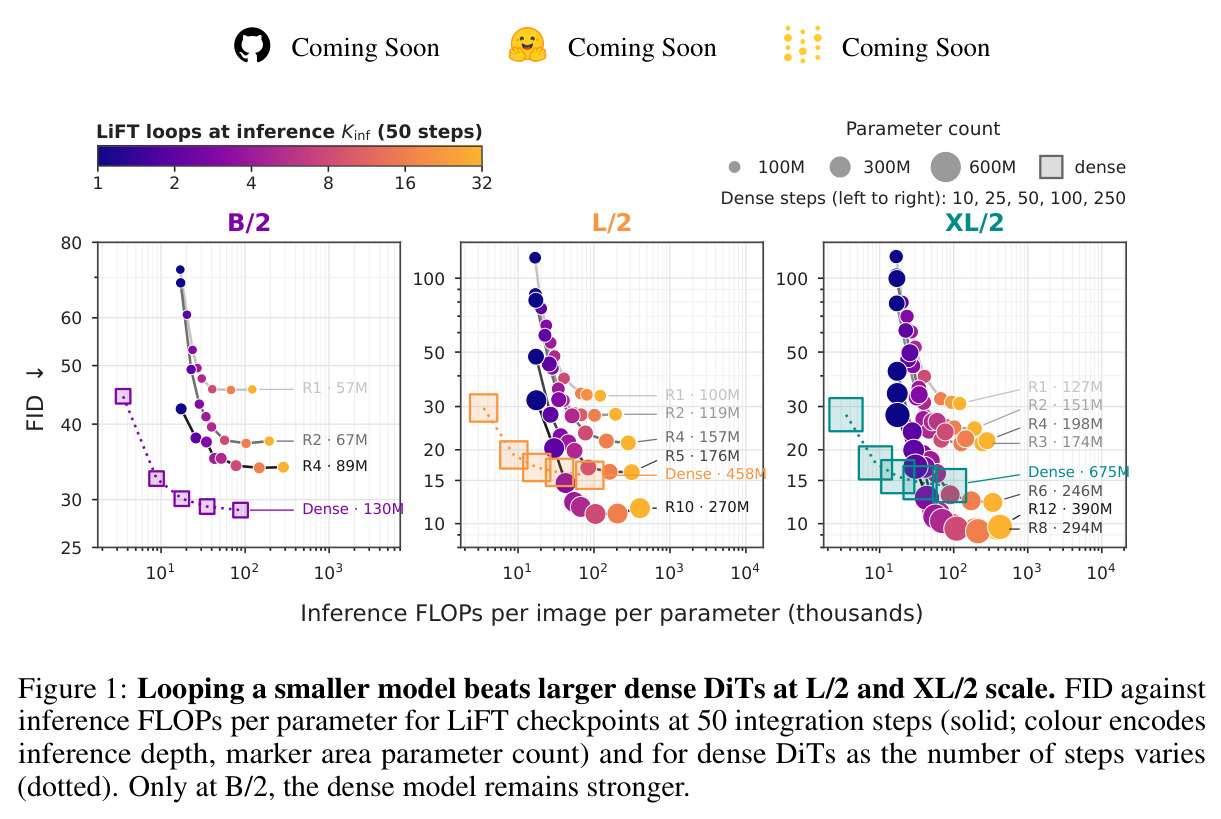
三个面板(B/2、L/2、XL/2)画出 FID 对每参数推理 FLOPs 的散点:LiFT 各检查点在 50 积分步下随推理循环数 $K_{inf}$ 变化(实线,颜色编码推理深度、标记面积编码参数量),稠密 DiT 随积分步数 10–250 变化(虚线)。在 L/2 和 XL/2 规模,较小的循环模型以更少参数和算力达到比更大稠密模型更低的 FID;只有 B/2 上稠密模型仍占优。
这是全文结论的一图总览:一眼看出'循环小模型打败稠密大模型'的规模依赖性,以及 LiFT 的两个算力轴(步数与循环)如何在坐标系中分离。