最小见证强化学习 Minimal Witness Reinforcement Learning
把强化学习从找单个解扩展到从验证器位恢复全部最小充分解的关系型信用分配方法
前置知识
单调充分谓词与反链 (antichain)
谓词 $s: 2^E \to \{0,1\}$ 判定子集 $S$ 是否足以导致目标结果,单调性指 $S \subseteq T \Rightarrow s(S) \le s(T)$(加元素不会把成功变成失败)。见证是 $s(S)=1$ 的集合;最小见证是没有真子集也是见证的集合;全体最小见证互不包含,构成反链 $\mathcal{M}$。
本文的目标函数、评估指标(born-minimal 率、反链召回)和全部理论(定理 1-6)都定义在反链上,不懂反链就无法理解论文要恢复的到底是什么。
子集格与上闭集(证域)
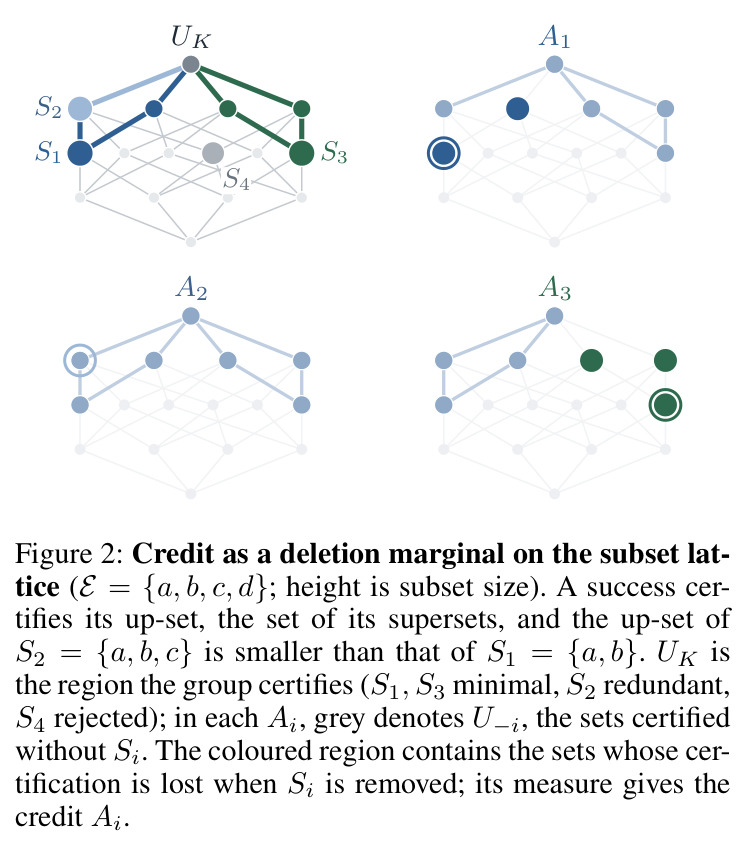
幂集 $2^E$ 按包含关系构成格。集合 $S$ 的上闭集 $\uparrow S = \{T : T \supseteq S\}$。单调性下,一次成功验证等于证明了整个 $\uparrow S$ 都充分,故称为“证域”;一组成功样本的证域是各上闭集的并 $U(W) = \bigcup_{S \in W} \uparrow S$。
MWRL 的组回报 $R(U(W))$ 与删除信用都建立在证域上,证域是把“单次验证调用”放大为“一整族保证”的关键数据结构。
策略梯度与组基线 (REINFORCE / GRPO / RLOO)
score-function 梯度 $\nabla_\theta J = \mathbb{E}[A \nabla_\theta \log \pi_\theta]$;减去任何与被更新轨迹无关的基线不改变期望梯度。GRPO 用组内均值方差归一化优势,RLOO 用其余 $K-1$ 条轨迹的均值做基线。
MWRL 的 l1o/l2o 估计器正是这一原理的实例:以“去掉轨迹 $i$ 后的组回报”为基线,只是基线里比较的是子集包含关系而非标量奖励。
GFlowNet 与最大熵 RL
两类学习终端分布的生成式方法:GFlowNet 训练采样律与给定奖励成正比 $q \propto R$,MaxEnt RL 最大化熵正则回报。它们的奖励都是“局部”的——同一集合在任何单调谓词下权重相同,只取决于自身与其验证位。
定理 1 证明这类逐样本局部方法在某些单调谓词下必然无法恢复完整反链,它们是本文最重要的对照类别与被证伪对象。
次模集合函数与覆盖度量
次模函数满足边际收益递减:往更大的集合里加元素的增益更小。MWRL 取几何乘积测度 $\mu$(每元素以 $p=0.7$ 独立出现)定义覆盖度量 $R_\mu(U)=\mu(U)$,它是成功上闭集之并的测度,对选中成功集是单调次模的。
删除信用就是该次模覆盖函数的边际增益,这保证了信用非负、重叠只算一次等性质,也是与次模 RL、超体积指标联系的桥梁。
机制可解释性中的电路发现与激活修补
在冻结语言模型中搜索注意力头/MLP 子集(电路):把子集外组件的激活替换为另一条对照提示上的激活(activation patching),用 KL 散度衡量输出分布保持程度,忠实度 $1 - \mathrm{KL}(S)/\mathrm{KL}_\emptyset$ 超过阈值 $\alpha$ 则接受。
第三个实验把 MWRL 直接用于 Qwen3 的稀疏电路发现,验证器位就来自上述 KL 阈值判定,且该原始验证器会违反单调性,是压力测试场景。
研究动机
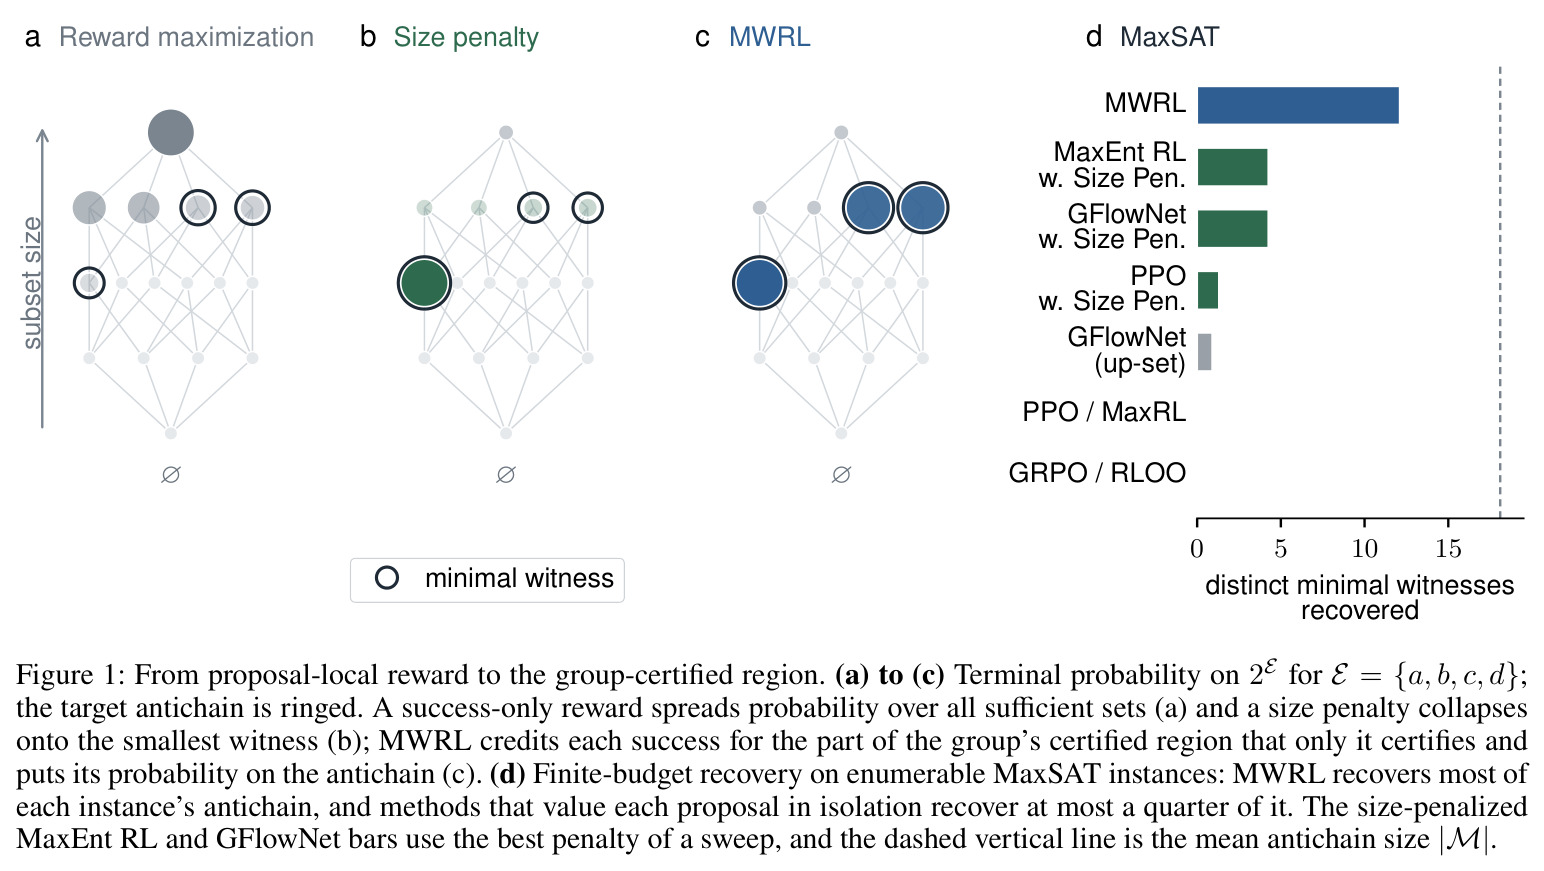
科学与工程中反复出现这样的问题:哪些因素的最小组合足以导致某个结果?论文用服务器诊断举例:电源烧毁、或两块镜像盘同时损坏、或一块盘加 CPU 损坏都会宕机,维护者必须知道全部最小故障组合(反链)才能根治。布尔逻辑的素蕴含项(Quine 1952)、化学反应的最低条件集、充分输入子集解释、机制可解释性的稀疏电路,都是同一结构的实例。当谓词可以写成公式或约束系统时,已有枚举算法(Quine–McCluskey、MUS 枚举、最小超图传递约简)能系统地列出全部最小见证;但许多重要场景只提供黑盒验证器,每次调用只返回接受/拒绝一位——RLVR(可验证奖励强化学习)正是如此。标准 RL 方法在这里系统失败:success-only 奖励给最小见证与其一切充分超集同样的回报,策略输出冗余超集;加大小惩罚又使策略塌缩到最小见证,错过其余不可比见证;MaxEnt RL 和 GFlowNet 在最佳惩罚强度下也只恢复约四分之一的反链。根本原因是这些奖励逐样本评估,无法区分“组内新见证”与“包含另一个已接受样本的冗余超集”。定理 1 证明这是原理性的:PPO/GRPO/RLOO 类可分离目标、GFlowNet/MaxEnt 类比例采样律、MaxRL/pass@k 类成功概率目标,在 $|E|\ge 3$ 时都存在某个单调谓词使其目标分布支撑偏离反链——更好的优化器也无济于事。
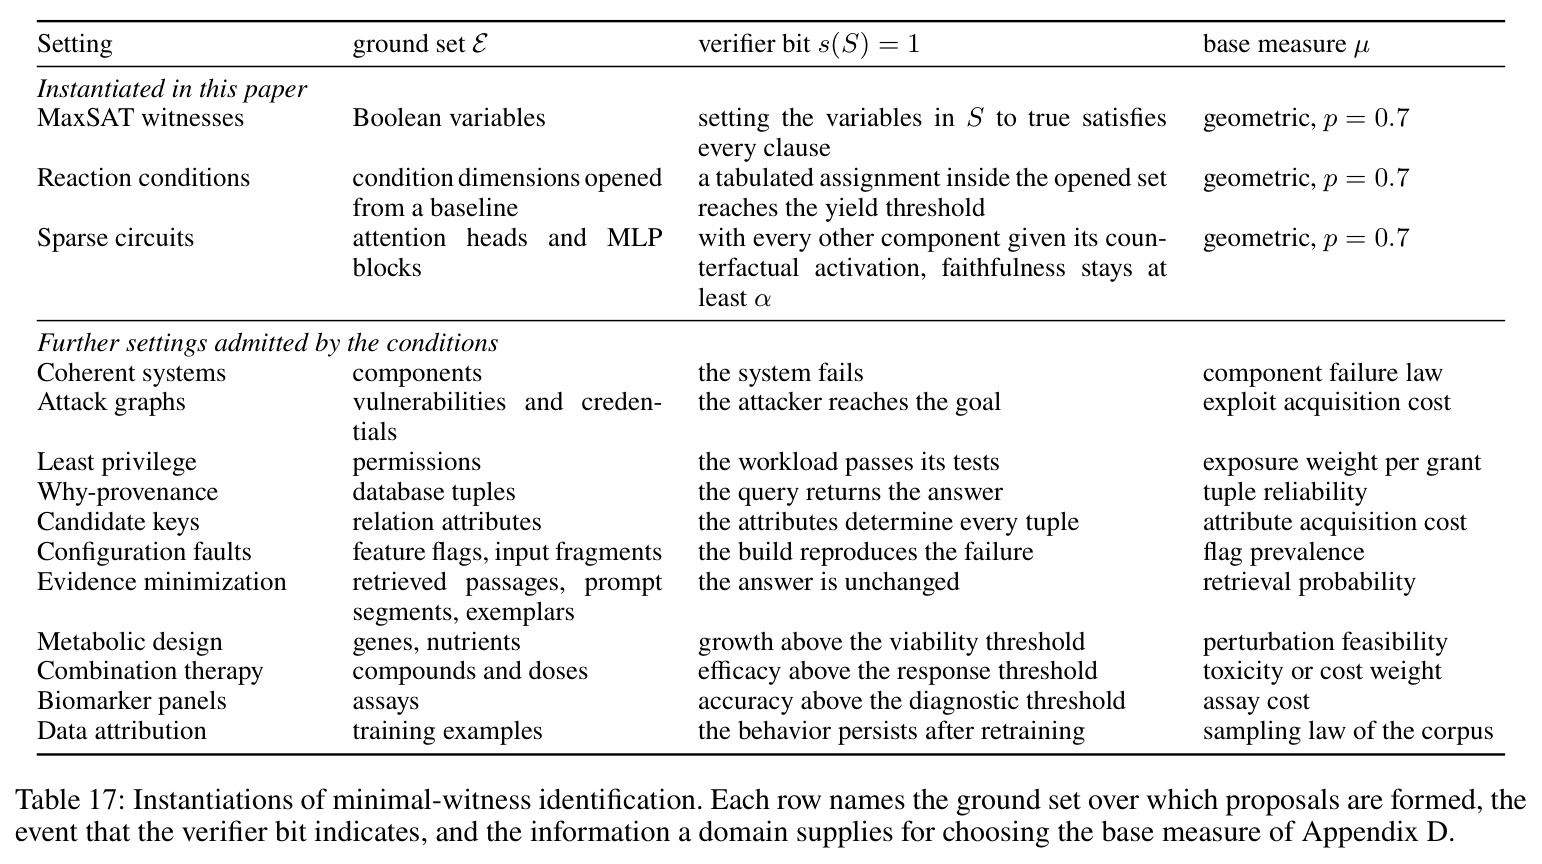
本文的目标是本文把“不可约的条件是什么”形式化为最小见证识别问题:固定上下文 $c$ 及其单调充分谓词 $s_c$,在只有黑盒二值验证器可用的前提下,训练策略 $\pi_\theta(\cdot \mid c)$,使其采样出的提议恢复完整反链 $\mathcal{M}(c)$。具体目标分三层。第一,设计恰当的组回报:同时奖励“精炼”(把被接受集合中多余元素删掉)与“发现组内其他提案未覆盖的新最小见证”,并给重复与冗余成功零信用。第二,给出两个可执行优化器:可枚举小实例上精确恢复整个反链的最小见证值迭代规划器,以及能扩展到语言模型规模的组策略梯度(含无偏的蒙特卡洛信用估计)。第三,在三个差异显著的领域验证:有 ground truth 的 MaxSAT 素蕴含项枚举(检验理论是否成立)、Suzuki–Miyaura 偶联的科学变量识别(检验一个策略能否跨底物摊销)、冻结 Qwen3 上的稀疏电路发现(检验在会违反单调性的原始验证器下的鲁棒性)。作者还系统给出了该形式化适用的十余类现实设置(攻击图、最小权限、证据最小化、数据归因等)。
与已有工作不同的是,独特切入点是把单调性变成信用分配的来源。单调性意味着对成功集合 $S$ 的一次验证调用同时证明了它所有超集都充分,每个成功样本因此携带一个上闭集证书 $\uparrow S$。MWRL 把整组成功样本的证书并起来度量,给每个提案“删除信用”:从组中拿掉它后,组证书区域损失的测度 $\mu(\uparrow S_i \setminus U_{-i})$。这个信号完全由问题定义(验证器位 + 子集序)导出,不需要任何外部多样性度量——这与 novelty/diversity 方法有本质区别:后者的距离度量、行为描述子或核会把冗余超集也当作“不同的发现”,且从不回答“答案何时完整”;而在包含序下 $\{a,b,c\}$ 严格劣于 $\{a,b\}$,重复与冗余自然得零信用。它也不同于次模 RL / 全局 RL——那些方法把非可加效用当作问题给定,而 MWRL 从验证器反馈构造效用。作者用表示定理(定理 2)证明:任何对删除重复/冗余成功不变的对称组值必然可写成证域的函数 $R(U(W))$,从而把“关系型信用”从启发式提升为该问题类的正则形式。
核心方法
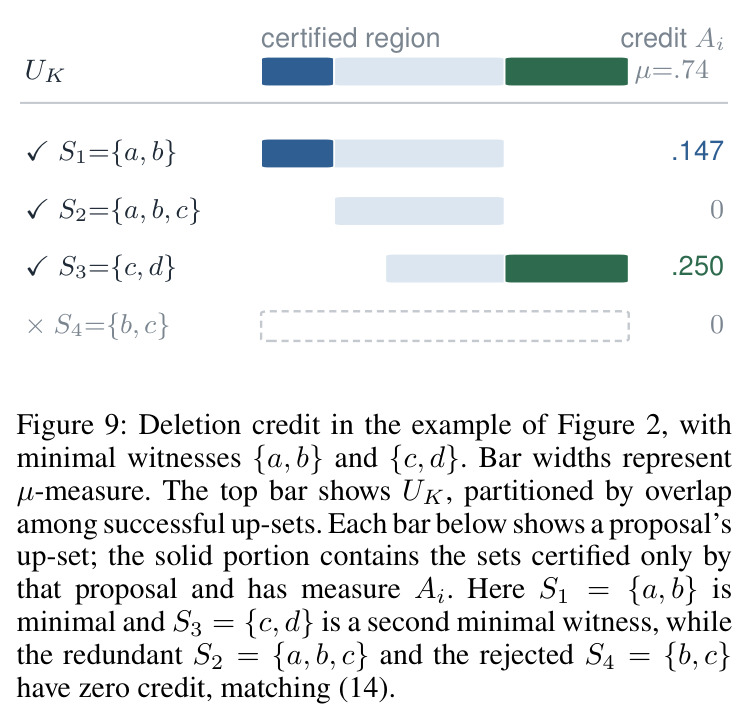
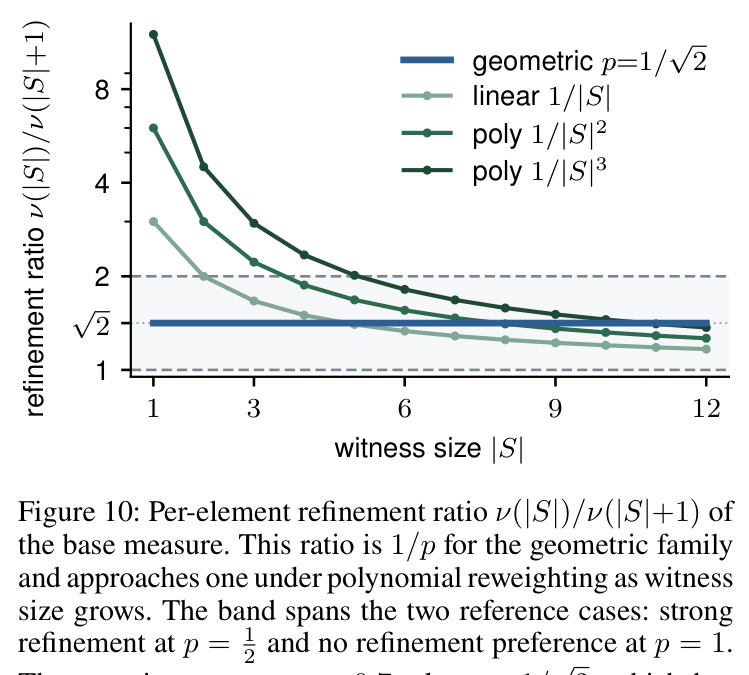
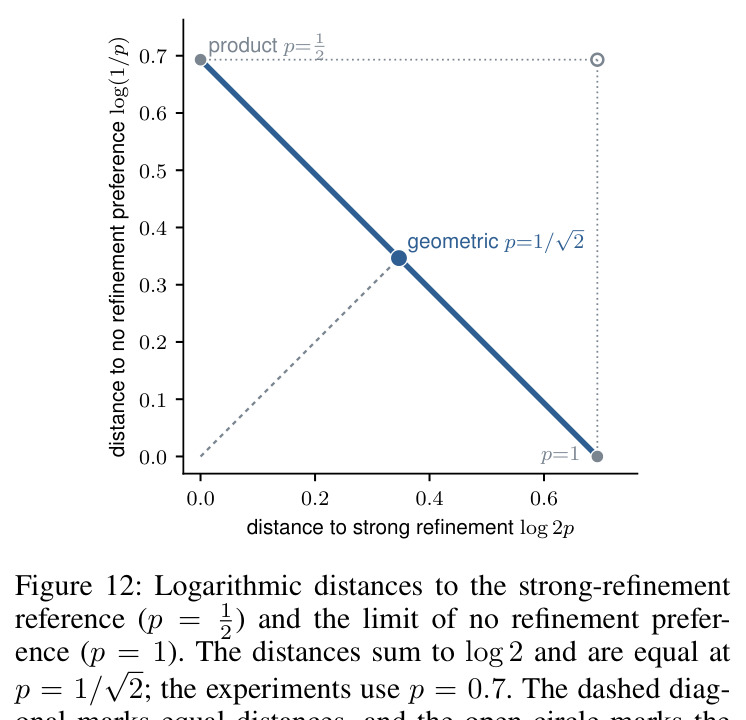
直觉上,一个被接受提议的价值不在于它自己是否成功,而在于它为整组证书贡献了其他提案没有覆盖的部分。技术路线分三步。第一步,证域表示:策略在子集格 $2^E$ 上行走(从 $\emptyset$ 逐个加元素直到 STOP,或从全集逐个删元素,配 stop 动作),回合终止时提交子集 $S$,验证器返回一位 $y_i = s_c(S_i)$;组内成功的证域为 $U_K = \bigcup_{j: y_j = 1} \uparrow S_j$。第二步,组回报与信用:定义 $G(W) = R(U(W))$ 并取覆盖度量 $R_\mu(U) = \mu(U)$,$\mu$ 是每元素以概率 $p$ 独立出现的几何乘积测度(实验统一用 $p = 0.7$);此时集合的见证价值 $\nu(S) = \mu(\uparrow S) = p^{|S|}$,每删一个元素价值乘 $1/p$ 且与当前大小无关——命题 2 证明这是唯一具有“秩均匀精炼”性质的测度族。每个提案的删除信用为 $A_i = R(U_K) - R(U_{-i}) = y_i \cdot \mu(\uparrow S_i \setminus U_{-i})$,再减 leave-two-out 基线得到可正可负的 $\tilde{A}_i$。第三步,优化:对 $\sum_i \tilde{A}_i \nabla_\theta \log \pi_\theta(\tau_i)$ 做 score-function 上升;小 ground set 上改用最小见证值迭代,在状态(已证域 $F$、剩余预算 $b$)上做 Bellman 回溯,每步选边际增益 $\Delta R(S \mid F)$ 最大的成功集,最大边际为零时停止,恰好 $|\mathcal{M}(c)|$ 步输出完整反链。
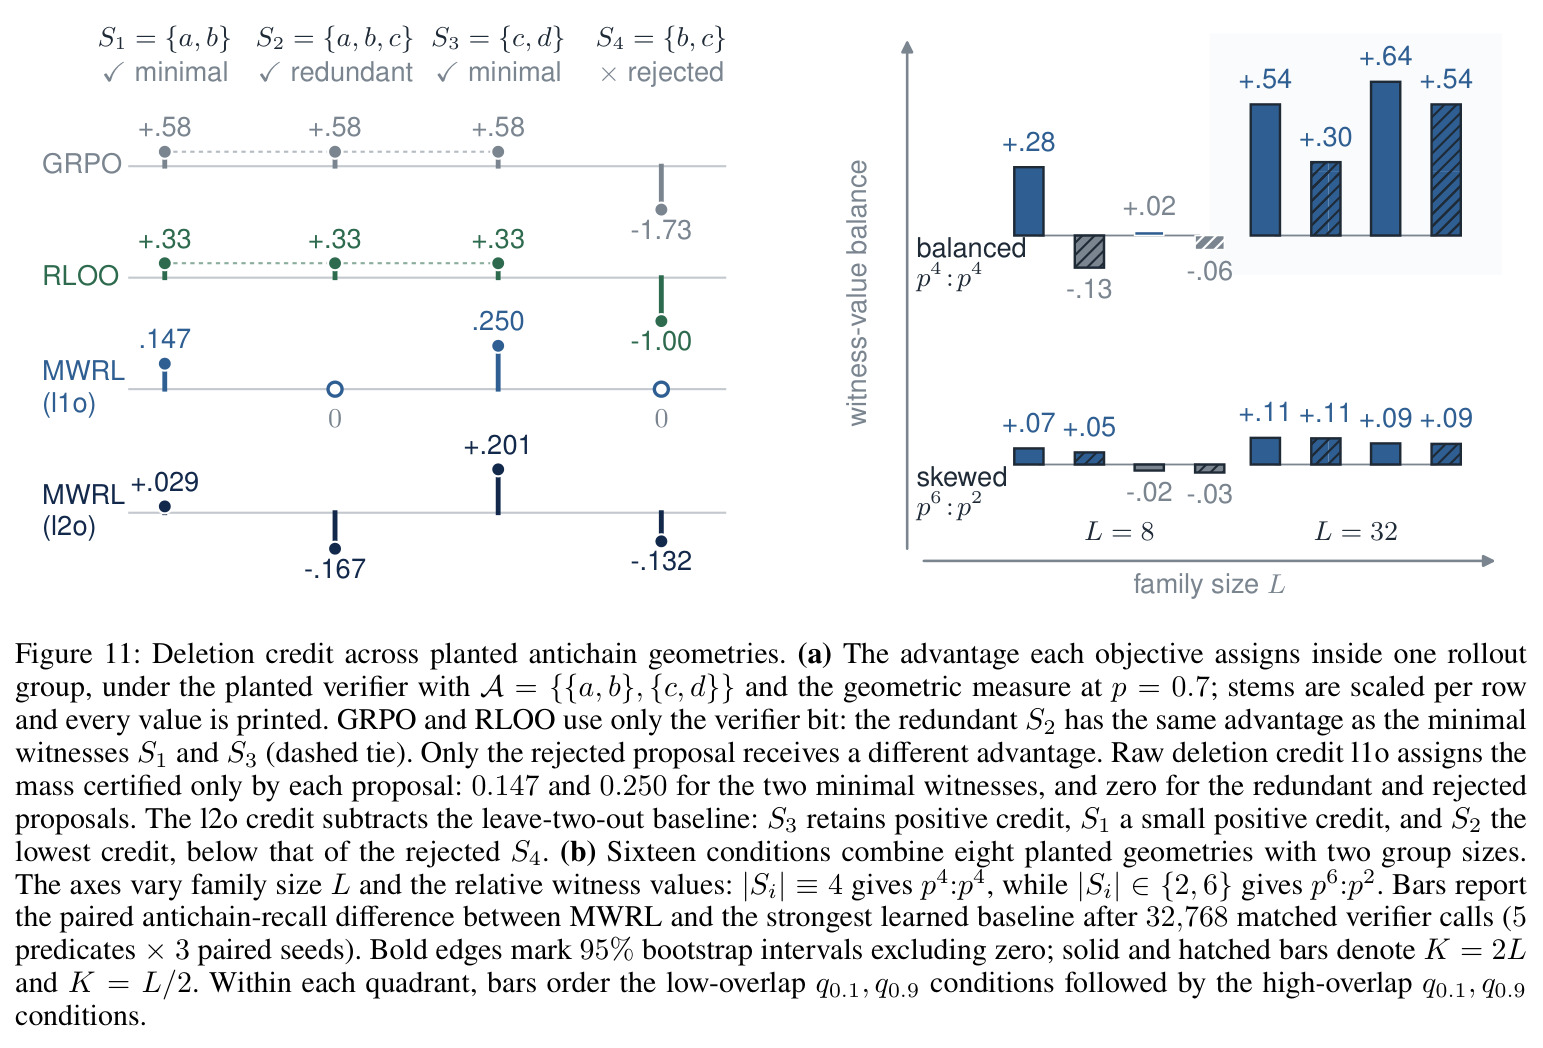
核心创新是“关系型信用分配”:把提案的价值定义为其对组证书区域的边际贡献,而非提案自身的任何函数。与已有方法的本质区别由三个定理刻画。定理 1(关系必要性):只要 $|E| \ge 3$,对任何逐样本可分离目标(PPO/GRPO/RLOO)、任何按局部奖励成比例采样的律(MaxEnt RL/GFlowNet)、任何只通过成功概率依赖 $q$ 的目标(MaxRL/pass@k),都存在某个拥有至少两个最小见证的单调谓词,使其目标分布的支撑偏离 $\mathcal{M}(c)$——失败源于奖励本身不含该信息,而非优化不充分。定理 3 进一步证明覆盖回报不可写成任何逐提案奖励之和,这种关系性是本质且不可回避的。在覆盖度量下删除信用有精确刻画(命题 3):$A_i > 0$ 当且仅当 $y_i = 1$ 且组内没有其他成功子集包含于 $S_i$——同一个全局非最小的提案可能在一组里得正信用,在含有其精炼版本的另一组里得零信用。这样同一个标量信用同时实现两件事:沿包含链向下精炼(更小集合的见证价值 $\nu$ 更大),以及在互不可比的见证之间分配预算(不同见证的上闭集各有独占部分)。
方法步骤详情
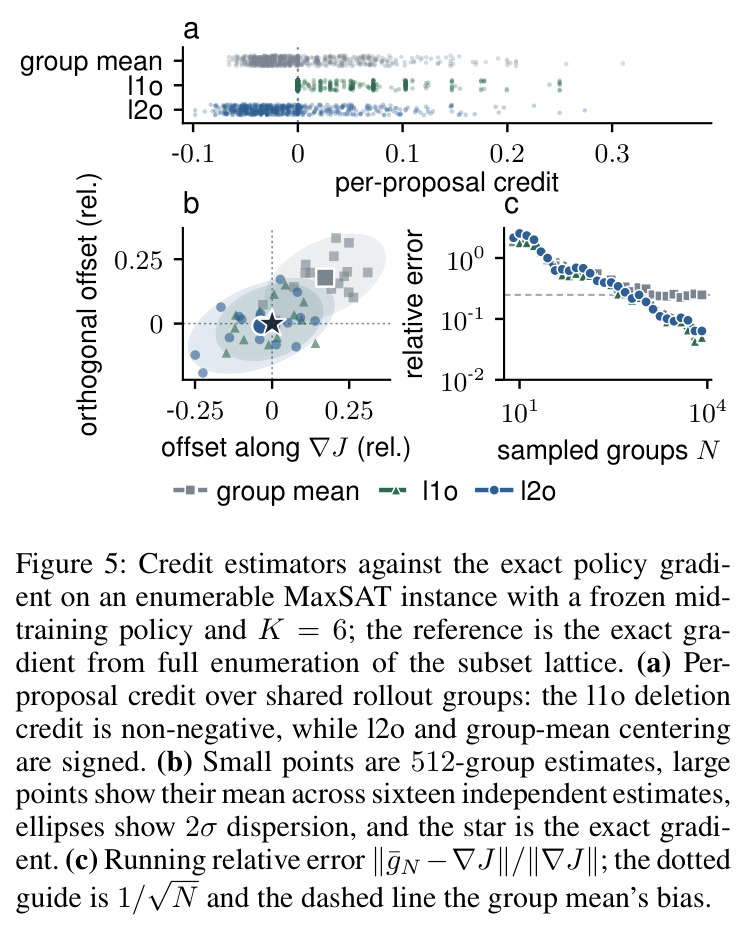
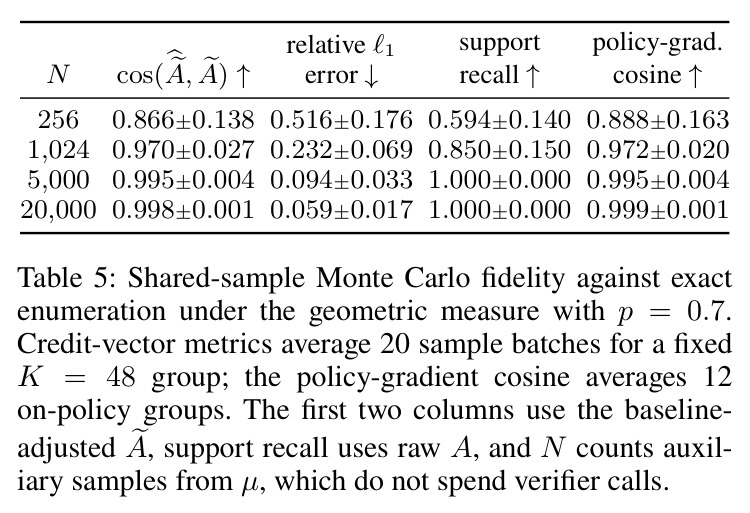
完整流程如下,输入为 ground set $E$、谓词 $s_c$、策略 $\pi_\theta$、组大小 $K$、测度 $\mu$。(1) 采样:每次更新对上下文 $c$ 独立采 $K$ 条轨迹得终端子集 $S_1,\ldots,S_K$(MaxSAT 从空集加变量,horizon 12;电路从全集删组件,horizon 等于组件数)。(2) 验证:每个终端调用一次验证器得 $y_i = s_c(S_i)$,此外不再调用。(3) 证域:$U_K = \bigcup_{j: y_j = 1} \uparrow S_j$,$U_{-i}$ 为去掉第 $i$ 条后的证域。(4) 删除信用:$A_i = R(U_K) - R(U_{-i})$;当组最小成功数超过 12 时,用共享样本蒙特卡洛替代指数级容斥:从 $\mu$ 抽 $N$ 个集合 $T^{(m)}$,$\hat{A}_i = \frac{1}{N} \sum_m \mathbf{1}[T^{(m)} \supseteq S_i] \prod_{x \in D_i} \mathbf{1}[T^{(m)} \not\supseteq x]$,单个提案开销 $O(N|D_i|)$ 且无额外验证器调用;$N = 20000$ 时信用向量与精确枚举的余弦达 0.998。(5) 基线与缩放:l2o 基线 $b_i = R(U_{-i}) - \frac{1}{K-1} \sum_{j \ne i} R(U_{-i,-j})$,$\tilde{A}_i = A_i - b_i$,再按组均值绝对值缩放。(6) 梯度上升:最大化 $J_K(\theta) = \mathbb{E}[R(U_K)]$,$\nabla_\theta J = \mathbb{E}[\sum_i \tilde{A}_i \sum_t \nabla_\theta \log \pi_\theta(a_{i,t} \mid x_{i,t})]$。可枚举小实例上用值迭代替代学习:在 $(F, b)$ 上回溯 $V_b^*(F) = \max_{s(S)=1} [\Delta R(S \mid F) + V_{b-1}^*(F \cup {\uparrow}S)]$,不固定预算执行至最大边际为零,命题 1 保证每步选中一个新的反链成员、$|\mathcal{M}(c)|$ 步收敛。部署时冻结策略采 $B$ 个提案,去重统计恢复的见证数。
技术新颖性
技术新颖性体现在四个层面。第一,问题层面:首次把“从验证器位恢复最小见证反链”形式化为可学习的 RL 目标,把强化学习从单解优化扩展到“解族学习”,并给出十余类可套用同一接口的现实设置(Table 17)。第二,理论层面:一组完整刻画——定理 1 证明三大类现有目标必然失败;定理 2 给出组值表示定理(任何忽略重复/冗余成功的对称组值必是证域函数);定理 3 证明覆盖回报本质不可分离;命题 2 刻画几何测度是唯一秩均匀精炼的测度族;定理 5 证明计数测度在有限预算 $K$ 下唯一最优分布是反链上的均匀分布 $p_m^* = 1/L$;定理 6 给出渐近恢复条件(每个见证质量 $\ge \epsilon$ 时,$K$ 组以概率 $\ge 1 - L e^{-K\epsilon}$ 含完整反链)。第三,算法层面:删除信用等价于次模覆盖函数的边际增益,共享样本蒙特卡洛把指数级容斥降为 $O(NK)$ 且不增加验证器调用;l1o/l2o 估计器的偏差分析表明组均值中心化有有限 $K$ 偏置而 l2o 无偏。第四,概念联系层面:证明几何测度下覆盖回报与多目标优化中的超体积指标(hypervolume)在子集格上等价(差一个常数),把“独占贡献”概念迁移到验证器学习场景。
实验结果
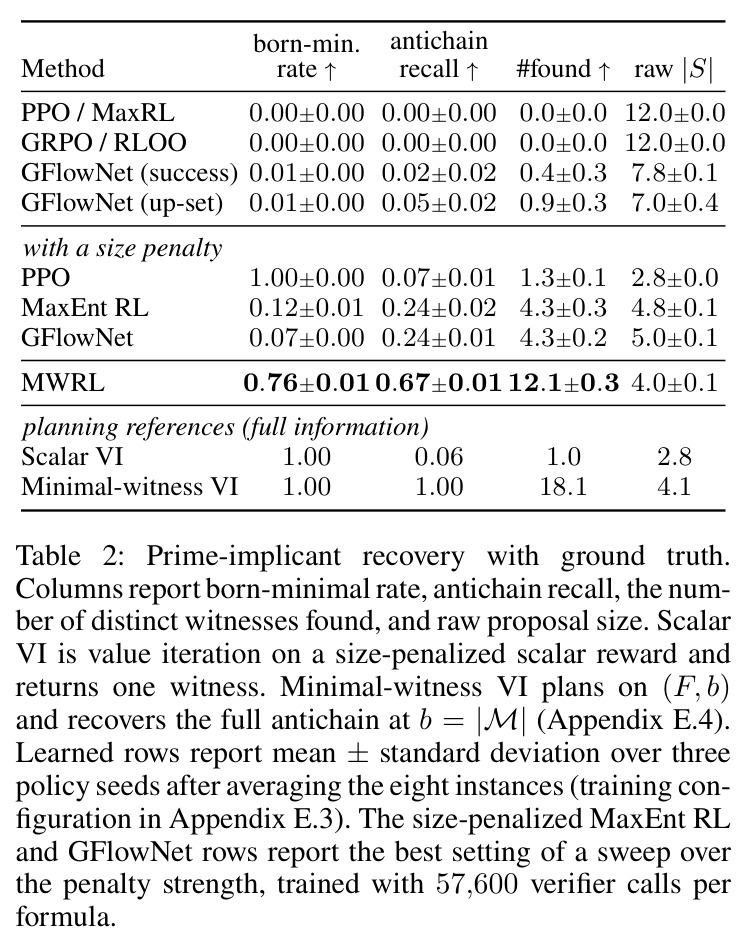
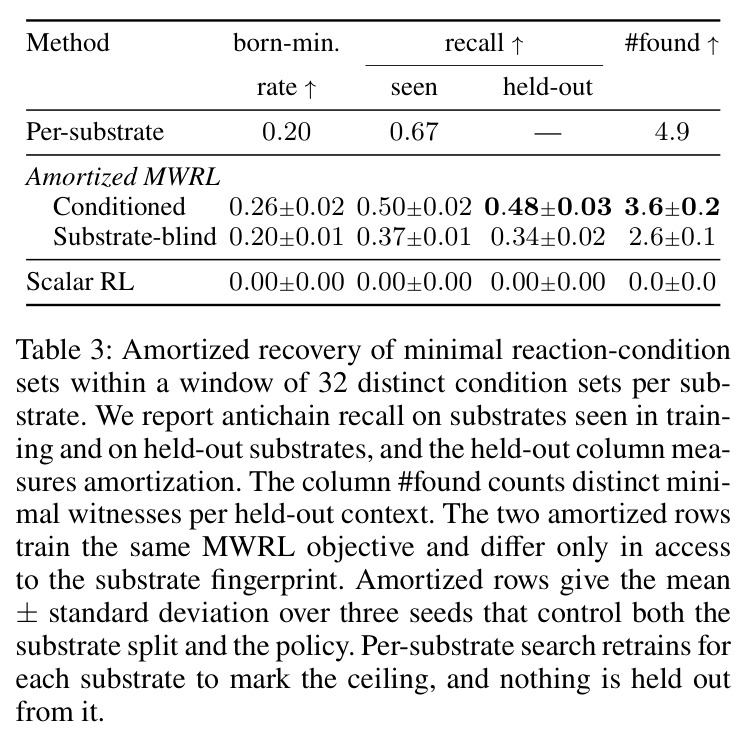
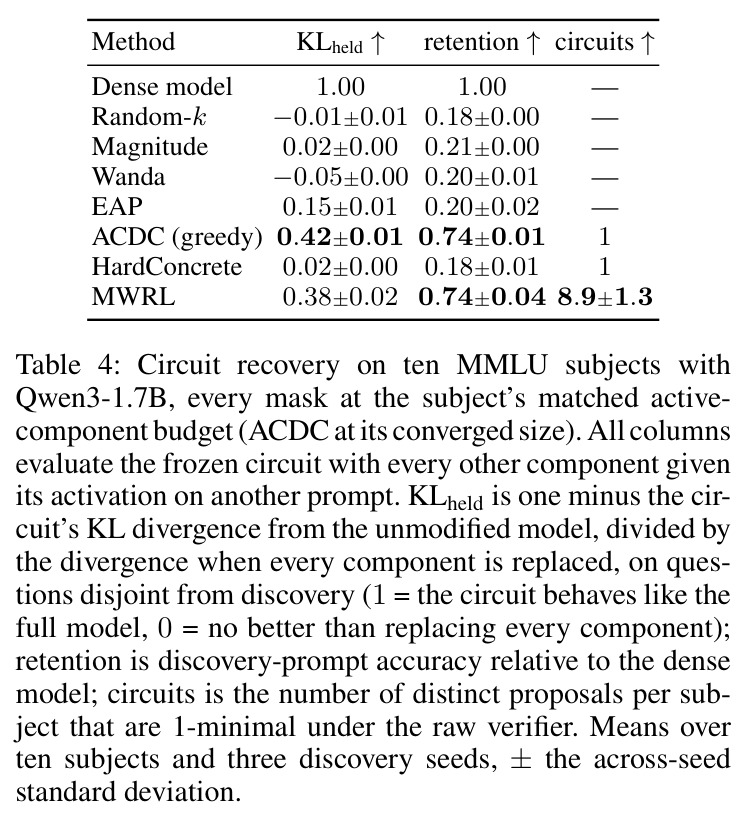
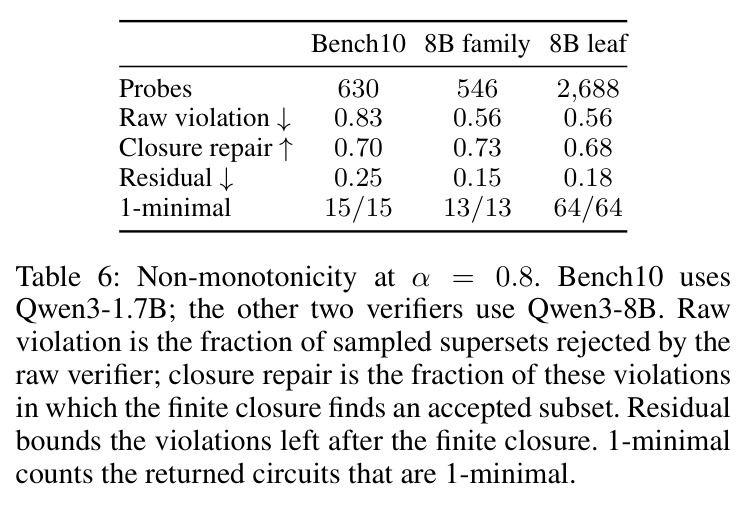
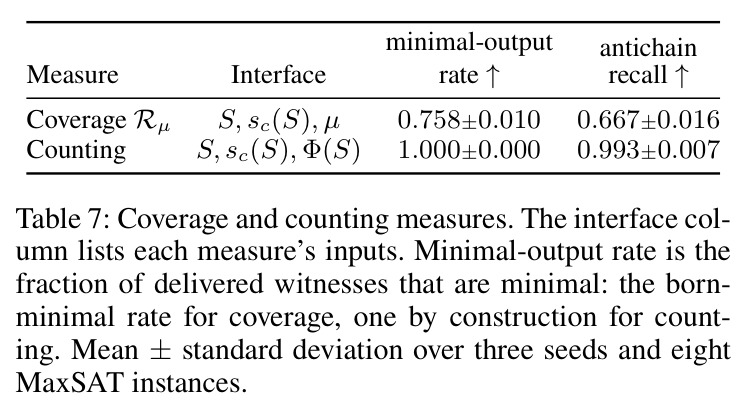
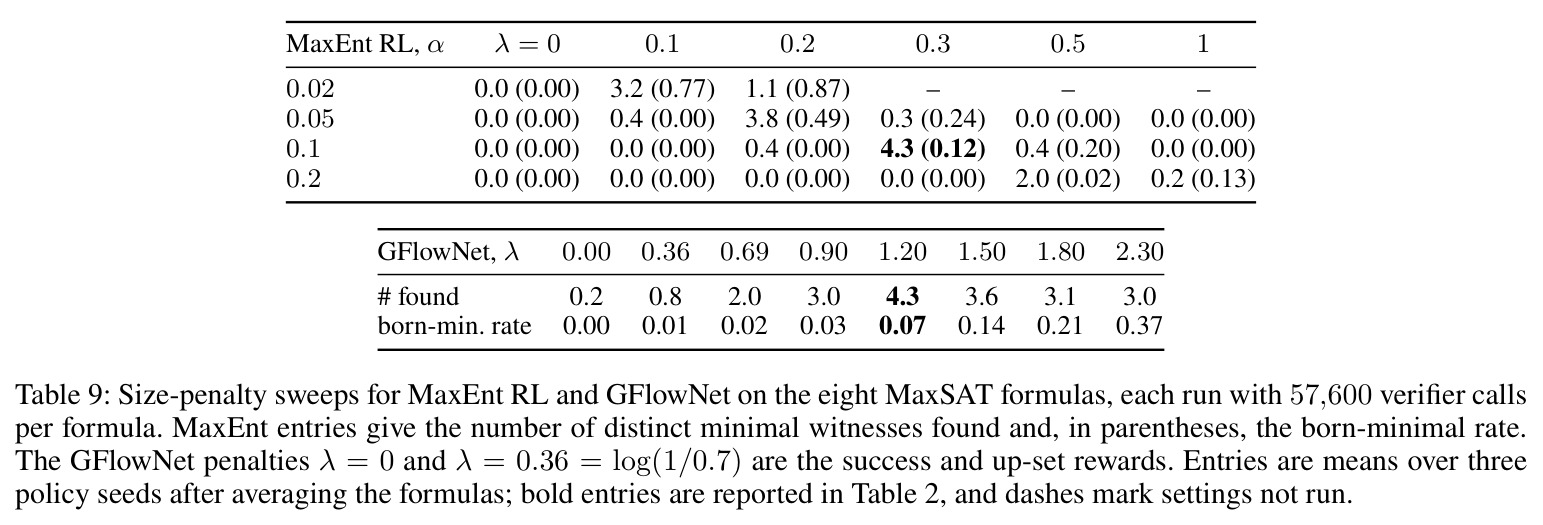
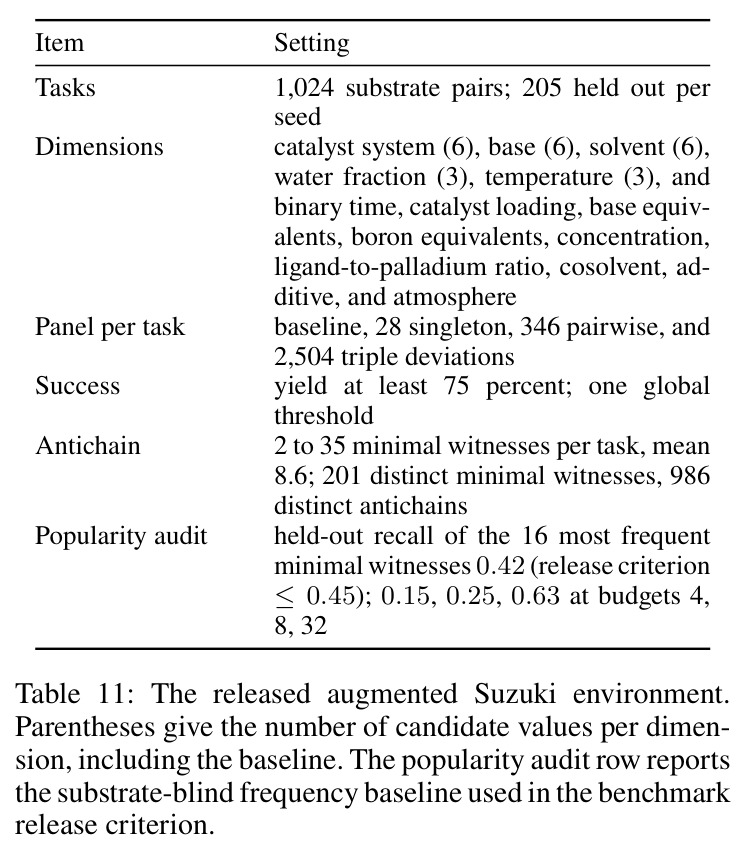
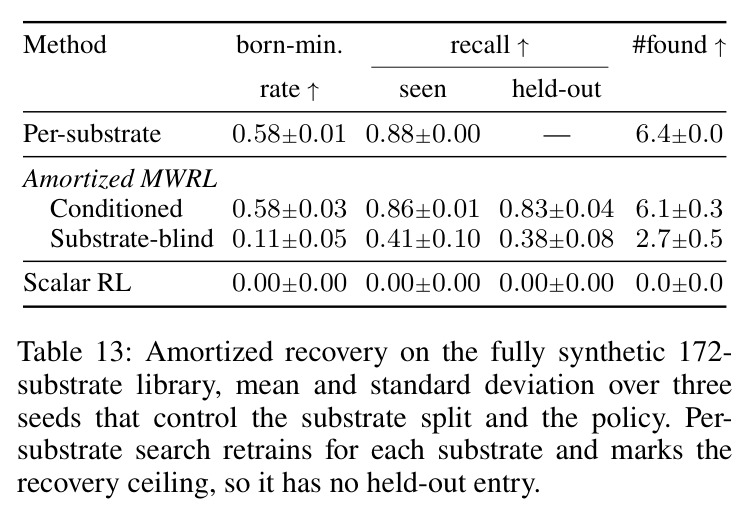
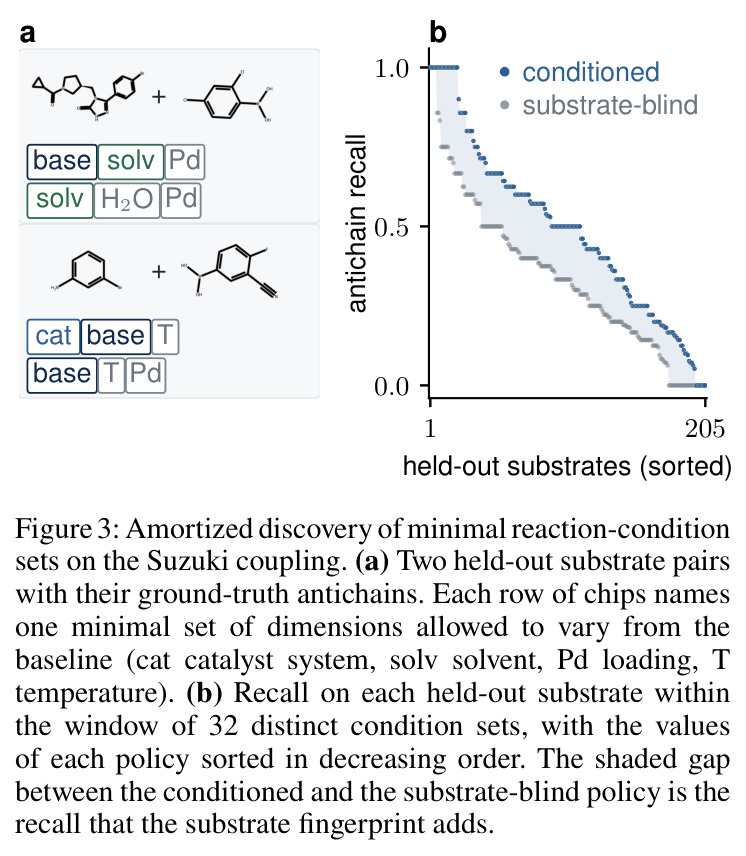
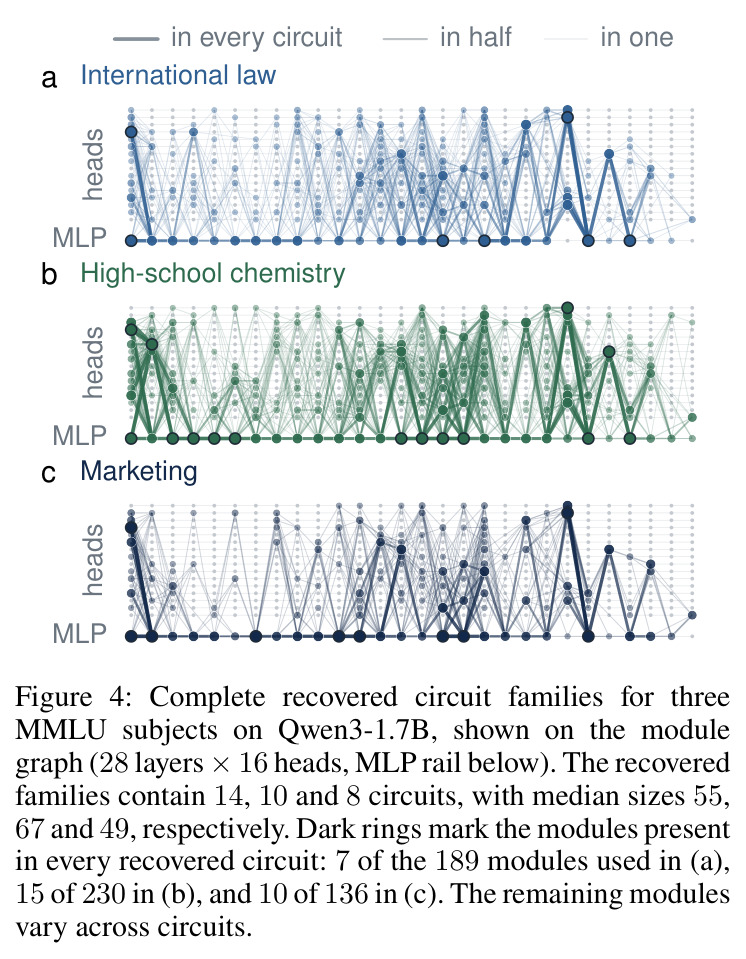
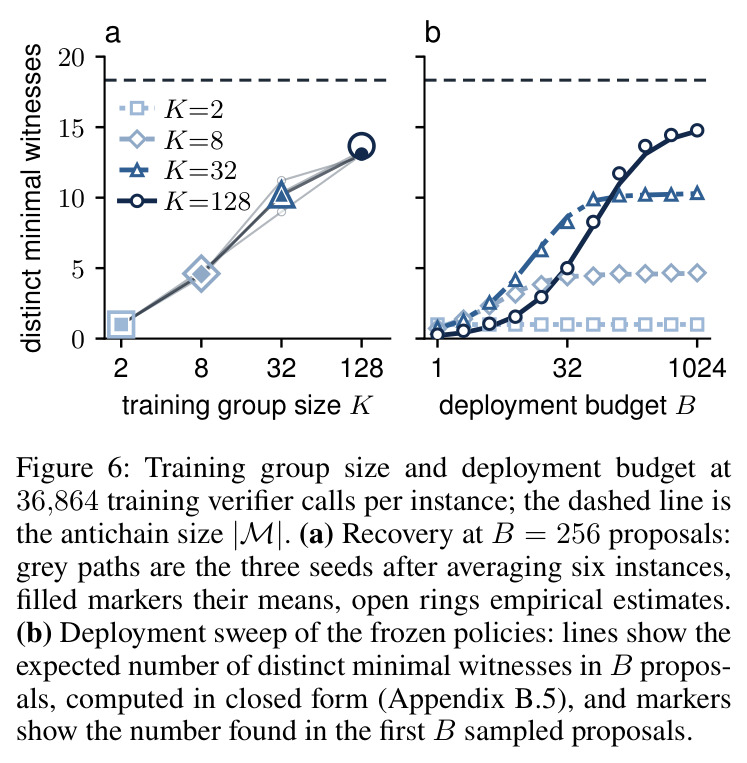
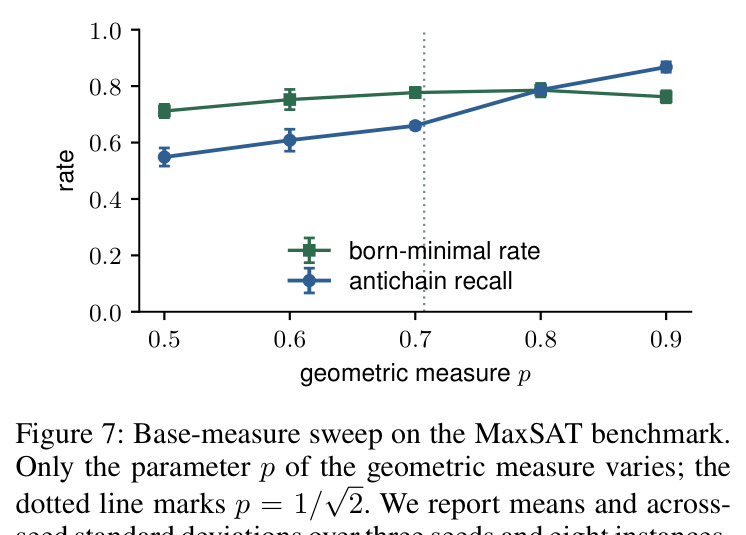
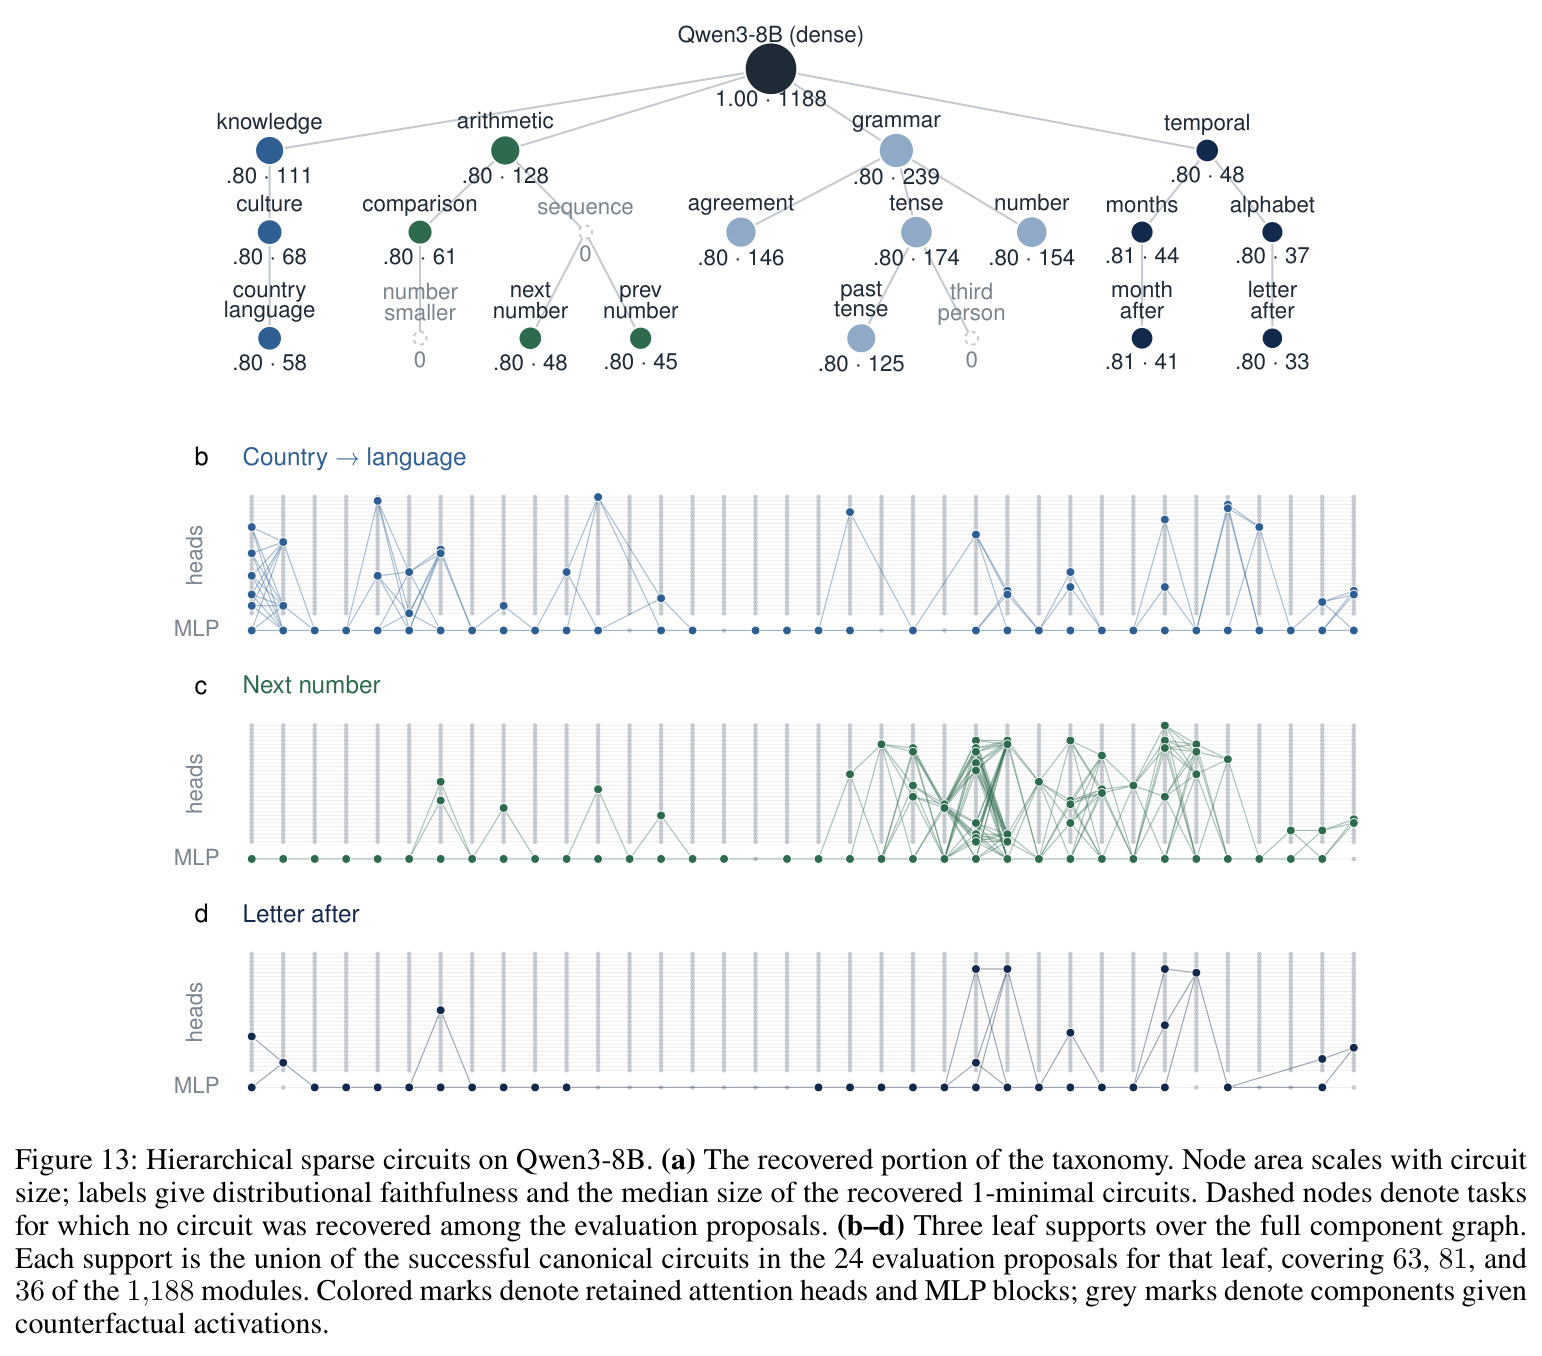
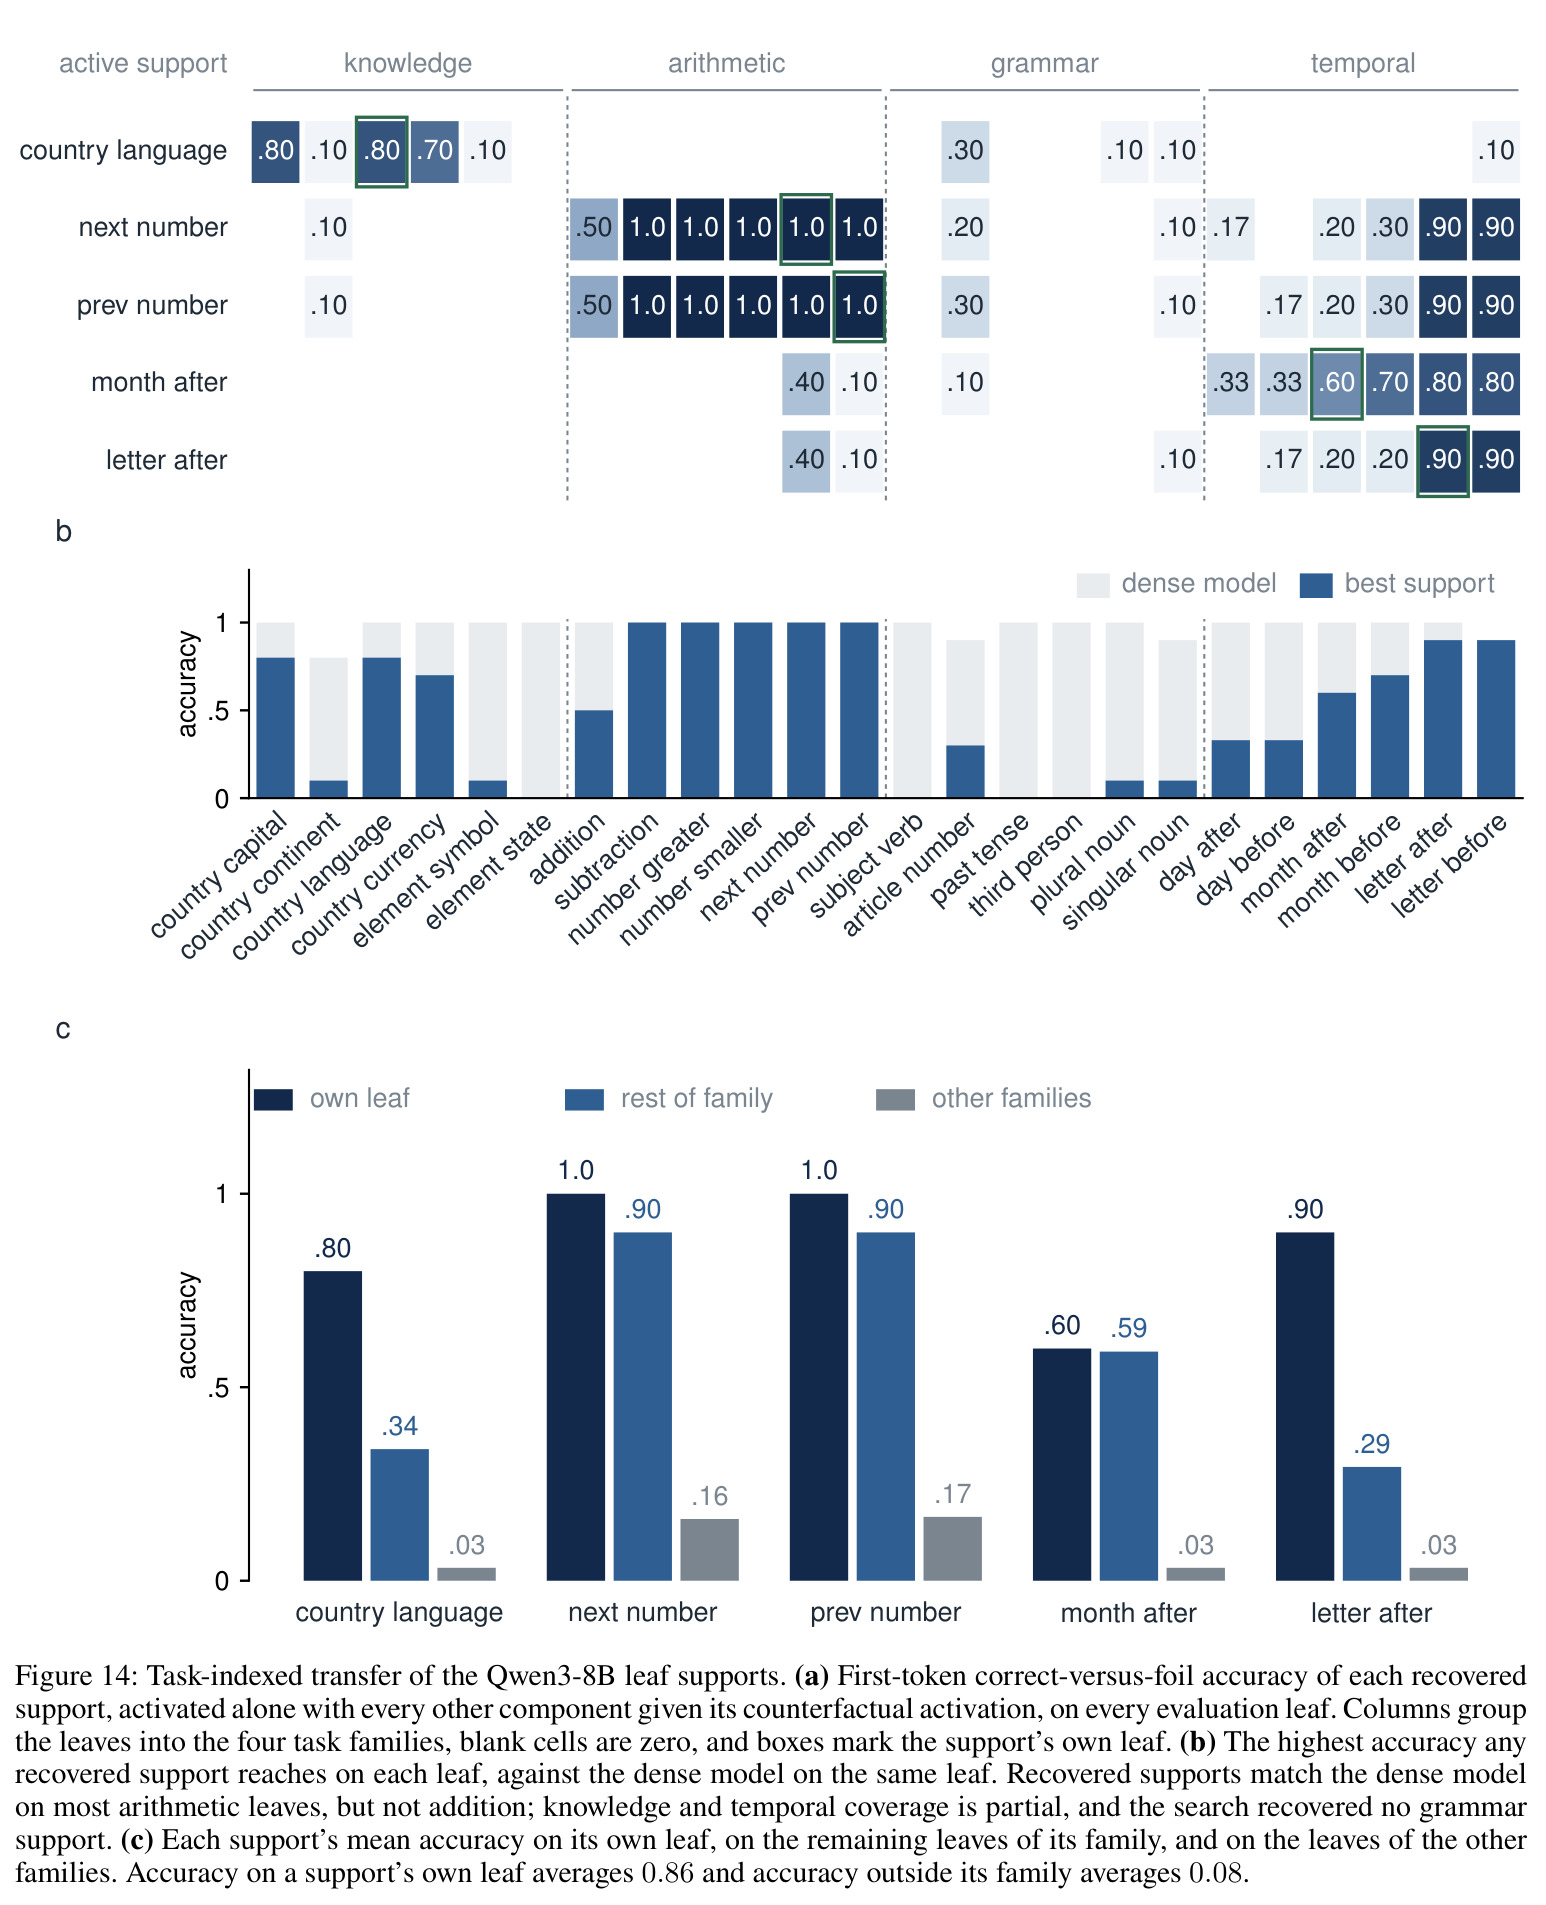
实验一(MaxSAT 素蕴含项枚举,8 个 $n=14$ 公式,每实例 16–19 个最小见证、均值 18.1):MWRL born-minimal 率 0.76±0.01、反链召回 0.67±0.01、平均找回 12.1±0.3 个见证;PPO/MaxRL、GRPO/RLOO 无惩罚基线三项全为 0(成功集合平均大小 12.0,全是冗余超集);加大小惩罚后 PPO born-min 率 1.00 但只找回 1.3 个(召回 0.07);MaxEnt RL 与 GFlowNet 在扫参后的最佳惩罚下各找回 4.3 个(约四分之一);规划参照中 minimal-witness VI 精确恢复 18.1 个、scalar VI 只恢复 1 个。实验二(Suzuki–Miyaura 变量识别,1024 个底物对、14 个条件维度、约 295 万行闭世界反应表、每种子 205 个 held-out):conditioned MWRL held-out 召回 0.48±0.03,接近逐底物单独训练的上限 0.67,显著高于 substrate-blind 消融的 0.34±0.01;scalar RL 为 0.00;在 172 底物的全合成库上 conditioned held-out 召回 0.83±0.04 匹配 per-substrate 的 0.88±0.00,blind 仅 0.38±0.08,证明指纹确实在编码“不同底物需要不同最小条件集”。实验三(Qwen3-1.7B 的 MMLU 十主题电路发现,476 个组件,验证阈值 $\alpha=0.8$):MWRL 每主题恢复 8.9±1.3 个 1-minimal 电路,$\mathrm{KL}_{\text{held}}$ 0.38±0.02、discovery retention 0.74±0.04;ACDC 忠实度相当(0.42/0.74)但每主题只输出 1 个电路;EAP/Wanda/Magnitude/HardConcrete 的 retention 只有 0.18–0.21。三个示例主题的完整电路家族含 14、10、8 个电路,中位大小 55、67、49,跨电路共享的核心模块仅 7/189、15/230、10/136。Qwen3-8B(1188 组件,4 族 12 子任务 24 叶的层级搜索)恢复出 knowledge/arithmetic/temporal 支撑而 grammar 失败;支撑在自家叶的平均 first-token 正确率 0.86,家族外仅 0.08,算术支撑可跨多数叶迁移但不覆盖加法。消融:训练组大小 $K$ 从 2 增到 128 单调提升恢复;共享样本 MC 信用 $N=5000$ 即近精确(策略梯度余弦 0.995、支持召回 1.000);基测度 $p$ 从 0.5 到 0.9,召回从 0.55 升至 0.87 而 born-min 率稳定在 0.71–0.79;单调性审计显示电路验证器确实违反单调(随机超集被拒率 0.83/0.56/0.56),但 MWRL 返回的电路 100% 通过单元素删除测试(15/15、13/13、64/64)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MaxSAT 素蕴含项枚举(8 个 n=14 单调公式,平均 18.1 个最小见证) | 反链召回 antichain recall(128 提案预算内恢复的互异最小见证比例) | MWRL 0.67±0.01(born-minimal 率 0.76,平均找回 12.1 个见证) | 最佳大小惩罚下的 MaxEnt RL 与 GFlowNet 各 0.24(4.3 个);无惩罚 PPO/GRPO 为 0.00 | 召回约 2.8 倍,多找回约 7.8 个见证;规划参照 minimal-witness VI 达 1.00(18.1 个)验证理论上限 |
| Suzuki–Miyaura 反应条件变量识别(1024 底物对,205 个 held-out,14 条件维度) | held-out 反链召回(32 个互异条件集窗口内) | conditioned MWRL 0.48±0.03(born-minimal 率 0.26) | substrate-blind 消融 0.34±0.01;scalar RL 0.00;逐底物单独训练上限 0.67 | held-out 召回比盲策略高 0.14,达到单独训练上限的约 72%,证明跨底物摊销有效 |
| 全合成 Suzuki 库摊销(172 底物,18 维条件空间) | held-out 反链召回 | conditioned MWRL 0.83±0.04(born-minimal 率 0.58±0.03) | substrate-blind 0.38±0.08;per-substrate 上限 0.88±0.00;scalar RL 0.00 | 几乎追平逐底物训练上限,是盲策略的两倍以上 |
| Qwen3-1.7B MMLU 十主题稀疏电路发现(476 组件,匹配稀疏度) | 每主题互异 1-minimal 电路数 / held-out 分布忠实度 KL_held | MWRL 8.9±1.3 个电路,KL_held 0.38±0.02,retention 0.74±0.04 | ACDC 仅 1 个电路(KL_held 0.42);EAP/Wanda/Magnitude/HardConcrete 的 retention 仅 0.18–0.21 | 在同等单电路忠实度下把输出从 1 个电路扩展为整个家族,忠实度远超排名类剪枝方法 |
局限与改进
作者承认的局限有三。第一,语言模型的原始电路验证器违反单调性:给已验证电路加随机组件后被拒率高达 0.83(1.7B Bench10)与 0.56(8B 两个验证器),存在闭包只能修复其中约 0.68–0.73,残余 0.15–0.25,因此训练只能依赖 1-minimality 这一弱保证,且确定性规范化器 Φ 在同一上闭集上不一致(约半数情形返回不同电路),计数测度在此不可靠。第二,充分性相对于验证器与探针分布:恢复的电路在 held-out 问题上重验失败(held-out 四选一准确率仅 0.21 vs 密集模型 0.64),作者明确警告更广的主张需要更广的探针分布,化学/生物部署须在目标总体上重验。第三,born-minimal 率 0.76 距 1 尚有差距;grammar 族在层级搜索中未找到任何电路(有限搜索不排除其存在)。我的补充观察:其一,覆盖度量的基测度 $\mu$ 是设计自由度,$p=0.7$ 靠与两个参照点的对数距离折中选定,在缺少自然失效概率/检索概率的领域缺乏指导,且 $\mu$ 直接决定有限预算下优先恢复哪些见证;其二,命题 4 要求组大小覆盖反链规模 $L$(概率下界 $1-Le^{-K\epsilon}$),而实验反链最大仅约 19–35 个成员,更大反链的训练开销线性增长;其三,召回率只能在可枚举实例上评估,湿实验室、数据归因等真实场景无法计算 recall;其四,LM 实验规模不超过 8B、任务是 MMLU 简单事实题,对复杂推理行为的适用性未知。
独立分析的弱点
独立分析四个弱点。一、非单调验证器下的理论缺口:当验证器以 0.56–0.83 的概率拒绝已接受集合的超集时,“一次接受等于证书整个上闭集”的解释坍塌,删除信用比较的只是原始验证位的包含关系,恢复的集合可能只是 1-minimal 而非真正最小。改进方向:训练时引入存在闭包 $s_\exists(S) = \mathbf{1}[\exists Q \subseteq S: s(Q)=1]$ 的采样修正,或学习验证器的单调代理模型并对残余违反率给出置信界。二、信用视野限于单个组:删除信用只在同一组 $K$ 个样本间比较,跨更新没有记忆,发现慢且要求大 $K$。改进方向:引入持久 archive(如 MAP-Elites 式保存历史证书区域),把历史成功并入 $U$ 再计算新样本的信用,等效组大小可放大数个量级。三、验证成本:每个终端提案一次完整验证(电路验证需 $P$ 次模型前向;湿实验室对应真实实验),且失败样本的排除信息(失败排除 $\downarrow S$)完全未被目标函数利用。改进方向:对失败也建模(覆盖-排除双目标)、验证器缓存与跨上下文迁移、训练廉价代理验证器并定期用真实验证器校准。四、$\mu$ 的先验依赖:不同 $\mu$ 给出不同的恢复优先序,可能把领域无关偏置注入“解释”,论文只扫了一维参数 $p$。改进方向:报告对完整测度族的敏感性,或在多个 $\mu$ 下取恢复结果的稳健交集作为高置信见证。
未来方向
作者提出的方向:把 MWRL 部署到 Table 17 列出的领域——攻击图中防御者需要封堵全部最小攻击路径、最小权限分析需要枚举让集成测试通过的全部最小权限集、RAG/长上下文的证据最小化、训练数据归因(哪些样本子集足以诱导某行为,验证靠重训)、代谢设计(FBA 基因敲除)、联合用药与生物标志物面板;湿实验室部署时把查表验证器换成贝叶斯优化加真实实验测量;把 8B 实验的三层层级搜索推广到更深的任务分类。基于成果可延伸的方向:把删除信用作为辅助目标加进 RLVR/GRPO 训练,使 LLM 在可验证任务上学习“充分答案的反链”而非单一答案,与 pass@k 与多样性文献直接对接;在机制可解释性中把反链作为“解释的多重性”的正式对象,回应可识别性争议(Méloux et al. 2025);用 MWRL 的组值替代局部奖励训练 GFlowNet,兼得比例采样与关系信用;用领域先验(组件失效率、检索概率)设定 $\mu$ 或跨上下文元学习 $\mu$;理论上把定理 1 推广到近似单调与非平稳验证器,并研究反链规模随上下文增长的样本复杂度。
复现评估
复现条件较好。代码开源:github.com/TSUITUENYUE/MWRL。三个实验的数据与配置均有详细说明。MaxSAT 基准完全可枚举($n=14$、8 个公式、全部 $2^{14}$ 状态可遍历验证;训练配置 Table 8:每公式 57,600 次验证调用 = 150 更新 × 8 组 × $K=48$,Adam lr $3\times10^{-3}$,评估 128 提案),最容易复现。Suzuki 基准随文释放:1024 个任务、每任务 2879 行、共 2,948,096 行的闭世界反应表、33 维底物指纹、明确的发布验收标准(反链 2–80 个成员、popularity audit ≤ 0.45)与训练协议(4,800 更新,评估存储 128 rollouts 使任何预算下的指标可重算);依赖 ChemRANG 目录 commit dc0a14b 与机理模拟器,作者明确标注增强数据是“锚定真实反应的模拟输出”而非实测产率,完整重建基准生成过程比跑训练更费劲。LM 实验用公开的 Qwen3-1.7B/8B 与 MMLU:1.7B 配置为 476 组件、每主题 $K=12$、10 组 × 40 更新 = 4,800 次验证调用,单张 NVIDIA L40 即可完成,算力门槛低是明显优点;8B 层级实验需要三轮 warm-start 训练(每轮 $K=10$、3 组 × 8 更新)。难点在于工程实现:子集格 MDP、共享样本蒙特卡洛信用、激活修补验证器、以及 EAP 归因与 ACDC 等 interpretability 基线的工具链。
论文图表
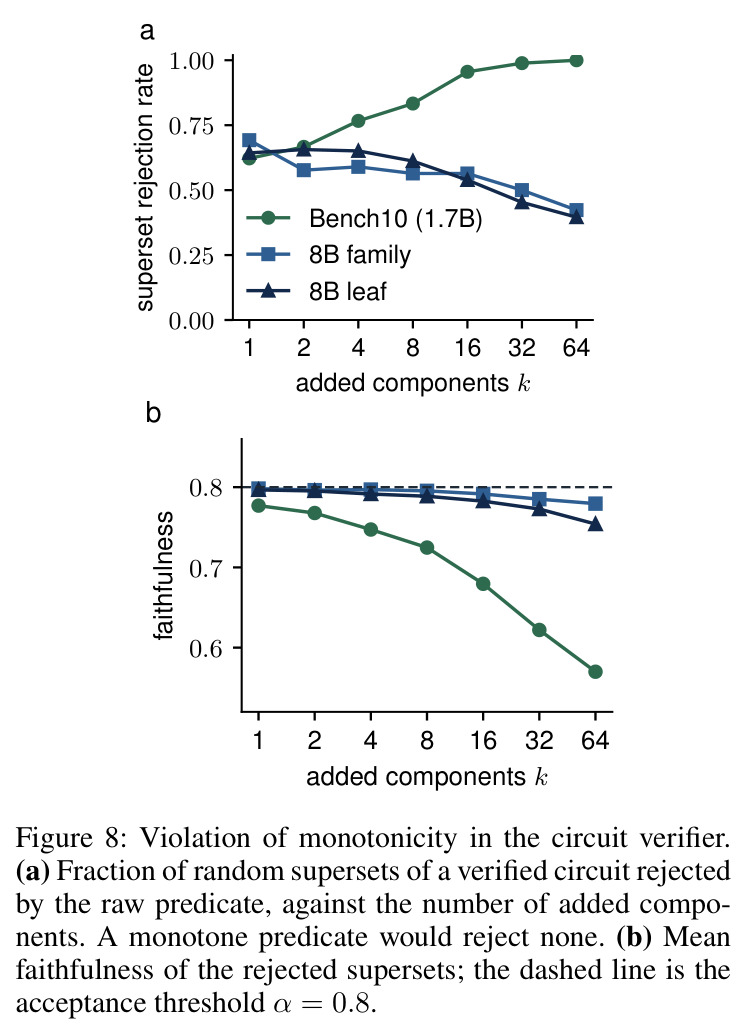
(a) 对已验证电路加入 $k$ 个随机组件后被原始验证器拒绝的比例,单调谓词应为 0,实测随 $k$ 增长(1.7B 上被拒超集的忠实度进一步低于阈值)。(b) 被拒超集的平均忠实度相对 0.8 接受阈值的分布。
定量刻画语言模型电路验证器违反单调性的程度,是理解 LM 实验只能主张 1-minimality 的依据。