优化优化器:语言模型发现更快的分子弛豫算法 Optimizing the Optimizer: Language Models Discover Faster Molecular Relaxation
LLM 智能体自动改造 Sella 优化器,DFT 弛豫省 23–60% 力调用
前置知识
分子几何优化
给定初始原子坐标,通过迭代调整构型使势能面能量降到局部极小点的过程。经典做法是准牛顿法:用力评估得到的梯度更新近似的 Hessian(曲率矩阵),在信任半径内走一步,重复直到能量、梯度与位移同时满足收敛阈值。步数越多,消耗的力评估次数越多。
本文的全部目标是减少达到收敛所需的力评估次数,只有理解优化循环与 Hessian 的角色,才能看懂智能体到底改了什么、为什么这些改动能省步数。
DFT 力评估成本
密度泛函理论(DFT)中每一步优化都要解 Kohn-Sham 方程并计算解析梯度,一次力评估的墙钟时间远超优化算法本身的开销,因此几何优化的实际成本近似等于力评估次数乘以单次 DFT 计算费用。r2SCAN-3c 是一种高性价比的复合 DFT 泛函,本文用 ORCA 在该级别做最终验证。
论文以力调用次数为唯一优化目标,并声称在 DFT 上省 23–60% 力调用即等比省钱,这是所有实验指标的现实意义所在。
GFN2-xTB
Grimme 组开发的半经验紧束缚量子化学方法,带多极静电与密度依赖色散修正,力的精度足以指导优化但成本比 DFT 低几个数量级,常用于高通量筛选。本文全部进化搜索都在 GFN2-xTB 上进行,把它当作'廉价替代势'。
整个自主动研究循环的评测都基于 xTB,候选改进能否迁移到搜索时从未见过的 DFT 势是论文最关键的科学验证,也是'便宜势上搜索'这一范式的成立前提。
内坐标与模型 Hessian
用键长、键角、二面角等几何内变量而非笛卡尔坐标描述分子,可大幅减少优化步数;模型 Hessian 则按化学规则(Badger 规则、Fischer–Almlöf 模型等)给每类坐标赋初始刚度。本文实测:仅换坐标系成本差 4.4 倍,仅换初始 Hessian 差 4.0 倍。
智能体接受的最大改进恰好集中在模型 Hessian 与坐标(消融移除代价 +18.7 个百分点),不理解这两个概念就无法理解进化发现的物理含义。
自主动研究(autoresearch)
Karpathy 提出的极简自动科研循环:固定基准、限制智能体只能改一个文件、每次实验限时、按测量结果机械地决定保留或丢弃。前驱包括 FunSearch/AlphaEvolve(LLM 进化程序)与 AI Scientist 等多智能体科研系统。
本文的方法章节就是该范式在计算化学上的一个实例,Algorithm 1 及其双门控是对该范式的具体化与加固,理解原范式才能看出本文的增量。
能量恢复率与相对力调用
指标:相对力调用 $C=\frac{1}{N}\sum_i n_i/n_i^{ref}$ 衡量省步比例;能量恢复 $r_i=\frac{E_i^{start}-E_i^{final}}{E_i^{start}-E_i^{final,ref}}$ 衡量降深是否一致,平均 $\bar r$ 是门控标准。
两道准入门完全建立在这两个指标上(有效性门要求 $\bar r \ge 1$、泛化门要求验证集同样达标),所有结果表格的数值也都是这两个指标的百分比形式。
研究动机
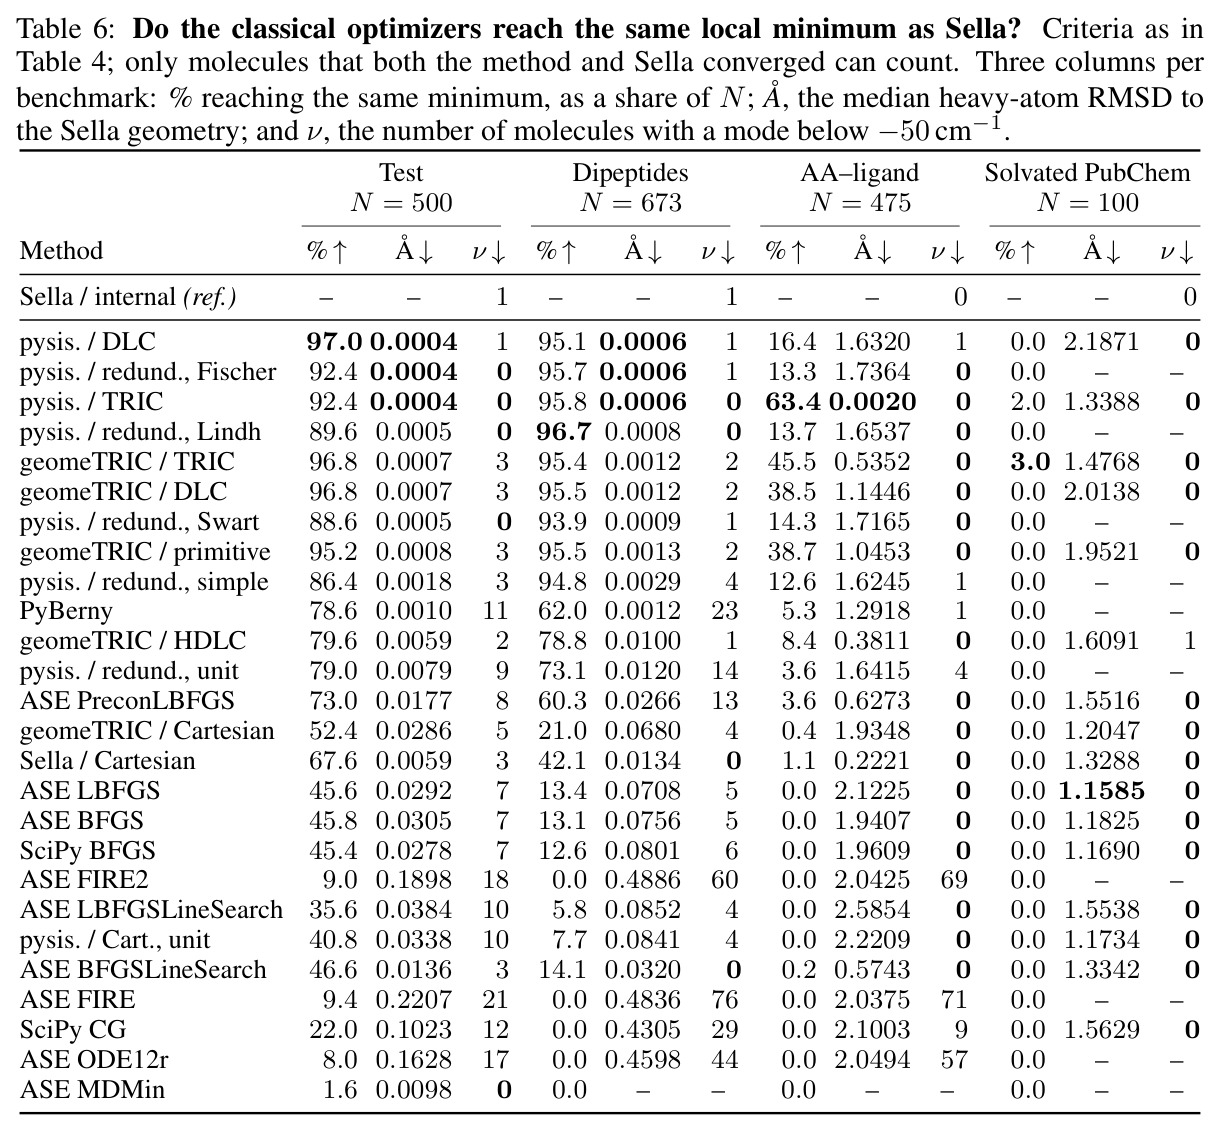
分子几何优化是计算化学中被调用最频繁的操作之一,其成本通常用所需力评估次数衡量:在廉价的力场下算法本身开销尚可忽略,但在 DFT 级别,一次力评估(解析梯度计算)主导整个弛豫的墙钟时间,优化器多走一步就多付一步的钱。数十年手工设计——从准牛顿更新、有理函数步、冗余内坐标到模型 Hessian 与 TRIC 平移旋转坐标——已把算法推到相当高的水准;作者在统一协议(同一收敛判据、同 xTB 后端、禁用各家自带停止条件)下测试 6 个开源包共 27 种配置,发现 Sella 2.5.0 在全部四个基准上力调用最少。但手工改进已接近收益递减:单片段分子上配置良好的 pysisyphus 只需 Sella 的 105.4%;而同一程序里仅把坐标系从 TRIC 换成 Cartesian 成本就涨 4.4 倍、仅把模型 Hessian 换成单位阵涨 4.0 倍,说明设计空间仍然很大,只是人工逐一试错的成本太高。
本文的目标是本文的目标是检验'自主动研究'(autoresearch)范式能否在计算化学的核心组件上做出真实改进:让 LLM 智能体直接改写优化器源码,以最少力调用数达到与参考相同的收敛判据和相同或更深的能量下降。具体约束有三:第一,DFT 弛豫太贵,无法评估成百上千个候选,搜索必须在廉价的 GFN2-xTB 半经验势上进行,之后再验证改进能否迁移到搜索时从未见过的 GFN-FF 力场和 r2SCAN-3c DFT 泛函;第二,候选优化器必须泛化到训练中未见过的分子,包括全新的化学域(673 个二肽、475 个氨基酸-配体对、100 个溶剂化体系);第三,必须防止优化器靠'提前停止、欠弛豫'来作弊省力调用。最终产出是在 DFT 层面可实际使用、显著快于最强开源优化器 Sella 的新算法家族 AutoSella。
与已有工作不同的是,本文的独特之处在于三点的组合。其一,进化对象不是启发式的自然语言描述或小函数,而是一个完整成熟的开源优化器代码库(Sella 被压缩为 5975 行的单文件 algo.py),智能体在其上做任意连贯修改,这与 FunSearch/AlphaEvolve 进化短程序、EoH/ReEvo 进化启发式描述都不同。其二,作者不进化目标本身(SAGA 的做法),而是在准入端工程化两道'门':有效性门要求平均能量恢复 $\bar r \ge 1$ 且零评测错误,堵死'少走步、欠收敛'的奖励劫持;泛化门要求同样的改进在未见验证集上复现,堵死对训练分子的过拟合。其三,用便宜替代势搜索、在 DFT 上验证迁移,并且用三个前沿模型(Claude Fable 5.1、GPT-6 Astra、Grok 4.6)在相同设置下独立重复实验,首次给出了'自主动研究产出强烈依赖模型能力'的直接对照证据。
核心方法
论文把'设计更好的优化器'改写成机器可判定的搜索问题:智能体只许编辑一个文件 algo.py,评测器不可触碰,返回候选的相对力调用成本与能量恢复,门控规则机械决定保留或丢弃。技术路线:先用 sys.settrace 追踪 Sella 2.5.0 的实际执行路径(9136 行中仅 1418 行、131 个函数被最小化路径触及),压缩为 5975 行单文件种子;训练/验证集取自 SPICE 2.0.1(469/465 个结构,含 PubChem 药物类分子、DES370K 二聚体与 25 个已注册药物),收敛判据为 geomeTRIC 式五条件测试(如 $|\Delta E|<10^{-6}\,E_h$、$\max|g|<4.5\times10^{-4}\,E_h/a_0$),力调用上限 200(溶剂化 500)。两轮各 66 活跃研究小时的独立运行分别由 Claude Code + Fable 5.1 与 Codex CLI + GPT-6 Astra 驱动,远程评测池含 192 个 CPU worker,单个候选全训练集评测仅需 60–90 秒。
核心创新是'双门准入'的自主动研究循环设计。优化器有一个天然漏洞:让力调用变少的最简单办法是提前停止、欠弛豫,因此单纯最小化 $C_{per-mol}$ 会被奖励劫持。本文的第一道有效性门要求候选在训练集上平均能量恢复 $\bar r_t \ge 1$(即平均至少降到与参考相同深度)且没有任何评测错误,未达标立即丢弃;第二道泛化门要求通过训练门的候选在 465 个未见验证分子上同样满足 $\bar r_{t,V} \ge 1$ 且成本低于当前冠军减去显著性阈值 $\delta = 10^{-4}$(防止数值噪声计入进展),否则该机制被记录为'不泛化'。与既有工作的本质区别在于:目标函数固定且不可被智能体触碰,防护逻辑全部放在接受/拒绝规则里;同时禁止分子特异识别(不许按 SMILES、分子式或图特征写特判),保证改进是算法级的。每轮只接受'一个连贯假设'的编辑,配以逐分子诊断数据和失败机制台账,使搜索成为有化学依据的假设检验而非随机变异。
方法步骤详情
流程分五步。(1)数据准备:从 SPICE 2.0.1 按 ECFP4 指纹贪心最大化 Tanimoto 多样性选样,起点结构先经 Sella/xTB 预弛豫筛选;训练 469、验证 465,四个 held-out 测试集(500 个 OOD PubChem、673 个二肽、475 个氨基酸-配体对、100 个溶剂化体系)。(2)指标:$C_{per-mol}=\frac{1}{N}\sum_i n_i/n^{ref}_i$ 与 $r_i=(E^{start}_i-E^{final}_i)/(E^{start}_i-E^{final,ref}_i)$。(3)循环(Algorithm 1):读研究台账 → 提出一个连贯编辑并提交 → 训练评测 → 有效性门 → 验证评测 → 泛化门 → 接受为新冠军或丢弃,失败想法最多三次修复。(4)基础设施:经受限中继提交,分发到 192 个 worker,失败任务返回含 8 帧几何/力与 200 条标量记录的诊断 bundle。(5)分析:按功能块消融(Figure 3),并在 GFN-FF 与 r2SCAN-3c DFT 上验证迁移。
技术新颖性
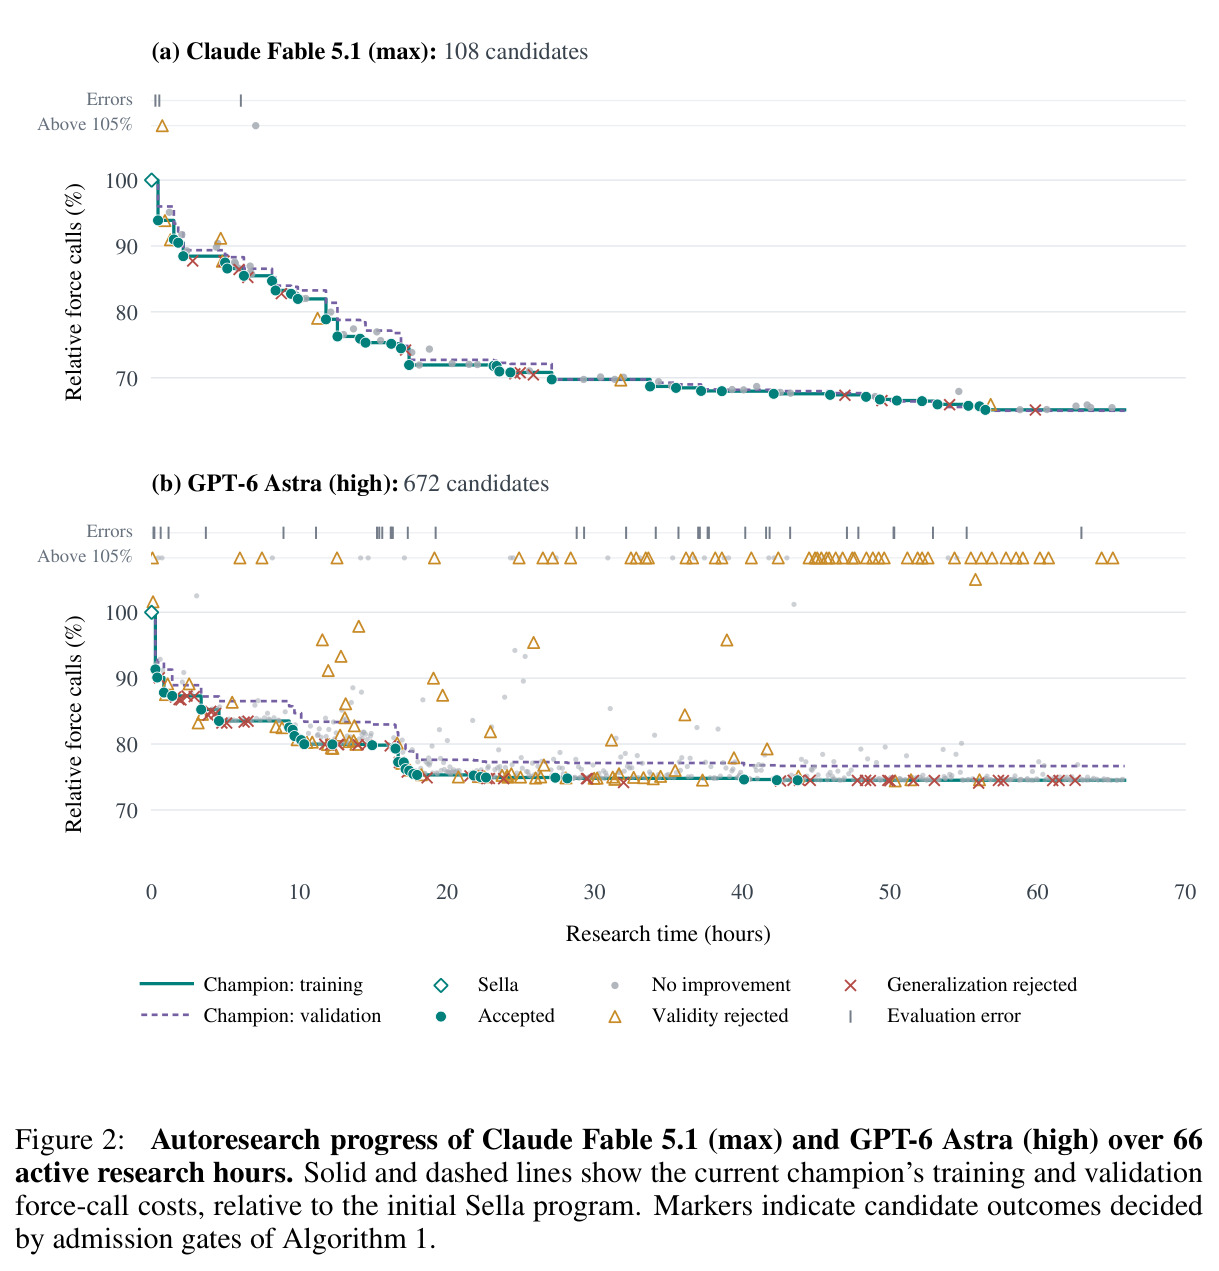
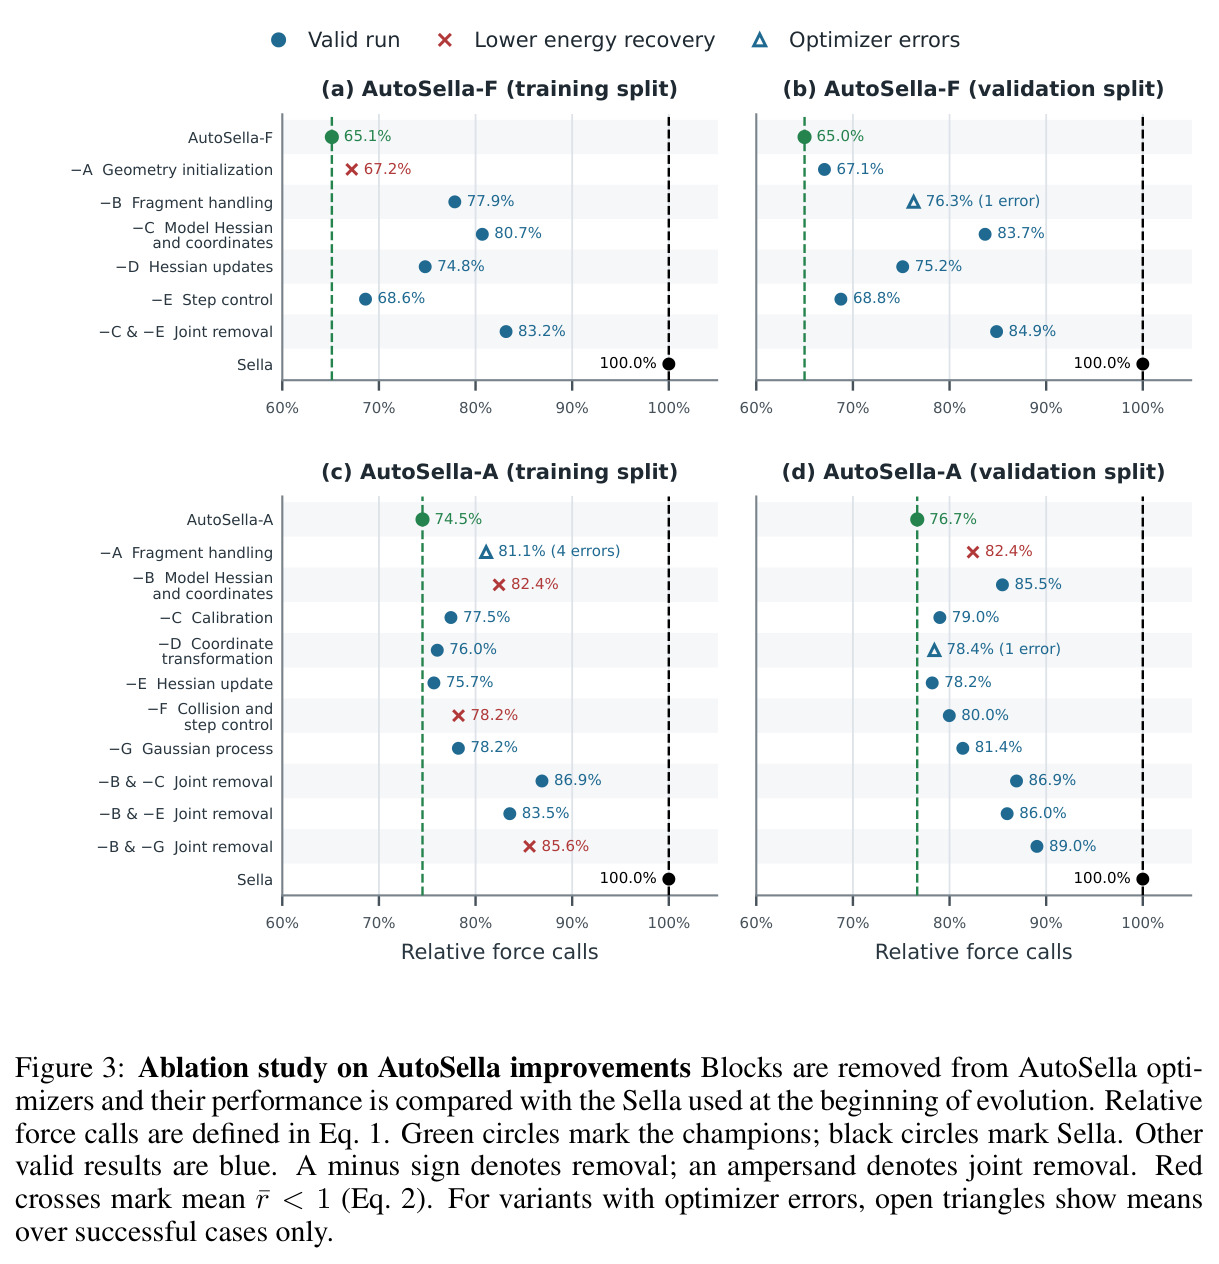
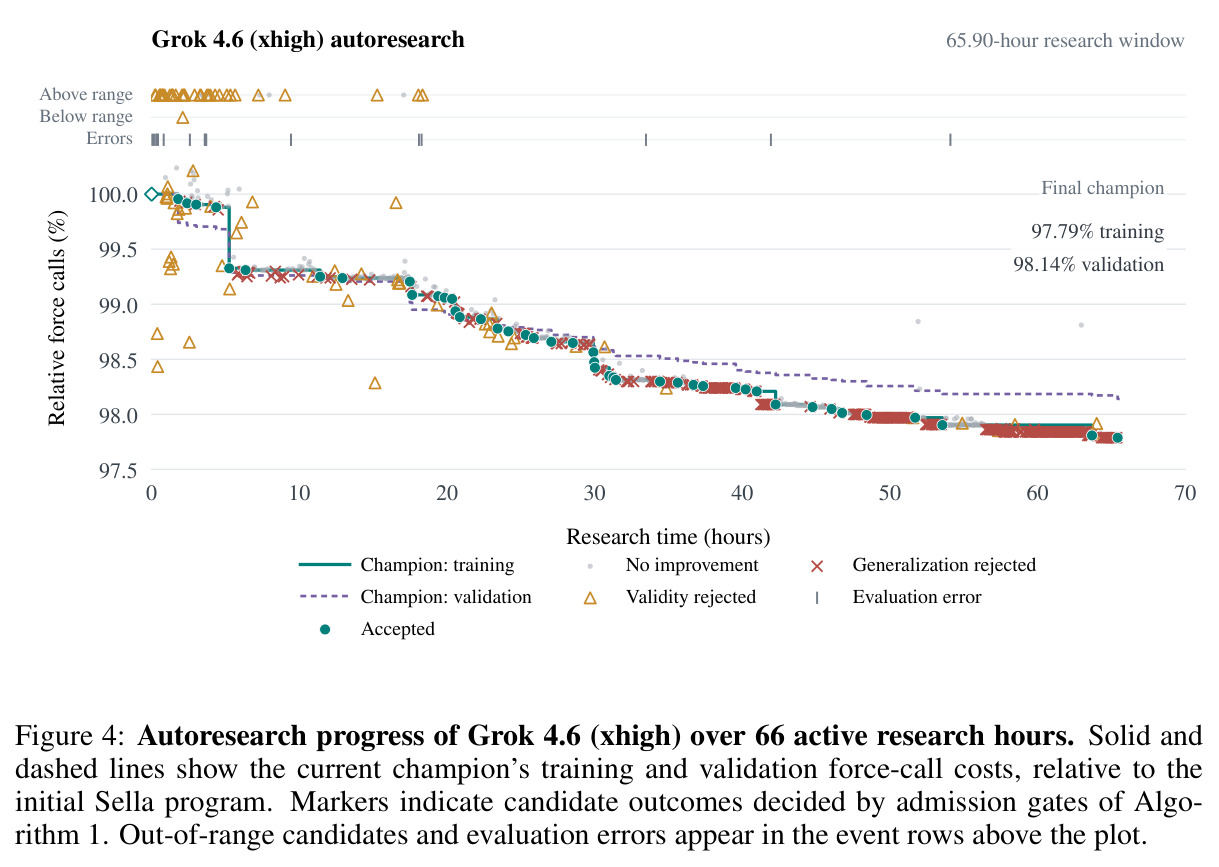
技术新颖性体现在四层。搜索对象层面:此前 LLM 进化搜索多针对数学构造(FunSearch 的装箱问题、AlphaEvolve 的矩阵乘内核)或单点启发式(产生 Lion 优化器的语法搜索),本文第一次在量子化学完整软件系统上做单轨迹 autoresearch,改动跨越坐标系、模型 Hessian、Hessian 更新、步长控制、片段处理等多个耦合子系统。防作弊层面:用能量恢复门而非修改目标来防欠弛豫,用第二数据集门防过拟合,这一'目标不可动、准入加锁'的模式比 SAGA 的外循环目标进化更简单可靠。物理机制层面:消融显示最大的两个贡献——把氢键、X–H 与芳香环接触、链上远距原子等非共价接触的刚度纳入模型 Hessian(移除代价 18.7 个百分点)和显式片段处理(11.3 个百分点)——是知识增强型改进,说明 LLM 能把化学直觉注入数值算法。模型对照层面:同设置下 Grok 4.6(900 候选仅 44 接受)只把成本降到 97.79%,而 Fable/Astra 达到 64.99%/76.66%(验证集),给出了自主动研究强烈依赖前沿模型能力的定量证据。
实验结果
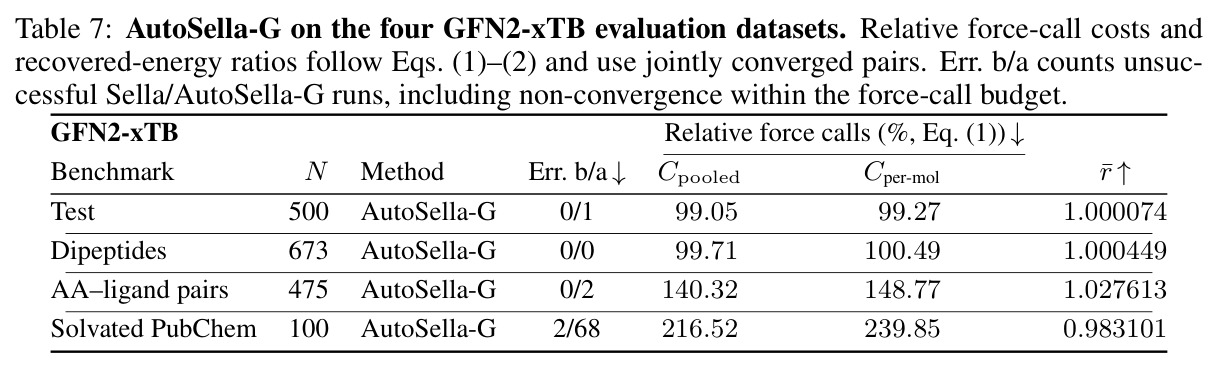
(1)GFN2-xTB(Table 1):AutoSella-F 每分子力调用仅为 Sella 的 73.25%/65.28%/69.79%/39.86%(Test/Dipep./AA–lig./Solv.),$\bar r$ 均 $>1$;AutoSella-A 相应为 80.94%/78.14%/92.57%,溶剂化回归到 118.77%。(2)跨势迁移(Table 2):搜索未用 DFT 梯度,r2SCAN-3c 上 F 只需 Sella 的 77.20%/73.14%/68.61%/40.24%,40.2–77.2%,$\bar r>1$;GFN-FF 上溶剂化降至 34.08%。(3)研究行为(Figure 2):Fable 108 候选接受 37 个(错 2.8%),Astra 672 候选接受 29 个(错 5.2%),验证集成本 64.99% vs 76.66%。(4)消融:对 F 贡献最大的是模型 Hessian 与坐标(+18.7 点)、片段处理(+11.3)、Hessian 更新(+10.2);Grok 4.6 对照仅 97.79%,溶剂化 239.85%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 分子几何优化 · GFN2-xTB · Test(500 个 OOD PubChem 分子) | 相对力调用 $C_{per-mol}$(Sella=100%)↓ | 73.25%(AutoSella-F,$\bar r=1.000284$) | Sella 2.5.0(100%) | 力调用减少 26.75%,能量恢复持平略升 |
| 分子几何优化 · GFN2-xTB · Dipeptides(673 个二肽) | 相对力调用 $C_{per-mol}$ ↓ | 65.28%(AutoSella-F,$\bar r=1.001613$) | Sella 2.5.0(100%) | 减少 34.72%,跨化学域泛化成功 |
| 分子几何优化 · GFN2-xTB · 氨基酸-配体对(475 个体系) | 相对力调用 $C_{per-mol}$ ↓ | 69.79%(AutoSella-F,$\bar r=1.024184$) | Sella 2.5.0(100%) | 减少 30.21%,且平均降到更低能量 |
| 分子几何优化 · GFN2-xTB · Solvated PubChem(100 个溶剂化体系) | 相对力调用 $C_{per-mol}$ ↓ | 39.86%(AutoSella-F,$\bar r=1.014870$) | Sella 2.5.0(100%) | 减少 60.14%,多片段复杂体系收益最大 |
| 分子几何优化 · r2SCAN-3c DFT · Test(500) | 相对力调用 $C_{per-mol}$ ↓ | 77.20%(AutoSella-F,$\bar r=1.000259$) | Sella 2.5.0(100%) | DFT 上减少 22.8%,而搜索从未使用过 DFT 梯度 |
| 分子几何优化 · r2SCAN-3c DFT · Solvated PubChem(100) | 相对力调用 $C_{per-mol}$ ↓ | 40.24%(AutoSella-F,$\bar r=1.012674$) | Sella 2.5.0(100%) | DFT 上减少 59.76%,为最大单项节省且能量恢复更高 |
| 分子几何优化 · GFN-FF 力场 · Solvated PubChem(100) | 相对力调用 $C_{per-mol}$ ↓ | 34.08%(AutoSella-F,$\bar r=1.012442$) | Sella 2.5.0(100%) | 减少 65.92%,第二个未见势上同样大幅迁移 |
| 开源优化器横向对比 · GFN2-xTB · Test | 相对力调用(相对 Sella)↓ | Sella 为 27 种配置中最快(最接近的 pysisyphus/DLC 为 105.4%) | geomeTRIC/Cartesian 572.2%、ASE BFGS 606.7%、ASE MDMin 935.0% | 证明以 Sella 为进化起点是合理且苛刻的选择 |
局限与改进
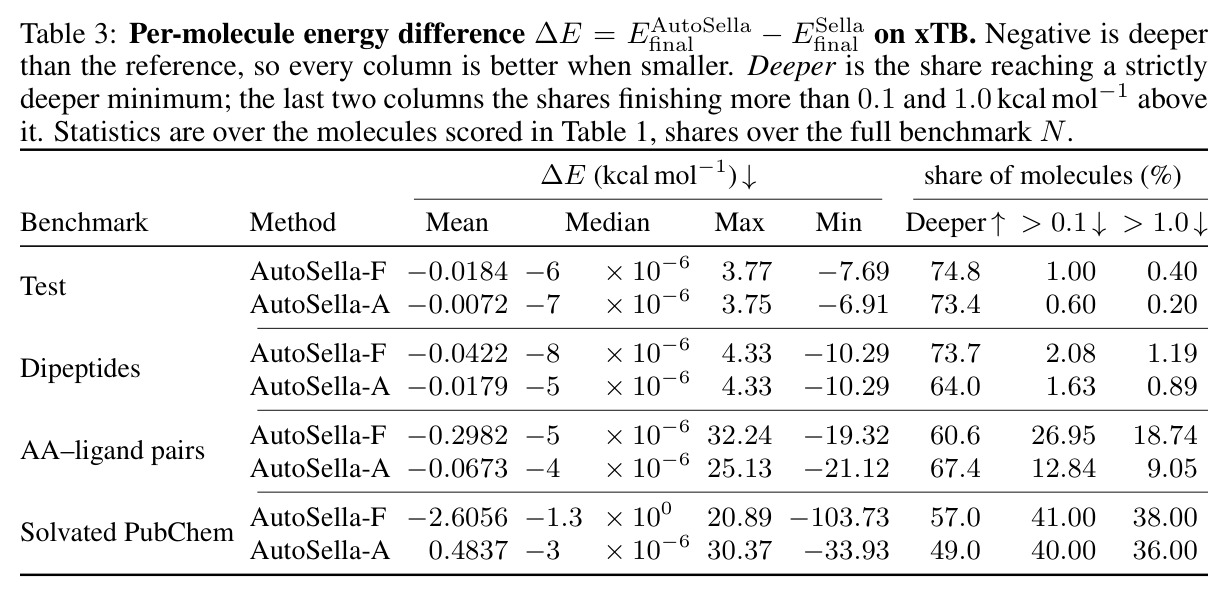
作者承认的局限:AutoSella-A 在多片段体系上不泛化(r2SCAN-3c 溶剂化 109.06% 且 $\bar r=0.993<1$);含片段体系上两个变体常停在与 Sella 不同的极小点——按 RMSD<0.1 Å、|ΔE|<0.1 kcal/mol、无低于 −50 cm⁻¹ 振动模的'同极小点'判据,F 在溶剂化体系仅 1.0%、AA–ligand 仅 39.8% 一致;能量分布还是双尾的:F 在溶剂化上有 38% 分子终点比参考高 1 kcal/mol 以上,靠 57% 更深的分子(最深 −103.7 kcal/mol)才把均值拉到 −2.61。我的补充观察:(1)训练集只有小分子与小二聚体,片段泛化差可能正是训练分布缺口,而门控只看均值能量、无结构一致性检查;(2)搜索只在 xTB 上进行,迁移只在 GFN-FF 与 r2SCAN-3c 两个 Grimme 系势上验证,未测周期体系与大体系;(3)$\bar r\ge1$ 是均值判据,不保证逐分子不劣化;(4)只覆盖能量最小化,Sella 的鞍点搜索未涉及;(5)对力评估便宜的 MLIP 或高并行场景收益打折。
独立分析的弱点
独立弱点分析:(1)均值门控对尾部风险不敏感——溶剂化体系上 F 有 38% 分子终点能量高 1 kcal/mol 以上,对需要唯一低能构象的下游应用(能垒、结合能)是隐患;改进方向是把逐分子分位数(如 95 分位劣化 ≤0.5 kcal/mol)纳入有效性门。(2)结构一致性只是事后检验而非搜索约束,'更快但去别处'在片段体系被容忍;改进方向是在训练评测中加入轻量结构检查或多起点一致性检验。(3)研究过程高度依赖专有前沿模型:Grok 4.6 几乎无进展说明弱模型无法复现,且 API 迭代、轨迹未全开源,学术复现门槛高;改进方向是开源完整研究日志、蒸馏研究策略或混合本地开源模型与传统进化算子。(4)起点制备依赖 Sella 预弛豫筛选,偏向易优化结构,可能高估稳健性;改进方向是纳入困难起点。(5)单轨迹搜索浪费好想法——被拒机制只躺在 backlog 从不组合重试;改进方向是分支重启或想法库周期性重组。
未来方向
作者提出的方向:把'廉价替代势 + 双门控'配方推广到其他科学算法的自动开发——天然候选包括过渡态/鞍点搜索、构象搜索、晶体结构松弛(Matbench Discovery、OC20 类工作流);结论还暗示可在搜索势与 DFT 之间引入机器学习势中间层。基于本文成果可延伸:(1)把泛化门从'验证分子'扩展到'验证势',搜索中交替使用多个廉价势(xTB、GFN-FF、小型 MLIP),只接受跨势有效的机制,或可消除 A 在溶剂化上的回归;(2)对两个冠军做机制交叉移植(如 F 的几何跟随 Hessian 更新 + A 的高斯过程代理步),检验进化机制的可组合性;(3)把 66 小时研究轨迹整理成'科学发现过程'数据集,研究 Fable 的'长分析-少提交'(平均 36.32 分钟/次)与 Astra 的'快迭代'(5.88 分钟)两种节奏的效率边界;(4)从理论上解释非共价接触刚度与几何跟随 Hessian 更新为何有效,反哺人工算法设计;(5)扩展到鞍点搜索与反应路径——力评估同样昂贵且 Sella 本是标准工具,绝对收益可能更大。
复现评估
复现条件总体良好。代码完全开源(github.com/vdeshchenya/autosella),含单文件化种子、挂具与评测协议;数据来自公开 SPICE 2.0.1 加 25 个 RowanSci 结构,附录 A 给出确定性选样流程;附录 B 的单文件化方法(sys.settrace 追踪出实际执行的 1418 行)与附录 C.1 的基础设施(xTB 6.7.1、ORCA 6.1.1、192 个 CPU worker、4 台 Xeon Gold 6348)描述详尽。算力门槛低:单候选全训练集评测 60–90 秒,整轮 66 小时研究用小型 CPU 集群即可承受。主要障碍在 LLM 侧:两个冠军由专有的 Claude Fable 5.1 (max) 与 GPT-6 Astra (high) 产生,66 活跃研究小时的 token 成本不菲,且模型迭代后行为不可精确复现——附录 H 的 Grok 4.6 对照直接证明弱模型无法重复该结果。不过最终产物是普通 Python 代码,可直接取用两个已进化的 algo.py 在自己的基准上评测,无需重跑搜索。
论文图表
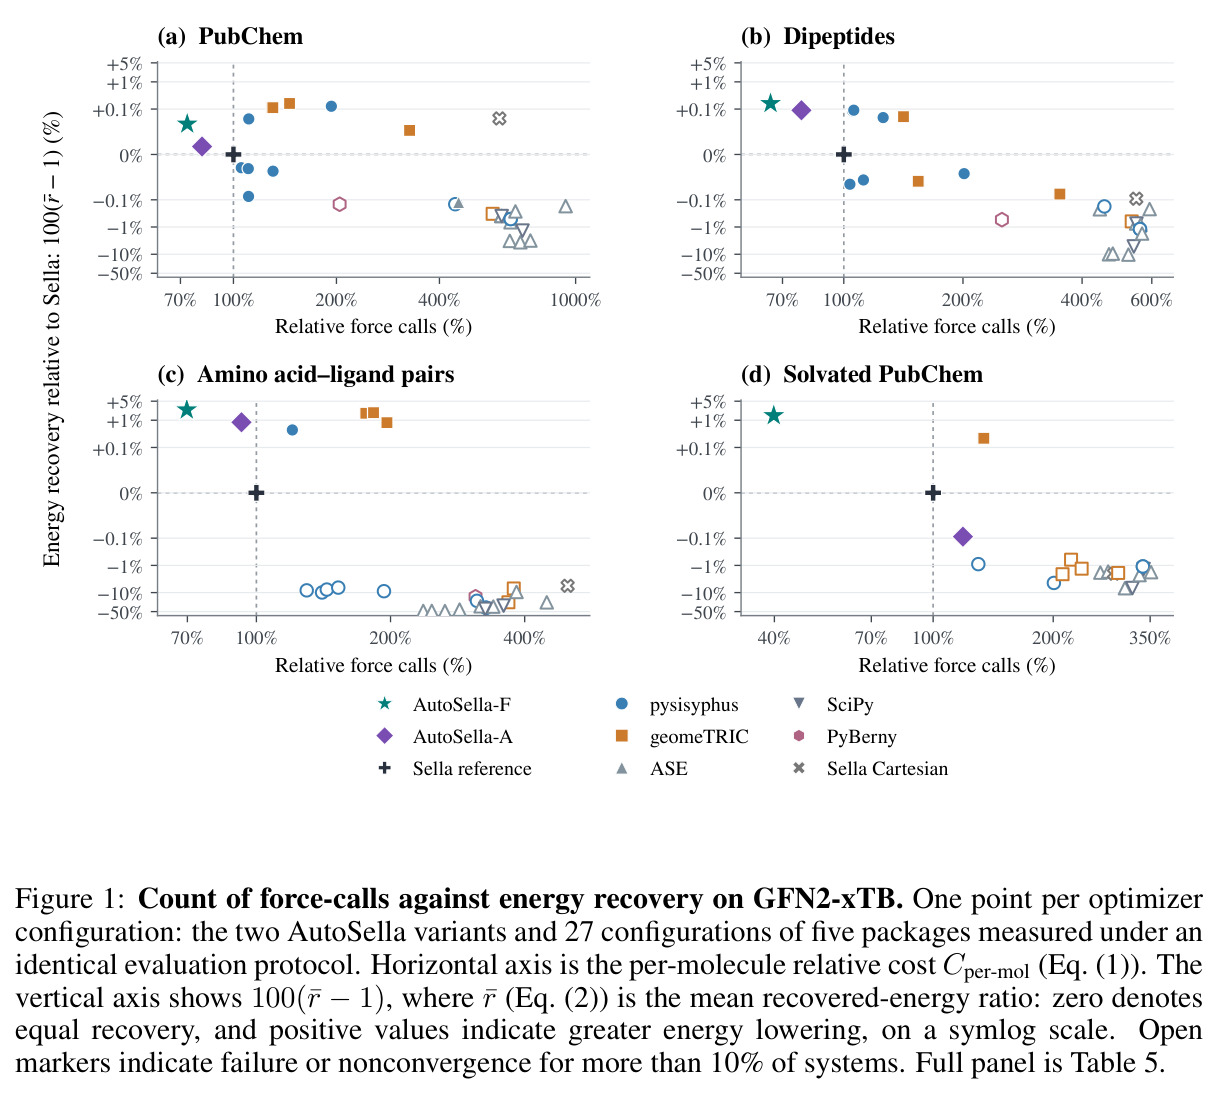
四个面板分别对应 PubChem、Dipeptides、AA–ligand、Solvated PubChem 四个基准:横轴为相对力调用 $C_{per-mol}$,纵轴为平均能量恢复偏离零的百分比(symlog 刻度);每个点代表一种优化器配置,AutoSella-F/A 位于左上方(更少力调用且能量恢复不低于参考),空心标记表示失败或不收敛超过 10% 的配置。
一图定标:既证明 Sella 2.5.0 是全部 27 个配置中最强的进化起点,又直观显示两个 AutoSella 变体在所有基准上同时左移(省力调用)且能量恢复不低于参考,是理解论文动机与结果全貌的入口。
两个 AutoSella 变体在四个 held-out 数据集上的 $C_{pooled}$、$C_{per-mol}$、$\bar r$ 与错误数:AutoSella-F 全线领先($C_{per-mol}$ 为 39.86–73.25%),$\bar r$ 全部大于 1;AutoSella-A 在前三个数据集为 78.14–92.57%,但在溶剂化体系回归到 118.77%($\bar r=0.999125$)。
主结果表:直接支撑'改进泛化到未见分子与新化学域'的核心声明,也是判断两个变体适用边界(单分子体系 vs 多片段体系)的第一手依据。
把同样的测量重复在 GFN-FF 力场与 r2SCAN-3c DFT 上:AutoSella-F 保持 34.08–77.20% 的成本且 $\bar r$ 全部大于 1(AA–ligand 上达 1.028167);AutoSella-A 在溶剂化 DFT 上需 109.06% 且 $\bar r=0.993028$,泛化失败。
论文最重磅的证据:整个搜索只用过 xTB、从未计算 DFT 梯度,节省却在 DFT 上完全兑现(摘要中的 40.2–77.2%),证明发现的机制是势无关的算法级改进,而非对替代势的过拟合。
用重原子 RMSD、|ΔE| 与数值 Hessian 振动谱三重判据检验是否到达同一极小点:单分子体系上 AutoSella-F/A 达到 97.2%/97.6%(Test)与 93.2%/95.7%(Dipeptides),中位 RMSD 仅 5–8×10⁻⁴ Å;但 AA–ligand 上降至 39.8%/69.5%,溶剂化体系仅 1.0%/18.0%;不过低一致体系的终点能量平均更低,且虚频极其罕见。
诚实地呈现方法边界:在多极小点密集的片段/溶剂化景观中,'更快'可能意味着'去了别处'。这是解读'溶剂化省 60% 力调用'时必须同时看到的另一面,也解释了作者的后续假设(水网络等替代排列)。
6 个包 27 种配置在同一协议下的全量对比:Sella 内坐标版(100%)最快,pysisyphus/DLC 最接近(Test 105.4%);geomeTRIC/Cartesian 572.2%、ASE BFGS 606.7%、SciPy BFGS 608.0%、ASE MDMin 935.0%;同一程序内换坐标系差 4.4 倍、换初始 Hessian 差 4.0 倍。
为'从 Sella 出发'的选择提供绝对标尺,也是论文关于坐标系统与初始 Hessian 各自贡献约 4 倍步数差异这一基础性结论的数据来源,方法学价值超出本文本身。
完整循环的伪代码:冠军 $a^\star$ 初始化为 vendored Sella 2.5.0;每轮智能体读取循环记录、叙事日志与已拒绝机制,提出一个连贯编辑 $a_t$;先在训练集评测,若 $\bar r_t < 1$ 或有评测错误则丢弃(有效性门),若 $C^t_{per-mol} \ge C^\star_{per-mol} - \delta$($\delta=10^{-4}$)则丢弃(无显著改进),否则进入验证集泛化门,全部通过才接受为新冠军。
方法的心脏:两道准入门如何形式化为可机械执行的接受/拒绝规则、以及'身份门控'(禁止分子特异特判)如何由智能体自查,所有后续结果都是这一循环的产物。