Prism:面向原生 2K 视频-音频联合生成模型训练的动态稀疏注意力 Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training
内容自适应动态块形状的稀疏注意力,让2K视听训练提速2.5倍且质量反超全注意力
前置知识
Rectified Flow(整流流)/ 流匹配
扩散生成的一种现代参数化。给定干净数据潜变量 $z_0$ 与噪声 $z_1 \sim \mathcal{N}(0,I)$,前向过程构造直线路径插值 $z_t=(1-t)z_0+tz_1$,网络 $\hat{v}_\theta(z_t,t)$ 学习预测速度方向 $z_1-z_0$,用均方误差 $\mathcal{L}=\mathbb{E}(\|(z_1-z_0)-\hat{v}_\theta(z_t,t)\|^2)$ 训练,推理时沿学到的速度场把纯噪声迭代搬运回数据流形。
Prism 的训练目标就是视频/音频双模态流匹配损失(式 10),理解损失形式才能明白动态稀疏注意力是如何嵌入训练过程、为何只需替换视频自注意力模块而不动其余结构的。
块稀疏注意力(Block Sparse Attention)
把 query/key 序列划分为固定形状的块,每块用平均池化得到代表向量;用块代表的点积加 softmax 估计块间相关性,每个查询块只与得分最高的少数 key 块做精细注意力,复杂度从 $O(N^2)$ 降到与稀疏比例成正比。被跳过的块完全不计算,因此实际加速与平均选中块数 $|S_i|$ 成正比。
Prism 完全建立在块稀疏注意力流程之上(继承 LongCat-Video/BSA 思路),其全部创新——动态块形状、混合 Top-k/Top-p 选择——都是对这套『平均池化代表 + 块级打分 + Top-k』管线的改造,不懂基线就看不懂改进点在哪。
双分支视频-音频 DiT 与跨模态交叉注意力
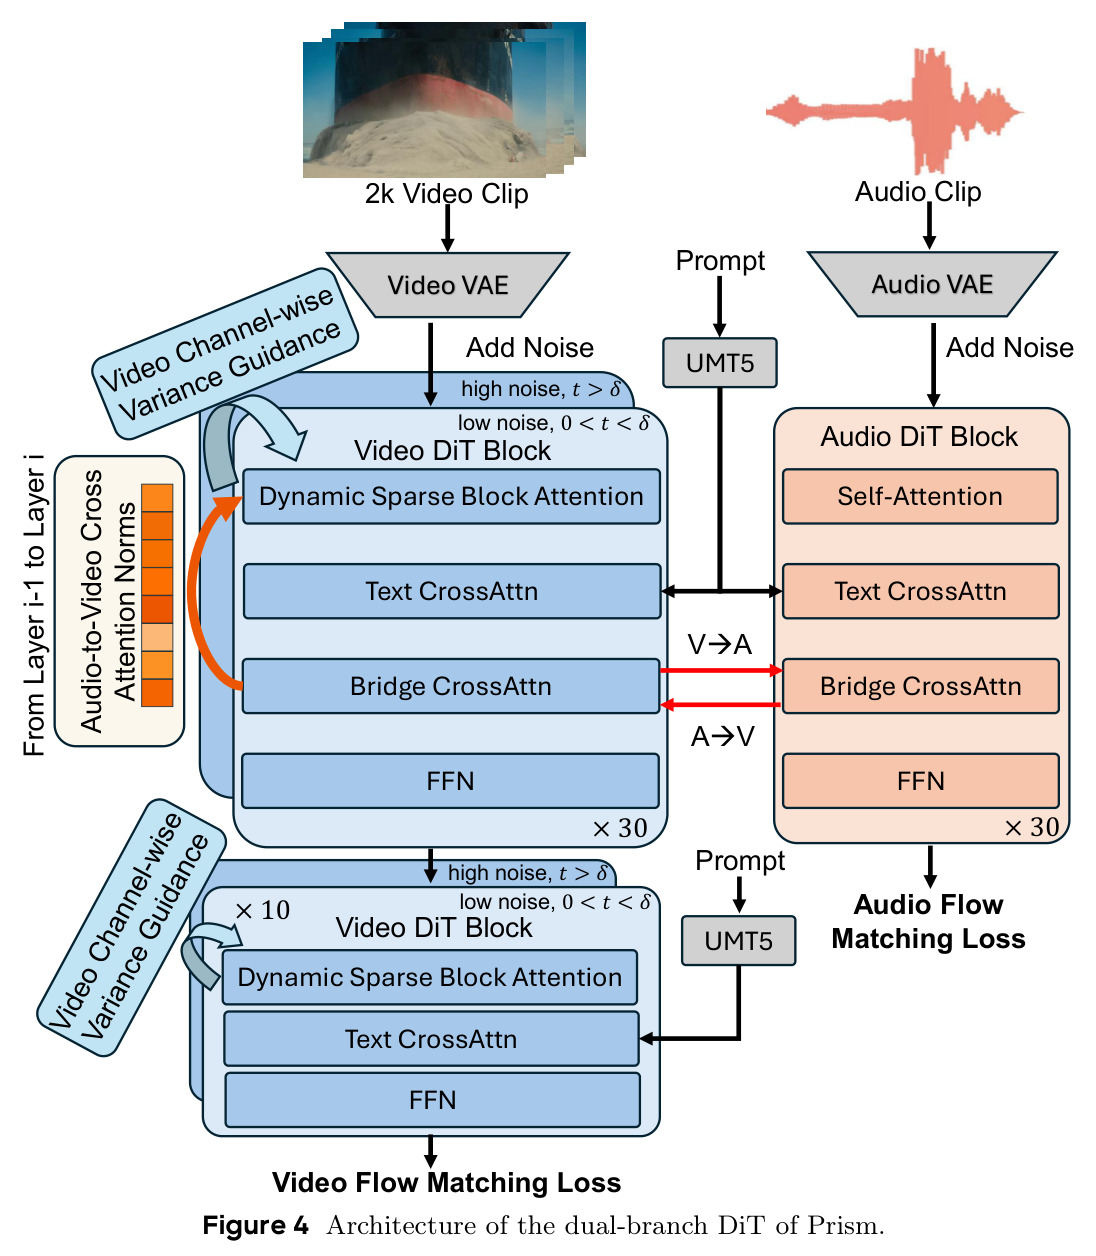
Prism 骨干继承 MOVA:视频分支与音频分支各有一套 DiT 块(Wan2.2 风格的高噪声/低噪声 MoE 双专家,各 40 层 40 头),token 经各自 VAE 压缩。每层包含自注意力、文本交叉注意力和双向桥接交叉注意力(A→V、V→A)。视频 hidden state 经音频到视频交叉注意力 $\hat{h}=\text{CrossAttn}(h,K_a,V_a)$ 注入音频信息,其输出 L2 范数 $\|\hat{h}\|_2$ 反映该视觉位置吸收了多少音频影响。
音频到视频交叉注意力范数是 Prism 两大引导信号之一,直接决定块形状向发声区域(唇部、手部)倾斜;不理解这个双分支架构,就看不懂引导信号从哪来、为什么是零成本的。
VAE 时空压缩与超长 token 序列
视频经因果 VAE 压缩后,一个 2K 片段(10~12 秒、24fps)仍产生约 87 万(推理)到超过 100 万(训练)个 token,自注意力 $O(N^2)$ 代价在此规模爆炸;同时序列越长、重复背景等冗余 token 的占比越高,而人脸、快速运动等信息性内容在空间上高度局部化。
这个 token 规模是一切问题的根源:全注意力既算不动、注意力权重又被冗余 token 稀释;它也是 Prism 只稀疏化视频自注意力(绝对成本大头)、音频分支保持全注意力的设计依据。
研究动机
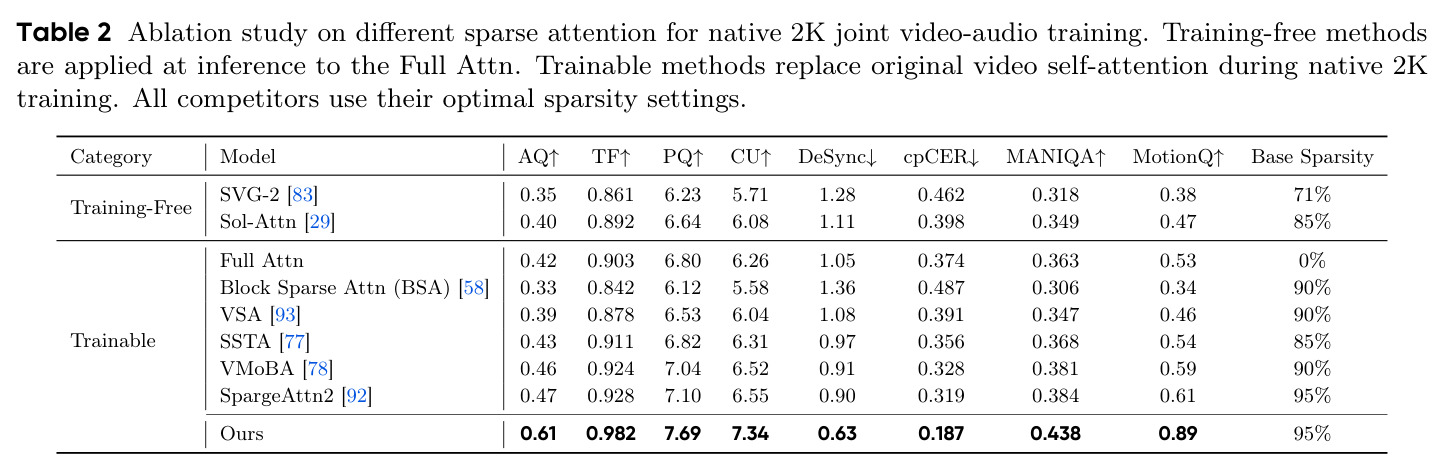
联合视频-音频生成模型(MOVA、LTX-2.3、Ovi 等)至今无法原生在 2K 分辨率训练,根本障碍有两个。其一是全注意力的二次方复杂度:经 VAE 压缩后,一个 2K 片段(12 秒、24fps)仍产生超过 100 万个 token,注意力矩阵规模让训练成本难以承受——实测全注意力单步训练 26.5 分钟、单卡推理内存 72.8G,以至于 2K 推理必须 4 卡并行。其二是注意力权重稀释:提高分辨率新增的 token 绝大多数是重复背景等冗余内容,而人脸、快速运动等真正承载信息的细节空间上高度局部化。全注意力不加区分地对待超长序列,冗余 token 拿走大部分注意力权重,信息内容欠关注,既损害 2K 新知识(皮肤纹理、手指动作)的学习,也扰动预训练先验(附录 A.12 的注意力可视化直接证实了稀释现象)。现有替代方案各有缺陷:LTX-2.3 只能在 720p 生成后再超分到 2K,生成阶段视觉细节受限,超分只会放大已有伪影;而现有稀疏注意力方法(training-free 的 SVG-2、Sol-Attn,trainable 的 VMoBA、SpargeAttn2、VSA、SSTA)都面向纯视频 480P/720P 推理加速,对所有 token 施加统一稀疏准则,完全忽略联合视频-音频数据中跨模态交互集中在发声区域的独特结构,搬到 2K 视听训练时反而显著掉点——固定形状的块稀疏注意力 BSA 在 2K 训练中 AQ 只有 0.33,比全注意力的 0.42 还差。
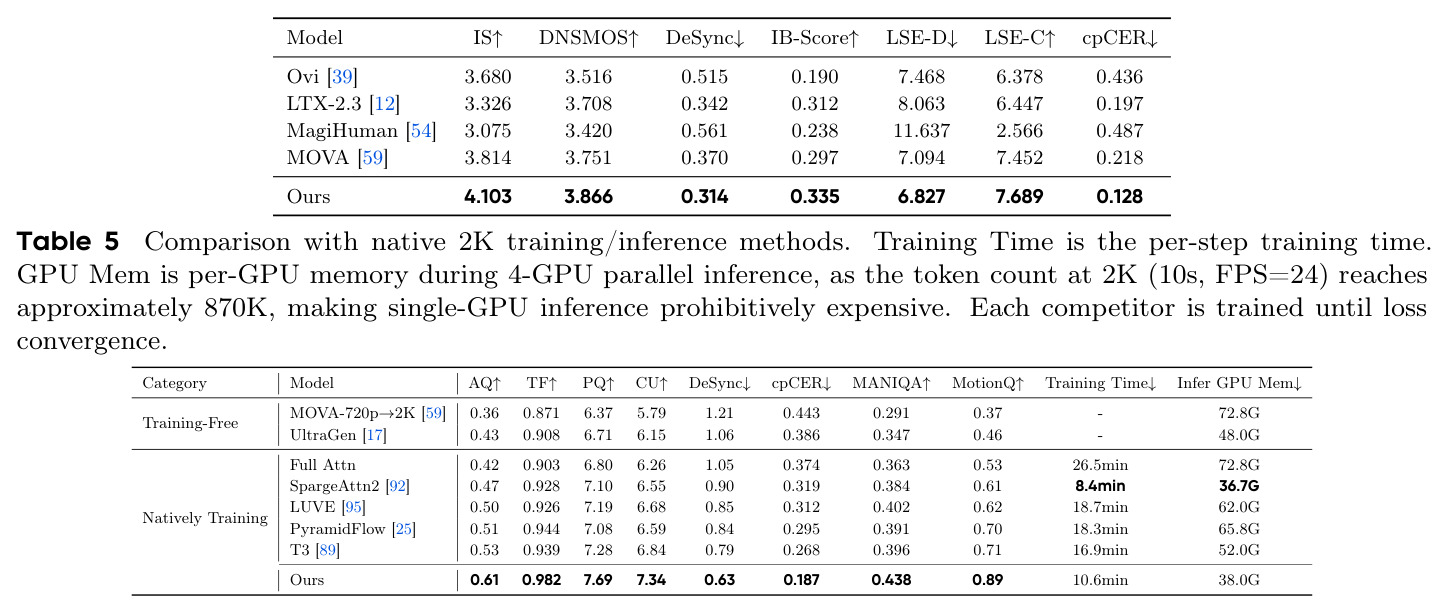
本文的目标是本文的目标是让联合视频-音频生成模型第一次实现原生 2K 分辨率训练,并把『分辨率』确立为与参数量、数据量并列的第三条能力扩展轴。具体拆成三个子目标:第一,效率上把 2K 训练加速约 2.5 倍(全注意力单步 26.5 分钟降到约 10 分钟量级),推理时间降 3 倍、GPU 内存降近一半;第二,质量上不能只求不掉点,而要全面超越全注意力——滤掉冗余 token 本身就能缓解注意力稀释,让模型更好吸收 2K 网格提供的新信息,同时保持乃至增强音视频同步;第三,稀疏注意力结构必须感知跨模态结构,保证发声区域(唇部、手部、乐器接触点)的音视频耦合在 2K 下不被稀疏化破坏——这是所有现有稀疏方法的盲区,且随分辨率提高愈发严重,因为发声区域在 token 序列中的空间占比不断缩小(Table 12 显示所有无音频感知的竞品从 1080P 到 2K 在 cpCER/DeSync 上都在退化)。
与已有工作不同的是,本文的独特切入角度是把『内容自适应的块形状』与『音频感知的稀疏结构』结合起来,成为第一个针对原生高分辨率联合视频-音频训练设计的注意力框架。已有可训练稀疏方法的共同假设是『固定形状块内语义连贯』,但 2K 数据恰恰打破这一假设:发声区域空间紧凑却时间剧变(嘴部开合),静态背景海量且近乎均匀,固定形状必然把语义不同的 token 混进同一块,使平均池化的块代表失真。Prism 的差异化有三层:(1) 用视频 value 特征的通道方差度量内容沿时间/高/宽三轴的变化速度,用音频到视频交叉注意力输出的 L2 范数度量音频对每个视觉区域的影响强度,两者合成逐轴变化指示 $g_d$;(2) 把块形状选择形式化为块内信息损失最小化 $J=\sum_d g_d(b_d^2-1)$,用拉格朗日乘子求出闭式解 $b_d^*\propto g_d^{-1/2}$,让快变轴获得更细划分,有理论最优性而非启发式;(3) 用混合 Top-k + Top-p 让每个查询块的稀疏度按注意力弥散程度动态变化。与 VMoBA 按『层索引』循环预定义分区不同,Prism 的分区由内容统计决定且逐头逐层独立。
核心方法
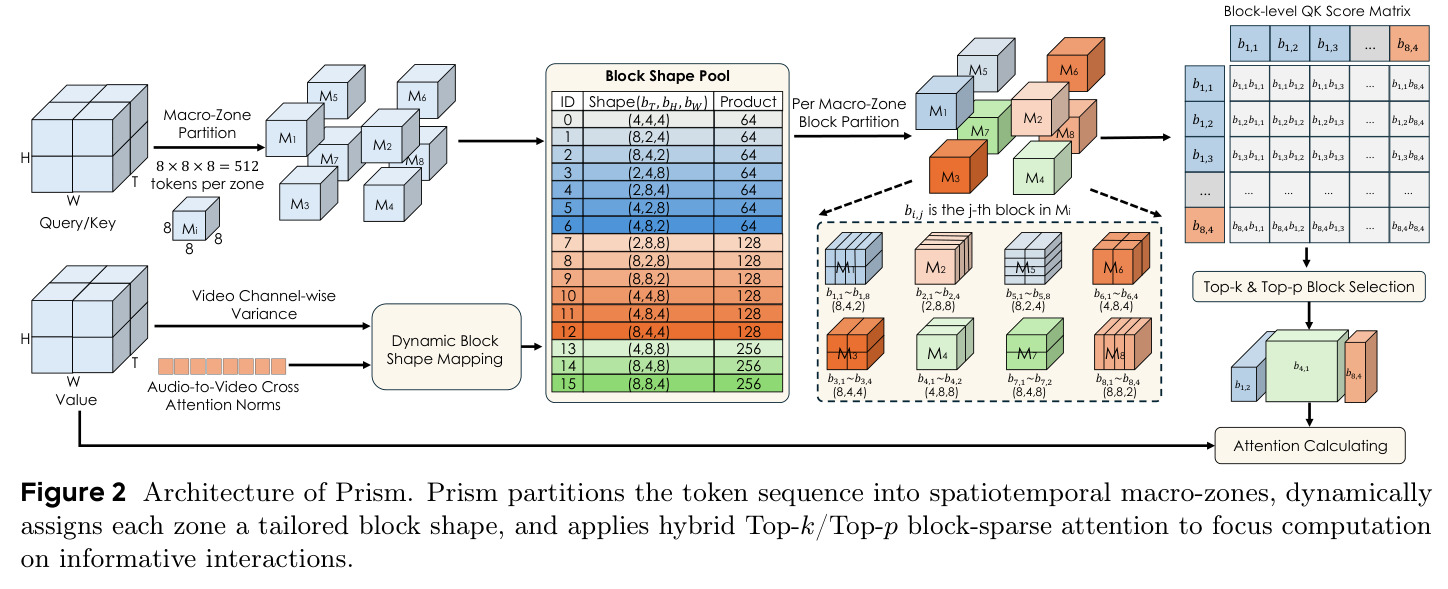
先说直觉:在 2K 分辨率下,token 序列的信息密度分布极度不均——发声区域(正在说话的脸、演奏的手)空间紧凑但时间变化剧烈,且是音视频耦合的核心;静态背景则贡献海量近乎重复的 token。要让块稀疏注意力在这种数据上有效,块划分本身必须跟着内容走:信息密集处用小而各向异性的块,冗余背景用大块压缩。Prism 的技术路线分三步。第一步,把 $T\times H\times W$ 的视频 token 网格划分为不重叠的 $8\times8\times8$ 时空宏区(macro-zone),在每个宏区、每个注意力头、每个扩散层上赋予一个量身定制的 3D 块形状:由视频通道方差引导 $r_{v,d}$(衡量视觉内容沿第 $d$ 轴变化多快)与音频到视频交叉注意力范数引导 $\bar{a}\cdot\hat{v}_{a,d}$(衡量音频对该区域的影响是否沿某轴剧烈变化)合成变化指示 $g_d=r_{v,d}+\bar{a}\cdot\hat{v}_{a,d}+\epsilon$;由区域信息密度 $\rho(m)$ 把块大小 $B$ 分为 64/128/256 三档;再从 16 个候选形状(每轴边长取自 $\{2,4,8\}$、乘积为 $B$)中选与拉格朗日理想解 $b_d^*\propto g_d^{-1/2}$ 最近的形状。第二步,按所选形状把 token 重排成块连续内存布局,Q、K 块平均池化后计算块级相关性得分,用 Top-k(95% 稀疏度)保证最低覆盖、Top-p(0.2)对注意力弥散的查询自适应扩展,得到每查询的 key 块集合 $S_i$。第三步,Triton 内核只对选中块执行带在线 softmax 的稀疏注意力。整个框架只替换视频自注意力(它占 2K 成本绝对大头),音频分支与全部交叉注意力保持不变,因此可直接继承 MOVA-720p 的全注意力权重。
核心创新是『动态块形状』:块分区的几何形状本身成为内容的函数。这是与所有已有方法的本质区别——固定形状 BSA、VSA 的粗到细、VMoBA 按层索引循环预定义 1/2/3D 分区、SpargeAttn2 的蒸馏目标、UltraGen/T3 的固定窗口,全都用同一形状处理所有区域。其意义在两个层面。第一,保证块代表可靠:块稀疏注意力用平均池化代表整块 token,只有块内语义连贯时代表才有意义;固定形状在 2K 下把剧烈变化的嘴部与静止额头混进一块,代表向量失真,下游块选择随之失效(Table 2 中 BSA 的 AQ 仅 0.33、比全注意力还低 0.09,直接证明了这一点)。Prism 让快变轴获得短边、慢变轴获得长边,块内 token 保持语义一致。第二,首次把跨模态结构注入稀疏注意力:音频到视频交叉注意力输出 $\hat{h}=\text{CrossAttn}(h,K_a,V_a)$ 的 L2 范数编码了每个视频 token 注入了多少音频信息,Prism 把其区域均值 $\bar{a}(m)$ 作为乘性门控叠加到方向方差上,使发声区域的块形状向音视频耦合结构倾斜(如说话时嘴唇区域获得时间边长 $b_T=2$ 的细时间划分),静音区域该项自动消失。第三个关键创新是混合 Top-k + Top-p 选择:固定 Top-k 对注意力尖锐的查询浪费预算、对弥散的查询覆盖不足,Prism 用 Top-k(95%) 保底、Top-p(0.2) 按累积权重 $\sum_{l=1}^{L}P_{i,j_l}\ge p$ 自适应扩张,让每个查询的稀疏度动态匹配其注意力分布。形状分配本身不是拍脑袋:它从块内信息损失 $J=\sum_d g_d(b_d^2-1)$ 在约束 $b_Tb_Hb_W=B$ 下的最小化推导而来,拉格朗日条件要求 $g_db_d^2$ 三轴相等,即 $b_d^*\propto g_d^{-1/2}$。
方法步骤详情
完整流程见论文 Algorithm 1,分五个阶段。阶段一(动态块形状分配,逐头逐层):输入为视频自注意力的 value $V$ 与上一层缓存的音频到视频交叉注意力范数 $\{a_{t,h,w}\}$(首层无音频项,$g_d$ 退化为 $r_{v,d}+\epsilon$);把网格划成 $N_m$ 个 $8\times8\times8$ 宏区;对每区先沿轴平均得 $\bar{V}^{(d)}_{m,i,c}$,计算通道方差 $\sigma^2_{v,d}(m)=\frac{1}{D}\sum_c\frac{1}{Z_d}\sum_i(\bar{V}^{(d)}_{m,i,c}-\mu^{(d)}_{m,c})^2$ 与各向异性比率 $r_{v,d}=\sigma^2_{v,d}/(\sigma^2_{v,T}+\sigma^2_{v,H}+\sigma^2_{v,W})$;再算音频耦合强度 $\bar{a}(m)\in[0,1]$ 与音频方向方差 $\hat{v}_{a,d}$,合成 $g_d=r_{v,d}+\bar{a}\cdot\hat{v}_{a,d}+10^{-4}$;信息密度 $\rho(m)$(区内空间方差加时间帧差方差,最大值归一化)经阈值 $\tau_{128}=0.5$、$\tau_{256}=0.25$ 定块大小 $B\in\{64,128,256\}$;按对数量标下的理想解 $\ell^*_d=-\frac{1}{2}\log_2 g_d+\frac{1}{3}(S+\frac{1}{2}\log_2 g_T+\frac{1}{2}\log_2 g_H+\frac{1}{2}\log_2 g_W)$($S=\log_2 B$)从候选集 $\mathcal{C}_{B}$ 中选欧氏距离最近的形状。阶段二(token 重排):区内按所选形状划块并重排为块连续内存布局,任意形状都映射到整数个 64-token 的 Triton tile($B$=64/128/256 对应 1/2/4 个 tile),保证合并内存访问。阶段三(块级打分与选择):$\bar{Q}_i,\bar{K}_j$ 为块均值代表,$P_i=\text{Softmax}(\bar{Q}_i\bar{K}^\top/\sqrt{D})$,$S_i=\text{Top-k}(P_i,k)\cup\text{Top-p}(P_i,p)$。阶段四(稀疏注意力内核):完整 query tile 驻留 SRAM,仅遍历 $S_i$ 中的 key 块,在线 softmax 维护运行最大值 $\xi_i$ 与运行和 $\zeta_i$,耗时正比 $|S_i|$。阶段五:逆置换把输出散射回原 token 顺序。训练配置:初始化自 MOVA-720p(16B 参数),只训注意力模块、其余冻结;10 万条 2K 视听片段,5 个 epoch,学习率 $10^{-5}$,AdamW,bf16,FSDP 加节点内序列并行 SP=8,共 160 块 NVIDIA H800;损失为双模态流匹配损失(式 10)。
技术新颖性
技术新颖性体现在四点。第一,问题层面的第一性:这是首个面向『原生高分辨率联合视频-音频训练』的稀疏注意力框架,此前可训练稀疏注意力(VMoBA、SpargeAttn2、SSTA、BSA、VSA)全部针对纯视频 480P/720P 推理加速,从未处理过跨模态耦合,Table 2 显示它们直接搬到 2K 视听训练时全面落后于 Prism。第二,理论支撑的形状分配:块形状不是启发式超参,而是从块内信息损失最小化推导而来——拉格朗日条件给出 $b_d^*\propto g_d^{-1/2}$;消融(Table 10)证实指数 $\alpha=1/2$ 恰为峰值,$\alpha=1/3$ 使块趋于各向同性、$\alpha=2$ 在训练后期因方差估计噪声被放大而发散(论文揭示了块形状震荡→代表失真→打分失真→下一步形状更错的复合误差反馈回路),Softmax/Rank/Entropy 等替代映射均偏离这一凹关系,Isotropic(各向同性)则全面最差。第三,零成本的音频感知信号:音频引导直接复用骨干中已存在的音频到视频交叉注意力输出范数(取上一层缓存),不增加任何额外模块或前向计算。第四,工程上用固定 64-token tile 兼容可变形状:既保住宏区级形状自由度又保证合并内存访问;并把离散决策(形状选择、块选择)全部 detach,梯度只经选中块上的稀疏注意力传播,与既有可训练稀疏注意力的稳定训练范式一致。附录 Table 11 的逐层/逐步/逐头形状统计(浅层以各向同性 444 为主、深层各向异性 824/428/842 增多、不同头的方向偏好正交)进一步证明该机制学到了真实的内容结构而非噪声。
实验结果
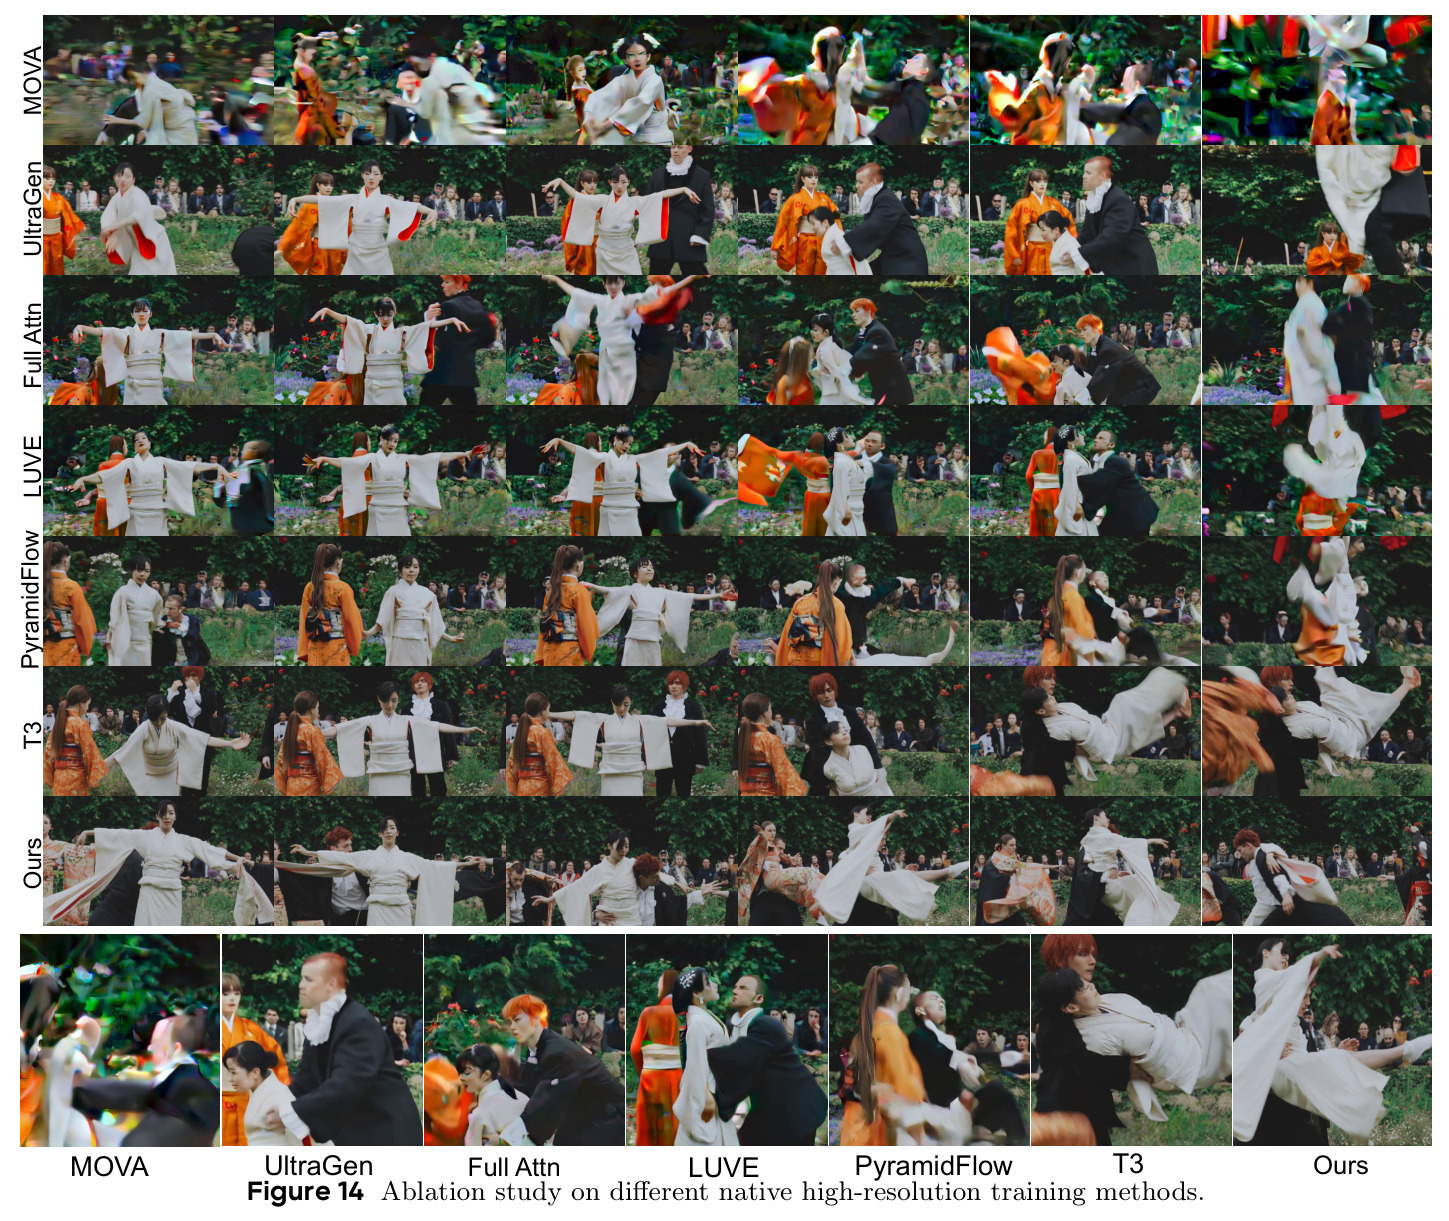
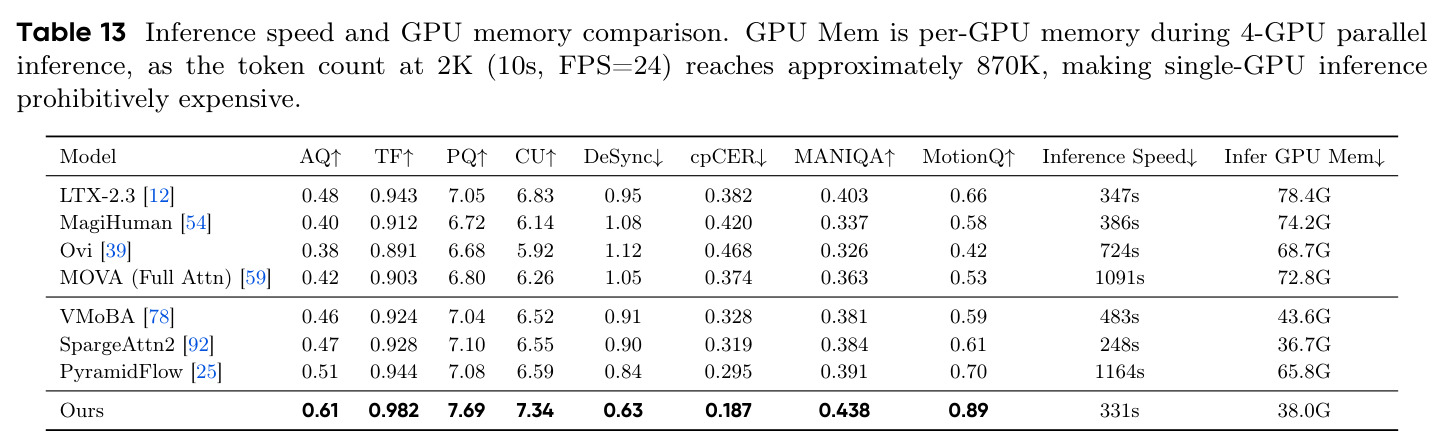
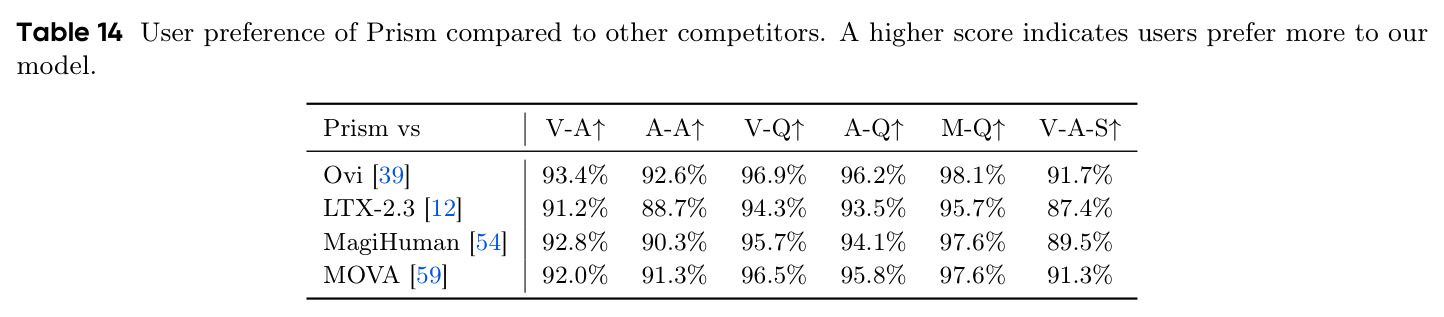
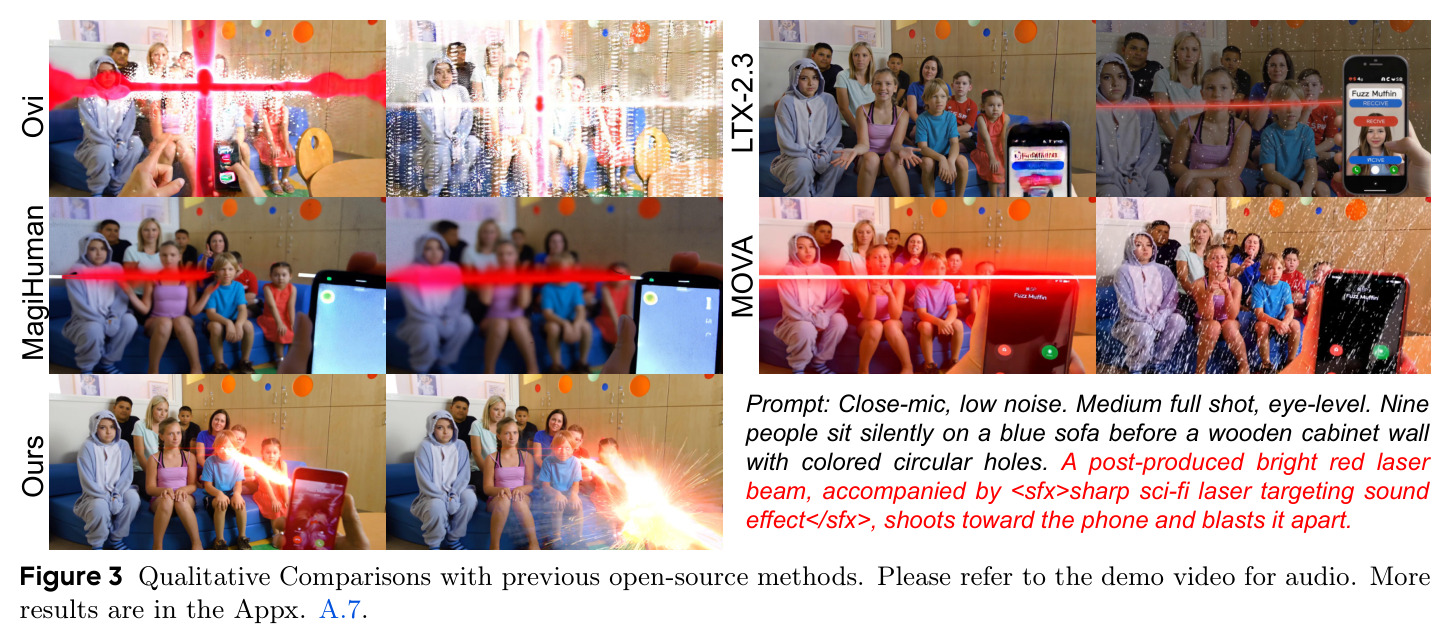
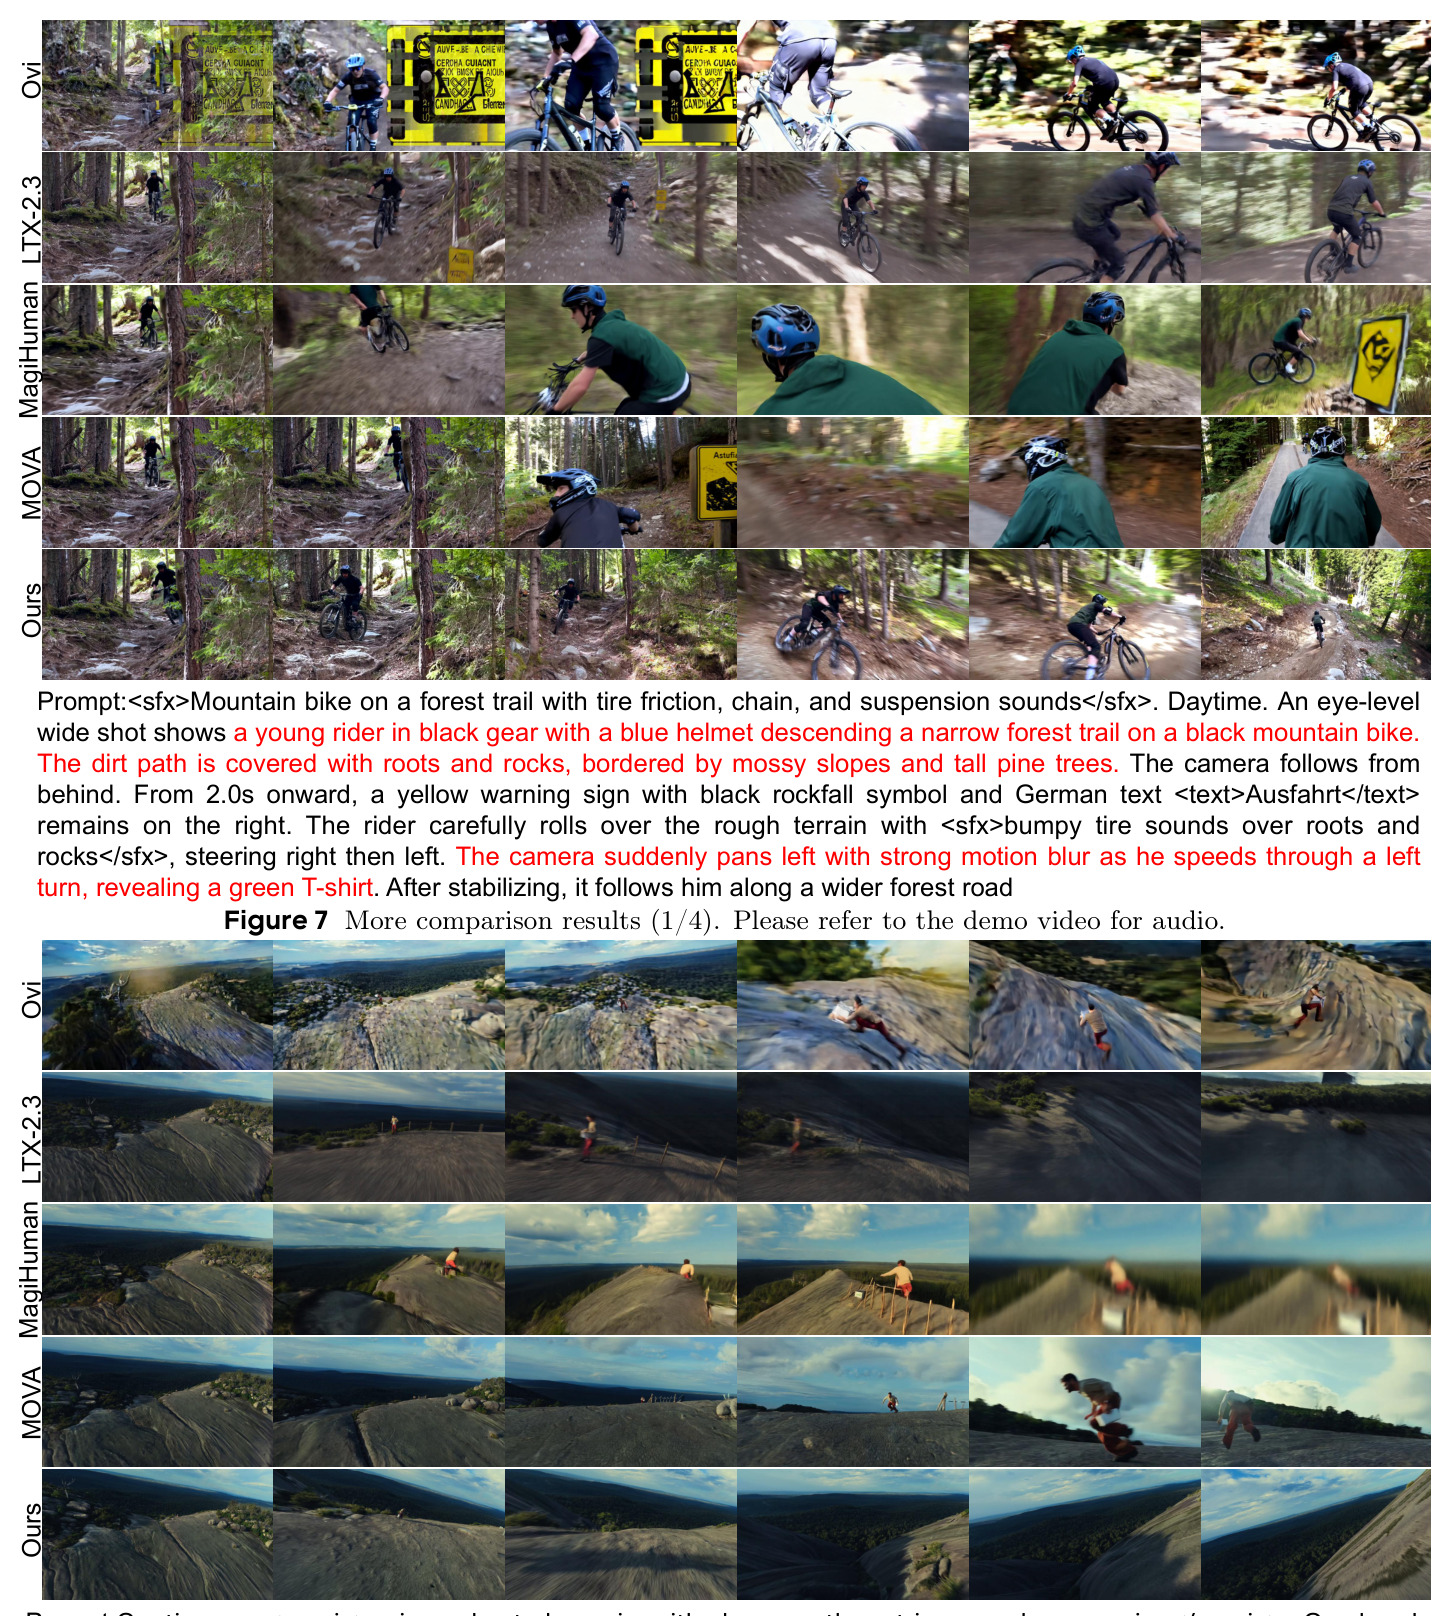
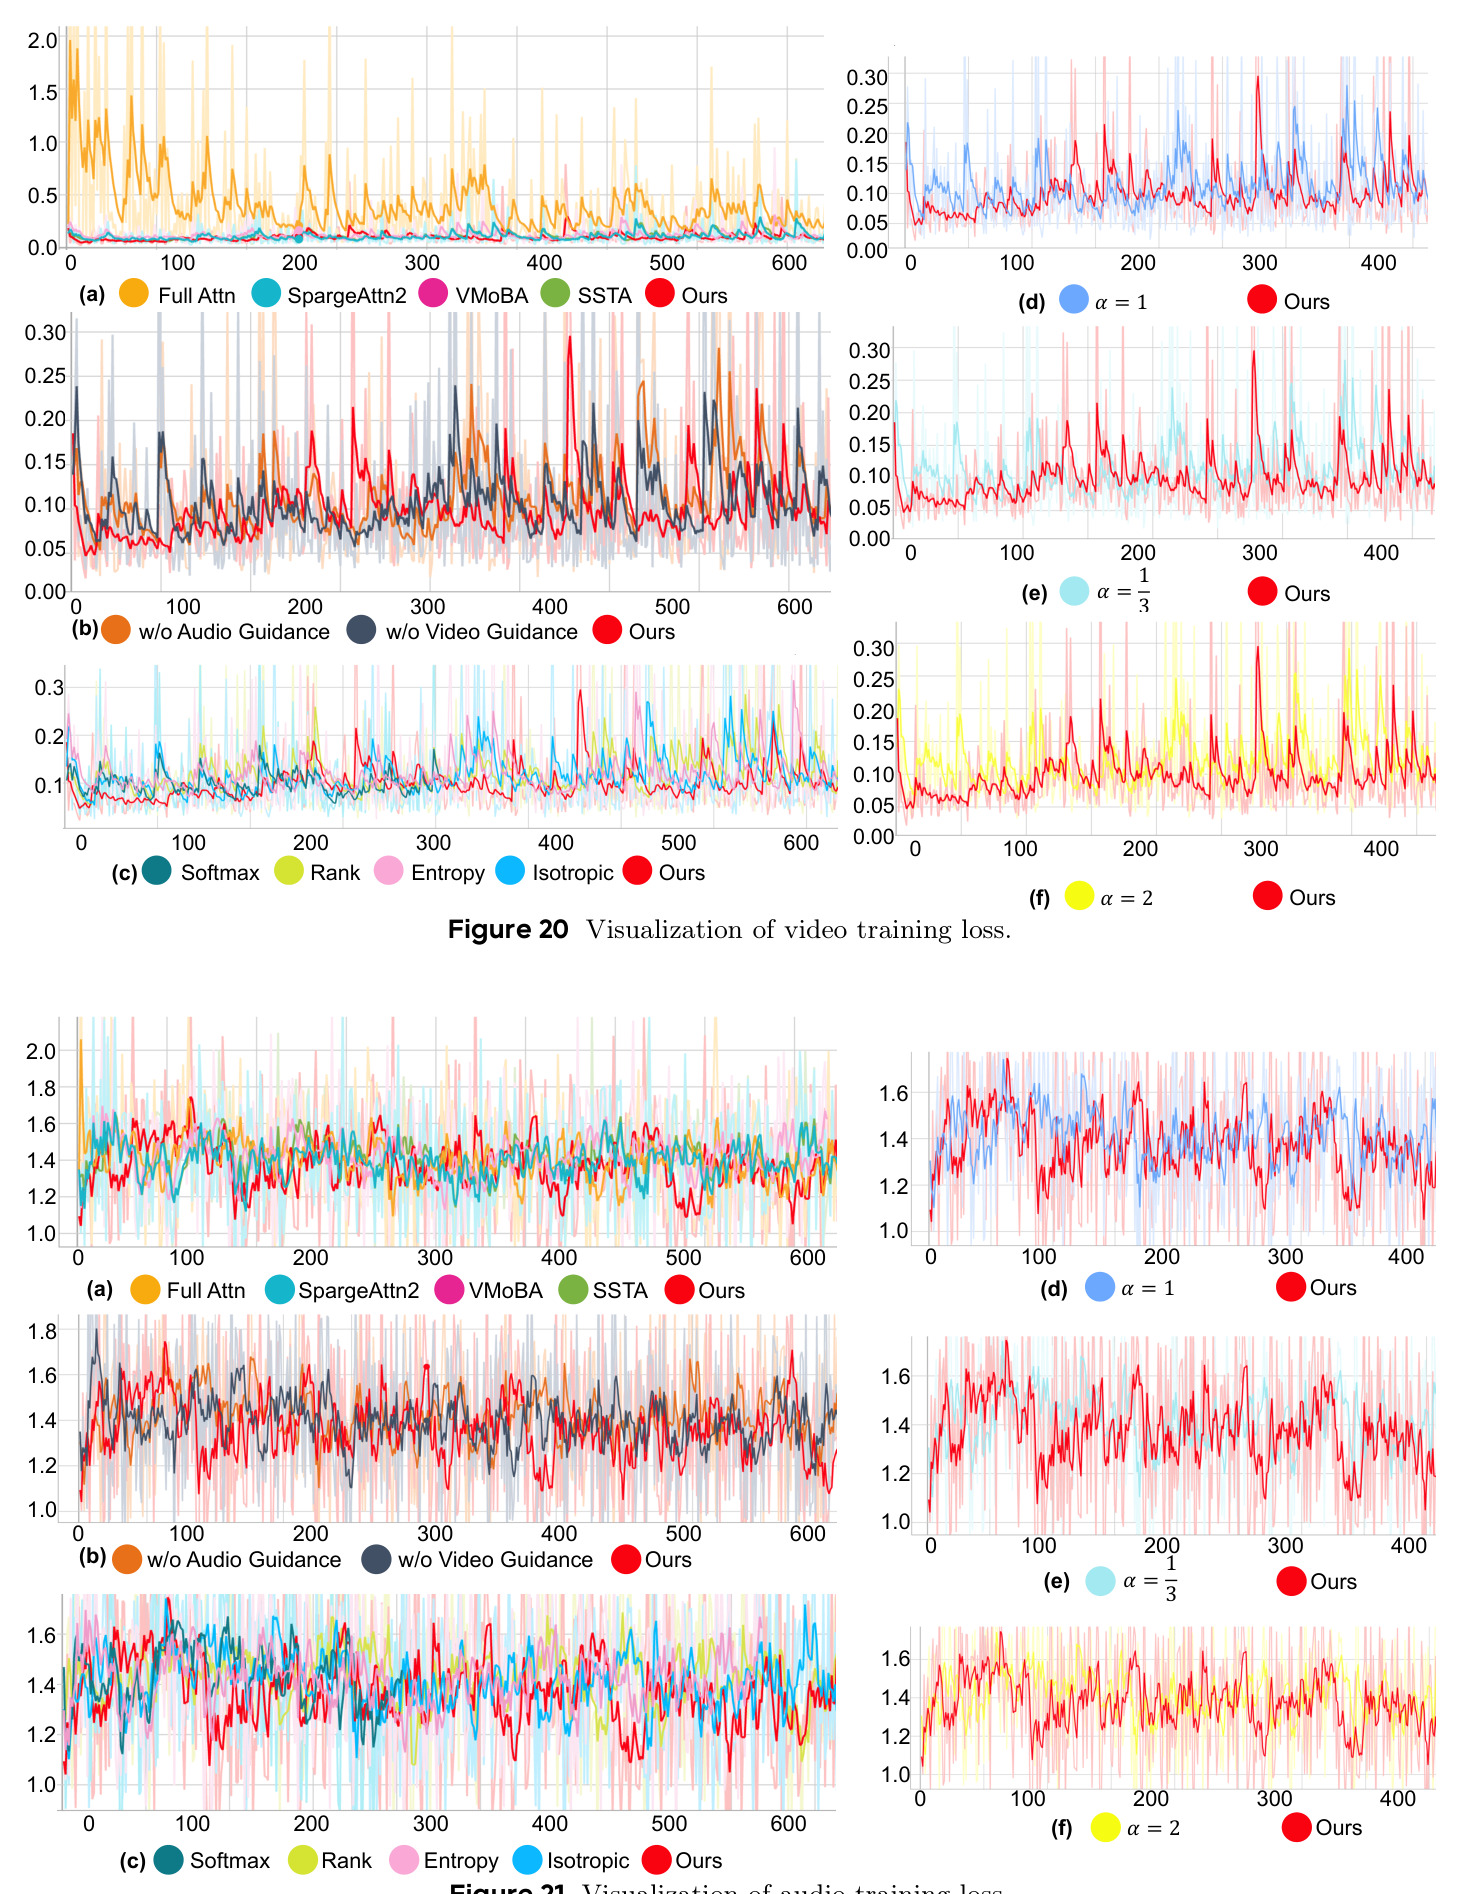
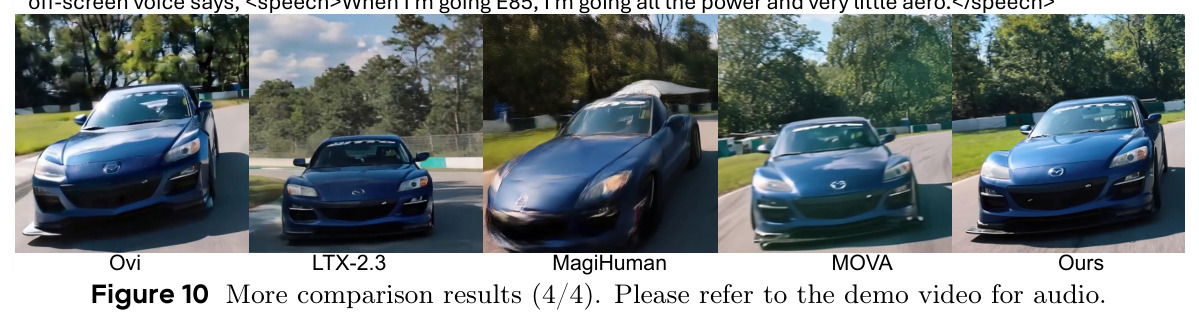
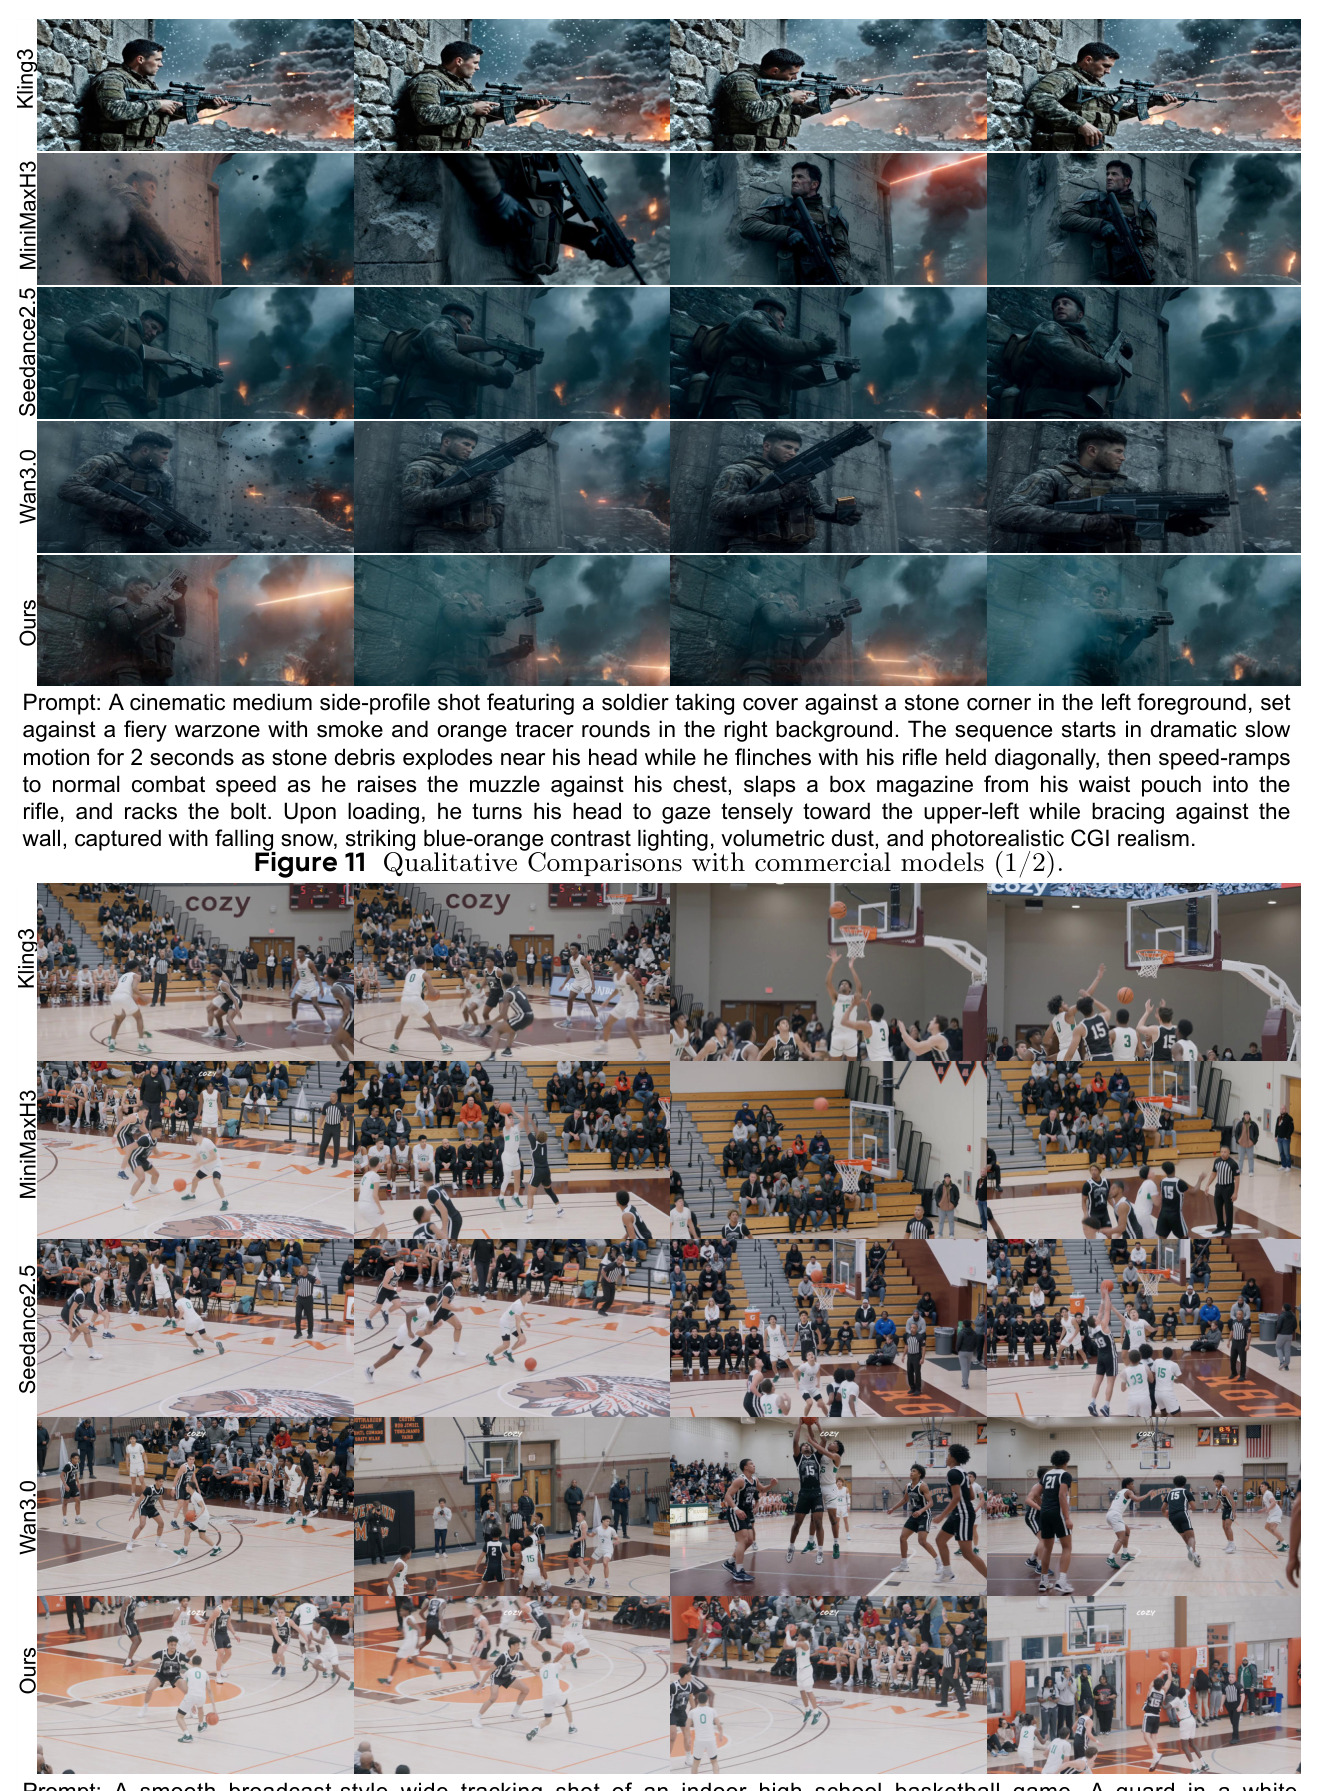
实验围绕『原生 2K 训练能否同时带来质量与效率收益』展开,结论一致且数据充分。(1) 主实验(Table 1,自建 2K-Bench,300 条未见 2K 视频):Prism 视频美学 AQ 0.61 大幅领先 MOVA 0.42、LTX-2.3 0.48、Ovi 0.38、MagiHuman 0.40;运动质量 MotionQ 0.89 vs 次优 LTX-2.3 的 0.66;音视频失同步 DeSync 0.63 vs MOVA 的 1.05;多说话人语音错误率 cpCER 0.187 vs LTX-2.3 的 0.382;高分辨率细节 MUSIQ 62.25 vs 55.60、MANIQA 0.438 vs 0.403。注意除 LTX-2.3 外所有对比模型都在同一 2K 数据上微调过,排除了数据不公平。(2) 稀疏注意力消融(Table 2):固定形状 BSA 最差(AQ 0.33),最强基线 SpargeAttn2 为 AQ 0.47/MotionQ 0.61,Prism 比 SpargeAttn2 的 MotionQ 高 46%、DeSync 好 30%,证明收益来自内容自适应形状而非稀疏化本身;training-free 方法(SVG-2、Sol-Attn)因不改变训练而全面垫底。(3) 原生高分辨率方法对比(Table 5):级联式 PyramidFlow(18.3min/步)与 LUVE 质量不及 Prism 且更慢,单遍 T3(16.9min)也落后;Prism 10.6min/步 vs 全注意力 26.5min,2.5 倍加速。(4) 分辨率缩放(Table 12):480P 时全注意力仍领先(AQ 0.56 vs 0.54),720P 起被 Prism 反超(0.58 vs 0.55),2K 时全注意力 AQ 跌至 0.42、甚至低于其自身 1080P 的 0.48;Prism 是唯一所有指标从 480P 到 2K 单调提升的方法(MANIQA +28%、MotionQ +56%),而所有竞品从 1080P 到 2K 在 cpCER/DeSync 上退化。(5) 效率(Table 13):推理比 MOVA 快 3 倍以上(1091s→331s/10s 2K 片段)、内存省 47%(72.8G→38.0G),同时 AQ +45%、MotionQ +68%、DeSync +40%;延迟分解显示动态机制开销仅 13.6%(形状分配 18s+重排 5s+选择 22s),86.4% 时间在稀疏注意力本身。(6) 训练损失(Fig 20/21):Prism 视频/音频损失均最低最稳;全注意力视频损失剧烈尖峰、音频损失持续上漂,固定形状稀疏方法音频损失同样上漂,说明它们保不住跨模态耦合。(7) 商业模型(Table 8):Wan3.0(AQ 0.74/MotionQ 0.96)、Seedance2.5(0.71/0.96)、Kling3.0(0.65/0.91)仍领先 16B 的 Prism(0.61/0.89),但 Prism 已是开源中最接近者。(8) 用户研究(Table 14):200 名被试二选一,对比 Ovi 时视觉文本对齐偏好 93.4%、运动质量 98.1%,对比 MOVA 时各项也超 91%。
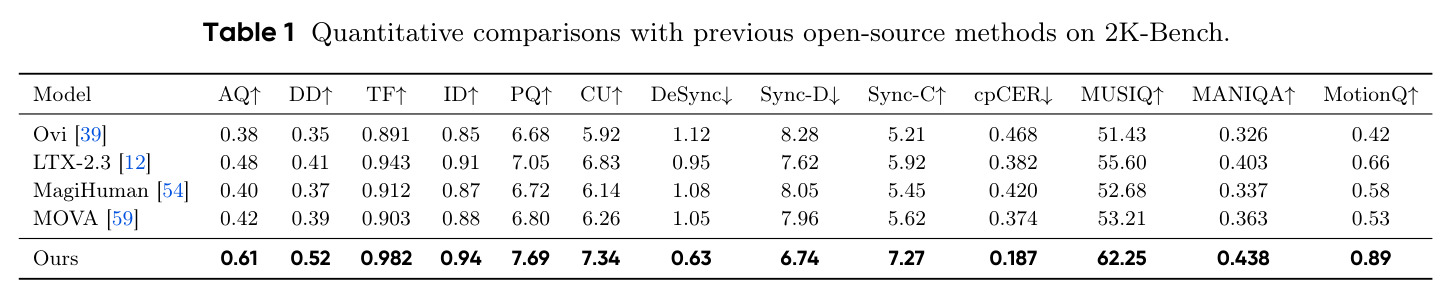
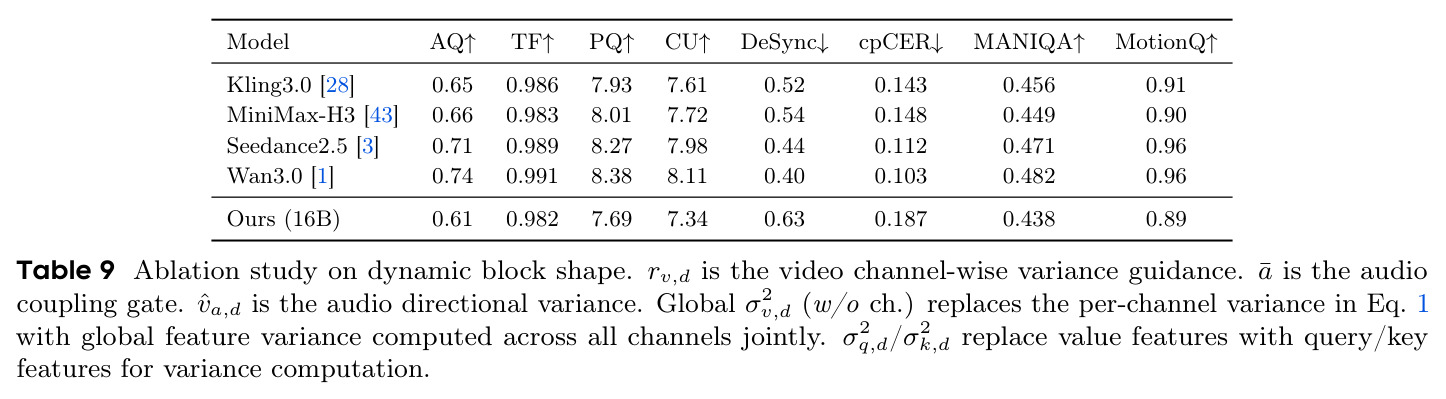
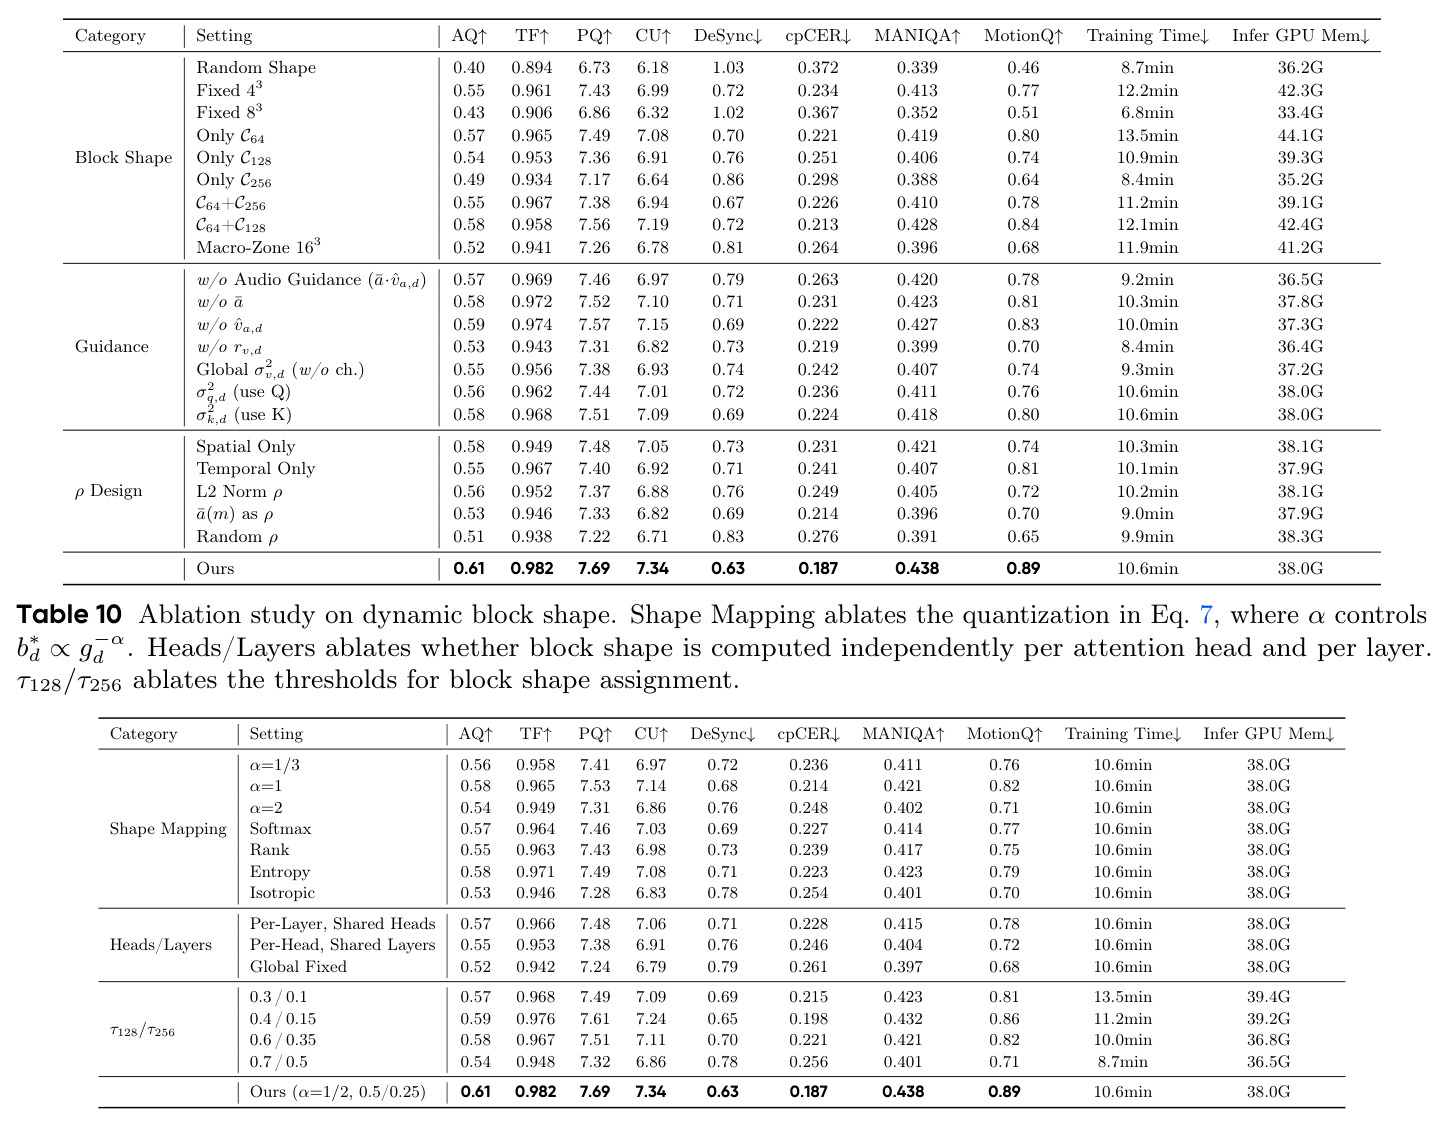
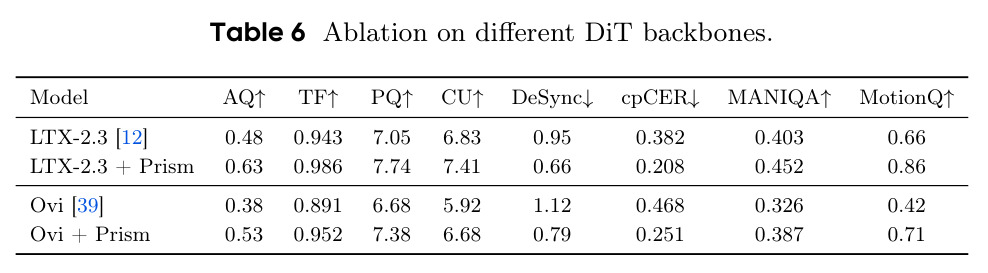
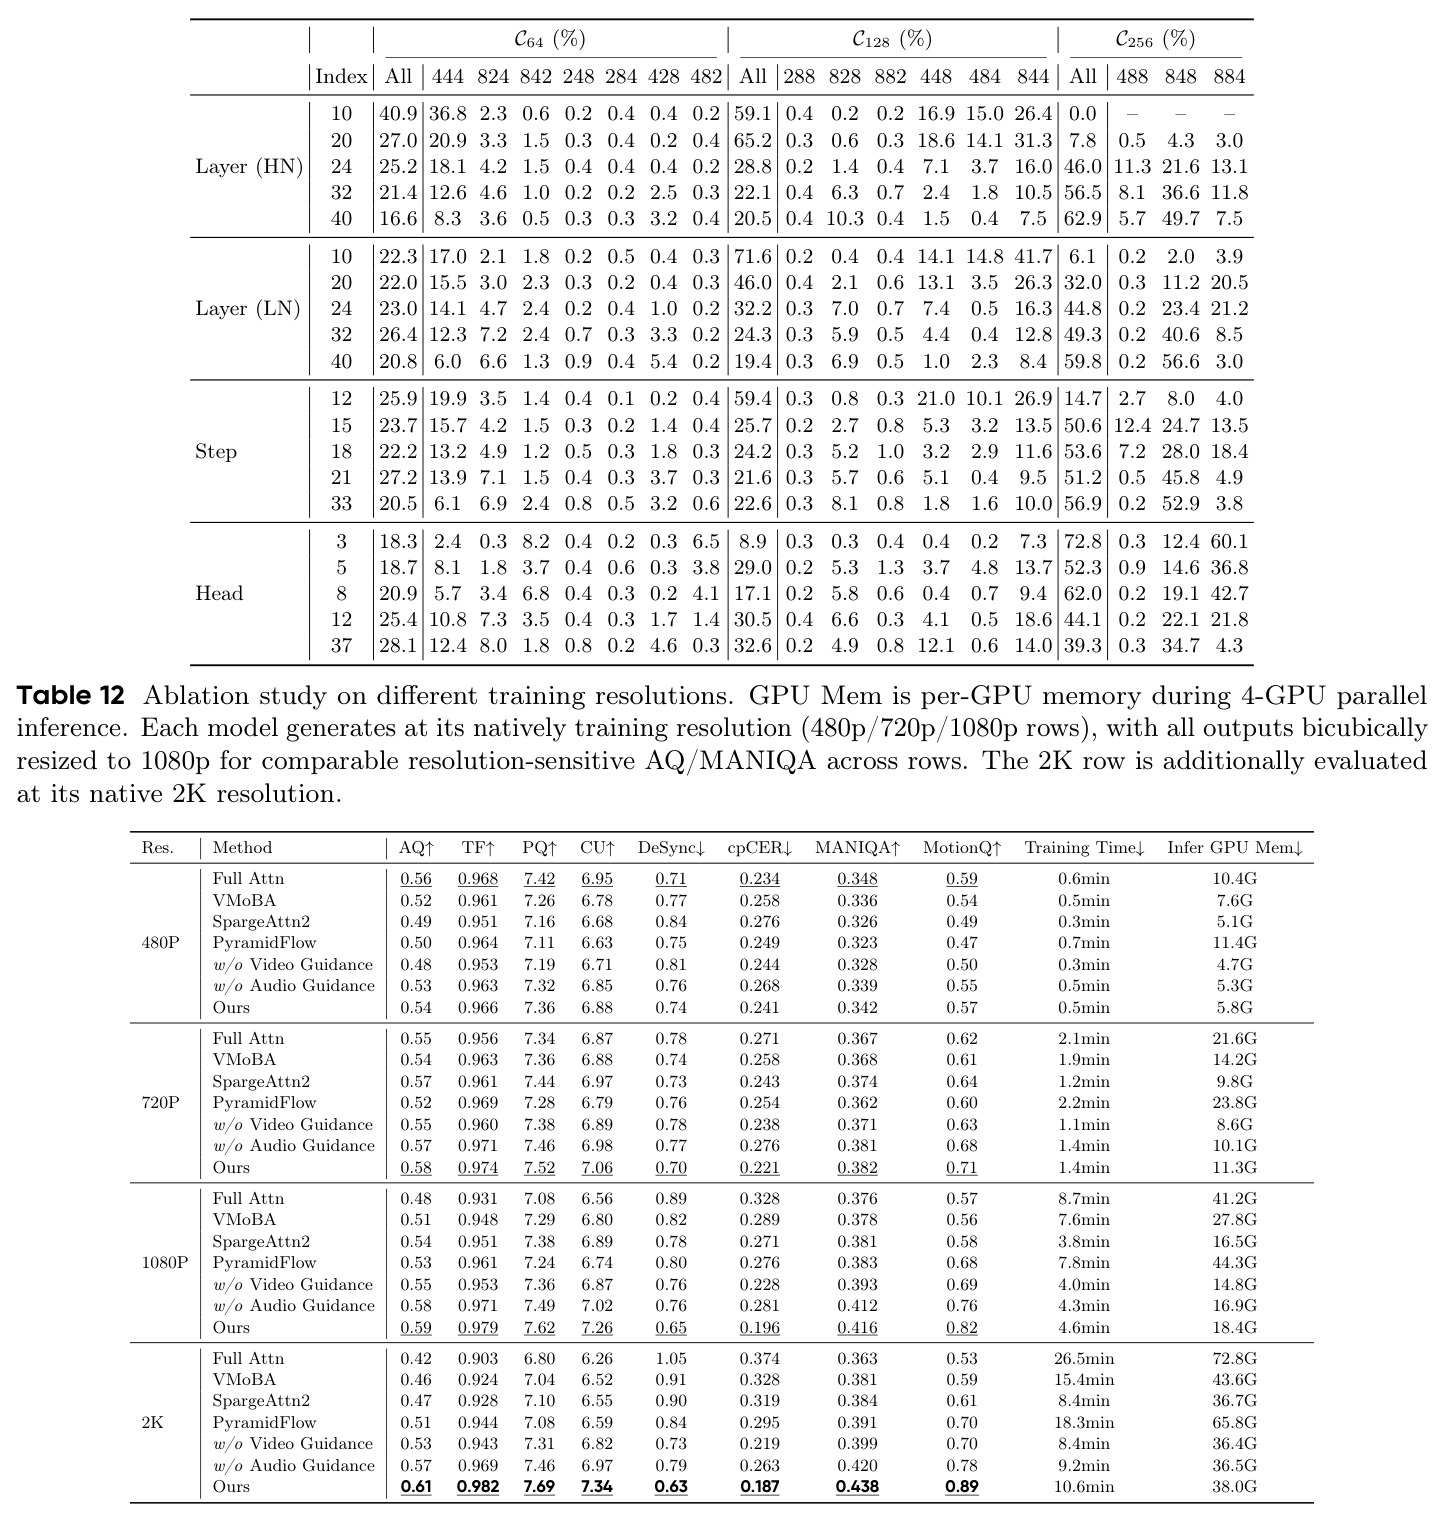
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 原生 2K 视频-音频生成(2K-Bench,300 条视频) | 视频美学质量 AQ(越高越好) | 0.61 | MOVA(全注意力,同数据微调)0.42 | +45% |
| 原生 2K 视频-音频生成(2K-Bench) | 运动质量 MotionQ(Gemini 评审,越高越好) | 0.89 | MOVA 0.53 / LTX-2.3 0.66 | 较 MOVA +68%,较 LTX-2.3 +35% |
| 原生 2K 视频-音频生成(2K-Bench) | 音视频失同步 DeSync(越低越好) | 0.63 | MOVA 1.05 | 降低 40% |
| 多说话人语音内容准确性(2K-Bench) | cpCER 说话人感知字符错误率(越低越好) | 0.187 | LTX-2.3 0.382 / MOVA 0.374 | 错误率减半 |
| 2K 原生训练效率(10s 24fps 2K 片段) | 每步训练时间(越低越好) | 10.6 min | 全注意力 26.5 min;次优稀疏法 SpargeAttn2 8.4 min 但质量低(MotionQ 0.61 vs 0.89) | 相对全注意力 2.5 倍加速 |
| 2K 推理效率(4 卡 H800 生成 10s 2K) | 单卡 GPU 内存 / 端到端时延 | 38.0 GB / 331 s | 全注意力 MOVA 72.8 GB / 1091 s | 内存 -47%,速度 3.3 倍 |
| 跨分辨率缩放能力(480P→2K 同数据训练) | 各指标随分辨率的变化 | 唯一所有指标从 480P 到 2K 单调提升(MANIQA +28%、MotionQ +56%) | 全注意力 2K 时 AQ 0.42 低于其 1080P 的 0.48;所有竞品 1080P→2K 时 cpCER/DeSync 退化 | 唯一实现分辨率缩放单调收益的方法 |
局限与改进
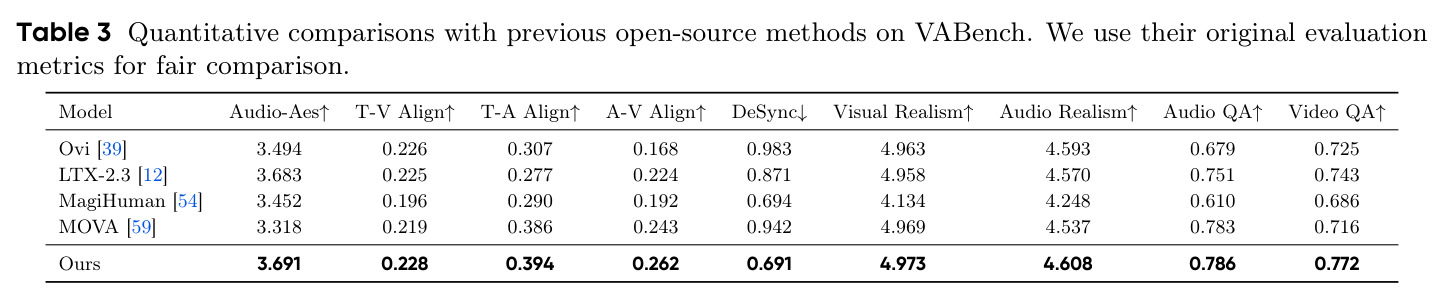
作者明确承认的局限:其一,镜头快速变焦/焦点切换时会模糊或人体形变(Fig 31 失败案例)——宏区时间跨度固定为 $Z_T=8$ 帧,快速镜头切换使同一宏区混入远景背景与近景人脸等高度异质内容,单一块形状无法同时忠实表示两者;其二,受 GPU 资源限制,未扩展到 4K 分辨率或更大 DiT 骨干,而 4K 会让 token 数再翻 4 倍。我自己的观察还有几点:第一,动态引导完全依赖启发式统计量(均值池化特征的方差、交叉注意力范数),作者自己承认『块内线性特征变化』假设在物体锐利边界处不成立,只靠 16 个离散候选形状的量化鲁棒性兜底,遇到训练分布外的极端内容(频闪、粒子特效、高密度纹理)时方差信号可能失真;第二,评测主力 2K-Bench 为自建数据,虽做了 URL 去重、感知哈希(Hamming≥8)、I3D 特征 FVD(5.5 倍于训练集内部距离)三重防泄漏检验,但与训练集同源(YouTube/Bilibili)且类目分布自定,跨社区可比性有限;MotionQ 由 Gemini 打分,LLM 评审存在固有偏差;第三方基准 VABench/MOVA-Bench 只在 720p 测试,缺少独立的第三方 2K 交叉验证;第三,稀疏化只覆盖视频自注意力,音频自注意力与全部交叉注意力保持稠密,10 秒级片段没问题,但扩展到分钟级长视频时音频与交叉注意力的相对成本会上升,设计需要重新评估;第四,与商业模型的音频质量差距仍明显(PQ 7.69 vs Wan3.0 的 8.38),作者归因于商业模型的音频后处理管线与更大配对数据,说明稀疏注意力解决了注意力结构问题,但解决不了数据与后训练层面的问题。
独立分析的弱点
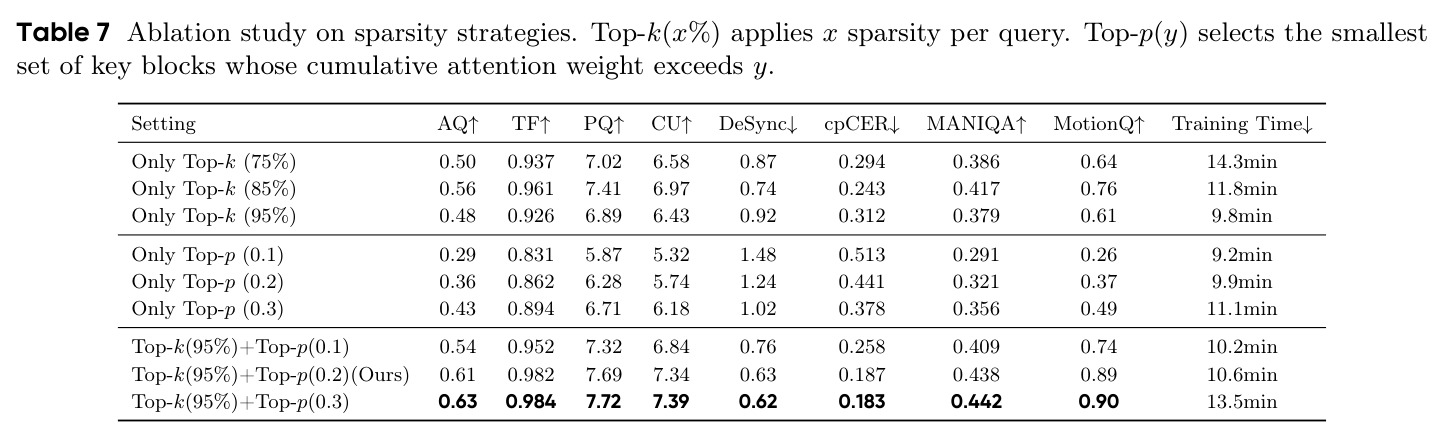
独立分析四个弱点并给出改进方向。(1) 固定时间宏区 vs 动态镜头:$Z_T=8$ 的固定时间跨度在频繁剪辑/变焦内容上必然产生异质宏区,这是作者承认的失败模式;改进方向是内容感知的自适应时间边界——用帧差或潜变量突变检测镜头切换并在切换处强制切分宏区,代价只是轻量预处理统计。(2) 引导信号的代理性质:通道方差与注意力范数是『信息量』的间接代理,可以用更直接的不确定性度量(块内注意力熵、或对平均池化重建误差的可学习估计器)替代;更进一步,形状选择与块选择目前均不可微、完全 detach,可尝试 Gumbel-Softmax 类松弛让稀疏结构由训练损失端到端优化,摆脱对手工阈值 $\tau_{128}/\tau_{256}$ 和闭式解的依赖。(3) 覆盖范围窄:音频自注意力、文本交叉注意力、桥接交叉注意力全部保持全注意力,当前设计针对『视频自注意力占主导』的短片段;若推广到长视频(数分钟)或高帧率,音频与交叉序列增长后将成为新瓶颈,需要为交叉注意力设计保留模态对齐的稀疏模式。(4) 质量速度曲线的陡峭区:Table 7 显示 Top-p 从 0.2 提到 0.3 时 MotionQ 仅从 0.89 升到 0.90,训练时间却增加 27%(10.6→13.5min),说明选择策略的调度还有优化空间,例如训练早期用宽松 p、后期收紧,或按去噪步动态调整(Table 11 已显示块形状配比随去噪步显著漂移)。(5) 评测体系自证:核心结论依赖自建 2K-Bench 与 LLM 评审的 MotionQ,现有用户研究仅 200 人、每题二选一,扩大多人种、多机构的人工细节盲评会更可信。
未来方向
作者提出的方向:一是自适应时间宏区边界,在检测到的镜头切换处分裂宏区以消除转场失真;二是扩展到 4K 原生训练,token 数再翻 4 倍将对稀疏内核和形状分配提出新挑战;三是探索更大 DiT 骨干以吸收 2K 网格的更丰富细节。基于本文成果可以自然延伸的方向:第一,把『分辨率缩放』确立为独立 scaling axis 并系统刻画其 scaling law——Table 12/Fig 19 已论证它与参数/数据缩放本质不同(提升空间上限但引入冗余退化风险),Prism 证明存在让其单调收益的注意力设计,后续可研究分辨率-参数-数据的联合最优配比;第二,把音频引导范式推广到其他跨模态条件生成,如音乐驱动的舞蹈生成、环境声驱动的场景生成,凡是『条件模态的影响在空间上高度局部化』的场景都适用同样的耦合感知块形状;第三,推理时的自适应稀疏调度:目前 Top-k/Top-p 阈值全程固定,而去噪不同阶段的注意力弥散度不同,按时间步动态调整稀疏度可能进一步加速;第四,可微块选择与端到端稀疏结构学习,让『哪些块重要』本身成为学出来的量;第五,与 RLHF 后训练结合——作者在商业模型对比中指出商业优势部分来自 RLHF,稀疏注意力与偏好优化叠加是缩小开源-商业差距的互补路径。
复现评估
复现条件评估:代码已开源(GitHub: Tencent-Hunyuan/Prism),项目页提供 demo 视频;2K-Bench 以非商业研究许可发布(300 条 10 秒 2K 视频,源自 YouTube/Bilibili 并经上传者授权,跟随 CelebV-HQ 许可模式)。论文的工程细节披露非常充分:完整算法伪代码(Algorithm 1 五阶段)、所有关键超参(Top-k 95%、Top-p 0.2、$\tau_{128}=0.5$、$\tau_{256}=0.25$、$\epsilon=10^{-4}$、宏区 $8^3$、16 候选形状、$\alpha=1/2$、学习率 $10^{-5}$、5 epochs、AdamW $\beta=(0.9,0.999)$、bf16、FSDP+SP=8)、Triton 内核配置(Triton 3.3.1、CUDA 12.8、num_warps=8、num_stages=3、BLOCK_M/N=64、BLOCK_D=128),以及训练数据的多级清洗流程(短边≥1440 像素、傅里叶频谱检测超分、美学分>0.4、MANIQA>0.3、Dynamic Degree>0.2、PQ>6.0、SyncNet 置信度>0.9、Qwen3-VL/Qwen3-Omni 打标)。主要门槛在算力与数据:完整复现需要 160 块 H800 训练 16B 模型 5 个 epoch,且 10 万条 2K 数据中网络采集部分的授权可能无法完全再分发。降低难度的路径是方法被证明骨干无关(Table 6:在 LTX-2.3、Ovi 骨干上分别把 AQ 从 0.48/0.38 提升到 0.63/0.53),可在小得多的骨干加单节点 8 卡上验证核心机制;推理只需 4 卡 H800(38G/卡)。综合评价:代码、基准、超参齐备,属于『高成本但可复现』,学术复现建议从消融级别的缩小配置入手。
论文图表
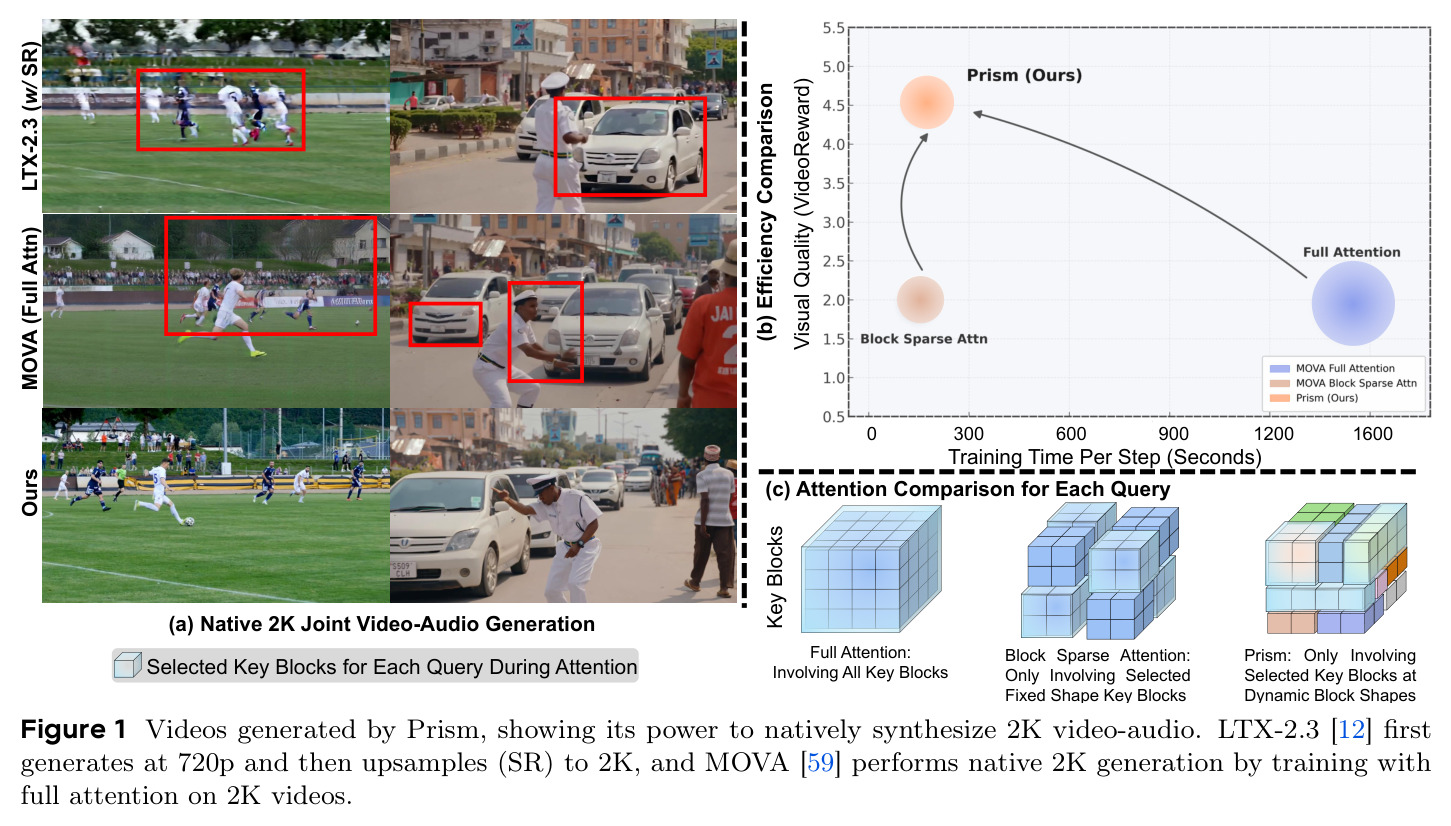
三联图:(a) 展示 Prism 原生生成的 2K 视听内容,与 LTX-2.3(720p 生成后超分)和 MOVA(全注意力 2K 训练)对比,后两者出现躯体畸变和模糊;(b) 训练效率散点图,横轴为每步训练时间(0-1600 秒),Prism 在质量-效率平面上优于 LTX-2.3 与 MOVA;(c) 三种注意力的逐查询 key 块选择示意:全注意力涉及所有块、固定形状块稀疏只选固定形状块、Prism 只选动态形状的 key 块。
一图总览论文的三个核心主张:原生 2K 生成的视觉优势、训练效率优势、以及动态形状块选择与全注意力/固定形状稀疏的本质区别,是理解全文定位的入口。
注意力图可视化:(a) 注意力热图叠加在视频帧上,权重集中于人脸和嘴部、静态背景权重极低(对比全注意力的稀释现象);(b) H/W/T 三轴注意力矩阵在空间轴呈紧对角、时间轴呈宽对角,直接验证『发声区域空间紧凑+时间剧变→块应空间短边+时间短边/长边』的核心动机;(c) 全注意力与 Prism 在背景/人脸/躯干不同宏区的选择模式对比。
为动机(注意力稀释、各向异性注意力结构)和方法设计(按轴变化速度分配形状)提供最直接的实证桥梁,是把直觉变成证据的关键图。
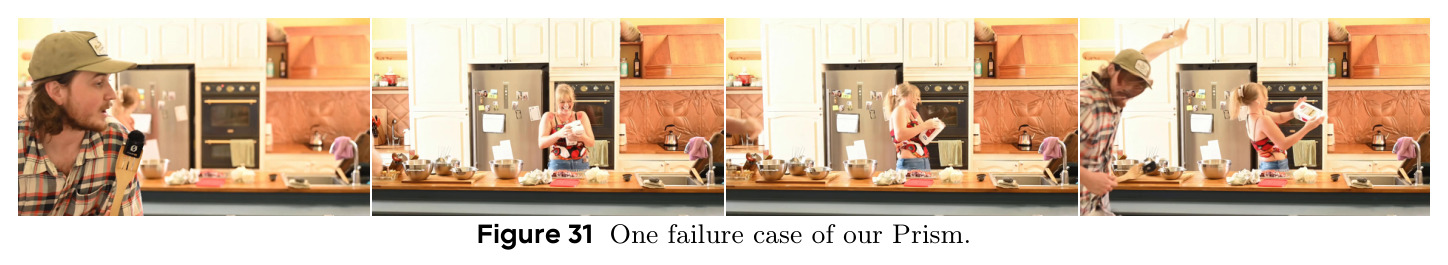
失败案例:相机焦点目标频繁切换(远景与特写间快速变焦)时,转场帧出现模糊与躯体形变——宏区固定 $Z_T=8$ 帧时间跨度使该区域混入远景背景与近景人脸两类异质内容,单一块形状无法同时忠实表示。
作者主动展示的方法边界,直接指出固定时间宏区这一结构性局限及『自适应时间边界』这一未来方向,对评估方法适用范围很重要。