Mobile-4DGS:面向移动端的静态-动态统一实时高斯泼溅 Mobile-4DGS: Unified Static-Dynamic Real-time Mobile Gaussian Splatting
用一阶球谐、显式二阶运动与深度序证书,在手机GPU上实时渲染静态与4D动态场景。
前置知识
3D 高斯泼溅(3DGS)
一种显式可微的新视角合成表示:场景由数十万到数百万个各向异性 3D 高斯基元组成,每个基元带位置 $\mu_i$、协方差 $\Sigma_i$(分解为尺度 $s_i$ 与旋转 $r_i$)、不透明度 $o_i$ 和球谐系数 $c_i$。渲染时把高斯投影到屏幕做光栅化与混合,训练靠可微光栅化反传梯度。
本文的全部压缩、密度控制与动态建模都作用在高斯基元的属性上,不理解 3DGS 的参数构成(位置/尺度/旋转/不透明度/SH)就无法理解存储瓶颈来自哪里、每个模块省掉了什么。
球谐函数(SH)与视角相关颜色
单位球面上平方可积函数的正交基,3DGS 用它参数化随观察方向 $\omega$ 变化的颜色 $c(\omega)=\sum_{\ell=0}^{L}\sum_m c_{\ell m} Y_{\ell m}(\omega)$。截断到 $L$ 阶有 $(L+1)^2$ 个系数,三阶 $\times$ 3 通道 = 48 个浮点数,是每个高斯最大的存储开销;低阶 SH 只能表达平滑的角度变化。
本文外观压缩的核心就是把三阶 SH 折叠成一阶 SH(每通道 4 个系数),论文的第一个创新 MC-SEA 完全建立在 SH 基的投影与角域能量稀疏性之上。
Alpha 混合与深度排序
体渲染按近到远顺序合成像素颜色 $C=\sum_i c_i(\omega)\alpha_i T_i$,其中 $T_i=\prod_{j<i}(1-\alpha_j)$ 是累积透射率。alpha 合成不可交换,所以渲染前必须对所有高斯按深度排序;排序是移动端渲染的主要瓶颈之一,也是本文深度序证书要规避的对象。
理解 alpha 合成的顺序敏感性,才能明白为什么 Mobile-GS 去排序会产生透明伪影,以及为什么本文不删排序、而是证明某些帧可以安全复用旧排序。
密度控制(Densification 与 Pruning)
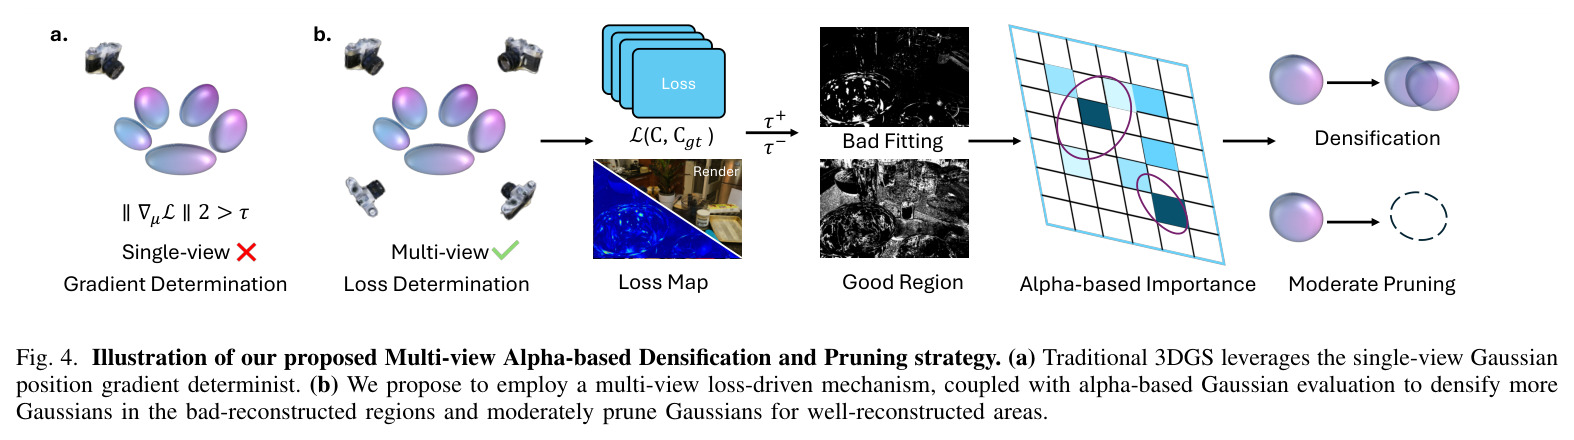
3DGS 训练期间的自适应策略:对位置梯度大的欠拟合高斯做克隆(clone)或分裂(split),删除低不透明度的冗余高斯(prune)。原版用单视角位置梯度 $\|\nabla_{\mu}\mathcal{L}\|>\tau$ 作判据,容易过拟合单视角噪声并导致基元数量膨胀。
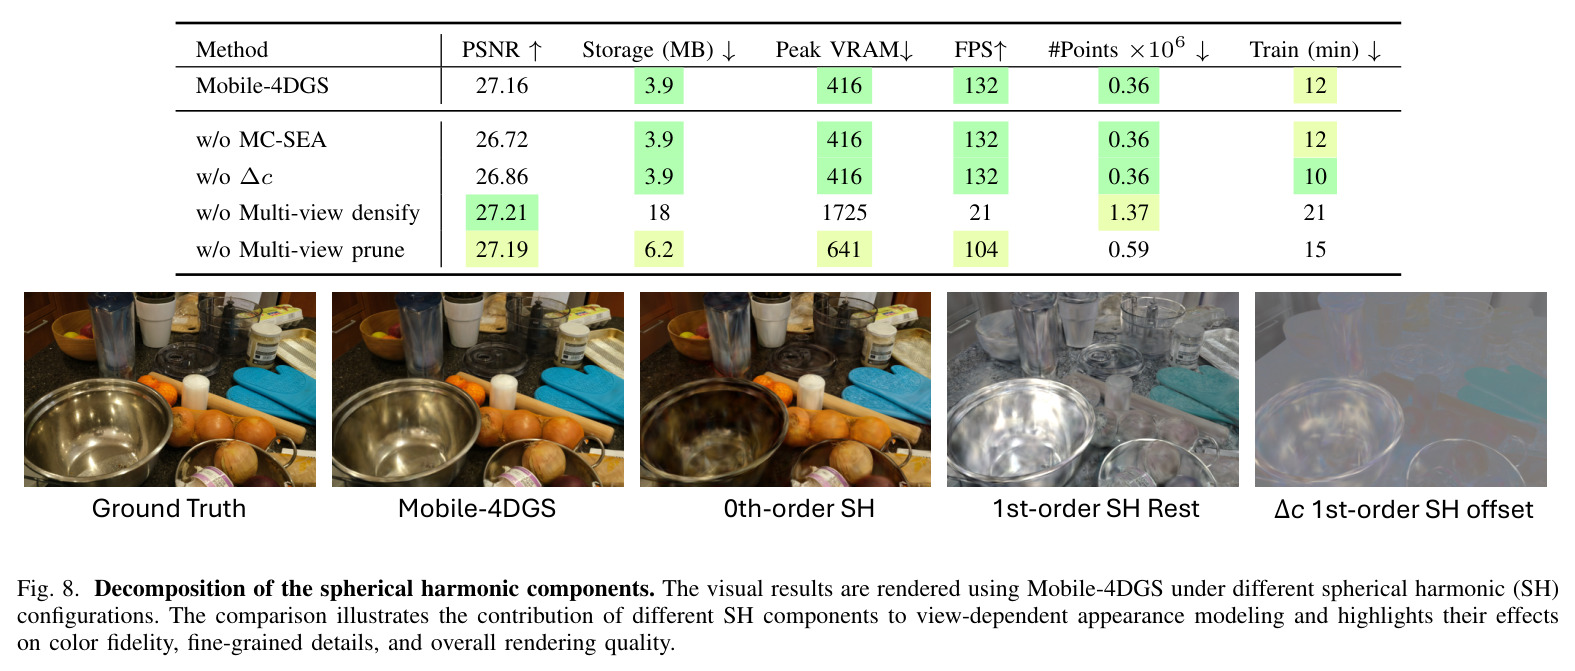
论文提出的多视角 alpha 密度控制是对这一机制的直接改造,消融表显示它贡献了最大的效率收益(点数 0.36M 对 1.37M、FPS 132 对 21)。
硬-具体松弛与直通估计器
把离散 0/1 变量松弛为可微随机变量的技巧:$s_i=\sigma((\ell_i+\log\frac{u}{1-u})/T)$,前向经 clamp 得到硬二值 $g_i=\mathbb{I}[\tilde{s}_i\ge 0.5]$,反向用 stop-gradient 把梯度送回连续值 $\tilde{s}_i$。温度 $T$ 退火使门从平滑逐渐变锐利,最终得到精确二值的静态/动态划分。
论文的静态-动态门控 $g_i$、整个 DOC 缓存机制都依赖『划分必须是精确二值』这一前提,不掌握 hard-concrete/STE 就无法理解划分如何既可训练又在推理时严格 0/1。
蒙特卡洛估计
用随机采样近似积分的方法:对定义在球面上的函数,均匀采样 $K$ 个方向后用样本均值估计其积分/矩,估计方差随 $K$ 增大按 $1/K$ 下降。本文用它把被丢弃的高阶 SH 残差在球面上采样并聚合成一阶方向矩 $E_{dir}=\frac{1}{K}\sum_k d_k\otimes E_{mag}$。
MC-SEA 是理解本文外观压缩的关键:为什么采样 $K=2048$ 个方向、为什么残差以能量+方向矩的形式保存,这些设计都来自蒙特卡洛估计的偏差-方差权衡。
研究动机
3DGS 在桌面 GPU 上可以实时渲染,但把静态与动态场景同时部署到资源受限的移动设备上时存在四个具体瓶颈。第一,外观建模普遍依赖三阶球谐(SH),每个高斯基元需要 48 个浮点系数(16 系数 × 3 通道),在百万级基元规模下,存储和光栅化时的内存带宽都难以承受——原版 3DGS 在 Mip-NeRF 360 室内/室外场景分别需要 478 MB 与 1361 MB 存储,量化后在手机上只有 11/5 FPS。第二,Mobile-GS、MEGS2 等轻量变体沿用单视角梯度式密度控制,容易过拟合并过度增殖基元,拖慢训练、增大存储与推理延迟。第三,主流 4D 方法(4D-GS、SC-GS 等)用 MLP 形变网络建模时间维度,回放时每帧都要做神经网络推理,Real-Time4DGS 在手机上仅 3 FPS 且需要 1701 MB 存储。第四,基元运动持续改变高斯间相对深度,缓存深度序不断失效,渲染器在播放时每帧都要重投影、重排序、合并并上传索引缓冲(每次 4N 字节),在移动端尤其昂贵。
本文的目标是本文的目标是构建一个统一的轻量级框架 Mobile-4DGS,让静态 3D 与动态 4D 高斯泼溅在商用手机 GPU(骁龙 8 Gen 3、iPhone 14 的 A15)上实现高保真实时渲染,同时把存储、基元数量、训练时间与每帧回放开销一并压下来。具体拆成四个可验证的子目标:其一,把视角相关外观压缩到一阶 SH(每通道仅 4 个系数)而不显著损失高光细节,且不需要昂贵的蒸馏或预训练;其二,用多视角一致的密度控制抑制冗余基元、避免点数膨胀;其三,用纯显式的时间参数(每高斯仅 8 个额外标量)取代逐帧形变网络,实现连续时间的 4D 建模;其四,让静态子集的深度序可整段缓存,并用闭式判据决定哪些回放帧可以复用已提交的绘制列表,从而跳过重投影、排序、合并与索引上传。静态场景被定义为零运动特例,两种模式共享同一套外观压缩、密度控制与渲染管线。
与已有工作不同的是,已有工作留下一个未解的矛盾:Mobile-GS 为了手机端吞吐率先抛弃排序、改用顺序无关渲染,但任意顺序的 alpha 合成在几何重叠区域产生透明伪影;Flux-GS 保留原排序获得更快渲染,却只支持静态场景。动态路线(4D-GS、HexPlane、4D-Rotor GS 等)则被逐帧神经网络推理和庞大的时间跟踪系数拖慢,难以在手机上实时。本文的独特切入是把『排序缓存』从一项独立工程变成表示本身的推论:学习到的门控恰好就是渲染器消费的二值静态/动态划分——静态流深度序只依赖相机、可整段缓存,动态流由显式二阶运动给出沿相机深度轴位移的闭式上界,进而导出一个深度序证书(DOC)判定已提交绘制列表是否仍有效。外观侧则不做蒸馏,而用蒙特卡洛方向矩直接把被丢弃的高阶 SH 能量折叠进一阶系数,把修正一次性烘焙进显式参数,保证推理零额外开销。
核心方法
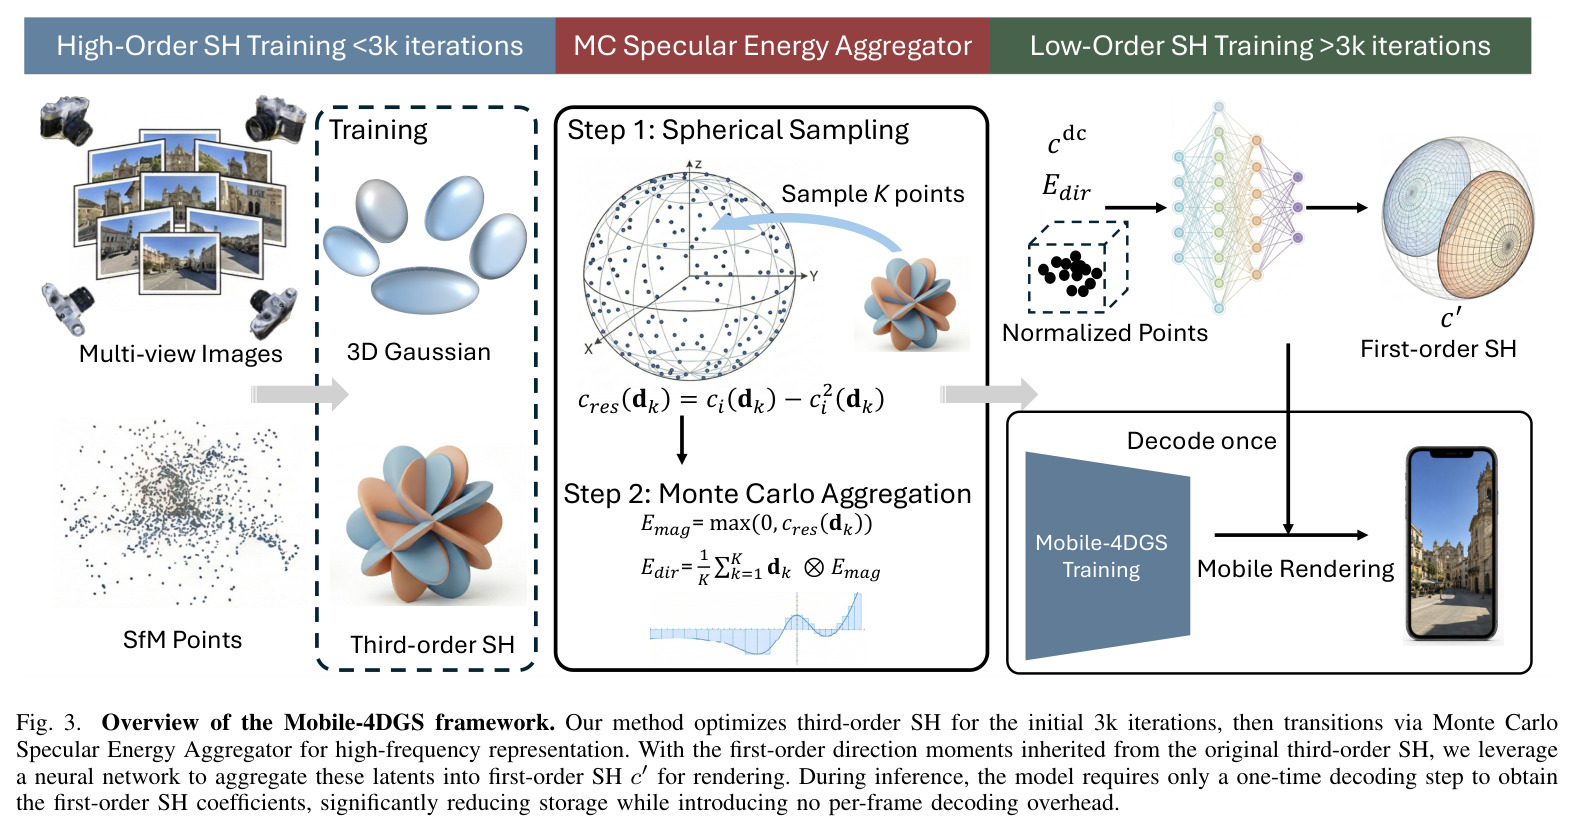
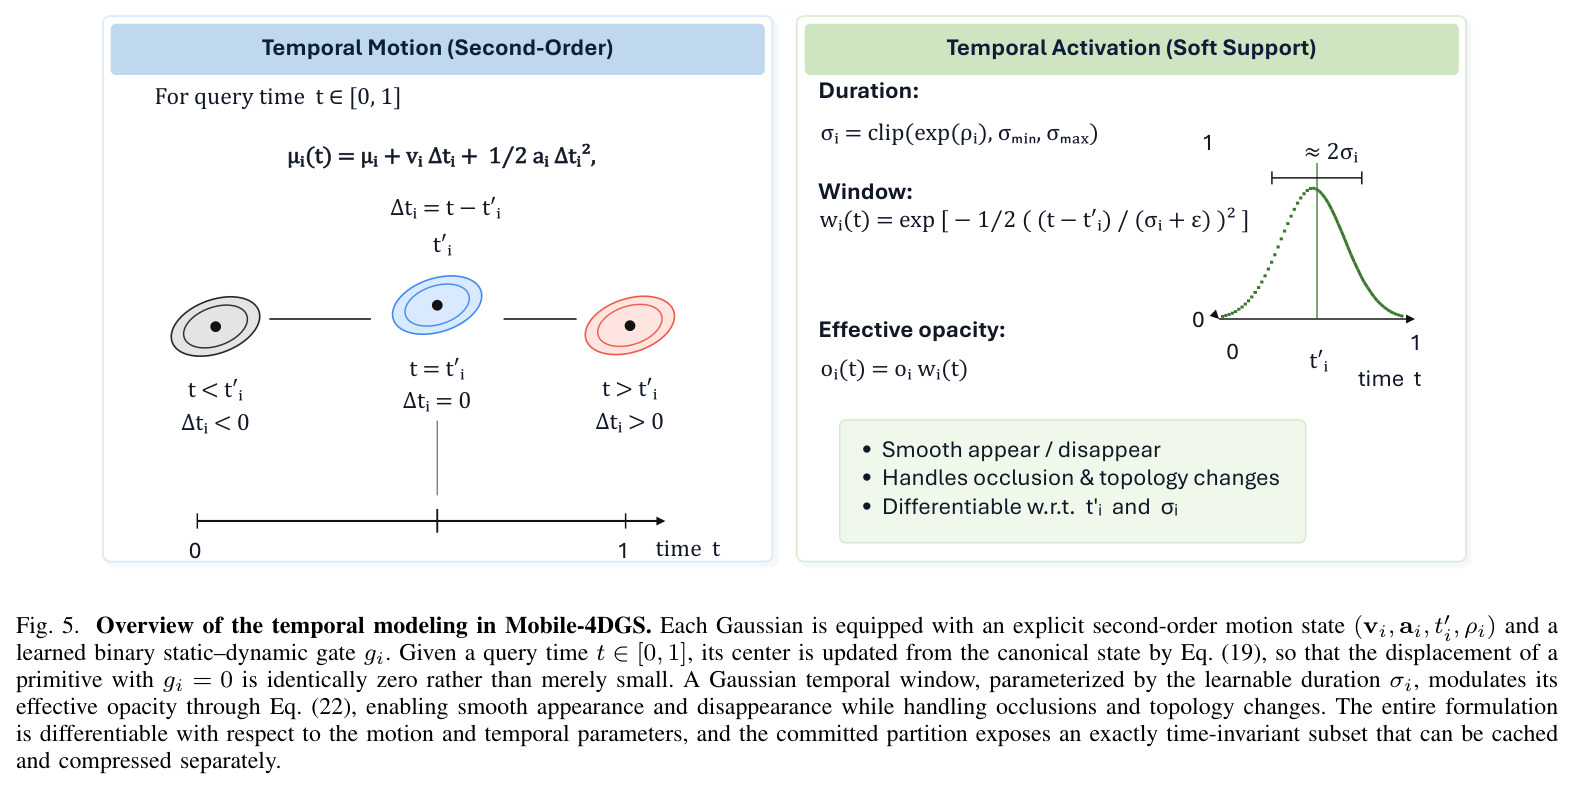
Mobile-4DGS 的整体思路是『训练时用高容量表示学习,部署时只留便宜的一阶显式参数,回放时用数学证书省掉排序』。训练课程上,先用完整三阶 SH 优化 3k 迭代建立高频表示;随后执行一次蒙特卡洛镜面能量聚合(MC-SEA),把三阶 SH 中被丢弃的镜面残差压缩成一阶 SH;再由属性条件 SH 增强模块(一个 4 层 MLP)预测残差偏移 $\Delta c$,并在推理前把偏移静态烘焙进高斯参数,使增强的视角相关建模不引入任何推理开销。几何侧提出多视角 alpha 密度控制:分层相机采样加 alpha 加权误差累计,指导克隆/分裂与温和剪枝,保持多视角结构一致性。动态侧把每个高斯扩展为带速度 $v_i$、加速度 $a_i$、规范时间 $t'_i$ 与对数时长 $\rho_i$ 的二阶运动系统,配合可学习软时间窗与硬-具体二值门 $g_i$,静态即 $g_i=0$ 的零运动特例,整条时间轴连续可微且推理时无需任何网络。渲染端用 WebGL 实现跨平台浏览器播放器,静态/动态两流分别做 16 位深度键的稳定计数排序后双指针合并,由深度序证书决定帧级复用,通过检验的帧完全跳过重投影、排序与索引上传。
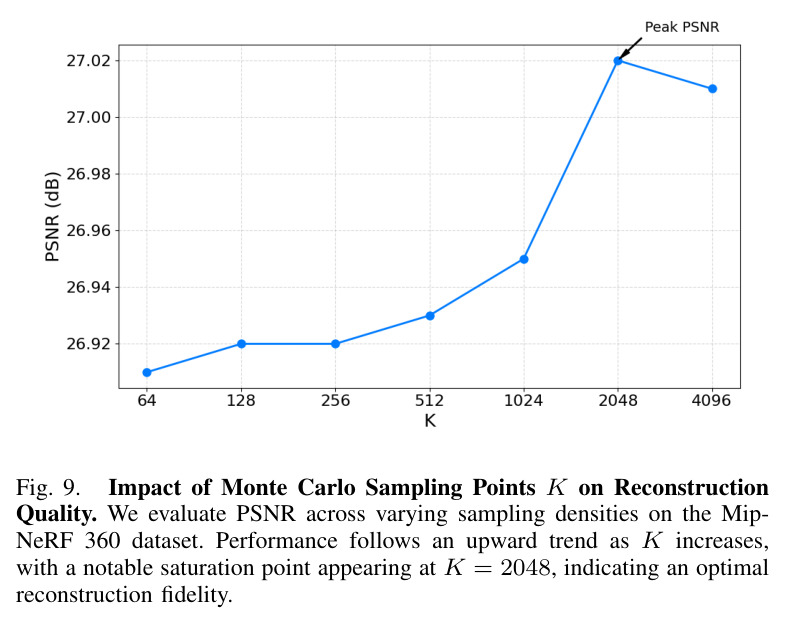
核心创新是四条互相咬合的洞察。其一,视角相关辐射在角域高度稀疏,高阶 SH 拟合尖锐镜面瓣需要大量系数相互抵消振铃,因此不必保留整个高阶空间:对每个高斯在单位球均匀采样 $K=2048$ 个方向,计算三阶与二阶 SH 的光度残差,聚合出能量 $E_{mag}$ 与方向矩 $E_{dir}$,再由小型 MLP 映射成一阶 SH——保留了残差的幅度与主导方向,且与蒸馏法不同,只在训练中执行一次、推理零开销。其二,密度控制应以多视角 alpha 贡献为准:单视角位置梯度缺乏场景级结构共识,分层多视角采样下的误差图与 alpha 加权累计能区分『多视角一致差』与『单视角遮挡噪声』。其三,动态建模的关键不是网络而是划分:硬-具体松弛学出的精确二值门 $g_i$ 让静态子集严格时不变、可缓存;动态子集用 8 个标量的二阶多项式轨迹加高斯时间窗建模平滑出现/消失,处理遮挡与拓扑变化。其四,DOC 把运动界 $|z_i(t)-z_i(t_c)|\le\Delta z(t)$ 转化为量化深度键空间的判据 $2M(t)<g_{\min}$,通过检验的帧在 16 位量化序意义下逐位不变地复用旧绘制列表,复用帧的通信量从 4N 字节降到 $O(1)$。
方法步骤详情
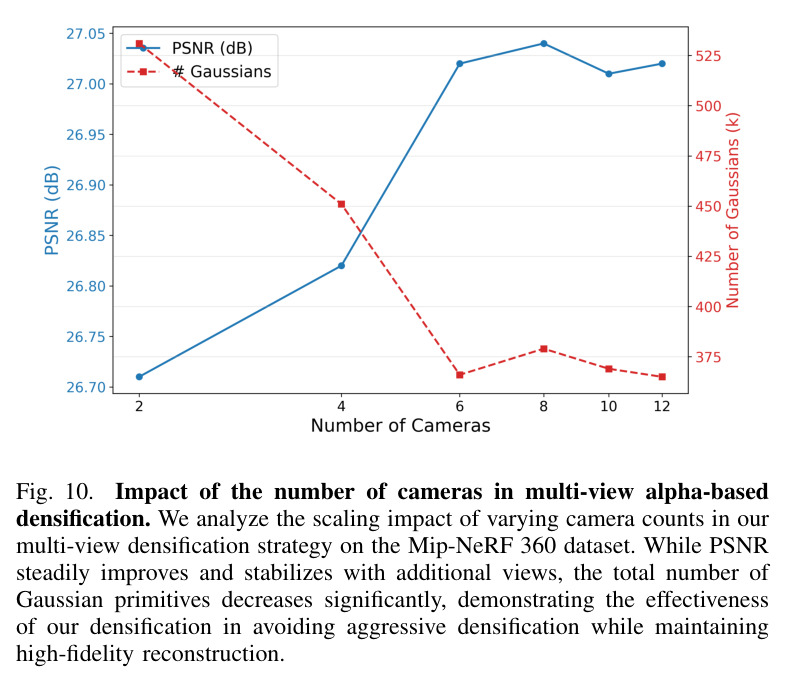
完整流程分六步。第一步,从 SfM 点初始化高斯,前 3k 迭代用三阶 SH 与混合损失 $\mathcal{L}=(1-\lambda)\mathcal{L}_1+\lambda\mathcal{L}_{DSSIM}$ 训练。第二步(MC-SEA):在单位球面均匀采样 $K=2048$ 个方向 $d_k$($\phi_k\sim U(0,2\pi)$,$\theta_k=\arccos(1-2\xi_k)$),计算残差 $c_{res}(d_k)=c_i(d_k)-c^2_i(d_k)$,聚合为 $E_{mag}=\max(0,c_{res}(d_k))$ 与 $E_{dir}=\frac{1}{K}\sum_k d_k\otimes E_{mag}$;归一化位置 $f(\hat\mu)$ 与基础色 $c_{dc}$(0 阶 SH)一起送入两个单隐层(64 神经元)MLP 得到一阶 SH 系数 $c'=\Psi(c_{dc},E_{dir},f(\hat\mu))$,此映射只执行一次。第三步(增强):4 层 MLP(128/64/32/12)$\Phi$ 以 $[\mu_i,\hat{s}_i,r_i,o_i,\hat{c}'_i]$ 为输入预测 $\Delta c_i=\Phi(\cdot)$,末层零初始化使训练初期自然回退到标准 3DGS,偏移在部署前烘焙进显式参数。第四步(多视角密度控制):对相机位置解最小二乘 $\sum_i P_i x^*=\sum_i P_i t_i$ 求场景中心,按方位角/仰角分箱采样 6 个代表性视角;渲染得误差图 $M^+$($\tau^+=0.1$)与 $M^-$($\tau^-=0.01$),自定义 CUDA kernel 累计每高斯 $S^+_i=\sum\alpha_i M^+$ 与 $S^-_i=\sum L\alpha_i M^-$;克隆/分裂掩码与 $S^+$ 的 0.6 分位取交,剪枝要求 $o_i<o_{\min}$ 且 $S^-_i$ 超过 0.1 分位。第五步(动态与划分):hard-concrete 门温度从 $T_{init}=2.0$ 退火到 $T_{final}=0.1$,稀疏损失 5k–20k 渐入、二值损失 22k 启动、25k 提交并冻结划分;运动证据 EMA 每 500 迭代按 0.995 分位晋升(每步至多 1%,晋升不可逆),配合 $\mathcal{L}_{acc},\mathcal{L}_{dur},\mathcal{L}_{ext}$ 正则与时间分箱密度控制;时间向量 $[v_i,a_i,t'_i,\rho_i]\in\mathbb{R}^8$ 用码本量化并熵编码,且在静态量化之后单独进行。第六步(回放):16 位深度键 $q_i=\text{clip}(\kappa(z_i-z_{\min}),0,B-1)$、两流稳定计数排序加双指针合并;DOC 检验 $2M(t)<g_{\min}$(精确证书)或 $M(t)\le\lceil\kappa r\bar{s}\|n\|_2\rceil$(预算分支,默认 $r=0.5$ 个平均半径),通过则整帧 $O(1)$ 复用。
技术新颖性
与最近邻工作的本质区别有三处。外观压缩方面:Mobile-GS 依赖从高阶教师蒸馏 SH,训练慢且流程复杂;CompGS/HAC 等压缩法侧重码本与熵编码;而 MC-SEA 把压缩对象定位在『被丢弃高阶带的角域能量矩』上,用一次性蒙特卡洛投影加属性条件 MLP 补残差,免蒸馏、免预训练,偏移烘焙后推理零开销。动态表示方面:4D-GS/SC-GS/Deformable-3DGS 以 MLP 形变为核心,每帧需网络推理;本文用显式二阶多项式轨迹($v_i,a_i$)加可学习时间支撑($t'_i,\rho_i$),整条时间轴连续可微但推理只是二次多项式求值,并首次把『静态/动态划分』本身作为可学习对象与渲染器共享——划分既是压缩结构(静态基元不占时间码本容量,共享一个解码为零运动的索引)也是排序缓存结构。回放系统方面:StopThePop/FlashGS 解决 tile 内深度问题但仍逐帧排序;本文的 DOC 由表示本身导出,是带精确性证明(16 位量化序意义下 $\pi_c=\pi(t)$,用反证法借助 Cauchy–Schwarz 与三角不等式)的帧级复用机制,预算分支又给出 $r=0.5$ 半径级的实用松弛。此外静态与时间量化分阶段进行,避免两类压缩误差互相干扰。这套『表示即缓存』的设计把算法贡献与移动端系统工程拧成一体,是它区别于以往排序加速或动态建模工作的关键。
实验结果
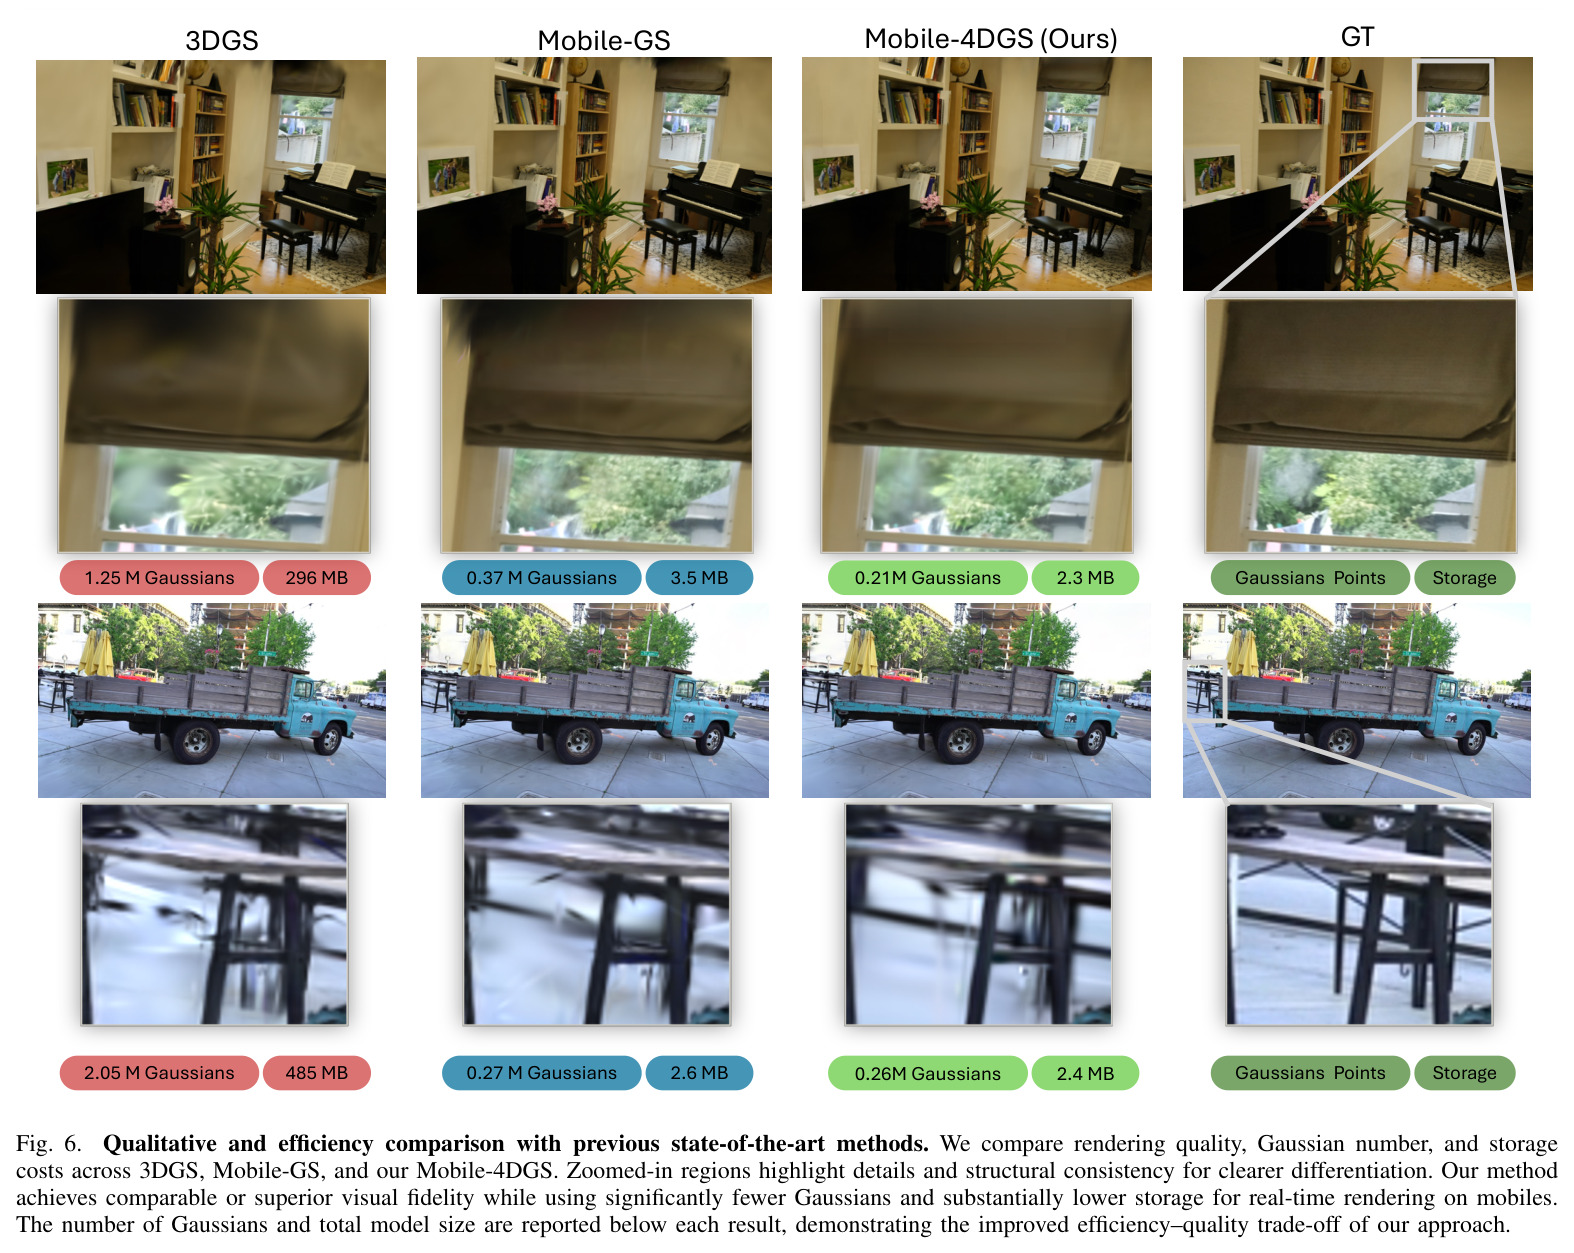
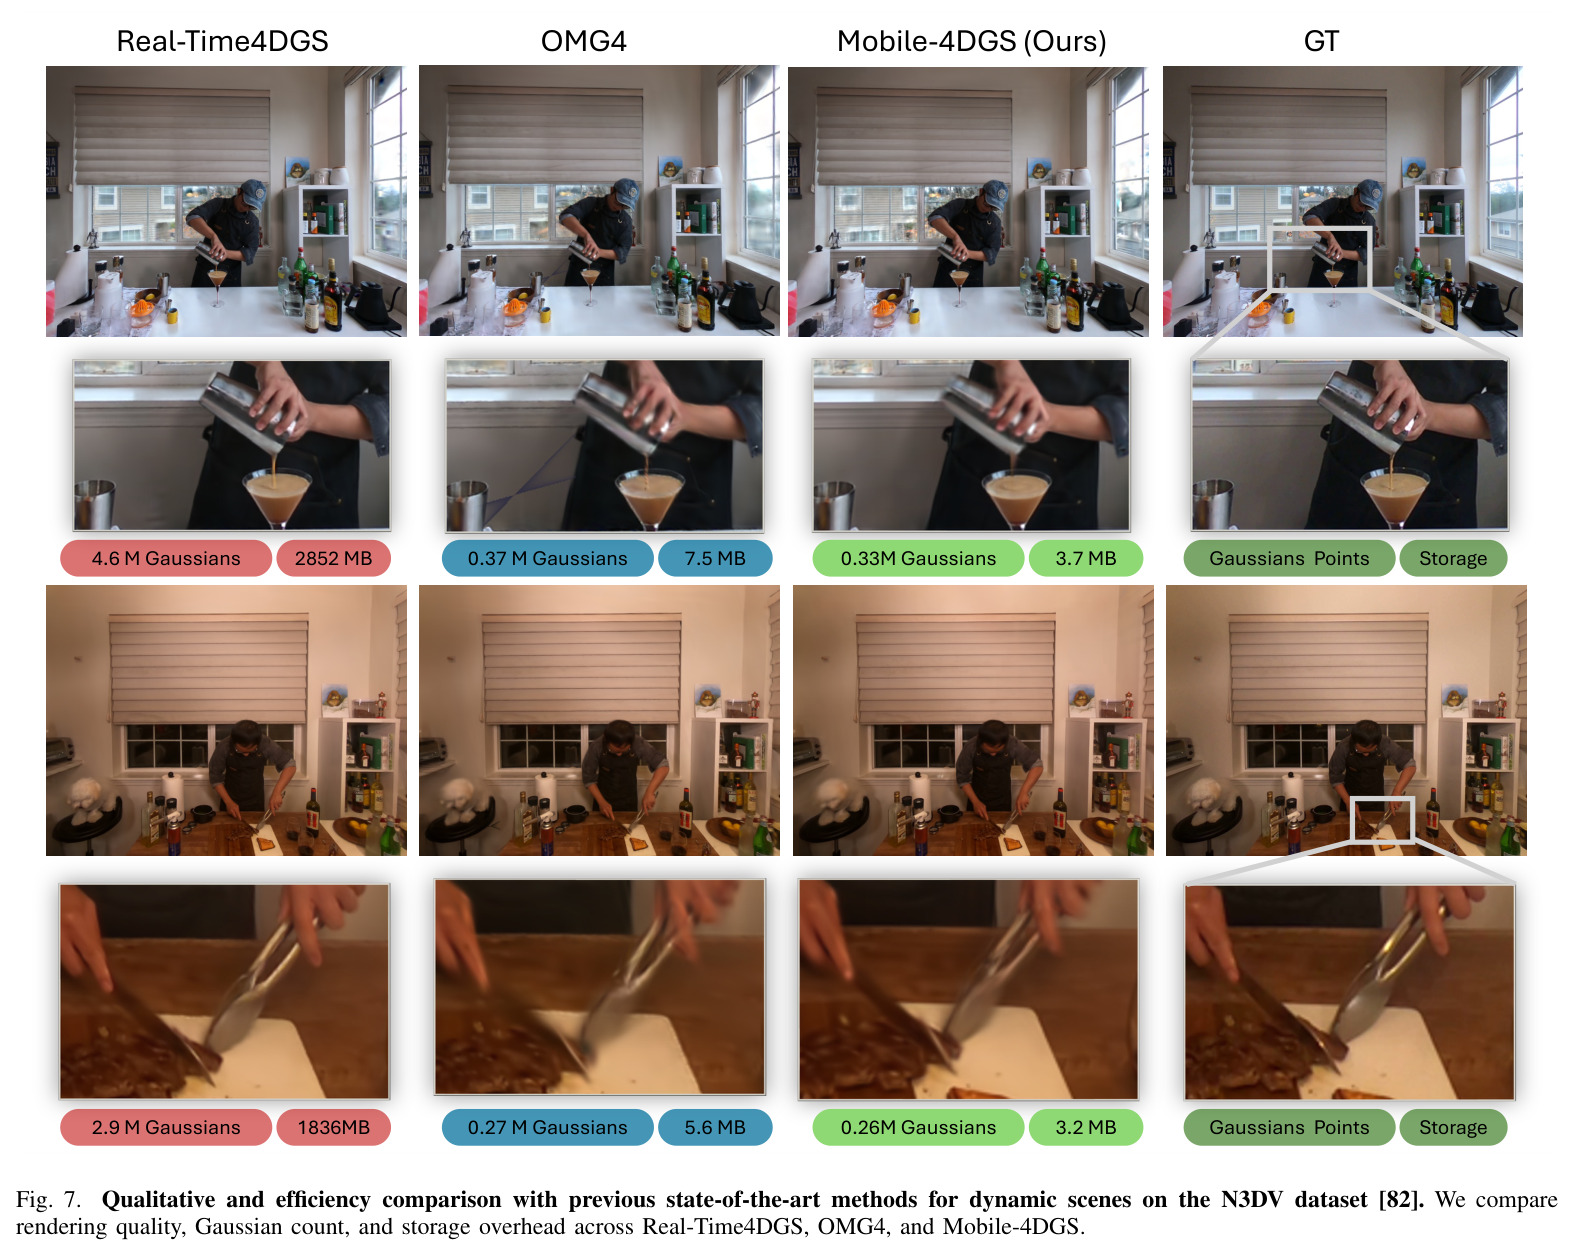
静态场景(骁龙 8 Gen 3 真机、offscreen 基准协议):在 Mip-NeRF 360 上,Mobile-4DGS 室内 PSNR 30.47 为全表最高,超过 3DGS 的 30.41 与 Mobile-GS 的 30.37,同时高斯数仅 0.27M、存储 2.8 MB、143 FPS、训练 12 分钟(Mobile-GS 需 86 分钟、Flux-GS 11 分钟);室外 24.42 PSNR / 0.46M 高斯 / 4.3 MB / 130 FPS,训练时间比 Mobile-GS 快约 11 倍。Tanks&Temples 上 PSNR 23.83 显著超过 3DGS 的 23.14(+0.69 dB)与 C3DGS 的 23.32,存储从 358.7 MB 降至 3.2 MB;Deep Blending 达 29.92 PSNR / 2.2 MB / 151 FPS。动态场景(iPhone 14,A15 芯片):N3DV 上 SSIM 0.945,与 OMG4 的 0.942 相当、略低于 Real-Time4DGS 的 0.949,但 FPS 达 47(对比 3 与 12,约为 OMG4 的 3.9 倍),存储 3.8 MB 为三者最小,训练 62 分钟不到 OMG4(417 分钟)的 1/6。消融实验证实每个组件都有正贡献:去掉 MC-SEA,PSNR 从 27.16 掉到 26.72;去掉 $\Delta c$ 掉到 26.86;去掉多视角致密化,点数从 0.36M 暴涨到 1.37M、峰值显存 416→1725 MB、FPS 132→21;去掉多视角剪枝,存储 3.9→6.2 MB、FPS 132→104。DOC 消融(200K 高斯、8.1% 动态、6 秒 60Hz 片段):单流整体排序每秒 worker 开销 124.7 ms、索引上传 23.2 MB/s;仅两流分离即降到 81.3 ms/s;$r=0.5$ 时复用率 81.0%、开销降到 13.9 ms/s(−83%)与 4.4 MB/s(−83%);60Hz 高频请求下复用率达 90.2%、排序开销 −82%。超参分析显示蒙特卡洛采样点 $K$ 从 64 到 2048 时 PSNR 单调上升、4096 后饱和,故取 $K=2048$;多视角相机数从 2 增到 6 时 PSNR 显著提升且高斯总数明显下降,故取 6 视角。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 静态新视角合成 · Mip-NeRF 360 室内(骁龙 8 Gen 3 真机渲染) | PSNR / 存储 / FPS / 训练时长 | 30.47 / 2.8 MB / 143 FPS / 12 min | 3DGS:30.41 / 478 MB / 11 FPS(量化版)/ 27 min;Mobile-GS:30.37 / 3.5 MB / 131 FPS / 86 min | PSNR 全表最高(超 3DGS 0.06 dB),存储较 3DGS 降低约 99.4%,FPS 较 Mobile-GS 提升 9%,训练快约 7 倍 |
| 静态新视角合成 · Mip-NeRF 360 室外(骁龙 8 Gen 3 真机渲染) | PSNR / 存储 / FPS / 训练时长 | 24.42 / 4.3 MB / 130 FPS / 12 min | Mobile-GS:24.51 / 5.5 MB / 114 FPS / 136 min;3DGS:24.61 / 1361 MB / 5 FPS(量化版) | 存储降低约 22%、FPS 提升 14%、训练快约 11 倍(PSNR 略低 0.09–0.19 dB) |
| 静态新视角合成 · Tanks&Temples | PSNR / SSIM / LPIPS / 存储 / FPS | 23.83 / 0.836 / 0.216 / 3.2 MB / 132 FPS | 3DGS:23.14 / 0.841 / 0.183 / 358.7 MB;C3DGS:23.32 / 0.831 / 0.202 / 21.8 MB | PSNR 超 3DGS 0.69 dB、超 C3DGS 0.51 dB,存储降至 3DGS 的约 1/112 |
| 静态新视角合成 · Deep Blending | PSNR / SSIM / LPIPS / 存储 / FPS | 29.92 / 0.902 / 0.272 / 2.2 MB / 151 FPS | 3DGS:29.41 / 0.903 / 0.243 / 697.3 MB;Mobile-GS:29.93 / 0.906 / 0.243 / 4.6 MB | PSNR 超 3DGS 0.51 dB、存储降至约 1/317,与 Mobile-GS 质量持平但存储减半、训练快 6 倍 |
| 动态场景渲染 · N3DV(iPhone 14,A15 芯片) | SSIM / SH 阶数 / FPS / 高斯数 / 存储 / 训练时长 | 0.945 / 1 / 47 / 285,707 / 3.8 MB / 62 min | Real-Time4DGS:0.949 / 3 / 3 / 2,770,350 / 1701 MB / 374 min;OMG4:0.942 / 3 / 12 / 283,297 / 5.8 MB / 417 min | FPS 为 OMG4 的 3.9 倍、Real-Time4DGS 的约 15.7 倍;存储最小;训练最快(约为 OMG4 的 1/6.7) |
| 4D 回放深度排序开销(DOC 消融,200K 高斯、8.1% 动态、6s@60Hz) | 每秒 worker 排序时间 / 索引上传 / 深度序复用率 | r=0.5:13.9 ms/s / 4.4 MB/s / 81.0% 复用;60Hz 请求下复用率 90.2%、14.7 ms/s | 单流整体排序(Monolithic):124.7 ms/s / 23.2 MB/s / 0% 复用;两流分离:81.3 ms/s | 排序时间降低 83%、索引流量降低 81%;r=0 精确证书也可使 worker 开销比单流降 28% |
局限与改进
作者明确承认的局限:本文不以在所有无约束重建指标上全面领先为目标,而是追求保真度、模型大小、训练成本与真机吞吐的权衡;精确 DOC($r=0$)非常保守,实测复用率仅 0.6%,因此默认采用允许有界深度序漂移的预算分支($r=0.5$ 时漂移达 0.44 个平均半径,$r=1$ 时 1.28);静态深度序缓存只在相机深度映射(视线方向 $n$ 与深度范围 $[z_{\min},z_{\max}]$)不变时有效,视角剧烈变化需整表重算,容差式相机变化测试不属于精确保证。我自己的补充观察:其一,室外场景 PSNR(24.42)仍低于原版 3DGS(24.61),T&T 的 LPIPS(0.216)略逊于 Mobile-GS(0.208),说明一阶 SH 加烘焙偏移在强镜面与感知细节上仍有损失;其二,协方差与颜色随时间恒定的假设限制了剧烈拓扑变化、大遮挡动态内容的表达;其三,所有训练都在 RTX 4090 上完成(动态场景 62 分钟),移动端只负责播放,无法在端侧即时重建;其四,offscreen 基准绕过了 120 FPS 显示上限与 UI 开销,真实屏幕合成帧率会受显示管线约束,论文标题中的实时性在真机完整链路上打了折扣;其五,DOC 的界依赖全体动态高斯的最大速度 $V$ 与最大加速度 $A$ 全局标量,少数高速基元会显著压低所有帧的复用率。
独立分析的弱点
独立分析出的弱点及改进方向:第一,外观模型对动态或复杂光照表达能力有限——$\Delta c$ 与相机视角无关且静态烘焙,遇到随时间变化的高光(水面反光、屏幕闪烁)会系统性欠拟合,可引入时间条件化的轻量偏移或按高斯聚类的方向码本。第二,二阶多项式轨迹隐含平滑运动先验,对突发的快速运动(挥手、跳跃、掉落)会产生运动拖尾与重复边缘,论文自己也要用 $\mathcal{L}_{ext}$ 来抑制;可改为分段三次样条或关键帧锚定的局部轨迹,配合运动分段检测自动切换。第三,DOC 的 $V,A,t'_{\min},t'_{\max}$ 是全局标量上界,一个高速高斯就能让所有帧都无法通过精确证书($r=0$ 复用率仅 0.6% 即是证据);可按空间簇或深度带计算局部界,把检验粒度从整帧降到簇级,让慢速区域照常复用。第四,训练流程有较多手调阶段(3k 切换 SH、5k–20k 稀疏渐入、22k 二值化、25k 提交划分、温度退火),对超参敏感且不利于被其他框架直接采用;可研究基于约束求解或自适应调度的自动课程。第五,静态子集仍有约 0.3M 基元与 2–4 MB 存储,要进入 1 MB 级需要与神经上下文熵模型或 2D 高斯化结合。第六,WebGL 管线绑定浏览器生态,原生 AR/VR 运行时(OpenXR)的移植、注视点渲染与多场景流式加载尚未覆盖。
未来方向
作者在结论中把该框架定位为『移动端新视角渲染与体视频回放的实用基础』,未来可自然延伸的方向包括:把静态/时间码本与神经上下文熵模型(如 HAC++ 一类方法)结合,把单场景存储压进 1 MB 级;轻量化训练管线以支持手机端或边缘端的即时重建与增量更新,摆脱对 RTX 4090 的依赖;把二阶运动门扩展为对象级或语义级划分,实现移动端 4D 编辑、物体操控与生成式内容更新;把 DOC 从整帧粒度推广到分块/LOD 大场景,结合流式加载支持城市级漫游,并把精确证书与异步预排序结合进一步隐藏延迟;探索注视点渲染下的排序预算自适应,让预算分支的 $r$ 随注视区域动态调整;把统一管线移植到 WebXR/OpenXR 服务 AR 导航、VR 会议等产品形态。此外,多视角 alpha 密度控制本身是正交贡献,可以嫁接到其他加速或压缩框架(如 Taming 3DGS 的预算约束、3DGS-MCMC 的训练范式)中,其与随机化训练的兼容性值得单独研究。
复现评估
复现条件总体友好。代码已在项目页开源(https://xiaobiaodu.github.io/mobile-4dgs-project/);四个评测数据集(Mip-NeRF 360、Tanks&Temples、Deep Blending、N3DV)全部公开;训练只需单张 RTX 4090,静态 12 分钟、动态 62 分钟(30k 迭代),是普通实验室可负担的算力级别。论文给出了较完整的超参数:$K=2048$、$\tau^\pm=0.1/0.01$、分位数 $0.6/0.1$、6 视角采样、两个映射 MLP(单隐层 64 神经元)与增强 MLP(128/64/32/12)结构、门温度退火 2.0→0.1、划分 25k 提交、晋升检查 0.995 分位且每步至多 1%、DOC 默认 $r=0.5$ 等,并有明确的训练课程时间线,算法 1 也给出了回放伪代码。主要风险在移动端工程侧:自定义 CUDA kernel(alpha 加权误差累计)、16 位深度键加稳定计数排序、WebGL/WebWorker 异步渲染、offscreen 基准协议都依赖实现细节,DOC 的位精确性声明更是严格绑定这些实现选择(例如稳定排序的行号决胜规则、量化分阶段先静态后时间的顺序)。总体难度中等:算法与实验部分可直接跟随论文复现,渲染器部分需要一定的图形学与移动端开发经验。
论文图表
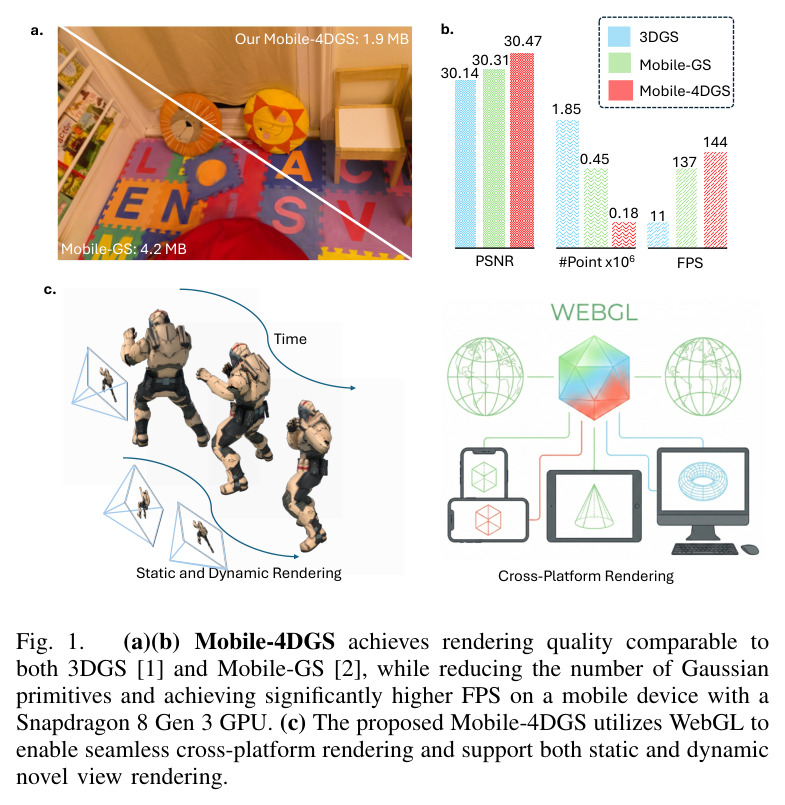
论文首页导图。左侧展示静态与动态渲染效果对比;中间柱状图给出三者在骁龙 8 Gen 3 GPU 上的量化对比:Mobile-4DGS 模型仅 1.9 MB(Mobile-GS 为 4.2 MB),PSNR 30.47(3DGS 30.14、Mobile-GS 30.31),高斯数 0.18M(Mobile-GS 0.45M、3DGS 1.85M),FPS 达 144(Mobile-GS 137、3DGS 11);右侧说明基于 WebGL 的跨平台渲染,同一管线同时支持静态与动态新视角渲染。
一图概括全文核心承诺:更少的基元、更小的模型、手机上显著更高的帧率,且静态/动态统一。快速把握论文卖点和量级都靠这张图。
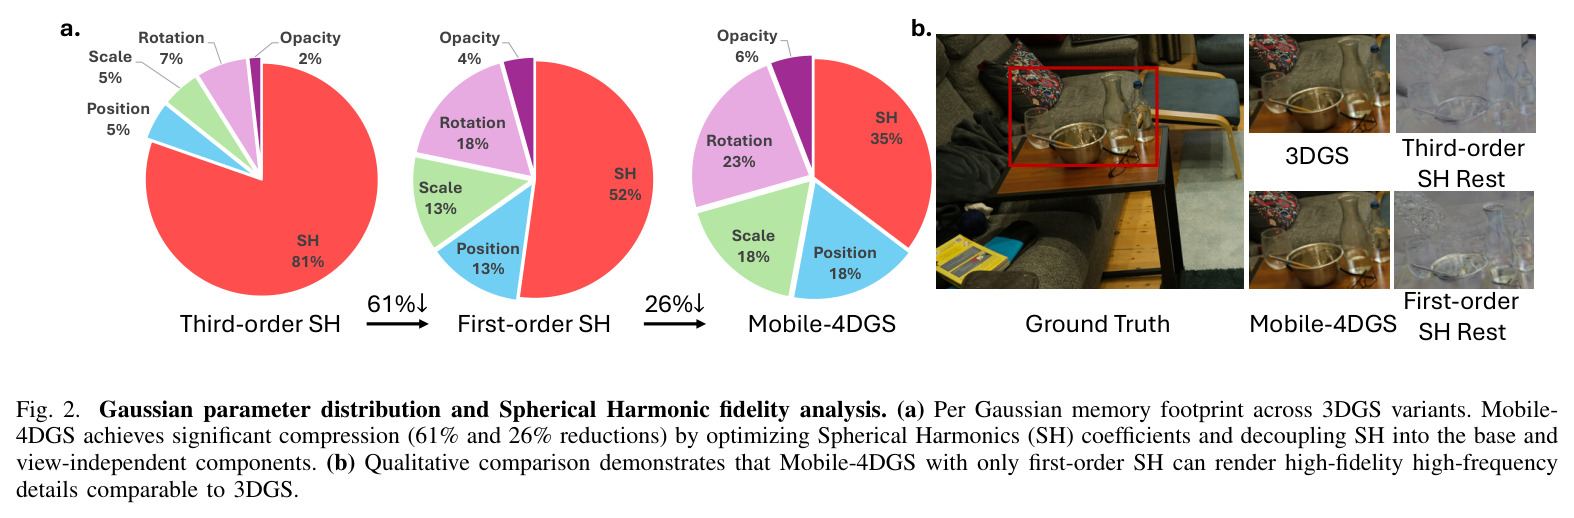
(a) 用饼图分解 3DGS、三阶 SH 变体与 Mobile-4DGS 的每高斯内存构成:原版中三阶 SH 占存储大头,Mobile-4DGS 把 SH 解耦为基础分量与视角相关分量后,SH 内存相对三阶基线降低 61% 与 26%,其余属性(位置 23%、尺度 18%、旋转 13% 等)占比相应上升。(b) 定性对比显示仅用一阶 SH 的 Mobile-4DGS 渲染的高频细节与完整 3DGS 相当。
这是论文动机的直接证据:SH 系数是存储瓶颈的主要来源,也是『一阶 SH 是否够用』这一核心问题的可视化回答。
对比两种回放帧的代价:提交帧(committed)需要 worker 端 $O(N+B)$ 的投影、排序与合并,主线程 $O(N)$ 的索引上传,负载 4N 字节;复用帧(reused)只需 $O(1)$ 的证书校验,无索引上传、负载 $O(1)$。计数排序的 $B=2^{16}$ 划痕空间跨帧复用,静态流仅在相机深度映射变化时重投影重排序。
量化了 DOC 带来的渐进复杂度收益:从每帧线性开销到常数开销,是理解 4D 回放为何能在手机上实时的关键表格。
在 Mip-NeRF 360 上按室内/室外子集对比 3DGS、3DGS*(Huffman 量化版)、Speedy-Splat、C3DGS、LocoGS-S、Mobile-GS/Mobile-GS*、Flux-GS 与本文,指标含 PSNR、#G、存储、FPS、训练时长。室内:本文 30.47 PSNR / 0.27M / 2.8 MB / 143 FPS / 12 min,PSNR 全表最高;室外:24.42 / 0.46M / 4.3 MB / 130 FPS / 12 min。原版 3DGS 存储高达 478/1361 MB,量化后仅 11/5 FPS。
静态场景的主结果表,完整呈现本文在质量-存储-速度-训练时间四维权衡上相对所有轻量基线的位置。
在 Tanks&Temples 与 Deep Blending 上对比 PSNR/SSIM/LPIPS/存储/FPS/训练时长:本文 T&T 23.83/0.836/0.216/3.2 MB/132 FPS/12 min,PSNR 超 3DGS 0.69 dB;DB 29.92/0.902/0.272/2.2 MB/151 FPS/12 min。基线中 3DGS 存储 358.7/697.3 MB 且无手机 FPS,LocoGS-S 存储最小(6.8/7.8 MB)但仍数倍于本文。
补齐两个标准真实场景基准,证明压缩思路不只在 Mip-NeRF 360 有效,且在 T&T 上出现罕见的『压缩后反超原版 3DGS』现象。
动态场景主结果:Real-Time4DGS SSIM 0.949 但需 2.77M 高斯、1701 MB、仅 3 FPS、训练 374 min;OMG4 SSIM 0.942、12 FPS、5.8 MB、417 min;本文 SSIM 0.945、SH 仅 1 阶、47 FPS、285,707 高斯、3.8 MB、训练 62 min——FPS、存储、训练时间三项全部最优,质量居中。
支撑『连续时间动态渲染可以用几 MB 的模型在手机硬件上部署』这一核心论断的唯一动态场景定量表格。
组件消融(PSNR/存储/峰值显存/FPS/点数/训练时长):完整模型 27.16/3.9 MB/416 MB/132 FPS/0.36M/12 min;去 MC-SEA 掉至 26.72;去 $\Delta c$ 掉至 26.86(训练还缩短到 10 min);去多视角致密化则点数暴涨到 1.37M、显存 1725 MB、FPS 骤降 21、训练 21 min;去多视角剪枝存储 6.2 MB、FPS 104。
逐一量化四个组件的贡献,特别是揭示多视角致密化对效率的压倒性影响与 MC-SEA/$\Delta c$ 对质量的互补贡献。
DOC 策略消融:Monolithic 0% 复用、124.7 ms/s、23.2 MB/s;两流分离降至 81.3 ms/s;精确证书 r=0 复用率仅 0.6%、104.1 ms/s(+28%);r=0.25 复用 65.5%、25.8 ms/s(−68%);r=0.5 复用 81.0%、13.9 ms/s(−83%)、4.4 MB/s、漂移 0.44;r=1 复用 90.2%、7.2 ms/s(−91%)、漂移 1.28;60Hz 高频请求下 r=0.5 复用率达 90.2%、14.7 ms/s(−82%)。
唯一量化『精确性-效率可调权衡』的表格:展示了复用率、排序开销与深度序漂移随预算 r 的完整曲线,是 DOC 模块的核心证据。