在推理型大语言模型中摊销序列实验设计 Amortizing Sequential Experimental Design in Reasoning LLMs
用信息增益奖励做强化学习,把序列贝叶斯实验设计摊销进 LLM 的推理过程,习得可泛化的提问策略
前置知识
贝叶斯实验设计(BED)
一种用生成模型 $p(\theta, y \mid x) = p(\theta)\,p(y \mid \theta, x)$ 来量化实验价值的框架:先验 $p(\theta)$ 表示对未知量 $\theta$ 的初始信念,似然 $p(y \mid \theta, x)$ 描述执行实验 $x$ 后观察到结果 $y$ 的概率。框架通过期望信息增益为每个候选实验打分,选出信息量最大的实验,观察结果后用贝叶斯后验 $p(\theta \mid y, x)$ 更新信念并迭代。诊断场景中 $\theta$ 是病人潜在疾病、$x$ 是检查项目、$y$ 是检查结果。
本文的整个目标就是把『每一步选信息量最大的实验』这一昂贵的在线流程一次性训练进 LLM,BED 是读懂其目标函数与奖励设计的语言。
期望信息增益(EIG)
衡量设计 $x$ 预期能带来多少关于 $\theta$ 的信息:$\mathrm{EIG}(x) = \mathbb{E}_{p(\theta)p(y|\theta,x)}[\log p(y \mid \theta, x) - \log p(y \mid x)]$,即观测 $y$ 前后不确定度的期望缩减。它涉及外层对 $\theta$ 与 $y$ 的期望、内层对预测分布 $p(y \mid x)$ 的边缘化,是『双重难处理』的量:序列设定下每步还要重新估计后验,实时决策时代价极高。
本文把 EIG 直接作为 RL 训练奖励,并利用有限可枚举的假设/答案空间把它精确算出(Rao-Blackwell 化),这是方法的核心机制。
摊销与深度自适应设计(DAD / sPCE)
摊销指把推理时的重复优化代价转移到训练阶段:训练策略 $\pi_\phi(x_t \mid h_{t-1})$ 直接从交互历史映射到下一个设计,部署时无需后验估计与 EIG 优化。Foster 等的 DAD 证明整条轨迹的总 EIG 等于各步条件 EIG 之和,并提出 sPCE 下界,用从先验采样的对比假设集近似边缘轨迹似然,$L \to \infty$ 时下界变紧。
本文继承 sPCE 的对比集构造,但把『每条轨迹重采样对比集』改为『固定对比集 + 均匀先验』,这是理解其生成模型设计的关键差异点。
GRPO 与可验证奖励强化学习(RLVR)
GRPO(Group Relative Policy Optimization)出自 DeepSeekMath:对同一状态采样一组 rollout,用组内相对回报充当优势信号更新策略,无需学习 critic 值函数。RLVR 指用可自动计算或验证的奖励(数学答案对错、信息增益等)做强化学习,避免依赖昂贵或主观的奖励模型。
本文用 GRPO + 信息增益奖励训练推理 LLM;只有理解组内相对优势机制,才能明白 $K$ 步信息回报如何把信用回传给第一步的推理与提问决策。
Rao-Blackwell 化
统计学中的方差缩减技术:把估计量对部分随机变量取条件期望,所得估计量期望不变、方差不增。本文利用假设空间 $\Theta_C$ 与答案空间 $\mathcal{Y}$ 都有限可枚举的特点,把『采一个 $(\theta^\star, y_t)$ 算实现的奖励 $r^{\text{real}}_t$』改为对所有假设和所有可能答案显式求和取期望,得到方差为零(在给定历史与设计下)的期望奖励。
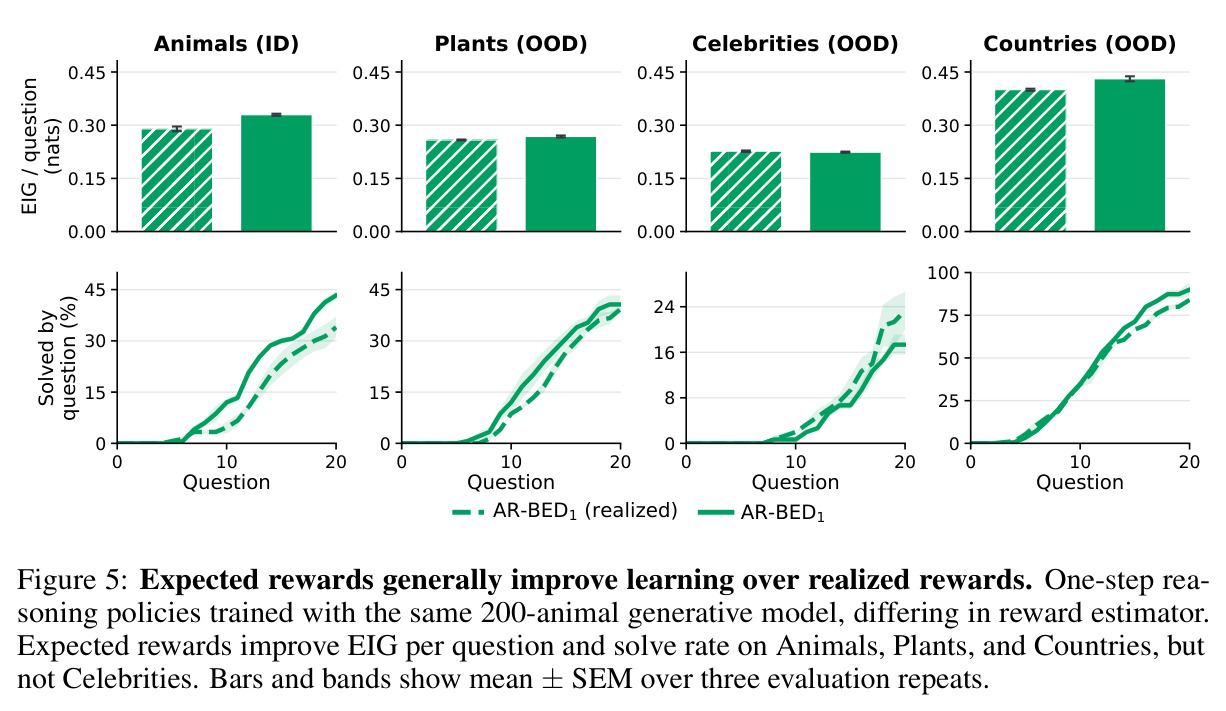
这是『期望奖励优于实现奖励』消融结论(Fig. 5)的理论根据,不看懂 Eq. 6 与 Eq. 7 的关系就无法理解论文的奖励设计。
Twenty Questions 环境
经典信息获取任务:隐藏一个目标(如『马』),提问者最多问 20 个可用 yes/no/maybe 回答的问题,依据答案逐步缩小候选集直至猜中目标。它是研究主动提问的标准沙盒,答案空间小而可枚举,便于精确计算信息增益与解决率。
本文的主训练与评估环境是 Twenty Questions:跨域迁移(动物→植物/名人/国家)以及向 MediQ 临床对话的任务迁移实验都在此基础上展开。
研究动机
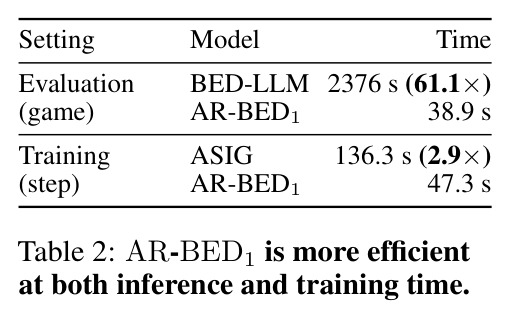
LLM 虽有庞大预训练知识与强推理能力,但在多轮交互式信息获取上表现很差:Krishnamurthy 等(2024)、Laban 等(2026)指出 LLM 在多轮设置中会『迷路』,Gupta 等(2025)进一步证明 LLM 对实验反馈不敏感——其表现更多依赖(可能不准确的)先验知识,而非根据新证据调整推理的能力。现有两条路线各有硬伤:推理时 BED(BED-LLM 等)每一步都要用 LLM 自身构造生成模型、维护后验并优化 EIG,单局耗时 2376 秒(是本文方法的 61.1 倍),且信息质量受限于策略模型自己的预测分布 $p(\theta)$ 和 $p(y \mid \theta, x)$;训练时方法 ASIG 直接摊销但同样使用 LLM 自生成的生成模型,且不显式训练推理过程——不加推理时甚至不如非推理基线。此外,单步 EIG 优化是短视的:某些状态下必须先问一个当下信息量为零的问题(如『确认上下文』),才能打开后续高信息量提问的空间。
本文的目标是本文要把序列贝叶斯实验设计摊销进一个推理型 LLM:训练它显式推理『哪些假设仍可信、哪些观察能区分它们、哪个问题能开启后续实验』,使其在每个决策点直接输出高信息量的问题,部署时无需在线 EIG 计算。具体目标有四:(1) 生成模型 $p(\theta, y \mid x)$ 独立于策略 LLM 指定,从而可以在自选的模型下评估动作的期望信息增益;(2) 用期望信息增益(而非单次实现值)构造训练奖励以降低方差;(3) 支持多步信息回报 $R_{t,K,\gamma}$ 以鼓励非短视策略;(4) 在 Twenty Questions 上提升域内与跨域(未见类别)的信息获取与解决率,并验证到 MediQ 真实临床问诊基准的正迁移,同时大幅降低训练与推理的计算成本。
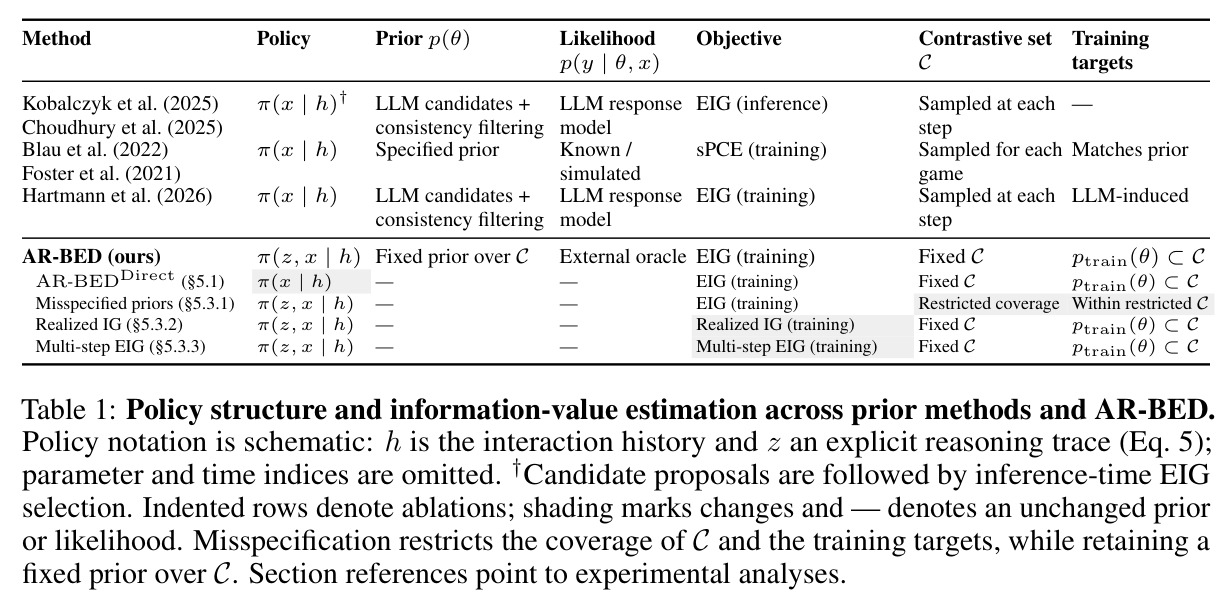
与已有工作不同的是,本文的独特切入是:训练时摊销允许把生成模型与被训策略彻底解耦。推理时 BED 只能用 LLM 自身诱导 $p(\theta)$ 与 $p(y \mid \theta, x)$,初始策略差则信号差;本文在训练环境里固定一个 200 动物的对比集均匀先验,再用独立的更大模型 GPT-5 做语义似然评估器,使信息度量在整个训练过程中保持平稳(附录 D.6 给出了梯度分解证明:解耦后不再出现奖励模型随策略漂移的 $\nabla_\phi R_\phi$ 项)。第二个差异是把推理轨迹 $z_t$ 显式纳入策略 $\pi_\phi(z_t, x_t \mid h_{t-1})$,奖励同时塑造『推理 + 提问』的联合输出,而 ASIG 只训练直接采样的问题分布。第三是用有限假设/结果空间上的精确边缘化(Rao-Blackwell 化)构造期望信息奖励,并在 GRPO 中用 $K$ 步 rollout 累积折扣回报,绕开在开放自然语言空间上学习 critic 的困难。
核心方法
直觉上,临床医生问诊不是盲目发问,而是在心里比较候选诊断、判断哪个检查最能区分它们。本文想让 LLM 把这套『信息价值评估』内化为可泛化的推理技能。技术路线:把策略参数化为 $\pi_\phi(z_t, x_t \mid h_{t-1}) = \pi_\phi(z_t \mid h_{t-1}) \cdot \pi_\phi(x_t \mid h_{t-1}, z_t)$,即先生成推理 $z_t$ 再输出问题 $x_t$。训练按三步循环:(1) 策略给定历史 $h_{t-1}$ 生成 $(z_t, x_t)$;(2) 独立的生成模型——固定对比集 $\Theta_C$ 上的均匀先验 $p_C(\theta_\ell) = 1/(L+1)$ 加 GPT-5 语义似然评估器 $p_{\text{oracle}}(y \mid \theta, x)$(答案空间 $\mathcal{Y} = \{\text{yes, no, maybe}\}$)——评估 $x_t$ 的信息价值;(3) 以 $K$ 步折扣信息回报 $R_{t,K,\gamma} = \sum_{k=0}^{K-1} \gamma^k r^{\mathrm{EIG}}_{t+k}$ 为奖励,用 GRPO 更新策略。主实验在 Gemma-4-E4B-it 上做 4-bit LoRA(rank 16、alpha 32),batch 128、每状态 8 个 rollout、训练 250 步、学习率 $10^{-5}$,多步训练取 $\gamma = 0.5$。
核心创新有三点且环环相扣。其一,生成模型与策略解耦:信息度量 $r^G(h, x) = \mathrm{EIG}_G(x; h)$ 固定、不随参数 $\phi$ 变化,策略梯度中不会出现『优化目标本身在漂移』的奖励模型项,训练信号平稳;而 BED-LLM/ASIG 用策略自身分布构造生成模型,更新参数的同时改变了『什么算有信息量』。其二,期望信息奖励:因假设与答案空间有限可枚举,把实现奖励 $r^{\text{real}}_t = \log \frac{p_{\text{oracle}}(y_t \mid \theta^\star, x_t)}{p_C(y_t \mid h_{t-1}, x_t)}$ 对 $(\theta, y)$ 显式求和,得到 $r^{\mathrm{EIG}}_t = \sum_{\ell=0}^{L} p_C(\theta_\ell \mid h_{t-1}) \sum_{y \in \mathcal{Y}} p_{\text{oracle}}(y \mid \theta_\ell, x_t)\left[\log p_{\text{oracle}}(y \mid \theta_\ell, x_t) - \log p_C(y \mid h_{t-1}, x_t)\right]$,它恰是有限模型下精确的一步 EIG(即 $r^{\mathrm{EIG}}_t = \mathbb{E}[r^{\text{real}}_t \mid h_{t-1}, x_t]$),消掉了采样 $(\theta^\star, y_t)$ 的方差。其三,用策略自身 $K$ 步 rollout 而非学习 critic 给未来信息分配信用,使 $K>1, \gamma>0$ 时能奖励『当下未必有用但打开后续信息空间』的问题。
方法步骤详情
完整训练流程:(1) 数据构造——用 GPT-5 生成 250 局动物域 Twenty Questions 游戏(100 个真实目标、200 个对比假设),每局在最终猜测前最多采样 5 个中间决策点,得到 1200 条部分轨迹作为训练状态,每条状态即一段含已问问题与答案的历史 $h_{t-1}$。(2) 奖励模型构建——固定 200 动物对比集与均匀先验;对候选问题 $x$,GPT-5 返回每个假设下 yes/no/maybe 的完整分布 $p_{\text{oracle}}(y \mid \theta_\ell, x)$,可缓存复用;历史似然按条件独立假设增量更新 $C_{t,\ell} = C_{t-1,\ell}\, p_{\text{oracle}}(y_t \mid \theta_\ell, x_t)$,后验 $p_C(\theta_\ell \mid h_{t-1}) = C_{t-1,\ell} / \sum_j C_{t-1,j}$ 精确可算,后验预测分布 $p_C(y \mid h_{t-1}, x_t) = \sum_\ell p_C(\theta_\ell \mid h_{t-1})\, p_{\text{oracle}}(y \mid \theta_\ell, x_t)$ 亦然。(3) rollout 与回报——对每个历史采 8 个 $(z, x)$;对每个提议,先剪枝低权重假设,再用 oracle 最可能答案推进至多 $K-1$ 步,累积折扣期望信息奖励(对完全随机目标做了实用近似,见附录 D.2)。(4) GRPO 更新——组内相对回报做优势,batch 128、lr $10^{-5}$、AdamW 8-bit、余弦调度含 10 步 warmup、温度 1.0、prompt/ completion 上限 1024/512 token,共 250 步。推理时只需策略模型本身,不再访问 oracle 或对比集。
技术新颖性
与最近邻工作的本质区别:相对 BED-LLM / Kobalczyk 等推理时 EIG 选择方法——本文把全部计算移到训练期,推理每局快约 61 倍,且不依赖策略自身诱导的分布;相对 ASIG(Hartmann 等,训练时摊销)——本文显式训练推理轨迹、用外部生成模型而非 LLM 自生成模型、并采用纯信息增益的期望奖励(ASIG 的评估配置还混入任务结局奖励);相对经典 DAD(Foster 等)与 Blau 等——本文把每条轨迹重采样的对比集改为固定集合,从而将其解释为一个有限贝叶斯世界(附录 D.3),使后验与后验预测都精确可算,并把 sPCE 分解出的逐步实现奖励替换为其 Rao-Blackwell 期望形式;相对 Blau 的 actor-critic 与 CA-BED 的会话树搜索——本文用策略自身 rollout 估计未来信息价值,避免在开放语言空间学 critic 或部署时做树搜索。Table 1 的消融链系统展示了这些设计选择各自的贡献,『生成模型构造 × 奖励估计 × 假设空间设定 × 多步目标 × 计算成本』的系统研究本身也是一项贡献。
实验结果
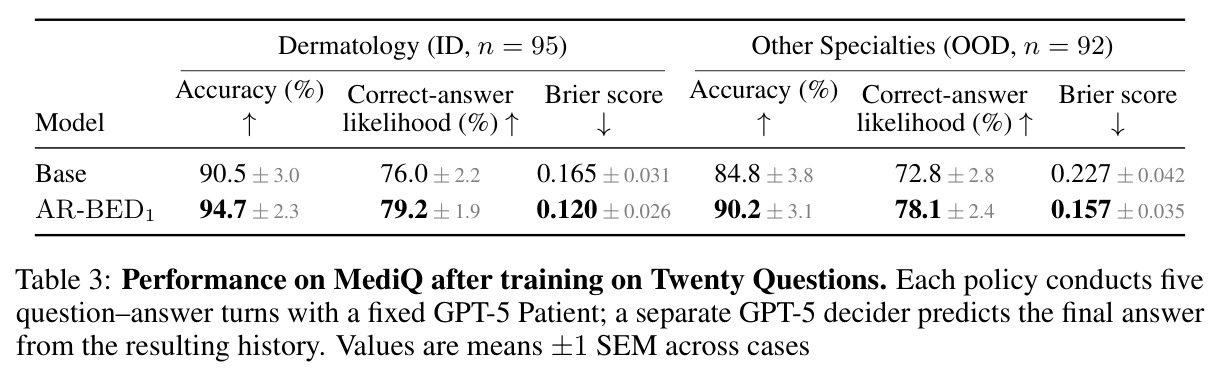
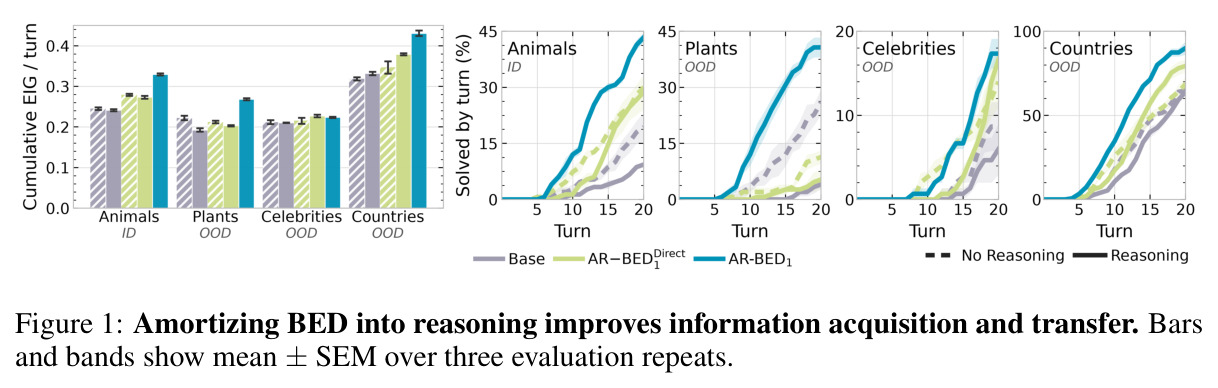
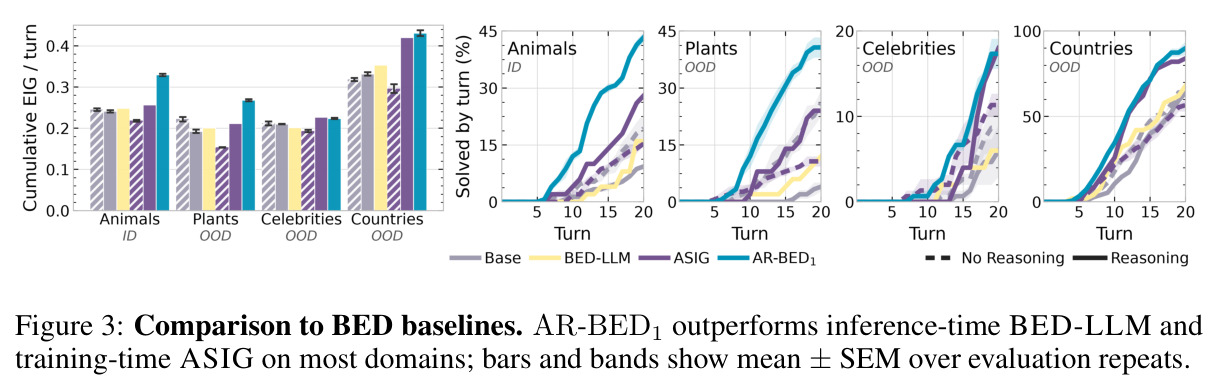
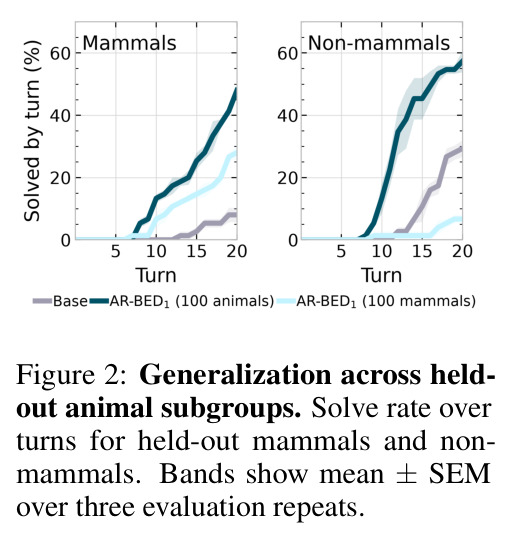
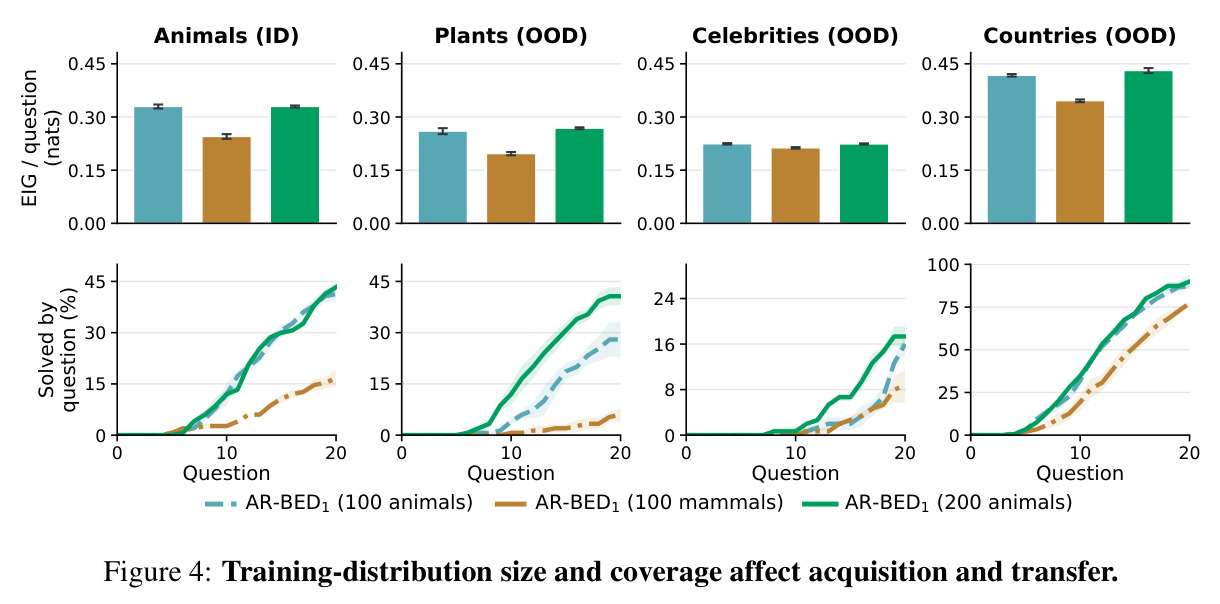
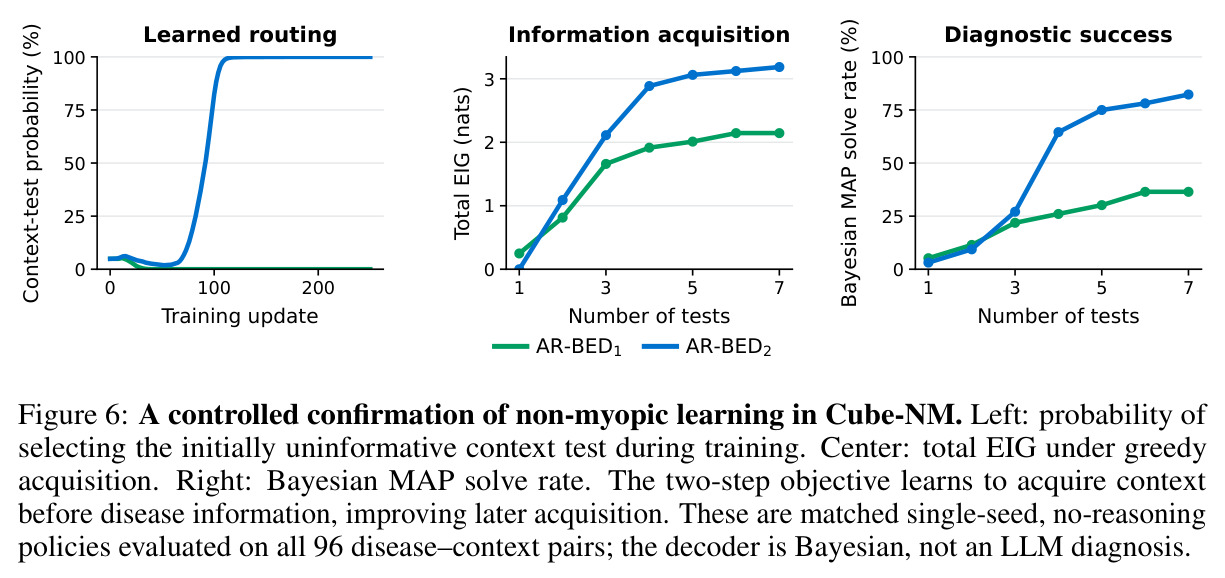
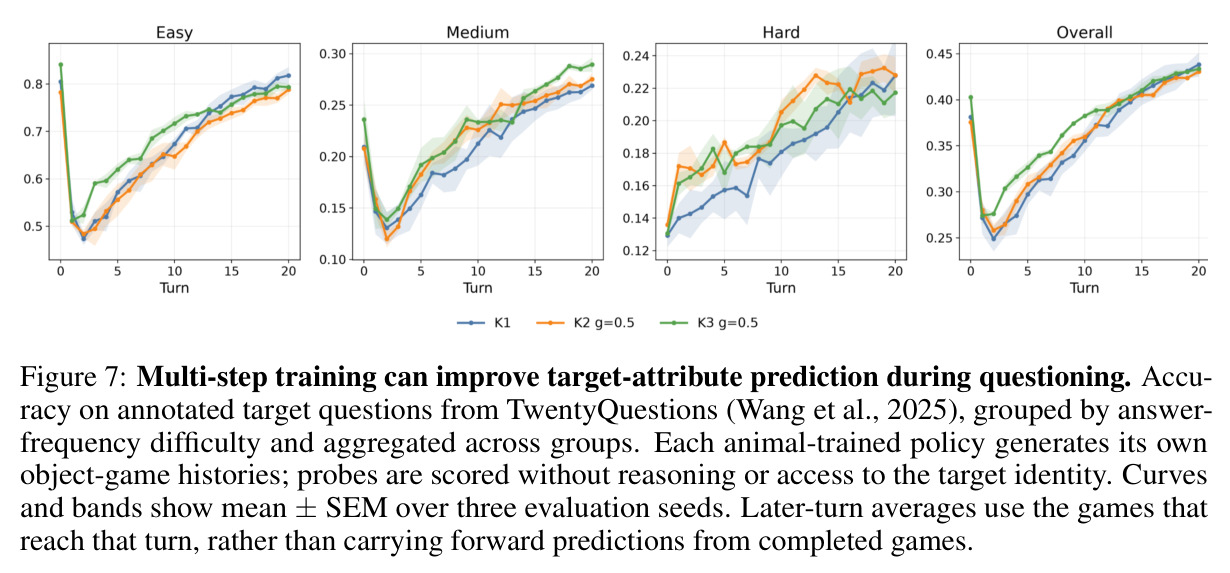
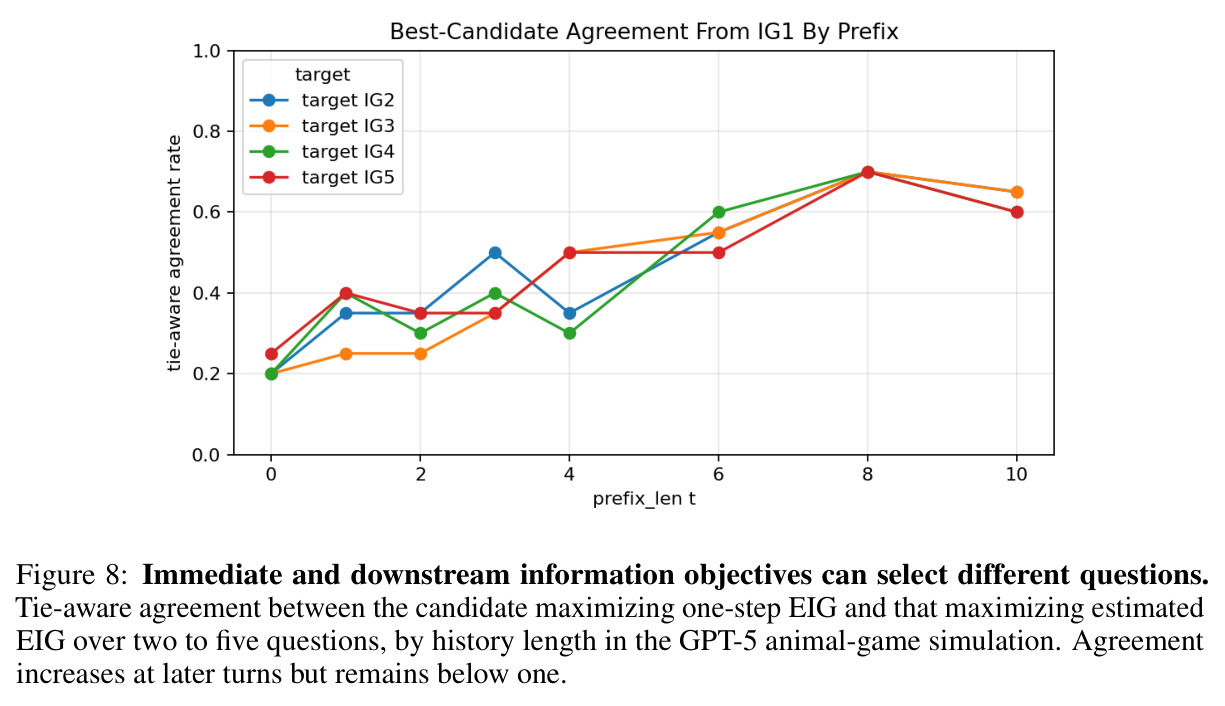
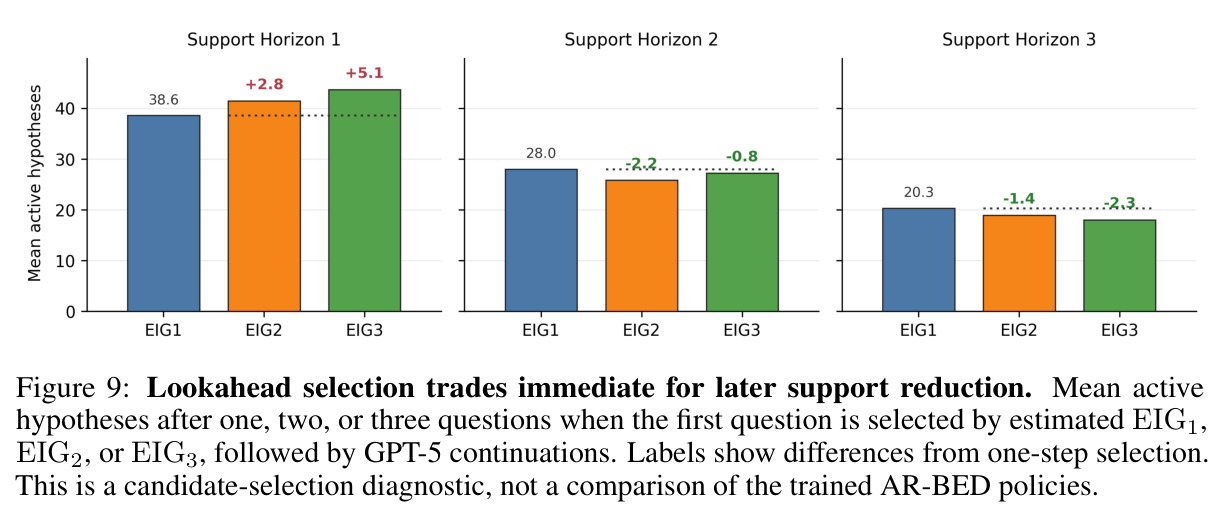
五个层面的发现。(1) 摊销进推理有效(Fig. 1):给基座模型加推理反而降低所有域的最终解决率(仅 Countries 的平均 EIG 略升);直接训练非推理策略(AR-BEDDirect)域内提升但跨域迁移不一致——在 Plants 上比 BASE 还差;AR-BED1 在全部四个域(Animals 域内 + Plants/Celebrities/Countries 域外)取得最高最终解决率,并在 Animals、Plants、Countries 三个域获得最高平均每回合 EIG。(2) 优于推理/训练时 BED 基线(Fig. 3、Table 2):BED-LLM 仅比『推理 BASE』略好、部分域的解决率与 EIG 还不及非推理 BASE;ASIG 不加推理时不优于非推理 BASE,加推理后仍低于 AR-BED1(Animals/Plants/Countries 上,Celebrities 打平)。效率上:BED-LLM 每局 2376 s(61.1 倍),AR-BED1 仅 38.9 s;训练每步 ASIG 136.3 s(2.9 倍)vs AR-BED1 47.3 s。(3) 设计消融:200 vs 100 对比集使 Plants 解决率 28.0%→40.7%、EIG 0.260→0.268,Animals 解决率 41.3%→43.3%(Fig. 4);仅哺乳动物的错误对比集严重伤害泛化——动物目标解决率 41.3%→16.7%、EIG 0.330→0.245,且在 held-out 非哺乳动物上显著更差(Fig. 2);期望奖励优于实现奖励——Animals EIG 0.290→0.330 nats/题、解决率 34.0%→43.3%,唯一例外是 Celebrities(23.3% vs 17.3%,Fig. 5)。(4) 非短视机制:Cube-NM 受控环境中 $K{=}2$ 策略学会先选零信息量的上下文测试,第 5 步 MAP 解决率 75.0% vs 30.2%(Fig. 6);开放域中收益温和——$K{=}2$ 在 3 步评估视野 +0.0116 nats/题(Fig. 10),属性预测第 5 轮准确率 $K{=}3$ 32.7% vs $K{=}1$ 29.7%(Fig. 7),即时与多步 EIG 的候选排序在前几轮仅 20–40% 一致(Fig. 8、9)。(5) 任务迁移(Table 3):医学版 AR-BED1 在皮肤科(ID,n=95)把 GPT-5 决策器诊断准确率从 90.5% 提到 94.7%、正确答案概率 76.0%→79.2%、Brier 0.165→0.120;其他专科(OOD,n=92)从 84.8% 提到 90.2%、Brier 0.227→0.157。
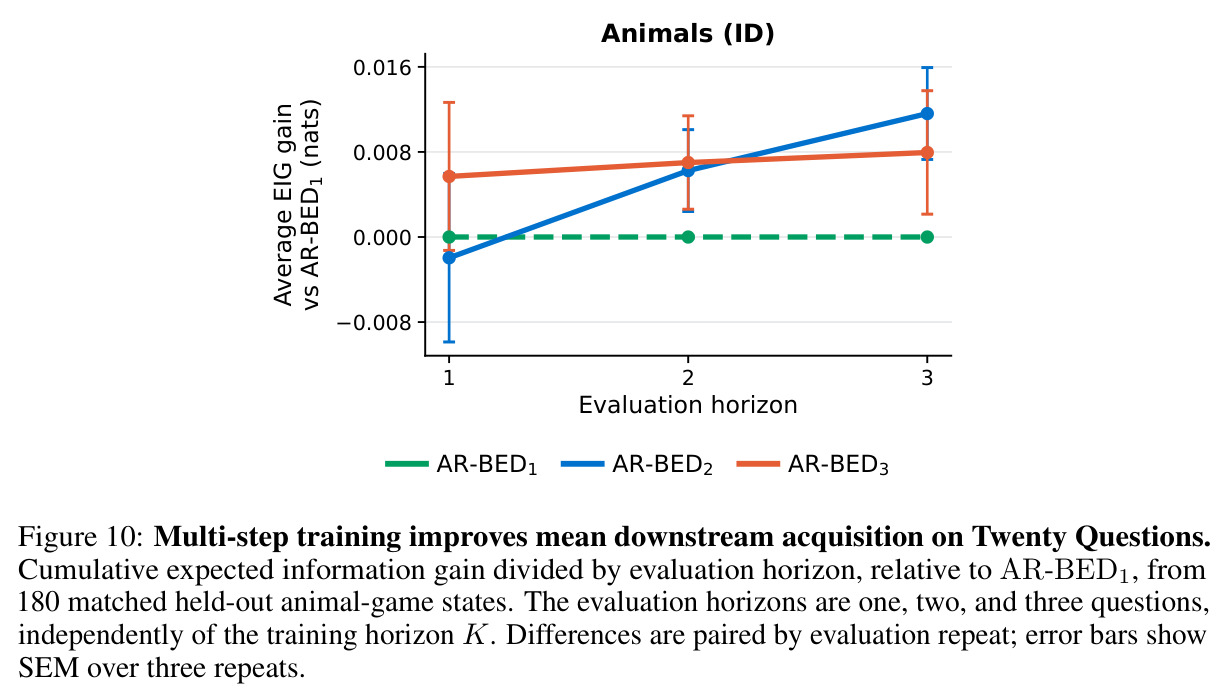
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Twenty Questions:域内 + 跨域信息获取(50 局 × 3 种子) | 最终解决率 / 平均每回合 EIG(nats) | AR-BED1 全部四域解决率最高;200 对比集下 Animals 43.3%、Plants 40.7%;期望奖励使 Animals EIG 达 0.330 nats/题 | BASE 加推理反而降解决率;AR-BEDDirect 跨域不一致(Plants 差于 BASE);实现奖励版 Animals 仅 34.0% / 0.290 nats | 期望 vs 实现奖励:+9.3pp 解决率、+0.040 nats EIG;200 vs 100 对比集在 Plants +12.7pp |
| 对比推理时 BED(BED-LLM)与训练时 BED(ASIG) | 解决率 / EIG 与每局、每步耗时 | AR-BED1 在多数域超过两者;推理每局 38.9 s,训练每步 47.3 s | BED-LLM 每局 2376 s(61.1 倍慢)且部分域不及非推理 BASE;ASIG 训练每步 136.3 s(2.9 倍慢),无推理时不优于 BASE | 推理提速约 61 倍、训练提速约 2.9 倍,且效果更好 |
| 对比集错误设定泛化测试(held-out 哺乳/非哺乳动物各 25 个) | 分 subgroup 解决率 | 动物对比集版本在动物目标上解决率 41.3% | 100 哺乳动物对比集版本仅 16.7%(EIG 0.245 vs 0.330),在非哺乳动物上显著更差,甚至在哺乳动物上也更差 | 覆盖正确假设空间带来 +24.6pp |
| Cube-NM 受控非短视环境(32 病 × 3 上下文 = 96 对,25 个测试) | 贝叶斯 MAP 解决率 | K=2 策略学会先选零信息上下文测试,第 5 步 75.0%(第 3 步 27.1%) | K=1 短视策略第 5 步 30.2%(第 1 步 5.2% 暂时领先) | +44.8pp(受控单种子机制验证) |
| MediQ 临床问诊迁移(5 轮问答 + GPT-5 决策器) | 诊断准确率 / 正确答案概率 / 多分类 Brier 分数 | 皮肤科(ID,n=95):94.7%、79.2%、0.120;其他专科(OOD,n=92):90.2%、78.1%、0.157 | 未微调基座:90.5%、76.0%、0.165;84.8%、72.8%、0.227 | 准确率 +4.2pp(ID)/ +5.4pp(OOD),Brier 分别降低 0.045 / 0.070 |
局限与改进
作者承认两点:其一,只研究了较短的 rollout 视野($K \le 3$),如何在延长视野的同时保持可靠训练信号是开放问题;其二,表现对对比集覆盖度敏感——当对比集相对真实假设空间错误设定(如仅含哺乳动物)时,模型会学到有缺陷的假设表示(『Is it a mammal?』这类强问题的 EIG 被估成约 0),集合大小、构成与先验权重的系统研究留待未来。我自己的观察还有六点:第一,方法依赖 GPT-5 做语义似然评估器与训练轨迹生成,所谓『外部生成模型』实际上把可信度问题转移到了一个更昂贵的黑盒模型上,似然校准误差会直接扭曲 EIG;第二,Twenty Questions 的答案空间被限制为 yes/no/maybe,与真实开放问答差距大;第三,所有评估重复只是不同解码种子(论文自己注明 evaluation repeats 不是 independent training seeds),Cube-NM 更是单训练种子,统计功效有限;第四,Celebrities 上期望奖励反而输给实现奖励(解决率 17.3% vs 23.3%),说明方差缩减收益并不均匀;第五,MediQ 的病人模拟器与决策器都是 GPT-5,迁移结论部分可能来自同家族模型的先验知识加更好的提问方式,而非纯粹的通用信息收集技能;第六,开放语言任务中多步训练的收益只有每题 0.006–0.012 nats 量级且非单调,实用价值有限。
独立分析的弱点
弱点一:oracle 依赖与成本。训练时每个候选问题都要 GPT-5 对多达 200 个假设输出完整答案分布,即使有缓存,扩展到更大假设空间或更长对话时 API 成本会爆炸;改进方向是用小型开源模型蒸馏似然评估器,或学习参数化的 $p(y \mid \theta, x)$。弱点二:假设空间静态有限。固定 200 假设集使信息度量只是有限世界内的 EIG(附录 D.4 明确承认它未必等于真实全空间 EIG),遇到集外实体时策略可能被误导;改进方向是按需扩展对比集(检索或生成新假设)并做在线先验更新。弱点三:任务奖励缺位。纯信息增益不考虑问题代价、风险或任务终局奖励,医疗场景里『信息量大』不等于『对诊断有用』;改进方向是把信息奖励与任务奖励加权组合,或按 EIG/成本比归一。弱点四:非短视机制脆弱。Cube-NM 里 $K{=}2$ 完美学到上下文路由,但开放域收益只有千分之几 nats,且 $K{=}3$ 未必优于 $K{=}2$(非单调);此外 rollout 用『oracle 最可能答案』推进是有偏近似;改进方向是自适应选择视野并对 rollout 近似做偏差校正。弱点五:评估统计薄弱。3 个解码种子 + 单训练 checkpoint,无法刻画训练随机性;改进方向是多训练种子报告方差。
未来方向
作者提出的方向:延长 rollout 视野同时保持训练信号可靠;系统研究对比集的大小、构成与先验加权对学习与迁移的影响。基于成果可延伸的方向:(1) 自动构造/扩充对比集——用检索或 LLM 生成假设并估计先验权重,使训练世界逐步逼近真实假设空间;(2) 把『期望奖励 vs 实现奖励』的分析推广到不可枚举的结果空间(需回到采样估计或变分下界);(3) 与推理时搜索结合——把摊销策略作为 CA-BED 式会话树搜索的提议分布,兼顾速度与最优性;(4) 把医学版环境扩展到真实电子病历问答,检验 GPT-5 模拟病人之外的迁移;(5) 探索代价感知、风险敏感或任务终点奖励与非平稳生成模型下的训练动态(附录 D.6 的策略梯度分解提供了理论工具);(6) 把该范式推广到科学实验设计、主动特征获取(如 AFABench 类场景)等自然语言之外的设计空间。
复现评估
复现条件总体友好但有外部依赖。开源情况:正文未给出代码仓库链接,但附录提供了极详细的材料——超参数(C.1:unsloth/gemma-4-E4B-it,4-bit 加载,LoRA rank 16 / alpha 32,GRPO,batch 128、每状态 8 rollout,lr $10^{-5}$,AdamW 8-bit,余弦调度 10 步 warmup,250 步)、全部提示模板(C.2:推理策略、oracle 似然评估、信念探针、MediQ 的医生/病人/决策器角色)以及完整的对比集清单(C.3:200 动物、200 植物、100 名人、195 国家)。数据:训练游戏由 GPT-5 生成(250 局→1200 状态),MediQ 基准公开(筛出 269 例诊断病例)。算力:4-bit LoRA 训练单张高端消费级 GPU 应可承受;但 GPT-5 API(gpt-5-2025-08-07)是硬依赖——似然评估、轨迹生成、MediQ 病人与决策器都用它,复现成本主要是 API 费用与行为漂移风险。总体难度:中等。工程细节齐全、单 checkpoint 评估降低了调优负担;主要风险是 Gemma-4-E4B-it 版本可得性与 GPT-5 似然输出随时间不可复现。
论文图表