在正确的潜空间中做超分辨率:冻结视觉基座模型基底 Super-Resolution in The Right Latent Space: A Frozen Vision-Foundation Substrate
改用冻结DINOv3-L融合层做超分基底,单步解码即达保真-感知与效率双最优
前置知识
潜空间中的图像流形
在任意图像编码器的潜空间里,干净、清晰、自然的图像的嵌入向量往往集中在一张低维曲面(流形)附近;降质(模糊、噪声、压缩伪影)会把图像的嵌入推离这张流形。重建类任务在几何上因此可以看成『把降质嵌入拖回流形上的正确位置』——流形上每个点对应一张合理的清晰图像,而『正确位置』指既忠实于输入语义、又保留残存像素细节的那个点。据此,恢复任务被分解为两个子问题:距离(嵌入离流形多远)与导航(能否找到流形上忠实的那个点)。
全文的问题定义、实验设计(潜空间插值线、逐带消融、基底替换)与失败模式分析(模糊=没到流形,幻觉=到了流形上错误的点)全部建立在这张几何图景上。
DINOv3 与自监督视觉基座
DINOv3 是 Meta 用自蒸馏(self-distillation)在 17 亿张无标注精选图像上训练的视觉 Transformer。它的训练目标是让同一图像在不同增广视图下的网络表征互相匹配,而不是重建像素。这带来两个对本文至关重要的性质:其一,特征对低层失真天然鲁棒,降质图像的嵌入不会偏得太远;其二,层级清晰——浅层保留像素级细节,深层承载退化鲁棒的抽象语义。DINOv3-L 共 24 层,每层 patch token 维度 1024,patch 大小 16。
本文的『基底』就是冻结 DINOv3-L 第 2–24 层的平均特征;理解它的训练目标为何使降质嵌入靠近流形、多层平均为何保留层级,是理解整个方法成立原因的前提。
重建导向潜空间(VAE 潜空间)
Stable Diffusion 系列使用的 VAE 编码器以像素重建为训练目标,潜空间忠实保留输入的一切内容——包括降质本身。论文指出这类空间有两个结构缺陷:降质图像的嵌入离干净图像流形很远,且空间中几乎没有语义信息,导致超分映射又长又缺乏指引,重降质下极易幻觉。SD3-VAE 潜空间为 16 通道、64×64 网格的紧凑表征,是本文所有对照实验中的『反面教材』。
它是本文的对照组:论文核心主张就是『不要在这种空间里做 SR』,并用基底替换实验(唯一改动编码器)证明了这一点。
感知-失真权衡
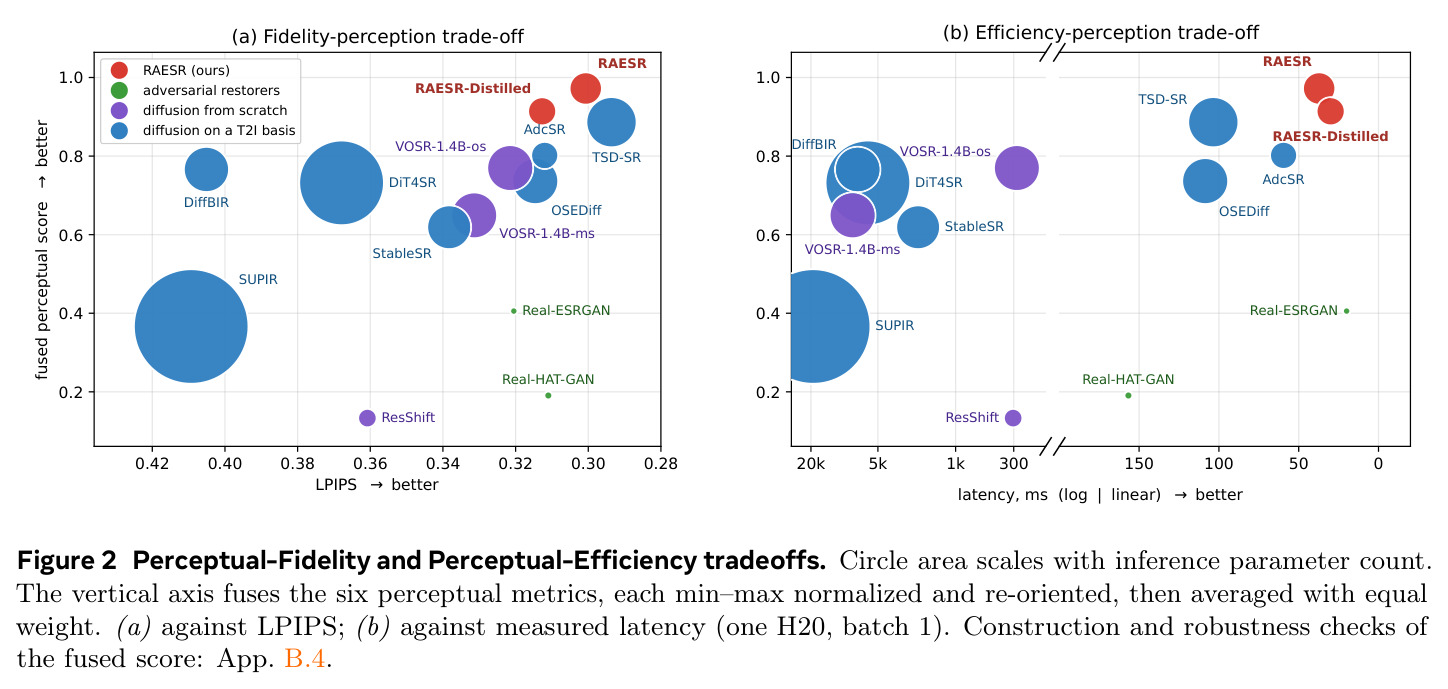
Blau 与 Michaeli 的经典结论:以逐像素距离衡量的失真(PSNR/SSIM)与以人眼感知质量衡量的逼真度在数学上相互制约——失真最小的估计器是模糊的后验均值,而感知上最优的输出必然不是逐像素最接近的。因此 SR 论文习惯把指标分为保真类(PSNR、SSIM、LPIPS)与感知类(NIQE、MUSIQ、MANIQA、TOPIQ、DISTS、CLIP-IQA),报告权衡曲线而非单一数字。
本文对 RAESR 的两大核心主张——最佳『保真-感知』权衡与最佳『效率-感知』权衡——都是在这套框架下陈述的,读 Table 1 与 Figure 2 必须先懂它。
投影式/相对论判别器
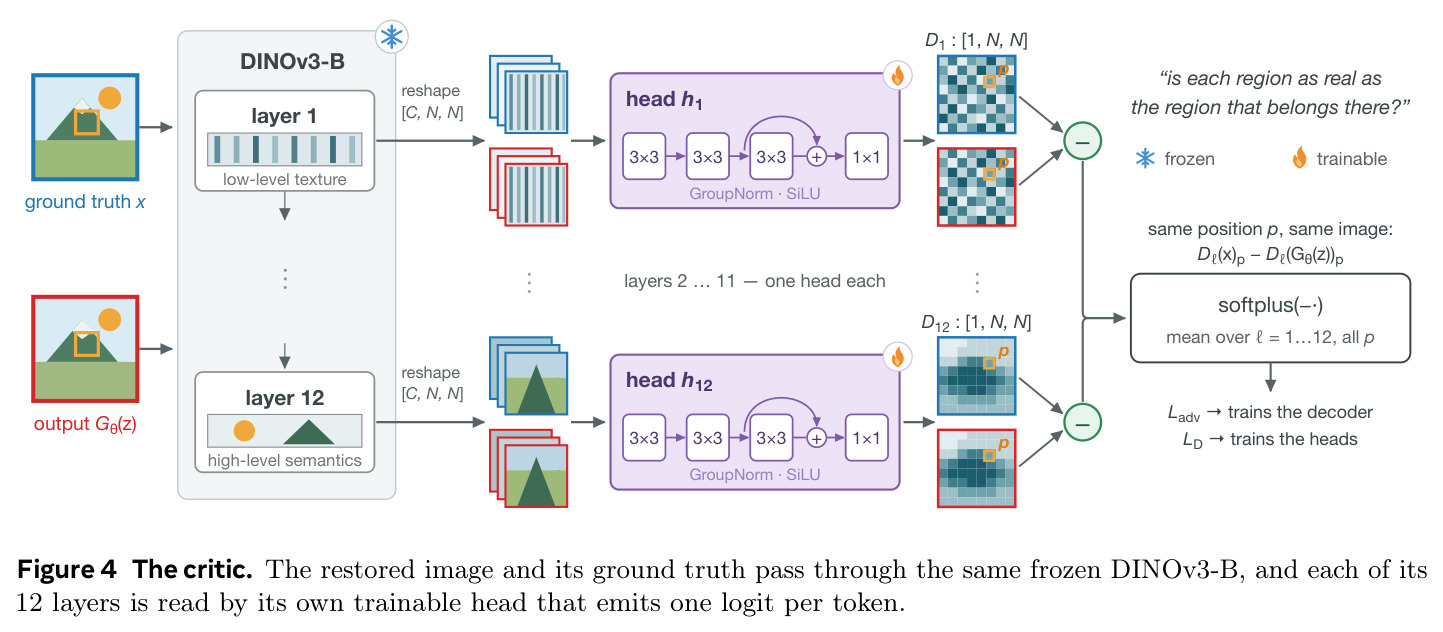
投影判别器(Sauer et al.)把条件信息投影进判别器特征以提供更细的梯度;Kumari et al. 证明可以直接用冻结的现成特征提构建判别器。本文的 critic 是两者改造的组合:真实图与生成图都过同一个冻结 DINOv3-B,其 12 层每层接一个可训练卷积头,每个 token 输出一个 logit(密集打分、不做图像级池化),损失按同图同位置配对的相对论形式 softplus(-(D(r)-D(f))) 训练,梯度惩罚 R1/R2 用有限差分近似,再加 logit 居中惩罚固定数值漂移自由度。
对抗项是把嵌入推回流形的唯一训练动力;critic 能否在从纹理统计到语义合理性的每个层级给出细粒度、相对化的判据,直接决定输出是糊、是幻觉、还是忠实。
研究动机
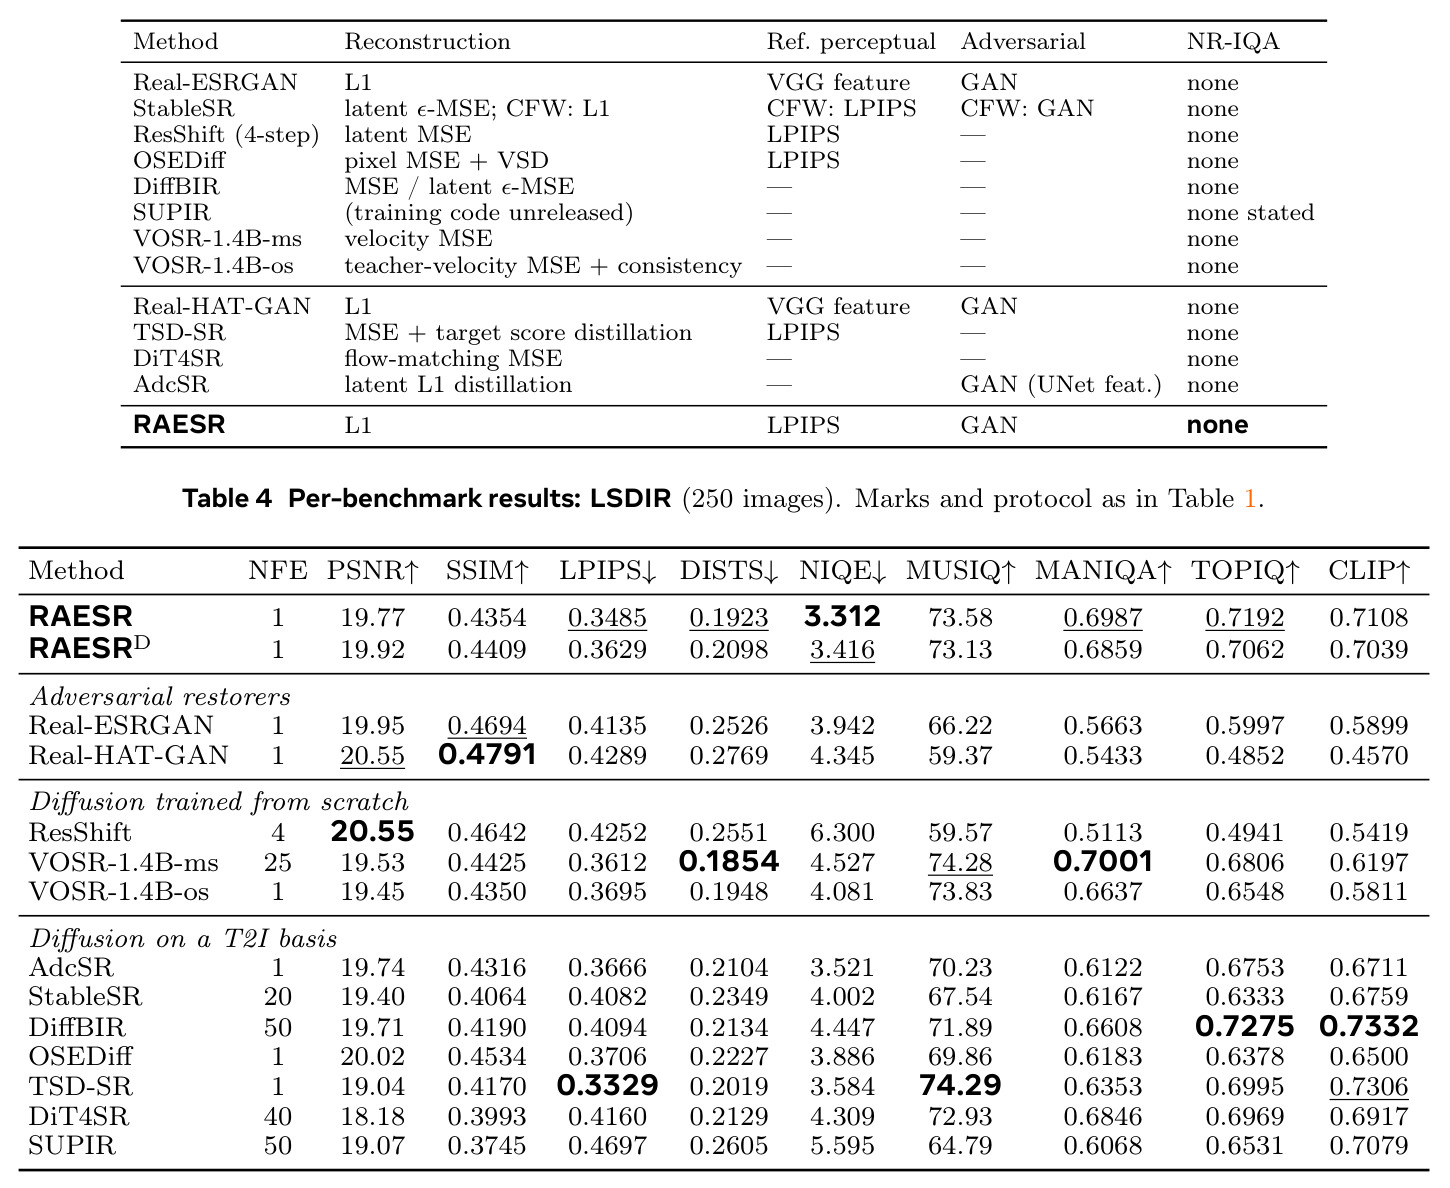
真实世界超分(Real-World SR)的输入带有未知的复杂降质(模糊、噪声、JPEG 压缩等)。现有所有已发表方法要么直接在像素空间做映射(Real-ESRGAN、Real-HAT-GAN 等一步 GAN 修复器),要么在重建导向的 VAE 潜空间里做(StableSR、SeeSR、SUPIR、OSEDiff、TSD-SR 等扩散系)。这两类空间都以像素重建为目标训练,会忠实保留降质本身,导致降质图像的嵌入离干净清晰图像的流形非常远:轻量 GAN(如 17M 参数、20 ms 的 Real-ESRGAN)一步跨不过这段距离,输出整体发糊;扩散方法靠预训练文生图先验用几十步、数十亿参数强行跨越(如 SUPIR 达 18,152M 参数、单图约 19.1 秒、46.8 GiB 显存),但映射长且缺乏语义指引,常落在流形上错误的点——表现为幻觉:恢复出锐利但内容错误的细节。已有补救都没有触及根源:FaithDiff 微调 VAE 编码器拉近降质与干净嵌入的距离;StableSR/SeeSR/PASD/SUPIR 注入文本或标签条件,VOSR/F2IDiff 注入 DINOv2 特征——但基底不变,映射依旧又长又弱指引。
本文的目标是本文要为 SR 找到并验证一个『合适的潜空间基底』,判据有两条:其一,降质图像在该空间中的嵌入应靠近干净图像流形,使回映射短而便宜;其二,空间内部应保有从像素细节到抽象语义的完整信息层级,能直接指引模型落到流形上忠实于输入的那个点。在这个基底之上,只需训练一个中等规模(415M)的单步解码器,就要在 RealSR、DRealSR、LSDIR、DIV2K-Val 四个基准的 ×4 超分上,相对 12 个已发表方法取得最佳保真-感知与效率-感知权衡,并把单张 512×512 图像的推理延迟压到约 37 ms(单卡 H20)——即同时做到更高质量与数量级更快的推理。
与已有工作不同的是,此前所有工作默认 SR 必须在像素空间或 VAE 潜空间进行,语义缺失就用外挂模块弥补。本文的独特切入是把『选择基底』本身当作第一性问题:受表示自编码器 RAE/RAEv2(用冻结自监督编码器加训练解码器替代 VAE 做生成)启发,作者把战场整个搬进自监督视觉基座 DINOv3-L 的多层融合潜空间——这是该类基底首次被用于修复任务。由于 DINOv3 的训练目标是跨增广视图匹配表征而非重建像素,降质图像天然嵌入在流形附近;多层融合又保留了从像素记录到语义的完整层级,两个缺陷在源头被消除,而不是被缓解。作者还给出可检验的判据(近流形性、信息层级)与配套的测量方法(插值线解码、线性恢复、子空间几何),把『选空间』从经验升级为可研究的问题。
核心方法
直觉上,换基底把 SR 从『在深海里把沉船拖回港口』变成『船本就搁浅在港口门口,一把拖拽即可』:在自监督潜空间里降质嵌入离流形很近,一步映射就够了。技术路线三件套。第一,基底:低清输入 $x_{LR}$ 先双三次上采样到 HR 尺寸,经完全冻结的 DINOv3-L/16 编码,按公式 $z = \frac{1}{23}\sum_{\ell=2}^{24} h_\ell + \mathrm{broadcast}(\bar{h}_{24})$ 融合第 2 到 24 层的 patch token 平均,再加第 24 层空间均值的广播项。第二,解码器:415M 参数的 Transformer(线性投影 $d\to1152$、28 层、16 头、MLP 宽 4096、2D RoPE),每 token 预测 16×16×3 像素,一次前向直接输出 $\hat{x}_{HR}$,无采样循环;输出各通道均值对齐输入以消除色偏(免费约 +0.36 dB PSNR)。第三,训练目标 $\mathcal{L} = \mathcal{L}_1 + 1.0\,\mathcal{L}_{LPIPS} + 0.5\,\mathcal{L}_{adv}$,对抗项来自冻结 DINOv3-B 加 12 个逐层卷积头的 critic(逐 token 相对论打分),三阶段课程:先双 cubic 退化重建、再强退化加对抗、最后混合强度短程收尾。
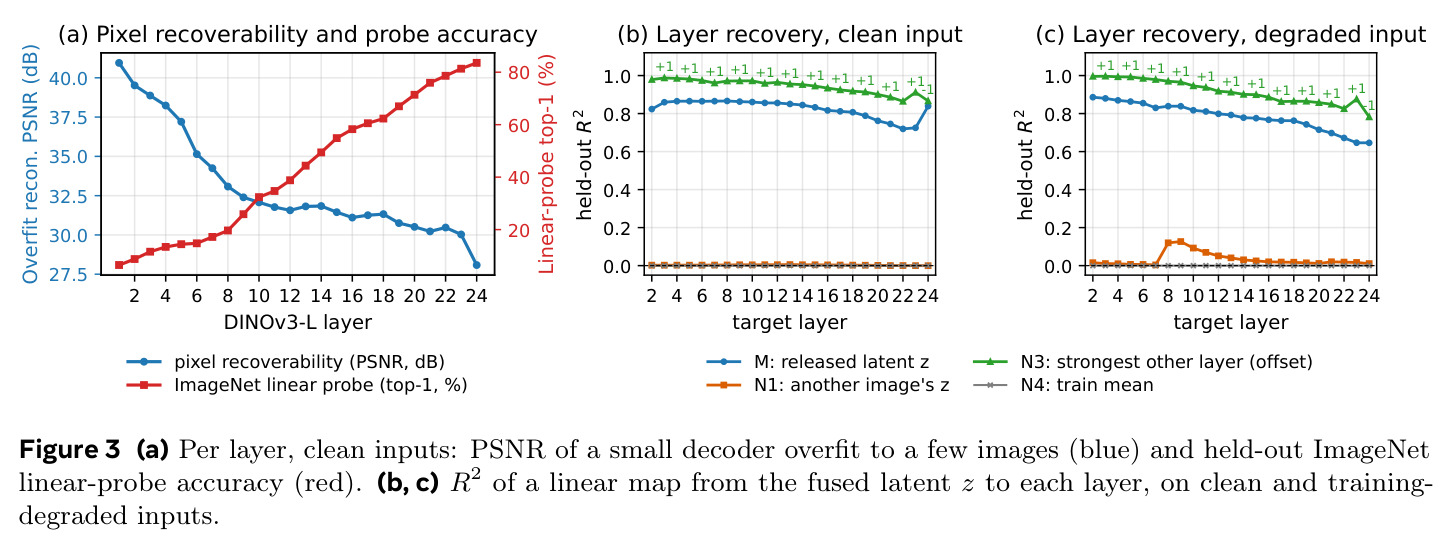
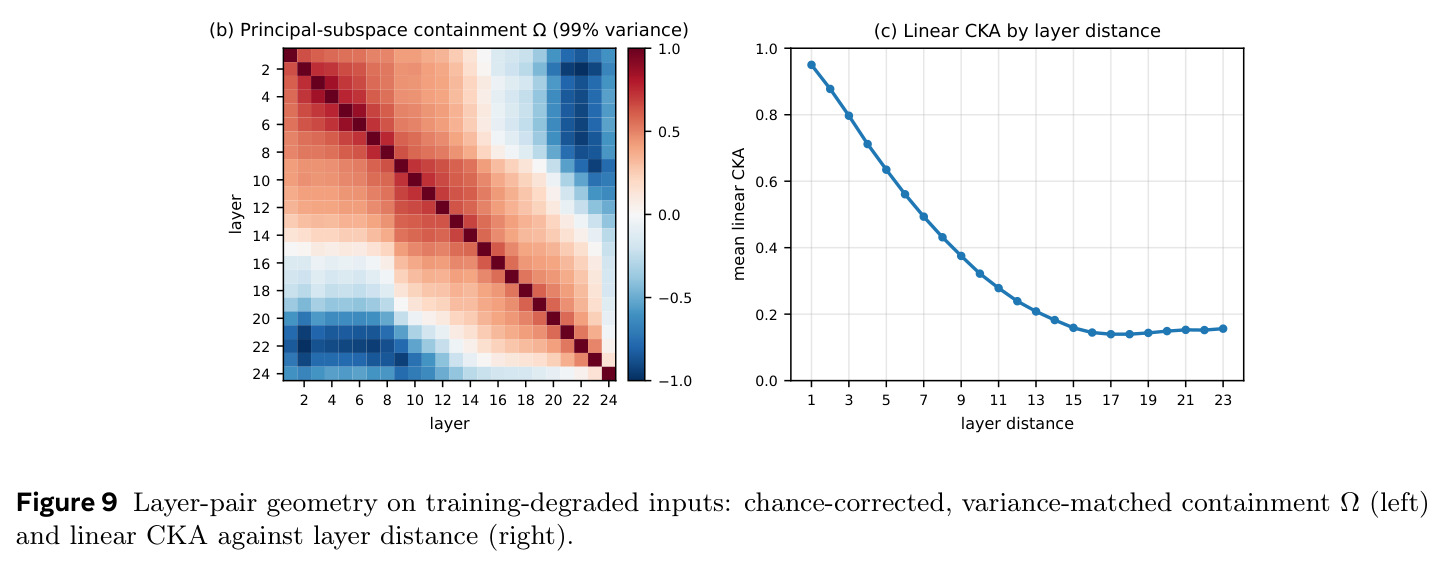
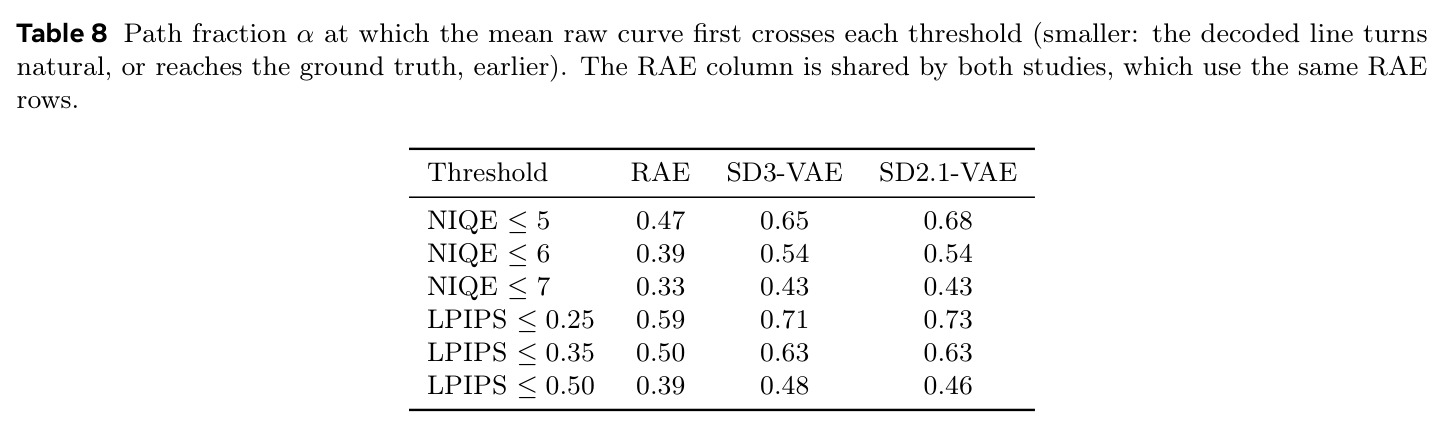
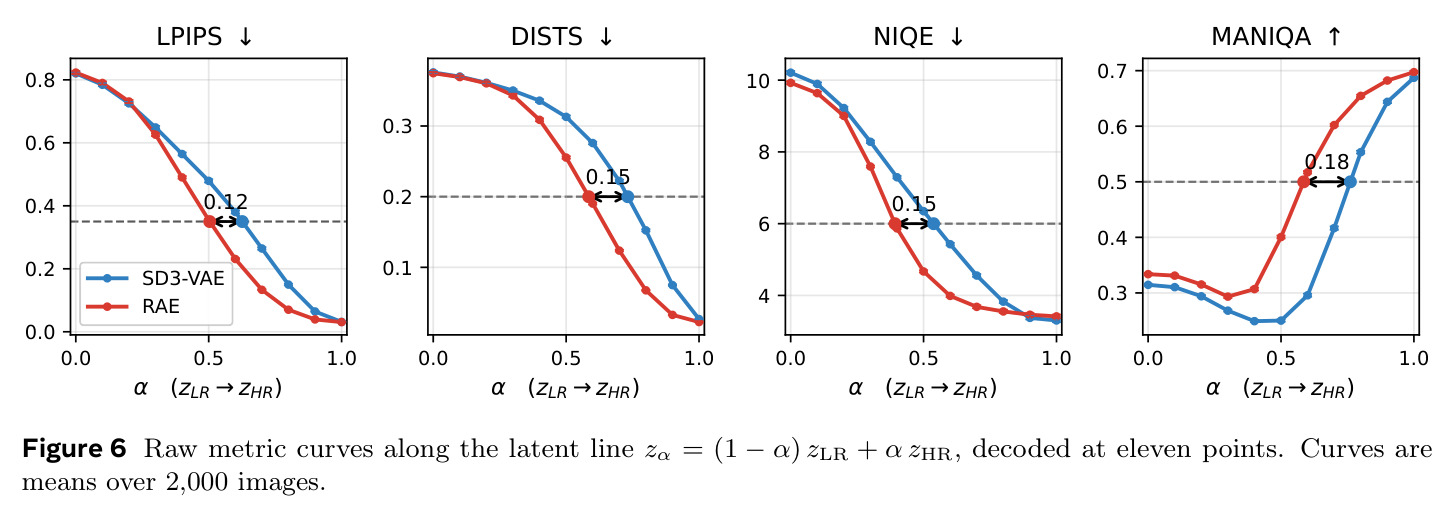
核心创新是『基底选择』这一视角本身,以及论证 DINOv3-L 融合层恰好是合适基底。与所有先前方法的本质区别:别人把 SR 映射放在重建导向空间里,再用更大的模型(扩散先验)或外挂语义条件补距离和语义;本文直接换空间,让两个缺陷从源头消失。DINOv3-L 融合层合适的原因有二。一是近流形性:DINOv3 的自蒸馏目标(匹配增广视图的表征)不依赖像素重建,对降质天然鲁棒——潜空间插值实验显示,沿直线 $z_\alpha = (1-\alpha)z_{LR} + \alpha z_{HR}$ 逐点解码,融合潜空间的图像远早于 SD3-VAE 变得清晰自然(NIQE≤5 在 $\alpha=0.47$ 即越过,SD3-VAE 需 0.65)。二是信息层级:逐层过拟合小解码器的重建 PSNR 从第 1 层 40.95 dB 递减到第 24 层 28.09 dB,ImageNet 线性探针 top-1 从 6.5% 升到 83.6%;而平均几乎不丢信息,因为远距层子空间解纠缠(首末层机会校正包含度 −0.60)而相邻层高度冗余(相邻 CKA 0.95,从融合潜变量线性恢复单层的 $R^2$ 最高 0.988)。
方法步骤详情
完整流程:① 输入处理:低清输入 $x_{LR}$ 双三次上采样到 HR 尺寸。② 编码:冻结 DINOv3-L/16 前向,取第 2–24 层的 1024 维 patch token(共 23 层,32×32=1024 个 token),按式 (1) 平均并与第 24 层空间均值的广播项相加,得到融合潜变量 $z$。③ 解码:$z$ 经线性层投影到 1152 维,过 28 层 Transformer(16 头、MLP 宽 4096、2D RoPE),每 token 预测 16×16×3 像素后 unpatchify 成 512×512 图像,最后各通道均值对齐输入。④ 三阶段训练:阶段 1 从官方 RAEv2 ViT-XL 重建解码器初始化(位置嵌入换 2D RoPE),在 LSDIR 512px 上仅用双 cubic 退化加 $\mathcal{L}_1$+LPIPS 训 5 万步(学习率 2e-5 余弦衰减);阶段 2 施加 VOSR-strong 二阶 Real-ESRGAN 退化,启用 $\lambda_{adv}=0.5$ 的对抗项,4 卡全局 batch 16 训 5 万步;阶段 3 在 LSDIR×10+FFHQ×8+Aesthetic-4K×1 的混合清单(166,994 张独立图像)上以 30% 强/50% 中/20% 弱退化训 600 步、全局 batch 64,对抗权重线性爬升,仅此阶段产出发布模型。⑤ critic:真值与生成图过同一冻结 DINOv3-B,12 层各接一个可训练卷积头(共 191M 参数,训后丢弃),每 token 输出 logit;判别损失为相对论 softplus 项加有限差分 R1/R2 梯度惩罚($\lambda_{gp}=0.25$)加 logit 居中惩罚($\lambda_{cp}=0.01$),TTUR 6 倍学习率、每步 2 次更新、496×496 中心裁剪使 critic 的 16px patch 网格与解码器错位半个 patch,从而暴露并压制拼接缝。⑥ 可选蒸馏:DINOv3-S/16+(28.7M)加 57.8M 投影器拟合教师潜变量,替换 303M 编码器(占推理参数 42%),解码器原封不动,得到 RAESR-Distilled(502M、30.0 ms)。
技术新颖性
新颖性有四点。其一,问题重述:把 SR 形式化为『潜空间流形上的回映射』,首次系统提出基底是否合适的两条判据(近流形性 + 信息层级)及其测量协议,把方法之争升维成空间之争。其二,基底迁移:RAE/RAEv2 的多层融合潜空间原本只用于生成和干净重建,本文首次将其用于真实退化修复,并补充了退化下的几何分析——退化使浅层更易线性恢复(第 7 层 95% 方差主成分数 28→19)、深层更难(第 19 层 285→326),解释了融合层级为何恰好提供『什么该保留、什么该合成』的互补指引。其三,对称设计:生成端融合 23 层,判别端也逐层设头,让『真实性』从纹理统计到语义合理性每个层级都被逐 token、按位置配对地判定——这是对投影判别器与冻结特征 critic 的改造组合,密集打分使弱区域无法被平均掉。其四,归因严谨性:用基底替换实验(唯一改动是冻结 SD3-VAE 换掉冻结 DINOv3-L,其余配方逐项一致)证明性能来自表征而非解码器配方,这种控制变量设计在 SR 文献中少见。
实验结果
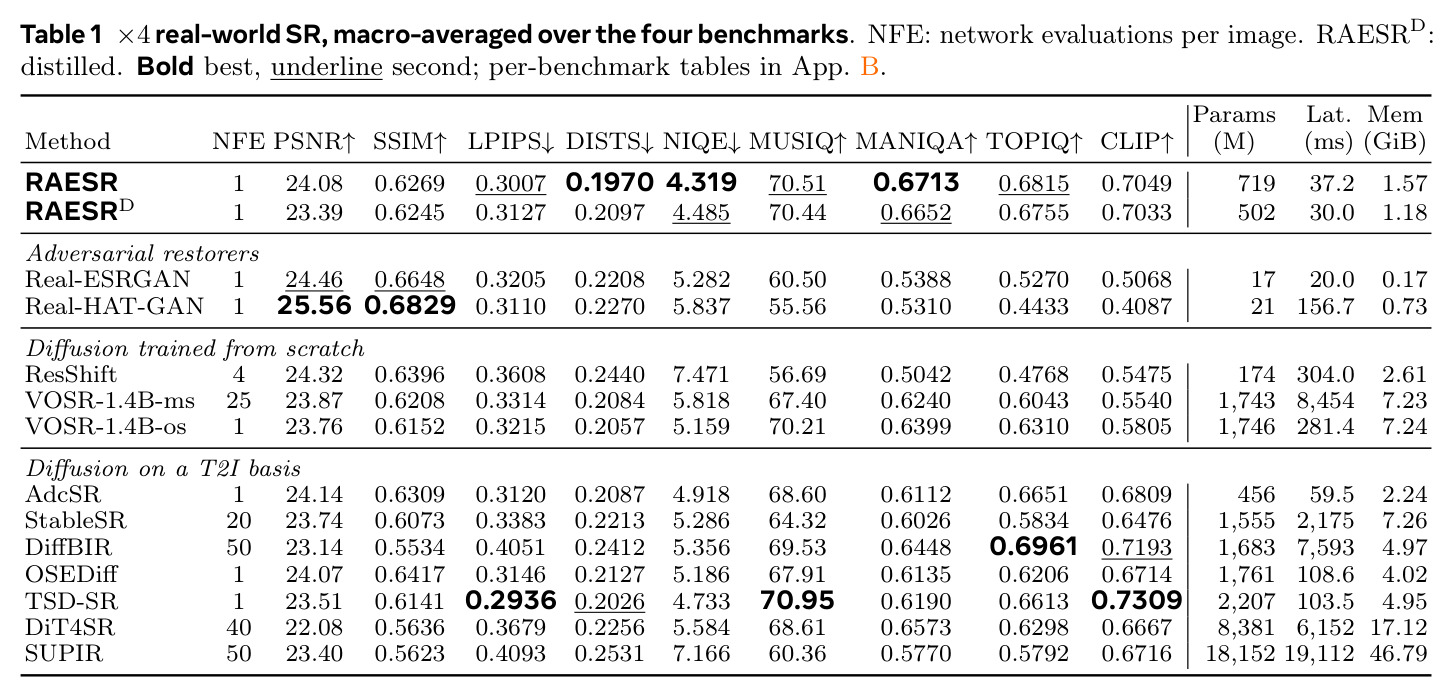
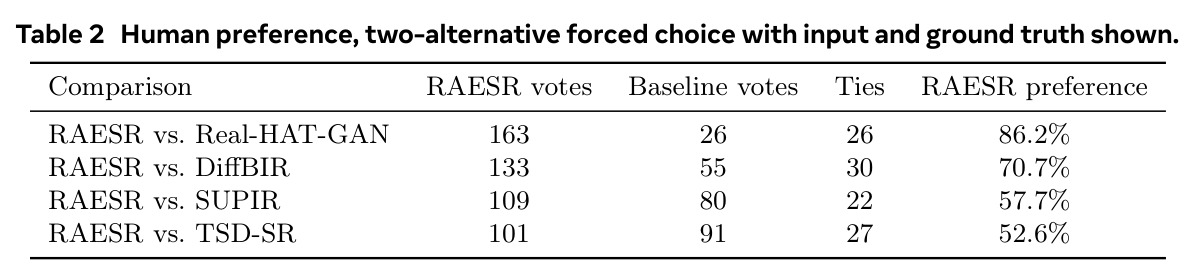
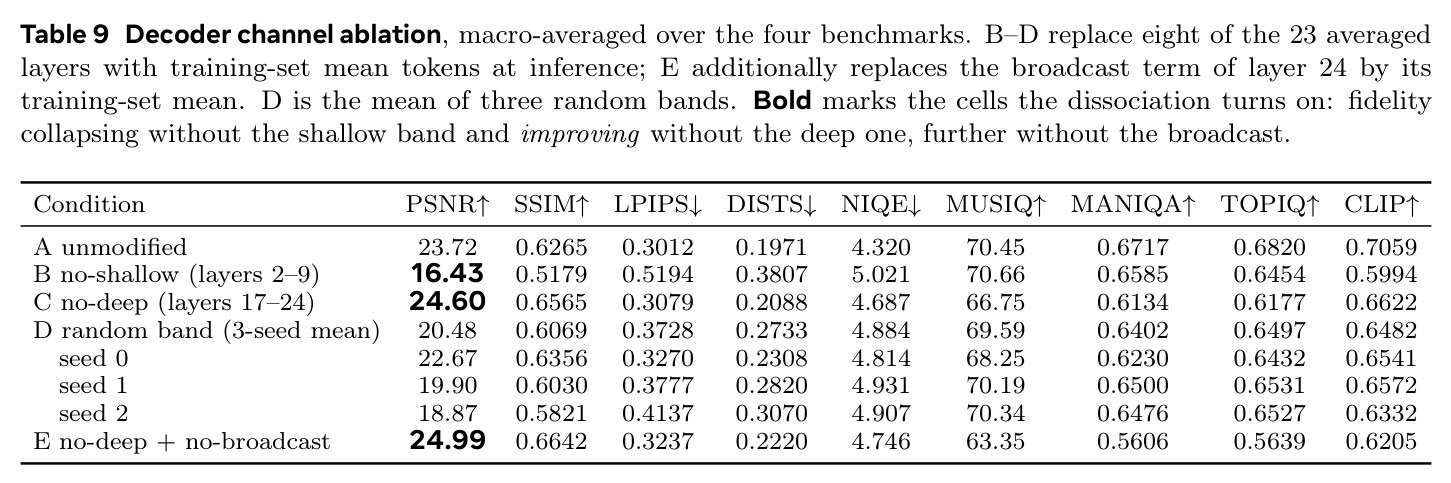
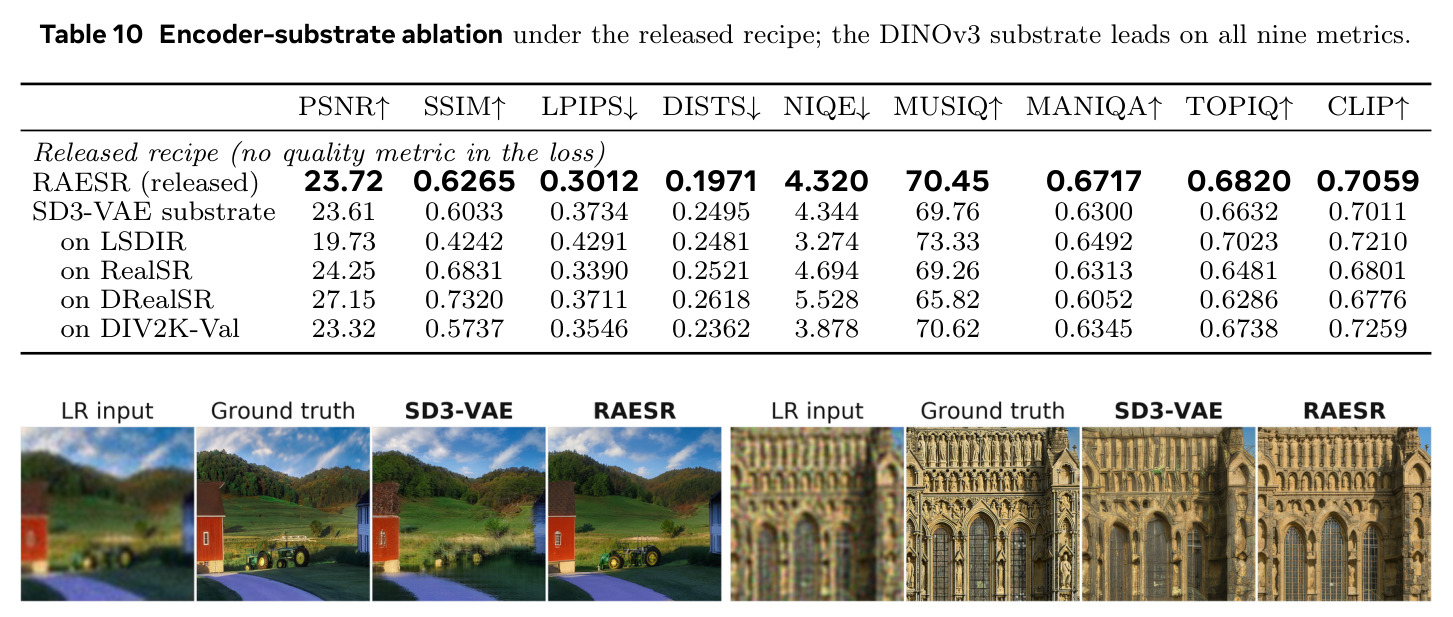
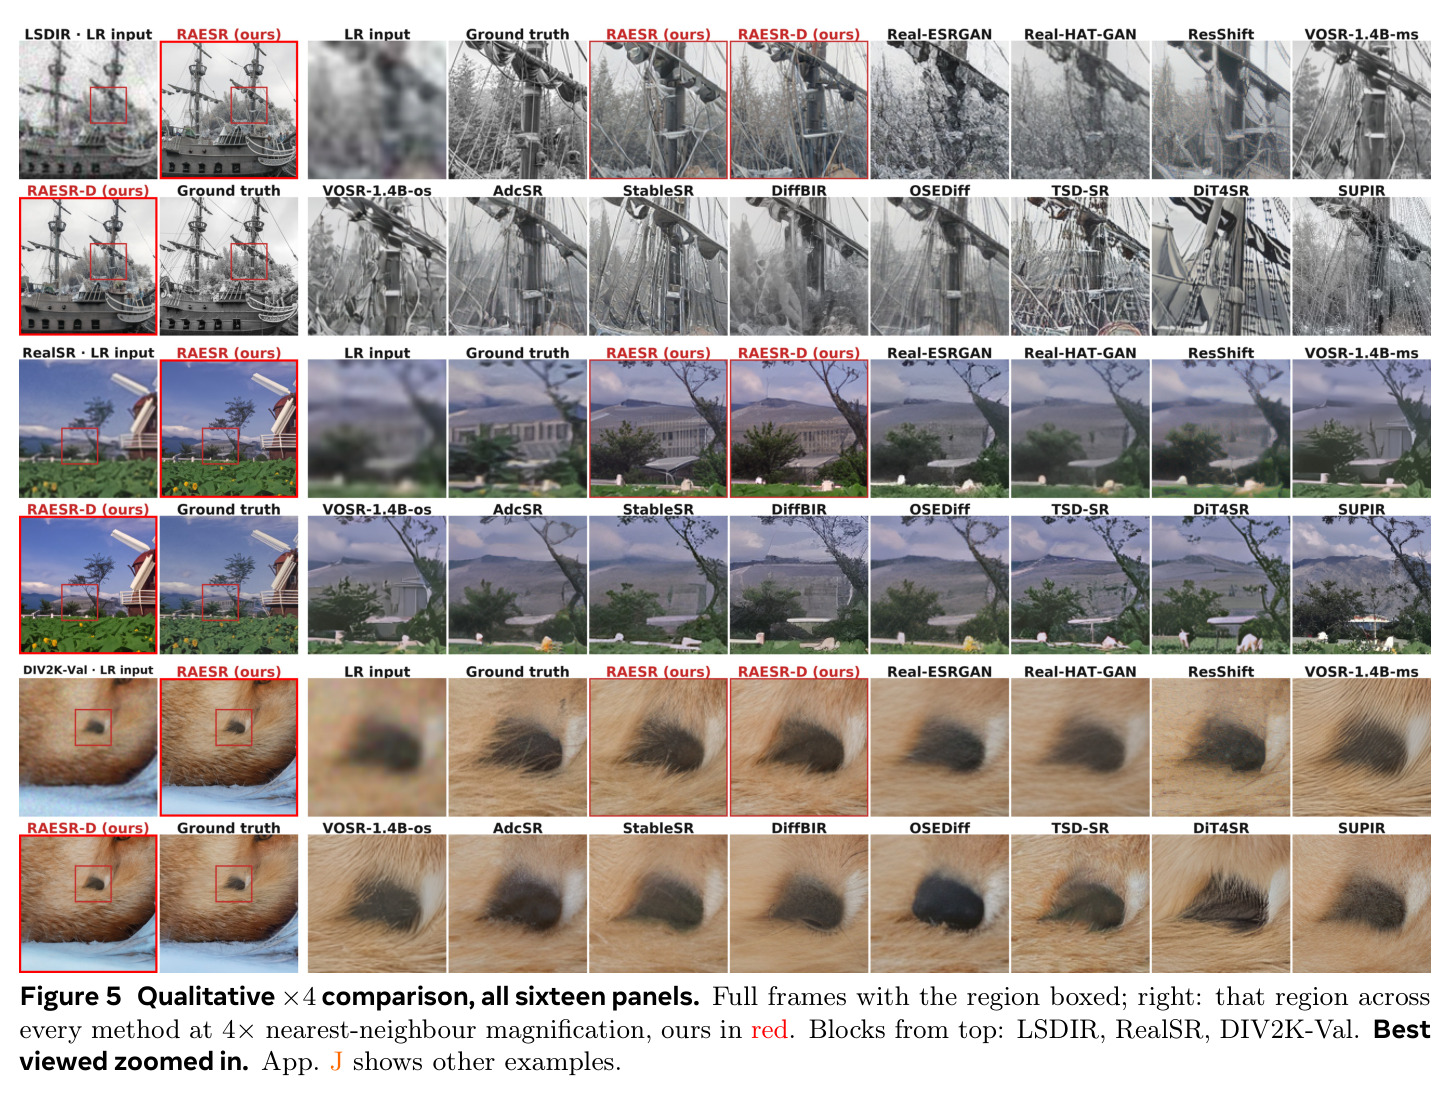
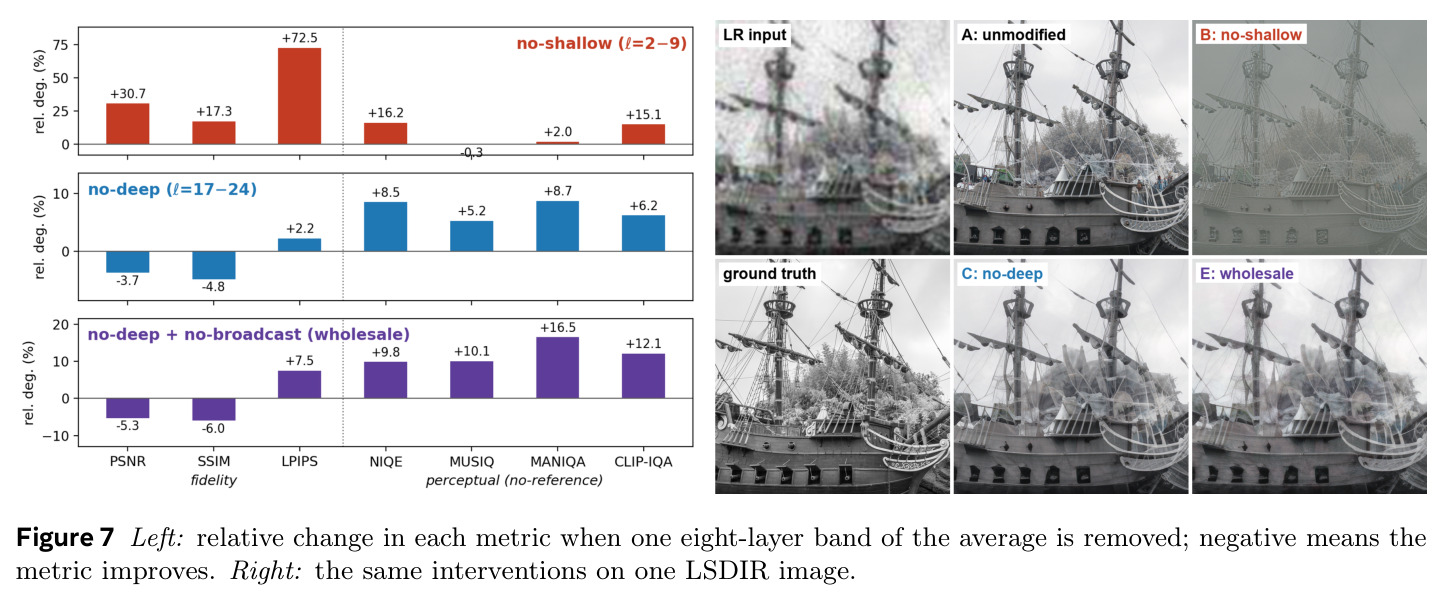
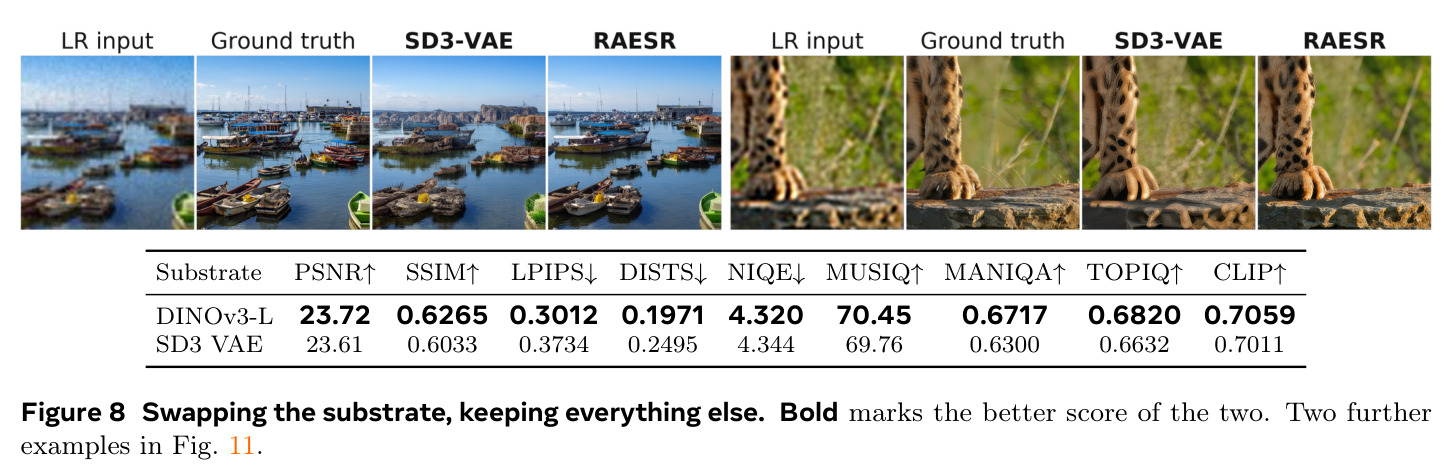
主实验在 RealSR(100)/DRealSR(93)/LSDIR(250)/DIV2K-Val(3000) 四基准上做 ×4 真实超分,对比 12 个官方权重方法。RAESR 四基准平均:PSNR 24.08、SSIM 0.6269、LPIPS 0.3007、DISTS 0.1970、NIQE 4.319、MUSIQ 70.51、MANIQA 0.6713、TOPIQ 0.6815、CLIP-IQA 0.7049,在 NIQE/DISTS/MANIQA 三项全场第一、LPIPS/MUSIQ/TOPIQ 三项第二(LPIPS 仅以 0.0071 之差落后 TSD-SR 的 0.2936),综合权衡均为第一;成本 719M 参数、37.2 ms、1.57 GiB(128→512,单张 H20,batch 1)。效率上比最快的一步扩散基线 AdcSR(59.5 ms)快 1.6×,比 20–50 步方法快 59–514×(SUPIR 19,112 ms);最近的竞争者 TSD-SR 参数是它的 3.1×、慢 2.8×。蒸馏版 502M/30.0 ms/1.18 GiB,性能小幅回落。人评二选一(100 图、展示输入与真值、匿名随机化、带 catch trial 质控):RAESR 对 Real-HAT-GAN 偏好率 86.2%、对 DiffBIR 70.7%、对 SUPIR 57.7%、对 TSD-SR 52.6%,全部胜出。归因分析三条证据链:① 潜空间插值线实验(2,000 张 LSDIR)显示融合潜空间沿 $z_\alpha$ 解码远早于 SD3-VAE 恢复自然统计(NIQE≤5 在 $\alpha=0.47$ vs 0.65 越过;LPIPS≤0.35 在 0.50 vs 0.63),随机方向对照与 SD2.1 复现排除了解码器锐化偏置的可能;② 逐带消融:去掉浅层带(第 2–9 层)PSNR 从 23.72 崩到 16.43 而感知指标仅微降,去掉深层带(第 17–24 层)PSNR 反升到 24.60 但 MUSIQ 掉到 66.75,再去掉广播项 MUSIQ 进一步掉到 63.35——浅层管保真、深层管语义;③ 基底替换:同一配方换冻结 SD3-VAE 后九项指标全败(LPIPS 0.3734 vs 0.3012,DISTS 0.2495 vs 0.1971,MANIQA 0.6300 vs 0.6717),重退化的 LSDIR 上差距最大(LPIPS +0.081),重退化下要么画出自信而错误的内容、要么出不了干净图,证明性能来自表征本身而非配方。定性上(Fig. 5),RAESR 是唯一恢复出背景顶棚、保留背景建筑、并正确重建狐狸鼻子上毛发拂过方向的模型。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ×4 真实世界超分(四基准宏平均) | NIQE↓(无参考感知质量) | 4.319 | TSD-SR 4.733(全场第二) | 绝对改善 0.414,全场第一 |
| ×4 真实世界超分(四基准宏平均) | DISTS↓(感知保真) | 0.1970 | TSD-SR 0.2026 | 降低 0.0056,全场第一 |
| ×4 真实世界超分(四基准宏平均) | MANIQA↑ | 0.6713 | DiT4SR 0.6573(全场第二) | +0.0140,全场第一 |
| ×4 真实世界超分(四基准宏平均) | LPIPS↓ | 0.3007 | TSD-SR 0.2936(全场第一) | 落后 0.0071,全场第二 |
| ×4 真实世界超分(128→512,单张 H20,batch 1) | 推理延迟 / 参数量 | 37.2 ms / 719M(NFE=1) | AdcSR 59.5 ms(最快一步扩散基线);SUPIR 19,112 ms / 18,152M | 比 AdcSR 快 1.6×,比 SUPIR 快约 514×、参数小 25× |
| 人评二选一(100 图,剔除平票) | RAESR 被偏好比例 | vs TSD-SR 52.6% | vs Real-HAT-GAN 86.2% / DiffBIR 70.7% / SUPIR 57.7% | 对四个强基线全部胜出 |
| 基底替换消融(同配方换冻结 SD3-VAE) | LPIPS↓ / MANIQA↑(四基准平均) | 0.3012 / 0.6717(DINOv3-L 基底) | SD3-VAE 基底 0.3734 / 0.6300 | 九项指标全胜,证明基底是性能来源 |
局限与改进
作者承认两条:一是单步无条件生成,没有用更多计算换更质量的机制,困难图像不能像多步扩散那样追加步数;二是『什么使基底合适』的结论只在 DINOv3 一个编码器家族上验证,对照基底只测了 SD3-VAE 一种。我的补充观察:① 像素级保真指标(PSNR/SSIM)低于像素空间 GAN 基线(24.08/0.6269 vs Real-HAT-GAN 25.56/0.6829),这是对抗方法的固有权衡,对逐像素保真敏感的场景(医学、遥感、文档)需谨慎;② 相对论 critic 抑制但不消除幻觉——对抗训练本质上奖励『看起来真实』的补全,重降质下语义指引仍可能指向错误细节;③ 全部评测固定在 512×512、16px patch 粒度,更大分辨率与非整数倍缩放的泛化未验证;④ 人评池仅 100 图、每基准抽 25 张,且对 TSD-SR 的优势(52.6%)相当微弱;⑤ 无参考指标(NIQE/MUSIQ 等)虽经核查各方法均未用作训练信号,但这类指标对纹理增强敏感,不完全等同人眼质量;⑥ 蒸馏版在 RealSR 上 PSNR 从 25.00 掉到 23.45,部署小模型时需重新权衡保真。
独立分析的弱点
独立分析四个弱点。① 单步 GAN 无质量-算力旋钮:遇到极端退化(严重压缩叠加运动模糊)时一步映射可能落错点,而论文自己论证长映射可以靠多步换质量——改进方向是在同一 DINOv3 潜空间内加一个可选的少步扩散/流精炼头,默认一步、难例多步,共用冻结基底,成本增量小且空间选择的一致性保留。② 证据面窄:『近流形 + 层级』两条判据只在 DINOv3-L 上成立、只对照 SD3-VAE,无法区分『任何足够强的 SSL 编码器都行』与『只有 DINOv3 行』两个极端——应系统评测 DINOv2、MAE、SAM、SigLIP 等作为基底的同一配方,这既检验主张又可能找到更优基底(更深层级、更强退化鲁棒性)。③ 语义先验绑定 DINOv3 的训练分布:基底冻结意味着其语义(17 亿张网络图像的分布)不可适配,对流域外内容(医学影像、工程图纸、汉字文档)融合层级的『语义指引』可能失效甚至误导合成——可在阶段 3 对浅层加 LoRA 或引入轻量域适配器,同时保住近流形性质;蒸馏前端也表明在不重训解码器的前提下替换编码栈是可行的。④ 评测与部署粒度固定:16px patch、512² 输出,任意尺寸大图需切块,块间缝隙在训练中靠 critic 网格错位技巧压制,推理时的拼接策略未讨论——可用重叠裁剪加边界融合,或利用 2D RoPE 训练随机分辨率来扩展。另外工程上编码器占 42% 推理参数(303M),虽已给出蒸馏方案,但蒸馏后保真下降明显,端侧部署仍是开放问题。
未来方向
作者的展望隐含在结论中:让 SR 社区把『选基底』当作与架构、损失同等重要的研究对象。可延伸的方向:① 把同一冻结基底推广到其他修复任务(去噪、去模糊、去雨雾、上色、修补),检验『近流形 + 层级』判据的普适性;② 系统扫描编码器家族(DINOv2/v3 各规格、MAE、SAM、SigLIP 等)建立『基底基准』,并研究融合层数 K、广播项与融合权重的影响;③ 在 DINOv3 潜空间里训练扩散/流模型,以多步换质量,与一步 GAN 共享基底形成可调谱系,正好补上作者承认的『无算力旋钮』短板;④ 把潜空间插值线、逐层 $R^2$ 恢复、子空间包含度这套几何分析工具发展为『基底体检』的标准流程,供后续工作快速评估新基底;⑤ 蒸馏前端(28.7M+57.8M)已证明表征可压缩,可进一步蒸馏到端侧实时超分;⑥ 引入退化感知条件化(把退化类型/强度编码进 token 或调制解码器),有望进一步压低重降质下的幻觉率;⑦ 视频超分是该基底的自然延伸——DINOv3 的时间一致性尚待研究,但逐帧语义稳定性可能带来时序增益。
复现评估
论文正文未给出代码或权重的明确链接,但通篇以『released model / released decoder』指称自己的模型,暗示会随论文发布,建议搜索项目页确认。复现的资源需求:需要 Meta 的 DINOv3-L/16 权重(冻结编码器,303M)、官方 RAEv2 ViT-XL 重建解码器作初始化、DINOv3-B 作 critic 底座;训练数据为 LSDIR 训练集 84,991 张(阶段 1/2)加 FFHQ-1024 与 Aesthetic-4K(阶段 3,合计 166,994 张独立图像、约 142 万行加权清单),退化在线合成、无需预生成低清集。算力:阶段 2 为 4 卡 × batch 4 × 5 万步,阶段 3 仅 600 步(2 卡 × batch 64 全局),蒸馏 2 万步——单机 4×A100/H100 量级数天量级可完成,在 GAN 修复器中属于偏轻的训练。附录 I 详尽到种子(42 与 20260812)、EMA 系数 0.9978、学习率日程与 critic 调度,评测协议确定性到机器精度,九个指标实现与各基线官方默认配置均有交代,因此复现评测门槛低、复现训练的主要风险在 GAN 稳定性细节(patch 错位、warmup、TTUR 等敏感超参),好在关键技巧都已写明。
论文图表
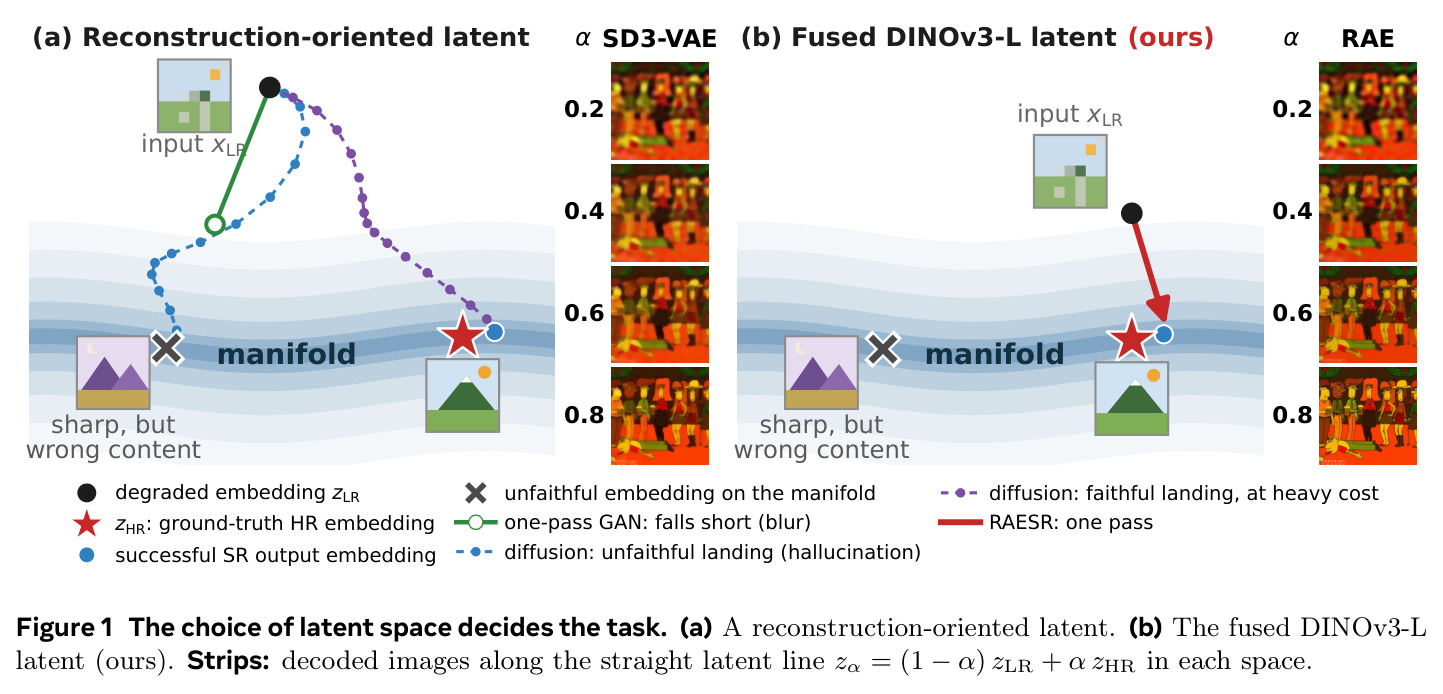
左右两个面板对比两种潜空间:重建导向的 SD3-VAE 潜空间中,降质嵌入 $z_{LR}$ 离流形很远——一步 GAN 落不到流形(发糊)、扩散虽能落到流形但常落错点(幻觉);融合 DINOv3-L 潜空间中 $z_{LR}$ 已靠近流形,单步映射即可。下方色条是沿直线 $z_\alpha$ 逐点解码的图像序列:RAE 空间明显更早变得清晰自然。
这是全文核心论点的图示:任务难度由空间选择决定。理解『为什么换基底』从这里开始,插值线色条也是后文 §5.1 定量实验的直观预演。