与开放世界共同演化:面向未来预测的递归自我改进 Evolving with Open Worlds: Towards Recursive Self-Improvement for Future Forecasting
以真实未来事件预测为活环境,参数、技能、环境三轴共演化实现递归自我改进
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指系统从自身经验中持续变强的能力:一轮改进的产物(参数、技能、环境)成为下一轮改进的输入,形成自我强化的闭环,而不是一次性提升后饱和。与单次训练不同,它强调能力随时间复利式累积。
这是全文的核心命题:论文把 RSI 形式化为状态 $\Sigma^{(t)}=(\theta,\mathcal{S},\mathcal{E})$ 经三个进化算子逐轮推进,理解它才能看懂三个模块为何这样设计。
可验证奖励强化学习(RLVR)与 GRPO
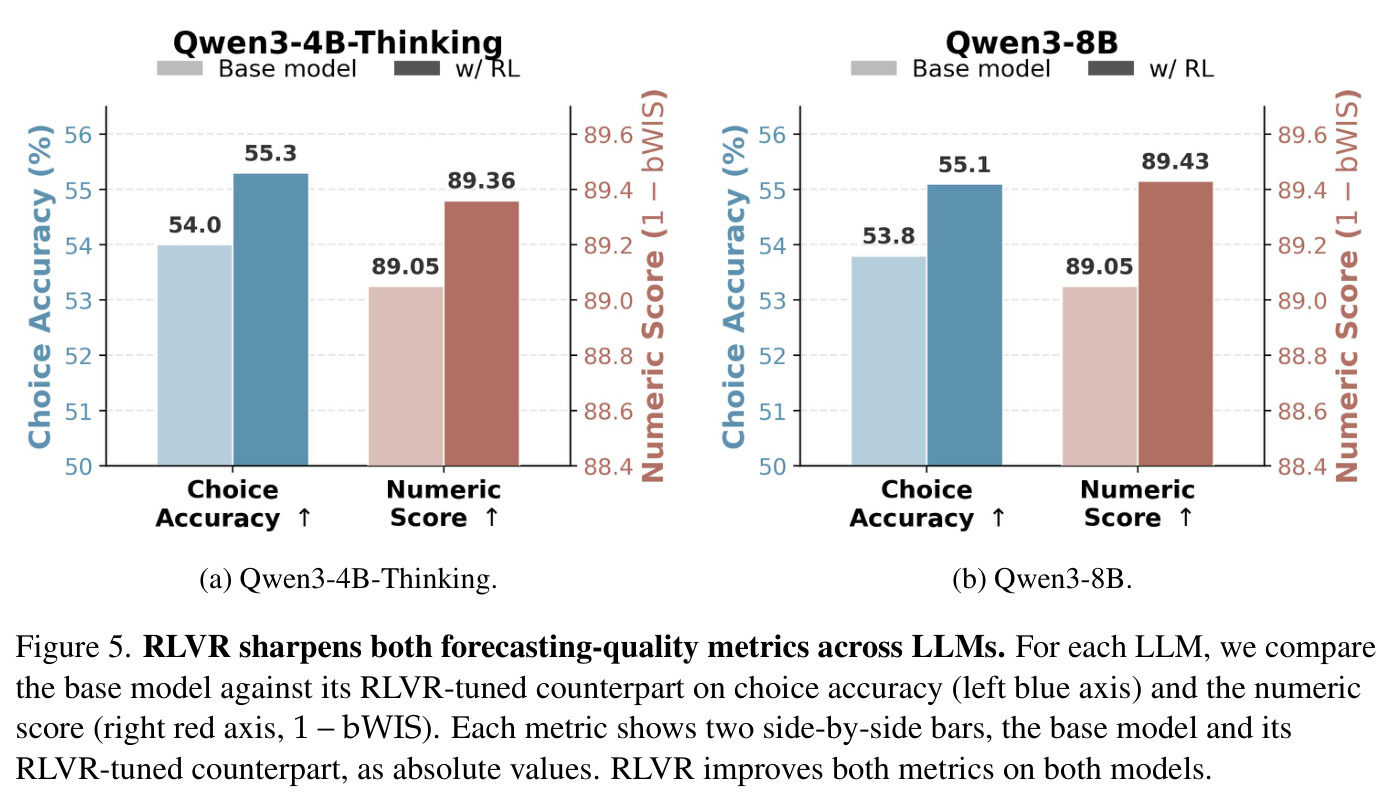
RLVR 用客观可核验的结果(此处为事后揭晓的真实事件结果)当奖励,无需人工标注。GRPO(Group Relative Policy Optimization)在同一题上采样 $G$ 个回答,用组内归一化 $A_i=(r_i-\text{mean})/\text{std}$ 计算相对优势,再做裁剪的策略梯度更新。
ATHENA 的参数级进化就是用 GRPO 在缓存证据上训练预测队,公式 (10)(11) 是方法核心;不懂 RLVR 就无法理解奖励如何来自真实世界。
拒绝采样微调(RFT)
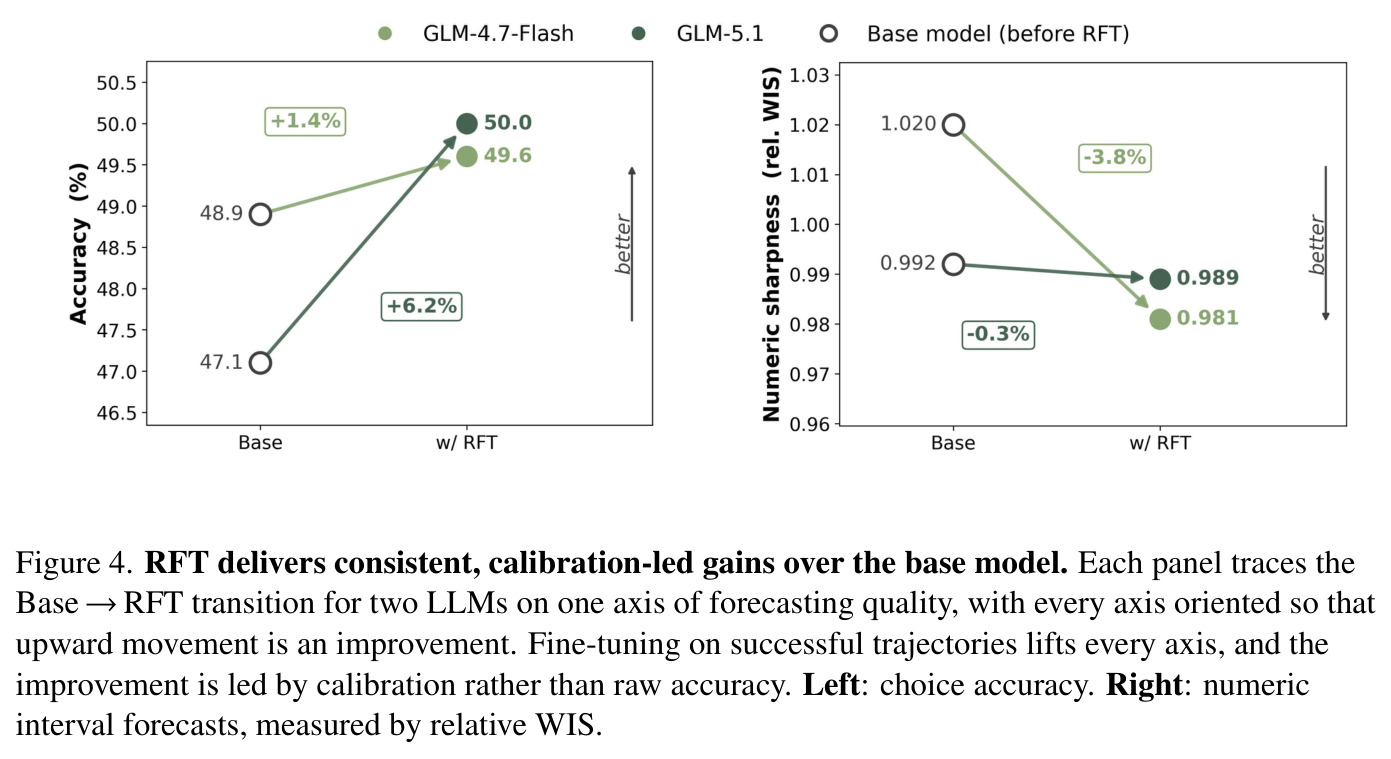
一种轻量微调范式:只在成功的推理轨迹(预测与真值一致的样本)上做监督微调,而不是像 RL 那样做在线采样与策略梯度。成本低于 RLVR,常作为多轮自改进的温和更新方式。
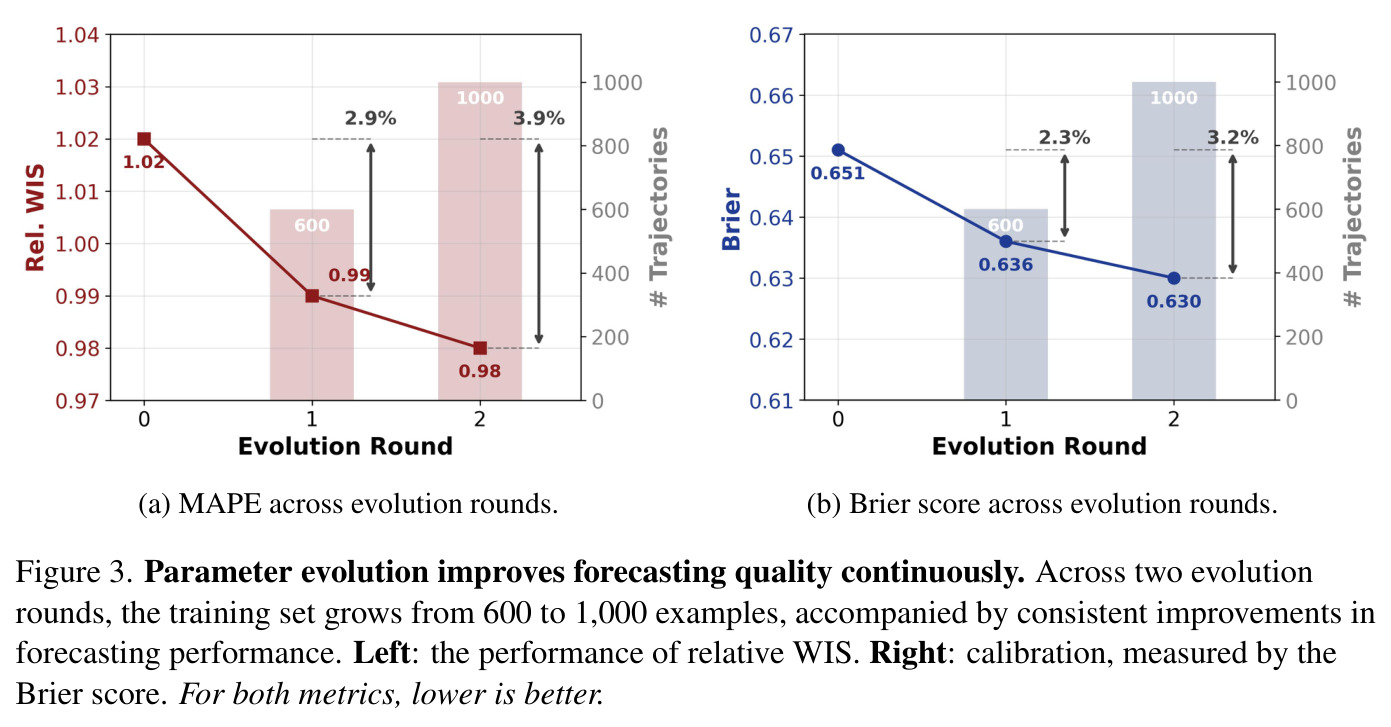
论文用 RFT 与 RLVR 两条路线做参数进化(Figure 3、4、10),多轮 RFT 是展示'逐轮复利'的关键证据。
Bradley–Terry(BT)评分
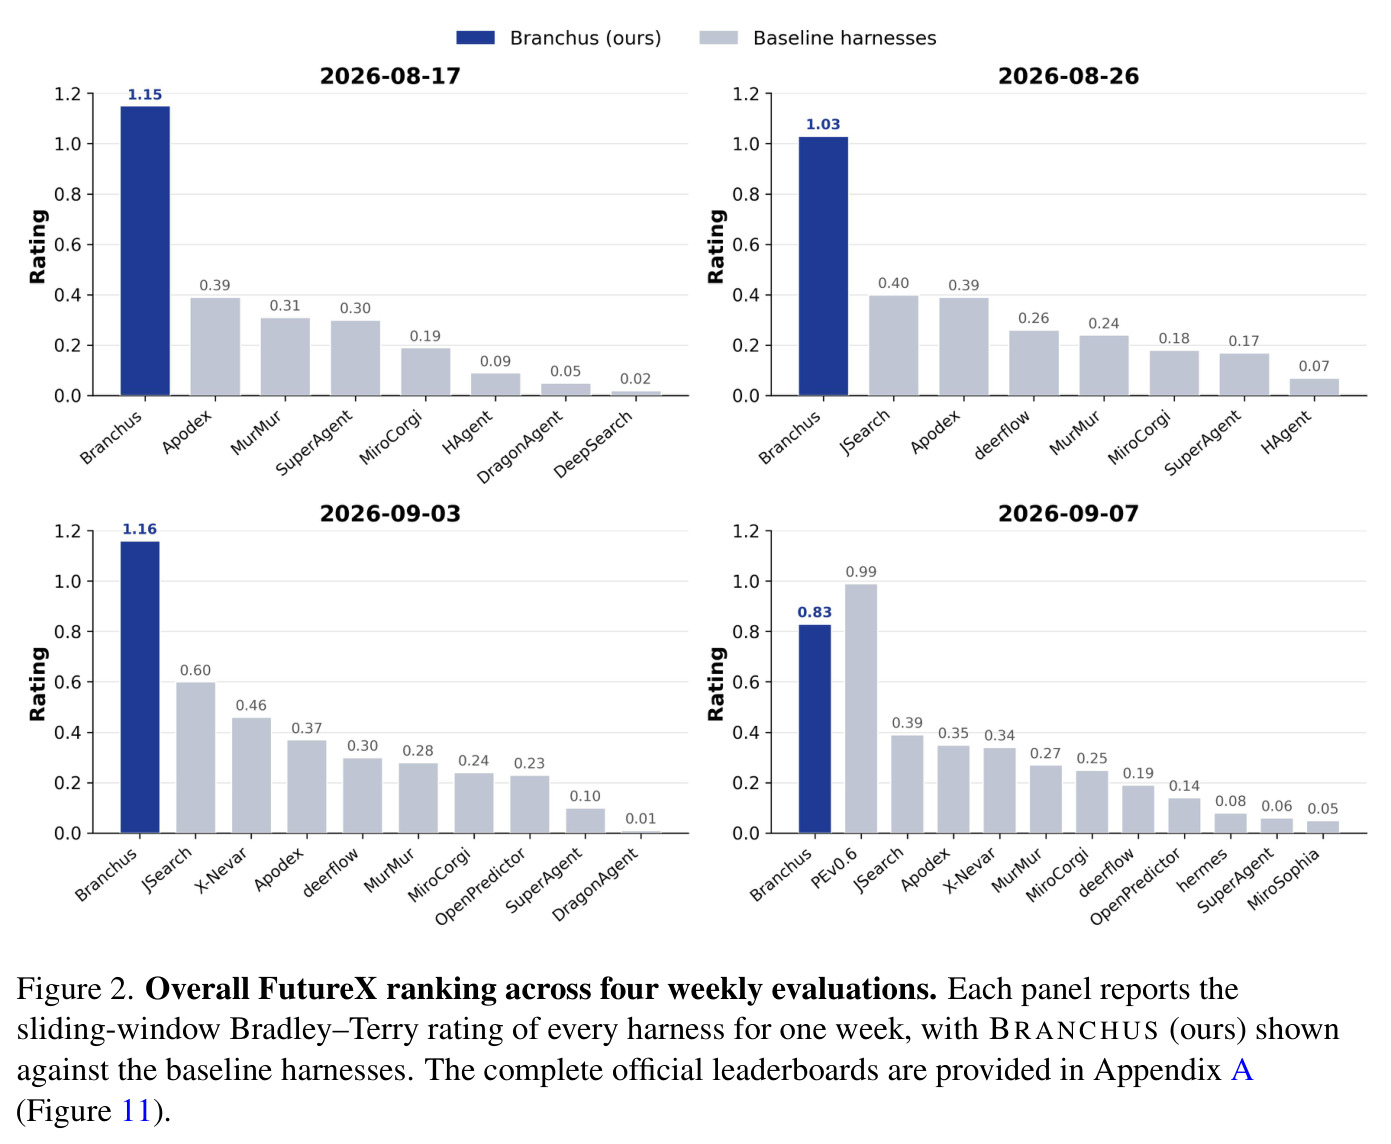
从成对比较结果推断每个系统潜在实力的统计模型,常用于排行榜(如国际象棋等级分)。FutureX 官方用滑动窗口 BT:每周各系统的两两对局结果被汇总为一个跨周一致的综合实力分。
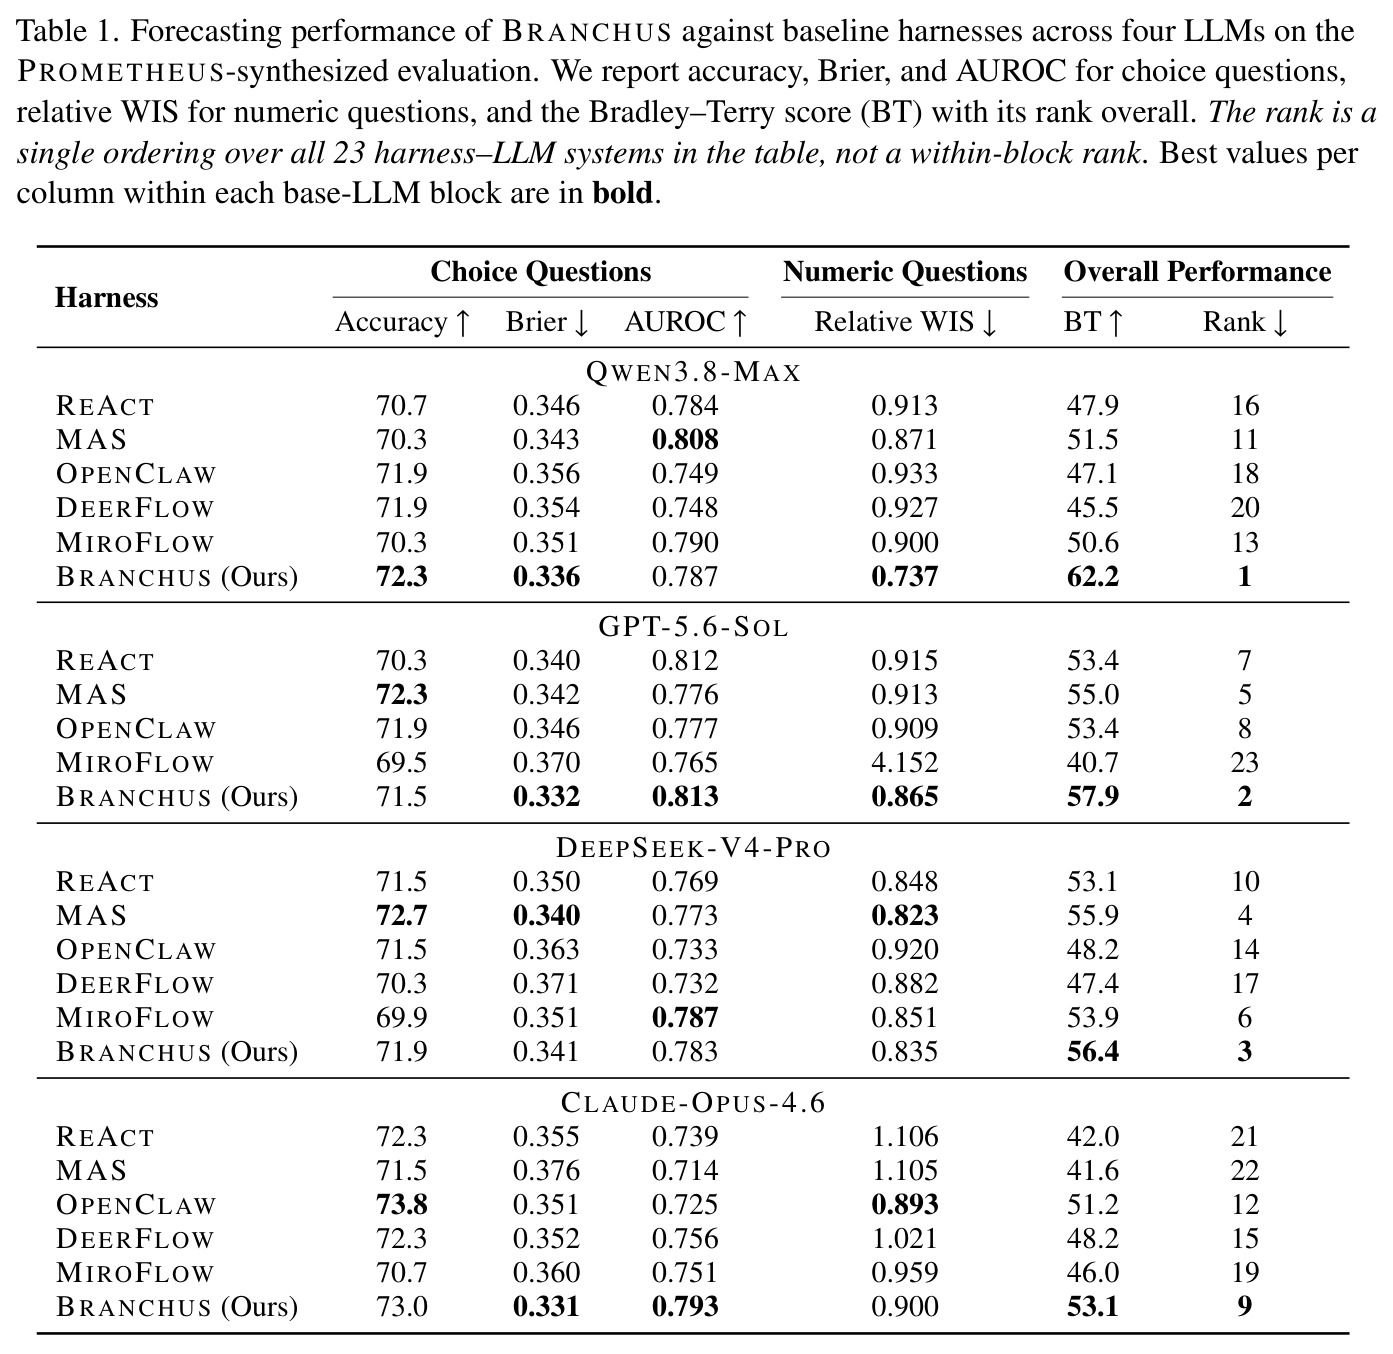
Table 1 的总排名列与 FutureX 排行榜都以 BT 为主指标,BT 融合了准确率与校准,是判断'谁是最强预测系统'的官方标尺。
Brier 分数与概率校准
Brier 分数是预测概率与实际结果之间均方差,越低越好,同时惩罚过度自信的错误和没有依据的犹豫。校准指预测概率与经验频率一致:说 70% 的事件应约七成发生。它是连续指标,比二值准确率更敏感地反映置信度的细微移动。
论文反复论证 Branchus 的优势在'校准'而非裸准确率:RLVR 使校准提升 0.31–0.38 而准确率仅动 1.3 分,校准被用作训练见效的早期信号。
加权区间得分(WIS)与相对 WIS
WIS 评价区间/分位数预测的质量,综合惩罚区间过宽(不锐利)与真值落在区间外(不准)。相对 WIS 以某基线归一,低于 1 表示优于基线;MAPE 与 Md-sAPE 则度量数值点预测的相对误差。
数值型预测题的成绩全靠 WIS/MAPE/Md-sAPE 评估(Table 1 与 Figure 3、6、10),不理解这些指标就读不懂'区间更紧、校准更好'的结论。
数据污染(Contamination)
指训练/评测数据泄露到模型可检索范围的问题。在未来事件预测中尤为尖锐:事件一旦解决,答案立刻可从网络搜到,之后再在该题上训练,模型学到的是'查答案'而非'做预测',训练信号被污染。
污染是本文方法设计的直接动因:搜索-预测解耦 + 冻结证据缓存,就是为了让 RLVR/RFT 在答案已公开的活环境中仍能获得干净的可验证奖励。
技能库与四层技能表示
技能是放在权重之外、推理时检索调用的程序性知识条目。本文每条技能为四层元组 $s=(s_1,s_2,s_3,s_4)$,从跨领域原则逐层具体化到可直接执行的步骤/信息源;检索时保留'仍适用于当前问题的最具体层级'。
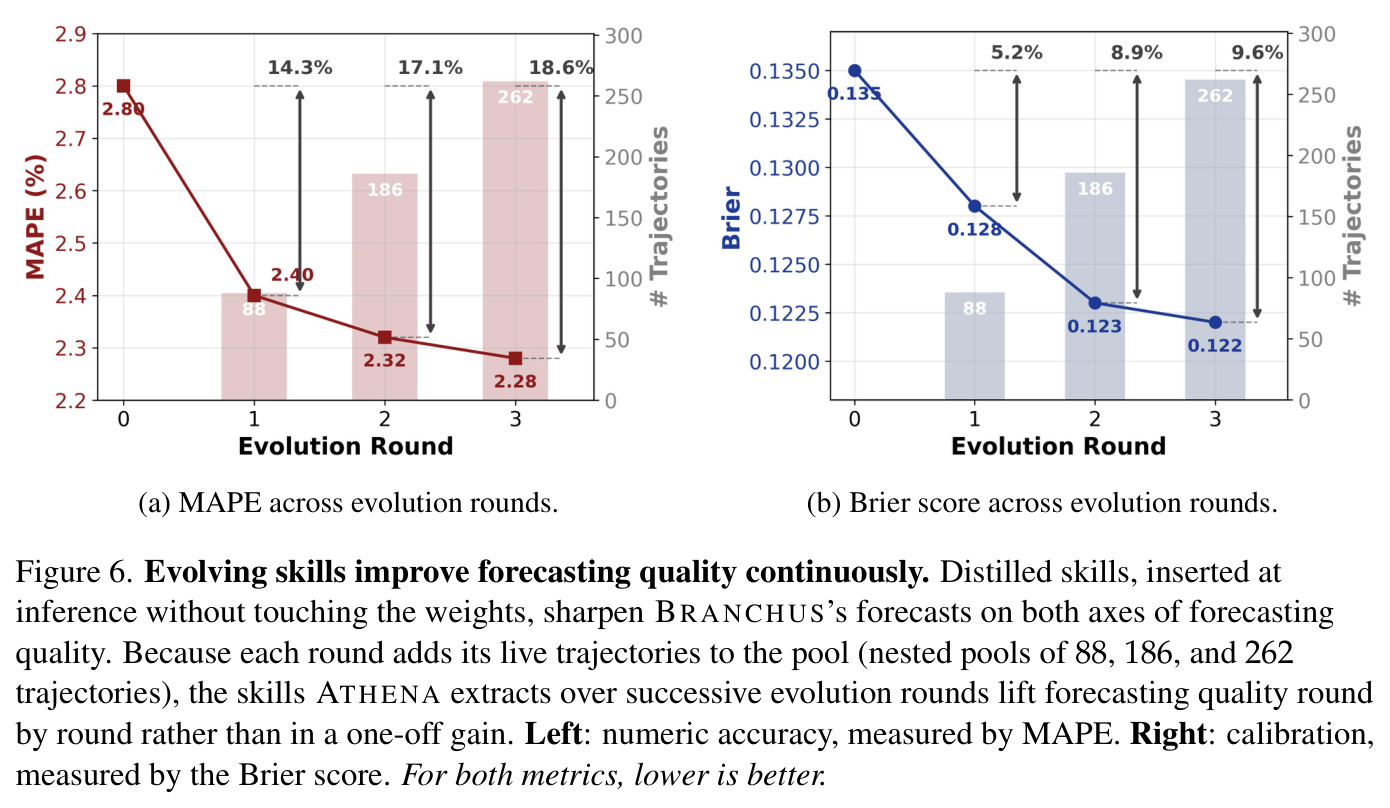
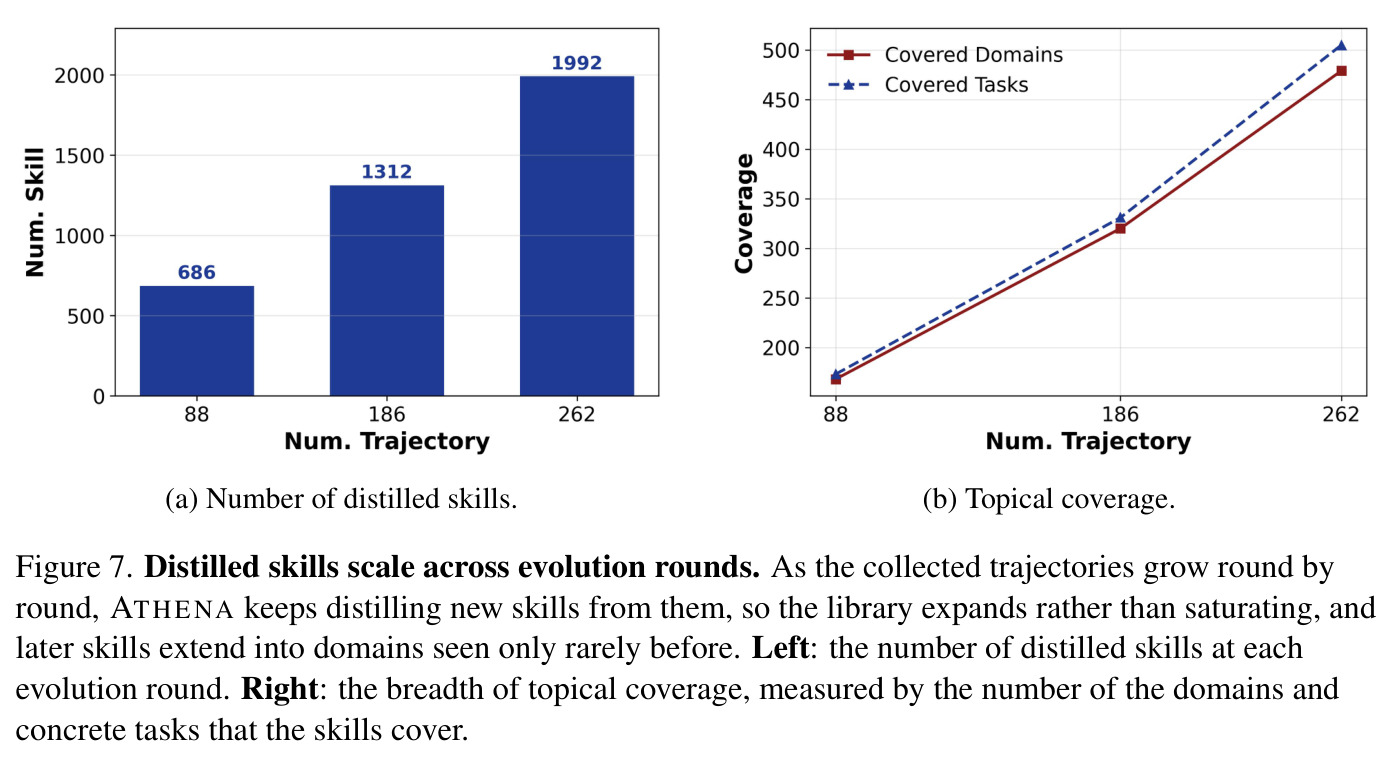
行为级进化 $\Phi_{\text{skill}}$ 的产物就是这个技能库(Figure 6、7、8),它是与参数进化互补的第二条自改进路线,也是'少量轨迹即可涨点'的关键机制。
研究动机
当前主流 AI 系统在发布时参数即被冻结,后续改进完全依赖外部干预:评估是静态的,模型在固定数据集上被打分,而这些数据集会被记忆或污染;提升是被动的,能力增长靠人工策展的数据和离线重训练驱动,而非系统自身经验。相邻研究路线也各有缺口:在自生成数据上做 self-training 缺乏外部可验证真值,容易放大模型自身偏见;持续学习处理的是静态或人工切分的任务流,而非真实、非平稳的反馈;面向推理的强化学习只在单个任务上优化奖励,改进不随时间复利。在真实事件预测场景中问题更尖锐:一旦事件解决,答案立刻成为可从网络检索的公开信息,任务的'清洁训练窗口'极短,而 RFT/RLVR 需要在同一批任务上反复 rollout 与精炼,留给训练的无污染、可验证经验严重不足——这是把活环境直接当训练场时一个很实际的死结。
本文的目标是本文要研究并实现递归自我改进(RSI):一个能从自身经验中持续变强的系统,上一轮改进的产物(参数、技能、环境)成为下一轮改进的输入,形成自我强化循环而非一次性收益后饱和。作者选择真实世界的未来事件预测作为试验台,因为它天然满足 RSI 研究对环境的三重要求:有根据(扎根于不断展开的真实世界而非人造数据集)、可验证(客观真值随时间自动到来,无需人工标注)、非平稳(世界持续变化、挑战不断更新)。具体拆成三件事:其一,构建一个真实、动态、可验证的预测环境,每天从真实新闻合成次日解决的题目;其二,设计一个能记录完整推理轨迹、可被强化的智能体预测系统;其三,构造进化引擎,把每条轨迹同时转化为参数更新、可复用技能和更难的对抗性任务,让智能体与环境共同演化、改进逐轮复利。
与已有工作不同的是,本文的独特切入在于:以往自我改进工作大多只推单一杠杆——或改模型权重、或改提示、或改记忆——作者则论证可持续自我改进的源头是'活环境':只有环境不断提出新挑战并自动判分,改进才有源源不断的经验可吃,否则任何单杠杆都会耗尽同一任务分布而饱和。方法上作者把事件预测从'追求单次精度的任务'重新定义为'研究智能体如何进化的环境'。针对活环境易污染的痛点,提出按时间敏感性解耦智能体:时间敏感的搜索队在事件解决前抓取并缓存证据,时间不敏感的预测队此后在冻结证据上反复训练,从而让原本难以落地的 RLVR/RFT 适配这种清洁窗口极短的环境。更关键的是,同一批稀缺的活轨迹被同时喂给三个杠杆——强化进参数、蒸馏成可复用技能、挖掘失败模式生成更难的对抗任务——而以往工作至多利用其中一种。
核心方法
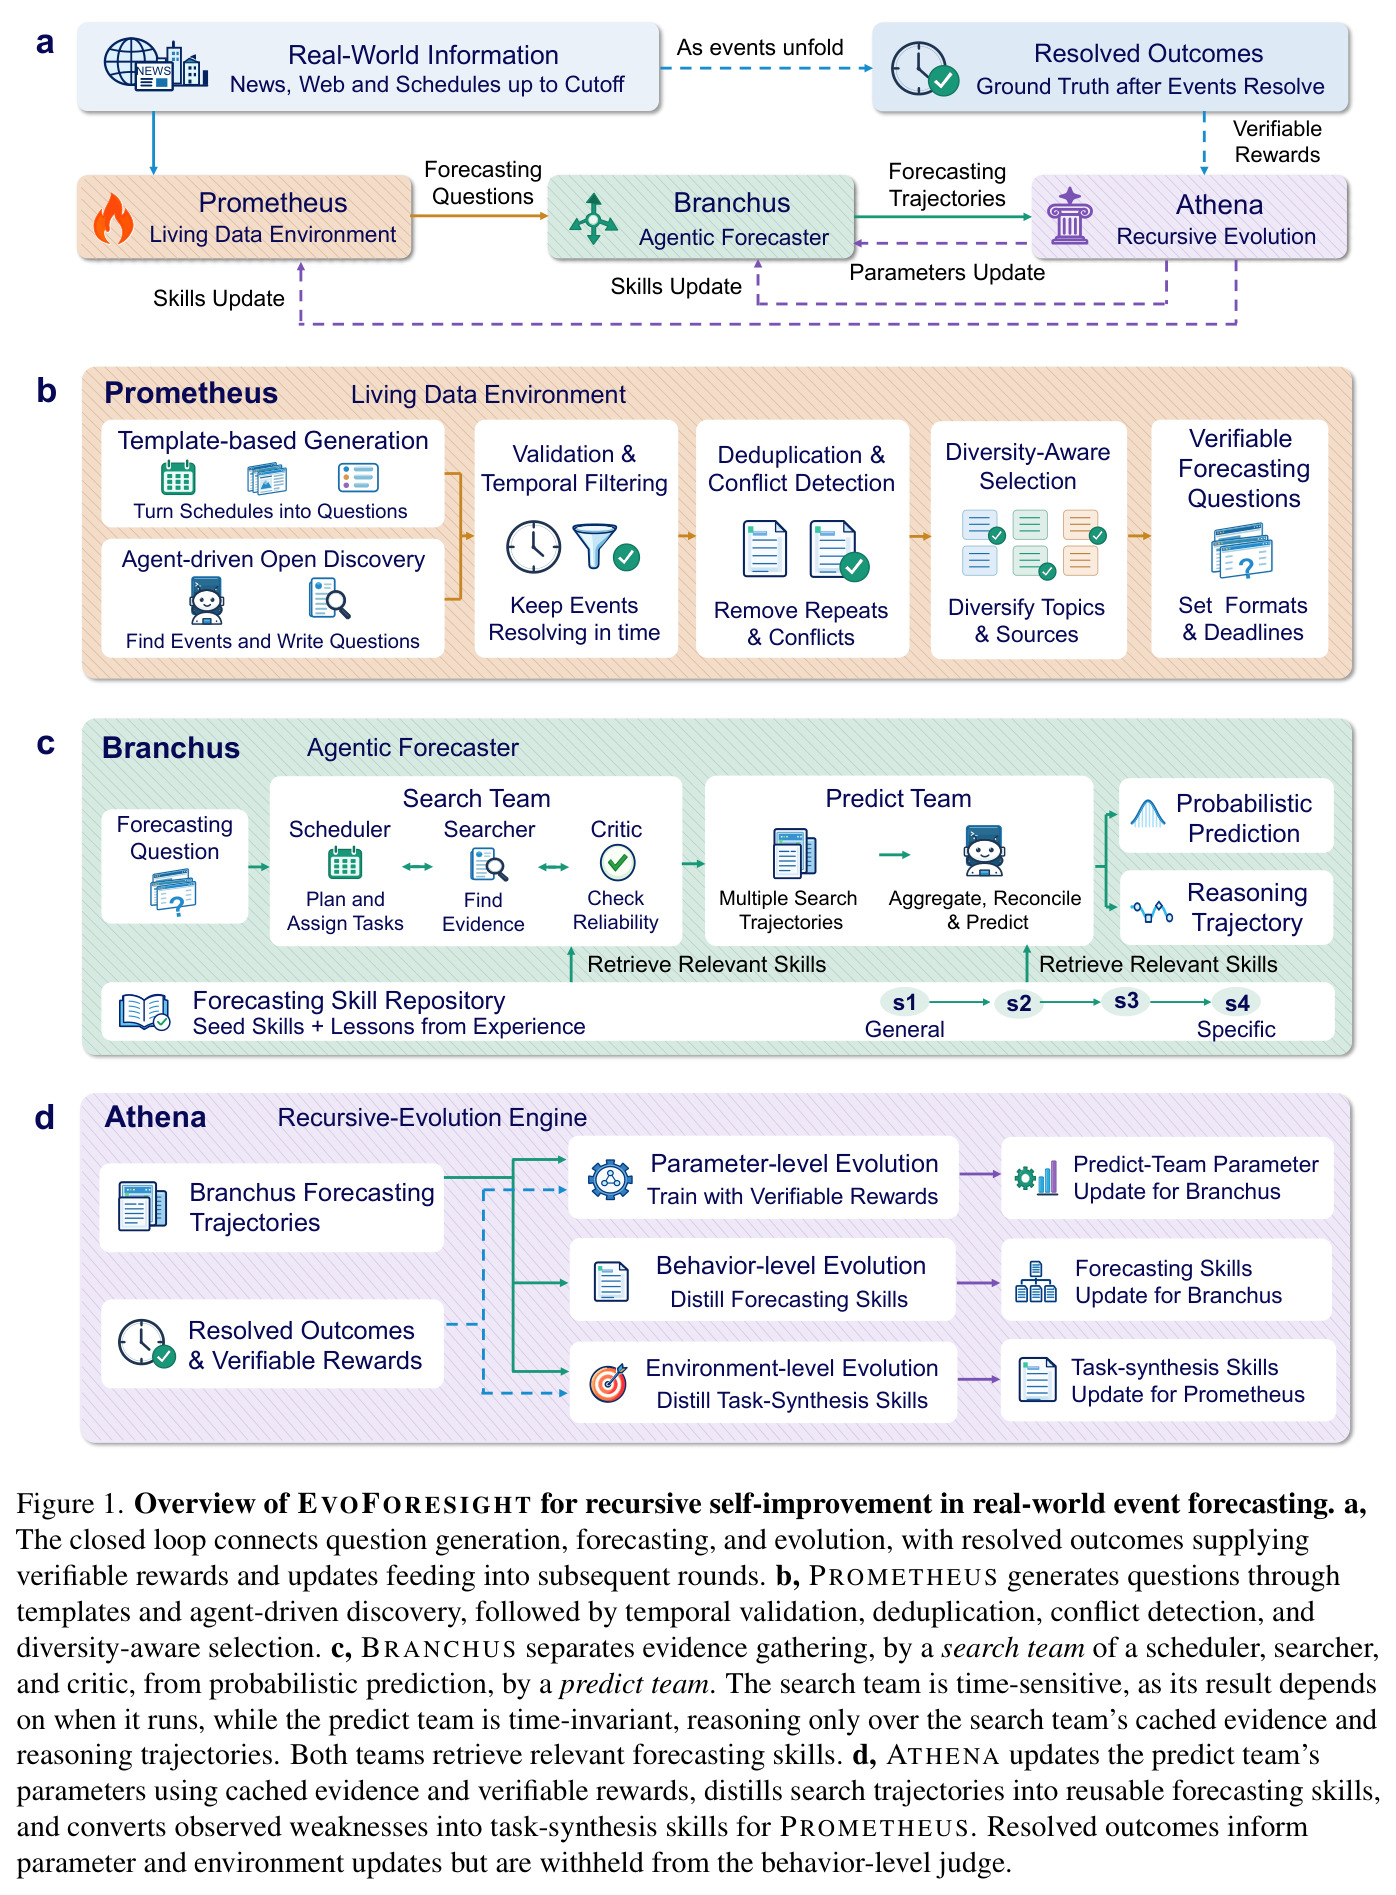
直觉上这个系统像生物体一样成长:世界不断提供新任务与客观反馈,系统把每次预测的完整推理轨迹'消化'成能力。技术路线是三模块闭环而非流水线。PROMETHEUS 是活数据环境:每天从 125 个网站抓取新闻与日程,合成次日解决的预测题,真值在事件发生前尚不存在。BRANCHUS 是智能体预测器:调用外部工具搜集证据并给出概率预测,同时产出完整轨迹,形式化为 $(\hat{p},\tau)\sim\pi_\theta(\cdot\mid q,\mathcal{S})$,题目为元组 $q=(e,o,f,t_{\text{cut}},t_{\text{dl}})$。ATHENA 是递归进化引擎,用三个算子把轨迹变回能力:$\Phi_{\text{rl}}$ 以可验证奖励强化学习更新参数,$\Phi_{\text{skill}}$ 把轨迹蒸馏成技能,$\Phi_{\text{env}}$ 从失败中合成出题技能使环境更难。系统状态 $\Sigma^{(t)}=(\theta^{(t)},\mathcal{S}^{(t)},\mathcal{E}^{(t)})$ 逐轮推进,奖励 $r(q,\hat{p})=\mathbf{1}[\arg\max_o\hat{p}(o)=y_q]$ 由事件真值而非人工标注提供。
核心创新有三点。第一,按'时间敏感性'而非角色来分解智能体:搜索队(调度器+搜索器+批评者)的工作依赖执行时刻——事件临近时证据在变、事件解决后答案可直接检索——必须趁题目开放时完成并缓存证据与轨迹;预测队的时间不变,只读取缓存的 $m$ 条搜索轨迹 $\{\tau_{\mathcal{S}}^{(j)}\}$,聚合调和后输出 $\hat{p}$。这一解耦让多轮 RLVR/RFT 全部在冻结证据池上进行:既避开'答案已可检索'的污染,也堵死 RL 的 on-policy 捷径——预测队无法影响自己看到的证据,收益只能来自对同一信息的更好推理。第二,同一条轨迹同时喂三个杠杆:强化进参数、蒸馏成技能、挖出失败造更难环境,三者共享同一经验基底。第三,环境作为教师:ATHENA 按类别统计错误率 $\rho^{(t)}(c)$,把难度定向加到智能体最弱的维度(数值预测、阈值判断等),同时冻结每道题的客观性与可解决性,只移动难度。
方法步骤详情
一轮进化(Algorithm 1)分三步。第一步任务合成:PROMETHEUS 抓取网页得语料,经模板实例化与智能体开放发现(Codex 从当日新闻自拟题目)生成草稿,再经时间过滤(保留 $t_{\text{cut}}<t_{\text{dl}}$ 且 $t_{\text{res}}\le t_{\text{cut}}+H$ 的题)、去重与冲突检测、多样性选择(新事件优先、每事件至多两题、冷门题型优先)后发布 $\mathcal{Q}^{(t)}$。第二步 rollout:搜索队的调度器分解问题、搜索器检索证据、批评者评估可靠性,搜索轨迹被缓存;预测队读取缓存证据输出 $\hat{p}$;事件解决后得到真值 $y_q$ 与奖励。第三步进化:$\Phi_{\text{rl}}$ 用 GRPO 只训预测队,同一证据采 $G$ 个预测,以组内相对优势 $A_i=(r_i-\text{mean}\{r_j\})/\text{std}\{r_j\}$ 做裁剪目标更新;$\Phi_{\text{skill}}$ 走 EVAL→EXTRACT→FILTER→ORGANIZE 四阶段管线,判分时扣留真值,幸存经验泛化为四层技能 $s=(s_1,s_2,s_3,s_4)$,检索时取仍适用的最具体层级;$\Phi_{\text{env}}$ 按类别错误率 $\rho^{(t)}(c)=\mathbb{E}[1-r(q,\hat{p})]$ 为最弱类别合成出题技能,注入下一轮生成器。
技术新颖性
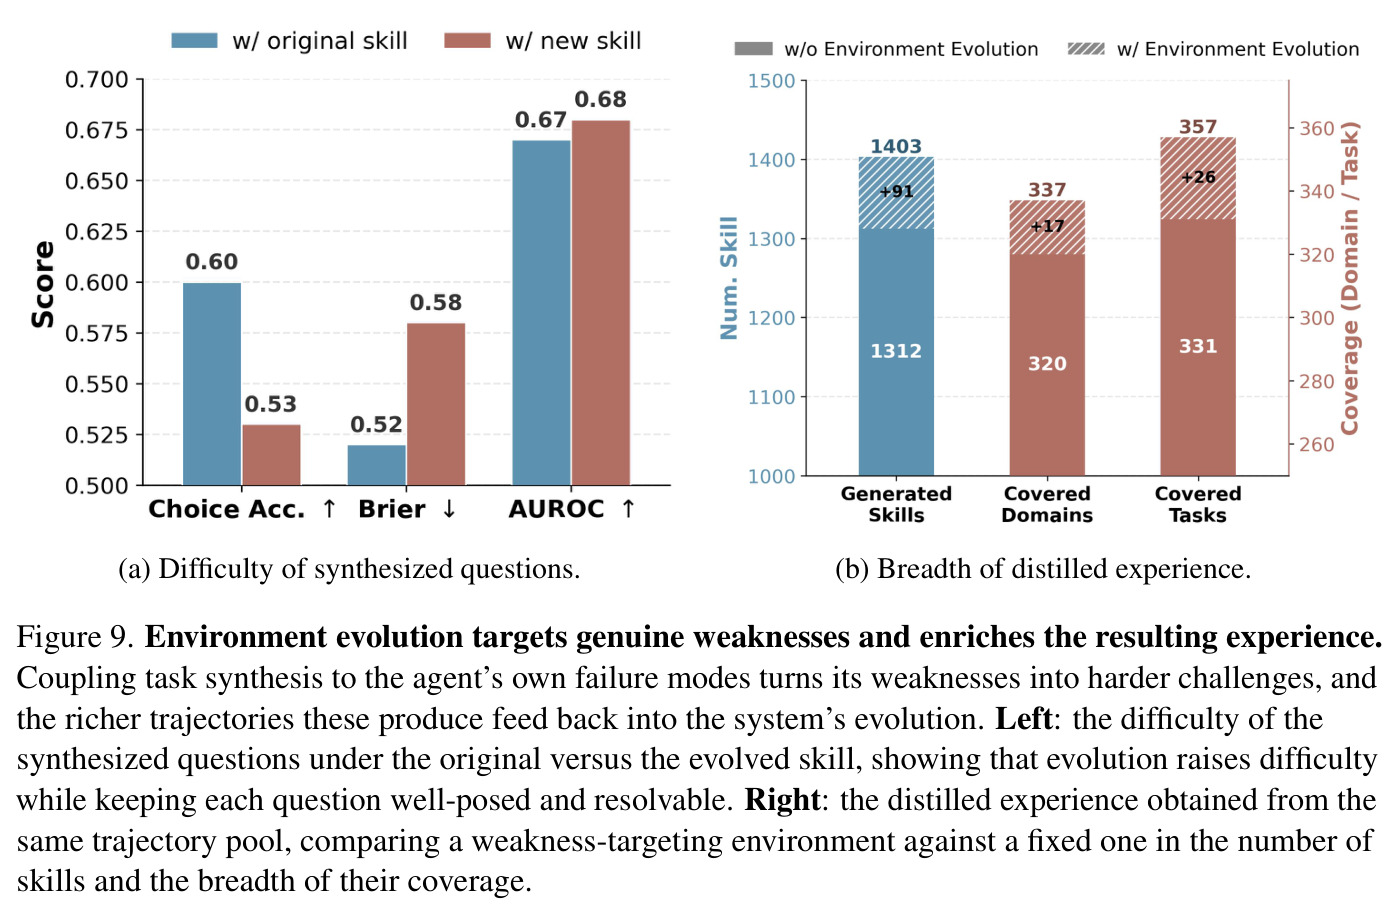
与已有工作的本质区别在于对'递归'的定义与实现:self-training 在自生成数据上循环、无外部真值;持续学习面对人工切分的静态任务流;推理 RL 优化单任务奖励、不跨期复利——本文则让上一轮的参数、技能、环境三产物成为下一轮的输入,且三者源自同一经验基底,这是系统级而非算法级的创新。技术新颖性具体有四点:(1) 以时间敏感性为准则分解智能体,使 RL 训练与活环境兼容,收益可严格归因于'对同样证据的更好推理'而非重新搜索;(2) 四层技能表示配合'最大适用层级'检索 $\ell^\star(s)=\max\{\ell: s_\ell \text{适用于} q\}$,没有精确先例的题仍能命中更抽象层级的原则,兼顾广谱启发式与具体配方;(3) 技能蒸馏的判分模型被扣留真值,因为预测对错是推理质量的糟糕代理,避免误学幸存者偏差;(4) 环境进化只移动难度维度而冻结客观性与可解决性——例如把'谁夺金'改成'金牌得主总成绩(公斤)'并以 268 公斤为显著阈值,题目变难但仍可从官方页面客观判定,这是'对抗课程'与'破坏可验证性'之间的关键分界。
实验结果
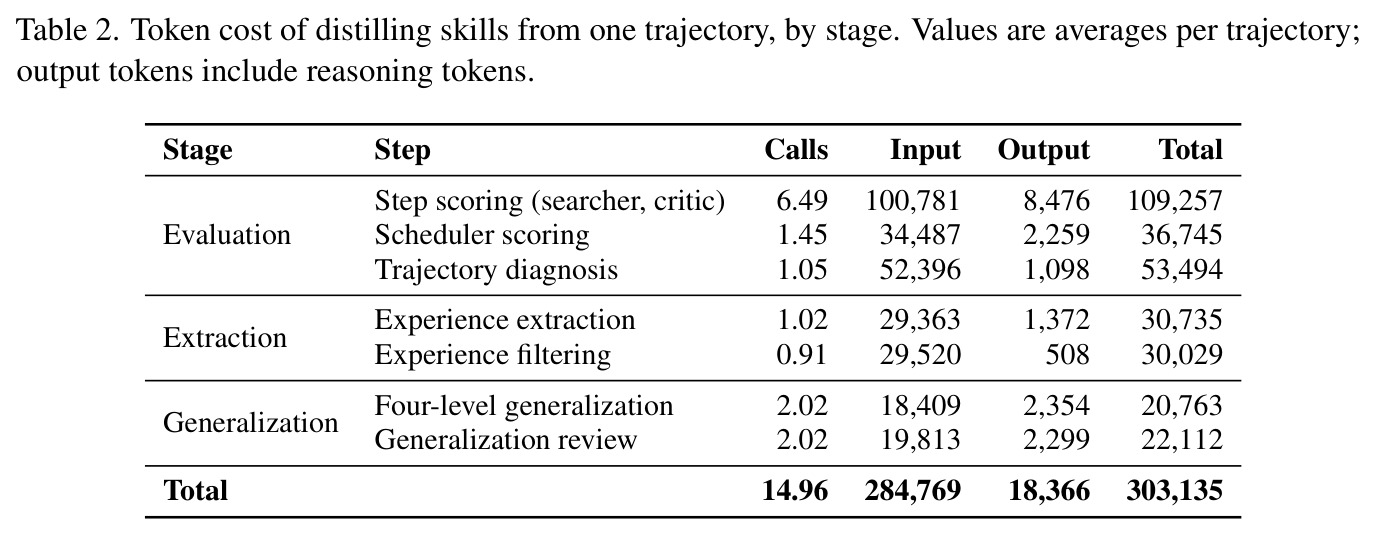
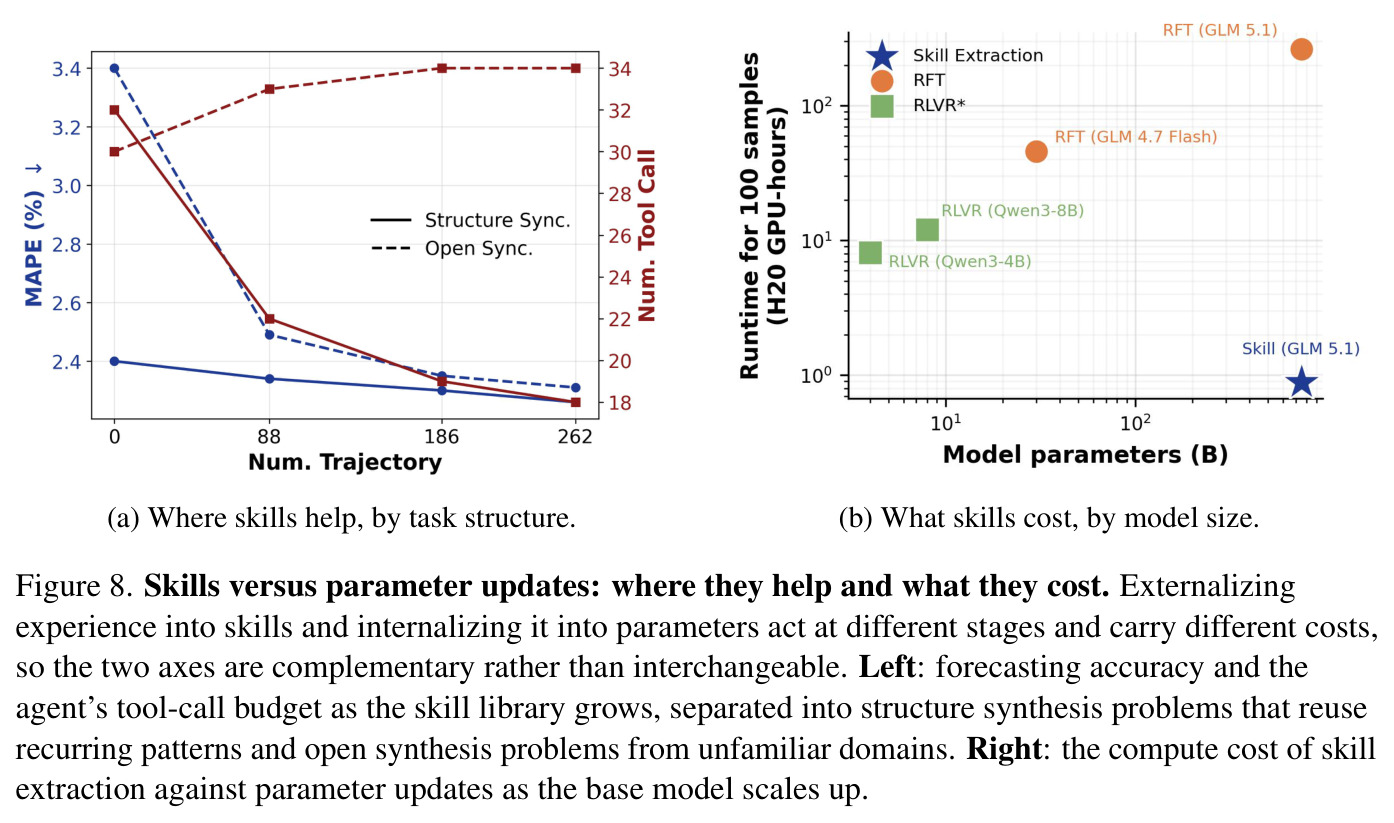
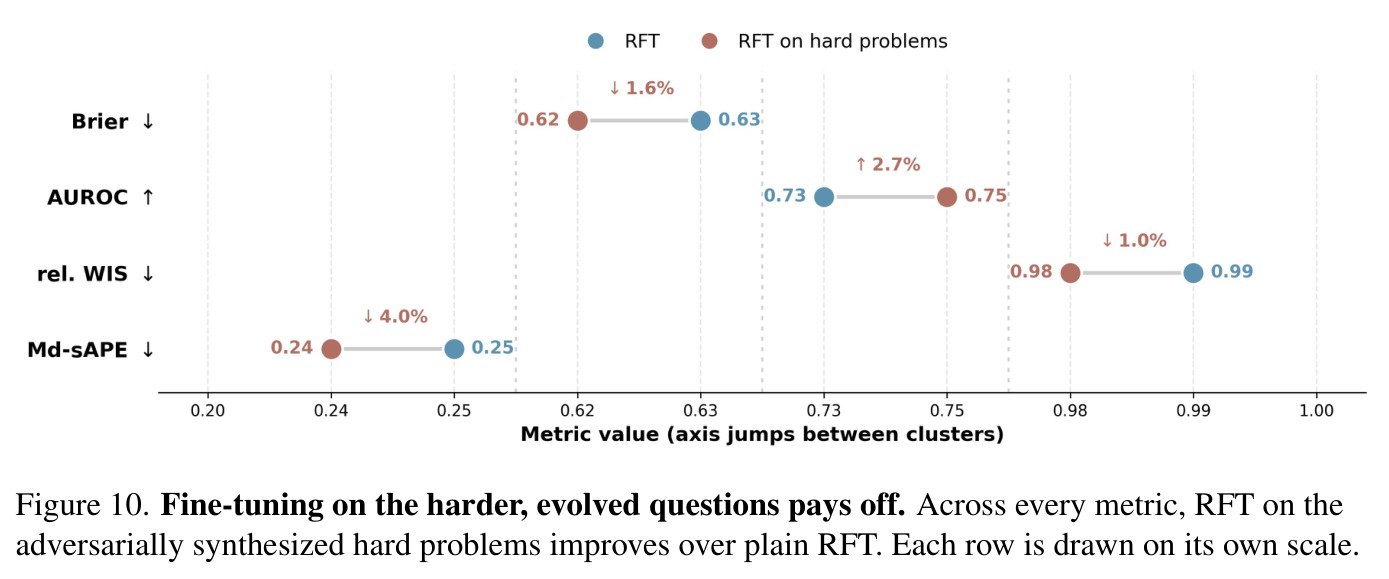
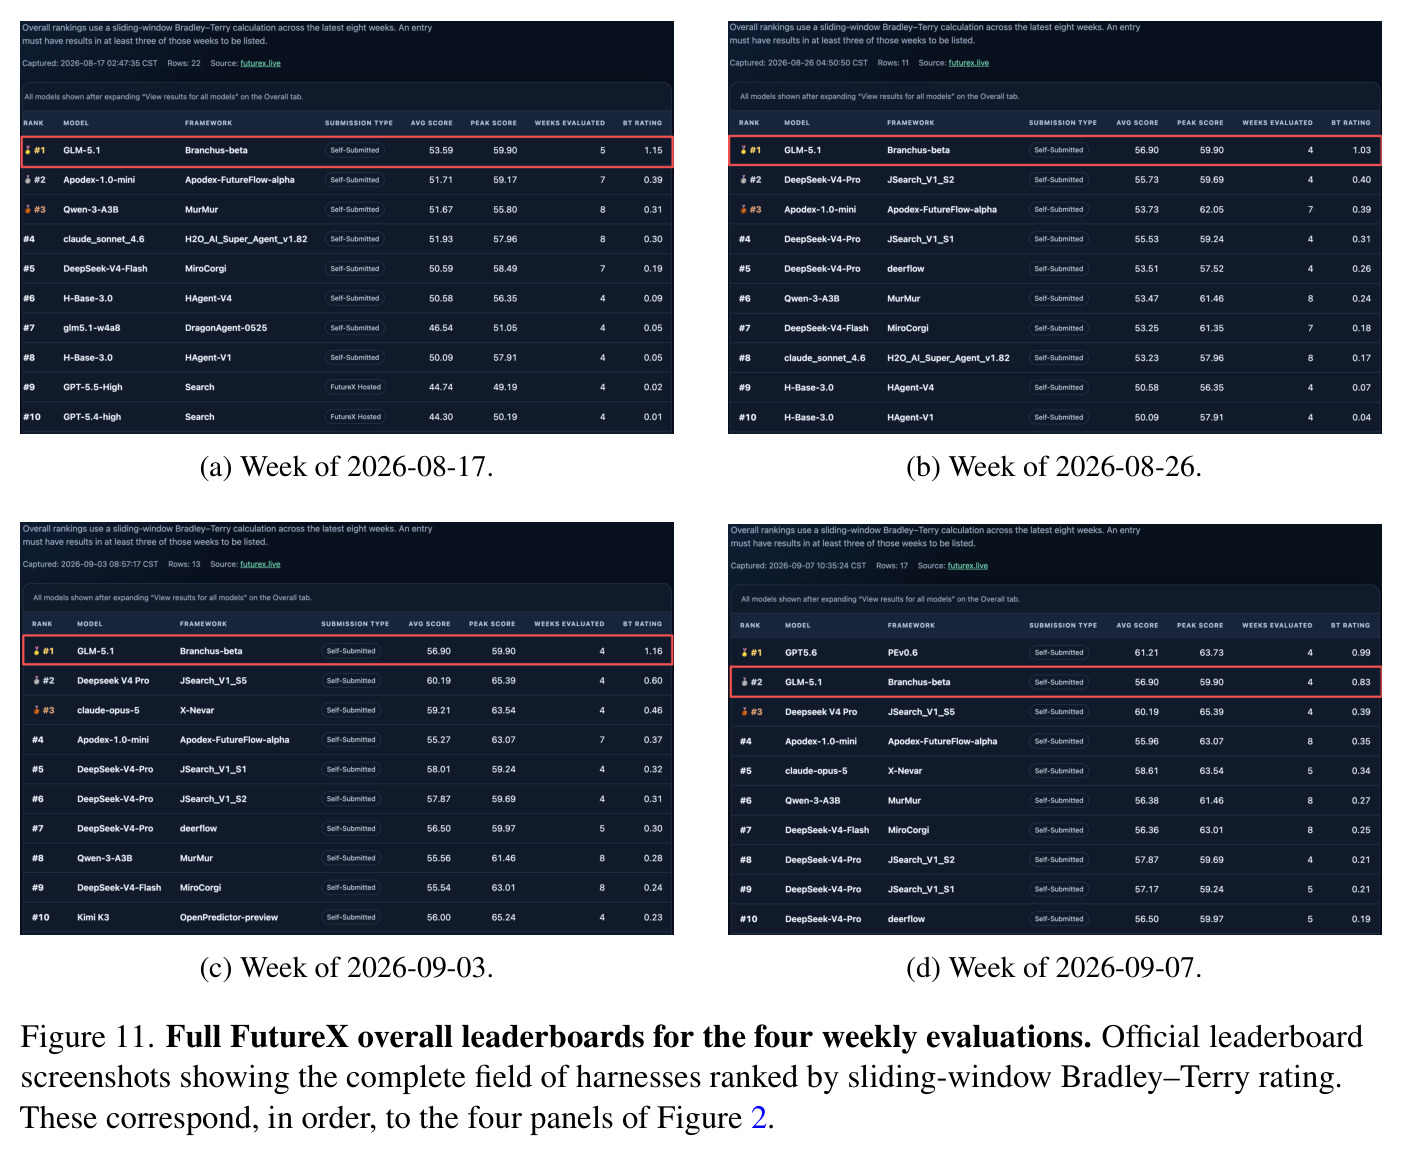
系统级结果:FutureX 官方排行榜连续三周全系统第一,rating 最高提升 195%;合成评测上四种基座 LLM 配置全部进入 23 个系统总排名前三(BT 62.2/57.9/56.4/53.1),对最强基线领先 +10.7 至 +0.5 BT;优势来自校准而非裸准确率——四个模型块中三个取得最优 Brier(0.331–0.336),Qwen/GPT 块相对 WIS 最优(0.737/0.865)。参数进化:RLVR 使两模型选择题准确率各 +1.3 分、数值分 $1-\tilde{\text{WIS}}$ +0.31/+0.38;RFT 使准确率 +0.7~2.9 分且校准领涨,GLM-4.7-Flash 两轮 RFT 使 Brier 0.651→0.636→0.630(任务池 600→1000)。技能进化:88/186/262 条轨迹嵌套池上 Brier 0.135→0.122、MAPE 2.80%→2.28%,逐轮增益 −0.007/−0.012/−0.013,主题覆盖 168→479 域(约 3 倍)。分工:结构合成题上工具调用 −44%(32→18),开放合成题上 +13% 且 MAPE −32%(3.40%→2.31%)。环境进化:同一 checkpoint 在进化题上选择准确率 0.60→0.53、Brier 0.52→0.58 而 AUROC 保持 0.678→0.68;同样 262 条轨迹蒸馏出技能 1312→1403、覆盖 320→337 域;对抗题上 RFT 相对普通 RFT 全面提升(Brier −1.6%、AUROC +2.7%、relWIS −1.0%、Md-sAPE −4.0%)。技能蒸馏成本约 30.3 万 token/条轨迹,无需梯度更新。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 真实未来事件预测(PROMETHEUS 合成评测,选择题+数值题) | Bradley–Terry 综合评分(23 系统总排名) | BT 62.2(Qwen3.8-Max,总排名第 1) | 同模型最强基线 MAS 51.5 | +10.7 BT;四模型配置全部进前三(+10.7/+2.9/+0.5/+1.9) |
| FutureX 每周真实世界预测排行榜 | 官方滑动窗口 BT rating | 连续三周全系统第一 | 全部其他 agent harness | rating 最高提升 195% |
| 数值预测区间质量(Qwen3.8-Max 块) | 相对 WIS(越低越好) | 0.737 | 最优基线 MAS 0.871 | 降低 15.4%,区间更锐利 |
| 选择题概率校准(四模型块) | Brier 分数(越低越好) | 0.331–0.336,四块中三块最优 | 基线范围 0.340–0.376 | 一致更低且 AUROC 不降 |
| RLVR 参数进化(Qwen3-4B-Thinking / Qwen3-8B) | 选择题准确率 / 数值分 $1-\tilde{\text{WIS}}$ | 准确率各 +1.3 分;数值分 +0.31 / +0.38 | 未训练基座模型 | 校准类指标提升远大于准确率,为早期信号 |
| 技能进化(推理期注入技能库,不动权重) | Brier / MAPE | Brier 0.135→0.122;MAPE 2.80%→2.28% | 无技能的 Branchus | Brier −0.013;MAPE −0.52 分;三轮嵌套池逐轮递增 |
| 对抗环境进化后微调 | 相对普通 RFT 的指标变化 | Brier −1.6%、AUROC +2.7%、relWIS −1.0%、Md-sAPE −4.0% | 普通 RFT | 全部四项指标一致改善 |
局限与改进
作者明确承认的边界有:改进的燃料受经验质量与数量限制,在可解决、有信息量的事件稀少或强文化依赖的领域,轨迹会很稀薄;长时程评估昂贵,回合速度由世界决定——事件若需数月才解决,每一轮改进就又慢又贵;非平稳漂移下的稳定性并无保证;环境这位教师只看得见显性失败,'过度自信'这类不改变对错结果的隐性弱点不会进入错误画像,因此环境只在错误已可见的地方最能改进智能体。我的补充观察:合成评测的出题(PROMETHEUS)与判分(Codex 检索打分)来自同一套自建系统,虽以真实事件结果为锚,但缺乏第三方复评;参数进化只覆盖预测队,搜索队从不接受 RL 更新,证据收集质量的提升完全依赖技能;题目视界为一整天,月/年级别的长周期预测无法进入当前闭环;对比基线是通用 agent harness 而非预测专用系统,基线侧的提升空间可能被低估。
独立分析的弱点
第一,隐性弱点不可见:错误画像 $\rho^{(t)}(c)$ 只统计显性错误率,模型'对了但置信度低/错了但置信度高'的校准缺陷不会触发环境进化,改进方向是把 Brier 分解或置信度差异并入类别诊断,让环境也针对校准弱点出题。第二,技能库缺乏遗忘与时效机制:世界规律漂移后旧技能可能失效甚至误导,论文自己也承认这一点,应引入时间加权、失败触发的技能退役检测与技能版本管理。第三,搜索队从不被 RL 更新:参数进化只作用于预测队,证据收集的深度与广度只能靠技能改善,可考虑用事后'证据充分性'奖励对搜索队做轨迹级 RFT,让搜索策略也进化。第四,单日视界限制了可学事件类型:数月后解决的事件无法参与当前回合,可设计分层视界、把不同解决周期的题目组成并行的多层进化环。第五,评估与出题同源风险:PROMETHEUS 既当出题人又当(经 Codex 的)判分人,虽有真实事件锚定,仍应扩大第三方评测(如持续跟踪 FutureX)与人工抽检的比例。
未来方向
作者提出的研究方向包括:拓宽经验来源的数量与质量以抬高递归循环的天花板;为技能库引入遗忘、时间加权与失败检测,使外部化经验在非平稳世界中长期可靠;设计更丰富的参数进化算子(让更新像技能积累一样逐轮复利)与更有表现力的技能组织/蒸馏/检索方式;把'活环境+智能体+进化引擎'的三件套方法论移植到同样满足有根据、可验证、非平稳的领域——科学发现、软件工程、战略规划。基于本文成果还可自然延伸:把'环境作为教师'课程化,按最近发展区自动调度难度;引入多个 Branchus 互相出题的竞争性共同进化;把概率校准作为开放世界 AI 行为的活体监测指标;以及在三个杠杆之间做算力自适应调度——何时值得花算力做参数更新、何时只做廉价的技能蒸馏(论文显示蒸馏约 30 万 token/轨迹,而参数更新随模型规模变贵)。
复现评估
代码开源在 https://github.com/RUCAIBox/EvoForesight,三个模块的完整 prompt 模板在附录 D,方法描述与公式相当完整。但复现门槛中等偏高:需要每天爬取 125 个网站的实时新闻流、用 Codex 检索并判定事件结果,这要求长期稳定的爬取与判分基础设施;系统级评测依赖多个前沿商业 API(GPT-5.5/5.6-Sol、Claude-Opus-4.6、DeepSeek-V4-Pro、Qwen3.8-Max),API 费用可观;FutureX 每周官方榜单无法自主重跑,只能旁观。可复现性较好的部分:RLVR 实验用开源的 Qwen3-4B-Thinking/Qwen3-8B,多轮 RFT 用 GLM-4.7-Flash,几卡级 GPU 即可训练;技能蒸馏纯推理、每条轨迹约 30.3 万 token(Table 2),成本可控。需要注意真实世界事件不可重放:逐轮进化实验无法在完全相同的题目上重复,只能复现方法框架与趋势,这也正是'活环境'评估的固有属性。
论文图表