FrugalEvo:面向成本感知的 LLM 引导程序演化 FrugalEvo: Towards Cost-Aware LLM-Guided Program Evolution
用强模型出策略、弱模型写代码,把演化搜索的单位成本收益最大化
前置知识
LLM 引导的演化搜索(LLM-guided evolutionary search)
维护一个程序种群数据库的自动优化范式:每轮从数据库选一个父程序,用 LLM 生成变异候选,交给任务评测器打分,好程序入库参与后续演化。代表工作 FunSearch、AlphaEvolve、OpenEvolve、ShinkaEvolve 已在圆填充、极值几何、系统优化等问题上取得超越已知构造的结果。核心循环是「选父→生成→评测→入库」,成本主要来自 LLM 调用与评测执行。
FrugalEvo 的整体框架就建立在这个循环之上,论文的全部对比基线(OpenEvolve、ShinkaEvolve、AdaEvolve、EvoX)都属于该家族,理解这个循环才能看清它在哪一步省钱、省了多少。
提示缓存(Prompt Caching / KV 缓存前缀复用)
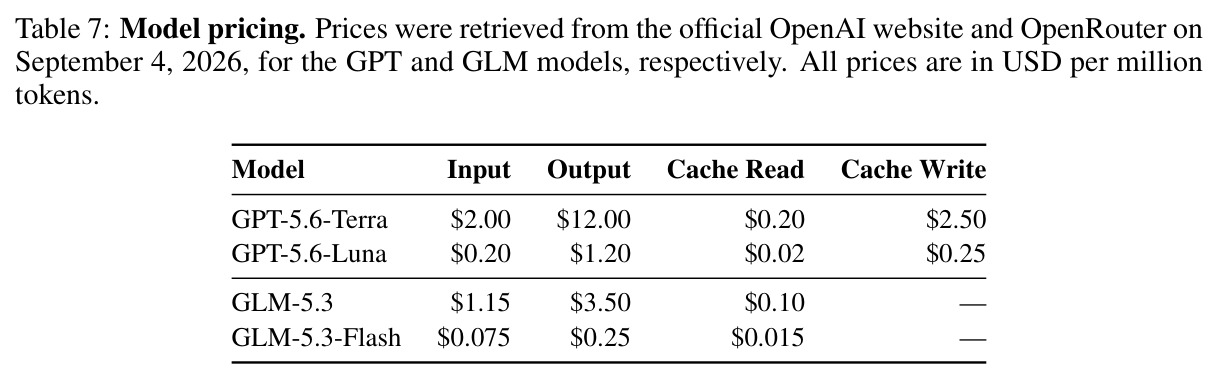
推理服务会把 prompt 前缀对应的 KV 状态缓存下来,后续请求若共享相同前缀即可复用,输入 token 按大幅折扣计价:论文表 7 中 GPT-5.6-Terra 输入 $2.00/百万 token,缓存读取仅 $0.20;GLM-5.3-Flash 输入 $0.075,缓存读 $0.015。前缀共享越长、跨调用越稳定,省的钱越多。
FrugalEvo 的 cache-efficient prompt 构造完全依赖这一机制,是论文压低成本的两大支柱之一,不理解缓存定价就看不懂 prompt 为什么要按「稳定在前、易变在后」排版。
MAP-Elites 与岛屿模型(island-based MAP-Elites)
MAP-Elites 是质量-多样性(quality-diversity)算法:把解空间按行为特征划分为若干网格,每个格子只保留当前最优个体,从而同时维持种群质量与多样性。岛屿模型则把种群分成多个相互隔离的子群独立演化,防止全体过早收敛到同一局部最优。两者结合是演化计算中管理程序数据库的经典做法。
FrugalEvo 的 search memory 组件用 island-based MAP-Elites 存储候选程序、策略历史与失败反馈,上下文构建器从中采样父程序与参考程序,这决定了搜索的多样性来源。
BA-AUC(Budget-Aware Area Under the Curve)
论文提出的新指标:设 $q(c)$ 为累计 LLM 成本达到 $c$ 时的历史最优评测得分,则 $\text{BA-AUC}(B)=\int_0^B q(c)\,dc$,即固定成本预算 $B$ 内「得分-成本」曲线下面积。若运行提前结束,把最终得分持平外推到 $B$;若超出预算则截断,保证所有方法在同一成本区间可比。
这是本文的核心评估指标,表 1、表 2 及图 5 的所有对比都围绕它展开,不理解这个定义就无法读懂实验部分。
测试时扩展(test-time scaling)
许多任务上,增加推理时计算(更多采样次数、更长的思考链、更多轮智能体迭代)能持续换取更好的表现,例如 repeated sampling 和长程搜索都遵循这一规律。推论是:分数高的方法未必更聪明,可能只是花钱更多,单独比较最终分数会系统性偏向烧钱多的方法。
这正是论文的核心动机:在测试时扩展效应明显的领域,必须按「单位成本的收益」而非「固定迭代次数后的分数」来评估方法,否则对比既不公平也无实用价值。
研究动机
现有 LLM 引导演化方法(AlphaEvolve、OpenEvolve、ShinkaEvolve、AdaEvolve、EvoX 等)习惯以「固定迭代次数后的性能」或「固定候选数量下的性能」报告结果,隐含假设每次迭代的成本大体相同。但这个假设不成立:一次迭代要调用 LLM 生成代码、调用评测器执行程序,不同方法的每次迭代成本差异巨大——论文图 1c 显示,圆填充任务上各方法的平均每迭代成本从约 $0.0097 到 $0.05 不等,相差 3-5 倍;更极端的是 CORAL、SwarmResearch 这类多智能体方法,平均要花约 $50 才在圆填充上做到 2.6359 左右的半径和。由于测试时扩展效应普遍存在,分数高可能只是因为烧钱多,这种评估方式掩盖了性价比差异,预算有限的实践者也无法据此判断哪个方法适合自己。
本文的目标是论文主张把评估范式从「每次迭代的收益」转向「单位成本的收益」:在固定 LLM 成本预算 $B$ 下最大化解的质量。具体目标有三层:(1) 提出 BA-AUC 指标,在固定预算内全程度量解质量随累计成本的变化,弥补只看最终得分的缺陷;(2) 设计成本感知的演化框架 FrugalEvo——用强而贵的高价模型做低频的策略探索,用便宜 10-15 倍的低成本模型做高频的代码实现与迭代精炼,并通过把 prompt 排版成前缀最大共享来充分利用 API 提示缓存;(3) 在数学、系统、算法三类共 20 个真实优化任务上验证:同等或更低成本下匹配或超越所有基线的最终解质量,同时在绝大多数任务上 BA-AUC 更高。
与已有工作不同的是,已有的降本工作要么在模型调用层面做级联与路由(FrugalGPT 学习模型级联、RouteLLM 按查询难度在强弱模型间路由),要么在搜索过程层面做自适应(ShinkaEvolve 追求样本效率、AdaEvolve/EvoX 自适应调整搜索、ThetaEvolve 用 RL 在测试时改进生成器),但几乎没有工作把「任务内在的分工结构」本身作为降本切入点。FrugalEvo 的独特观察是:演化搜索中「想出好点子」和「把点子写成能跑的代码并反复调试」是能力要求截然不同的两种子任务——前者低频出现、需要深度推理,值得用贵模型;后者高频重复、机械性强,交给输入价格仅为其 1/10(Luna vs Terra)到 1/15(Flash vs GLM-5.3)的便宜模型即可。此外论文注意到 API 提示缓存按共享前缀折算计费的特性,把 prompt 有意排版成「稳定前缀在前、易变内容在后」,让大部分输入 token 走缓存价。这种「按子任务能力要求异构分配模型 + 面向缓存友好的流程设计」的组合是本文独有的切入角度。
核心方法
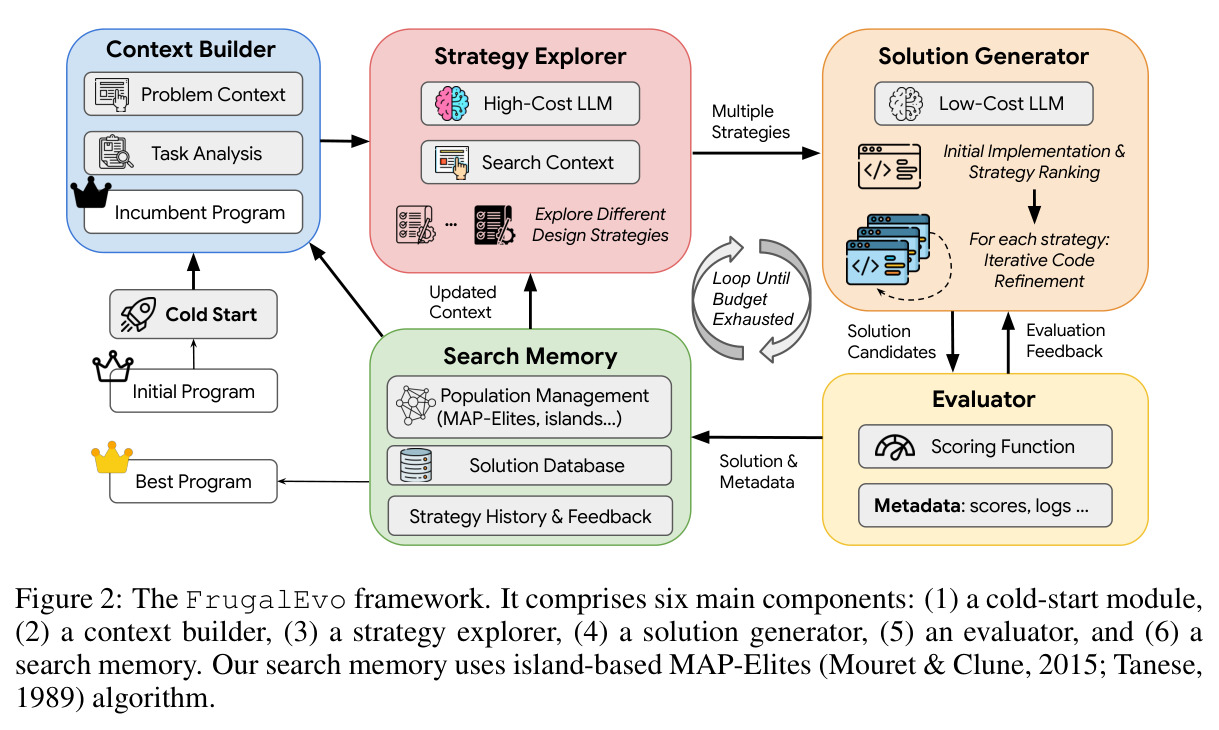
直觉上,FrugalEvo 把「出主意」和「干活」分开:贵模型只做少数几次调用负责战略层——分析问题、提出若干个机制层面互不相同的改进策略;便宜模型大量调用负责执行层——把每个策略实现成代码、评测、根据报错和分数反复修补直到榨干该策略的价值。形式化上,论文先把 LLM 引导演化写成固定预算 $B$ 下的程序优化:评测器 $\mathcal{E}(x)=(s(x),a(x))$ 返回任务分数与辅助反馈,搜索策略从程序数据库 $\mathcal{D}_t$ 构建上下文 $C_S(\mathcal{D}_t)$,LLM 采样 $x_{t+1}\sim G_{\text{LLM}}(\cdot\mid C_S(\mathcal{D}_t))$,评测后入库,目标是预算内 $\max s^\star$。技术上框架由六个组件组成:冷启动模块、上下文构建器、策略探索器(高价 LLM)、解生成器(低价 LLM)、评测器、以及基于岛屿 MAP-Elites 的搜索记忆,整个循环执行到预算耗尽,返回历史最优程序。
核心创新是「策略探索-代码实现」的异构模型协作,与已有方法的本质区别在于:所有对比基线(包括 AlphaEvolve、OpenEvolve 等)在整个搜索过程中始终用同一个模型完成变异生成;FrugalEvo 则把候选程序生成拆成两步——高价 LLM(GPT-5.6-Terra 或 GLM-5.3)在单次 API 调用中提出 $K$ 个机制互异的设计策略,每个策略必须说明改动机制、替换范围、计算预算限制和收益原理,禁止只调随机种子或迭代数这类表面变化;低价 LLM(Luna 或 Flash)负责实现与精炼。第二大创新是 cache-efficient 演化流程:prompt 严格按「固定指令→低频变化内容(岛屿最优与精英程序排前、随机采样参考排后)→高频变化的尝试反馈追加在末尾」排序,最大化相邻调用间的前缀共享,把尽可能多的输入 token 计入便宜的缓存读价格(如 Terra $2.00/M vs 缓存读 $0.20/M)。消融实验证明两个设计缺一不可。
方法步骤详情
完整流程分四个阶段。阶段一冷启动:低价 LLM 对任务给的初始程序反复做局部精炼,直到评测分数不再提升(连续无效次数超过上限 $F$ 即停),最优者成为「现任」(incumbent)$x^\star$,避免用弱初始程序浪费宝贵的策略探索;随后高价 LLM 执行一次 ANALYZEONCE,分析任务描述与评测器代码、识别优化目标与合法性约束并缓存复用。阶段二策略探索:上下文构建器从搜索记忆取出当前现任、岛屿精英、历史策略及失败反馈拼成搜索上下文,高价 LLM 据此提出 $K$ 个策略 $\{S_i\}_{i=1}^K$ 和一个可选的参考实现,参考程序若改进现任则替换之。阶段三初始实现与策略排序:低价模型为每个策略各生成一个试验实现并评测,按得分 $q_i$ 稳定排序得 $\pi=\text{Argsort}(-q_i)$。阶段四迭代精炼:按排名逐个策略执行,每轮固定该策略与当前现任为父程序,最多 $M$ 次顺序尝试,每次尝试的评测反馈(错误信息、分数)追加到 prompt 末尾指导修补;一旦某次尝试改进现任,立即以新现任开启同一策略的下一轮;当整轮改进量 $\Delta\le\epsilon$ 时换下一策略。搜索记忆以岛屿 MAP-Elites 存储全部候选、策略与失败历史,预算耗尽返回 $x^\star$。
技术新颖性
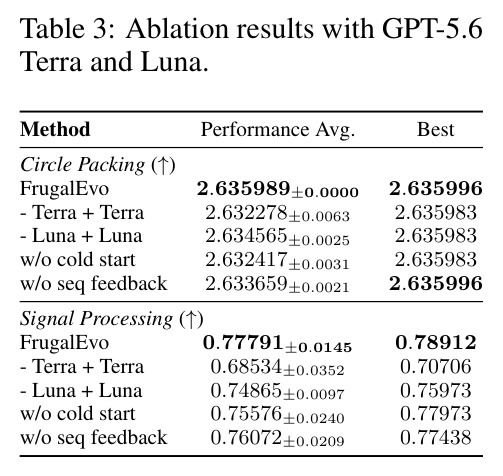
技术新颖性体现在四个层面。(1) 评估指标:BA-AUC $\text{BA-AUC}(B)=\int_0^B q(c)\,dc$ 把累计成本作为曲线横轴,使「早停运行」与「超预算运行」在同一区间可比,直接挑战了按迭代次数报告进展的领域惯例。(2) 架构:策略探索与代码实现解耦并异构分配,区别于 FrugalGPT/RouteLLM 的查询级路由——这里的分工由任务结构(探索 vs 实现)先天决定,而非逐查询判断难度,也不需要训练路由器或访问 token 级概率(与 SqueezeEvolve 不同)。(3) 系统:据我所知首次把提示缓存的前缀定价显式纳入演化搜索的 prompt 工程设计,形成「字段变化频率决定排版顺序、排版顺序决定缓存命中」的可复用构造规则。(4) 流程:策略排序后的顺序精炼协议——失败反馈串行注入 prompt、改进即换父不换策略、整轮无改进才切换——保证贵模型产出的每个战略方向都被便宜模型充分榨取。消融表 3 定量支撑了各组件:Circle Packing 上只用 Terra 均值从 2.635989 掉到 2.632278,去冷启动掉到 2.632417,去顺序反馈掉到 2.633659 且方差增大。
实验结果
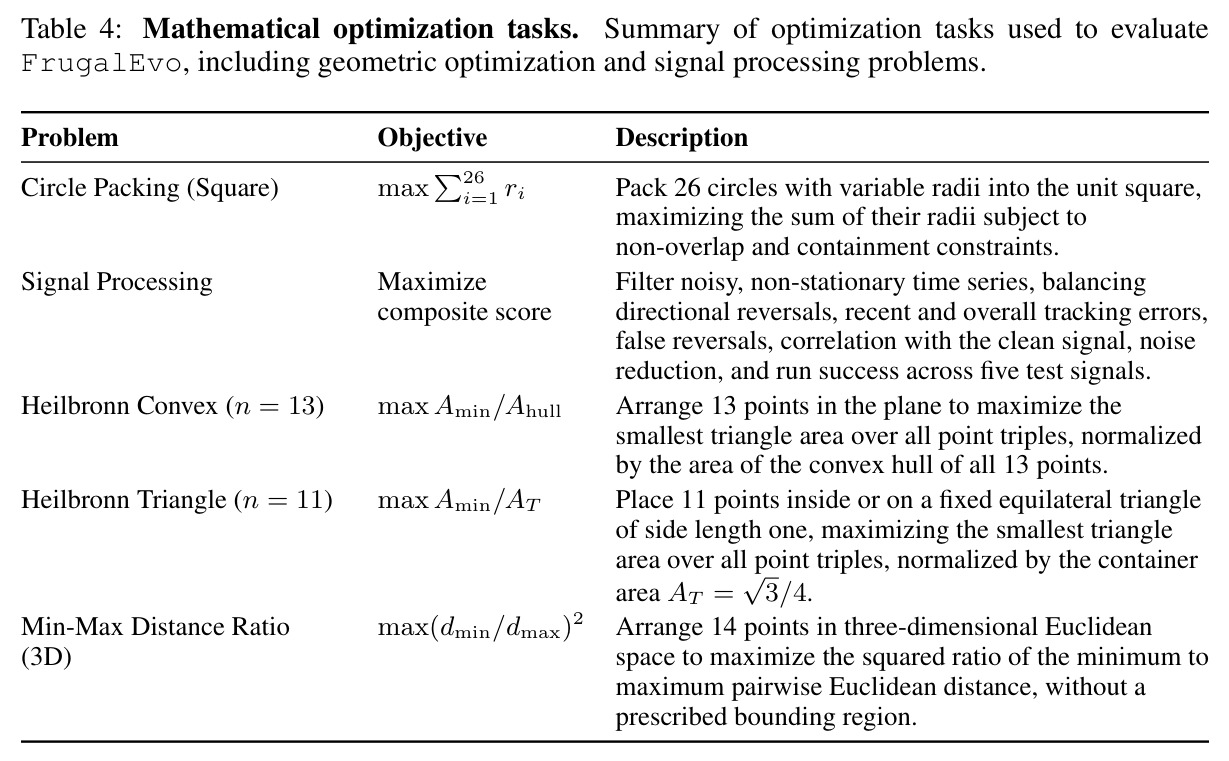
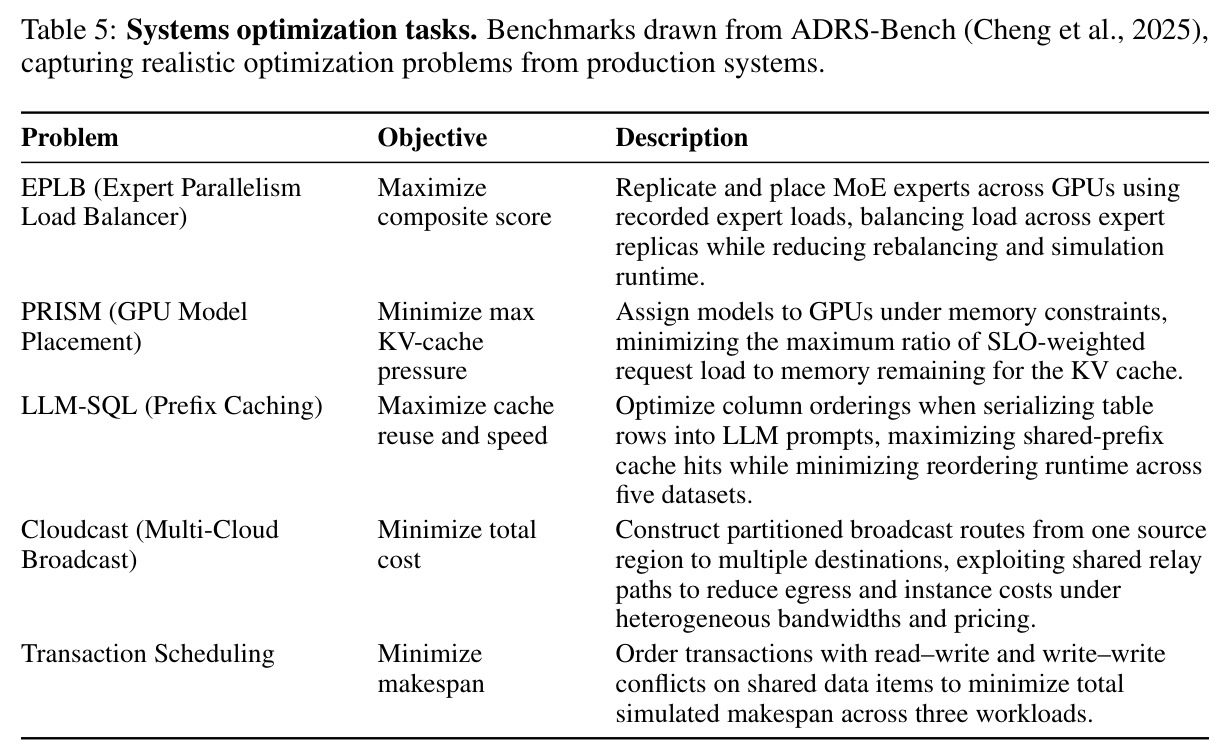
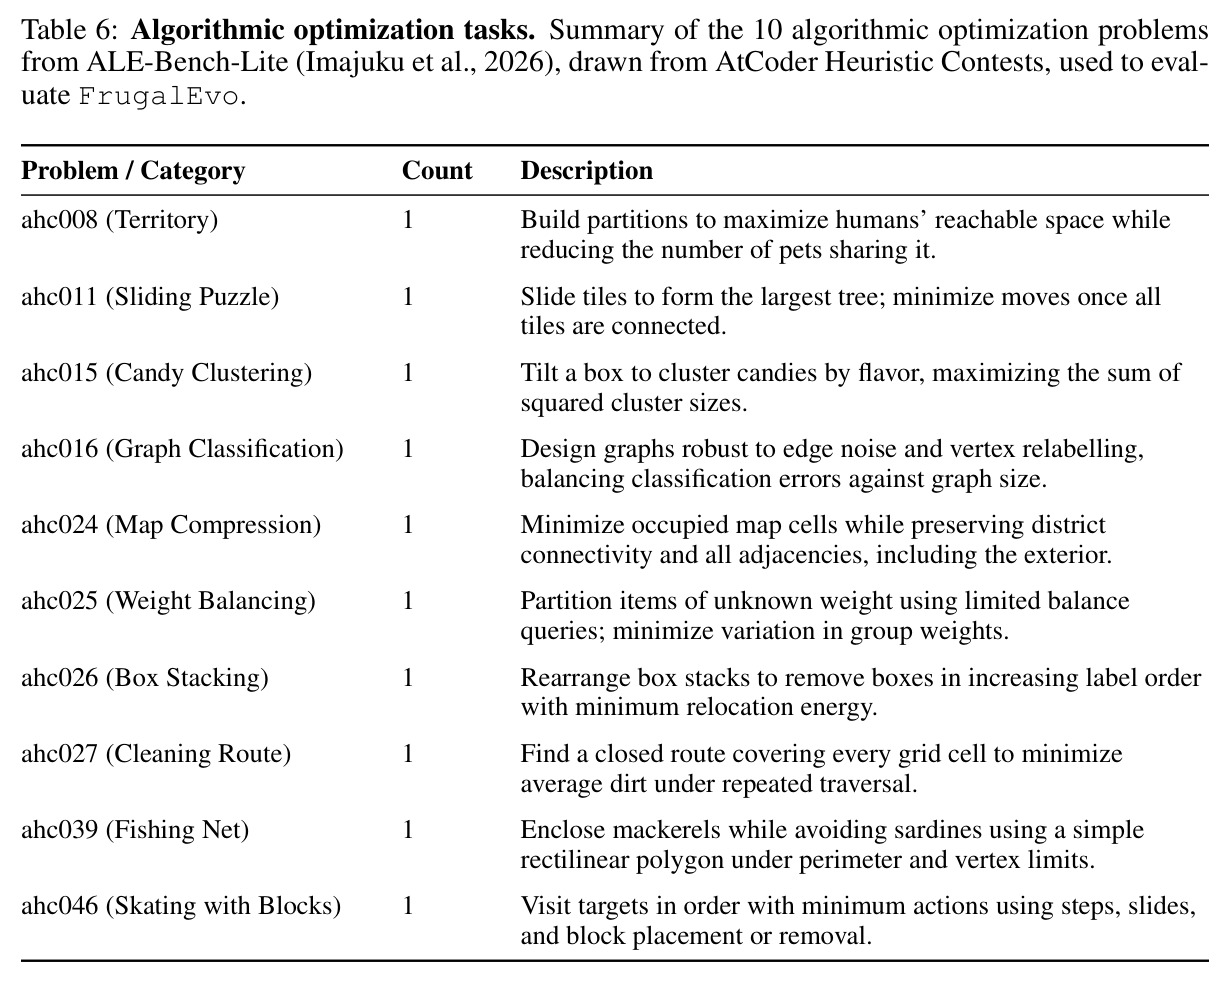
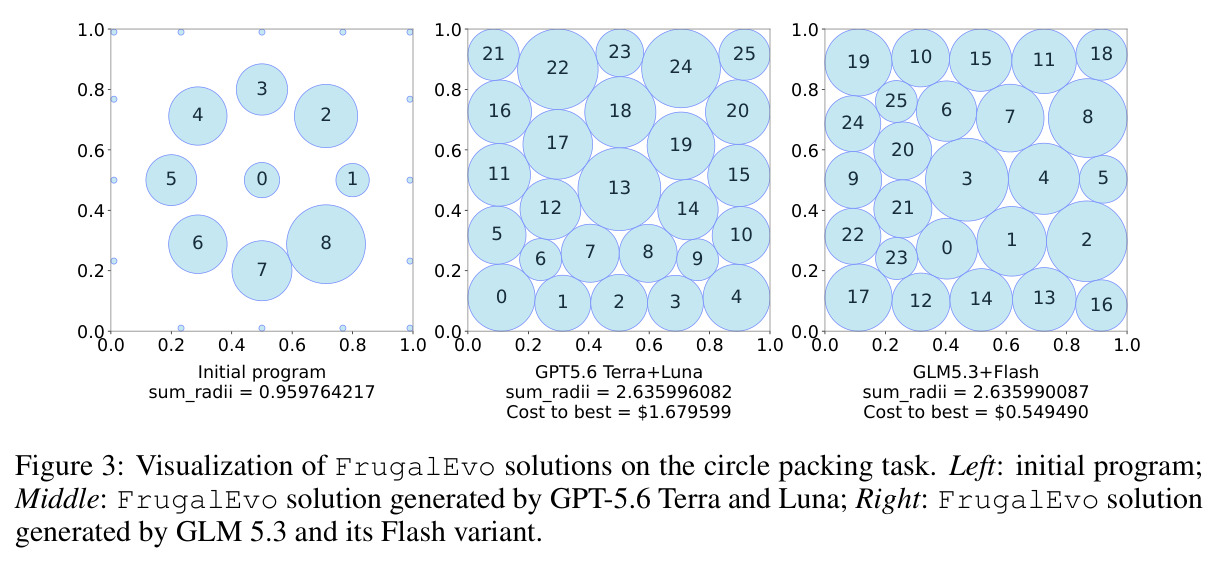
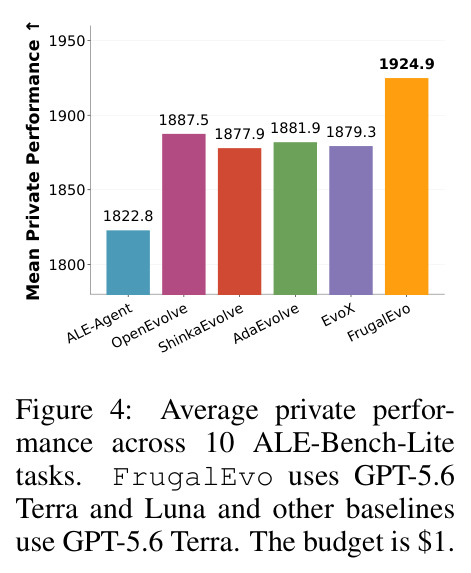
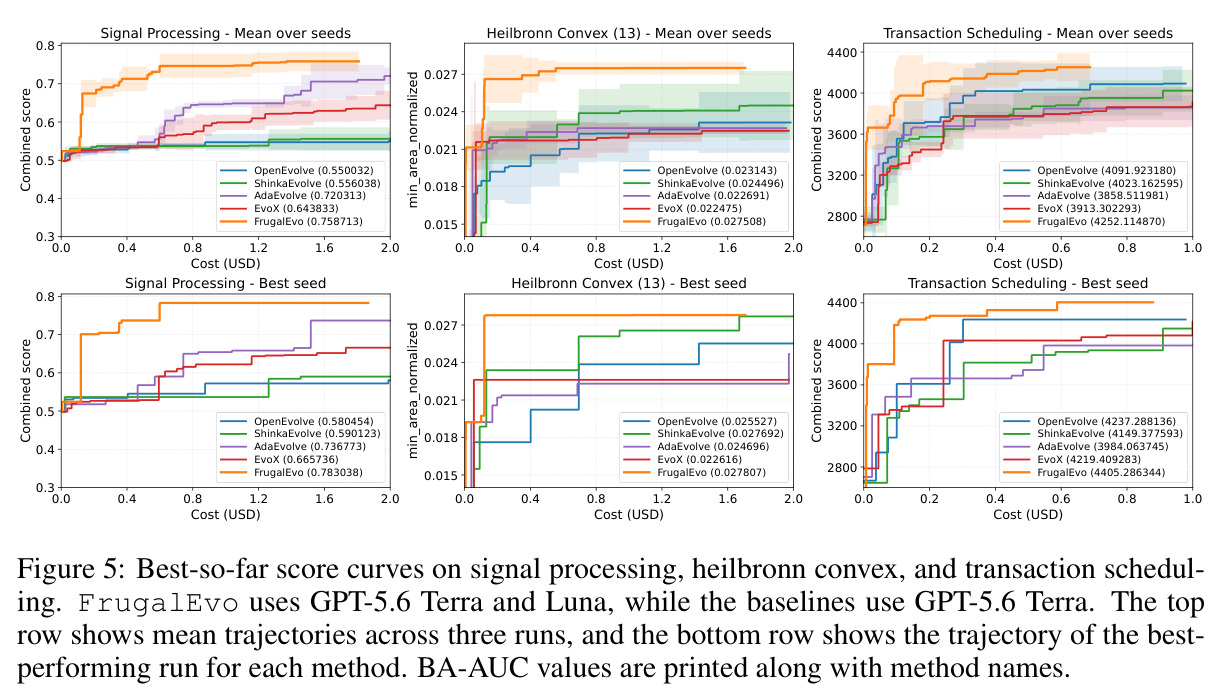
论文在 20 个真实优化任务上以每设置 3 次独立运行做了系统对比。数学优化(表 1):FrugalEvo 在两个模型配置下全部 5 个任务取得最高平均 BA-AUC;GPT 配置下 5/5 任务平均分最优,GLM 配置下 4/5 最优。圆填充达到 2.635996(GPT-5.6 Terra/Luna,花费 $1.68)与 2.635990(GLM-5.3/Flash,仅 $0.55),超过 AlphaEvolve 报告的 2.635(成本未知),而 CORAL 与 SwarmResearch 平均花约 $50 才达到 2.635985/2.635996,成本节省 30-90 倍。信号处理 best 0.78912(最强基线 AdaEvolve 0.73677);Heilbronn Convex (13) GLM 配置 best 0.03094 追平 AlphaEvolve;Heilbronn Triangle best 0.03653 追平 AlphaEvolve;Min-Max-3 best 4.165783 优于 AlphaEvolve 的 4.165850(越小越好)。系统优化(表 2):5 个 ADRS 任务两配置均最佳或相当,4 个任务 BA-AUC 最高;EPLB 0.1473、LLM-SQL 0.7346、Transaction Scheduling 4405.29(OpenEvolve best 4237.29)。算法优化(图 4):ALE-Bench-Lite 10 任务平均私榜分 1924.9,领先 OpenEvolve 1887.5、AdaEvolve 1881.9、ShinkaEvolve 1877.9、EvoX 1879.3,起点 ALE-Agent 仅 1822.8。成本-性能曲线(图 5)显示三个代表任务上 FrugalEvo 在前 $0.2 内即建立明显优势并保持到预算结束。消融(表 3):Circle Packing 去掉模型协作(只用 Terra)均值 2.635989→2.632278,Signal Processing 0.77791→0.68534;去冷启动两任务降至 2.632417/0.75576;去顺序反馈降至 2.633659/0.76072 且标准差明显增大,说明各组件均有实质贡献。
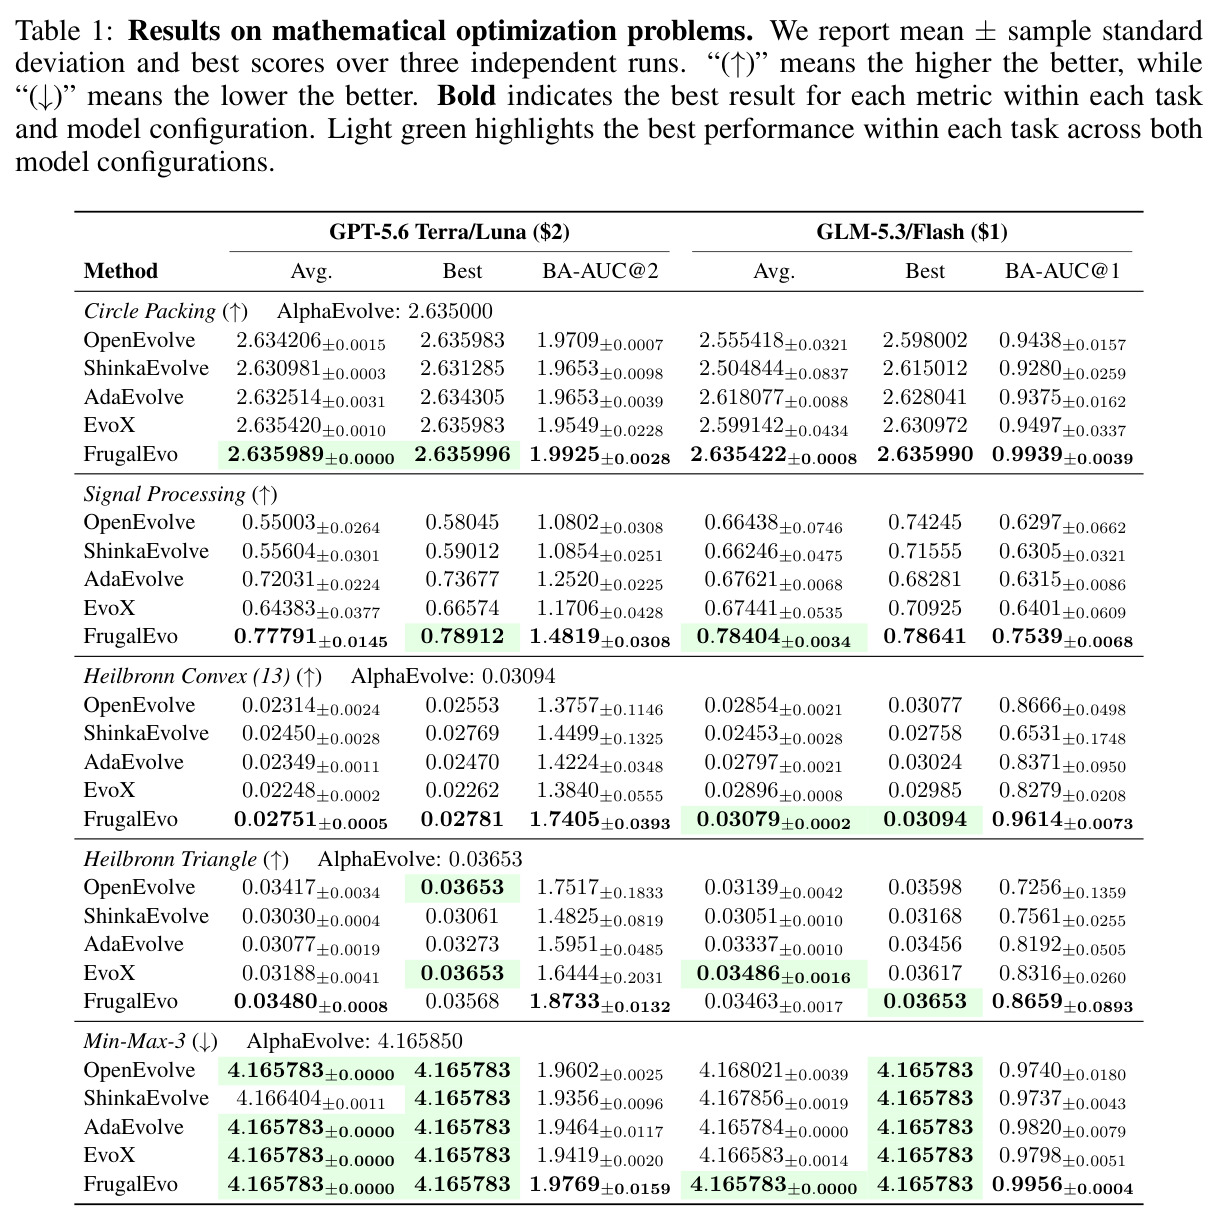
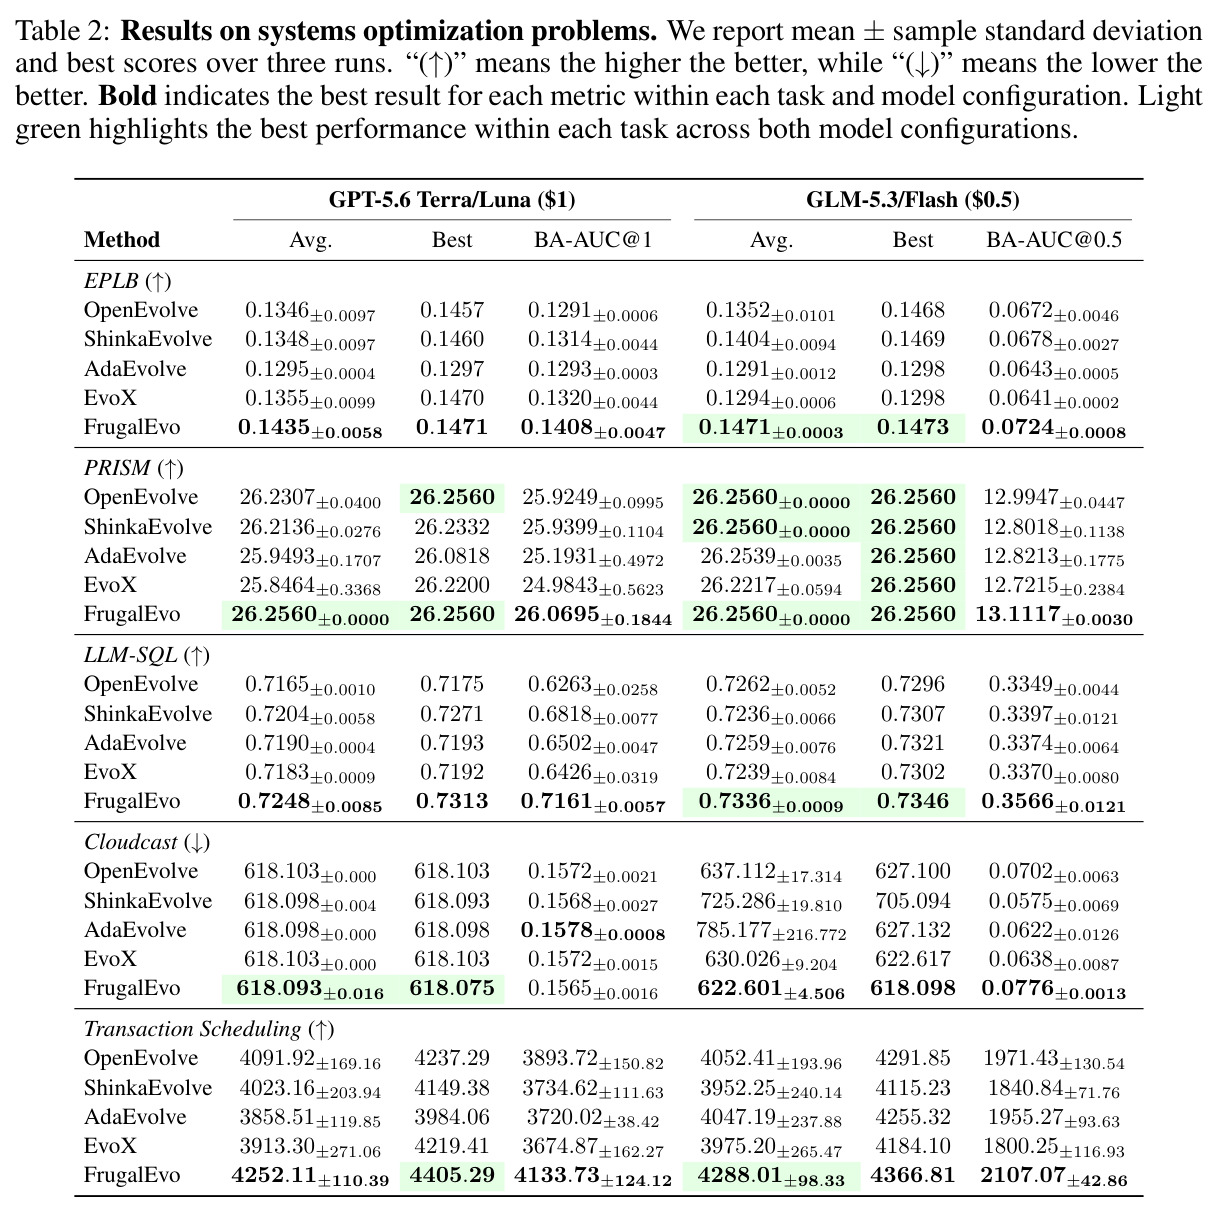
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Circle Packing(圆填充,数学优化) | 26 圆半径之和 (↑) 与 BA-AUC | GPT 配置均值 2.635989±0.0000、best 2.635996、BA-AUC@2 1.9925,花费 $1.68;GLM 配置仅 $0.55 达 best 2.635990、BA-AUC@1 0.9939 | AlphaEvolve 2.635(成本未知);OpenEvolve 2.634206;ShinkaEvolve 2.630981;AdaEvolve 2.632514;EvoX 2.635420;CORAL 约 $50 达 2.635985;SwarmResearch 约 $50 达 2.635996 | 以约 1/30-1/90 的成本匹配或超越全部基线;对次优基线 BA-AUC 提升约 +0.3%~+1.9% |
| Signal Processing(信号处理,数学优化) | 复合滤波得分 (↑) | GPT 配置均值 0.77791±0.0145、best 0.78912、BA-AUC 1.4819;GLM 配置均值 0.78404、best 0.78641 | AdaEvolve 0.72031(GPT 配置次优基线均值);OpenEvolve 0.55003;ShinkaEvolve 0.55604;EvoX 0.64383 | 均值较最强基线 +8.0%,best +7.1%,BA-AUC 较 AdaEvolve 1.2520 提升 +18.4% |
| Transaction Scheduling(事务调度,系统优化) | 综合吞吐得分 (↑) | GPT 配置均值 4252.11±110.39、best 4405.29、BA-AUC@1 4133.73;GLM 配置 best 4366.81 | OpenEvolve 4091.92 / best 4237.29;ShinkaEvolve 4023.16;AdaEvolve 3858.51;EvoX 3913.30 | 均值较最强基线 +3.9%,best +4.0%,BA-AUC 提升 +6.1% |
| ALE-Bench-Lite(10 个 AtCoder 启发式竞赛算法任务) | 平均私有分数 (↑),预算 $1/任务 | 1924.9(GPT-5.6 Terra + Luna) | OpenEvolve 1887.5;ShinkaEvolve 1877.9;AdaEvolve 1881.9;EvoX 1879.3;起点 ALE-Agent 1822.8 | 较最强基线 OpenEvolve +37.4 分(+2.0%),较起点 +102.1 分 |
局限与改进
作者承认的局限有两点:其一,方法适用于解的生成与评测完全在代码环境内自动完成的场景,无法直接扩展到需要与物理世界交互的领域,例如生物发现中评测一个解可能需要无法用代码执行自动化的湿实验;其二,策略探索依赖人工精心设计的指令,当前指令是为计算优化任务手工定制的,而非从每个任务自动派生。我自己的观察还有几点:预算只计入 LLM 成本,评测器 CPU 执行成本未纳入 BA-AUC,对评测极慢的任务(如需长时间模拟的 Cloudcast)结论可能反转;BA-AUC 依赖 API 定价,而定价与缓存折扣随厂商和时间变动,且 GPT 配置预算(数学 $2/系统 $1)与 GLM 配置($1/$0.5)并不严格等价,跨配置比较需谨慎;策略排序只依赖每策略一个试验实现,评测含噪声或实现偶发超时可能错杀好策略;每个设置仅 3 次运行,对演化搜索这类高方差过程统计功效偏弱;方法还隐含依赖同一厂商存在强/弱同族模型对,若两档模型能力差距缩小或缺少廉价变体,收益会缩水。
独立分析的弱点
独立分析的弱点与改进方向:(1) 模型分工是静态的——精炼阶段全程固定用低价模型,但消融显示只用 Luna 时 Signal Processing best 仅 0.75973(完整版 0.78912),说明低价模型确实会在策略理解上卡壳;可引入动态升级机制,例如同一策略连续 $M$ 次精炼失败后让高价模型接手一次。(2) 单试验排序噪声大:每个策略仅凭一个初始实现的得分排名,若实现恰遇超时或随机性不利的评测,好策略会被跳过或低排;改进方向是给头部策略 2-3 次实现机会,或用得分区间而非点估计排序。(3) 缓存友好的 prompt 排版依赖「哪段变化频率低」的人工先验(岛屿精英在前、随机采样在后),可让系统自动统计各字段历史变化频率来决定排版。(4) BA-AUC 忽略评测器成本:Cloudcast 等任务评测本身要跑模拟,若按次计价并入 $c$,方法排名可能改变,应报告含评测成本的版本。(5) 策略探索 prompt 是手写的,对新任务领域的泛化无保证,且「高价模型提策略」这一前提依赖模型具备真正的算法设计能力,在更难的开放问题上策略质量可能成为新瓶颈。
未来方向
作者明确提出的方向有二:把方法扩展到需要与物理世界交互的科学领域(如生物、化学的湿实验发现),这要求评测端支持异步、昂贵、非确定性的外部实验,预算模型也要把实验成本计入;以及开发自动生成策略探索指令的方法,让框架对新任务自我适配。基于本文成果可自然延伸的方向包括:把异构协作从「两档模型」推广为「能力阶梯」,在精炼内部按尝试失败次数动态路由模型档位;把 BA-AUC 从评估指标升级为优化目标本身,做预算分配的在线学习——学会何时该花高价探索、何时该用低价榨取;把 cache-efficient prompt 构造总结为通用 agent 的记忆排版原则并验证在其他智能体任务上的收益;与 ThetaEvolve、TTT-Discover 等测试时 RL 方法结合,把省下的预算用于改进实现模型本身;在多目标问题(如 Min-Max 距离比)上探索策略空间的结构化分解;以及系统研究成本预算与解质量的标度律,回答「预算翻倍能换多少分」这一对实践者最关键的问题。
复现评估
复现条件相当友好,属于低成本高可行性的一类。代码已开源(GitHub: chchenhui/frugalevo),论文承诺接收后公开全部代码、数据与补充材料;三个评测来源全部公开可获取——数学任务为 OpenEvolve 仓库的 5 个问题、系统任务为 ADRS benchmark 的 5 个任务、算法任务为 ALE-Bench-Lite 的 10 个 AtCoder 启发式竞赛题,评测器与初始程序齐备。算力上无需自建 GPU 集群,只需能调用 GPT-5.6 Terra/Luna 或 GLM-5.3/Flash 的 API;单次运行预算极低(数学任务 $1-2、系统任务 $0.5-1),即使完整复现 20 任务 × 3 运行 × 2 配置,LLM 开销估计也只有数百美元量级,个人研究者可负担。难度评估:跑通框架容易,但要严格复现表格数字需注意三点——API 定价随时间变动会改变成本曲线与 BA-AUC、演化搜索方差大而论文每设置仅 3 次运行、策略探索 prompt 的手工细节影响较大(好在附录 D 完整给出了两个核心 prompt,显著降低了这一不确定性)。综合判断为中低难度、值得复现。
论文图表
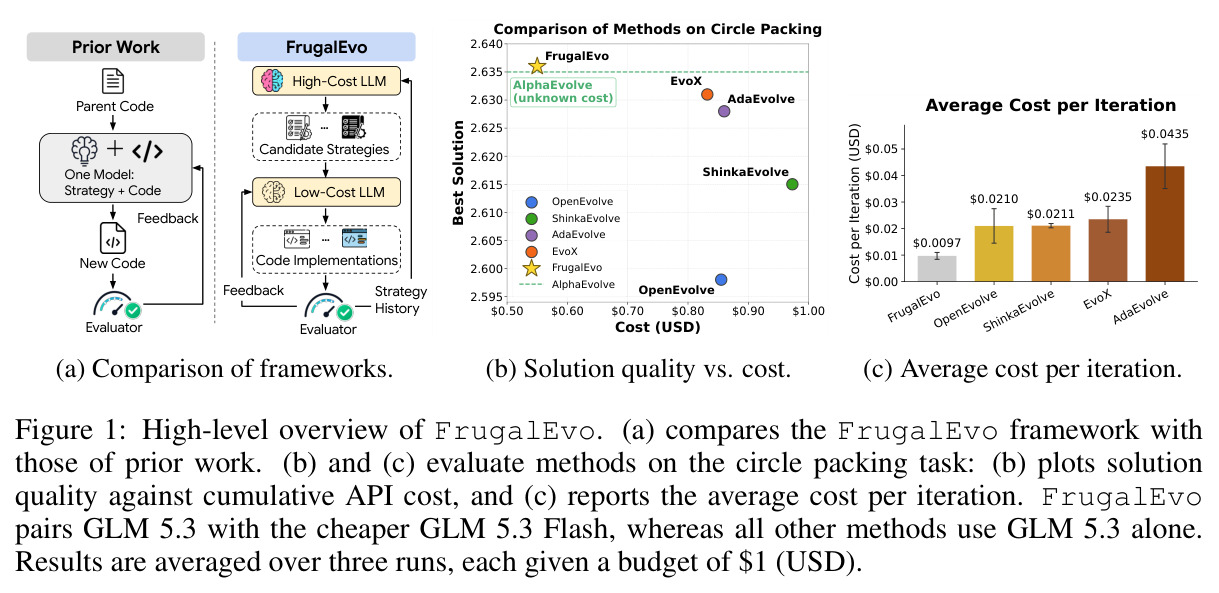
三联概览图:(a) 框架对比——先前工作用单一 LLM 从父代码直接生成候选,FrugalEvo 拆成高价 LLM 出候选策略、低价 LLM 出代码实现,评测器反馈回流入搜索历史;(b) 圆填充任务上解质量对累计 API 成本的曲线,FrugalEvo(GLM 5.3 + Flash)以约 $0.55 达到 2.635,超越所有用 GLM 5.3 的基线;(c) 各方法平均每迭代成本柱状图,FrugalEvo 约 $0.0211/次,基线为 $0.0210-$0.05。
这是全文的电梯演讲:一图同时呈现了核心思想(分工)、核心卖点(成本-质量曲线优势)和成本量化(每迭代成本降低),读者看懂这张图就抓住了论文的贡献骨架。