SwarmEvolve:潜空间智能体集群驱动的演化发现与优化 SwarmEvolve: Latent Agent Swarms for Evolutionary Discovery and Optimization
450个潜空间智能体以KV缓存通信做演化程序搜索,3–8分钟达到基线60分钟水平
前置知识
KV 缓存(KV Cache)
Transformer 自回归解码时,每个位置在各注意力层的键(key)和值(value)会被缓存下来,新 token 只需一次单位置前向、attend 到缓存即可,无需重算整个前缀。缓存与文本逐位置对应、可沿序列维直接拼接,因此能把多段内容的缓存连成一条长序列喂给同一模型。
本文的全部“智能体通信”都建立在 KV 缓存可直接拼接之上:智能体不传文本,而是把自己的思考过程以缓存形式交给总结者读取。
潜空间推理(Latent Reasoning)
区别于解码出思维链文本,潜空间推理把最后一层隐状态 $h_t$ 直接当作下一步输入嵌入 $e_{t+1}$,在连续向量空间中“思考”而不采样 token。LatentMAS 用岭回归闭式解出对齐矩阵 $W_a$ 完成映射并重新缩放范数,无需任何训练。
这是 SwarmEvolve 高吞吐的根本来源:每个智能体 40 步潜推理只需几十次单位置前向,比 20–35 秒的文本推理快一个数量级。
LLM 引导的演化搜索
把数学/计算问题写成“搜索一个好程序”:维护候选程序档案,用 LLM 充当变异与交叉算子生成新程序,由确定性评估器打分、择优入库。FunSearch、AlphaEvolve 及开源的 OpenEvolve、ShinkaEvolve、CodeEvolve 都属此范式,差异在于维持多样性的手段(岛屿、MAP-Elites 等)。
SwarmEvolve 是该范式的最新成员;实验分数定义为“目标值 / AlphaEvolve 发表构造的目标值”,理解这一点才能读懂全部结果表格。
RoPE 旋转位置编码
Qwen3 等模型用旋转矩阵 $R_i$ 乘以位置 $i$ 的 query 和 key,角度随 $i$ 线性增长,使注意力得分只依赖相对偏移:$(R_i q)^\top (R_j k) = q^\top R_{j-i} k$。把一段 KV 缓存从位置 $0,1,2,\ldots$ 搬到 $\delta,\delta+1,\ldots$ 只需给每个缓存键乘 $R_\delta$,值不受影响。
450 个智能体的缓存都从位置 0 开始,拼进总结者上下文前必须用 RoPE 旋转搬移位置,这是实现潜通信的关键工程细节。
MAP-Elites 档案
一种质量-多样性算法:按行为特征把解空间划分成格子,每个格子保留质量最高的个体,同时维持解的多样性与高质量。AlphaEvolve 及其开源变体用它存储候选程序,避免搜索过早收敛到单一思路。
SwarmEvolve 同样维护程序档案并从中选父程序,理解档案机制才能看懂精化/杂交/探索各类群如何取材。
研究动机
FunSearch、AlphaEvolve 等用 LLM 充当变异与交叉算子的演化搜索,已在 cap set 构造和 4×4 复矩阵乘法算法等开放问题上取得突破,但这一范式有一个共同瓶颈:慢且贵。每个智能体每轮都要解码一长段文本思维链,单个程序的文本推理耗时 20–35 秒;不断增长的解档案、评估器反馈和智能体间文本消息让上下文越拉越长;想扩展到更多智能体、更大模型或测试时训练时,成本成倍放大。实测中,OpenEvolve、ShinkaEvolve、CodeEvolve 在单张 L40S 上用 Qwen3 8B 跑满 60 分钟,分别只生成 158、99、81 个程序,而许多开放数学问题需要的搜索规模远超于此。多样性同样受限:文本框架一次只生成一条回答,或只运行一小队角色化智能体,提案多样性的上限天然偏低。
本文的目标是本文要回答的核心问题是:能否让一群低成本的智能体集群让演化搜索更快、更强?具体目标可量化为三点。其一,单张 GPU 上每轮并行运行数百个智能体(450 个),把每小时评估的程序数提升到现有 SOTA 框架的 5–13 倍;其二,以中位数 3–8 分钟达到 OpenEvolve、ShinkaEvolve、CodeEvolve 跑满 60 分钟才取得的最佳分数;其三,在 21 个数学发现与科学计算问题上,用 Qwen3 8B、14B、32B-FP8 三个开源模型都拿到最高平均分,并仅用冻结的 8B 模型在若干问题上超越 AlphaEvolve 用前沿 Gemini 模型发表的构造。终极愿景是让大规模 AI 驱动的科学发现不再依赖前沿模型或巨额算力预算。
与已有工作不同的是,已有工作改善搜索的思路几乎都停留在“文本层面”:更好的上下文(把分数变化、相关文献、模拟同行评审喂给模型)、拒绝近似重复提案、自适应分配预算、多角色智能体辩论或共享内存协作。本文的独特切入点是把潜空间推理与潜空间通信(LatentMAS 机制)整体搬进演化搜索:智能体根本不解码文本,而是在连续嵌入空间中思考,并以 KV 缓存为媒介直接“读取”彼此的思考过程。这一视角转变带来两个此前被忽视的好处——多样性可以靠并行数量直接堆出来(一轮 450 份不同视角的思考轨迹),而交叉可以在潜空间里自然发生(总结者一次读入 30 份缓存即完成想法重组)。此外,新颖性过滤直接测隐状态向量的余弦距离,省掉了 ShinkaEvolve 所需的外部嵌入模型加 LLM 评审两道开销。
核心方法
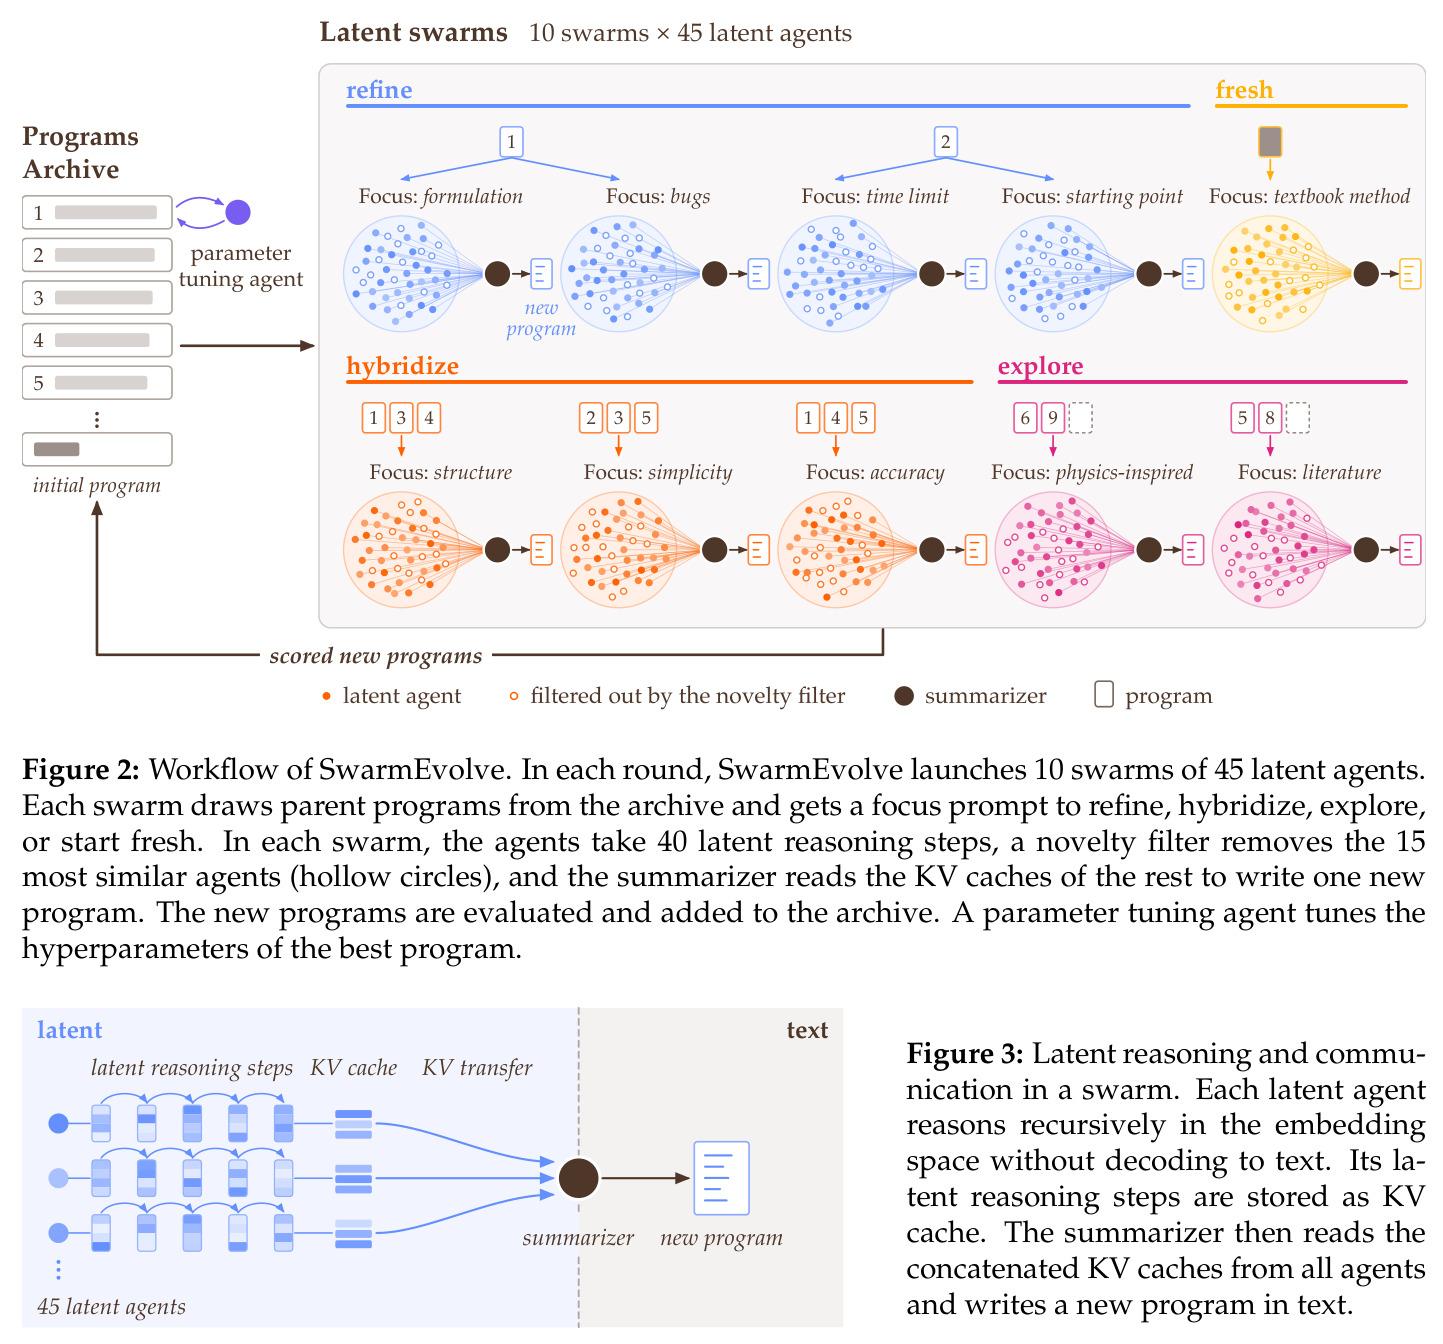
直觉上,SwarmEvolve 像是把一场程序设计竞赛交给 10 个讨论小组:每组 45 名“只在脑内思考、不开口发言”的成员,各自带着不同的思考角度(5 种焦点措辞 × 9 种思维方式,如第一性原理、质疑假设)去读问题和父程序;先淘汰组内想得最雷同的 15 人,再由一名“总结者”直接读取剩下 30 人的“脑电波”——他们的 KV 缓存——综合写出一份新程序。技术上,每个智能体先读问题、焦点提示与父程序及其评估结果,然后执行 40 步潜推理:把最后隐状态经对齐矩阵映射回输入嵌入空间 $e_{t+1} = \gamma \frac{W_a h_t}{\|W_a h_t\|}$,其中 $W_a = W_{in}^\top W_{out}(W_{out} W_{out}^\top + \rho I)^{-1}$ 是把词输出嵌入映射回输入嵌入的岭回归闭式解,$\gamma$ 为词嵌入平均范数。全部 450 个智能体合成一个 batch 一次跑完,读同一父程序的智能体通过 paged attention 共享该程序的 KV 缓存,单轮约一分钟。
核心创新是用潜空间推理加 KV 缓存通信彻底绕开“文本”这一瓶颈,由此同时获得三个已有框架无法兼得的性质。第一是多样性:文本框架一次生成一条回答,SwarmEvolve 每轮 450 个智能体各有专属提示和父程序,一次采出 450 份不同的思考轨迹。第二是内建交叉:交叉不再需要 LLM 读取多段文本后费力综合,而是总结者的 KV 缓存按序列维直接拼接 30 个智能体的缓存,$K^{(\ell)} = [K_1^{(\ell)}; \ldots; K_{30}^{(\ell)}; K_{prob}^{(\ell)}; \ldots; K_{ins}^{(\ell)}]$,想法的重组发生在连续向量空间里,天然完成“杂交”。第三是高吞吐:智能体之间没有任何解码或编码步骤,450 个智能体的潜推理总共只需几秒。配套的新颖性过滤器直接在隐状态空间做贪心最远点选择,把“想法去重”变成一次数值计算——无需外部嵌入模型和 LLM 评审,这是与所有文本框架最本质的分野。
方法步骤详情
每轮约 1 分钟,流程如下。(1) 组建集群:10 群 × 45 个智能体,分四类——4 个精化群各领档案中最好两个程序之一(每程序两群,焦点轮换)、3 个杂交群各随机领前十佳中的 5 个程序(每程序 9 个智能体读)、2 个探索群各从全档案随机领 4 个程序(另有 9 个智能体只读题面不读父程序)、1 个全新起步群只领初始程序;每个智能体的提示是“5 种焦点措辞 × 9 种思维方式”中的独特组合。(2) 潜空间推理:智能体读完输入后执行 40 步潜推理,450 个智能体单 batch 并行。(3) 新颖性过滤:以 40 步平均隐状态 $\bar{h}_j = \frac{1}{40}\sum_{t=1}^{40} h_{j,t}$ 为代表,中心化并归一化为 $z_j$,用贪心最远点选择 $j^\star = \arg\max_{j \notin K} \min_{i \in K}(1 - z_j^\top z_i)$ 留下 30 个、淘汰 15 个。(4) 传递缓存:总结者的 KV 缓存按序列维拼接 30 份智能体缓存、$Q$ 份父程序缓存、题面与指令;拼接前每个智能体的键乘 $R_\delta$ 做 RoPE 位置搬移。(5) 写程序:总结者解码出方向描述与一份完整程序。(6) 参数调优:每轮由调参智能体读最佳程序的全部数值参数,提议单数值修改,每轮至多评估 8 个。(7) 评估:去重、查语法、自动补 import,确定性评估器在 8 个 CPU 核上并行打分,结果连同日志入档案。
技术新颖性
与已有技术的区别可分三层看。算法层面:FunSearch 用岛屿、AlphaEvolve 系用 MAP-Elites 维持多样性,都在文本空间操作;SwarmEvolve 的多样性来自“数量 × 提示差异化 × 隐状态距离过滤”的组合,且过滤发生在生成之后、解码之前,几乎零成本。通信层面:多智能体框架(辩论、共享内存、编排器)靠文本消息传递,上下文随消息增长;本文的潜通信把消息压进 KV 缓存且无需任何训练——对齐矩阵是闭式岭回归解,RoPE 旋转解决位置对齐。搜索算子层面:变异和交叉首次被拆到不同空间——变异由 450 个潜推理智能体承担,交叉由总结者在缓存拼接中自然完成,另设专门的参数调优智能体处理数值超参。消融实验进一步印证:把潜推理换回文本推理(即便给更高的 token 预算)分数也会下降,因为每轮变慢、单位时间评估数锐减。
实验结果
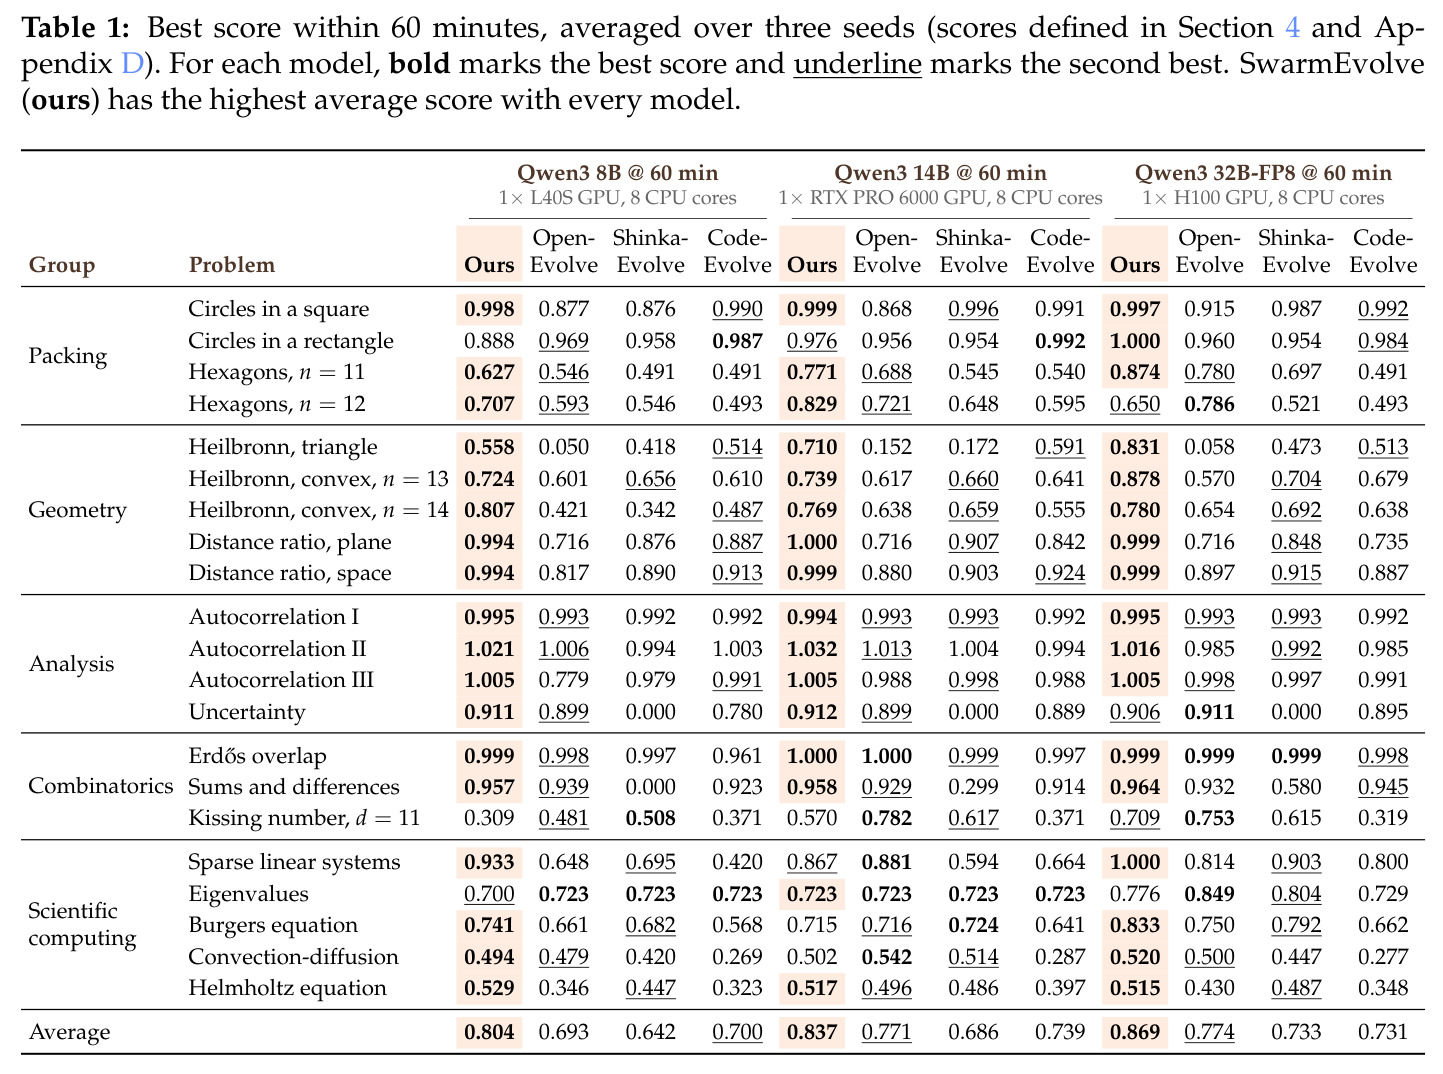
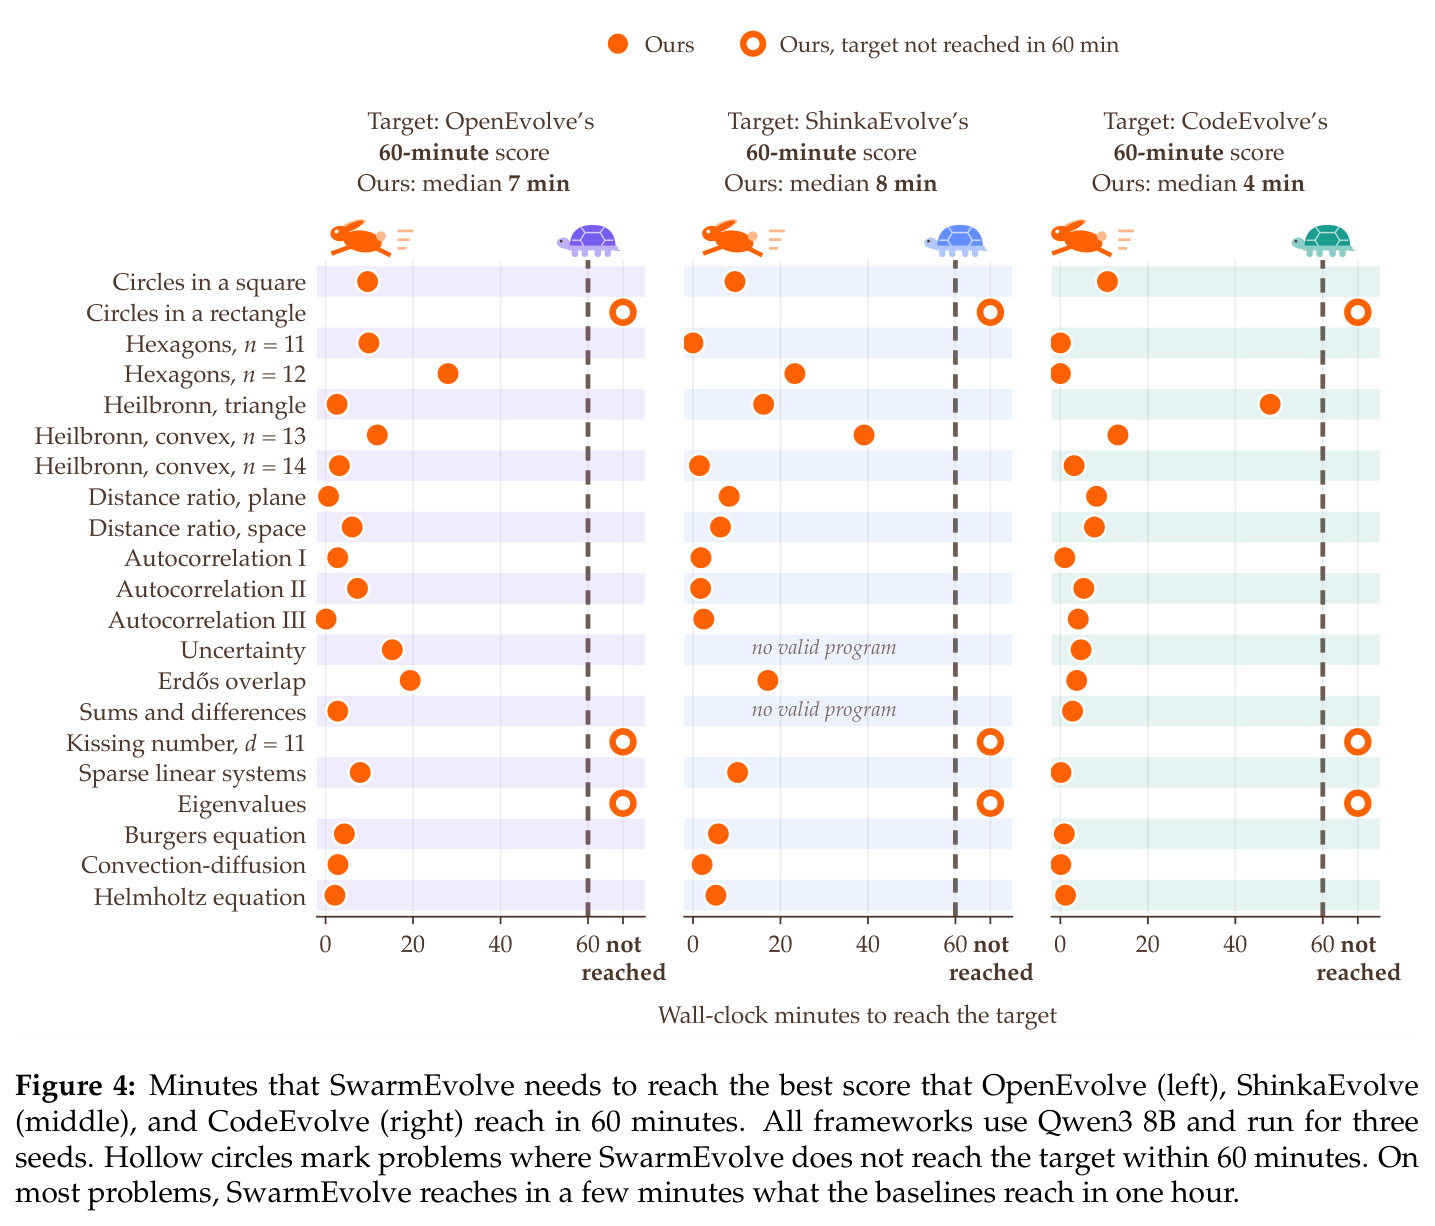
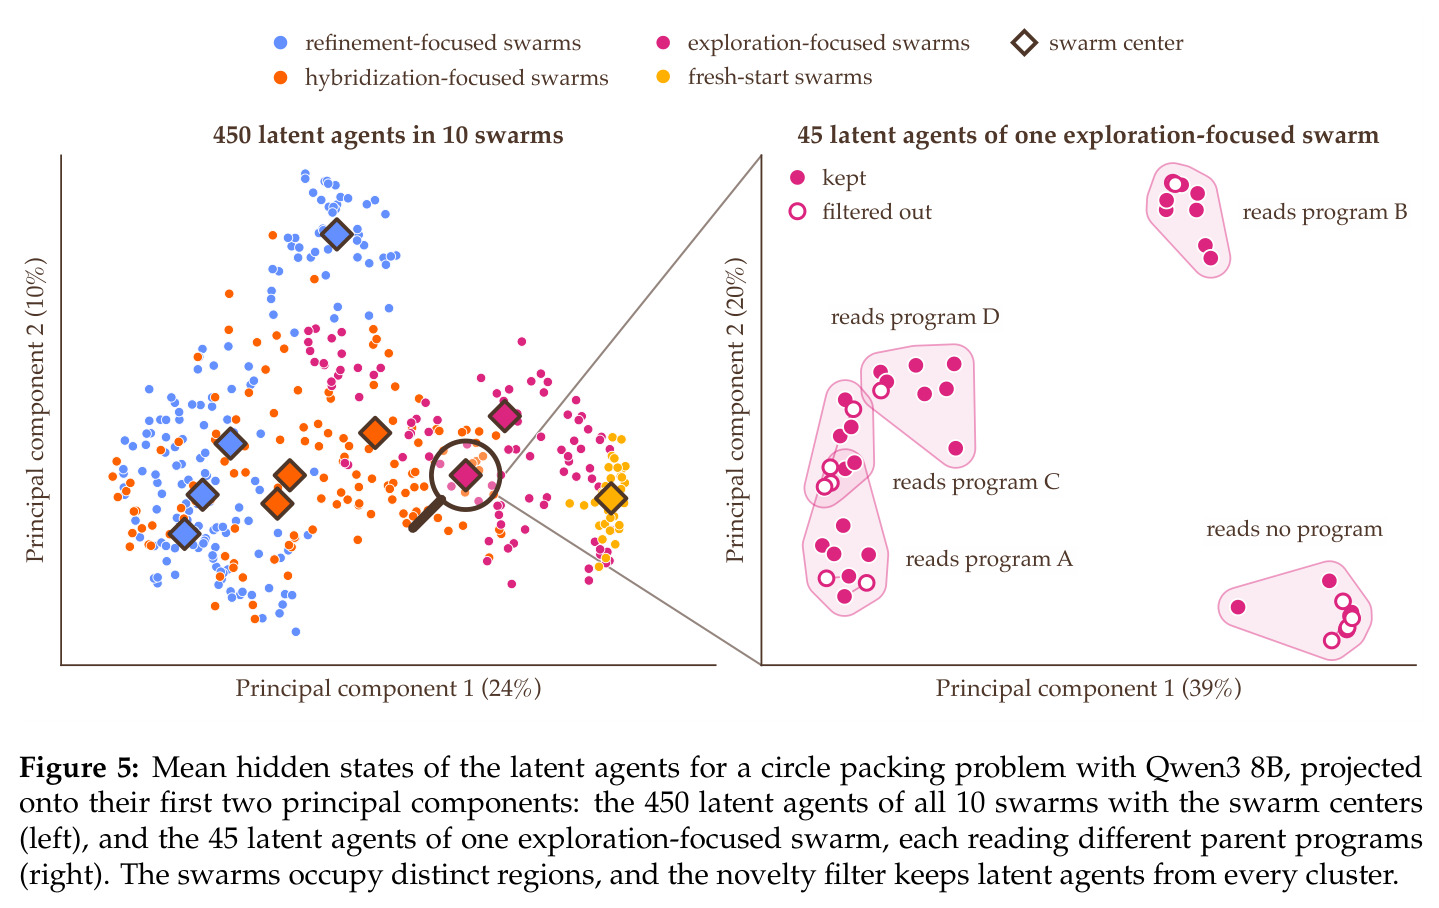
在 21 个问题(装箱 4 题、几何 5 题、分析 4 题、组合数学 3 题取自 AlphaEvolve 附录 B,另加稀疏线性系统、特征值、Burgers、对流扩散、Helmholtz 5 个科学计算题)上,每个框架用 Qwen3 8B/14B/32B-FP8 各跑 3 个种子、60 分钟单 GPU。结果一(分数):平均最佳分数全面领先——8B 下本文 0.804,对 OpenEvolve 0.693、ShinkaEvolve 0.642、CodeEvolve 0.700;14B 下 0.837 对 0.771/0.686/0.739;32B-FP8 下 0.869 对 0.774/0.733/0.731;且 8B 的 0.804 已超过所有基线配 32B-FP8 的成绩。结果二(吞吐):60 分钟生成 734 个程序,是 OpenEvolve 158、ShinkaEvolve 99、CodeEvolve 81 的约 4.6–9 倍。结果三(速度):中位数仅需 4–8 分钟(8B)、3–6 分钟(更大模型)即达到各基线 60 分钟的最佳分数,15 分钟时平均分已超所有基线在所有模型下的 60 分钟均值。结果四(满分突破):32B-FP8 下稀疏线性系统 5 题全部达到满分 1.000,没有任何基线运行做到。结果五(超越 AlphaEvolve):仅用冻结 Qwen3 8B 即在 3 个问题上超越 AlphaEvolve 用前沿模型发表的构造——26 圆装箱达到已知最优半径和 2.635983,自相关 II/III 不等式分数 1.021/1.005。潜空间 PCA 分析显示各群占据不同区域、过滤后每个父程序簇都有保留,支撑了多样性主张。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 21 个数学发现与科学计算问题(Qwen3 8B,60 分钟) | 平均最佳分数 | 0.804 | OpenEvolve 0.693 / ShinkaEvolve 0.642 / CodeEvolve 0.700 | 相对最佳基线(CodeEvolve)提升约 15% |
| 程序生成吞吐(Qwen3 8B,60 分钟单 GPU) | 评估程序总数 | 734 个 | OpenEvolve 158 / ShinkaEvolve 99 / CodeEvolve 81 | 约 4.6–9 倍 |
| 达到 OpenEvolve 60 分钟最佳分数(Qwen3 8B) | 墙上时钟分钟数(中位数) | 7 分钟 | OpenEvolve 需 60 分钟 | 约 8.6 倍加速 |
| 稀疏线性系统(Qwen3 32B-FP8) | 正确数字分数 | 1.000(5 题全部满分) | OpenEvolve 0.814 / ShinkaEvolve 0.903 / CodeEvolve 0.800 | 唯一全对的框架 |
| 自相关 II 不等式(Qwen3 8B) | 相对 AlphaEvolve 发表构造的分数 | 1.021 | AlphaEvolve(前沿 Gemini 模型)1.000 | 用 8B 小模型小幅超越 |
| 26 圆装箱于正方形(Qwen3 8B) | 圆半径之和 | 2.635983 | AlphaEvolve 发表构造 | 达到该问题已知最优值 |
局限与改进
作者承认三点局限。其一,所有潜智能体与总结者必须共用同一个 LLM,因为只有同源模型的 KV 缓存才能直接拼接,跨模型需要学习缓存翻译。其二,实现要求标准注意力机制,线性注意力、状态空间与混合架构把历史压缩进固定大小的状态,多个智能体的状态如何合并尚无方案。其三,单轮 KV 缓存显存随智能体数 × 潜推理步数 × 层数线性增长,最大的 32B 模型已需要大显存 GPU。我补充几点观察:科学计算类问题的绝对分数并不高(特征值 0.700–0.849、Helmholtz 约 0.5、对流扩散约 0.5),说明潜推理对复杂物理求解器的改进能力仍有限;个别问题反而落后,如 8B 下 kissing number(d=11)本文 0.309 低于 ShinkaEvolve 的 0.508;评估器必须是确定性且廉价的 CPU 程序,这一前提排除了评估昂贵的仿真类问题;60 分钟的统一对比窗口对慢热型方法可能不利;潜推理过程不可读,出错时难以像文本思维链那样人工诊断。
独立分析的弱点
第一,新颖性过滤用的是 40 步平均隐状态的余弦距离,这只是语义多样性的粗糙代理——均值向量距离近的两个智能体思路未必雷同,反之亦然,可能误杀真正不同但均值接近的提案;改进方向是引入轻量训练的多样性度量,或对每步隐状态做更细粒度比较。第二,“交叉”完全托付给单个总结者的一次解码,30 份缓存拼接后上下文长达数千位置,总结者可能出现注意力稀释、输出质量方差大;可尝试多总结者投票或按簇分组摘要再合并。第三,40 步潜推理是固定超参,对简单问题浪费算力、对难题可能不够;可按问题难度或父程序分数自适应调节步数。第四,吞吐优势依赖“评估便宜”这一前提——若单次评估要几分钟(大型仿真),734 个程序的吞吐红利会被 CPU 评估队列吞没;应引入代理模型预筛选或评估预算分配。第五,去重目前只检测完全相同的程序,潜空间里明显相似的提案仍会浪费评估名额;可直接复用隐状态距离做语义级去重。
未来方向
作者提出的方向包括:用学习到的模型间 KV 缓存翻译突破单模型限制,让集群中混跑异构模型;为线性注意力、状态空间模型设计多智能体状态合并机制;把单轮缓存分摊到多 GPU 以支持更大模型与更长运行;引入压缩潜消息降低显存压力。基于本文成果还可延伸:把潜集群搜索搬到符号回归、PDE 求解器设计、算法优化与证明策略搜索等更多科学场景(作者已在讨论中点名);将新颖性过滤与图 5 式潜空间可视化结合,做搜索过程的实时可解释监控;探索潜推理步数、集群规模与模型规模三者的联合缩放律;把评估反馈也编码进缓存(目前父程序评估结果仍是文本读入),逼近全潜空间的完整演化循环;对评估昂贵的问题结合训练小代理模型做早期筛选。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/Qile-J/SwarmEvolve);模型全部是开源权重的 Qwen3 8B、14B、32B-FP8;单 GPU 即可复现:8B 用一张 L40S、14B 用 RTX PRO 6000、32B-FP8 用 H100,均配 8 个 CPU 核,每问题每种子 60 分钟。21 个问题中 16 个直接复用 OpenEvolve 发布的 AlphaEvolve 附录 B 题面、初始程序与评估器,另 5 个科学计算问题的细节在附录 D,问题与评估器都是现成的。主要工程门槛在于推理栈定制:需要获取并操作隐状态与 KV 缓存(对齐矩阵 $W_a$ 的闭式解、paged attention 共享缓存、RoPE 位置搬移、跨序列缓存拼接),vLLM 生态可支撑但需自行改造。总体难度中等:有 GPU 和 LLM 推理工程经验的团队可在数天内复现主干方法,完整复现 21 题 × 3 模型 × 3 种子的全部实验约需数十 GPU 小时。
论文图表
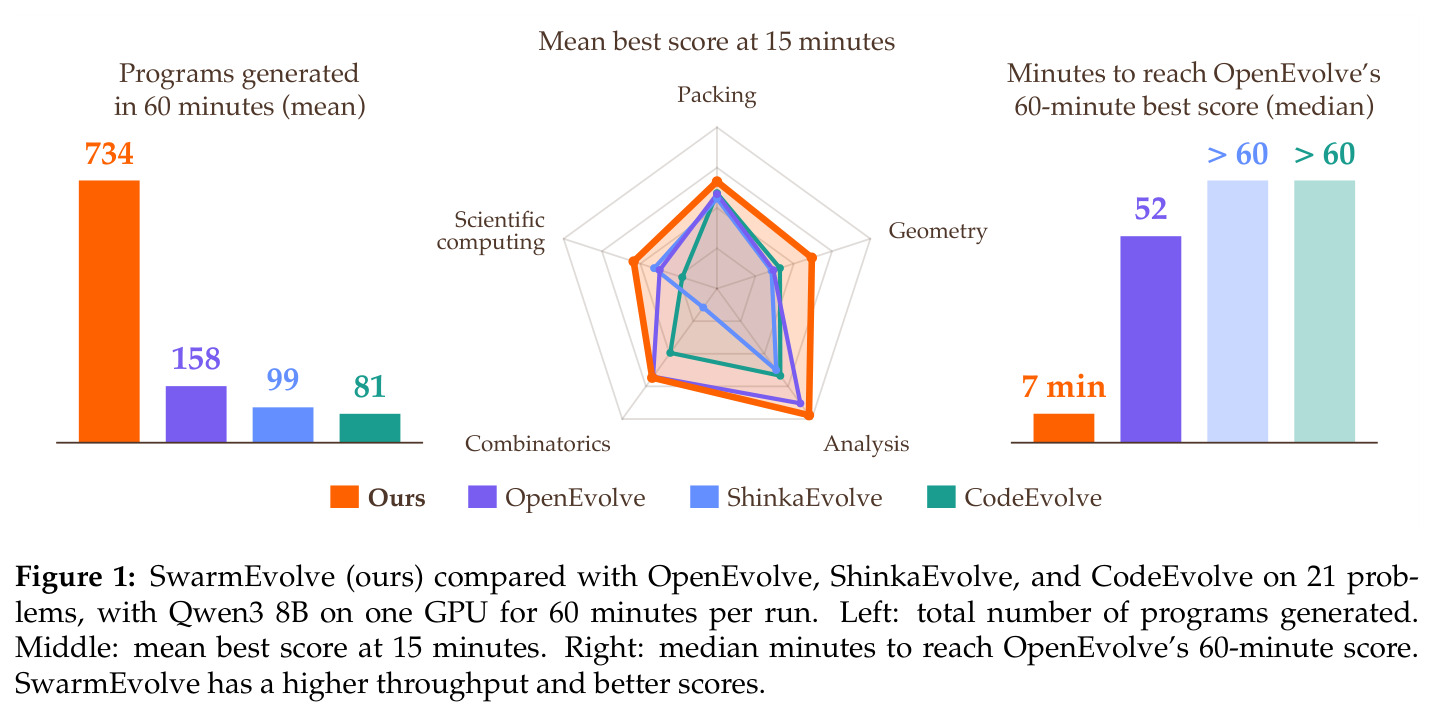
三联概览图:左侧柱状图显示 60 分钟生成程序总数(本文 734 对 158/99/81),中间为 15 分钟时平均最佳分数,右侧为达到 OpenEvolve 60 分钟最佳分数的中位分钟数(本文 7 分钟对超过 60 分钟)。
一张图浓缩了论文全部卖点——吞吐量、早期分数、收敛速度,是快速判断本文价值与阅读后续细节的入口。
示意图:每个潜智能体在嵌入空间递归推理、不解码任何文本,其 40 步思考以 KV 缓存形式存储;总结者拼接所有智能体的缓存后,以文本写出一份新程序。
论文最核心的机制——“潜空间推理 + 缓存通信”——全靠这张小图建立直觉,不懂它就无法理解吞吐优势从何而来。