世界嵌入基准:视频表征中物理信息的评测 World Embedding Benchmark
8000个物理仿真视频评测嵌入模型的物理对齐与量化信息可恢复性,发现二者存在权衡。
前置知识
对比学习(Contrastive Learning)
一种表示学习范式:把匹配的正样本对(如视频与描述)在嵌入空间拉近、负样本推远,典型用 InfoNCE 损失,温度 $\tau$ 控制难度,CLIP、E5 等检索模型均由此训练。
本文的适配实验正是用持续对比训练把物理视频-文本对注入预训练嵌入模型,检索/配对分类的提升与回归的退化都由这一机制引起。
线性探针(Linear Probe)
冻结预训练编码器,只在其输出表征 $z$ 上训练一个线性映射 $f_\theta$ 去预测目标。若简单线性模型就能从 $z$ 恢复某信息,说明该信息已被编码且线性可访问;反之说明编码器没学到,或信息被非线性缠绕、难以提取。
本文用线性回归探针从冻结视频嵌入预测雷诺数、弹性模量等物理量,是衡量“量化物理信息可恢复性”的核心手段。
nRMSE 与 Spearman 秩相关
nRMSE 是按目标值范围归一化的均方根误差 $\mathrm{nRMSE}=\frac{\sqrt{\frac{1}{N}\sum_i(\hat{y}_i-y_i)^2}}{y_{\max}-y_{\min}}$,衡量绝对精度;Spearman $\rho$ 衡量预测与真值的排序一致性。
回归任务的主、辅指标:两者结合才能判断模型是精确预测出了物理量,还是只排对了相对大小顺序。
JEPA(联合嵌入预测架构)
自监督视频表征学习方法:在嵌入空间预测被遮挡或未来片段的表征,而非像素级重建,从而学到预测性、抽象的动态表征。V-JEPA2 完全不使用文本对齐,只从视频自身学习。
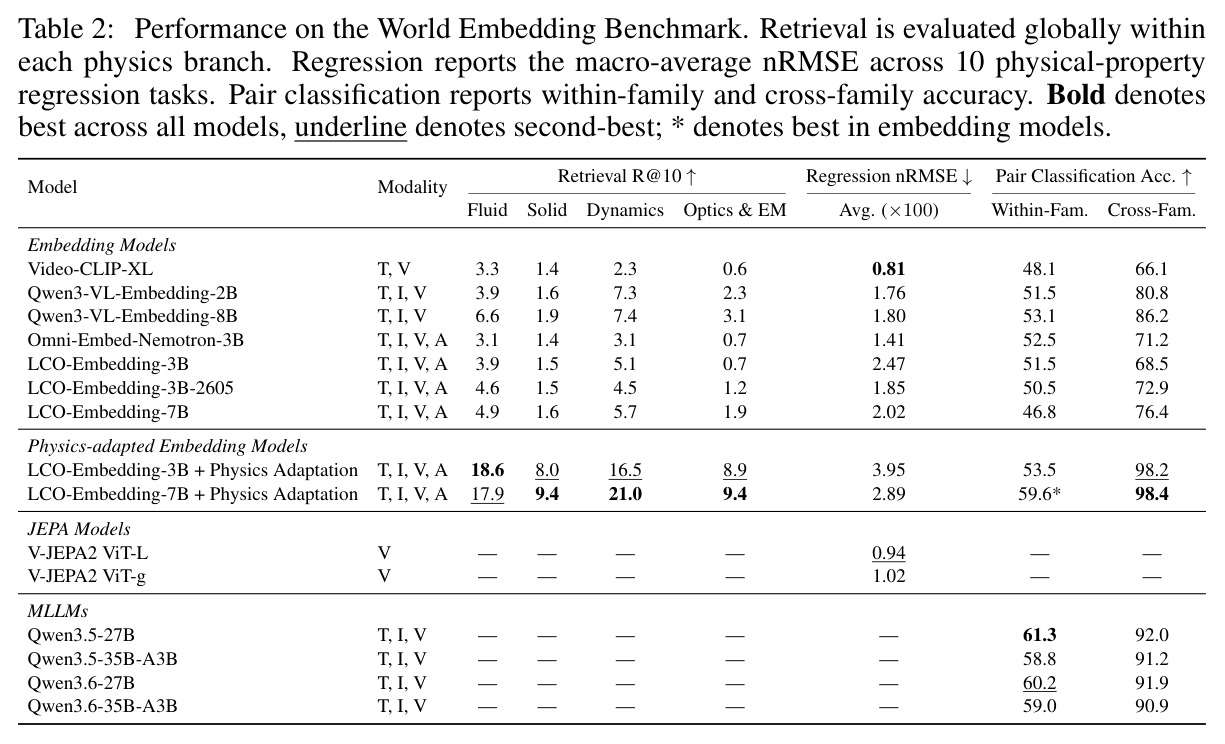
论文发现 V-JEPA2 冻结特征的物理回归 nRMSE 0.94 优于多数文本对齐模型,是支撑“信息编码与语言对齐是两回事”这一核心论点的关键证据。
检索增强生成(RAG)
生成前先从外部库检索相关参考(此处为视频),把参考作为条件输入生成模型以提升保真度。本文用多模态嵌入模型检索物理相关视频,作为 MiniMax-H3 生成物理场景时的参考帧。
RQ3 检验物理表征的实际用途:检索器物理能力越强,生成视频的物理保真度增益越大,这把表征评测与下游生成价值联系起来。
世界模型与物理保真度
世界模型指能预测环境在不同条件下如何演化的生成模型;物理保真度指生成内容遵循物理规律(守恒律、因果时序、材料响应)的程度。VideoPhy、PhyGenBench 等评测显示当前视频生成“视觉逼真但物理常识差”。
这是论文的问题背景:要成为世界模型,表征必须编码物理量,本文正是系统评测这一点的工具。
研究动机
视频生成模型正被寄望于成为世界模型,但近期评测(VideoPhy、PhyGenBench、VBench-2.0 等)一致显示:生成视频的视觉逼真度与物理常识遵循度之间存在巨大鸿沟——画面好看,但物体穿模、流体失真、因果颠倒。表征层面的问题更加模糊:一个视频嵌入可能能把场景识别为“流体流动”或“弹性形变”,却完全无法区分粘度或刚度的参数变化。而现有评测资源是割裂的:PDEBench、The Well、CFDBench 等数值基准面向代理模型的场预测精度,IntPhys、Physion、CLEVRER 等视觉基准只考物体级因果推理,没有一个基准能在受控条件下同时考察多模态嵌入的跨模态物理对齐与量化物理信息可恢复性。论文由此提出核心问题:视频嵌入里到底保存了多少物理世界的信息?这些信息有多容易被访问?
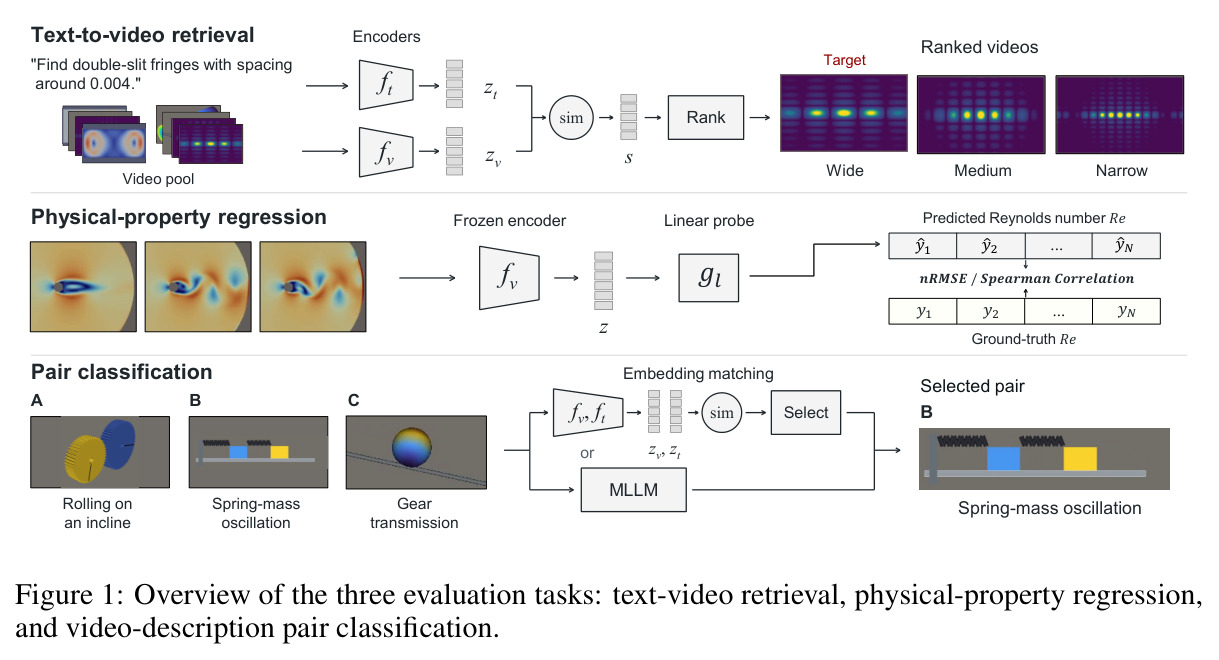
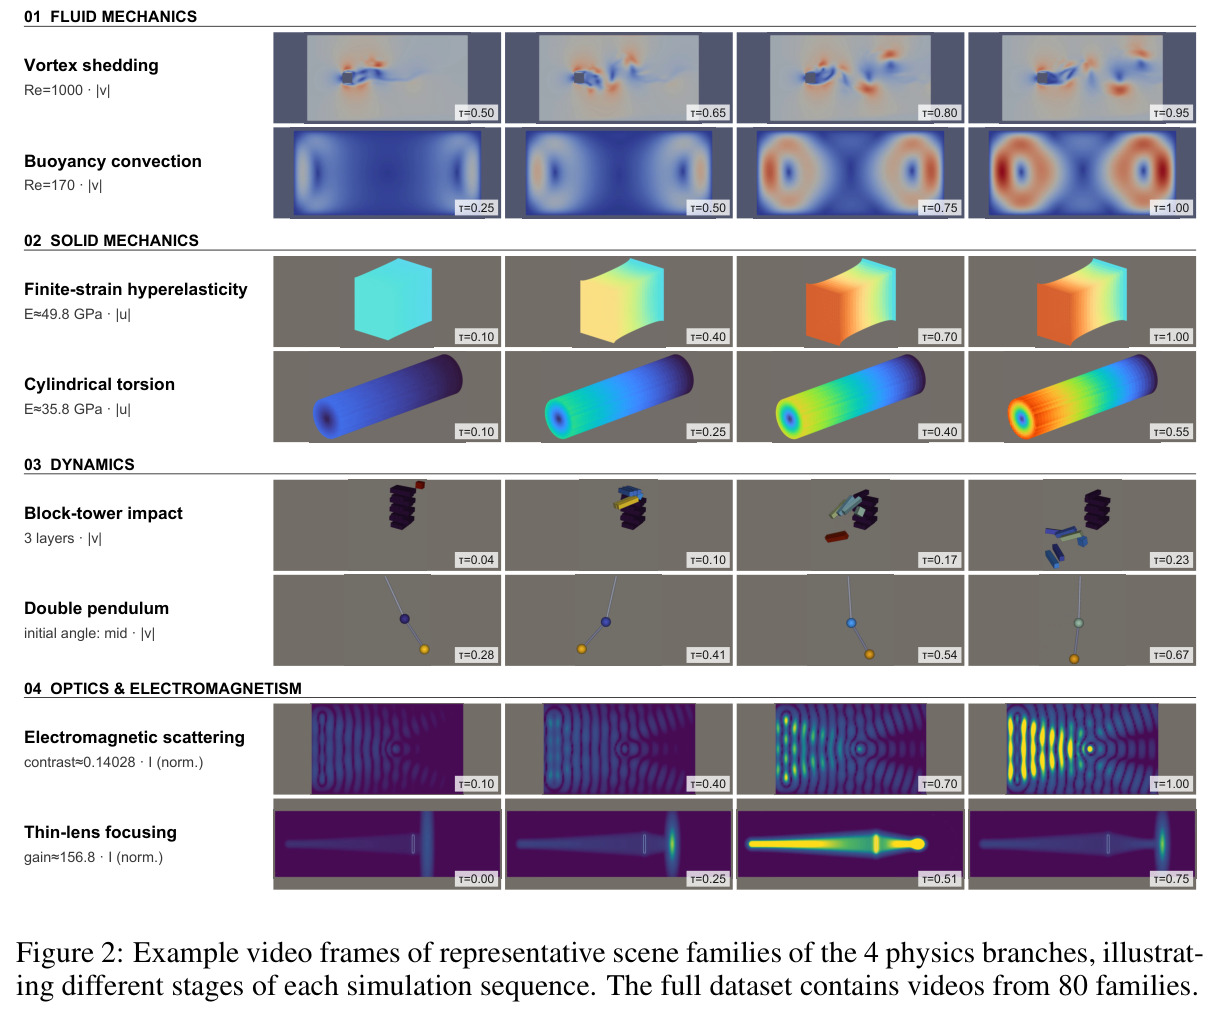
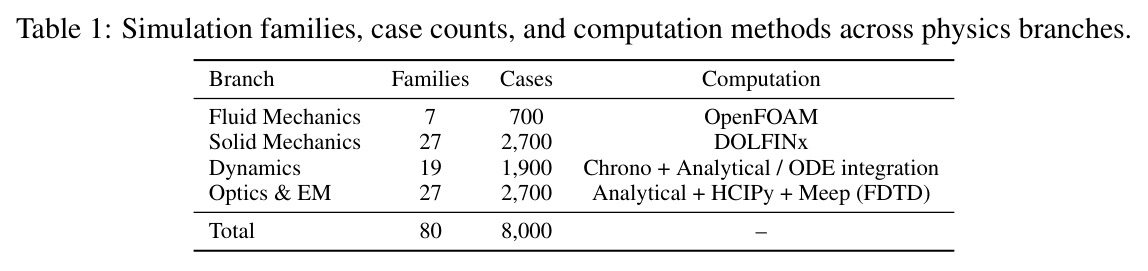
本文的目标是论文的目标是构建 World Embedding Benchmark:一个由受控数值仿真驱动的视频嵌入物理评测基准,包含 80 个物理家族、四大分支(流体力学 700 案例、固体力学 2700 案例、动力学 1900 案例、光学与电磁学 2700 案例)共 8000 个仿真案例,每个家族 100 个案例对应同一物理系统在不同参数下的实例,配有渲染视频和仿真产生的精确物理标注。在此之上定义三个互补任务——分支内双向文本-视频检索、冻结嵌入上的线性探针物理属性回归、视频-描述配对分类——分别度量跨模态物理对齐、量化信息可恢复性与细粒度物理判别力,并回答三个研究问题:当前表征模型是否编码物理(RQ1)?对比适配能否改善物理对齐(RQ2)?物理表征能否改进视频生成(RQ3)?
与已有工作不同的是,独特切入点有三。第一,能力解耦:作者明确区分“嵌入中编码了物理信息”(可用探针恢复)与“信息可通过跨模态相似度访问”(检索/分类可达),指出二者可以独立失败——这正是此前评测混淆之处。第二,数据形态:首次把 OpenFOAM、DOLFINx、Project Chrono、HCIPy/Meep 等成熟求解器产生的仿真场渲染成视频并保留生成参数作为真值,服务于嵌入评测而非代理模型评测;每个家族 100 个仅参数不同的实例天然构成“同族细粒度负例”,能测出对雷诺数、波长这类连续量的敏感性。第三,评测对象横跨三类表征范式——文本对齐的全模态嵌入模型、无文本自监督的 V-JEPA2、直接提示的 MLLM——用同一把尺子量出“生成模型有能力但嵌入空间没暴露”的错位。
核心方法
直觉上,要回答“视频嵌入知道多少物理”,必须先有标准答案。作者的思路是:不用真实世界难以标注的视频,而是用经过验证的数值仿真器生成参数可控的物理场景——流体用 OpenFOAM 有限体积法,固体用 FEniCSx/DOLFINx 有限元(涵盖线性弹性、Neo-Hookean 有限应变能与 J2 塑性等),动力学用 Project Chrono 加解析/ODE 积分,光学用解析公式与 HCIPy 场传播,电磁用 Meep FDTD 解麦克斯韦方程组——再用 ParaView 渲染 PNG 帧序列、FFmpeg 编码 MP4,使每段视频携带精确的生成参数与派生物理量。在此数据上搭建检索、回归、配对分类三个评测任务;随后按 LCO-Embedding 配方对预训练嵌入模型做物理对比适配,观察三任务指标的此消彼长;最后把不同检索能力的嵌入模型接入 MiniMax-H3 做检索增强生成,在 PhyGenBench 上验证表征质量对生成物理保真度的传导作用。
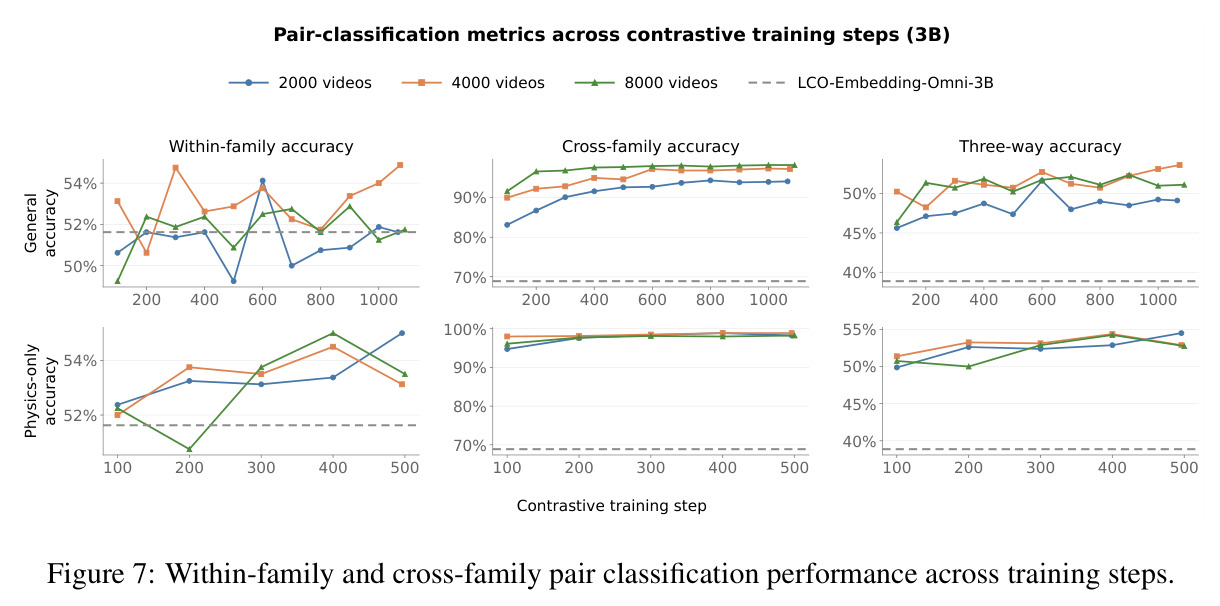
核心创新是把“对齐”与“可恢复性”拆成两条正交的评测轴。检索与配对分类衡量嵌入空间中的跨模态物理对齐——相似度排序能否把“双缝条纹间距约 0.004”匹配到正确视频;线性回归探针衡量量化信息的可恢复性——冻结嵌入里是否线性编码了雷诺数 $Re$、波长 $\lambda$、杨氏模量 $E$ 等连续量。已有物理基准要么只测数值场预测(PDEBench、The Well),要么只测物体级因果(Physion、CLEVRER),都没碰过多模态嵌入空间的物理内容。另一个关键设计是家族结构:同族 100 个案例只差参数,天然提供细粒度负例,使“族内配对分类”成为对数值敏感性的低成本探针,而“跨族分类”测系统级判别——分开报告才能暴露“跨族容易、族内接近随机”的失衡。适配实验进一步把这对指标变成因果关系探针:对比训练提升对齐的同时回归退化,直接证明二者会此消彼长。
方法步骤详情
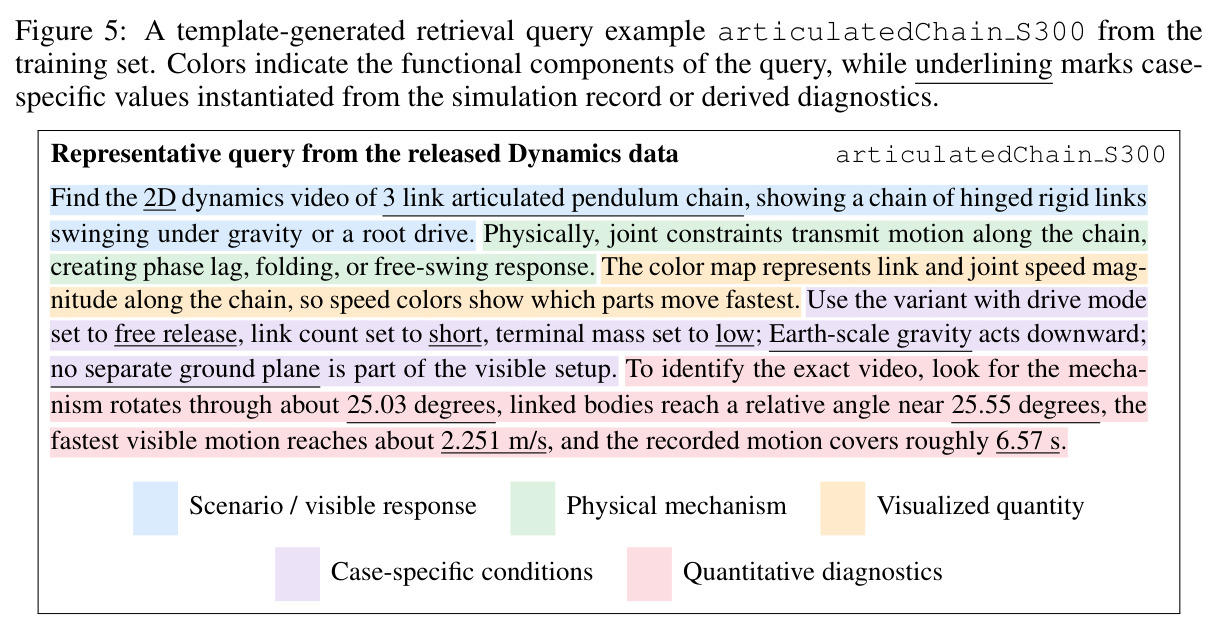
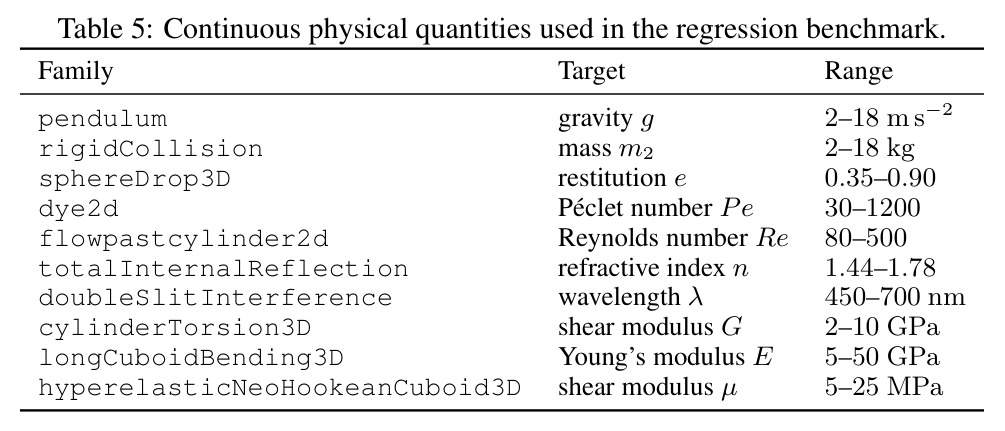
第一步,数据生成:80 个家族各按控制方程与本构律定义,用 OpenFOAM、DOLFINx、Chrono、HCIPy/Meep 计算 100 个参数实例,输出速度、位移等场;质检过滤异常后经 ParaView 渲染、FFmpeg 编码为 MP4。第二步,检索评测:每家族一个模板,槽位从元数据实例化,每案例一个主查询,分支全库内双向检索报 mean Recall@10。第三步,回归:10 个家族各定一个连续目标(雷诺数、波长、杨氏模量等),冻结编码器后拟合线性探针 $\hat{y}_i=f_\theta(z_i)$,报 nRMSE 与 Spearman $\rho$。第四步,配对分类:每家族 10 个锚点各配同族与跨族负例,嵌入模型比相似度、MLLM 直接答题。第五步,适配训练:重新仿真 8000 对(数值不同于基准),physics-only {2k,4k,8k} 子集训 {16,8,4} epochs;general 混 271k 通用对、2 epochs。第六步,RAG:各模型检索 top-1 参考视频供 MiniMax-H3 生成,在 PhyGenBench 上对比。
技术新颖性
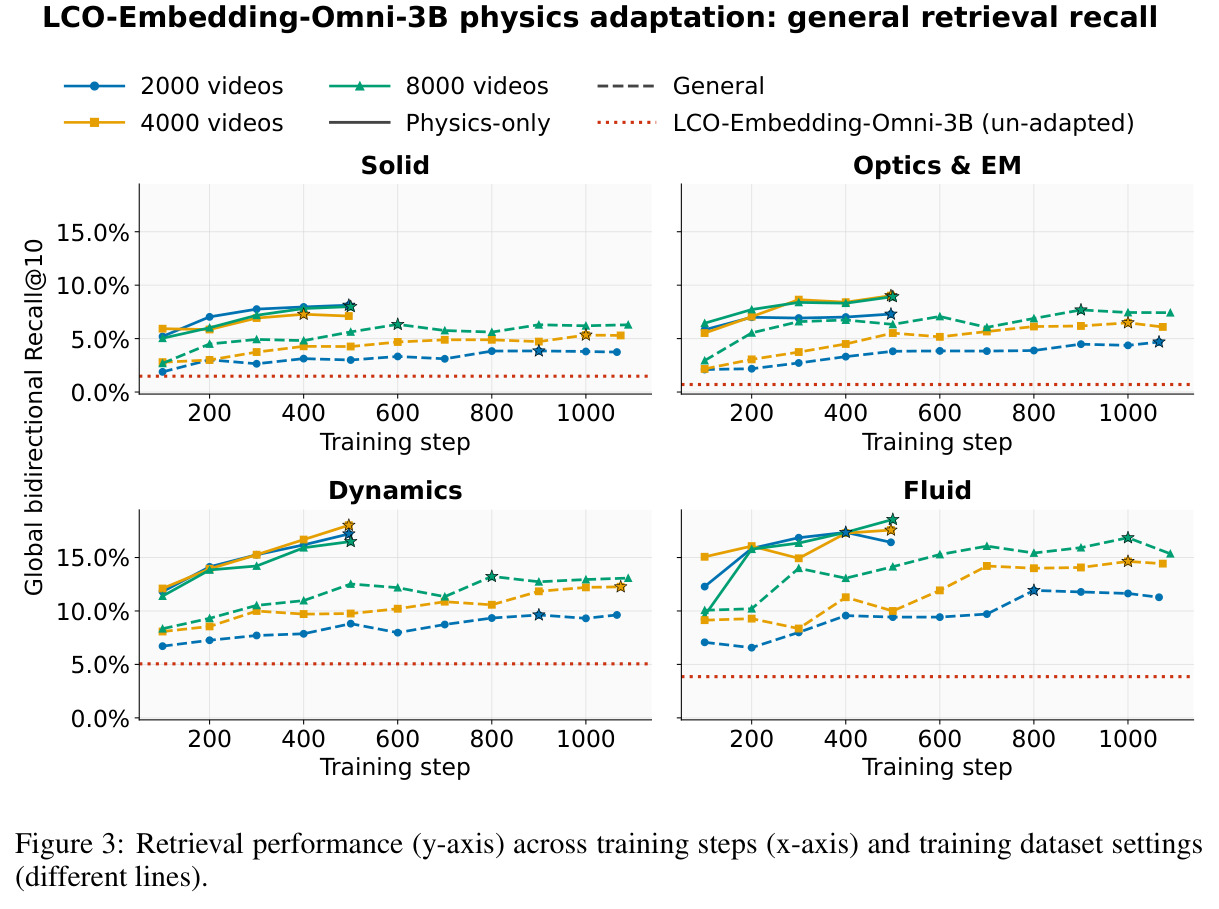
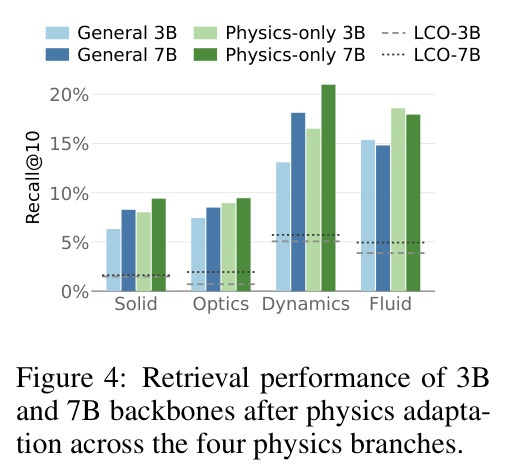
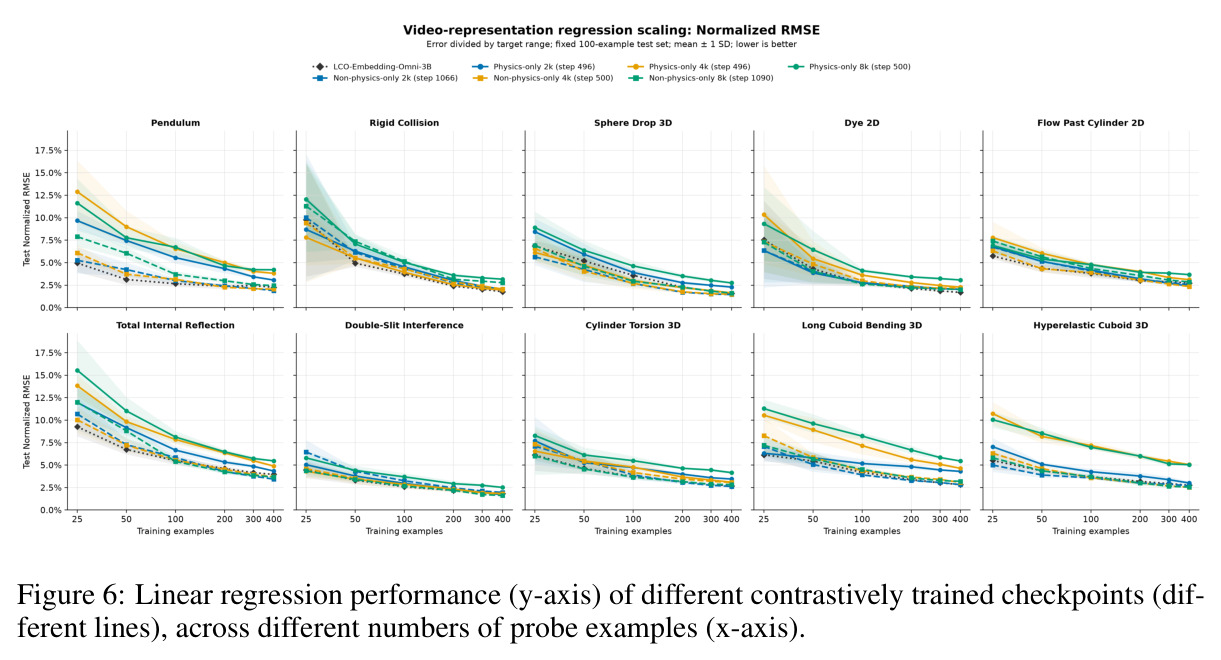
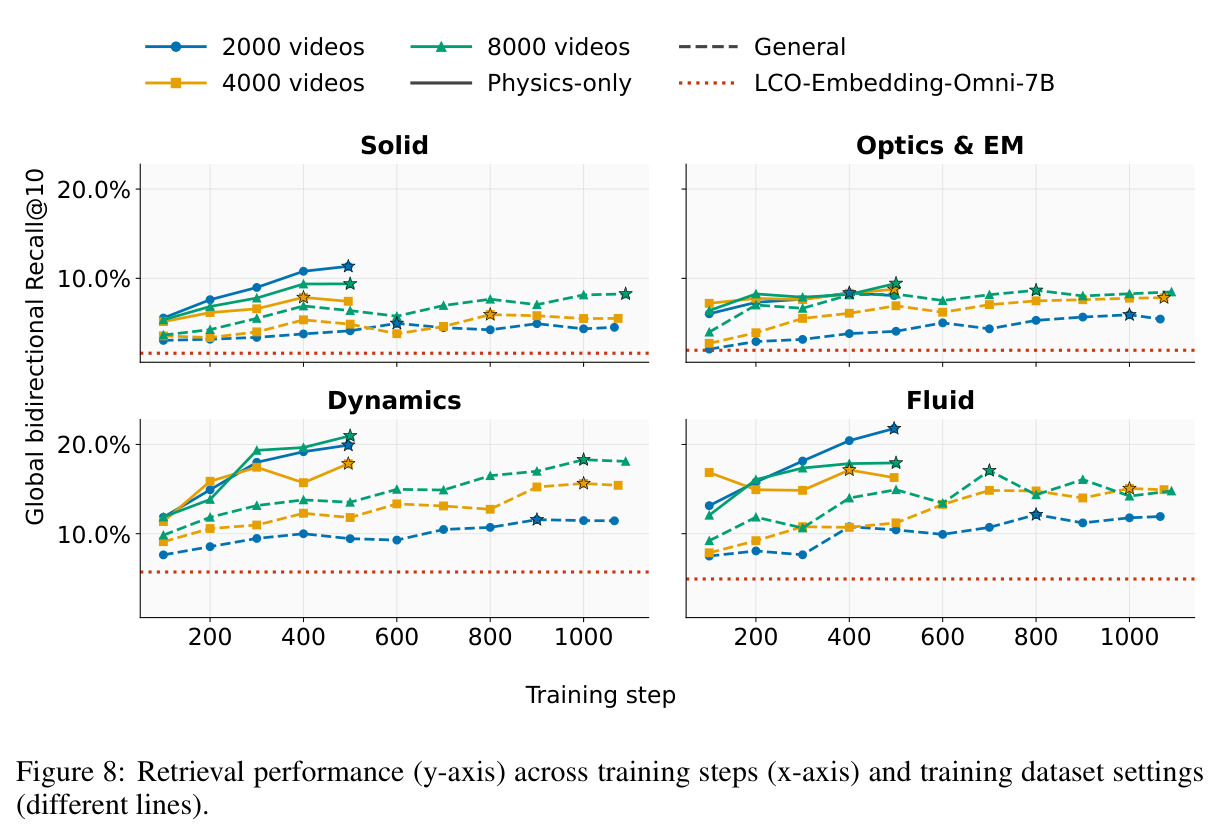
技术新颖性体现在四个层面。其一,受控真值:不同于真实视频只有粗标注,仿真给出每个案例的精确参数,使回归与检索评测完全可控、可复现。其二,结构化难度:家族×100 实例的设计让基准能同时出“跨系统判别”(容易)与“参数级判别”(接近随机)两档考题,精确诊断失败模式。其三,结论新颖:首次系统证明(a)预训练嵌入“有物理信息但不对外对齐”——V-JEPA2 无任何文本训练,回归 nRMSE 却低至 0.94,但无法做检索;(b)对比适配是“重组织”而非“增强”——检索 R@10 从个位数升至 8–21,回归 nRMSE 却从 1.85 恶化到 3.95(3B),并支持生成-表征缩放律在物理领域成立(7B 适配后全面优于 3B);(c)物理对齐需要远超通用域的优化量——2k 样本要 16 epochs 且 1000 步后仍未收敛,而通用嵌入训练 ≤2 epochs 即足够。这些发现为后续训练目标设计(如加入显式回归损失)提供了明确靶点。
实验结果
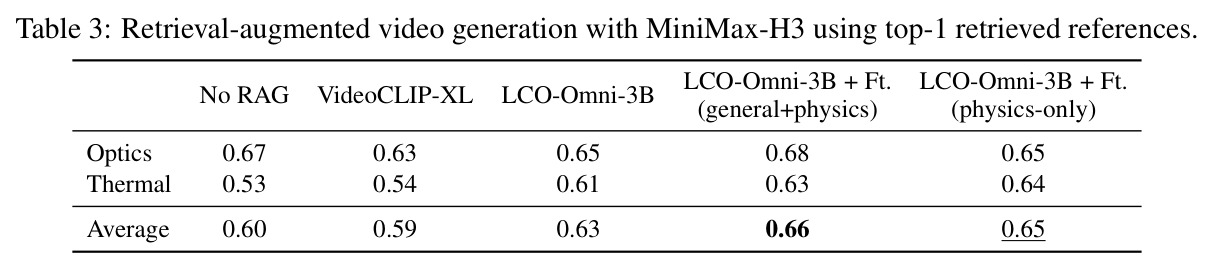
实验一(主基准):预训练嵌入模型物理检索极弱,Recall@10 最高不过个位数——最优 Qwen3-VL-8B 仅 Fluid 6.6、Dynamics 7.4;族内配对分类 46.8–53.1% 与随机无异,跨族 66.1–86.2% 则明显容易。但回归探针显示信息确实在:Video-CLIP-XL 宏平均 nRMSE 低至 0.81、V-JEPA2 为 0.94。MLLM 直接提示显著更强(族内 58.8–61.3%、跨族 90.9–92.0%),说明能力存在但未暴露于嵌入相似度。实验二(适配):LCO-3B 检索大幅跃升(Fluid 4.6→18.6、Dynamics 4.5→16.5),7B Dynamics 达 21.0、跨族配对升至 98.4%;但 3B 回归 nRMSE 从 1.85 恶化到 3.95,混 271k 通用数据也救不回,检索全程未收敛。实验三(RAG,Table 3):MiniMax-H3 无 RAG 平均 0.60,弱检索器 VideoCLIP-XL 反降至 0.59,LCO-3B 为 0.63,物理适配后达 0.66——检索器越懂物理,生成增益越大。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 物理文本-视频检索(Fluid 分支) | Recall@10 | 物理适配 LCO-Embedding-3B:18.6 | 预训练最优 Qwen3-VL-Embedding-8B:6.6 | 约 2.8 倍(+12.0 个百分点) |
| 物理文本-视频检索(Dynamics 分支) | Recall@10 | 物理适配 LCO-Embedding-7B:21.0 | 预训练最优 Qwen3-VL-Embedding-8B:7.4 | 约 2.8 倍(+13.6 个百分点) |
| 族内配对分类(细粒度物理判别) | Accuracy | 物理适配 LCO-7B:59.6% | 预训练嵌入最佳 53.1%(随机水平 50%) | +6.5 个百分点,逼近 MLLM 的 58.8–61.3% |
| 跨族配对分类 | Accuracy | 物理适配 LCO-7B:98.4% | 预训练嵌入最佳 86.2% | +12.2 个百分点 |
| 物理属性回归(10 任务宏平均) | nRMSE×100(越低越好) | 适配后 LCO-3B:3.95 | 未适配 LCO-3B:1.85;Video-CLIP-XL:0.81 | 退化 +2.10,暴露对齐-可恢复性权衡 |
| 检索增强视频生成(PhyGenBench 平均) | 物理保真评分 | LCO-3B+适配(general+physics):0.66 | 无 RAG:0.60;VideoCLIP-XL 检索:0.59 | +0.06,且弱检索器反而损害生成 |
局限与改进
作者承认的局限:物理适配后的检索 Recall@10 仍远低于通用域视频检索水平,且在分配的训练资源内未收敛,说明报告的只是当前条件下的结果而非上限;对比学习损害回归的机制只有两种候选解释(表征校准的副作用、对比目标本身不适合量化信息),没有实验定论。我自己的观察:第一,查询全部由模板确定性生成,语言多样性低,嵌入模型可能只是不适配这种句式而非真不懂物理,检索数字可能偏悲观;第二,回归目标只有 10 个家族各一个标量,且渲染通道(如位移幅值、速度着色)与目标量强相关,探针可能利用的是渲染编码线索而非物理理解;第三,配对分类是二选一设置,族内准确率 53–60% 的实际含义受负例采样方式影响;第四,RAG 实验只覆盖 PhyGenBench 的 Optics 与 Thermal 两个分支、top-1 检索、单一生成器 MiniMax-H3,外推性有限;第五,MLLM 对照只测了 Qwen3.5/3.6 家族,缺少更强闭源模型来校准“生成模型已具备该能力”这一论断的普适性。
独立分析的弱点
弱点一,模板化查询的双刃剑:确定性模板保证可复现,但同族查询句式高度统一,检索失败可能反映句式适配不足而非物理无知;改进方向是用 LLM 多样化改写查询,报告两版的性能差距。弱点二,对齐-回归权衡的机制悬而未决:是对比训练把已编码信息“挤出”线性子空间,还是对比目标本就不适合量化信息?改进方向:加显式回归辅助项 $\mathcal{L}=\mathcal{L}_{con}+\lambda\|\hat{y}-y\|^2$ 做对照,或将探针换成浅层 MLP,定位信息是被破坏还是变得非线性。弱点三,训练不收敛且 2k 样本需 16 epochs,物理对齐数据效率极低;改进方向:数据扩到百万级、课程学习(先跨族后族内)。弱点四,可视化通道与目标量耦合:固体视频几乎都渲染位移幅值,模型可能读色标而非力学;改进方向:多渲染通道消融量化泄漏。弱点五,下游验证太薄:单生成器、两分支、top-1 检索;改进方向:多生成器、top-k 重排、真实视频库,检验增益是否随检索器能力单调。
未来方向
作者指向的方向:把物理对齐与量化可恢复性作为联合评测标准来指导物理接地表征开发;探索对比学习之外的训练目标(作者类比为文本嵌入中优化语义相似度的表征回归损失),以同时保住检索与回归;把物理表征作为连接物理系统理解与生成式世界模型的桥梁,继续放大 RAG 路线的价值。基于本文成果可延伸的工作:第一,多任务物理嵌入训练——对比、回归、排序联合目标,直接优化“既对齐又可恢复”的帕累托前沿;第二,用回归探针反向评估生成视频的物理保真度——从生成视频的嵌入估计 $Re$、$E$ 等并与提示词对比,形成自动化物理评测闭环;第三,把基准扩展到真实实验视频(PIV 流场、材料试验、光学实验),检验仿真到真实的迁移能力;第四,融入音频与多模态组合查询,评测碰撞声、振动频率等跨模态物理线索;第五,沿生成-表征缩放律把物理适配推到更大骨干与数据规模,检验检索能否逼近通用域水平并最终收敛。
复现评估
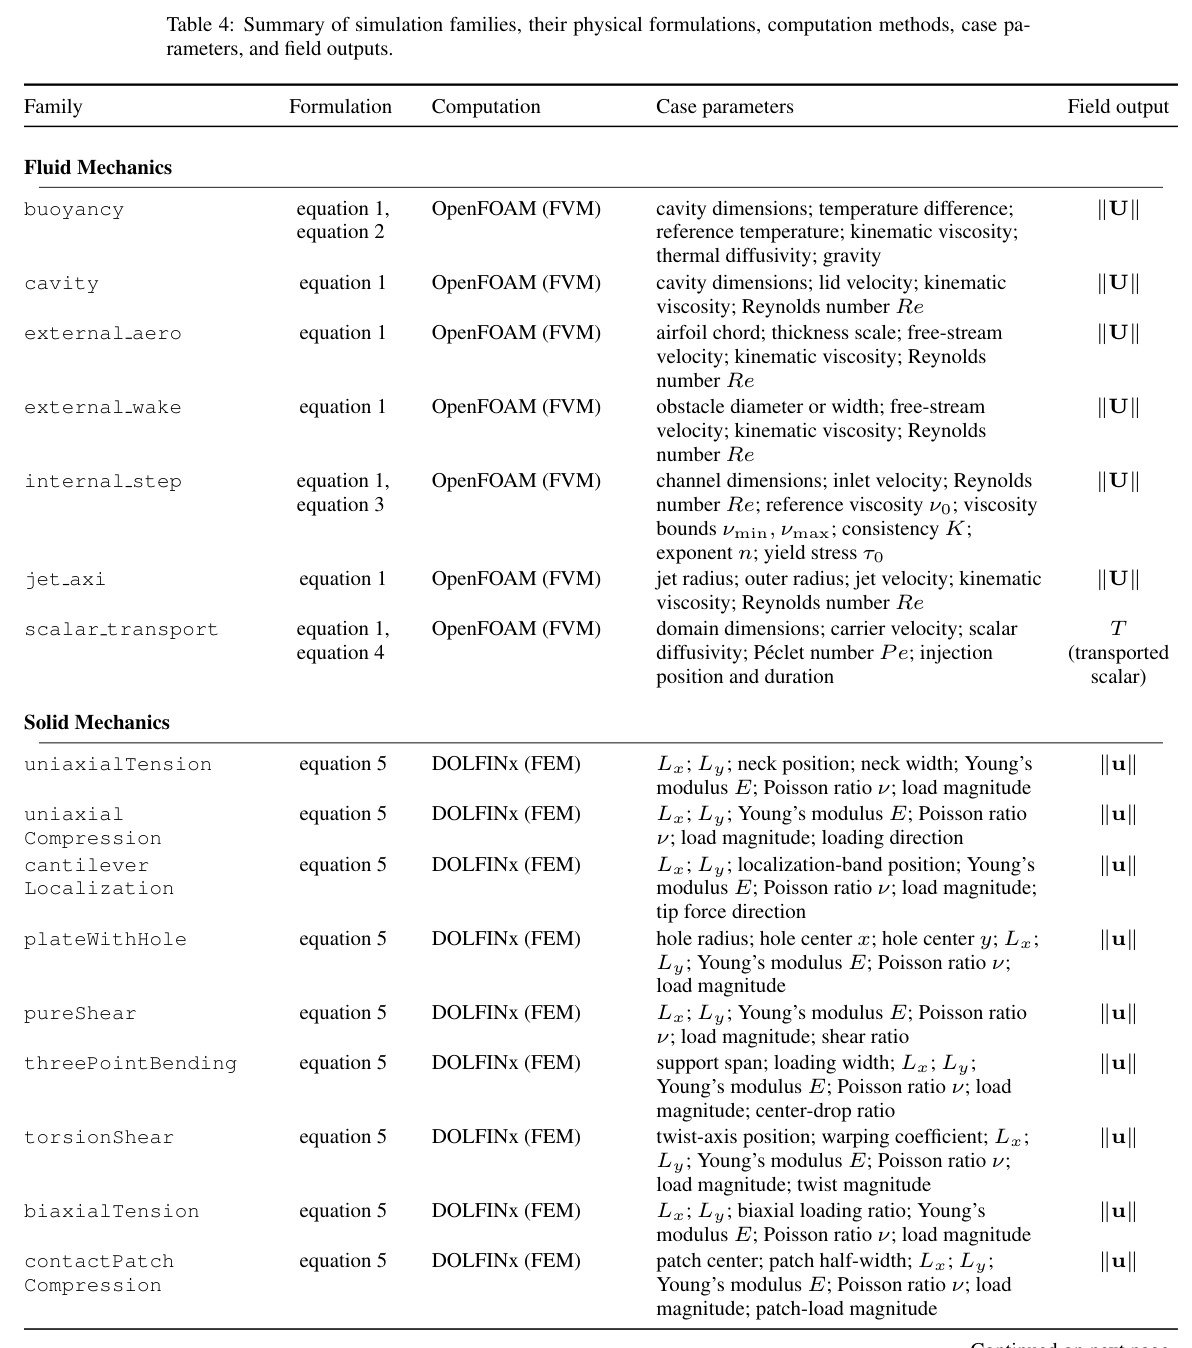
复现条件相当好。数据与代码双开源:数据集在 HuggingFace(World-Representation-Lab/world-embedding-benchmark),代码在 GitHub;依赖的仿真器全部开源(OpenFOAM、FEniCSx/DOLFINx、Project Chrono、HCIPy、Mitsuba 3、Meep、ParaView、FFmpeg),查询由模板确定性生成、硬负例固定随机种子采样,附录 B/C 给出全部 80 家族的公式、参数与场输出清单,理论上可完全重建数据。评测端算力门槛低:冻结嵌入+线性探针,单卡即可;配对分类只需相似度比较或 MLLM 推理。适配训练规模适中:8000 对物理数据,physics-only batch 64、最多 16 epochs,general batch 512、2 epochs,初始化自公开的 LCO-Embedding-Omni-3B/7B,单机多卡可承受;但检索未收敛,逼近最佳检索性能可能需要更多算力。RAG 部分依赖开放权重的 MiniMax-H3 与外部视频库。整体复现难度:中等偏低。
论文图表