世界模型的物理期末考试:视频生成物理一致性测量基准 World Models' Last Exam in Physics
40个受控任务直接测量视频世界模型的物理一致性,最优模型仅得57.76分
前置知识
视频世界模型
以视频生成为核心的世界模拟器:给定初始帧与条件(文本提示或动作),模型预测环境未来将如何演化。当被用于具身智能的预测与规划(乃至世界动作模型 WAM)时,生成结果不仅要视觉逼真,还必须遵循物理规律,否则模拟结论与据此制定的计划都不可信。
本文的全部动机就是检验这类模型是否真正理解物理。读者需先知道视频世界模型在具身智能中的定位,才能理解为什么物理一致性评测如此重要。
物理一致性
指生成视频中的事件满足相应物理定律的程度,如自由落体距离正比于时间平方、反射角等于入射角、纯滚动满足 $v = \omega R$。它区别于画面清晰度或时序连贯性:一段平滑流畅的视频仍可能违反动量守恒或能量关系。
物理一致性是本文基准要度量的核心对象,40 个任务的设计与评分公式全部围绕可观察的物理关系是否成立展开,不理解它就无法读懂评分协议。
测量式评测
通过直接测量视频中的物理量(轨迹、周期、光线角度、液位等)并与物理定律推导的判据比较来打分,而非依赖视觉语言模型的主观判断或与参考视频的相似度。其优势是可解释、能定位具体违反了哪条定律,且无需参考视频。
这是本文与 Physics-IQ(参考相似度)和 VLM 判断类基准的本质区别。理解这一范式,才能明白其尺度抵消任务设计与门控评分公式的用意。
时序一致性门控
先用 VLM(本文用 Qwen3.6-27B)为视频打一致性分 $C \in [0,100]$,评估物体是否持续存在、画面是否连续可测。只有 $C \geq 80$ 的视频,其物理分 $P$ 才以 0.85 的权重计入综合分,否则综合分只剩 $0.15C$。
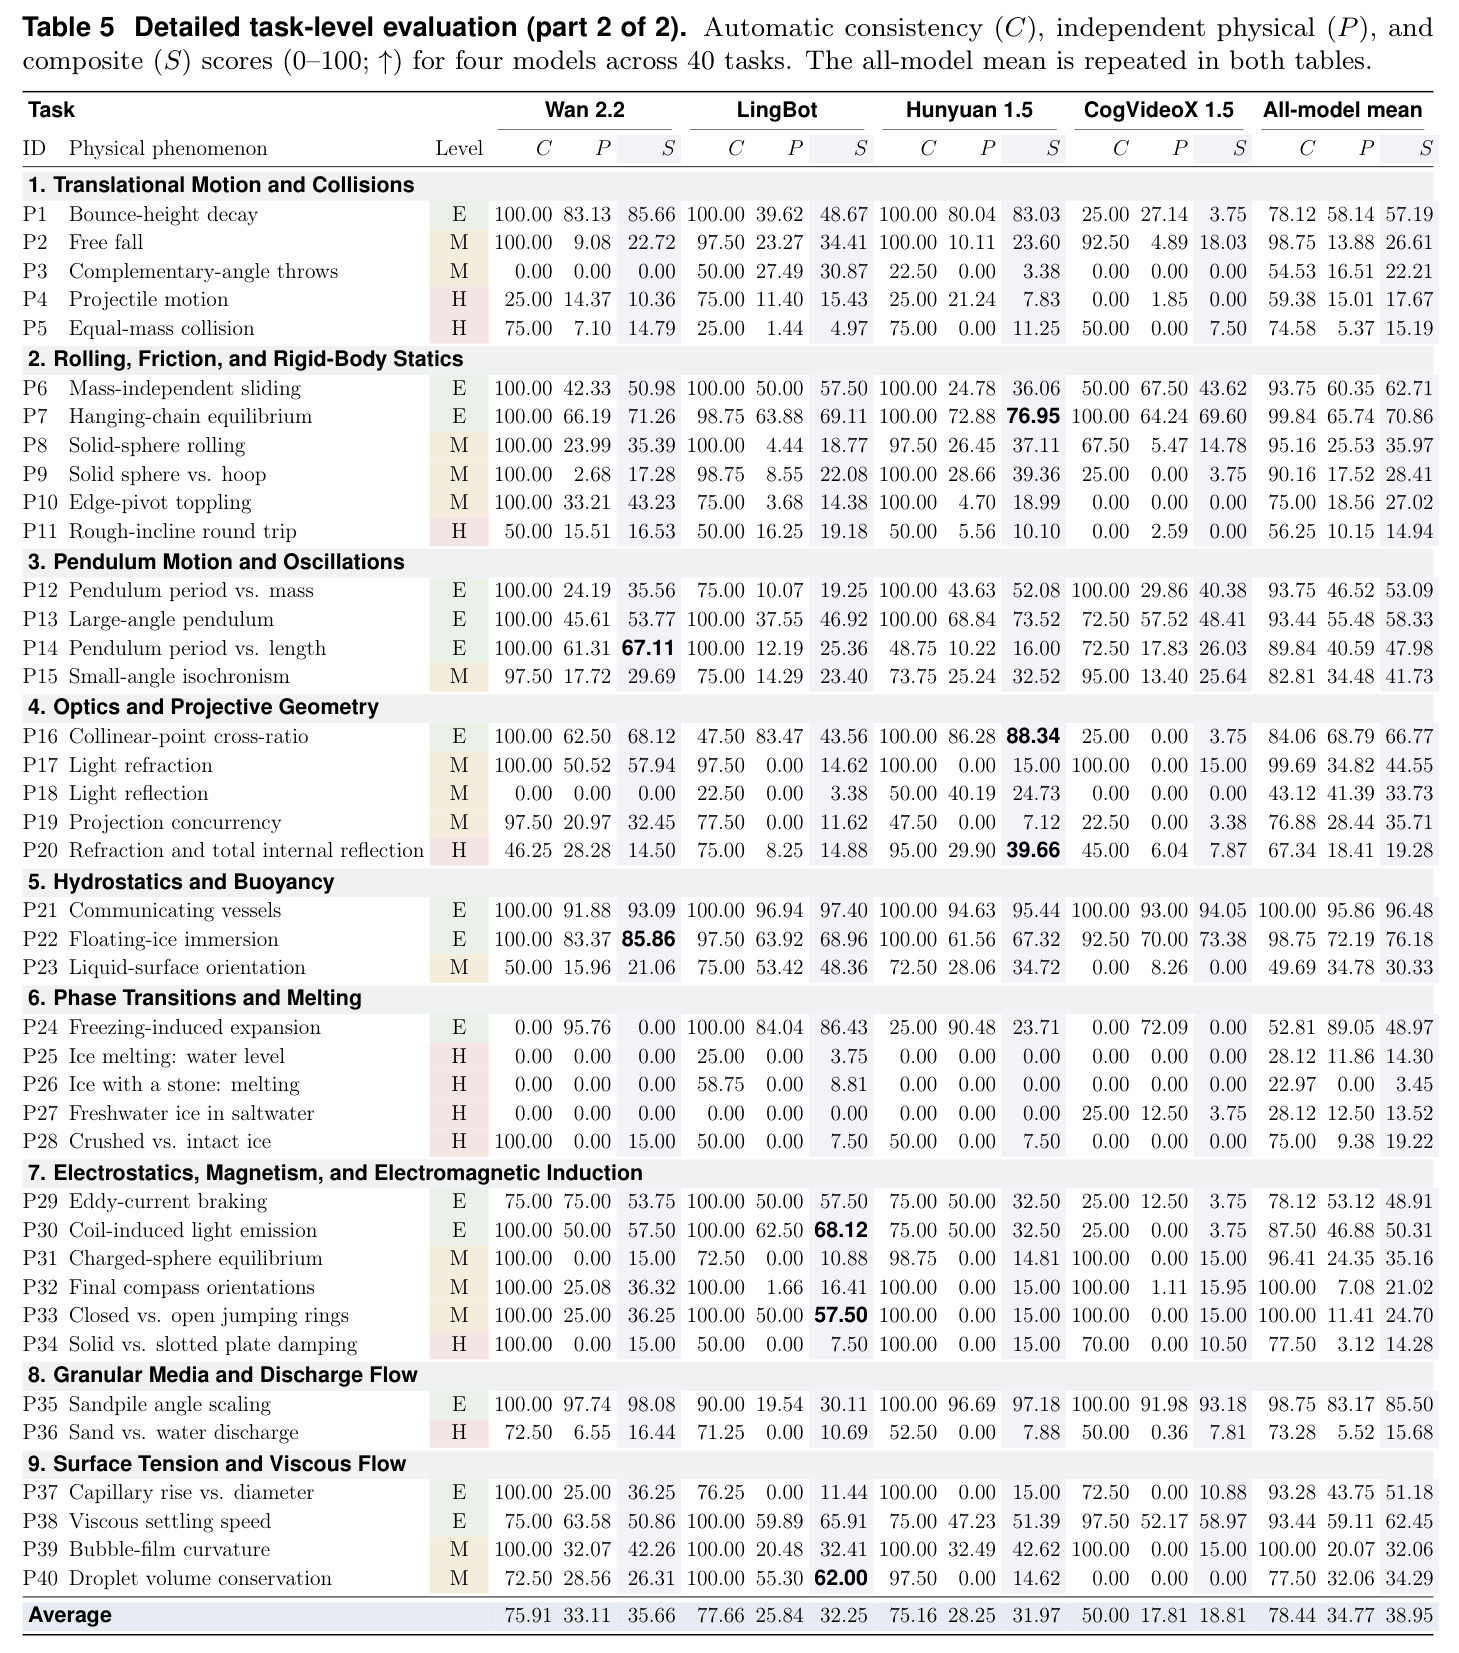
门控机制决定了任务没做出来与做了但物理错如何区分,是解读主结果表(如 P26 含石冰块八模型物理分全为零)的关键。
尺度抵消比值
利用同一视频内共享的像素尺度与统一时间采样率,把待检验的物理关系写成比值形式,使未知的长度/时间标定在比值中自动消去,如周期比 $T_1/T_2$、滚动比 $v/(\omega R)$、抛体高度射程比 $H/R$,从而无需绝对标定即可检验定律。
这是 40 个任务的核心设计原理,解释了为什么只用像素级测量(无需真实米尺或时钟标定)就能检验物理定律是否被遵守。
点跟踪与分割工具链
CoTracker3 跟踪视频中指定点的长时程轨迹,SAM 2 提供可提示的视频物体分割掩码。二者是本文测量管线的感知基座,配合几何拟合(直线/轮廓拟合)、ROI 光度学与事件检测,从生成视频中提取可观测量。
复现或扩展该基准必须依赖这条开源感知工具链,它们决定了哪些物理量可被可靠测量,也是测量误差与模型误差边界的来源。
研究动机
视频生成模型日益被用作世界模型与世界动作模型(WAM)的基础,服务具身智能中的预测与规划,但它们经常生成视觉上逼真、物理上却自相矛盾的画面,例如自由落体不遵循匀加速规律、反射光线角度错误、碰撞中动量凭空产生或消失。现有评测手段有三大缺陷:一是依赖视觉语言模型(VLM)判断,而 VLM 自身的物理推理能力不足——论文引用 PQSG 的报告,GPT-5.5 在 FinePhyEval 物理类问题上准确率仅 64.6%,而物体级问题可达 88.4%,说明其物理判断不可靠;二是基于参考视频的方法(如 Physics-IQ)度量生成结果与真实录像的相似度,得分对参考质量和视频对齐高度敏感,且无法直接指出违反了哪条物理定律;三是直接物理测试(如 Principia)虽然直接度量运动量,但几乎只覆盖力学领域。因此,学界缺乏一个跨物理领域、不依赖参考视频、又能给出可解释量化证据的视频物理一致性评测框架。
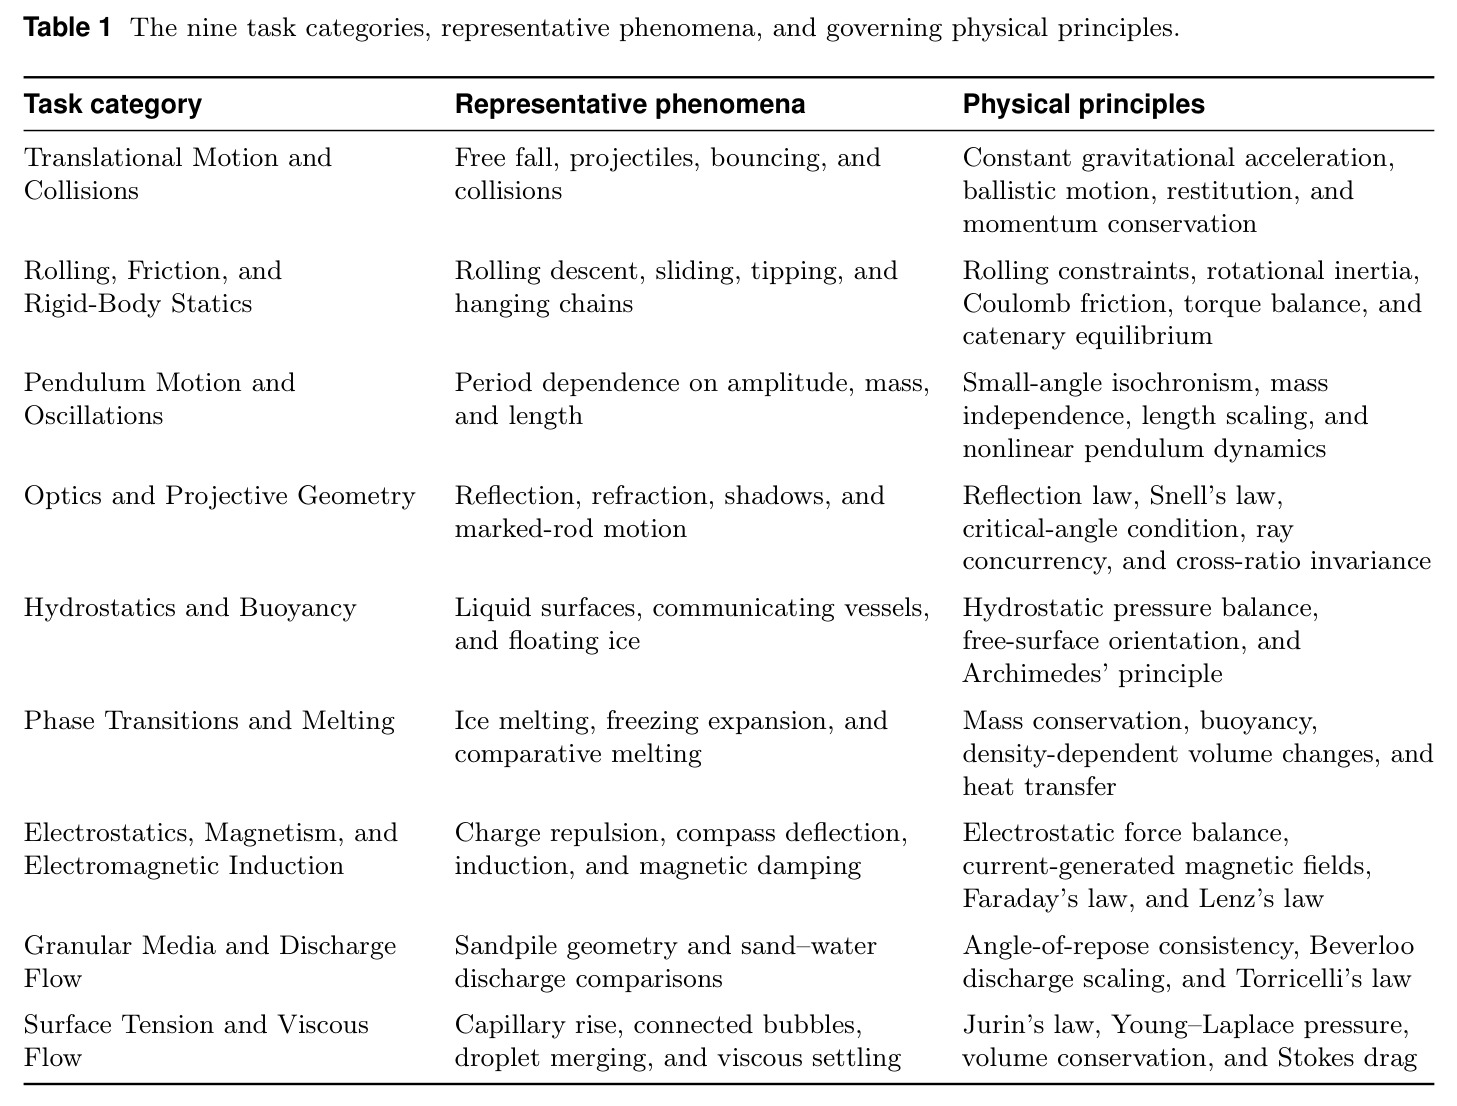
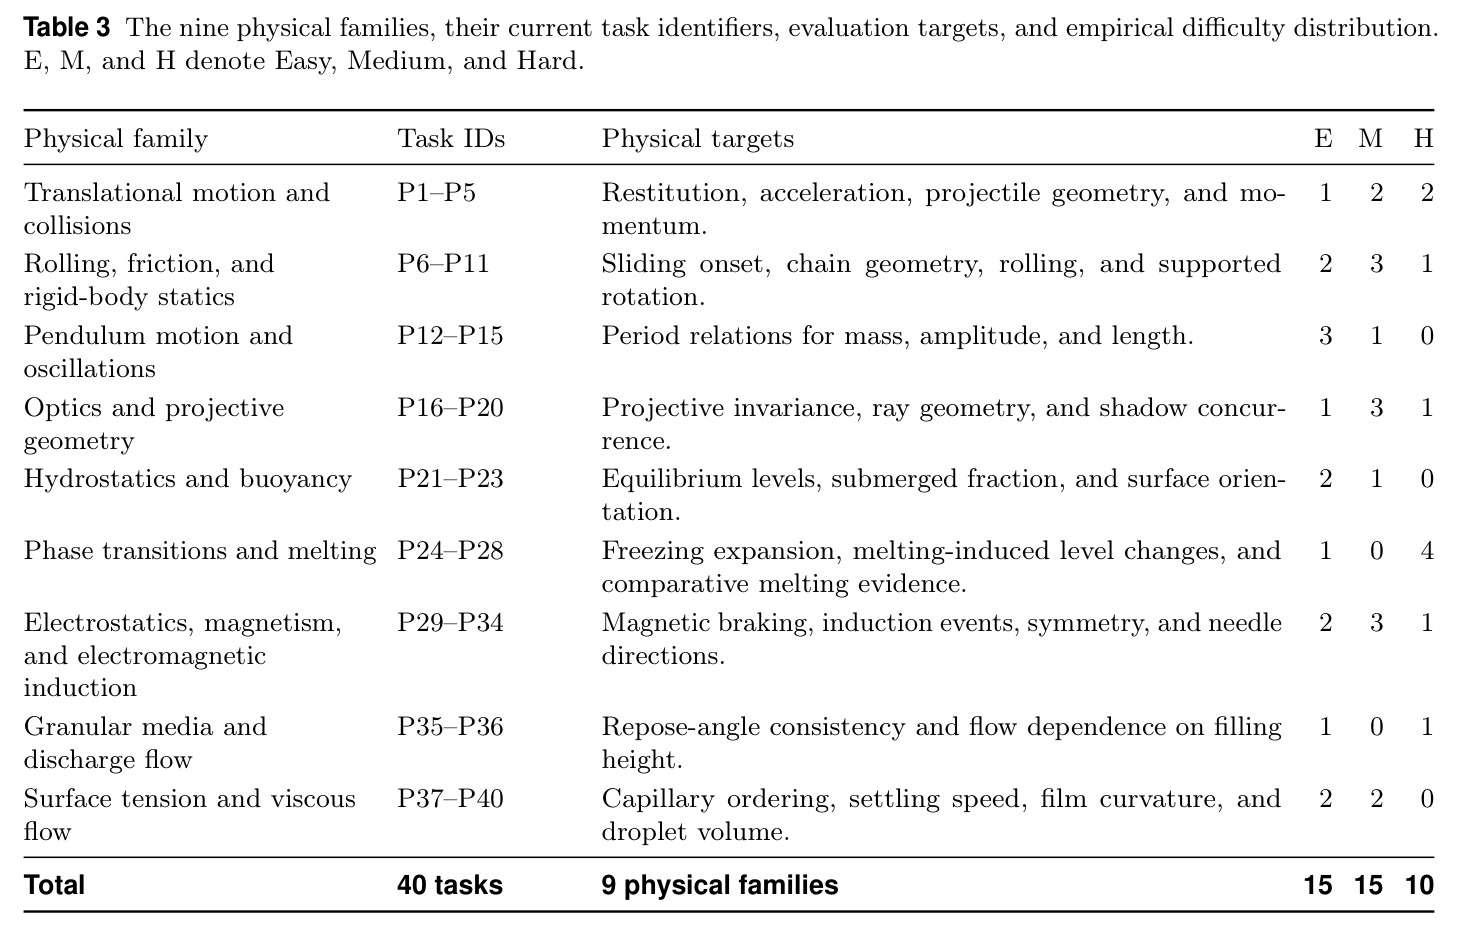
本文的目标是本文的目标是构建一个测量式(measurement-based)基准——World Models' Last Exam in Physics,系统评测视频世界模型能否再现环境在物理约束下的演化。具体包括三点:其一,设计 40 个受控任务,覆盖平动与碰撞、滚动摩擦与刚体静力学、单摆振荡、光学与射影几何、静水与浮力、相变与融化、静电磁与电磁感应、颗粒介质与泄流、表面张力与黏性流共九大类物理现象;其二,为每个任务定义可观察、可度量的物理判据,评测器结合任务可观察性筛选与任务专属定量物理测量,无需参考视频或模拟器真值即可打分,并显式区分测量不到与物理不对两种情形;其三,用该基准评测 8 个图生视频模型(每个模型×任务生成 4 个样本,共 1,280 个视频),诊断模型在哪些物理关系上可靠、在哪里系统性失败,为追踪物理一致性进展提供可解释的标尺。
与已有工作不同的是,本文的独特切入在于把受控生成条件与可测量的物理判据配对。作者不是问视频像不像真实录像,也不是让 VLM 直接评价物理对不对,而是为每个任务设计尺度抵消型(scale-canceling)的可观察关系检验:利用同一视频中共享的像素尺度和时间采样率,把未知标定因素在比值中消去,例如斜抛运动的最大高度与射程之比 $H/R$ 应等于 $1/4$、两单摆周期比 $T_1/T_2$ 应为 1、纯滚动中 $v/(\omega R)$ 应为 1,从而无需绝对长度或时间标定即可检验物理定律。另一独特点是显式区分测量不到与物理不对:先用一致性门控判定视频是否可测,再独立尝试物理测量并保留全部中间证据,门控只决定物理分是否计入综合分而不篡改测量结果。这使评测既可解释又可诊断,填补了 VLM 判断法与参考视频法之间的方法论空白,并把直接物理测试从力学扩展到九大领域。
核心方法
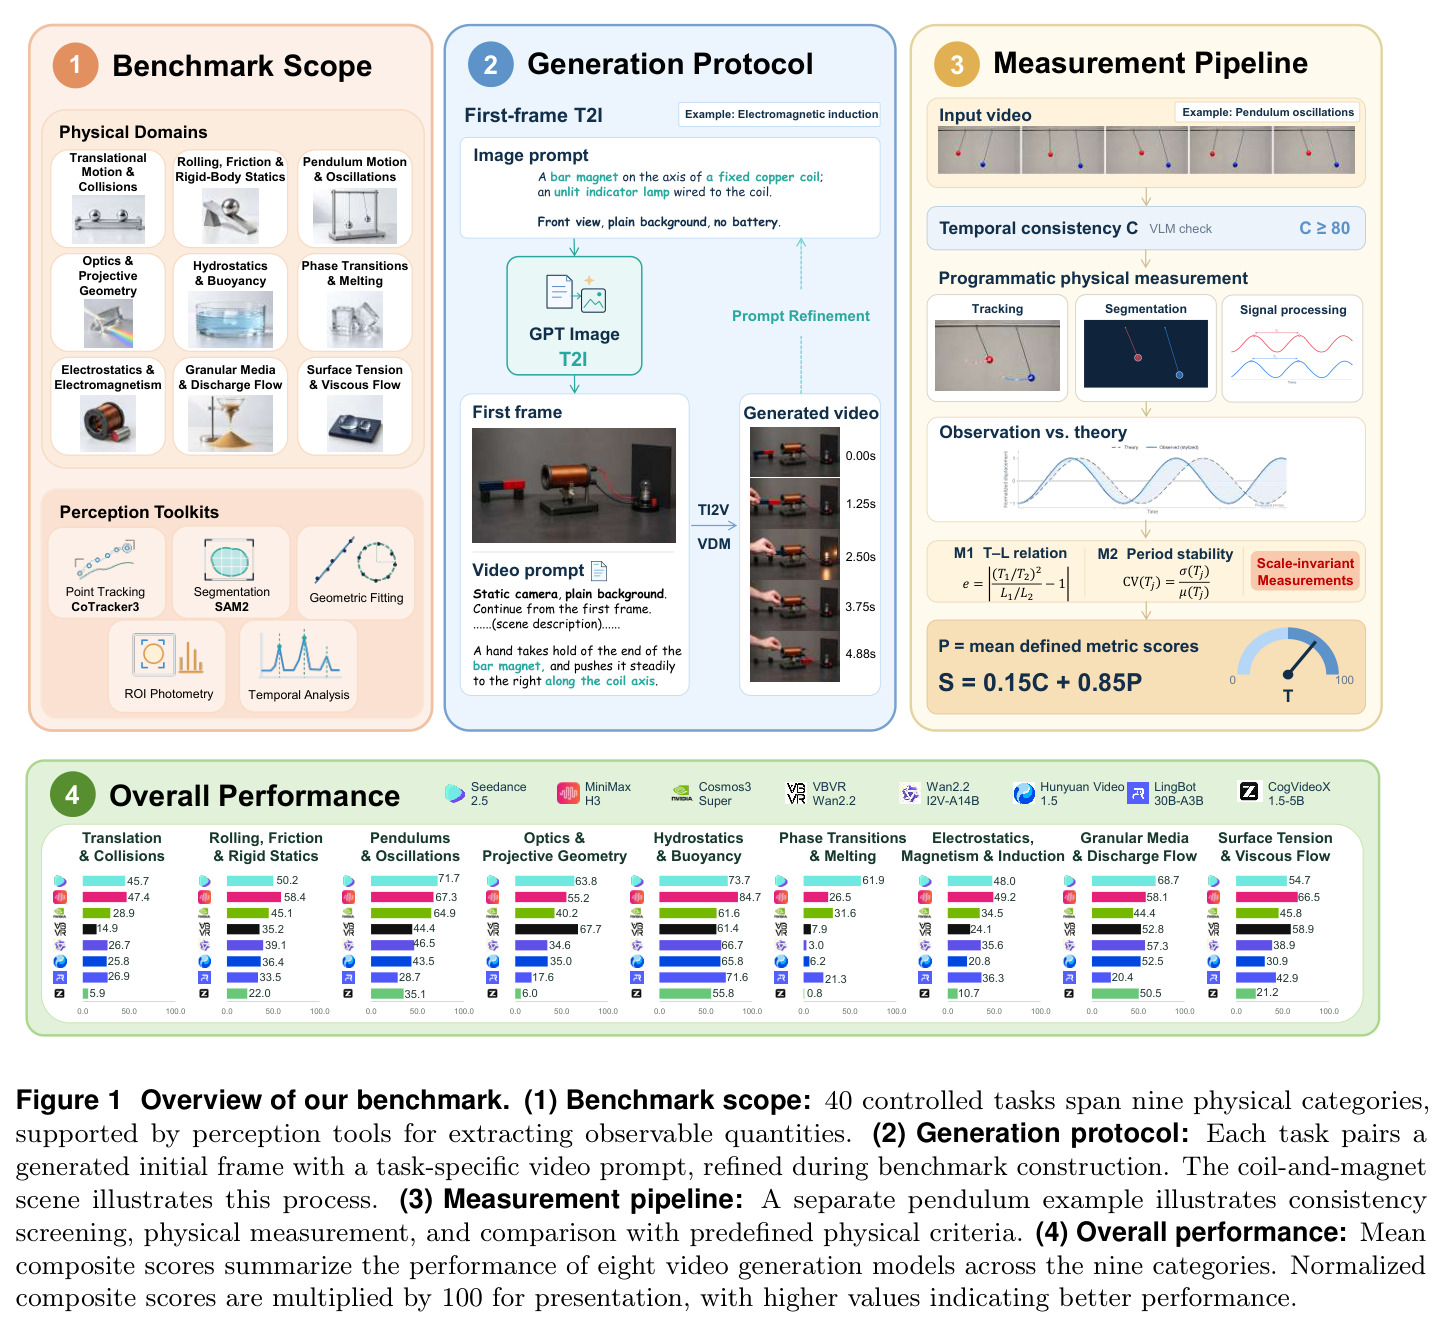
方法分三层:任务定义、标准化生成、物理评测。每个任务表示为 $T_k = (A_k, I_{0,k}, p_k, R_k)$:$A_k$ 是物理假设(材料、初始条件、观察几何),$(I_{0,k}, p_k)$ 是首帧图像与视频提示词,$R_k$ 是待检验的可观察物理判据;被测模型生成 $V_{k,r} = G_\theta(I_{0,k}, p_k)$。评测时先用 Qwen3.6-27B 打出时序一致性分 $C(V) \in [0,100]$,考察物体持续存在与视觉连续性;随后无论门控结果如何都尝试任务专属测量:提取 $z_k = E_k(V)$,计算残差 $r_{k,j} = f_{k,j}(z_k; A_k)$ 并映射为一致度 $q_{k,j} = \phi_{k,j}(r_{k,j}) \in [0,1]$,物理分 $P_k = 100 F_k(q_k)$。综合分 $S = 0.15C + 0.85\tilde{P}$,仅当 $C \geq 80$ 且有物理分时 $\tilde{P} = P_k$,否则为零。直觉:视频先要可看(一致性筛选),更要物理对(占 85% 权重)——自由落体 P2 全部视频过门控但平均综合分仅 26.61,说明两者是两回事。
核心创新是把物理预测改写为可观察关系,并设计三类尺度抵消检验。空间关系类:检验几何量之间的比例,如斜抛运动以 45° 发射并回到原高度时,$r_{spatial} = \frac{H/R}{1/4} - 1$ 应近零,初速度与重力加速度在比值中消去,$H$、$R$ 可直接以像素度量;时间关系类:检验周期或事件时序之比,如两个等长小角单摆改变摆锤质量后周期应不变,$r_{temporal} = \frac{T_1}{T_2} - 1$,共享时间轴使帧到秒的换算消去;时空耦合类:检验运动与几何的一致,如纯滚动要求 $r_{spatiotemporal} = \frac{v}{\omega R} - 1 \approx 0$,$v$ 以像素/帧、$\omega$ 以弧度/帧度量。与已有方法的本质区别在于:VLM 判断法把物理推理外包给不可靠的评测模型(GPT-5.5 在 FinePhyEval 物理题上仅 64.6% 准确率),参考视频法依赖录像质量,而本文的分数直接来自物理量测量,误差经 $s(e; a) = \frac{1}{1 + |e|/a}$ 映射为分数,每一步证据可追溯。
方法步骤详情
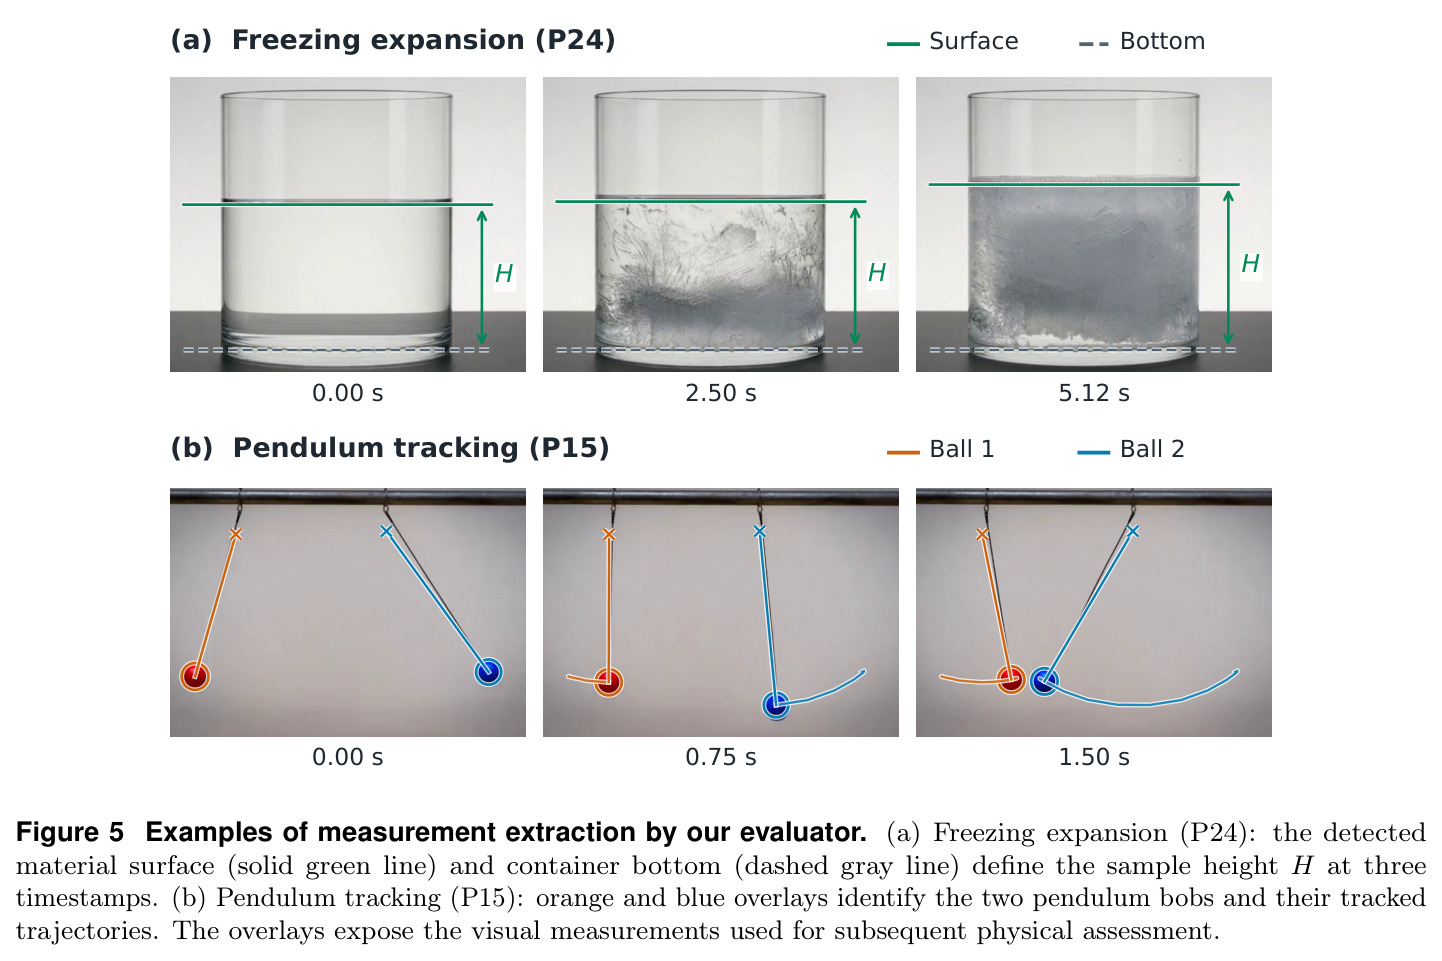
流程五步。一、任务设计:构建 40 个任务归入九类(自由落体、悬挂链平衡、光反射、连通器、含石冰块融化、沙堆休止角等),明确控制定律与假设,优先设计共享未知量可抵消的匹配对照场景,并按跨模型均分划分 E/M/H 难度组(15/15/10 任务)。二、首帧构建:把实验要求译成图像提示词,用 GPT-Image-2.5 生成候选首帧以确立初始构型并保证被测量可见,再配规定实验如何展开、哪些属性固定、观察区间多长的视频提示词,经试点生成—人工检查—修订的迭代闭环精化。三、视频生成:通过统一接口向 8 个模型(分辨率 832×480 至 1344×768、帧数 81 至 129)提交相同图文对,每对生成 4 个样本、种子固定 42–45,共 1,280 个视频。四、一致性筛选:Qwen3.6-27B 按任务专属提示输出 $C \in [0,100]$,$C < 80$ 者物理分不计入。五、测量打分:用 CoTracker3 点跟踪、SAM2 分割、几何拟合、ROI 光度学与事件检测提取轨迹、周期、光线角度、液位等,按 $s(e;a)=1/(1+|e|/a)$ 映射误差(单摆长度任务 $a=0.20$),指标平均成 $P_k$,最终按 $S = 0.15C + 0.85\tilde{P}$ 汇总。
技术新颖性
技术新颖性体现在四点。其一,测量式评测范式:在无需参考视频、无需真实标定数据、无需模拟器真值的条件下,通过任务内比值检验物理关系,与 Physics-IQ(参考相似度)、Principia(仅力学直接测试)形成互补,把直接物理测试从力学扩展到光学、流体、热学、电磁、表面张力九大领域。其二,门控式综合分:物理测量独立于门控进行、中间证据全部保留,$C \geq 80$ 只决定 85% 权重的物理分是否计入,显式区分任务没做出来与做出来了但物理错——例如自由落体 P2 全部视频通过门控但平均综合分仅 26.61,量化暴露时序连贯与物理正确之间的鸿沟。其三,评测器有效性有独立验证:用已知物理关系的 2D 合成动画(480 个参考视频,每任务 12 个)旁路门控测试测量模块,Easy/Medium/Hard 平均物理分达 97.93/96.64/98.25。其四,与人类判断的对比有严格量化协议:320 个视频、10 名标注者、917 对可比对,同时报告排序一致率与成对确认一致率双指标,并以人类间一致率作为天花板参照。
实验结果
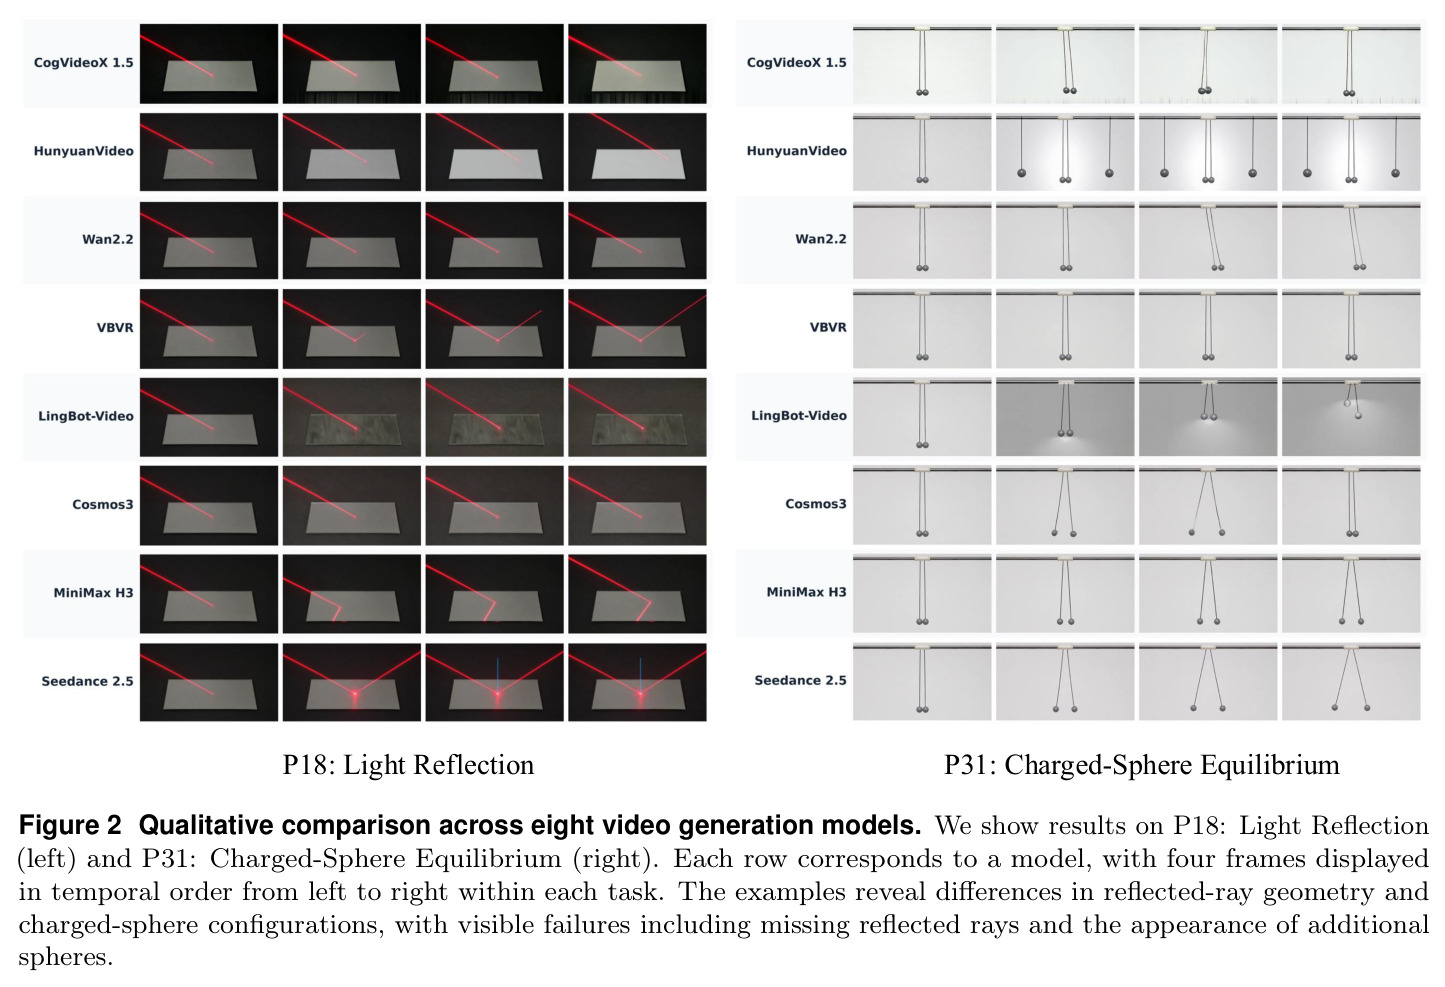
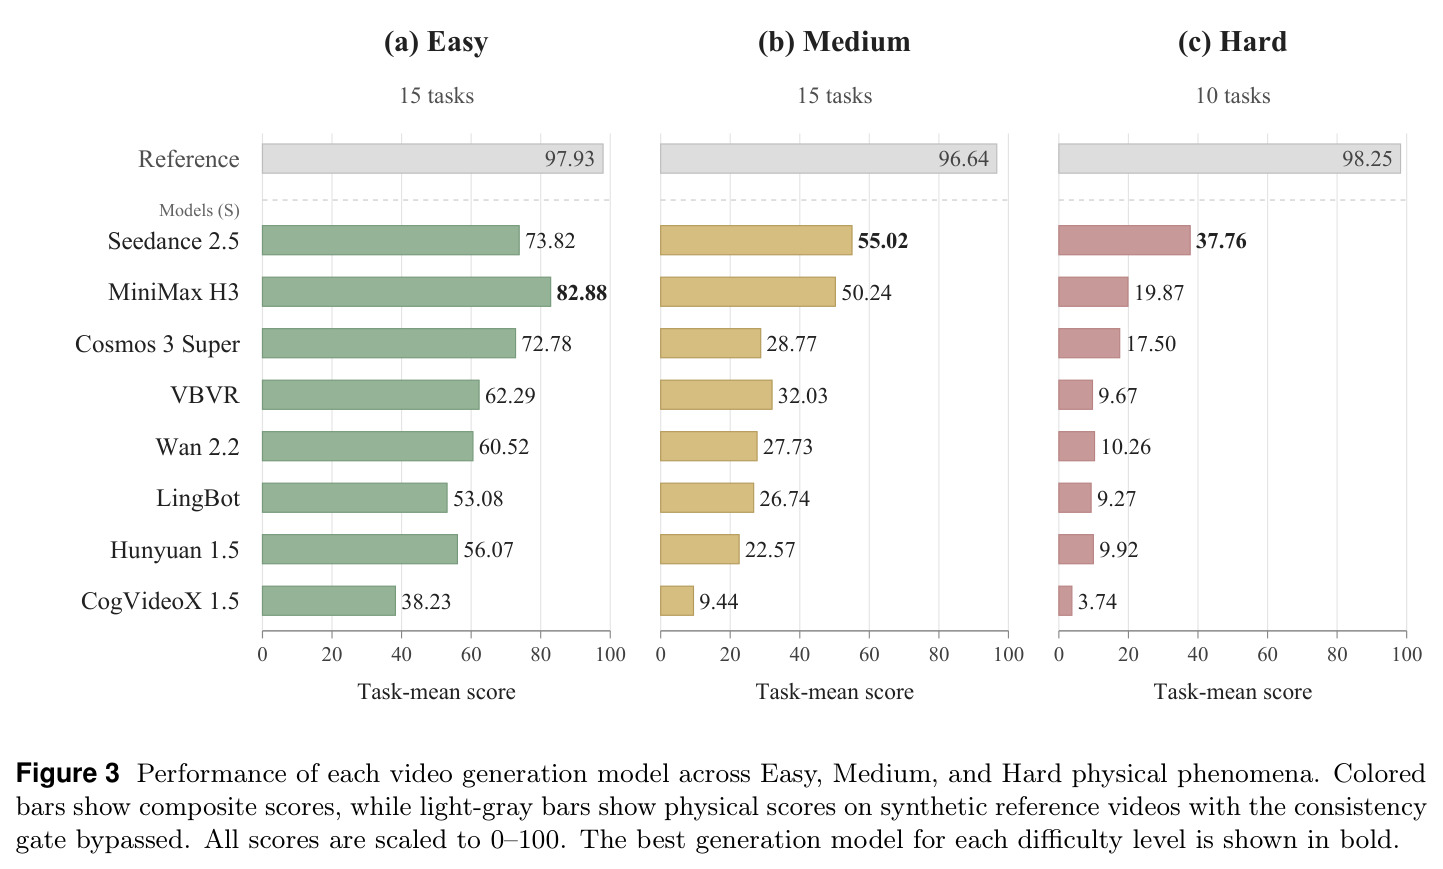
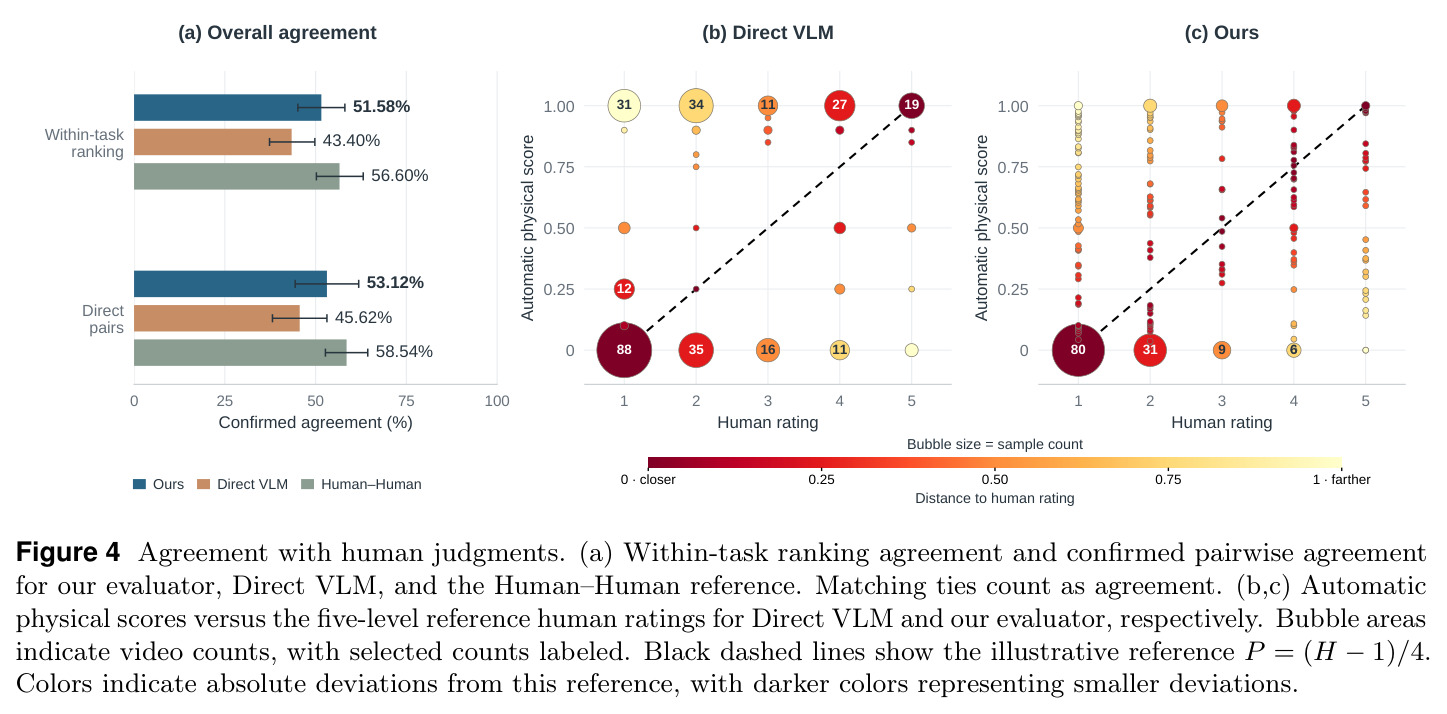
主实验评测 8 个模型共 1,280 个视频。综合分:Seedance 2.5 以 57.76 居首,MiniMax H3 54.89,Cosmos 3 Super 42.46,VBVR 37.79,Wan2.2 35.66,LingBot 32.25,Hunyuan 31.97,CogVideoX1.5-5B 仅 18.81,最强者距满分仍差 42 分。任务级发现极具诊断价值:含石冰块融化 P26 全员失败,模型均分 3.45、最高 15.00,八模型物理分全为零;光反射 P18 两极分化,Seedance 96.15、VBVR 95.75,其余至多 49.82;带电球平衡 P31 上 Seedance 98.34、MiniMax 97.24,其余至多 15.00;连通器 P21 全员优秀(93.09–99.01)。难度分析:Easy 任务过门控比例 89.4%,Hard 仅 56.9%;MiniMax 在 Easy 组领先(82.88),Seedance 在 Hard 组以 37.76 领先 MiniMax 的 19.87。合成参考验证:480 个动画视频旁路门控后 Easy/Medium/Hard 物理分 97.93/96.64/98.25、总体 97.53/100,证明低分来自生成模型而非测量模块。人类一致性:917 对可比对上排序一致率 51.58%,比 Direct VLM 基线 43.40% 高 8.18 个百分点,距人类间 56.60% 仅差 5.02;160 对成对比较确认一致 53.12%,比 Direct VLM 的 45.62% 高 7.50 个百分点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 40 任务整体物理一致性评测 | 综合评分 S = 0.15C + 0.85P(0-100) | 最优模型 Seedance 2.5 得 57.76 | 最弱模型 CogVideoX1.5-5B 得 18.81,其余模型在 31.97–54.89 之间 | 榜首较榜尾高 38.95 分,但距满分仍差 42.24 分,暴露整体物理一致性缺口 |
| 评测器与人类判断的排序一致性(917 对) | Within-task ranking agreement(%) | 51.58%(473 对一致) | Direct VLM 基线 43.40%(人类间参考 56.60%) | 较 Direct VLM 提升 8.18 个百分点,距人类间上限仅 5.02 个百分点 |
| 评测器与人类判断的成对比较一致性(160 对) | Confirmed pairwise agreement(%) | 53.12%(85 对确认一致) | Direct VLM 45.62%(人类间参考 58.54%) | 较 Direct VLM 提升 7.50 个百分点,距人类间上限 5.42 个百分点 |
| 合成参考视频测量有效性验证(480 个已知物理关系的动画) | 平均物理分(旁路一致性门控,0-100) | 总体 97.53,Easy/Medium/Hard 分别 97.93/96.64/98.25 | 被测生成模型 Hard 组任务均分最高仅 37.76(Seedance) | 接近满分,证明低分来自生成模型而非测量模块失效 |
| Hard 难度组(10 个任务) | 任务均综合分 | Seedance 2.5 得 37.76(组内最高) | MiniMax H3 为 19.87,其余模型低于 18 | 较次优高 17.89 分,显示高难物理场景上的鲁棒性优势 |
局限与改进
作者承认的局限:当前评测受任务相关证据的可见性与提取可靠性约束;通过门控既不证明物理正确,也不保证所需量都能恢复;未测量的物理属性保持未验证状态,评测只能确认观察到的关系成立。我自己的观察:其一,$C \geq 80$ 的门控阈值是经验设定,且筛选本身依赖 Qwen3.6-27B 的 VLM 判断,在筛选环节重新引入了对 VLM 的依赖;其二,每个任务每模型仅 4 个样本、种子固定 42–45,方差估计能力有限,且不同模型分辨率与帧数差异巨大(832×480/81 帧 vs 1344×768/124 帧),时长与清晰度差异可能系统性影响测量成功率,构成不公平比较隐患;其三,任务均为单一物理关系的简化场景,与真实世界的多物体耦合、遮挡、复杂光照差距大,结论对生产环境的迁移性存疑;其四,部分任务使用二元方向检验或事件证据分(如 P31 除头部两模型外恰好都拿 15.00),分数粒度较粗,难以细粒度区分失败程度。
独立分析的弱点
独立分析三点弱点。第一,测量器与被测模型的误差可能混淆:提取器 $E_k$ 依赖分割、跟踪与几何拟合,若模型生成罕见的视觉风格(异常配色、模糊边界),提取失败会被记为物理错误——虽然中间证据被保留供诊断,但自动流程无法自我纠错。改进方向:对低分视频抽样人工复核,或训练领域专属的鲁棒提取器并按提取置信度加权。第二,首帧与提示词全部由 GPT-Image-2.5 生成且每个任务仅一套固定图文对,模型对特定画面风格的偏好可能扭曲排名,例如某模型恰好擅长该首帧构图。改进方向:每任务生成多套风格化首帧与提示词变体,报告跨变体方差以剥离输入偏好。第三,门控与测量对时间流速的假设脆弱:视频模型可能改变时间进度(慢放或快放),周期比等时间检验虽能抵消全局换算,但单一视频内的变速会破坏共享时间轴假设,且不同模型帧数不同(81–129 帧)、观察区间不一致。改进方向:在提示词中加入经过验证的时钟标记物作为内部时间基准,或按物理时长归一化后再比较。此外,纯黑背景等刻意简化的观察几何虽利于测量,但也让模型更容易走捷径。
未来方向
作者提出的方向:扩展任务覆盖面,并在更复杂场景中提升测量鲁棒性。基于本文成果可延伸的方向:其一,把测量式评分用作后训练奖励信号——类似 NewtonRewards 从可测代理量构造物理奖励,本文 40 个任务的残差 $r_{k,j}$ 天然是稠密奖励的候选,可用于强化学习微调视频模型的物理一致性;其二,从静态单关系检验扩展到多事件组合与长时程一致性,例如碰撞后滚动、融化后再冻结的级联场景,考察世界模型多步规划的可靠性;其三,服务世界动作模型(WAM)评测:在生成视频上叠加动作条件,检验动作-物理后果链条的因果一致性;其四,引入三维标定与多视角首帧,使空间检验摆脱对侧视几何的强依赖,覆盖透视畸变更真实的场景;其五,将人类评估协议扩展为公开排行榜,积累跨版本模型的物理一致性纵向数据;其六,测量提取器可结合可微物理引擎做软约束拟合,输出连续置信度以替代门控二元决策,缓解测量不到与物理不对的边界模糊问题。
复现评估
复现评估:论文给出项目主页(https://lab.einsia.ai/phys-last-exam)与联系邮箱,但正文未明确说明代码与 1,280 个生成视频是否全部开源,复现难度中等偏高。可行路径:40 个任务的图像/视频提示词、物理判据与评分映射在论文中描述较充分(如 $s(e;a)=1/(1+|e|/a)$、单摆长度任务 $a=0.20$),可重新实现;感知工具链全部开源(CoTracker3、SAM2)。主要门槛有三:一是合成参考动画的生成工具未在正文给出;二是 Qwen3.6-27B 的一致性筛选提示词与阈值需自行调校;三是 1,280 个视频的生成费用不菲,Seedance、MiniMax 等需商业 API 访问。算力方面,评测侧只需推理级 GPU(跟踪与分割),无需训练。建议先复现 3–4 个有合成参考验证背书的任务(如单摆、连通器)校准提取器,再扩展全量;人类评估部分(10 名标注者、320 个视频)在资源有限时可直接引用作者报告的 51.58%/53.12% 作参照基准。
论文图表