T3lescope:从图像进行任意分辨率高保真生成式表面重建 T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
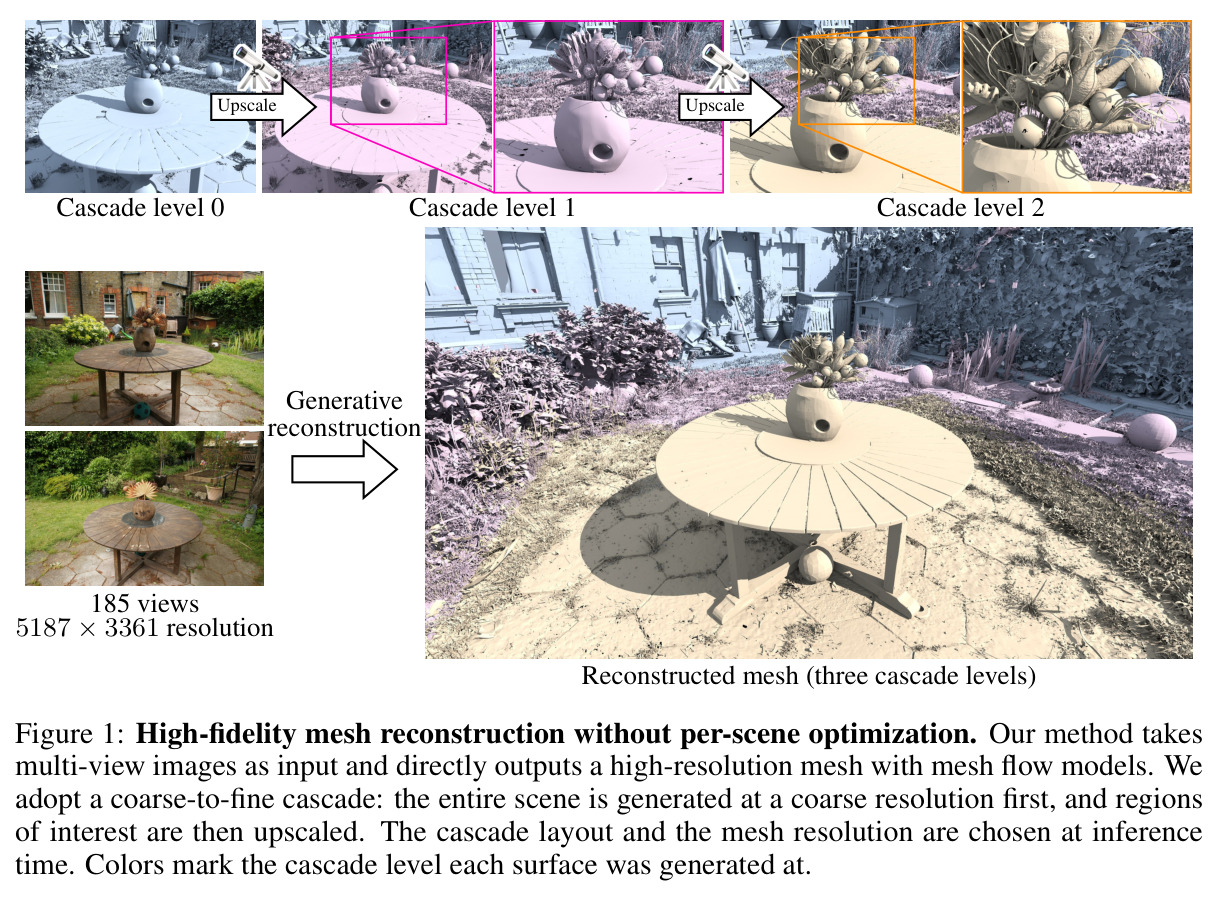
单一固定分辨率3D生成器经推理时由粗到细级联,免逐场景优化重建任意尺度高保真网格
前置知识
流匹配(Flow Matching)
一类生成模型训练范式:把数据 $x_0$ 与噪声 $\epsilon$ 用线性插值路径 $x_t = (1-t)x_0 + \sigma_t \epsilon$ 连接,训练速度场 $v_\theta$ 拟合路径的时间导数,采样时从 $t=1$ 的纯噪声用 Euler 步积分回 $t=0$。相比 DDPM 训练更稳定、路径更直,TRELLIS.2 的 SS 与 mesh 两个去噪器都以条件流匹配训练。
本文的级联细化本质是把父级几何加噪到中间时刻 $t_s$ 后继续积分(Equation 1),完全建立在流匹配的连续时间框架上,不懂它就无法理解细化步的采样 schedule。
稀疏体素结构化生成(TRELLIS.2 两阶段)
TRELLIS.2 把 3D 生成拆成两步:SS 阶段在 $R^3$($R=64$)稀疏体素网格上生成表面体素的占据结构,mesh 阶段再在活跃体素上生成形状潜码,由形状 VAE 解码成 $512^3$ 分辨率三角网格;两阶段均为以 DINOv3 图像特征加相机内外参为条件的 Diffusion Transformer。
T3lescope 直接以 TRELLIS.2 为骨干(mesh 流还从 1.3B 剪枝到 655M 参数),级联中父级解码器上采样到 $2R$ 再裁出子 cell 的 $R^3$ 体素块等关键操作全部依赖这套表示。
SDEdit 与父级初始化
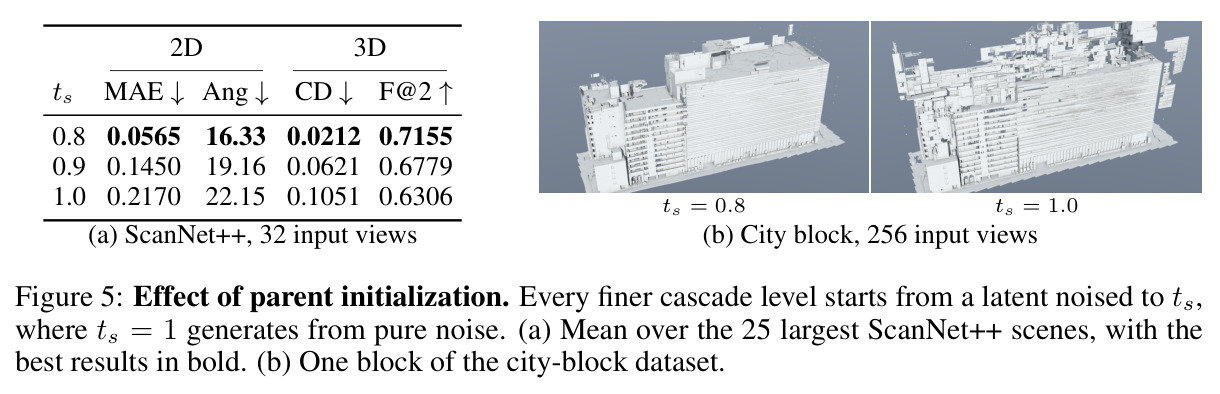
SDEdit 是图像编辑的经典技巧:把参考图加噪到中间时刻 $t$(保留部分结构),再从那里去噪,得到既忠实参考又更精细的结果;$t$ 越大越自由、越小越保守。本文用它连接级联层级:细层从父层几何加噪到 $t_s=0.8$ 再去噪,兼顾继承全局结构与恢复新细节。
$t_s$ 是全方法最重要的单一超参:消融显示它把大场景 32 视图的 Chamfer 距离从 0.1051 降到 0.0212(降 80%),是理解『继承全局结构 vs 依赖局部图像』权衡的核心。
MultiDiffusion 与重叠 cell 融合
让多个扩散去噪器共享一个全局潜码的融合框架:把场景切成重叠 50%(stride 为半边长)的窗口 cell,每个去噪步各 cell 独立预测,再用中心高、边界趋零的可分离 Hann 窗加权平均写回共享潜网格,保证相邻窗口平滑过渡。GenRecon 用它把物体级生成器扩展到场景级。
T3lescope 每一层都靠 MultiDiffusion 并行采样数百到数千个 cell;但作者指出『远距离 cell 只能经重叠间接通信』这一缺陷,正是引入级联的动机。
Chamfer 距离与 F-score
把重建网格与真值网格各采样为点集 $P$、$G$ 后的表面误差指标:Chamfer 距离(CD)是双向最近邻平均距离(米);F@$\tau$ 是在阈值 $\tau$(厘米)下精确率与召回率的调和平均,衡量表面覆盖与准确的平衡;NC(normal consistency)是最近邻点对法向余弦相似度的均值。
论文所有主表由 CD、F@2(或 T&T 的按场景阈值 F@$\tau$)、NC 构成,且 T&T 阈值小至 3mm、ScanNet++ 用 2cm,理解这些紧阈值才能读懂『生成表面轻微偏移被惩罚』的实验结论。
DINOv3 特征与像素对齐条件
DINOv3 提供图像的 patch 级语义特征(一个 token 覆盖 16×16 像素)。像素对齐条件把 3D 体素投影到各视图、在投影处采样图像特征后送入 3D 网络,是物体级与场景级 3D 生成的标准条件方式;但 token 网格粗,双线性采样会丢失亚 token 细节,上采样到图像分辨率又会导致缓存爆炸(512×512 tile 需 0.5 GiB/视图)。
本文的体素查询注意力与 ConvNeXt 细节分支正是为解决这个分辨率-内存两难设计的(每视图仅约 5.25 MiB),是方法第二大贡献的直接背景。
研究动机
现有多视图网格重建方法分三类,各有硬伤。逐场景优化方法(2DGS、NeuS、MILo、GaussianWrapping)为每个场景单独拟合一个 3D 表示,密集视角下表面精确,但缺乏学习到的 3D 先验:在稀疏视角、遮挡以及反光、透明表面(如卡车的玻璃车窗、桌上的玻璃瓶)上会失败,而且每个场景都要做一次昂贵的优化。前馈方法(Depth Anything 3、MapAnything、Murre)一次前向预测深度或点图,但输出与图像对齐,必须跨视图融合才能得到完整网格,跨视图不一致会引入噪声、孔洞和重复表面。生成式重建(最接近的先前工作 GenRecon)用学到的 3D 生成器直接输出完整网格、能补全弱观测区域,但生成器工作在固定分辨率的体素网格上,空间覆盖与几何细节不可兼得:把它扩展到大场景时需用 MultiDiffusion 把场景切成重叠局部小块,远处区域只能通过块间重叠间接交互,全局几何一致性难以维持——在城市街区这类街拍看不到屋顶的场景中问题尤其严重。层次化 3D 生成器(XCube、SCube)虽能由粗到细,但层次深度、空间范围和输出分辨率都在训练时固定,无法按场景灵活调整。
本文的目标是本文的目标是:不做任何逐场景优化,仅凭带位姿的多视图图像,在从单个物体、室内房间到整个城市街区(数米到上百米)的尺度范围内,直接生成全局一致且细节丰富的高保真网格。关键诉求是空间覆盖范围与输出分辨率不在训练时固定,而在推理时按需选择——同一套模型权重既可以只跑粗层快速得到全场景布局,也可以对感兴趣区域继续细化上采样;同时用学习到的生成先验补全稀疏观测、反光与透明表面等弱约束区域,并在不同视图数(16 到 256)与图像分辨率(约 1K 到 9504×6336)之间稳定泛化,最终在室内(ScanNet++)、室外物体(Tanks and Temples)与城市街区三个尺度上同时超过前馈与生成基线、匹敌或超越逐场景优化。
与已有工作不同的是,本文的独特切入是把 2D 图像领域中『训练免调』的由粗到细细化思想(SDEdit、DemoFusion 复用同一个模型逐步细化上采样样本)首次系统地搬进 3D 场景重建。与 GenRecon 让所有块在同一尺度并行生成不同,本文让细层从粗层继承几何做 SDEdit 式去噪,全局结构沿级联显式传播到每个 cell;与 XCube/SCube 在训练时固定层次、每层一个模型不同,本文只在单个 cell 上做多种物理尺度的训练、共享一套权重,训练不需要粗细配对数据,级联深度、cell 布局与物理尺度全部推迟到推理时决定。配套地,作者重新设计了与 cell 无关的多尺度图像条件机制(tile 金字塔特征库 + 体素查询注意力),使任意位置、任意尺度的 cell 都能取到分辨率匹配且可复用的图像特征——这解决了『推理时任意配置级联』带来的条件难题。
核心方法
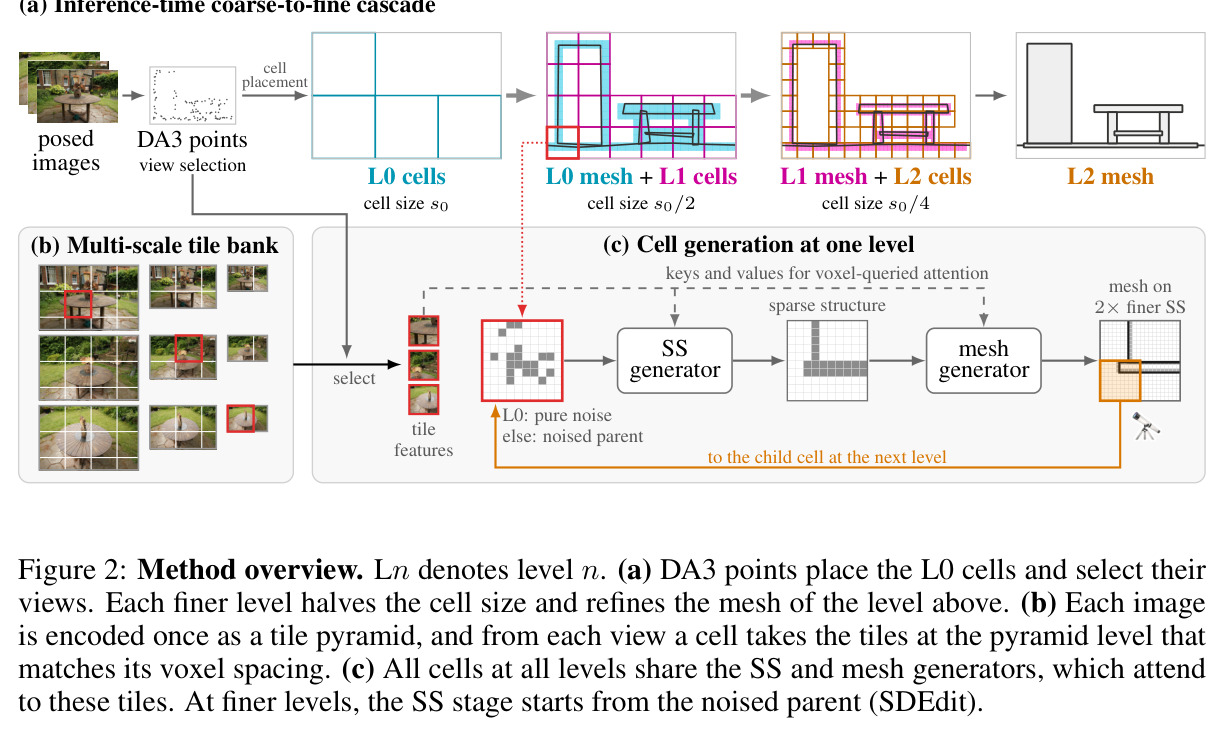
先说直觉:生成器分辨率固定($R=64$ 的稀疏体素网格,mesh 解码 $512^3$),一个 cell 不可能既覆盖大范围又保住细节,那就先用大 cell 建立全局布局,再逐层把 cell 尺寸减半去细化局部。技术路线:采用 TRELLIS.2 两阶段生成器——SS 阶段生成稀疏体素占据结构,mesh 阶段在活跃体素上生成形状潜码并解码为网格,两者都是以 DINOv3 图像特征加相机内外参为条件的 latent flow matching Diffusion Transformer。场景级生成沿用 GenRecon:把场景切成边长 $s$、重叠 50%(stride $s/2$,体素间距 $\Delta=s/R$)的 cell,用 MultiDiffusion 在共享场景潜网格上逐步融合各 cell 预测。级联第 $l$ 层 cell 边长 $s_l=s_0/2^l$(ScanNet++ 用 4/2/1 m,城市街区用 80/40/20/10 m):第 0 层从纯噪声出发覆盖全场景建立布局,之后每层 cell 减半、只布在父层预测出的表面附近,从父层继承几何并加噪细化;图像条件由推理前构建的 tile 特征库提供,DA3 深度只用于布点与选视图。
核心创新有三。其一,推理时由粗到细级联复用单一固定分辨率生成器:父网格解码器把形状潜码上采样到 $2R$ 分辨率,子 cell(边长减半)恰好对应其中一个 $R^3$ 体素块;把该占据块编码为 SS 潜码 $\bar{x}_0^{(l+1)}=A_{SS}E_{SS}\hat{O}^{(l)}_{sub}$,加噪到中间时刻 $t_s=0.8$($x_{t_s}=(1-t_s)\bar{x}_0+\sigma_{t_s}\epsilon$),再用同一个 SS 流模型以 $K=10$ 个 Euler 步去噪——即 SDEdit 式层级细化。由于模型只在单 cell 上多尺度训练、不接收绝对位置与物理尺寸,同一权重适用于任意位置与尺度的 cell,级联深度、布局与尺度全部推理时决定。其二,与 cell 无关的多尺度图像条件:体素查询注意力以当前体素特征为 query,对各视图投影点附近的 DINOv3 token 做统一 softmax,用 RoPE 编码射线方向、亚 token 像素偏移与表观体素尺度三个相对量,mesh 阶段再叠加轻量 ConvNeXt 细节分支;配合 512×512 tile 金字塔特征库,每个 tile 只编码一次,跨 cell、阶段与流步骤复用。其三,DA3 深度仅用于第 0 层布点与视图选择,绝不融进输出几何。
方法步骤详情
完整流程(附录 C):第 1 步,用 DA3 点云确定场景包围体与第 0 层 cell(边长 $s_0$,半步长晶格布置),并为每个 cell 选视图。第 2 步,构建 tile bank:每张输入图做逐级减半的金字塔并切成 512×512 的 tile;每个 cell 按『1 个 SS 体素约 8 像素』选取金字塔层级、取覆盖其投影的 tile,tile 作为带调整内参的虚拟相机,经冻结的 DINOv3 与 ConvNeXt 编码一次缓存(约 5.25 MiB/视图),每 cell 最多 64 个。第 3 步,SS 阶段:在共享场景潜网格上跑 MultiDiffusion,每个流步各 cell 独立预测潜码、按 Hann 窗加权融合;第 0 层从纯噪声开始,细层先由父级解码器上采样到 $2R$、裁出子 cell 的 $R^3$ 占据块编码,加噪至 $t_s=0.8$ 后以 $K=10$ 步去噪。第 4 步,mesh 阶段在活跃体素上同样以 MultiDiffusion 生成形状潜码(12 流步,CFG 尺度 SS 7.5、mesh 4.0)。第 5 步,用父层占据(膨胀一体素)决定子层 cell 布点。第 6 步,最细层用带 4 体素 margin 的分块解码拼成无缝全场景网格,非均匀场景再做层级环状拼接。训练以条件流匹配逐 cell 进行(通用模型:SAGE-10K、3D-FRONT、200 栋程序化住宅、100 个草地场景;城市模型:自建日式街区+BIM),尺度平衡采样,无父-子配对监督。
技术新颖性
与最近邻工作 GenRecon 的本质区别在于全局上下文的传播方式:GenRecon 的每个去噪器只见局部 cell,远处区域只能经 50% 重叠间接通信,街拍看不见的屋顶等区域容易碎裂;T3lescope 的细层从同一个粗层父几何出发,全局结构显式传播到每个 cell——城市街区 Chamfer 距离从约 5 m 降到 0.645 m 是直接证据。与 XCube/SCube 的区别在于层次是否固定:它们为每个层次训练专门模型、尺度在训练时定死;本文一个模型多尺度训练即可在推理时任意加深级联(基准用 3 层、城市街区用 4 层,同一套权重)。与 2D 级联扩散(每分辨率训练一个模型)不同,这里靠『cell 尺寸减半、生成器分辨率不变』实现单模型复用,直接借鉴 2D 训练免调细化(SDEdit/DemoFusion)思想并证明其在 3D 成立。条件机制上,相比 Pixal3D 把 DINO 特征上采样到图像分辨率(0.5 GiB/视图、每流步重算),本文 token 级注意力+ConvNeXt 分支每视图仅约 5.25 MiB、可全量缓存;以不断演化的体素状态为 query,还让视图权重随 transformer 块与去噪步自适应,而非在进入 3D 网络前就固定视图聚合权重。
实验结果
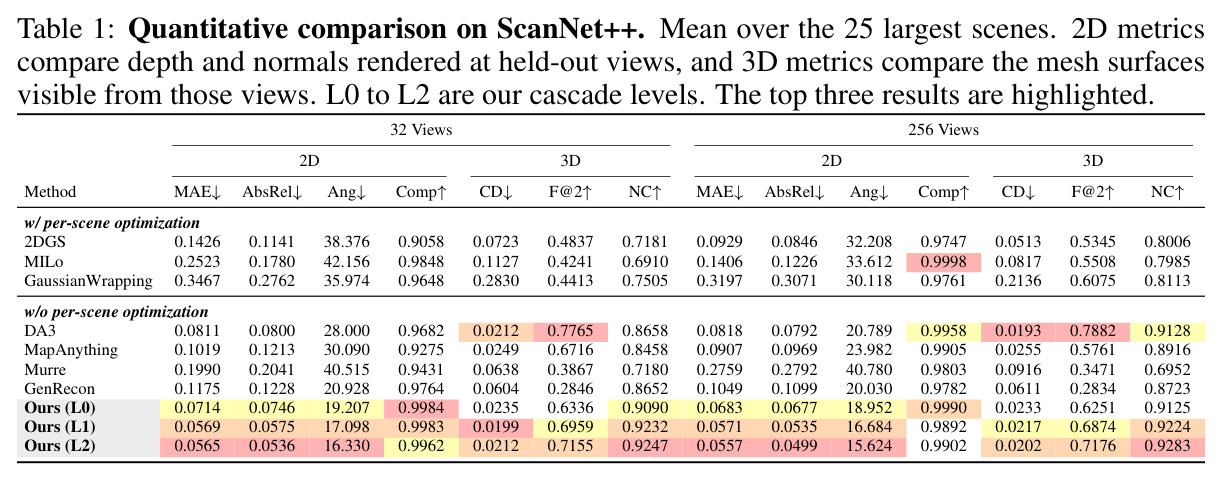
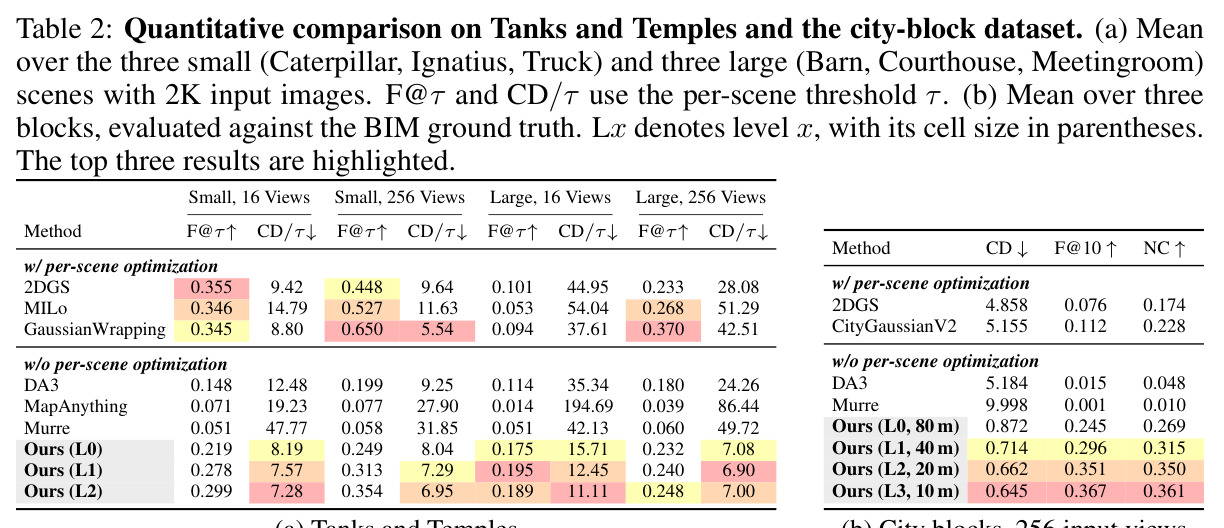
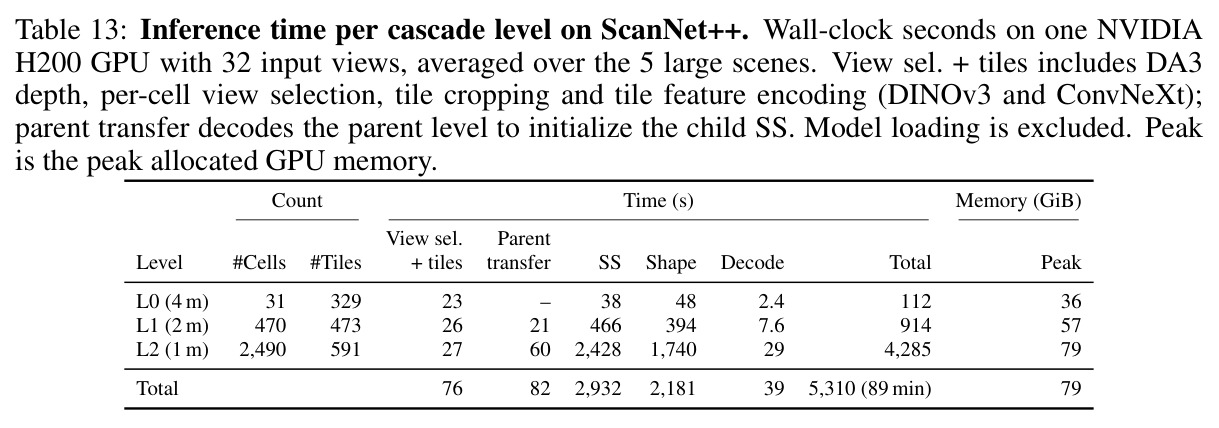
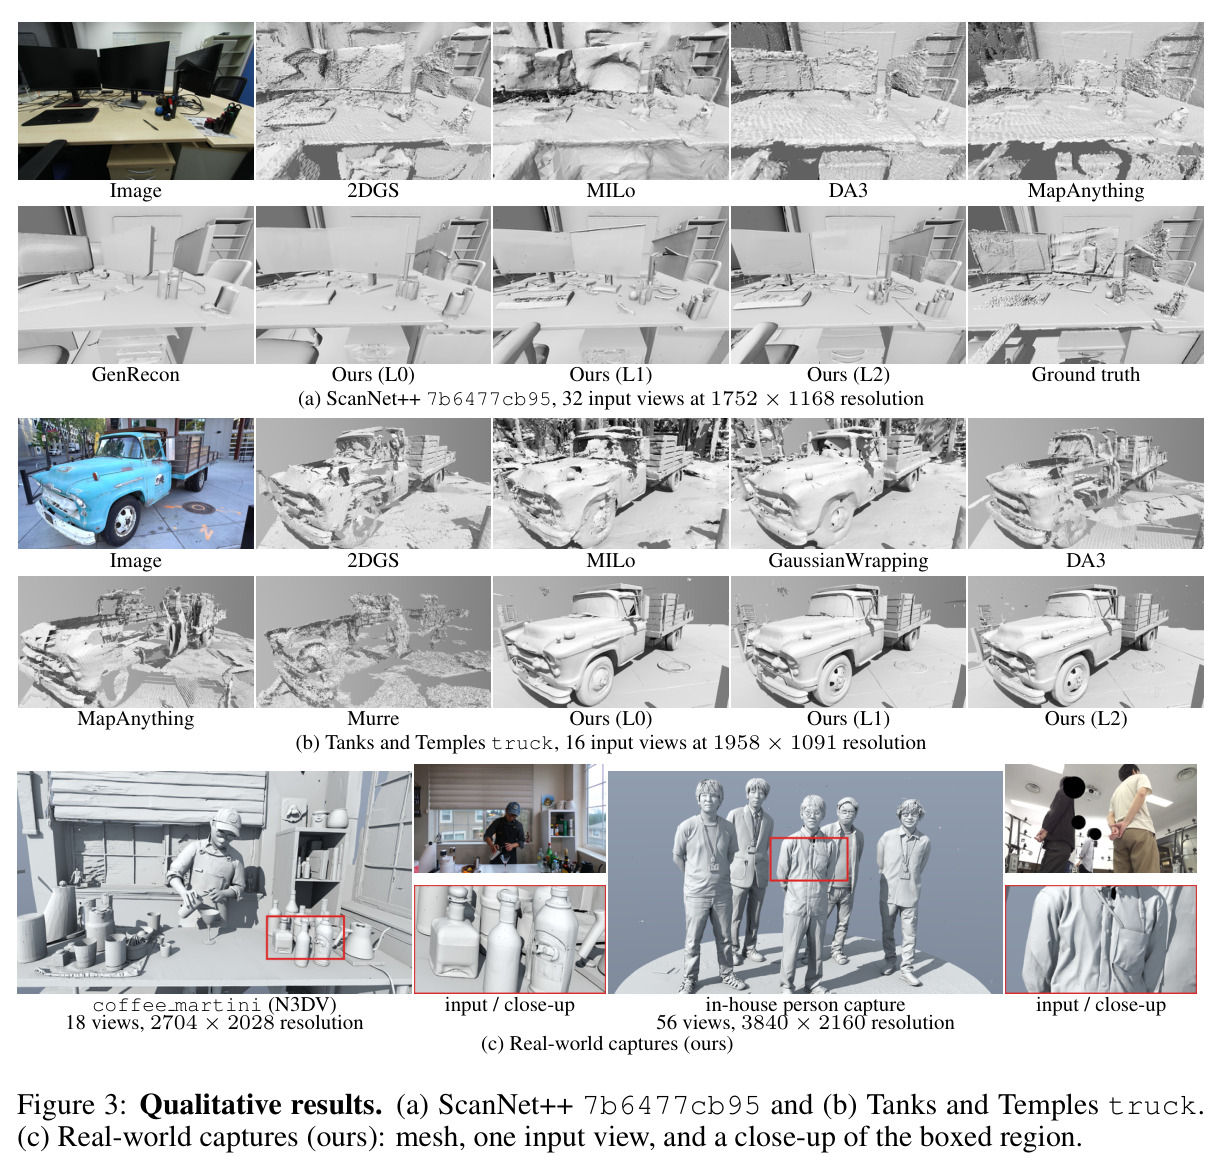
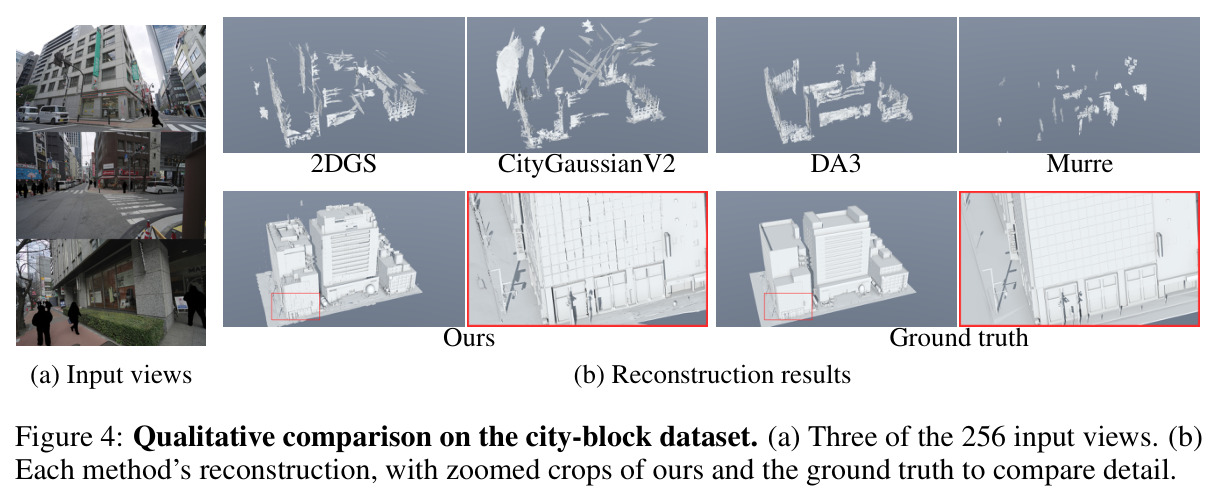
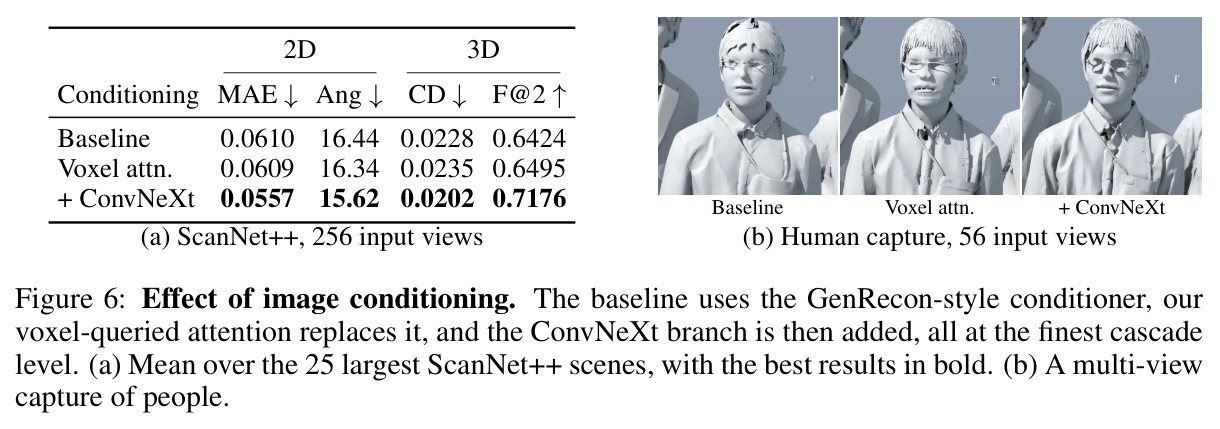
(1) ScanNet++(25 个最大场景):32 视图下本文 L2 的 MAE 0.0565 m、法向角 16.33°、CD 0.0212 m、F@2 0.7155,全面超过生成基线 GenRecon(CD 0.0604、F@2 0.2846);DA3 的 F@2 0.7765 更高但 MAE 0.0811、Ang 28.0° 更差。本文从 32 到 256 视图几乎不变(F@2 0.7155→0.7176),2DGS 却从 0.53 掉到 0.48;无优化方法中本文三个 3D 指标超过所有逐场景优化基线。(2) Tanks and Temples:大场景 16 视图取得最高 F@τ 0.175(DA3 0.114)与最低 CD/τ 15.71;256 视图小场景 F@τ 0.354 低于 GaussianWrapping 的 0.650(3–25 mm 紧阈值惩罚生成表面的轻微偏移)但 CD/τ 6.95 更优;只有本文能补全卡车的透明反光车窗。(3) 城市街区(自建 41 街区数据,256 视图):基线全部失败(CD 4.858–9.998 m),本文 L3 达 CD 0.645 m、F@10 0.367,每加一层级联指标单调提升(L0 0.872→L3 0.645 m)。(4) 消融:$t_s$ 从 1.0 降到 0.8 使大场景 CD 从 0.1051 降至 0.0212(降 80%);条件机制 F@2 从 0.6424→0.6495→0.7176。(5) 成本:单张 H200 上到 L1/L2 约 17/89 分钟,峰值显存 79 GiB。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ScanNet++ 大场景网格重建(32 视图) | Chamfer 距离 (m) / F@2 / NC | 0.0212 / 0.7155 / 0.9247(L2) | GenRecon:0.0604 / 0.2846 / 0.8652 | CD 降低约 2.9 倍,F@2 提升约 2.5 倍 |
| ScanNet++ 深度与法向精度(32 视图) | 深度 MAE (m) / 法向角误差 (°) | 0.0565 / 16.33(L2) | DA3:0.0811 / 28.00;GenRecon:0.1175 / 20.93 | MAE 降低 30%~52%,法向角误差降低 22%~42% |
| Tanks and Temples 大场景(16 视图,2K) | F@τ / CD/τ | 0.175 / 15.71 | DA3:0.114 / 35.34;2DGS:0.101 / 44.95 | F@τ 提升 54%,CD/τ 降低约 56% |
| 城市街区重建(256 视图,自建数据集) | Chamfer (m) / F@10 / NC | 0.645 / 0.367 / 0.361(L3,10 m cell) | 2DGS:4.858 / 0.076 / 0.174;DA3:5.184 / 0.015 / 0.048 | CD 降低约 7.5 倍,F@10 提升约 4.8 倍 |
| 父级初始化消融(ScanNet++ 大场景,32 视图) | Chamfer 距离 (m) | 0.0212(ts=0.8) | ts=1.0(细层从纯噪声生成):0.1051 | CD 降低 80% |
| 图像条件消融(ScanNet++,256 视图,L2) | F@2 | 0.7176(体素查询注意力 + ConvNeXt) | GenRecon 式双线性采样条件:0.6424 | F@2 提升 0.075 |
局限与改进
作者承认的局限:由于不做逐像素拟合,重建表面相对观测可能略有偏移,在密集视图加紧阈值(T&T 3–25 mm)下 F 分数受损——小场景 256 视图 F@τ 0.354 明显低于 GaussianWrapping 的 0.650;计算成本随 cell 数与级联深度增长(cell 数理论上每层约 8 倍,实测 L2 达 2490 个 cell),L2 全场景采样需 89 分钟与 79 GiB 显存,远慢于前馈方法;方法假设图像已带位姿;对无界场景中的远距离物体重建失败(Figure 18:4K、256 视图下远处物体缺失)。我的补充观察:其一,生成先验补全的弱观测区域(透明车窗、屋顶)是『合理推测』而非观测事实,方法不提供不确定性度量,用于测量、验收等精度敏感场景时有风险;其二,ScanNet++ 上 DA3 在 F@2 与小场景 CD 上仍占优,说明在观测充分的区域纯生成路线的精度上限未必高于专用前馈深度模型;其三,城市模型依赖自建的日式街区+精确 BIM 配对数据训练,跨城市、跨建筑风格泛化未经验证;其四,$t_s=0.8$ 是全局经验值,而稠密视图下 $t_s=1$ 的 F@2 反而更高(小场景 256 视图 0.7849 对 0.6167),说明该超参存在按场景或视图密度自适应的空间。
独立分析的弱点
弱点一(不可验证的补全):生成式补全不输出置信度,下游无法区分『观测支撑的高精度表面』与『先验脑补的表面』,透明与镜面区域的几何可能系统性偏差。改进:让流模型输出逐体素方差或用多次采样一致性作为置信图,在级联中记录每个区域受图像约束的程度。弱点二(推理慢且显存高):MultiDiffusion 要求每个流步评估所有 cell,L2 达 2490 个 cell、89 分钟,难以交互式使用。改进:蒸馏到少步采样器(作者已提出);按相机邻近度或曲率排序渐进细化,而非一次性铺满所有细 cell。弱点三(对 DA3 的依赖):粗层布点与视图选择完全依赖 DA3 深度,其在天空、水面、强反光下的失败会传导为布点缺失。改进:增加基于相机轨迹凸包或占据熵最大化的后备布点,或训练轻量布局预测器互为校验。弱点四(紧阈值下的表面偏移):不逐像素拟合导致 T&T 密集视图 F@τ 落后。改进:在最细层附加轻量图像对齐微调(只优化形状潜码几十步渲染损失),兼得泛化与像素级贴合。弱点五(数据与评测同源):城市模型训练与评测都来自日本城市街拍+BIM,跨地域泛化存疑,建议补充其他国家/风格的对照评测并公开更多训练街区。弱点六(误差继承):细层继承父层误差,$t_s$ 偏小时父层错误被保留放大,可用图像证据对父层几何做显式纠错而非仅加噪。
未来方向
作者明确提出的方向:把 SS 与 mesh 流模型蒸馏成少步采样器以大幅降低采样成本;把 T3lescope 扩展到无界场景,解决远距离物体重建失败。基于本文成果可延伸的方向:其一,级联框架与外观建模天然可组合,可在同一 tile bank 上加外观/材质流模型,实现几何+PBR 材质的一次性生成,服务数字孪生;其二,把静态级联扩展到 4D——时序上让当前帧细层继承上一帧几何,面向动态场景与视频重建;其三,不确定性感知的级联:细层只在父层置信度低或图像证据强的区域加密,进一步节省算力并输出置信图;其四,级联初始化不限于父层几何,可融合 DA3/MapAnything 等前馈深度作为更细的先验,以弥补紧阈值下的精度差距;其五,城市模型利用 OpenStreetMap、卫星影像或程序化城市做弱监督预训练,验证并增强跨地域泛化;其六,在 3D 中探索 2D 训练免调细化的其他机制(噪声重排、结构引导、跨层注意力),进一步压低 $t_s$ 敏感性。
复现评估
项目页已上线(pfnet-research.github.io/t3lescope),但正文未明确承诺开源全部代码。数据:作者将发布城市街区评测集(图像、每街区 3DGS 模型与 BIM 网格,人物与车牌已打码);其余训练数据基本公开——SAGE-10K、3D-FRONT、TexVerse、ScanNet++、T&T、Mip-NeRF 360、N3DV,但 200 栋程序化住宅与 100 个草地场景依赖自研生成管线,城市训练集(38 街区、126,068 张照片)不承诺完整发布。依赖组件全部公开:TRELLIS.2、DINOv3、ConvNeXt、DA3。算力门槛高:mesh 流需先把 TRELLIS.2 从 30 块剪枝到 15 块(1.3B→655M 参数)并用 16 张 H200 微调 50k 步;TexVerse 多视图预训练用 16–32 张 H200(SS 流约 80k 步、mesh 流约 200k 步);场景级微调 8 张 H200 每流 25k 步;还需复现 tile bank、体素注意力(RoPE 相对编码)、MultiDiffusion 融合与分块网格解码等工程细节。推理门槛较低但需大显存:单张 H200(峰值 79 GiB),大场景 L2 约 89 分钟。综合:代码开源时仅推理验证为中等难度,完整从头复现训练为高难度,主要障碍在多阶段训练课程、剪枝流程与自建数据工程。
论文图表
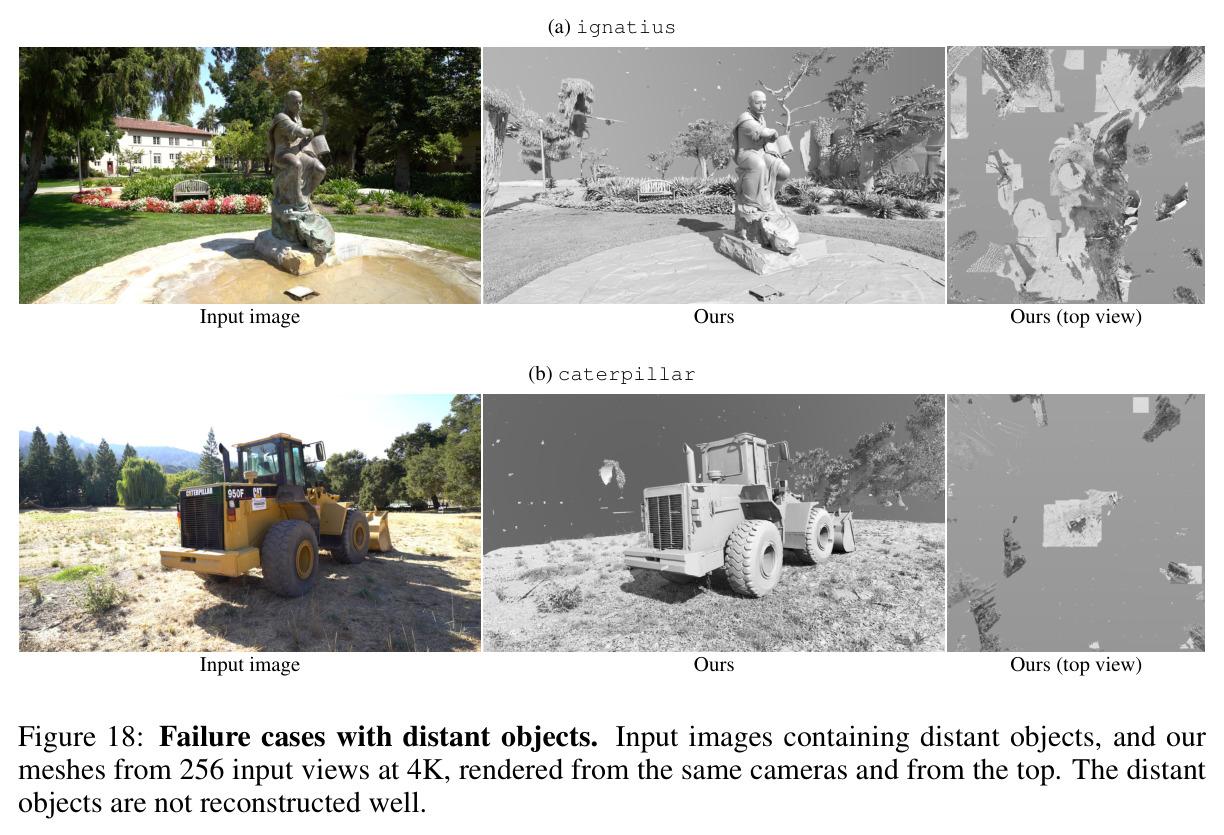
失败案例:含远距离物体的输入图像(4K、256 视图),重建网格从相同相机视角与顶部渲染——远处的物体重建质量很差,几乎缺失或严重变形。
作者明确承认的失败模式:方法目前限于有界场景与中近距离表面,界定了适用范围,对评估实际部署价值很重要。