在线蒸馏中的增益与坍塌:一个强化学习视角 Gains and Collapse in On-Policy Distillation:A Reinforcement Learning Perspective
教师即隐式奖励模型:在线蒸馏只放大既有能力,偏好偏置导致奖励黑客式坍塌。
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
一种大模型后训练方法:每个迭代由当前学生模型自己采样生成回复,教师模型在学生生成前缀上通过 token 级反向 KL 散度提供监督,即教师只在学生到过的状态上打分,而非像离线蒸馏那样直接提供教师自己的训练序列。训练分布由学生决定,监督信号由教师给出。
本文的全部结论都建立在这个机制上:学生在哪些状态被评估、教师如何打分,直接决定了哪些学生行为会在训练中被放大,这是理解增益与坍塌的关键。
反向 KL 散度与隐式奖励模型
反向 KL 衡量学生分布 $\pi_{S_\theta}$ 相对教师分布 $\pi_T$ 的偏离,展开后可重写为在学生采样前缀上最大化隐式奖励 $r_T(h,a)=\log \pi_T^{(\tau_T)}(a\mid h)$ 加熵正则的策略优化目标。因此教师天然充当一个隐式奖励模型,无需显式标注即可对学生每个 token 打分。
论文的核心公式化与所有诊断工具(优势、选择间隙、优势十分位)都从这个奖励解释推导而来,是把 OPD 类比成强化学习的数学基础。
pass@k 与问题覆盖
pass@k 表示每个问题从 $k$ 个独立采样回复中至少有一个正确的概率,$k=1$ 即平均准确率。覆盖指在给定采样预算内至少被解出一次的问题比例;$k$ 越大 pass@k 越逼近覆盖。二者共同区分了让答案更容易采到与真正多会做题。
论文用 pass@k 曲线随 $k$ 的衰减和覆盖审计,来严格区分提升采样效率与扩展能力边界这两个本质不同的结论。
奖励黑客(Reward Hacking)
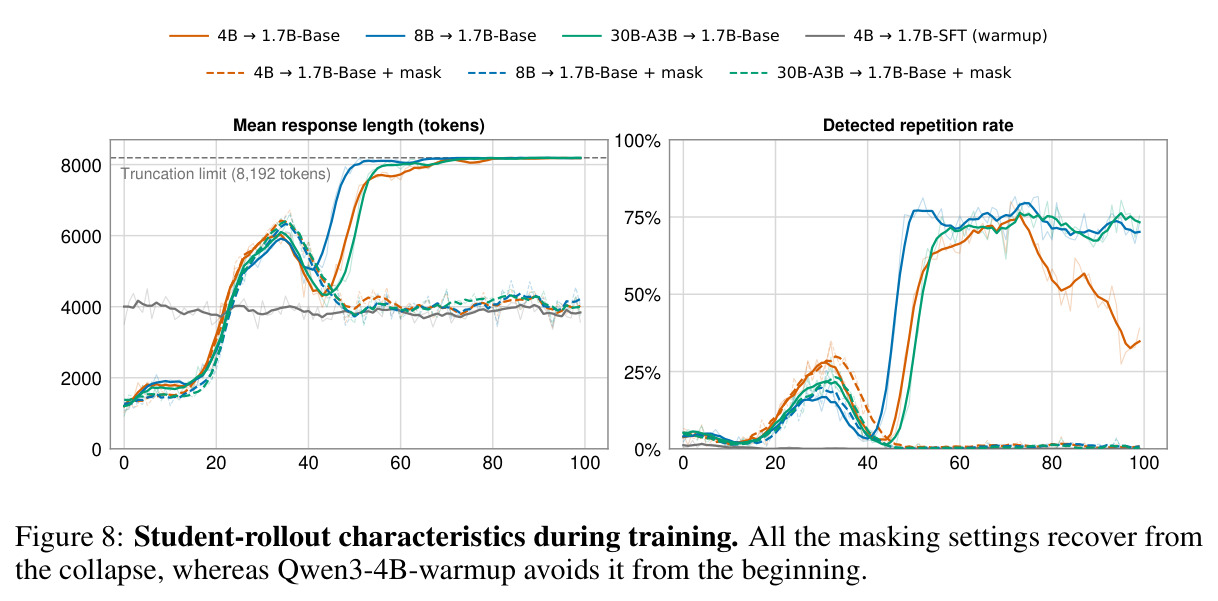
指优化过程成功拟合了奖励信号但该信号与真实目标错位的现象:模型学会最大化奖励分数而非提升真实质量。在本文中表现为教师隐式奖励偏爱超长、重复的病态回复时,学生越训越贴合教师偏好,生成质量却持续恶化,最终撞满生成长度上限并陷入机械重复。
论文的核心论断是 OPD 坍塌本质上是奖励黑客而非优化失败,这一重新定性直接决定了正确的修复方向。
选择间隙 $\Gamma$
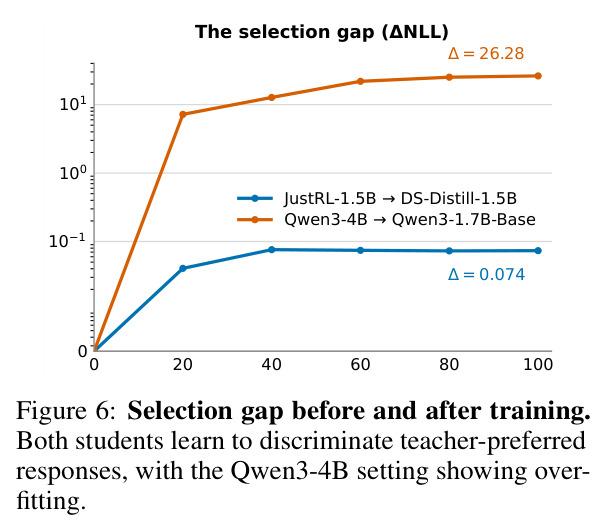
论文提出的诊断量:将学生回复按教师优势排序,取教师最偏好与最不偏好的各 10%,计算两组回复训练前后的 NLL 变化 $\Delta\mathrm{NLL}=\mathrm{NLL}_{S_t}-\mathrm{NLL}_{S_0}$ 之差。$\Gamma>0$ 说明训练选择性地强化了教师偏好的回复,数值越大表明对教师偏好的拟合越极端。
它是证明坍塌学生忠实拟合了教师偏置奖励的关键量化证据:坍塌设置中 $\Gamma$ 高达 26.28,而成功设置仅 0.074。
研究动机
在线策略蒸馏已成为 DeepSeek、Kimi 等前沿模型大规模后训练流程的重要组成部分:每个迭代学生自己采样回复,教师在学生生成的前缀上以 token 级反向 KL 提供监督。然而在报告性能收益的同时,多项工作也记录了训练不稳定与退化行为——回复长度失控、严重重复。Li 等人在 Qwen3-4B 蒸馏到 Qwen3-1.7B-Base 的设置中观察到近乎全部回复撞上生成长度上限的坍塌,并把原因归于教师与学生分布的巨大失配。但已有研究无法回答两个根本问题:OPD 训练到底学到了什么——是扩展了学生的解题能力,还是只是重新加权了学生已有的行为?为什么同一个方法有时带来稳定增益,有时却训练到彻底崩溃?缺乏对增益与坍塌的统一解释,使得 OPD 的使用基本依赖试错。
本文的目标是本文的目标是用一个统一的强化学习视角同时解释 OPD 的成功与失败:把教师显式建模为学生回复上的隐式奖励模型 $r_T(h,a)=\log \pi_T^{(\tau_T)}(a\mid h)$,即教师给学生自己采样的行为打分。在此视角下回答三个递进问题:其一,成功的 OPD 是否真的扩展了学生的能力边界,还是只提高了既有能力的采样效率;其二,文献中报告的坍塌是否属于奖励黑客,即优化成功但拟合了错误目标;其三,若是奖励黑客,其根源是什么,能否在不更换教师的前提下通过干预训练信号缓解。作者在三个教师-学生组合的数学推理任务上验证这套解释,并给出两种可操作的防坍塌手段:屏蔽病态回复的损失、用 SFT 检查点初始化做预热。
与已有工作不同的是,以往工作把 OPD 失败归因于教师-学生分布失配、优化不收敛或近似反向 KL 更新带来的偏差,改进思路集中于换更强教师、修目标函数或离线预热。本文的独特切入点是换一个问题:不看教师自己生成得怎么样,而看教师在学生 rollout 上给了什么分数。这带来两个反直觉的观察:其一,坍塌的训练其实收敛得完全正常,学生反而越来越贴合教师的偏好信号;其二,教师自身几乎从不生成那些它给学生打高分的病态回复,说明教师的生成质量并不能代表它作为评估者的可靠性。由此论文把研究焦点从教师生成能力转移到教师对学生 rollout 的评估可靠性上,并把坍塌定性为候选池中的病态样本被优先强化的奖励黑客。
核心方法
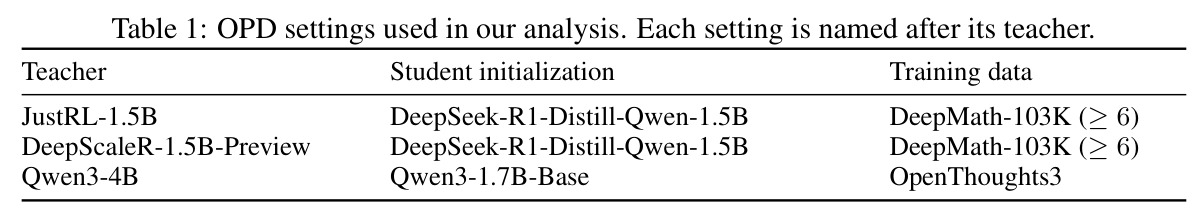
论文先把采样 token 反向 KL 形式的 OPD 严格重写为最大熵策略优化:在学生 rollout 前缀分布 $h\sim d_{\bar S}$ 上,目标为 $\mathcal{L}_T(\theta;\bar S)=-\mathbb{E}_{h}\big[\mathbb{E}_{a\sim\pi_{S_\theta}(\cdot|h)}\, r_T(h,a)+H(\pi_{S_\theta}(\cdot|h))\big]$,其中隐式奖励 $r_T(h,a)=\log \pi_T^{(\tau_T)}(a|h)$。每个 rollout token 定义优势 $A_t^T=r_T(h_t,y_t)-\log\pi_{\bar S}(y_t|h_t)$,作为停梯度量进入 PPO 式裁剪目标,并加指向初始学生的参考 KL 正则(系数 0.001)。实验含三个设置:JustRL-1.5B 与 DeepScaleR-1.5B-Preview 分别监督 DeepSeek-R1-Distill-Qwen-1.5B(DeepMath-103K 难度不低于 6 的子集,16384 token 上限),Qwen3-4B 监督 Qwen3-1.7B-Base(OpenThoughts3,8192 token 上限);统一用 Slime 框架训练 100 个 rollout 迭代,在 AIME24-26 与 AMC23 上评估,分析用每题 256 条回复。
核心洞察是:教师隐式奖励的是学生自己的行为,包括教师自己几乎不会生成的行为。因此 OPD 的本质不是知识迁移,而是按教师偏好对学生已可达的行为空间做重新加权——偏好与质量对齐时,正确回复更容易被采到,表现为小采样预算下准确率提升;偏好与质量错位时,训练就变成教科书式的奖励黑客,学生越来越会拟合教师的偏好信号(选择间隙 $\Gamma$ 从接近 0 涨到 26.28),同时生成超长、重复的病态文本。与已有工作的本质区别在于诊断对象:不是去修优化器或换更强教师,而是审查教师在学生 rollout 上的奖励可靠性,并通过控制哪些学生回复进入强化(masking 切断病态样本的损失、SFT warmup 减少病态样本的暴露)来消除坍塌。
方法步骤详情
方法按五步展开。第一步形式化:把反向 KL 目标展开为隐式奖励加熵正则的策略优化,推导出 token 级 PPO 式更新。第二步能力审计:对 $S_{\mathrm{INIT}}$ 与 $S_{\mathrm{OPD}}$ 各采样 256 条回复(AMC23 到 1024 条)计算 pass@k;再对仅被 OPD 解出的 AIME 问题向 $S_{\mathrm{INIT}}$ 追加 768 次采样(池扩到 1024)并人工复核推导有效性,审计可解集是否扩大。第三步坍塌诊断:对比成功与坍塌设置的损失、优势收敛曲线,Min-10NN 回复集中度,训练后回复在 $S_{\mathrm{INIT}}$ 下的 NLL,以及选择间隙 $\Gamma$——教师最偏好与最不偏好各 10% 回复的平均 $\Delta\mathrm{NLL}$ 之差。第四步奖励画像:把 $S_{\mathrm{INIT}}$ 回复按教师优势分成 A1 到 A10 十分位,统计各档正确率、长度、截断率、重复率,检验训练前奖励是否已偏置。第五步干预:保持教师、数据与优化配方不变,屏蔽撞到生成长度上限回复的损失,或将学生初始化换成已发布的 Qwen3-1.7B-SFT 检查点做预热,对比病态行为随训练的演化与最终平均准确率。
技术新颖性
技术新颖性有三点。第一,公式化虽接近已有策略梯度实现,但把 OPD 严格重述为教师即隐式奖励模型加学生自采样候选池,并据此设计出一整套诊断工具(选择间隙 $\Gamma$、优势十分位画像、$S_{\mathrm{INIT}}$ 下 NLL 对比)是新的。第二,实验结论颠覆直觉:坍塌设置中优化正常收敛、学生回复落在 $S_{\mathrm{INIT}}$ 的低 NLL 区域、选择间隙暴涨到 26.28,证明坍塌不是发散而是高效拟合了错误目标,这是首次在 OPD 中给出奖励黑客的完整证据链——训练前教师优势已偏爱病态回复(正确率接近零但长度、截断、重复率随优势档位递增),训练中被放大,终点 99.4% 截断、38% 重复。第三,干预思路新在不动教师、只动候选池:masking 直接切断病态回复的强化通路,SFT warmup 通过改善初始 rollout 分布减少病态样本出现,两者分别从供给和暴露两端缓解奖励黑客,且证明坍塌并非不可逆。
实验结果
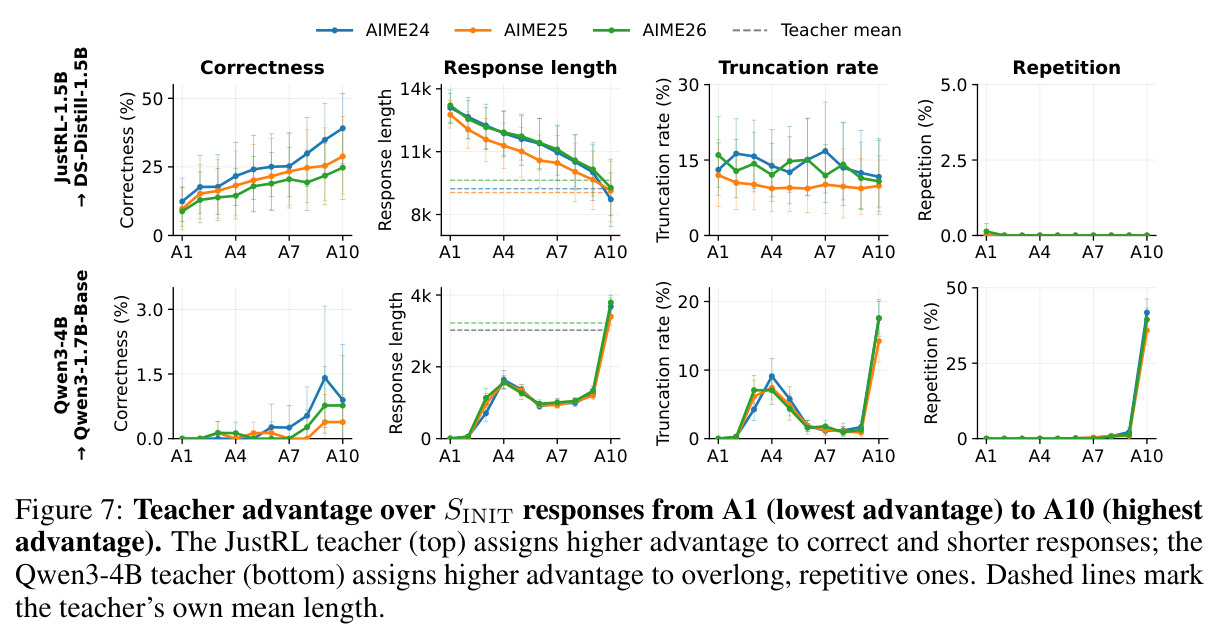
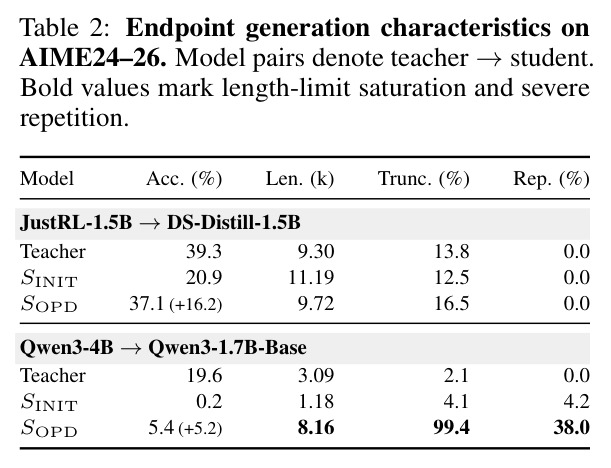
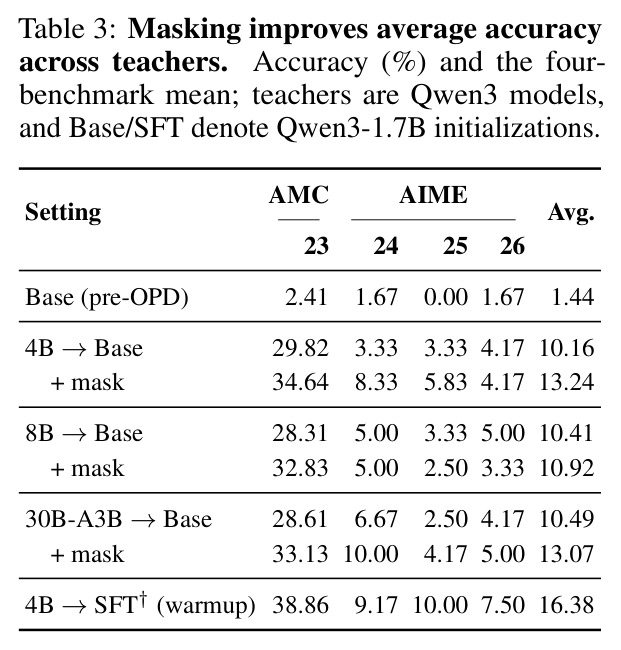
结论分四块。其一,OPD 不扩展能力边界:pass@k 增益随采样预算 $k$ 增大而衰减,$k=1$ 时 $S_{\mathrm{OPD}}$ 明显更优,$k$ 到 256/1024 时差距消失;对仅被 OPD 解出的问题追加 768 次采样并人工审计后,73 个可解问题中 JustRL 教师下 $S_{\mathrm{OPD}}$ 覆盖 65 个、DeepScaleR 下 63 个,无一题仅被 OPD 解出;但对已可解问题,90.6%(JustRL)与 84.4%(DeepScaleR)的题目平均 mean@256 提升 22.6% 和 14.7%,增益来自更容易采到正确答案。其二,坍塌不是优化失败:JustRL 与 Qwen3-4B 设置的损失、优势曲线形状无本质差异,Min-10NN 距离都在下降,训练后回复均落在 $S_{\mathrm{INIT}}$ 的低 NLL 区。其三,坍塌是奖励黑客:JustRL 学生准确率 20.9% 升至 37.1%(+16.2),无重复;Qwen3-4B 学生仅从 0.2% 升到 5.4%(+5.2),截断率 99.4%、重复率 38%、长度 8.16k,远差于教师(2.1%、0%、3.09k);选择间隙 $\Gamma$ 分别为 0.074 与 26.28;训练前优势十分位显示 JustRL 教师偏爱正确且简短的回复,而 Qwen3-4B(8B、30B-A3B 同样)给正确率接近零的超长重复回复打最高优势。其四,干预有效:masking 使 4B/8B/30B-A3B 教师下五基准平均准确率提升 3.08/0.51/2.58 个百分点;SFT warmup 达到最佳 16.38%,比 Base 初始化的 10.16% 高 6.22 个点且全程未坍塌。
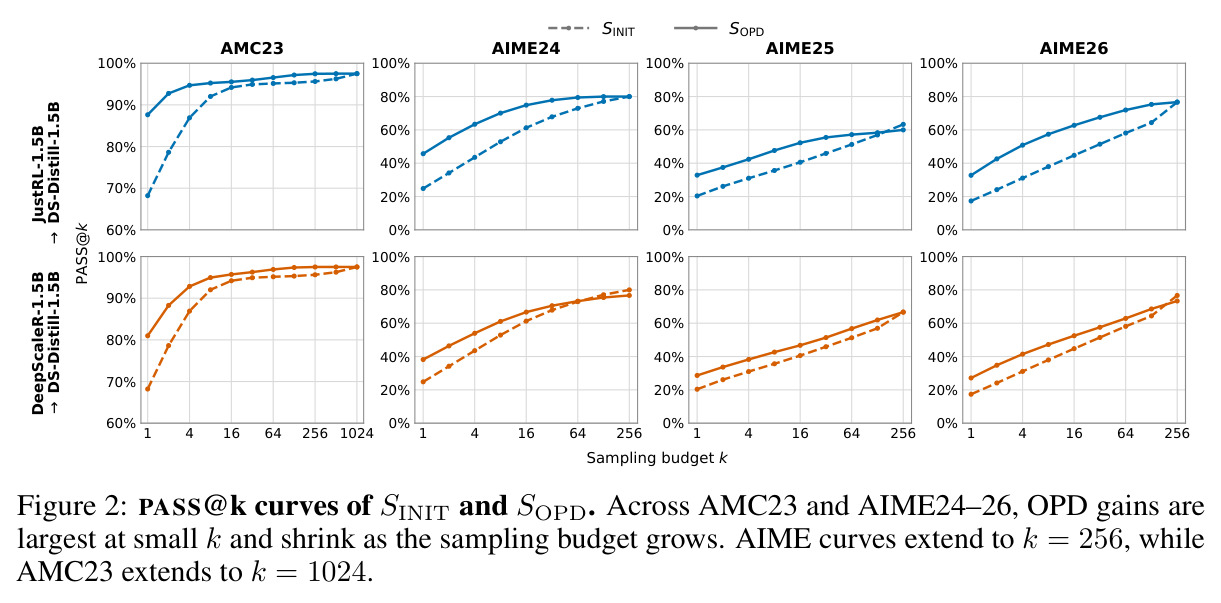
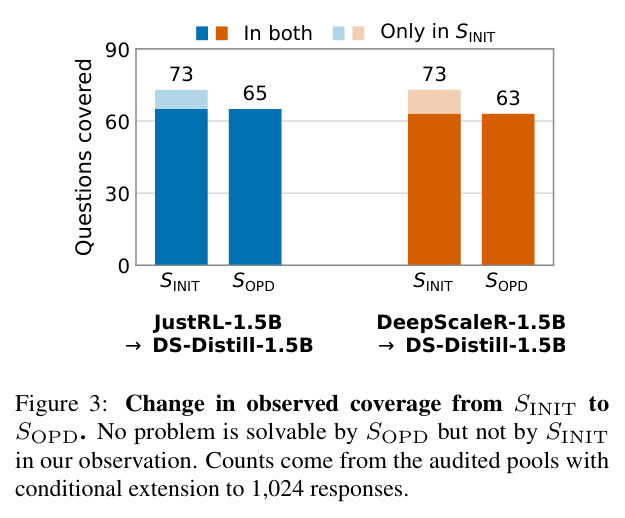
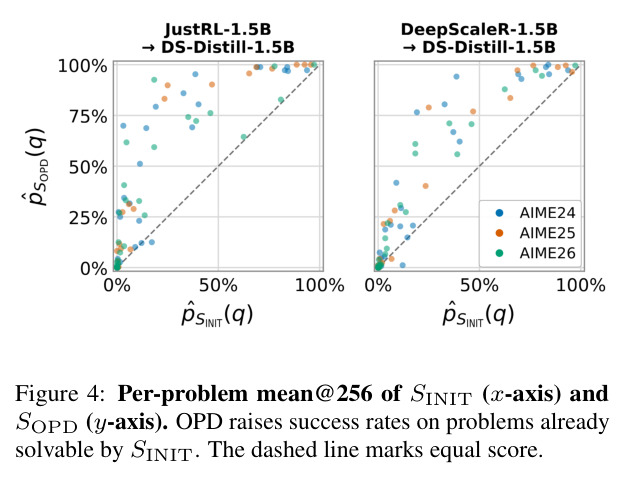
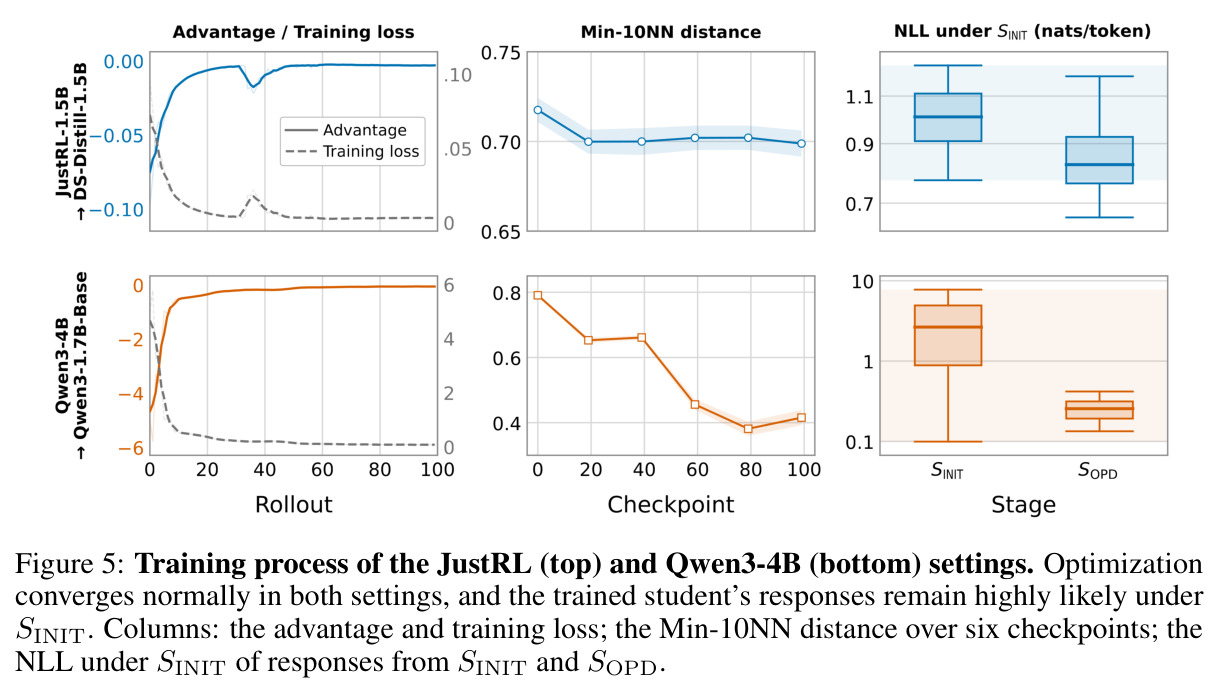
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数学推理(AIME24-26)能力边界审计 | 审计后覆盖问题数 | 73 个可解问题中 S_OPD 覆盖 65(JustRL 教师)/63(DeepScaleR 教师),无 OPD 独有可解题 | 初始学生 S_INIT 扩充采样后覆盖全部 73 题 | 0,证明无能力扩展,增益全部来自既有能力的采样效率 |
| 数学推理(AMC23+AIME24-26,JustRL-1.5B 教师) | 准确率(mean@4) | S_OPD 达 37.1% | S_INIT 为 20.9% | +16.2 个百分点,接近教师本身的 39.3% |
| 数学推理(Qwen3-4B 教师坍塌设置) | 准确率 / 截断率 / 重复率 | S_OPD 为 5.4% / 99.4% / 38.0%,长度 8.16k | S_INIT 为 0.2% / 4.1% / 4.2%,长度 1.18k | 准确率 +5.2 个点但行为严重退化为奖励黑客,远差于教师(截断 2.1%、重复 0%) |
| Qwen3-4B 蒸馏 Base + masking | 五基准平均准确率 | 13.24% | 无 masking 的 OPD 为 10.16% | +3.08 个百分点,训练后期从坍塌中恢复 |
| Qwen3-8B / Qwen3-30B-A3B 蒸馏 Base + masking | 五基准平均准确率 | 10.92%(8B)/ 13.07%(30B-A3B) | 10.41%(8B)/ 10.49%(30B-A3B) | +0.51 / +2.58 个百分点,但 8B 下 AIME25、AIME26 个别下降 |
| Qwen3-4B 蒸馏 Qwen3-1.7B-SFT(warmup) | 五基准平均准确率 | 16.38% | Qwen3-4B 蒸馏 Base 为 10.16% | +6.22 个百分点,全程避免坍塌,为所有设置中最佳 |
局限与改进
作者承认的局限:实验仅覆盖小模型(学生 1.5B/1.7B,教师最大 30B-A3B)和数学推理任务,结论能否推广到更大模型和其他领域未知;masking 与 SFT warmup 是针对超长加重复这一特定病态设计的干预,主要用于验证解释而非提出通用解法;覆盖性结论基于有限采样(每题最多 1024 次),更大预算或不同解码设置仍可能从初始模型中挖出新解。我自己的观察:其一,masking 以撞生成长度上限作为病态判据过于粗糙,确实需要长链思考的难题上合法的长推理可能被误杀,这或许能解释 8B 教师下 AIME25、AIME26 反而从 3.33%、5.00% 降到 2.50%、3.33%;其二,优势十分位与选择间隙都依赖 $S_{\mathrm{INIT}}$ 的 rollout 分布,结论严格说是教师对 Base 学生评估不可靠,warmup 可能只是掩盖而非消除教师偏置;其三,学生全部来自 Qwen 系,未验证跨家族泛化;其四,未研究教师打分温度 $\tau_T$ 等超参对隐式奖励可靠性的影响,也没有与离线蒸馏等替代方案做成本收益对比。
独立分析的弱点
最值得挑剔的是 masking 规则的设计:只屏蔽撞到生成上限的回复,而坍塌前兆(长度持续膨胀)在未触顶时已经出现,干预属于事后止血而非事前预防,且对需要长推理的任务有误伤风险,8B 教师下 AIME25、AIME26 的回落可能正是误伤所致。改进方向是引入长度感知的优势去偏(类似 RLVR 中的 length-debiased advantage),或对教师优势与回复质量的一致性做在线监测与动态加权。第二,作者把坍塌归因于教师偏好偏置,但证据链是相关性式的(训练前高分回复病态、训练中被放大),缺少因果隔离实验,例如人工纠偏教师分数或换用校准后的奖励再训练,验证坍塌是否随之消失。第三,覆盖审计只在 AIME24-26 上进行,题目总量很小(每年 30 题),AMC23 的高 $k$ 结论可能不同,统计功效有限。第四,Min-10NN 与选择间隙等诊断指标计算开销大,且重复文本在嵌入空间中的距离是否可靠未加讨论。第五,warmup 依赖 Li 等人发布的特定 SFT 检查点,两个干预的成功都可能与该检查点的数据配方纠缠,泛化性存疑。
未来方向
作者提出的方向:把结论推广到更大模型与非数学领域;设计通用而非针对特定病态的 OPD 稳定化方法;将评估与训练脚本开源以便复现。基于本文成果可以自然延伸的方向包括:第一,系统研究教师侧变量(规模、RL 训练程度、打分温度 $\tau_T$)对隐式奖励在学生 rollout 上可靠性的影响,构建教师评估可靠性基准,使 OPD 教师选择像 RL 奖励模型选择一样有据可依;第二,把 masking 推广为基于优势与质量一致性的动态样本筛选,或引入教师偏好校准、对比式前缀修正,从奖励端而非候选端消除偏置;第三,理论上刻画隐式奖励下的概率放大动力学,解释为何低 NLL 区的病态行为被优先选择以及坍塌的相变条件;第四,研究多教师与自蒸馏设置下偏好偏置的传播与放大规律;第五,把覆盖审计方法(追加采样加人工复核)标准化为量化各类后训练方法对能力边界真实影响的通用协议。
复现评估
复现条件相当好。代码已在 GitHub 开源(HancCui/opd_hacking),项目主页同步提供;所有模型公开:教师 JustRL-1.5B、DeepScaleR-1.5B-Preview、Qwen3-4B/8B/30B-A3B,学生 DeepSeek-R1-Distill-Qwen-1.5B、Qwen3-1.7B-Base,以及 Li 等人发布的 Qwen3-1.7B-SFT 检查点;数据集 DeepMath-103K(难度不低于 6 子集)与 OpenThoughts3 公开;训练框架 Slime 开源,关键超参完整(100 个 rollout 迭代、参考 KL 系数 0.001、16384/8192 token 上限),附录给出完整训练评估协议、覆盖审计、Min-10NN、十分位分析与干预细节。主要门槛是算力:蒸馏 1.5B-1.7B 学生 100 个迭代需要多卡集群;pass@k 分析每题 256 至 1024 次采样外加 768 次追加采样,推理开销不小;人工审计推导环节也无法完全自动化。只想复刻核心诊断(优势十分位、选择间隙)的研究者可用更小模型和少量题目低成本验证。
论文图表
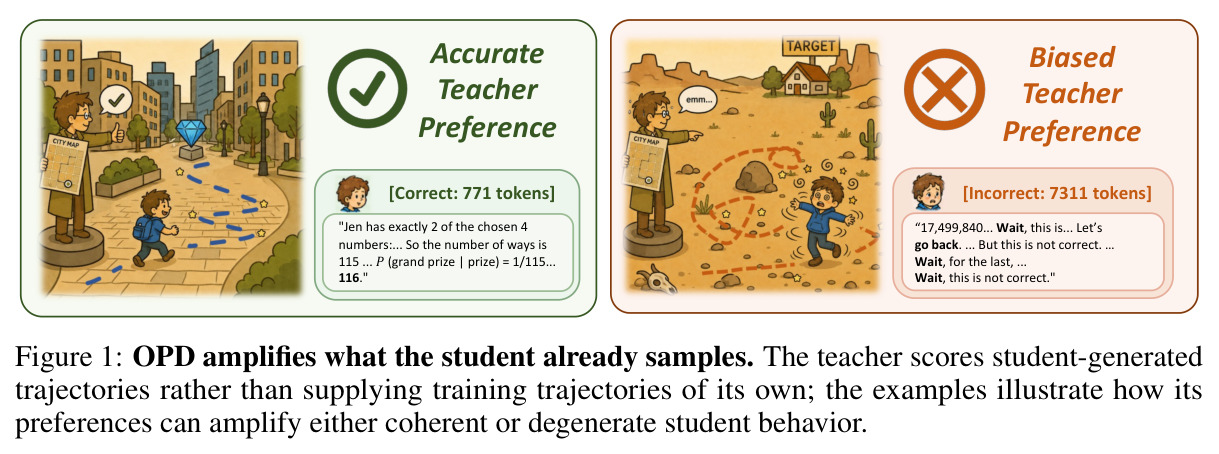
示意图对比两种教师偏好下 OPD 的不同结局:偏好准确的教师(Accurate Teacher Preference)会放大一条 771 token 的正确简洁解答,而偏好偏置的教师(Biased Teacher Preference)会放大一条 7311 token、充满来回自我怀疑的错误冗长回复,尽管教师自己很少生成这类文本。
这是全文论点的直觉总纲:教师只对学生已采样的轨迹打分而非提供自己的训练轨迹,其偏好既可以放大健康行为也可以放大退化行为,为后续所有分析提供心智模型。