LastOPD:驯服潜在在线策略蒸馏中的坍塌 LastOPD: Taming Collapse in Latent On-Policy Distillation
只对齐最后一层隐状态并在10步内淡出潜在监督,保住早期增益且避免训练坍塌。
前置知识
在线策略蒸馏(On-Policy Distillation, OPD)
让学生模型自己采样回答,再由冻结教师对学生实际生成的每个 token 的下一词分布打分,通常以 KL 散度为损失(本文用 reverse top-k 形式,$k=16$:在学生自己的 top-k 支撑集上算学生与教师分布的反向 KL)。由于每次纠错都落在学生自己产生的上下文上,避免了离线蒸馏模仿教师文本带来的 exposure bias。
LastOPD 的 token 级损失项就是这一形式,理解 OPD 才能明白潜在信号是加在什么基线上、交叉淡出最终交棒给了谁。
潜在(特征)蒸馏
源自 FitNets 的思路:选一对师生层,用投影器对齐宽度后,以 L2 距离把学生隐状态拉向教师隐状态,期望行为收益随之而来。OPRD 把这一前提带入在线策略框架:按相对深度配对全部层、冻结低秩投影器(OPRD-Bridge),同架构时无需投影器(OPRD-Vanilla)。
本文研究的正是这种潜在信号在 OPD 中先增益后坍塌的现象,方法设计(在哪对齐、何时关掉)全部围绕它展开。
CKA(Centered Kernel Alignment,中心核对齐)
衡量两组激活矩阵表示相似性的指标,对线性变换不敏感,取值约 0 到 1,越接近 1 表示两个层编码的表示结构越相似。常用来画 layer-to-layer 相似度热图,为跨模型配对层提供依据。
论文用逐层 CKA 热图判断师生层是否功能对应,并发现其读数被巨大激活维度严重夸大(4B 对中层已达 0.98-0.99),这是诊断部分的关键证据。
巨大激活(Massive Activations)
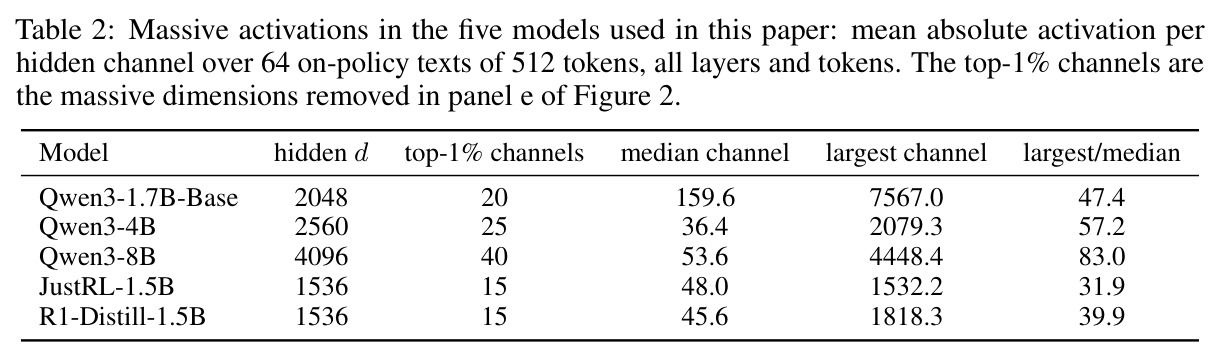
LLM 中极少数隐藏维度的激活值远高于中位数(与 attention sink 相关)。本文测得五个模型的最大通道激活是中位通道的 31.9 到 83.0 倍(如 Qwen3-8B 为 83 倍)。这几个维度可主导 CKA、余弦相似度等指标,使对齐读数虚高,掩盖真实的功能差异。
它是『对齐持续上升但行为变差』这一假象的重要来源:掩掉前 1% 通道后,第一步投影余弦从 0.88 跌到 0.29,说明高对齐大部分是假象。
J-Lens(逐层读出)
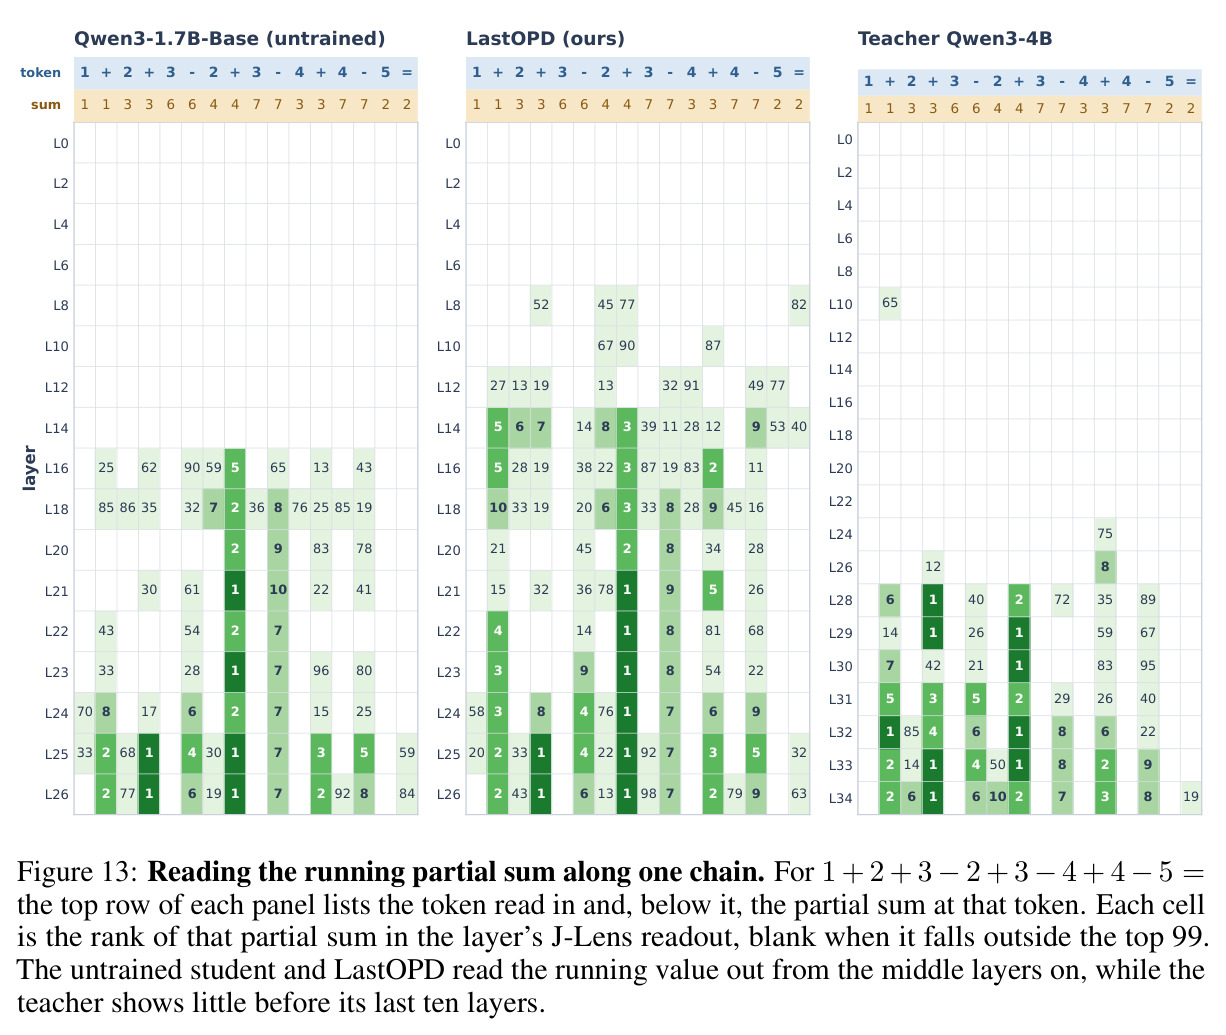
类似 logit lens 的可解释性工具:为模型每一层拟合一个解码器,把该层隐状态直接映射到词表上的下一词 logits,从而观察信息在哪一层『浮出』到可读空间。配合线性探针还能检测层里『知道但没说出』的信息。
论文用它揭示教师『早知道、晚说出』而学生『边算边说』的层角色错位,这是解释坍塌成因、支撑 LastOPD 设计的核心证据。
研究动机
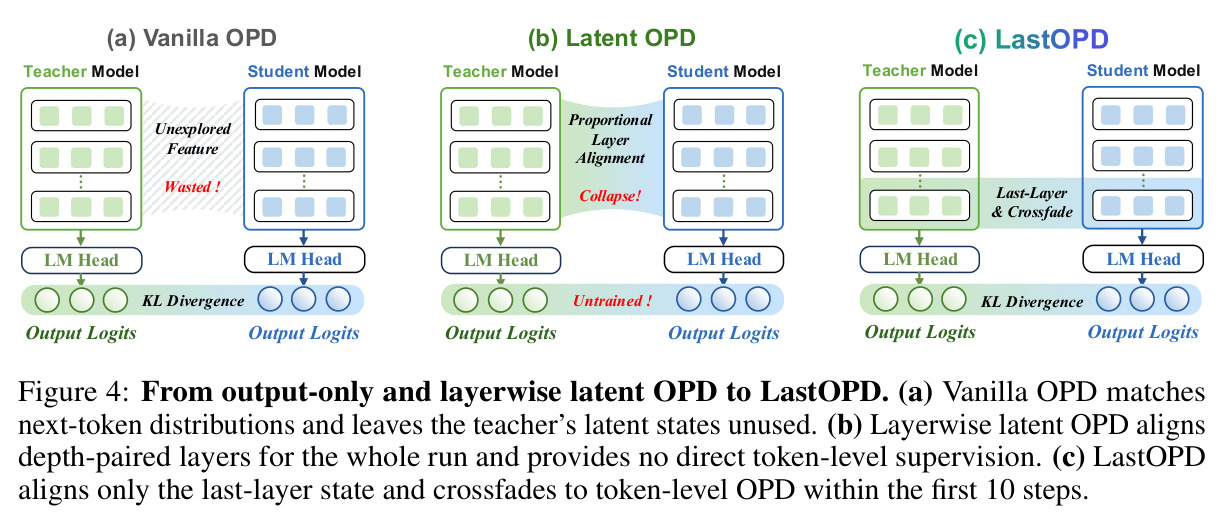
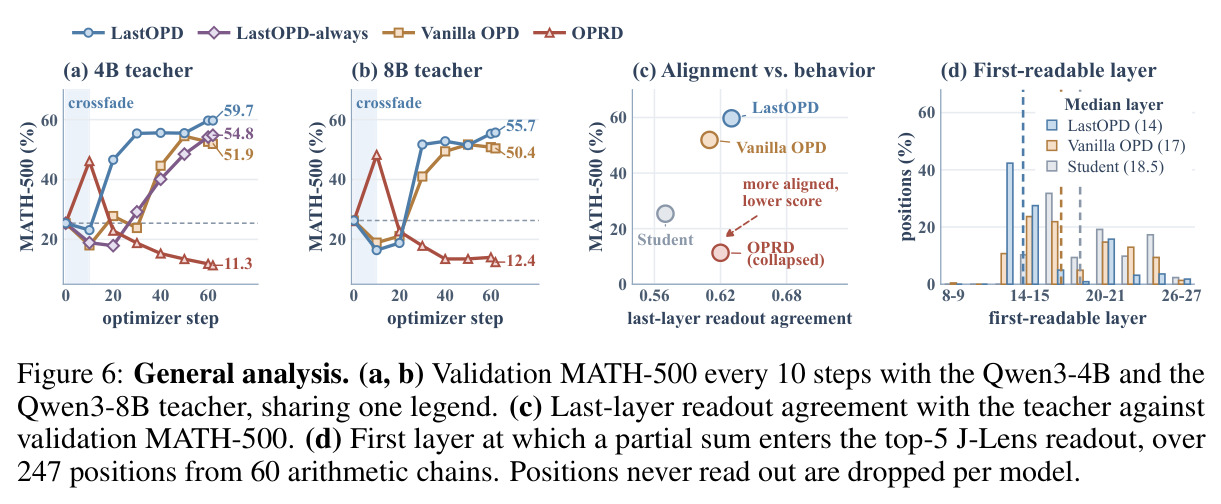
在线策略蒸馏传递的信号只有一个:教师读到 LM head 之后的下一词分布。它只告诉学生教师『说什么』,却丢失了教师『怎么想』——每个 token 背后的计算停留在 LM head 上游的隐状态里,从未被打分。为补上这块信息,OPRD 等方法把潜在监督引入 OPD,按相对深度逐层对齐师生隐状态。但作者在把 Qwen3-4B 和 Qwen3-8B 蒸馏进 Qwen3-1.7B-Base 时观察到两个失败现象。其一『先增益后坍塌』:仅用潜在监督(OPRD-Bridge)在 10 步内把 MATH-500 从 25.4 拉到 46.2,比同期 token-only OPD 高 28 分,但继续训练到 62 步跌至 11.3(官方 12.12),比未训练学生的 24.45 还低,延长到 150 步后从第 70 步起在 9.4–10.8 徘徊、毫无恢复。其二『对齐越好行为越差』:全层损失优化的投影余弦在精度见顶后仍从 0.97 升到 0.98(8B 教师从 0.95 到 0.98),而 4B 实验的 MATH-500 同期跌了约 35 分;更反直觉的是,未训练学生与教师的中层 CKA 已高达 0.99,两者得分却是 24.5 对 82.9。
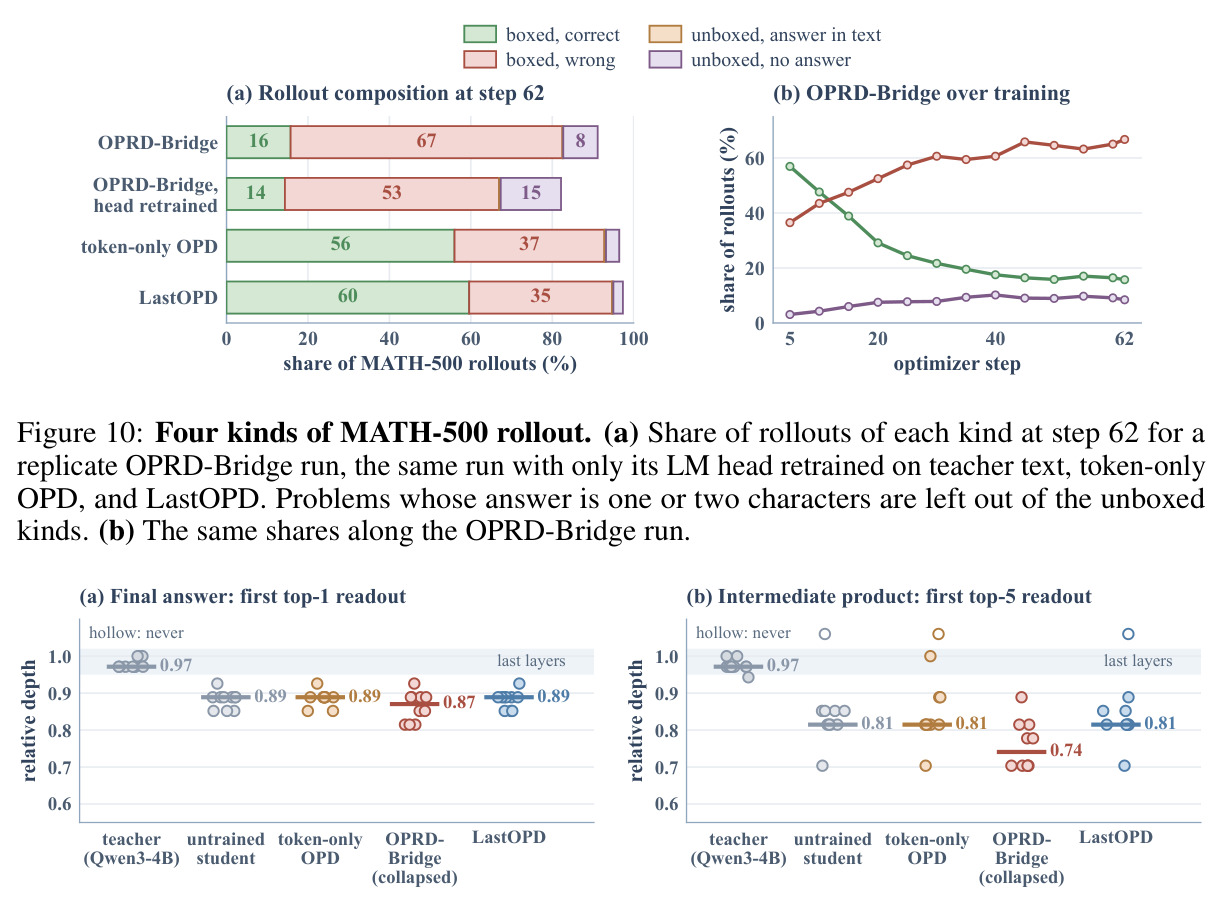
本文的目标是本文要回答一个核心问题:在线策略蒸馏如何既留住潜在监督带来的早期增益,又不陷入后续坍塌。具体拆成三步。第一步,确认坍塌的性质:把 OPRD-Bridge 延长到 150 步,确认坍塌持续且表现为大量『格式完好但算错』的简短答案(rollouts 中约 66.8% 是 boxed 错误答案,只有 8.5% 是死循环),而非沉默或乱码。第二步,找出坍塌原因:检验『按深度配对的层在两个模型中做同样的工作』这一潜在蒸馏的隐含前提是否成立——用 J-Lens 逐层读出、算术线性探针、逐层 CKA 热图和巨大激活统计,确定师生各层分别在哪一层『知道』答案、在哪一层『说出』答案,以及测得的相似度有多少是巨大激活造成的虚高。第三步,在诊断基础上设计一个无需层配对、推理零开销、跨架构可用的方法,把潜在信号有益的部分留下来、有害的阶段避开,并在三个师生组合上验证相对 token-only OPD 与持续联合监督的净增益。
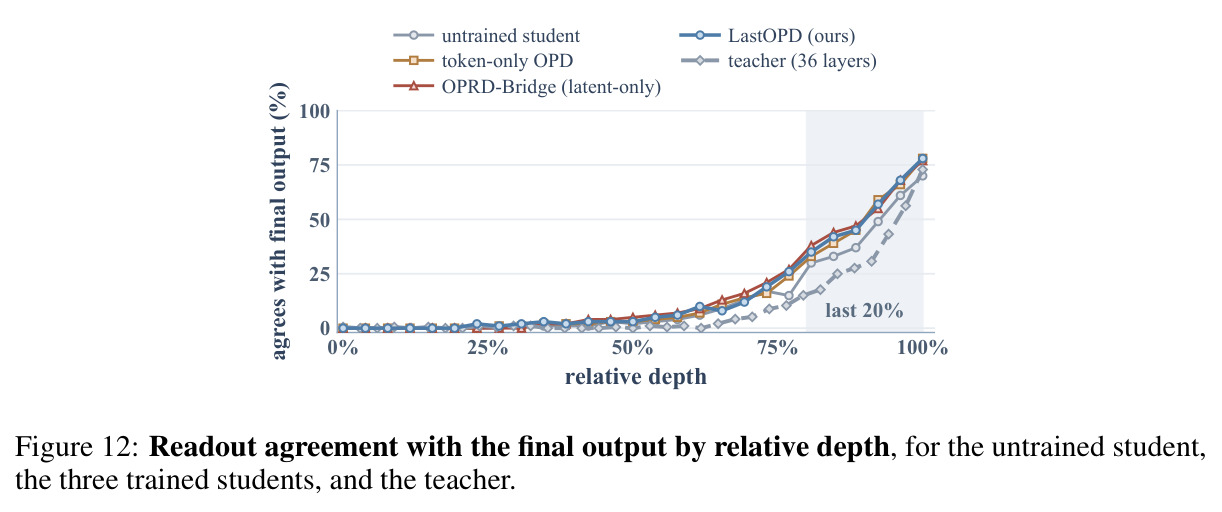
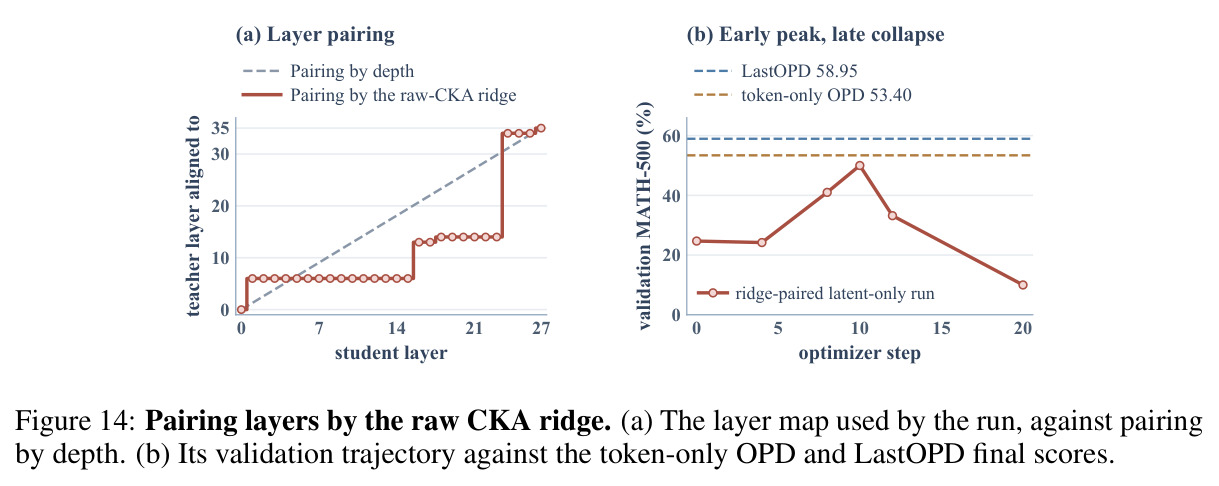
与已有工作不同的是,从 FitNets 起,潜在蒸馏建立在单一前提上:选层、拉齐、行为收益自然到来。OPRD、LOPD、PHF 等并发工作都把这个前提搬进在线策略框架,却没人追问两件事:对深度和宽度都不同的师生对,那个对齐目标到底够不够得着?就算暂时够得着,它还能帮多久?本文的独特切入是先诊断、后设计。诊断给出两个否定性发现:一是角色错位——J-Lens 显示教师『早知道、晚说出』(线性探针第 9 层就达 94% 准确率,但答案要到约 97% 深度才可读出),学生『边算边说』(从第 12 层起逐渐读出),同深度的层做着不同的事;二是相似度虚高——前 1% 巨大激活通道把 4B 对的中层 CKA 抬到 0.98(掩掉后第一步投影余弦从 0.88 掉到 0.29),而同源对照组的对角 CKA 真实达到 0.983。进一步证明掩码(11.33→5.60)和按 CKA 脊线重新配层(第 20 步即坍塌)都救不了潜在-only 训练,因为它们仍不监督学生的下一词预测。这把矛头指向『信号施加的位置与时长』而非对齐目标本身,自然引出『只在最后一层、只在前 10 步』的 LastOPD。
核心方法
直觉上,潜在监督像一剂猛药:最初几步能迅速把学生拉向教师的『思维方式』带来增益,但持续对齐会把学生拖向它理解不了的教师状态,最终损害预测。LastOPD 的对策是给这剂药限定位置和疗程。技术上极简:保留标准在线策略蒸馏的 reverse top-k token 损失 $\mathcal{L}_{\mathrm{OPD}}$($k=16$),再在两个模型 LM head 之前的最后一层隐状态上加对齐项。设 $z_{S,t}$、$z_{T,t}$ 为位置 $t$ 的最后一层状态,用小型可训练 MLP $g_\psi:\mathbb{R}^{d_S}\to\mathbb{R}^{d_T}$ 弥合宽度差(宽度相同时为恒等映射),以 L2 距离把投影后的学生状态拉向教师状态(向量先经 $\nu(z)=z/(\lVert z\rVert_2+\epsilon)$ 归一化,教师侧加 stop-gradient)。关键在调度:前 $T_w=10$ 步内 $\mathcal{L}_t=\alpha(t)\mathcal{L}_{\mathrm{OPD}}+\lambda_{\mathrm{rep}}\beta(t)\mathcal{L}_{\mathrm{rep}}$,潜在权重 $\beta(t)=\max(0,1-t/T_w)$ 线性降到 0,token 权重 $\alpha(t)=\min(1,t/T_w)$ 线性升到 1。第 0 步只有潜在项,第 10 步起就是纯 token-only OPD;投影器推理时直接丢弃。
核心创新是把潜在信号的施加同时限定在『哪里』和『何时』两个维度。『哪里』:只对齐最后一个 post-normalization 隐状态——无论模型多深多宽,两个 LM head 读的都是这个状态,它是通往下一词预测的共同接口,因此完全绕开『哪层配哪层』的难题,也不再需要冻结投影器。『何时』:潜在项只在前 10 步起作用——10 恰是诊断实验中 latent-only 蒸馏达到峰值(46.2)的步数——随后线性交棒给 token 级监督,在坍塌发生之前把学生交还给行为信号。这与 OPRD 的本质区别在于:OPRD 假设按相对深度配对的层做同样的工作,并在整个训练中保持全层潜在损失;LastOPD 则假设跨架构模型只有最后一层状态是功能对应的,且潜在信号的有益成分在最初几步就被吸收,之后继续对齐只会把学生拉向它理解不了的状态。同源对照实验支持这一解释:当各层本来就对应(对角 CKA 0.983)时,潜在项全程开着反而最好(MATH-500 87.22 全场最佳),说明问题不在潜在信号本身,而在它是否被用在真正对应的接口上、是否及时收手。
方法步骤详情
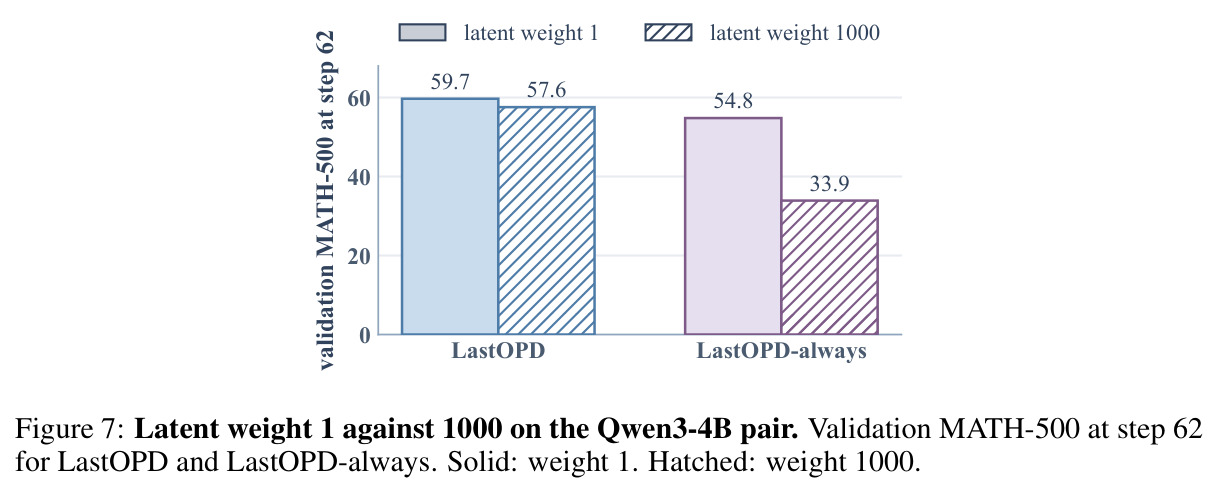
完整训练流程如下。第一步,准备:教师冻结,学生为 Qwen3-1.7B-Base,师生共享 tokenizer;数据为 DAPO-Math-17k,Qwen3 非思考模式;每步抽 32 个 prompt、各采样 4 条回答(温度 1.0,上限 8192 token),共 62 步、约 7.9k 条 rollout,学习率 $10^{-5}$。第二步,前向:学生在自己的 rollout 上计算各位置的下一词分布 $p_{\theta,t}$ 与最后一层隐状态 $z_{S,t}$;教师在前 10 步还需提供 $z_{T,t}$ 与候选 token 打分。第三步,合成损失:第 0 步只有潜在项;前 10 步潜在权重线性降至 0、token 项(学生 top-16 候选上的反向 KL)权重线性升至 1;跨尺寸对取 $\lambda_{\mathrm{rep}}=1$,同源 1.5B 对按 OPRD 惯例取 1000。第四步,更新:梯度同时更新学生参数 $\theta$ 与投影器 $\psi$,教师始终冻结。第五步,收尾:第 10 步起进入纯 token-only OPD 直至 62 步结束,此后不再需要教师隐状态,成本与标准 OPD 相同;推理时丢掉投影器,学生结构与原模型完全一致。评估固定在最终 checkpoint——刻意不挑中间峰值,因为峰值之后可能坍塌。
技术新颖性
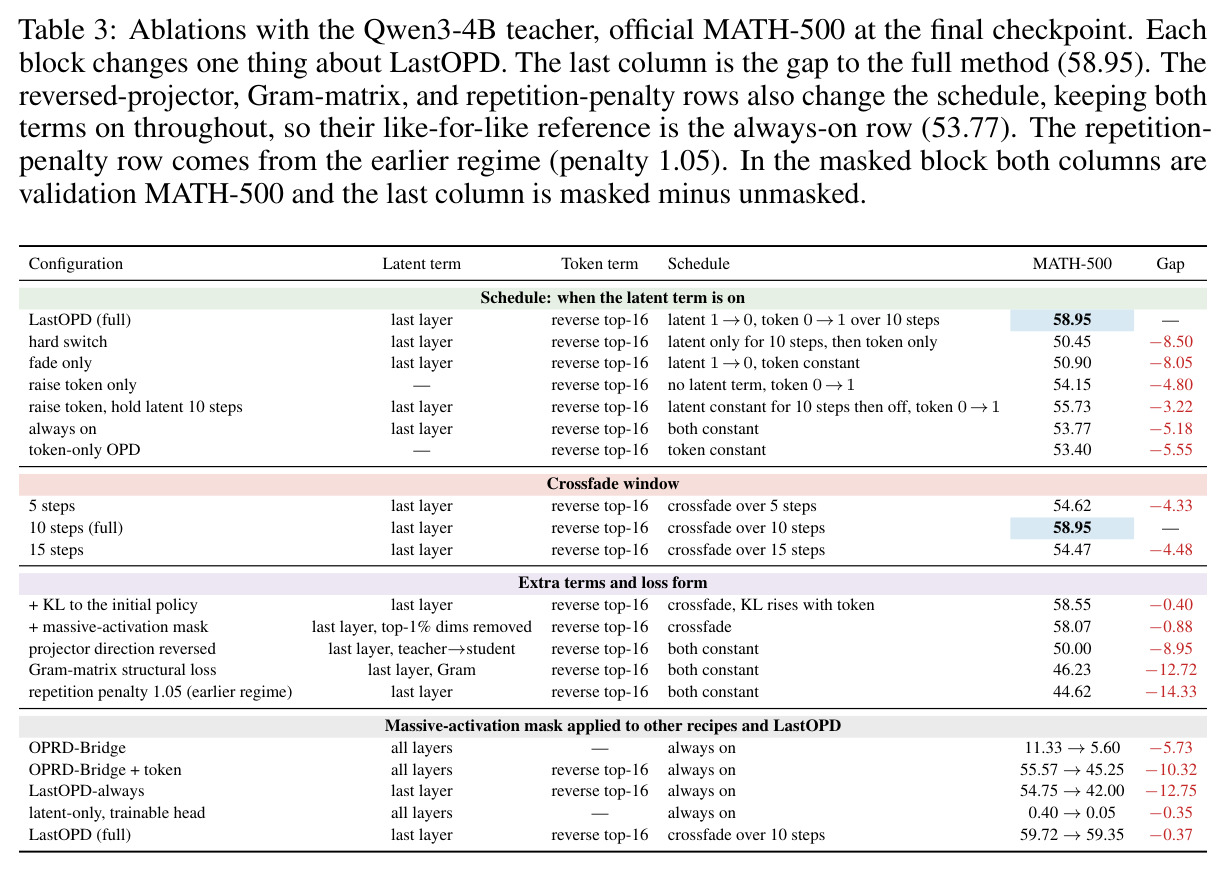
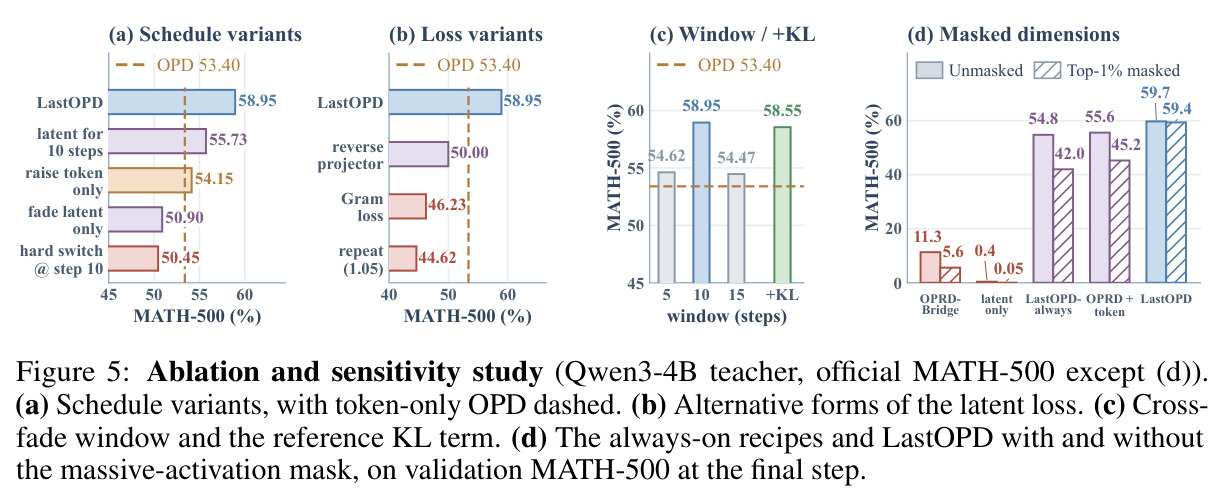
新颖性体现在三个层面。现象学上,首次系统记录了潜在 OPD 的『早增益晚坍塌』与『对齐-行为脱钩』,并证明两个看似合理的修复都无效:把巨大激活从潜在损失中掩掉(11.33→5.60)、按原始 CKA 脊线重新配层(第 10 步冲到约 50、第 20 步即坍塌)——它们的共同点是仍然只监督隐状态,从不监督学生的下一词预测,而唯一能稳住学生的改动恰是补上 token 项(OPRD-Bridge 12.12→53.70)。诊断方法上,把 J-Lens 读出、算术线性探针(教师第 9 层探针达 94% 而读出在 63% 深度才启动)、逐层 CKA 与巨大激活统计(五个模型最大/中位通道比 31.9–83.0)串成完整证据链,提出『教师早知道晚说出、学生边算边说』的角色错位解释。方案上,不修复对齐而是限制定位与时长,看似简单实则反直觉:消融显示交叉淡出两个半程缺一不可(硬切换 50.45、只淡出 50.90、只升 token 54.15、恒定 latent 10 步 55.73,均低于完整的 58.95),且 5/15 步窗口、反向投影器、Gram 矩阵损失、加 KL 正则五种变体全部更差。
实验结果
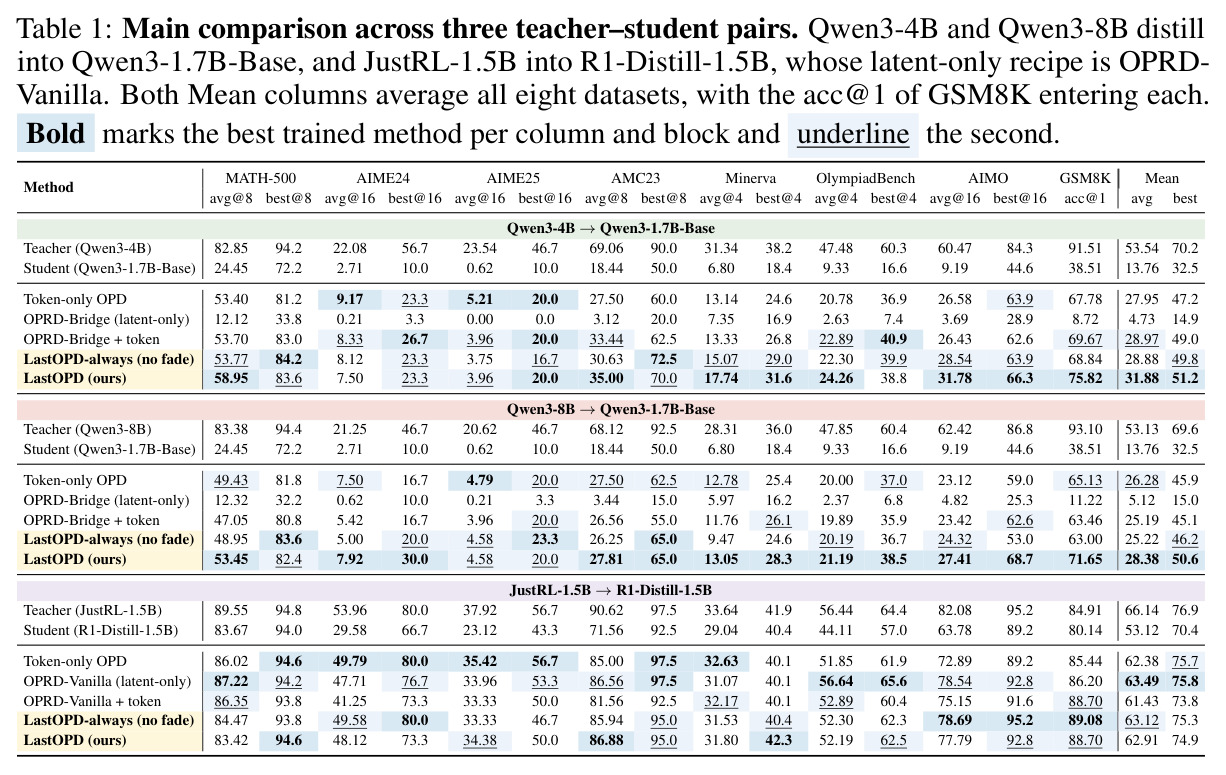
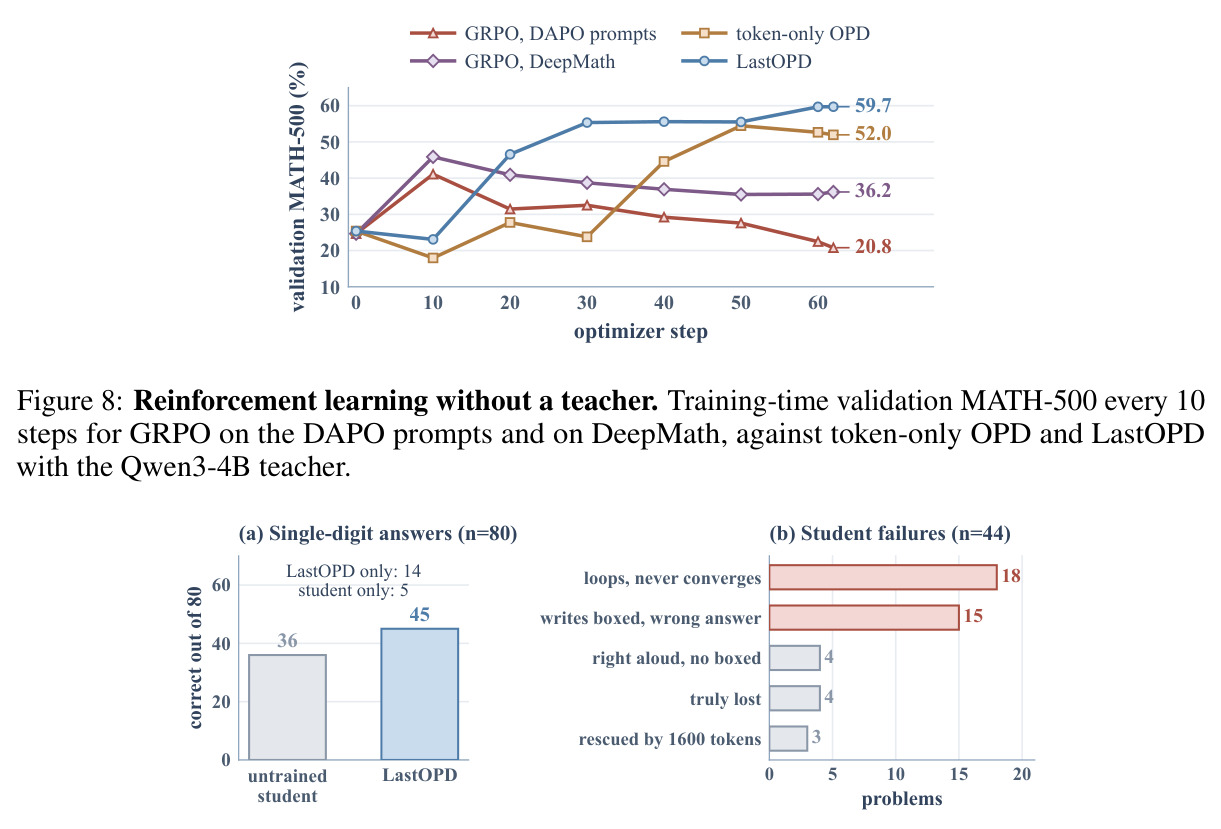
主实验(Table 1,每格为最终 checkpoint 单次运行)。4B 教师块:LastOPD 在 MATH-500 avg@8 达 58.95,超 token-only OPD(53.40)5.55 分;latent-only OPRD-Bridge 坍塌至 12.12,低于未训练学生的 24.45;潜在项全程保留的 LastOPD-always 为 53.77,低 5.18 分。8B 块:LastOPD 53.45 对 OPD 49.43(+4.02),always 为 48.95。泛化:其余 7 个数据集分别领先 5/6 个,最多多 8.0/6.5 分;八数据集平均 31.88/28.38 对 27.95/26.28,best@N 均值 51.2/50.6 对 47.2/45.9。效率:LastOPD 第 30 步达 55.4(4B)/51.7(8B),已超 OPD 62 步终点(51.9/50.4),约一半步数追平;延长到 150 步仍稳定在 57 附近,OPRD-Bridge 停在 9–11。同源对照:latent-only OPRD-Vanilla 反而全场最佳(87.22),LastOPD 83.42,但八数据集均值 62.91 距最佳 63.49 仅 0.58。消融证实交叉淡出两个半程缺一不可(硬切换 50.45、只淡出 50.90、只升 token 54.15,对完整的 58.95),窗口 5/15 步掉 4 分以上,巨大激活掩码伤所有 always-on 配方却几乎不动 LastOPD(59.72→59.35)。诊断:期末最后一层 CKA 上 LastOPD(0.546)反而略低于 OPD(0.570);无教师 GRPO 也从峰值 41.1 衰减到 20.8;LastOPD 把部分和首次可读层中位数从 18.5/17 提前到 14。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MATH-500(Qwen3-4B → Qwen3-1.7B-Base) | avg@8 准确率(%) | 58.95 | 53.40(token-only OPD) | +5.55 |
| MATH-500(Qwen3-8B → Qwen3-1.7B-Base) | avg@8 准确率(%) | 53.45 | 49.43(token-only OPD) | +4.02 |
| 八个留出数据集平均(4B 教师) | avg 准确率(%) | 31.88 | 27.95(token-only OPD) | +3.93 |
| 八个留出数据集平均(8B 教师) | avg 准确率(%) | 28.38 | 26.28(token-only OPD) | +2.10 |
| 八个留出数据集平均(4B / 8B 教师) | best@N 均值(%) | 51.2 / 50.6 | 47.2 / 45.9(token-only OPD) | +4.0 / +4.7 |
| 训练效率(4B / 8B 教师) | 追平 token-only OPD 62 步最终分所需步数 | 约 30 步 | 62 步 | 步数约减半 |
| MATH-500(JustRL-1.5B → R1-Distill-1.5B 同源对) | avg@8 准确率(%) | 83.42 | 87.22(OPRD-Vanilla latent-only,该对最佳) | −3.80(八数据集均值仅落后最佳 0.58) |
局限与改进
作者承认且实验可见的局限:其一,固定 10 步交叉淡出对同源对是净损失——那对模型中层本来就对应(对角 CKA 0.983),latent-only OPRD-Vanilla 全程开着反而全场最佳(87.22 对 LastOPD 83.42),说明『何时收手』应依师生相似度自适应;其二,$T_w=10$ 是在 MATH-500 验证协议上选定的,窗口改为 5 或 15 步就掉 4 分以上,对超参较敏感且带轻微事后选择嫌疑(好在其余 7 个数据集构成独立证据);其三,全部实验在数学推理域,跨尺寸对仅限 Qwen3 家族加一个 1.5B 同源对照,未验证代码、指令跟随等能力;其四,每格只有单次运行、无方差报告,训练-时间验证分与官方分约有 2 分偏差;其五,坍塌机理仍停留在『教师状态含学生理解不了的部分』这一假设层面,没有形式化定义或因果验证。我自己的观察:J-Lens 与算术探针都是个位数算术的玩具设定,向真实推理链外推的证据强度有限;GRPO 无教师也从 41.1 衰减到 20.8,暗示部分问题可能是通用的在线策略训练不稳定,而论文未与 KL 约束等 RL 稳定化手段做替代对比。
独立分析的弱点
独立分析几点弱点。第一,10 步窗口是手工调出的魔法数字:消融显示 5 步 54.62、15 步 54.47,对窗口高度敏感,且 8B 教师的精度跳升比 4B 晚 10 步,说明不同规模对的最优窗口本身可能不同——改进方向是用在线信号(如潜在增益的边际曲线、boxed 错误率的前兆上升)自适应控制淡出节奏。第二,『只留最后一层』在同源或相近架构下丢掉了中层监督的真实价值:同源对上 latent-only 全程开着拿到 87.22 全场最佳,说明存在一批『中层对齐有长期收益』的情形被一刀切放弃——改进方向是先用廉价的掩码 CKA 或探针诊断师生层是否功能对应,再在 LastOPD 与全层潜在监督之间做决策。第三,评估全在数学题上,对代码生成、多轮对话、agentic 任务是否同样『加速不减分』完全未知,需复验。第四,单次运行加 8 样本验证协议,±2 分的噪声与 4–5 分的提升相比方差信息不足,应多种子重复并报置信区间。第五,方法只改蒸馏信号,流水线仍需教师逐步打分(前 10 步还要教师隐状态),未与更便宜的序列级蒸馏或稀疏 token 评分变体比较成本-收益。
未来方向
作者提出的与可延伸的方向。作者侧:把交叉淡出思想推广回 LOPD、PHF 等并发潜在蒸馏方法,检验『短窗口』是否普适;进一步刻画教师状态中『学生能理解/不能理解』两部分各是什么(可用 SAE 特征分解验证)。基于本文成果可延伸:一,自适应调度——用对齐增益平台期或坍塌前兆信号在线决定 $\beta(t)$ 的节奏,替代固定 $T_w$,这同时能解决同源对上 10 步淡出的净损失;二,鲁棒对齐度量——设计对巨大激活免疫的表示相似度(掩码空间 CKA、秩相关等),让层配对与坍塌预警建立在干净信号上,本文已证明原始 CKA 会严重误导;三,机制理论——形式化『早知道晚说出』与『边算边说』两种计算组织的差异,预测何种架构组合的潜在对齐可行、何时必然失败;四,蒸馏+RL 混合——GRPO 自身也衰减(41.1→20.8),潜在或 token 蒸馏信号或许可作为 RL 的锚定正则防止策略漂移,值得系统研究;五,领域与规模扩展——把结论推广到代码、多语言、agentic 任务及更大尺寸差距,检验『强化学生自己的思考方式而非替换为教师的』这一核心结论的普适性。
复现评估
复现条件相当好。代码已开源(github.com/Muyiiiii/LastOPD);师生模型均为公开权重(Qwen3-4B/8B、Qwen3-1.7B-Base、JustRL-1.5B、R1-Distill-1.5B);DAPO-Math-17k 与八个评测集公开;附录 A 给出完整超参:62 步、每步 32 prompt×4 rollout、温度 1.0、学习率 $10^{-5}$、$k=16$、跨尺寸对 $\lambda_{\mathrm{rep}}=1$、同源对 1000;评估用温度 0.7、top-p 0.95。算力门槛低:总训练量约 7.9k 条 rollout,只有前 10 步需要教师隐状态,之后教师仅提供 top-16 打分;1.7B 学生加冻结 4B/8B 教师的前向反向,单机多卡(如 8×A100 级)即可复现。主要成本在评估:8 个数据集、avg@4–16 采样、最长 31744 token 生成,以及 J-Lens、探针、CKA 等诊断实验(附录 B 有逐步协议)。风险点:每格为单次运行,验证分与官方分约有 2 分偏差,应对比最终 checkpoint 而非验证峰值;两对模型的权重约定(1 与 1000)易踩坑;MATH-500 同时用于诊断与窗口选择,其余 7 个数据集才是无偏证据。总体属于小算力可复现、难度中等偏低的工作。
论文图表
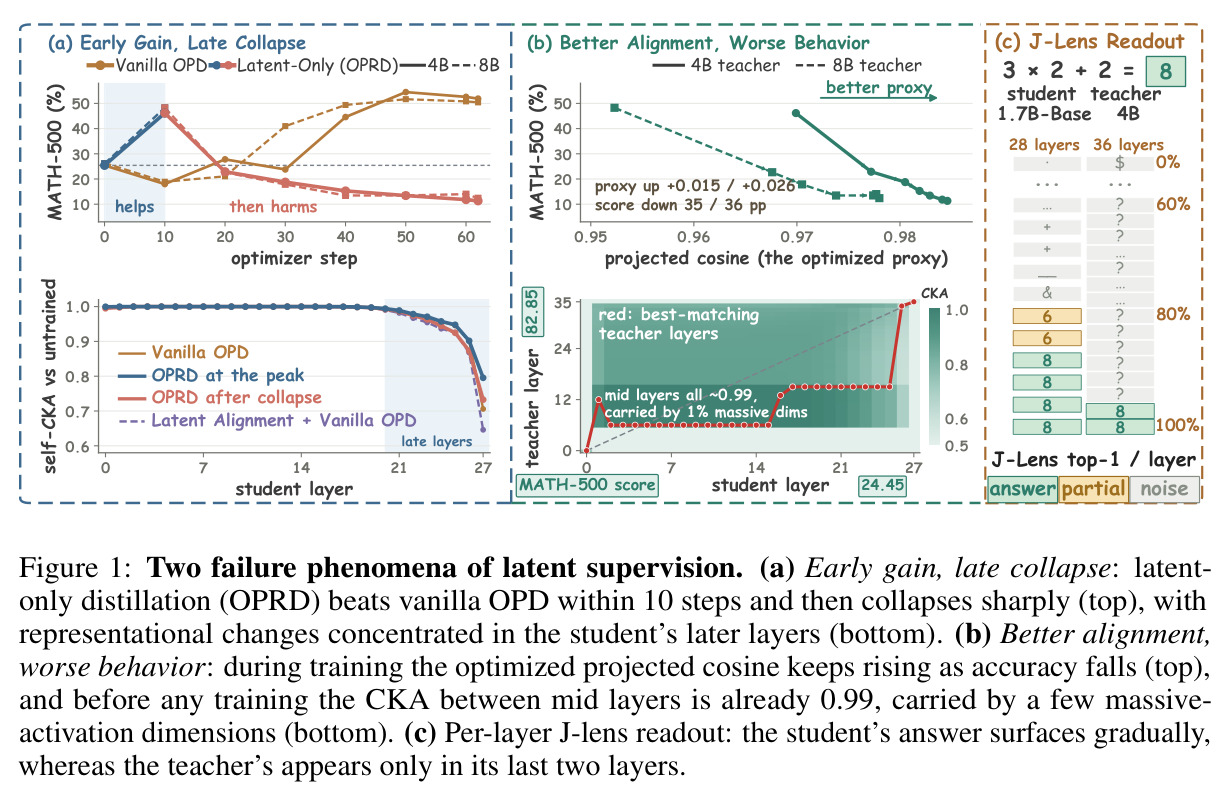
三联图。(a) 先增益后坍塌:latent-only 蒸馏(OPRD)在 10 步内超过 vanilla OPD 达到峰值,随后急剧坍塌至起点以下(上),且表示变化集中在学生后段层(下方的逐层 self-CKA)。(b) 对齐更好、行为更差:训练中投影余弦持续上升而 MATH-500 下降(上);未训练时中层 CKA 已达约 0.99,且被少数巨大激活维度承载(下)。(c) 逐层 J-Lens 读出:学生的答案从中段逐渐浮出,教师的答案只在最后两层出现。
这是全文的提纲图:两个失败现象加上层角色错位的初步证据,构成本文全部动机,后续诊断与方法设计都是对这三个面板的展开。
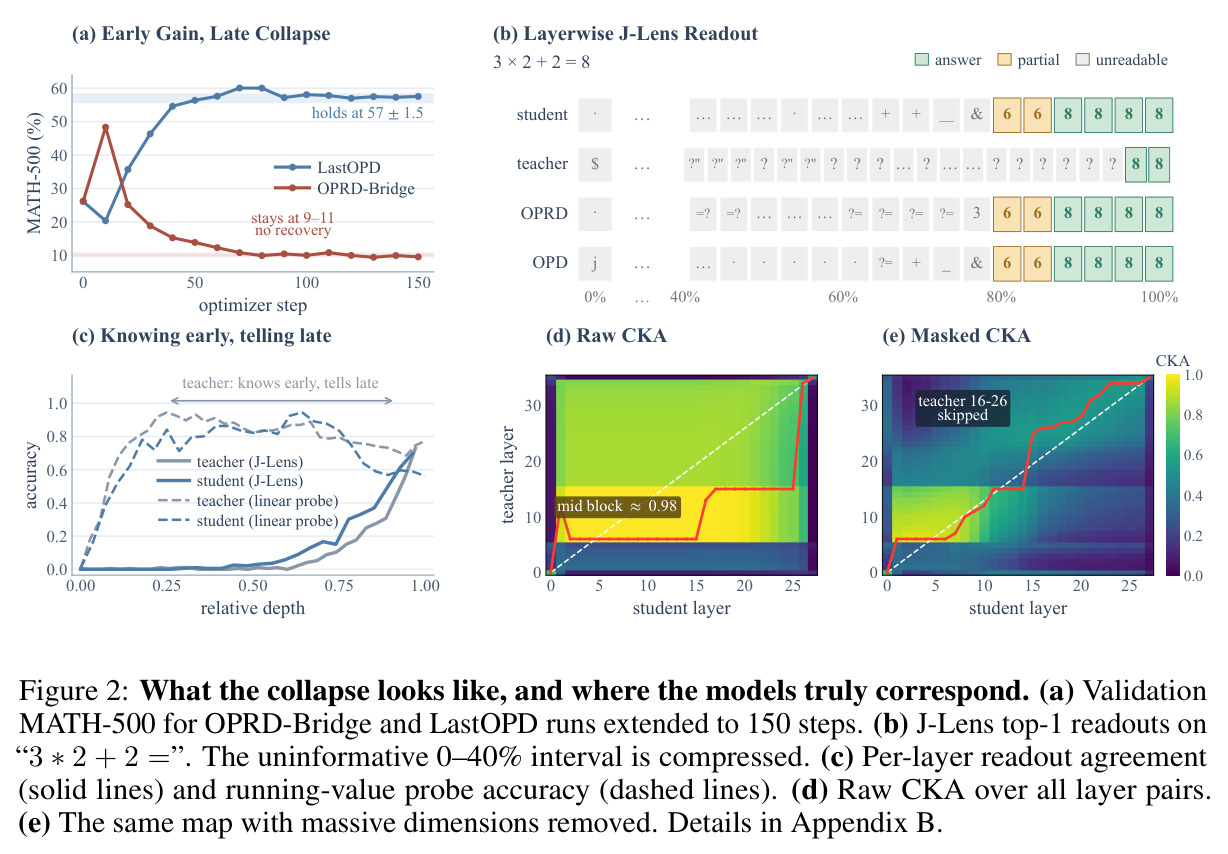
五联诊断图。(a) OPRD-Bridge 与 LastOPD 延长到 150 步的验证曲线:OPRD-Bridge 从第 70 步起停在 9.4–10.8 无恢复,LastOPD 从第 90 步起稳定在约 57。(b) 『3×2+2=』上的逐层 J-Lens 读出:学生先读出中间积 6 再读出答案 8,教师直到最后两层才读出答案。(c) 192 个位置上的逐层读出一致率(实线)与线性探针准确率(虚线):教师探针第 9 层达 94% 但读出在 63% 深度才启动,学生边算边说。(d) 全层对 CKA:中层约 0.98、对比度低。(e) 掩掉巨大维度后的 CKA:脊线靠近对角,但教师 16–26 层从未被选中。
这是诊断部分的核心证据图:同时呈现坍塌的不可逆性、『教师早知道晚说出/学生边算边说』的角色错位、以及原始 CKA 相似度的虚高,直接支撑 LastOPD 的设计动机。
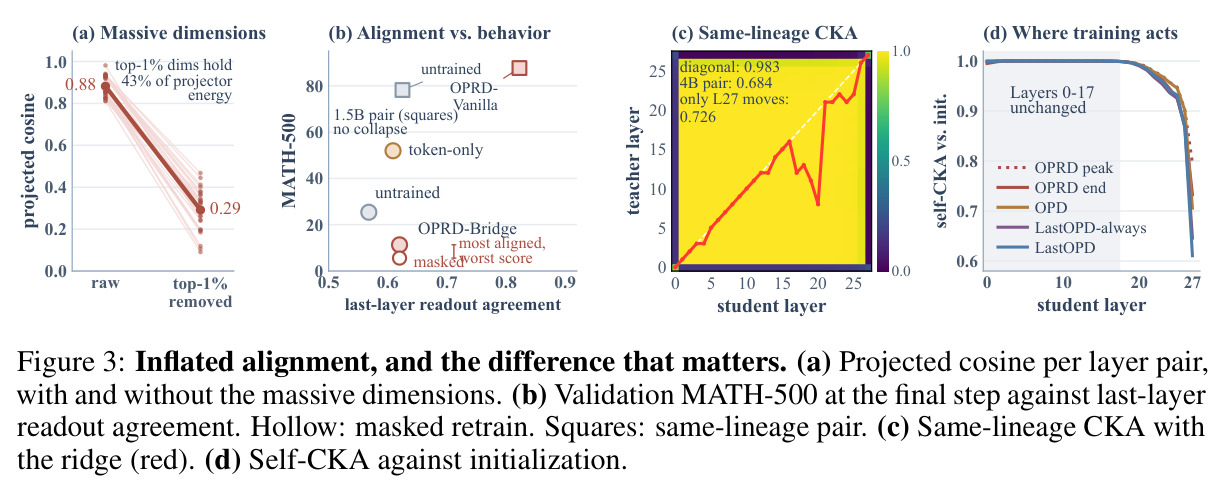
四联图。(a) 各层对的投影余弦:含巨大维度时高达 0.88,掩掉后跌至 0.29,证明高对齐主要由少数维度承载(它们占冻结投影器能量的 43%)。(b) 最终步 MATH-500 对最后一层读出一致率散点:更对齐的模型分数更低,掩码重训(空心点)反而更差。(c) 同源对照组(JustRL-1.5B vs R1-Distill-1.5B)的 CKA 呈清晰对角线 0.983,远高于 4B 对的 0.684。(d) 各配方相对初始化的 self-CKA:OPRD-Bridge 的变化集中在后段层。
量化了『对齐假象』的成因与规模,并用同源对照确立关键分界:层真正对应时潜在监督不坍塌,层不对应时持续对齐有害——这是『最后一层接口』设计的直接依据。
(a) 在 80 道答案为个位数的 MATH-500 题上,LastOPD 贪心解码答对 45 题对未训练学生的 36 题(净胜 14 负 5),且全部正确答案在 600 token 内收尾。(b) 未训练学生的 44 个失败案例以 1600 token 重试后仅 3 题被救回,失败主要是死循环或 boxing 错误答案。
用可机器验证的个位数答案排除解析与截断干扰,细化收益来源:LastOPD 的提升来自真实推理而非格式或更长的尝试。
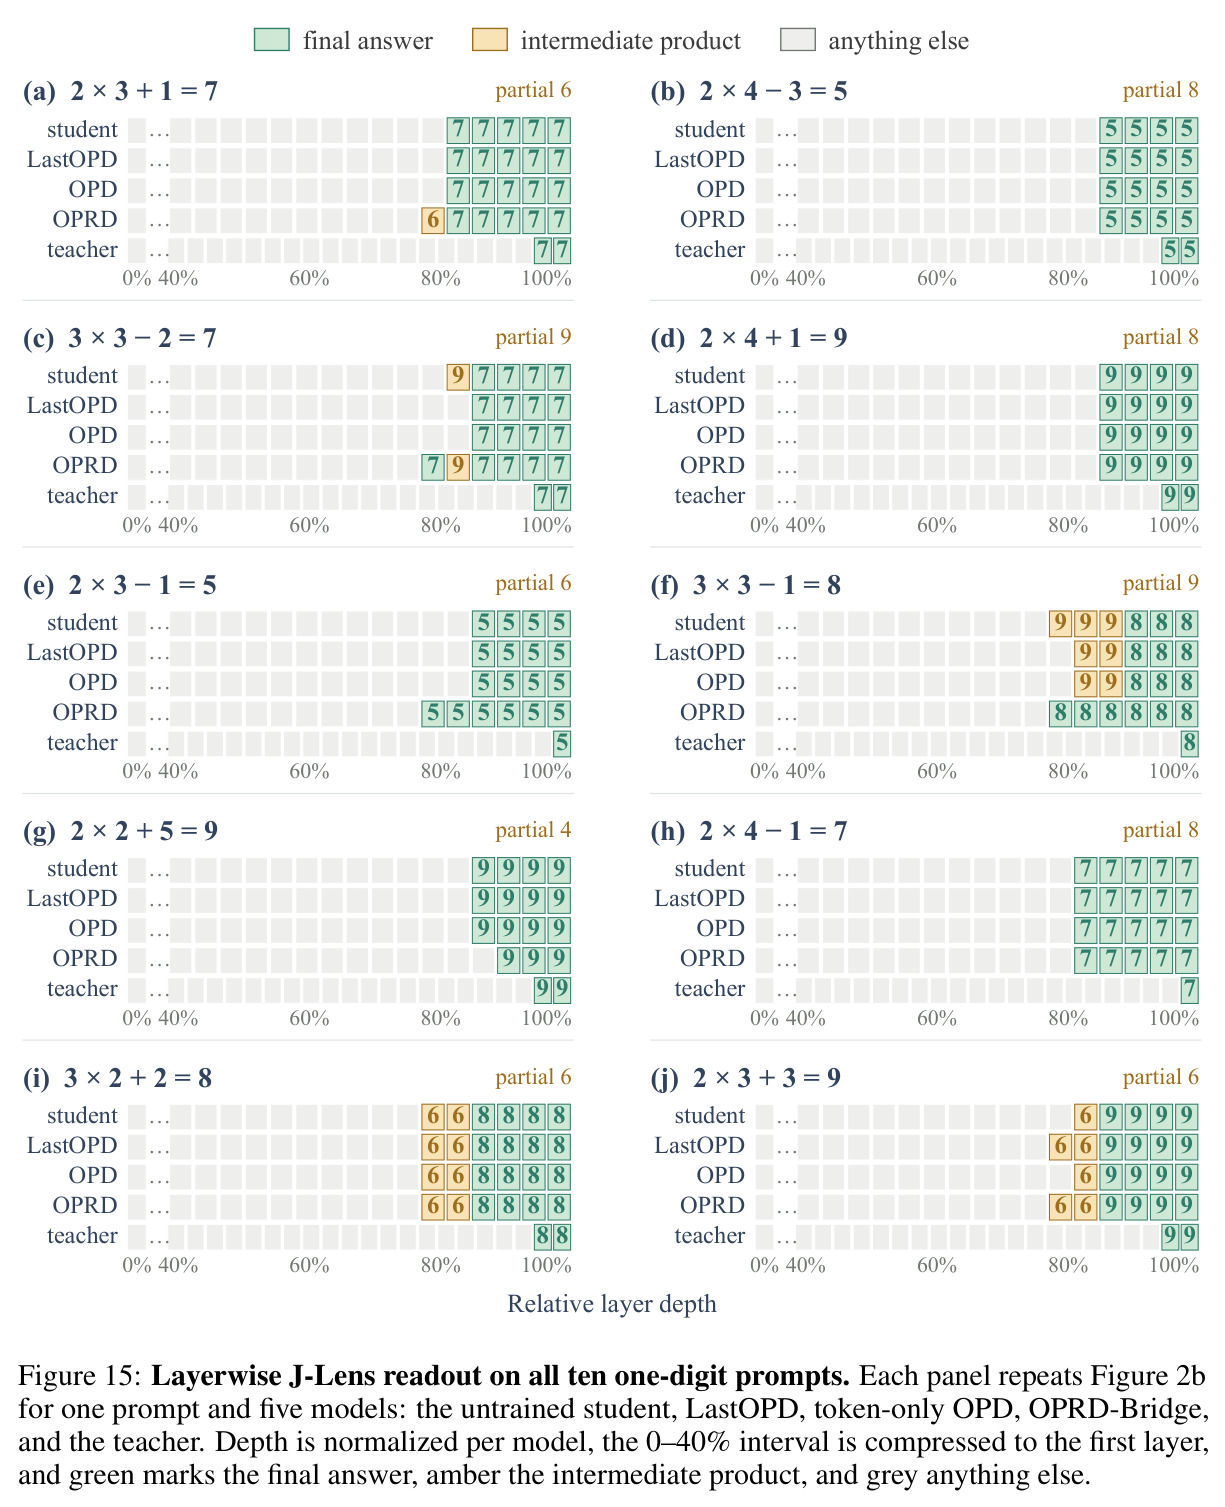
十个个位数算术题上,最终答案首次成为 top-1 J-Lens 读出(左)与中间积首次进入 top-5 读出(右)的相对深度散点。教师的中位数约 0.97,而未训练学生、token-only OPD、OPRD-Bridge、LastOPD 全部在 0.87–0.89(答案)和 0.74–0.81(中间积)。
证明所有训练配方都没有改变学生『在哪一层说出答案』:LastOPD 没有把学生改造成教师的『早知道晚说出』模式,支撑『强化而非替换学生思维方式』的核心论断。