自回顾蒸馏:将事后经验转化为先验前瞻 Self-Retrospection Distillation: Turning Post-hoc Experiences into Prior Foresight
把事后轨迹的教训蒸馏为交互前预判,让全对或全错的轨迹也能产生学习信号
前置知识
RLVR 与 GRPO(组相对策略优化)
强化学习与可验证奖励(RLVR)用数学检查器、单元测试或任务评分表给完整轨迹打标量奖励 $r(\tau)$,再回传给产生它的动作。GRPO 对同一任务采样 $G$ 条 rollout,用组内归一化优势 $A(\tau^i)=(r_i-\mu_r)/\sigma_r$($\mu_r,\sigma_r$ 为组内均值与标准差)加权对数似然,免去价值网络。
本文的核心问题正是 GRPO 的软肋:当组内所有 rollout 奖励全同时 $A(\tau^i)=0$,整组梯度为零。不理解组相对优势的机制,就无法理解 SRD 为什么能让「无奖励对比」的轨迹重新产生学习信号。
On-policy 自蒸馏(OPSD)与特权教师
同一个模型兼任教师与学生:教师额外看到特权信息(如验证过的正确解 $z_{hind}$),学生在自己的 rollout 前缀上被逐 token 地蒸馏向教师分布 $\bar\pi_\theta(\cdot \mid h_t, z_{hind})$,损失是 KL 散度。教师用 stop-gradient 或 EMA 副本实现,不回传梯度。
SRD 是 OPSD 的直接后续工作,复用了其教师-学生框架和 EMA 教师实现,但把蒸馏目标从「行为分布」换成了「前瞻分布」。论文的基线对比和消融都围绕 OPSD 展开,不懂 OPSD 就读不懂 Table 2 和 RQ1。
广义 Jensen–Shannon 散度 $JSD_\beta$
两个分布的对称散度:$JSD_\beta(p_T\|p_S)=\beta\,D_{KL}(p_T\|m)+(1-\beta)D_{KL}(p_S\|m)$,其中混合分布 $m=\beta p_T+(1-\beta)p_S$。相比 KL 更稳定、梯度有界,$\beta=0.5$ 时完全对称,工程上用 top-$k$ log-prob 近似。
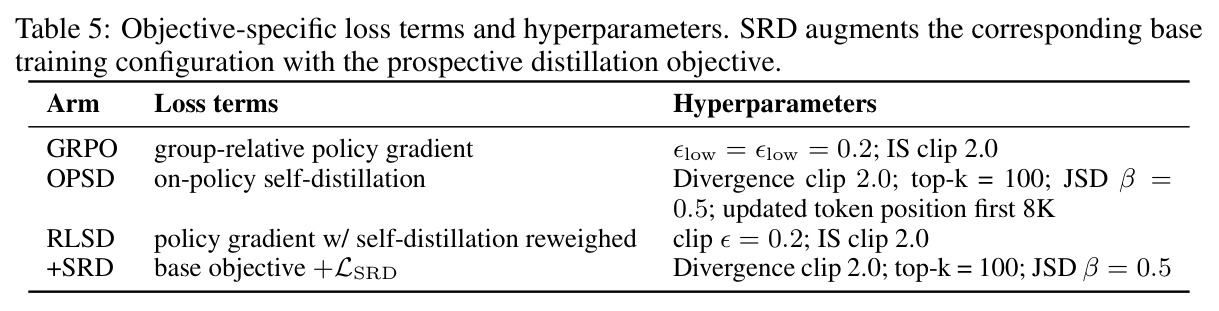
SRD 的辅助损失 $\mathcal{L}_{SRD}$ 就是用 $JSD_\beta$($\beta=0.5$,top-$k$=100,裁剪 2.0)实现的 token 级对齐,理解它才能复现训练目标并明白为何比 KL 更不易爆。
Dynamic sampling(动态采样)
DAPO 式训练技巧:丢弃对当前目标无贡献的 rollout 组并重新采样,保证每步提交的批次都有有效梯度。RLVR 家族过滤奖励标准差为零的组,OPSD 过滤全错组(没有成功轨迹可当教师)。
动态采样正是「浪费轨迹」问题的制度根源——被过滤组里的信息直接扔掉。论文的对比实验刻意让每个基线保留自己的过滤条件,SRD 的价值恰恰体现在这些被丢弃的组上。
前瞻学习与轨迹盲预测(trajectory-blind foresight)
指模型在只看到任务描述 $x$ 和环境上下文 $e$、不接触任何真实交互的条件下做出的预测(知识需求、可能失败)。它与看完成轨迹的条件分布形成一对「无信息/有信息」视角,二者之差就是可以被蒸馏的信号。
SRD 全文建立在这对分布的对比上:$p^i_{fore}=\pi_\theta(\cdot \mid x,e,c^i)$ 对 $p^i_{hind}=\bar\pi_\theta(\cdot \mid x,e,f^i,c^i)$。理解「轨迹盲」这个约束,才能明白为什么蒸馏结果可以在推理时零开销地内化。
研究动机
RLVR 已成为 LLM agent 后训练的主流范式:对每条完成的轨迹用可验证器打标量奖励,再按组相对优势回传给动作策略。GRPO 的优势定义为 $A(\tau^i)=(r_i-\mu_r)/\sigma_r$,当组内 $G=8$ 条 rollout 的奖励全同时(全对或全错),$A(\tau^i)=0$,整组不产生任何梯度;标准做法(dynamic sampling)直接丢弃这些组并重采样,轨迹中蕴含的任务结构与失败模式信息随之被浪费。这个盲区在能力两端最严重:论文在四个 Qwen3.5 规模上的实测显示,可用预算占比从不超过 63%,被丢弃的份额呈 U 形(98.0%、39.1%、37.0%、41.3%)——2B 模型 98% 的组全错,GRPO 训练成功率峰值仅 1.6%、最终 0.0%;而强模型又滑向全对饱和(全对组占比从 0% 升至 27.9%)。长视野任务尤甚:多数尝试以失败告终。另一条线上的 on-policy 自蒸馏(OPSD)虽然用特权信息构造了更稠密的 token 级监督,但全错组没有任何成功轨迹可供蒸馏,且其监督目标仍是动作分布,在 9B 规模上甚至低于未训练模型(HotpotQA 低 5.50pp、2Wiki 低 3.76pp、LCB-v6 低 2.18pp),Math 平均还出现反向缩放(9B 39.70% 低于 4B 的 41.81%)。
本文的目标是本文问一个互补的问题:一次已完成的交互,除了告诉 agent「该做什么」,还能否教会它「交互前本该预知什么」。具体目标有三。其一,提出 prospective learning(前瞻学习)这一新的后训练目标:用事后经验(hindsight)监督交互前的预测(foresight)——给定任务与环境上下文,让模型预测任务可能需要的知识与可能踩的坑,再用完成轨迹提供的特权信息校正这些预测。其二,给出可组合的实例化方法 SRD,作为权重 $\lambda=0.01$ 的轻量辅助损失叠加在 GRPO、OPSD、RLSD 等任意基线目标上,在 4 类共 10 个工具推理与长视野 agent 基准上验证增益(最高 +24.2pp)。其三,让每条轨迹都能产生监督:奖励决定轨迹教哪一课(成功教 KNOWLEDGE、失败教 PITFALL),而不是决定它是否教课,从而在奖励无方差的困难区与饱和区两端都保持学习信号——2B 全错组占 98% 的极端设置下,把训练成功率从 0.0% 拉到 60.6%。
与已有工作不同的是,已有方法的监督目标清一色是行为本身。RLVR 把轨迹压成标量奖励回传给动作策略;OPSD 及其后续(自修订、技能摘要、过程记忆)把结构化 hindsight 喂给教师、再把教师的行为分布蒸馏给学生,统一形式是 $\max_\theta \mathbb{E}[U(\pi_\theta, z_{hind}, x)]$,效用函数围绕动作分布 $\pi_\theta(\cdot \mid h_t)$ 设计。本文的独特切入是把监督目标从「事后改进动作」换成「事前塑造预判」:hindsight 不再用于锐化下一步该做什么,而是用于对齐一个不看轨迹的前瞻分布 $p_{fore}=\pi_\theta(\cdot \mid x,e)$。这个思路承自预测控制、世界模型与 hindsight relabeling 的谱系,但有三点关键差异:不需要重构完整未来轨迹(不同于 Dreamer 类世界模型),不需要在推理时显式生成或消费 foresight(它只是训练靶点,学到的预判内化为表征),也不需要重新标注历史经验(不同于 HER)——完成的交互只作为训练期的特权监督,教同一个策略「什么本可以提前知道」。
核心方法
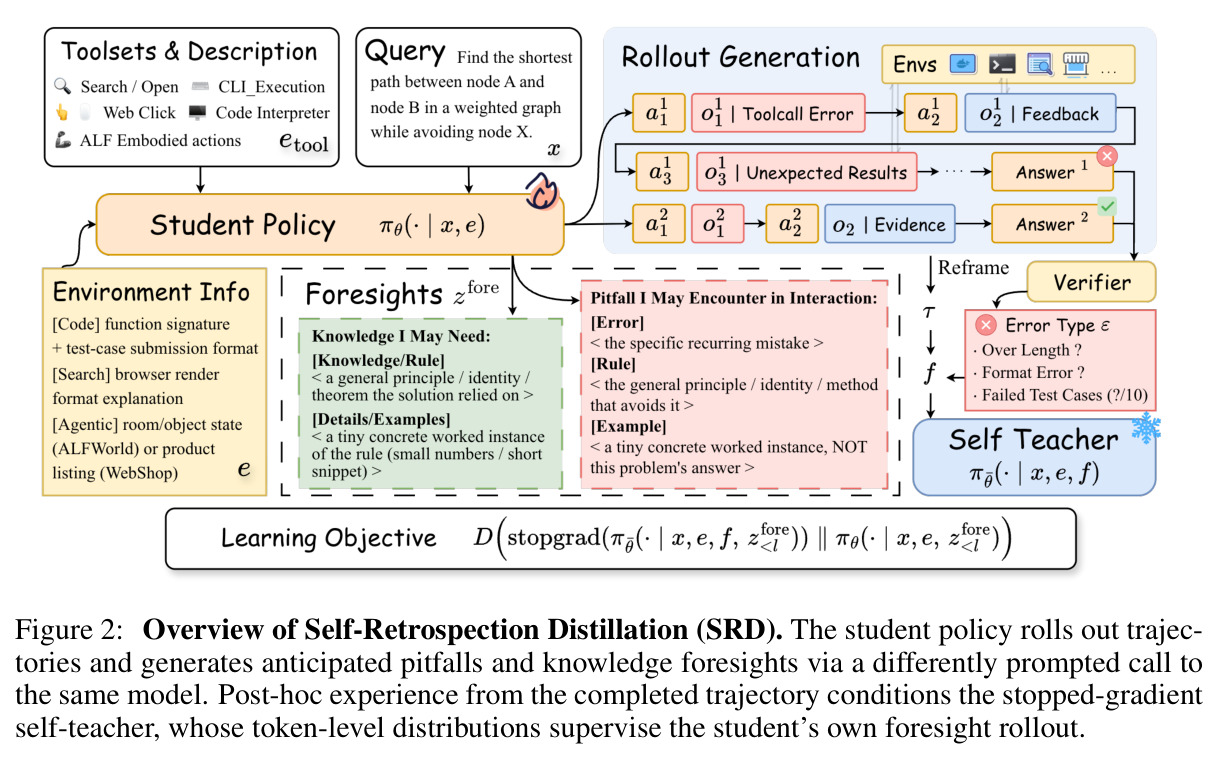
直觉上,一条完成的轨迹是一份「事后诸葛亮」:成功轨迹暴露了解出这道题需要哪些可复用的知识,失败轨迹暴露了哪类动作必然踩坑。SRD 让同一个模型同时扮演两个角色:学生只看任务 $x$ 和环境上下文 $e$,被提示去预测(foresight)「解这类题需要什么知识/这类题容易怎么失败」;教师是同一模型的 stop-gradient(EMA,更新率 0.05)副本,除 $x,e$ 外还额外看到特权事后上下文 $f^i=(\tau^i, y^*, \epsilon^i)$(完整轨迹、金标答案或正确解、错误标注),它对同一个学生生成的前缀逐 token 给出更有远见的分布。训练就是在学生自己采样的 foresight 序列上最小化两者的 token 级散度。技术路线上,每个 rollout 按奖励选视角 $c^i$($r_i=1$ 用 KNOWLEDGE,$r_i=0$ 用 PITFALL),损失为 $\mathcal{L}_{SRD}=\frac{1}{G}\sum_i \sum_l D\big(\bar\pi_\theta(\cdot \mid x,e,f^i,z^i_{fore,<l})\,\|\,\pi_\theta(\cdot \mid x,e,z^i_{fore,<l})\big)$,用广义 Jensen–Shannon 散度 $JSD_\beta$($\beta=0.5$)实现,以 $\lambda=0.01$ 的权重与任意基线目标 $\mathcal{L}_B$ 相加联合优化。foresight 只是训练目标,推理时无需显式生成。
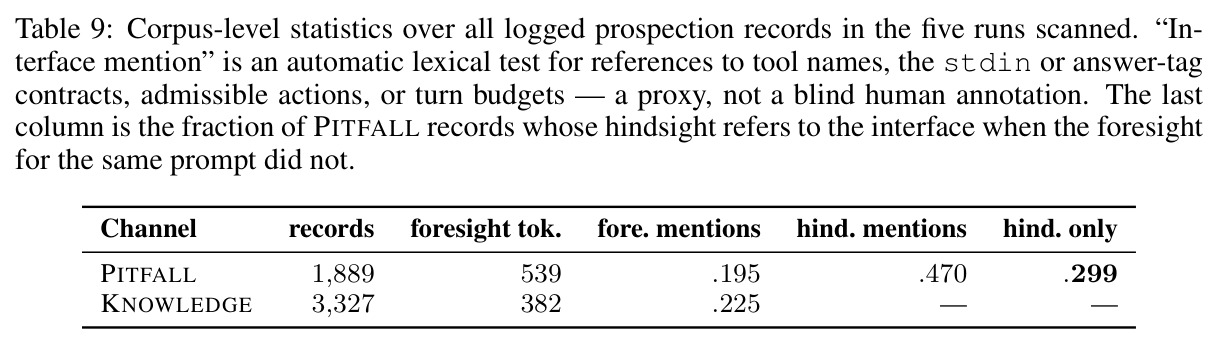
核心创新在于改变了监督的「目标空间」,这是与 OPSD 家族的本质区别:OPSD 让 hindsight 教师改善学生的行为分布 $\pi_\theta(\cdot \mid h_t)$——即「知道正确解之后,下一步 token 该怎么发」;SRD 让 hindsight 教师校准学生的前瞻分布 $\pi_\theta(\cdot \mid x,e)$——即「不看轨迹时,本该预知什么」。由此带来三个结构性优势。第一,监督不再被奖励方差门控:附录 A 证明在奖励均匀组上 reward 更新方向 $U_R$ 逐点为零、任何缩放都无法恢复,而前瞻方向 $H$ 在那里没有结构性强制归零,估计成本也无需付出 $n_R=\Omega((G\pi(p)\epsilon^2)^{-1})$ 的门控代价($\pi(p)=\min\{p,1-p\}$)。第二,正负经验在同一目标下统一:成功轨迹走 KNOWLEDGE 视角、失败轨迹走 PITFALL 视角,全错组(OPSD 因无成功轨迹而失灵之处)恰好是 PITFALL 最丰富的场景。第三,foresight 只塑造训练期表征,推理时零开销。论文用 Table 9 的语料统计佐证机制真实存在:29.9% 的 PITFALL 记录中,事后 hindsight 提到了工具接口层面的关键事实(如 stdin 答案格式、回合预算),而同一道题的事前 foresight 完全没提——这正是 SRD 要弥合的差距。
方法步骤详情
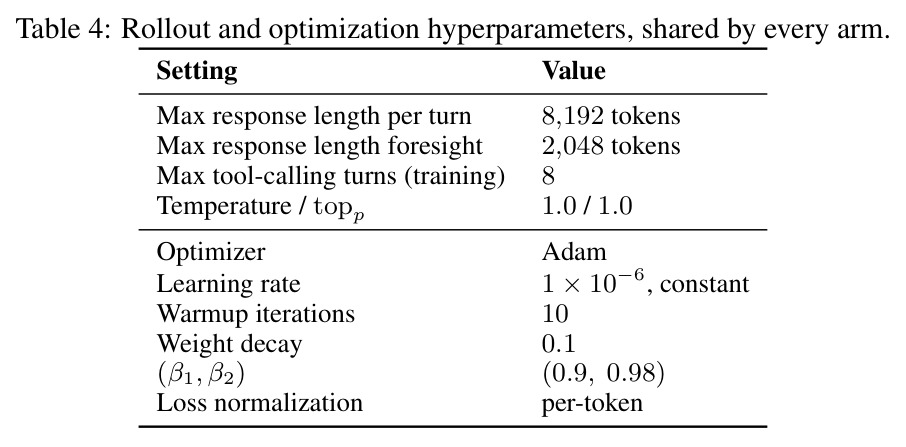
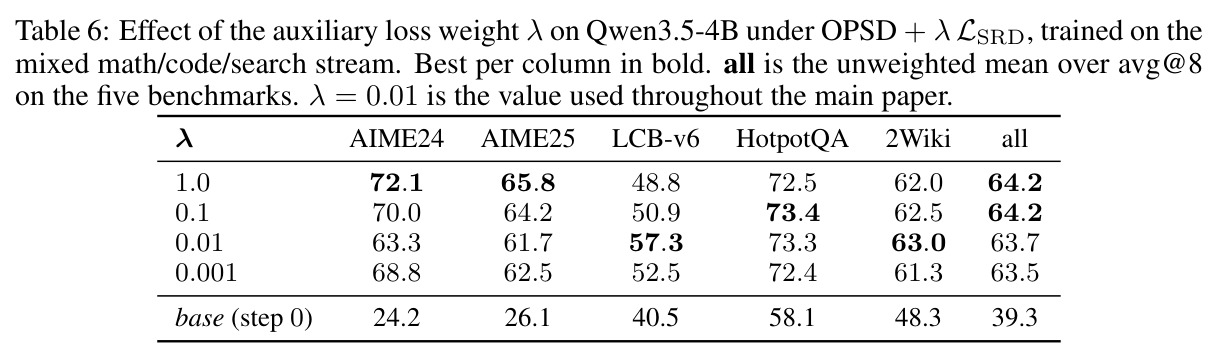
完整流程分六步。第一步,对每个任务 $x$ 采样 on-policy rollout 组 $\{\tau^i\}_{i=1}^G$($G=8$),可验证器给出奖励 $r_i$,与基线共用同一数据流和动态采样预算。第二步,为每条轨迹选视角 $c^i$:$r_i=1$ 取 KNOWLEDGE(从正确解中提炼 1–3 条可迁移的 [Knowledge/Rule]/[Details/Examples] 微技能块,禁止泄露本题答案),$r_i=0$ 取 PITFALL(两阶段构造:先对单条失败轨迹诊断出 [Error]/[Rule]/[Example] 块,再把同题所有失败轨迹的块聚合成一份简短的共享「这题通常怎么失败」清单,避免冗长重复的拼接)。第三步,构造特权事后上下文 $f^i=(\tau^i, y^*, \epsilon^i)$。第四步,学生在只有 $(x,e,c^i)$ 的条件下采样 foresight 序列 $z^i_{fore}\sim p^i_{fore}$(上限 2048 token)。第五步,EMA/stop-gradient 教师(更新率 0.05)以 $(x,e,f^i,c^i)$ 和学生前缀 $z^i_{fore,<l}$ 为条件,对每个位置输出教师分布;按 token 级广义 $JSD_\beta$($\beta=0.5$,top-$k$=100 近似,散度裁剪 2.0)计算损失并对组平均得 $\mathcal{L}_{SRD}$。第六步,与基线联合优化 $\mathcal{L}_{B+SRD}=\mathcal{L}_B+\lambda\mathcal{L}_{SRD}$,$\lambda=0.01$(Table 6 显示 $\lambda$ 跨三个数量级增益稳定:聚合分 63.5–64.2,基线 39.3)。每步 16 prompt × 8 rollout = 128 条轨迹,学习率 $10^{-6}$ 恒定,8×H200 单节点,温度 1.0、最多 8 轮交互。部署推理时模型与普通策略无异。
技术新颖性
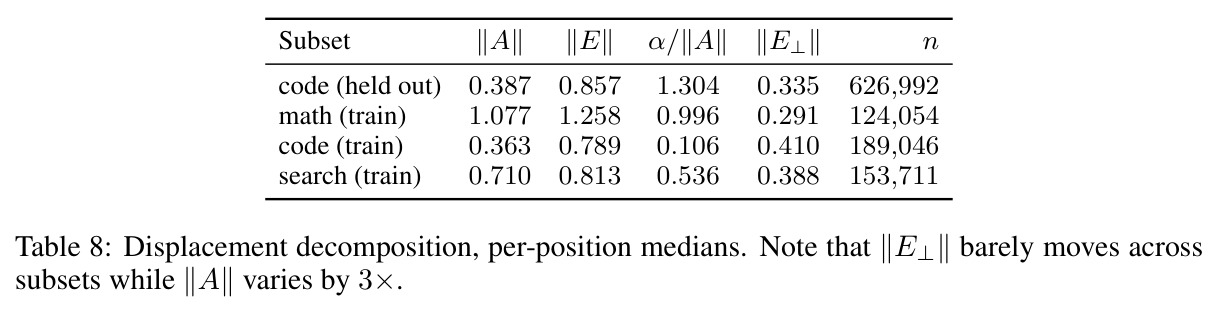
新颖性可从四个层面评估。概念层面,「prospective learning」把事后经验的使用从行为修正扩展到预交互预测,填补了 RLVR/OPSD(回顾式)与世界模型/规划(前瞻式)之间的空档——此前没有工作把 agent 自身完成的轨迹当作对其 foresight 的特权监督信号。技术层面,SRD 的组件都是现成件:自蒸馏、EMA 教师、token 级 JSD、结构化 prompt;新的在于组合方式——视角 $c^i$ 由奖励二值选定,使同一个目标函数自然覆盖成功与失败两类经验,而特权上下文是「结构化 hindsight」而非 OPSD 的原始 trace 前缀,RQ1 消融显示 hindsight 前缀稳定优于 trace 前缀(9B AIME26:77.50 vs 65.42)。理论层面,附录 A 给出清晰分离:组相对优势的支撑被混合结果事件 $q_G(p)=1-p^G-(1-p)^G\le G\pi(p)$ 门控,前瞻算子没有这个零支撑门;估计成本上 $n_R=\Omega((G\pi(p)\epsilon^2)^{-1})$ 对 $n_H=O(1+\epsilon^{-2})$,说明差距是结构性的而非信号变弱。实证层面,RQ4 用 Fisher 度量下的位移分解量化了互补性:加 SRD 后 GRPO 沿自身方向多走 30%($\alpha/\|A\|=1.30$)且新增约等量的正交分量($\|E^\perp\|/\|E\|=0.49$),说明 SRD 不是重加权而是提供了新方向。
实验结果
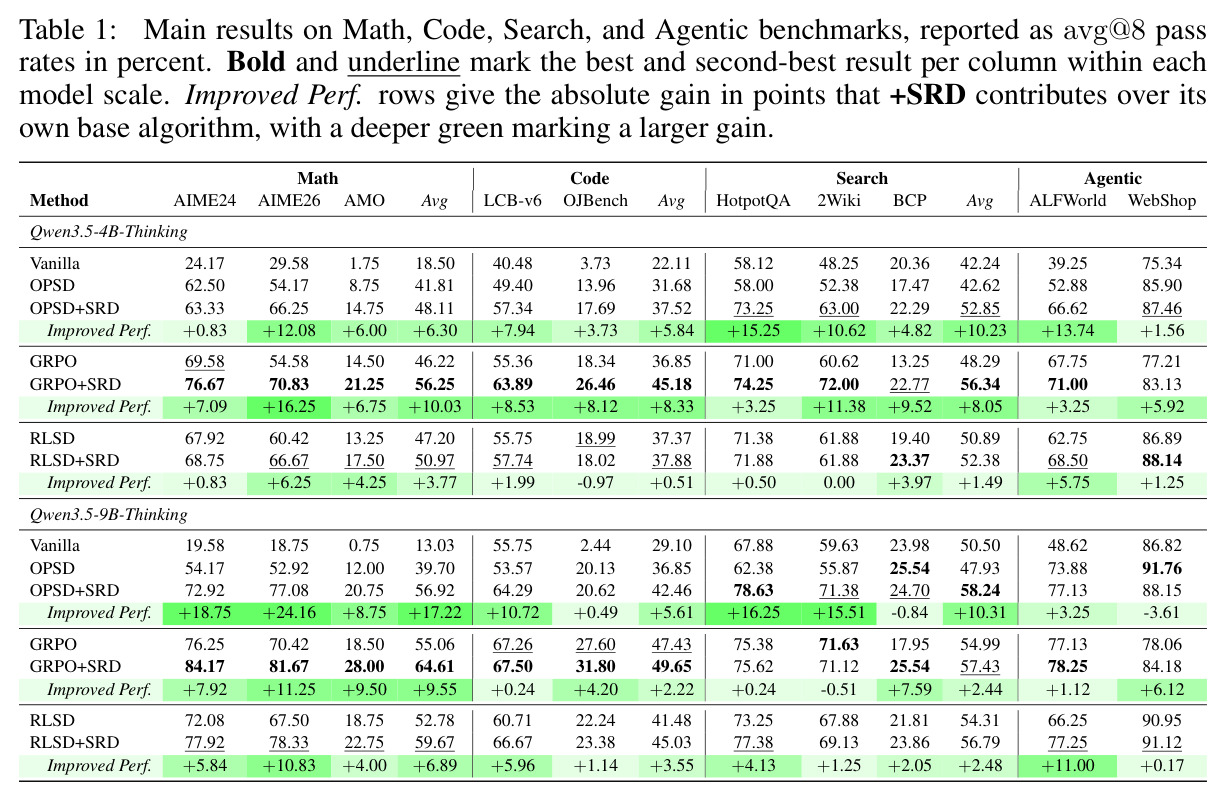
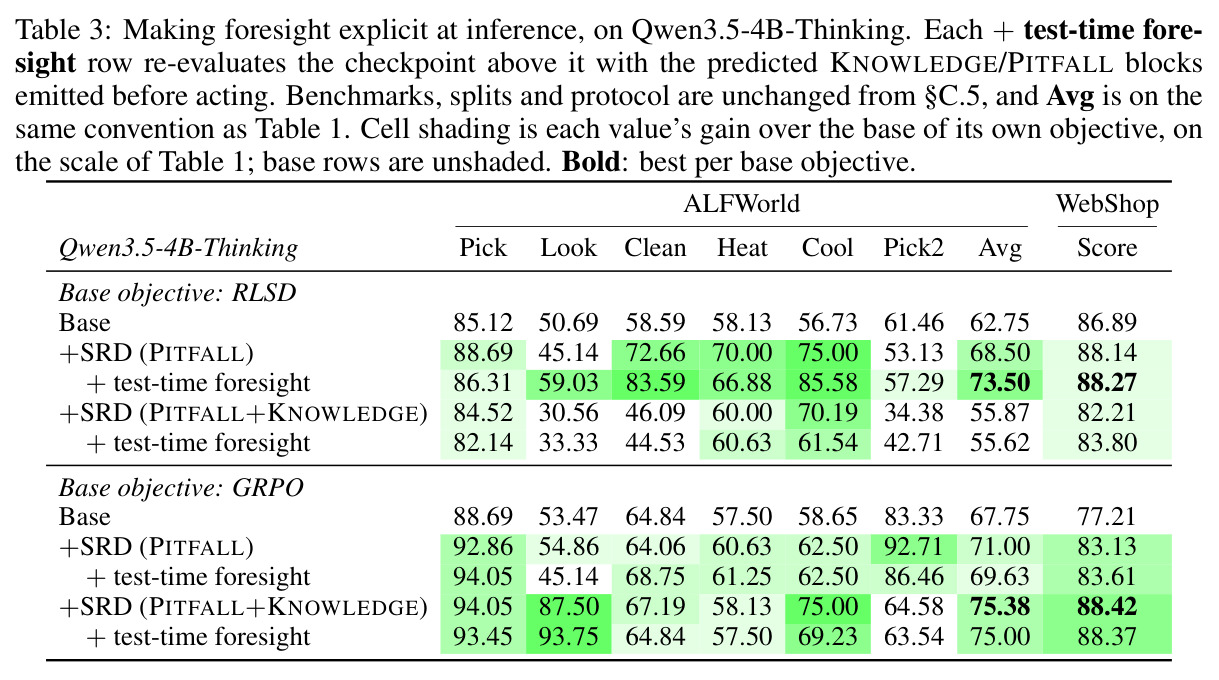
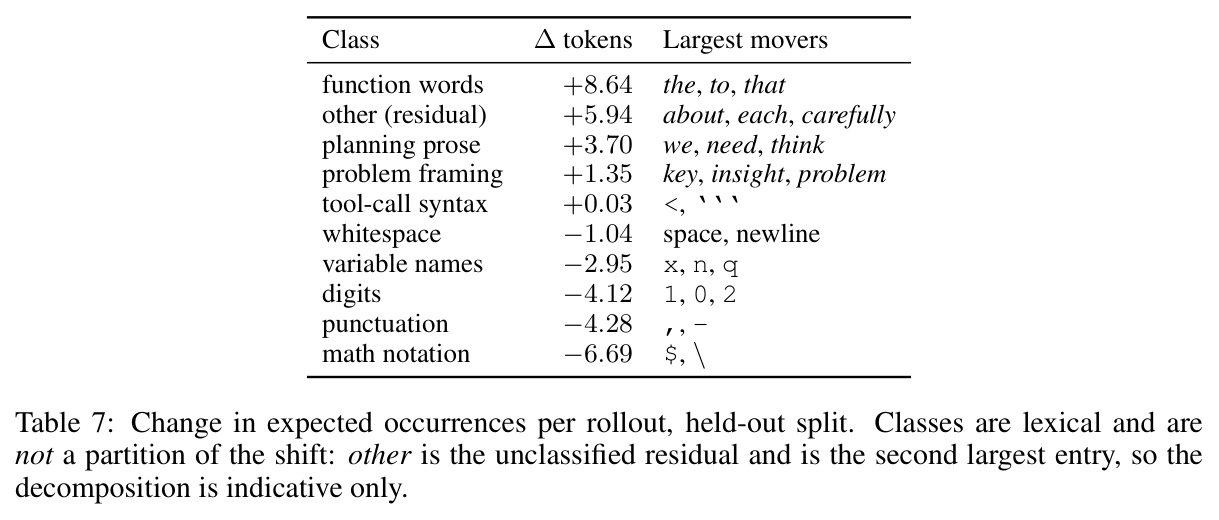
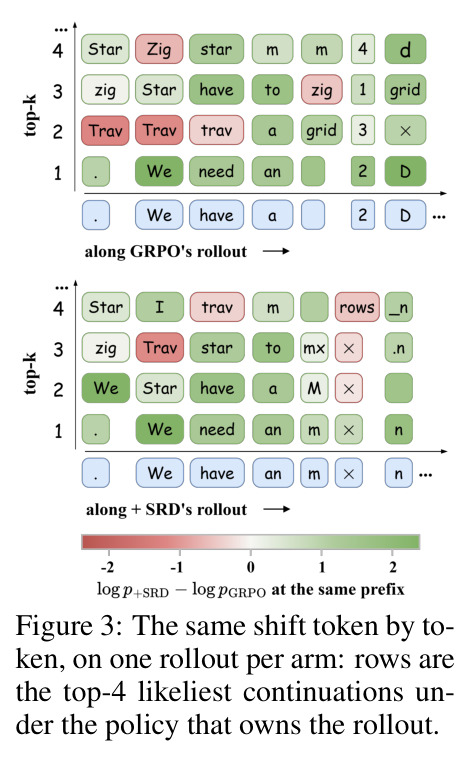
主实验(Table 1)在 Math(AIME24/AIME26/AMO-Bench)、Code(LCB-v6/OJBench)、Search(HotpotQA/2Wiki/BrowseComp-Plus)、Agentic(ALFWorld/WebShop)四类十个基准、Qwen3.5-4B/9B-Thinking 两个规模、三个基线上验证 SRD,每个 +SRD 行只用 PITFALL 通道。核心数字:4B GRPO+SRD 把 Math 均值 46.22→56.25(+10.03pp)、Code 36.85→45.18(+8.33pp)、Search 48.29→56.34(+8.05pp)、ALFWorld +3.25pp、WebShop +5.92pp;9B OPSD+SRD 把 Math 39.70→56.92(+17.22pp)、Search +10.31pp;单格最大增益 9B AIME26 的 +24.16pp(52.92→77.08);混合目标 RLSD+SRD 在 ALFWorld 66.25→77.25(+11.00pp)。18 个「基线×规模」组合仅 1 处回归(9B OPSD WebShop −3.61pp)。OOD 迁移成立:训练用 LCB stdin 格式、评测用 functional 格式,4B GRPO+SRD 在 OJBench +8.12pp;ALFWorld 未见环境上 6 个组合全部提升 1.12–13.74pp;交互长度 10 倍以上的 BrowseComp-Plus 有 5/6 设置提升(最高 +9.52pp)。SRD 还修复了 OPSD 的不稳定:9B OPSD 曾低于未训练模型(HotpotQA −5.50、2Wiki −3.76、LCB-v6 −2.18pp),加 SRD 后恢复单调缩放(4B 48.11、9B 56.92)。机制分析:RQ1 显示 hindsight 前缀优于 trace 前缀、PITFALL-only 是效率最优(KNOWLEDGE 散度训练中不降,rollout 又占一步时间的 78–87%);RQ2 发现 SRD 把 token 预算从内联数学记号(−6.69)挪向连接词(+8.64)与规划语言(+3.70),工具调用语法不动(+0.03),工具调用次数 2243→2888;RQ3 的 2B 极端案例中 GRPO 最终成功率 0.0%、同预算加 SRD 达 60.6%;RQ4 分解显示 GRPO+SRD 沿自身方向多走 30% 且有近半正交新方向,而 OPSD+SRD 沿原方向收缩为 0.28 倍(像锚);RQ5 显示把 foresight 显式搬到推理时几乎无效(4 个 checkpoint 中 3 个仅 ±2–11/800)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Math 均值(4B,AIME24+AIME26+AMO) | avg@8 pass rate (%) | 56.25(GRPO+SRD) | 46.22(GRPO) | +10.03 pp |
| AIME26(9B) | avg@8 pass rate (%) | 77.08(OPSD+SRD) | 52.92(OPSD) | +24.16 pp(全文最大单格增益) |
| Math 均值(9B) | avg@8 pass rate (%) | 56.92(OPSD+SRD) | 39.70(OPSD) | +17.22 pp,并修复 OPSD 的反向缩放 |
| Code 均值(4B,LCB-v6+OJBench) | avg@8 pass rate (%) | 45.18(GRPO+SRD) | 36.85(GRPO) | +8.33 pp(stdin 训练→functional 评测的 OOD 迁移) |
| Search 均值(4B,HotpotQA+2Wiki+BCP) | avg@8 pass rate (%) | 56.34(GRPO+SRD) | 48.29(GRPO) | +8.05 pp |
| ALFWorld(9B,OOD 未见环境) | 成功率 (%) | 77.25(RLSD+SRD) | 66.25(RLSD) | +11.00 pp |
| 2B code-only 极端设置(98% 组奖励均匀) | 训练成功率 (%) | 60.6(GRPO+SRD) | 0.0(GRPO,峰值仅 1.6) | 从完全无法起步到 60.6%,验证零奖励对比下仍可学习 |
局限与改进
作者承认的局限包括:其一,KNOWLEDGE 通道基本冗余——训练中其散度几乎不降(约 0.0045 与 0.003),叠加后偶有回退(4B AMO −4pp、9B AIME26 62.92 vs 65.42),作者只给出启发式解释($\mu_H=(1-p)\mu_P+p\mu_K$、散度依赖的梯度界),未完全说明机制;其二,RQ5 显示推理时显式 foresight 收益接近零且有风险——错误预测会条件化整个 episode(附录 F.3 记录了一次错误 foresight:把两物件任务的携带限制安到了目的地头上),且八个策略臂无一能同时改善 ALFWorld 全部 6 种任务类型(best–worst 差距 10.16–60.07pp,Look 从 −20.13 到 +40.28pp),均值掩盖了任务间 trade-off;其三,RQ5 只有单 seed、两个目标一个规模,KNOWLEDGE 伤害 RLSD 的解释只是猜想;其四,作者撤回过一个统计量(E.6:$\cos(F-A,A)$ 恒为负是数学假象,修正后对齐度 0.74),显示分析迭代中的陷阱;其五,语料统计(Table 9 的 29.9%)只是词汇 proxy,未做人工盲评。我自己的观察:hindsight 构造依赖金标答案 $y^*$ 与错误标注 $\epsilon^i$,对无唯一正确答案的开放任务不直接适用;训练开销显著增加(wall-clock 每步 197→258–279 秒,约 +30%,来自 foresight 采样与教师前向);实验局限于 Qwen3.5 家族与模拟环境(ALFWorld/WebShop),真实 Web/OS agent 未验证;RQ3 报告的是训练成功率而非 held-out 成功率;自蒸馏 hindsight 可能强化基座模型的既有偏差(作者在伦理声明中亦承认)。
独立分析的弱点
独立分析有五个弱点。第一,对可验证性的依赖:PITFALL/KNOWLEDGE 的构造需要 $r_i\in\{0,1\}$ 和金标解 $y^*$,在开放域(真实网页操作、写作、多目标优化)会失效;改进方向是把 verifier 换成 LLM-as-judge 或自一致性多数投票产生软标签(附录 B.2 已有雏形),并研究噪声 hindsight 下的鲁棒性。第二,训练成本:每条轨迹多一次 foresight rollout(2048 token)加教师打分,rollout 占一步时间的 78–87%,总时长 +约 30%;改进方向是条件启用——只在奖励均匀组上调用 SRD(混合组 GRPO 本就有梯度),或用 PITFALL 散度下降率在线决定何时停止蒸馏。第三,自蒸馏天花板:教师与学生同源,hindsight 质量受当前策略限制,F.3 的 ALFWorld 案例中教师开出的药方(「遍历全部已知家具」)超出了 8 步动作预算,说明 hindsight 本身可能违反环境约束;改进方向是给 hindsight 构造加预算感知约束,或用验证器回筛 hindsight 的可执行性。第四,KNOWLEDGE 通道价值不明:成功组的经验目前几乎被浪费,而全成功组占比随规模增大(0→27.9%);改进方向是重新设计知识通道(如仅在知识散度高于阈值时启用)或沉淀跨任务技能库。第五,评测粒度:Avg 掩盖 ALFWorld 任务类型间 trade-off(Pick2 从 −27.08 到 +9.38pp),且 RQ5 单 seed 结论脆弱;改进方向是多 seed 加分任务类型报告。
未来方向
作者明确提出把 prospective learning 当作后训练的一条设计轴:不只优化 agent 如何从经验中学习行为,还优化它能多好地预判一次交互将要求什么、在哪里失败。由此可延伸的方向包括:其一,更丰富的 foresight 结构——目前只预测知识与陷阱两类文本块,可以扩展到预测未来观测、工具返回、行动后果(决策相关的部分世界模型),甚至分层预测(先粗后细);其二,推理时 foresight 的复活——RQ5 显示未校准的显式 foresight 无益甚至有害,但如果 foresight 的置信度被校准(预测把握与事后命中挂钩),它有望成为推理时规划与风险提示的信号,形成「训练期内化、推理时调用」的完整闭环;其三,跨任务前瞻记忆——把 PITFALL 块沉淀为可检索的失败模式库,让新任务的 foresight 以历史陷阱为条件;其四,理论延伸——A.6 的有效行数 $G_{eff}$ 尚未实证测量,前瞻算子的收敛性、最优 $\lambda$ 调度以及软奖励(非二值)下的门控分析都值得研究;其五,把 SRD 与过程奖励模型、多智能体经验共享结合,检验前瞻监督在更长视野(BrowseComp-Plus 已显示 10 倍工具调用仍有效,5/6 设置提升、最高 +9.52pp)和真实计算机操作环境中的外推能力。
复现评估
复现条件总体透明。模型用公开的 Qwen3.5-4B/9B-Thinking;训练数据全部公开(DAPO-Math-17K、LiveCodeBench stdin 划分、Search-R1 配方与检索设置、ALFWorld/WebShop 标准划分);完整的 prompt 模板(附录 B.1 给出 KNOWLEDGE/PITFALL 的 hindsight/foresight 四套提示及硬约束示例)、全部超参(Table 4/5:学习率 $10^{-6}$ 恒定、EMA 0.05、$JSD_\beta$ 取 $\beta=0.5$、top-$k$=100、裁剪 2.0、$\lambda=0.01$、每步 16×8 轨迹、温度 1.0、最多 8 轮交互、单轮上限 8192 token)和 $\lambda$ 消融(Table 6)都已给出,$\lambda$ 跨三个数量级稳定(聚合分 63.5–64.2 vs 基线 39.3)降低了调参风险。算力门槛较高:主实验在单节点 8×H200 上训练 4B/9B,每步 wall-clock 195–279 秒(rollout 占 78–87%);2B 的 RQ3 实验规模较小,普通实验室多卡单节点可行。读到的正文中未见官方代码开源链接,SRD 损失需自行实现(token 级 JSD + EMA 教师不难,多轮工具 rollout 的教师打分工程量不小)。综合评估:有现成 RLVR 基础设施(verl/OpenRLHF 类)的团队约 1–2 周可复现核心结论;最容易的入口是 GRPO+SRD 的 math/code 设置;需注意 RQ3 报告的是训练成功率而非 held-out 指标,RLSD 复现需按论文取消目标衰减。
论文图表
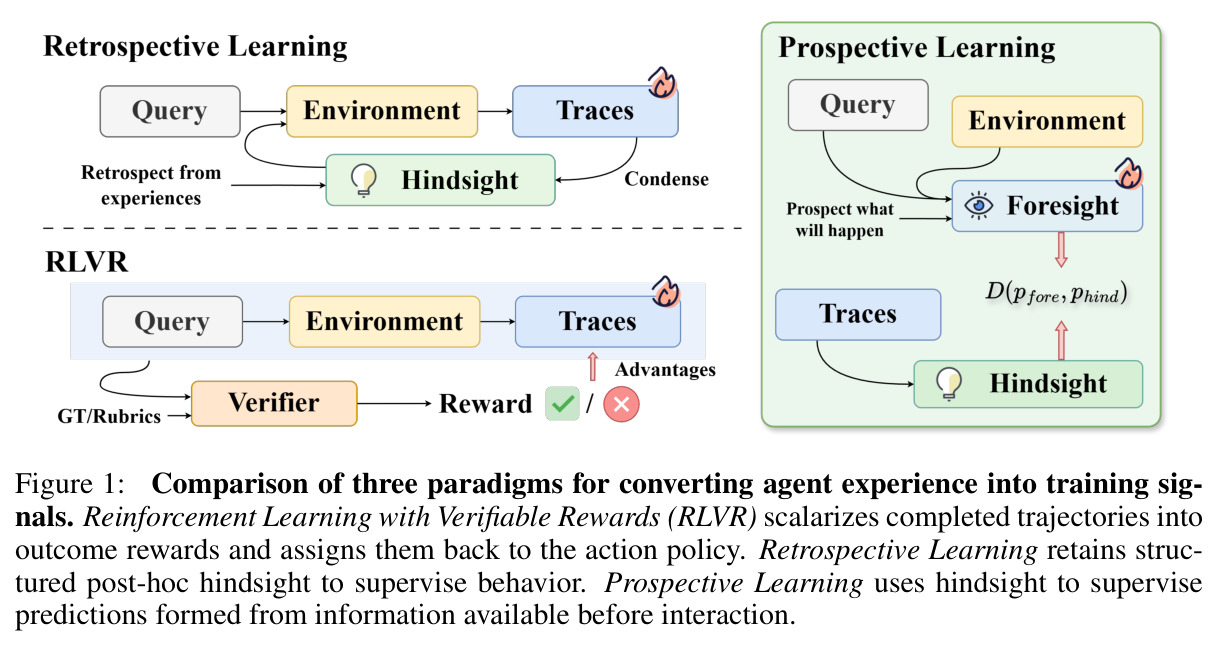
并排对比三种把 agent 经验转化为训练信号的范式:RLVR 把完成的轨迹标量化为结果奖励并回传给动作策略;Retrospective Learning 保留结构化的事后 hindsight 来监督行为;Prospective Learning(本文)用 hindsight 监督「仅凭交互前可得信息」做出的预测。
这是全文的概念地图:一张图看清 SRD 与 RLVR、OPSD 类方法在「监督目标」上的本质分野——前两者都用经验改进行为,SRD 用经验改进预判。理解本文一切主张都应从这张图的对比出发。
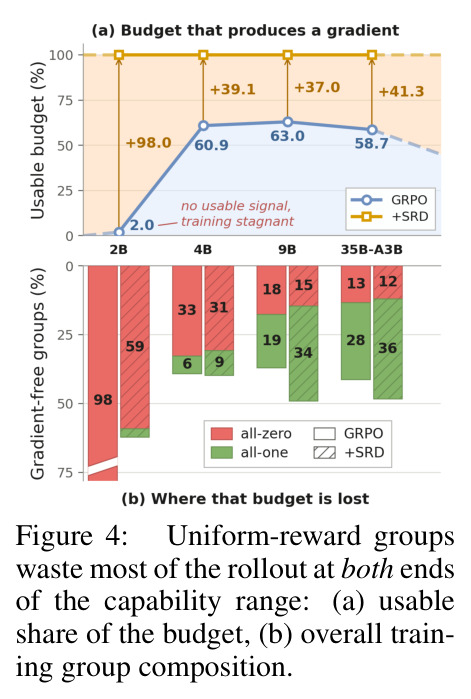
在 code-only 训练、关闭动态采样的设置下,跨四个 Qwen3.5 规模展示奖励均匀组的浪费:可用预算占比从不超过 63%,被丢弃份额呈 U 形(98.0、39.1、37.0、41.3 个百分点);全错组占比从 98.0 单调降到 13.4,全对组从 0.0 升到 27.9。
这是论文动机的核心实证:能力两端(全错饱和与全对饱和)都缺乏奖励对比,GRPO 在那里结构性失效。2B 端 98% 组被浪费正是「0.0% vs 60.6%」戏剧性对比的舞台,也是 SRD 存在价值的量化依据。
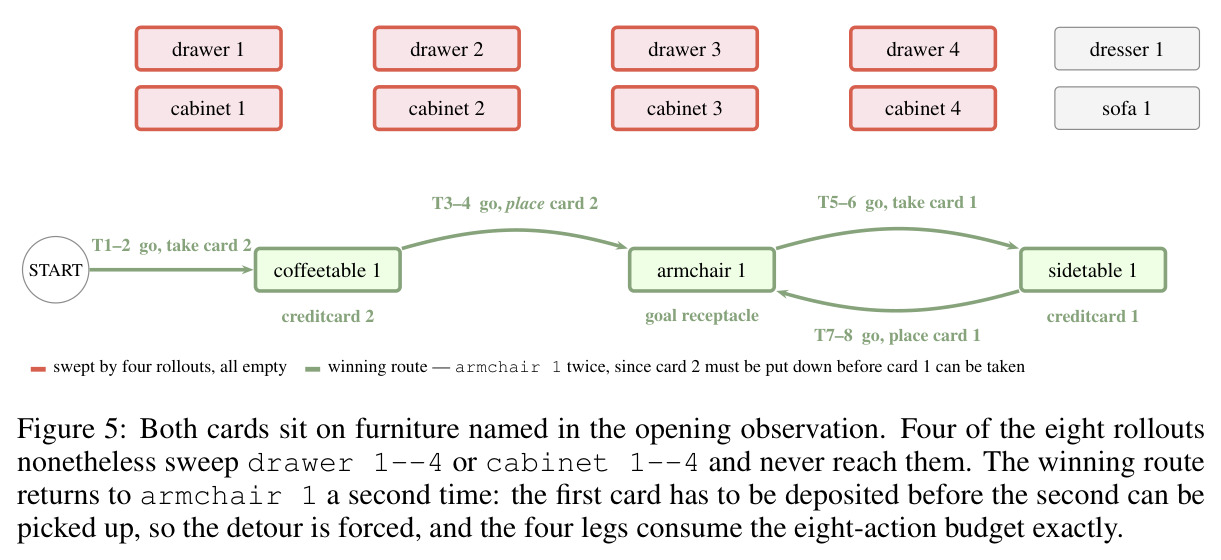
ALFWorld「put two creditcard in armchair」任务的房间示意图:八步预算恰好够一条最优路线(先取 coffeetable 上的卡 2 放到 armchair,再去 sidetable 取卡 1 返回 armchair)。8 条 rollout 中 4 条在抽屉/柜子间空扫,从未到达卡片所在家具;失败案例展示违反携带限制后模型误记「take」选项仍在而耗尽预算。
这是机制审计的交互案例:任务的关键约束(携带上限)不出现在任何提示文本中,只能通过行动暴露;SRD 聚合的 PITFALL hindsight 恰好把 8 条失败切分成两类并逐一诊断。它同时暴露了局限——教师开出的药方「遍历全部家具」超出 8 步预算,说明 hindsight 本身可能不可执行。
复合分析表。左侧消融:教师前缀(trace vs hindsight)×蒸馏通道(pitfall/knowledge)——hindsight 前缀显著更优(9B AIME26 77.50 vs 65.42),pitfall-only 最划算,加 knowledge 有回退风险且 rollout 更贵。上中:PITFALL 散度训练中下降 47%/30% 而 KNOWLEDGE 持平(约 0.0045/0.003)。下中/下右:位移分解,held-out 上 $\alpha/\|A\|=1.30$、$\|E^\perp\|/\|E\|=0.49$、$\cos(A,E)=+0.81$、$\cos(S,E_S)=+0.98$。
一张表同时回答「怎么配置 SRD 最好」(RQ1)和「SRD 对策略参数做了什么」(RQ4):前瞻监督沿宿主方向延伸并新增正交分量,对 RL 是加速、对自蒸馏是锚定。这是理解 SRD 为何是互补信号而非替代品的关键。