八叉树作为显式三维语言 Octrees as an Explicit 3D Language
用稀疏八叉树占据字节作显式3D语言,参数隔离双流让冻结LLM兼顾3D生成理解且不伤语言能力
前置知识
八叉树(Octree)
递归地把一个立方体空间均分为八个子立方体的层次数据结构,只有被物体占据的节点才继续向下细分,因此天然跳过大量空白区域,是高效表示高分辨率3D体素的经典手段(Meagher 1982,O-CNN/OctNet等均基于它)。
本文的核心表示 S-Octree 完全建立在八叉树的粗到细结构与稀疏性之上,不理解八叉树就无法理解几何如何变成 token 序列。
Z-order(莫顿)序列化
把多维坐标的二进制位按位交织排成一维遍历顺序的编码方式,其关键性质是保持空间局部性:三维中相邻的体素在序列里也倾向于彼此靠近,因此适合交给自回归模型按序建模。
OctLLM 按 Z-order 把占据的八叉树节点摊平成 LLM 读写的 1D 序列,序列局部性与 3D 局部性的对应关系是理解其生成质量的基础。
旋转位置编码 RoPE
通过对注意力中 query/key 做复数旋转向量注入相对位置信息,是现代 LLM 的主流位置编码。Qwen2.5-VL 的多模态 RoPE 已给每个 token 三个位置通道。
OctLLM 复用这三个通道,把八叉树节点的 3D 中心坐标(加深度缩放)写进去,使模型同时看到序列历史与空间位置,这是 3D-aware 的关键机制。
VQVAE 码本离散化
用向量量化自编码器把连续形状压缩成有限码本中的索引序列,是 ShapeLLM-Omni、SAR3D 等 3D LLM 的主流表示。压缩不可避免地丢失细几何细节,且索引不再携带显式空间结构。
它是本文的主要对照:论文用消融证明同样的模型换成 S-Octree 而非 1024 个 VQVAE token,FID 直接降低 20.5%,支撑“显式 3D 语言”这一中心论点。
LoRA 低秩适配
冻结原权重、只训练一对低秩矩阵增量 $\Delta W = BA$ 的参数高效微调方法。合并回主干后仍会改变语言 token 所经过的权重;低秩约束也限制了新模态的表达容量。
LoRA 是本文“语言遗忘”对照实验与 token-routed LoRA 消融的对象:rank-64 LoRA 即使混入文本数据仍掉 5.1 分 MMLU,高秩 LoRA 在全量数据上还会梯度爆炸。
FID / KID 与 CLIP 分数
FID 用 Inception-V3 或 DINOv2 特征衡量生成分布与真实分布的均值协方差距离,KID 是无偏最大均值差异,两者越低越好;CLIP 分数取条件与生成渲染的余弦相似度,衡量文本/图像条件一致性。
论文的生成评测全部建立在 Toys4K 上的渲染版 FID/KID/CLIP 协议上,理解这些指标才能读懂 Table 1 及各消融表的数字含义。
研究动机
现有 3D 大语言模型在两个环节都在“打折”。第一是几何如何进入模型:ShapeLLM-Omni 把每个形状压缩成 VQVAE 码本索引,LLM 看到的隐码早已丢失细几何细节、也不再携带显式空间组织;LLaMA-Mesh 把网格序列化成 OBJ 文本,顶点坐标被当作普通字符串,掩盖了形状的局部性与层次性。第二是骨干如何吸收新模态:这些系统普遍用全参数微调或 LoRA 改动预训练权重,语言 token 依赖的通路被 3D 梯度覆写。作者在 Section 4 给出了触目惊心的数字:3D 训练后 ShapeLLM-Omni 的 MMLU 从骨干的 64.65 跌到 30.17,HellaSwag 从 67.44 跌到 26.74,GSM8K 从 83.54 跌到 27.45;LLaMA-Mesh 也跌到 51.84/34.03/52.69——通用语言能力损失三分之一到一半。
本文的目标是论文目标是构建一个同时满足两个要求的 3D 原生多模态 LLM:其一,3D 几何以保留空间结构的显式形式进入模型,让 LLM 能直接读写坐标与层次都清晰的几何序列,从而在生成中保住部件级结构、在理解中产出更准确的 3D 描述;其二,获取 3D 模态的过程不得侵蚀骨干的通用语言能力。落到可检验的指标上,就是在统一多模态 LLM 阵营内做到图像到 3D、文本到 3D 生成与 3D 描述的 SOTA,同时让 MMLU、HellaSwag 与冻结骨干完全一致、GSM8K 差距小于 1 分。
与已有工作不同的是,本文的独特切入有两条,都来自对现有方案“缺什么”的重新框定。表示侧,作者把八叉树当作 LLM 可直接读写的“显式 3D 语言”而非压缩中间产物:每个占据 token 都锚定 3D 坐标与深度,空间局部性和层次结构不再被隐码或坐标文本隐藏。适配侧,作者把 2D 多模态中已验证的模态解耦原则(Mixture-of-Transformers、X-Fusion 的“各模态走各自权重、共享自注意力”)首次系统搬进 3D:mesh token 路由到独立的全秩 3D 分支,文本图像 token 留在冻结通路。已有多数 3D LLM 采用“改权重”路线,没有任何一个同时做到显式层次表示与参数隔离。
核心方法
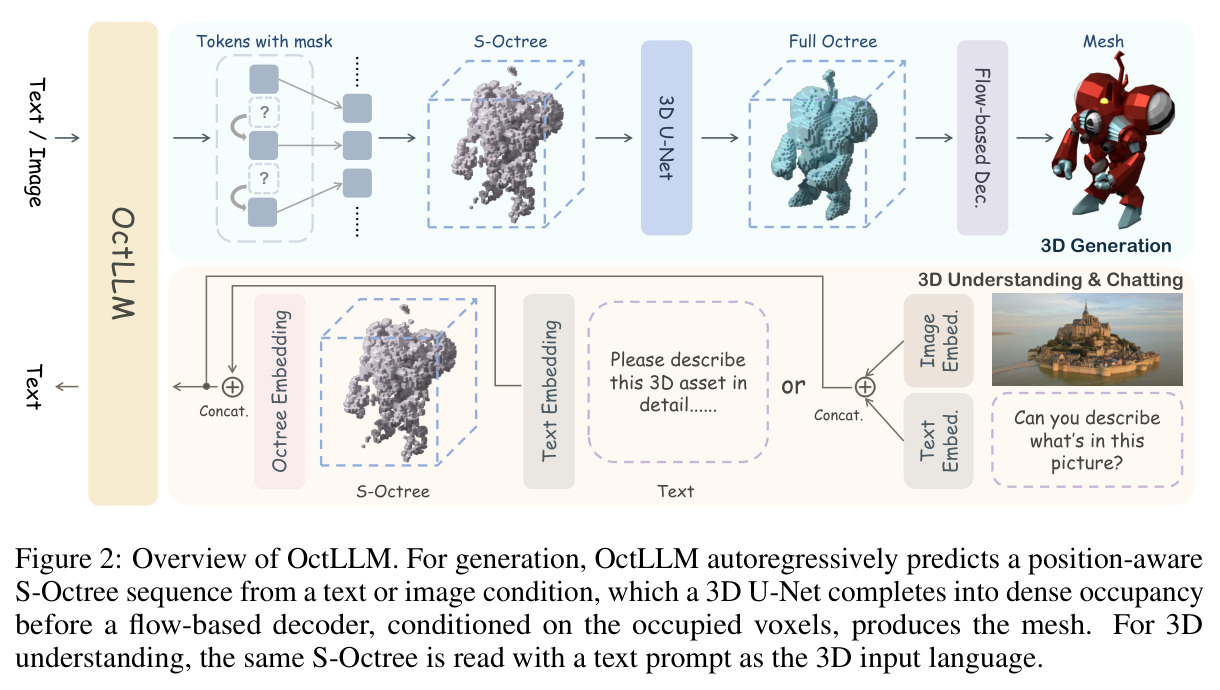
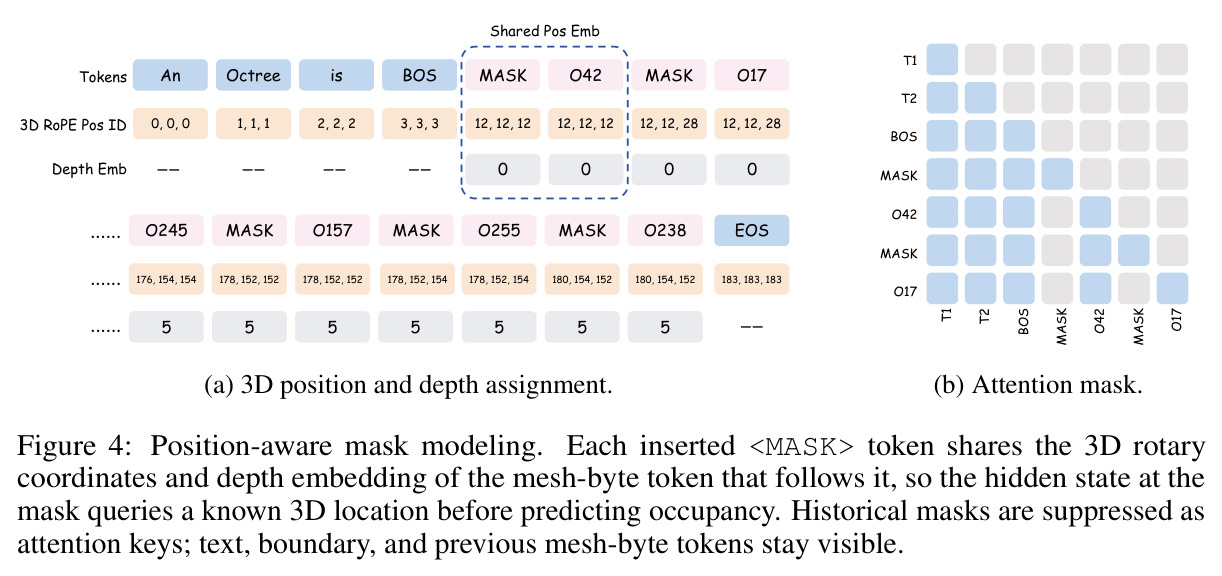
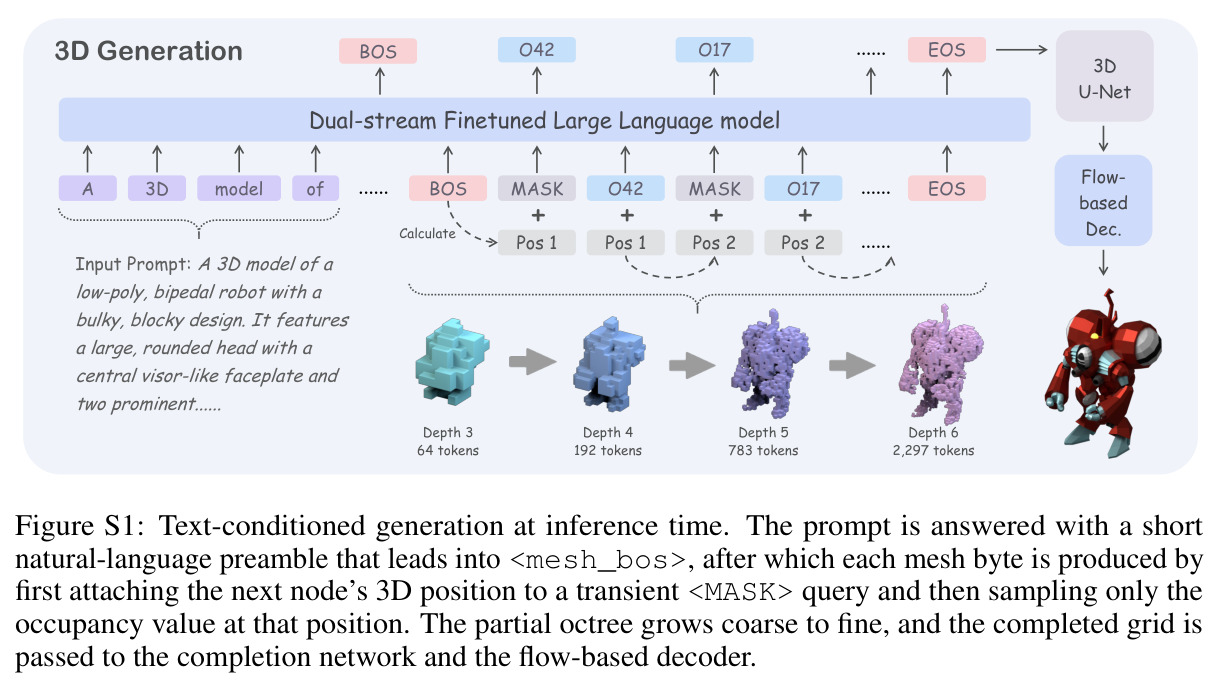
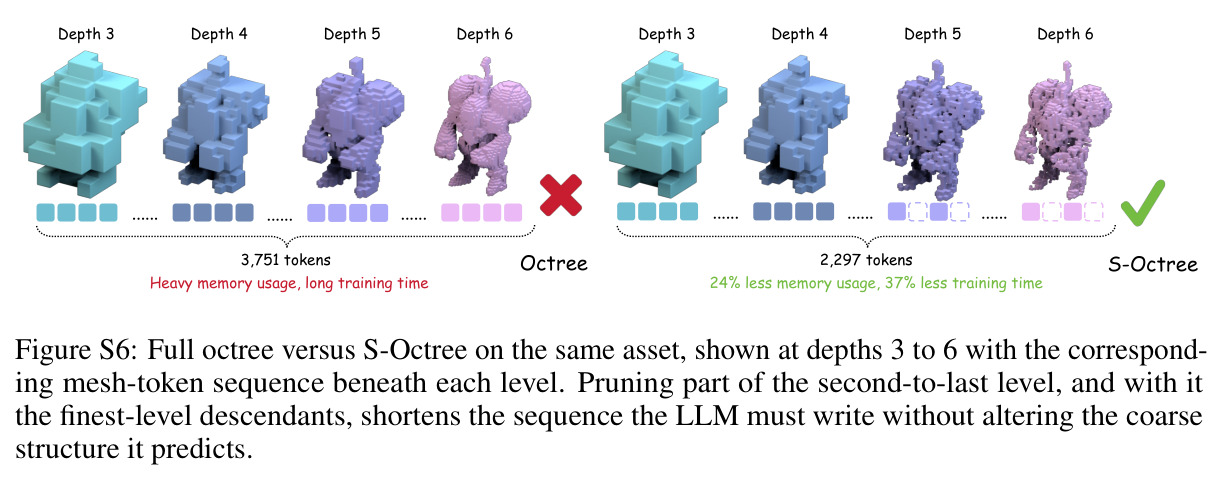
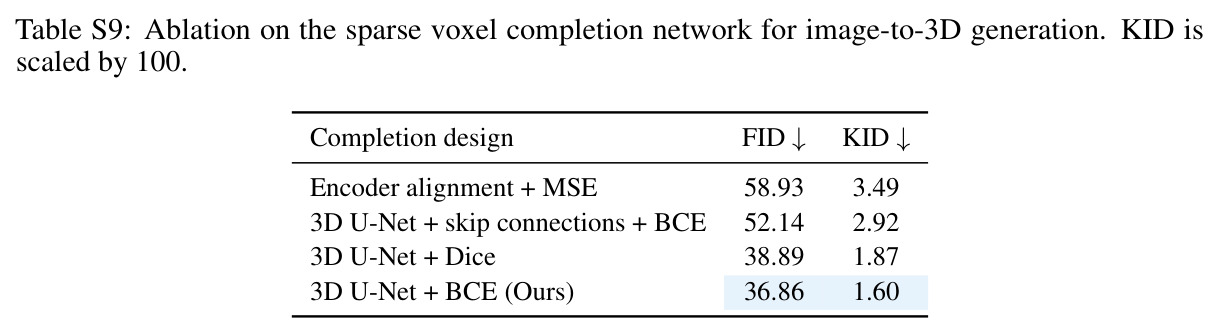
先说直觉:让 LLM 直接“看见”带坐标的几何本身,同时让 3D 学习只发生在自己的参数里。技术路线分四步。第一步 token 化:输入网格被体素化为深度 6 的八叉树(最细分辨率 $64^3$),按 Z-order 遍历,把每 8 个占据位打包成一个取值 $[0,255]$ 的 mesh 字节 token,序列长度比二进制序列缩短 8 倍;再随机把倒数第二层 50% 的节点置空并删去其最细层后代,得到更短的 S-Octree。第二步生成:自回归预测每个字节前先插入携带目标 3D 位置与深度的 $\langle MASK\rangle$ 查询 token,历史掩码在注意力中被抑制。第三步补全:3D U-Net 把稀疏占据补成稠密占据。第四步解码:TRELLIS 流匹配生成器以占据坐标为结构条件、原文本/图像为语义条件,输出最终带纹理网格。理解任务则把 S-Octree 直接作为输入与文本一起喂给模型。
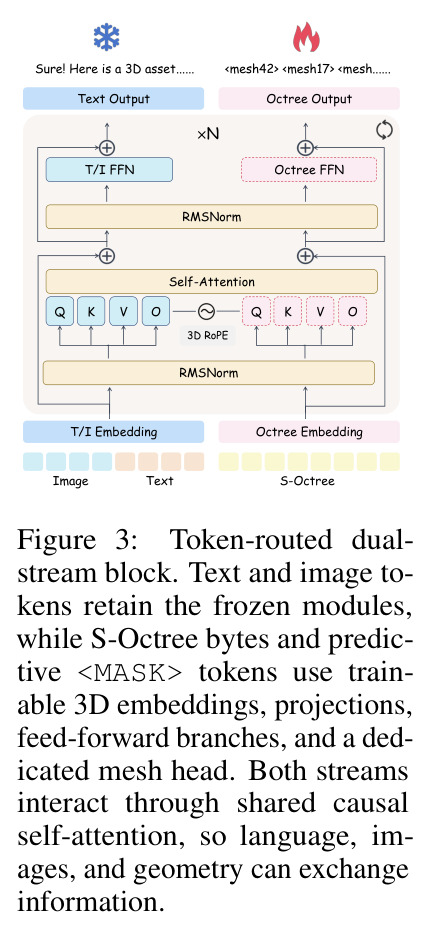
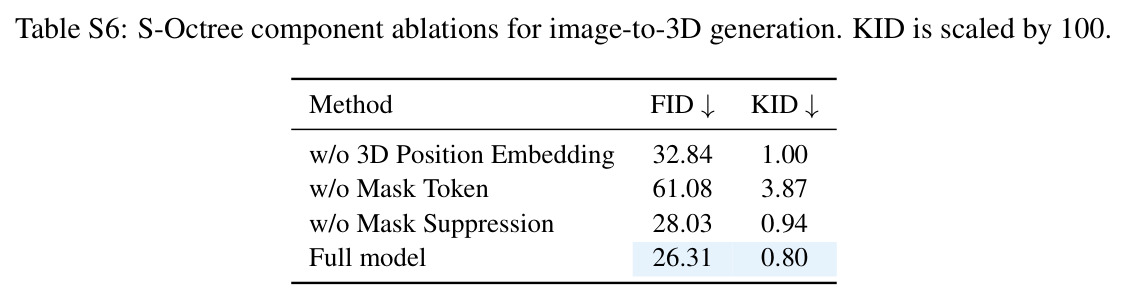
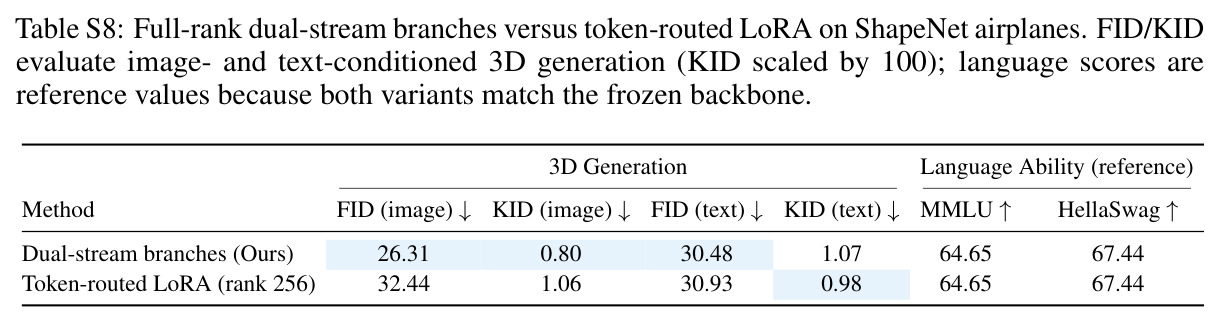
核心创新一是“显式 3D 语言 + 位置感知掩码建模”:与 VQVAE 隐码或 OBJ 文本有本质区别,占据字节保留坐标与层次,LLM 直接建模空间结构(消融显示比 1024 个 VQVAE token 降低 FID 20.5%);掩码查询把“在哪预测”与“预测什么”解耦,历史掩码作为纯位置查询被从注意力键中剔除。核心创新二是“token 路由双流架构”:路由指示 $r_i=1$ 的 mesh 与掩码 token 走可训练 3D 分支,$r_i=0$ 的文本图像 token 走冻结通路,FFN 按 $\mathrm{FFN}_{route}^{\ell}(h_i) = (1-r_i)\,\mathrm{FFN}_{base}^{\ell}(h_i) + r_i\,\mathrm{FFN}_{3D}^{\ell}(h_i)$ 选择分支,Q/K/V/O 投影同理,两流仅共享因果自注意力。这与全参微调的区别是 3D 梯度永不触碰语言通路,与 LoRA 的区别是 3D 分支全秩、容量不受低秩约束;mesh 词表还配独立嵌入与输出头,占据预测不与词预测竞争。
方法步骤详情
数据:合并 Objaverse-XL Sketchfab 子集、HSSD、ABO 与 ShapeNet,按 TRELLIS 流程渲染 24 视角,四个固定视角由 Qwen3.5-9B 生成几何标注,得 195K 资产、585K 条指令。模型:冻结 Qwen2.5-VL-7B-Instruct 骨干,28 层中 12 层插入 3D 分支,新增约 2.80B 可训练参数,mesh 词表含 256 个占据字节 token 与边界、掩码 token。训练:生成样本对每个目标字节插入位置感知掩码并经 mesh head 监督,理解样本不加掩码、只监督语言回答,损失 $\mathcal{L}_{LLM} = -\frac{1}{|T_{text}|+|T_{mesh}|}\big(\sum_{T_{text}}\log P_{vocab} + \sum_{T_{mesh}}\log P_{mesh}\big)$;主模型 69K 步、16 张 H20,补全网络 155K 步、8 张 RTX 5090。推理:部分八叉树唯一确定下一节点,挂掩码查询在 256 个合法字节内采样,KV 缓存随即删除该查询,U-Net 补全后交 TRELLIS 出网格。
技术新颖性
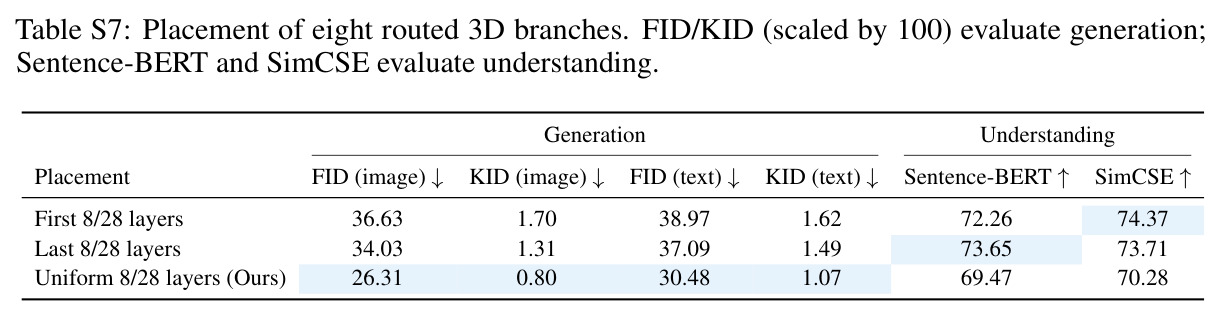
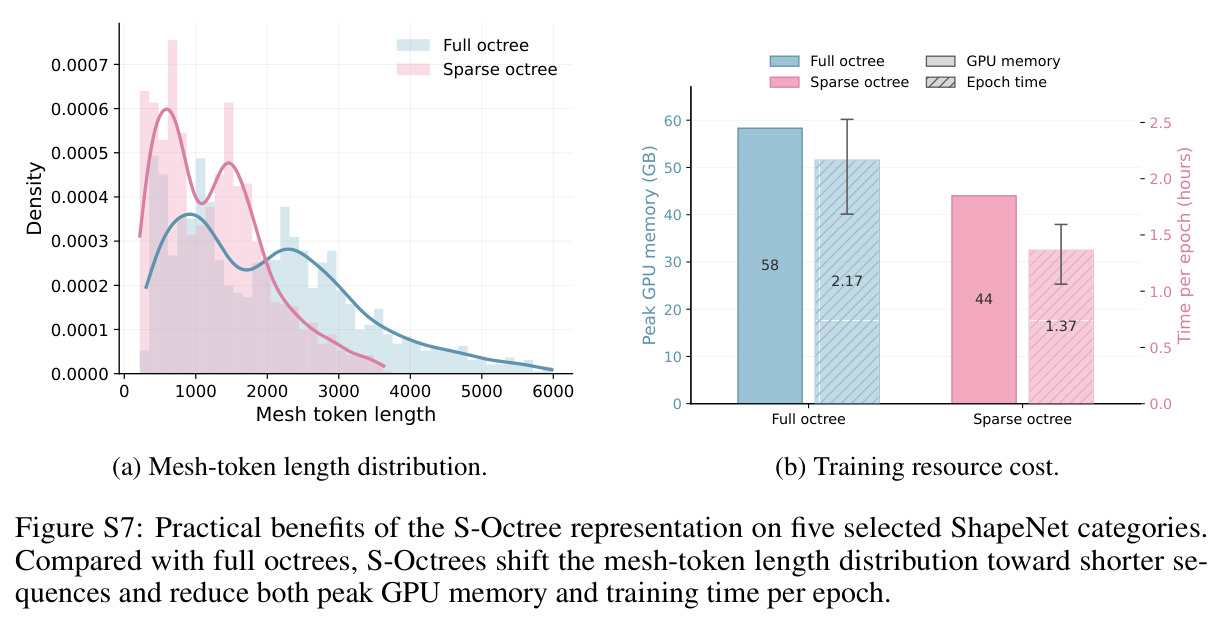
技术新颖性体现在多处组合设计。S-Octree 的“随机剪枝 + 网络补全”创造了一种新的职责分工:LLM 专注全局布局与非平凡部件,几何网络负责稠密局部补全,实测省 24% 显存、1.6 倍训练速度且质量不降(FID 26.31 vs 全八叉树 27.54)。3D RoPE 优雅地复用 Qwen2.5-VL 已有的三通道多模态位置通道,让“序列秩”让位于“3D 坐标”,再配可学习深度嵌入统一不同层级的坐标尺度。位置感知掩码借鉴了 Uni-3DAR,但作者把它嵌入通用 LLM 的双流框架,并在推理时通过删除 KV 条目实现掩码抑制,保持上下文干净。分支放置研究给出实证结论:均匀覆盖全深度最优,预算增加时应投向后半段更深的层。与 OctGPT 的区别在于 OctGPT 是任务专用生成器,本文把八叉树语言接入通用多模态 LLM 并首次做到“学 3D 不忘语言”;与 2D 模态解耦工作(Mixture-of-Transformers)的区别在于新增了独立 mesh 嵌入、输出头与引导性自然语言前缀来解决 $\langle mesh\_bos\rangle$ 冷启动。
实验结果
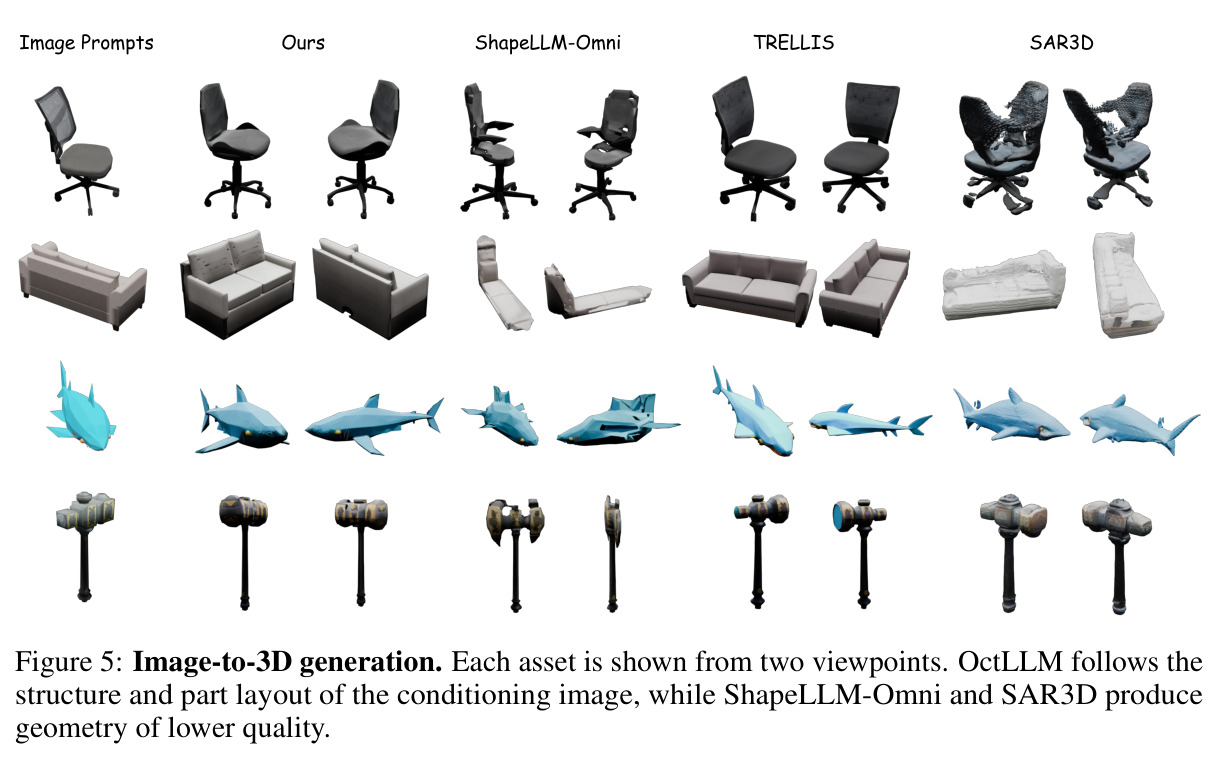
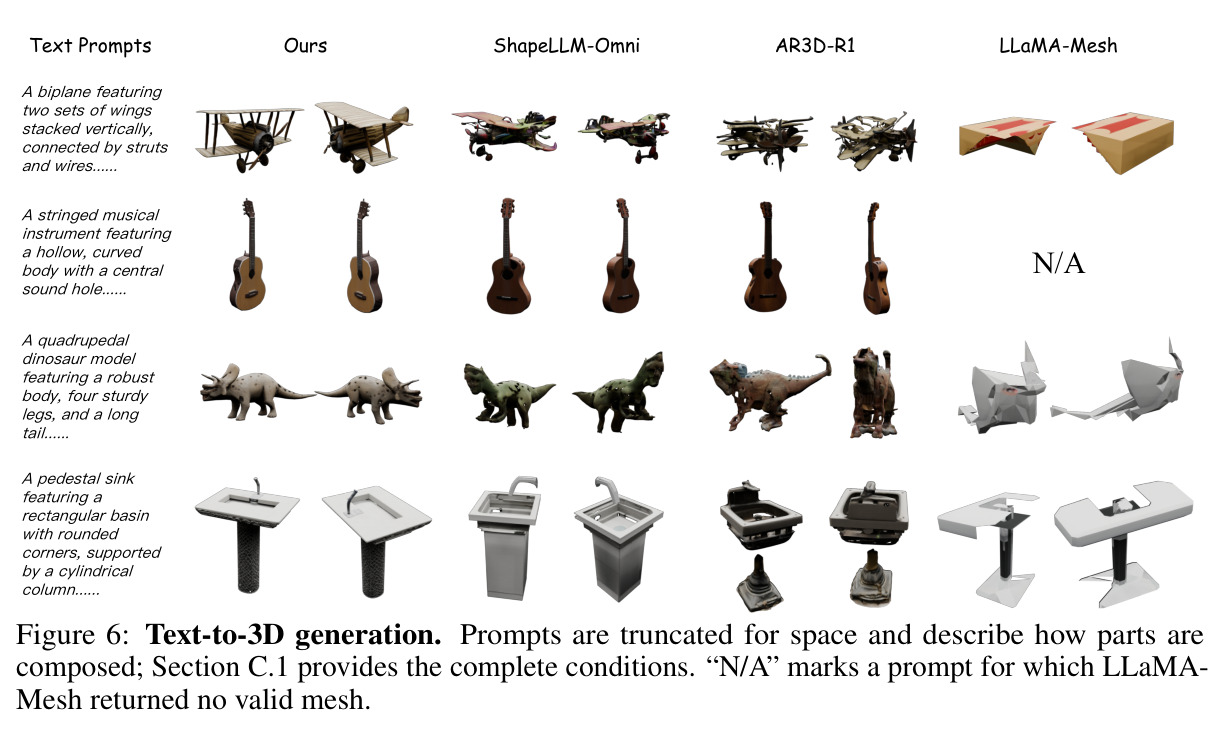
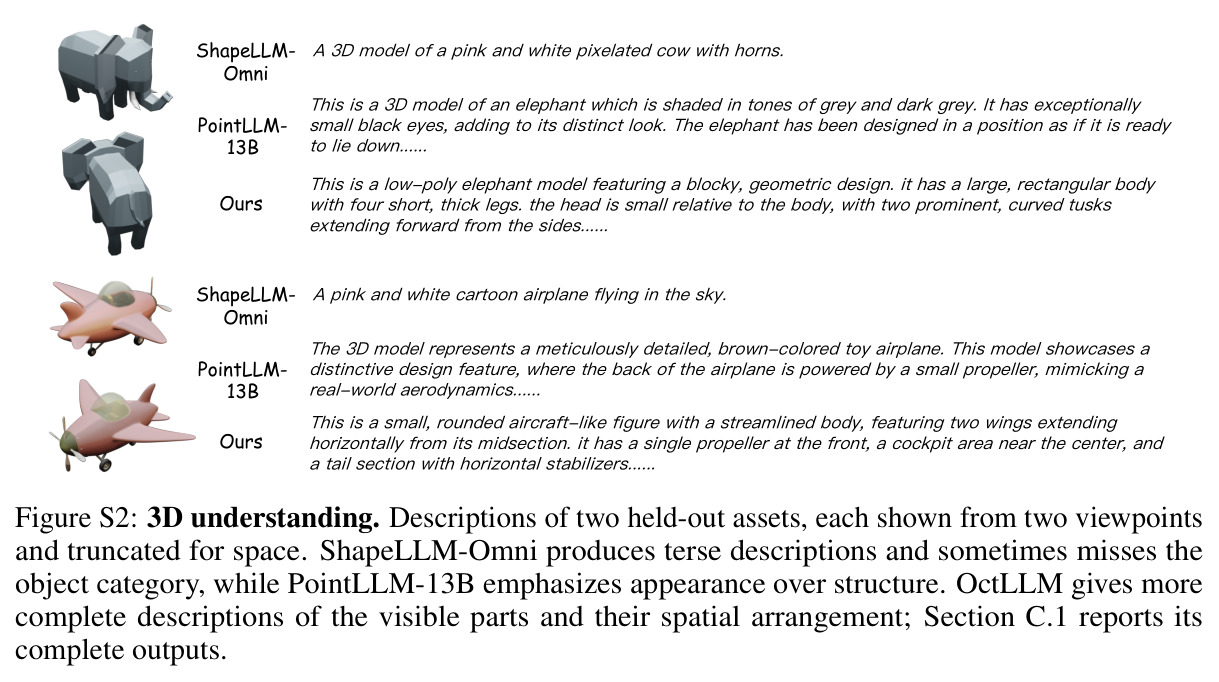
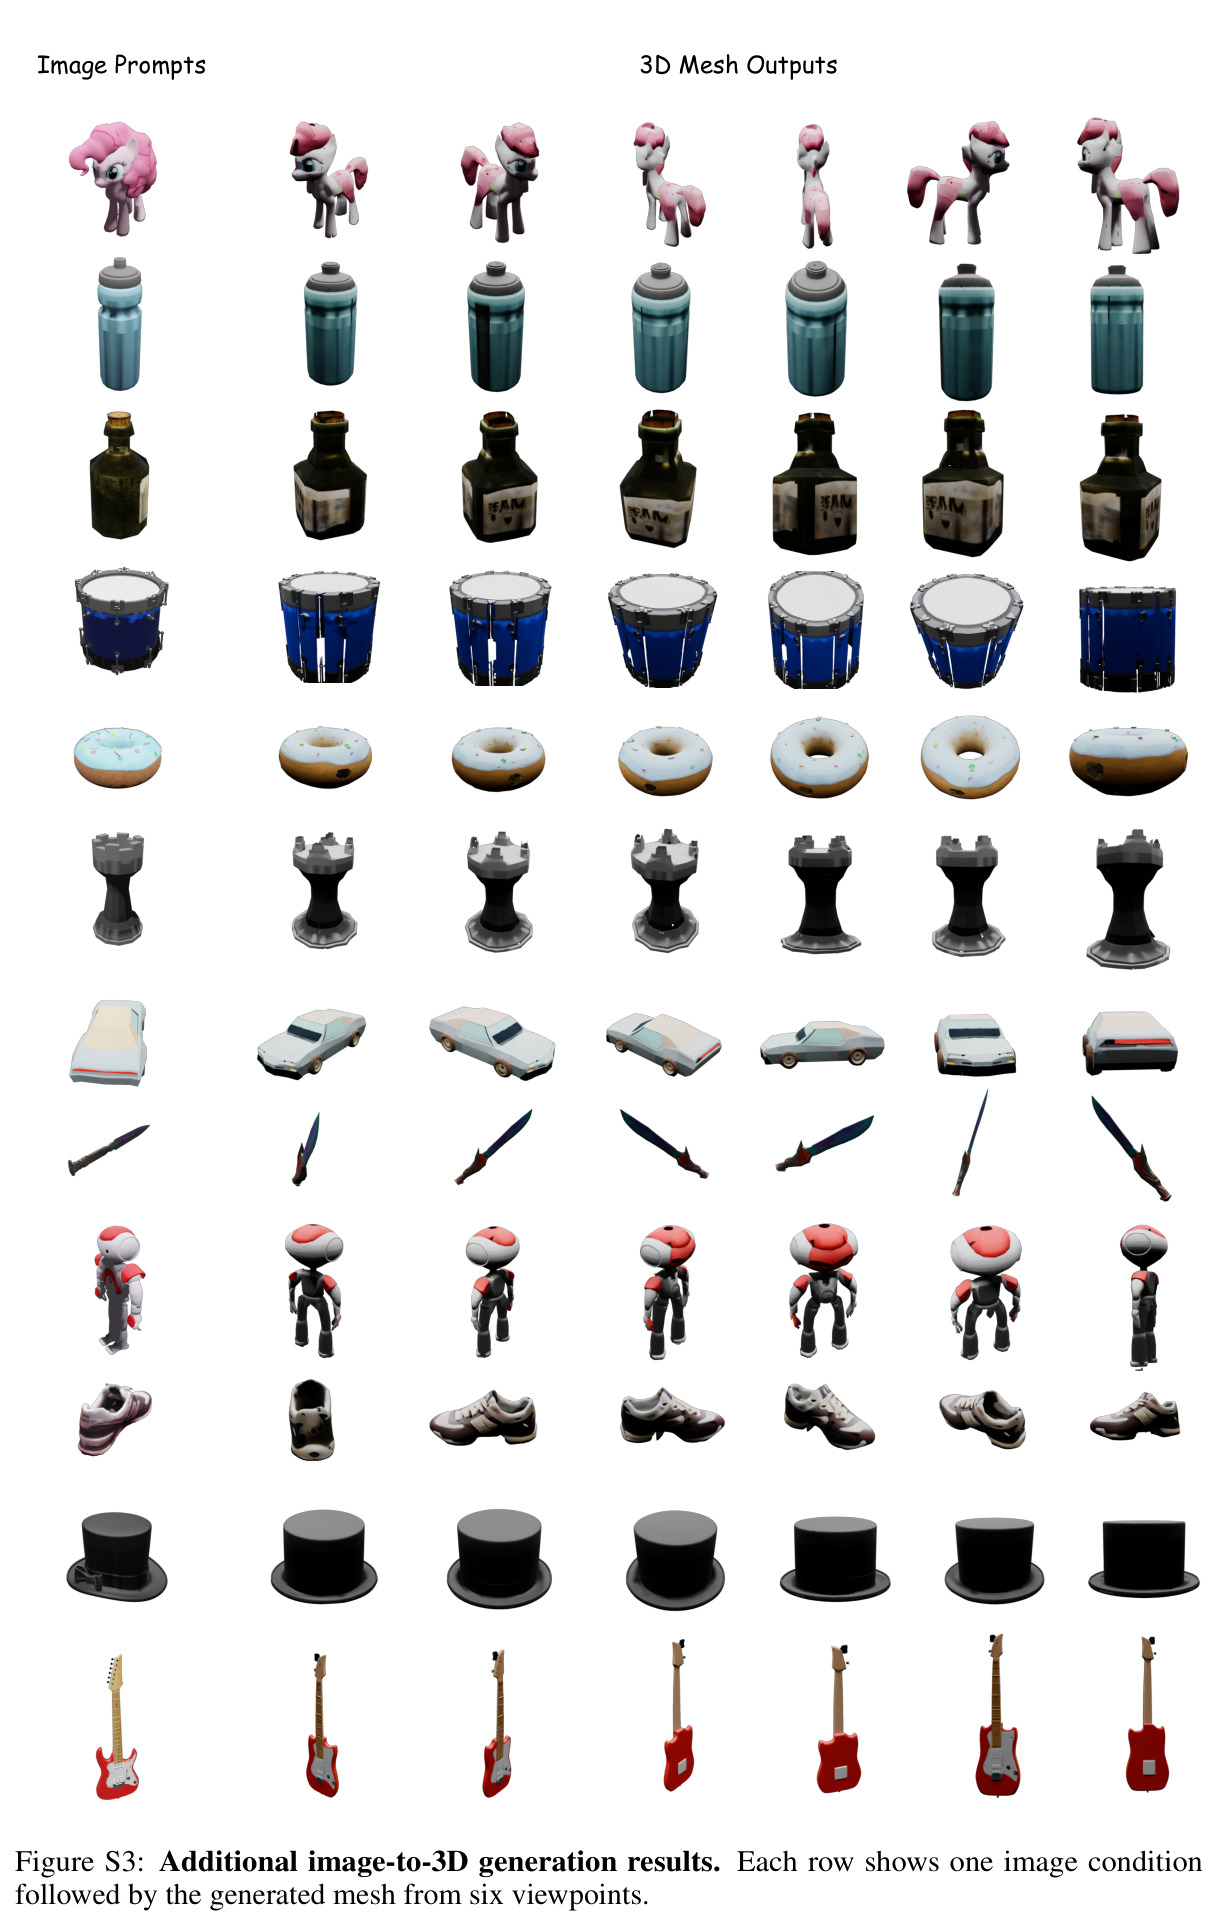
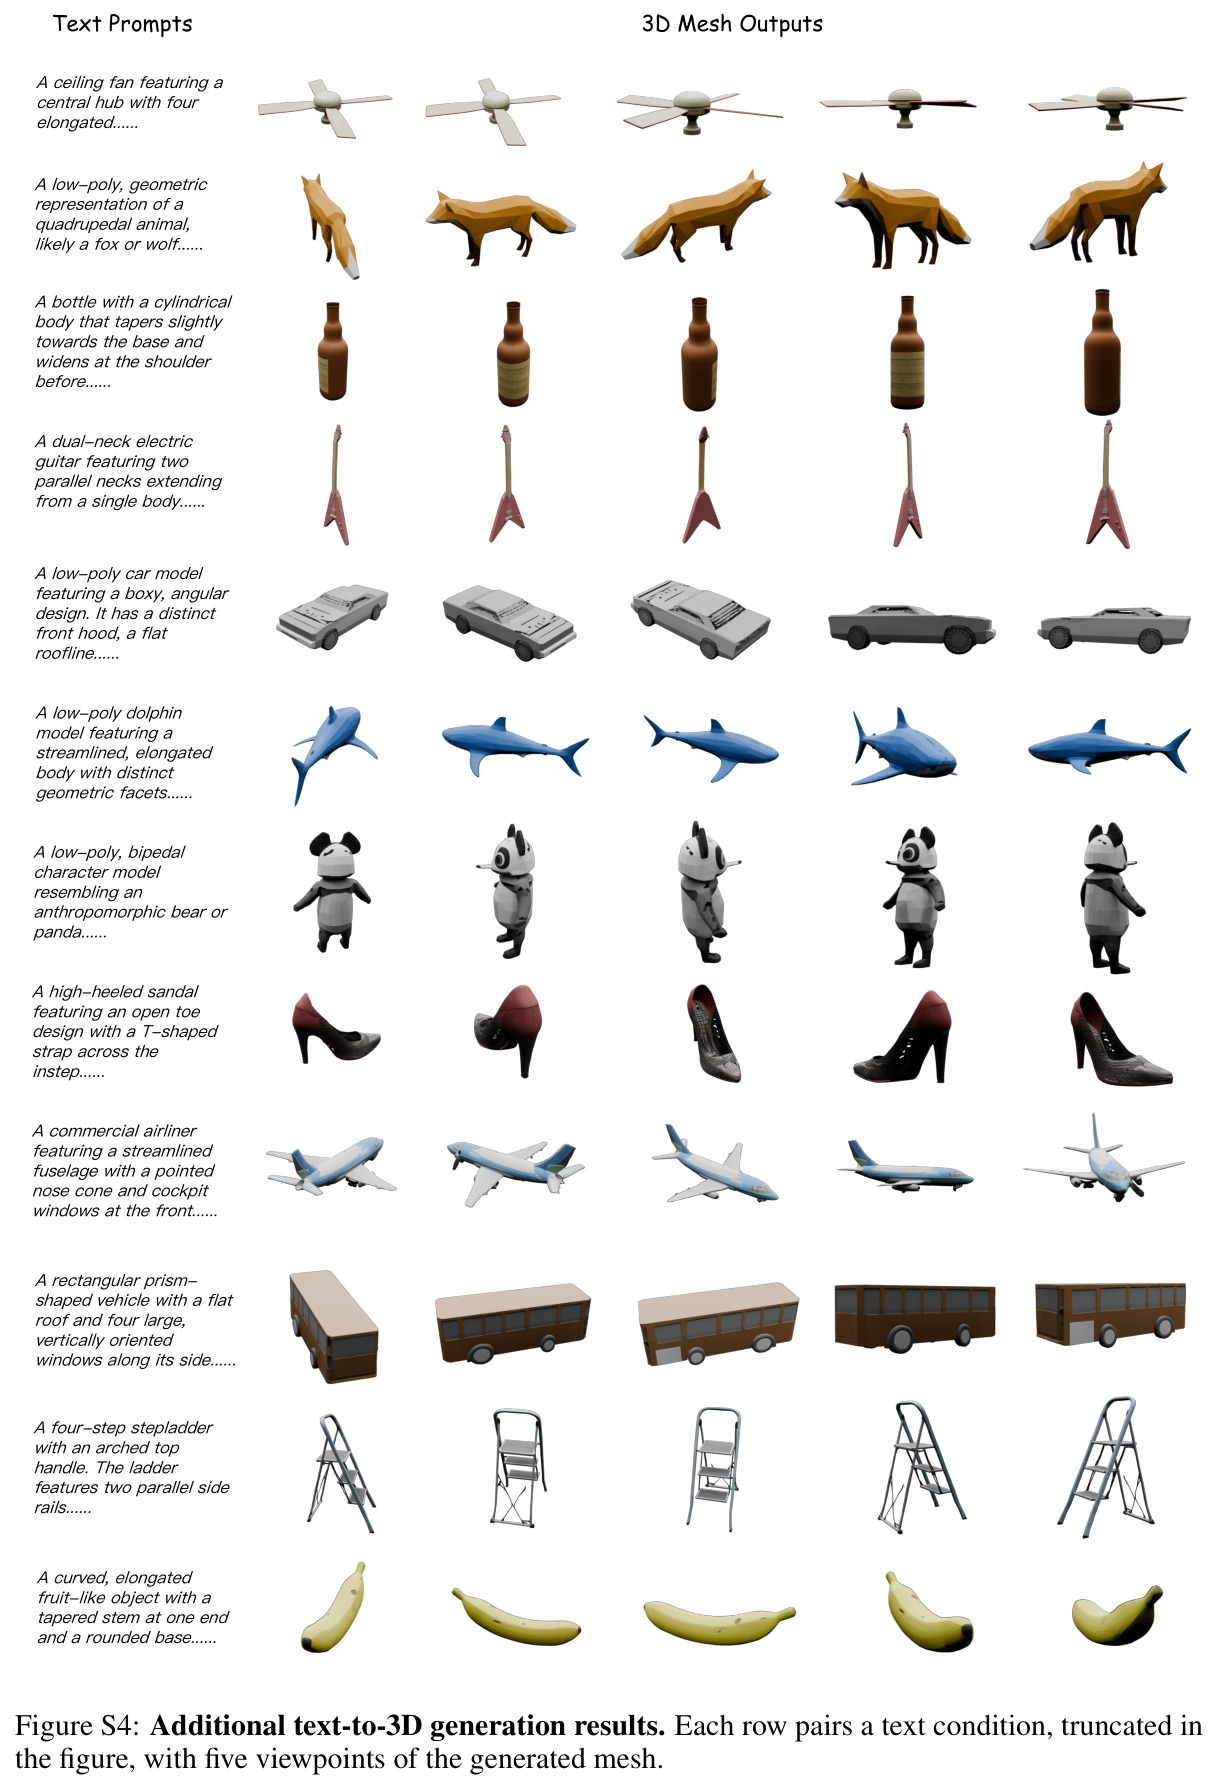
实验逐一拆解。图像到 3D(Toys4K):Inception FID 31.58、KID 0.56,较 ShapeLLM-Omni(38.21/1.02)降低 17.4% 与 45%,DINOv2 指标与 CLIP 对齐(87.31)同样领先;TRELLIS 仍全场最佳(18.15),但 LLM 基线同样用它解码,差距确实来自表示与管线。文本到 3D:FID 45.61 优于 ShapeLLM-Omni 52.36 与 LLaMA-Mesh 66.68,也略胜专用生成器 OctGPT(46.40),KID 0.98 全场最佳。理解(PointLLM-200):渲染锚定评委 GPT-img 46.88 全场最佳,较 ShapeLLM-Omni 高 28.7 分,其余三项为多模态 LLM 第一,但逊于读彩色点云的 PointLLM-7B。语言保持:MMLU 64.65、HellaSwag 67.44 与骨干完全一致,GSM8K 83.01 仅差 0.53,IFEval 差距屏蔽 mesh 词表即消除;对照 ShapeLLM-Omni 掉 34.5/40.7 分。效率:均 1,277 token、37.59 秒,快于 LLaMA-Mesh 85.30 秒与 OctGPT 52.53 秒。消融:S-Octree 较 VQVAE 降 FID 20.5%,去掩码 token 最伤(26.31→61.08),全秩分支优于 rank-256 LoRA。
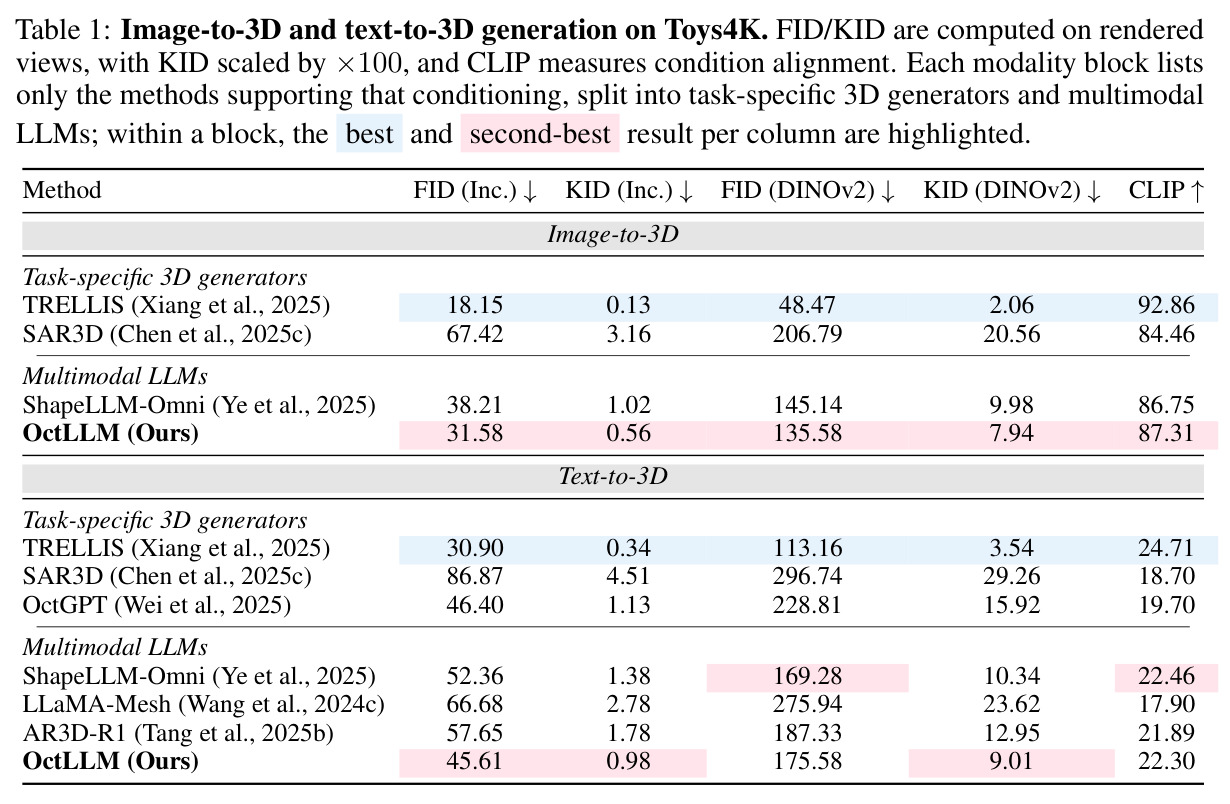
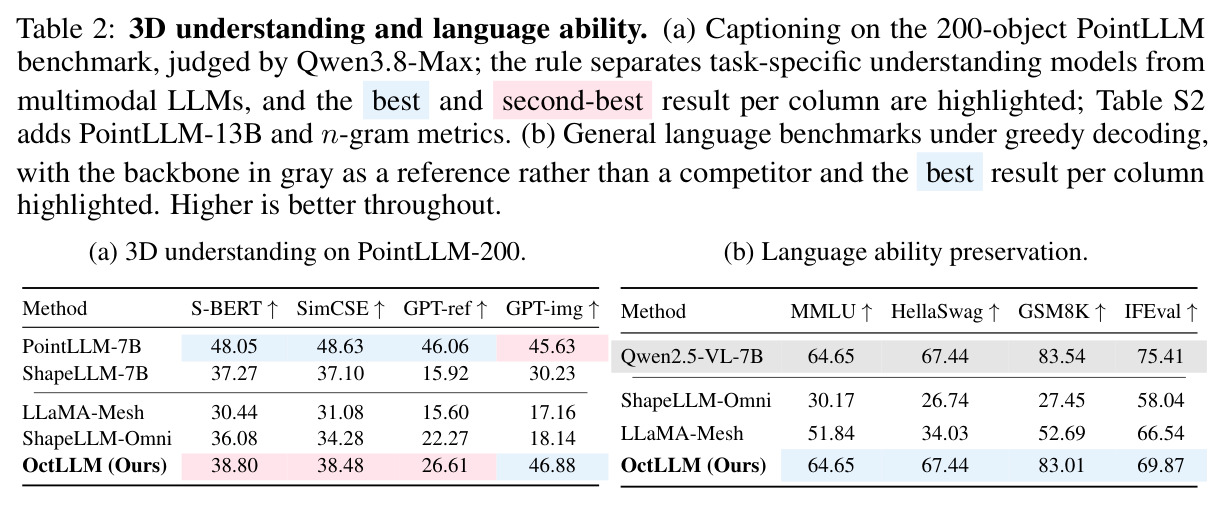
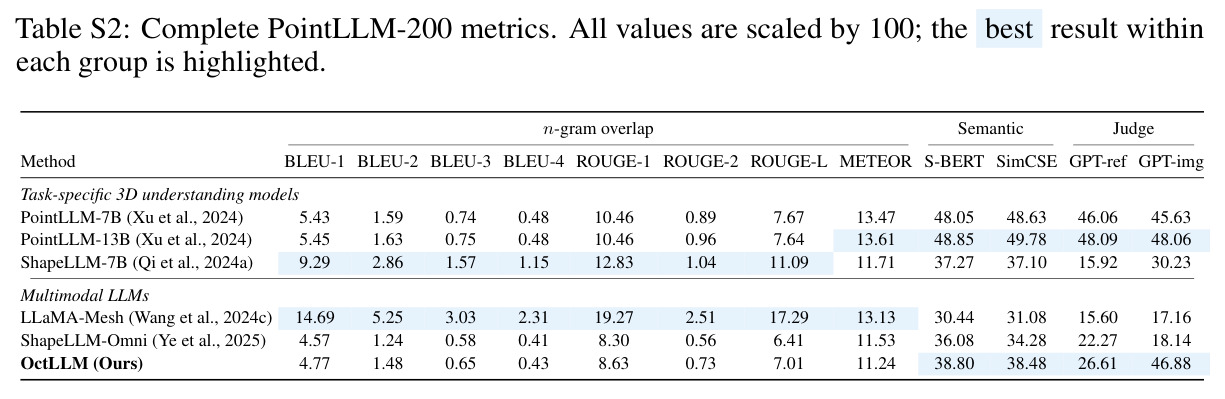
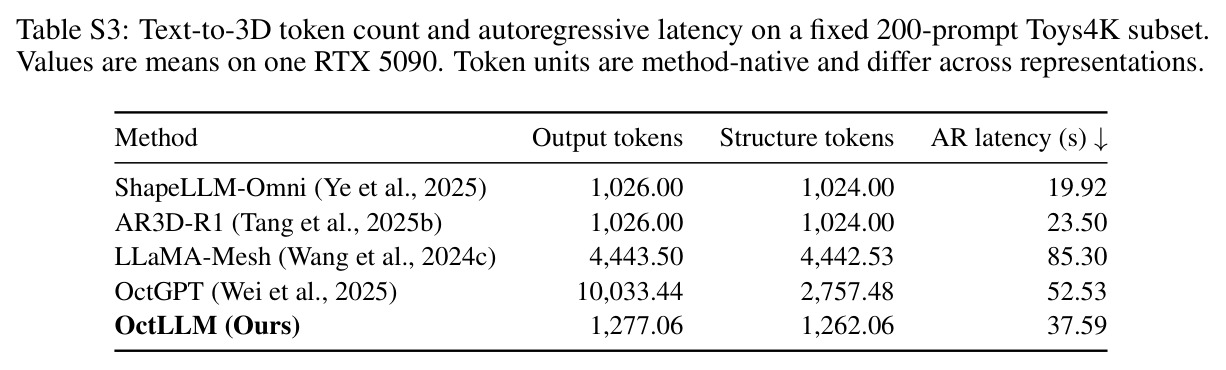
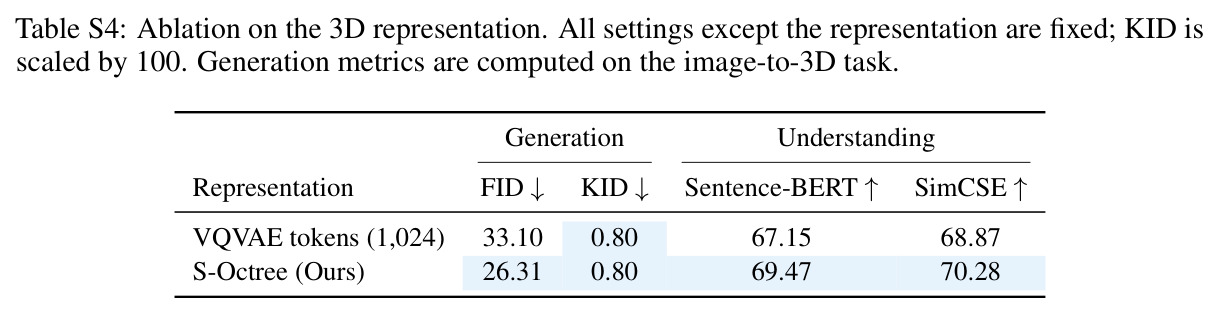
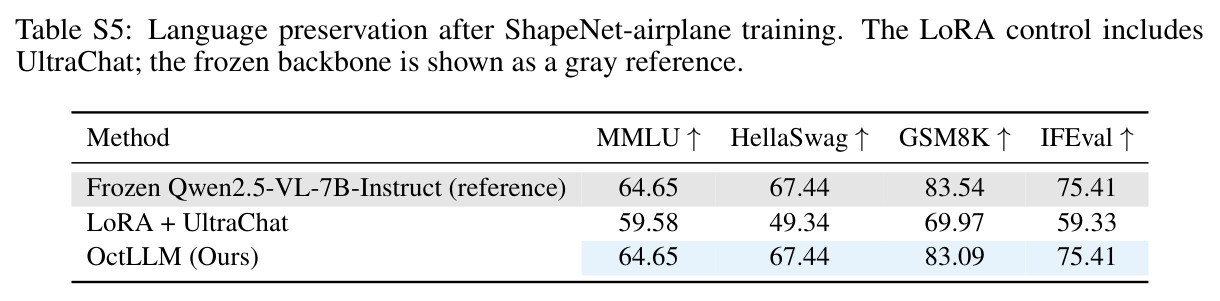
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像到3D生成(Toys4K) | Inception FID ↓ | 31.58 | 38.21(ShapeLLM-Omni,多模态LLM最优基线) | 降低17.4% |
| 图像到3D生成(Toys4K) | Inception KID(×100)↓ | 0.56 | 1.02(ShapeLLM-Omni) | 降低45% |
| 文本到3D生成(Toys4K) | Inception FID ↓ | 45.61 | 52.36(ShapeLLM-Omni)/ 46.40(专用生成器OctGPT) | 降低12.9%,并首次超越专用八叉树生成器OctGPT |
| 3D描述(PointLLM-200) | GPT-img 渲染锚定评委 ↑ | 46.88 | 18.14(ShapeLLM-Omni) | +28.7分,全场最佳(含任务专用模型) |
| 语言能力保持 | MMLU ↑ | 64.65 | 骨干64.65;ShapeLLM-Omni 30.17 | 与骨干完全一致,对手损失34.5分 |
| 语言能力保持 | HellaSwag ↑ | 67.44 | 骨干67.44;ShapeLLM-Omni 26.74 | 与骨干完全一致,对手损失40.7分 |
| 3D表示消融(ShapeNet飞机) | 图像到3D FID ↓ | 26.31(S-Octree) | 33.10(VQVAE 1024 token) | 降低20.5%,且理解指标S-BERT/SimCSE同步提升 |
| 自回归推理效率(200条Toys4K提示) | AR延迟(秒)↓ | 37.59(均1,277 token) | 85.30(LLaMA-Mesh)/ 52.53(OctGPT) | 快约2.3×/1.4× |
局限与改进
作者在附录 E 承认三点局限。第一,变长 S-Octree 平均 1,793 个 token,比 ShapeLLM-Omni 固定 1,024 token 更长,推高训练时间与显存。第二,几何要经过 S-Octree 生成与 3D U-Net 补全两次学习预测,上游占据误差会传播甚至放大,产生孔洞等伪影。第三,S-Octree 只编码几何,不支持颜色材质等外观的理解,也不支持 3D 编辑。我的补充观察:其一,生成质量上限实际被外挂的 TRELLIS 解码器卡住(TRELLIS 自身 FID 18.15 vs OctLLM 31.58),“统一 LLM”的 3D 保真度仍明显落后专用系统;其二,50% 剪枝是均匀随机而非按部件复杂度自适应,细小关键部件可能被过度剪除后补不全;其三,评测规模偏小(生成仅 Toys4K 1K 资产、理解仅 200 个物体),且评委单一依赖 Qwen3.8-Max;其四,所谓“参数高效”只是相对全参微调,2.80B 新增参数的绝对开销并不小,部署时显存占用同样上升。
独立分析的弱点
独立分析弱点并给改进方向。第一,双阶段误差级联:LLM 预测的占据错误会被 U-Net 补全放大成孔洞伪影(作者亦承认),改进方向是补全网络与 LLM 端到端联合训练,或让补全网络接收 LLM 的预测不确定性。第二,表示无外观通道:模型无法描述颜色材质,理解评测因此在 GPT-ref/S-BERT 上输给读彩色点云的 PointLLM-7B,可扩展为“占据+外观”双通道 token。第三,均匀 50% 剪枝一刀切:对细节密集的物体会系统性丢失细部,应按局部占据密度自适应分配剪枝率,作者也提到空间自适应细化。第四,依赖外部 TRELLIS:管线并非端到端,最终质量与延迟瓶颈都在外部解码器,可训练自家的流匹配输出头。第五,IFEval 上 mesh head 误触发说明双词表边界训练欠稳,可用更强输出格式约束。第六,评委单一依赖 Qwen3.8-Max 且未报告与人工评测的对齐度。第七,12 个路由块共 2.80B 新参数,“参数高效”只是相对全参微调,绝对开销不小,可探索分支共享或分组低秩投影。
未来方向
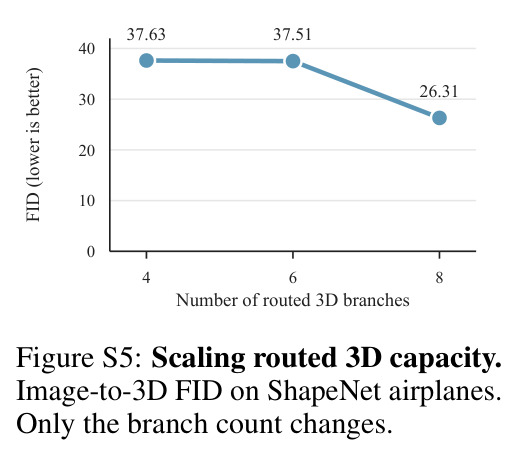
作者明确提出的方向包括:为 S-Octree 增加原生颜色与材质通道,使 OctLLM 能像描述几何一样描述外观;训练自有的 3D 生成头以摆脱对 TRELLIS 的依赖;引入 3D 编辑能力;以及用空间自适应八叉树细化缩短变长序列。基于本文成果还可以自然延伸:其一,把八叉树语言从单物体推广到场景级与多物体组合生成,天然支持部件级的增删改,这正好接上 3D 编辑;其二,研究路由块数量与骨干规模的缩放律——消融已显示 4/6/8 分支存在明显拐点,更系统的 scaling 分析有空间;其三,把位置感知掩码查询与并行/投机解码结合,进一步压缩 37.59 秒的自回归延迟;其四,将显式占据语言用于机器人操臂、具身导航等需要结构化空间推理的下游任务;其五,探索把 S-Octree 与物理仿真或可微渲染结合,让 LLM 的 3D 输出直接接受物理或感知反馈的强化学习优化。
复现评估
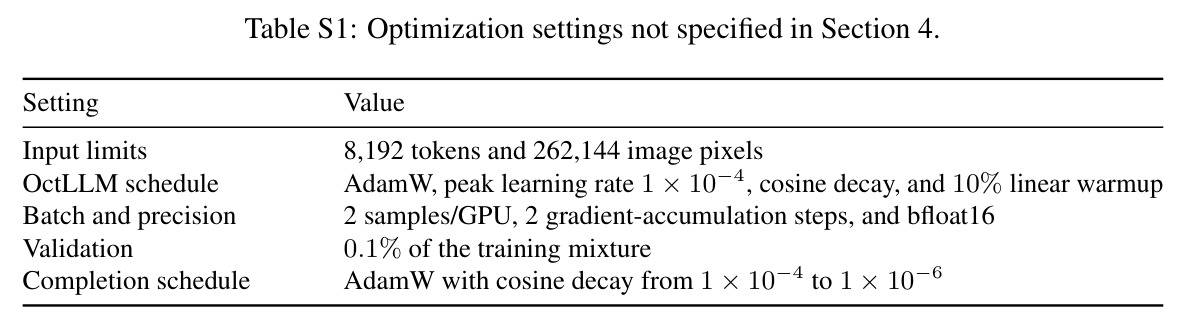
复现条件友好但算力门槛不低。开源:代码与权重已公开,论文附训练与推理的 Algorithm S1/S2、系统提示词原文、两个评委完整 prompt、渲染协议(Blender 4.0 EEVEE、24 个 Hammersley 相机)与全部超参(AdamW、峰值学习率 $1\times10^{-4}$、余弦衰减、10% warmup、bf16、有效批 64)。数据:需获取 Objaverse-XL Sketchfab 子集、HSSD、ABO、ShapeNet 并按 TRELLIS 流程重跑 24 视角渲染,标注依赖本地部署的 Qwen3.5-9B。算力:主模型 16 张 H20 跑 69K 步,补全网络 8 张 RTX 5090 跑 155K 步,这是主要门槛;S-Octree 把峰值显存从 58GB 压到 44GB,可塞进 48GB 的 L40,消融级复现(ShapeNet 飞机、4 张 80GB A100、至多 15 epoch)成本温和,可先复现 Table S4-S9 再考虑全量训练。综合评估:文档与代码齐备、协议透明,属于认真投入可以完整复现的工作,难度中等偏上。
论文图表
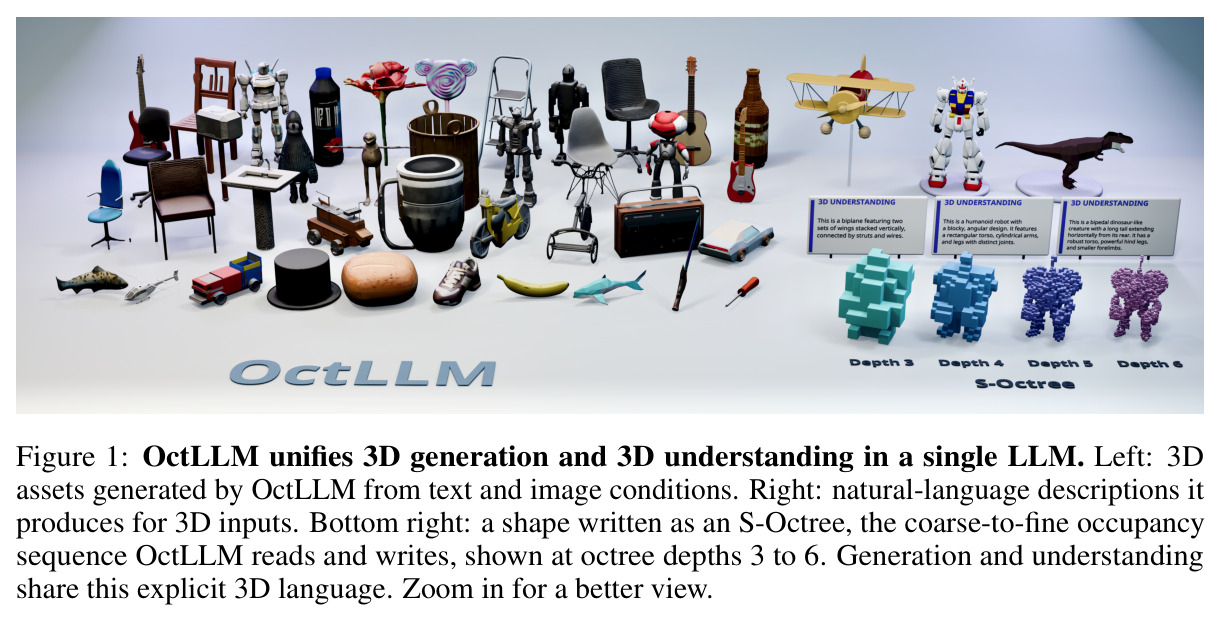
概览图:左侧展示 OctLLM 由文本与图像条件生成的 3D 资产,右侧展示它为 3D 输入生成的自然语言描述,右下角展示一个形状被写成 S-Octree(深度 3 到 6 的粗到细占据序列)。
一图总览论文要解决的统一问题:生成与理解共享同一显式 3D 语言,是快速建立直觉的入口。