Imagine3D-LLM:教会多模态大模型在回答前想象三维场景 Imagine3D-LLM: Teaching MLLMs to Imagine 3D Scenes Before Answering
让多模态大模型在LLM内部想象出紧凑3D高斯场景再作答,空间推理大幅超越像素级几何注入
前置知识
多模态大语言模型(MLLM)
由视觉编码器、视觉-语言投影层和预训练 LLM 组成的模型。每张输入图像先被切成 patch 编码成视觉 token,投影到语言嵌入空间后与文本 token 拼接,一起送入 LLM 做因果注意力并自回归生成文本。LLaVA-Video-7B 每张图编码为 210 个 token,是本文的基座模型。
本文的全部改动都发生在 MLLM 的 token 序列和 LLM 内部:往序列里插入可学习的高斯摘要 token,并从 LLM 中间层抽取隐状态解码 3D 表示,不先理解 MLLM 的输入组织方式就无法理解方法本身。
3D高斯泼溅(3DGS)
一种显式场景表示:把场景表示为一组各向异性 3D 高斯基元,每个高斯由中心 $\mu\in\mathbb{R}^3$、不透明度 $\sigma\in[0,1)$、协方差矩阵 $\Sigma\in\mathbb{R}^{3\times3}$ 和球谐系数 $c$(编码视角相关颜色)参数化,可通过可微光栅化从任意视角实时渲染出图像。
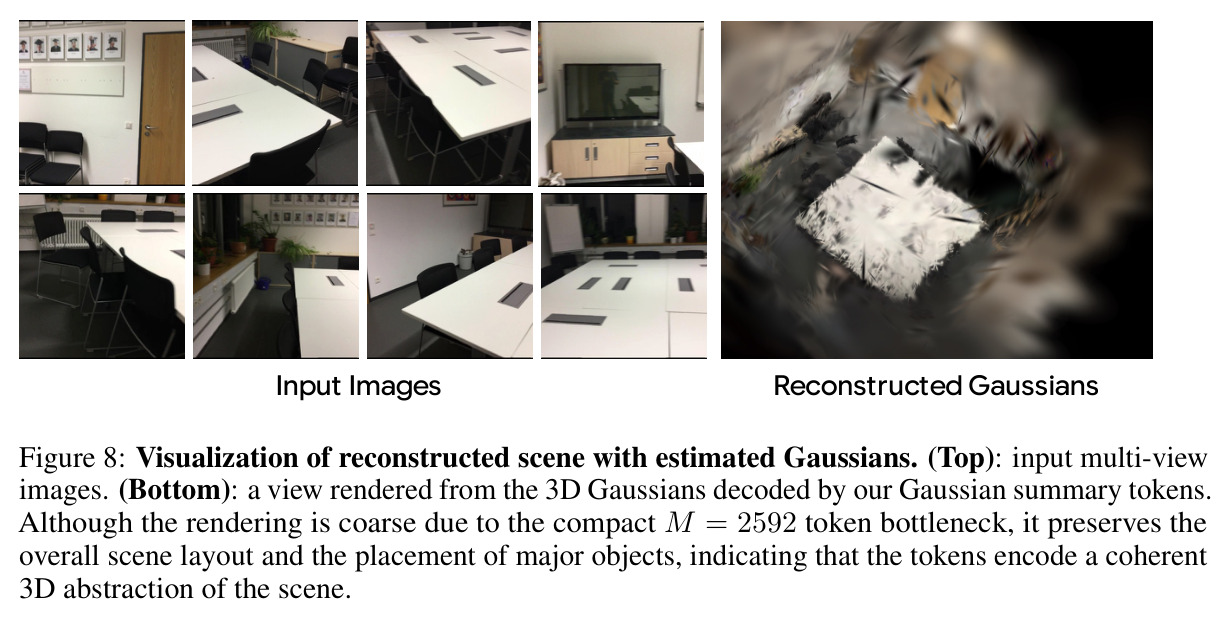
本文让摘要 token 解码出的正是 3DGS 参数:每个摘要 token 解码 32 个高斯,全场景约 8.3 万个高斯构成紧凑场景表示,重建损失就靠把渲染结果与真实输入帧对比来监督。
可微渲染与光度损失
可微光栅化把 3D 高斯投影到指定相机视角生成图像 $\hat{I}_k$,整个渲染过程对高斯参数可导,因此可以把渲染图与真实图 $I_k$ 逐像素比较(MSE 损失加感知相似的 LPIPS 损失)作为损失反向传播,无需 3D 真值标注即可监督 3D 表示学习。
光度重建损失是本文的核心训练信号之一:$\mathcal{L}_{recon}=\sum_k[\lambda_{MSE}\mathcal{L}_{MSE}+\lambda_{LPIPS}\mathcal{L}_{LPIPS}]$,模型没有用任何点云或深度真值,全靠'渲染要像输入'这一约束逼出 3D 几何。
查询/摘要token与信息瓶颈
在 Transformer 序列中插入少量可学习 query token(如 Perceiver、BLIP-2 的 Q-Former 做法),它们通过注意力从大量输入 token 中主动检索信息。当 query 数量远少于输入 token 时形成信息瓶颈,迫使模型把冗余内容压缩、把重复出现的内容合并到同一组 token 中。
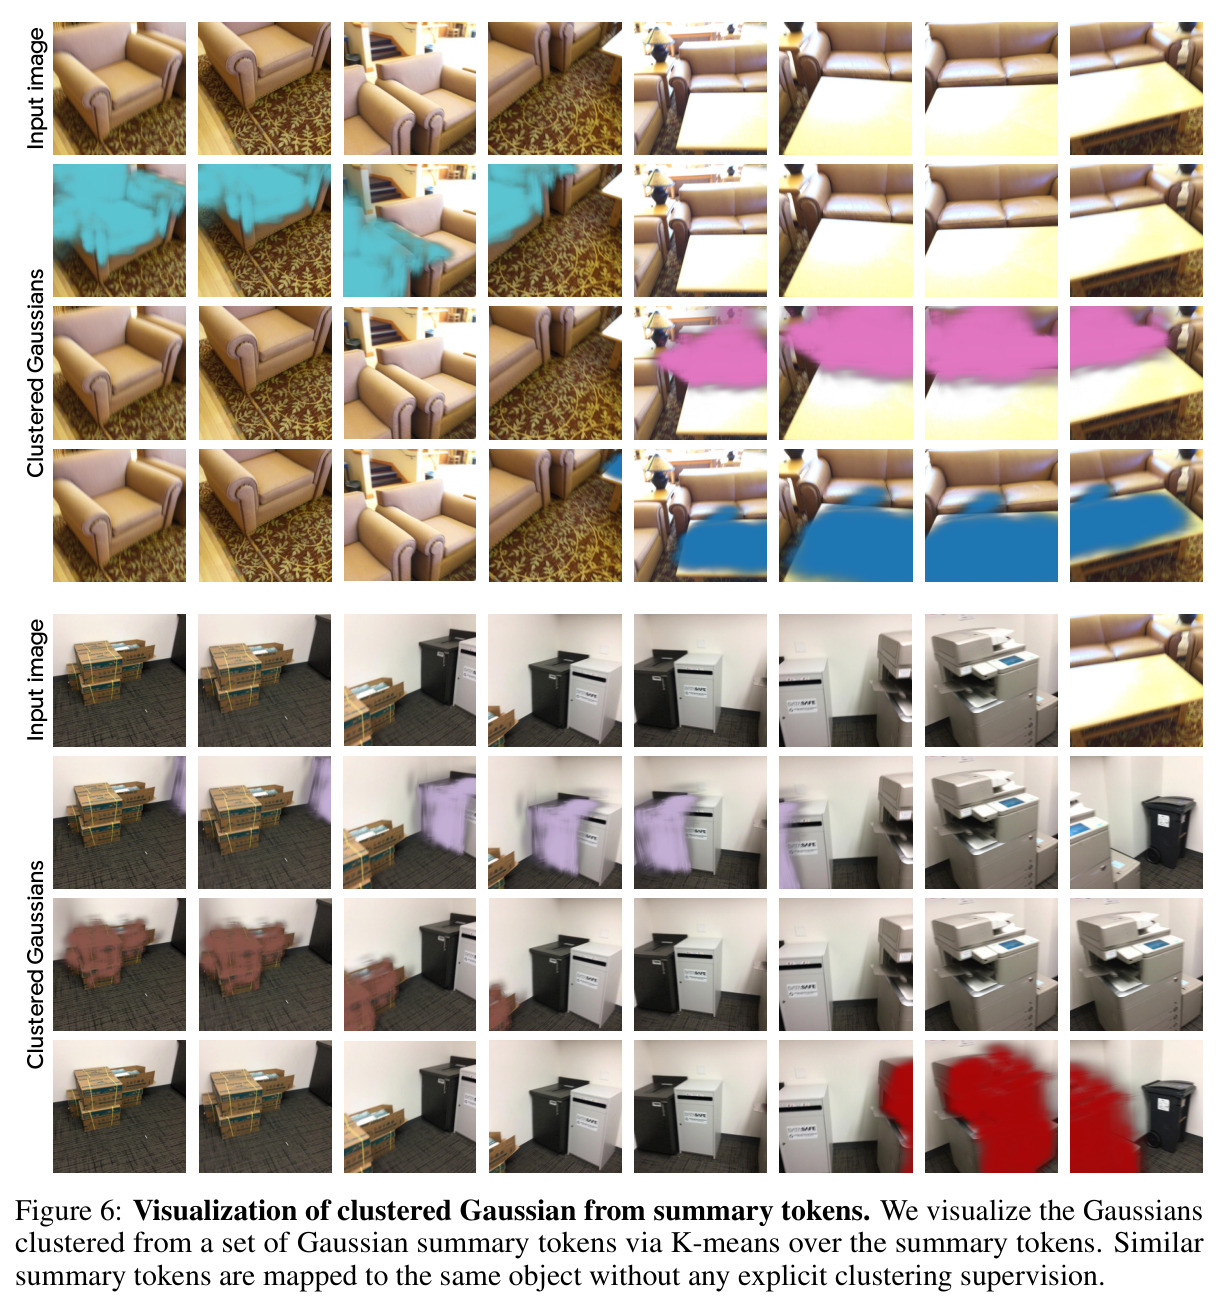
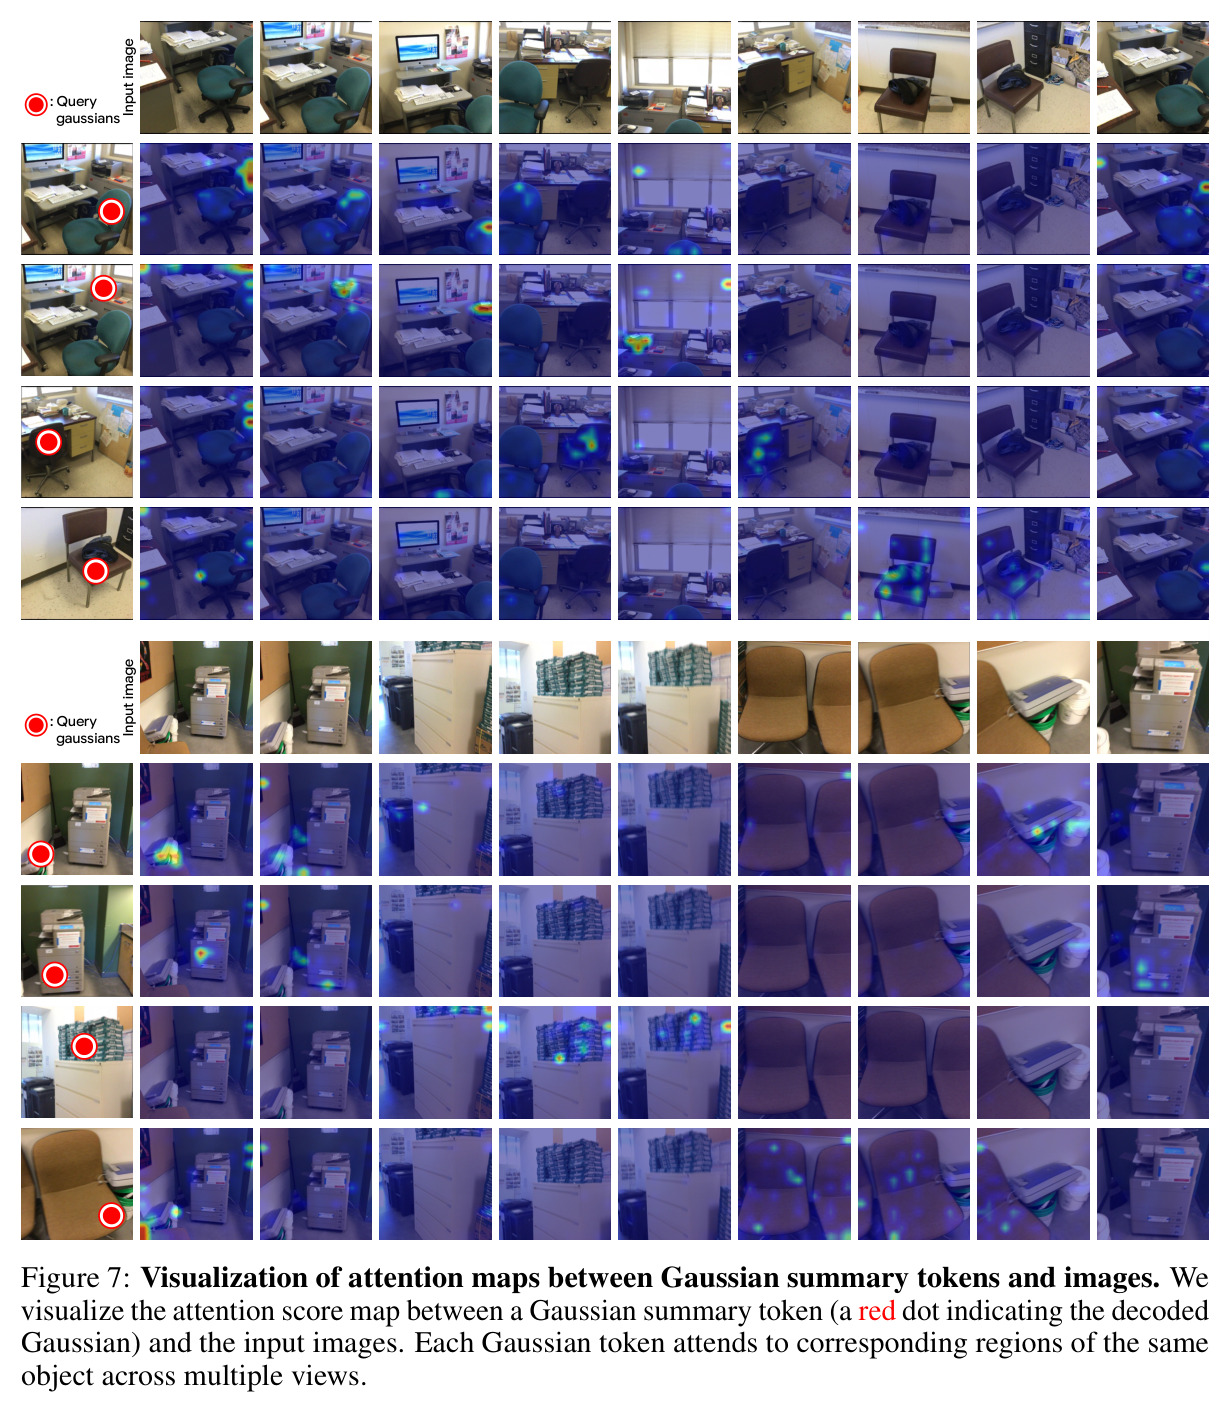
本文的核心设计就是瓶颈式摘要 token:$M=2592$ 个摘要 token 对 6720 个图像 token,作者论证正是这个瓶颈促使模型把跨视角重叠的同一物体合并进共享 token,涌现出物体级分组。
知识蒸馏
让一个已训练好的教师模型为学生提供监督信号:既可以在 token/特征层面对齐表示(如余弦相似度损失),也可以对最终输出(如高斯参数)做 L2 回归。教师训练时冻结,只参与训练、不参与推理,作用是给学生提供稠密的学习目标、加速收敛。
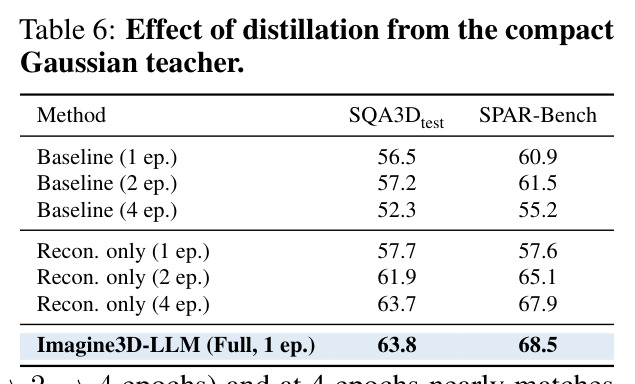
纯光度监督经 LLM 反传收敛极慢,本文引入预训练的紧凑高斯估计器 ZipSplat 作为教师,用 token 级余弦损失加参数级 L2 损失蒸馏,使模型 1 个 epoch 就达到无蒸馏需 4 个 epoch 的水平。
ScanNet系列3D基准
基于 ScanNet 室内扫描数据集构建的一组 3D 理解任务:SQA3D 和 ScanQA 考察情境化空间问答,Scan2Cap 考察 3D 接地描述,ScanRefer 和 Multi3DRefer 考察语言定位 3D 物体,Real-3DQA 与 SPAR-Bench 则专门设计来惩罚语言捷径、检验真实 3D 推理。
论文的七个评测基准中六个来自 ScanNet,训练数据也是这些基准的训练集加上 SPAR-7M 的 10 万条子集,理解各基准的指标(EM、CIDEr、Acc@IoU、F1)是读懂实验表的前提。
研究动机
多模态大语言模型处理单张图像已接近甚至在某些任务上超越人类,但一旦输入从单视角变成需要真正三维推理的多视角图像,即便最大最强的模型也明显落后于人类。现有工作主要走两条路:一是注入像素级跨视角对应信号,例如 Video-3D-LLM 和 LLaVA-3D 把点云导出的 3D 位置编码附加到 patch 特征上,GPT4Scene 渲染鸟瞰视角标记,Ross3D 设计跨视角重构预训练任务,3DRS 用显式对应监督做特征蒸馏;二是把 MLLM 图像特征与 3D 重建基础模型(CUT3R、VGGT)的特征融合,代表有 VLM3R、G2VLM 和同期工作 3DThinker。但两类方法都在细粒度像素级 3D 信号上做文章,收益只有增量:在 SPAR-Bench 上 GPT-4o 仅 36.4 分,72B 规模的 Qwen2.5-VL 也只有 39.4 分,通用 2D MLLM 普遍在 30-39 分区间,与人类水平差距巨大。
本文的目标是本文的目标是让 MLLM 在回答问题之前,先在模型内部对多视角输入完成一次'心理重建':把分散在各视角的视觉证据汇总成一个紧凑、以物体为中心的 3D 场景表示,再基于该表示进行推理作答。具体要求是:(1)不依赖外部点云输入或 3D 基础模型的特征融合,仅凭多视角图像端到端训练;(2)学到的表示应是抽象、粗粒度而非像素级精确的,符合人类空间认知方式;(3)在 SQA3D、Real-3DQA、ScanQA、Scan2Cap、ScanRefer、Multi3DRefer 和 SPAR-Bench 七个空间推理与 3D 理解基准上全面超越依赖像素级几何信号或几何基础模型特征的先前方法,并弄清收益究竟来自重建本身还是额外数据与教师信息。
与已有工作不同的是,本文的独特切入角度是从认知科学重新审视问题:人类脑中并不维持像素级对应或稠密深度图,而是跨视角识别共同物体,以它们为锚点推断视角间粗略、抽象的空间关系,再在心里组装出紧凑的 3D 布局——支撑推理的表示是物体级、近似级的。先前所有方法都在追求更细的像素级 3D 信号,本文反其道而行:用远少于图像 token 的高斯摘要 token 作为信息瓶颈,迫使模型把跨视角重叠内容合并进共享 token,解码出一组紧凑的 3DGS 表示并只靠光度重建加语言建模联合训练。核心论断是'想象场景比被告知像素级几何更有效':要求模型主动推断场景底层结构,会让 3D 感知信号传播到整个 LLM 的内部表征中。
核心方法
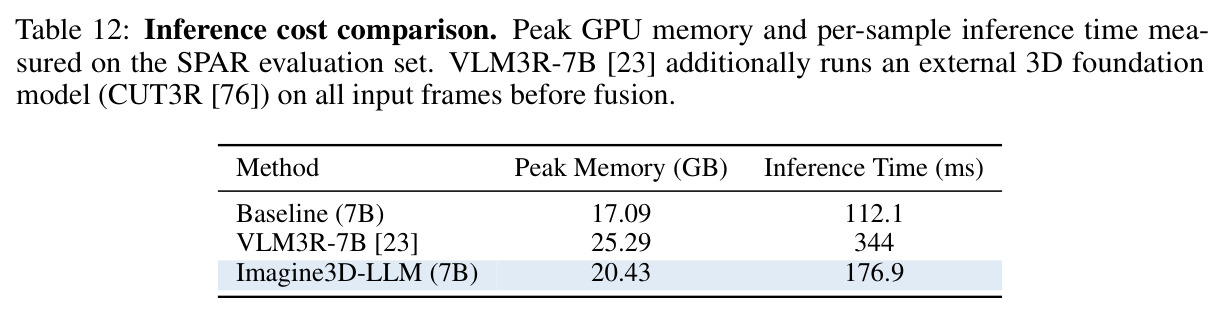
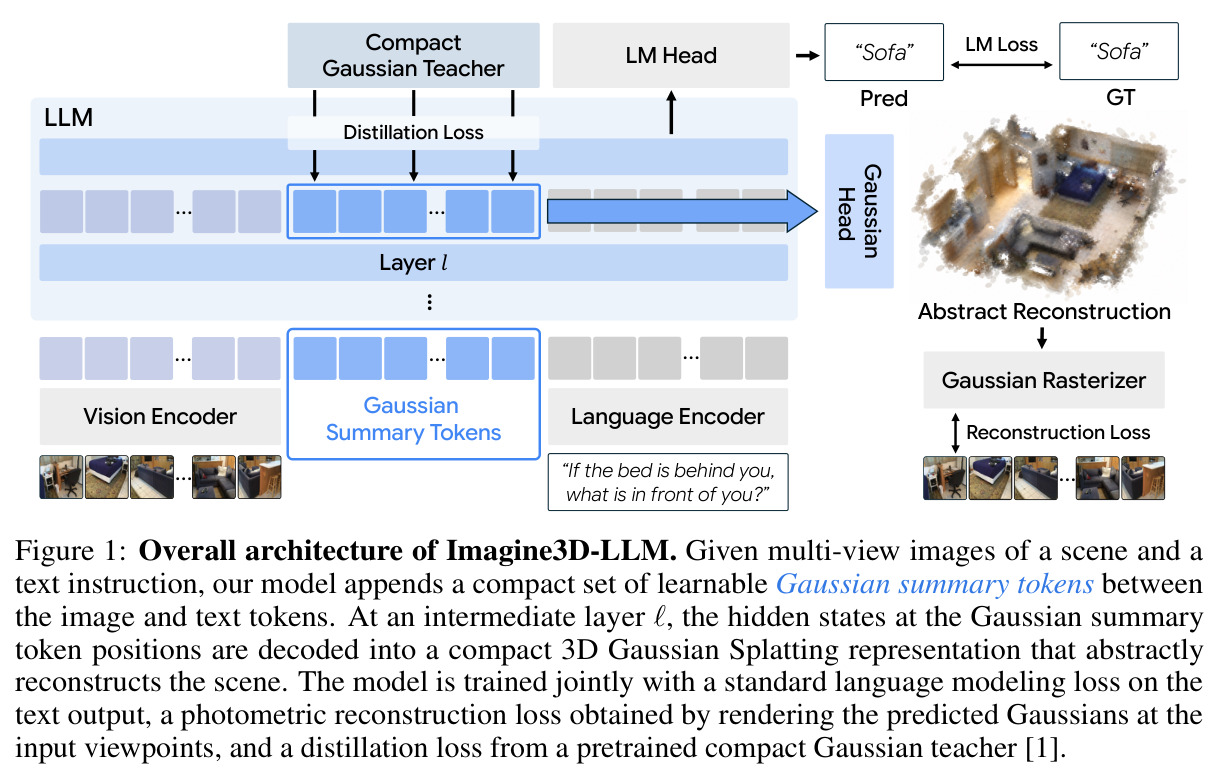
方法的直觉是让模型像人一样'先想象、后作答'。技术上,Imagine3D-LLM 以 LLaVA-Video-7B 为基座,在图像 token 序列后追加 $M=2592$ 个可学习高斯摘要 token(每帧 81 个,远少于 32 帧共 $KN'=6720$ 个图像 token),与文本 token 一起送入 LLM 做因果自注意力。在中间层(28 层中的第 14 层)读取摘要 token 隐状态,经三层 MLP 高斯头解码出 $M\times G$ 个 3D 高斯基元(每 token $G=32$ 个),再用可微光栅化在输入视角渲染。训练联合三个目标:下一词预测损失 $\mathcal{L}_{LM}$、光度重建损失 $\mathcal{L}_{recon}$(MSE+LPIPS)与从冻结的 ZipSplat 教师蒸馏的 $\mathcal{L}_{distill}$。整个模型在 ScanNet 系数据加 10 万条 SPAR-7M 子集上用 16 张 GH200 微调 1 个 epoch,推理时仅多出摘要 token 的序列开销和一个 MLP 解码头。
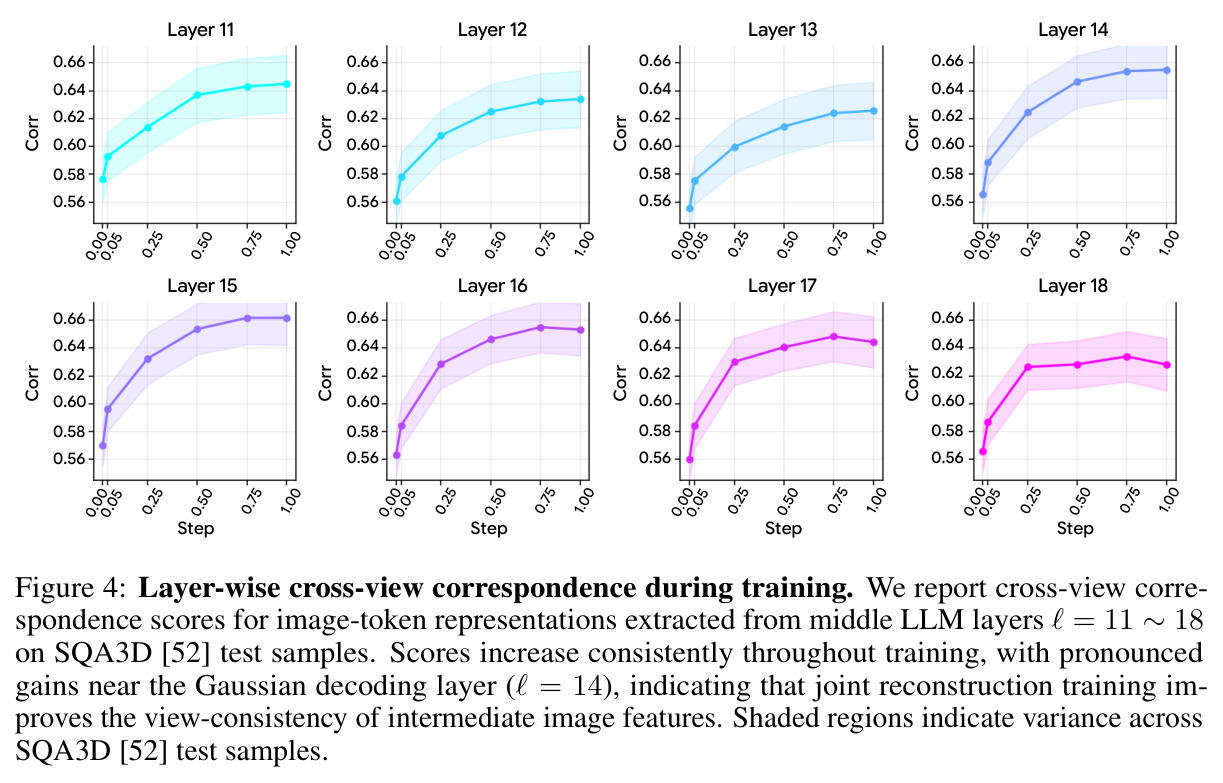
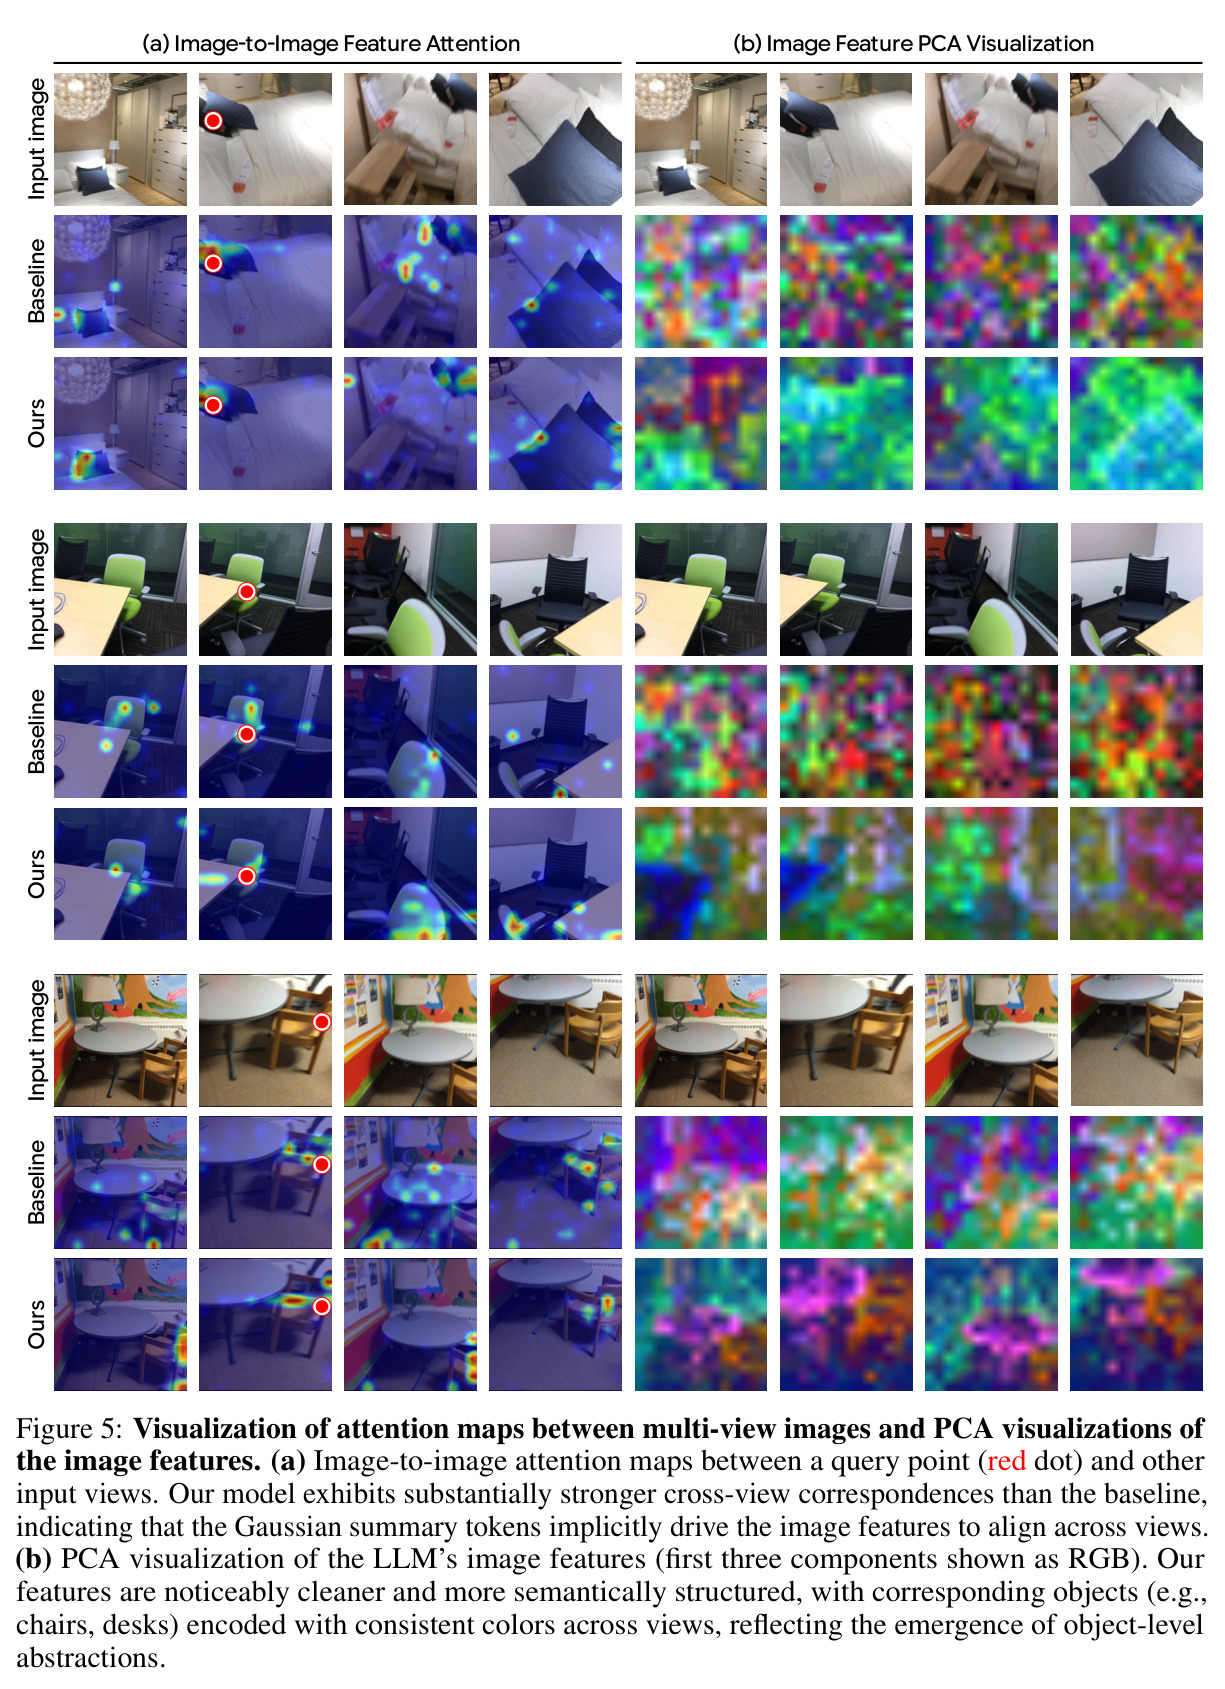
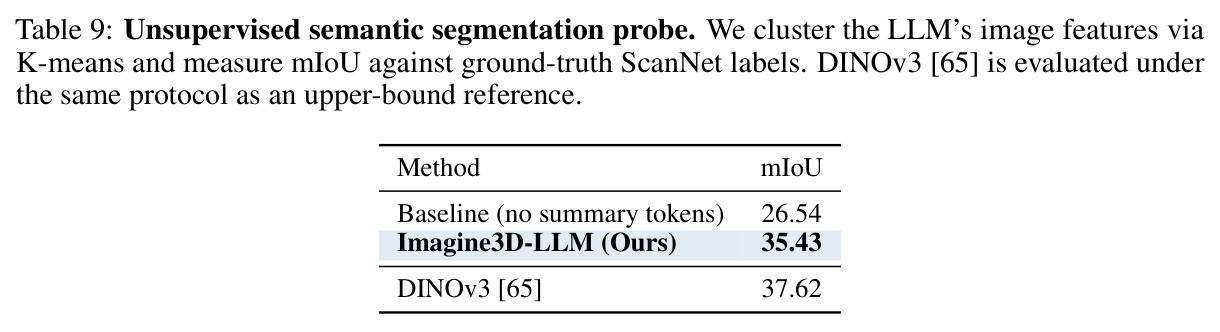
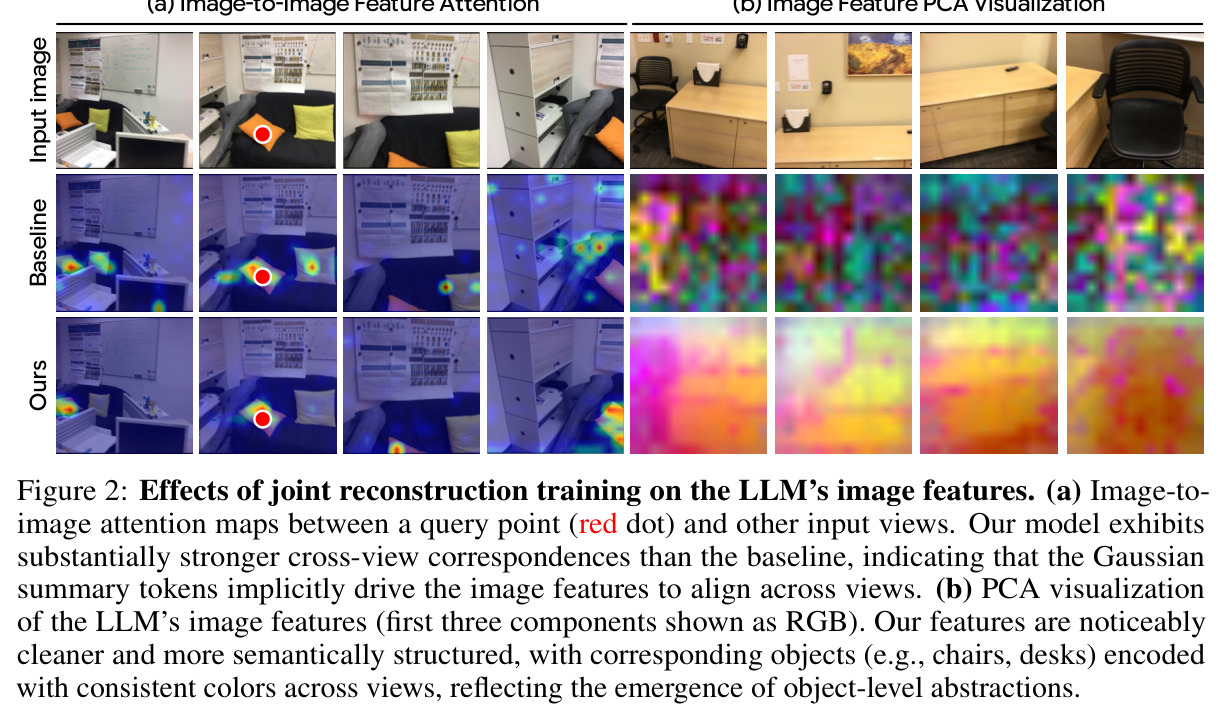
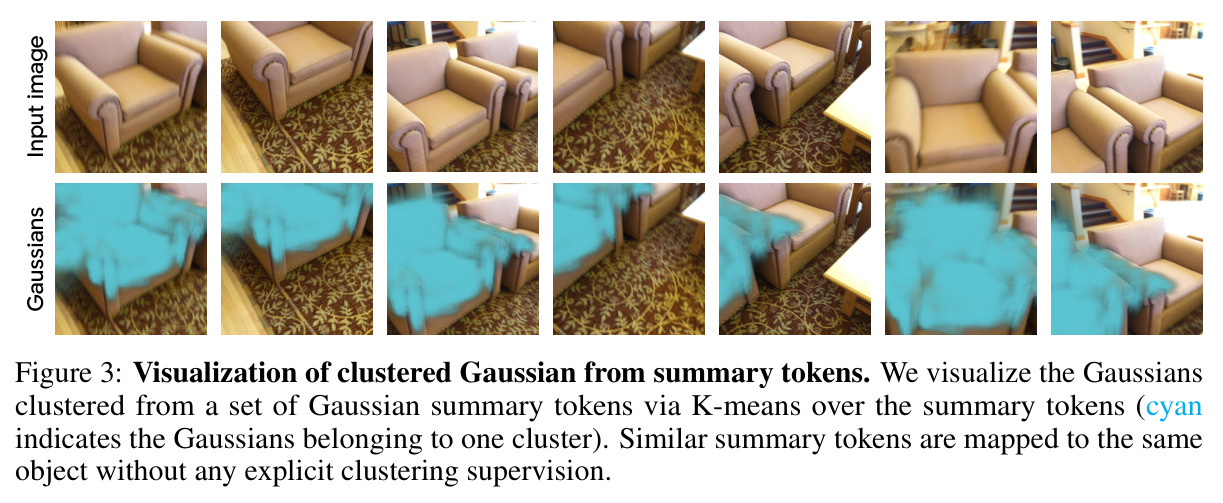
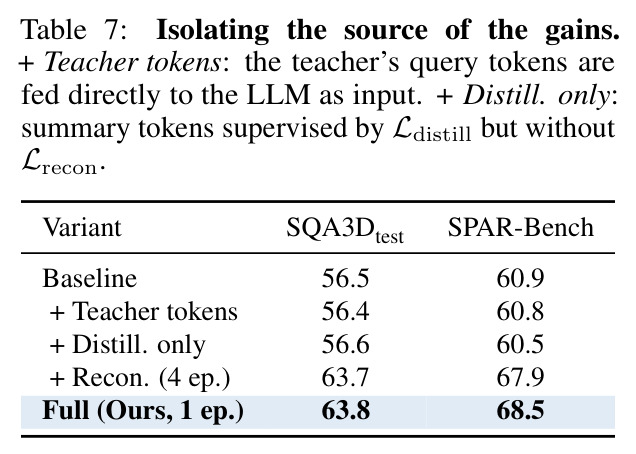
核心创新是把'要求模型自己重建场景'作为训练信号,而非把现成几何喂给模型。两个关键设计:其一,高斯从摘要 token 而非图像特征解码——若直接从图像特征预测与视角对齐的高斯,模型会偷懒地把 2D 图像内容复制成高斯而不恢复真实几何;摘要 token 迫使模型主动从全部图像 token 中检索并聚合 3D 证据。其二,信息瓶颈 $M\ll KN'$——2592 对 6720 的压缩比迫使跨视角重叠内容合并进共享 token,从而涌现物体级分组(Fig. 3 中对摘要 token 做 K-means,一个簇的高斯恰好锁定同一物体,且没有任何聚类监督)。更关键的发现是:尽管只有摘要 token 直接受重建监督,LLM 的图像特征本身也变得更 3D 感知——跨视角注意力显著更锐利(Fig. 2a),PCA 可视化显示同一物体在各视角被一致编码(Fig. 2b)。消融(Tab. 7)证明收益确实来自重建本身:直接注入教师 token 得 56.4、只做蒸馏得 56.6,都与基线 56.5 持平,唯有加上重建损失才跃升至 63.8。
方法步骤详情
第一步视觉编码:LLaVA-Video 把 32 张输入图各编码为 210 个 token 并投影到语言空间,得到图像 token 序列 $e_{img}$(共 6720 个)。第二步插入 $M=2592$ 个可学习高斯摘要 token,组成 $[e_{img}; e_{gs}; e_{text}]$,摘要 token 经因果注意力吸收全部图像信息。第三步高斯解码:从 28 层 LLM 的中间层 $\ell=14$ 抽取摘要 token 隐状态,三层 MLP 头为每 token 解码 $G=32$ 个高斯(中心、不透明度、协方差、球谐系数),全场景约 8.3 万个高斯。第四步可微光栅化在 32 个输入视角渲染,计算 $\mathcal{L}_{recon}=\sum_k[\lambda_{MSE}\mathcal{L}_{MSE}+\lambda_{LPIPS}\mathcal{L}_{LPIPS}]$。第五步蒸馏:冻结的 ZipSplat 教师细化出 $M$ 个查询 token,计算 $\mathcal{L}_{token}=\frac{1}{M}\sum_i[1-\cos(g(h_{gs}^i),\bar{Q}_T^i)]$ 与参数回归 $\mathcal{L}_{param}=\frac{1}{M}\sum_i\|G_i-G_i^T\|_2^2$。第六步以 $\mathcal{L}_{full}=\mathcal{L}_{LM}+\lambda_{recon}\mathcal{L}_{recon}+\lambda_{distill}\mathcal{L}_{distill}$ 在 SQA3D、ScanQA、Scan2Cap、ScanRefer、Multi3DRefer 加 10 万条 SPAR-7M 子集上全模型微调,16 张 GH200、批大小 64、仅 1 epoch。
技术新颖性
技术新颖性有三点。首先,这是首个把 C3G 式'从少量查询 token 前馈解码紧凑 3DGS'的范式内嵌进 MLLM 的工作:既有紧凑表示方法要么难以扩展到足量基元,要么依赖现成 3D 实例分割,本文让摘要 token 与语言推理共享同一序列和同一套表示。其次,与特征融合路线(VLM3R、G2VLM、3DThinker 把 CUT3R/VGGT 特征拼进 LLM)的被动注入不同,重建损失迫使摘要 token 主动 attend 图像 token,从而重塑 LLM 内部的注意力与表征;Tab. 7 表明被动注入教师 token(56.4)或只做蒸馏(56.6)都不涨点,唯有重建有效,这是对'几何特征融合为何收益有限'的机制性回答。第三,发现'学习重建'的监督会传播到未直接受监督的图像特征上,带来更锐利的跨视角对应和更语义化的特征组织,说明重建目标是一种能全局重塑模型内部表征的归纳偏置,而非局部附加模块。
实验结果
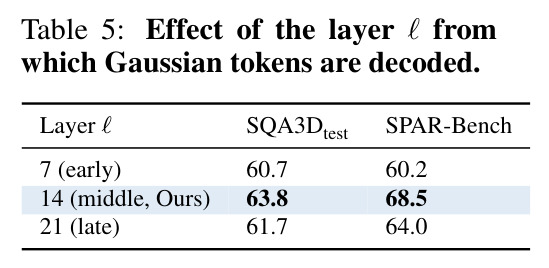
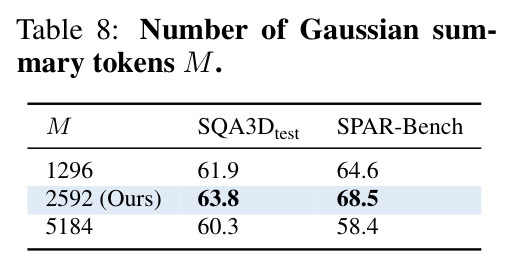
在七个基准上刷新或追平 SOTA。3D 问答(Tab. 1):SQA3D EM/EM-R 63.8/66.4,超过此前最强 Ross3D(63.0/65.7)与受控基线(56.5);Real-3DQA 39.2/44.3 大幅领先 Ross3D(36.6/41.5),该基准专门惩罚语言捷径,说明提升来自真实 3D 推理;ScanQA CIDEr 109.3、BLEU-4 20.5、METEOR 21.3 均最优(Ross3D 为 107.0/17.9/20.9),仅 EM 29.9 略低于 30.8。描述与定位(Tab. 2):Scan2Cap CIDEr 99.2 领先此前最高的 3DRS(86.1)逾 13 分,ROUGE 67.6、BLEU-4 48.3、METEOR 32.6 全面最优;ScanRefer Acc@0.25/0.5 达 62.8/56.3,Multi3DRefer F1@0.25/0.5 达 60.2/55.0。空间推理(Tab. 3):SPAR-Bench 均值 68.5(低/中/高 60.5/67.0/76.0),比最强空间感知模型 3DThinker-7B(63.3)高 5.2 分、比 72B 的 Qwen2.5-VL(39.4)高 29.1 分,中层级较受控基线涨 15.5 分(51.5→67.0)。消融:解码层取中间层 $\ell=14$ 最好(早层 60.7/60.2、晚层 61.7/64.0,Tab. 5);无蒸馏时仅靠光度损失需 4 epoch 才追平(63.7/67.9),纯 LM 基线 4 epoch 反而降到 52.3/55.2(Tab. 6);M=2592 最优,1296 容量不足(61.9/64.6),5184 削弱瓶颈(60.3/58.4,Tab. 8)。
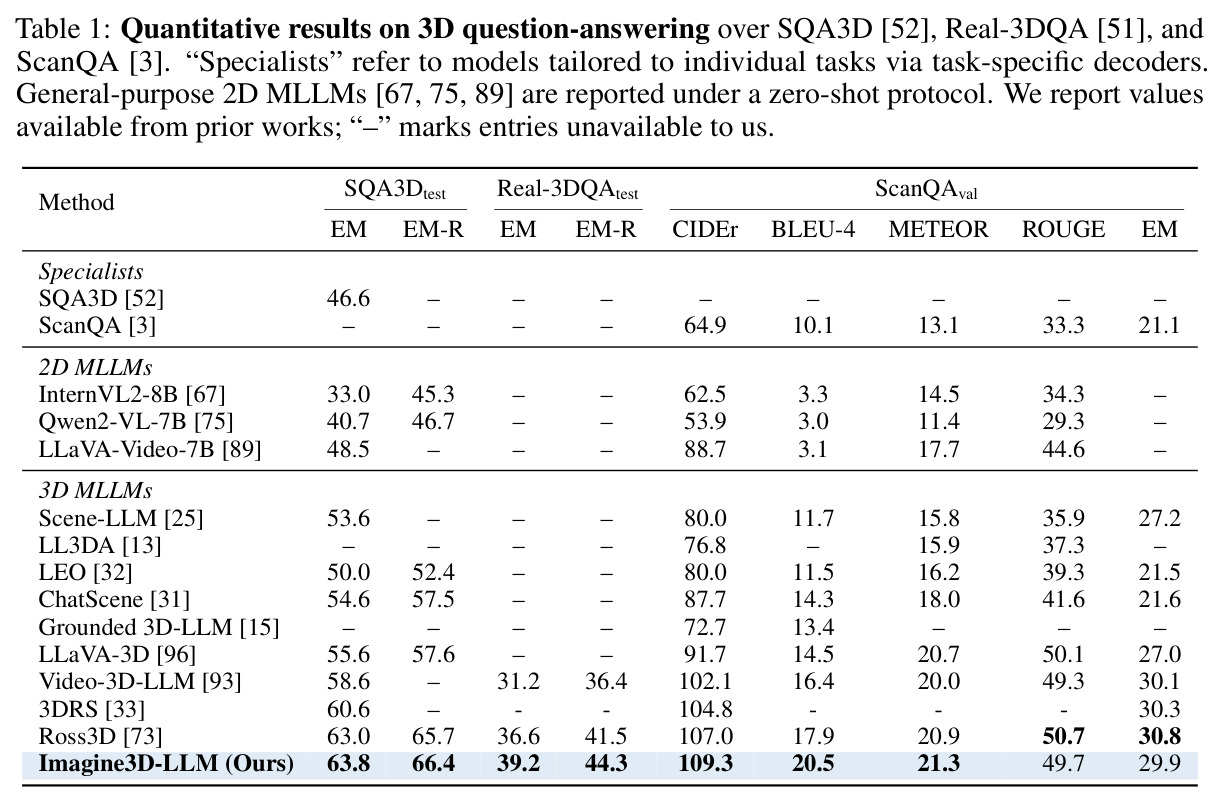
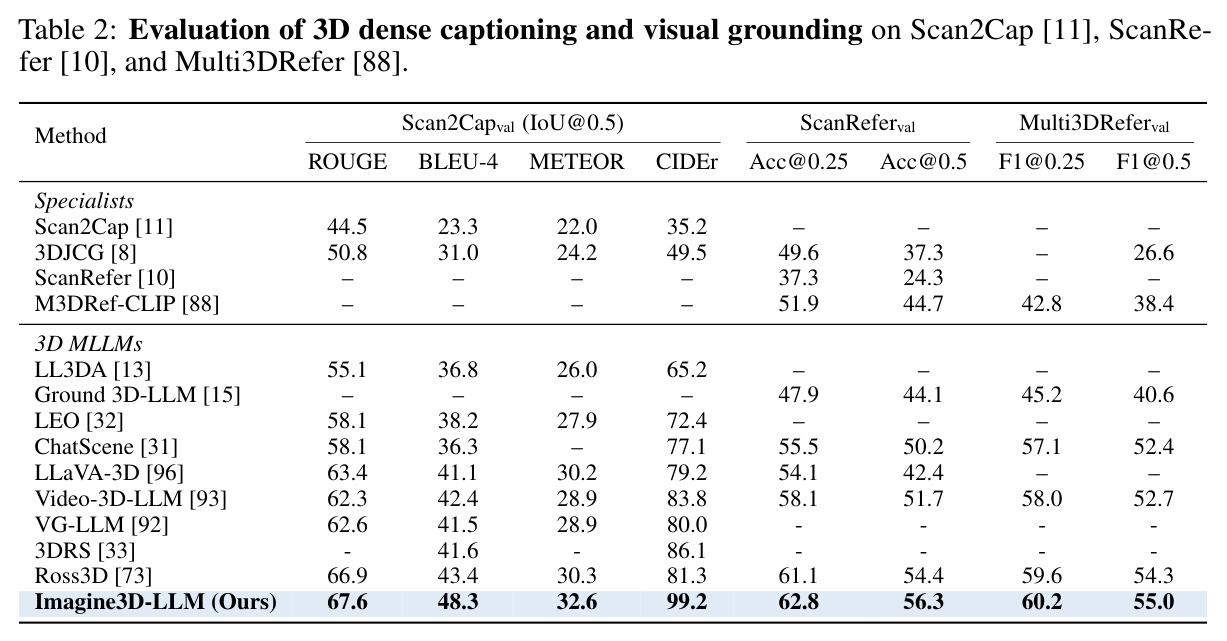
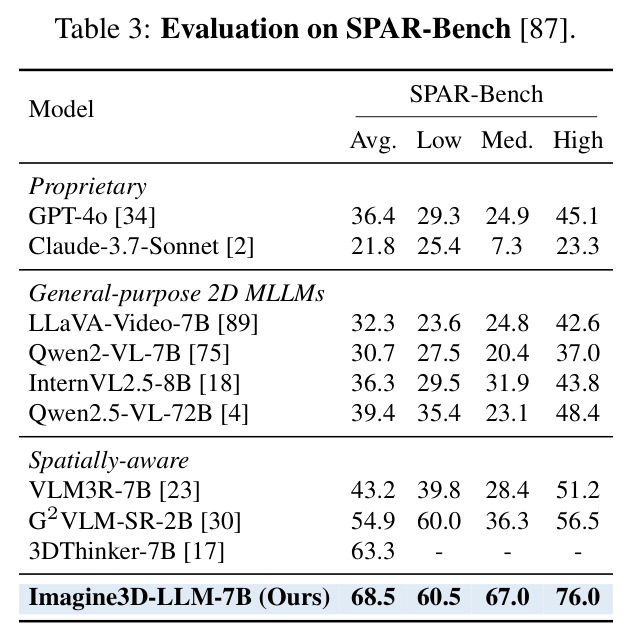
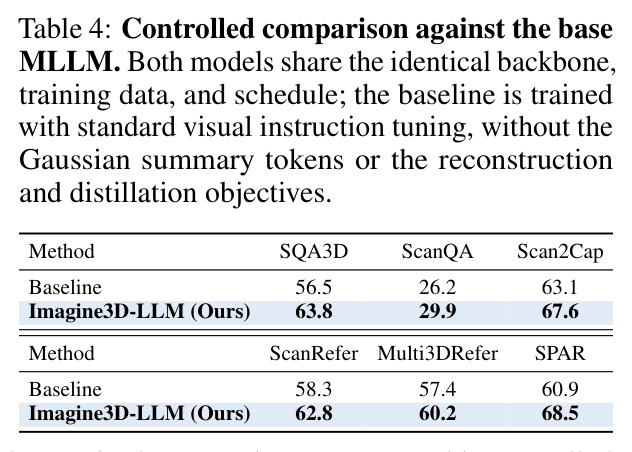
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SQA3D 情境化 3D 问答 | EM / EM-R | 63.8 / 66.4 | Ross3D 63.0 / 65.7 | +0.8 / +0.7 |
| Real-3DQA 真实 3D 推理问答 | EM / EM-R | 39.2 / 44.3 | Ross3D 36.6 / 41.5 | +2.6 / +2.8 |
| ScanQA 3D 问答 | CIDEr | 109.3 | Ross3D 107.0 | +2.3 |
| Scan2Cap 3D 接地描述(IoU@0.5) | CIDEr | 99.2 | 3DRS 86.1 | +13.1 |
| ScanRefer 3D 定位 | Acc@0.5 | 56.3 | Ross3D 54.4 | +1.9 |
| Multi3DRefer 3D 指代 | F1@0.5 | 55.0 | Ross3D 54.3 | +0.7 |
| SPAR-Bench 空间推理 | 平均准确率 | 68.5(低/中/高:60.5/67.0/76.0) | 3DThinker-7B 63.3;Qwen2.5-VL-72B 39.4 | +5.2 / +29.1 |
局限与改进
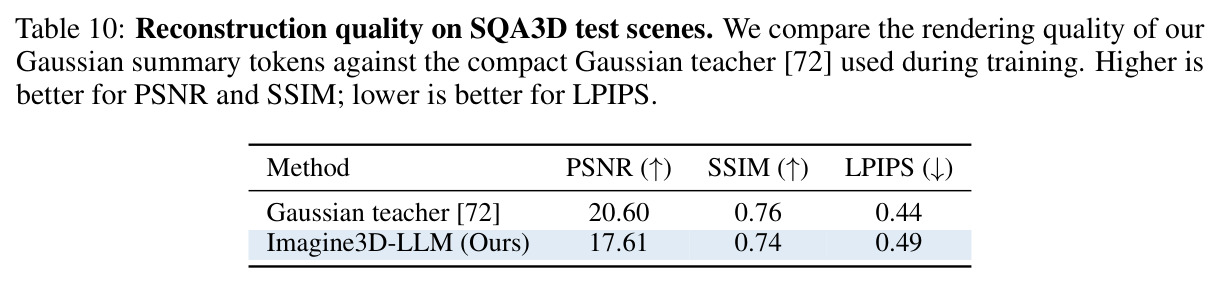
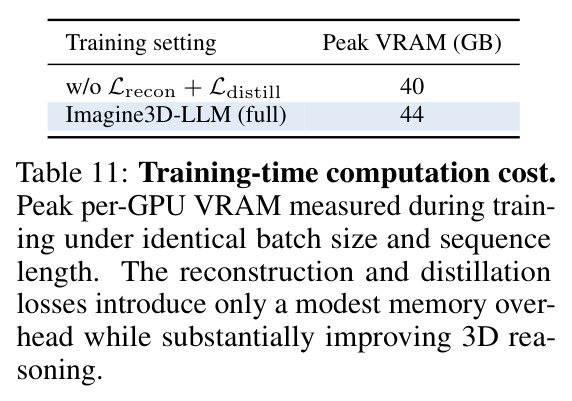
作者承认并暗示的局限:训练与评测高度集中于 ScanNet 系数据,作者引用先前分析指出仅用 ScanNet 训练会过拟合到数据集而非学到通用 3D 推理,为此补采了 10 万条 SPAR-7M 子集,但场景覆盖仍窄;ScanQA 上 EM(29.9 vs 30.8)和 ROUGE(49.7 vs 50.7)两项略输 Ross3D,收益并非无死角。我的观察:重建损失只在 32 个输入视角上计算,模型从未被要求渲染新视角,'想象'出的几何质量无从评估——论文没有报告任何 3DGS 保真度或深度精度指标;固定 $M=2592$ 对简单与复杂场景一视同仁,且推理序列额外增长约 39%;教师 ZipSplat 带来额外依赖与超参($\lambda_{token},\lambda_{param}$);评测限于静态室内场景,动态、户外与真实开放环境未验证;SQA3D 上 +0.8 的 EM 提升已接近该基准的饱和区间,含金量有限。
独立分析的弱点
独立分析的几个弱点及改进方向:(1)算力门槛极高——16 张 GH200 训 7B 模型,且纯光度监督经 LLM 反传收敛过慢、必须蒸馏才能在 1 epoch 内可用,可探索低分辨率渲染、随机视角子采样或高斯头预热等更高效的监督方式;(2)基准偏食——七个基准中六个源自同一 ScanNet 场景分布,SOTA 可能部分来自对场景先验的拟合,应在 ARKitScenes、Habitat-Matterport 等异构数据上训练并做跨数据集零样本评测;(3)瓶颈宽度敏感——M=5184 时 SPAR 反而崩到 58.4,说明压缩比需要按场景复杂度自适应,可研究动态 token 分配或嵌套 dropout 正则;(4)重建与推理的因果链是黑箱——论文只有注意力图和 PCA 可视化等定性证据,应显式度量重建几何(深度误差、新视角 PSNR)并与下游得分做相关性分析,验证'想象质量决定推理质量'这一隐含假设;(5)受教师上限约束——蒸馏继承 ZipSplat 的表示偏差,教师失败案例会传导给学生,可用多教师集成或随训练进度退火蒸馏强度。
未来方向
作者展望:让机器在回答前理解场景结构,是迈向更接近人类 3D 感知方式的 MLLM 的一步,可延伸到引言中点名的机器人、具身智能与 AR/VR 等下游领域。基于本文成果还可延伸:(1)把'心理重建'从静态室内推广到动态视频与户外场景,用 4D 高斯或时序摘要 token 建模运动;(2)把想象出的高斯表示当作可交互的世界模型,支持规划与反事实空间问答——SPAR 高层级 76.0 分显示空间想象能力的潜力;(3)重建目标可作为一种通用辅助任务叠加到任意 MLLM 上,与几何基础模型特征融合路线正交互补;(4)把摘要 token 与生成式渲染结合,让'想象'从判别式重建升级为真正的生成式新视角合成,处理输入视角未覆盖的区域;(5)在更大基座(如 72B)和更广语料上验证'重建即归纳偏置'结论的规模律,以及探索仅靠重建预训练而非指令微调获得 3D 能力的可能性。
复现评估
复现难度中等偏高。有利因素:基座 LLaVA-Video-7B、教师 ZipSplat、被借鉴的 C3G 均为公开模型,ScanNet 系数据集(需签署使用协议)与 SPAR-7M 公开可取;训练仅需 1 个 epoch;论文给出了公式级的损失定义和完整消融(层选择、token 数、蒸馏贡献、训练时长),Tab. 6 甚至提供了无蒸馏时 1/2/4 epoch 的对照曲线,便于判断自己的复现是否在正轨上。不利因素:需要 16 张 GH200 级别的算力,多数实验室难以承担完整训练;论文未见明确的代码开源声明,仅有项目页 cvlab-kaist.github.io/Imagine3D-LLM2026;各损失权重 $\lambda_{recon},\lambda_{token},\lambda_{param}$ 的具体取值要查附录。若只做推理验证,加载权重后每场景增加 2592 个摘要 token 的序列开销和约 8.3 万个高斯的 MLP 解码,成本可控;若从头复现训练,建议先在小规模子集上验证蒸馏对收敛的加速效应,再扩展到全量数据。
论文图表