DeskForge:用可控桌面环境为计算机操作智能体生成密集监督数据 DeskForge: Dense Supervision from Desktop Environments for Computer-Use Agents
构建可控Linux桌面环境自动生成百万级密集标注,同时提升GUI定位与长程任务完成率
前置知识
计算机操作智能体(Computer-Use Agent)
能像人一样操作电脑的 AI 智能体:观察屏幕截图,理解界面,然后执行点击、打字、滚动等动作来完成多步任务(如填表单、发邮件、管理文件)。常见架构分两层:规划器(planner)决定“做什么、点什么”,动作模型(action model)把决策落成屏幕上的具体坐标。OSWorld、WebArena 等环境用于评测这类智能体。
本文的最终目标就是提升这类智能体的动作执行能力:实验固定规划器、只替换动作模型权重,验证定位数据的改进能转化为任务完成率的提升。
GUI 视觉定位(GUI Grounding)
给定一张界面截图和一句自然语言指令(如“点击导出按钮”),模型需要在图上输出目标控件的位置(一个点坐标或边界框),预测点落在标注区域内即算正确。它是计算机操作智能体的底层核心能力——定位不准,后续动作全部失效。ScreenSpot-Pro、OSWorld-G、UI-Vision 等基准专门评测该能力。
DeskForge-1M 的主要监督形式就是单目标定位样本,微调实验的核心指标、四个 held-out 条件和五个外部基准全部围绕定位准确率展开。
辅助功能树(Accessibility Tree / AT-SPI)
操作系统为无障碍访问(读屏器等)暴露的界面结构接口,Linux 上是 AT-SPI。它以树形结构描述每个控件的类型、语义名称、状态(是否可点、是否选中)和父子层级,相当于界面的“DOM”。但它依赖应用实现、经常不完整,且语义名不等于屏幕上真实渲染的文本(如图标有名字但没文字)。
DeskForge 的标注管线以辅助功能树为主要结构来源,但作者强调它不是金标准,必须与截图像素和窗口几何交叉验证——这是理解本文标注方法的关键。
ScreenTag 与屏幕解析
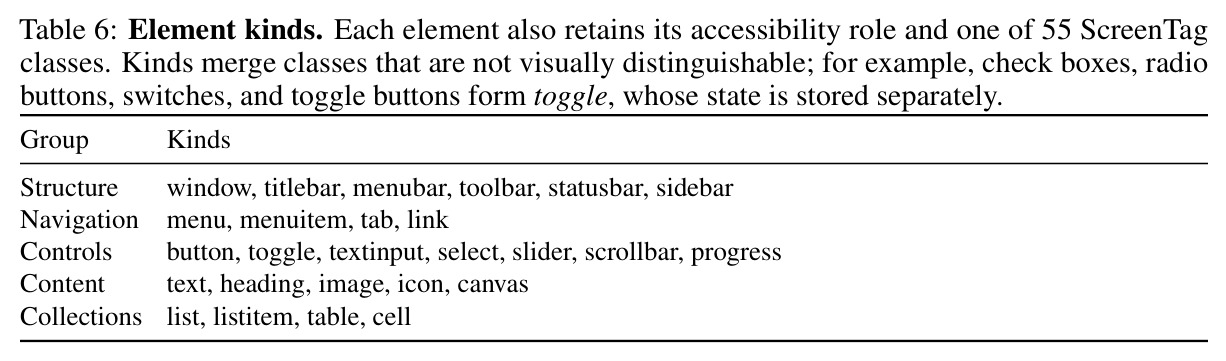
ScreenTag 是同组前作 ScreenParse 提出的屏幕紧凑标记化表示:把整屏可见元素序列化为保留层级的 markup(55 个类),让 VLM 像读 HTML 一样“读”屏幕。屏幕解析(screen parsing)指从截图中恢复全部元素的结构化描述,是定位之外另一种监督形态。
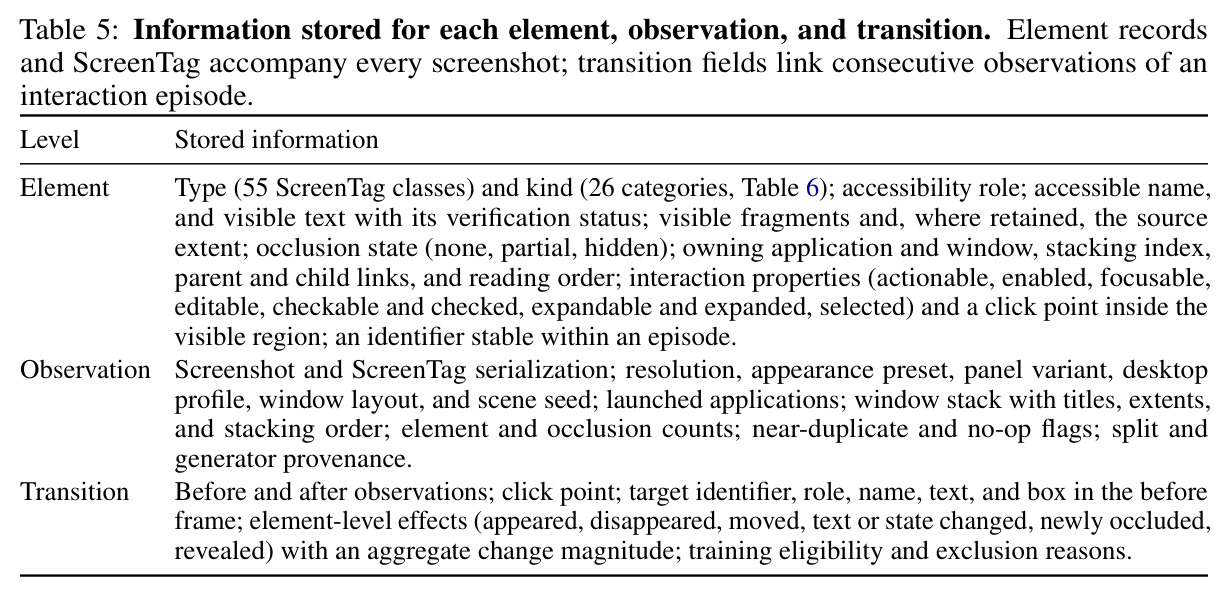
DeskForge-1M 的每张截图都附带 ScreenTag 序列化和元素级记录,理解这一表示才能明白语料如何同时支持单目标定位、全屏元素检测和未来的动力学学习。
LoRA 参数高效微调
Low-Rank Adaptation:冻结预训练模型全部原始权重,只在注意力等层注入可训练的低秩分解矩阵 $\Delta W = BA$(秩 $r \ll d$),训练参数量只有全量微调的千分之几,却能逼近其效果。4B–8B 的 VLM 用 8 张 H100 跑一轮即可完成。
本文对四个视觉语言模型的微调全部采用 LoRA(8×H100、1 epoch、全局 batch 64),理解它才能评估实验的算力门槛与复现成本。
可见区域碎片(Visible Fragments)
多窗口桌面中控件常被其他窗口部分遮挡,只有一部分真正可见、可点击。DeskForge 把被遮挡元素的暴露部分表示为一组矩形的并集(union of rectangles),点击只允许落在可见碎片内,而不是把整个逻辑边界都当作有效点击区。标注同时保留完整范围和可见范围两套几何。
这是本文区别于普通框标注的关键设计,也是评测中“目标可见面积损失”这一难度指标的定义基础,直接关系到遮挡场景实验的解读。
研究动机
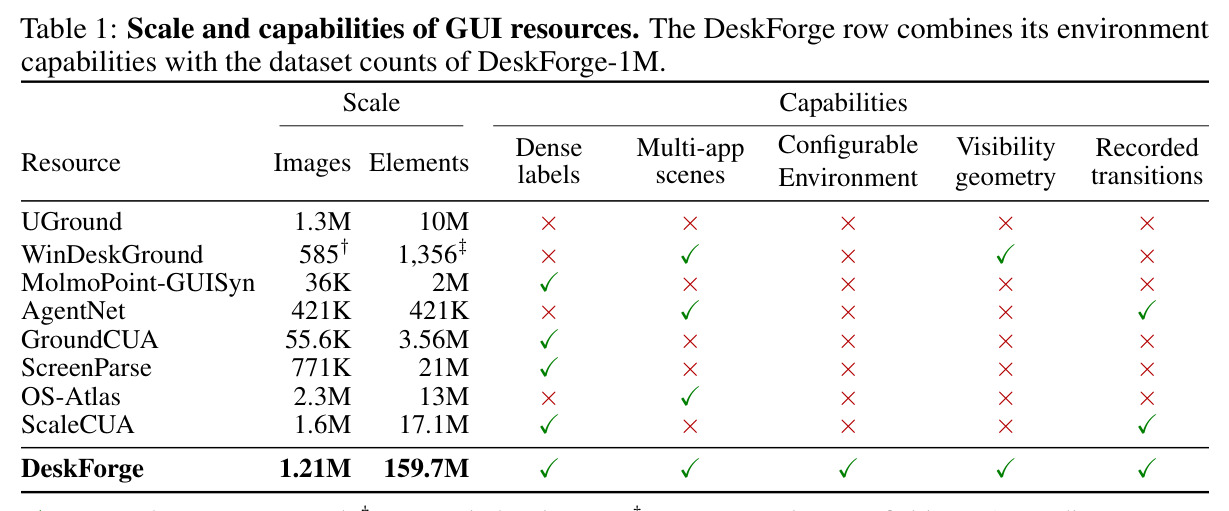
计算机操作智能体要在真实桌面里可靠地定位操作目标,而真实桌面恰恰是所有界面场景中最难的一种:多个应用窗口共存、互相重叠、控件外观高度相似、跨应用干扰物密布。现有训练资源没有一个能同时覆盖这种场景的三个需求——完整桌面画面、密集标注、可控变化。具体看数据格局:ScreenParse 有 771K 图、21M 元素,GroundCUA 有 55.6K 图、3.56M 人工核验元素,但都只标注单个网页、单块手机屏或单个应用;UGround 有 1.3M 图但无密集标注;WinDeskGround 拼接 585 张窗口图来模拟多窗口,却是静态的、不能继续交互;OSWorld、WebArena 等可执行环境为任务评测设计,不产出密集标注。后果直接反映在成绩上:Table 2 中最强公开模型 UI-Venus-2-9B 在 DeskForge 新场景条件下也只有 78.92% 的定位准确率,通用的 Gemma4-E4B 更是只有 12.27%;而语料统计显示桌面场景平均每屏 132 个元素、97.7% 的截图含被遮挡元素——模型在这种密集、遮挡、干扰并存的环境下定位失败是常态而非例外。
本文的目标是本文的目标是让“复杂桌面场景”本身变成可批量生产的训练数据。具体而言,构建一个可控的 Linux 桌面环境 DeskForge:按一份场景规格(scene specification)选择应用组合与初始状态、准备应用内容、设定窗口布局与叠放顺序、外观主题和显示分辨率,让真实应用在隔离会话中运行并被自动探索;同步产出每个屏幕的密集元素级标注(几何、文本、可见性、交互属性、层级与窗口归属)以及每次点击的执行结果(前后观测对)。在此环境上构建百万级语料 DeskForge-1M,然后验证三件事:微调能否提升在从未见过的桌面配置上的定位准确率;增益能否迁移到外部定位基准;只替换动作模型能否在固定规划器下提高长程任务完成率。
与已有工作不同的是,本文的独特切入角度可以概括为一句话:“生成桌面本身,而不是录制桌面”。此前所有工作都在三个象限里打转:静态采集(Rico、ScreenParse、GroundCUA 采了什么就是什么,场景不可变);单应用自动化探索(GUIrilla 通过原生辅助功能 API 建状态-动作图,但一次只处理一个应用);静态合成与拼接(MolmoPoint-GUISyn 渲染生成的 HTML 界面,WinDeskGround 拼窗口截图,视觉或交互上不真实);以及面向评测的可执行环境(OSWorld、OpenApps,可控但无密集标注)。DeskForge 第一次把“环境可控性”用于数据生成:在同一个共享桌面里组合多个真实应用、系统性地变化联合布局与周围上下文、执行真实点击并记录结果,使密集标注、多应用场景、可配置环境、可见性几何、录制转移五项能力首次同时成立(Table 1 中唯一打满勾的资源)。
核心方法
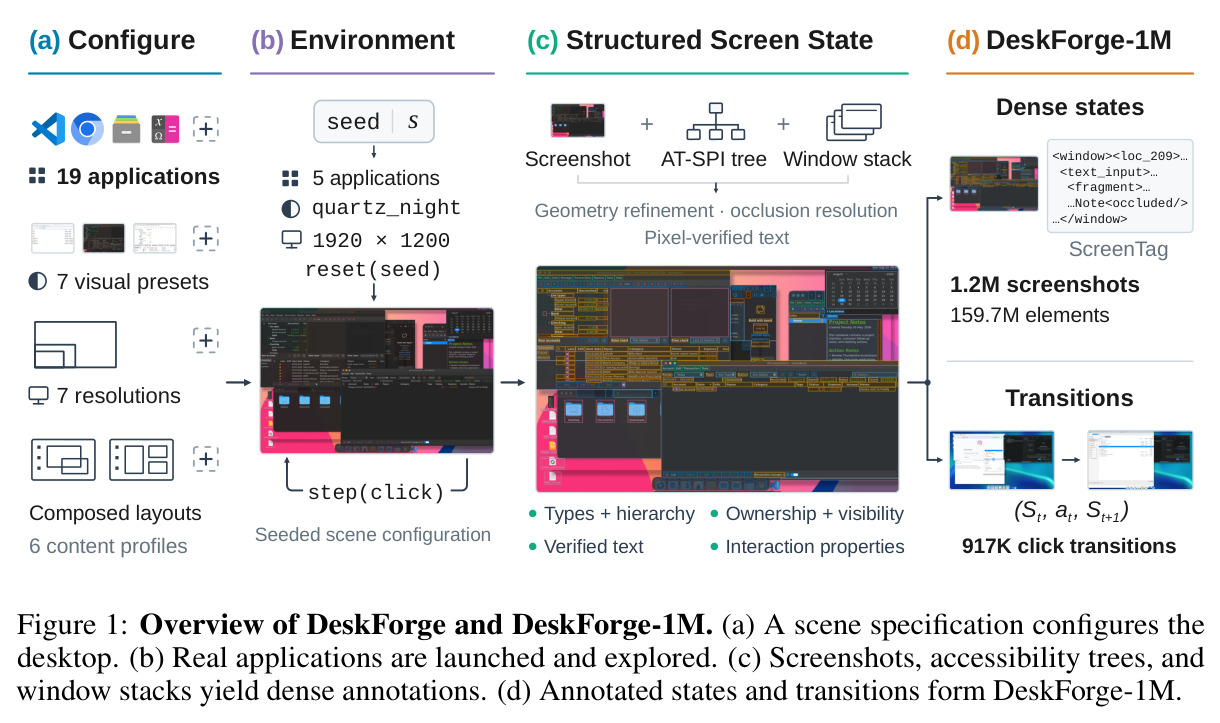
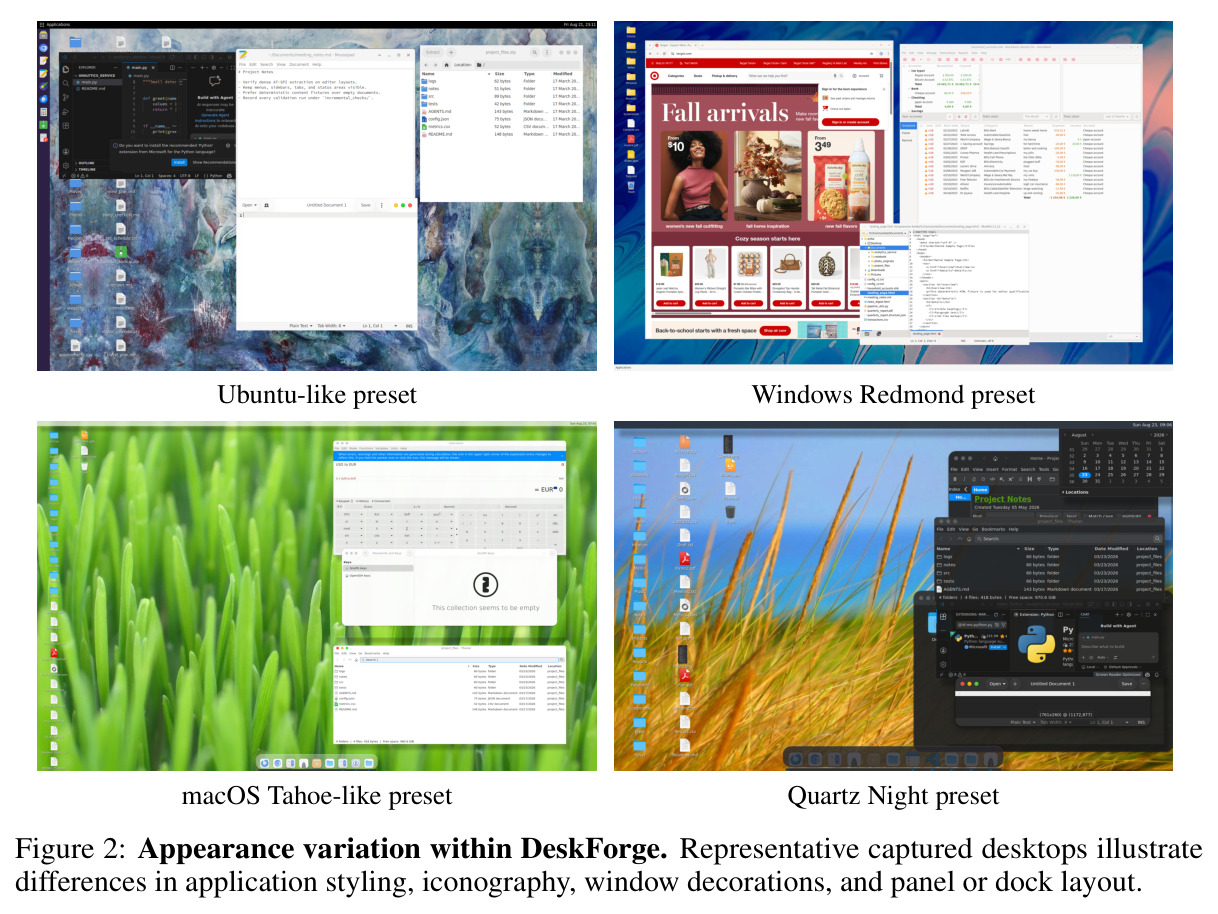
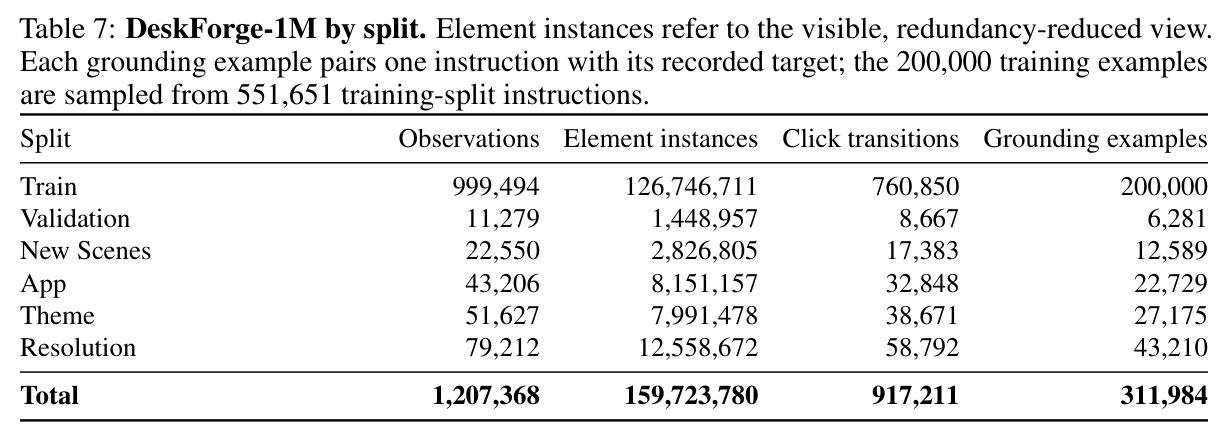
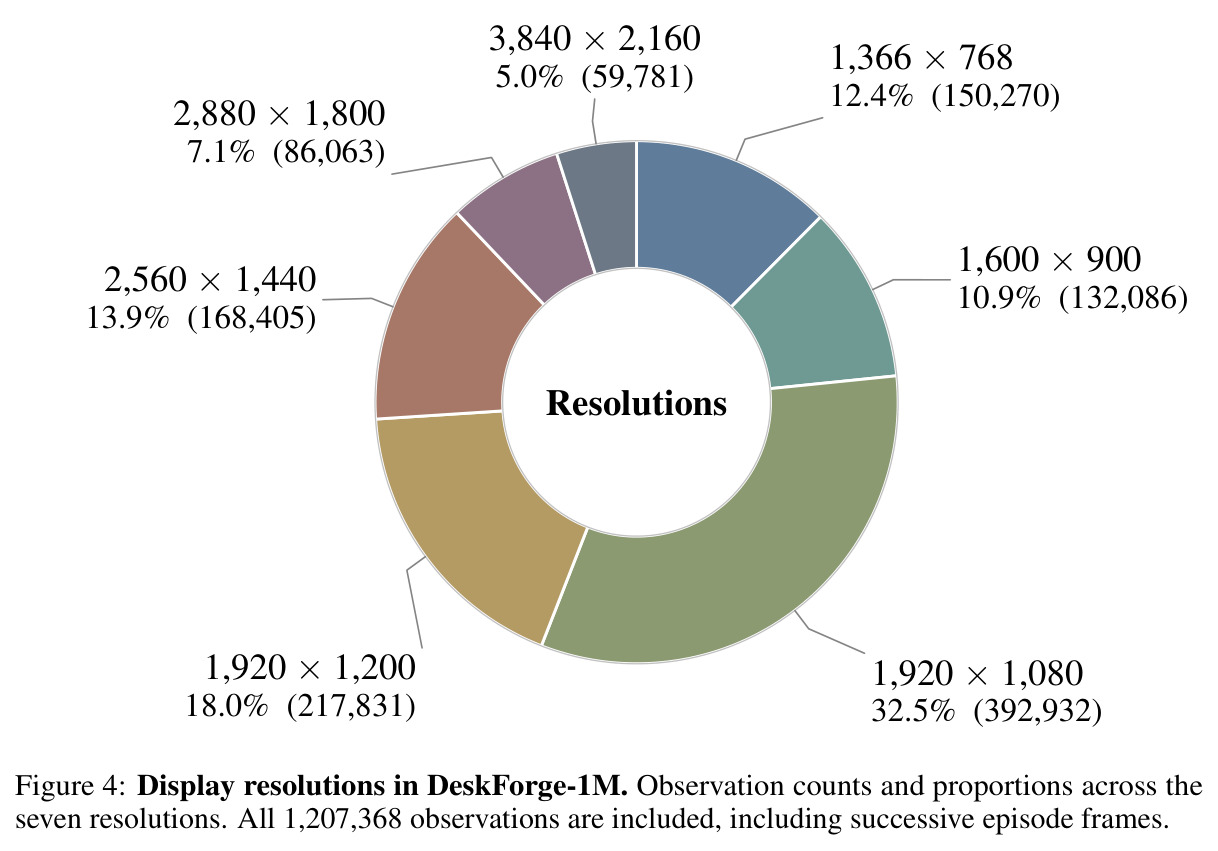
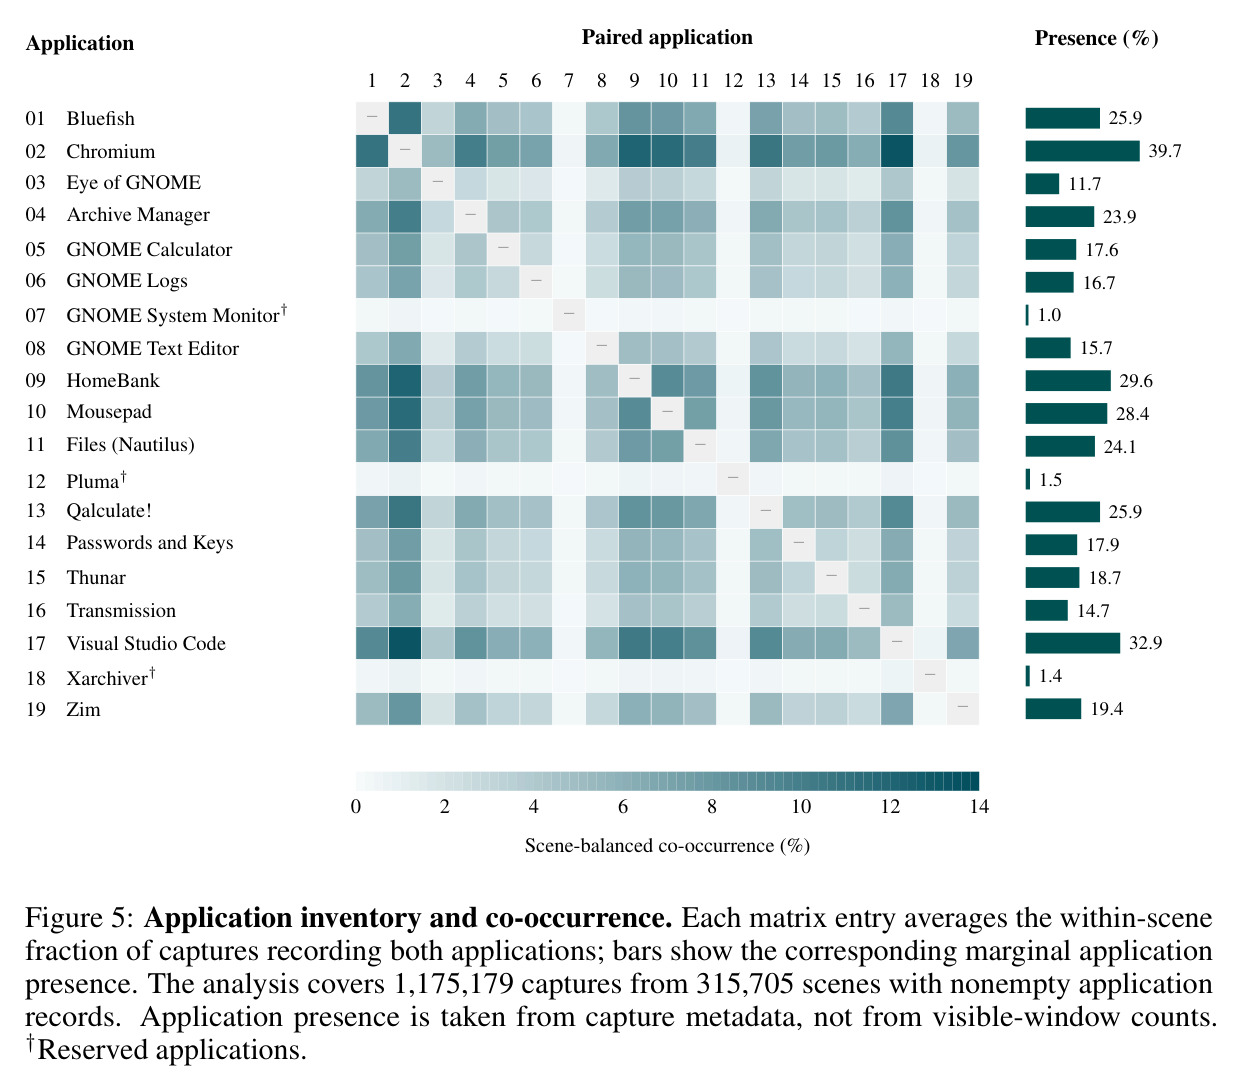
先说直觉:既然桌面定位的难点——多窗口、遮挡、相似控件、跨应用干扰——都可以被人工配置出来,那就可以像摄影棚“摆拍”一样,批量生成自带标准答案的桌面场景,而不必去真实使用中费力采集。技术路线分三个阶段。第一阶段是场景组合:一份场景规格选定应用(共 19 个)、初始状态、内容档案(6 种 content profiles)、窗口布局与叠放约束、7 种外观预设(经典 Linux、Ubuntu 风格、Windows 风格、macOS 风格及明暗变体)和 7 种分辨率(1366×768 到 3840×2160),用 reset(seed) 保证可复现。第二阶段是环境探索:在运行中的桌面里按元素选择(而非任务目标驱动)采样可点击元素并执行点击,记录每步转移 $(S_t, a_t, S_{t+1})$,包括界面无变化的情形。第三阶段是标注管线:把截图、AT-SPI 辅助功能树、窗口栈几何三者融合,做几何精化、遮挡解析(可见区域表示为矩形并集)和像素级文本核验,输出 55 类 ScreenTag 序列化加完整元素记录。最终产出 DeskForge-1M:1.21M 带标注观测、159.7M 元素实例、917K 条点击转移,约 324K 个场景。
核心创新是把“真实应用的可控组合 + 自动交互”当作监督信号源,这与已有方法有本质区别。第一,用真实应用而非合成渲染:应用自己绘制界面,视觉与交互行为逼真,区别于 MolmoPoint-GUISyn 那种生成 HTML 再渲染的假界面。第二,多应用同屏组合而非单应用探索:GUIrilla 等自动化探索一次只处理一个应用,而 DeskForge 把浏览器、编辑器、文件管理器等多个应用放进同一桌面,让“干扰”“遮挡”“窗口归属”这些难点成为数据的固有属性,并可按比例控制。第三,辅助功能树被降级为“证据之一”而非金标准:管线用字符几何和像素检查判断哪些文本真正渲染在屏幕上(图标的语义名不会被当成屏幕文字),用窗口几何补回辅助功能树遗漏的控件,用矩形并集精确表示部分遮挡元素的可见区域。第四,交互被显式记录为带结果的转移对 $(S_t, a_t, S_{t+1})$,使同一语料除了定位监督外还能支撑全屏检测乃至未来的正/逆动力学学习。这四点合起来,使标注成本近乎为零、规模可达百万级,同时难点分布可控。
方法步骤详情
完整流程分七步。第一步,场景配置:输入一份 specification 和应用 manifest(启动命令、预置内容、脚本化初始状态),加采样权重与布局约束,reset(seed) 在隔离会话中启动所选应用。第二步,观测截取:对每一帧同时保存截图、AT-SPI 树和窗口栈(标题、范围、叠放顺序)。第三步,标注融合:几何精化依次处理元素边界、祖先容器裁剪、视口限制、窗口重叠与瞬态浮层;对部分遮挡元素,可见支撑写成矩形并集;字符几何加像素检查判定文本是否真的显示在屏幕上;辅助功能树缺失的桌面控件从窗口几何恢复;同时保留父子层级、阅读顺序和应用/窗口归属。第四步,质量控制:自动审计剔除 4.7% 标注不一致或过疏的截图,人工审计确认 99.8% 的抽样元素标注正确。第五步,交互录制:在元素的估计可见区域内采样点击,记录 $(S_t, a_t, S_{t+1})$ 及元素级效果(出现、消失、移动、文本或状态变化、新遮挡、揭示)。第六步,指令构建:用 Qwen3.6-27B 读前后两帧加目标上下文,以简洁、标准、语境化三种风格写单步指令,过滤掉需坐标或标记才能理解的描述; successor 观测只用于写指令、不喂给定位模型;人工审计 97.8% 指令合格。第七步,训练与评测:固定 200K 样本视图(before 截图 + 指令 → 目标可见区域),LoRA 微调 Qwen3.5-4B、Gemma4-E4B、InternVL3.5-8B、UI-R1-3B 四个模型,8×H100、1 epoch、全局 batch 64;按场景级划分出 New Scenes、Theme(保留 Quartz Night Nord 预设)、App(留出 GNOME System Monitor、Pluma、Xarchiver)、Resolution(保留 2880×1800)四个 held-out 条件。
技术新颖性
技术新颖性体现在四个层面。其一,范式层面:把可控环境从“评测场”改造成“标注工厂”——此前的可执行环境(OSWorld、OpenApps、CUA-Gym)为验证任务成功而建,DeskForge 把同样的可控性用于系统性制造困难样本,应用数、遮挡率、外观、分辨率都是可调旋钮。其二,标注融合层面:首次在完整桌面层面把辅助功能树、像素证据、窗口几何三方对齐,解决了两个被普遍忽视的问题——“可听不可见”(辅助功能名字不等于屏幕文本)和“部分遮挡”(用矩形并集保留暴露部分,而非整框当点击区)。其三,监督视图层面:同一语料提供三种用途不同的视图——单目标定位(200K 训练 VLM)、密集全屏标注(训练 RT-DETRv4-L 检测器)、以及显式保留的 917K 转移对(供未来正/逆动力学 $ abla$ 类目标使用),数据利用率设计上就超越了“一次标注一种用法”的常规。其四,评测设计层面:场景级划分加四个 held-out 条件(新场景/保留主题/保留应用/保留分辨率)专门检验分布外泛化,避免“训测同景”的虚高。
实验结果
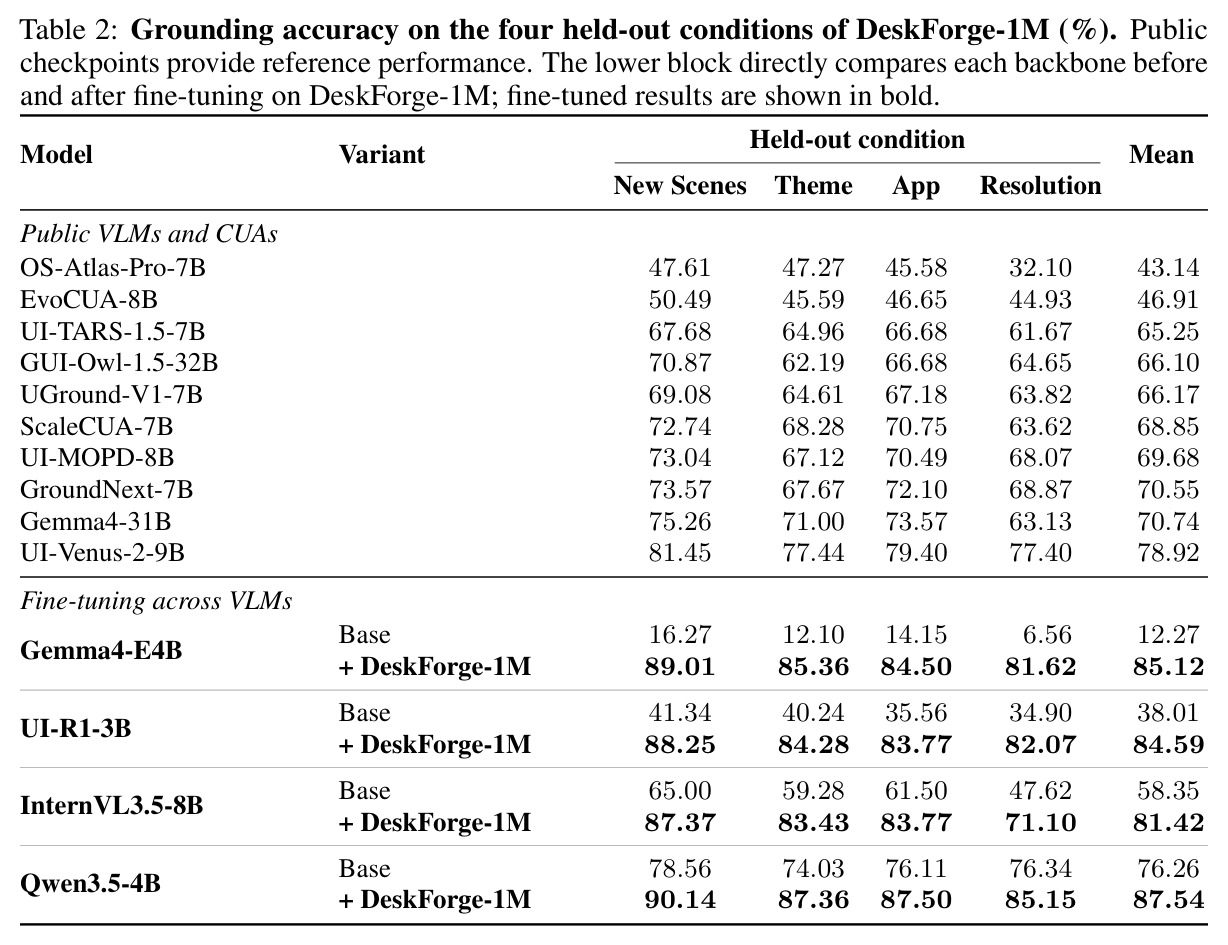
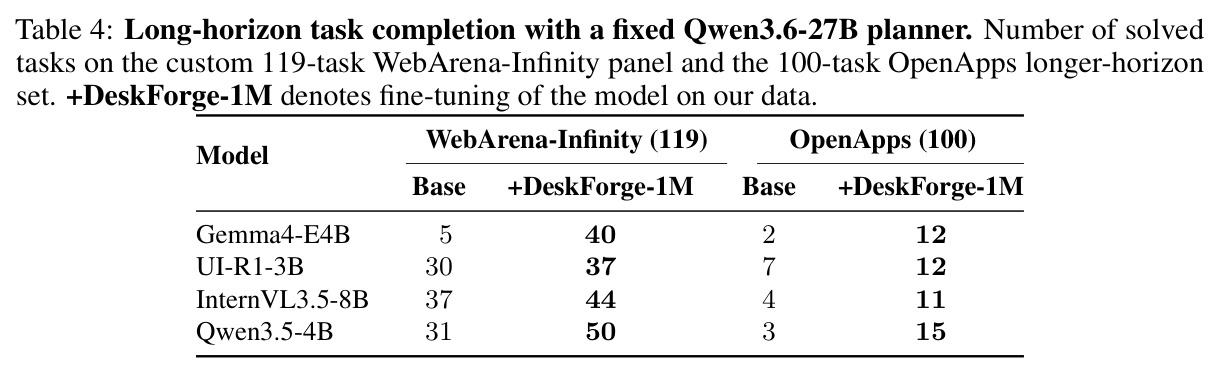
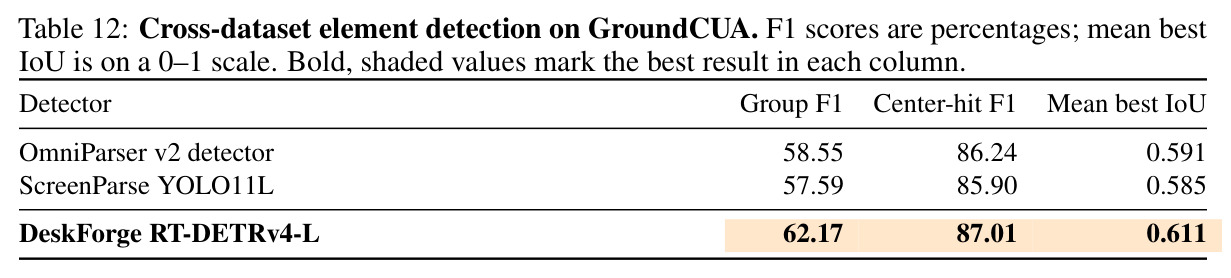
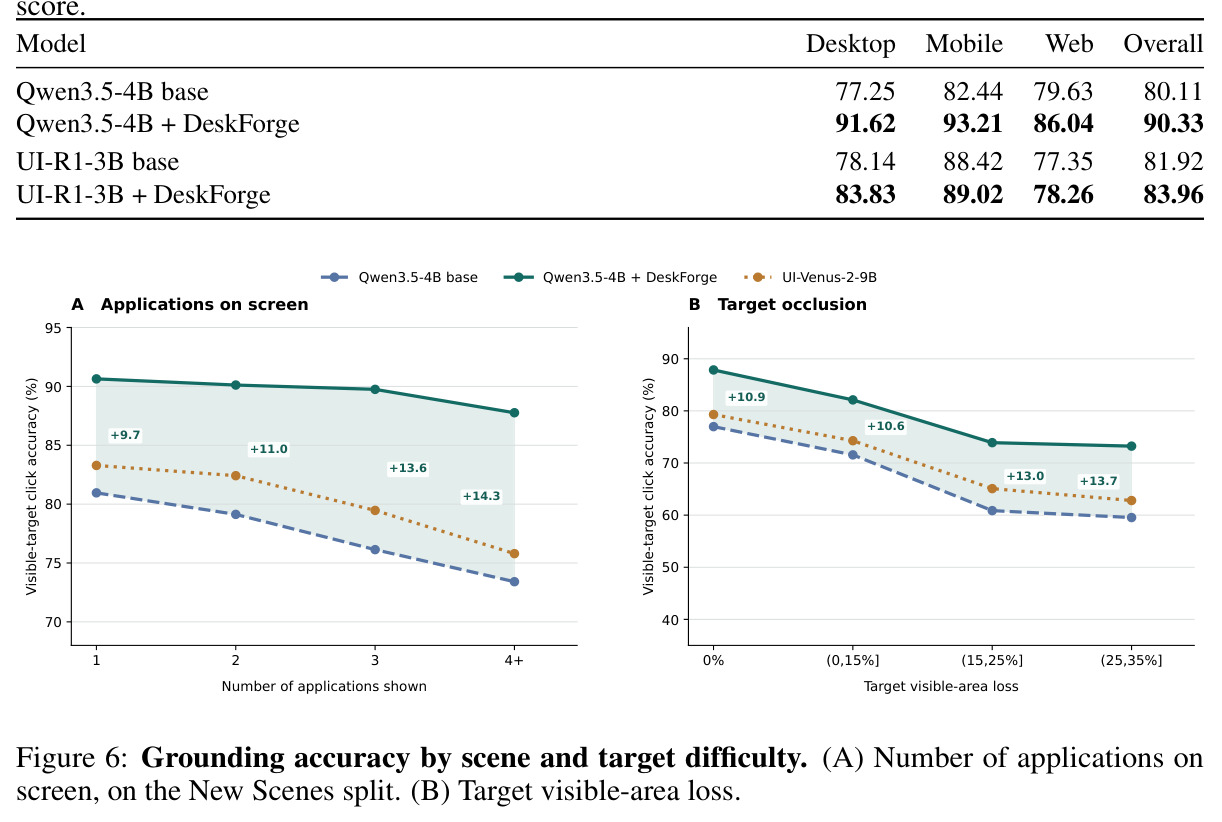
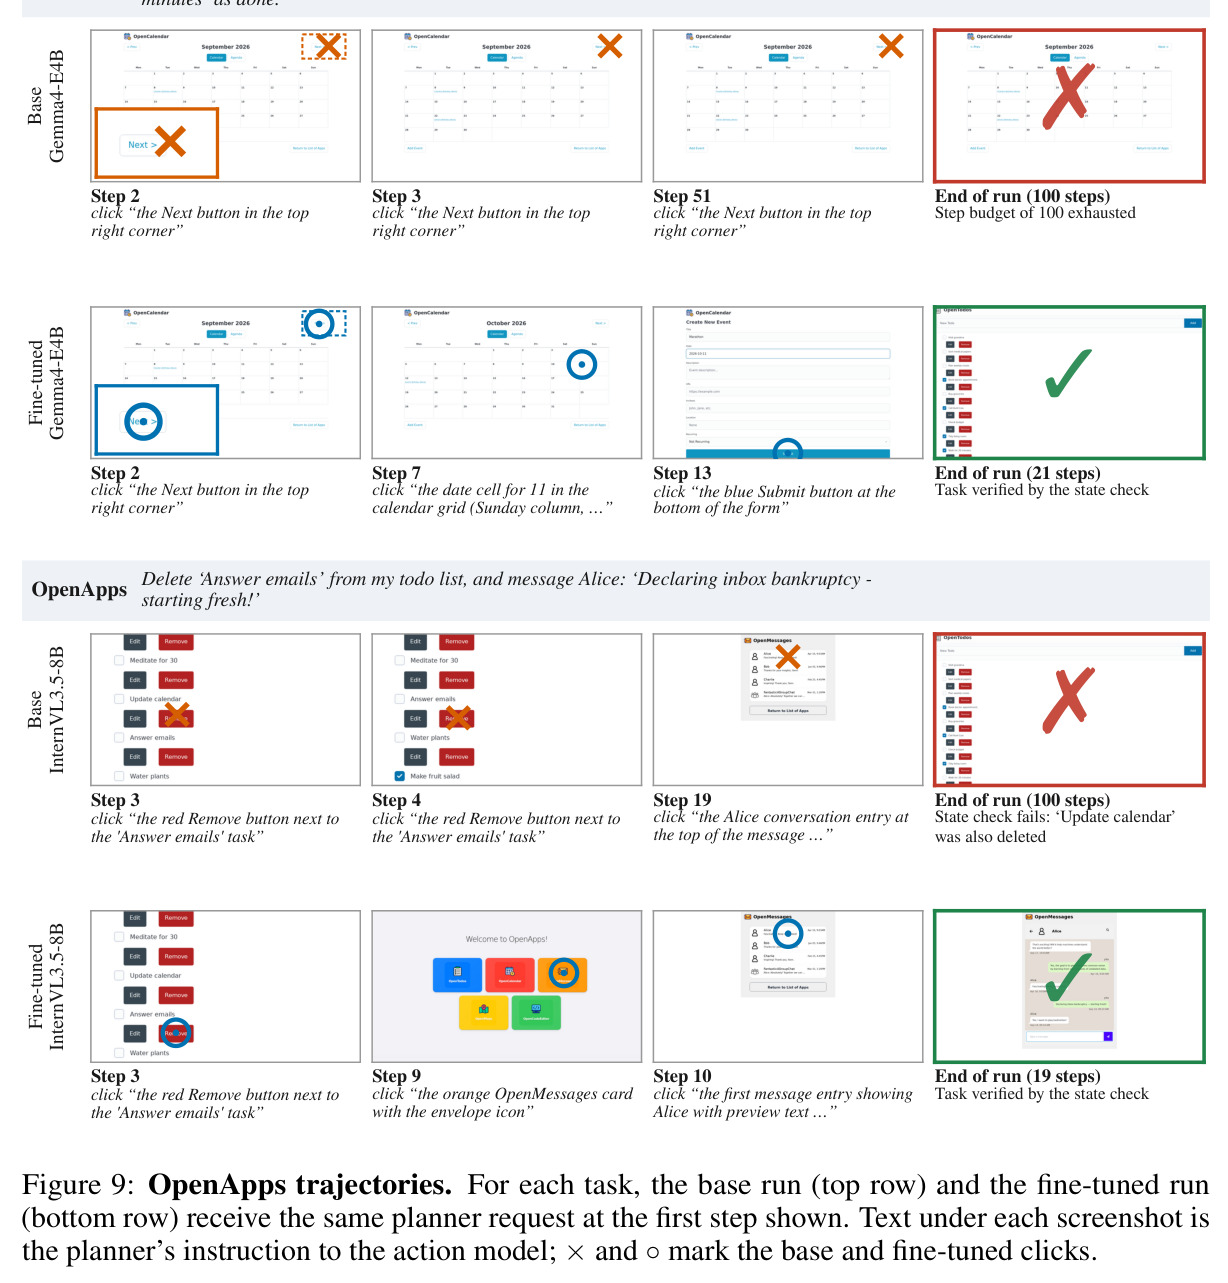
实验回答了四个问题,全部得到肯定答案。第一,held-out 定位(Table 2):四个模型在全部四个 held-out 条件上均提升——Qwen3.5-4B 平均 76.26%→87.54%,UI-R1-3B 38.01%→84.59%,Gemma4-E4B 12.27%→85.12%,InternVL3.5-8B 58.35%→81.42%;微调后的 Qwen 超过十个最强公开检查点中最强的 UI-Venus-2-9B(78.92%)。增益在难场景更大:同屏应用从 1 个增至 4 个以上时,微调 Qwen 与 base 的差距从 9.7 分扩大到 14.3 分;目标可见面积损失升到 35% 时差距从 10.9 分扩大到 13.7 分(Figure 6)。第二,外部迁移(Table 3):五个基准全胜——Qwen 在 ScreenSpot-Pro +11.51 分(30.17%→41.68%)、OSWorld-G +10.11 分(51.24%→61.35%);Gemma 五基准均值 +24.9 分;GUI 特化的 UI-R1 在 ScreenSpot-Pro 从 14.48%→27.20%,说明数据对已有 CUA 仍有增量;ScreenSpot-v2 分域(Table 11)显示 Qwen 桌面 +14.37、移动 +10.77、web +6.41,尽管语料不含移动屏。第三,长程任务(Table 4):固定 Qwen3.6-27B 规划器、只换动作模型权重,WebArena-Infinity 119 任务上 Qwen 31→50、Gemma 5→40、InternVL 37→44、UI-R1 30→37;OpenApps 100 任务上 Qwen 3→15、Gemma 2→12、UI-R1 7→12、InternVL 4→11——纯单目标定位监督就提升了多步任务完成率。第四,全屏检测(Table 12):DeskForge 密集标注训练的 RT-DETRv4-L 在外部 GroundCUA 上 group F1 达 62.17%,超过 OmniParser v2(58.55%)3.62 分、ScreenParse YOLO11L(57.59%)4.58 分,center-hit F1 87.01、mean best IoU 0.611 亦均为最佳。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeskForge-1M held-out 定位(四条件均值:新场景/主题/应用/分辨率) | 点击准确率(%) | Qwen3.5-4B 微调后 87.54;UI-R1-3B 84.59;Gemma4-E4B 85.12;InternVL3.5-8B 81.42 | 各自 base:Qwen 76.26、UI-R1 38.01、Gemma 12.27、InternVL 58.35;最强公开模型 UI-Venus-2-9B 78.92 | Qwen +11.28 分并超最强公开模型 8.62 分;UI-R1 +46.58 分;Gemma +72.85 分 |
| ScreenSpot-Pro(专业高分辨率桌面定位) | 准确率(%) | Qwen3.5-4B 41.68(base 30.17);UI-R1-3B 27.20(base 14.48) | Qwen3.5-4B base 30.17 | Qwen +11.51 分;UI-R1 +12.72 分 |
| OSWorld-G | 准确率(%) | Qwen3.5-4B 61.35 | Qwen3.5-4B base 51.24 | +10.11 分 |
| 五外部基准均值(SS-Pro/SS-v2/OSWorld-G/UI-Vision/MMBench-GUI) | 平均准确率(%) | Gemma4-E4B 提升 24.9 分(五基准全部提升);UI-R1 均值 39.87→47.14 | 各模型 base 检查点 | Gemma +24.9 分(四模型中最大);InternVL +1.51 分(最小) |
| WebArena-Infinity(119 任务,固定 Qwen3.6-27B 规划器) | 解决任务数 | Qwen 50;Gemma 40;InternVL 44;UI-R1 37 | Qwen 31;Gemma 5;InternVL 37;UI-R1 30 | Qwen +19;Gemma +35(8 倍);InternVL +7;UI-R1 +7 |
| OpenApps(100 任务长程集,固定规划器) | 解决任务数 | Qwen 15;Gemma 12;UI-R1 12;InternVL 11 | Qwen 3;Gemma 2;UI-R1 7;InternVL 4 | Qwen +12(5 倍);Gemma +10(6 倍);UI-R1 +5;InternVL +7 |
| GroundCUA 跨数据集全屏元素检测 | Group F1(%),辅以 center-hit F1 与 mean best IoU | DeskForge RT-DETRv4-L 62.17(center-hit F1 87.01,IoU 0.611) | OmniParser v2 58.55;ScreenParse YOLO11L 57.59 | +3.62 / +4.58 分,三项指标全部最佳 |
局限与改进
作者明确承认的局限有三条:当前采集基于 Linux 后端,且依赖应用有合适的辅助功能支持,无障碍结构差的应用无法接入;七种外观预设只是复现 Windows/macOS 的视觉惯例,并不运行原生应用;VLM 训练聚焦单目标定位,保留的界面结构与状态变化数据尚未被联合利用。我的补充观察:其一,19 个应用的覆盖面仍然有限,缺少 ScreenSpot-Pro 所代表的 CAD/创意类专业软件,微调后 Qwen 在该基准上也仅 41.68%,说明专业界面仍是硬骨头;其二,指令由 Qwen3.6-27B 单一模型合成,语言风格受其偏好约束,且单步指令与真实用户的多步、带状态的意图表达存在分布差异(人工审计的 97.8% 合格率也只覆盖“措辞是否指对目标”,不覆盖指令风格多样性);其三,长程评测中规划器与微调主力模型同为 Qwen 系,同族兼容性可能放大收益,换异构规划器未验证;其四,应用级 held-out 只留出 3 个应用,对“完全陌生的应用家族”的泛化证据有限;其五,移动端 +10.77 的迁移机制论文未解释,读者难以判断这是桌面定位能力的泛化还是更一般的视觉定位先验在起作用。
独立分析的弱点
独立分析出五个弱点及改进方向。第一,Linux 单后端:原生 Windows/macOS 应用(尤其 Office、Adobe 类)的渲染细节、控件行为与字体渲染差异显著,deskForge 预设只是“看起来像”;改进方向是接入原生平台后端,或用高保真 UI 复刻 + 差异化渲染参数做域随机化。第二,对辅助功能树的依赖形成覆盖上限:自绘控件或无障碍实现糟糕的应用(不少专业软件正是如此)会被系统性漏掉;作者已提出“补充视觉标注”,具体可落地为用视觉基础模型做伪标注、窗口几何与像素显著性做交叉验证、低置信度样本送人工抽检的半自动管线。第三,语料利用严重不充分:159.7M 元素实例与 917K 转移只用了 200K 单目标视图训 VLM,密集 ScreenTag 解析和 $(S_t,a_t,S_{t+1})$ 动力学目标都还没有用于 VLM 训练,这是最明显的“免费”提升空间。第四,探索是无目标随机点击,产出的是单步指令而非任务轨迹,无法直接训练规划器;可借鉴 OS-Genesis 的逆向任务合成,把转移串成带状态验证的多步任务。第五,指令多样性依赖单一生成模型;改进方向是多模型交叉生成加一致性过滤,并按用户画像(新手/专家、不同语言)控制系统性改写。
未来方向
作者提出的方向:一是利用保留的转移数据开展正/逆动力学学习——正向预测“点击后界面如何变化”、逆向反推“什么动作造成此变化”,让模型理解动作后果而非仅会点;二是开发带状态验证的目标条件多应用任务,把 DeskForge 从数据工厂扩展为可在线训练长程智能体的环境;三是接入原生平台后端、更广的应用集成和补充性视觉标注,覆盖辅助功能结构稀少的界面。基于本文成果可自然延伸的方向:把已在 GroundCUA 上超过 OmniParser v2 的检测器作为解析前端,与指令条件定位组成“全屏解析 + 目标定位”双通路 agent 架构;用 917K 转移训练轻量世界模型,供规划器做前瞻模拟与自我校验;针对低分辨率与专业软件做课程式数据配比,冲击 ScreenSpot-Pro 剩余的 58% 失败案例;在 OSWorld 完整任务集而非 119 任务子集上验证端到端收益的普适性。
复现评估
开源情况良好:论文承诺框架代码、DeskForge-1M 数据集和微调后的模型都从项目页(saidgurbuz.github.io/deskforge)发布,附录提供了标注管线细节(附录 A/B/D)、训练配置(附录 C)、指令生成完整 prompt(附录 G),透明度较高。算力方面门槛不高:VLM 微调只需 8×H100、LoRA、1 epoch、全局 batch 64、200K 样本,检测实验微调 RT-DETRv4-L 算力需求更低,多数有集群的实验室可负担。真正的难点在数据侧:1.21M 截图加 159.7M 元素记录预计是 TB 级存储;若要从零复现数据生成,需要搭建 Linux 桌面、隔离会话管理、19 个应用的 manifest 与内容预置脚本、主题资产集成、辅助功能-像素-几何融合管线,工程隐性成本很高,种子化设计虽保证可复现但调通管线需大量迭代。总体评估:用官方数据复现微调实验属于中等难度;完整复现环境与数据生成属于高难度。
论文图表
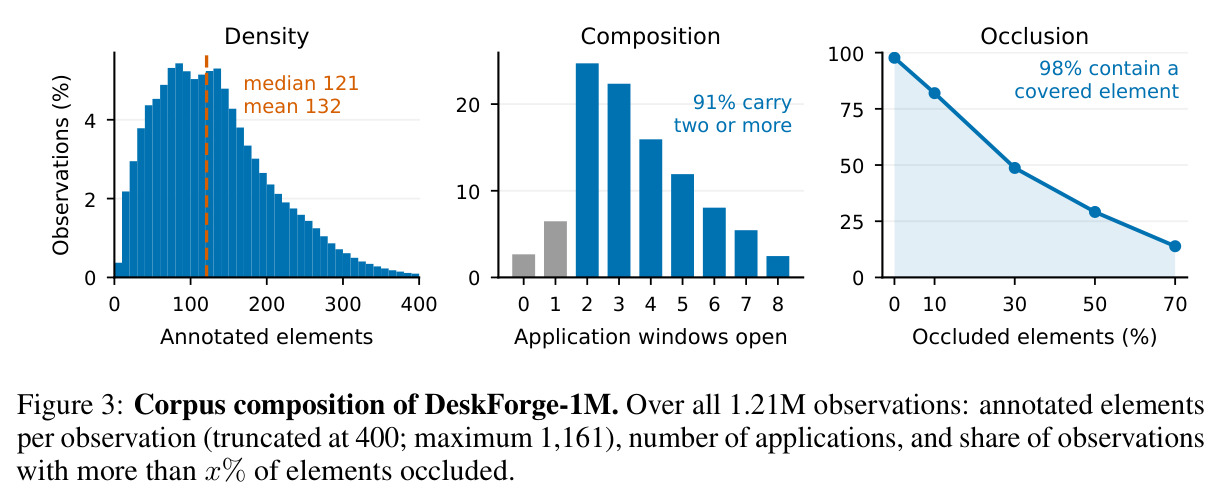
三个直方图刻画语料难度:每屏标注元素数(均值 132、中位数 121、截断于 400、最大 1161);同屏应用窗口数(90.9% 的观测含两个及以上应用);元素遮挡比例(97.7% 的观测含被遮挡元素,近半数观测中超过 30% 的元素被遮挡)。
用数据证明桌面场景确实密集、拥挤、遮挡严重——这既是本文动机的经验支撑,也是解读后续难度分组实验的背景。