EditHero:首个长时程部件级3D编辑与Vibe建模基准 EditHero: A Benchmark for Long-Horizon Part-Level 3D Editing and Vibe Modeling
程序化构建每轮精确真值的首个长时程3D编辑基准:代码智能体保真更强但更慢
前置知识
原生3D潜变量生成(TRELLIS)
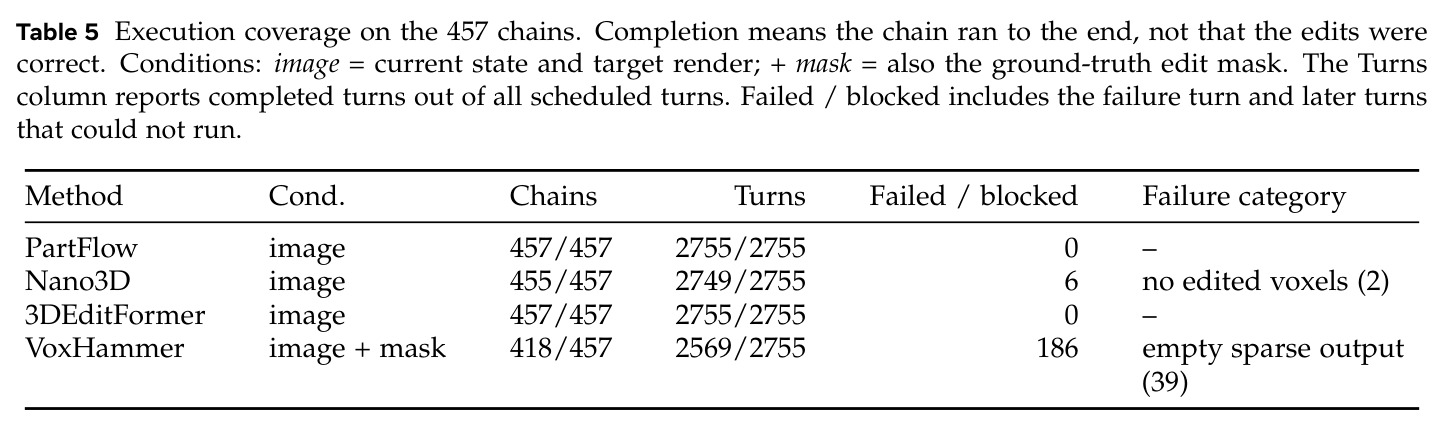
TRELLIS 将 3D 物体编码为结构化潜变量:稀疏的活动体素网格加每个体素的局部特征,并在其上训练流匹配生成模型,可从文本或图像直接生成带纹理的 3D 资产。论文评测的 4 个非智能体编辑方法(PartFlow、Nano3D、3DEditFormer、VoxHammer)全部构建在 TRELLIS 结构化潜变量之上,把编辑视为在潜空间中的受控再生成。
理解『非智能体编辑 = 整体潜变量再生成』这一前提,才能明白它们为何每轮都会或多或少改动整个物体、误差为何跨轮累积,这正是论文的核心批评点。
训练式与免训练 3D 编辑(ControlNet 分支 / 反演 / FlowEdit)
训练式方法用配对编辑数据训练:PartFlow 给生成器加源控制分支,3DEditFormer 用双引导注意力融合源与目标条件。免训练方法复用预训练生成器:VoxHammer 反演源物体并在保留区域复用缓存的潜变量与注意力键值;Nano3D 用 FlowEdit 公式跟随源条件流与目标条件流之差来实现局部改动。
论文对比的正是这 4 类代表方法,弄清它们各自『怎么保留原内容』,才能理解它们在长编辑链上失效方式的差异(如 VoxHammer 保不住、PartFlow 跟不上)。
Self-rollout(自滚动评测协议)
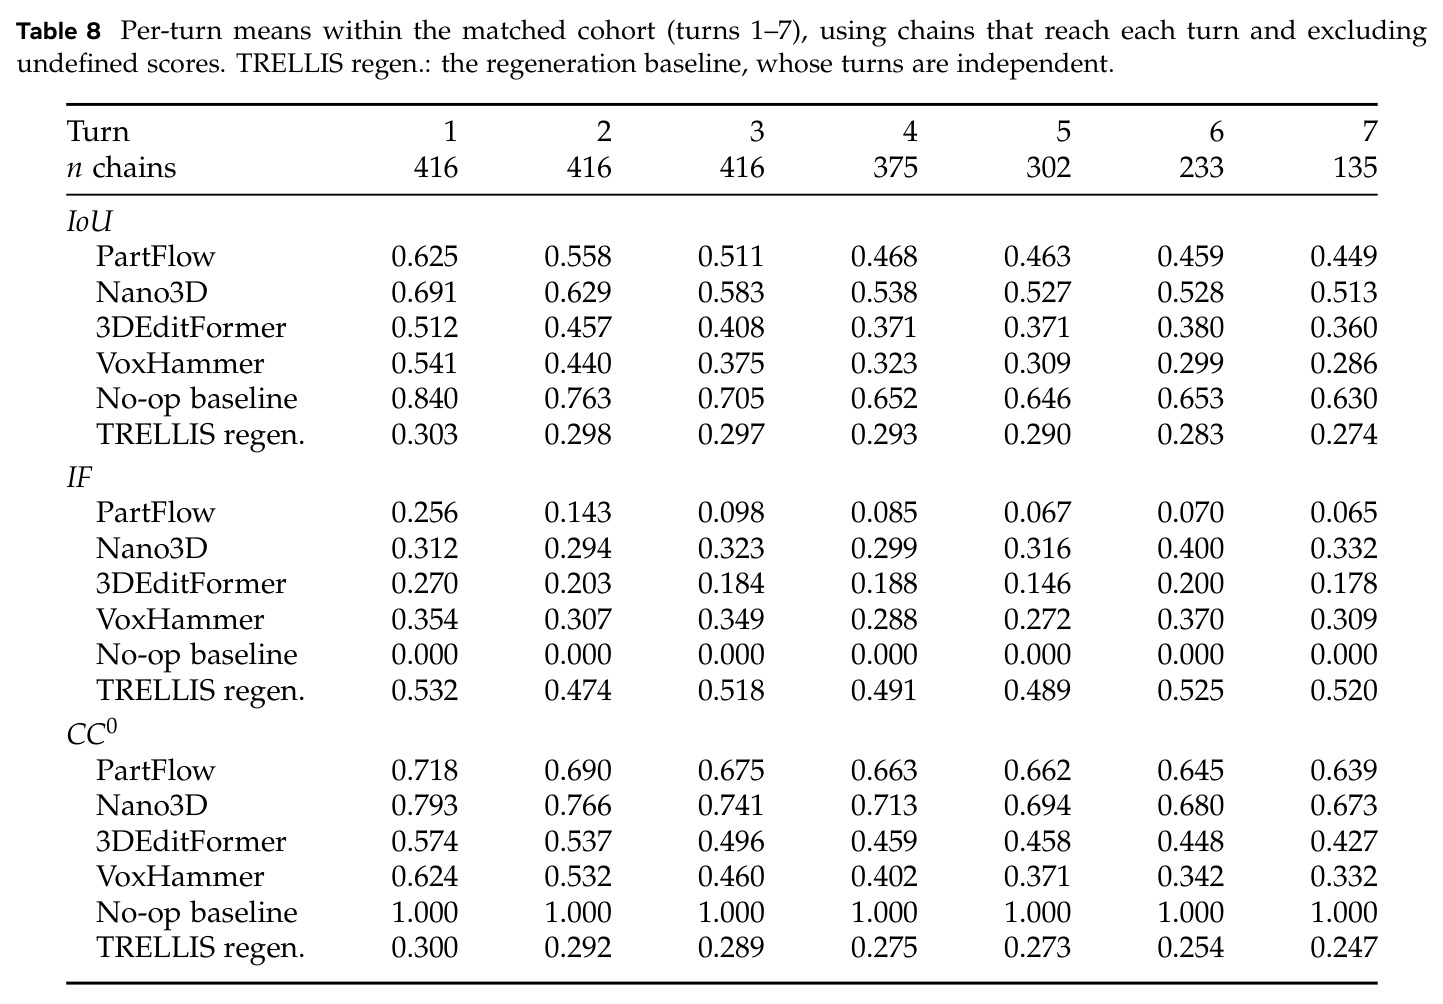
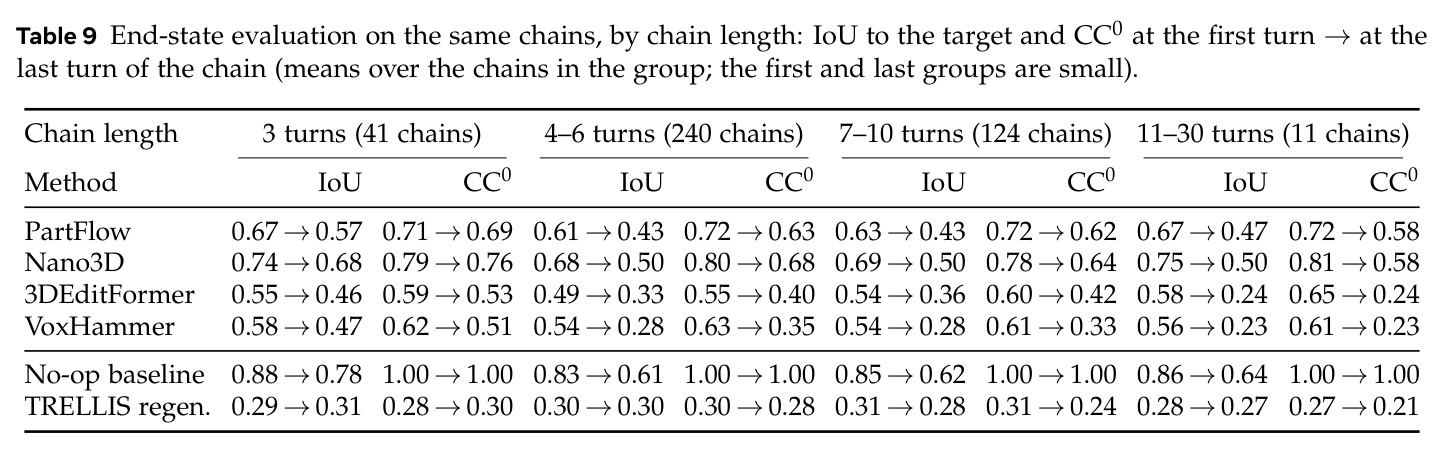
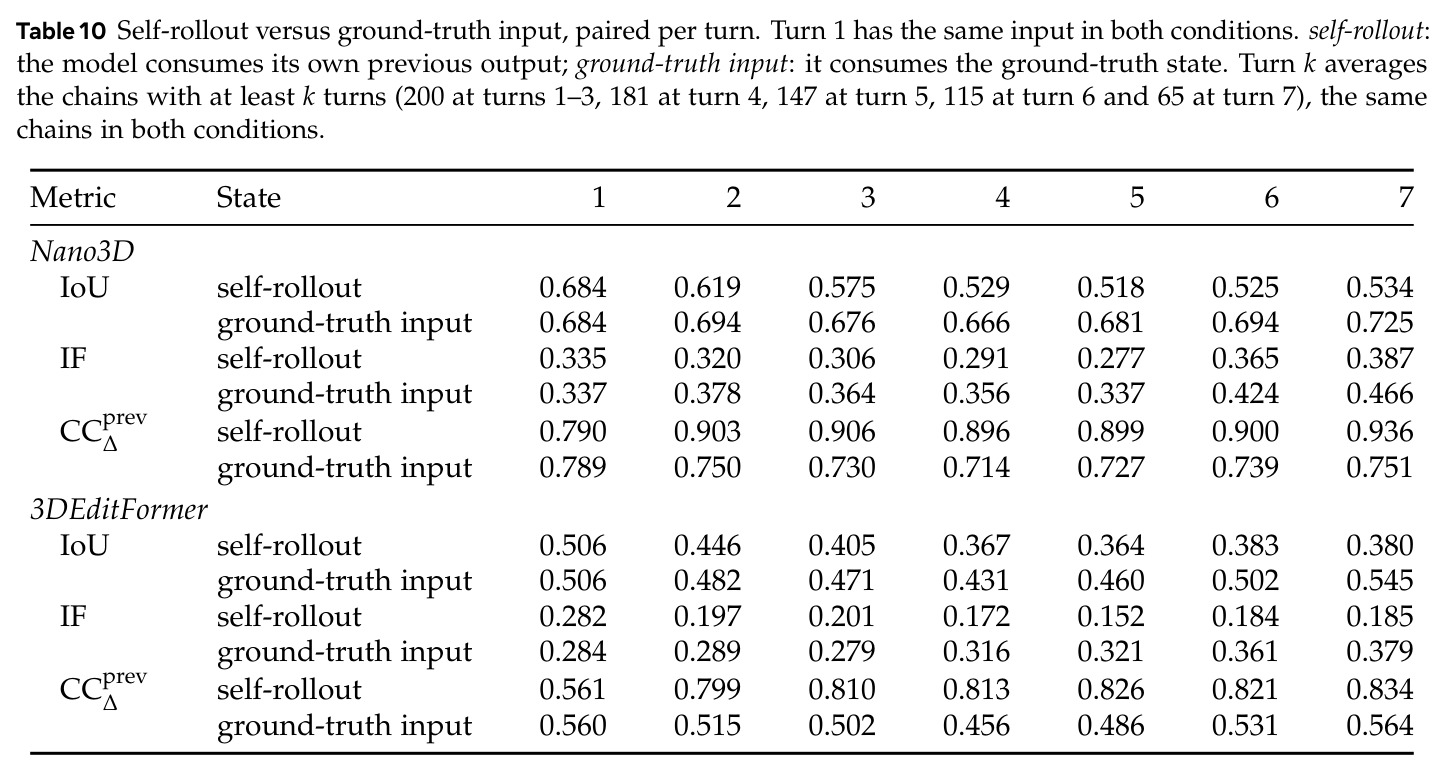
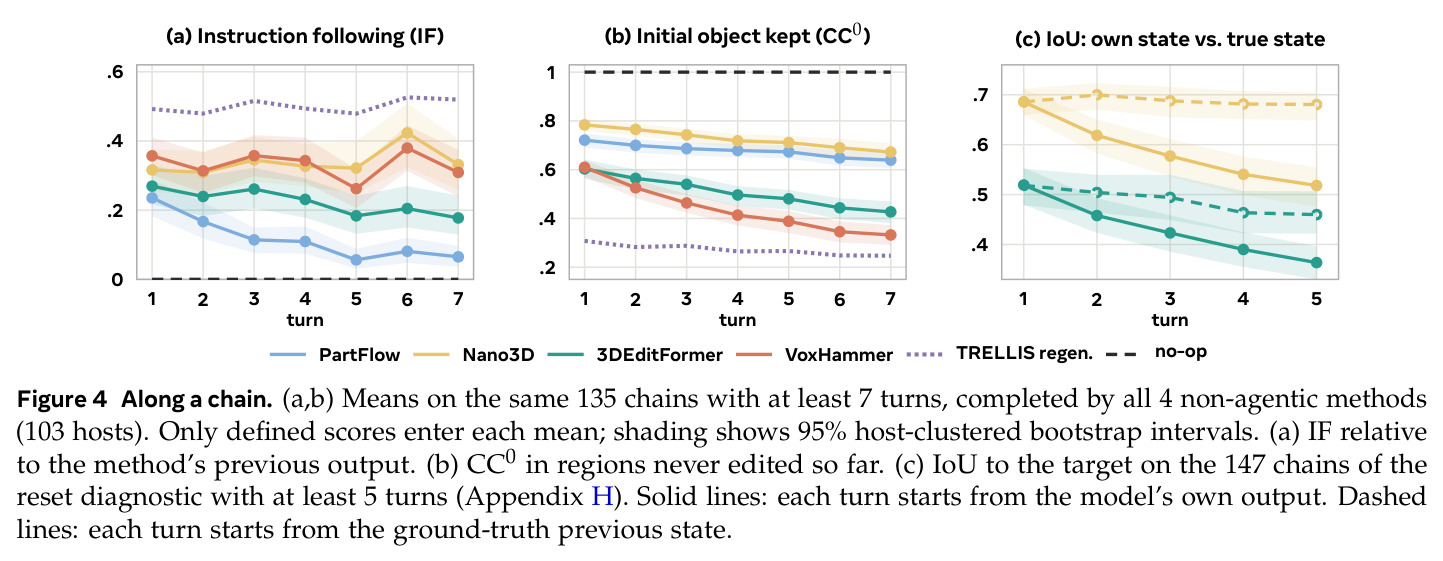
评测协议:第 $k$ 轮的输入是方法自己在第 $k-1$ 轮的输出 $\hat{S}_{k-1}$,而非真值状态,模拟真实迭代工作流。这样任何一次多余的改动都会作为下一轮的输入被继承,可度量误差在长序列中的累积。配套的重置诊断改喂真值输入 $S_{k-1}$,把『继承误差』与『指令本身更难』两种效应分离。
论文的核心结论(误差主要来自继承而非指令变难)正是通过 self-rollout 与真值输入对比得出的,不懂该协议就看不懂 Figure 4c 和 Table 10。
LLM/VLM 代码智能体(agentic editing)
大模型检查当前网格与渲染,编写程序(论文基于 Blender 渲染、img2threejs v2.0.0 风格代码)直接增删部件或改材质,再渲染比对、迭代修正后提交。新几何必须用代码从图元构建,禁止外部资产与生成式模型,因此『只改动被点名的部件、其余不动』是由构造保证的。
这是论文对比的另一极:自底向上编辑的保真来自代码的确定性,与生成式方法的概率性保留形成本质对照,是『智能体天然适合编辑』结论的基础。
槽位(slot)与四种部件级操作
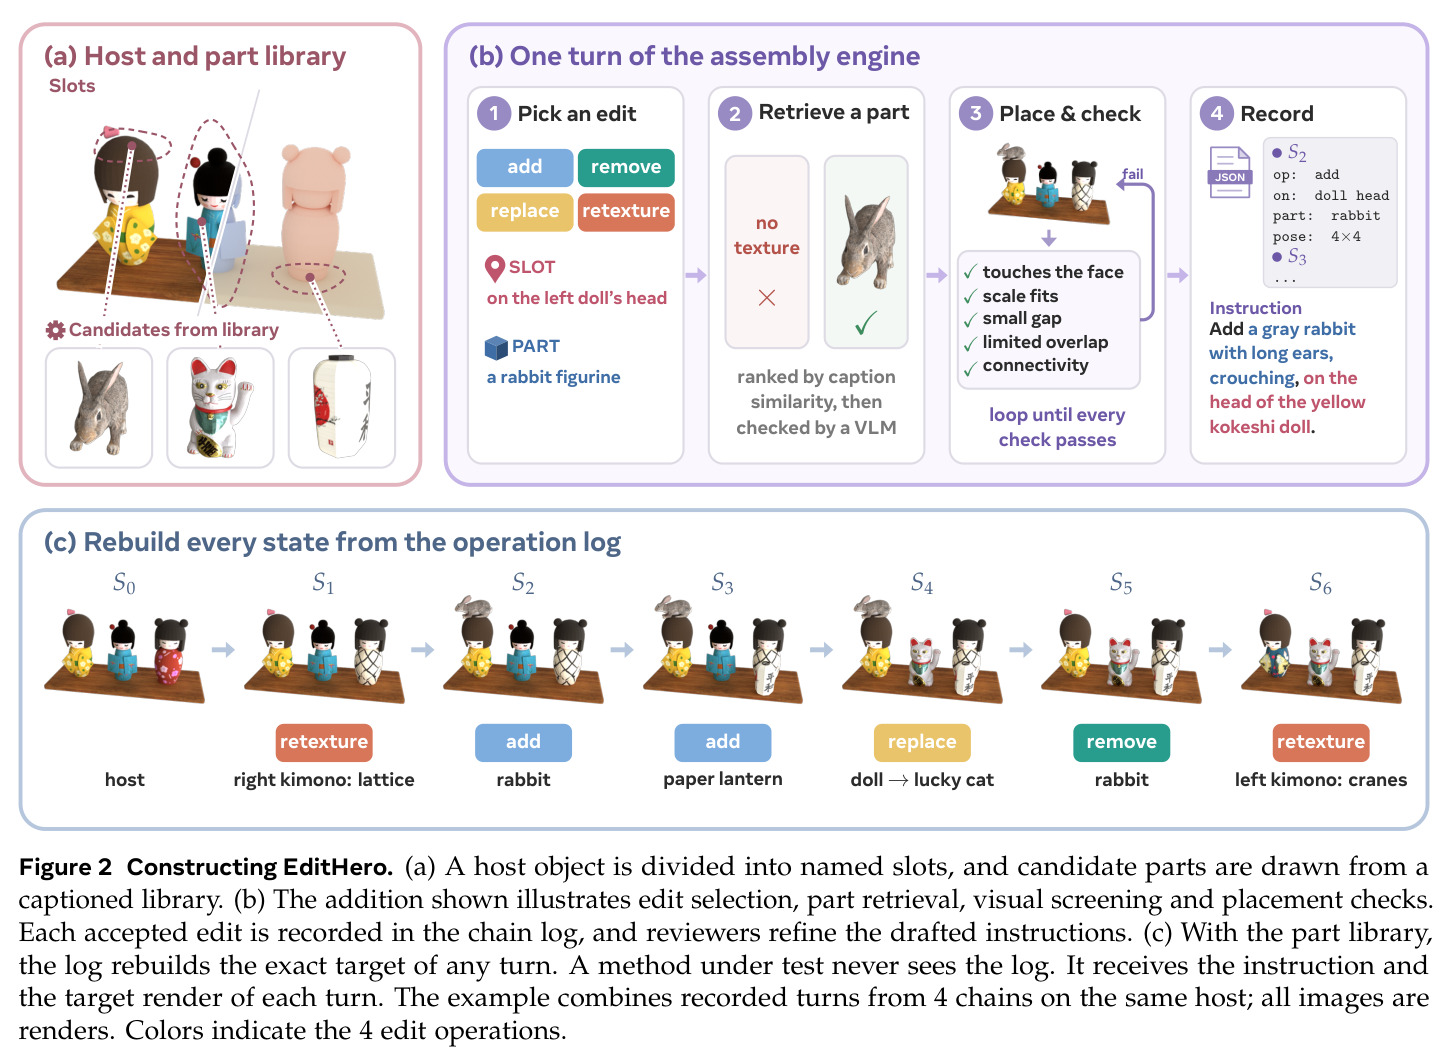
宿主物体的部件按接触图与描述聚合成少量可命名的槽位(如头部、手臂、门廊雨棚),指令用自然语言指名槽位而不含内部标识符。四种原子操作:add(在自由接触面挂新部件)、remove(删除槽位内容,可能是多件)、replace(同位置换部件)、retexture(只改材质不动几何)。
槽位既是编辑的单元,也是引擎精确重建真值的钥匙:评测中的编辑区域 $E_k$ 就由被点名部件在新旧真值态中的并集定义。
研究动机
3D 资产在美术与游戏生产中不是一次编辑完成的,而是通过一连串修改演化:每一轮只改动当前资产的一部分,同时必须保住此前所有工作。近年提出的 vibe modeling 正设想用户通过迭代自然语言对话塑造资产,但现有文本/图像引导的 3D 编辑方法几乎都只在『干净源物体 + 单次编辑』上评测。现有配对数据集只提供孤立编辑,其目标要么来自学习型编辑模型或图像引导重建本身(目标可能包含无人要求的改动),要么只是姿态或语义部件变换,都无法回答:一个方法能否在不丢失先前修改、不退化资产的前提下反复编辑自己的输出?例如第 2 轮加上的帽子第 5 轮被要求移除,方法是精确执行还是顺手改了别处?长时程下的指令跟随与内容保持,此前没有任何带精确 3D 参考的评测,甚至没有能定义『每轮正确状态』的数据。
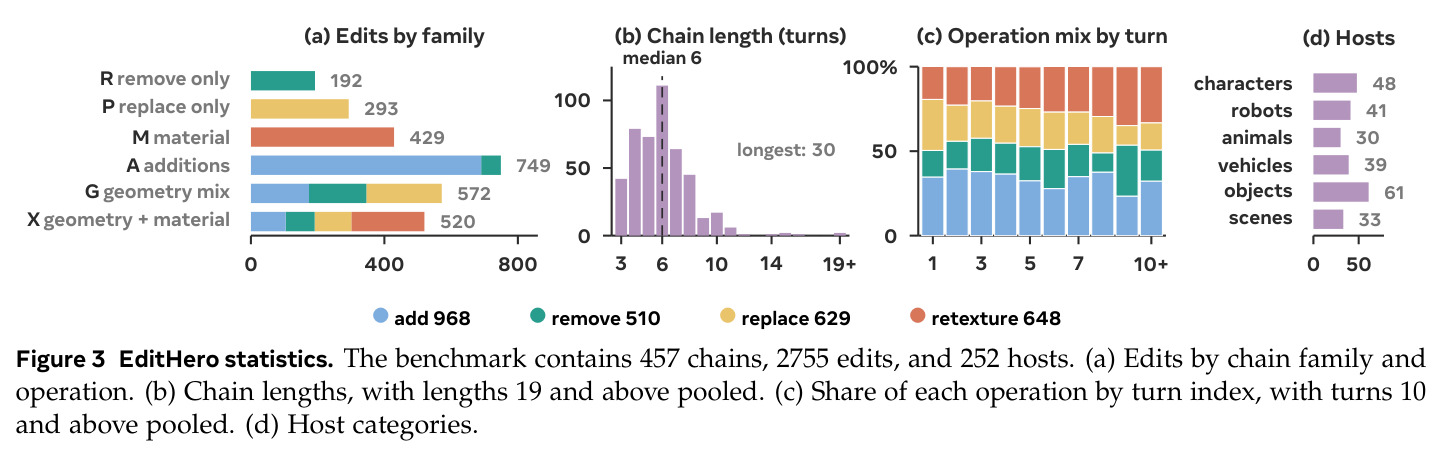
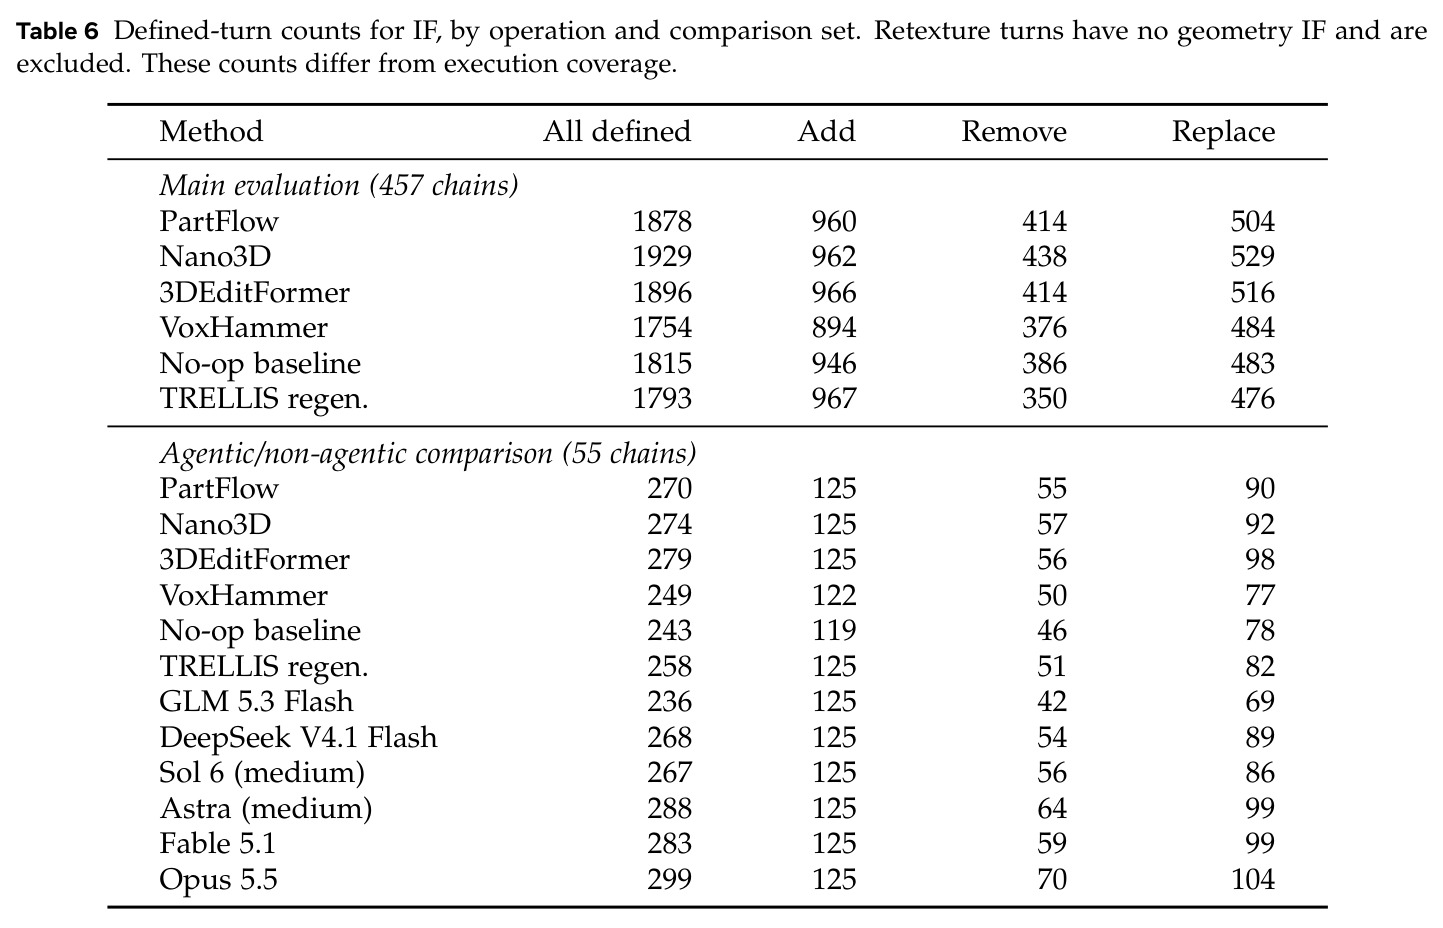
本文的目标是本文构建并开放第一个长时程部件级 3D 编辑基准 EditHero:给定带纹理、部件分段的宿主物体和一串自然语言编辑指令(附每轮目标渲染图),方法须逐轮执行 add/remove/replace/retexture 四种部件级操作。为此需要一个数据引擎:以确定性组装方式程序化拼装每轮的精确目标状态——最终 457 条链、2755 次编辑、252 个宿主物体,每链 3–30 轮(中位 6 轮),中位指令长度 17 词,全部经人工审核。在此之上用统一的 self-rollout 协议对比两类对立方法——4 个非智能体生成式编辑方法与 6 个 LLM/VLM 代码智能体,并设计把『编辑区指令跟随』与『非编辑区内容保持』分开的指标,回答:迭代式 3D 编辑现在可不可靠、哪种范式更接近 vibe modeling 的要求。
与已有工作不同的是,独特之处有三。第一,真值靠构造而非生成:像 CLEVR/Kubric 程序化生成场景那样,引擎从部件库检索、VLM 筛选并按几何检查放置部件,每次编辑是一个原子操作写入 JSON 日志,配合部件库可确定性重放、精确重建任意轮次状态 $S_k = o_k(\cdots o_1(S_0))$——现有基准的目标来自图像引导生成或姿态变换,天然含噪且无中间参考。第二,评测在方法自身输出上进行并配以新指标:编辑区域按被点名部件而非体素/像素差定义,指令跟随锚定方法自身上一轮输出,杜绝什么都不做的基线白拿分数。第三,首次把『自顶向下整体再生成』与『自底向上代码改部件』两种哲学对立的范式放进同一长时程协议、同一指标体系下较量,并用量化证据支撑『智能体天然适合编辑』的判断。
核心方法
直觉:真实创作中每轮只应改动被点名的部件,其余原样保留;要评测这一点,就必须在每一轮都知道『正确的状态是什么』。技术路线分两半。数据引擎侧:宿主物体划分为可命名的槽位;每轮从部件库(主体 PartVerse-XL,源自 Objaverse-XL,少量 HY3D-Bench)按 caption 嵌入相似度检索候选部件,经 VLM 与四项几何检查后放置;retexture 用 Qwen-Image-Edit 重绘槽位渲染、再由 TRELLIS.2 纹理模块把新材质贴回未变几何;每轮操作连同部件、位姿、纹理写入 JSON 链日志,可确定性重建任何状态。评测侧:self-rollout 协议下每轮输入方法自身输出;指标拆成编辑区(指令跟随 IF)与非编辑区(内容一致性 $CC_{prev}$、$CC_0$),并设两个极端参照——no-op 基线(每轮返回初始物体,IF=0、CC=1)与 TRELLIS 重生成基线(每轮只看目标图重建,IF 高但 CC 低),好的编辑器应同时胜过这两端。
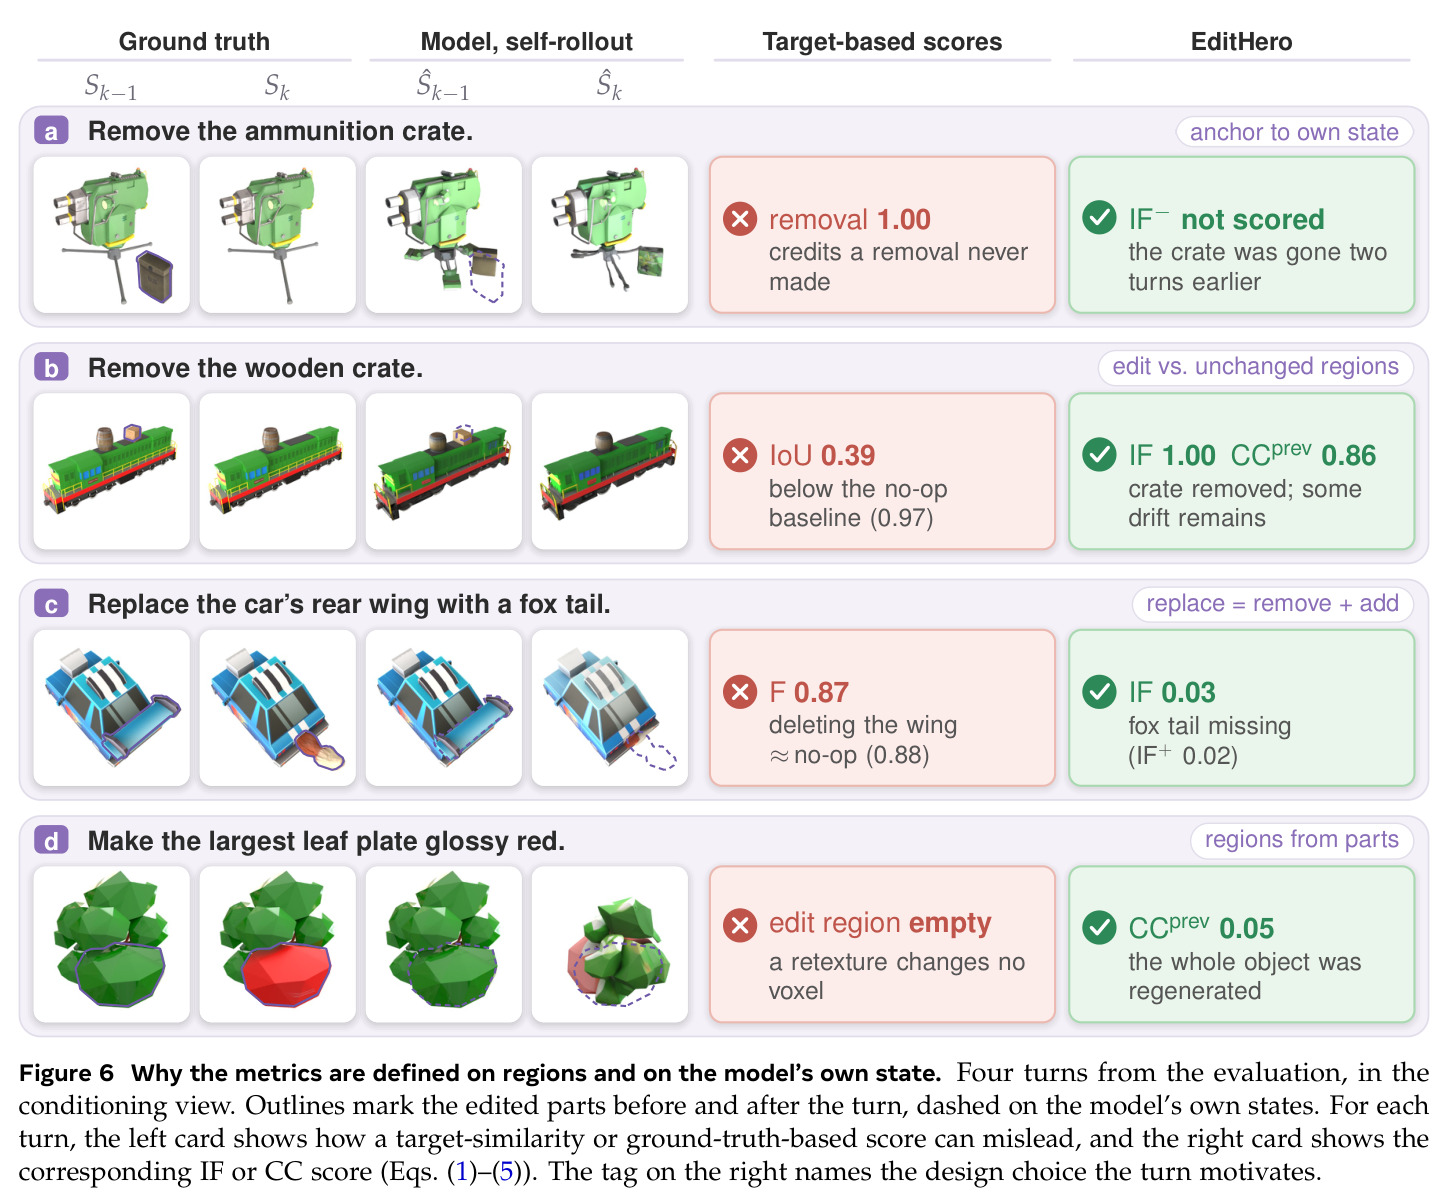
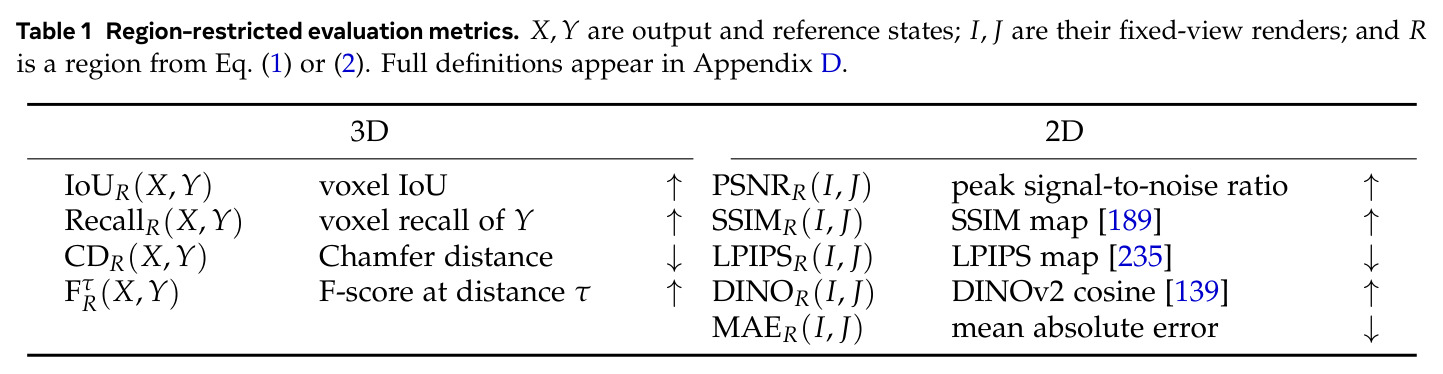
核心创新是『真值靠构造』加『区域化、锚定自身的指标』。已有配对基准的目标由生成模型产出,本身可能包含无人要求的改动,且只覆盖单轮;EditHero 用确定性组装引擎使序列中每一轮都有可重放的精确 3D 参考。指标层面,编辑区域 $E_k = \mathcal{D}(\mathcal{V}(S_{k-1}[M_k]) \cup \mathcal{V}(S_k[M_k]))$ 由被点名部件 $M_k$ 在编辑前后真值态的体素并集膨胀一圈得到——区域随部件身份而非像素差定义,光照变化或 retexture 不会重定义『哪里允许改』。更关键的是指令跟随锚定方法自身上一轮输出:新增所需体素集 $A_k$ 与待删除体素集 $D_k$ 都相对 $\hat{S}_{k-1}$ 计算,$IF^+ = Recall_{A_k}(\hat{S}_k, S_k)$、$IF^- = 1 - Recall_{D_k}(\hat{S}_k, S_{k-1})$。于是『第 2 轮删掉的帽子第 5 轮原样还在』不会被记为成功的删除,no-op 基线恒有 IF=0、CC=1。这组设计第一次把『看起来像目标』与『这一轮真的做了要求的改动』干净分开。
方法步骤详情
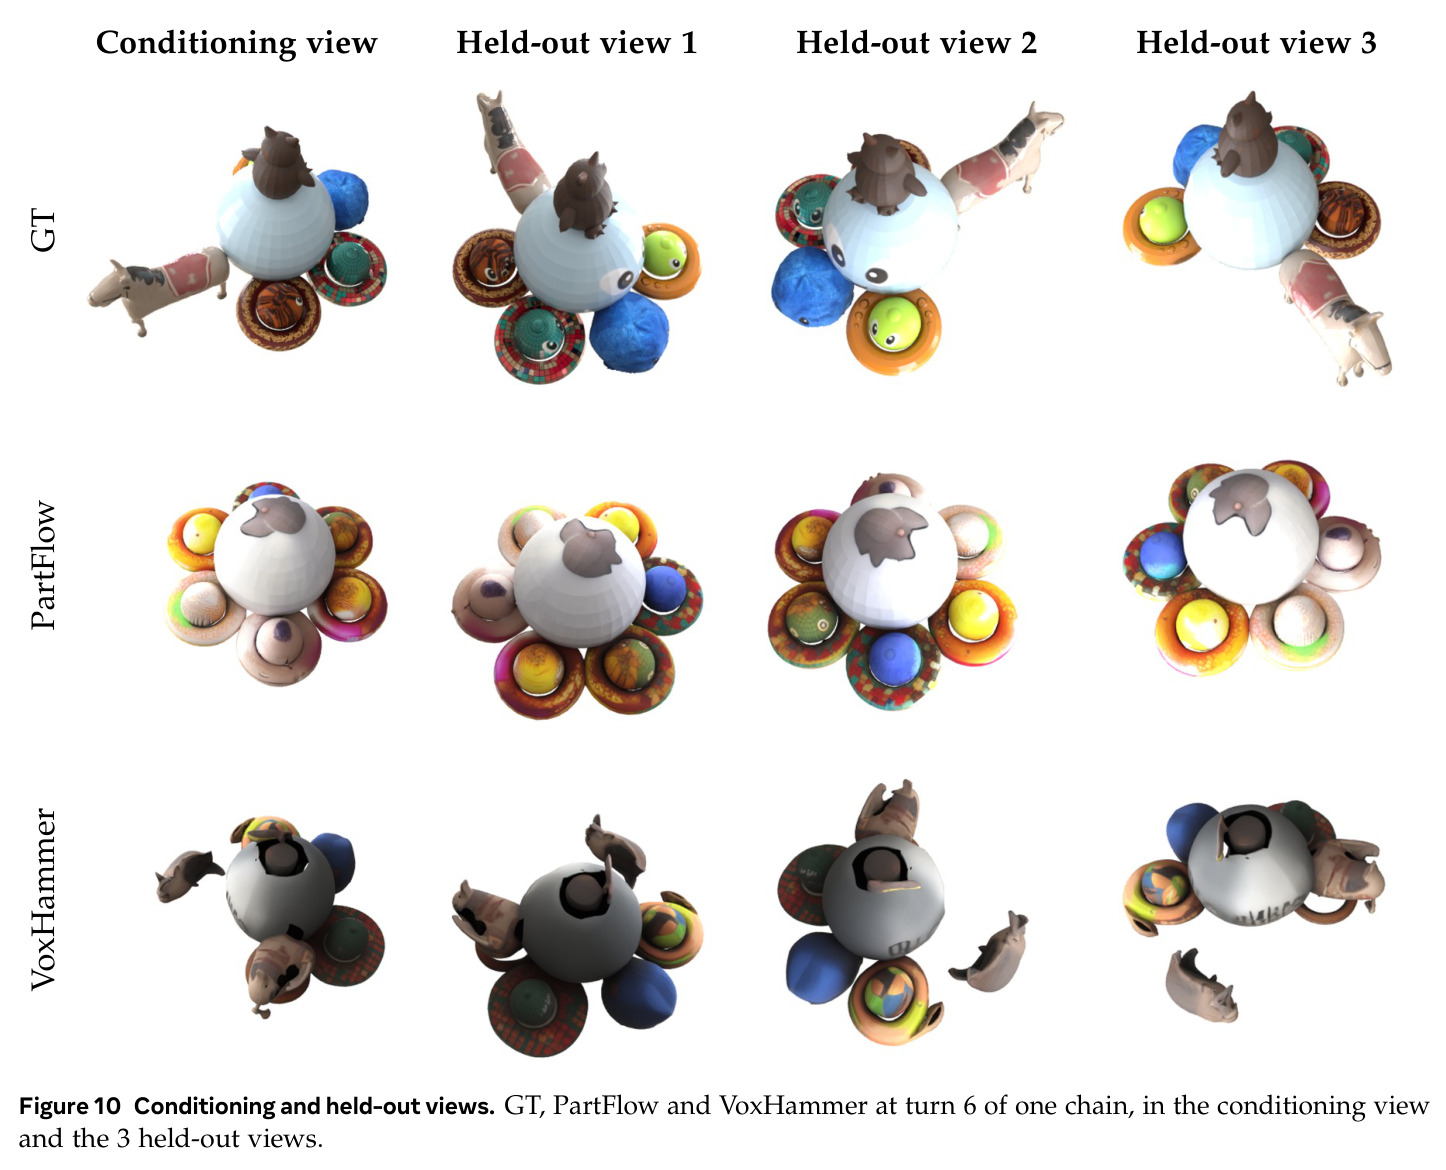
构造:先建带描述的部件库(描述由 Qwen3-VL-32B-Instruct 生成),宿主按部件接触图与描述聚合成槽位并人工审核。每轮选定操作后执行:add 在自由接触面挂新部件,remove 删除槽位内容,replace 在同一接触面替换,retexture 只改材质。检索放置:按 caption 嵌入相似度取候选,初始位姿取自接触面(平面/轴向/点配合),缩放 0.75–2 倍,再过四项检查——存在接触框、间隙小于对角线的 0.01、保持单一连通体、互穿比例低于 0.02——失败换下一候选,VLM 审语义。retexture 由 Qwen-Image-Edit 重绘槽位渲染、TRELLIS.2 纹理模块把新材质贴到未变几何。每轮写入 JSON 日志(槽位、部件、位姿、纹理),修复时改日志并重建受影响轮次;人工审核查语义、朝向、比例、指令歧义与依赖错误,修不了则剪掉重建。评测:全链统一坐标框架与 4 个固定相机(1 条件视图 + 3 保留视图,方向选使最差轮编辑最可见,估计与实测 Spearman $\rho=0.95$);体素化到 $64^3$ 网格;3D 用 IoU/Recall/CD/F-score($\tau=0.01$),2D 用 PSNR/SSIM/LPIPS/DINO/MAE,按区域限制;IF 仅在区域不少于 8 个体素且覆盖至少四分之一真值变化时定义,replace 取 $IF^+$ 与 $IF^-$ 的调和平均。
技术新颖性
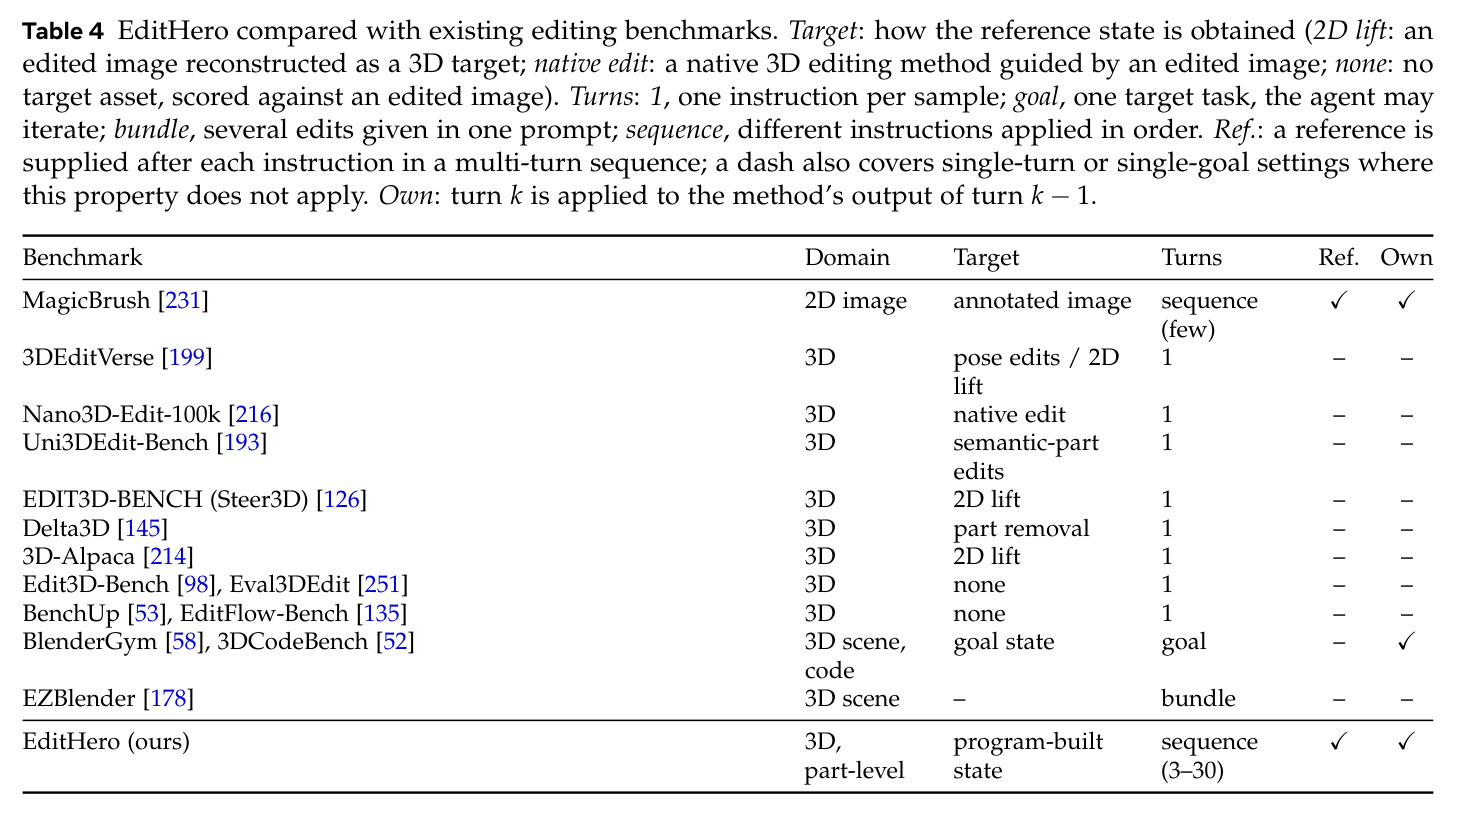
与既有基准逐一对比可见其新:MagicBrush 虽是多轮序列但限于 2D;3DEditVerse、Nano3D-Edit-100k、Uni3DEdit-Bench、EDIT3D-BENCH、Delta3D、3D-Alpaca 都是单轮,目标来自 2D lift、原生编辑模型或语义部件变换;Edit3D-Bench、Eval3DEdit、BenchUp、EditFlow-Bench 没有目标资产;BlenderGym 与 3DCodeBench 让智能体向单一固定目标迭代,EZBlender 只是把多个编辑打包进一个提示。EditHero 是首个在同一资产上评测自然语言部件编辑序列、每轮提供精确 3D 参考、并要求方法在自身输出上连续工作的基准。指标创新在于按部件身份定义区域并把 IF 锚定到方法自身状态——论文用 4 个反例(Figure 6)演示旧式打分如何误导:删除早前已丢失的部件被记满分、只删不加的 replace 在整体 F-score 上与 no-op 相差不到 0.02、retexture 无几何变化导致编辑区为空、整体再生成把未点名的部分也改掉。评测创新是首次让代码智能体与生成式编辑同台,并用真值输入的重置诊断定量分解误差来源。
实验结果
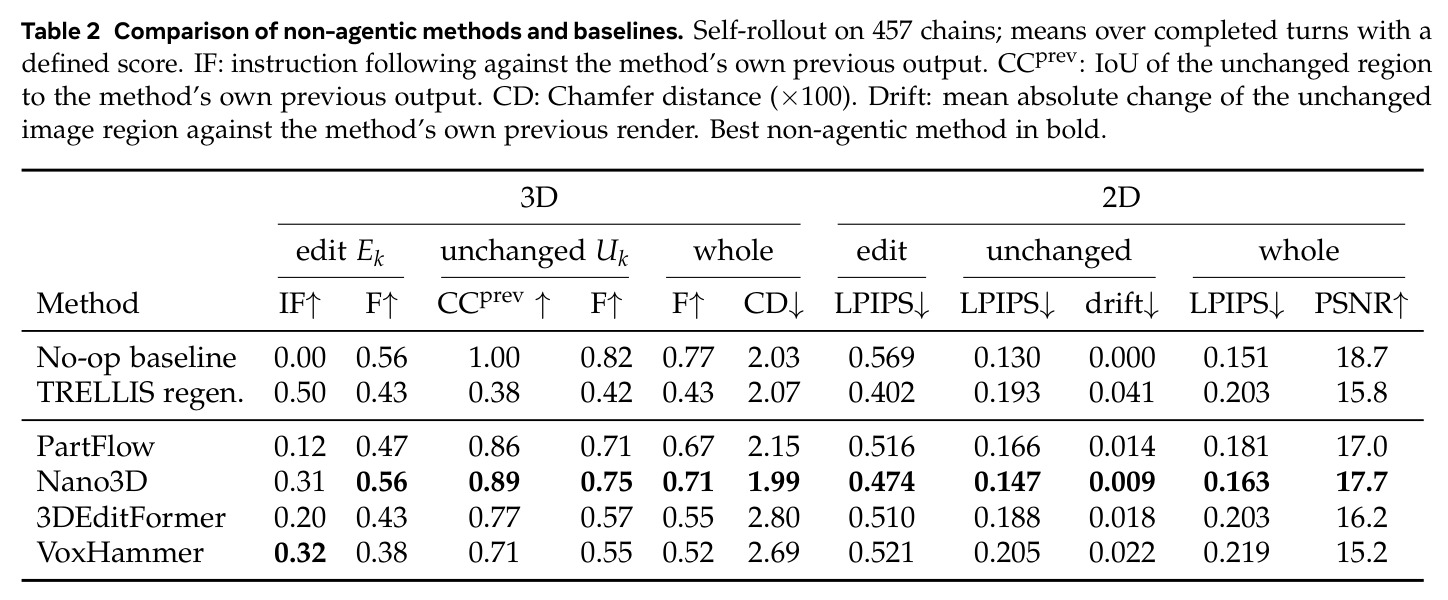
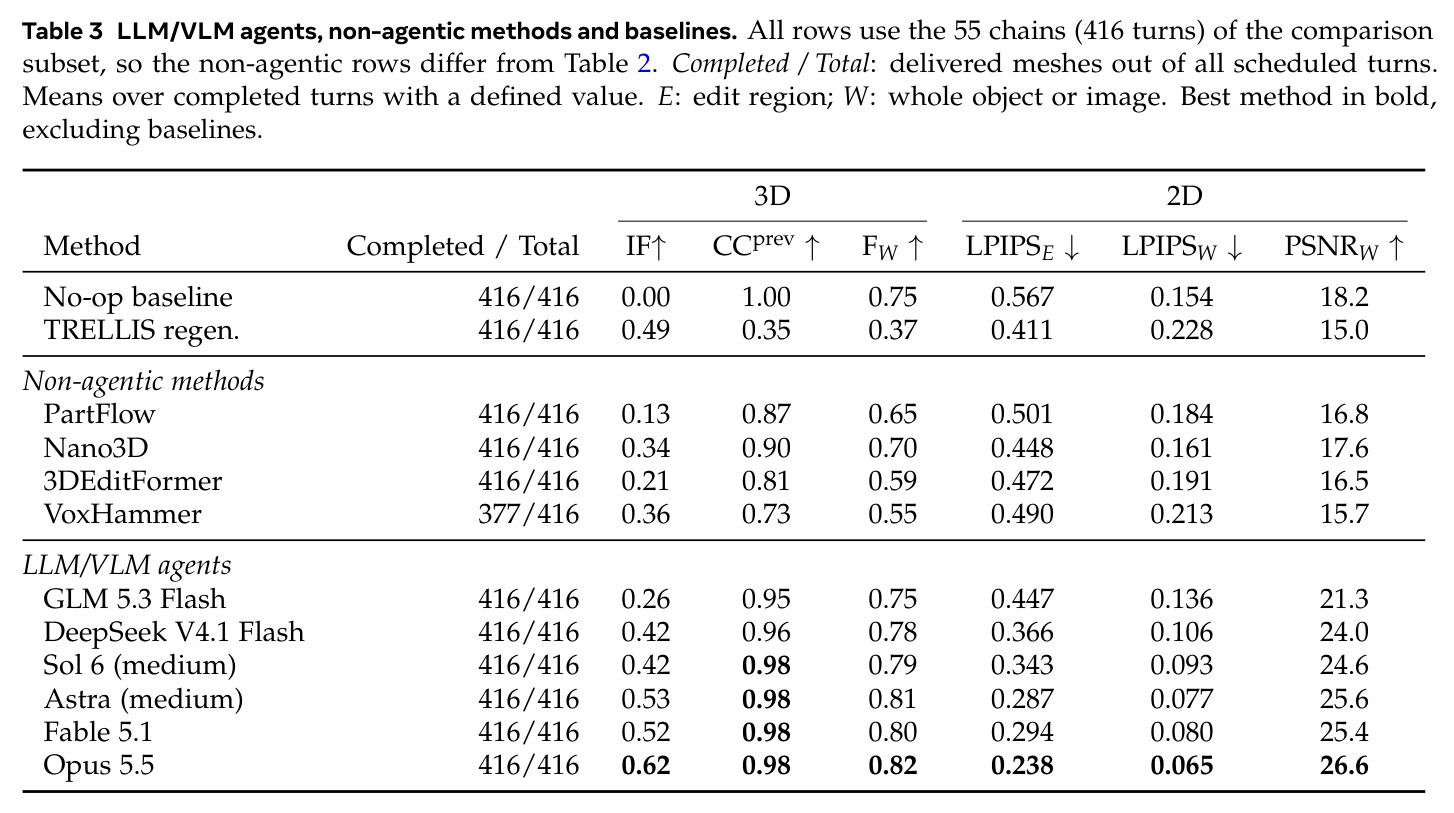
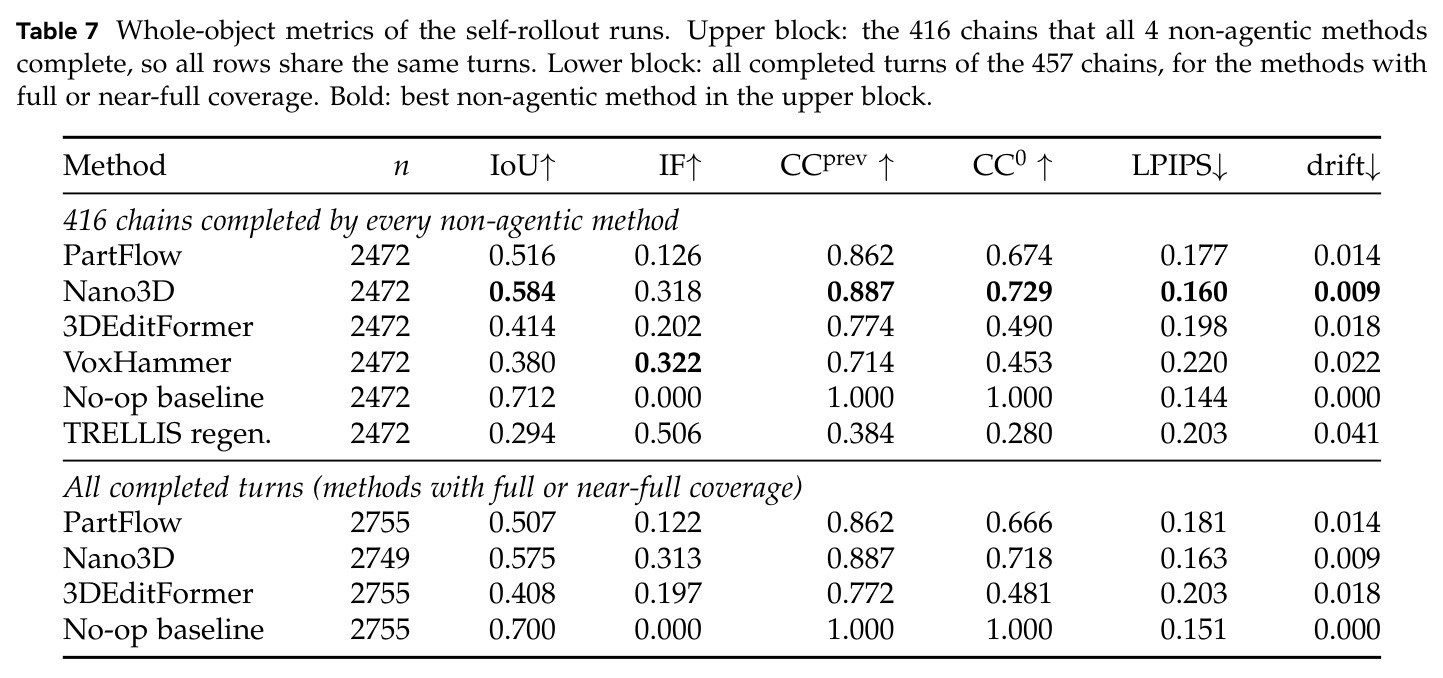
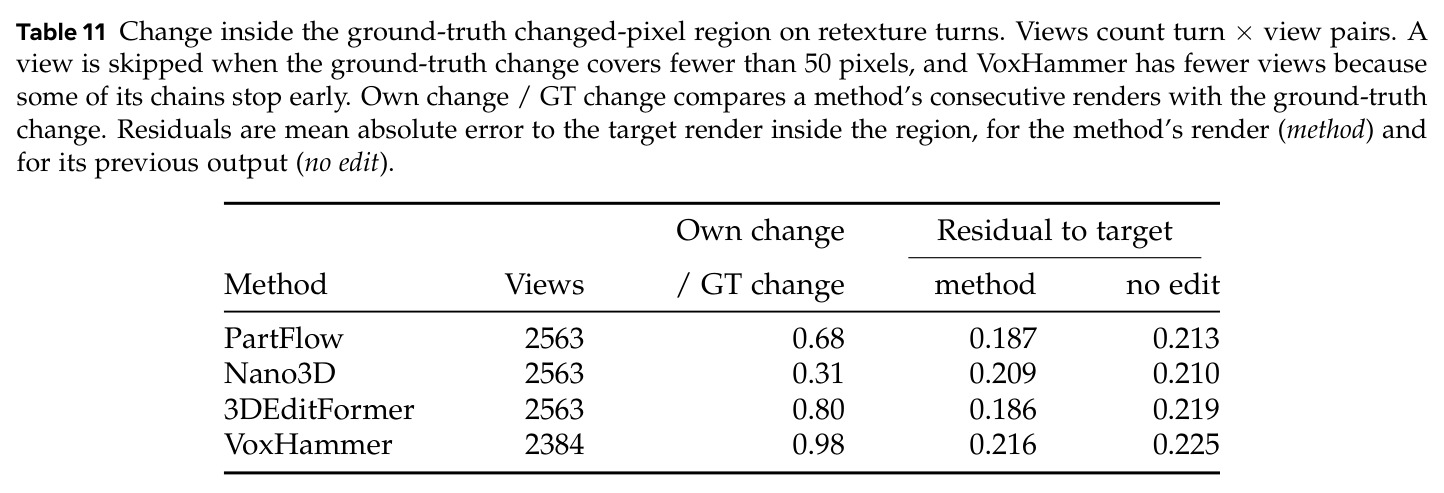
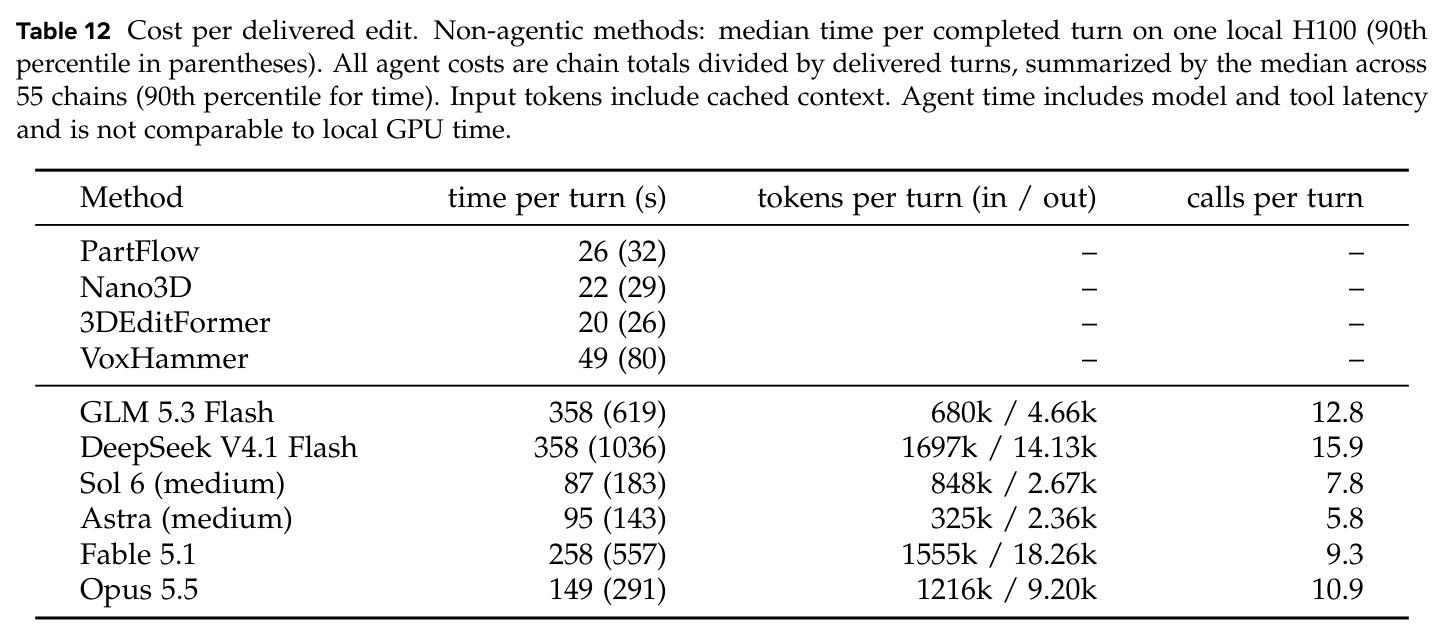
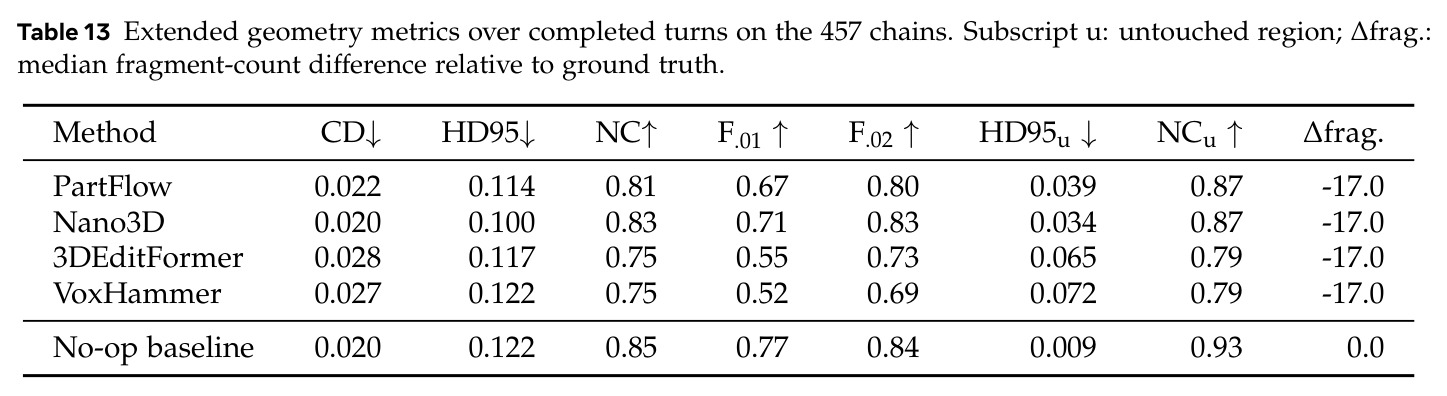
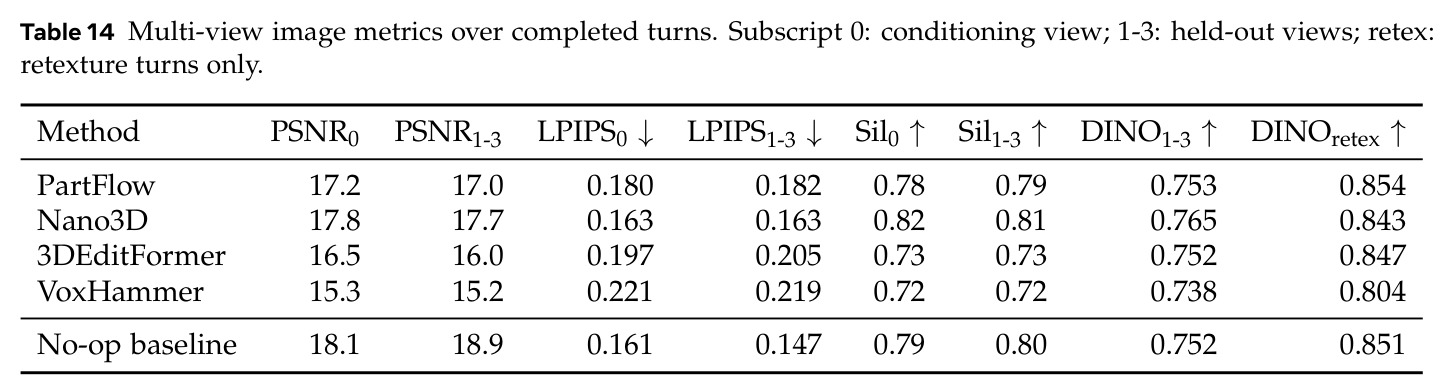
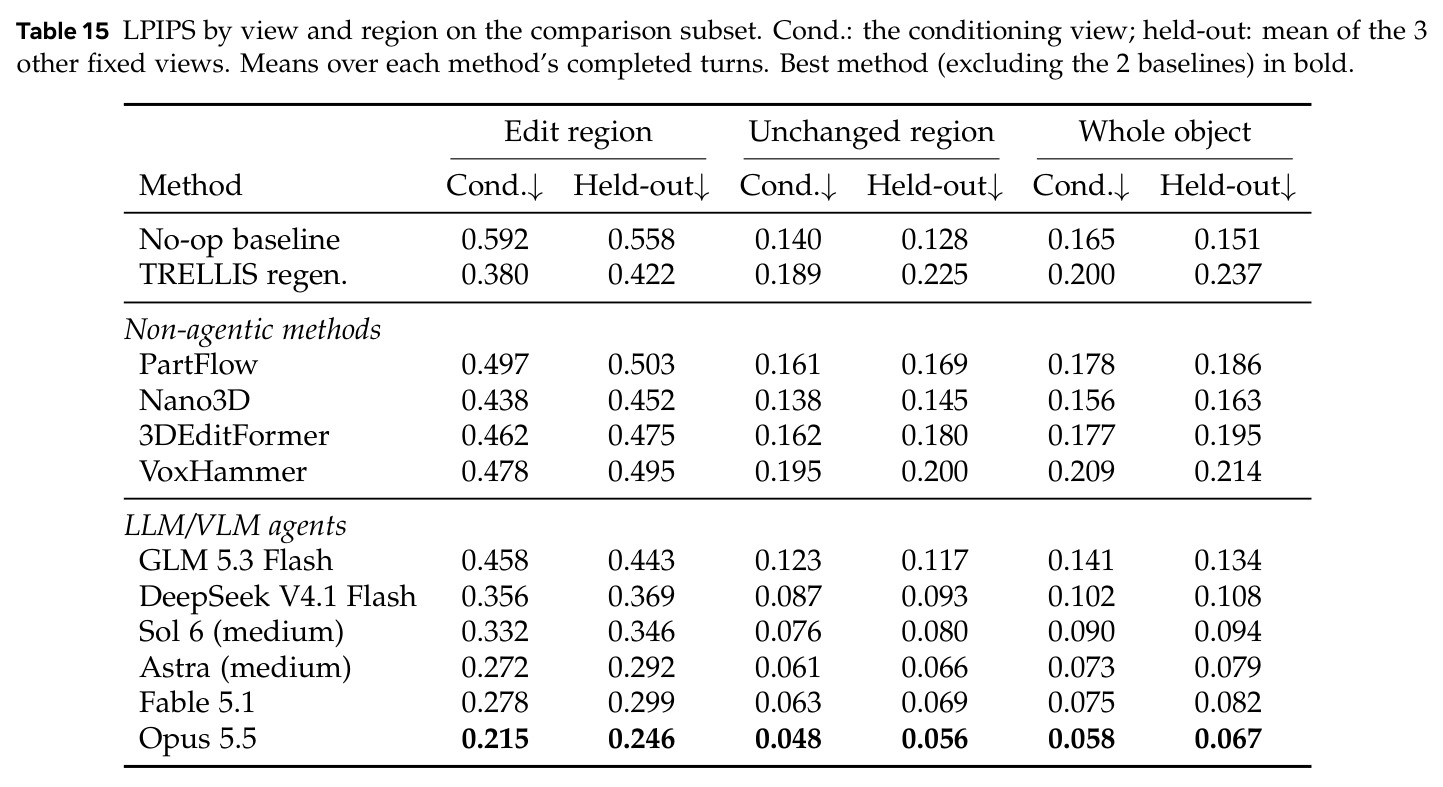
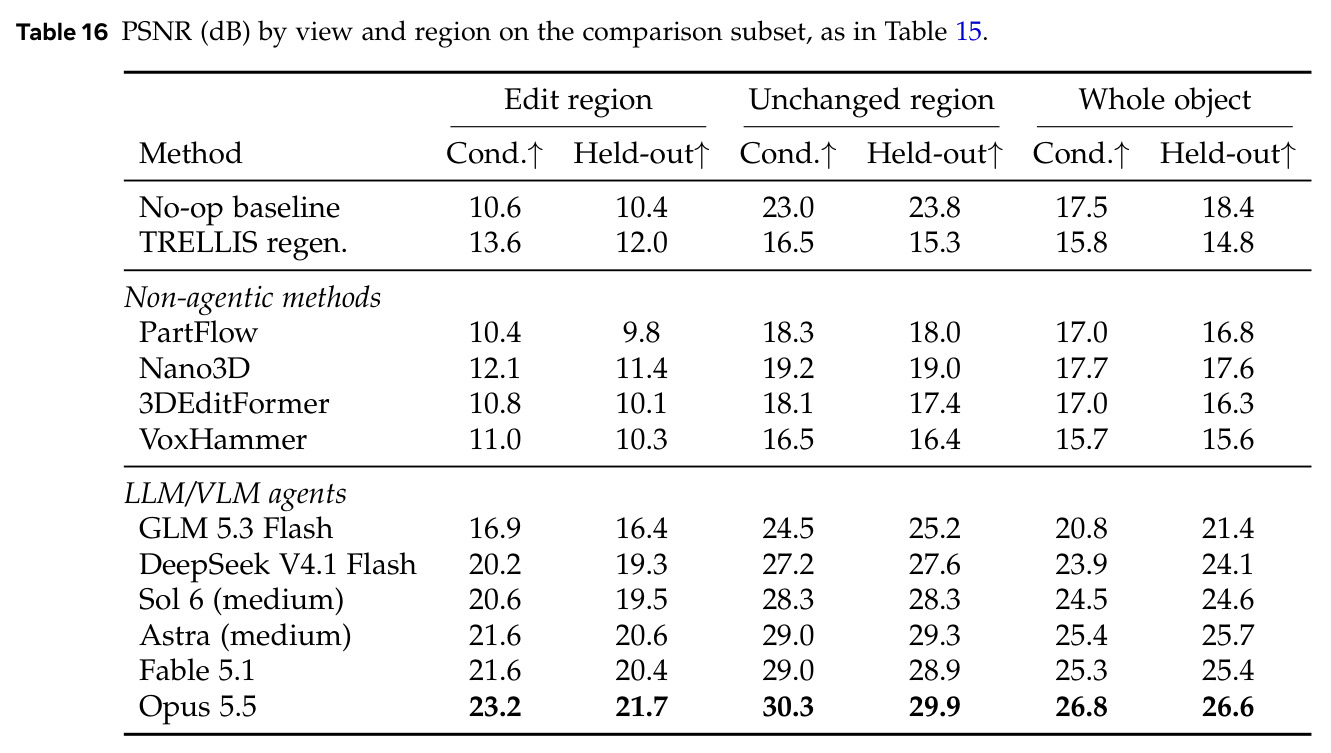
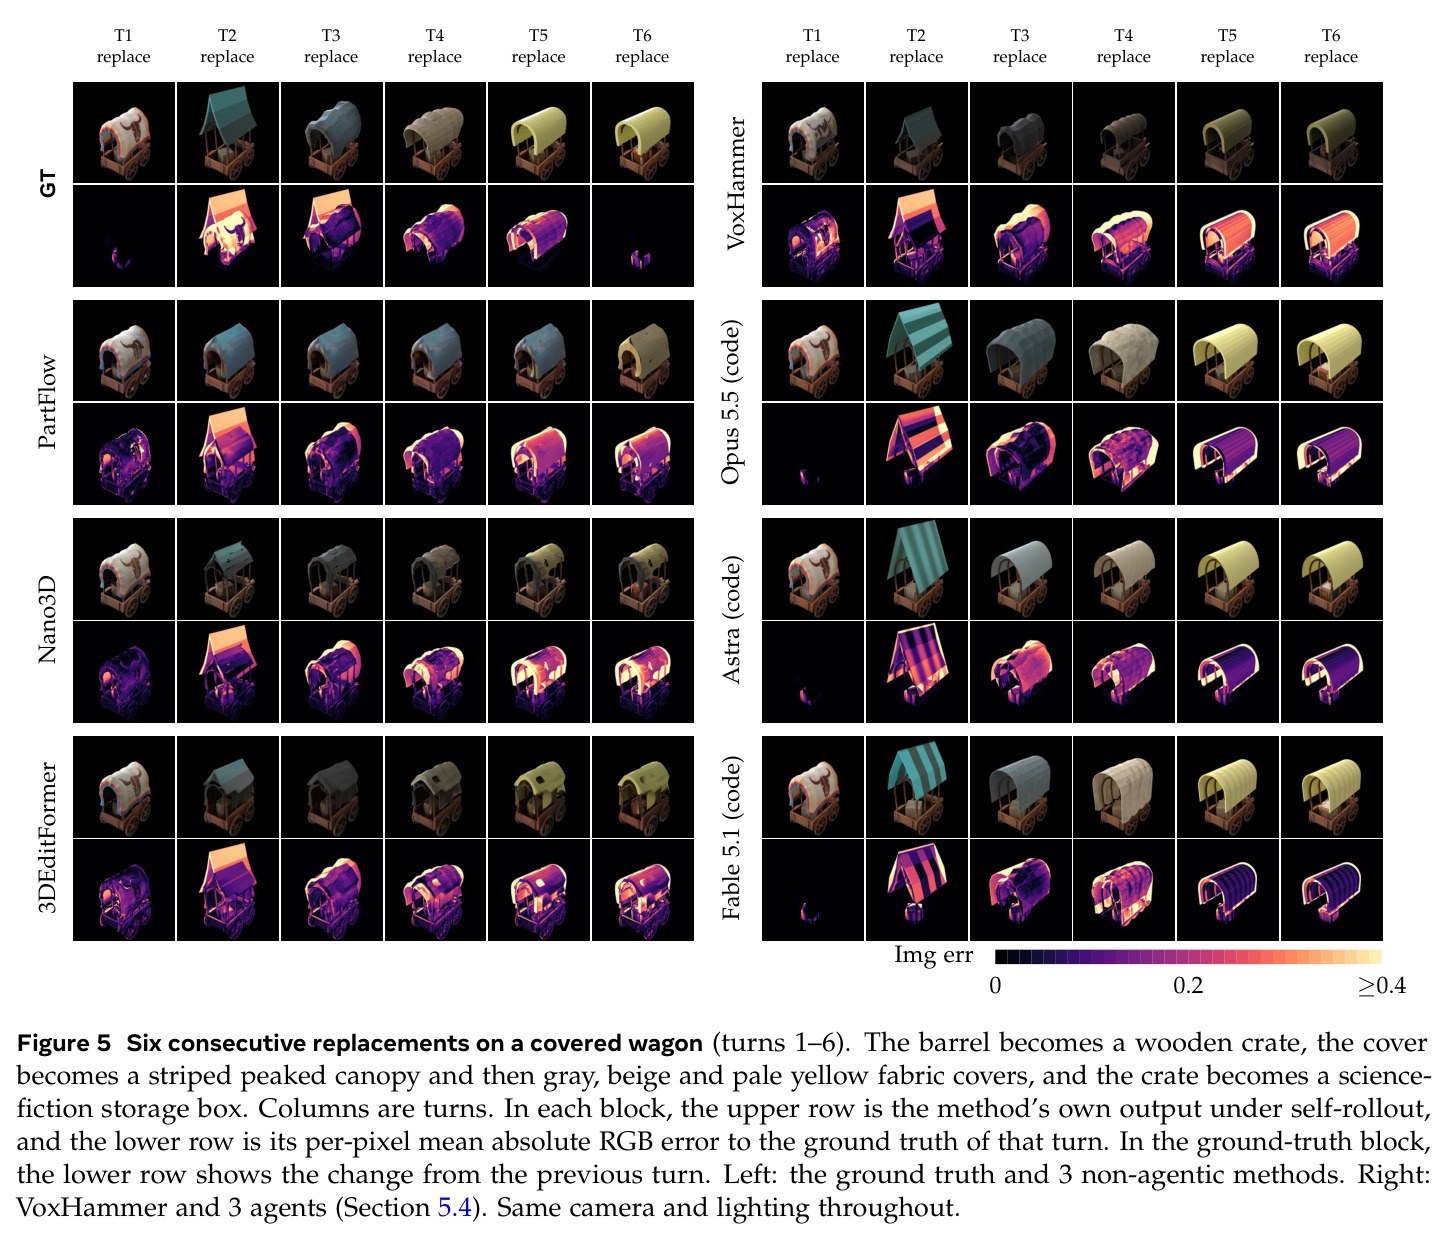
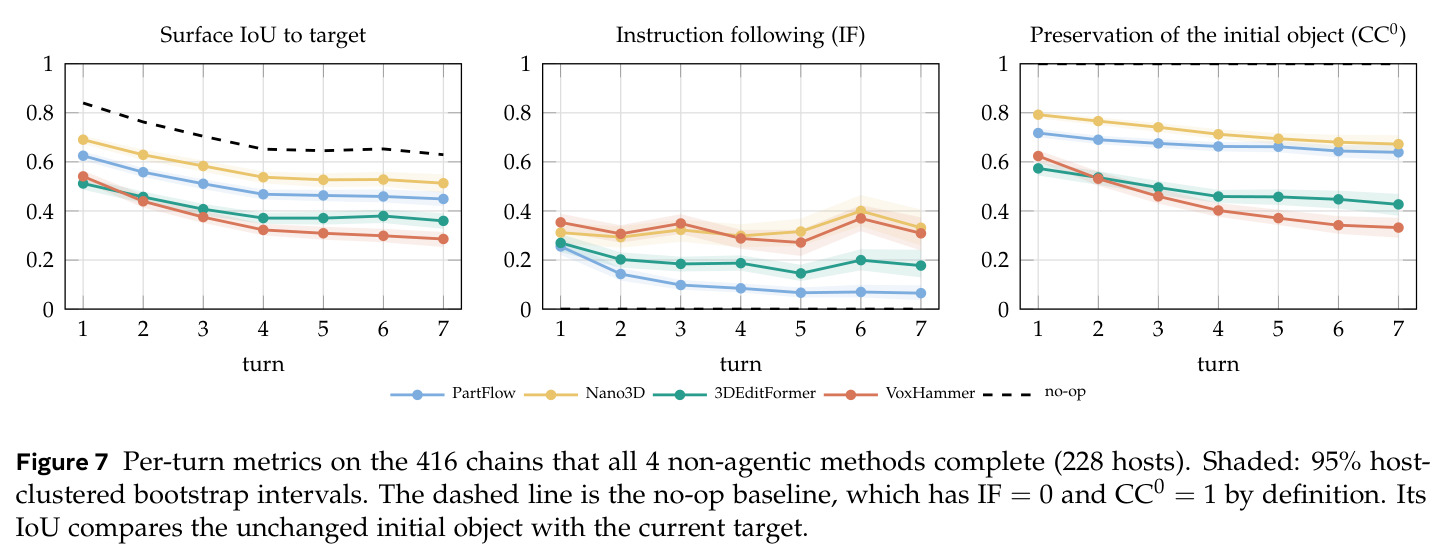
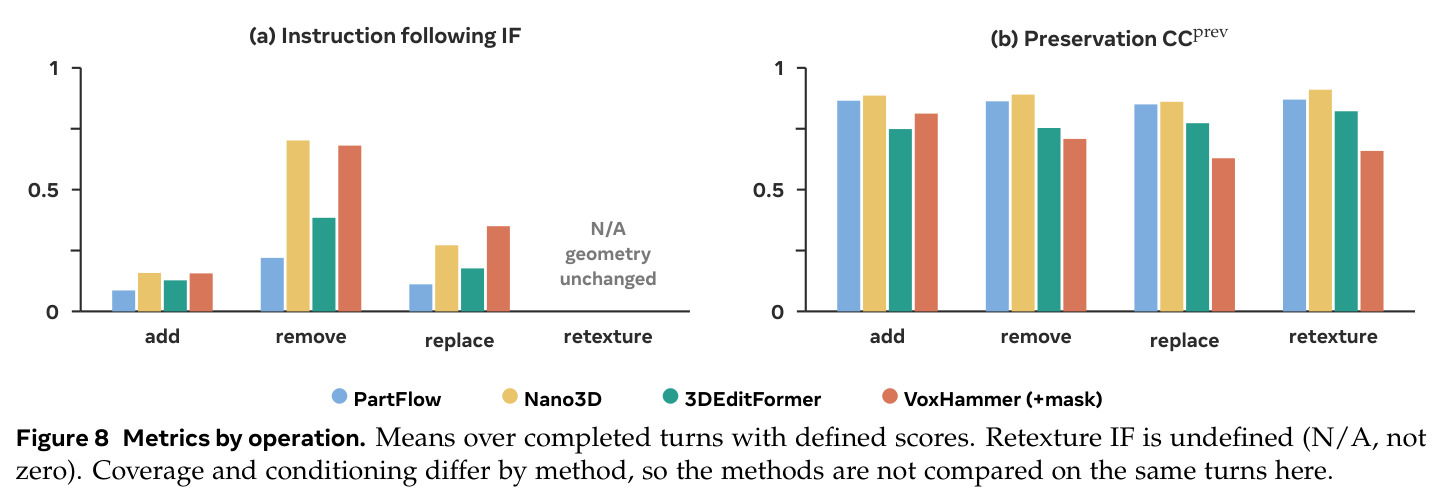
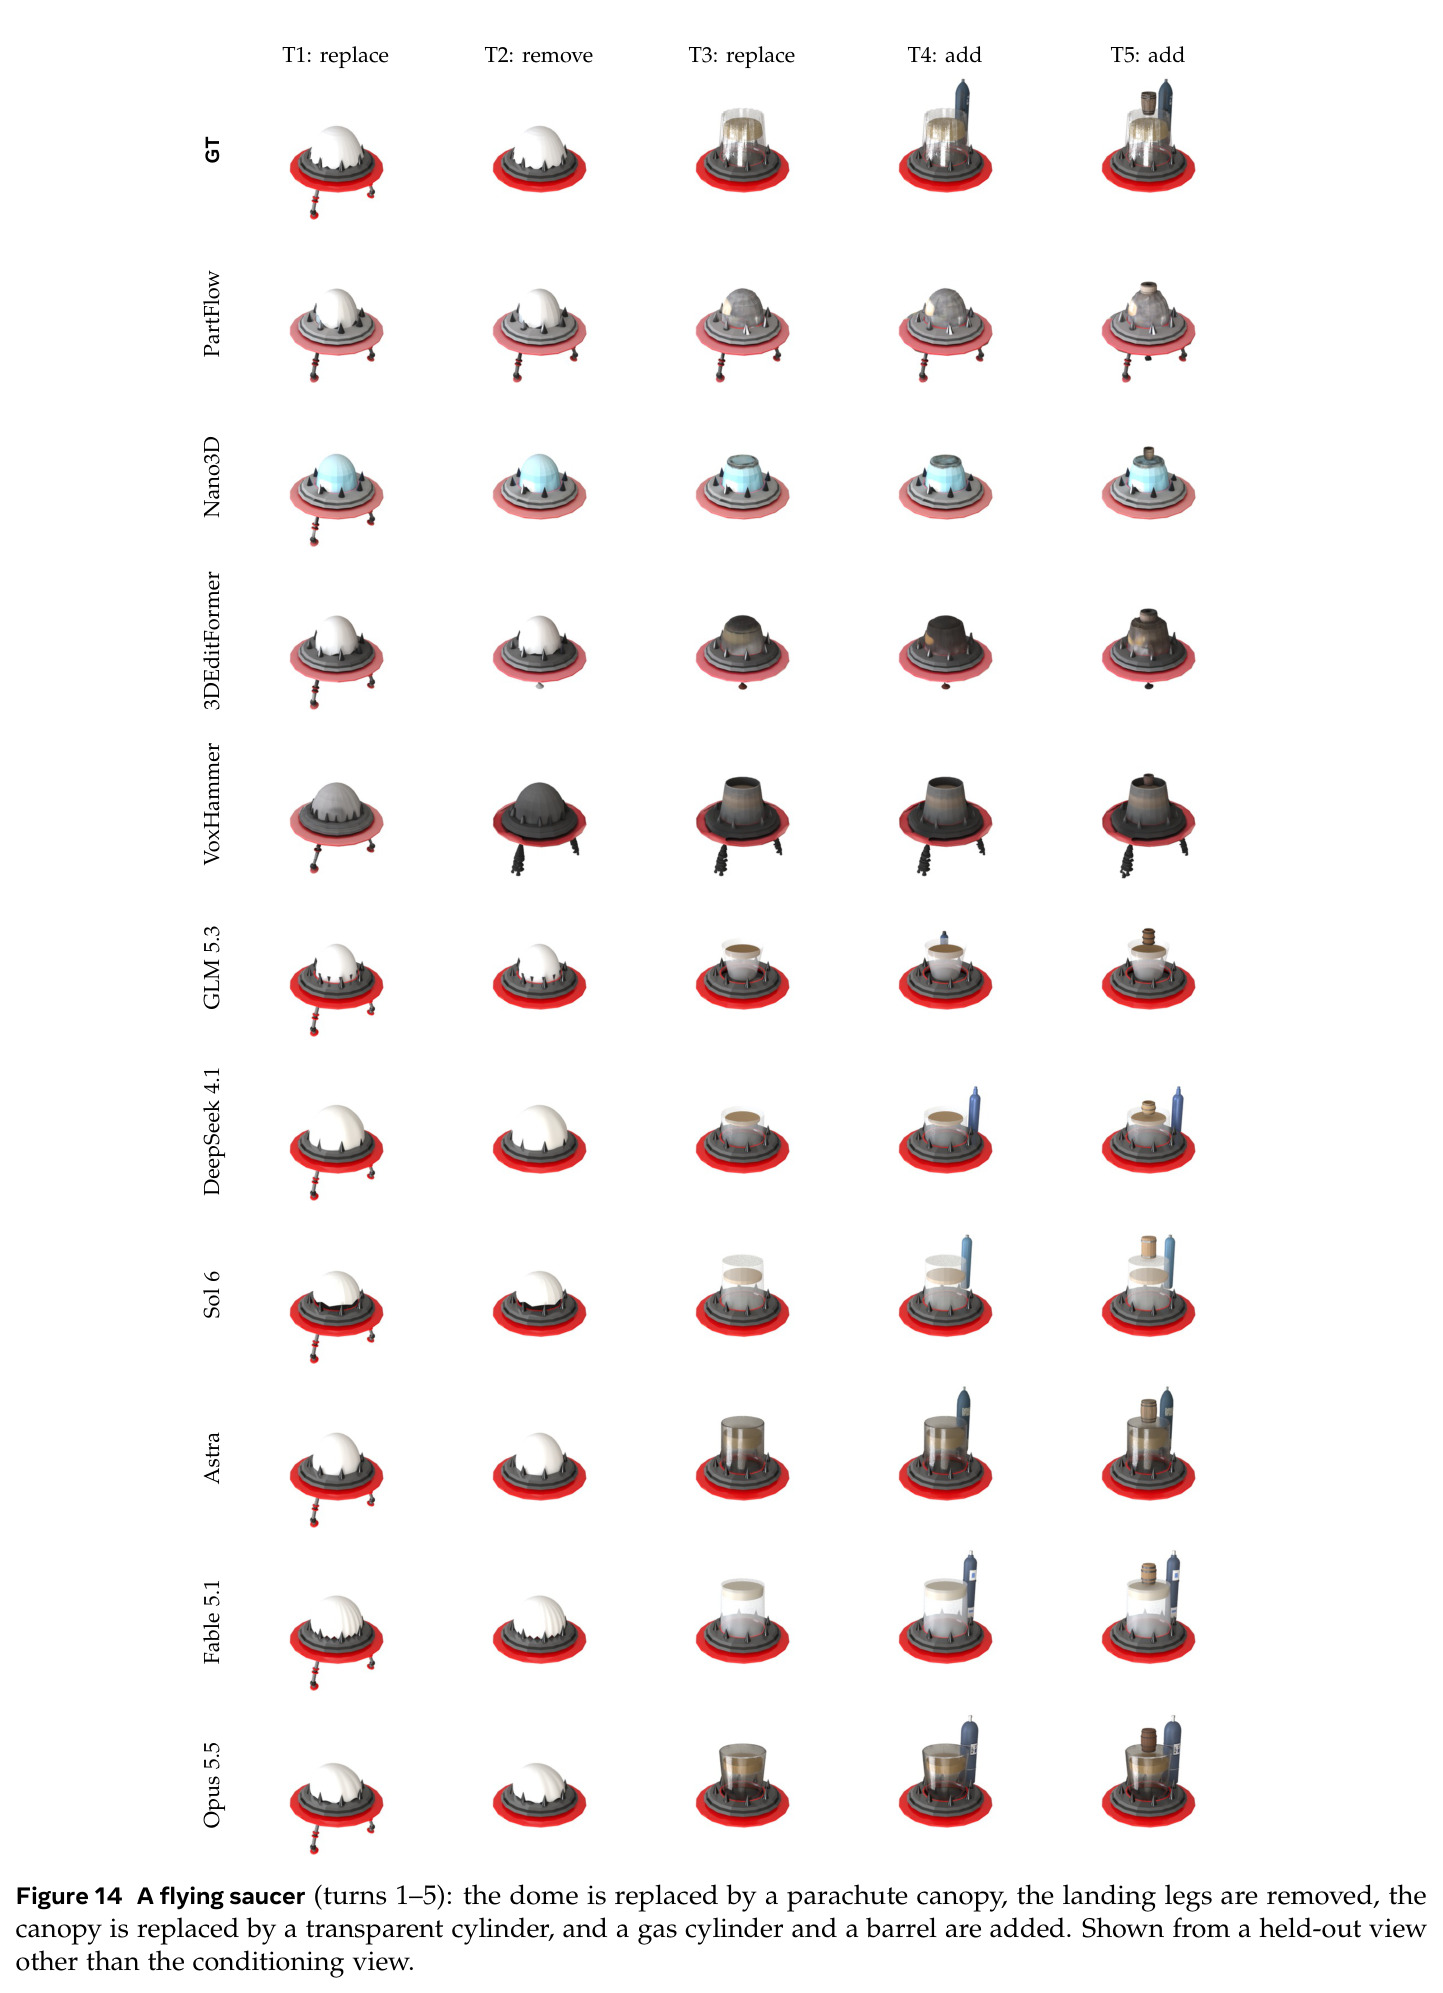
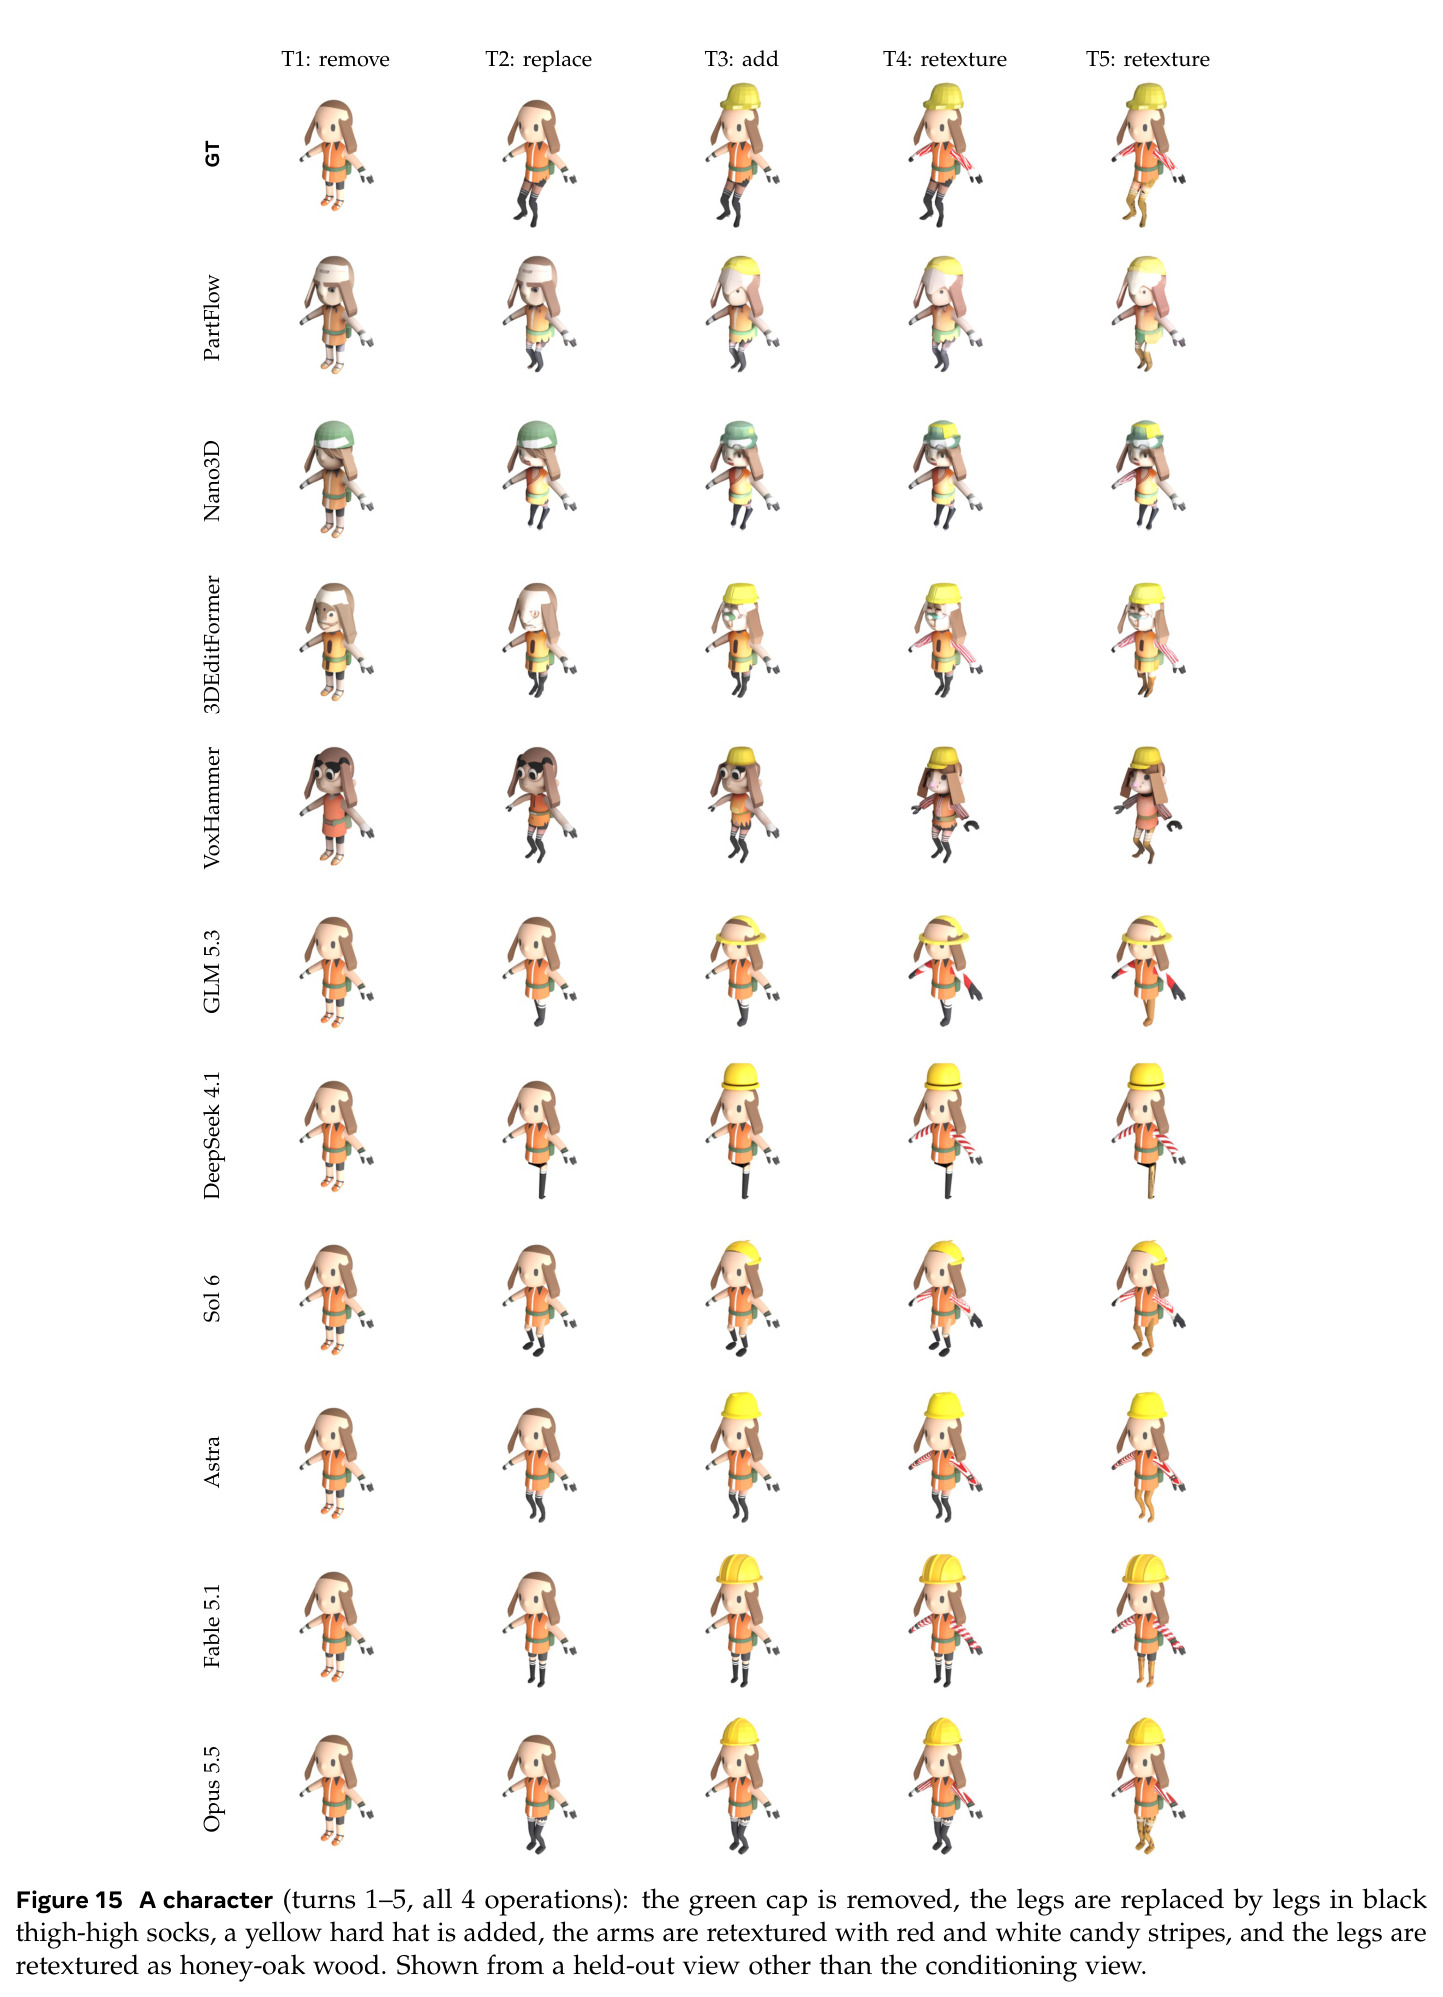
五个核心发现。其一,整体指标奖励不作为:全物体 F-score、LPIPS、PSNR 上 no-op 基线(每轮返回初始物体)胜过全部 4 个非智能体方法(PSNR 18.7 对 15.2–17.7),只有编辑区指标有区分力——编辑区 LPIPS 各方法 0.474–0.521 优于 no-op 的 0.569。其二,非智能体方法从第一轮就漏执行:IF 全程仅 0.12–0.32,第 1 轮即只有 0.24–0.36;Nano3D 最均衡(IF 0.31、CCprev 0.89、编辑区 LPIPS 0.474),VoxHammer IF 0.32 但 CCprev 仅 0.71,还在 39 条链上输出空稀疏结构;TRELLIS 重生成基线 IF 最高 0.50 但 CCprev 仅 0.38。其三,误差累积且主要是继承:第 1→7 轮 CC0 从 0.60–0.78 跌至 0.33–0.67;重置诊断显示改喂真值输入后第 5 轮 IoU Nano3D 0.68(自滚动 0.52)、3DEditFormer 0.46(自滚动 0.36)。其四,智能体显著更强:55 链(416 轮)子集上 6 个 LLM 的 CCprev 全部 0.95–0.98(非智能体最高 0.90),除 GLM 5.3 Flash 外 IF 均更高,Opus 5.5 达 IF 0.62、编辑区 LPIPS 0.238、全物体 LPIPS 0.065(no-op 0.154)、PSNR 26.6 dB;删除最易(IF 0.88–0.99),添加/替换最难(0.10–0.49 / 0.17–0.52)。其五,代价是速度:LLM 每次编辑需 1.5–6 分钟、6–16 次调用(Opus 5.5 中位 149 秒),非智能体在单张 H100 上仅 20–50 秒。材质上非智能体方法误差蔓延全物,Nano3D 对重绘区域只产生 0.31 倍真值变化,几乎等于没编辑。
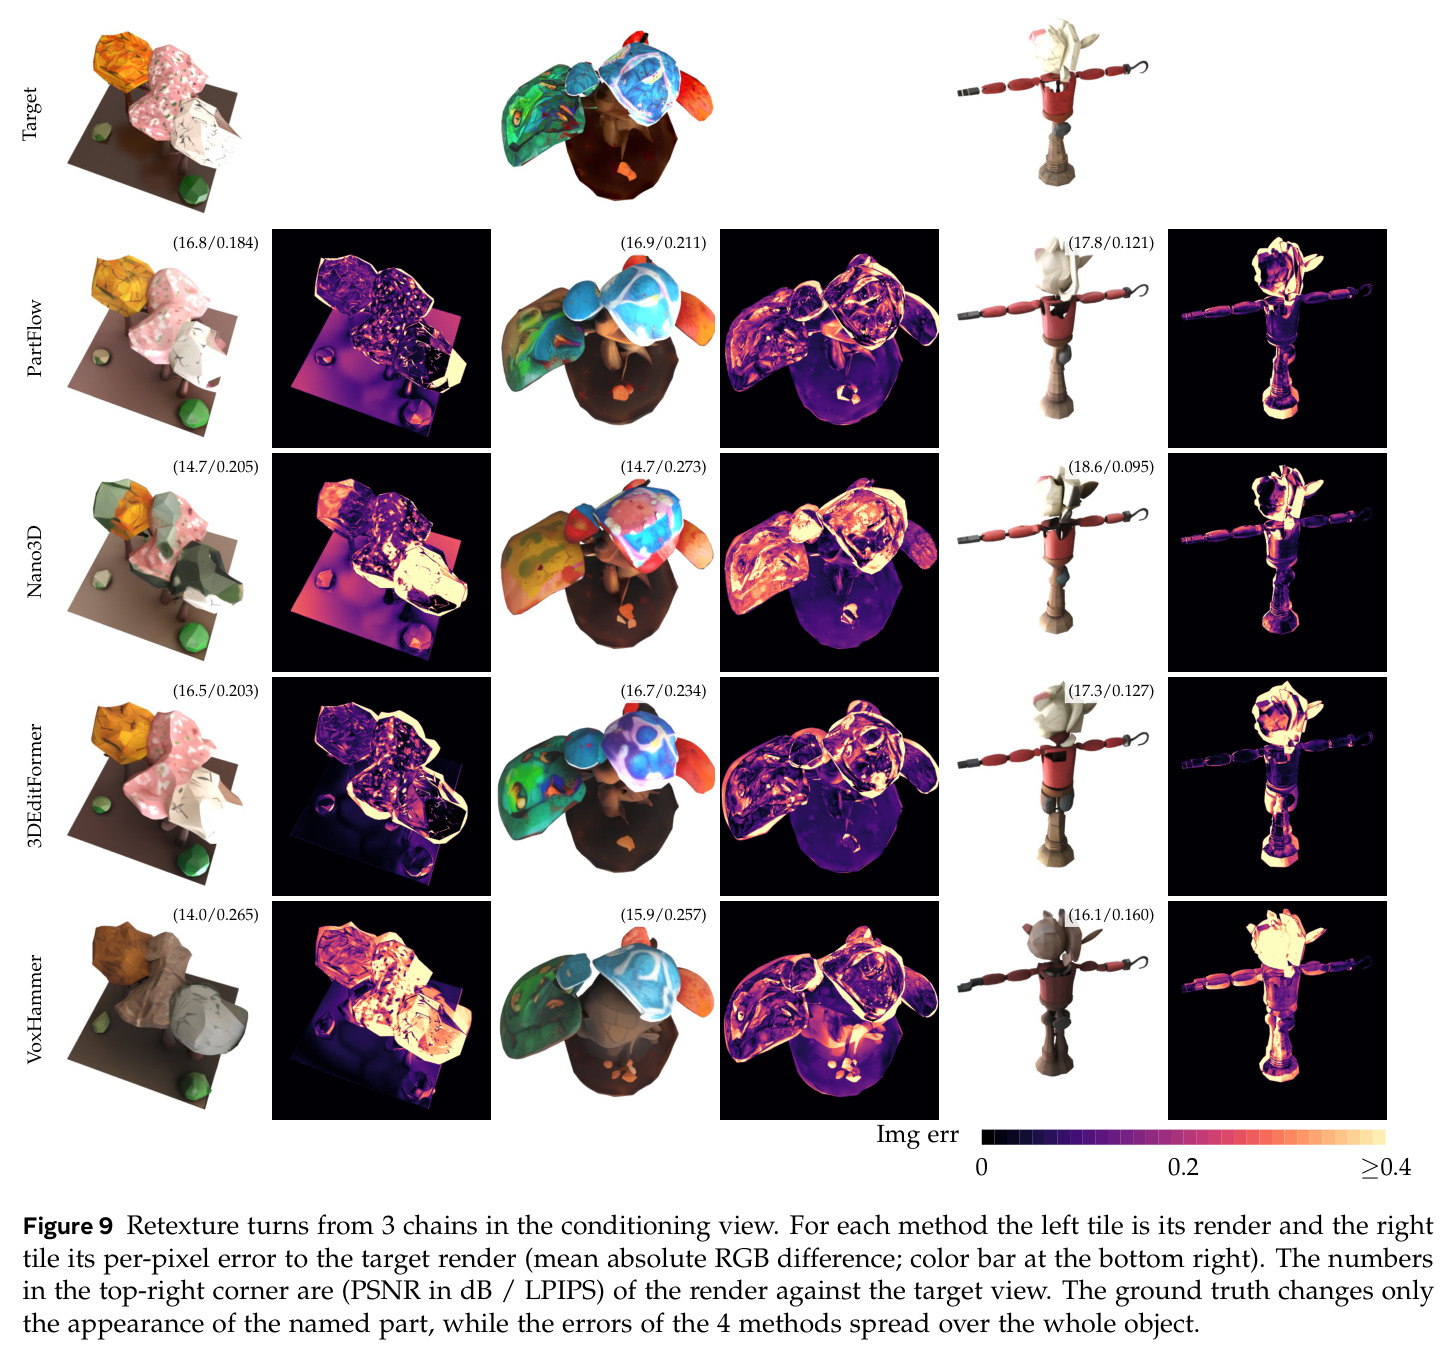
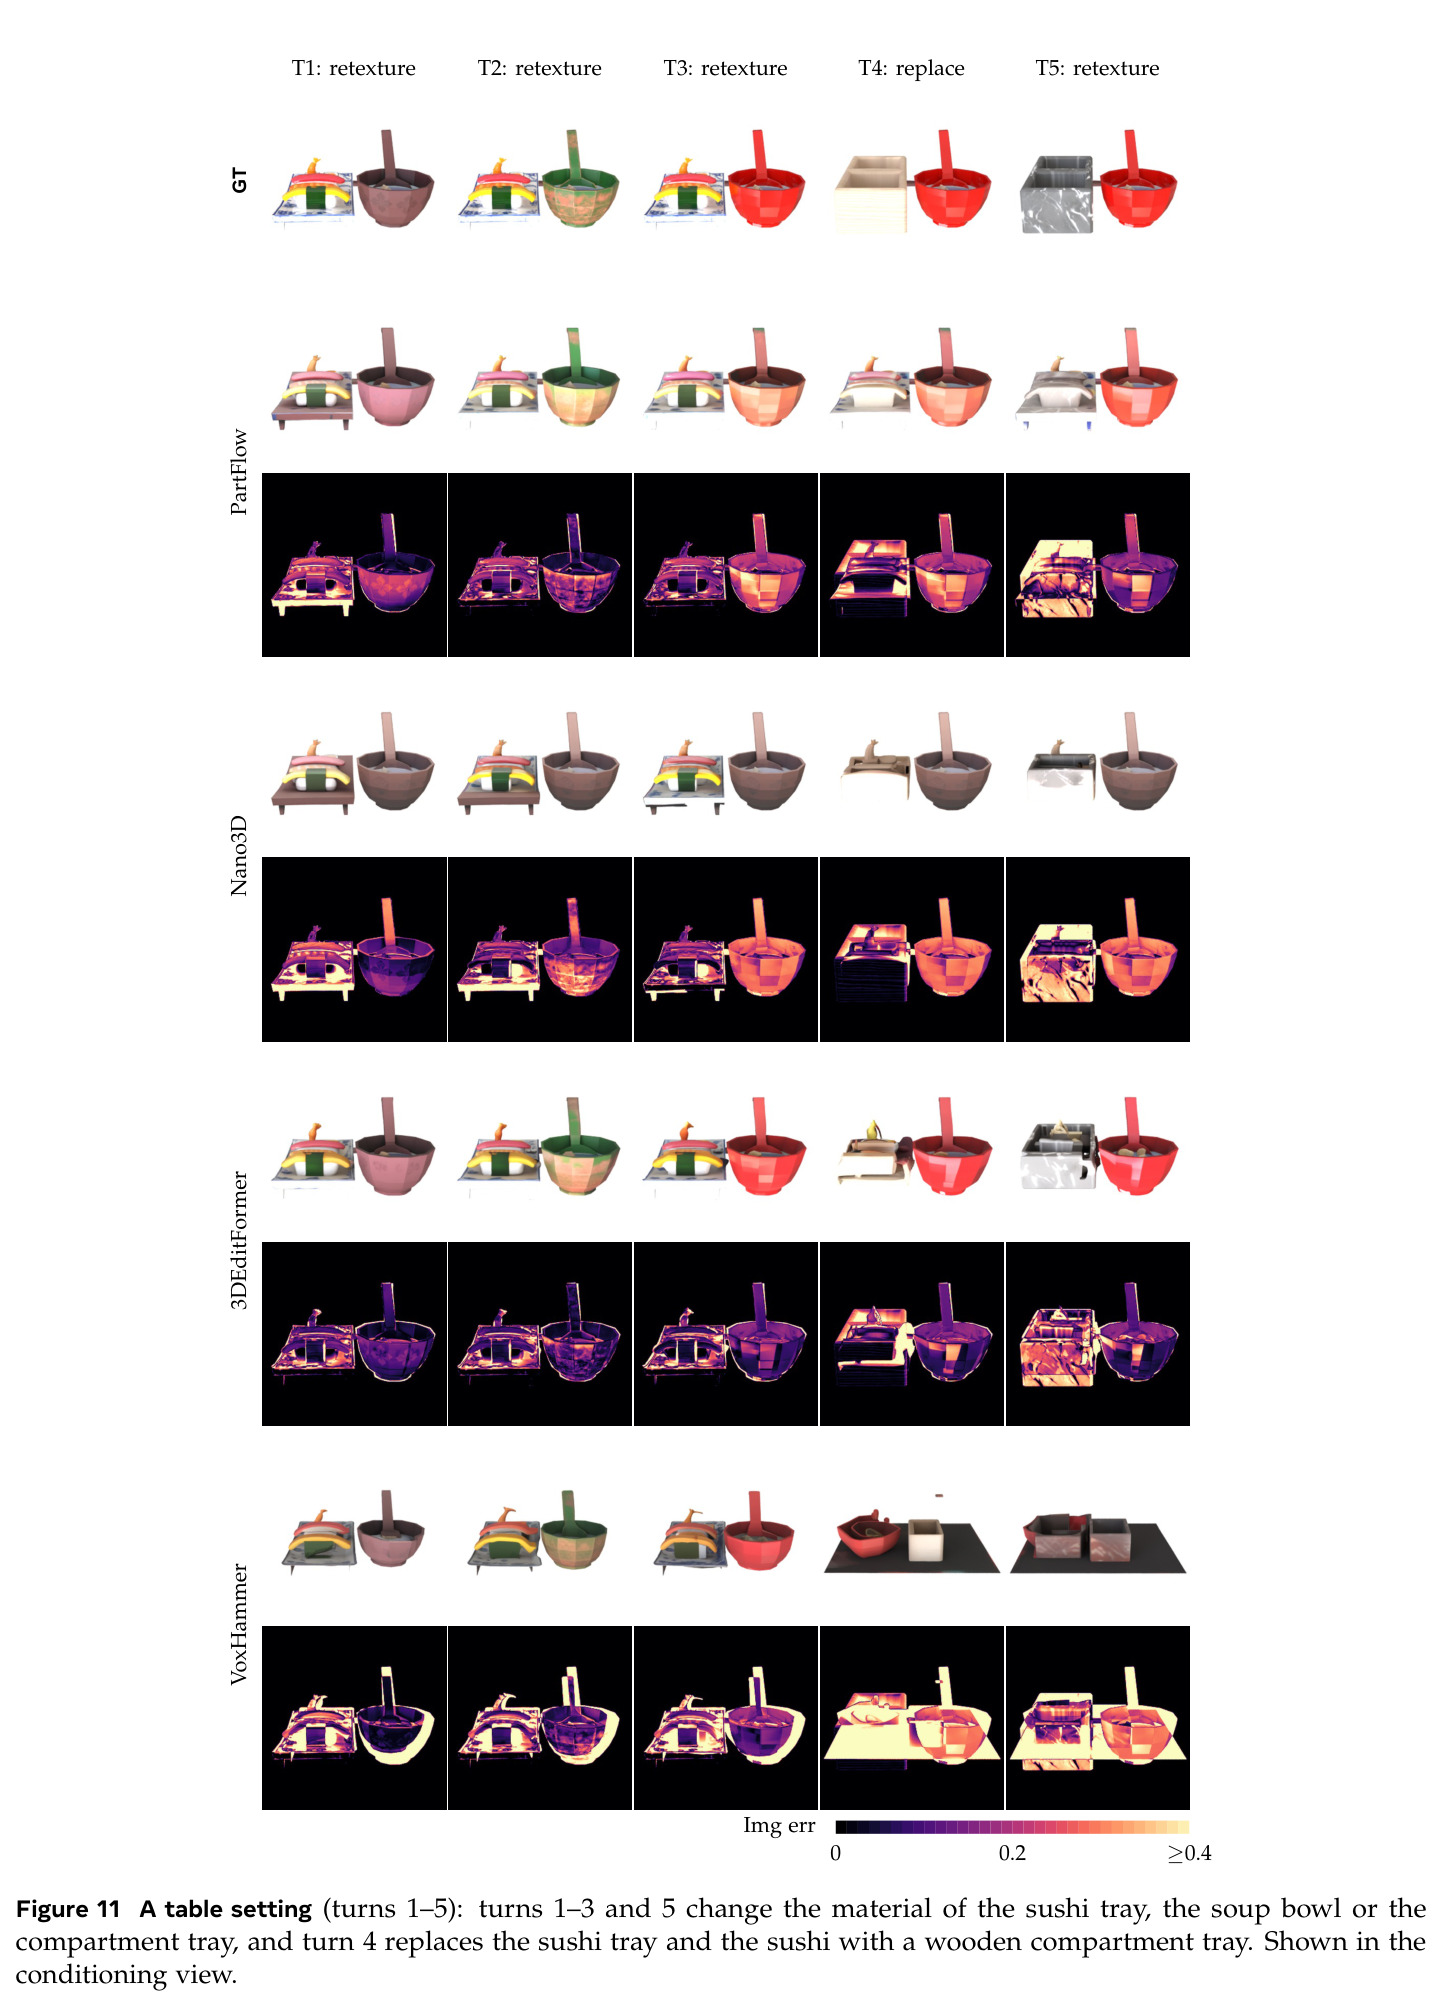
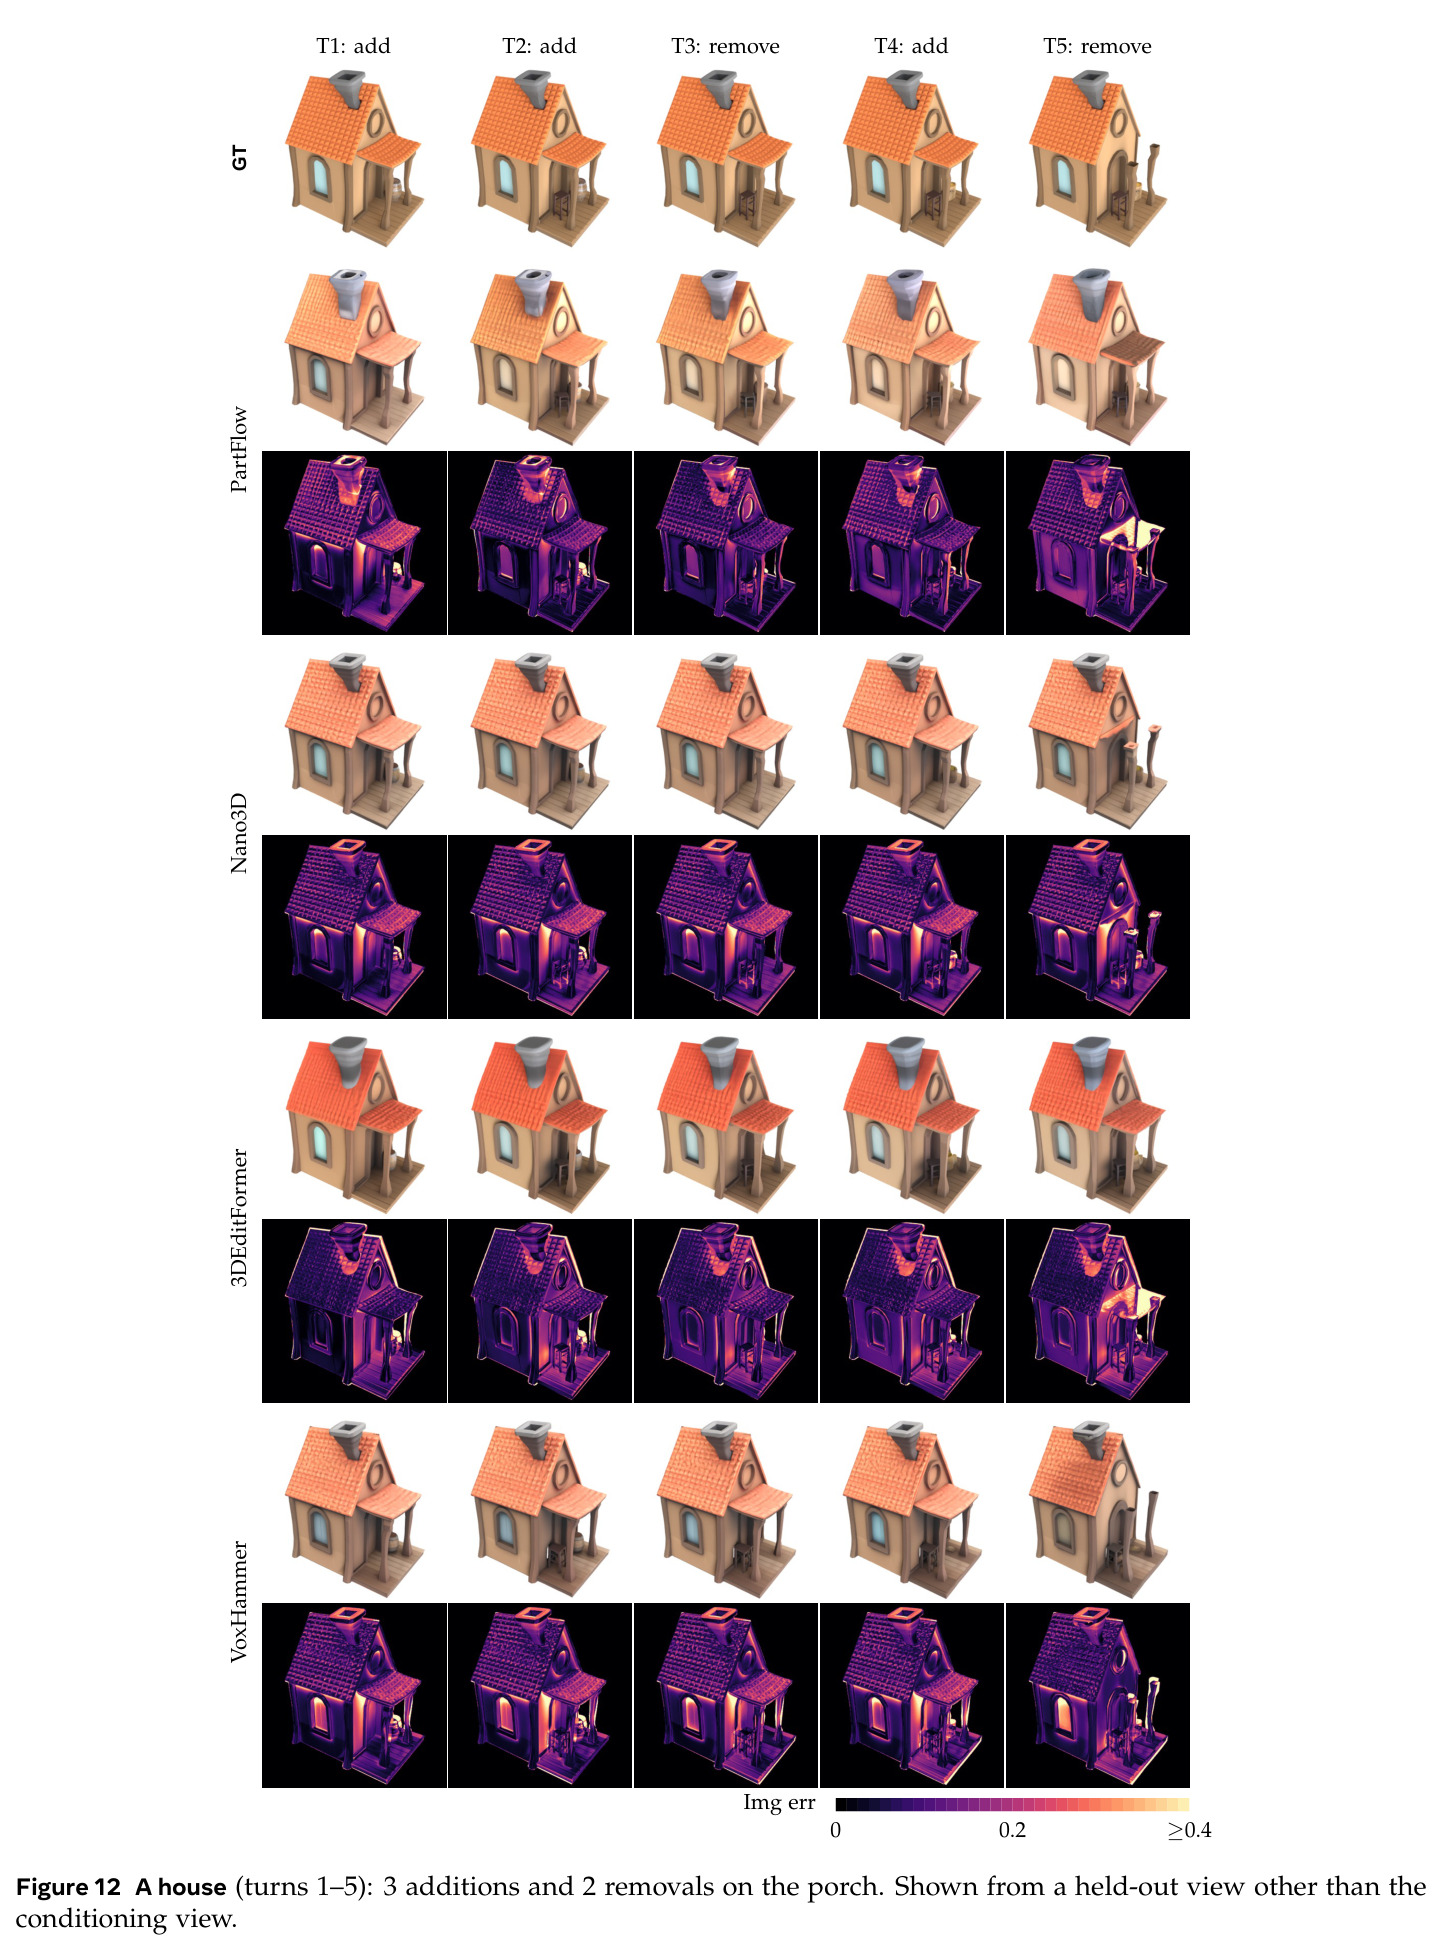
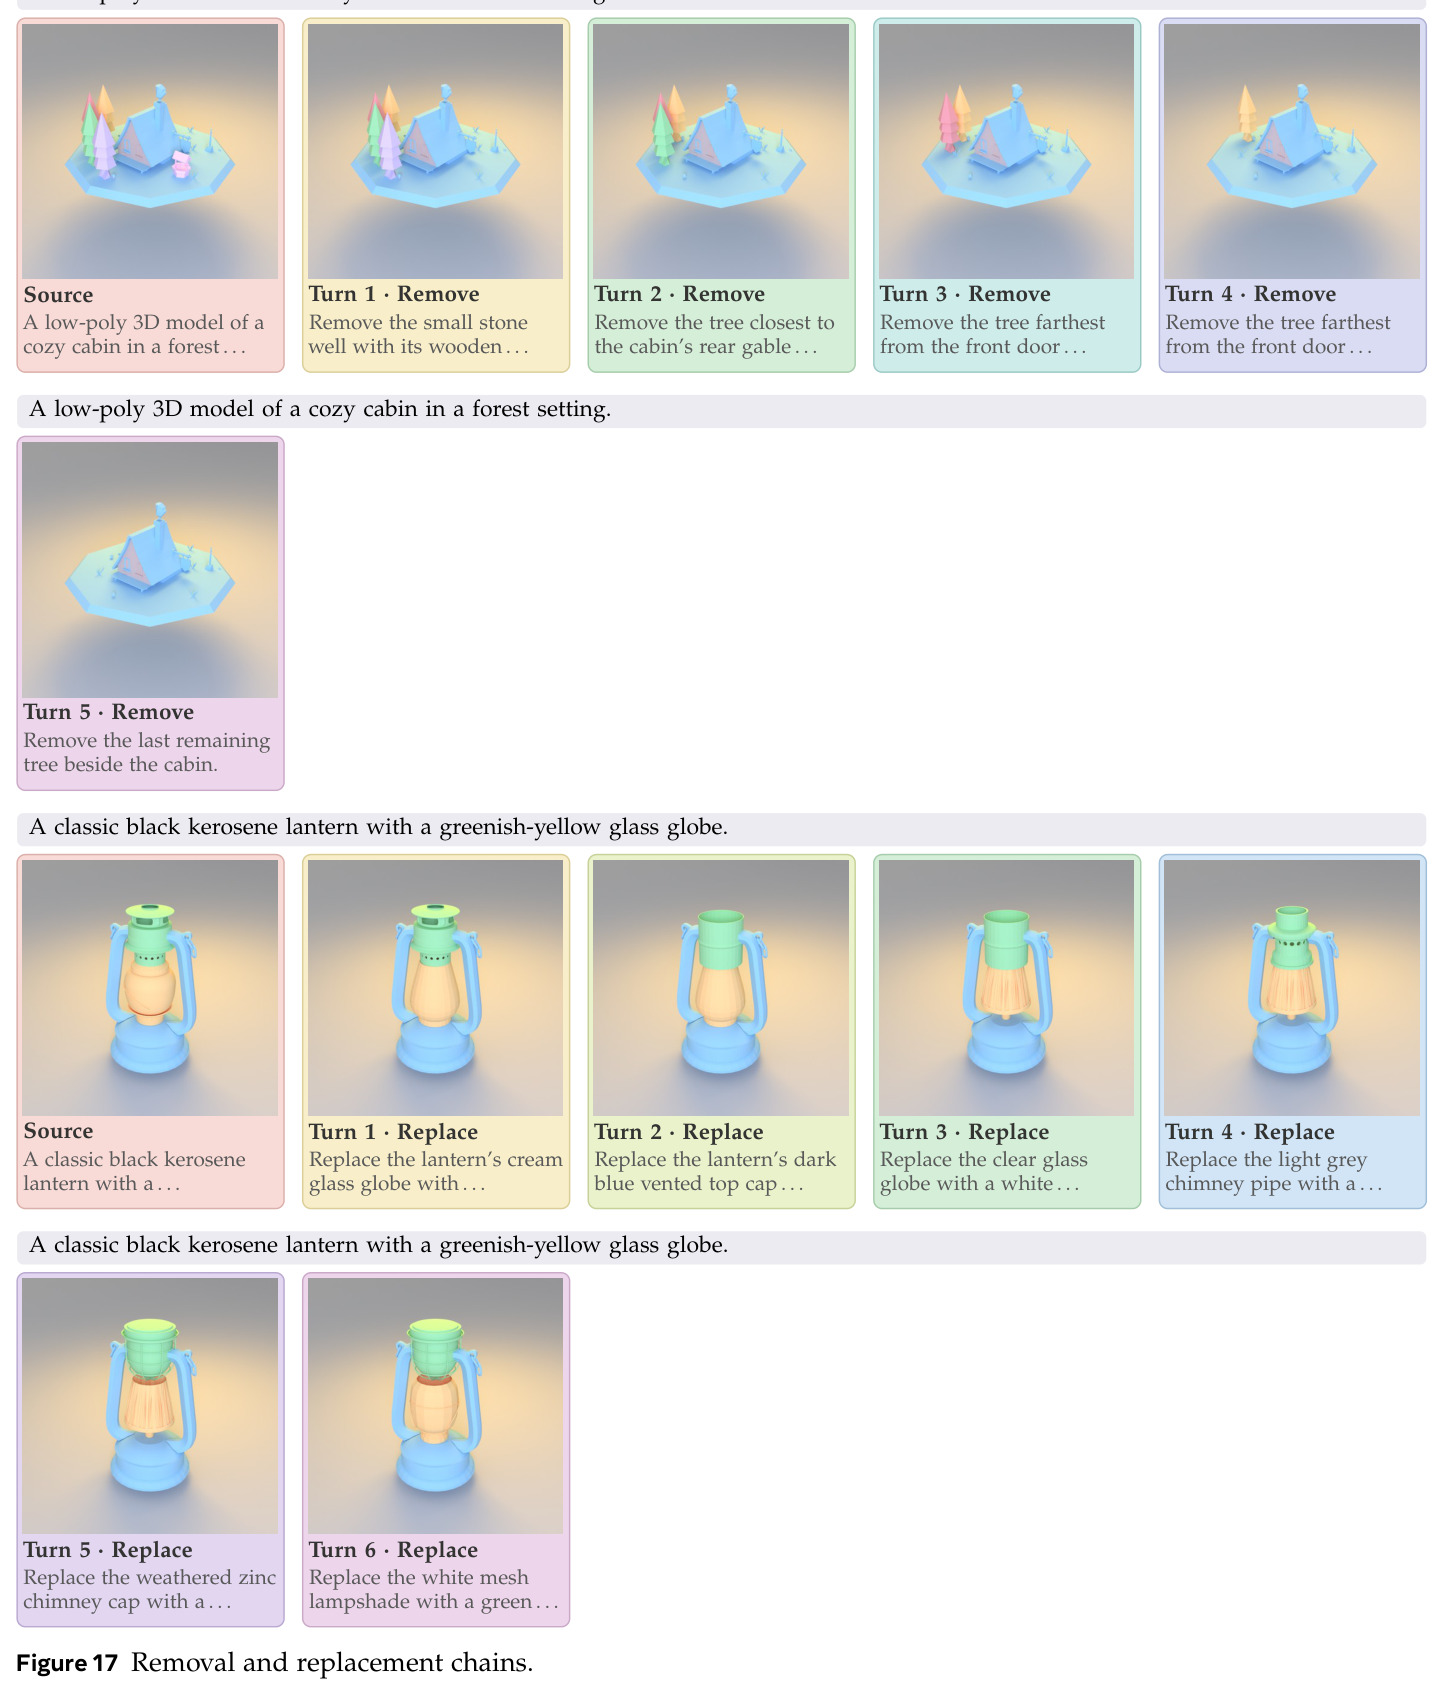
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长时程部件级编辑·指令跟随(55 链对比子集) | IF ↑ | Opus 5.5:0.62 | 最强非智能体 VoxHammer:0.36;no-op 基线:0.00 | +0.26(相对最强非智能体约 72% 提升) |
| 非编辑区内容保持(55 链) | CCprev(IoU)↑ | Astra / Fable 5.1 / Opus 5.5:0.98 | 最强非智能体 Nano3D:0.90;TRELLIS 重生成:0.35 | +0.08,且 6 个 LLM 全部 ≥0.95 |
| 编辑区外观相似度(55 链) | LPIPS ↓ | Opus 5.5:0.238 | 最强非智能体 Nano3D:0.448 | 降低 0.210(约 47%) |
| 全物体图像保真(55 链) | LPIPS ↓ / PSNR ↑ | Opus 5.5:0.065 / 26.6 dB | no-op 基线 0.154 / 18.2 dB;Nano3D 0.161 / 17.6 dB | 对 no-op:LPIPS 降约 58%、PSNR 升 8.4 dB——唯一整体超过 no-op 的方法族 |
| 编辑区几何(457 链主评测) | F-score(τ=0.01)↑ | 最强非智能体 Nano3D:0.56 | no-op 基线:0.56 | 基本持平——说明整体几何指标无法反映真实编辑能力,必须拆区域 |
| 单次编辑耗时 | 中位时间 | 非智能体 Nano3D:22 s(单张 H100) | 最强智能体 Opus 5.5:149 s、10.9 次模型调用 | 智能体慢约 7 倍,交互性是其当前短板 |
局限与改进
作者承认的局限:代码构建新几何仍然困难(add/replace 的 IF 明显低于 remove 的 0.88–0.99),智能体单次编辑要数分钟,达不到交互速度;作者明确把『能否找到既快又准的智能体与传统方法结合』留作开放问题。我自己的观察:第一,程序化拼装的目标多为低多边形、积木式风格资产,部件库语义有限,结论外推到高精度扫描或有机形态(雕塑、角色面部)未必成立;第二,智能体在评测中能看到每轮目标渲染图,这比真实 vibe coding(只有用户描述、无目标图)条件更强,可能高估了智能体的实用性;第三,非智能体方法全部来自 TRELLIS 潜变量生态,未覆盖网格 token 自回归、3D Gaussian 编辑等其他表示族;第四,材质评估较薄——IF 对 retexture 无定义,changed-pixel 诊断区域比部件区域更窄,且 Nano3D 因无材质模式被改路由到 replace,其材质表现解释需谨慎;第五,闭源商业模型(Opus、Sol、Astra、Fable 等)版本会漂移,结果难以长期复现;第六,55 链智能体对比子集是人工挑选的『编辑清晰可见』链,可能对双方都偏乐观。
独立分析的弱点
独立分析的弱点与改进方向。弱点一:智能体延迟高(每次 1.5–6 分钟、输入 token 数十万)——可蒸馏为小模型或限制推理预算、只对被改槽位做增量渲染比对、更激进地缓存跨轮上下文。弱点二:代码从图元搭建新部件,尺寸形状常偏离目标(Figure 5 中三个 LLM 的车篷仍偏简单)——可配程序化部件原语库或确定性网格查询接口,保留『只改指定部件』的构造性保证同时提升几何丰富度。弱点三:基准目标风格单一(积木/低多边形),对 artist-grade 高模资产未验证——应扩充有机形态部件与更深部件层级。弱点四:智能体比真实 vibe coding 多看到目标图,评测条件偏强——应增设纯文本条件组。弱点五:IF 在 retexture 上未定义,材质只有 changed-pixel 近似——可引入材质/纹理嵌入或 BRDF 参数误差等感知指标。弱点六:非智能体样本窄(4 个 TRELLIS 系方法),缺 mesh-token 自回归或 Gaussian 编辑的对照。弱点七:VoxHammer 有 39 链空输出失败,长链下的鲁棒性问题在原单轮评测中不可见,提示未来方法应报告失败率与断链行为。
未来方向
作者提出的方向:发布数据合成引擎与全部编辑链以支持可靠的迭代 3D 编辑研究;探索智能体与传统生成方法的混合,以期兼得速度与精度。基于本文成果可延伸:其一,把自滚动误差纳入训练——用类似 DAgger 的策略在模型自身状态上微调或做序列级强化学习,专治误差继承(重置诊断已证明它是主要损失来源);其二,让智能体维护结构化编辑日志(与引擎 JSON 同构)作为跨轮记忆,使 add/remove 依赖(如先拆附件再换支撑件)可验证、可回滚;其三,混合架构:LLM 负责规划与部件定位,局部生成器负责该部件的高质量填充,兼取两派之长;其四,把基准扩展到场景级、铰接资产并引入物理合理性约束;其五,在无目标图的纯文本 vibe modeling 设定下重测,并加入用户在环的主观评价;其六,研究重复编辑下的伪影累积理论,与 2D 图像域反复编辑的复制-退化现象相呼应。
复现评估
复现评估:作者承诺发布数据合成引擎与全部编辑链(项目页 alaya-lab.github.io/EditHero,代码 github.com/AlayaLab/EditHero),智能体共享提示与 img2threejs v2.0.0 适配也将随基准放出。数据方面,457 条链、2755 次编辑、252 个宿主与部件库规模适中,评测协议(坐标框架、4 固定相机、$64^3$ 体素化、$\tau=0.01$、IF 最小 8 体素等常数)在附录写得非常具体,对复现友好。算力方面,非智能体方法用官方代码与权重在单张 H100 上即可复现(每编辑 20–50 秒,2755 轮约数十 GPU 小时);智能体部分依赖商业 API(Opus 5.5、Fable 5.1 走 Claude Code,Sol 6/Astra 为 Codex 子代理,GLM/DeepSeek 走 OpenRouter),单链预算约 3 小时、每编辑输入 token 数十万,成本不低且闭源模型版本迭代会改变结论。基准构建需人工审核(每轮多视角渲染检查与指令改写),重建整个数据引擎工程量中等偏大。总体:非智能体对比易复现,评测协议完整,智能体对比受 API 与模型版本制约,建议锁定版本后复跑。
论文图表
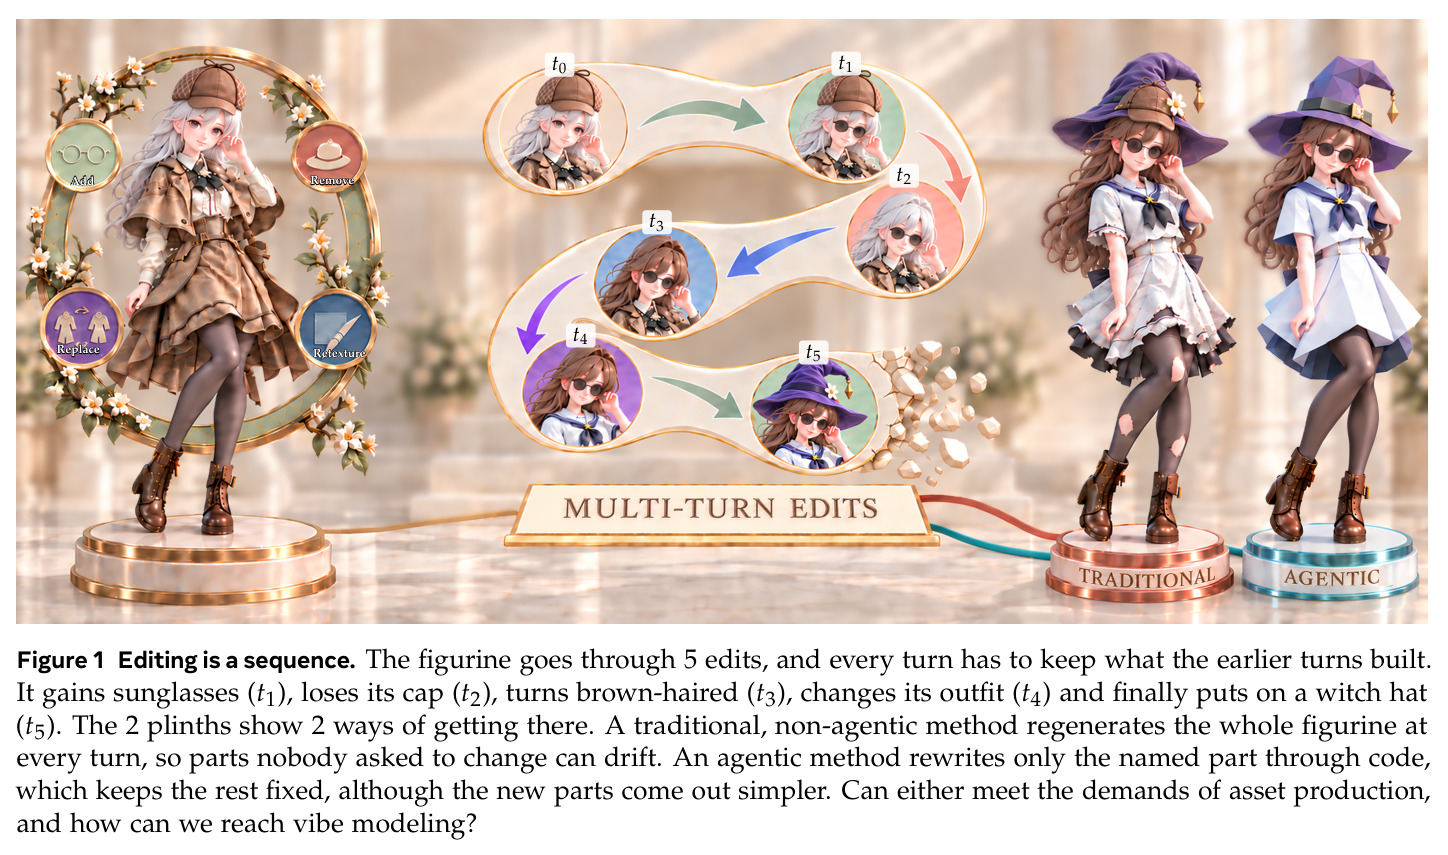
题图:一个手办经过 5 轮编辑(加墨镜 t1、摘帽 t2、变棕发 t3、换装 t4、戴巫师帽 t5),两侧基座对比两种实现路径——传统非智能体方法每轮整体再生成导致无人要求的部分漂移,智能体方法通过代码只改被点名的部件、其余保持不变但新部件更简单。
一眼看清论文的问题设定(编辑是序列)、两类对比范式及其各自缺陷,是理解全文动机的最佳入口。