InterEvolve:面向人形机器人移动操作的奖励程序测试时进化 InterEvolve: Test-Time Evolution of Reward Programs for Humanoid Loco-Manipulation
冻结人形控制器,用LLM在测试时进化分阶段奖励程序,零训练解锁新移动操作技能
前置知识
Forward-Backward(FB)表征与行为基础模型
FB 表征把策略的折扣未来状态占用分解为前向映射 $F(s,a,z)$ 与后向映射 $B(s')$ 的乘积:$M_z^\pi(ds'|s,a)\approx F(s,a,z)^\top B(s')\rho(ds')$。任意奖励 $r$ 只需对参考分布求期望得提示 $e_z^r=\mathbb{E}_\rho[r(s')B(s')]$,作为潜变量 $z$ 输入同一个策略,即可零样本地执行新奖励而无需重训练。BFM-Zero 等人形行为基础模型即基于此构建。
本文的电机模型就是一个对象感知的 FB 模型,奖励程序全靠“奖励→潜变量提示”这条通路执行;不懂 FB 就无法理解为何换奖励不用重训练,也读不懂 Eq. 1 的提示推断。
CMA-ES(协方差矩阵自适应进化策略)
一种无梯度黑盒优化算法,通过维护并自适应更新候选参数分布的均值与协方差矩阵,在连续参数空间高效搜索。本文内循环用它调优奖励程序常数 $\theta$:每代采 4 个候选($\lambda_{ES}{=}4$)、3 代、每个候选在 16 个搜索场景上评估,合计 192 个 rollout/提案。
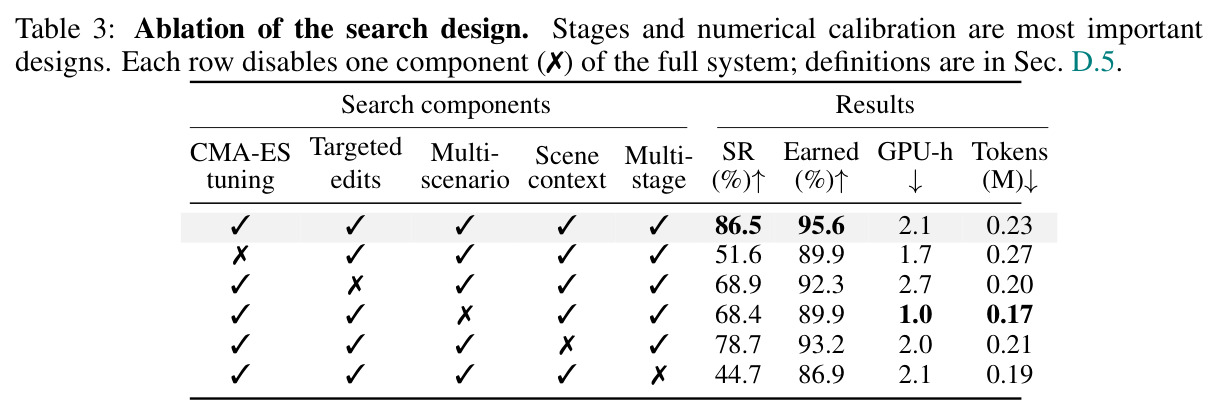
理解“LLM 管结构、CMA-ES 管常数”的双层搜索分工,以及消融中去掉 CMA-ES 后成功率从 86.5% 跌到 51.6% 的原因,都需要知道它的作用方式。
移动操作(loco-manipulation)
指机器人同时协调行走与全身操作的任务类别,例如边走边推箱、抬起箱子搬运到目标高度、绕开障碍推送、用脚踢物体等。难点在于接触丰富(手/脚与物体持续接触)、多阶段(接近-接触-运输-释放),且需要 29 个全身关节的协调控制。
本文全部 8 个基准任务族与 3 个复合任务都是移动操作,方法对任务接口的表达力要求(多阶段、接触模式切换)正来源于此。
测试时扩展(test-time compute scaling)
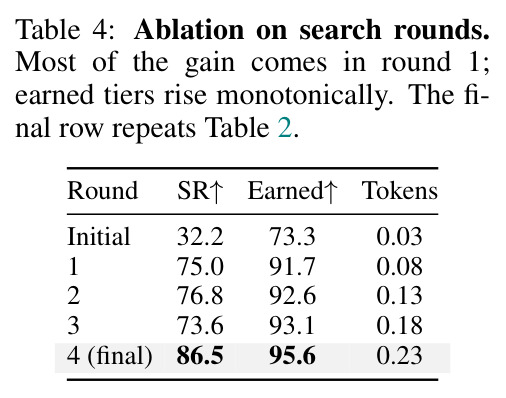
源自语言模型的思想:不改变模型权重,用更多推理算力(重复采样、逐步搜索、验证器筛选)换取更好的输出质量。本文把它迁移到控制领域:用更多仿真 rollout 提炼更好的任务策略,成功率随进化轮数从 32.2% 升至 86.5%。
这是论文的核心主张与标题来源——InterEvolve 本质是“控制版测试时扩展”,评价其贡献必须对照这一框架。
奖励破解(reward hacking)
指智能体找到让奖励分数很高、但并未真正完成设计者意图的行为漏洞,通常由设计不当的奖励项引起(如孤立的身高项会选到腾空状态而非持物抬升),是 LLM 自动奖励设计方法必须应对的经典问题。
图 1 的动机实验正是人工奖励被破解而失败、进化出的程序用新的身体用法成功;技能库里的“教训”(抬升项必须与手接触相乘)也源于对此的防范。
研究动机
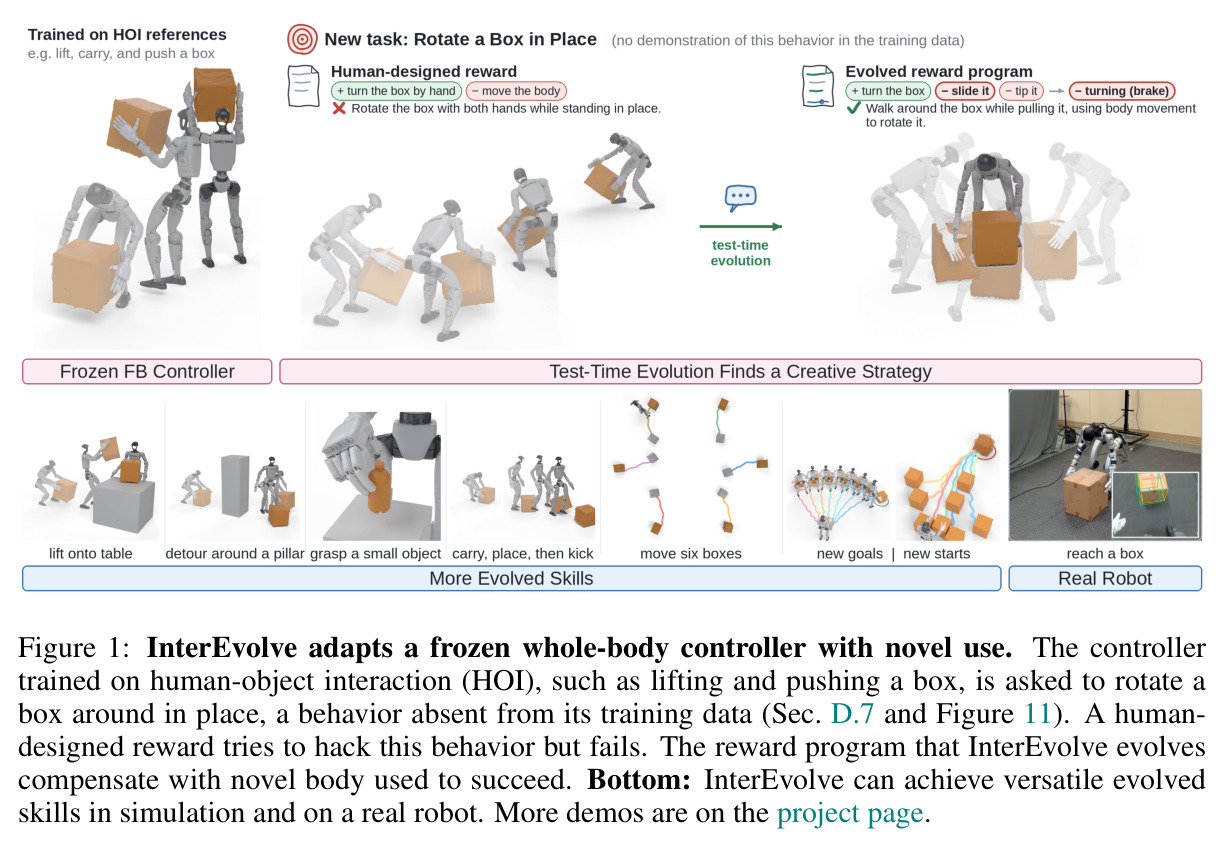
已学习的人形控制器能从人类演示数据掌握推、抬、搬箱子等全身移动操作,但开放环境中必然遇到训练时未枚举的任务:论文开篇的例子是,一个会推、抬、搬箱子的控制器被要求“把箱子翻到另一个面”时没有对应演示,尽管所需动作都在其已有能力范围内。更麻烦的是现有任务接口都不合适:运动参考(motion references)、目标状态(goal states)、技能标签(skill labels)要么难以刻画接触丰富的多阶段交互,要么把“翻箱子”这类目标翻译成参考轨迹或新技能本身就很难设计。奖励本是更有表达力的替代——它在训练中塑形行为的作用早被证明(Andrychowicz et al., 2020)——但常规做法每改一版奖励都要重新训练一个策略(如 Eureka),迭代极慢。数据也印证了“能力在、表述不行”:8 个目标条件任务族上人工写的奖励程序平均成功率仅 8.0%,CMA-ES 调参后也只有 18.0%;同时现有人形 FB 模型(BFM-Zero)只观察身体,仅对象目标不同的奖励会坍缩为同一行为,参考跟踪成功率仅 8%。此外人工奖励还容易被破解:图 1 中让机器人原地转箱的人工奖励失败,进化出的程序反而用新的身体用法成功。
本文的目标是本文要实现“测试时进化”:控制器权重完全冻结,人形机器人在有限尝试预算($K$ 轮)内做到三件事——(i) 找到既有技能的新用法去完成从未训练过的任务;(ii) 从自己的执行结果中改进任务策略;(iii) 把学到的东西保留下来,让后续长程复合任务(如搬箱-放置-踢箱、翻新面的箱子)能建立在早期经验之上。为此需要一个任务接口:对接触丰富、多阶段的交互足够有表达力(能规定哪些接触重要、何时切换阶段),又足够便宜可修改(每次尝试只需一批并行仿真 rollout,而非一次 RL 训练),还要可度量(执行反馈能指导下一版修订)。论文把这个接口具体化为分阶段奖励程序,并把自适应形式化为:在预算内进化程序 $P$,使固定验证器 $C$ 的各准则通过情况最好。
与已有工作不同的是,本文的独特切入有三点。第一,进化的对象是“任务规范”而非动作或策略:TEXEDO、RGB 等测试时搜索工作在动作/轨迹空间规划,Eureka、DrEureka 等 LLM 奖励设计方法每个候选都要训练新策略;InterEvolve 让搜索发生在任务规范空间,控制器冻结,每个候选的代价只是一批 rollout,与语言模型的测试时扩展(更多推理算力换更好答案)同构。第二,把 FB 行为基础模型“对象化”:既有 FB/后继特征模型只看身体,本文用“冻结身体先验 + 可训练对象残差”的最小改动,让同一个策略能区分只差对象目标的奖励。第三,结构-常数分离的双层搜索与防作弊评估:LLM 只改结构(哪些奖励项、哪些阶段),CMA-ES 只调常数 $\theta$;验证器 $C$ 由 LLM 解析一次后固定,智能体无法靠改评分器放水;候选与当前最优共享初始条件对比、且须在 64 场景×3 次重复上超过运行间噪声才被接受,保证被接受的编辑在新初始条件下仍然成立。跨任务则以可读文本技能库(程序+常数+教训)积累经验。
核心方法
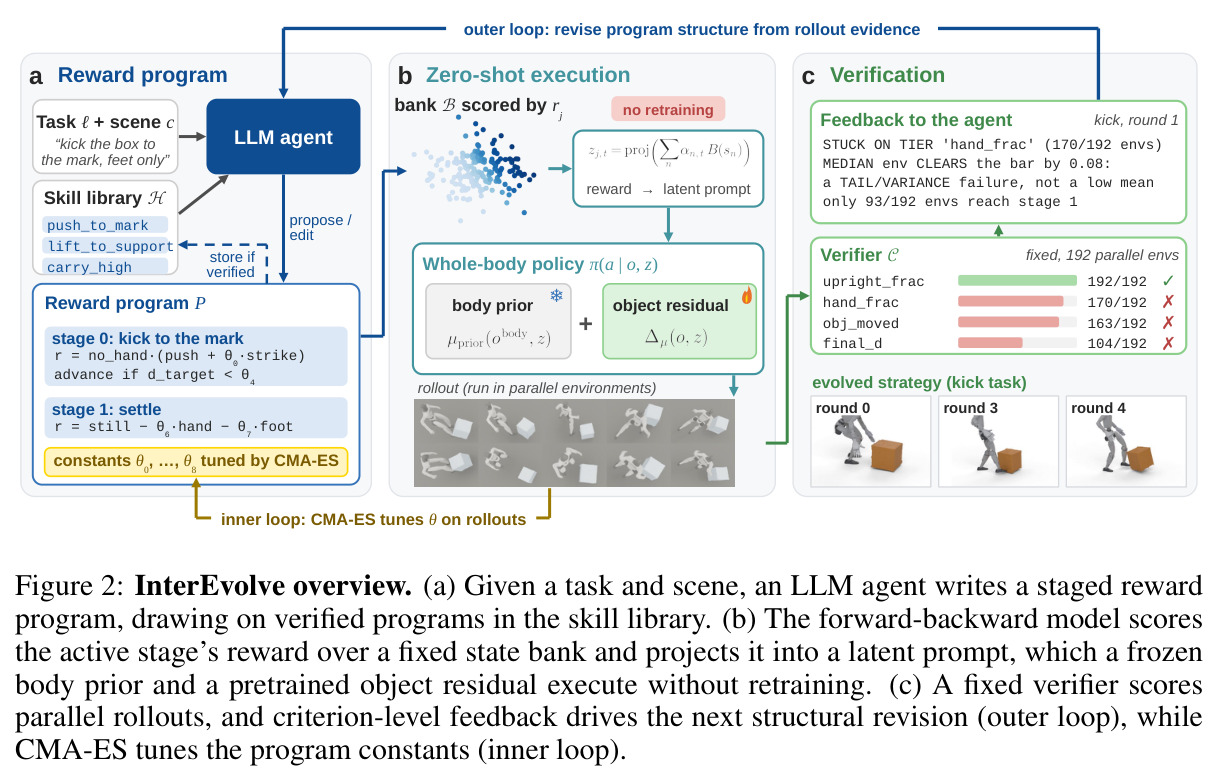
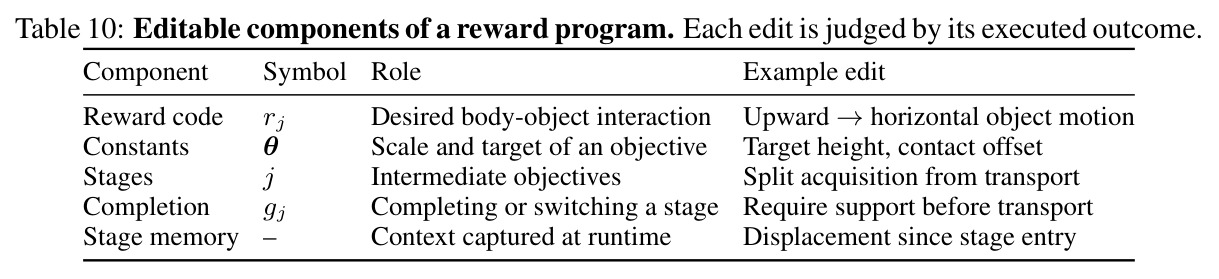
直觉:一个广泛预训练的控制器已经拥有新任务所需的大部分运动能力,瓶颈在“怎么把任务表述给它”。InterEvolve 把任务写成奖励程序 $P=(\theta,\{(r_j,g_j)\}_{j=1}^J)$:$J$ 个有序阶段(如朝向物体、建立接触、运输、释放),每阶段有奖励代码 $r_j$ 与完成条件 $g_j$,外加可调常数向量 $\theta$(权重、阈值、核宽等)。执行靠对象感知 FB 电机模型:当前阶段奖励在约 5 万状态的奖励推断库 $\mathcal{B}$ 上打分,做 softmax 倾斜加权得潜变量提示 $z_{j,t}=\mathrm{proj}\left(\sum_{n}\alpha_{j,n,t}B(s_n)\right)$,其中 $\alpha_{j,n,t}\propto\hat r_{j,n,t}\exp(\beta\hat r_{j,n,t})$,每个控制步重算并驱动冻结策略 $\pi(a_t|o_t,z_{j,t})$。进化分两层嵌套循环:外循环由权重冻结的 LLM 智能体(DeepSeek-V4-Flash)依据逐准则、逐阶段的执行反馈修改程序结构,并按早期“探索”、中期“精炼”、后期“微调”三阶段接收不同指令;内循环用 CMA-ES 在智能体声明的界内调 $\theta$(每个有效提案 192 个 rollout)。候选与当前最优在同批场景比较,在 64 确认场景×3 次重复上超过评估噪声才替换;预算 $K{=}4$ 轮,通过全部准则或耗尽预算即停,最终程序与常数存入技能库供后续任务检索与嫁接。
核心创新是“任务知识外置”:控制器只学一次怎么动,任务知识活在权重之外、LLM 可读可改、可用执行验证的奖励程序里。推理与控制在不同时间尺度上分别改进——控制器随交互数据变强,智能体随测试时搜索和增长的程序库变强,二者互不重训。与 Eureka 等“每个候选奖励训练一个策略”的方法本质不同:这里每个候选由固定控制器零训练执行(FB 表征把任意奖励映射为潜变量提示),单次迭代成本从一次 RL 训练降为 192 个并行 rollout,因此能用测试时算力换任务成功率(SR 从 32.2% 升到 86.5%)。第二个关键是对象感知 FB 模型:在 actor、前向映射 $F$、后向映射 $B$ 三个网络上给冻结身体分支加可训练对象残差,均值动作 $\mu_\pi(o_t,z_{j,t})=\tanh\left(\mu_{\text{prior}}(o^{\text{body}}_t,z_{j,t})+\Delta\mu(o_t,z_{j,t})\right)$,用 OMOMO+GRAB 人-物交互数据训练,解决了只看身体的 FB 模型“奖励只差对象目标就坍缩”的问题(Table 1 中 BFM-Zero 跟踪 SR 仅 8%)。第三,固定验证器与“程序+教训”式技能库,让每次编辑都被诚实度量、并跨任务复用。
方法步骤详情
第一步,预训练电机模型:把 OMOMO(大物体操作)与 GRAB(小物体抓取)重定向到 Unitree G1(橡胶手与 Inspire 灵巧手两种具身),每物体留 50 段评估、其余 3866 段训练;在 FB 目标+演示判别器下只训练对象残差分支(身体分支冻结),并在训练回放上一次性采样约 5 万状态的奖励推断库,缓存 $B(s_n)$ 与奖励特征,进化期间冻结。第二步,解析任务:语言请求 $\ell$ 与场景 $c$ 经 LLM 辅助解析器一次性实例化验证器 $C=\{C_i\}$(如保持直立、手不接触、最终距离 <0.3m 等),此后固定。第三步,初始程序:智能体输出 1-3 阶段的 JSON 程序,每阶段含 reward(F,C,W) 与 transition(C,W) 及权重上下界;验证器先丢弃非法代码(如读未声明特征)。第四步,内循环校准:CMA-ES($\lambda_{ES}{=}4$、3 代、16 搜索场景)为每个有效提案调 $\theta$,共 192 rollouts。第五步,选择:调参候选与当前最优在同批搜索场景比较,最强者与当前最优再在 64 确认场景×3 重复上重评,改进超过运行间噪声才替换。第六步,反馈:报告逐准则通过率与中位差距(如“hand_frac 170/192,中位数超阈值 0.08,属尾部/方差失败而非低均值”)与阶段轨迹(停留时长、obj_z 变化),并指出哪个程序在哪个准则上领先,支持跨程序阶段嫁接。第七步,终止与积累:$K{=}4$ 轮(含初始共 5 轮)或全准则通过即停,程序、常数、各准则通过率与经验教训写入技能库(8 个任务约 28KB),置于后续每轮提示中。
技术新颖性
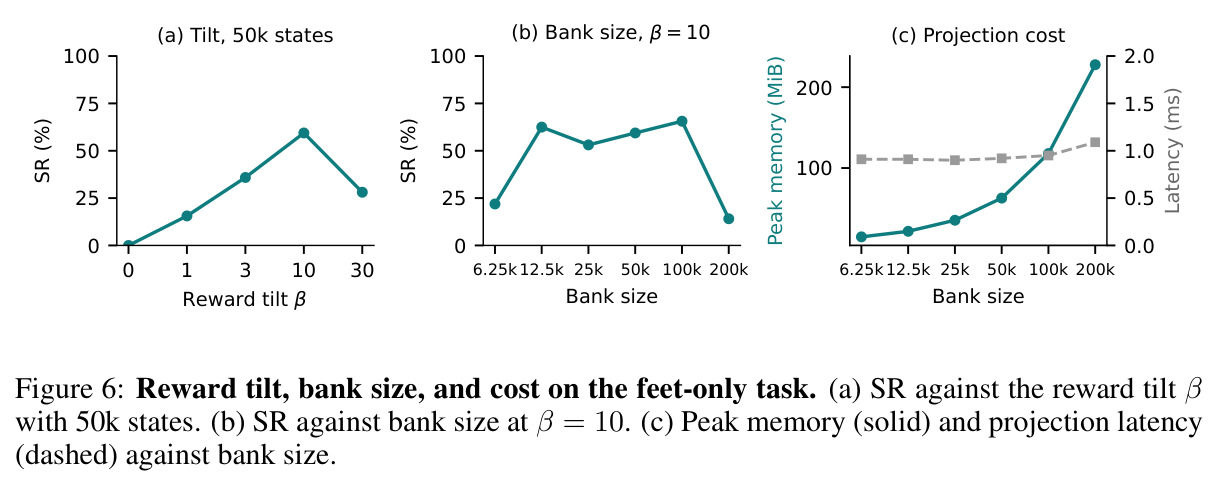
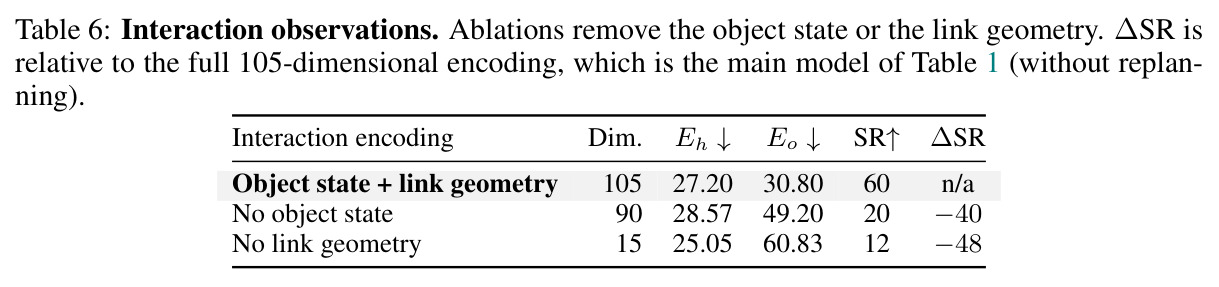
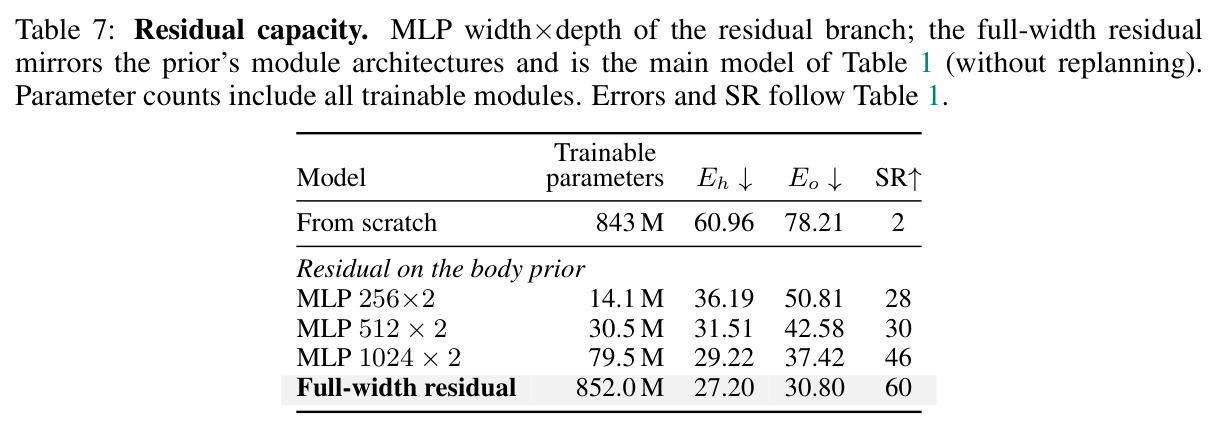
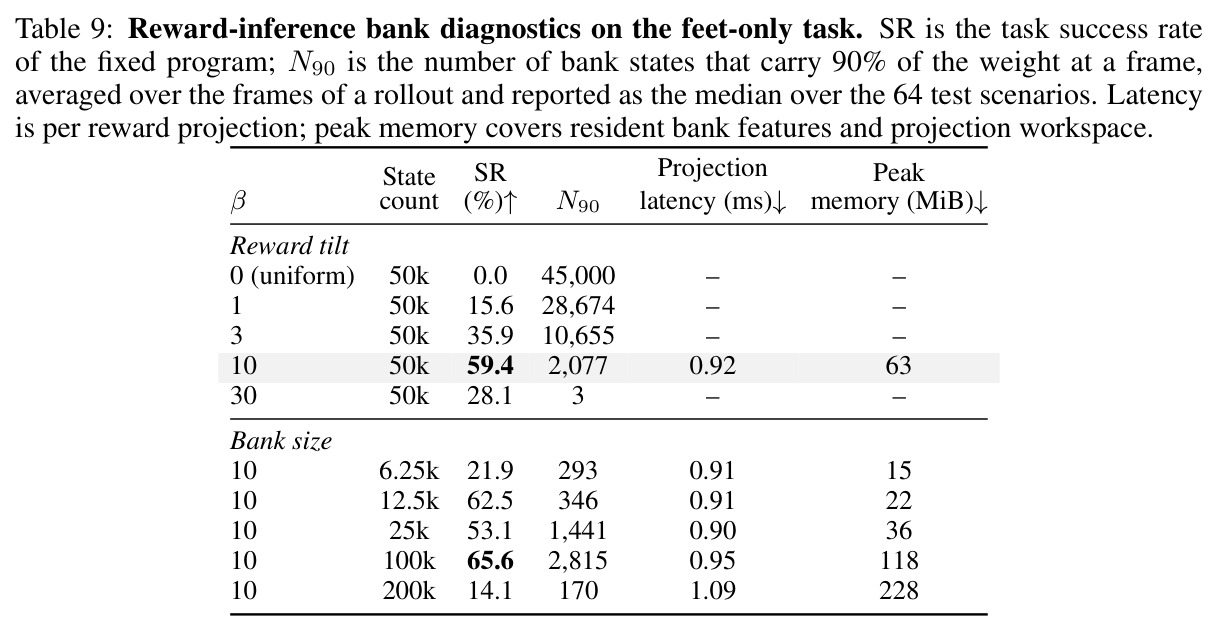
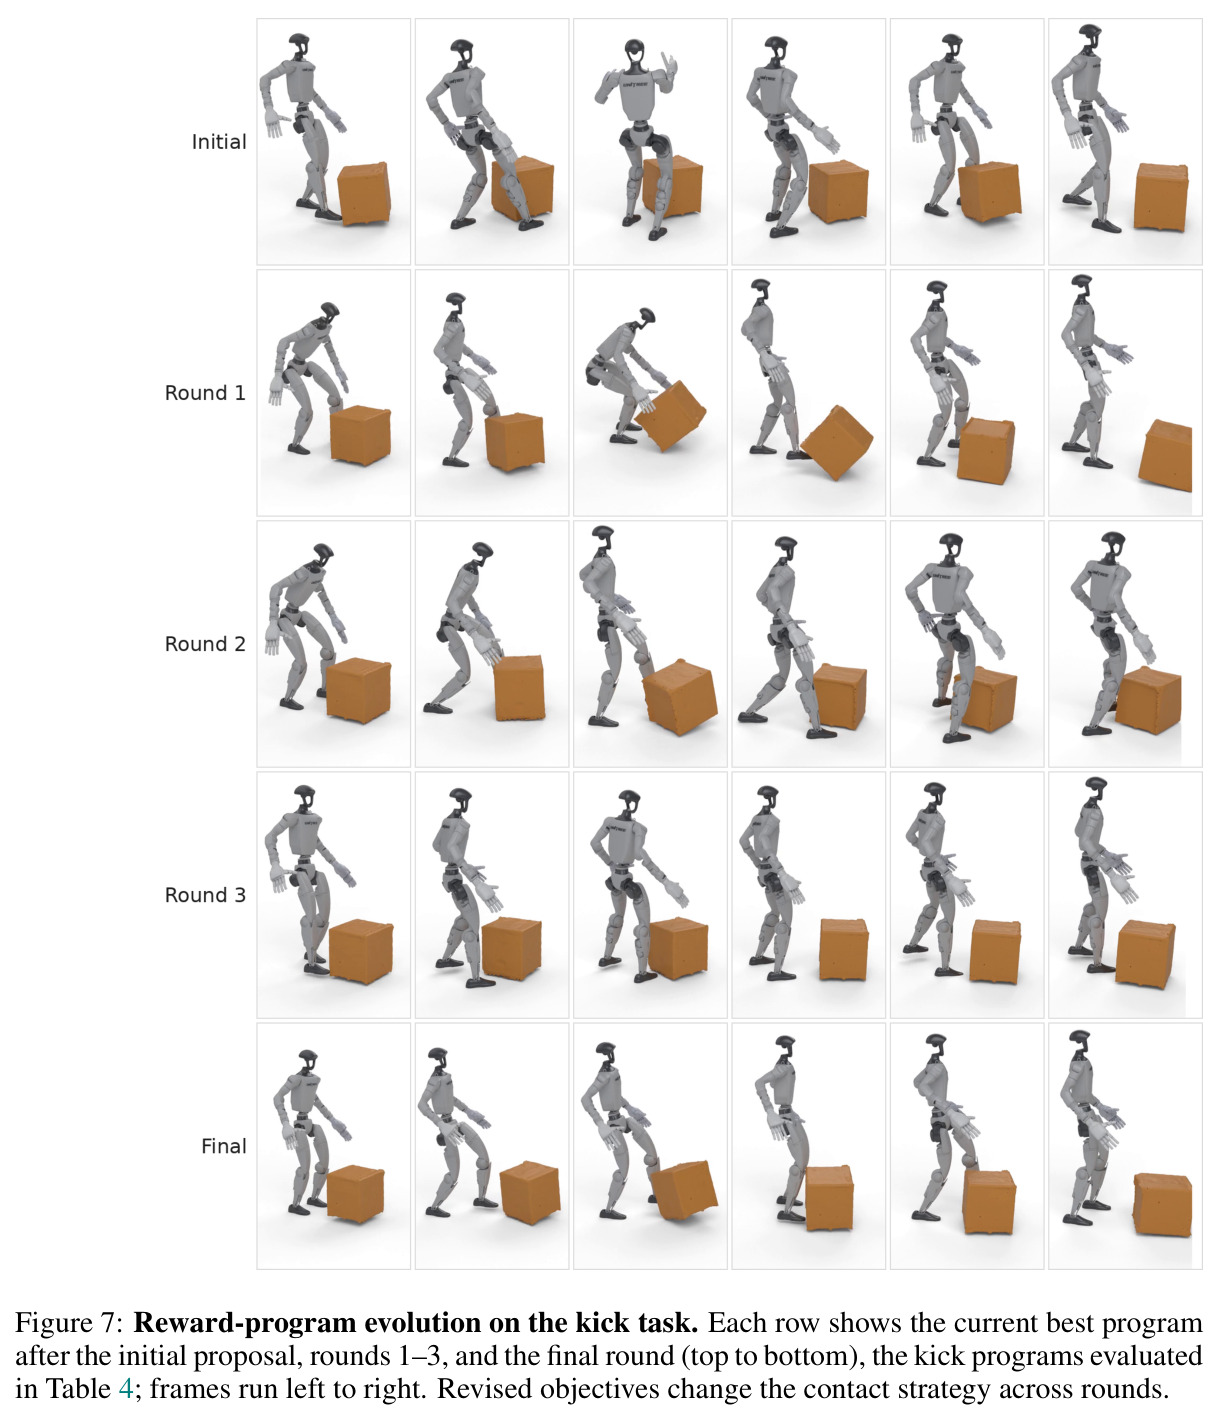
技术新颖性可从四个层面看。(1) 表征层:FB/后继特征文献(Touati & Ollivier 2021;Tirinzoni et al. 2025;BFM-Zero 2026)的模型都只处理身体观测,本文的“冻结身体先验+对象残差”是对 FB 家族的对象感知扩展;消融(Table 6/7)显示两个交互输入缺一不可(去对象状态 SR 60→20,去链路几何 60→12),从头训练 843M 模型 SR 仅 2,而 852M 全宽残差达 60,说明“先验承载身体技能、残差学习交互”的分离成立且容量需匹配。(2) 推断层:把奖励到行为的映射做成“在固定状态库上 softmax 倾斜加权”(Eq. 1),每步重算提示使阶段奖励可读实时上下文;Table 9 揭示倾斜系数 $\beta$ 与库大小的权衡(均匀加权 SR=0,过尖 $\beta{=}30$ 掉到 28.1%,200k 大库反而因权重过度集中失败到 14.1%)。(3) 搜索层:结构-常数分离(LLM 管 $r_j,g_j$、CMA-ES 管 $\theta$)与“哪个程序在哪个准则领先就嫁接哪一阶段”的合并指令是新的智能体工程设计。(4) 积累层:经验以可读程序+调好常数+设计教训的文本形式沉淀(如“抬升项必须与手部接触相乘,否则会选到空中状态”),可在长程复合任务中复用,而非锁在不可读的策略权重里。
实验结果
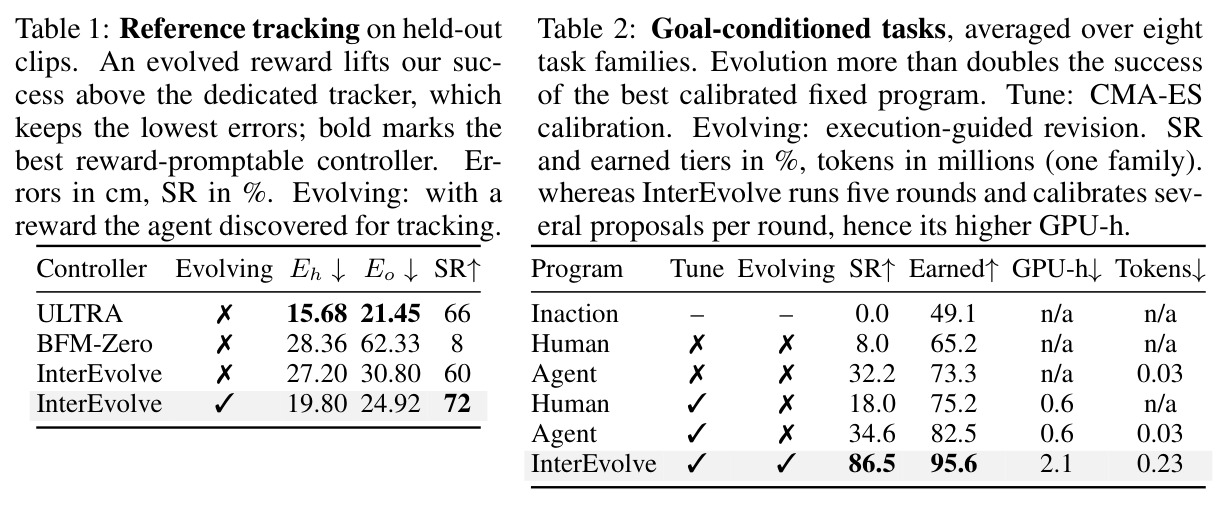
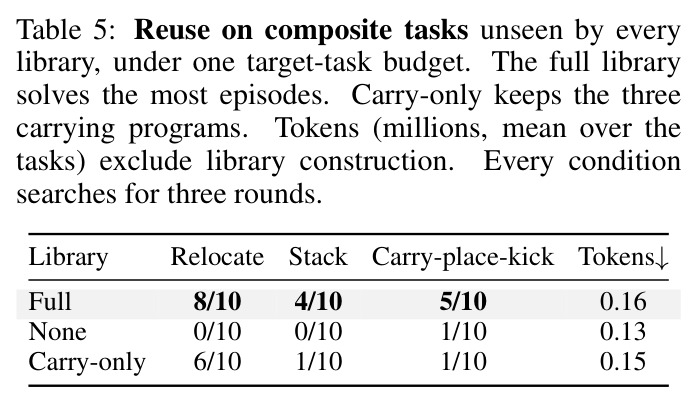
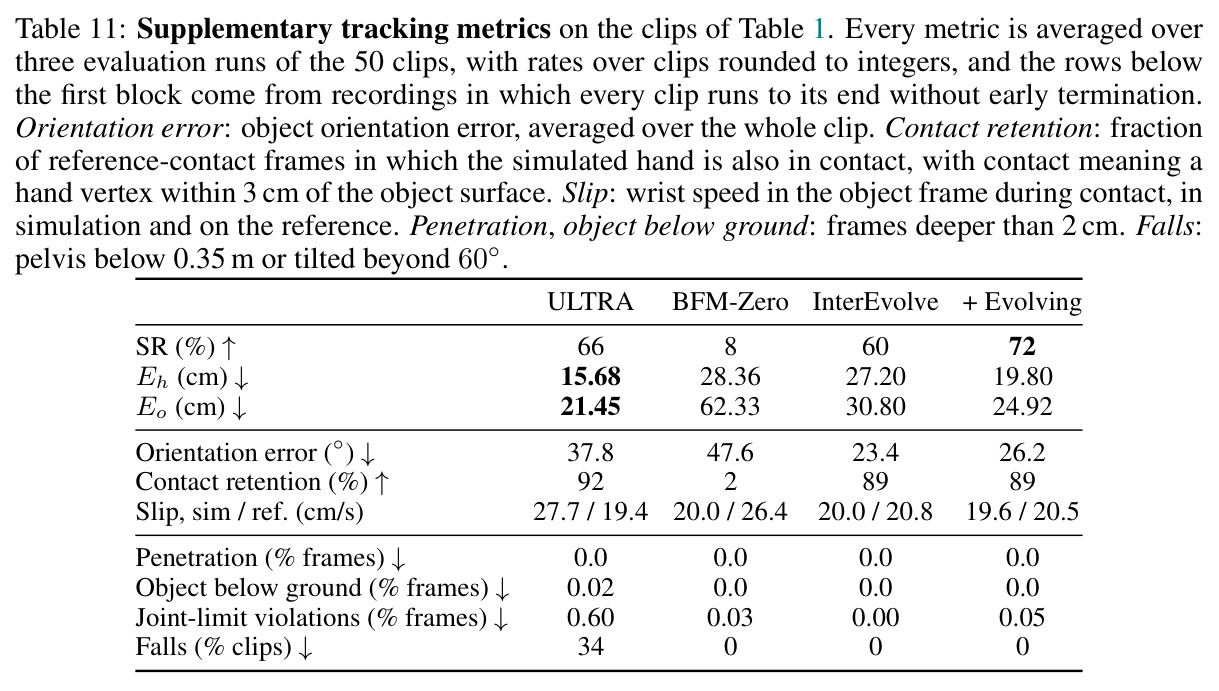
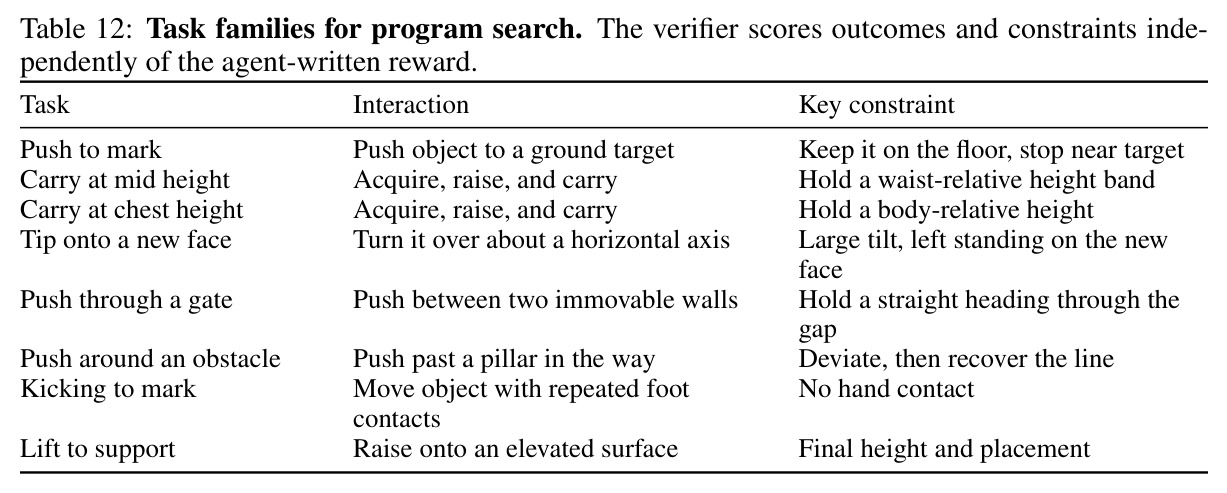
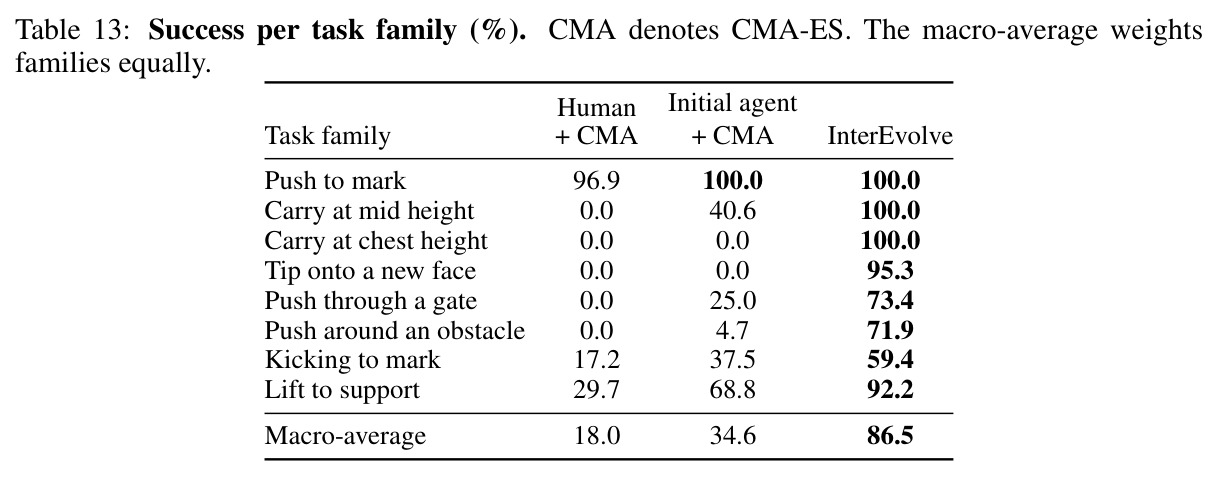
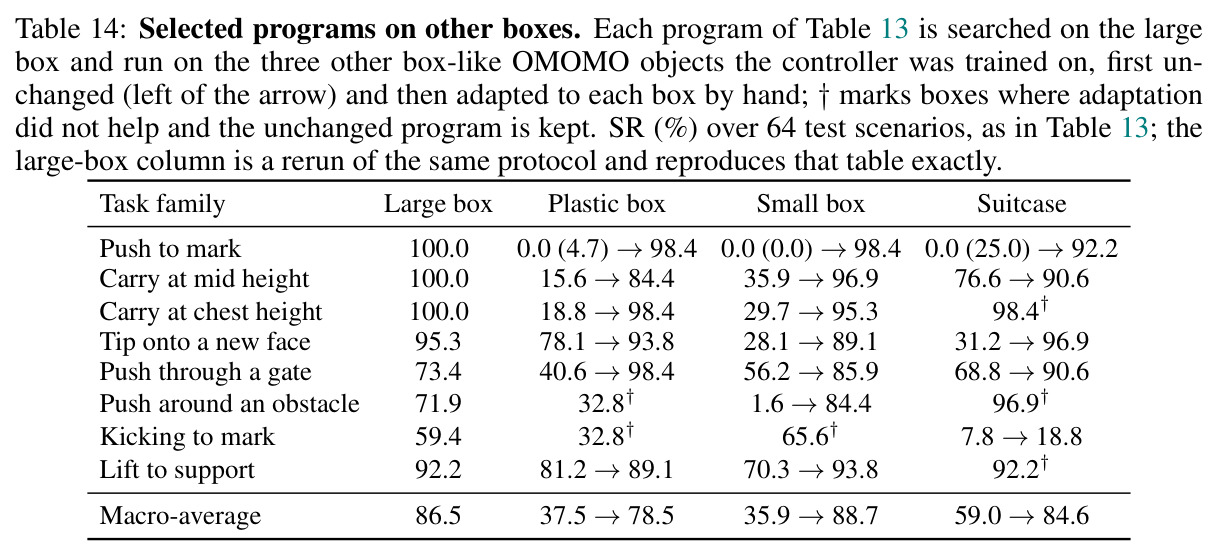
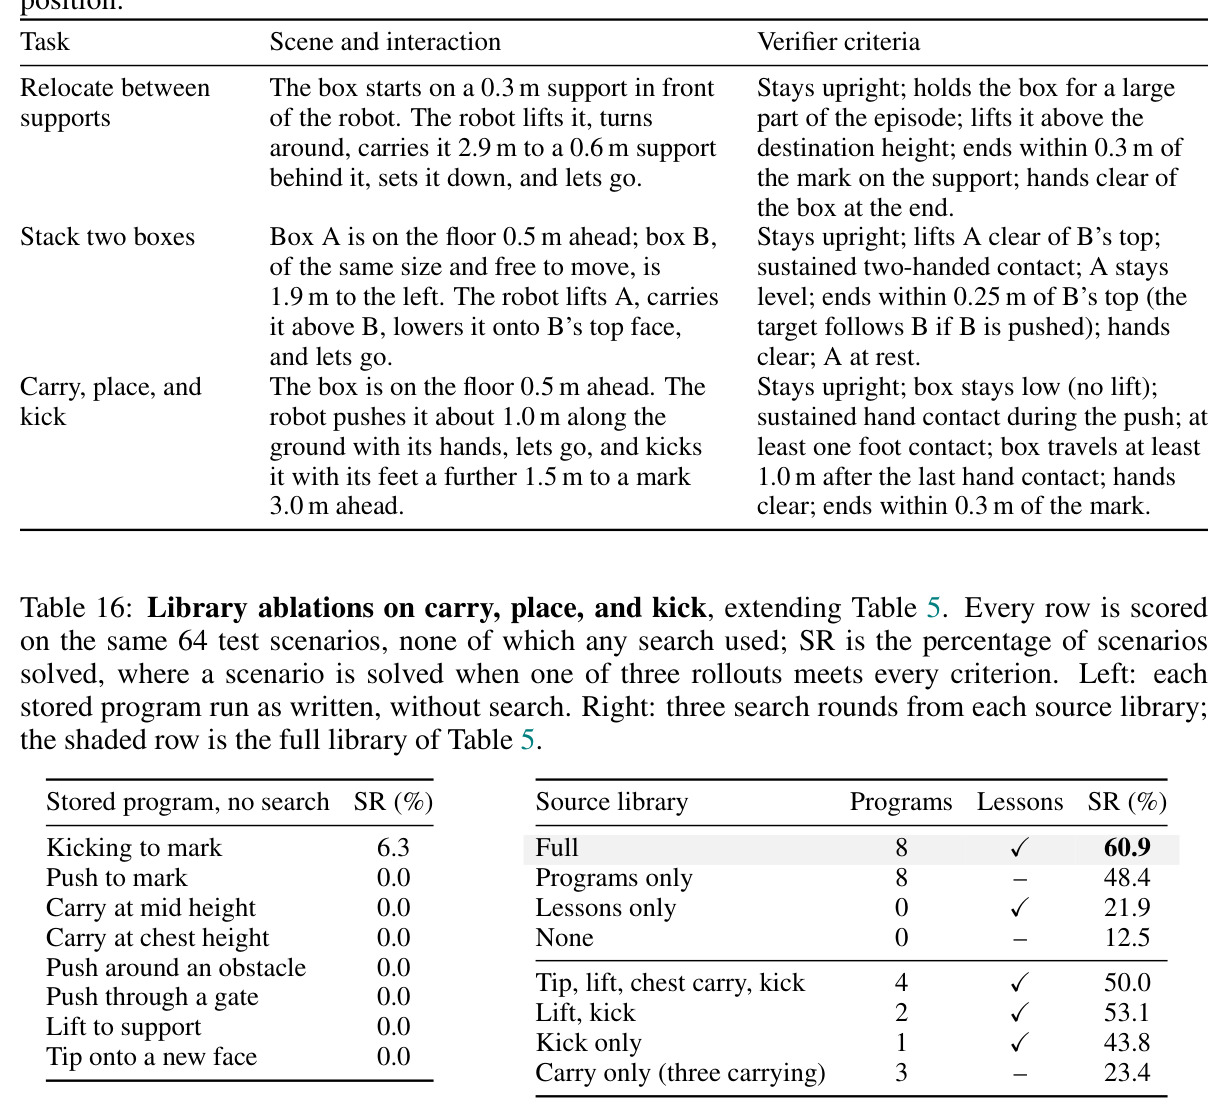
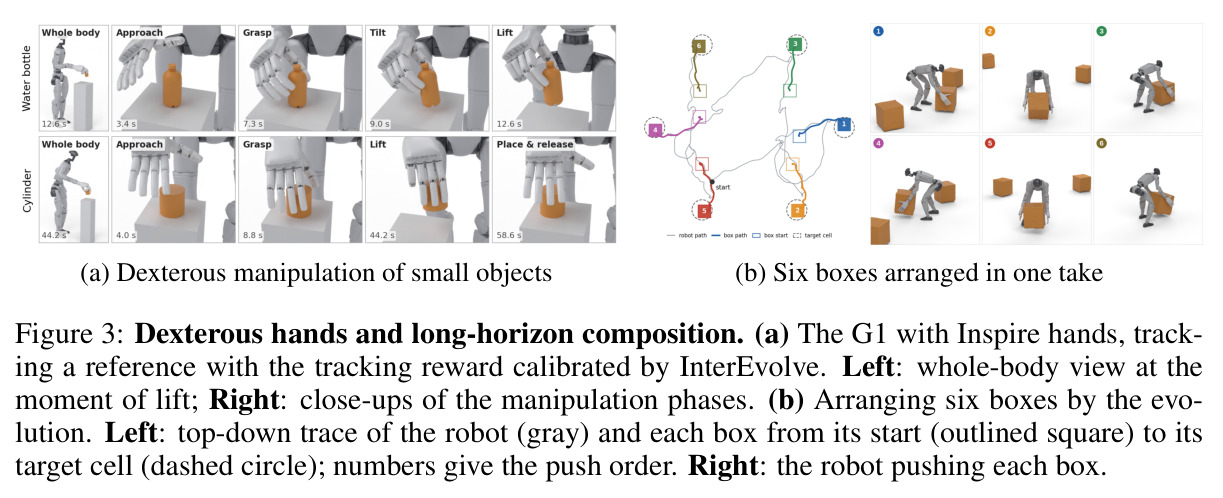
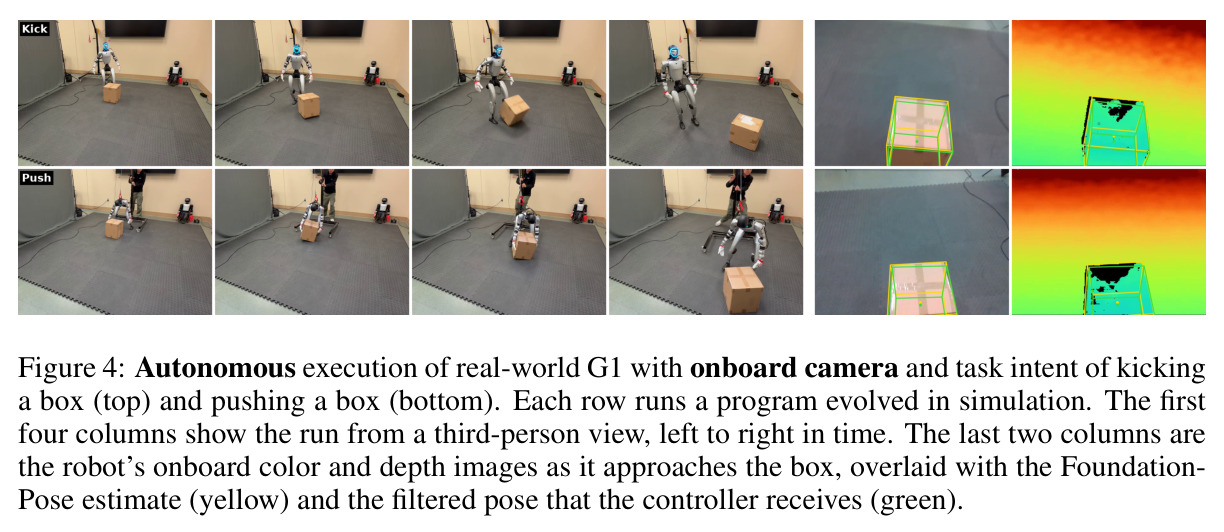
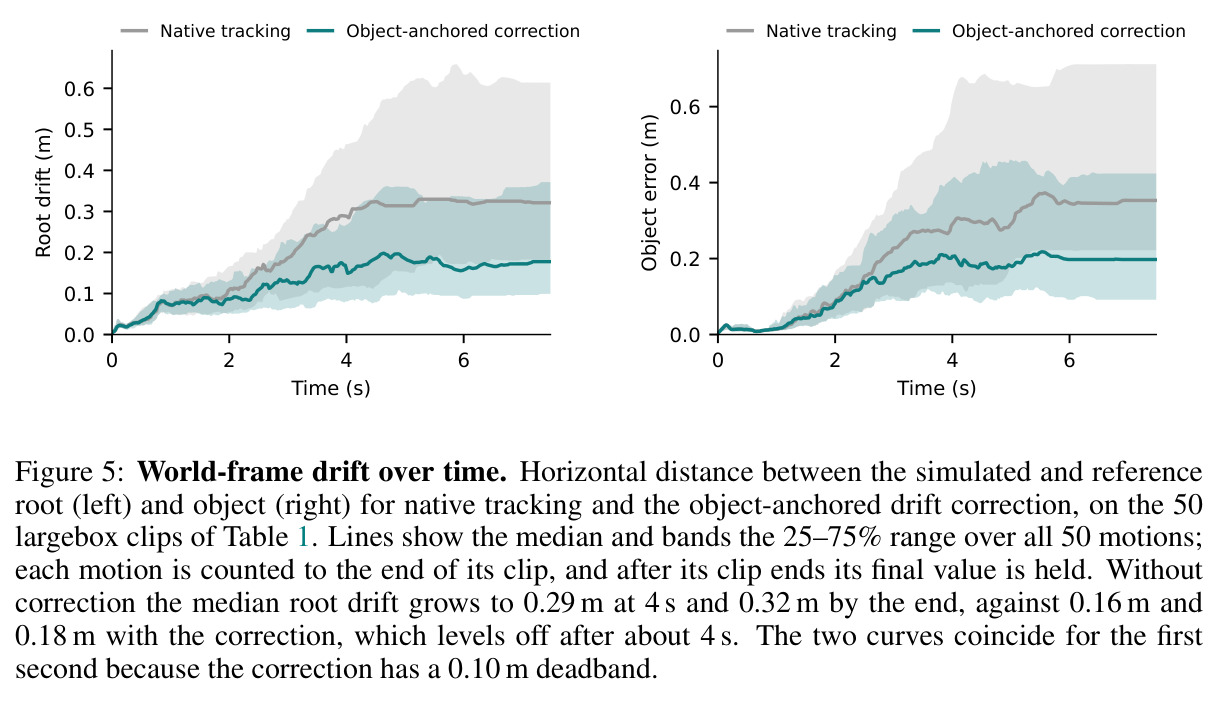
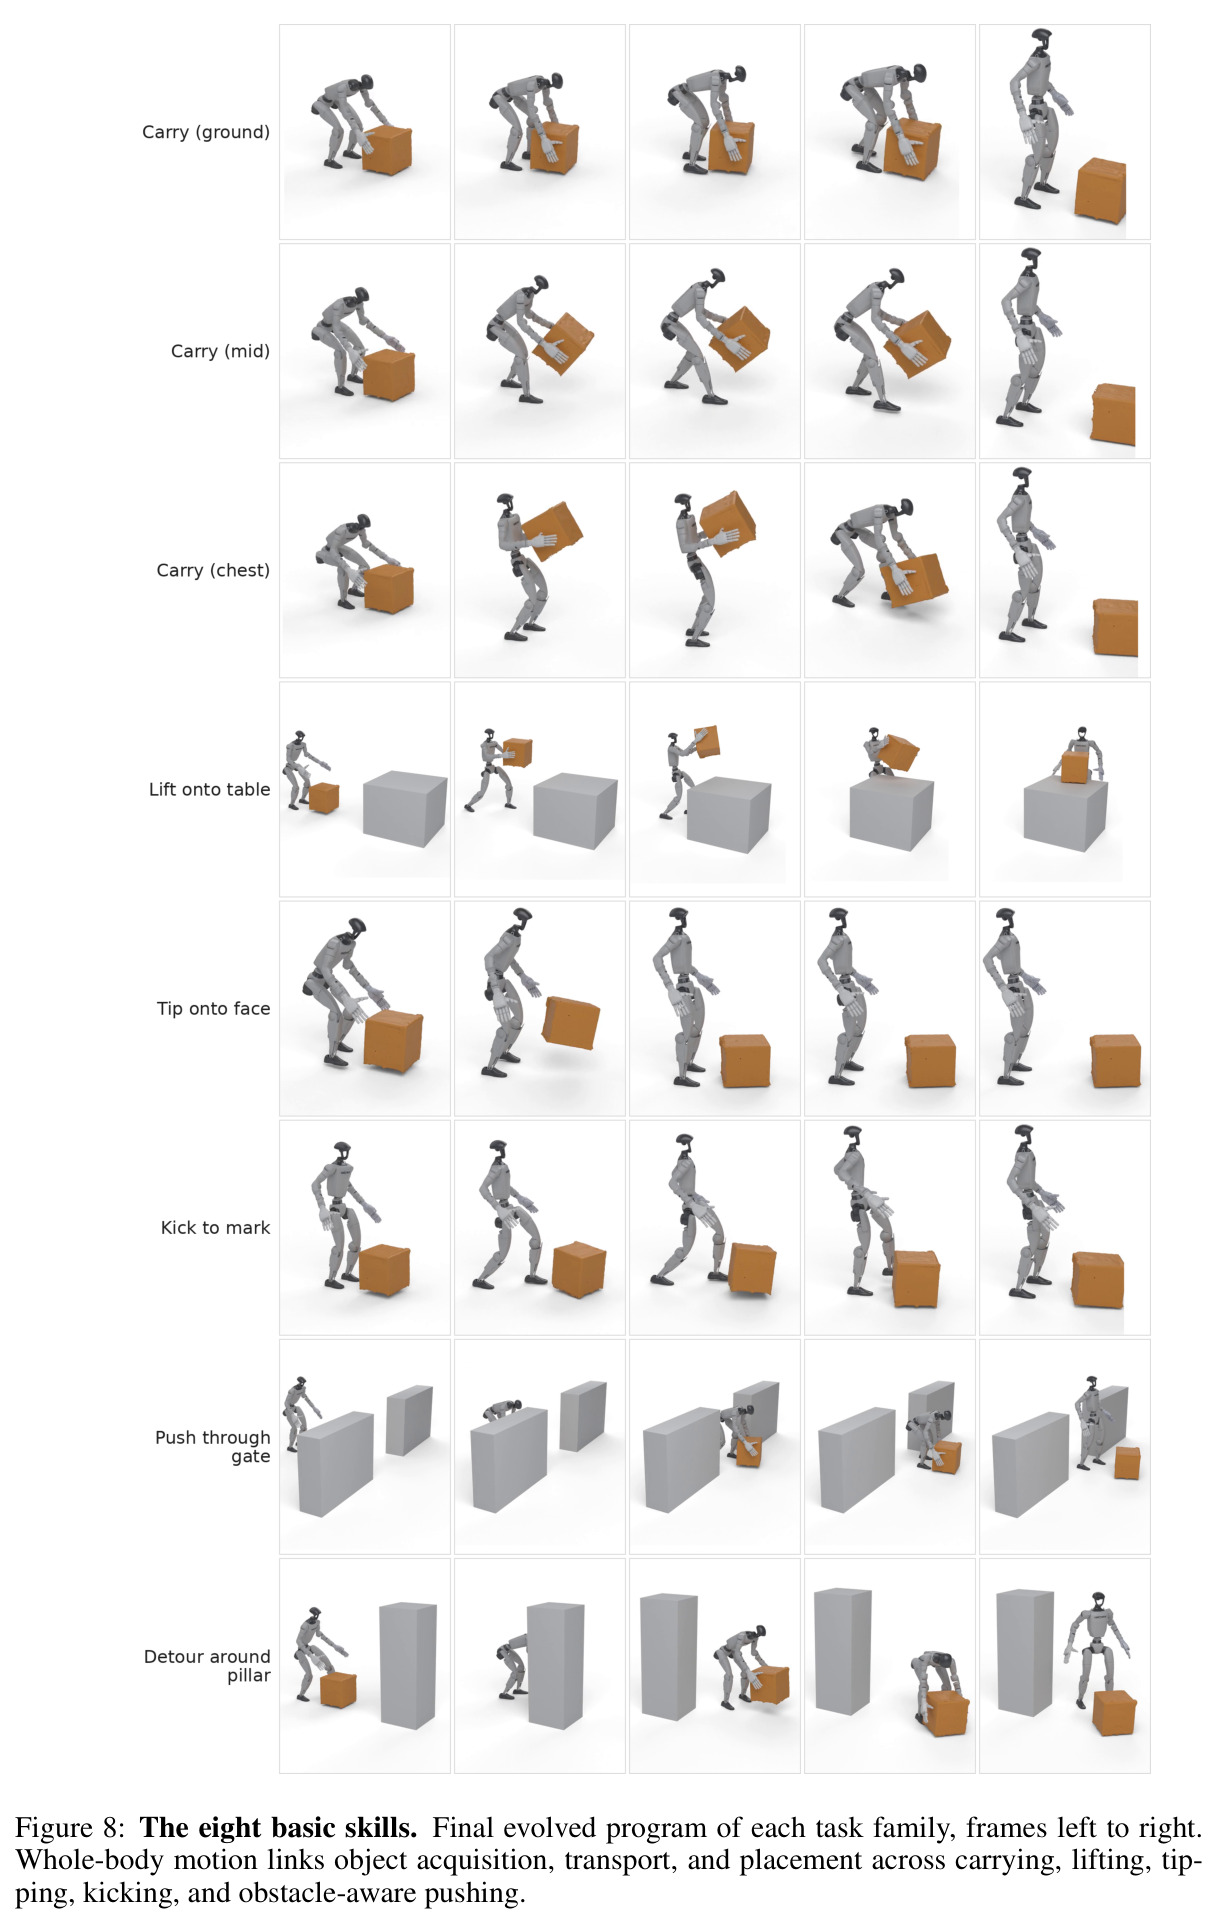
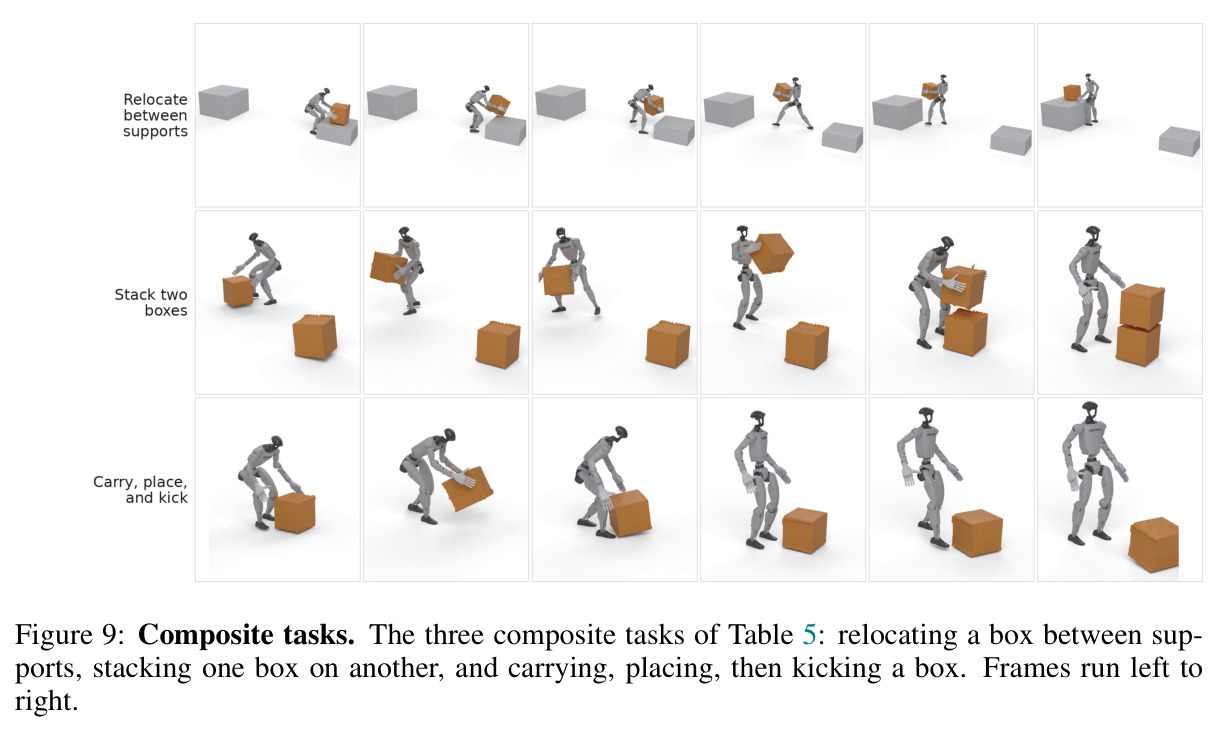
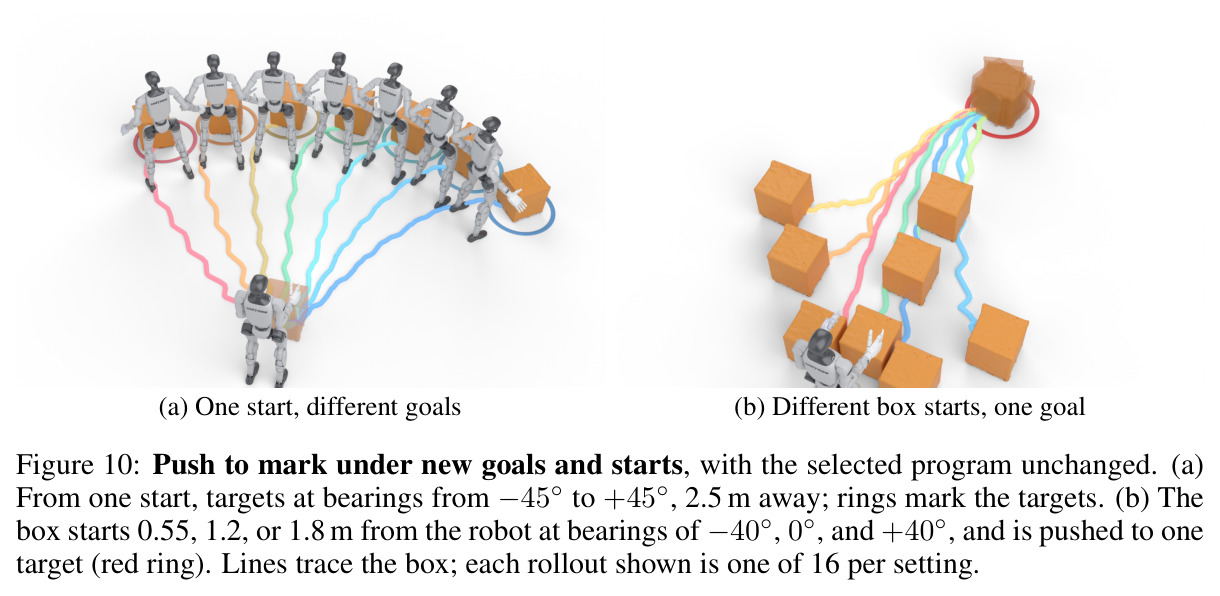
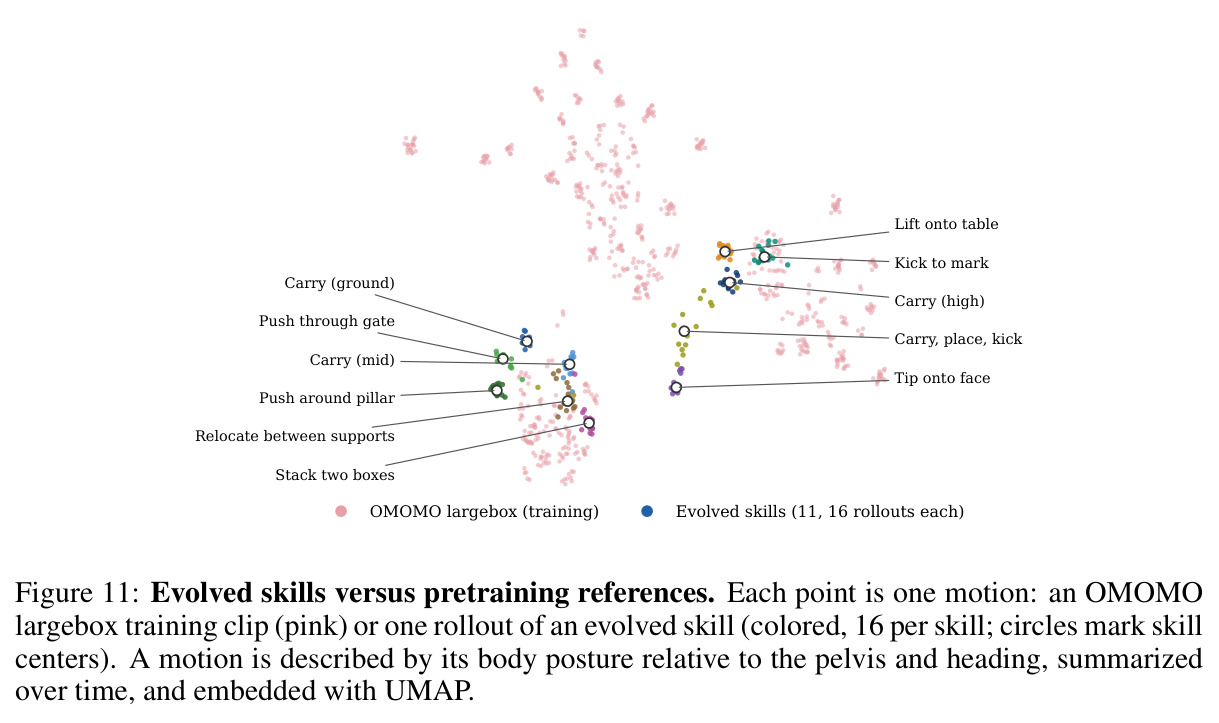
(1) 参考跟踪(Table 1,50 段留出大箱片段):专用 RL 跟踪器 ULTRA 达 $E_h{=}15.68$cm、$E_o{=}21.45$cm、SR 66%;仅身体的 BFM-Zero SR 仅 8%,印证对象坍缩;InterEvolve 电机模型 SR 60%、$E_o{=}30.80$cm;智能体进化的“对象锚定漂移修正”奖励(增益 $k_p{=}3$)把 SR 提至 72% 反超 ULTRA,朝向误差 23.4° 优于 ULTRA 的 37.8°,跌落 0 vs 34%,中位根漂移 4 秒时从 0.29m 降至 0.16m。(2) 目标条件任务(Table 2/13,8 族宏平均):人工程序 8.0%,+CMA 18.0%;智能体初始 32.2%,+CMA 34.6%;完整进化 86.5%/Earned 95.6%,成本仅 2.1 GPU-h 与 0.23M tokens——比最佳校准固定程序翻倍以上,证明增益来自结构而非调参。逐族:推到标记 100%、腰部搬运 100%、胸部搬运 100%、翻面 95.3%、抬上支撑 92.2%、过门 73.4%、绕障 71.9%、踢 59.4%(最难,因踢在训练数据中罕见)。(3) 消融(Table 3):单阶段 44.7%(降幅最大);无 CMA-ES 51.6%;单场景 68.4%;全重写 68.9%;无场景上下文 78.7%。(4) 轮数(Table 4):SR 32.2→75.0(第 1 轮)→76.8→73.6→86.5(第 4 轮),Earned 单调升至 95.6;每轮仿真 16-34 分钟 vs LLM 仅 1-2 分钟,仿真主导成本。(5) 复用(Table 5/16):三个复合任务上全库 8/10、4/10、5/10,无库 0/0/1,仅搬运输库 6/1/1;直接照搬存储程序几乎全败(仅踢 6.3%),三轮搜索后全库 60.9% vs 无库 12.5%——增益来自进化整合库而非直接检索。(6) 长程:六箱围圈排列、单次复位跑 12 个阶段,全部落在目标格 11cm 内且已放箱不被扰动。(7) 迁移(Table 14):不改程序换新物体宏平均 36-59%,手工适配后 78.5-88.7%。(8) 新颖性(Fig. 11):抬上桌、胸部搬运、搬-放-踢与 729 段预训练参考的最近邻距离排在第 98 百分位,属参考中没有的新运动。(9) 真机:G1 以机载 RGB-D+FoundationPose+LiDAR 融合感知自主执行踢/推程序,50Hz 控制。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 参考跟踪(50 段留出大箱片段) | 成功率 SR(%) | 72 | ULTRA 66;BFM-Zero 8 | 较专用跟踪器 +6pp,较身体only FB 模型 +64pp |
| 参考跟踪误差 | $E_h$ / $E_o$(cm) | 19.80 / 24.92 | ULTRA 15.68 / 21.45 | SR 更高、朝向误差更低(23.4° vs 37.8°),关节误差略逊于专用跟踪器 |
| 8 个目标条件任务族(宏平均) | SR(%) | 86.5 | 智能体初始程序+CMA-ES 34.6;人工程序 8.0 | +51.9pp(翻倍以上),成本 2.1 GPU-h、0.23M tokens |
| 踢箱到标记(最难任务族) | SR(%) | 59.4 | 智能体初始+CMA-ES 37.5 | +21.9pp |
| 复合任务:搬-放-踢(技能库复用) | 10 场景成功数 | 5/10(全库) | 无库 1/10;仅搬运输库 1/10 | +4 场景 |
| 搬-放-踢(64 场景,三轮搜索,Table 16) | SR(%) | 60.9(全库) | 无库 12.5;仅教训 21.9;仅程序 48.4 | +48.4pp(vs 无库) |
局限与改进
作者承认的(附录 E):程序搜索受电机库、奖励推断库与可用测量三重上限约束——控制器没学过的行为无法诱导(踢族只到 59.4%);每次搜索需数 GPU 小时仿真加 LLM 延迟,无法在物理执行中实时重规划;累积经验目前不回灌控制器。我补充几点:(i) 真机部署是“离线进化+重放潜变量序列”,执行中若物体位姿估计失效只能暂停,没有在线重进化或真机反馈闭环;(ii) 验证器虽固定,但它由 LLM 从语言任务一次性解析实例化,解析偏差本身未被校验,且准则依赖人工预定义的特征词汇 $F/C$(obj_vel、hand_contact 等),完全新的交互模态(如插销、柔体、工具使用)缺乏特征支撑;(iii) 任务与物体范围窄:8 个族全是推/搬/抬/翻/踢变体,物体限于 4 种箱状 OMOMO 物体与 GRAB 小物件,堆叠仅 4/10,精密放置仍是短板;(iv) 跨物体泛化常需人工适配(Table 14 多个 † 项),踢塑料箱/小箱、绕障推塑料箱适配后仍无改善;(v) 评估全在 Isaac Lab,sim-to-real 只在两个演示任务上检验,对接触建模误差的敏感性未量化;(vi) 每轮约 190 万环境步的仿真开销使实时应用不可行。
独立分析的弱点
(1) 预算与结构刚性:每轮一次 LLM 调用、每提案固定 192 rollouts、阶段数限 1-3;更复杂任务(工具使用、双臂协同、柔性物体)可能需要更深分解或树式结构探索,改进方向是自适应预算分配与带跨轮记忆的搜索树。(2) 奖励推断库静态且对超参敏感:库 $\mathcal{B}$ 一次性构建后冻结,Table 9 显示 200k 大库因倾斜权重过度集中反而失败(SR 65.6%→14.1%),训练回放中稀疏的行为(踢)直接限制可达上限;可在线扩库、按任务条件化采样,或用生成模型合成边界状态充实库。(3) 硬阈值阶段切换:完成条件 $g_j$ 阈值不当会过早切换(Fig. 2 中 stage 0 仅持续 0.66s/14s),可引入驻留时间学习或相邻阶段潜变量的软过渡插值。(4) 刚体、单物体假设:未测柔性物体、铰接物体与多物体同时操作,堆叠成功仅 4/10,说明需要更丰富的接触状态特征与更细的放置准则。(5) 真机无在线适应:真机动力学偏移时重放潜变量序列会失效,改进方向为边缘端轻量 CMA-ES 在机调 $\theta$,或对程序做域随机化验证后再部署。(6) 泛化依赖人工适配:Table 14 显示换物体常要手工改程序,可让技能库显式索引“物体参数→常数修正”规则,实现换物体自动适配。
未来方向
作者提出的:让累积经验反过来更新控制器权重(打破“控制器与任务知识分别改进”的边界);用更快仿真器(如 mjlab 替代 Isaac Lab)大幅缩短进化时间;进一步扩大测试时搜索规模。基于成果可延伸的:(1) 把验证器部分准则交给视觉-语言模型做开放判定,支持无预定义特征词汇的新任务;(2) 用进化成功的程序生成离线 RL 蒸馏数据反哺对象残差分支,形成“测试时搜索→训练时巩固”闭环;(3) 技能库的课程化、去重与跨具身(非 G1 机器人)程序迁移;(4) 部署时在线适应:利用机载感知反馈在真机上微调常数 $\theta$(CMA-ES 的轻量在线版);(5) 将 FB 提示空间搜索与视频生成先验(Imagine2Real 等)结合,为稀疏行为(如踢)提供更好的搜索起点;(6) 从理论上刻画奖励程序的可组合性——哪些阶段可安全嫁接、何时合并会破坏稳定性,目前合并指令全靠提示工程保证。
复现评估
论文未声明开源代码,项目页(sirui-xu.github.io/InterEvolve)提供视频演示。有利因素:附录把复现细节写得非常完整——电机模型结构(105 维交互编码:15 维对象状态+90 维链路几何;残差分支需全宽 852M 可训练参数才能达 SR 60)、训练目标(FB+判别器+辅助 critic,Eq. 2/3)、奖励推断库构建与 Eq. 1/5、提示模板全文(角色/特征词汇/代码规则/三阶段指令/反馈格式,附录 C.2)、预算核算($\lambda_{ES}{=}4$、3 代、16 搜索场景、64 确认场景×3 重复)、全部 8 个任务族与 3 个复合任务的验证器准则(Table 12/15)、成本(五轮平均 950 万环境步、2.1 GPU-h、0.23M tokens;每轮仿真 16-34 分钟+LLM 1-2 分钟)。不利因素:依赖 OMOMO/GRAB 到 Unitree G1 的重定向管线(改自 OmniRetarget)、Isaac Lab、DeepSeek-V4-Flash API 与真机 G1(含 FoundationPose/LiDAR 感知栈)。总体判断:协议级可复现性好,纯仿真部分单卡可行(熟练机器人 RL 工程师数周量级),含真机的完整复现需数月。
论文图表
输入任务 $\ell$、场景 $c$、验证器 $C$、电机模型 $\pi$ 与状态库 $\mathcal{B}$、技能库 $\mathcal{H}$、预算 $K$。智能体先写初始程序;随后 $K$ 轮循环:构造提示(任务+场景+验证器+库+当前最优及反馈)→解析验证提案→内循环 CMA-ES 调 $\theta$→与当前最优同场景比较→确认场景重评(改进超噪声才替换)→总结逐准则/逐阶段反馈→全准则通过则提前终止;最终把当前最优程序与验证结果存入 $\mathcal{H}$。
完整算法伪代码,是把 Figure 2 的概念流程落到可实现步骤的枢纽,复现时的入口。
八任务族宏平均:不动基线 SR 0.0%/Earned 49.1%;人工程序 8.0/65.2;智能体初始程序 32.2/73.3;人工+CMA 18.0/75.2;智能体+CMA 34.6/82.5;InterEvolve 完整进化 86.5/95.6,成本 2.1 GPU-h、0.23M tokens(含五轮、每轮多个提案校准)。
核心主表:把“结构修改”的增益(86.5 vs 34.6)与“调参”的增益(32.2 vs 34.6)干净分离,是全文最重要的一张表。
漂移修正奖励的锚定与增益消融:无修正 SR 60;根锚定 $k_p{=}2$ SR 68;对象锚定 $k_p{=}3$ SR 72;双锚定误差最低(18.24/24.10)但 SR 68 低于纯对象锚定,故主表采用对象锚定。另测了每 2 步更新、核宽、导数项、偏航反馈与阈值增益等变体,均不及对象锚定 $k_p{=}3$。
展示智能体发现的奖励所处的调参景观,说明“进化找到的方案”在邻域内是稳健的局部最优。
三个复合任务的场景与验证器准则:支撑间搬移(从 0.3m 支撑抬起、转身搬运 2.9m 到 0.6m 支撑放下松手);叠两箱(抬 A 越过 B 顶、水平放下、终距 B 顶 0.25m 内);搬-放-踢(手推约 1m、松手、再踢 1.5m 至 3m 外标记,最后一次手接触后箱须再行进至少 1m 且末端距标记 0.3m 内)。
复合任务的精确定义,解释了为何“仅搬运库”对堆叠/踢任务几乎无帮助——接触模式覆盖决定复用。