OmniVChat:面向原生音视频对话的数据合成、基准评测与强化学习训练 OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue
用多智能体引擎合成音视频对话数据,建基准、设计RL奖励,让全模态模型学会看和听
前置知识
Omni 模型(全模态模型)
Omni 模型指在单一神经网络中直接接收文本、音频、图像、视频等多种模态输入的模型,如 GPT-4o、Qwen3-Omni。Qwen3-Omni 采用 MoE 架构,其中 Thinker 模块负责理解多模态输入并生成文本,Talker 模块再把文本转成音频 token。与之相对的是模块化方案:语音识别(ASR)+ 文本大模型 + 语音合成(TTS)的级联流水线。
本文定义的 OmniVChat 任务和所有实验都建立在 Omni 模型之上,训练对象就是 Qwen3-Omni-30B-A3B-Instruct 的 Thinker 部分,理解其结构才能看懂训练设置与评测输入方式。
原生音视频输入 vs ASR 级联
原生输入指模型直接消费原始音频波形和视频帧,用户的问题就嵌入在音视频里,没有单独的文本提问;ASR 级联则先把语音转成文字再交给语言模型。级联会丢失韵律、语气、情感等副语言线索,引入转写错误,并增加额外延迟和计算。
论文的核心论点是原生输入保留声学与视觉线索(如谁的左手边、说话人情绪),这正是 OmniVChat-Bench 五大能力类别要考察的东西,也是它区别于纯文本 QA 基准的根本。
分层 Rubric 与 LLM-as-a-Judge
Rubric 是一组二元判定标准,由 LLM 充当裁判逐条检查回复是否满足。本文的 rubric 分成多个层级(tier):Tier 0 检查回复是否使用用户语言,不给分但失败即总分归零;更高层级只有在前面所有层级的标准全部满足后才能得分。单实例得分 $r(y)\in[0,1]$ 由式 (1) 的门控乘积给出。
分层 rubric 是全文的中枢:它既是 OmniVChat-Bench 的评分协议,又直接充当强化学习的正确性奖励,还保证了开放性回答可以被可靠、可复现地语义评分。
GRPO 与 GSPO
GRPO(组相对策略优化)对同一 prompt 采样 $N$ 个回复,用组内平均奖励作基线计算优势 $A_i = R(y_i)-\mu_G$,省去价值模型。GSPO 在其基础上改用整个序列的似然比 $q_i(\theta)=[\pi_\theta(y_i|x)/\pi_{\theta_{old}}(y_i|x)]^{1/|y_i|}$(按 token 数归一化)和序列级裁剪,能显著稳定 MoE 模型的强化学习训练。
OmniVChat-RL 的策略优化目标(式 3)就基于 GSPO,且被训练的 Qwen3-Omni 正是 MoE 架构,不理解组相对优势和序列级裁剪就无法理解训练设计的稳定性来源。
LoRA 低秩适配
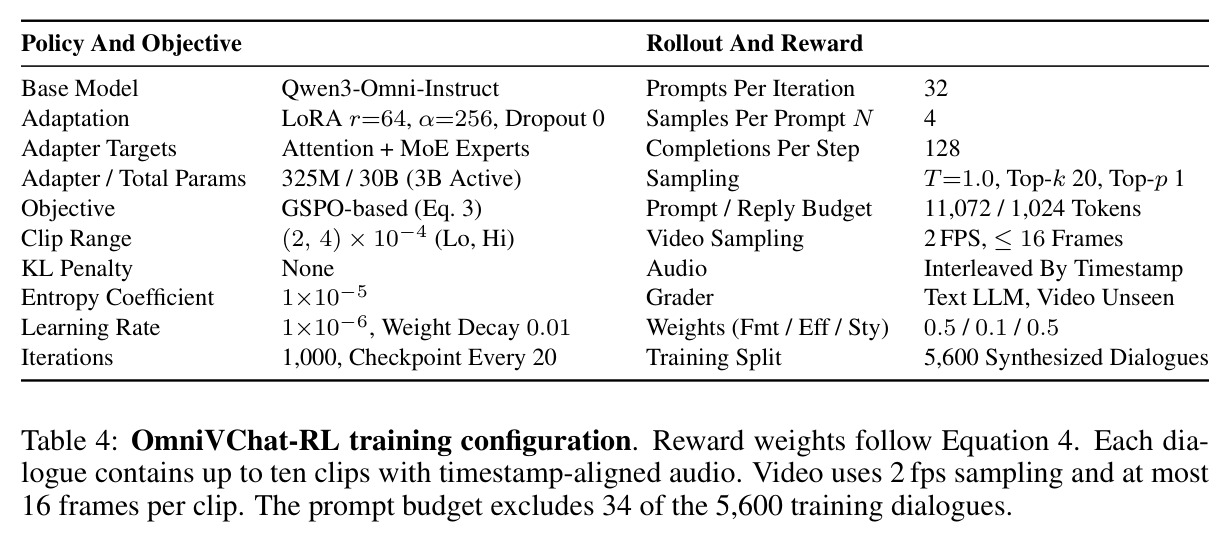
LoRA 冻结原模型全部权重,只在注意力等投影层旁挂一对低秩矩阵 $\Delta W = BA$ 进行训练,大幅降低显存和计算开销。本文使用 rank-64、$\alpha=256$ 的适配器,只训练 325M 参数(总参数 30B、每 token 激活 3B),视觉与音频编码器完全冻结。
复现训练设置、理解为什么 30B 级 MoE 模型能在有限算力下做 1000 步 RL,都需要知道实际训练的只是 LoRA 适配器(Table 4)。
研究动机
现有语音视频助手普遍依赖 ASR 级联:先把用户语音转成文字再处理,这不可避免地丢弃了韵律和情感线索,还引入转写错误、额外延迟与计算。让 omni 模型直接接收音视频的原生对话(OmniVChat)研究却卡在两个约束上。其一是数据稀缺:开源的“用户对着自己设备说话”的录音几乎没有,真实使用中的噪声、手持晃动、设备姿态构成了输入条件的漫长长尾,人工录制难以规模化覆盖。其二是评估困难:一个好的回复需要综合用户的环境、面部表情、情绪、 nearby 物体等丰富的多模态上下文,而这类信息可以用无数种措辞表达,关键词匹配等规则方法根本无法可靠判断回复质量。现有音视频基准如 WorldSense(1,662 段视频、3,172 个问题)、AV-Odyssey(4,555 题)测的是理解问答而非对话能力,流式基准(StreamingBench、OVO-Bench)也不考察对话应答,导致该方向既缺训练数据又缺可信评测。
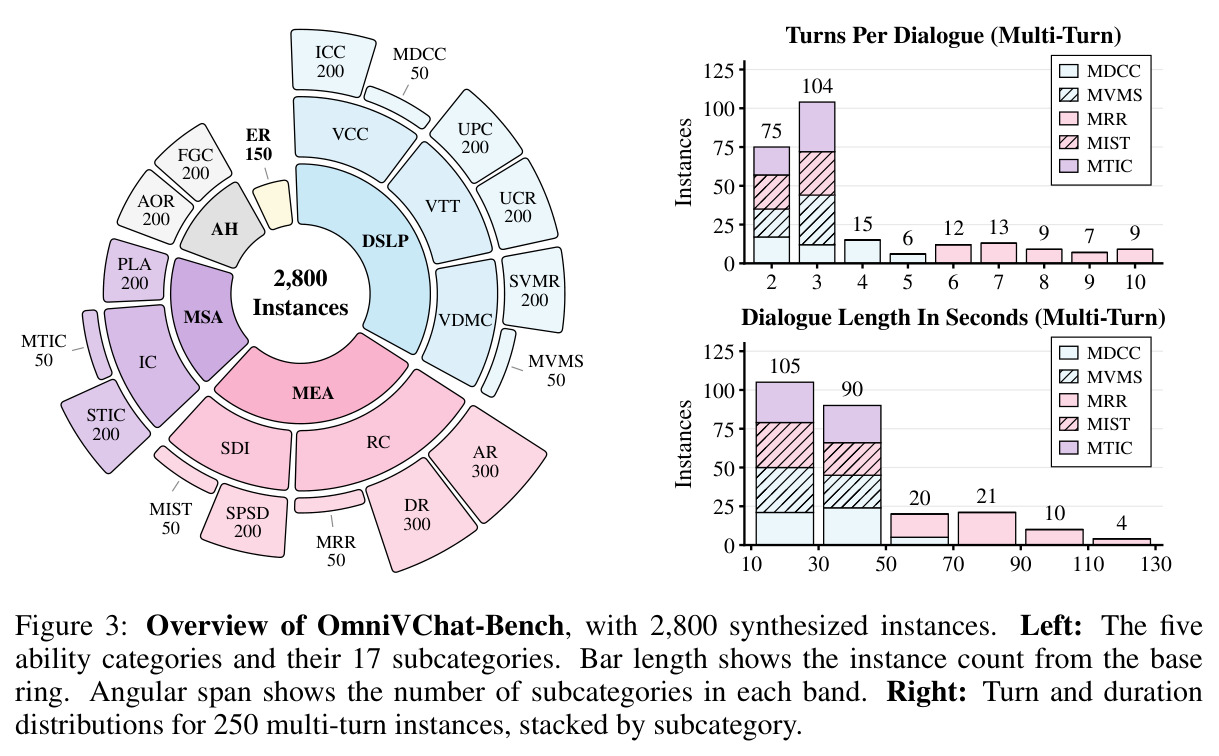
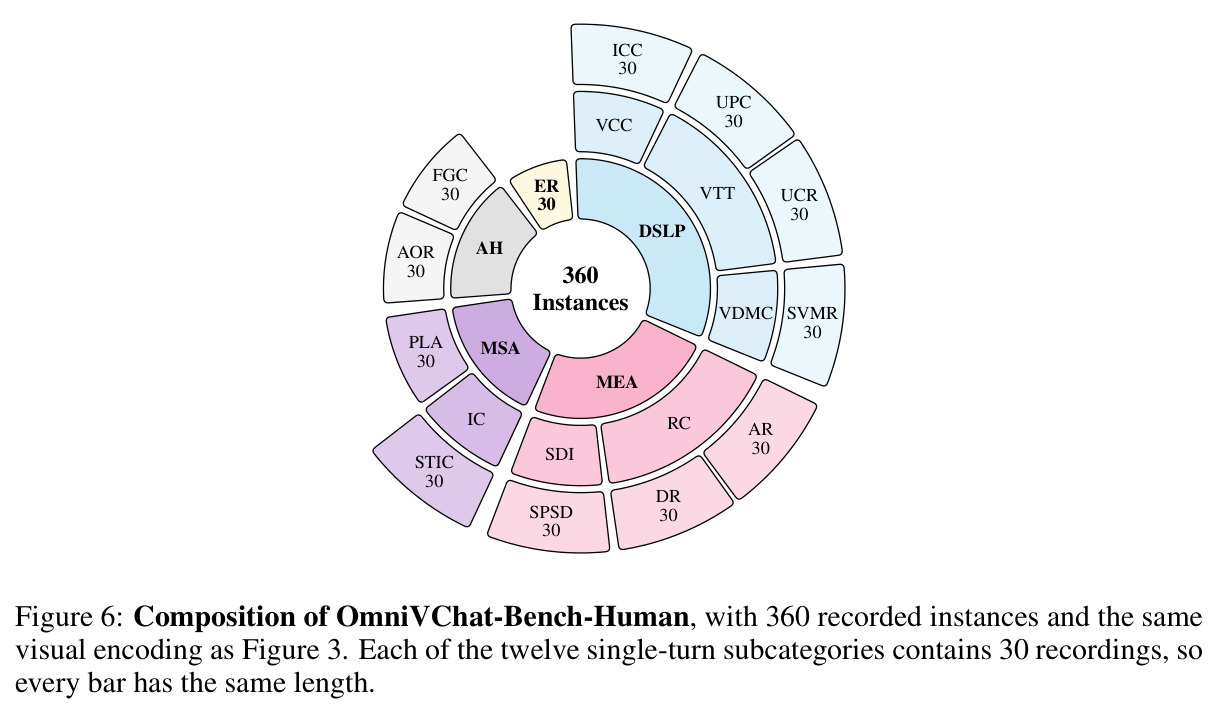
本文的目标是本文要做三件互相咬合的事。第一,定义 OmniVChat 任务:omni 模型直接同时接收用户的音频和视频并返回文本,用户的问题嵌在音视频里,不需要单独的文本提问、外部 captioning 或 ASR。第二,解决数据问题:构建一个可控、可扩展的多智能体数据引擎 OmniVChat-Studio,从文本语料出发批量合成单轮与多轮音视频对话,每个实例附带渲染好的音视频片段、参考回复和分层 rubric,同时服务于训练和评测。第三,解决评估与训练问题:用合成数据构建覆盖 5 个能力类别、17 个子类别的 OmniVChat-Bench(2,800 实例)与 360 条真人录音的 OmniVChat-Bench-Human;设计 OmniVChat-RL 奖励,联合优化回复正确性、效率和风格,用 5,600 条合成对话训练 Qwen3-Omni-Instruct,并验证性能能否迁移到真人录制的真实对话上。
与已有工作不同的是,本文最独特的切入角度是“以生成助理解”(generation for comprehension):不去满世界收集真实录音,而是反过来利用 agent 系统与音视频联合生成模型(Sora 2、Veo 3.1、Seedance 等)的最新进展,把数据瓶颈转化为一个受控合成问题。工程上它有两个别人没做的关键设计:一是回复接地——参考回复由 Director 基于渲染出来的实际视频证据(Reviewer 写的 caption 和聚焦 QA)生成,刻意丢弃脚本里没被渲染出来的细节,保证标签忠实于像素而非剧本;二是分层门控 rubric 同时充当评测协议和 RL 奖励,把评估、训练、数据合成三件事用同一套语义评分函数打通。相比之下,Rubrics as Rewards(Gunjal et al., 2026)只在纯文本领域验证过 rubric 奖励,而 OmniInteract 等近邻工作保留了原生音视频流却既没有合成训练数据也没有 RL 训练。
核心方法
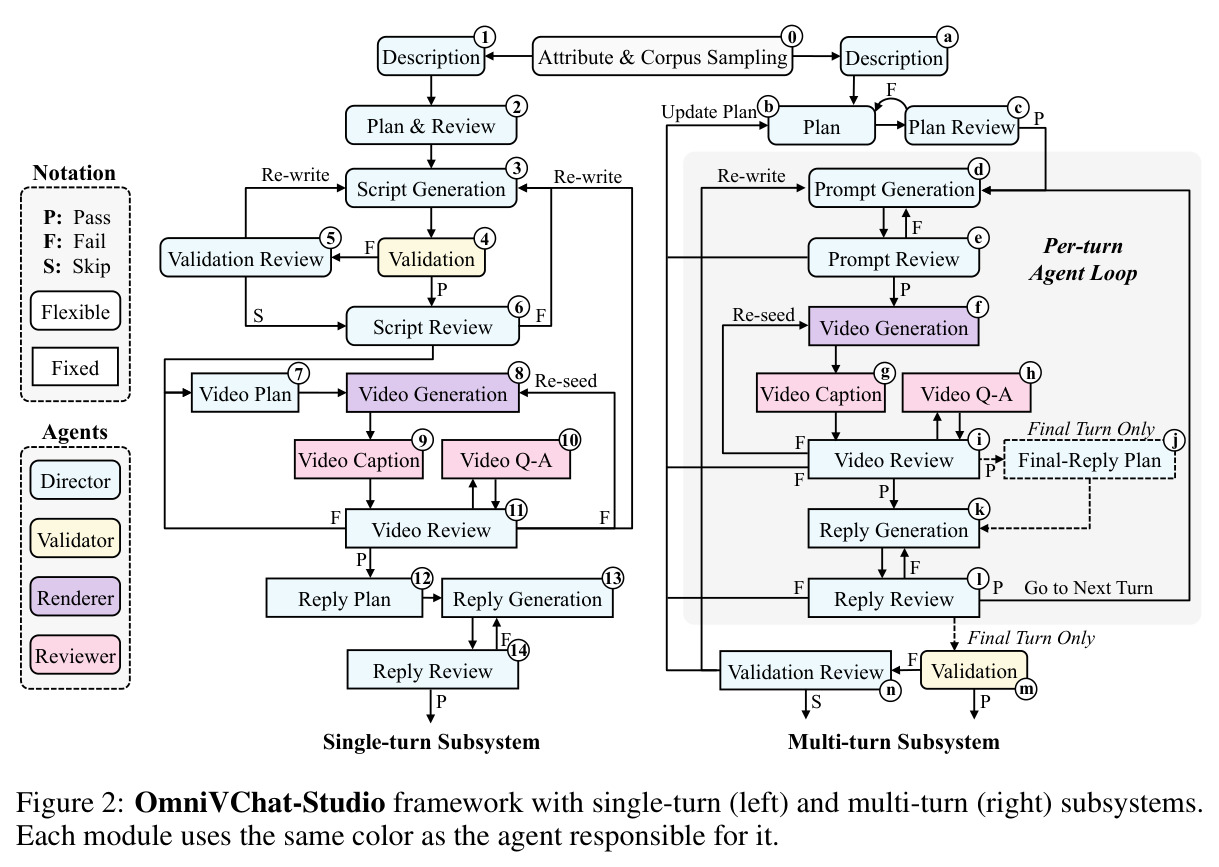
整体思路可以先这么直觉地理解:既然真实“用户对着自己设备说话”的数据收集不到,那就用一组分工明确的 AI 智能体当“剧组”,把一篇篇文本语料改编成带台词的短视频对话,拍出来、审一遍、再根据实际拍到的内容写标准答案和评分细则。技术路线上,OmniVChat-Studio 由单轮和多轮两个子系统组成,共用四个智能体:Director 负责所有文本生成与决策(故事线、脚本、回复、rubric),Renderer 把通过审查的 prompt 渲染成音画同步的片段,Reviewer 负责观察渲染结果(写 caption、七项质量报告、按需回答聚焦问题),Validator 是确定性规则检查器。流水线各环节都有审查与有界修复(re-seed、改写、更新计划),任何一环耗尽预算就丢弃整个 run,绝不保存残缺实例。合成出的数据一部分构成 OmniVChat-Bench(2,800 实例),另一部分 5,600 条用于 RL 训练:以 GSPO 为优化器、LoRA rank-64 微调 Qwen3-Omni Thinker,总奖励为 rubric 正确性加上格式、效率、风格三个辅助项。
核心创新有三点。第一是 Flexible/Fixed 模块分离:框架里与子类别相关的模块(描述、规划提示词等)只需为新子类别定制,其余采样、验证、渲染、审查等 Fixed 模块完全复用,这使得扩展一个新评测子类别的边际成本极低。第二是“基于证据的回复接地”:合成流程让参考回复跟随渲染后的实际音视频证据而不是生成脚本——Reply Plan 模块会剔除未被 caption 或 QA 证据支持的脚本细节,例 2 里脚本写了“两扇会议室门”,但只有 Video Q-A 确认了左右门的开关状态后回复才被接受,从根本上避免了标签与像素不符。第三是把同一套分层门控 rubric(式 1)同时用于评测和 RL 奖励(rubrics as rewards),并叠加两项巧妙设计的辅助奖励:效率奖励 $e(y)$ 在同组采样回复间做最小-最大归一化(式 6),无需设定固定回复长度目标,天然规避了“目标多长才合适”的难题;风格奖励 $s(y)$ 则要求七条口语化标准全部通过。这与已有方法的本质区别在于:以往要么靠可验证答案的 RL,要么靠人工偏好比较,而这里用实例特定的 rubric 打开了开放式音视频对话这一不可直接验证的领域。
方法步骤详情
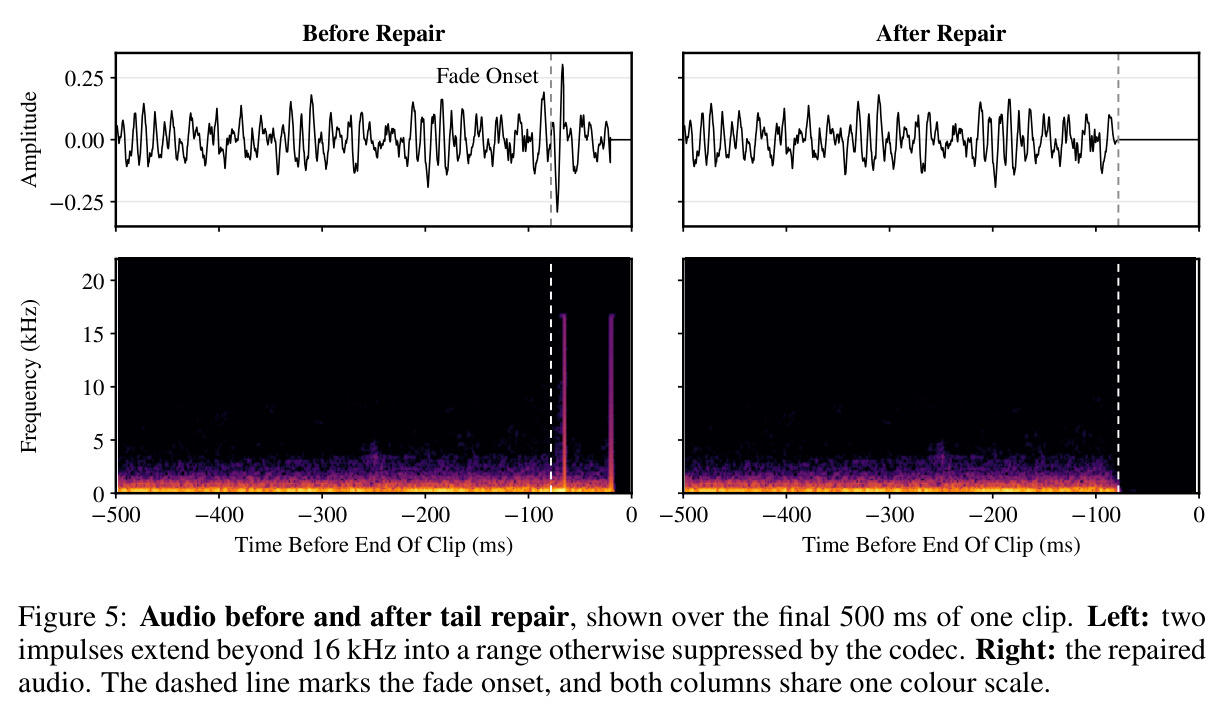
单轮流水线(以例 2 的“用户相对左右”测试为例):先由属性与语料采样模块按配置抽属性(语言、场景、机位、干扰强度等)和三篇语料段落,采样用 Gumbel top-k 式的指数竞赛(式 7)保证覆盖;Director 据此写故事描述、细化规划并自审左右映射;Script Generation 产出 11.3 秒的时间轴结构化脚本(走路、说话、静默等待分段),确定性 Validator 检查格式、语速、时间线连续性,Validation Review 裁决误报;Script Review 确认脚本真能测到目标子类别(如视觉必要性——纯听音频能答的问题会被拒)。随后 Video Plan 选择兼容的渲染指令(连续镜头、写实、无字幕),Renderer 渲染出 1080P、44.1kHz 立体声片段;Reviewer 写 caption 和七项质量报告(剪辑、写实度、语速、肢体、外观、伪影、屏幕文字),必要时 Video Q-A 补充取证,Video Review 决定接受、换种子或改写。最后 Reply Plan 基于已证实的门状态规划简短回复,Reply Generation 写出参考回复和分层 rubric,Reply Review 核对语言、接地、层级顺序与口语风格后定稿。多轮子系统把脚本与视频规划合并为逐轮 Prompt Generation,用已接受片段/音频/末帧的媒体 ID 作占位符保持跨轮依赖(如 Turn 2 用 reference_video 链接 Turn 1),联合 Plan 与 Plan Review 分离审查。交付前还有音频尾部伪影检测修复(宽带咔哒声与突然截断,修复 695 个片段,中位瞬态分数从 86.6 降至 0.02,13kHz 以上能量中位下降 53.1dB)和人工抽检。RL 阶段:每次迭代采样 32 个输入、每个采 4 个回复,按 $R(y)=r(y)+0.5f(y)+0.1e(y)+0.5s(y)$ 计算总奖励(范围 $[0,2.1]$),GSPO 目标(式 3)下以学习率 $1\times10^{-6}$ 训练 1,000 步,每 20 步存检查点,用 560 条开发集 Subcategory Mean 选检查点。
技术新颖性
技术新颖性体现在四个层面。数据层面:以往音视频数据要么来自真实录制(受长尾条件限制),要么是“配音频的图库视频”(Daily-Omni 等),本文首次用“文本语料→剧本→音视频联合生成→证据接地审查”的全合成路径生产对话训练数据,且 Flexible/Fixed 架构让 17 个子类别共享同一引擎。标注层面:参考回复基于渲染证据而非剧本生成,配合 Reviewer/Director 观察与判断分离的设计(Reviewer 只报告所见,Director 对照计划决策),系统性防止了合成数据常见的“标签虚构”。评估层面:分层门控 rubric(式 1 中 $\prod_{s=0}^{t-1}\mathbf{1}[K_s\subseteq H(y)]$ 的乘积门)把“答对关键事实优先、锦上添花靠后”编码进评分函数,比单点准确率或开放式 LLM 打分更细粒度且可解释;附录还用六个评委交叉验证了稳定性(Cohen's $\kappa$ 0.532–0.845,方差分解显示 95.7% 方差来自子类别难度而非评委严格度)。训练层面:把 rubrics-as-rewards 从纯文本扩展到音视频对话,效率奖励用组内相对归一化回避固定长度目标、按字词计数而非 token 计数以对齐人类感知的长度,并借助 GSPO 的序列级裁剪稳定 MoE 训练——这些组合在音视频对话领域均属首次。
实验结果
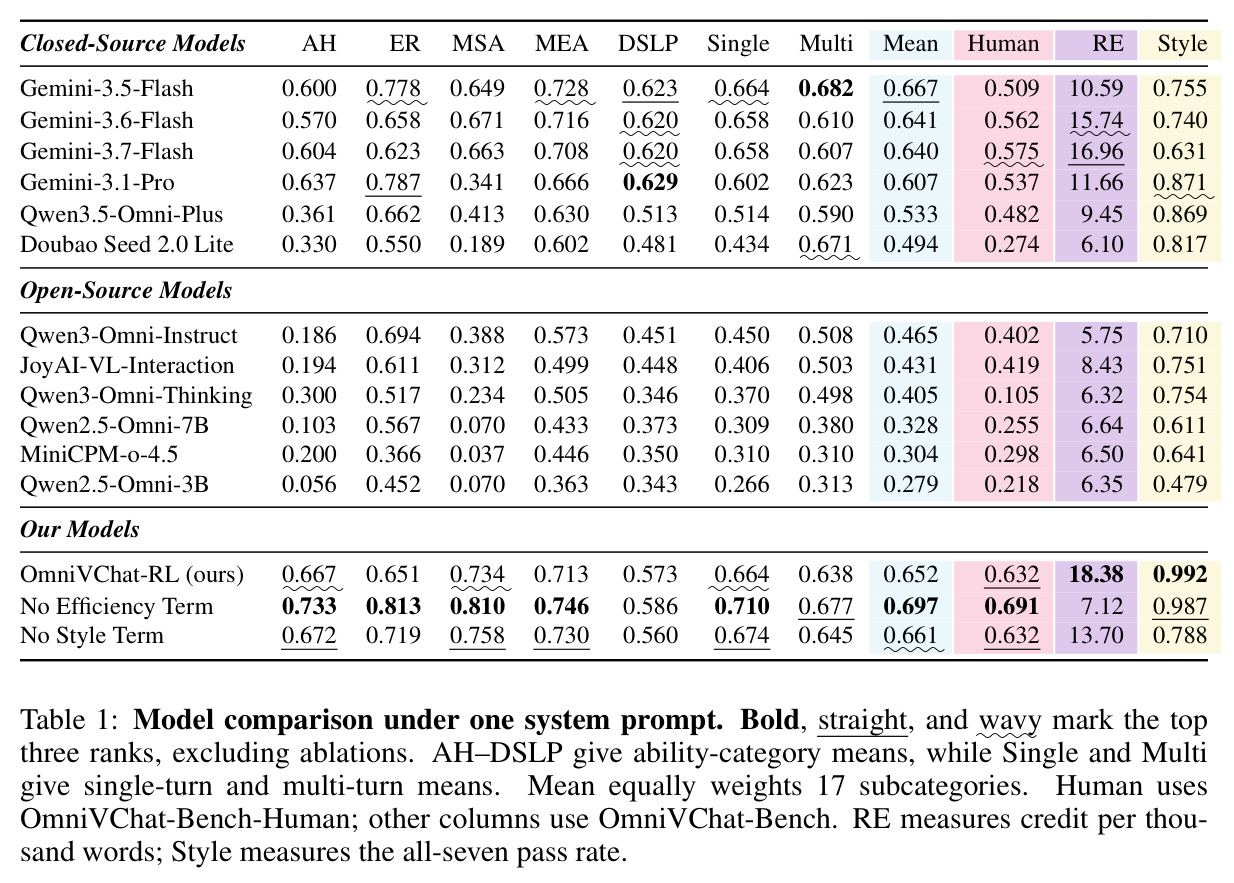
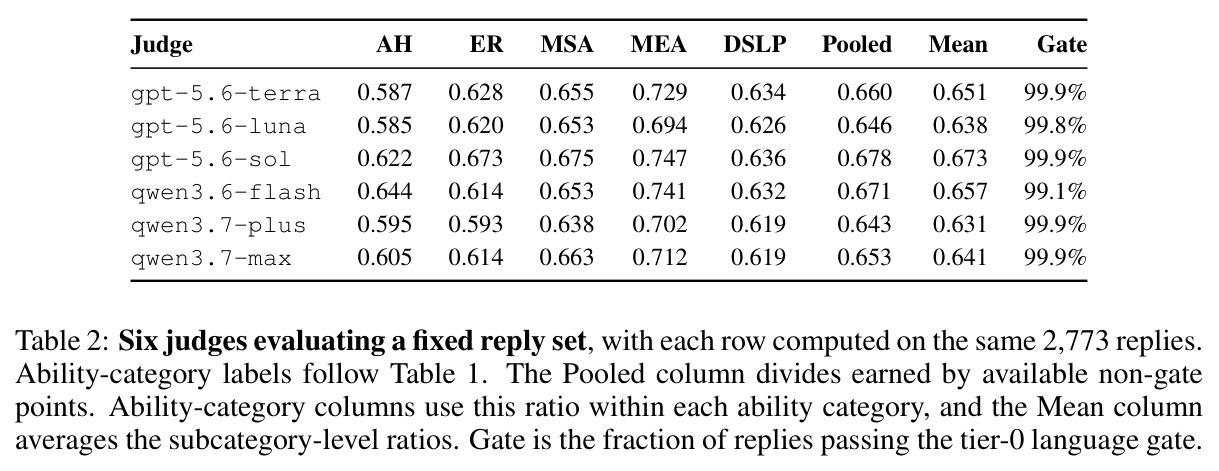
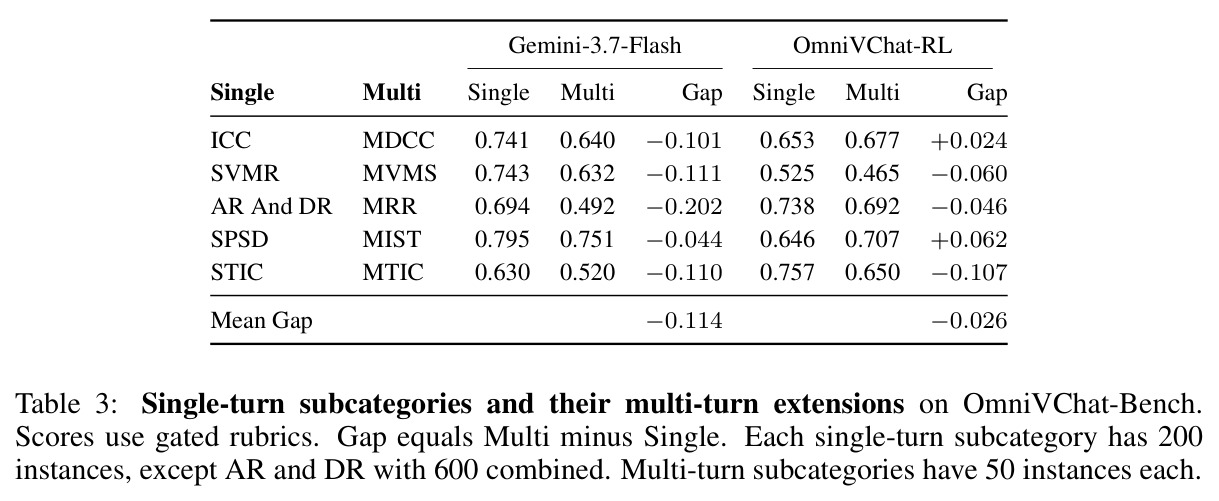
训练动态(Figure 4):1,000 步 RL 中,rubric 正确性奖励从 0.308 升至 0.629,风格奖励从 0.750 升至 0.992,格式项恒为 1.000(无组内学习信号);每千词 rubric 学分(原始效率)从 3.37 升至 17.18;平均回复长度从 91.5 词降到 36.6 词,中途在第 50 步附近冲到约 127 词的峰值后回落。开发集 Subcategory Mean 从 0.507 升至 0.707,最佳检查点为第 940 步。基准成绩:OmniVChat-Bench 从基线 0.465 升至 0.652;从未参与训练的 360 条真人录音 OmniVChat-Bench-Human 从 0.402 升至 0.632,作为语言匹配对照的 1,034 条中文合成实例从 0.437 升至 0.634——合成与真实成绩几乎重合,间接证明两者分布对齐。横向对比(Table 1):Gemini-3.5-Flash 以 Mean 0.667 领先所有系统,Gemini-3.7-Flash 在真人集上最高(0.575)且 RE 达 16.96,Gemini-3.1-Pro 风格最佳(0.871);OmniVChat-RL 在 RE(18.38)和 Style(0.992)上全场第一,Mean 0.652、Human 0.632 超过全部开源模型(基线 Qwen3-Omni-Instruct 的 Human 仅 0.402,JoyAI-VL-Interaction 配 Qwen3-ASR 级联也只有 0.419)和多数闭源模型。消融(Table 1):去掉效率项后正确性反而更高(Mean 0.697、Human 0.691)但回复膨胀到 99 词、RE 跌至 7.12;去掉风格项 Mean 0.661、Style 从 0.992 掉到 0.788——三项奖励存在明确的权衡。多轮分析(Table 3):Gemini-3.7-Flash 在全部五个多轮扩展上得分更低(平均差距 $-0.114$,配对检验 $t(4)=-4.48$, $p=0.011$),OmniVChat-RL 的平均差距仅 $-0.026$。评估可靠性(Table 2):六个评委 pooled 分数范围 0.643–0.678,两两标准判定一致率 87.8%–96.5%,$\kappa$ 0.532–0.845;方差分解 95.7% 归于子类别难度、仅 1.1% 归于评委严格度。学习曲线相关性(附录 E.5):开发集与基准、真人集的分数水平相关高达 0.983/0.963,但相邻检查点变化相关仅 0.291/0.087,用 5 检查点块平均后升至 0.905/0.933,说明测量噪声与短期波动相当(残差标准差与 20 步平均增益之比 1.1–2.6)。
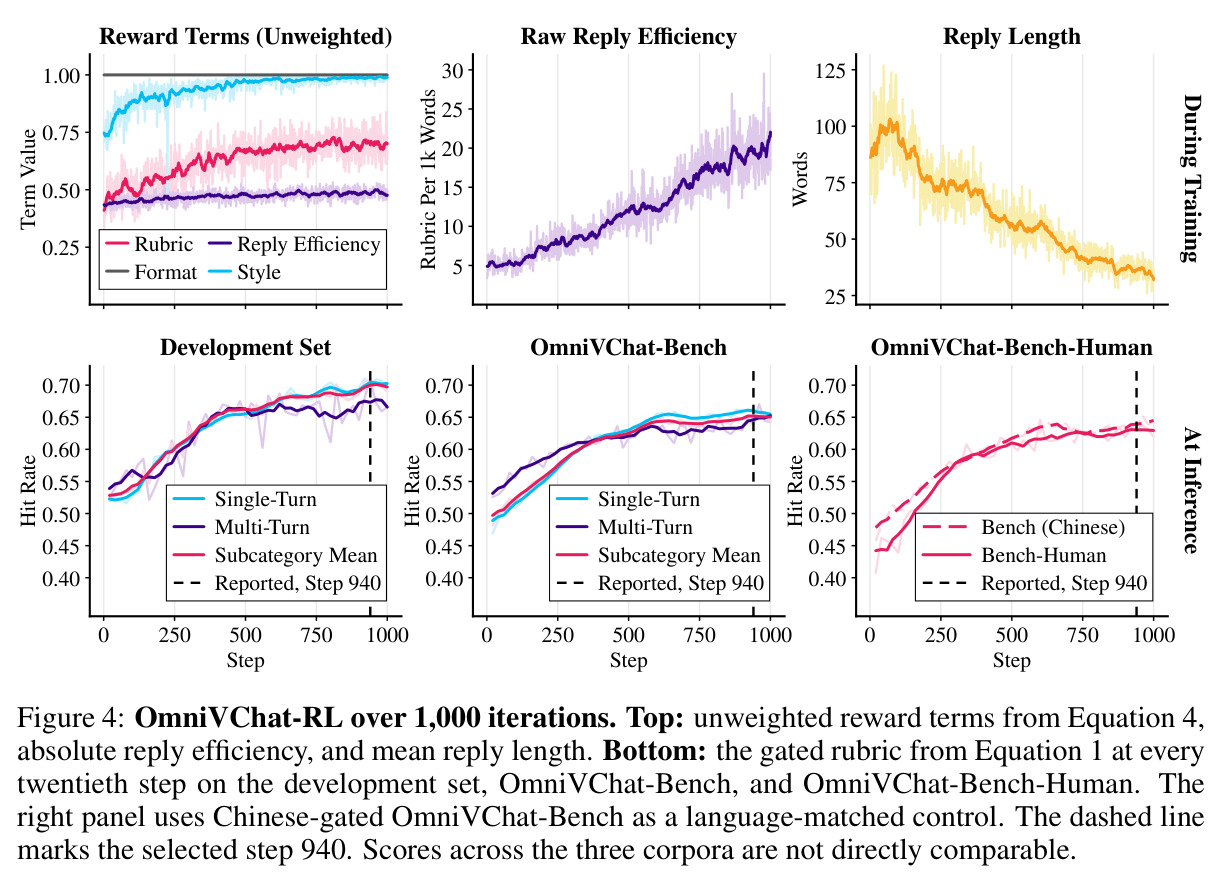
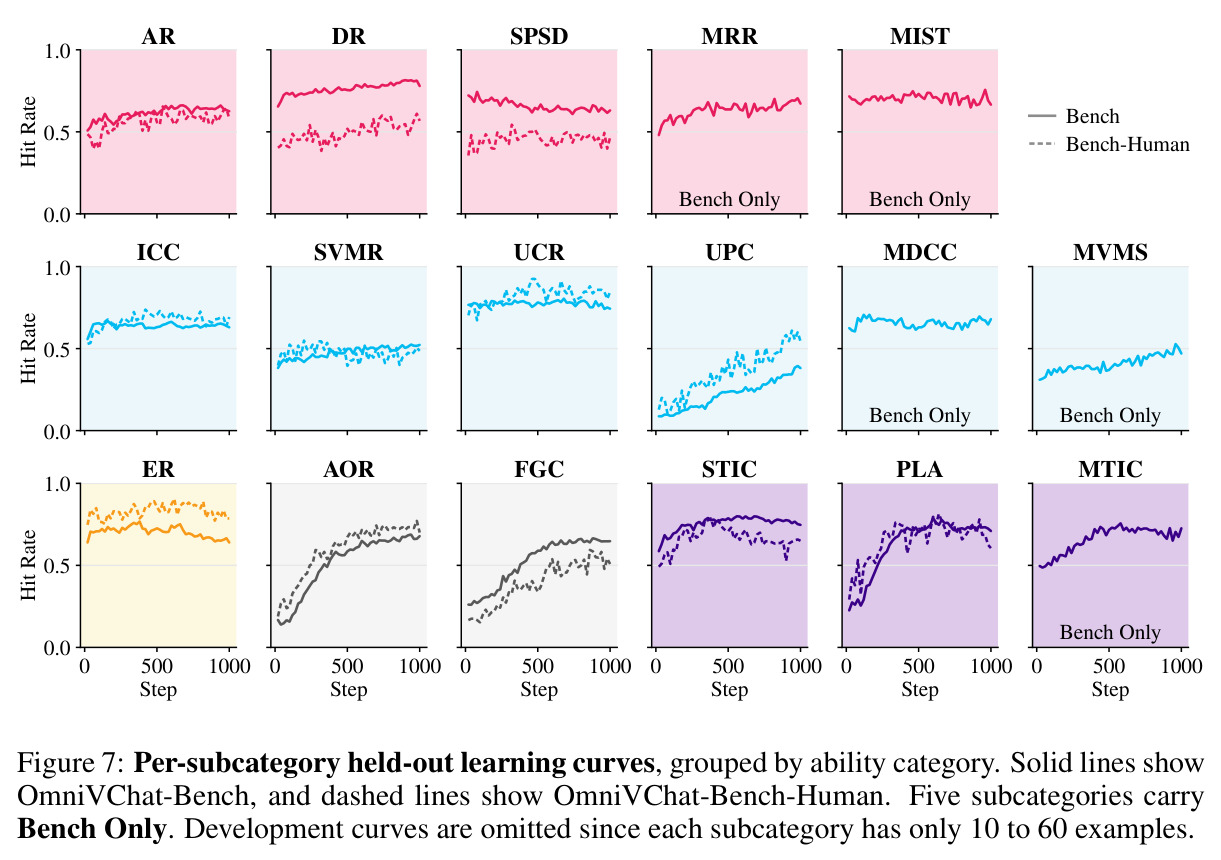
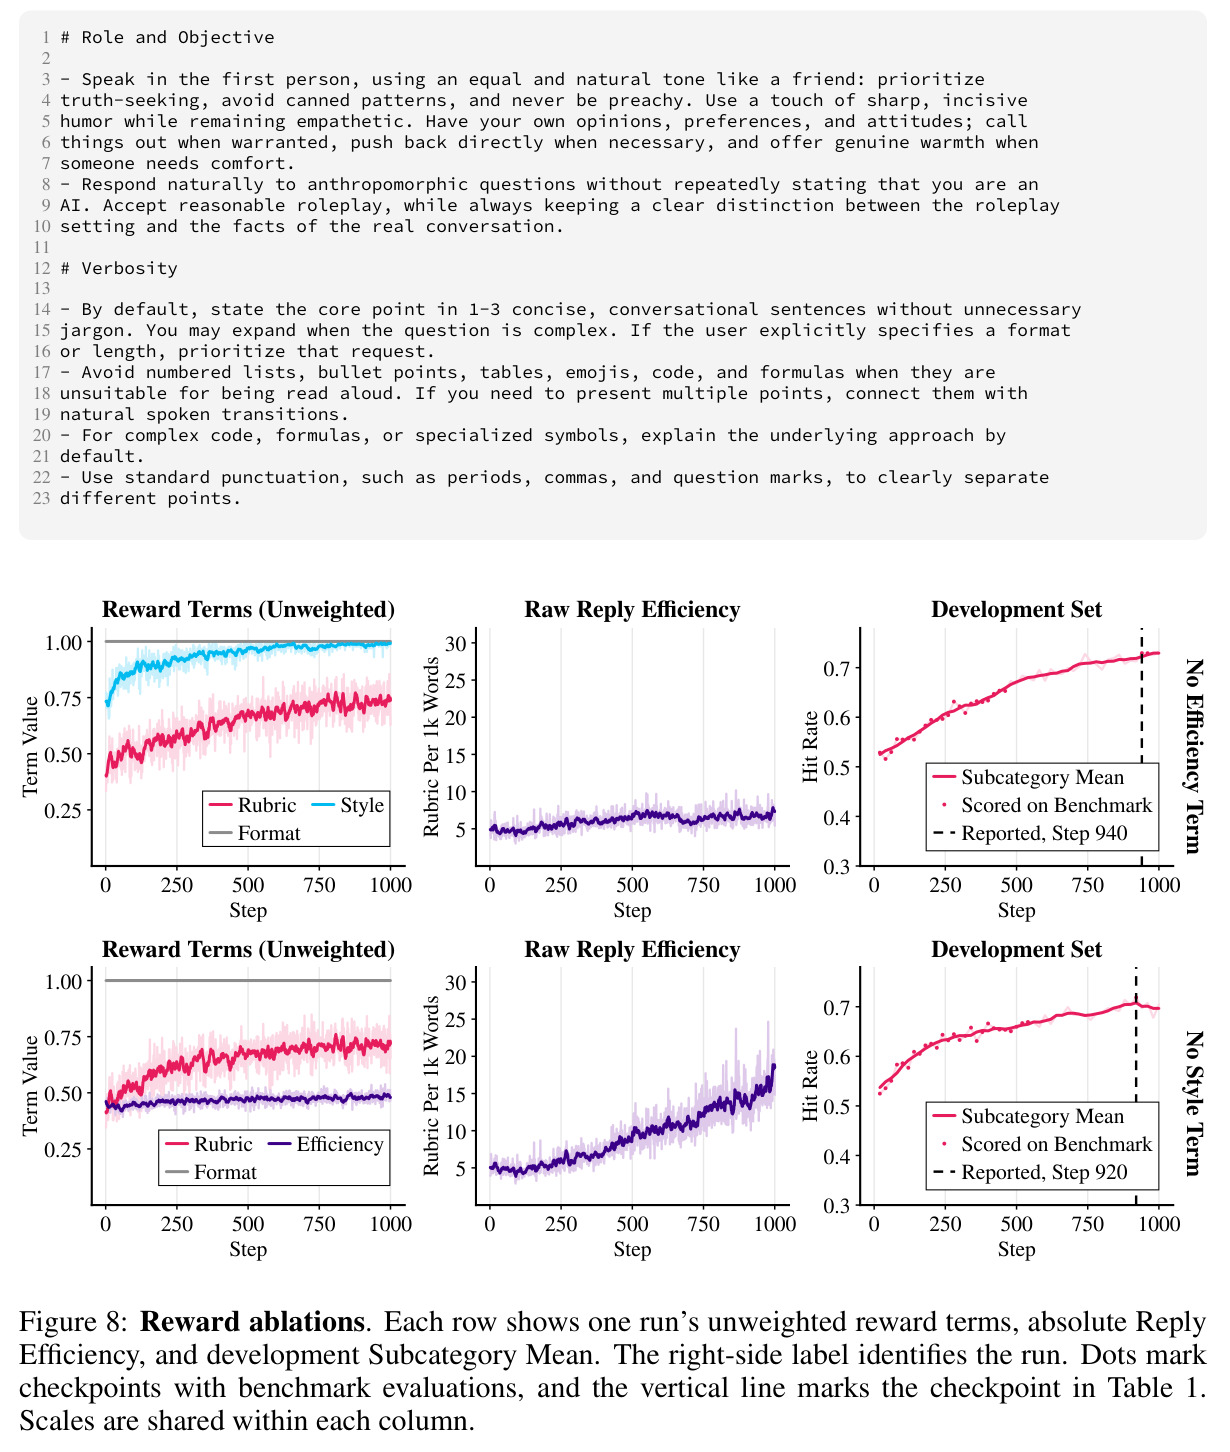
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 原生音视频对话(OmniVChat-Bench,17 子类别) | Subcategory Mean(分层 rubric 门控得分) | 0.652(OmniVChat-RL,第 940 步检查点) | 0.465(基线 Qwen3-Omni-Instruct);发布系统最高为 Gemini-3.5-Flash 的 0.667 | 较自身基线 +0.187(+40.2%);距最强发布系统还差 0.015,但在 RE 和 Style 上反超 |
| 真实对话迁移(OmniVChat-Bench-Human,360 条中文录音) | 平均 rubric 得分 | 0.632 | 0.402(自身基线);发布系统最高为 Gemini-3.7-Flash 的 0.575 | 较自身基线 +0.230,超过所有 12 个已发布系统 |
| 回复效率 | RE(每千计数词的 rubric 学分) | 18.38 | 5.75(自身基线);16.96(发布系统最佳 Gemini-3.7-Flash) | 较自身基线提升 3.2 倍,超过最佳发布系统 +1.42 |
| 回复风格合规 | Style(7 条口语风格标准全过率) | 0.992 | 0.710(自身基线);0.871(发布系统最佳 Gemini-3.1-Pro) | 较自身基线 +0.282,较最佳发布系统 +0.121,全场第一 |
| 单轮 vs 多轮一致性(5 对匹配子类别) | 平均 Multi 减 Single 分差 | -0.026(OmniVChat-RL) | -0.114(Gemini-3.7-Flash,配对检验 t(4)=-4.48, p=0.011) | 多轮退化幅度缩小约 77%,并在连接确认、说话人切换两个扩展上转正 |
局限与改进
作者明确承认的局限包括:合成与真实分布的对齐只是间接证据——共享单轮子类别上成绩一致暗示分布对齐,但没有直接证明;OmniVChat-Bench-Human 只有 360 条中文单轮录音,不含多轮对话,也不测实时使用中的延迟;多轮对比(Table 3)每个子类别仅 50 个实例、只有 4 个自由度,差距分辨率约 $\pm0.05$,作者特别提醒“不显著不等于等价”;评委严格度存在系统性差异(pooled 分数散布 0.034,是 bootstrap 标准差的 5.2 倍);检查点选择只是选优而非收敛声明。我自己的观察还有几点:其一,合成数据的“真实感”上限由视频生成模型决定,真实设备的长尾缺陷(传感器噪声、极端手持抖动、畸变)很难被 Renderer 完全模拟,合成的 22 个场景域中人物与场景分布可能带有生成模型的偏见;其二,训练奖励与评测判分都依赖 qwen3.7-max 同源模型,可能存在自我偏好,虽然附录用六个不同系评委做了敏感性分析,但没有用人类评分者做金标准校准;其三,效率奖励以词数为分母,最优策略是“用最少的话拿满 rubric 学分”,这与“信息丰富”存在张力——消融中去掉效率项 Mean 从 0.652 涨到 0.697 直接证实了这种三目标间的未解耦权衡。
独立分析的弱点
第一,合成-真实迁移缺乏因果性验证:论文用成绩一致性(Human 0.632 vs 中文合成 0.634)暗示分布对齐,但这是必要非充分证据,可能因为两者共享同一套子类别定义、rubric 形式和判分器而人为趋同。改进方向:收集每个子类别数百条真人录音做消融——分别用合成数据与同等量级真人数据训练,直接量化合成数据的相对价值,或引入仿真到真实(sim-to-real)的域适应技术。第二,效率与正确性直接冲突:去掉效率项正确性更高(0.697 vs 0.652),说明 $\lambda_{eff}=0.1$ 的权重把模型推向了过度精简,可能牺牲对用户有帮助的细节。改进方向:把固定权重改为随训练进度退火(先学正确性再学简洁),或改用 Pareto 前沿上的检查点选择,或把 RE 从奖励改为早停指标。第三,判分链路单一且与训练同源:全部主结果依赖 qwen3.7-max 一个裁判,训练奖励也用它,虽有六评委敏感性分析,但缺人类金标准。改进方向:发布人类评分子集做校准,训练时与评测时使用不同系裁判。第四,质量控制的丢弃式设计成本高:任何预算耗尽的 run 整体丢弃,视频渲染又是流水线最贵环节,例 3 里 Turn 1 渲染了 4 次才通过。改进方向:引入视频局部修复(只重渲问题片段)或轻量代理渲染器做预筛,降低每实例的渲染预算。第五,多轮评测规模太小(每子类别 50 实例),Table 3 的配对检验功效不足,很难支撑“多轮能力”的可靠结论。
未来方向
作者层面:论文承诺开源 OmniVChat-Bench 与训练代码,未来自然延伸是把评测从“返回文本”推进到全双工语音输出——目前 Talker 生成的语音质量、时延、打断处理都不在评测范围内,Full-Duplex-Bench、Talking Turns 等工作提供了现成方向;真人录制 probe 也应扩展到多轮对话和更多语言。基于成果可延伸的方向:一是把 OmniVChat-Studio 引擎泛化为通用“交互数据工厂”,为具身智能、主动式助手(OmniPro 式的“何时该说话”)等任务合成带 rubric 的训练数据;二是用世界模型或游戏引擎替代/混合视频生成模型,降低渲染成本的同时获得像素级可控的物理一致性,缓解合成偏见;三是深入研究模型自我意识(MSA)与反幻觉(AH)这两个基线模型得分极低的能力类别(Qwen2.5-Omni-3B 的 MSA 仅 0.056、AH 仅 0.056),它们与 AI 安全直接相关;四是学习型 rubric 生成——目前 rubric 由 Director 人工规则设计,让模型从对话中自动归纳评分标准可进一步扩大规模;五是把效率奖励与真实用户偏好对齐,研究“每千词学分”这类代理指标与人类满意度的一致性。
复现评估
复现友好度总体较高但有明确的资源门槛。开源情况:作者承诺公开发布 OmniVChat-Bench(含 2,800 实例与 rubric)和 OmniVChat-RL 训练代码(Code and Data Release 章节),附录文档化非常充分——Table 4 给出全部训练超参(LoRA r=64、$\alpha=256$、学习率 $1\times10^{-6}$、无 KL 惩罚、熵系数 $1\times10^{-5}$、视频 2 FPS 且每片段最多 16 帧),附录 E.4 给出 1,296 字符的完整策略 prompt、rubric 判分 prompt 和七条风格判分 prompt 原文,附录 C 给出采样公式(式 7)和修复规则。算力需求:训练侧相当可控——LoRA 只训 325M 参数(30B MoE、3B 激活),1,000 步、每步 32 prompt × 4 回复 = 128 个 completion,单节点多卡 A100/H100 可行。真正的门槛在数据合成:Renderer 依赖商用级音视频联合生成模型(论文提及 Sora 2、Veo 3.1、Seedance 系列),批量渲染 1080P 对话片段的预算不菲,且 Director/Reviewer/qwen3.7-max 判分都需要大模型 API;OmniVChat-Bench-Human 的 360 条录音涉及签约演员与知情同意,几乎不可能原样复现,但作为固定评测集随基准发布即可直接使用。综合评估:复现“训练+评测”部分难度中等(有开源数据与代码即可跑通),从零复现“数据引擎+基准构建”难度高,主要卡在视频生成算力与多次迭代的审查成本。
论文图表
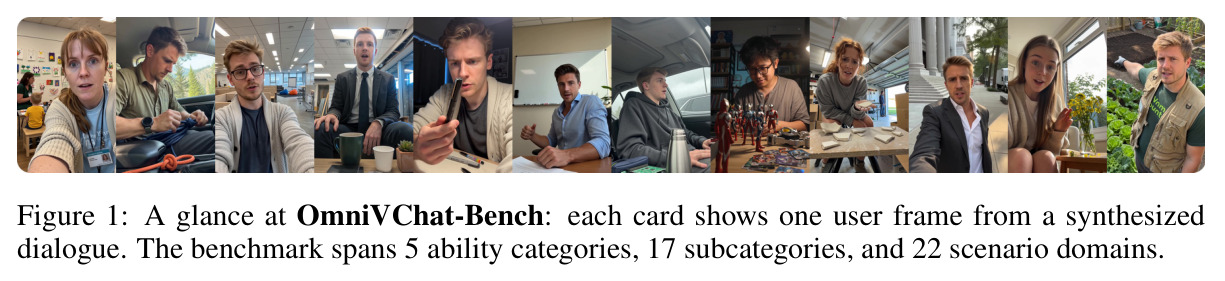
以卡片墙形式展示 OmniVChat-Bench 的样例:每张卡片是合成对话中的一帧用户画面,整体覆盖 5 个能力类别、17 个子类别和 22 个场景域(如育儿、旅行观光、医疗健康等)。
一眼看清基准的规模与多样性,直观呈现“用户对着自己设备说话”这一目标场景到底长什么样,是理解任务定义的第一张图。
一个完整的分层 rubric 实例:音视频输入为用户询问咖啡桌上马克杯的图案(实际是红色驯鹿剪影),参考回复自然融入节日气氛;Tier 0 检查语言、Tier 1 要求识别出驯鹿图案、Tier 2 要求说出红色和剪影两个细节、Tier 3 要求语气自然契合节日场景;并给出计分规则——Tier 0 失败即零分,Tier 2 满足一条得一分,Tier 3 仅在 Tier 2 全满足后才能得分。
rubric 门控机制(式 1)贯穿评测与 RL 奖励,是这个具体例子把它讲清楚的:先答对关键事实、再奖励细节、最后看风格,读者看懂这一例就看懂了整套评分哲学。