科学乌托邦?学术研究生态系统的闭环大语言模型模拟 Science Utopia? Closed-Loop LLM Simulation of Academic Research Ecosystems
SUTO用LLM智能体闭环模拟4万研究者的学术生态,量化拒稿、资助与探索策略的十年效应
前置知识
LLM 智能体模拟
用大语言模型驱动的智能体扮演社会角色(研究者、审稿人、资助机构等),在模拟环境中依据自然语言指令做决策并交互,产生群体层面的涌现行为。与基于硬编码规则的经典智能体模型(ABM)相比,LLM 智能体能完成撰写论文、撰写审稿意见这类需要语言生成能力的任务,行为更灵活、更接近人类。本文让 40,000 多个 LLM 研究者智能体在 61 个模拟世界里连续决策十年。
本文的方法论基础就是把学术生态当作 LLM 智能体系统来模拟,理解智能体的状态设计、记忆与反馈回路是读懂框架的前提。
匹配反事实实验
从完全相同的初始条件(同一批研究者、机构、会议与设置)出发,只改变一个制度机制(如录用率、每项目投稿上限、是否披露作者身份),对比多个'平行世界'的长期结果差异。由于其他一切相同,结果差异可归因于被干预的机制。这是社会科学因果推断的理想化设计,真实学术界几乎无法实施。
本文所有结论都来自匹配反事实实验,理解'控制变量、单机制干预'的逻辑才能正确解读各实验组与基线的对比。
累积优势(马太效应)
指早期获得微小优势的个体(早期拿到资助、早期发表高引论文)在正反馈机制下不断积累更多资源、声誉与机会,导致'富者愈富'的分层现象。在科学学中它是解释资助与引用不平等自我强化的核心理论,检验它需要追踪个体多年的纵向数据。
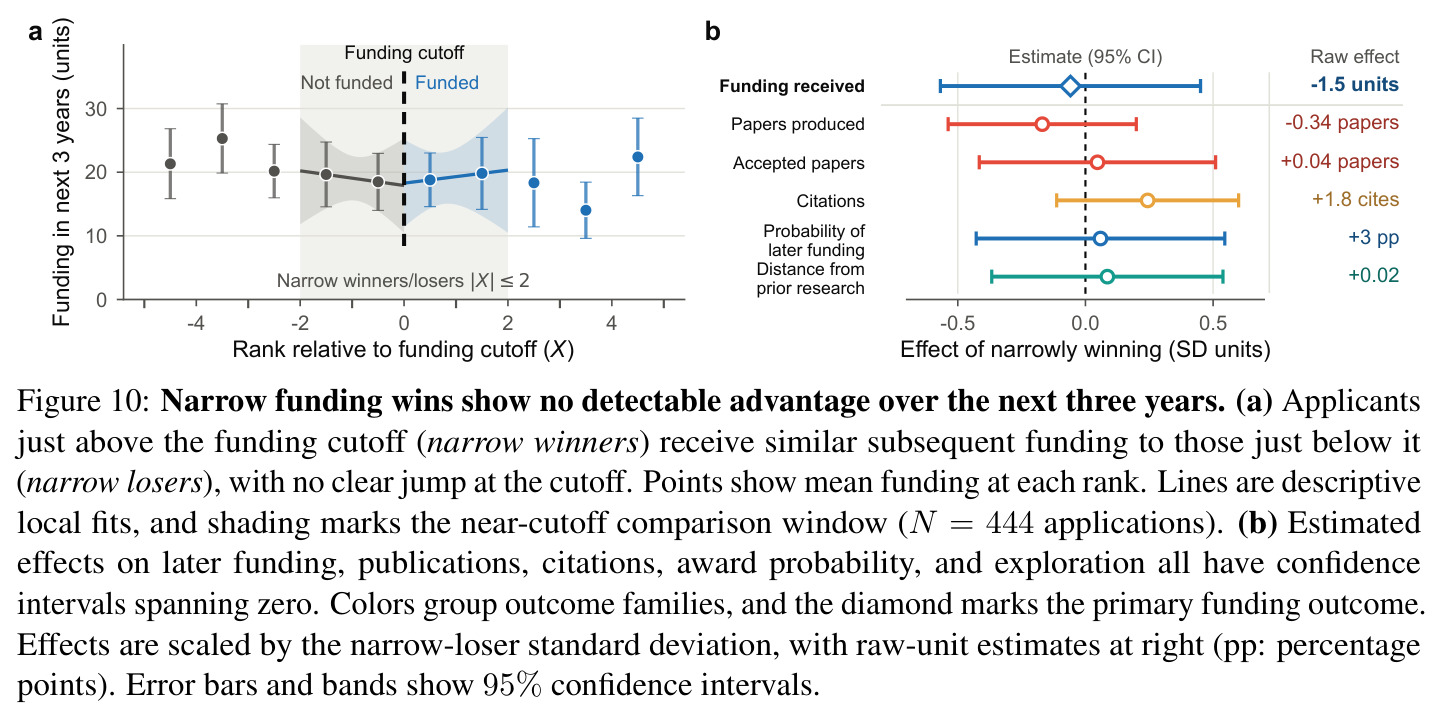
论文的核心问题之一是:在模拟生态中险胜赢得早期资助是否带来持续的职业优势,以及资源不平等如何内生涌现。
CD 颠覆性指数
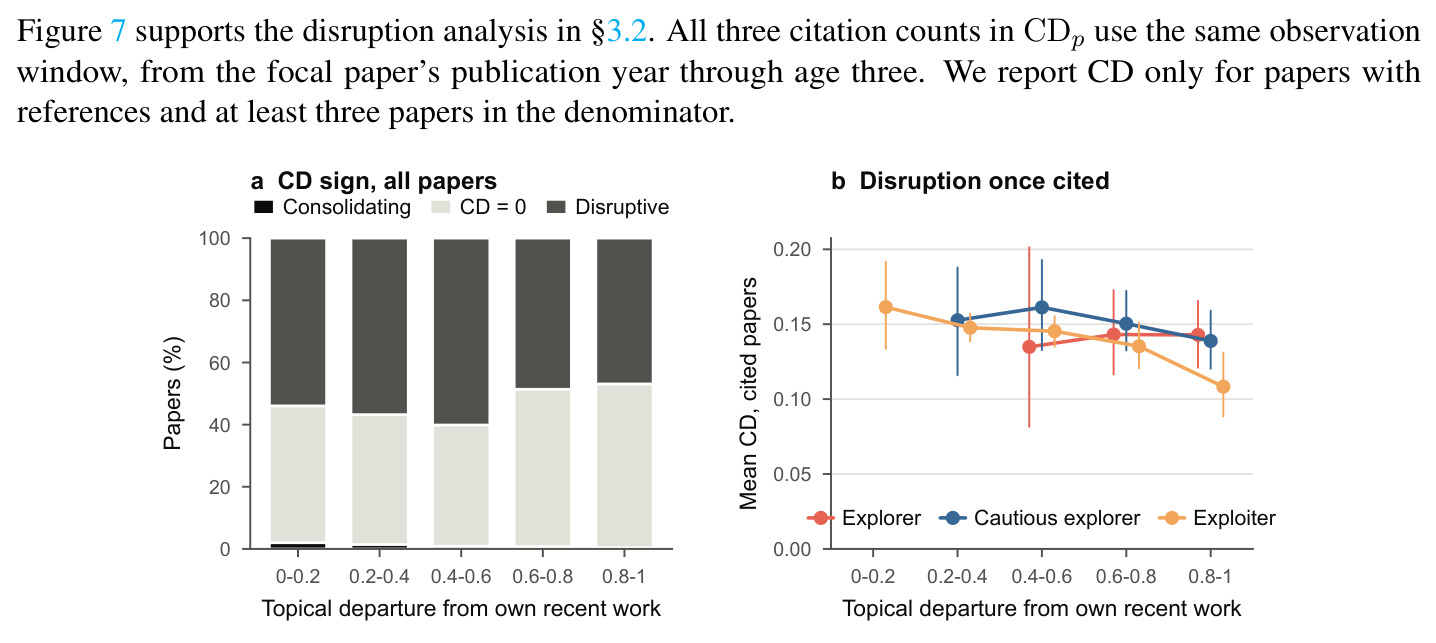
衡量一篇论文是'颠覆'还是'巩固'了后续研究:$CD_p = \frac{n_{focal}-n_{both}}{n_{focal}+n_{both}+n_{prior}}$,其中 $n_{focal}$ 是只引用该论文、不引用其参考文献的后续论文数,$n_{both}$ 是两者都引用的数量,$n_{prior}$ 是只引用参考文献的数量。正值说明后续工作绕过前人直接建立在该论文上(颠覆),负值说明论文与前人被一起引用(巩固)。
论文用它回答'改变自己的研究方向是否等于改变领域方向'这一关键问题,是解读 §3.2 颠覆性分析的必备工具。
基尼系数
衡量资源分配不平等的标准指标,取值 0 表示完全平均、1 表示完全不平均,广泛用于收入分配研究;科学学中用来量化资助经费、引用量在研究者间的集中程度。本文用它追踪模拟世界中资助资源与引用的分层随时间的演化。
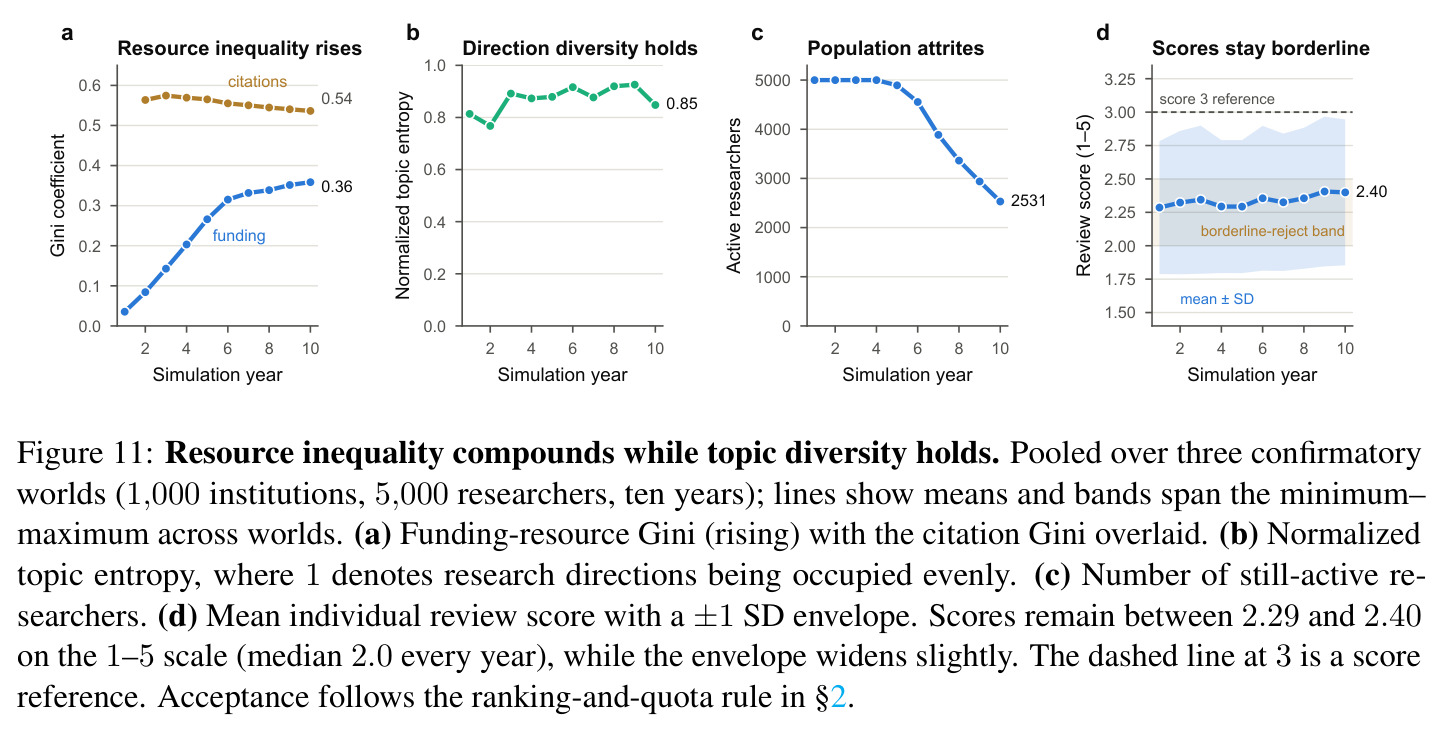
论文发现模拟世界的资助 Gini 从初始约 0.04 涨到第十年约 0.36,这是'资源分层内生涌现'结论的直接量化证据。
主题熵
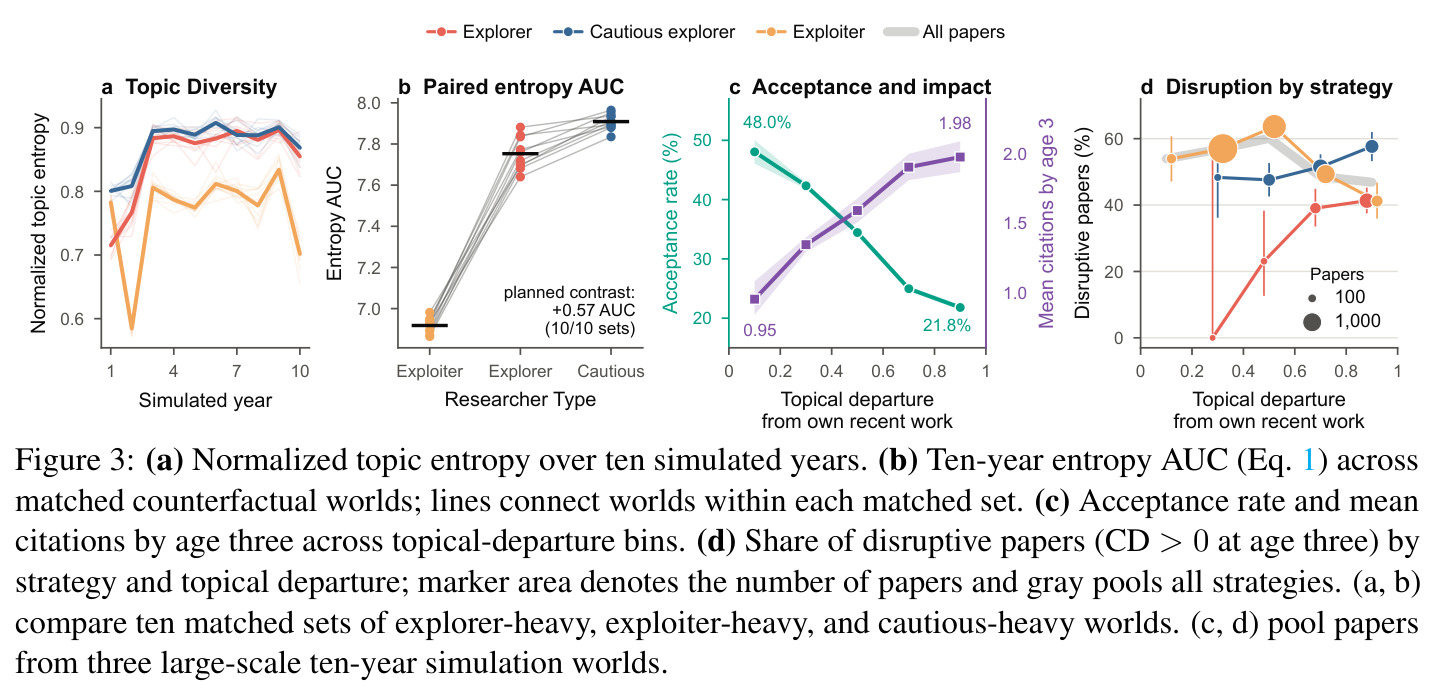
借用信息熵衡量研究主题分布的均匀度:$H_t = -\sum_{d\in D} p_{t,d}\log p_{t,d}/\log|D| \in [0,1]$,其中 $p_{t,d}$ 是第 $t$ 年所有方向选择中选择方向 $d$ 的比例。熵越高说明研究主题越分散、生态多样性越好;论文进一步用熵曲线下面积 $\mathrm{AUCH} = \sum_{t=1}^{T-1}(H_t+H_{t+1})/2$ 汇总十年间的多样性。
'谨慎探索策略维持长期科学多样性'的结论完全建立在主题熵与 AUCH 的跨世界比较之上,不懂熵就无法评估该证据。
研究动机
科学进步依赖研究者、机构、资助机构、合作网络与科学文献长期共同演化的生态。随着 LLM 快速进入选题、实验、写作和同行评审等环节,AI 介导的微观决策(选什么题、和谁合作、投哪里、给什么分)正在宏观层面重塑科学:哪些想法获得影响力、哪些方向得到持续支持、谁还能留在科研队伍里。要在真实学术界追踪这些效应几乎不可能——你无法随机让一半院系改用另一套资助规则,替代政策下的反事实结果也观察不到。现有 LLM 智能体工作停留在任务级:单次创意生成、单篇论文评审、单份手稿写作;经典的科研 ABM 虽研究过发表-重投、资助与累积优势,却缺乏以真实文献为内容基础的决策模型。因此单环节的改进未必转化为更高效、更多样、更可持续的生态:低录用率推高重投、重投加重审稿负担、预算耗尽迫使研究者退出——这些闭环反馈至今缺乏可控的研究工具。
本文的目标是本文的目标是构建 SUTO(Science Utopia)——一个持久化、闭环的 LLM 智能体模拟框架,把研究方向选择、合作、投稿、同行评审、重投、引用、资助分配和研究者流失整合进同一个逐年循环,使每一年的模拟结果(接收、审稿意见、资助、预算耗尽)都写入研究者的持久状态并影响其后续决策。在此之上运行匹配反事实实验:从相同初始世界出发,仅改变一个制度机制(录用率、投稿上限、资助容量伸缩、作者信息披露、资助保守性惩罚),追踪其多年下游效应。框架围绕三个问题组织:发表与资助规则如何塑造生态长期动态?个人探索策略如何影响职业结局与科学多样性?累积优势与偏见在何种条件下内生涌现?
与已有工作不同的是,独特切入在于三个设计的组合。其一,闭环持久状态:研究者携带专业技能、声誉、预算、记忆和利益冲突五元组,预算耗尽者退出种群,这与一次性任务级模拟有本质区别;其二,文献落地:论文产物从真实 arXiv 语料按时间检索,评审和引用基于真实科学内容而非凭空生成,避免生态动态被 LLM 幻觉主导;其三,受控反事实:从同一初始世界出发做单变量干预,把'被测机制'与'它引起的变化'分离,而粗糙的设计会直接抹掉想研究的反馈效应。规模上,61 个世界、8,000 个机构、40,000+ 研究者、约 39 万研究者-年、40 万发表决策和 120 万条 LLM 评审,把 AgentRXiv、ResearchTown 等此前研究社区模拟推到新量级,使十年尺度的生态级结论第一次有了受控实验支撑。
核心方法
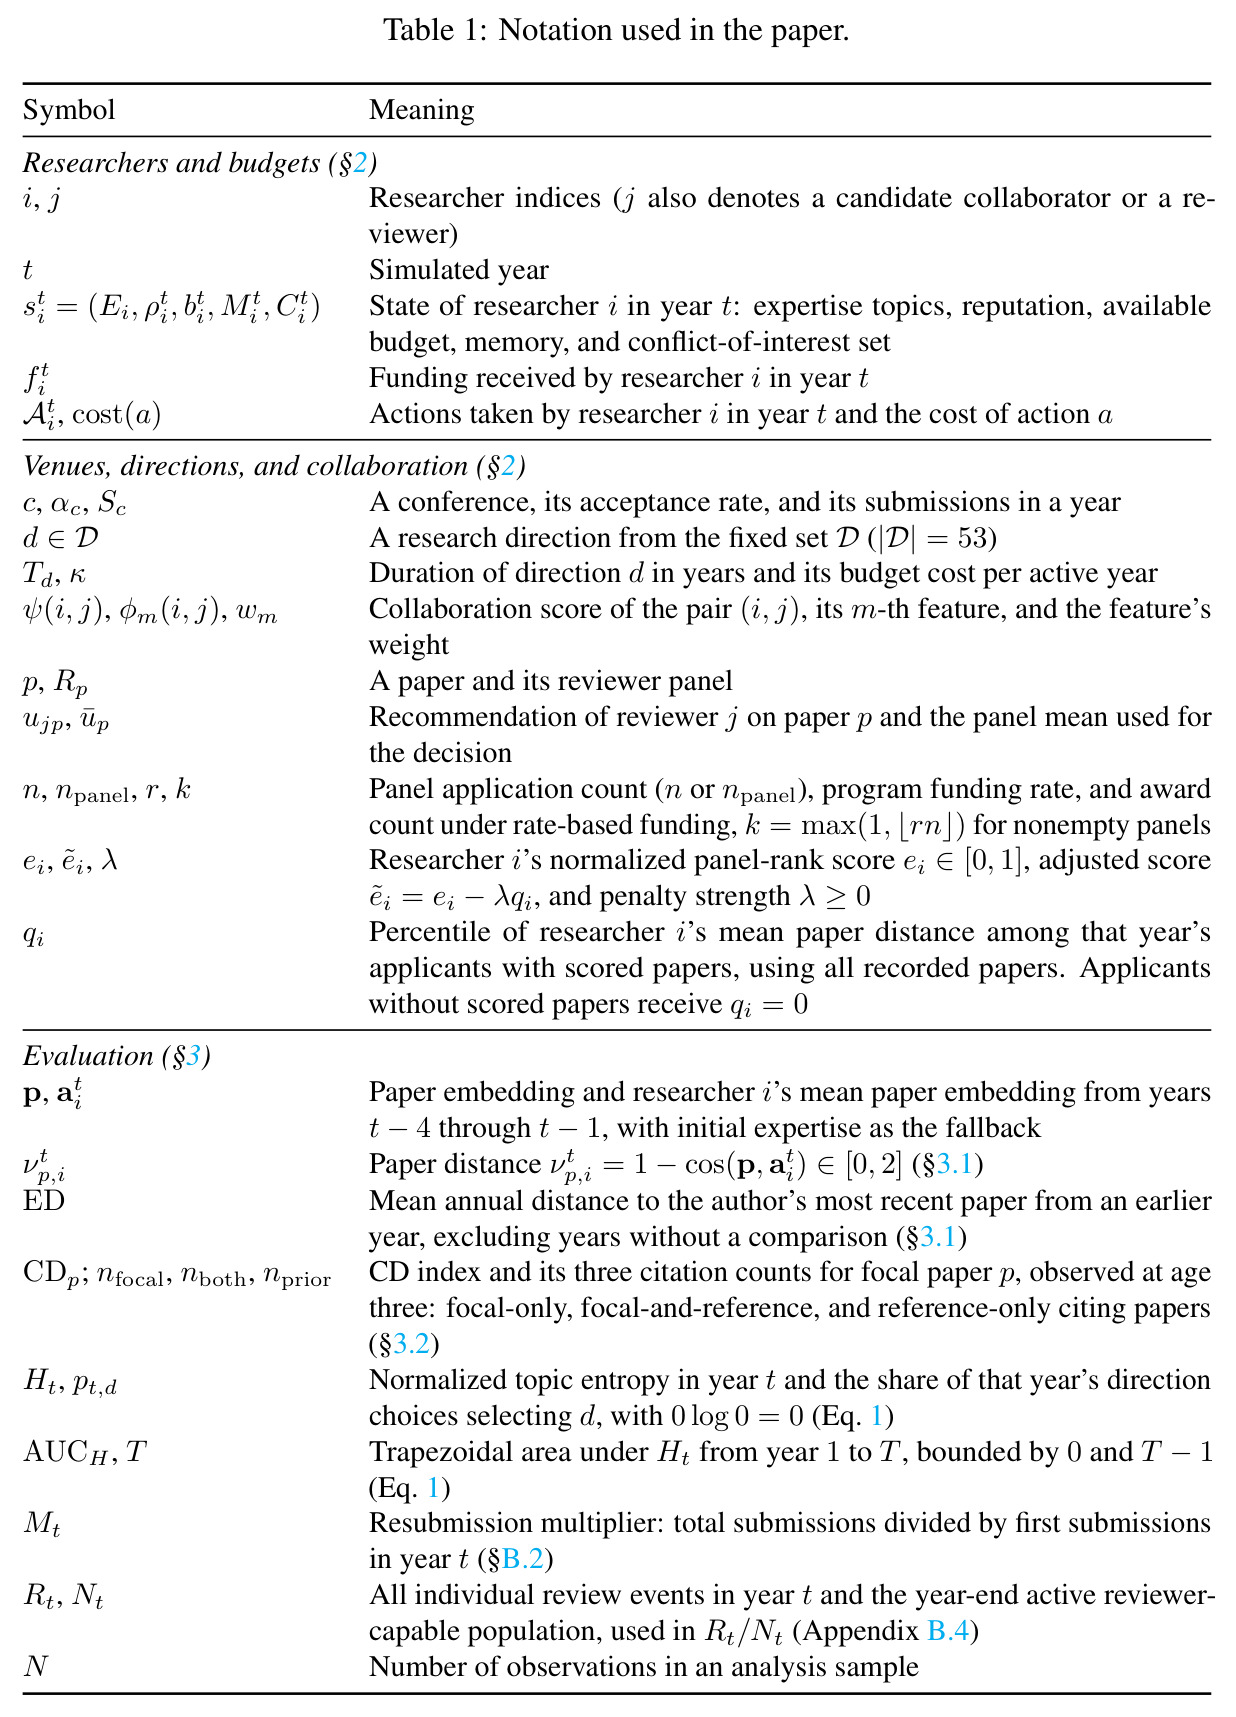
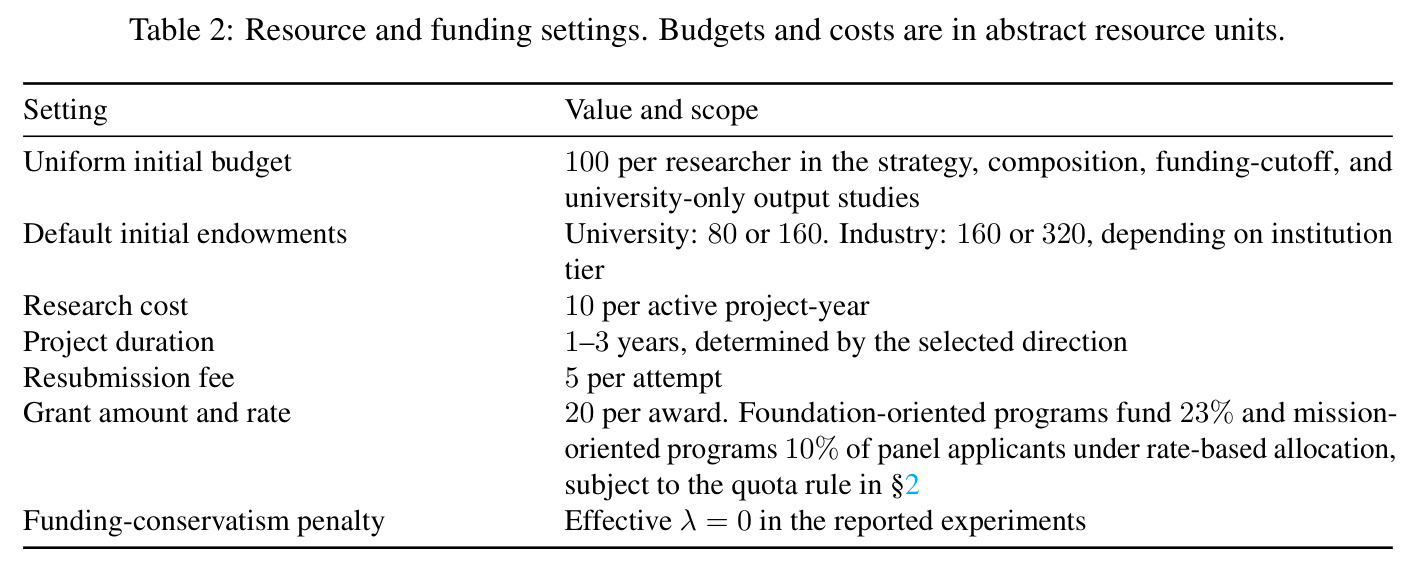
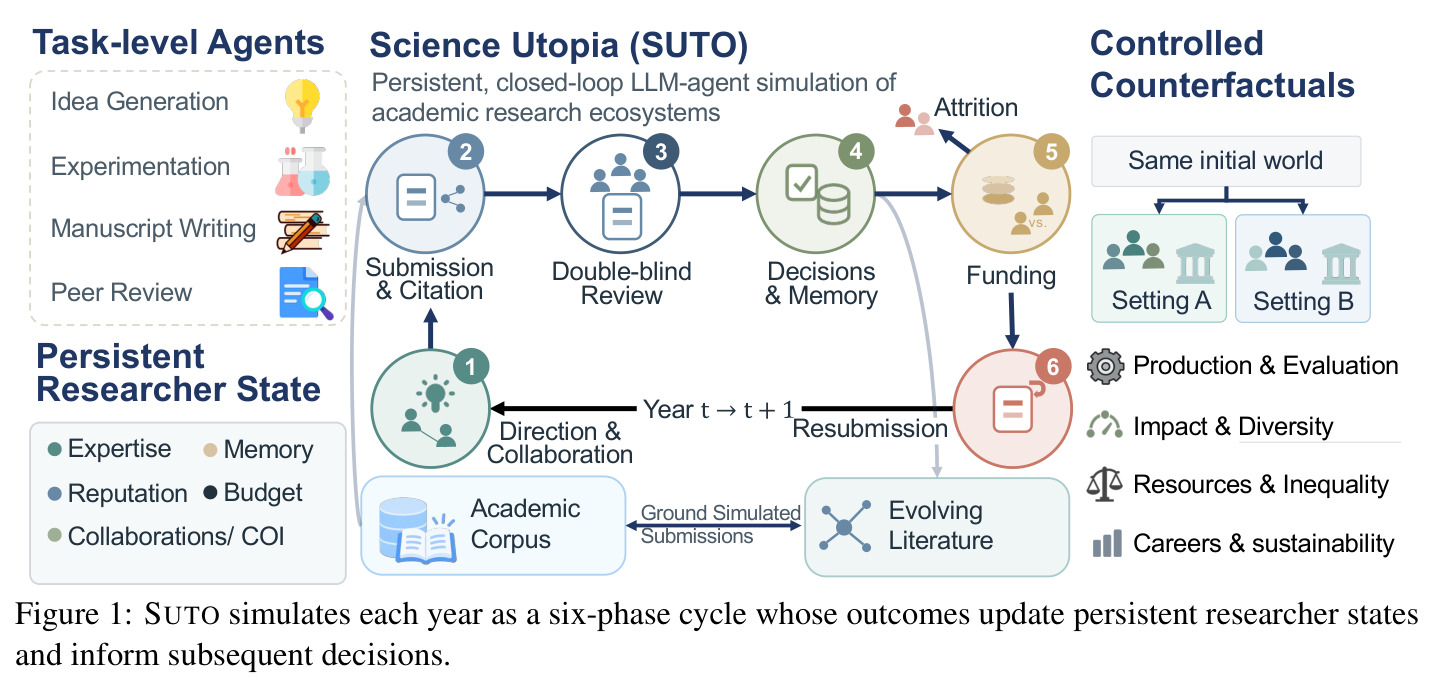
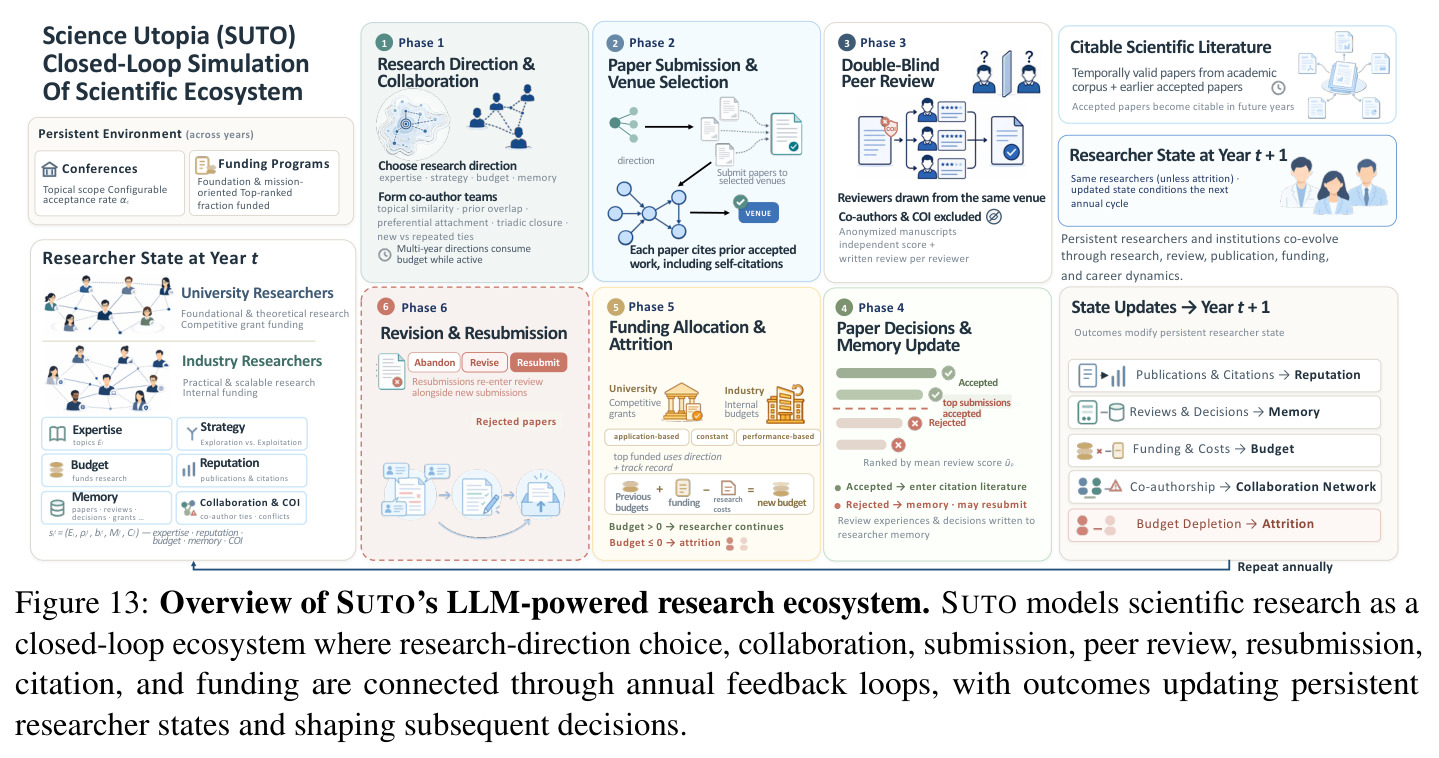
直觉上,SUTO 把学术界建模成一个逐年推进的回合制系统:每年研究者选方向、找合作者、完成项目并投稿,投稿被分配给三位审稿人评审,会议按录用率排名接收,大学研究者申请竞争性资助,预算耗尽者退出,被拒论文的作者决定是否修改重投,然后进入下一年。每个研究者的状态是五元组 $s_t^i = (E_i, \rho_t^i, b_t^i, M_t^i, C_t^i)$,分别是专业技能主题、声誉、预算、记忆(记录过往发表、评审经历与资助结果)和利益冲突集合(由单位与合著关系诱导);年底预算按 $b_{t+1}^i = b_t^i + f_t^i - \sum_{a\in A_t^i} \mathrm{cost}(a)$ 更新。技术路线上,模拟年映射到真实日历年,智能体只能引用该时点前可得的文献;论文从 SciEvo 的 arXiv 语料中检索;每个会议覆盖固定主题子集并有录用率 $\alpha_c$;资助项目分基金会导向与任务导向两族,大学研究者靠外部竞争性资助、业界研究者靠与接收论文挂钩的内部经费。
核心创新是'持久闭环 + 文献落地 + 匹配反事实'三位一体。与任务级 LLM 智能体(一次评审、一次选题)不同,SUTO 中每个结果都会回流:差评影响重投决策、甚至让作者对他人工作更苛刻;发表成功强化既有方向;接收论文进入可引用文献池;资助改变预算、预算决定去留,进而改变投稿量和审稿人池。与经典 ABM 相比,选题、评审、引用等决策由基于真实文献内容的 LLM 完成,具备科学保真度而非纯规则推理。控制设计也很巧妙:预算被解释为类似 AI 使用 token 的抽象资源约束;测试资助保守主义时,把申请者在 panel 内的排名归一化为 $e_i\in[0,1]$,按主题偏离百分位 $q_i$ 施加惩罚 $\tilde{e}_i = e_i - \lambda q_i$,在不改变底层评估的前提下分离出'惩罚偏离'这一个机制;重投与人口增长则通过 2×2 交叉实验分离各自贡献。
方法步骤详情
每个模拟年按固定顺序执行六个阶段。阶段 1(方向与合作):上一项目已结束的活跃智能体依据专业技能、资源与记忆,从固定方向集 $D$ 中选择新方向,方向持续 $T_d$ 年、每年耗 $\kappa$ 预算;合作开启时用 $\psi(i,j)=\sum_m w_m\phi_m(i,j)$ 为候选合作者打分,特征涵盖主题相似度、近期发表重叠、优先连接与三元闭合。阶段 2(投稿与引用):作者按带宽提交新论文,从 SciEvo 检索与方向匹配且时间有效的候选 arXiv 论文,选定产物与兼容会议并引用可达文献。阶段 3(评审):每篇投稿分配三名审稿人,基于标题、摘要与主题给出 1–5 分推荐及书面理由,默认双盲。阶段 4(决策与记忆):论文得分为平均推荐 $\bar{u}_p$,会议按录用率接收前 $\max(1,\mathrm{round}(\alpha_c|S_c|))$ 篇,评审与决策写入作者记忆。阶段 5(资助与流失):大学研究者提交基于既往论文的简短提案,资助 agent 从契合度、潜力、履历打分,每个 panel 按比率 $r$ 资助前 $k=\max(1,\lfloor rn\rfloor)$ 名;预算耗尽者离开种群。阶段 6(重投):从第二年起,被拒论文的作者依据审稿意见、投稿历史、资源与重投成本决定放弃、修改或重投,重投稿与新投稿一起重新进入评审。
技术新颖性
技术新颖性有四点。第一,规模与完整性:61 个世界、40,000+ 研究者、约 39 万研究者-年、40 万发表决策、120 万条评审,远超 AgentRXiv(重复交互中累积成果)和 ResearchTown(研究者-论文图上的读写评)等先前系统,且首次把重投、引用、资助、流失耦合进同一反馈回路。第二,落地机制:从真实 arXiv 语料按年检索论文产物,使评审与引用针对真实科学内容,规避纯生成式论文带来的事实噪声。第三,方法学工具箱:熵曲线下面积 AUCH 比较跨世界多样性、标准化均值差(SMD)及 95% 置信区间报告策略对比、CD 指数区分颠覆与巩固、Gini 追踪资源分层,形成可迁移到其他模拟研究的度量组合。第四,制度杠杆直接映射政策:录用率、每项目投稿上限、资助容量伸缩、评审匿名性、资助保守性惩罚强度 $\lambda$,都是现实学术治理可操作的对象,使框架天然具备'科研政策沙盒'属性。
实验结果
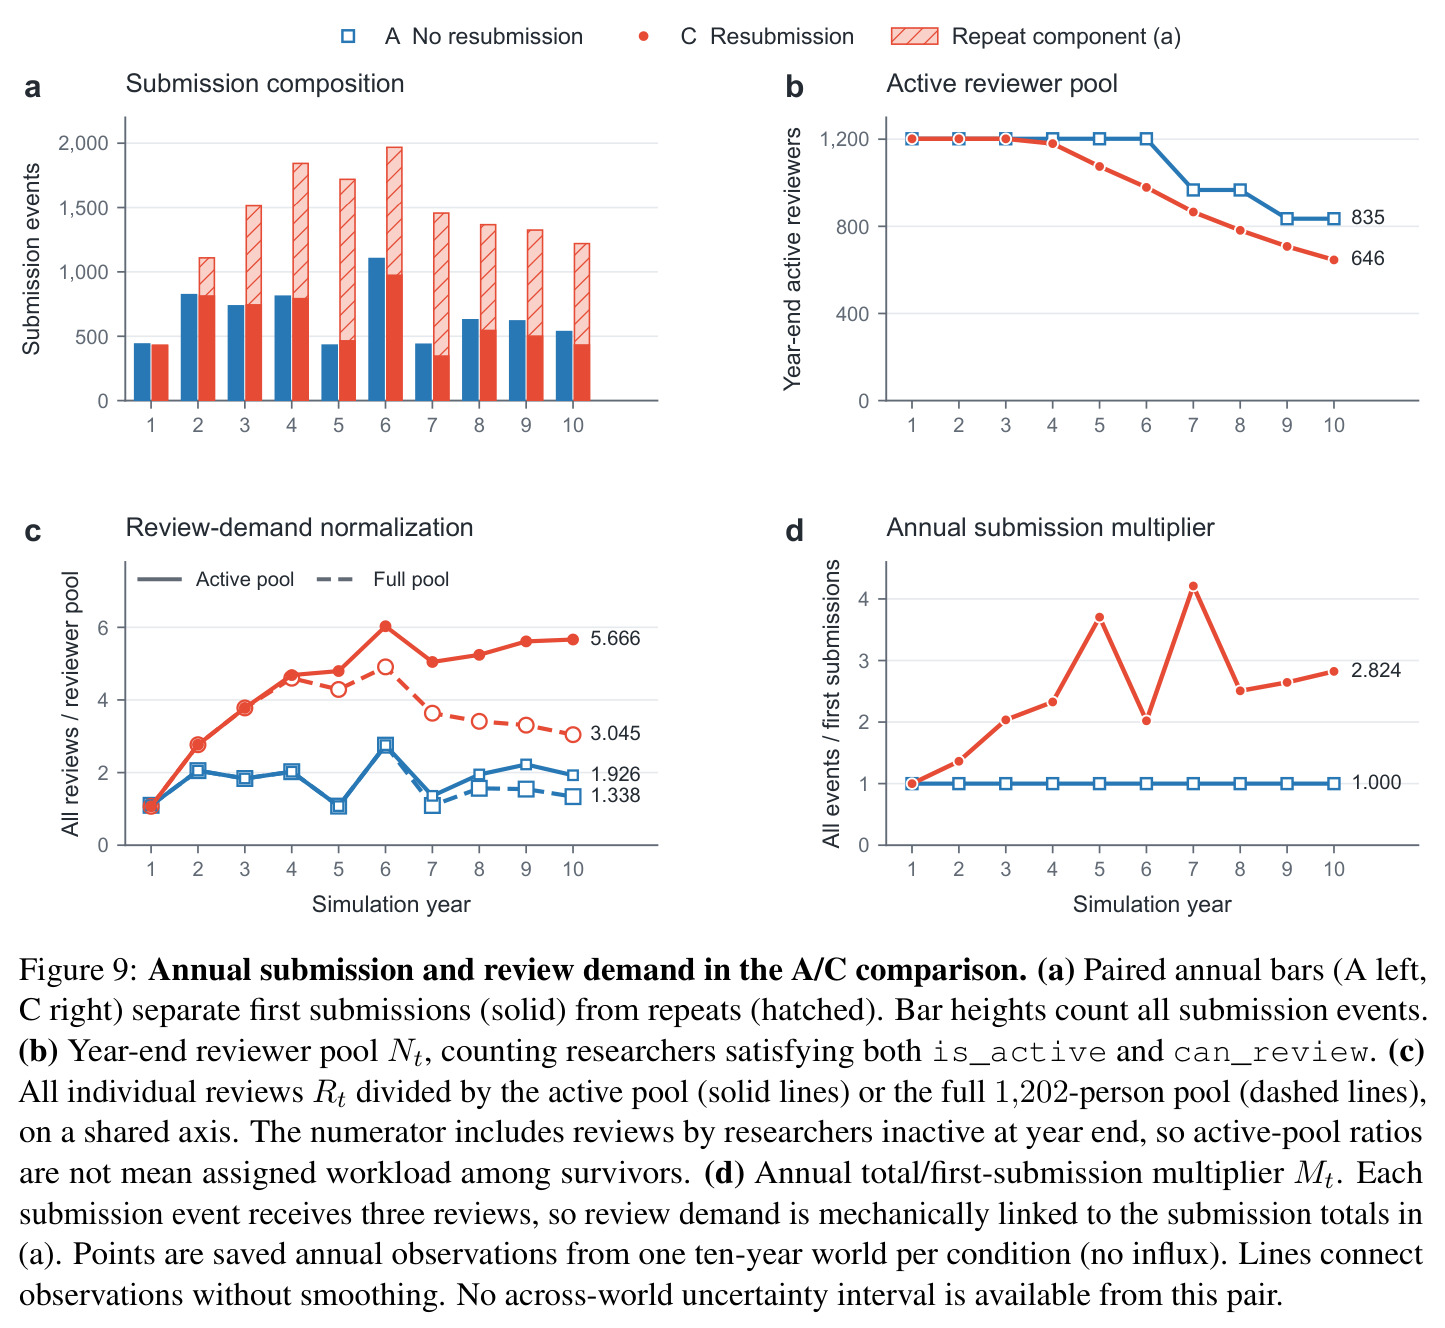
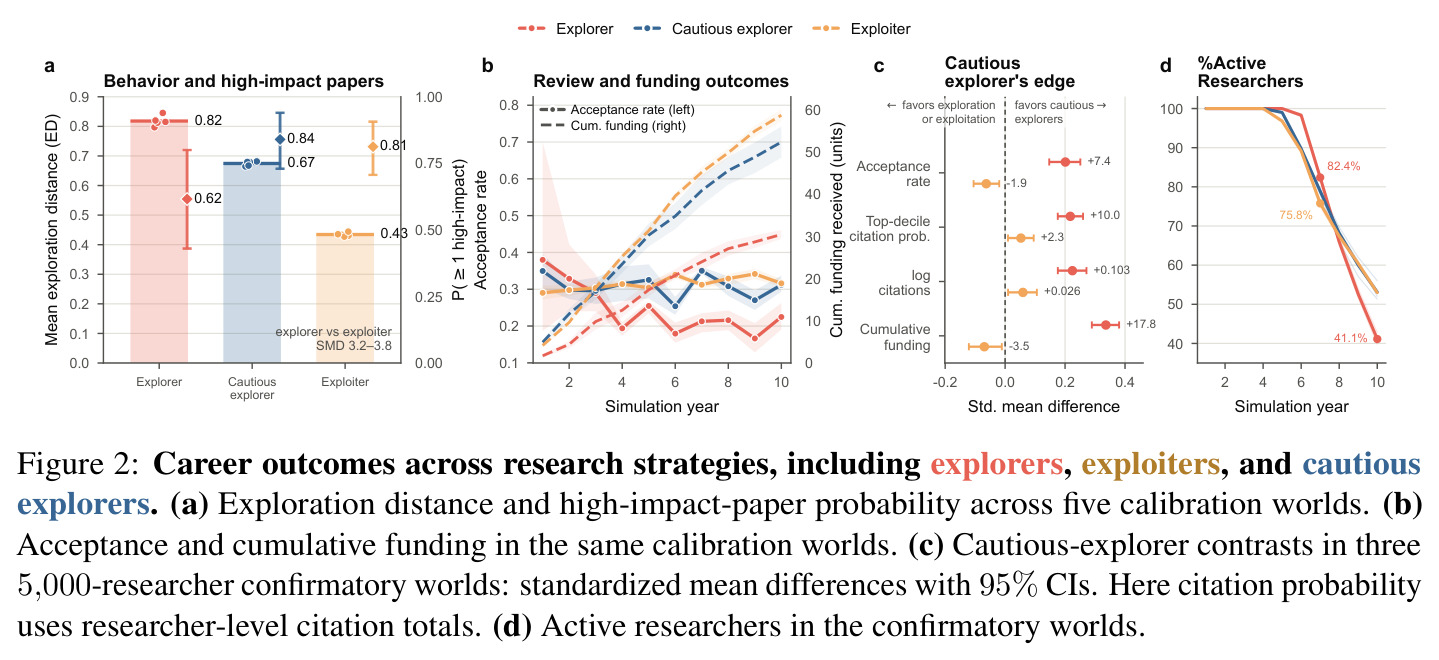
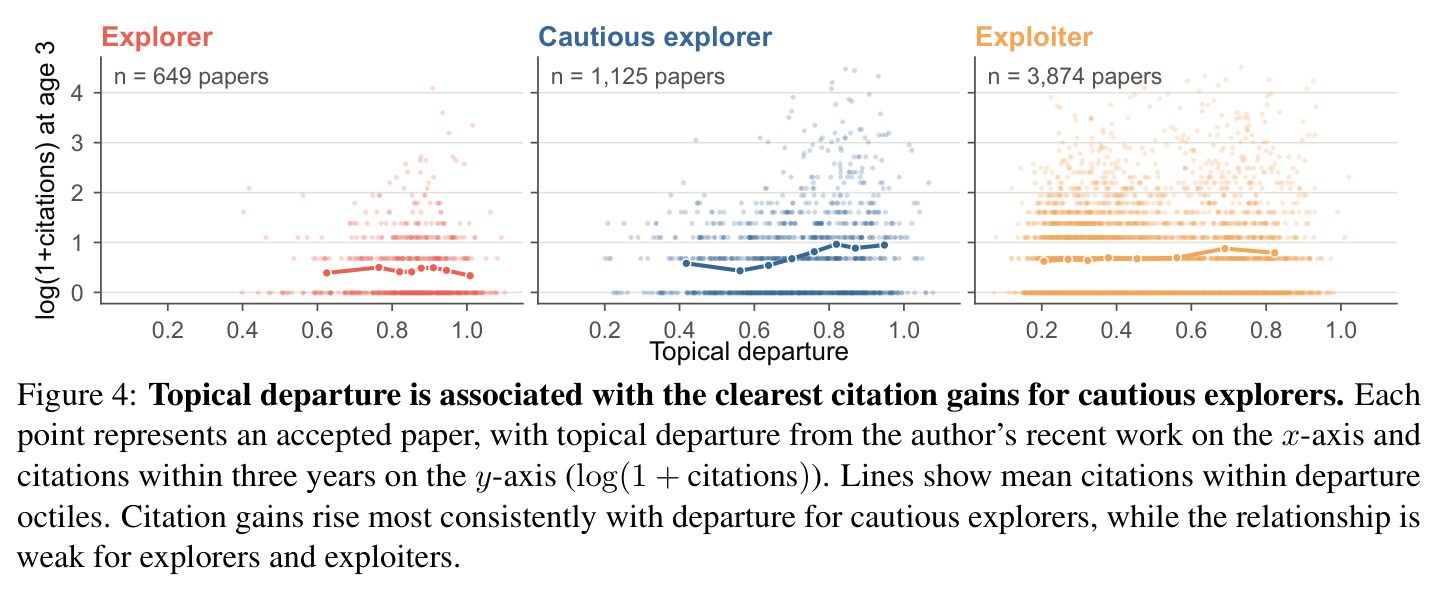
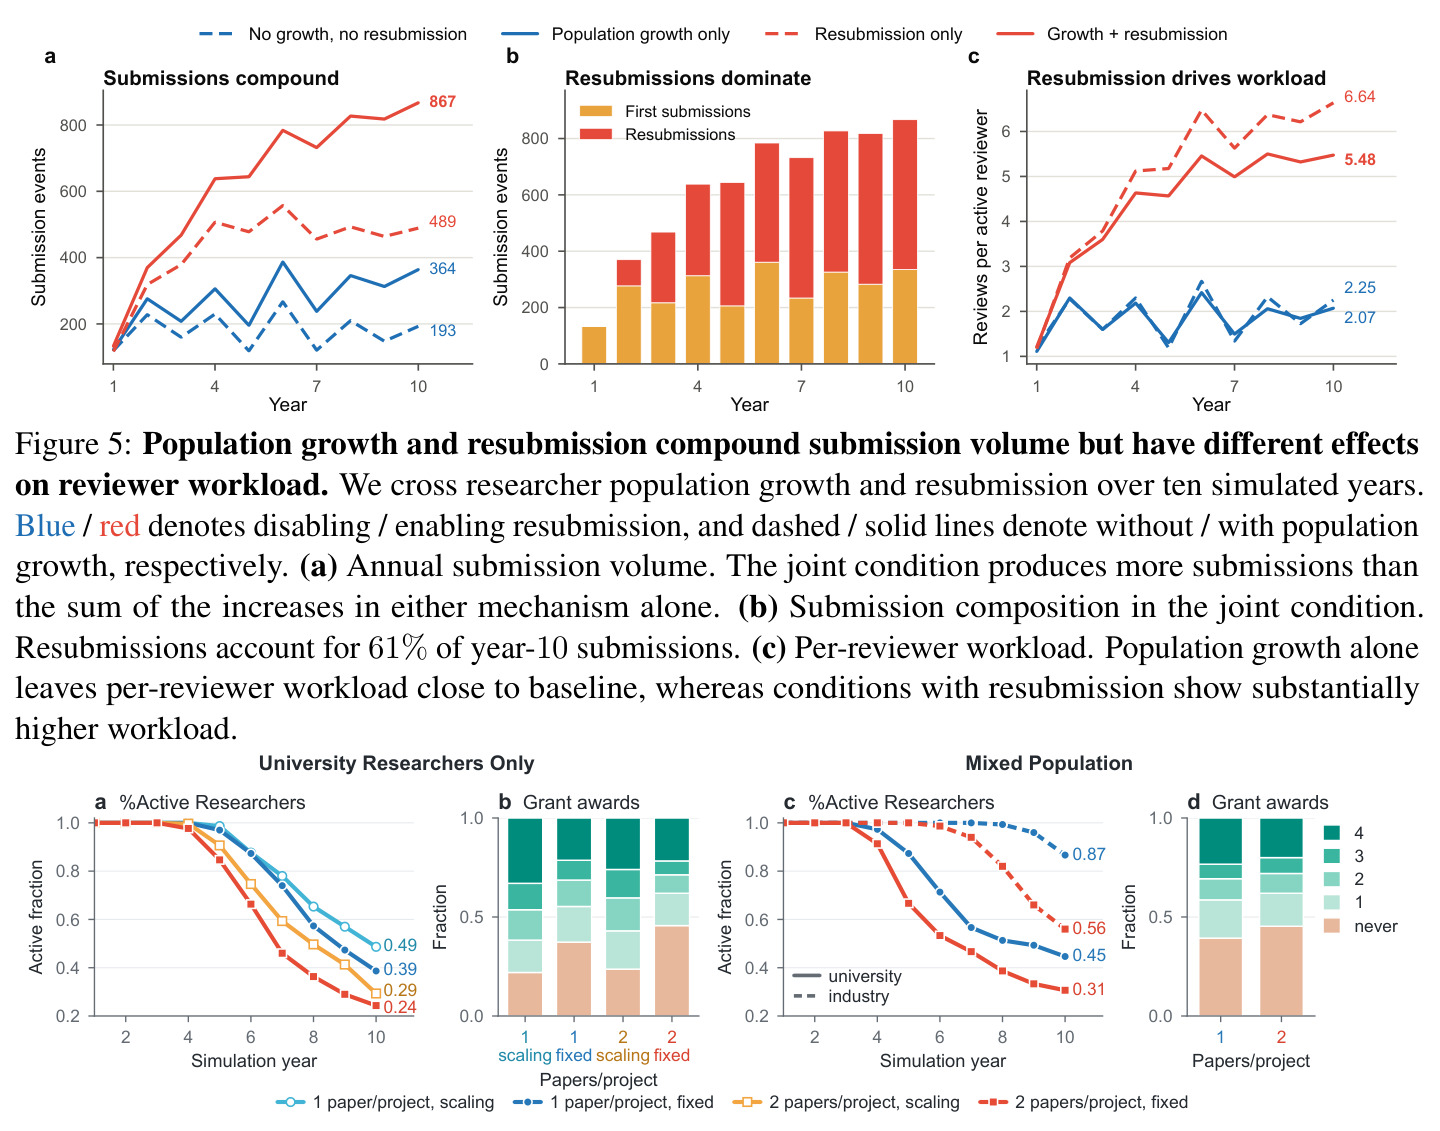
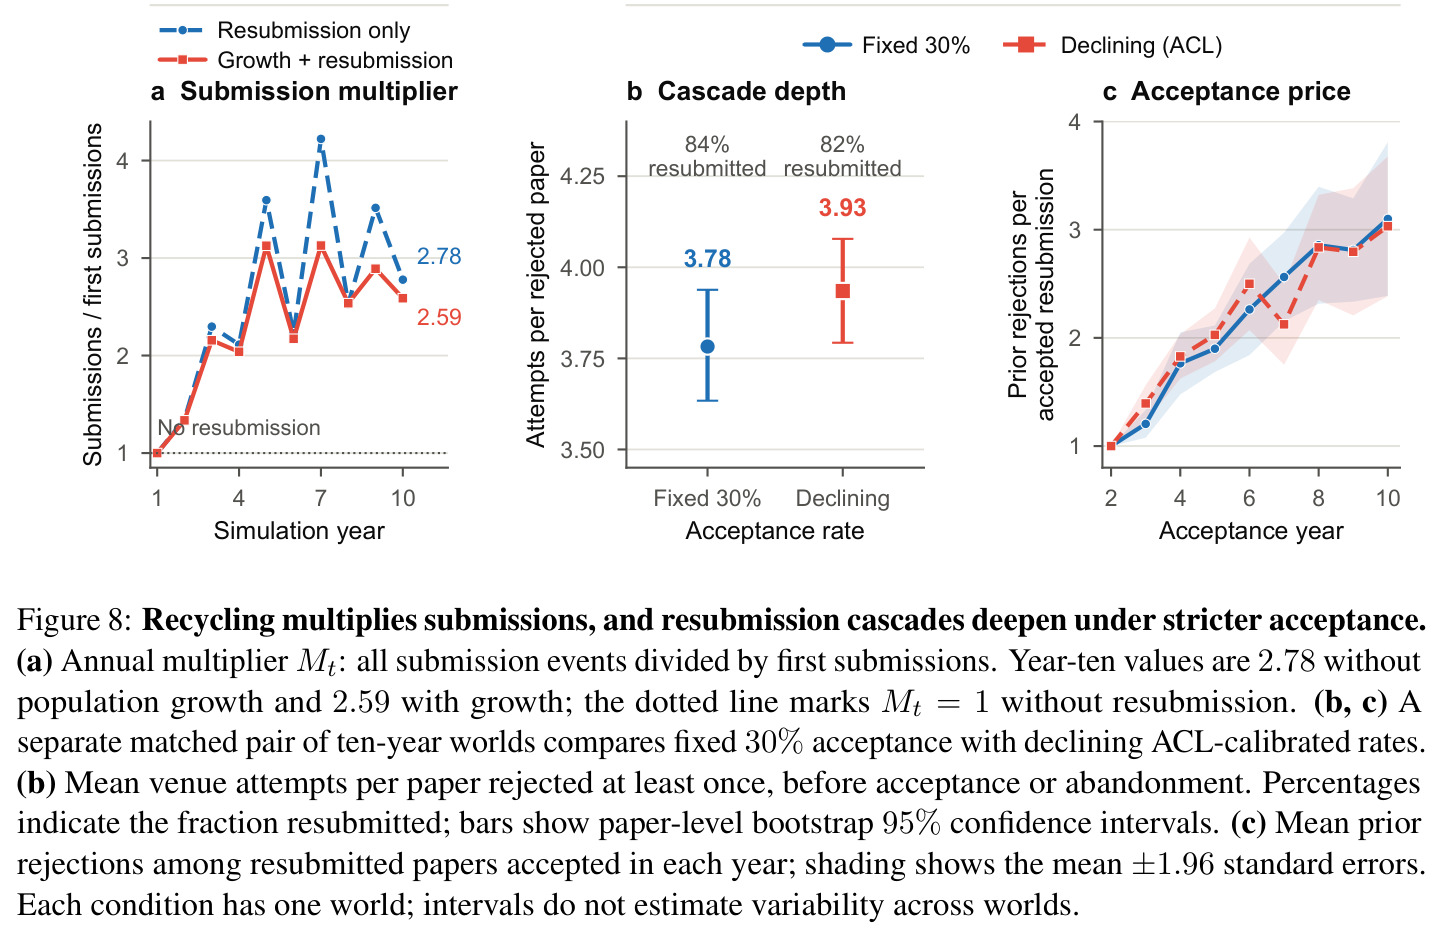
核心发现分三层。研究者层:(1) 谨慎探索者最优——录用率 37.2%(探索者 29.8%、利用者 39.2%),高影响力论文概率 0.84(0.62/0.81),累计资助最高,十年存活率约 53% 而探索者仅 41.1%;谨慎主导世界比利用主导世界主题熵高 0.11、比探索主导世界十年 AUCH 高 0.156。成果层:(2) 主题偏离越大越难发表——录用率从最低偏离档 48.0% 降至最高档 21.8%,评审分 2.45→2.28;但被接收论文三岁平均引用 0.95→1.98、90 分位 3→5,构成'选择-影响力'权衡;(3) 偏离不等于颠覆:正 CD 论文占比 54.0%→46.9%,谨慎探索者却从 47.6% 升至 57.7%;(4) 重投放大审稿负担:仅人口增长使人均年审稿量保持 2.07(基线 2.25),仅重投升至 6.64;固定 30% 与 ACL 递减录用率(28%→20.3%)十年对比中首投量相近(1,706 vs 1,741),但总投稿增长 282% vs 358%,被拒论文平均尝试 3.78 vs 3.93 次,更严标准仍增加 14% 审稿量;(5) 披露第一作者信息使评审分升 0.055–0.077 分(120 篇预注册随访 CI [0.026, 0.128]),再披露合作关系无额外效应。制度层:(6) 每项目投稿 1→2 使接收量 +63%/+69%,但十年活跃率 39%→24%(固定容量)/49%→29%(伸缩);混合人群中大学 45%→31%、业界 87%→56%;从未获资助者 22%→37%,获资助者内部 Gini 仅 0.36→0.39;(7) 三个 5,000 人验证世界无干预十年:Gini 0.04→0.36、活跃人口 5,000→约 2,530,但主题熵维持 0.81–0.85、53 个方向全有人研究,资源分层与智力多样性解耦;45.5 万条评审均值稳定在 2.29–2.40。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 审稿负担(人口增长×重投 2×2 析因实验) | 每位活跃审稿人年均审稿次数 | 仅启用重投:6.64;两者皆开:5.48–6.64 | 仅人口增长:2.07;两者皆关:2.25 | 重投使人均审稿负担升至基线约 3 倍,人口增长则几乎不影响人均负担 |
| 发表强度提升(每项目投稿上限 1→2) | 第 10 年活跃研究者比例(纯大学世界) | 伸缩容量 29%;固定容量 24%(接收量 +69%/+63%) | 上限为 1 时伸缩容量 49%、固定容量 39% | 接收量大幅增加的代价是十年参与率下降 15–20 个百分点 |
| 研究策略职业结局(10 年追踪) | 录用率 / 高影响力论文概率 / 十年存活率 | 谨慎探索者:37.2% / 0.84 / 约 53% | 探索者 29.8% / 0.62 / 41.1%;利用者 39.2% / 0.81 / 约 53% | 谨慎探索者在引用与累计资助上最优(如相对利用者引用概率 SMD +0.103) |
| 评审公平性(作者信息披露对比) | 1–5 分制评审分数变化 | +0.055 分;120 篇预注册随访 +0.077 分(CI [0.026, 0.128]) | 双盲评审 | 首次量化单盲偏置幅度;追加披露合作关系无额外效应 |
局限与改进
作者承认的局限包括:未模拟'提案-资助'管线,直接假定发表记录与提案评估正相关;方向集固定为 53 个、模拟年与真实日历年一一对应等简化设定。我自己的观察:其一,4 万个研究者智能体共享同一个底层 LLM,行为异质性主要来自 prompt 角色设定,所谓'涌现'的分层可能放大模型自身偏见,且文中没有将模拟产出的录用率、引用分布、合作网络与真实 bibliometric 统计定量对齐,外部效度未经校验;其二,评审分数集中在 2.0–2.5(62–72%)、十年间标准差仅从 0.50 升至 0.55,分布明显比人类评审更窄,说明审稿人模型欠异质;其三,预算规模、方向成本 $\kappa$、重投费用等参数为人工设定,结论对这些参数的敏感性未系统报告;其四,120 万条评审的 API 成本不菲,社区复现门槛较高;其五,引用与'影响力'均在模拟内部闭环定义(引用的是模拟世界接收的论文),能否外推到真实引用动力学存疑。
独立分析的弱点
独立分析四个弱点。第一,缺外部校准:框架宣称科学保真,却没有把模拟产出的录用率、引用分布、作者生产力与真实会议(如 ACL 十年统计)定量对齐,匹配反事实的内部效度强但外部效度存疑——改进方向是用真实数据校准关键参数并报告敏感性分析。第二,审稿人同质化:三名审稿人来自同一 LLM 的不同 prompt 实例,专家匹配度与宽严差异被压缩,'披露作者信息 +0.055 分'这类效应可能混入模型对'名声感'的语料偏见——应引入异质审稿人(不同能力档、不同模型家族),并与人类开放评审田野实验的效应量做对比。第三,策略与方向空间外生:探索者/谨慎探索者/利用者是预先指派的角色,真实研究者会随资助与年龄切换策略;53 个方向的固定集合也无法表达新方向的诞生——可让策略内生演化、方向空间可扩展,进而研究'新领域涌现'的条件。第四,单一模型依赖:全部行为由一个 LLM 生成,未报告换用其他底层模型后的稳健性,结论可能是特定模型先验的产物——至少应在 2–3 个不同家族的模型上复现核心反事实。
未来方向
作者希望 SUTO 成为理解与重塑科研生态的基础,帮助政策制定者看到局部规则如何累积成长期动态。可延伸方向:一是真实数据校准——用真实会议统计与文献库验证模拟是否复现已知科学学规律(引用幂律、优先连接、合作网络结构),量化'模拟-现实差距';二是政策搜索——把录用率曲线、资助容量、审稿配额等制度参数当作可优化变量,用网格或贝叶斯优化搜索最大化长期参与率与多样性的政策组合;三是人机混合生态——引入人类参与者与 LLM 智能体共存,直接测量 AI 参与率上升的因果效应;四是把推理成本本身建模为资源约束,用不同规模/成本的模型扮演不同资历研究者,落实'预算≈AI token'的隐喻;五是扩展制度要素——加入 rebuttal、跨会议转投、期刊分层、tenure 决策、负责任 AI 使用规范等机制,检验结论在更丰富制度空间中的稳健性。
复现评估
复现条件较好但有成本门槛。代码开源(github.com/Ahren09/ScienceUtopia),配套项目网站(Ahren09.github.io/ScienceUtopia)提供框架文档;文献基础是公开的 SciEvo arXiv 语料,无需私有数据。主要成本在 LLM 调用:61 个世界产生约 40 万发表决策和 120 万条评审,用商业 API 复现全部实验预计需要数千至上万美元与数天到数周时间,个人难以完整复现;但单个校准世界(如 5,000 研究者×10 年)或更小规模世界可在有限预算内运行,建议先复现单世界管线再逐步扩展。摘要未披露默认底层模型、调用量与推理费用,也未见预生成模拟轨迹数据的发布计划——若作者公开轨迹与智能体记忆快照,社区可跳过 LLM 调用直接复现全部分析,将大幅降低门槛。总体:代码与语料可得性好,完整复现难度中高。
论文图表