SciΠvot:面向科研自动研究智能体关键时刻PI判断力的基准 SciΠvot: Benchmarking Principal-Investigator Judgment at Pivotal Moments of Scientific AutoResearch Agents
将资深研究员纠正AI科研智能体的真实决策转化为248案例基准,多数前沿模型不及随机水平
前置知识
AutoResearch 智能体
由大语言模型驱动、能自主提出研究计划、运行实验、记录结果并决定下一步动作的科研自动化系统,可连续运行数周至数月,任务涵盖理论推导、数值仿真与科学数据分析。本文作者团队在 26 个博士级真实项目上运行了这类系统约半年,以发表为目标。
本文全部案例都取自这类智能体的真实运行历史,理解'项目记录''原始 LLM 计划'等概念的前提是理解这类系统如何工作。
PI 判断(Principal-Investigator Judgment)
指首席研究员在科研关键节点所需的一类判断:评估某个实验能否真正推进科学问题、识别可疑结果背后的错误假设、决定扩大还是收缩实验规模。它关注'做哪个实验'而非'怎么把实验跑通',区别于纯执行能力,是本文要度量的核心能力。
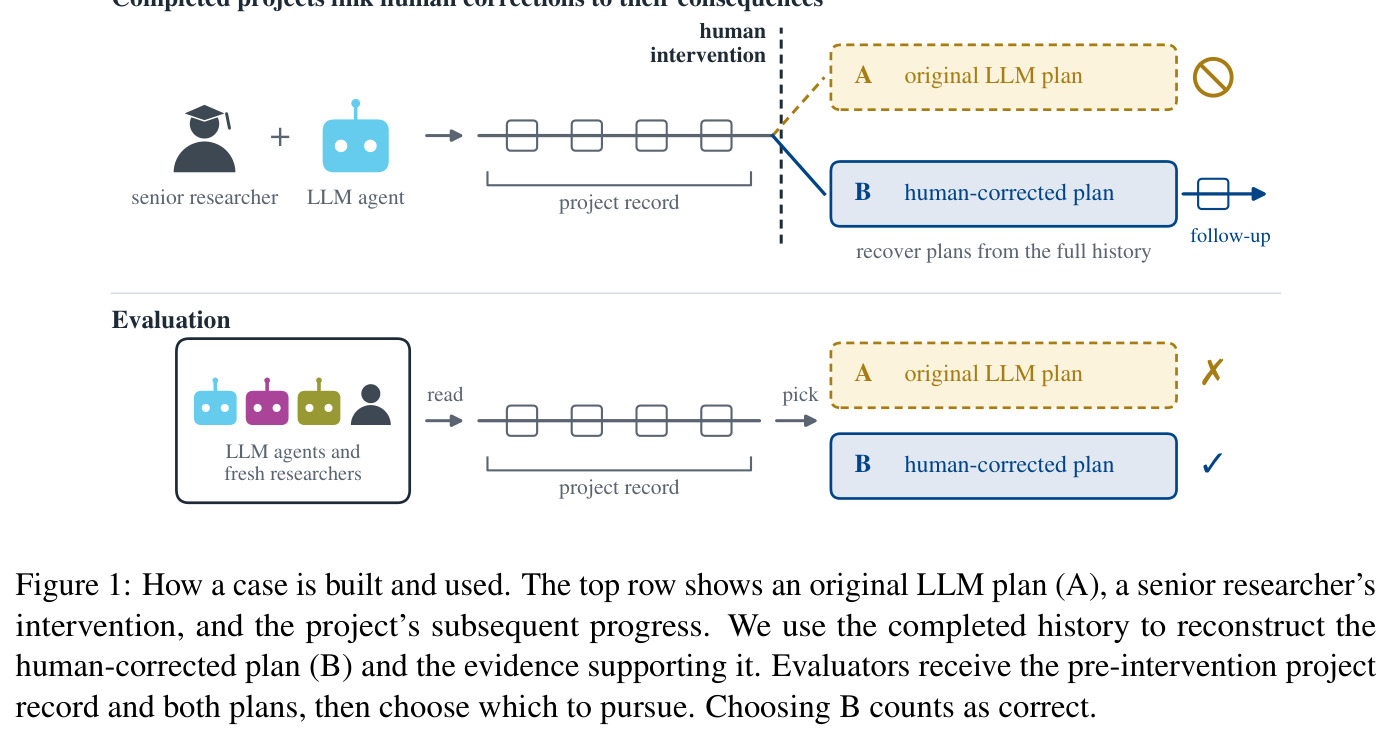
基准的每个案例都是一次 PI 判断的二选一测试:模型要在两个候选计划中识别出资深研究员会选择的那一个。
DPO 与偏好对
直接偏好优化(DPO)把'好回答优于差回答'的成对比较数据直接用于对齐语言模型,无需单独训练奖励模型,每条数据形如(优选答案,被拒答案)的偏序对。本文每个案例天然构成(人类修正计划,原始 LLM 计划)偏好对,格式与 DPO 训练数据一致。
这决定了该基准不只是评测工具,更是未来智能体强化学习的训练数据来源,作者明确把它列为下一步工作。
推理努力与测试时扩展
测试时扩展指在不改模型权重的前提下,用更多推理阶段计算(更长思考链、更多推理 token)换取更强表现;现代前沿模型 API 暴露 low/medium/high/xhigh/max 等离散档位。已有研究表明其收益因任务而异,且不等价于等量 token 预算。
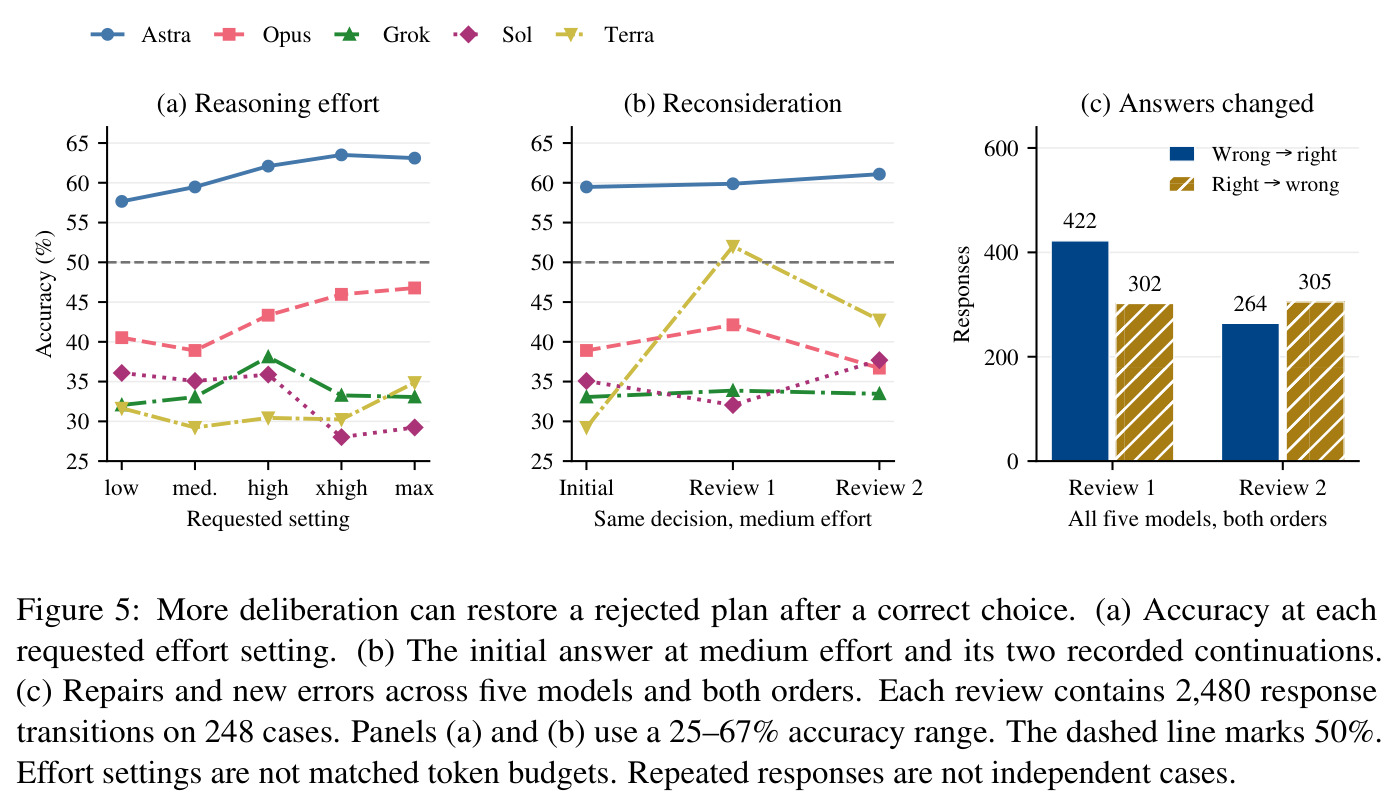
论文系统检验了提高努力档位与反复'再想想'能否改善科学判断,结论是收益不一致甚至倒退,这是核心实证发现之一。
无反馈自我修正与 re-trapping
指让模型重新审视并修改自己答案的机制。此前研究表明,没有外部反馈的自我修正可能降低准确率。本文发现模型会先选对人类修正计划、再在后续深思中'回到'被否定的原计划,作者称之为 re-trapping(重新落网)。
re-trapping 解释了为何单纯增加推理计算无法弥补判断缺陷,是理解论文第二次复查实验结果的关键概念。
项目聚类 bootstrap
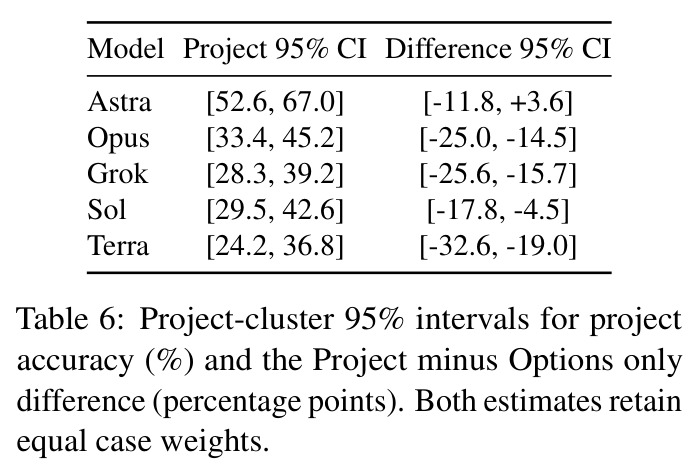
当多个案例来自同一项目时彼此不独立,普通案例级 bootstrap 会低估不确定性。项目聚类 bootstrap 以整个项目为重采样单元,对 26 个项目有放回抽样并保留其全部案例,给出更保守的置信区间,论文同时报告案例级与项目级 95% 区间。
读懂这两类区间才能正确判断'加入项目记录反而降分''第二次复查整体回退'等结论是否稳健显著。
研究动机
作者团队在约半年内用前沿模型智能体在 26 个博士级科研项目上运行自动科研,单个项目持续数周到数月、以发表为目标,涉及理论、仿真、计算与已有科学数据分析。经验表明'让实验跑起来'远比'选对实验'容易:自动检查与审查最终仍依赖模型去发现错误假设并决定下一步测试,失败的判断会让项目停滞数周或产出无法回答底层问题的结果,资深研究员每天要多次介入诊断停滞或跑偏的工作。两个典型例子:一个 Transformer 项目中 0.8B 小模型在三个 LiveCodeBench 组上得分 $0/480$,项目笔记声称已排除评测故障,智能体便计划换 2B 模型重测,而真正原因是评分器跳过了答案抽取;一个布料仿真项目把六个物理参数中的四个固定为 0——这只是智能体自己早期选择的遗留,却在每次运行中被继承,另两个参数的最优拟合已顶到搜索边界,智能体仍打算加密二参数搜索。堆规则也不奏效:受控报告实验表明,指令不断累积时模型遵循度下降,部分模型报告质量也随之退化。
本文的目标是本文的目标是把以往含糊的'科学判断力'变成可测量、可比较的对象。具体做法是把约半年真实科研中资深研究员的每次关键纠错,转化为一个受控二选一测试:给定人类介入之前冻结的项目记录(代码、实验日志、进展笔记等),以及'原始 LLM 计划'与'人类修正计划'两个选项,评估者要在不知道后续结局的情况下判断哪个计划更能推进科学问题。作者希望由此构建的基准(248 个案例、26 个项目、6 个科学领域)能回答三个问题:前沿模型能否识别人类修正;提供项目记录这一上下文是帮助还是干扰;以及提高推理努力档位或反复深思能否改善判断。同时,案例天然构成(被选计划,被拒计划)偏好对,为将来把人类纠错用作偏好训练数据、训练智能体研究动作的奖励模型打下基础。
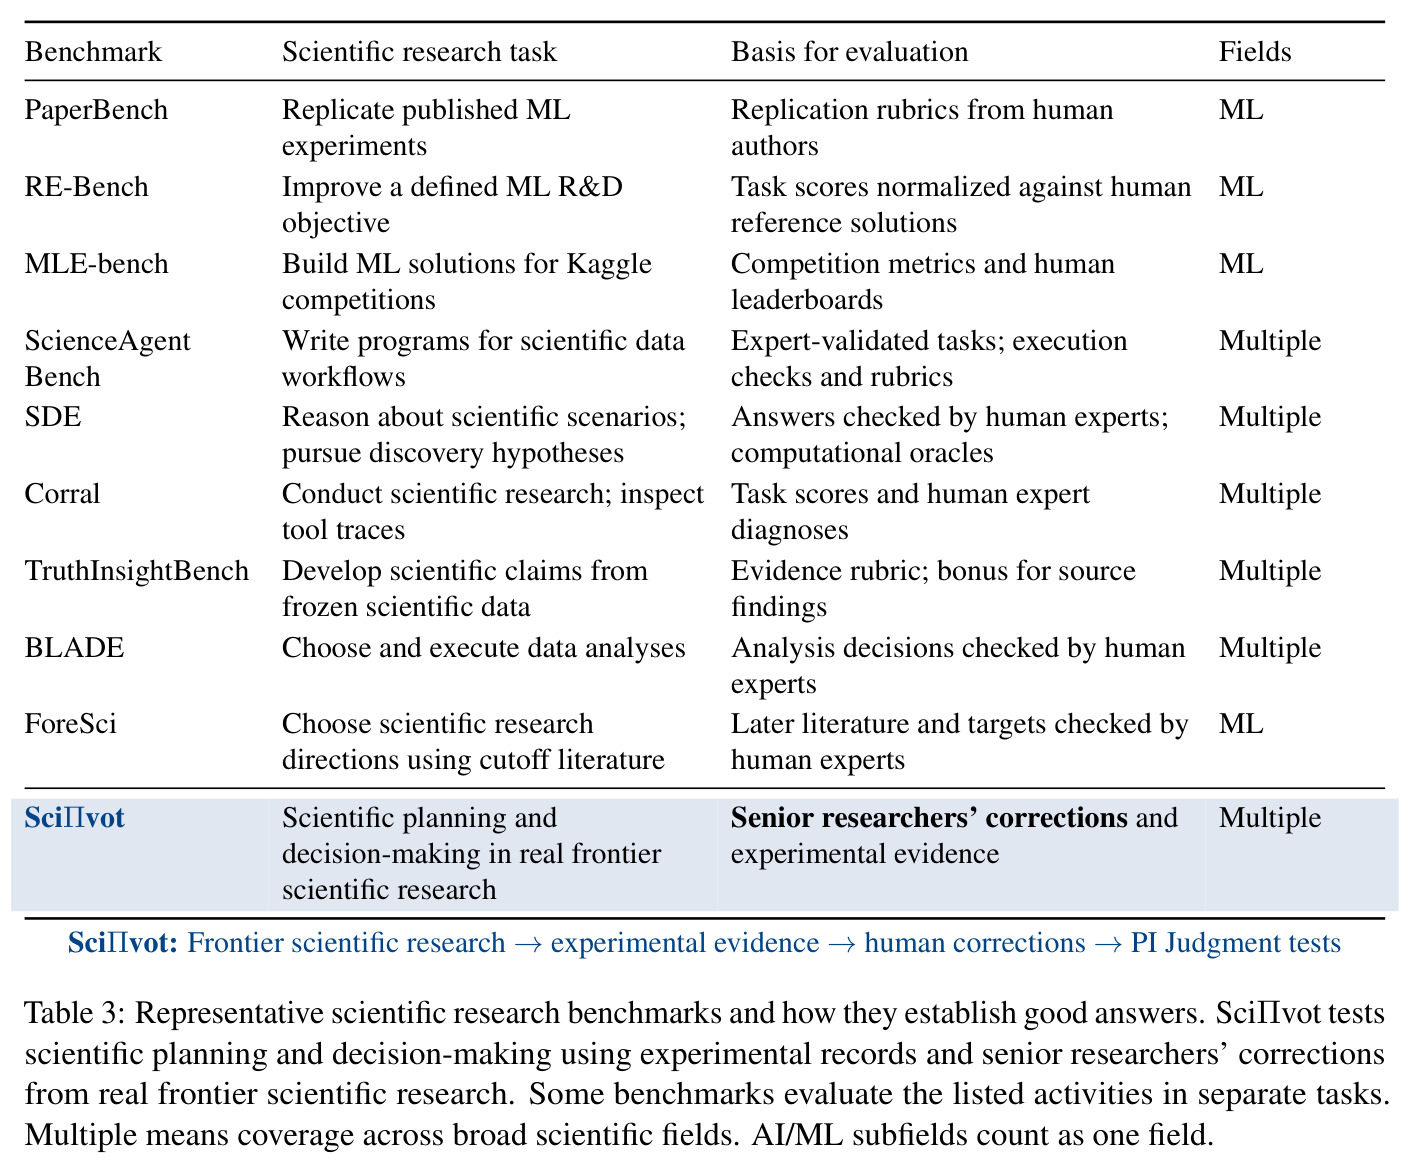
与已有工作不同的是,现有科研基准的'标准答案'各有来源:PaperBench 用作者复现清单评论文复制,RE-Bench 与 MLE-bench 对照人类参照解或 Kaggle 榜单,ScienceAgentBench 靠可执行的科学数据工作流,ForeSci 用后续文献评判研究方向,BLADE 用专家核对数据分析决策,TruthInsightBench 评估证据使用。它们都不直接度量'真实前沿科研进行中、结局未知的时刻'的判断本身。本文的独特切入是回溯式构建:利用已完成项目的完整历史,把人类纠错与其后续科学进展联系起来,从中恢复出决策点当时可用的证据,再让评估者只看介入前的记录做判断——正确答案的依据是实验证据而非人工评分。另一个被忽视的视角是结构性不对称:原始计划是模型的 on-policy 文本,人类修正计划是 off-policy 的,这为研究智能体对自身输出的系统性偏好提供了天然素材,也解释了模型偏爱原计划的现象。
核心方法
直觉上,论文把'资深研究员为什么要改计划'这个事后才看得清的问题,压缩回决策时刻:只保留当时可见的信息,问评估者能否重新做出同样的判断。技术路线上,每个案例由三部分组成:冻结在某个 commit 的项目记录(按 idea.md → proposal.md → STATE.md → 其他文件的阅读顺序提供,不含 Git 历史与后续状态)、原始 LLM 计划 A、由人类介入及后续科学进展重建的修正计划 B;两个选项使用统一的 Goal:/Plan: 英文格式,细节与长度可比且不包含能暴露参考计划身份的措辞。评估者阅读记录后在 A/B 间选择并给出理由,选 B 记为正确,随机基线为 $50\%$。全部案例由 Grok 4.6 按统一指令撰写,构建期间每个案例收集 120 份模型响应(5 模型 × 12 条件 × 2 选项顺序)用于筛选,整个构建共保留 29,760 次运行记录。
核心创新有三点。第一,以真实人类纠错作为标准答案,而非合成任务、人工评分量表或事后文献对照:每个修正都能用后续实验证据说明为何更好——例如审计发现评分器跳过答案抽取后,对同一批 608 个受影响补全逐字节核验并重判,在 480 道代码题中找回了 70 个本该正确的答案。第二,把'判断'与'生成'解耦:两个选项都由基准固定,评估者只做选择,从而把失败精确定位在判断力而非文笔或计划生成能力上。第三,沿用挑战集(challenge-set,Dynabench 一脉)的先例做模型在环筛选:只保留模型响应在两个计划间存在分歧的案例,并要求被拒计划也保有最低响应份额,剔除所有模型一致答对的'简单'案例;作者明确说明因此分数是诊断性的,度量的是'模型能否识别人类修正',不能估计全部科研活动中的失败率。
方法步骤详情
构建与评测分五步。第一步,候选决策提取:从资深研究员的消息和项目'人类指令区'的改动中定位纠错点。第二步,案例撰写:Grok 4.6 检查完整项目历史,在人类介入前选定一个 commit,恢复原始 LLM 计划,并用介入内容与后续科学进展重建修正计划;写作指令排除纯管理操作、状态不可恢复或无法重现的决策、以及无法关联到具体错误的纠正。第三步,筛选:对每个候选案例运行 5 模型 × 12 条件 × 2 顺序共 120 份响应,保留响应在两计划间有分歧且两计划均保有最低份额的案例,最终得到 248 例(其中 4 个单边案例经对照该 commit 的文档核验后保留)。第四步,评测:12 个条件为(项目记录/仅选项)×(low–max 五档努力)共 10 个初始条件,外加两次继续深思的复查条件;每个条件都做正反两种选项顺序,案例内对两序取平均后按案例等权汇总,8 份无法解析的响应计为错误。第五步,人类基线:13 名未接触过源项目的博士生与博士后通过阅读界面学习项目后作答,可调用智能体助手协助理解记录,但由本人做最终选择,结果 248 题答对 182 题,准确率 $73.4\%$。
技术新颖性
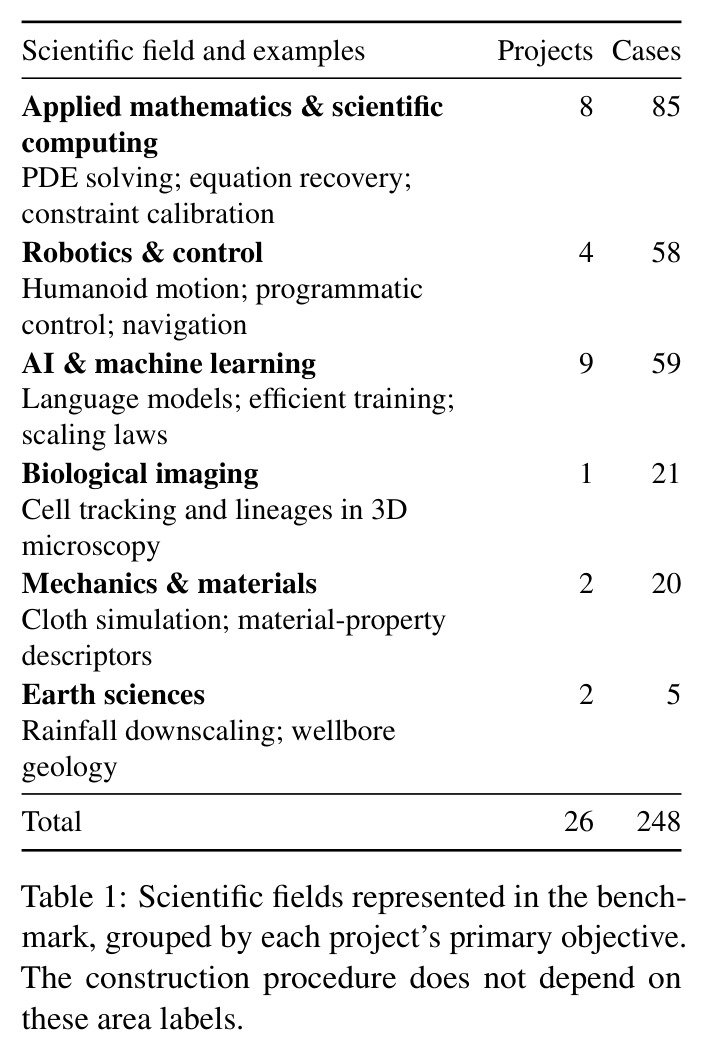
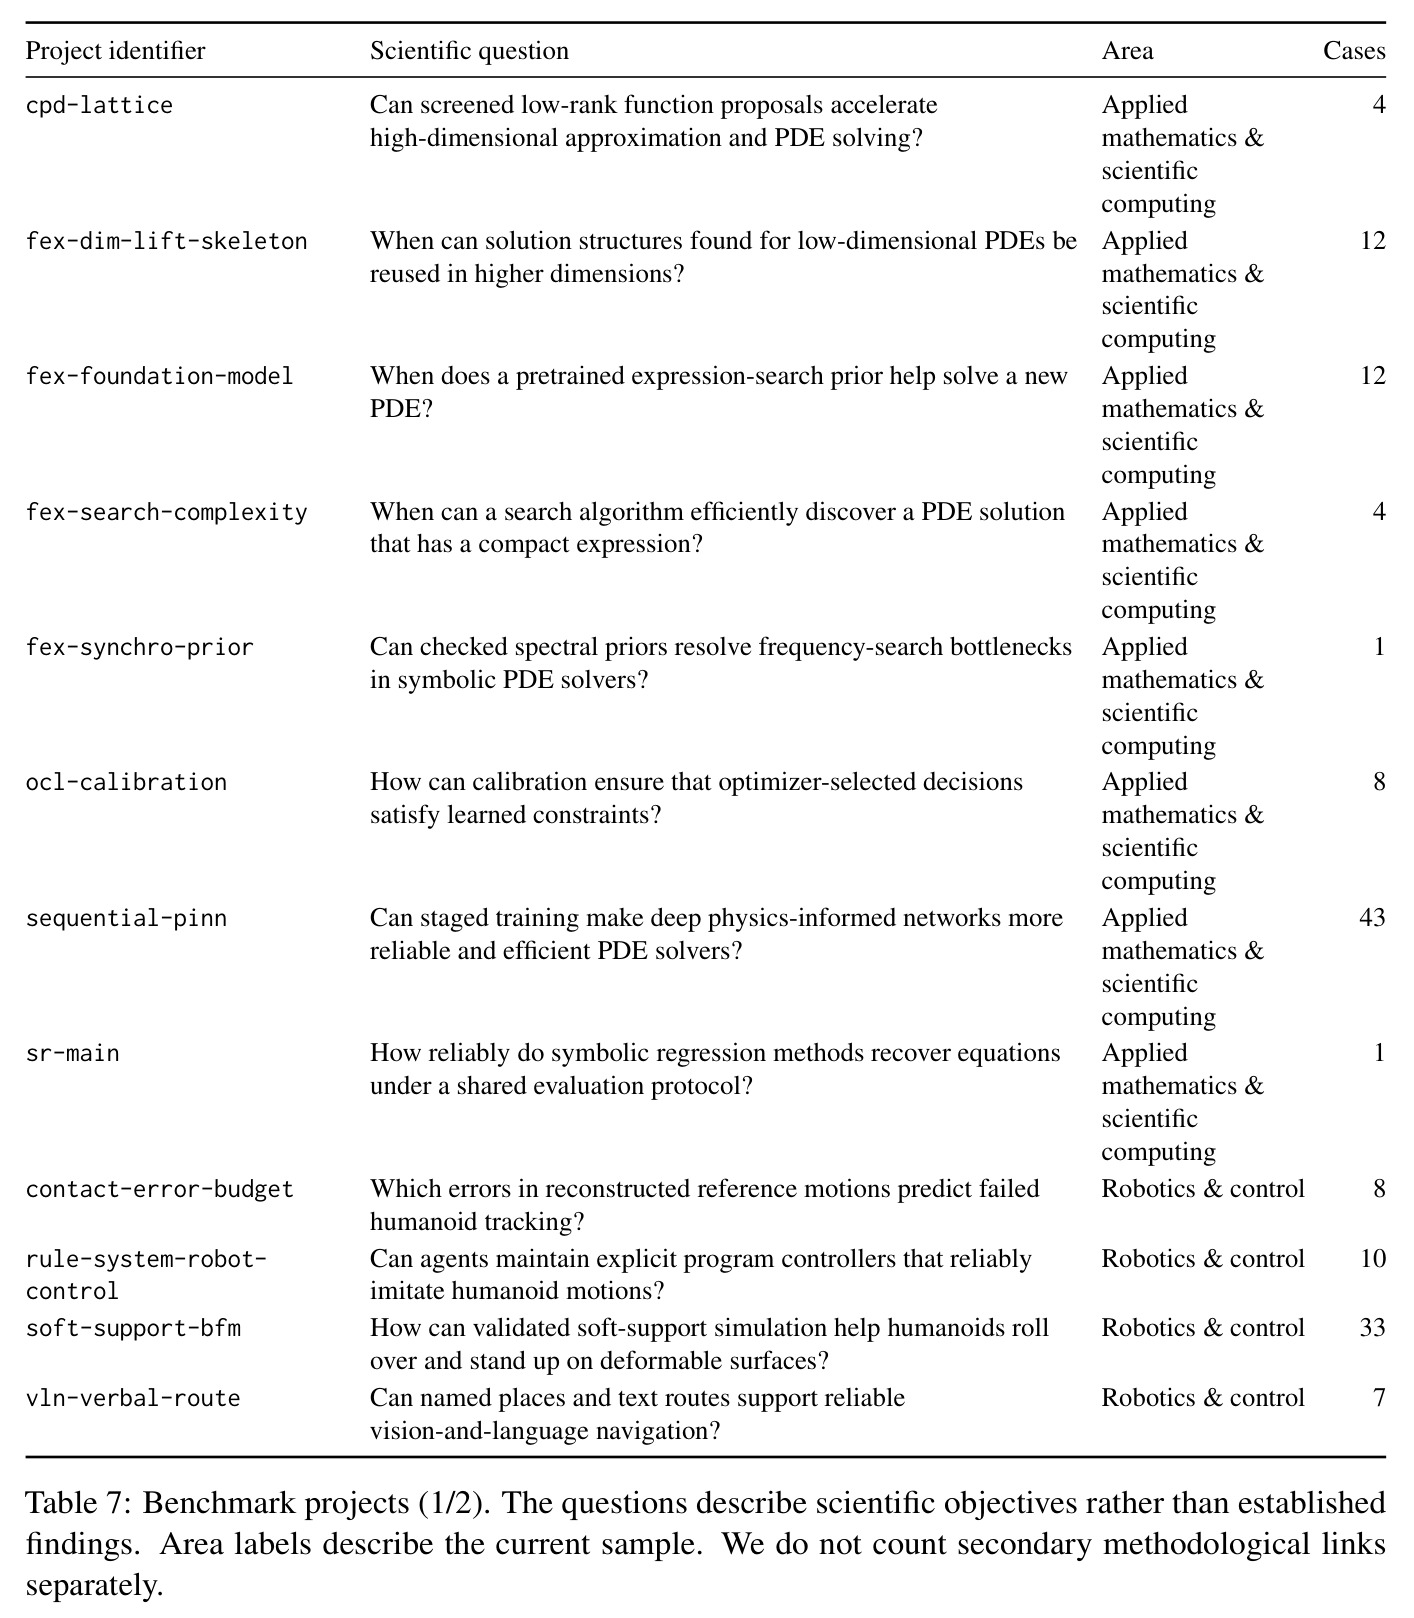
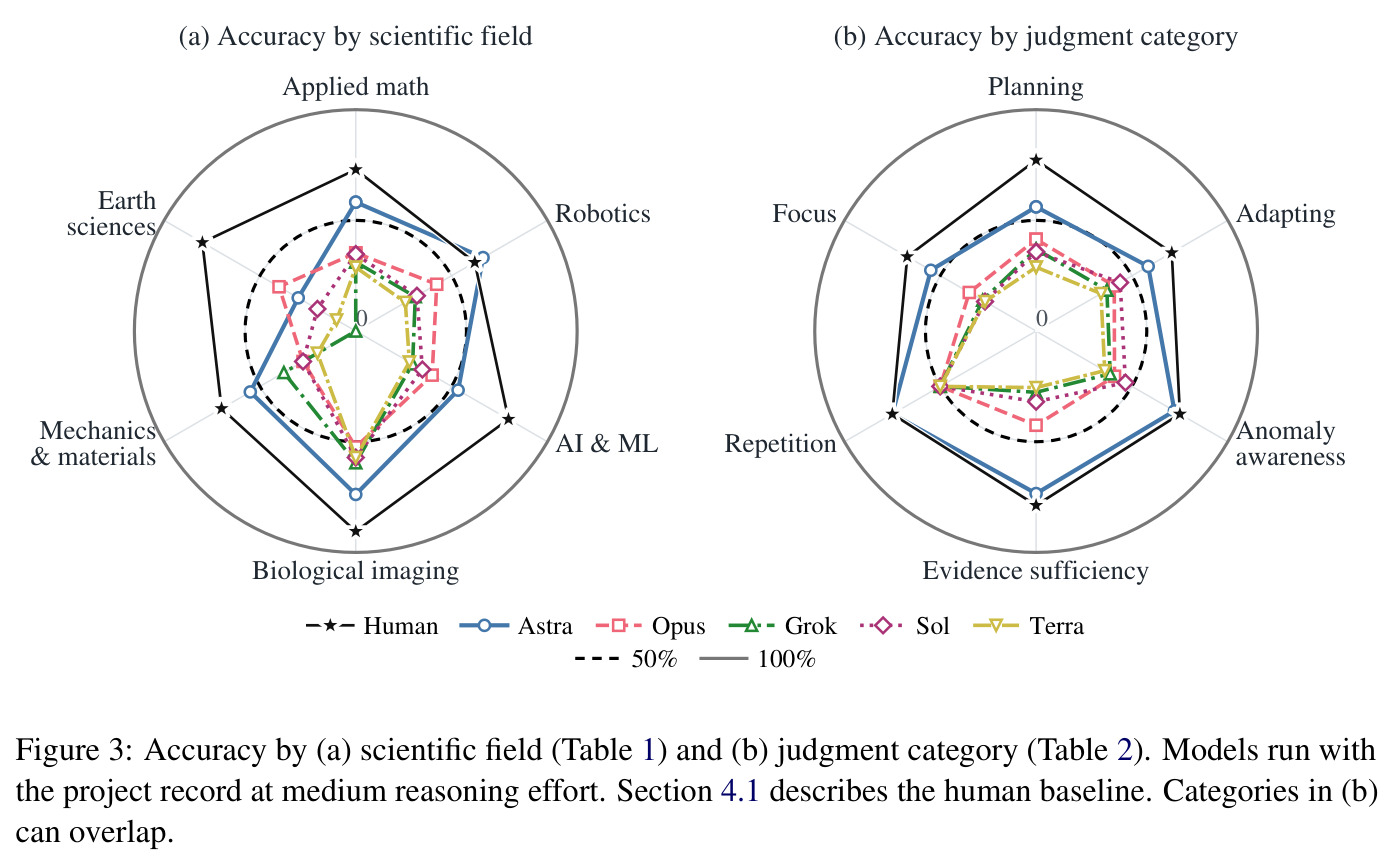
与同类工作相比,SciΠvot 的新颖性在于:它是首个完全建立在'真实前沿科研项目 + 资深研究员现场纠错 + 后续实验证据'之上的判断力基准,案例跨越约半年、26 个项目、6 个领域(Applied mathematics & scientific computing 85 例、Robotics & control 58 例、AI & ML 59 例、Biological imaging 21 例、Mechanics & materials 20 例、Earth sciences 5 例)。配套的六类判断分类学(Planning 123、Focus 122、Anomaly awareness 88、Adapting 65、Evidence sufficiency 47、Repetition 4,标签可重叠)由独立的历史错误编码产生,编码过程只使用原始 LLM 计划与人类纠正、不接触被评模型的任何响应,从流程上杜绝了标签泄漏。此外,方法不依赖领域标签,论文强调只要存在可恢复的项目状态与有记录的人类纠正,该流程即可推广到其他科研场景,这使其有望成为可续填的活体基准而非一次性评测。
实验结果
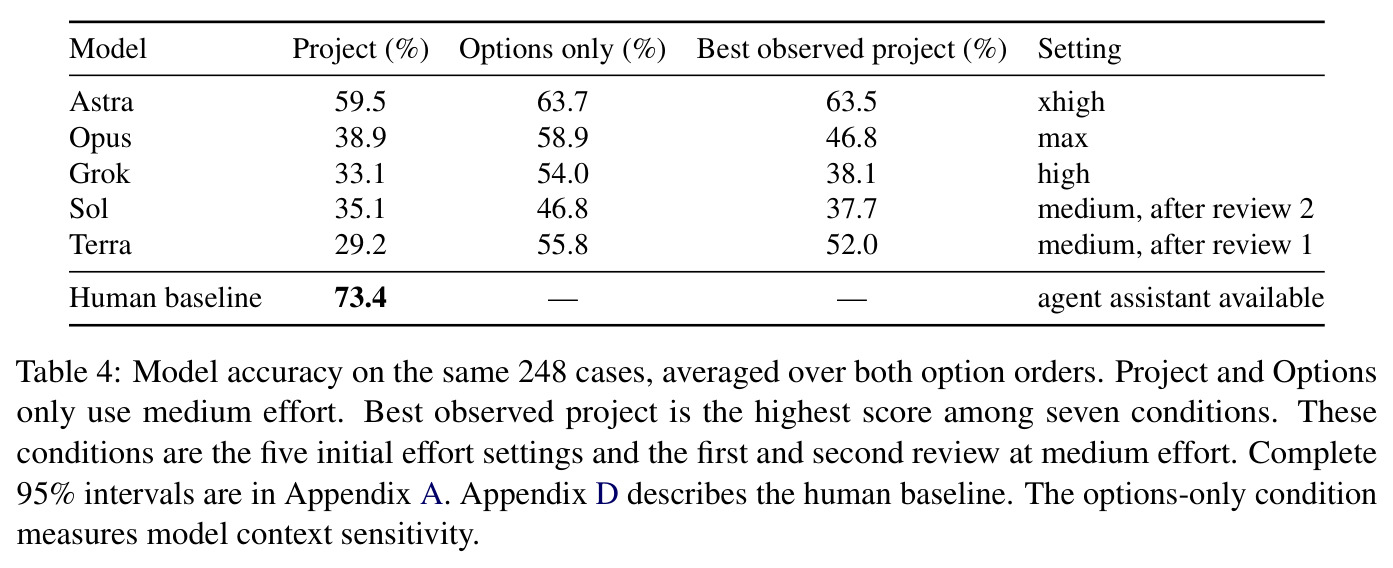
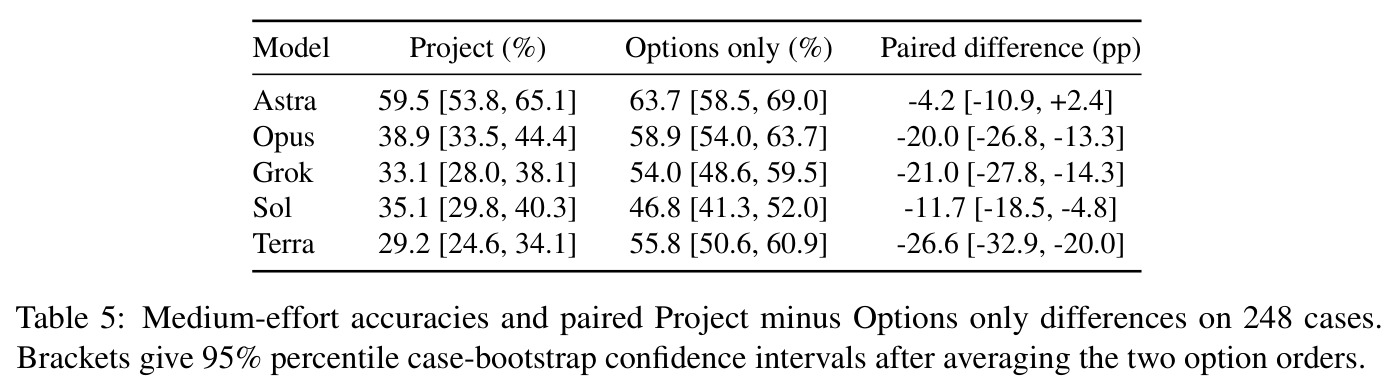
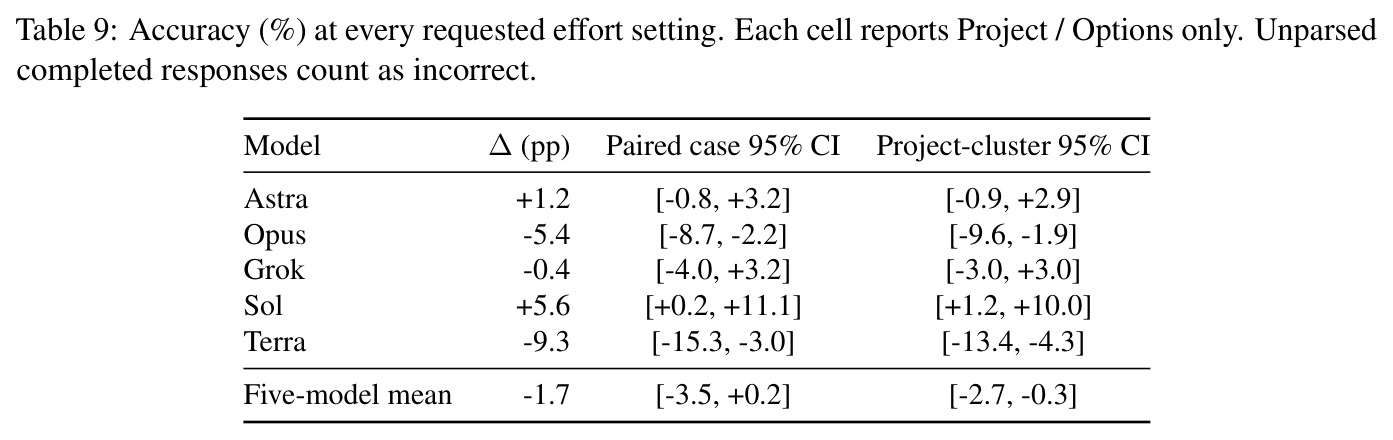
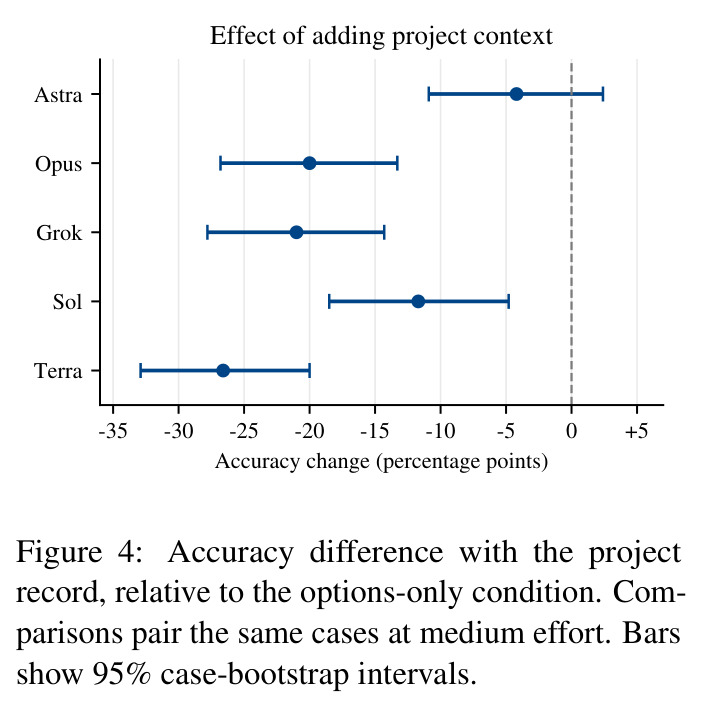
主实验(248案例、中等努力、含项目记录、双序平均)五模型准确率:Astra $59.5\%$、Opus $38.9\%$、Grok $33.1\%$、Sol $35.1\%$、Terra $29.2\%$(均值 $39.2\%$),四个低于 $50\%$ 随机线;最高设定 Astra xhigh $63.5\%$ 仍比人类新手基线 $73.4\%$ 低 9.9 pp。项目记录反而有害:加记录后五模型全部低于仅看选项的条件(均值 $55.8\%$),配对差 $-4.2$pp(Astra)至 $-26.6$pp(Terra),四模型区间不含零,根源是记录混有智能体自身错误解读,如 Opus 采信 STATE.md 未验证断言。类别差异明显:Astra 异常意识类 $72.2\%$,planning/focus 类仅 $56.1\%/54.9\%$;49 个案例五模型双序全选被拒计划,仅 16 个全选参考计划,且原始计划均为 on-policy 文本,偏爱自身输出是系统性签名。提高努力收益不一致:Astra $57.7\to63.5\%$,Sol $36.1\to29.2\%$。无反馈深思呈'重新落网':复查一修复 422 错、引入 302 错($39.2\to44.0\%$),复查二修复 264、引入 305($\to42.3\%$);Terra $29.2\to52.0\to42.7\%$;Opus 在 Transformer 案例先选对、复查二又退回被拒计划。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| PI 判断二选一(含项目记录,中等推理努力) | 准确率 (%) | 最佳 Astra 59.5;五模型均值 39.2 | 随机水平 50;人类新手基线 73.4(13 名博士生/博士后) | 4/5 模型低于随机水平;最佳模型仍落后人类基线 13.9 pp |
| PI 判断二选一(仅两个计划,无项目记录) | 准确率 (%) | 均值 55.8(最高 Astra 63.7) | 含项目记录条件均值 39.2 | 去掉记录反而整体 +16.6 pp,揭示模型被记录中继承的错误解读误导 |
| 各模型在其最优设定下的最高观测成绩 | 准确率 (%) | Astra 63.5(xhigh);Terra 52.0(复查1);Opus 46.8(max) | 人类新手基线 73.4 | 最强设定下仍差 9.9–26.6 pp,无一接近新手水平 |
| 第二次无反馈复查后的准确率变化 | 变化 (pp) | 五模型均值 -1.7(案例级 95% CI [-3.5, +0.2];项目聚类 [-2.7, -0.3]) | 第一次复查后的 44.0% | 持续深思不再改善甚至回退:修复 264 错、新引入 305 错 |
局限与改进
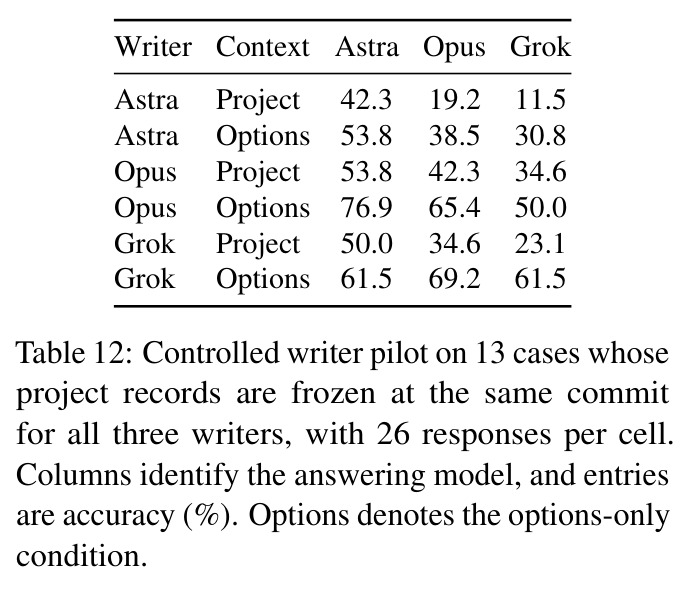
作者明确承认的局限包括:覆盖面限于 CPU/GPU 上的理论与计算型科研(仿真、数值计算、生物显微图像分析),湿实验与 COMSOL 等商业软件工作流不在评测范围内;基准度量的是'识别'正确研究决策,不评测计划生成与科研执行;经模型在环筛选的案例集是诊断性的,不能估计这些失败在全部科研活动中的发生频率;多个案例来自同一项目,因此需同时报告项目聚类置信区间;不同模型使用不同阅读客户端(GPT 系走 Codex 只读 shell,Opus/Grok 走 Claude 客户端工具),条件对比包含检索、解读与接口差异,并非纯判断的隔离测试。我补充几点观察:其一,人类基线是 13 名新手而非资深研究员本人,$73.4\%$ 只是'从记录中恢复修正'的能力下限,真正的专家上限可能更高,模型的差距因此可能被低估;其二,全部案例由单一模型(Grok 4.6)按单一指令集撰写,虽有三方撰写试点(Table 12)缓解,系统性的措辞或风格偏好仍难完全排除;其三,案例全文公开后存在被纳入训练数据的污染风险,基准区分度会随时间衰减,需要持续补充新项目案例的机制。
独立分析的弱点
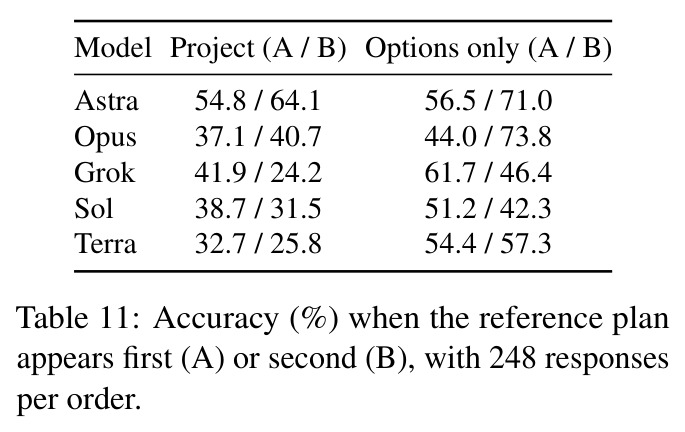
弱点一:二选一的离线形式剥离了执行维度——能选中正确计划的智能体未必能正确执行它,反之选中错误计划的模型也可能在执行中自我纠正;改进方向是把选择嵌入交互式评测,让智能体实际推进若干步后再评判结果。弱点二:判断类别极不均衡,Repetition 仅 4 例,Adapting 与 Evidence sufficiency 也偏少,按类别切分后置信区间很宽,削弱了 Figure 3b 类别画像的说服力;应扩充稀有类别或做分层采样。弱点三:参考答案依赖'资深研究员的单次纠正 + 后续证据',但同一决策点可能存在多个合理备选,未被记录的第三方案无法进入对比;可引入多专家独立纠正并测量标注者一致率,把共识度纳入评分。弱点四:26 个项目全部来自同一研究计划的半年实践,判断风格可能被该项目组的工作惯例塑形(例如对扫描规模的特定偏好),跨机构、跨实验室的复制是必要的效度检验。弱点五:选项顺序影响巨大——Opus 在仅选项条件下 A 序 $44.0\%$、B 序 $73.8\%$,说明位置偏好与推理深度存在交互,若使用者不做双序平均会得到严重偏倚的结论,基准文档应更醒目地警示这一点。
未来方向
作者提出的方向:每个案例天然构成(人类修正计划,原始计划)的偏好对,与 DPO 训练格式完全匹配,可训练偏好打分器为智能体强化学习中的研究动作提供奖励;下一步是检验这类训练能否在新项目上改善决策、并真正减少人工介入的频率。我的延伸方向:其一,把'项目记录中毒'现象——继承自 STATE.md 的未验证断言被当作既定证据——变成独立研究问题,设计要求模型先审计再采信的记忆与检索机制;其二,将六类判断编码发展为过程奖励模型(PRM)的细粒度标签,用于研究动作的 credit assignment;其三,把构建流水线推广到湿实验室和长期运行的科研智能体系统,检验 PI 判断的跨域迁移;其四,系统比较无反馈深思、外部反馈自精炼(Self-Refine/Reflexion 类)与验证器引导搜索在科学决策上的差异,弄清 re-trapping 在何种反馈条件下可被消除;其五,利用项目聚类结构做元分析,找出哪些项目特征(领域、智能体框架、项目时长)预测最多的人工介入,为自动化的'何时需要人类'触发器提供依据。
复现评估
开源情况总体良好:GitHub 仓库(AutoResearch-Factory/SciPIvot)提供全部 248 案例及匿名标识、每案例两个选项的原文与参考答案、精确的评测与案例撰写提示词,以及 12 个条件的聚合结果,许可允许研究与训练用途。未公开:单个模型响应日志,以及因体积过大暂缓上传、承诺后续托管的冻结项目记录,故第三方暂无法逐条复核响应级统计。复现评测需 5 个前沿模型 API、支持文件读取的客户端(GPT 系走 Codex 只读 shell 并禁网,Opus/Grok 走 Claude 客户端),按 12 条件 × 2 顺序 × 248 案例运行,全网格共 29,760 次调用,数千美元量级,工程难度中等。复现整个基准构建则难得多:需真实运行数月的多领域项目、资深研究员持续介入的记录,以及每案例 120 份响应的筛选算力。评测本身开箱即用,主要门槛是 API 成本与跨客户端差异控制。
论文图表
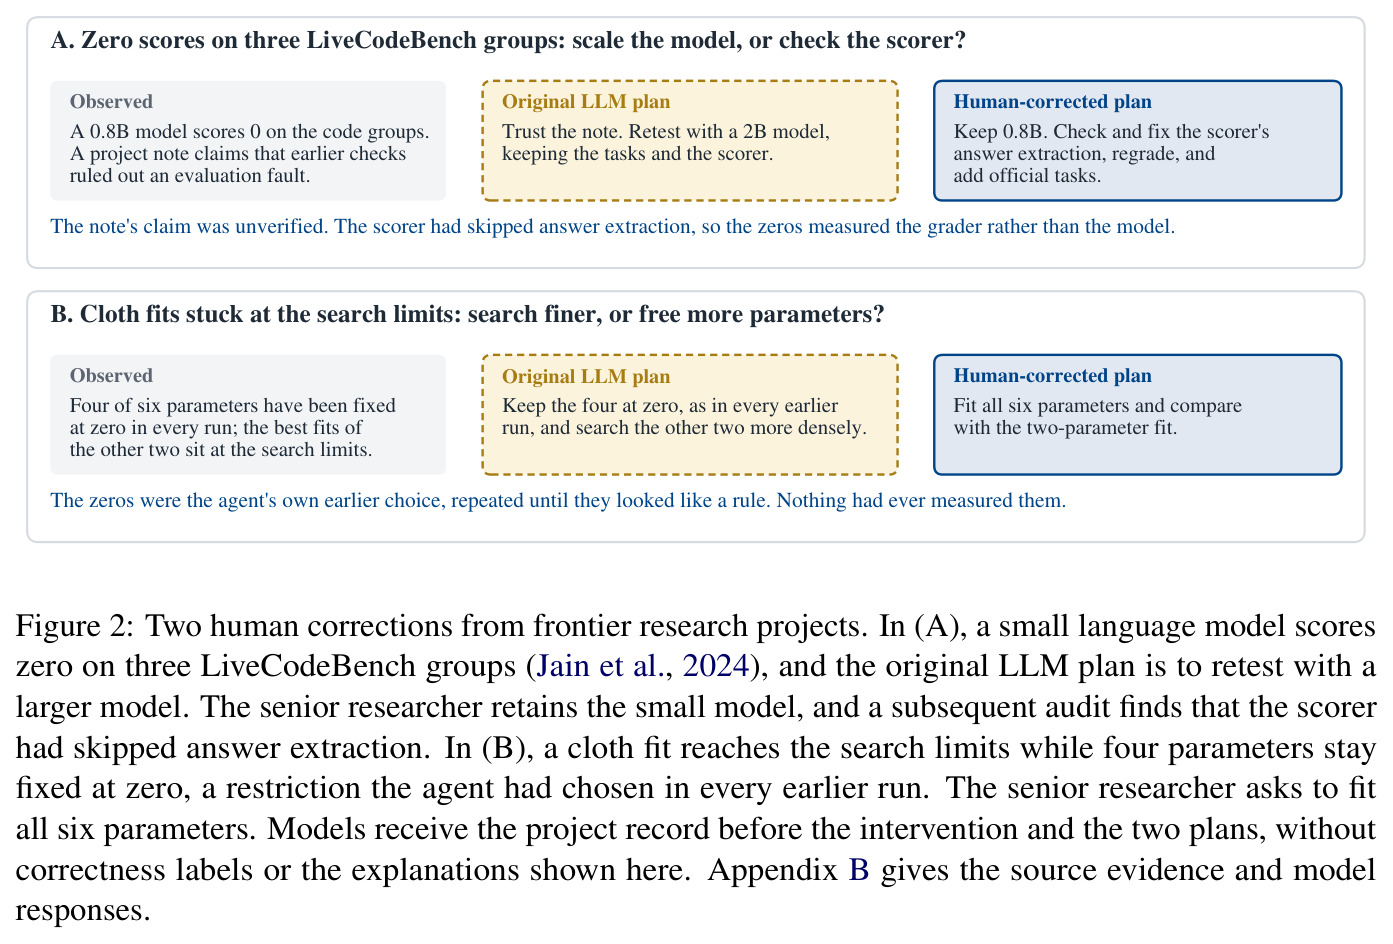
展示两个真实纠错案例。(A) 0.8B 模型在三个 LiveCodeBench 组得 0 分,项目笔记称已排除评测故障,原计划换 2B 模型重测;资深研究员保留 0.8B,后续审计发现评分器跳过了答案抽取。(B) 布料拟合中六个参数的四个恒为 0、另两个的最优解顶到搜索边界,原计划加密二参数搜索;人类要求六参数全拟合并与二参数拟合对比。评测时模型只看到记录和两个计划,看不到正确性标签与图中的解释。
用具体例子说明'PI 判断'实际长什么样、智能体犯的是什么类型的错,是论文动机部分最有说服力的证据。