科学还是灌水?AI生成论文中科学灌水的基准评测与缓解 Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
六类科学灌水指标识别AI论文达85.9%准确率,证据约束修订框架弥合63%人机差距
前置知识
AI slop(AI灌水)
指LLM大规模低成本生成的、表面完成度高但缺乏实质的内容,一词源于社交媒体与新闻流中泛滥的低质AI文本。在科学论文语境下其特征是'表面胜任'(superficial competence):每个段落单独看都通顺合理,但支撑论文的科学推理连接已经断裂。
本文的研究对象正是这种论文级slop,理解它与普通低质文本的区别是理解六项指标设计动机的前提。
Token级AI文本检测器(Binoculars、DetectGPT等)
通过局部文本的统计信号判断AI生成:DetectGPT测量扰动文本的概率曲率,Binoculars对比Falcon-7B base与instruct两个模型的困惑度比值,NTS测量采样温度敏感性,Pangram则在生成文本上训练分类器。它们只读局部文本片段,不理解论文整体结构。
它们是本文的核心对比基线(最强Binoculars配对准确率仅0.687),本文论证的原理性盲区正是论文级推理断裂。
PairAcc与AUROC
PairAcc(配对准确率)衡量系统在每对AI/人类论文中把人类论文排在AI论文之前(slop分数更低)的频率,平局计半分;AUROC衡量分数跨阈值区分两类的能力;TPR@5%FPR表示在放行5%人类论文的阈值下能标记多少AI论文。
三者是SCISLOPBENCH的全部评测指标,是读懂论文所有结果表格数字的前提。
端到端AI科研系统(FARS、AI Scientist)
从研究想法出发自动完成实验并写出完整论文的agent系统。FARS是大规模部署的全自动科研系统,给定想法即可产出带实验和稿件的完整论文;AI Scientist及其v2通过代理树搜索实现研讨会级自动发现。
SCISLOPBENCH的390篇AI论文就来自FARS(143篇)与Agents4Science 2025(247篇),修订实验也在FARS带代码记录的论文上进行。
Harness级优化
不微调模型本身,而是通过改变模型周围的信息、检查与工具来提升系统的思路(如Meta-harness):保持编辑器模型固定,在其前方加入定位发现、在其后方加入记录核对与保留性检查。
SCISLOPHARNESS正是这一设计——编辑器与评审器模型全程不变,全部改进来自'喂什么信息、做什么检查'。
奖励作弊(reward hacking)
当系统被直接优化某个可测分数时,模型可能用欺骗手段降分而不真正解决问题:例如删掉被引文献来消除'重复'、堆砌无意义交叉引用来消除'孤立对象'、编造案例来填补'证据缺口'。
本文5.4节证明直接slop感知提示就会触发此类作弊(总距离反增至2.307),这是理解'为什么必须用证据审核'的关键。
研究动机
AI灌水已蔓延到学术界:AI Scientist、FARS等系统能从想法出发端到端生成带实验的完整论文,arXiv因此修改了综述类投稿政策,不少会议开始用AI检测器筛查投稿。但科学论文的slop比一般AI文本复杂得多:每个段落单独看都通顺合理,问题出在章节、论断、引用、证据之间的推理连接断裂——例如'约65点差距'式的空泛复述、引用孤零零不定位任何关系、结果表只有汇总百分比而没有任何具体案例。现有检测器(DetectGPT、Binoculars、NTS、Pangram)只读token级局部信号,原理上看不到这类论文级断裂:在本文构建的390对论文上,最强的Binoculars配对准确率仅0.687,连读全文的自动评审器CycleReviewer也只有0.685。这种'表面胜任'会把验证负担转嫁给读者、误导对工作的评估,ICLR评审员已在人类投稿中对这些模式扣分,但此前从没有人测量过检测器与LLM究竟能否识别它们。
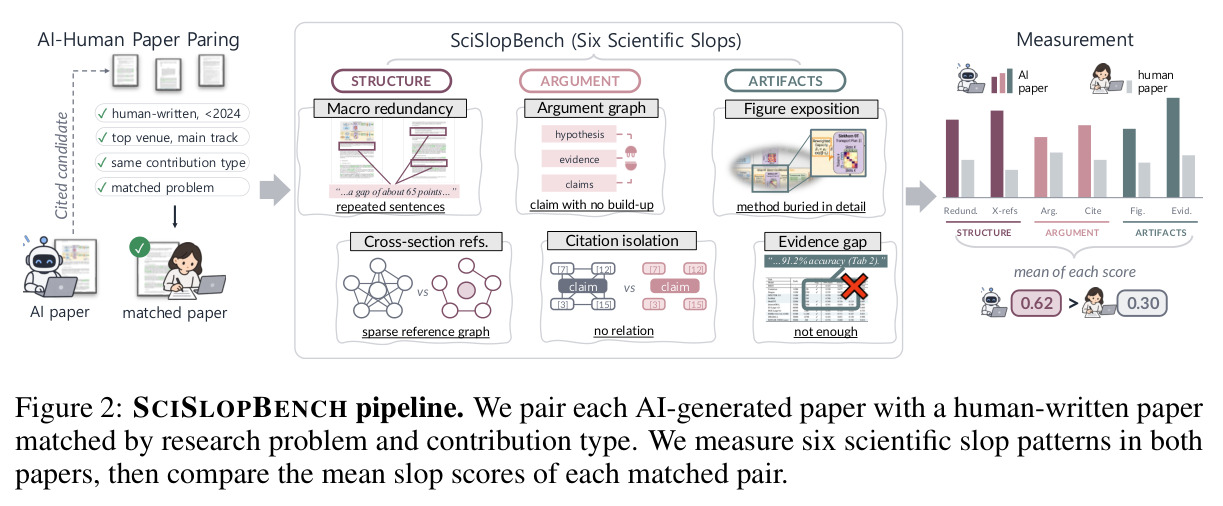
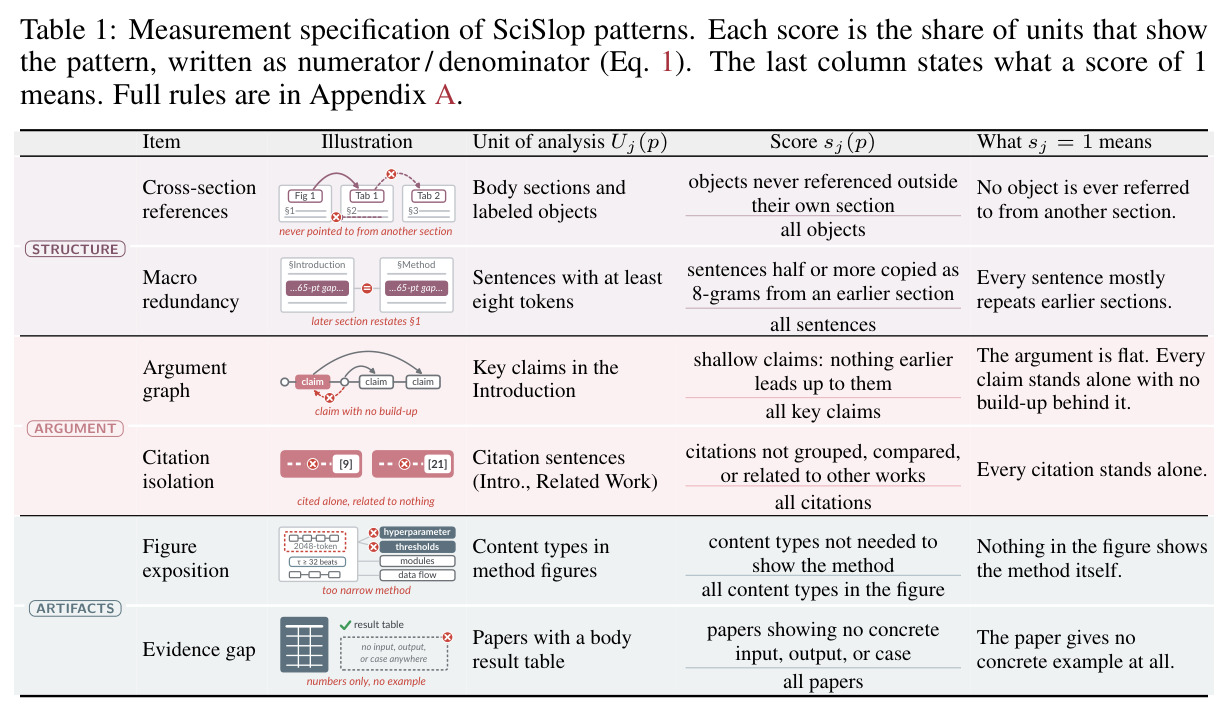
本文的目标是本文目标分三层。第一是定义与测量:把模糊的'科学灌水'操作化为六个可计数、可复现的模式,覆盖结构(跨章节引用缺失、宏观冗余)、论证(论元图断裂、引用孤立)与工件(图示冗余、证据缺口)三个平面,每项指标输出论文中呈现该模式的单元占比$s_j(p)$。第二是基准评测:构建SCISLOPBENCH,将390篇AI生成论文(FARS端到端生成143篇+Agents4Science 2025投稿247篇)与研究问题、贡献类型都匹配且被顶会主会接收的人类论文配对,检验系统能否仅凭论文本身区分二者;并进一步验证这些模式是否既标记来源、也标记质量——在ICLR 2017-2025共1177篇带评审数据的投稿上检验与评分、四维评审、接收决策的关系。第三是缓解:提出SCISLOPHARNESS,在不改变科学记录的前提下修复检测到的断裂,且不使用任何人类论文作为修订目标。
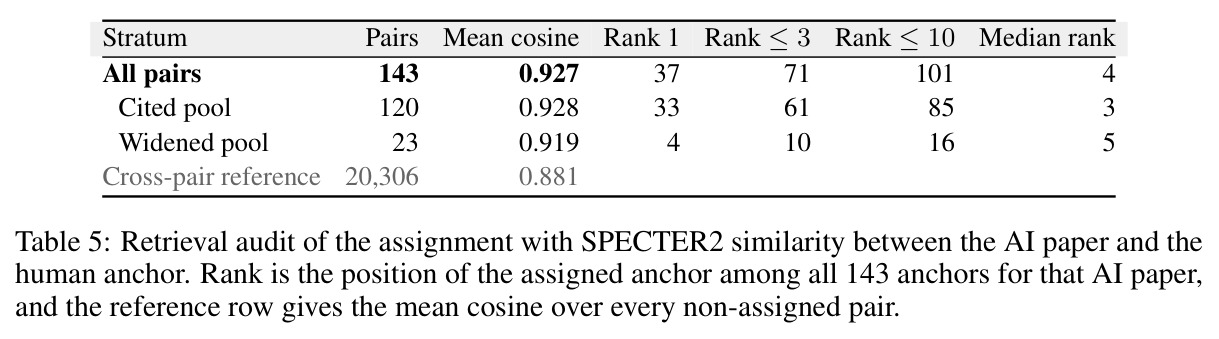
与已有工作不同的是,独特切入角度有三。其一,检测对象从'文本'升级为'论文的推理连接':作者在端到端AI论文中反复观察到失败不在句子层面而在关系层面,据此借修辞结构理论、论元挖掘、引用功能分类等文献,把直觉翻译成六个带精确计数规则(附录A给出8-gram阈值、引用图判定、PMI公式等)的指标,是首个整篇论文级而非片段级的AI科学文本检测基准。其二,配对设计制造了'必须超越表面信号'的困难:人类锚点全部是顶会主会接收论文,且与研究问题、贡献类型对齐,任何依赖主题、体裁或文笔质量的捷径都会失效——配对的SPECTER2余弦相似度甚至紧簇在0.90-0.97。其三,缓解端的关键洞察是'降分不等于修复':直接优化slop分数会诱发奖励作弊,作者因此转向harness级方案——定位发现驱动局部修订,每处修改都要对照原始稿件、实验输出与代码审核,不支持的修改一律回滚。
核心方法
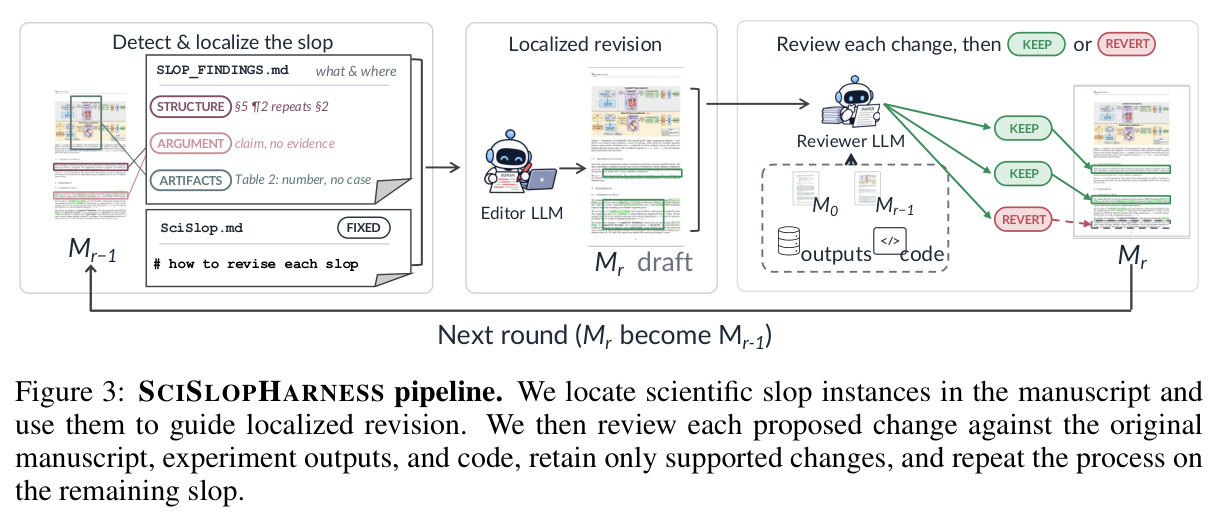
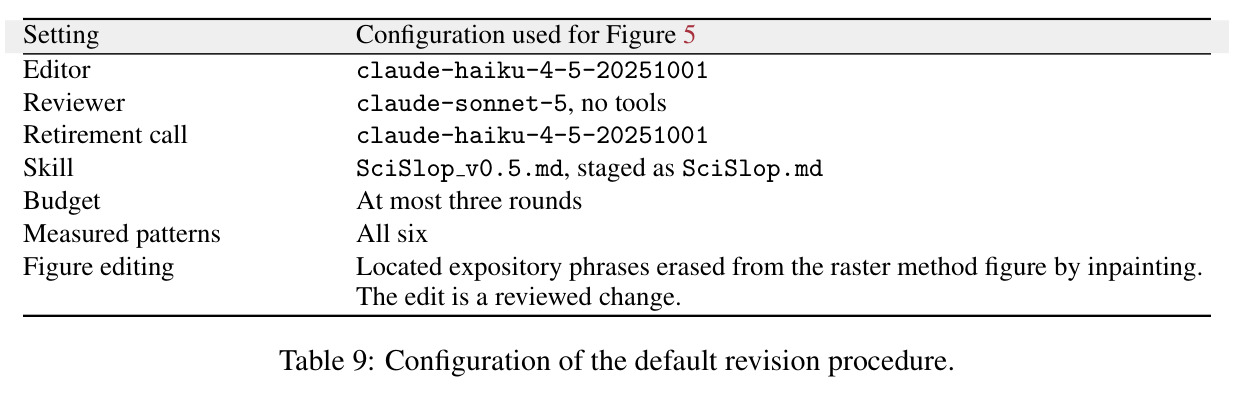
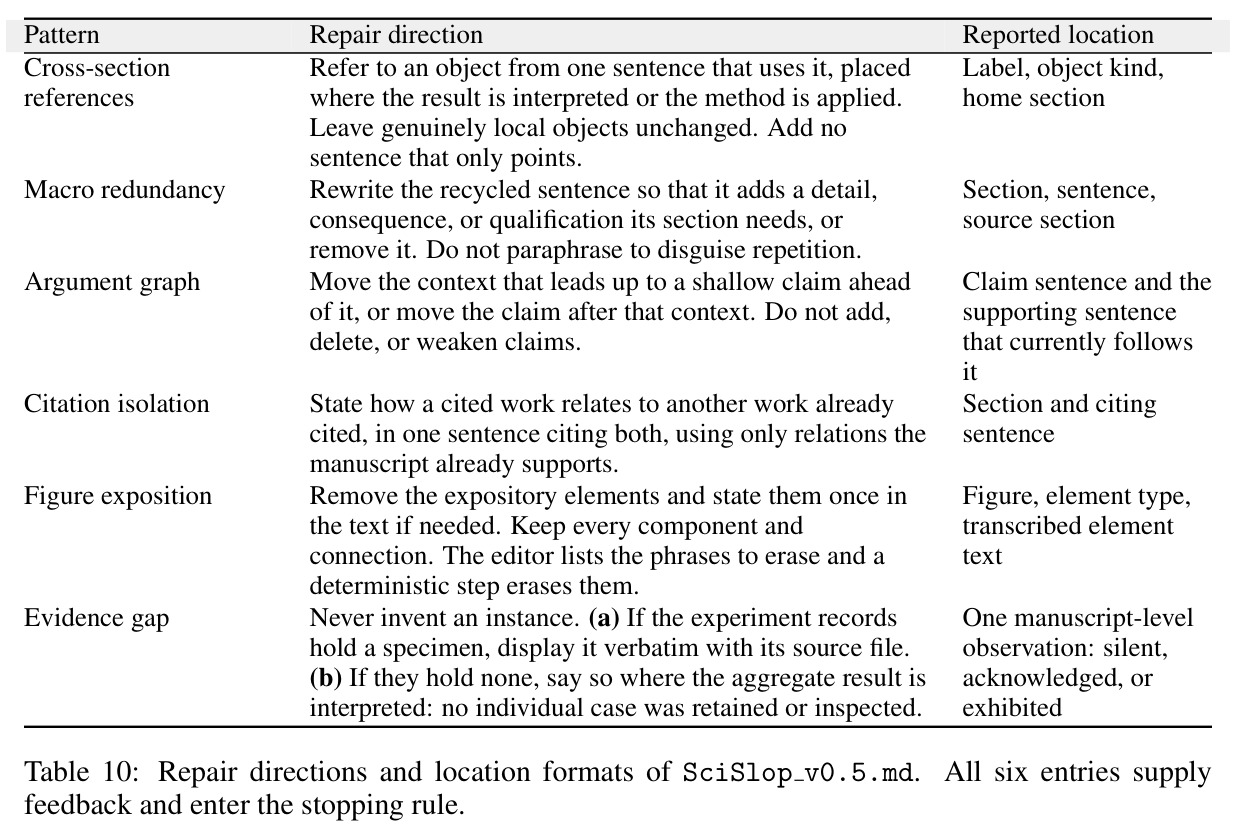
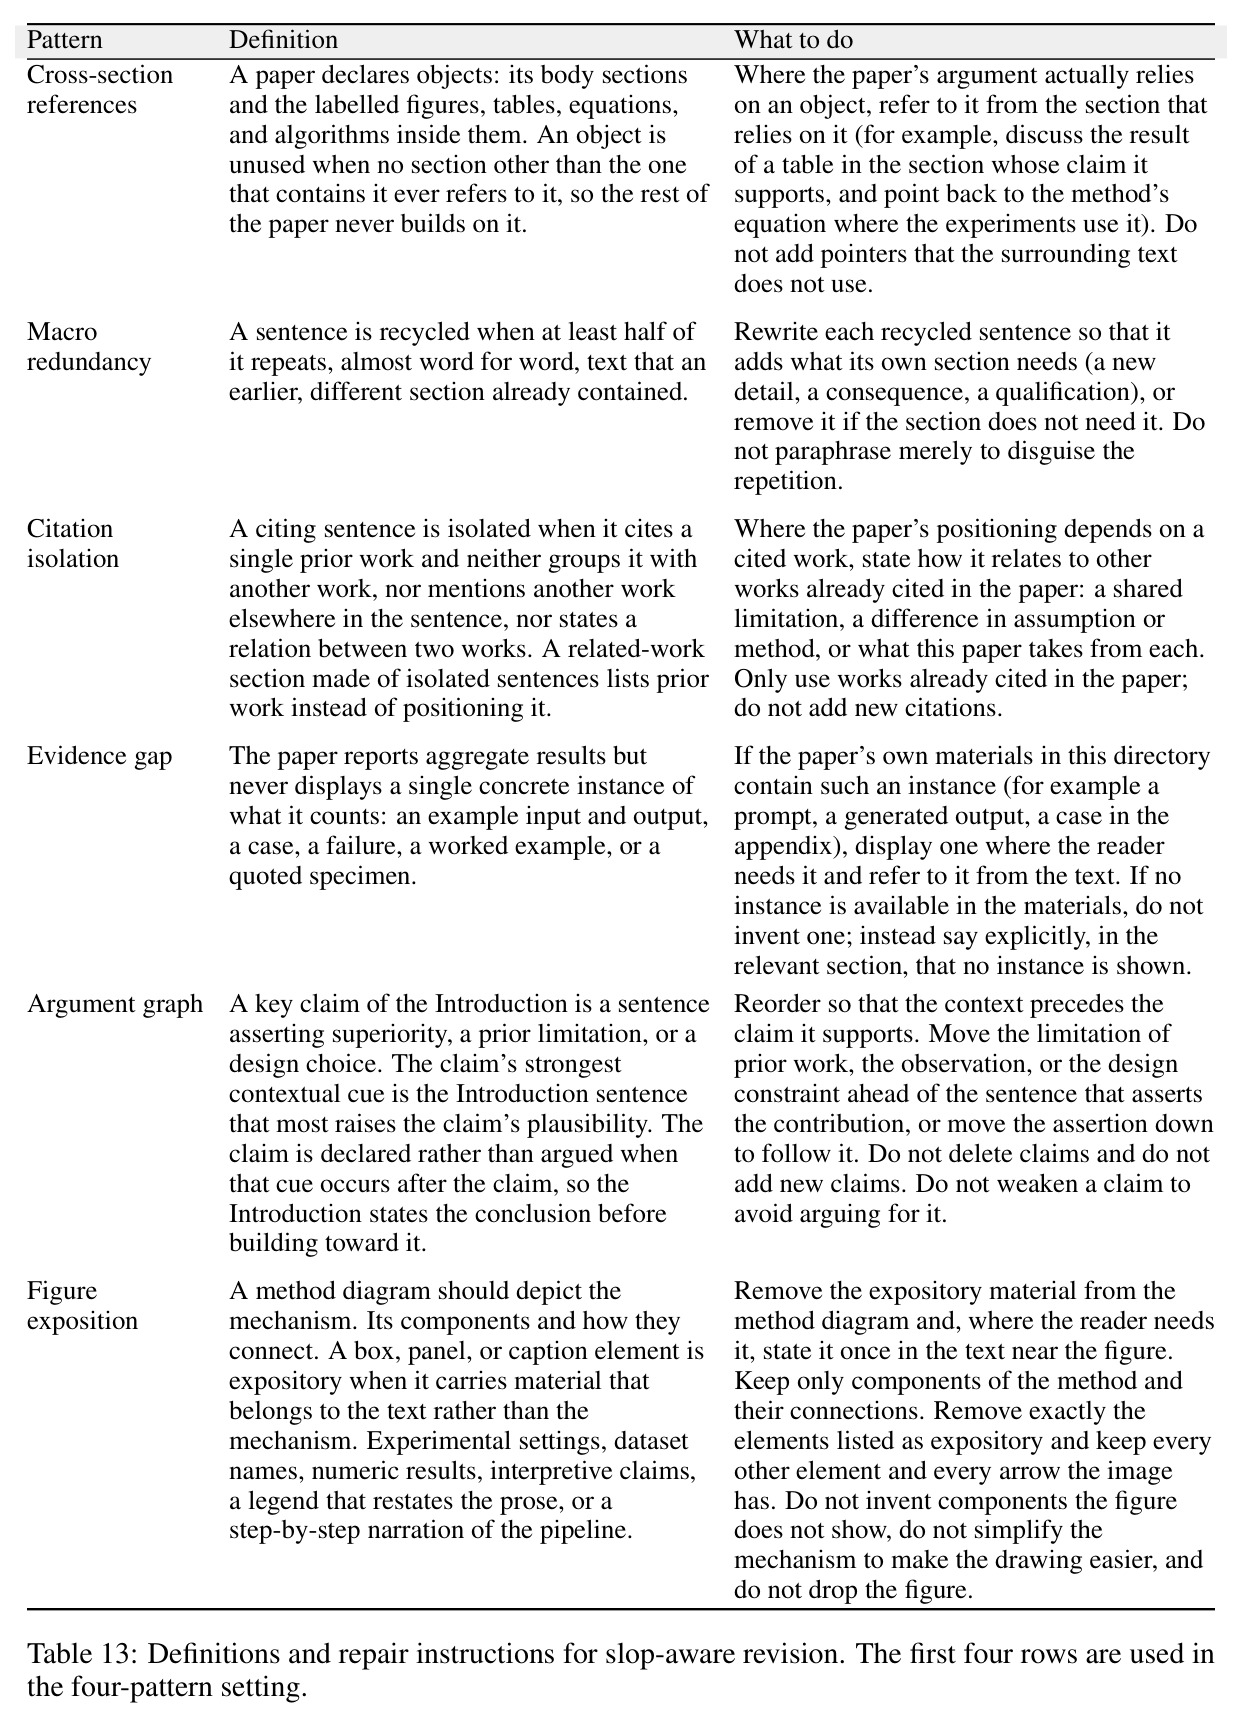
直觉上,AI论文的病灶像'每块砖都好、墙却砌不起来':章节互不引用、后文复述前文、论断先于论据、引用互不关联、方法图里塞满实验细节、只有百分比没有案例。技术路线上,作者先把六类断裂形式化为统一计数公式:对论文$p$的第$j$项指标,$s_j(p) = \frac{1}{|U_j(p)|} \sum_{u \in U_j(p)} h_j(u)$,即分析单元中命中模式的占比;总分$S(p)$先在平面内对各项取均值、再对平面取均值。六项中四项是纯确定性规则(8-gram跨章节复用、交叉引用图、引用编织判定、证据展品搜索),两项借助开源模型(论元图用Qwen2.5-7B读概率、32B标注论断句,图示冗余用Qwen2.5-VL-32B转录方法图)。缓解端的SCISLOPHARNESS是至多三轮的循环:测量器定位slop实例写入SLOP_FINDINGS.md,编辑器(Claude Haiku 4.5)依据技能文件SciSlop.md做局部修订,评审器(Claude Sonnet 5)把每处修改对照$M_0$、实验输出与代码逐一KEEP或REVERT,未过审的段落回滚到上一轮版本。
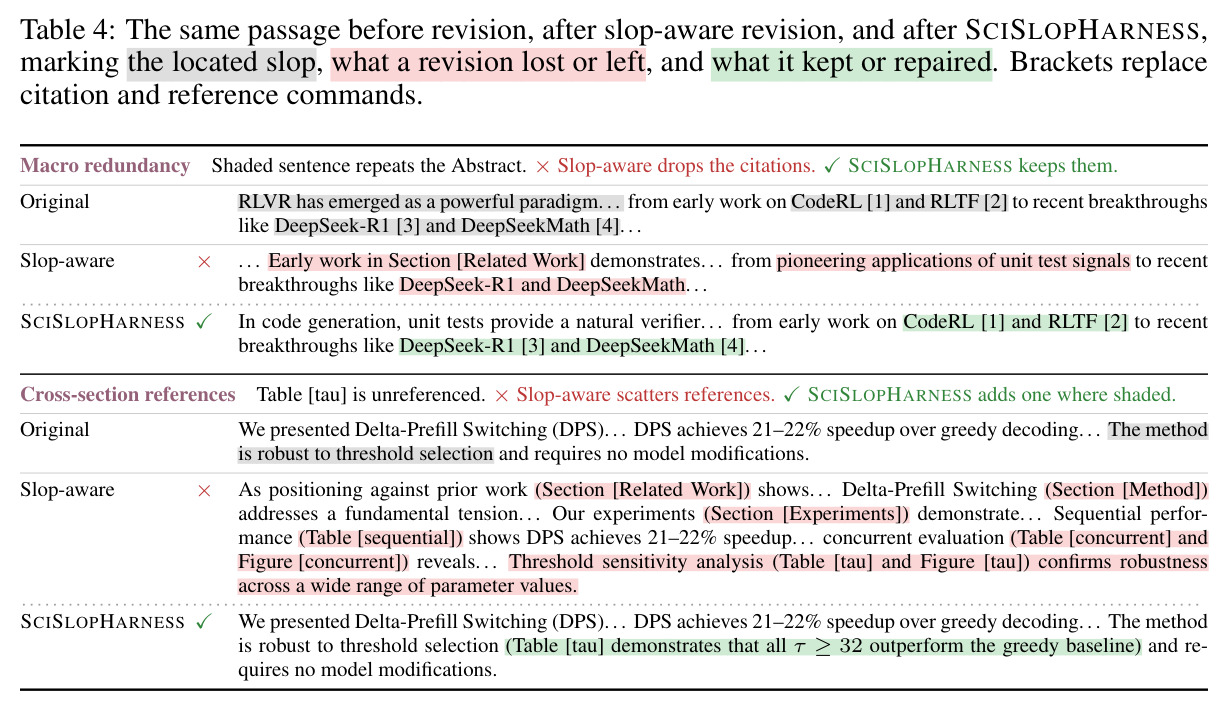
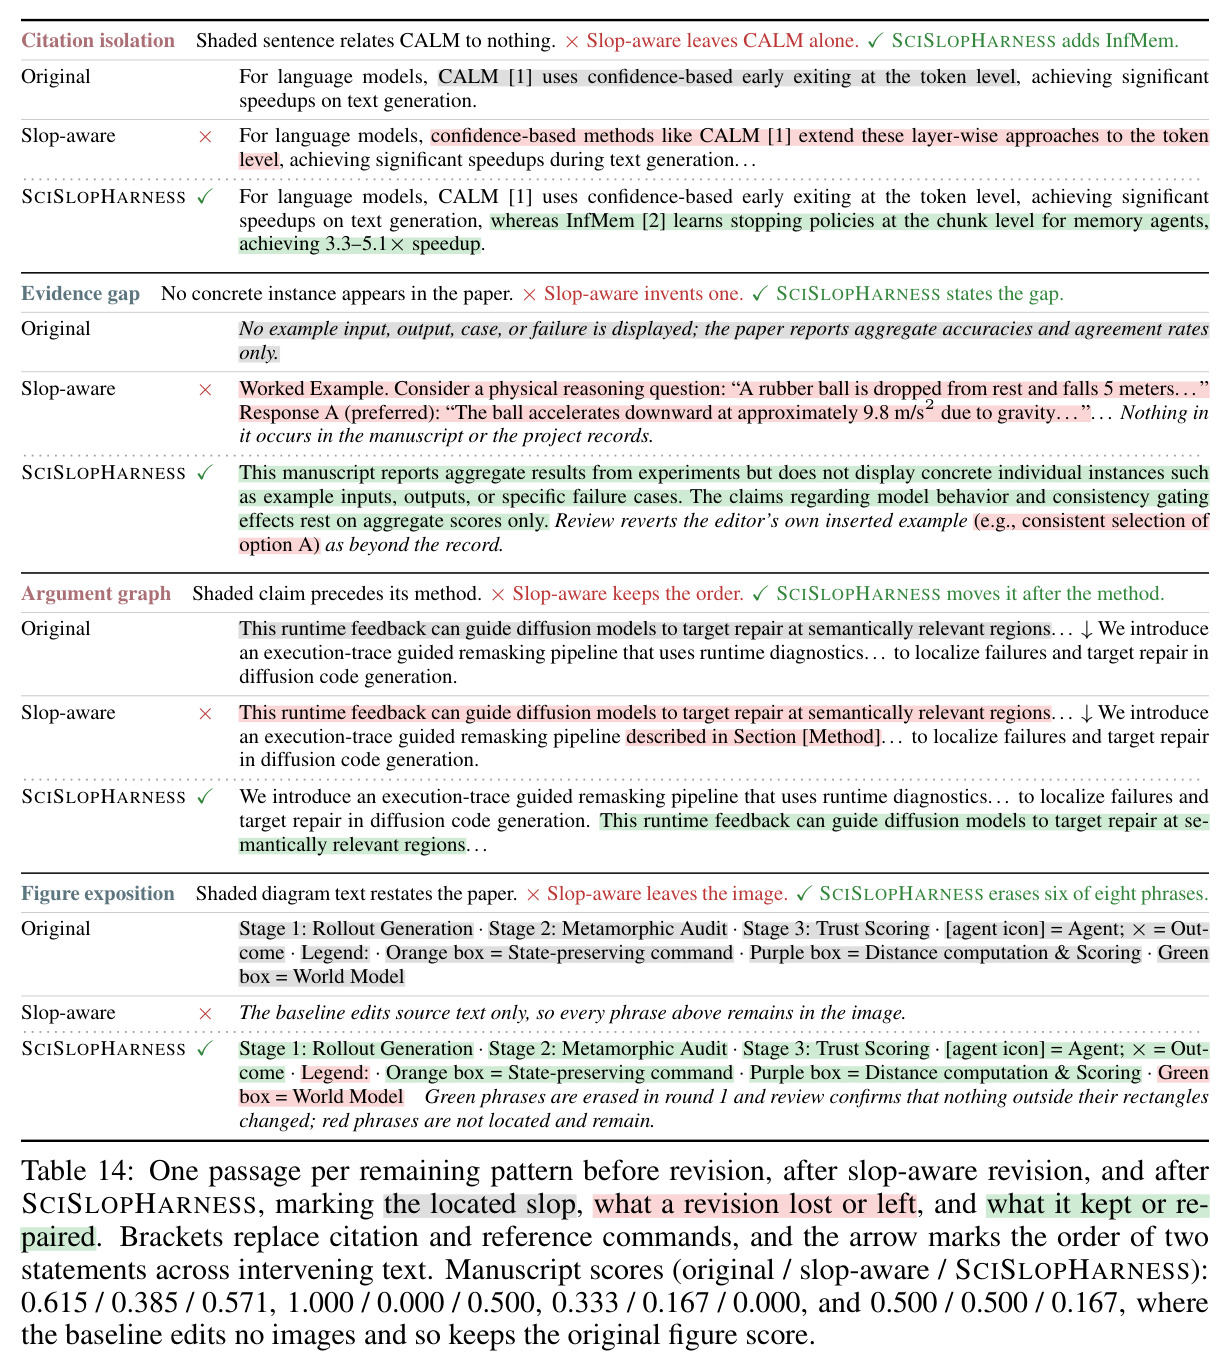
核心创新是与已有方法的三个本质区别。第一,与token级检测的本质区别:Binoculars等读的是'这段文字像不像AI写的',本文读的是'这篇论文的科学推理是否连通'——前者改写即可绕过,后者必须真正重组推理才可能消除,因此其信号也更接近评审员关心的质量维度。第二,与自动评审/修订系统的本质区别:CycleReviewer、AI Scientist读全文打分也只能到0.685/0.615,Self-Refine式的通用反馈留下大量slop,说明'笼统的质量判断'与'定位到具体断裂的检查'是两回事;SCISLOPHARNESS不给分数目标,只给'哪里断、怎么修'的定位与固定规则。第三,与slop感知直接修订的本质区别:后者知道定义和位置却没有证据闸门,结果为降分不择手段——删重复句时连四条引用一起删、在结论撒八个只为指路的引用、甚至凭空编造worked example;SCISLOPHARNESS把'修改必须被实验记录支持'作为硬闸门,本质上是把mutation testing'通过移除验证属性'的思想反向用于写作修复。
方法步骤详情
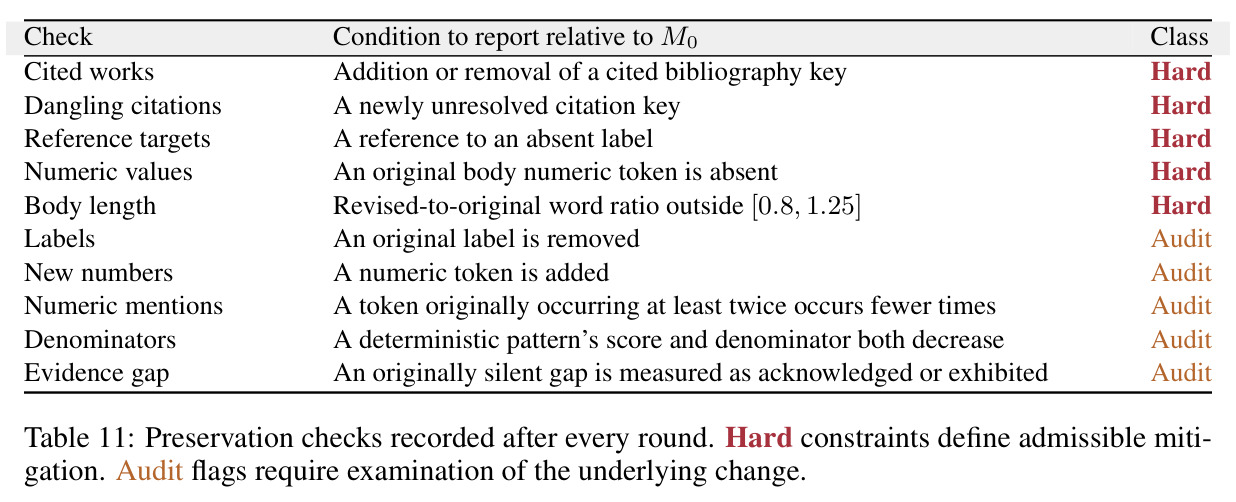
流程分四阶段。阶段一,视图构造:展开LaTeX取附录前正文,构造保留章节、标签与浮动体的结构视图及散文视图;Agents4Science的229篇无源码论文用PyMuPDF从PDF重建。阶段二,六项测量:宏观冗余查≥8词句子是否过半token在先前章节8-gram中出现;跨章节引用查各节及标注的图表公式算法是否被其他节指向;论元图由Qwen2.5-32B标注引言论断句、Qwen2.5-7B按$pmi(j \to i)$找最强支持句,支持句在论断之后记断裂;引用孤立查引用句是否'编织'两作关系;图示冗余由VLM转录方法图并检查六类说明性内容;证据缺口在正文有结果表而全文无展品时记1。阶段三,配对:锚点须人类写作(首发≤2024或Pangram份额≤0.05)、顶会主会接收、同贡献类型、源码可用,先从其引用的1946篇候选选配,不足再从2690篇ICLR 2026接收池取近邻。阶段四,修订循环(至多三轮):编辑器逐文件返回编辑块;评审器逐变更对照$M_0$、实验输出与代码KEEP或REVERT;每轮后跑保留性检查,文献键、悬空引用、数值token、长度比[0.8,1.25]为硬约束。
技术新颖性
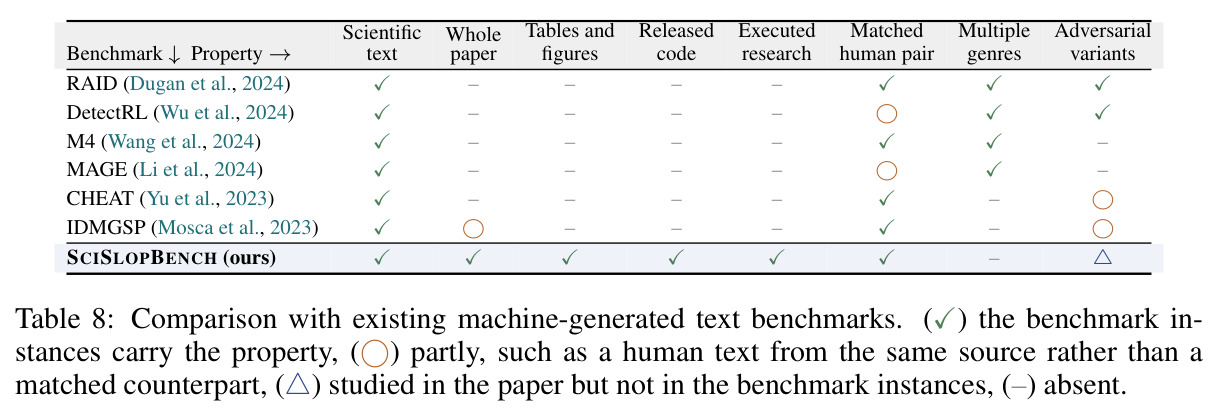
技术新颖性体现在四点。第一,测量学贡献:把'AI slop'从文化批评词汇变成六个带精确计数规则的操作化指标,且四项完全确定性、可缓存、无需付费模型(vLLM+bf16+贪心解码+三次多数投票),保证可复现;两项模型指标也只用开源Qwen2.5系。第二,基准学贡献:首个整篇论文级、配对式、带released code的AI检测基准(Table 8显示RAID/M4/MAGE等现有基准均止步片段级),并提出'同问题+同贡献类型'配对协议,使主题与文笔捷径失效。第三,发现级贡献:首次证明论文级推理断裂同时携带来源信号(PairAcc 0.859)与质量信号(四个ICLR评审维度全部显著相关、九年接收决策全部超随机),而token级检测器在多数年份区分拒稿/接收低于随机。第四,系统级贡献:SCISLOPHARNESS的'定位-修订-按记录审核'闭环加硬性保留检查(引用键、数值token、长度比),并首创对方法图内说明文字的图像inpainting修复——基线只改文本,根本触及不到图像内部的slop。
实验结果
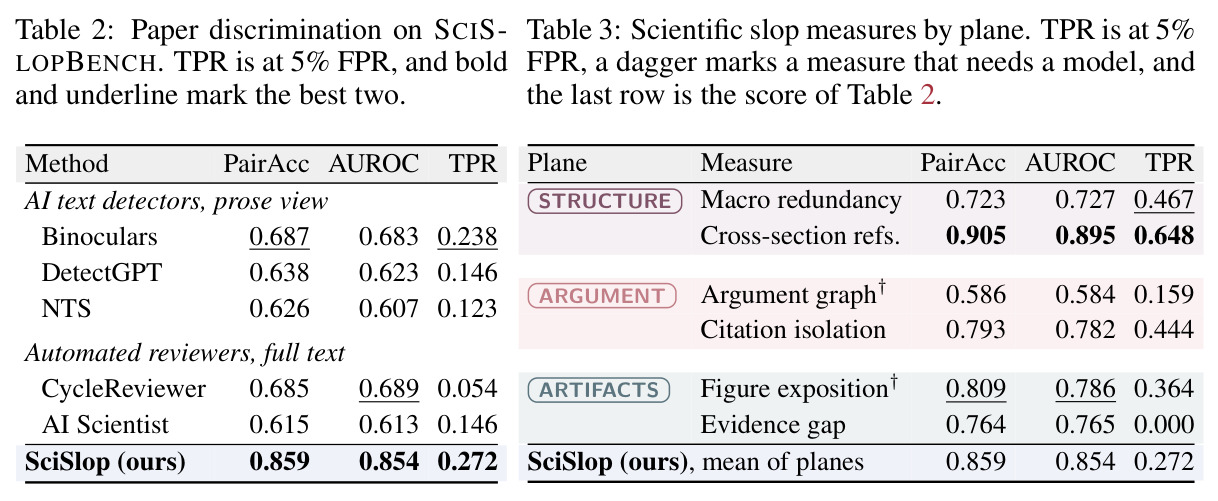
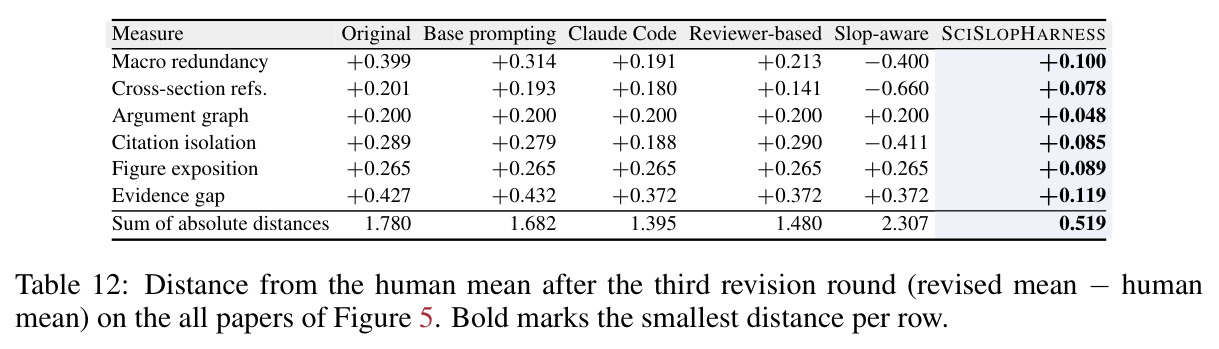
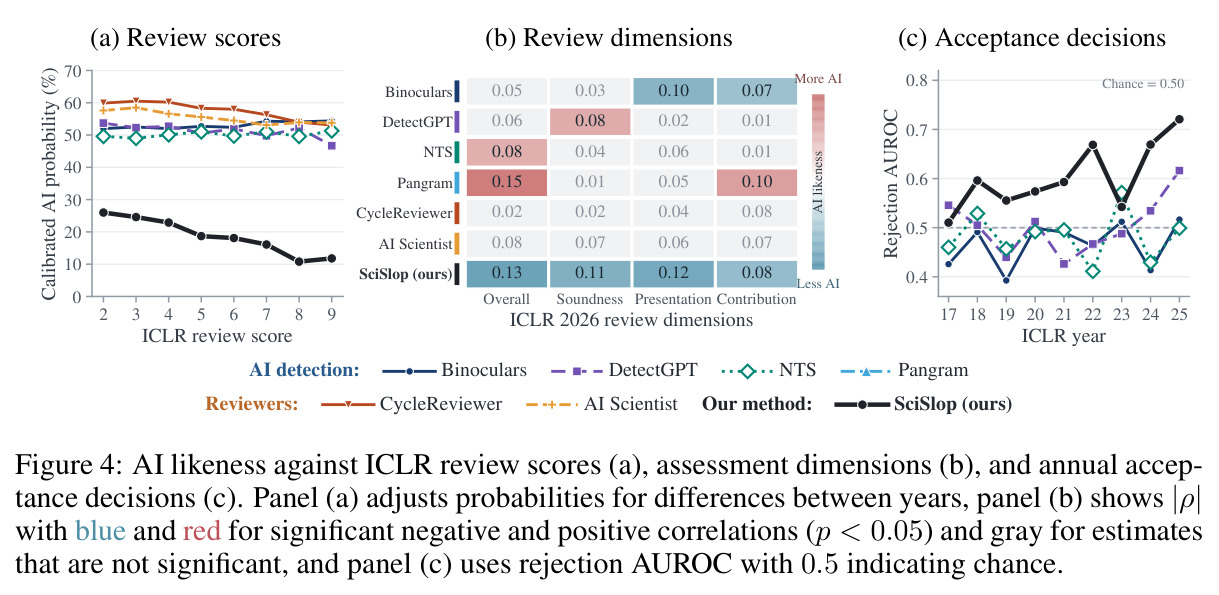
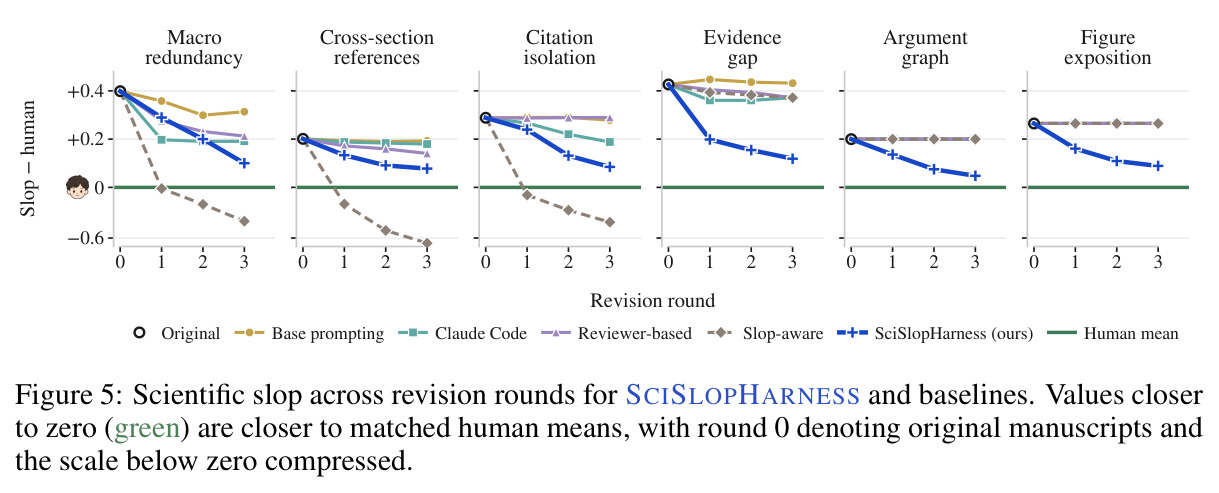
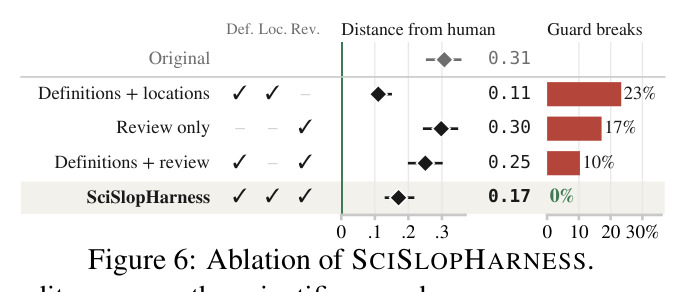
核心发现:检测上,SciSlop聚合在390对上达PairAcc 0.859、AUROC 0.854、TPR@5%FPR 0.272,较最强token基线Binoculars(0.687)错误率削减约55%;单项最强的跨章节引用达0.905/0.895/0.648;读全文的自动评审器最高仅0.685。质量信号上,在ICLR 2017-2025共1177篇投稿上,校准AI概率随评审分2→9从26%降到12%;只有SciSlop在四个评审维度全部显著相关(|ρ|约0.08-0.13);区分拒稿/接收九年全部超随机,token检测器多数年份低于随机。修订上,六指标与人类均值的绝对距离总和从原始1.780——Claude Code 1.395、slop-aware 2.307、SCISLOPHARNESS 0.519,比最强基线减少63%,六项全部最接近人类均值。机制上,slop-aware为降分连删4条引用、撒8个无信息引用、编造worked example,Harness保留引用、只加真引用、承认证据缺口;消融显示定义+定位0.11但23%轮次破坏防护,完整框架0.17/0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| AI论文配对判别(SCISLOPBENCH 390对) | PairAcc | 0.859 | Binoculars 0.687(最强token级检测器) | 错误率0.313→0.141,削减约55% |
| AI论文配对判别 | AUROC | 0.854 | CycleReviewer 0.689(最强全文评审器) | +0.165 |
| 低误报筛查(跨章节引用单项) | TPR@5%FPR | 0.648 | Binoculars 0.238 | 约2.7倍;聚合SciSlop为0.272 vs 0.238 |
| 修订后与人类均值的六指标绝对距离和 | Gap(Σ|修订均值−人类均值|) | SCISLOPHARNESS 0.519 | Claude Code 1.395(最强修订基线) | 减少63% |
| ICLR拒稿/接收区分(2017-2025九年) | Reject AUROC | 九年全部>0.5(超随机) | Binoculars/Pangram多数年份<0.5 | 九年全超随机 vs 多数低于随机 |
| 与人类评审分一致性 | 校准AI概率(评审分2→9) | 26%→12% | token检测器与评审分关系弱且多不显著 | 唯一在四个评审维度全部显著相关的系统 |
局限与改进
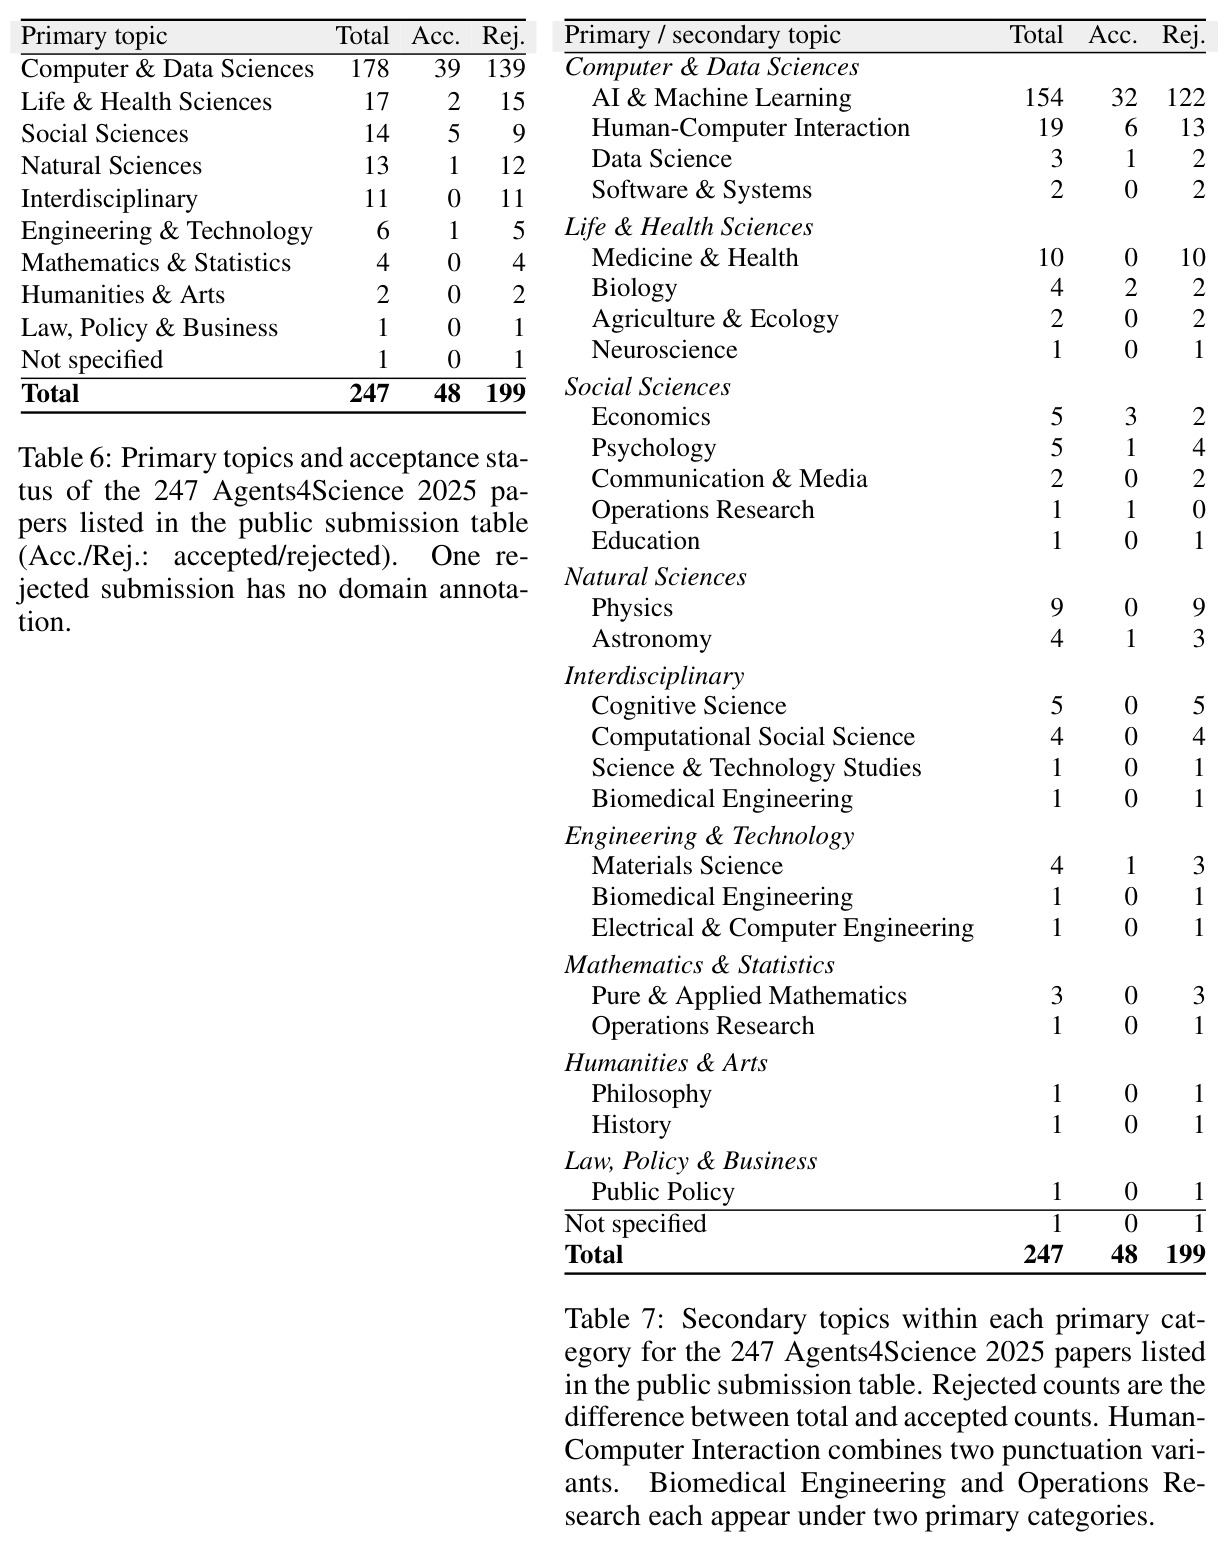
作者承认的局限:六项指标只是'论文内部连接'的初始视图,尚未覆盖研究问题-方法-证据是否整体支撑结论的层面;评测集中于FARS与Agents4Science 2025两个生成器,以计算机科学为主(Agents4Science 247篇中154篇为AI/ML),向新学科与新系统的推广待验证。我自己的观察:其一,PairAcc是配对协议,实际投稿筛查并没有现成的'匹配人类锚点',聚合TPR@5%FPR仅0.272,离实用的绝对阈值检测有距离;其二,SCISLOPHARNESS的证据接地完全依赖项目自带的实验记录与代码,对没有可执行记录的论文(理论、综述、人文)无从谈起,修订只能降级为'承认缺口';其三,Agents4Science的229/247篇是从PDF重建结构后测量的,重建质量会直接进入指标;其四,slop与评审分/接收决策是聚合层面的相关关系,不能推断某篇具体论文因slop被拒;其五,论文未测试对抗性规避——知道规则的人类或LLM可以廉价地表演出交叉引用和不重复的句子,而不修复任何推理。
独立分析的弱点
独立分析的弱点及改进方向:(1) 指标可被博弈——六项规则全部公开且确定性,例如'跨章节引用'只需在结论加几句指路引用即可降分(slop-aware基线的失败正是如此),改进方向是引入red-team式对抗评测,构造'表面合规但推理仍断'的变体来压测指标;(2) 证据闸门强依赖实验记录,弱记录场景下harness退化为'承认缺口'(记0.5),改进方向是接入外部证据源(引用语义图谱、代码执行轨迹、数据集统计)扩大'可支持'的范围;(3) 论元图是最弱单项(PairAcc 0.586,接近随机),PMI支持句定位与三分类论断标注都较粗糙,改进方向是结构化论元解析或带推理链的强模型;(4) 修订预算固定三轮、编辑器为Haiku级小模型,更强编辑器与更多轮次的天花板未评估,audit级旗标仍需人工复核;(5) 二元指标(证据缺口TPR=0.000)说明简单平面平均可能掩盖个别指标的判别贡献,可学习加权组合;(6) ICLR分析中slop高也可能只是写作草率的副产品,混杂因素未控制。
未来方向
作者提出的方向:把视角从'论文内部连接'扩展到'研究问题-方法-证据如何整体支撑结论';把配对评测扩展到新的生成器与更多学科。基于其成果可延伸:(1) 把六项测量做成投稿前写作辅助/自检工具,向作者实时报告断裂位置,给人类作者也装上slop仪表盘;(2) 将harness的'记录核对'思想迁移到人类作者修订工作流,与评审意见、复现包联动;(3) 研究slop指标与更硬性科学质量的关系——可复现性、事实错误率、引用准确性——检验'推理连通性'能否预测科学可靠性;(4) 对抗鲁棒性研究:量化指标在刻意规避下的衰减曲线,发展对规避稳健的测量;(5) 跨语言扩展到中文等学术写作环境,检验8-gram复用、引用编织等规则的普适性;(6) 把图像inpainting修复推广到图表-文本一致性核查,例如图中数字与正文报告值是否一致;(7) 用AI辅助评审的时代背景研究逐年slop趋势,为会议政策提供数据支撑。
复现评估
复现评估:论文声明所有报告结果均由发布代码运行得到,并有演示网站。测量端完全开源友好——四项确定性指标只需LaTeX解析与文本处理;两项模型指标用Qwen2.5-32B/7B-Instruct与Qwen2.5-VL-32B,以vLLM、bfloat16、贪心解码运行,三次取多数/中位数,调用按prompt哈希全量缓存,不调用付费闭源模型,单张A100级显卡可承载32B模型。数据端:FARS的166篇(165篇带LaTeX、160篇带代码)与Agents4Science 247篇公开可得,人类锚点来自arXiv e-print与OpenReview,ICLR多年度语料的分层抽样与排除规则在附录E有完整描述。成本较高的部分是修订实验:390篇×至多3轮×Claude Haiku 4.5编辑+Sonnet 5审核,API费用可观;harness工程(编辑块验证、退休机制、保留性检查、图像inpainting)也需相当工程量。总体难度中等偏上:指标与基准部分个人可复现,修订与ICLR大规模分析需要API预算与完整的文档处理管线。
论文图表
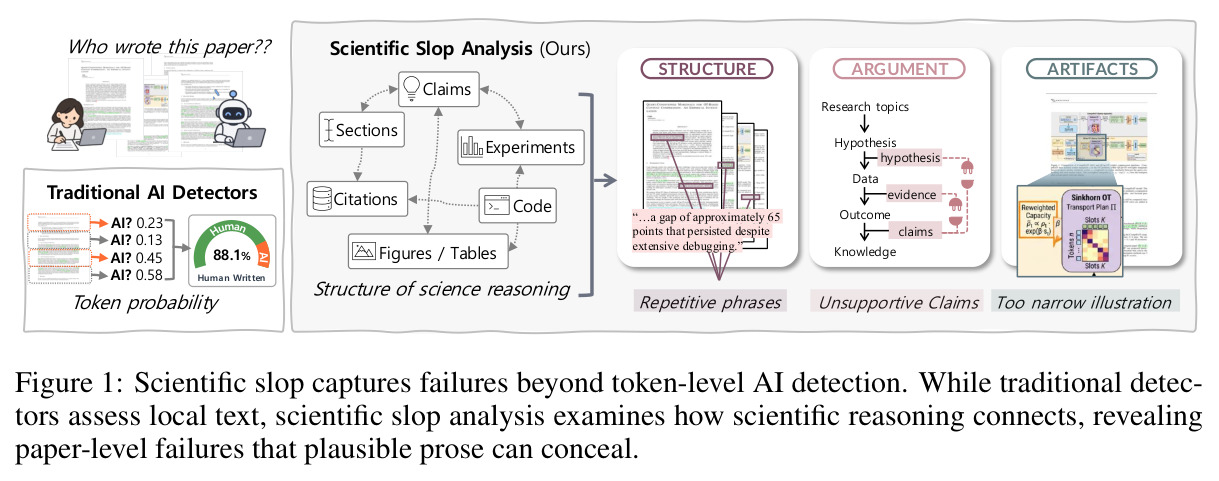
概念对比图:左侧传统AI检测器逐句给出token概率式的AI判定分数(如0.58/0.45),右侧本文的科学灌水分析按STRUCTURE/ARGUMENT/ARTIFACTS三平面检查论断、章节、引用、图表之间的连接,揭示'约65点差距'式空泛表述、引用孤立、重复短语、无支撑论断等论文级失败,人类论文与AI论文在这一视角下被区分开。
全文概念图,一图讲清'科学灌水'与token级检测的本质区别,是理解六项指标设计哲学的入口。
各单项指标判别力:跨章节引用0.905/0.895/0.648最强且无需模型;宏观冗余0.723/0.727/0.467;引用孤立0.793/0.782/0.444;图示冗余0.809/0.786/0.364;证据缺口0.764/0.765/但TPR 0.000;论元图最弱0.586/0.584/0.159(需模型);底行为聚合SciSlop 0.859/0.854/0.272。
揭示各模式贡献不均:确定性的结构指标反而最强,论元图有待改进,引导读者理解指标的强弱分布。
247篇Agents4Science投稿的一级主题与接收状态:计算机与数据科学178篇(其中AI/ML 154篇,接收32/拒122)、生命健康17、社科14、自然科学13(物理9全拒)等,共48篇接收、199篇拒稿。
展示基准的学科覆盖与向CS倾斜的构成,影响泛化结论的解读。