可信AI审稿人的缺失拼图:从修辞鲁棒性基准RobustReview到SciCore科学内核评审 A Missing Piece for Trustworthy AI Reviewers: From Benchmarking Rhetorical Robustness to SciCore Review
提出修辞鲁棒性基准与双分支SciCore审稿框架,让AI审稿既抗措辞操纵又不丧失论文区分力
前置知识
LLM-as-a-Judge(LLM 当裁判)
指用大语言模型代替人工来评估其他文本或系统的输出质量,典型做法是把待评对象连同评分标准(rubric)一起喂给 LLM,让它输出分数或偏好判断。该范式已被用于模型评测、代码评估和学术审稿,但已被证明对候选顺序、回答长度、提示措辞等与实质内容无关的因素敏感。
本文研究的对象就是'LLM 担任学术审稿人'这一具体 LLM-as-a-Judge 场景,全文讨论的稳定性、区分力和人类一致性都是这个范式的评估维度,不理解该范式就无法理解论文要解决什么问题。
ICLR 评审量表
ICLR 会议官方评审采用多维度打分:Overall Assessment(总体评价,约 1-10 分)、Soundness(方法论稳健性)、Presentation(表达清晰度)、Contribution(贡献度)、Confidence(审稿人自信度)等。人类均分通常作为衡量论文质量的参考,也被用来评估自动评审系统与人类判断的吻合程度。
RobustReview 基准按人类 Overall Assessment 均分把论文分成 6 个区间分层抽样,所有评审协议都沿用 ICLR 评分标准和量表,SciCore 的两分支也输出同尺度的分数以便融合,因此必须熟悉这套量表。
ICC(A,1) 组内相关系数
两向混合效应、绝对一致、单一度量的组内相关系数,公式为 $\text{ICC}(A,1)=\frac{M_{SR}-M_{SE}}{M_{SR}+(P-1)M_{SE}+N(M_{SC}-M_{SE})}$,其中 $M_{SR},M_{SC},M_{SE}$ 分别是论文间、表达方式间和残差均方。它衡量'同一论文的不同版本得分是否接近,相对于论文之间的得分差异',高值表示论文间差异远大于版本内波动。
ICC 是本文联合稳定性-区分力指标的核心:只看漂移(MAD)会被分数坍缩欺骗,ICC 能识别出'稳定但没有区分力'的伪鲁棒性,是理解本文主要结论和 Table 1/2 数据的关键。
按论文族配对的 Bootstrap 重采样
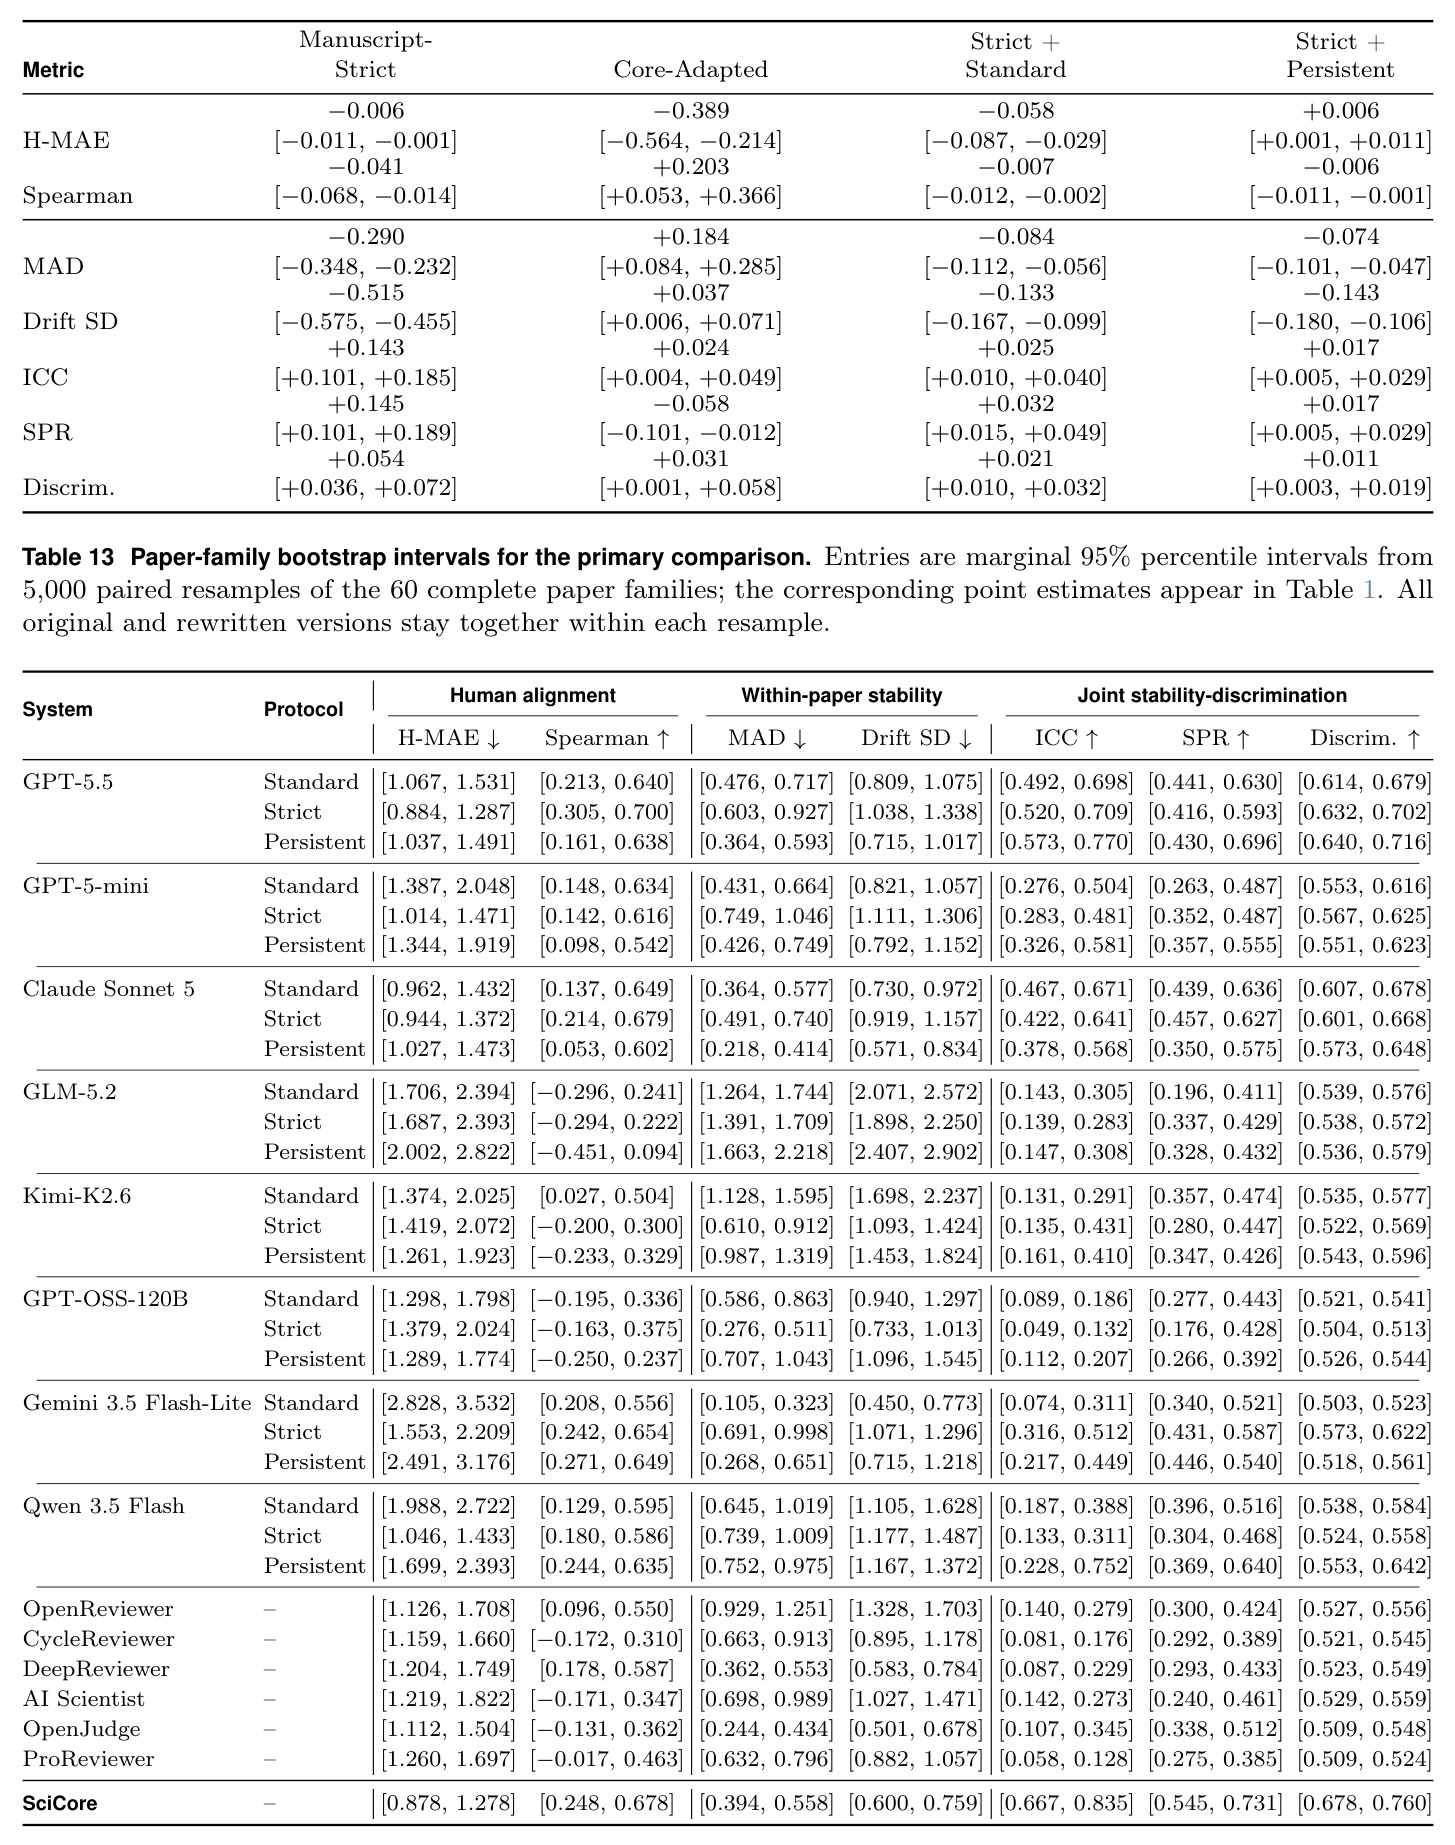
Bootstrap 是通过反复从样本中有放回地重采样来估计统计量置信区间的方法。本文的变体是'论文族配对重采样':每次重采样以论文为单位(60 篇论文族整体抽出),同一篇的原文和全部 20 个变体始终绑在一起,5,000 次重采样后计算各指标的 2.5% 和 97.5% 分位数作为 95% 置信区间,且同一批重采样用于所有配置以便做配对差值检验。
基准只有 60 篇论文,点估计不稳定;论文的显著性结论(如 SciCore 相对 Manuscript-Strict 在 5 个鲁棒性指标上的改善)全部由这种配对 bootstrap 区间支撑,不熟悉它就无法判断哪些提升是真显著的。
最大不变量(Maximal Invariant)
统计学概念:对等价关系 $\sim$,映射 $C^*$ 是最大不变量当且仅当 $C^*(x)=C^*(x') \Leftrightarrow x \sim x'$。它把同一等价类的所有元素映射到相同值(不变性),同时保证不同等价类不被压扁(极大性)。任何对 $\sim$ 不变的下游函数都可以且只能分解为经过 $C^*$ 的映射。本文用它刻画'同一科学内容的不同修辞实现'这一等价类。
科学内核分支的理论动机正是:理想的抽取器应是修辞实现等价类上的最大不变量,这解释了为什么'先抽取结构化内核再评审'能同时获得稳定性与区分力,是理解方法设计哲学的钥匙。
Blackwell 实验比较与信息窬化(garbling)
Blackwell (1953) 的统计决策理论结果:若观测 $W$ 能模拟出观测 $\tilde{X}$(即 $\tilde{X}$ 是 $W$ 的随机后处理,称为窬化),则在任何决策问题下用 $W$ 能达到的最优风险不差于用 $\tilde{X}$。反之,后处理不可能增加决策相关信息,只会丢失信息或引入噪声。
论文用该原理论证'先从科学内核重建一篇论文再评审'是多余的窬化层——重建无法创造内核中没有的决策信息,反而引入新的修辞实现;这解释了消融实验中 ReconstructReview 表现更差的理论原因。
研究动机
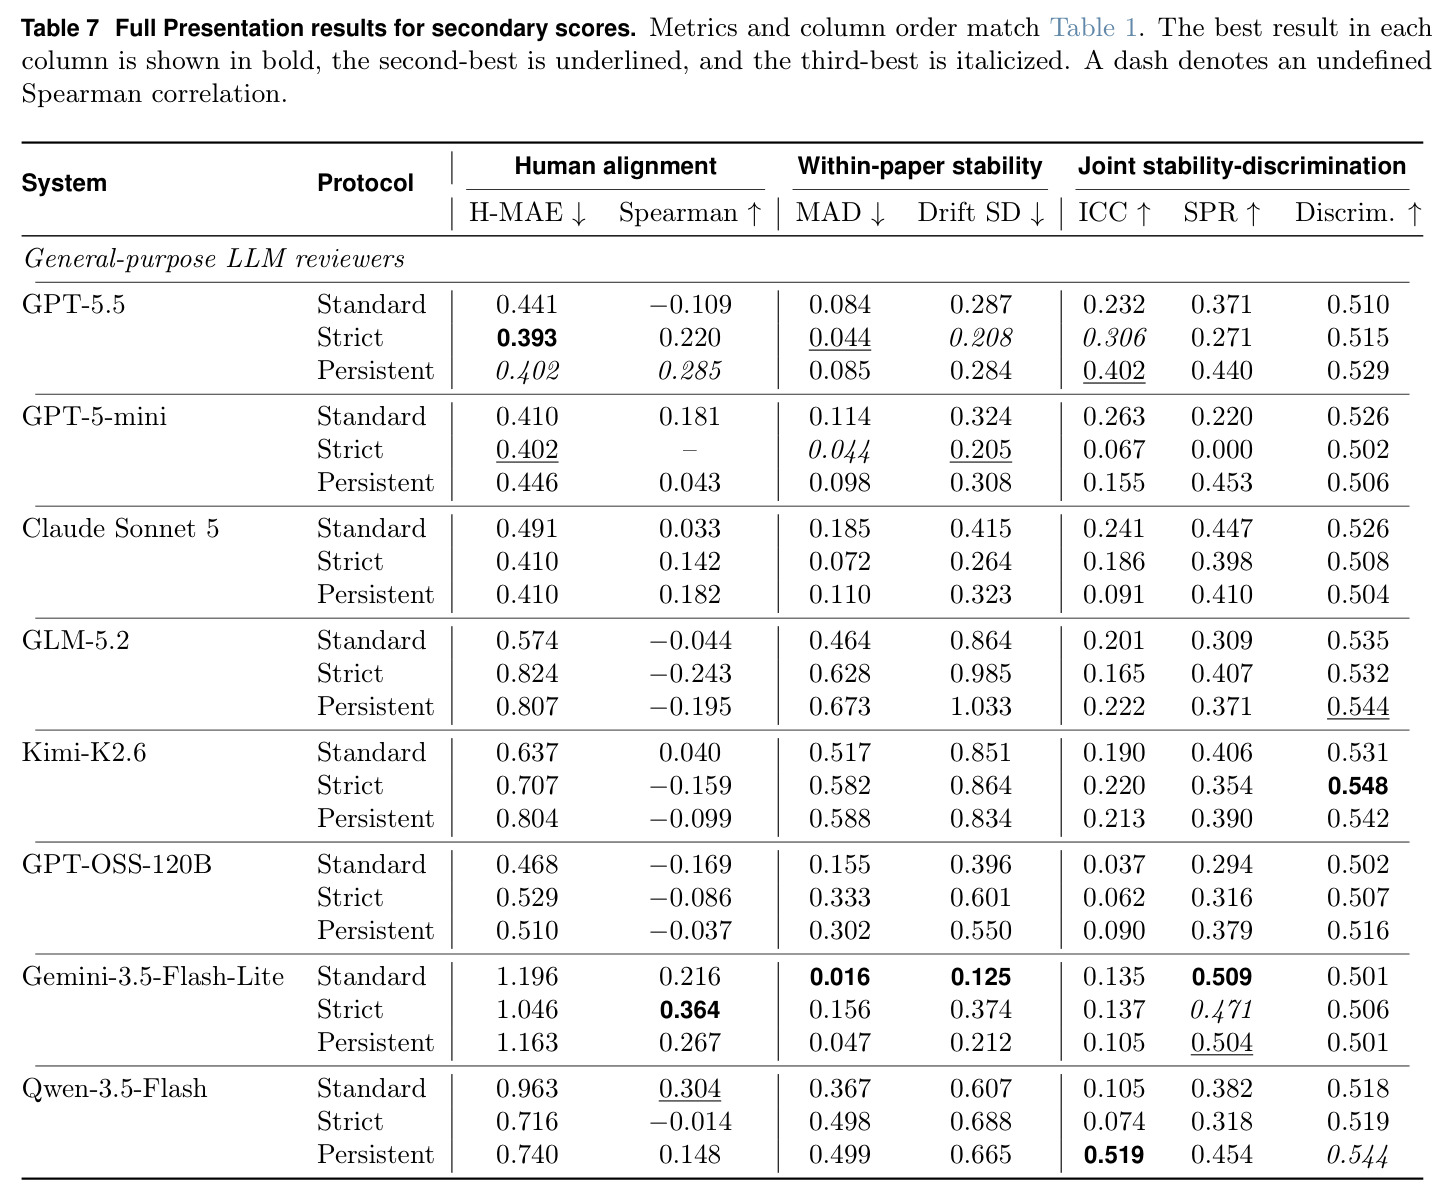
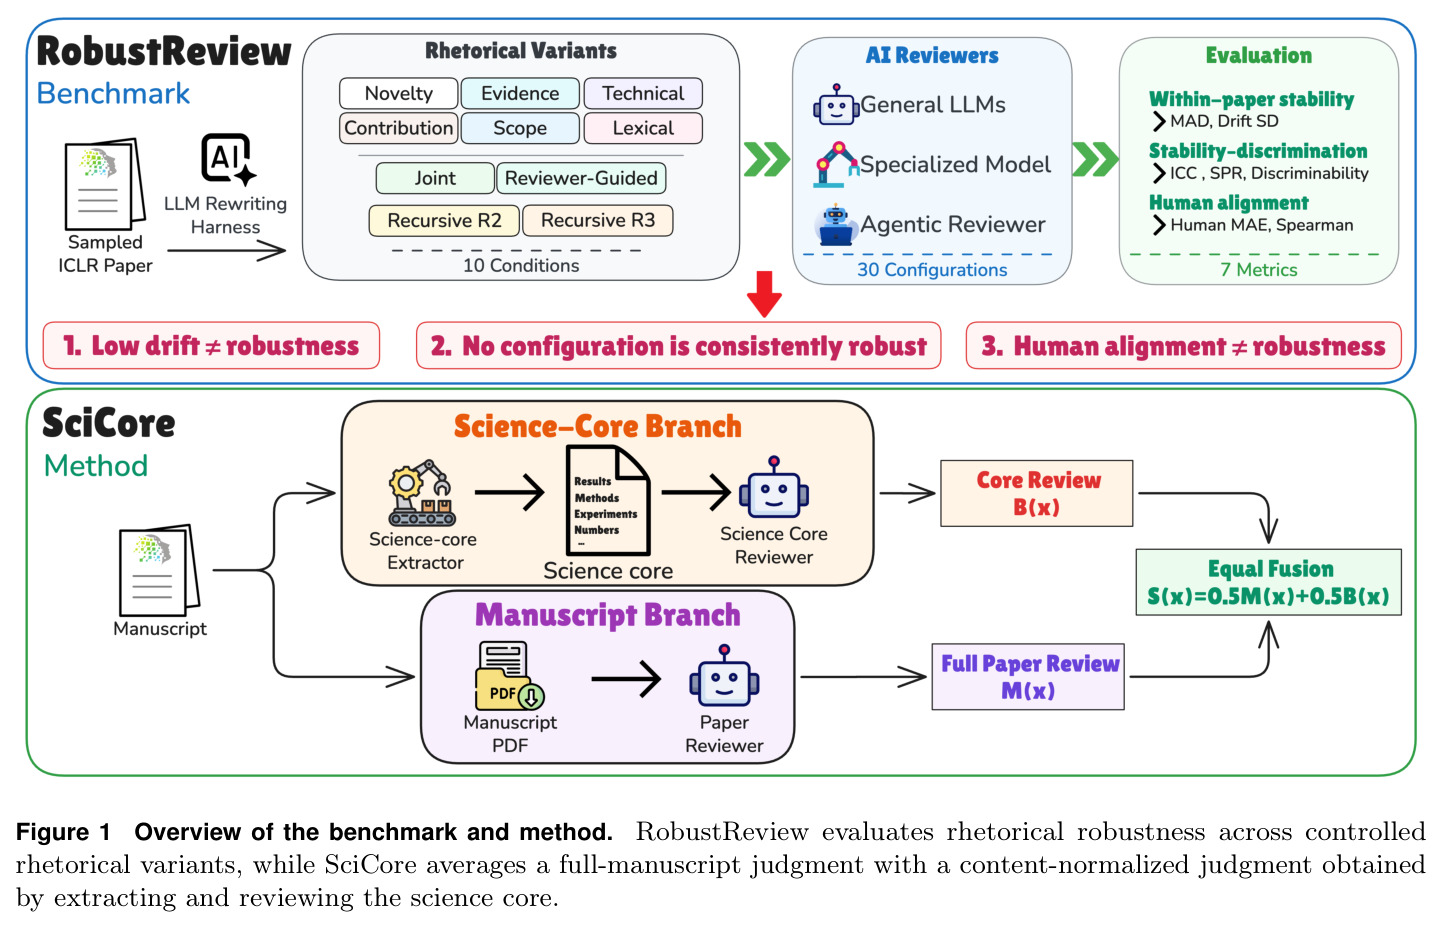
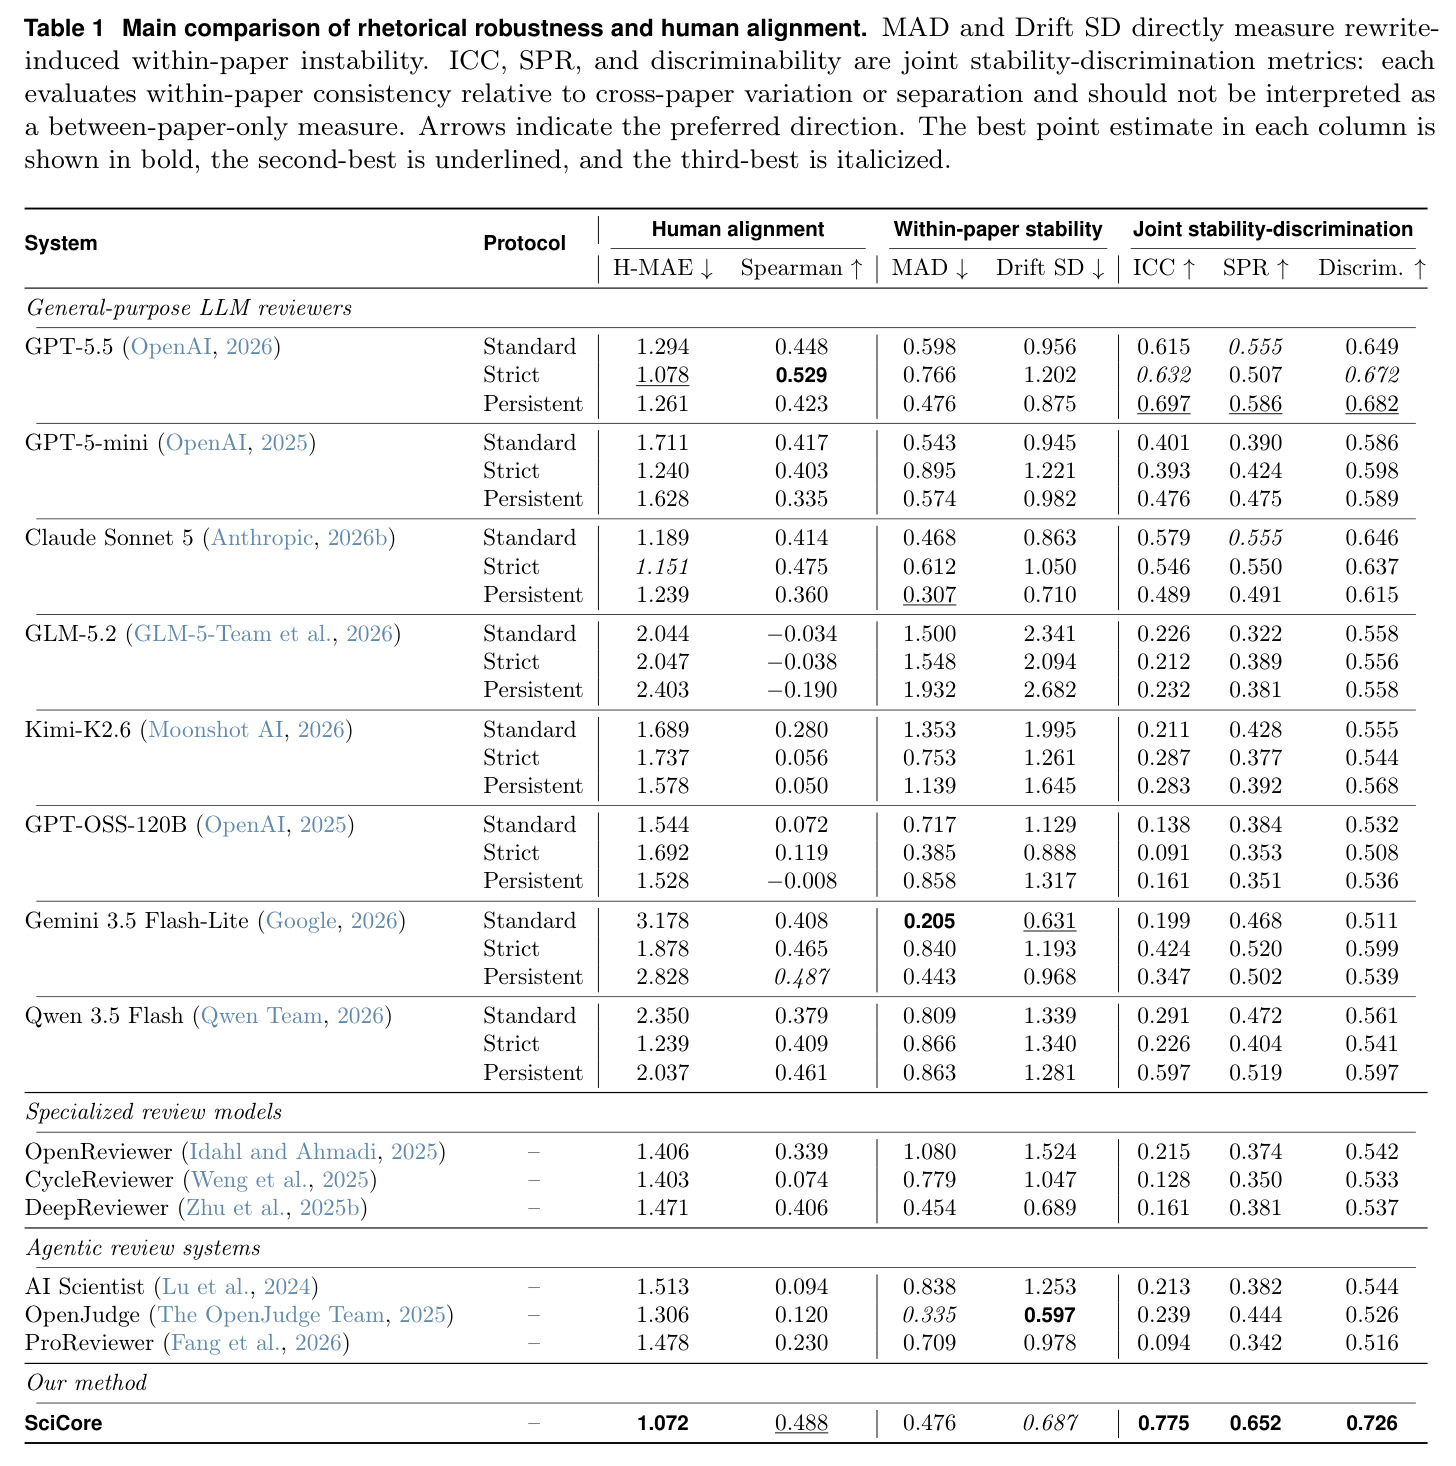
AI 审稿系统正被大规模引入学术出版流程,但现有评估几乎只问一件事:AI 给的分像不像人类审稿人。本文指出这里缺了一块关键拼图——同一篇论文的科学内容完全相同、只改措辞和包装,AI 审稿人就可能给出截然不同的分数。已有工作证实了这种脆弱性:仅改标题的风格就能改变 AI 评分(Du, 2025);对摘要和全文的改写、夸大可以系统性抬高自动评分(Kaneko, 2026; Li et al., 2026b);甚至出现了不增加任何实验、仅靠重新包装全文就提升评审分数的 paper laundering 攻击(Baumann et al., 2026; Yang et al., 2026b)。当 LLM 让低成本、外观合理的全文改写变得唾手可得时,能被措辞操纵的评审实际上是在奖励修辞优化而非科学改进,既损害个体论文的公平性也侵蚀整个科学记录的可信度。更麻烦的是,现有评估从未把稳定和区分力作为联合要求来度量:一个给所有论文都打同样分数的审稿人看起来极其稳定,实则完全失效。实验证实这不是杞人忧天——Gemini-3.5-Flash-Lite 在 Standard 协议下取得全场最低的改写漂移 MAD=0.205,但其 ICC 只有 0.199、判别力 0.511 几乎等于随机水平。
本文的目标是本文要回答的核心问题是:AI 审稿人能否在措辞变化下保持判断稳定,同时不丧失区分不同论文的能力?为此作者设定了三个具体目标。第一,把修辞鲁棒性形式化为一个联合要求:论文内稳定性(同一论文的内容保持改写版本应得到接近的分数)加上论文间区分力(不同论文的分数差异必须显著大于改写引起的波动),并把与人类评分的一致性作为独立维度分开度量,避免用一致性冒充鲁棒性。第二,构建一个可控的全稿基准 RobustReview:从 60 篇 ICLR 2026 投稿(按人类均分 6 个区间分层各抽 10 篇)出发,施加 10 种修辞条件、由两套独立改写系统(GPT-5.5 与 Claude Opus 4.8)各生成一个变体,共 1,260 份完整稿件,用 7 个指标评估 30 个评审配置,覆盖 8 个通用 LLM 乘 3 种协议、3 个专用评审模型和 3 个 agentic 系统。第三,在揭示仅靠提示词无法可靠实现内容导向评审之后,提出一个能系统性提升联合鲁棒性、且不牺牲人类一致性的审稿架构 SciCore,作为对该缺失维度的方法论回应。
与已有工作不同的是,本文的独特切入角度有三层。概念上,首次把修辞鲁棒性定义为稳定性乘区分力的联合要求,并论证人类一致性与鲁棒性是两个独立性质:在原始稿件上与人类打分一致,并不能保证在改写版本上稳定;实验也证明两者对评审协议的排序不同——GPT-5.5 的 Strict 协议人类一致性最好(H-MAE=1.078、Spearman=0.529),而 Persistent 协议鲁棒性最好(ICC=0.697),因此人类一致性评测不能替代匹配式鲁棒性评测。此前对 AI 审稿操纵的研究要么依赖隐藏指令和显式对抗扰动(Ye et al., 2024; Lin et al., 2025),要么只刻画了改写能抬分这一现象(Li et al., 2026c),本文则把改写做成匹配的论文族设计,给出可公平比较 30 个评审系统的受控基准,并首次命名和系统分析伪鲁棒性这一测量失效模式。方法侧,不同于 Persistent 协议让审稿人在阅读全文时无视修辞的指令路线,SciCore 从不变量表示理论(Eaton, 1989; Dubois et al., 2021)出发,先物理性地把稿件变换成内容归一化的科学内核再评审,并用 Blackwell 实验比较给出为何应直接评审抽取记录而非重建论文的信息论依据,这在此前的 AI 审稿文献中没有先例。
核心方法
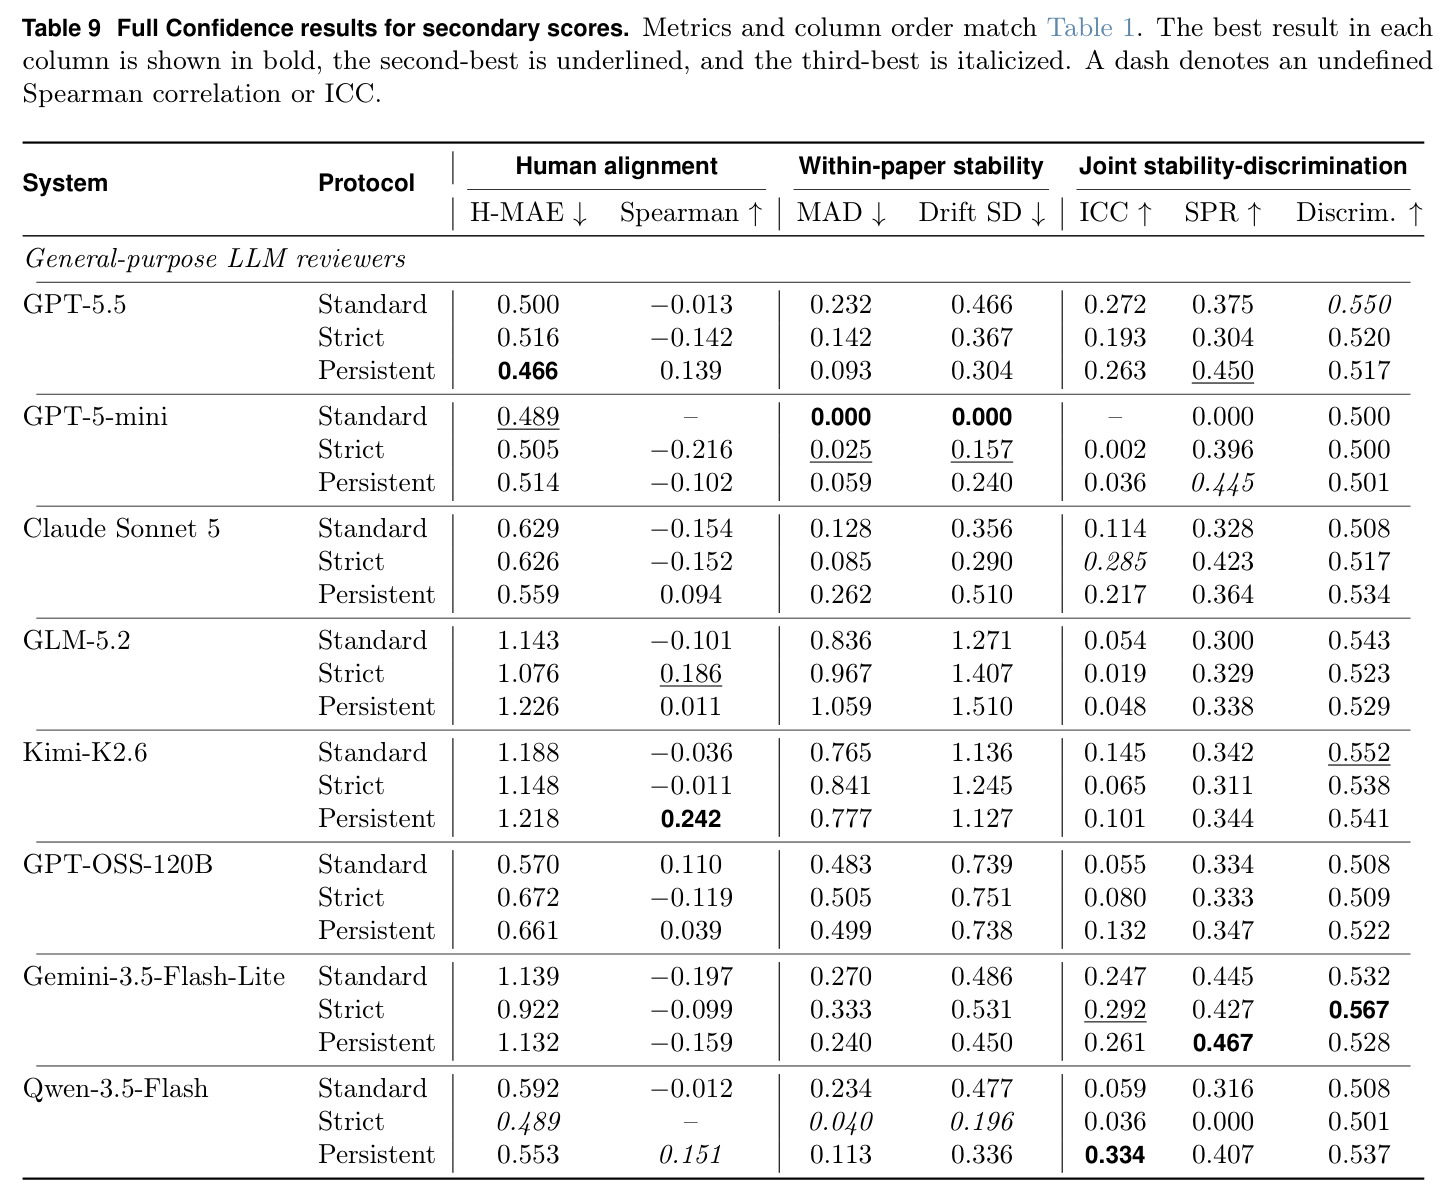
直觉上,可信的 AI 审稿人应该像资深科学家一样透过修辞看科学:同一项工作换种说法不该改变评价,但不同工作的差距也不能被抹平。技术路线分两部分。第一部分是基准 RobustReview:从 ICLR 2026 投稿中筛出与 arXiv LaTeX 源码匹配(文本相似度超过 0.8)的论文,按人类 Overall Assessment 均分切成 6 个区间([1,3) 到 [7,8.5])各随机抽 10 篇共 60 篇;对每篇施加 10 种修辞条件——新颖性立场、范围框定、证据措辞、贡献显著性、技术语域、语言复杂度 6 种单维条件,加联合改写、2/3 轮递归改写(R2/R3)、评审者引导改写 4 种复杂条件;每条件由 GPT-5.5(Codex CLI)与 Claude Opus 4.8(Claude Code)独立生成一个变体,共得 1,200 个变体加 60 篇原文 = 1,260 份完整稿件。评估用 7 个指标:论文内稳定性(MAD、Drift SD)、联合稳定性-区分力(ICC、SPR、判别力)、人类一致性(H-MAE、Spearman)。第二部分是 SciCore 双分支评审:稿件分支用 Strict 协议评完整 PDF,科学内核分支先抽取结构化科学内核再直接评审该记录,最终分数取两者均值 $S_{\text{SciCore}}(x)=\frac{1}{2}M(x)+\frac{1}{2}B(x)$。
核心创新是科学内核(science core)分支:与其要求审稿人在阅读全文时忽略修辞(Persistent 协议的思路),不如先把稿件变换成一个内容归一化的结构化记录——包括核心研究想法与主张、问题形式化、数学公式与推导、方法与假设、实验或理论证据、已报告结果、作者自述贡献、可复现性信息和局限性——然后只评审这份记录。其理论根基是最大不变量原理:理想的抽取映射 $C^*$ 应满足 $C^*(x)=C^*(x') \Leftrightarrow x \sim_{sci} x'$,即同一科学记录的不同修辞实现被映射到相同表示,而科学上不同的稿件不会被压扁;任何修辞不变的评判都能且只能分解为经过 $C^*$ 的映射(Proposition A.1)。这与已有方法的本质区别在于:提示词工程只是软性要求模型忽略修辞,修辞信号仍然进入了上下文窗口;科学内核是硬性地在输入侧剥离修辞表面,审稿分支根本看不到原文的措辞、排版和行文。此外作者用 Blackwell 实验比较证明从内核重建论文再评审(ReconstructReview)是信息窬化——重建不可能增加决策相关信息,反而可能引入新的修辞实现(Proposition A.2),这从理论上支持直接评审抽取记录的设计选择。
方法步骤详情
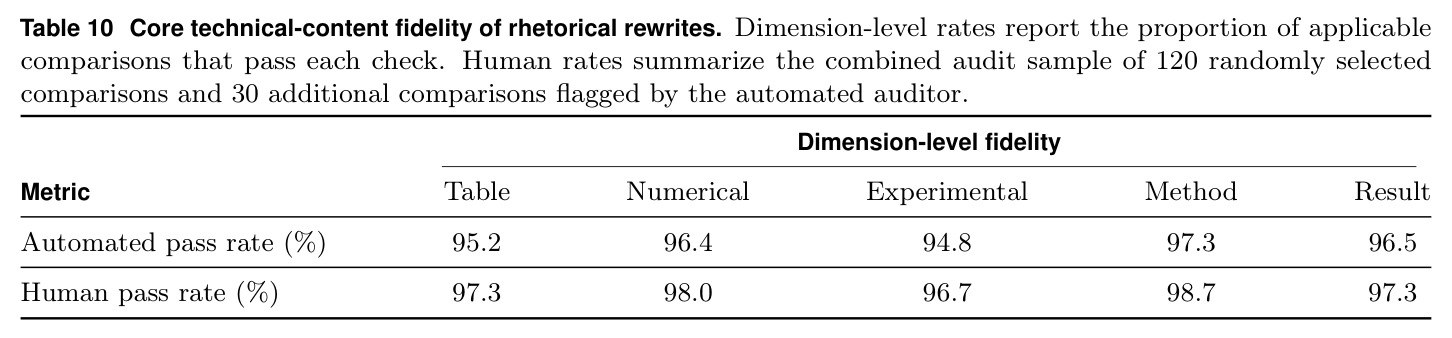
第一步,构建改写族:在完整 LaTeX 项目上改写(保护引用、交叉引用、图表与参考文献文件),改后重新编译验证结构;用独立的 DeepSeek V4 Flash 审计 5 个维度(表格/数值/实验/方法/结果)的保真度,自动通过率 94.8%–97.3%,120 个随机加 30 个被标记样本的 3 人工复核通过率 96.7%–98.7%,标注者间一致性 94.6%。第二步,跑评审网格:24 个通用 LLM×协议配置(Standard 按 ICLR 标准;Strict 提高证据门槛;Persistent 反复强调基于实质内容打分),加 OpenReviewer、CycleReviewer、DeepReviewer 三个专用模型与 AI Scientist、OpenJudge、ProReviewer 三个 agentic 系统,共 30 个配置在同一语料上执行。第三步,计算指标:$\text{MAD}_m=\frac{1}{NK}\sum_{i,k}|\Delta^m_{ik}|$ 与 Drift SD 度量漂移;$\text{SPR}_m=\frac{\text{Var}(y^m_{i0})}{\text{Var}(y^m_{i0})+\mathbb{E}[(\Delta^m_{ik})^2]}$、ICC(A,1) 与判别力(同论文版本得分更近于不同论文的概率)联合检验稳定性是否伴随区分力。第四步,SciCore 推理:GPT-5.5 按客观第三人称抽取科学内核(表格转写保留数值、不保留图片、无法可靠读取处记录不确定性),内核用 Adapted 协议直接评审,稿件分支用 Strict 评审完整 PDF,两分支各输出 ICLR 量表分后等权平均,融合无需额外调用。
技术新颖性
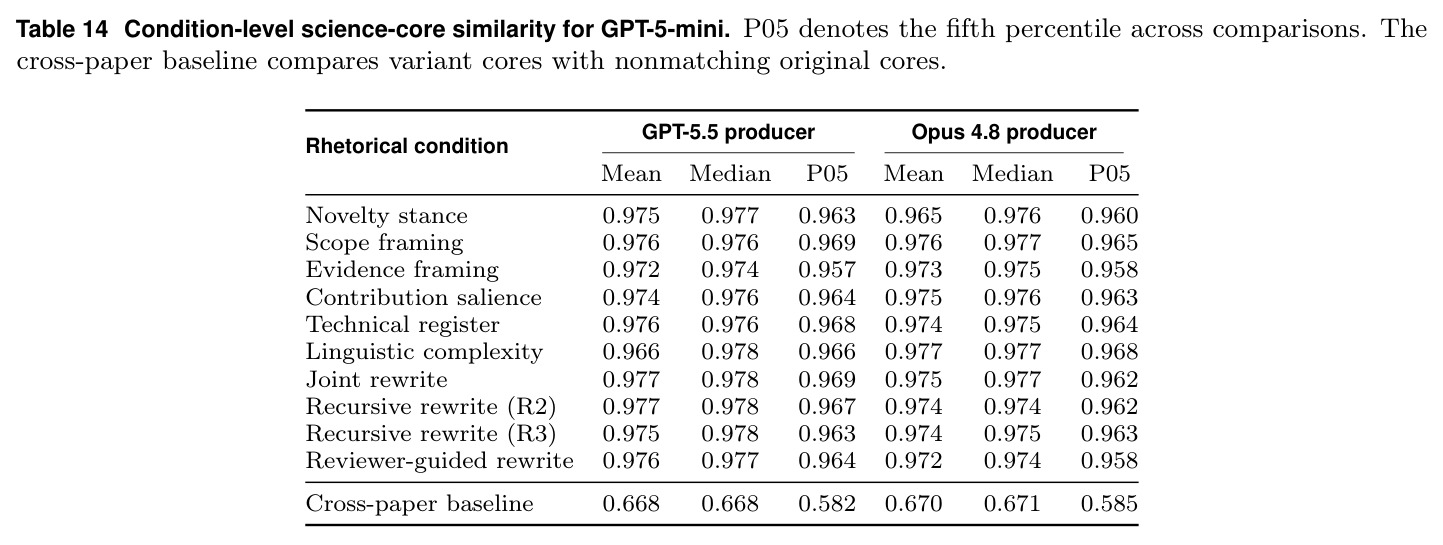
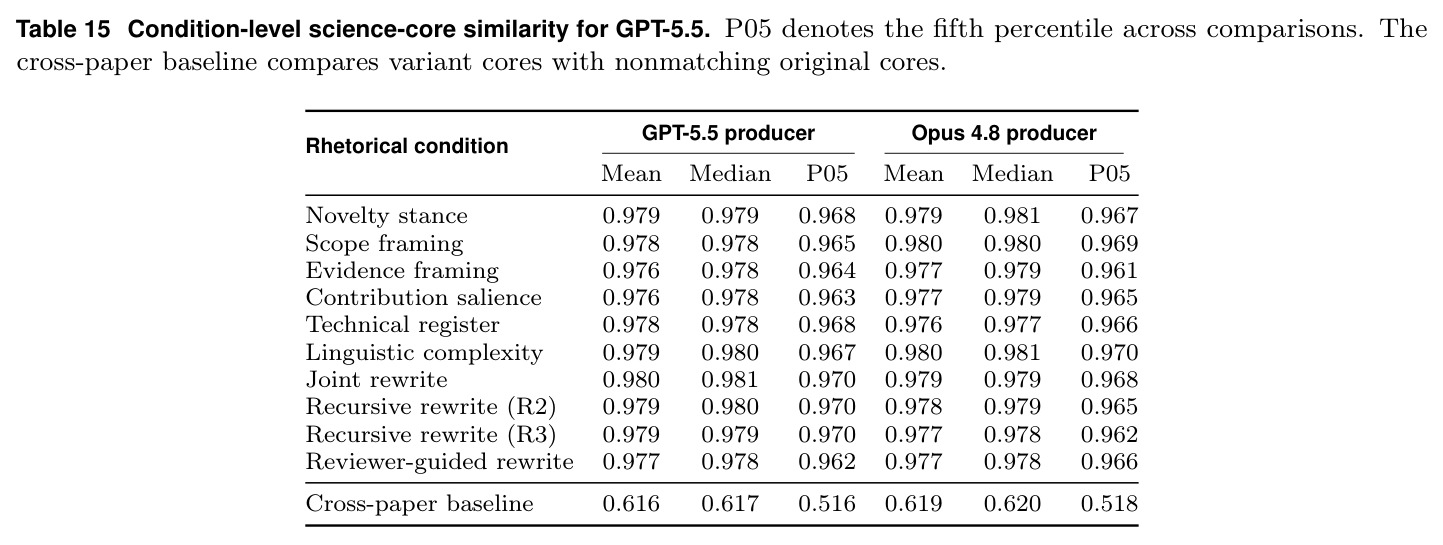
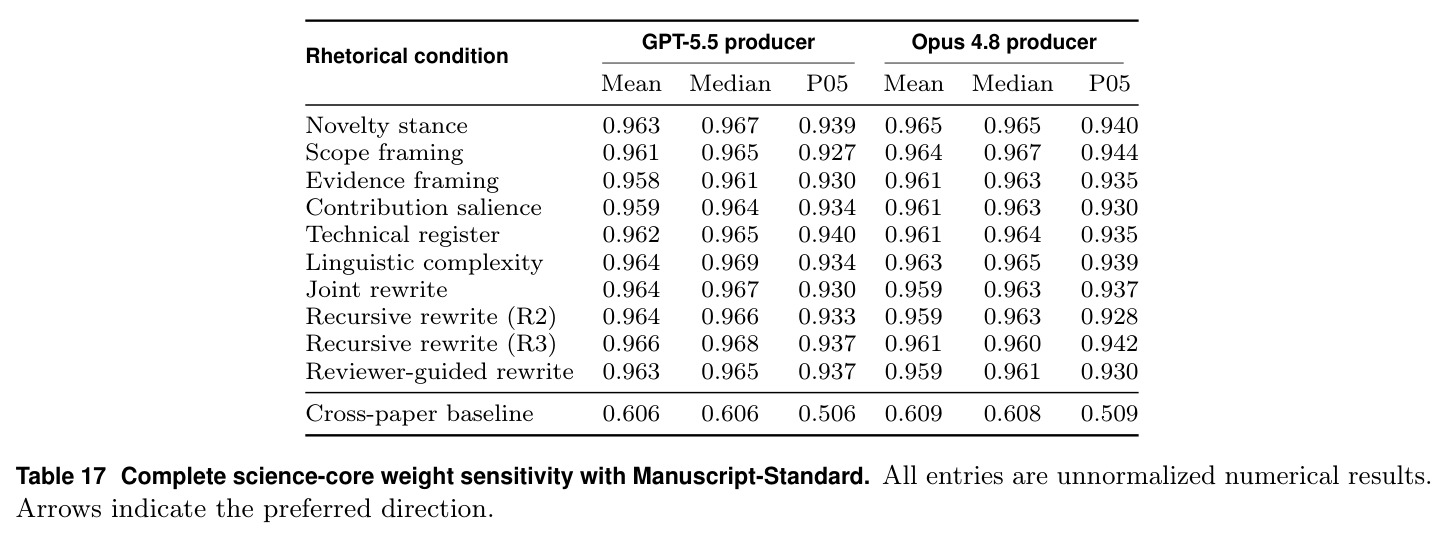
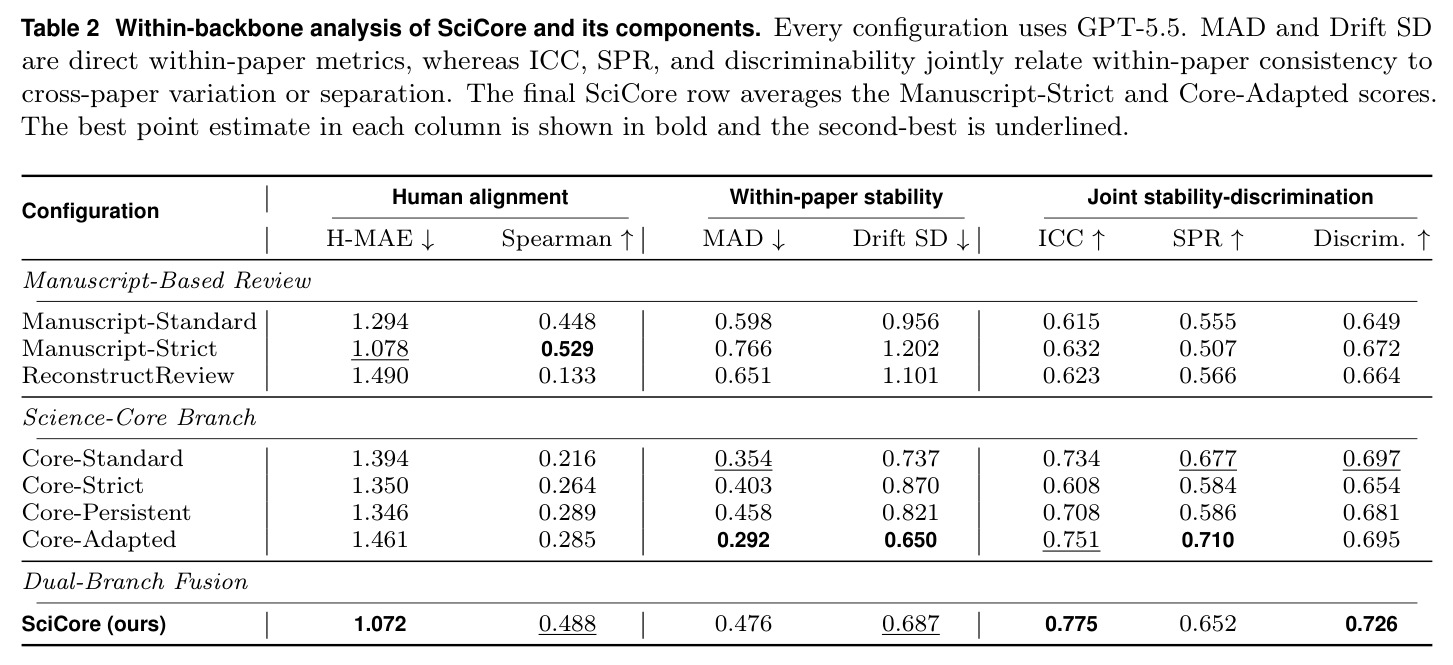
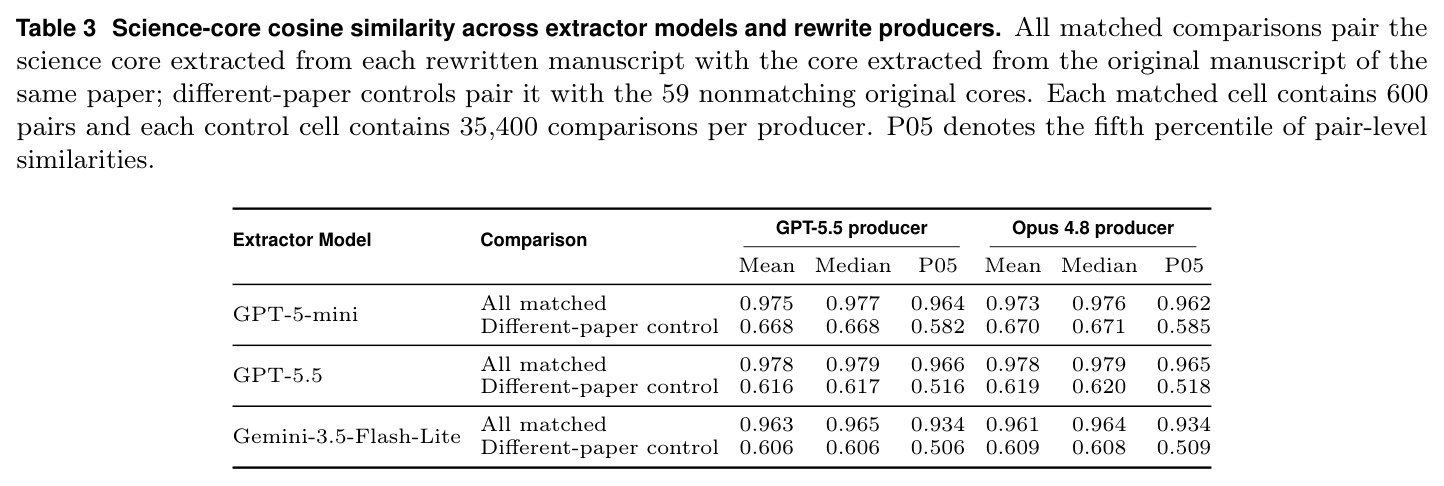
技术新颖性体现在四点。其一,把鲁棒性度量从单一漂移指标升级为七指标体系,并定义伪鲁棒性(false robustness)失效模式:低漂移若源于跨论文分数坍缩反而是缺陷,修正了此前只看漂移的评估方式。其二,双分支等权融合 $S_{\text{SciCore}}=\frac{1}{2}M+\frac{1}{2}B$ 极简且两分支各自可解释,附录还给出 Lipschitz 条件下的 MAD 上界分解(Equation 7):当内核分支漂移更小时,平均能稀释修辞敏感性。其三,消融设计异常严谨:用 ReconstructReview 对照排除重建路线(MAD 从 0.598 恶化到 0.651);用两份/三份全稿协议分数平均的对照组排除平均操作的机械解释——三协议平均 ICC 达 0.781 高于 SciCore 的 0.775,但 SciCore 在 7 项中 5 项更优且帕累托不被支配;用同 PDF 重复评审建立噪声基线(MAD 0.294–0.329、ICC 0.846–0.862),证明 MAD 从 0.766 降到 0.476 远超解码随机噪声。其四,用嵌入相似度在表示层验证不变性:GPT-5.5 抽取的匹配内核相似度 0.978,跨论文仅 0.616–0.619,为稳定性与区分力提供了独立于分数的证据。
实验结果
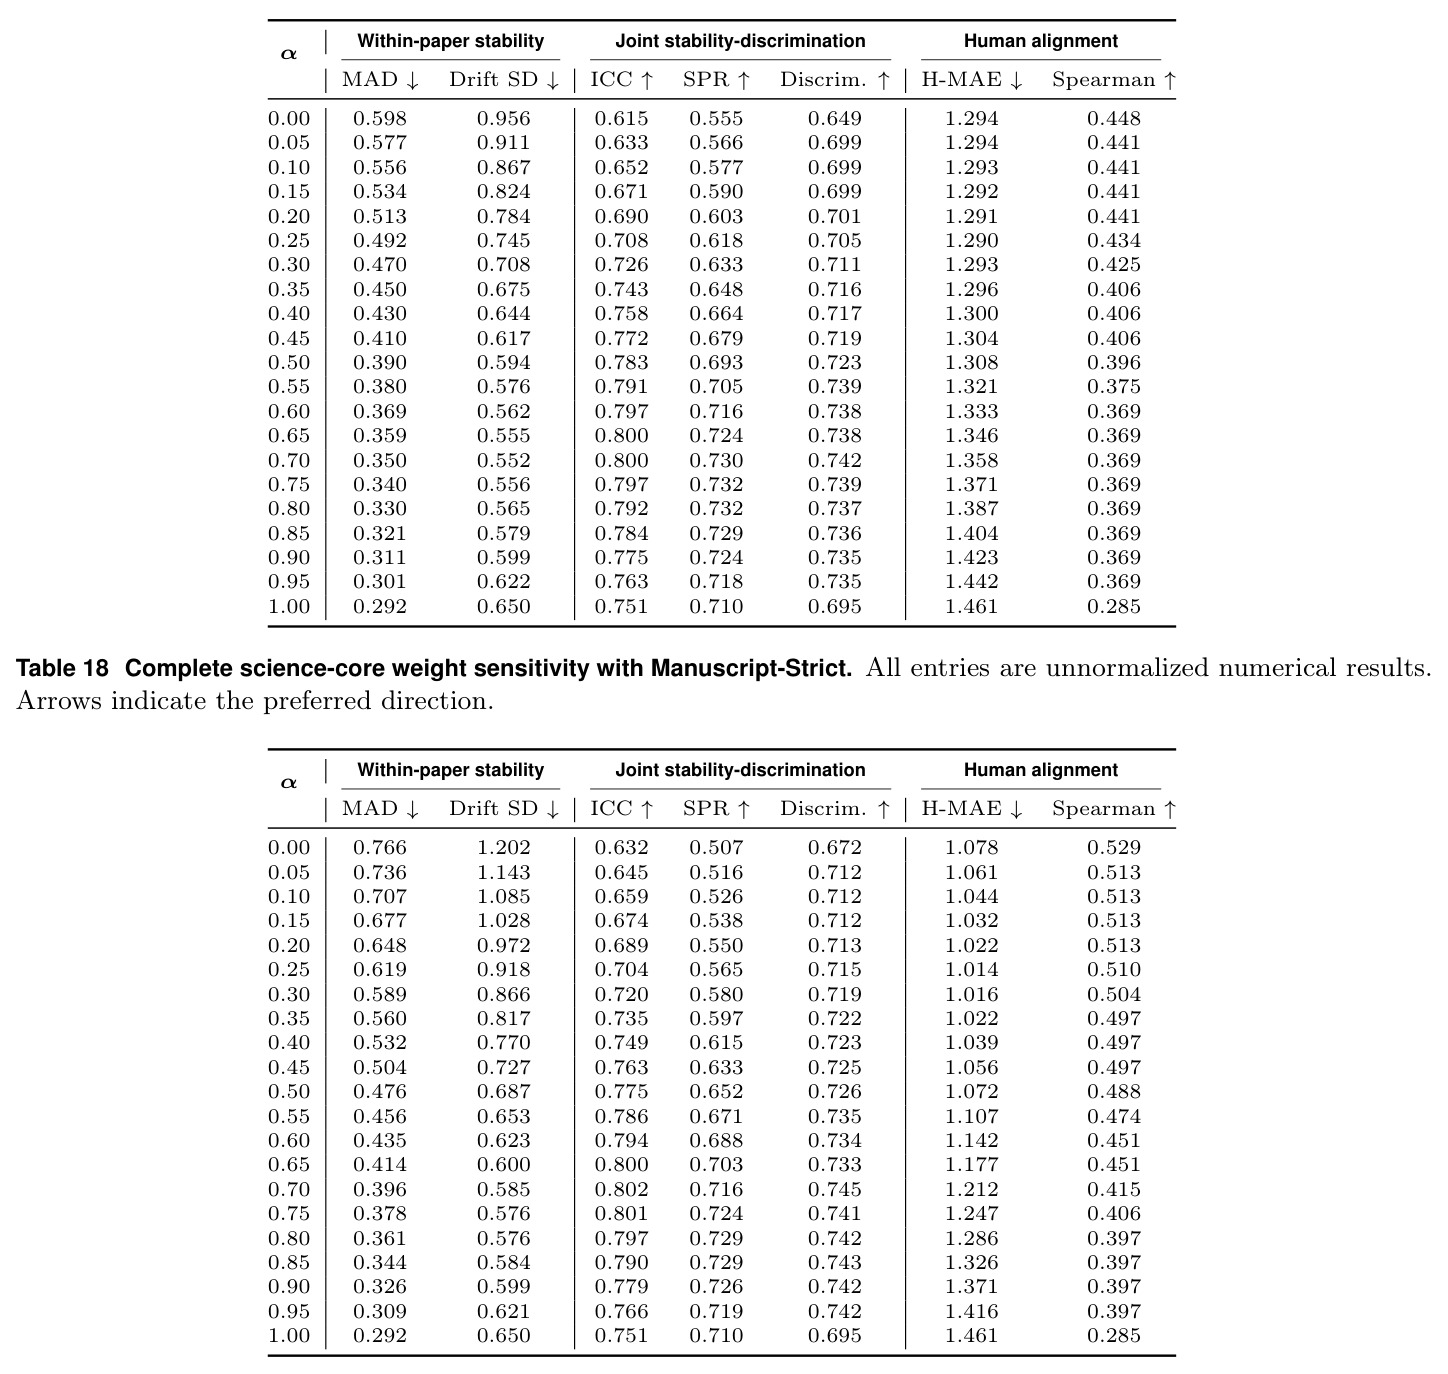
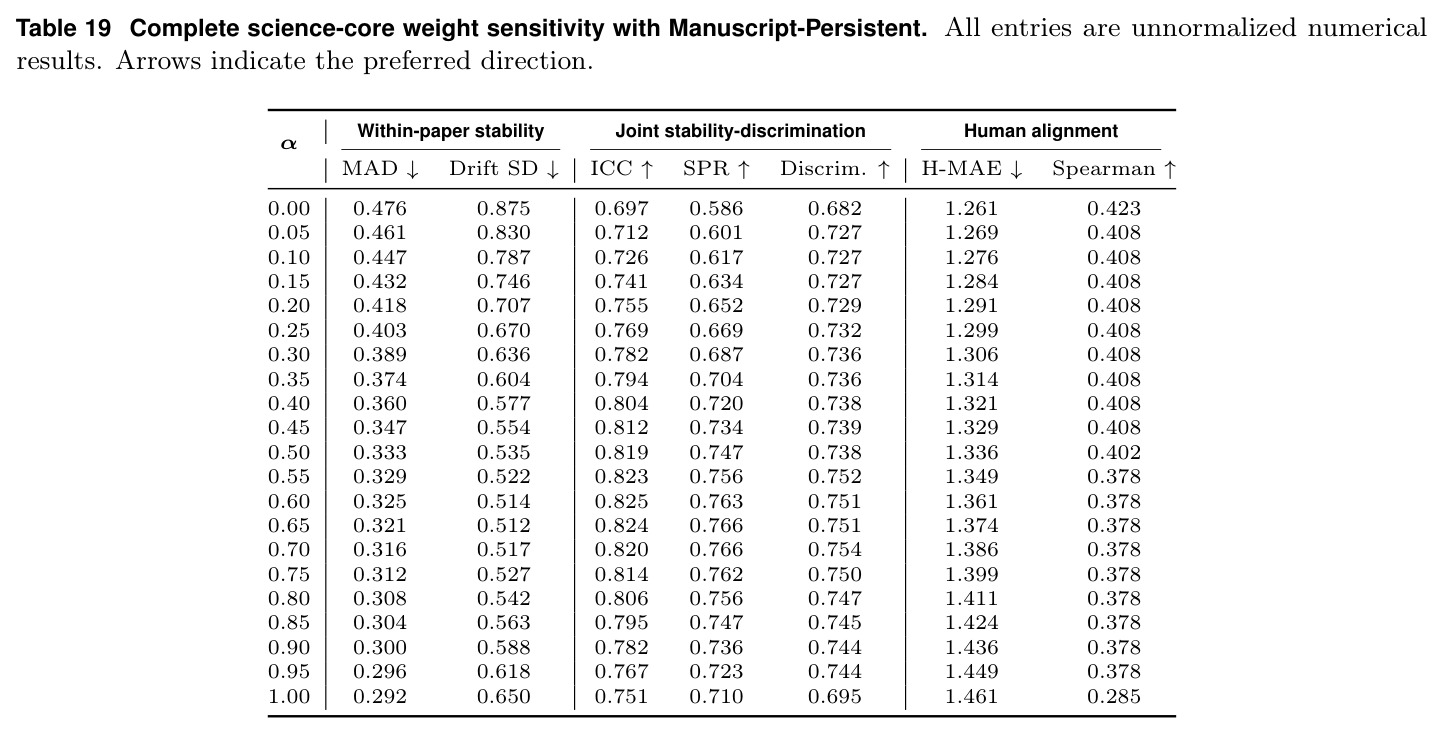
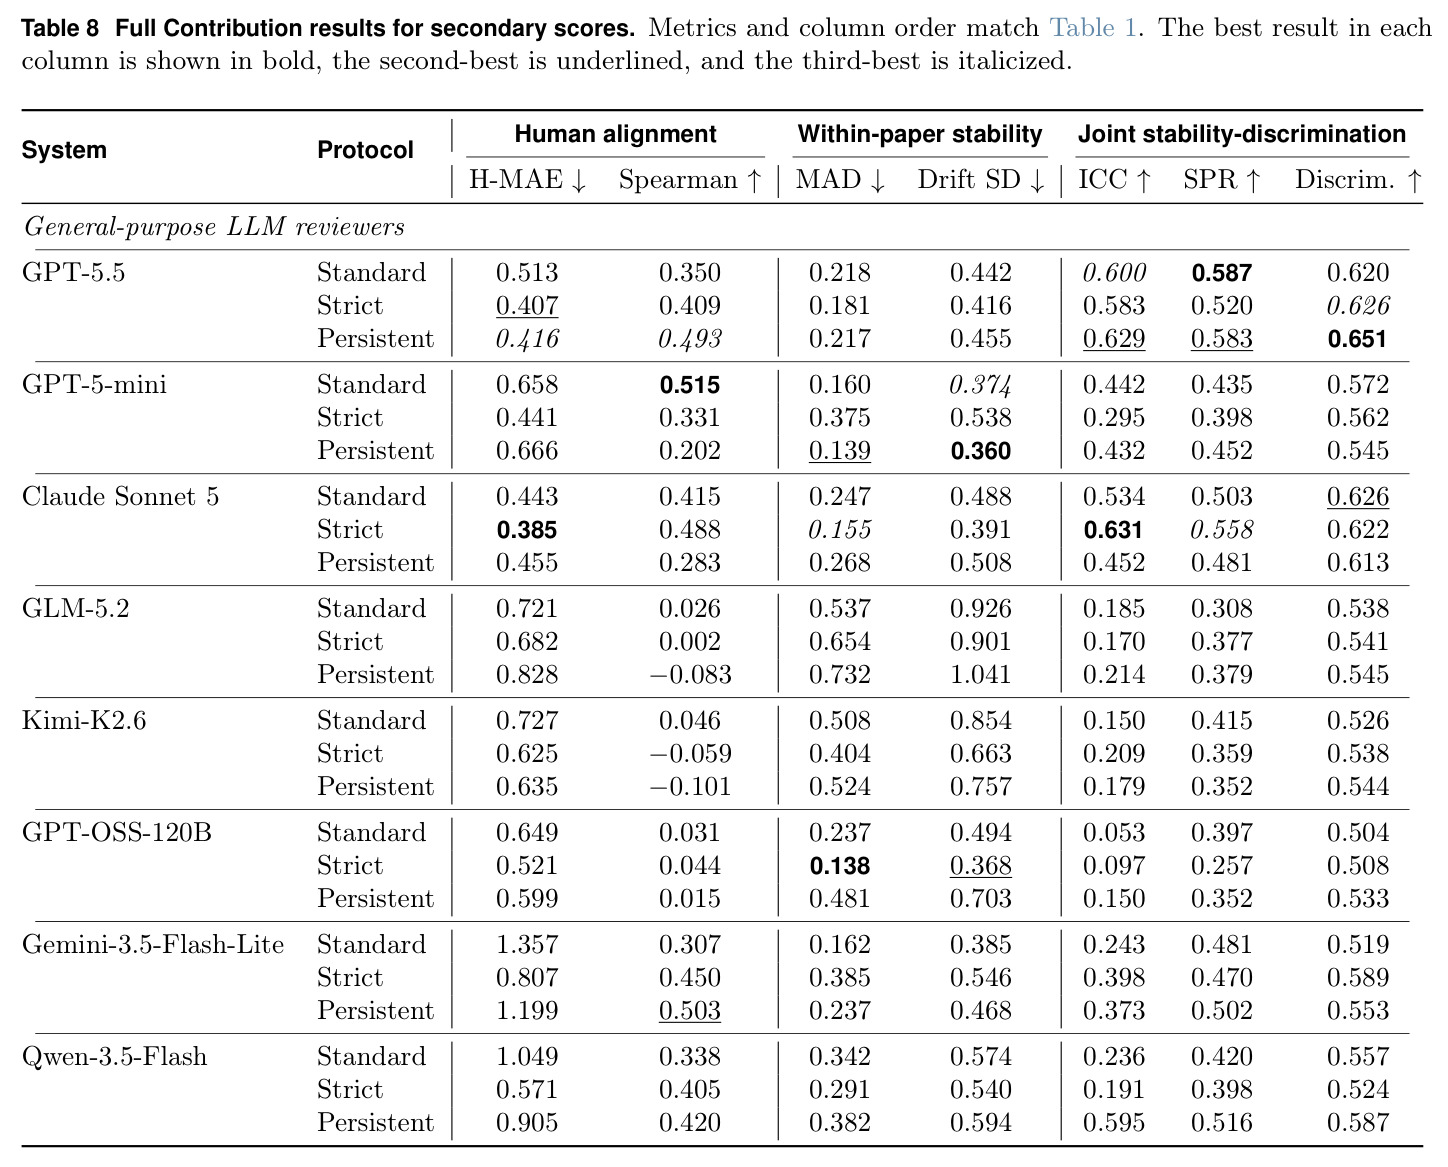
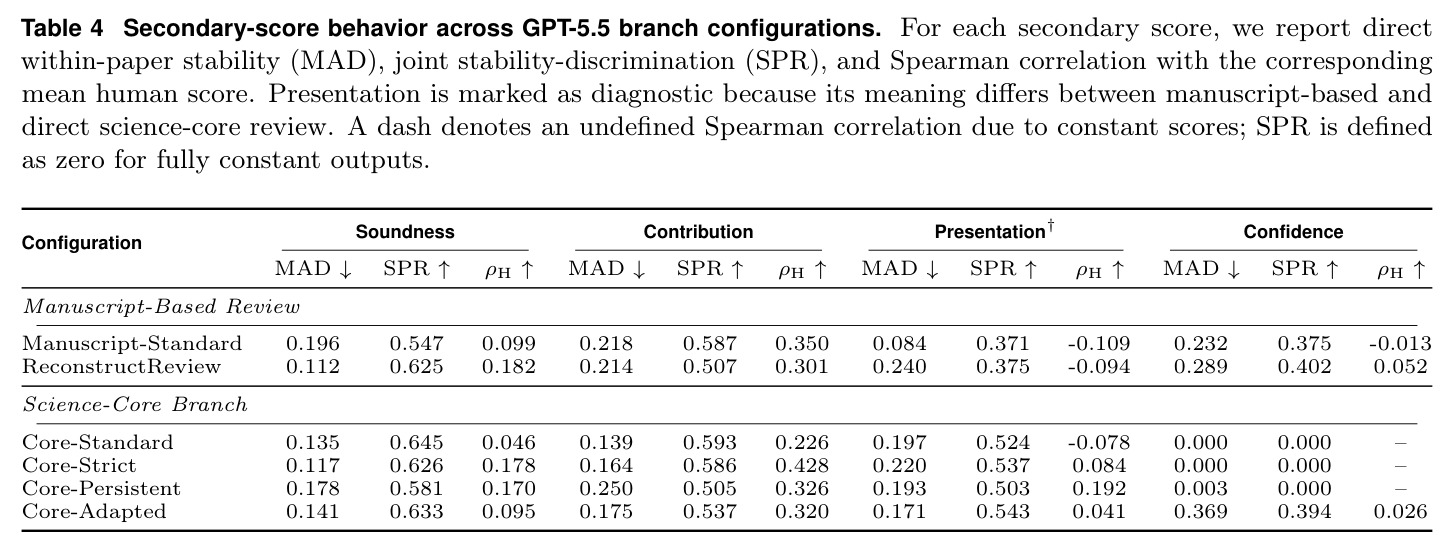
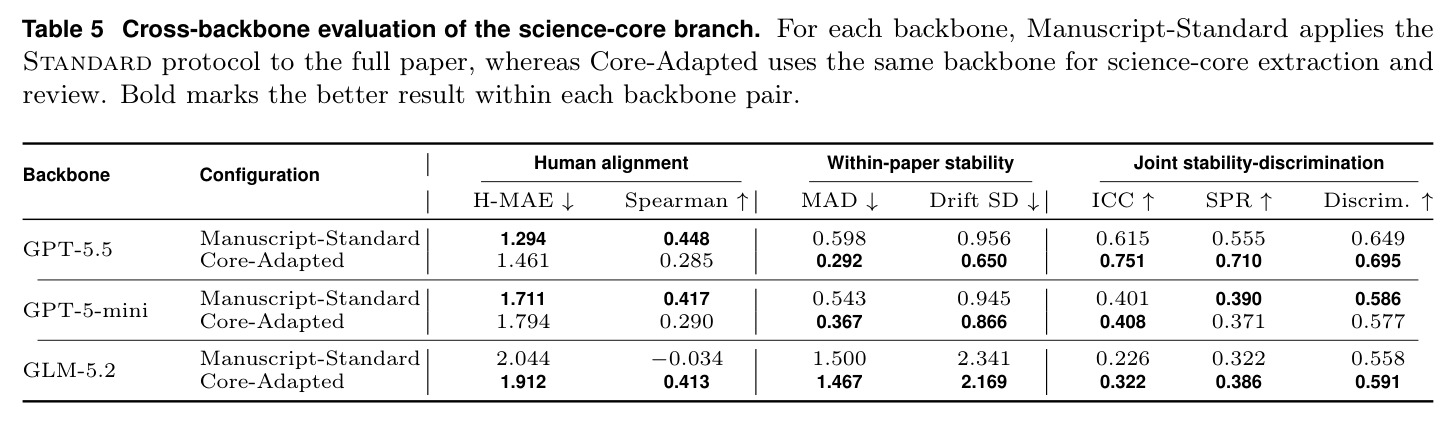
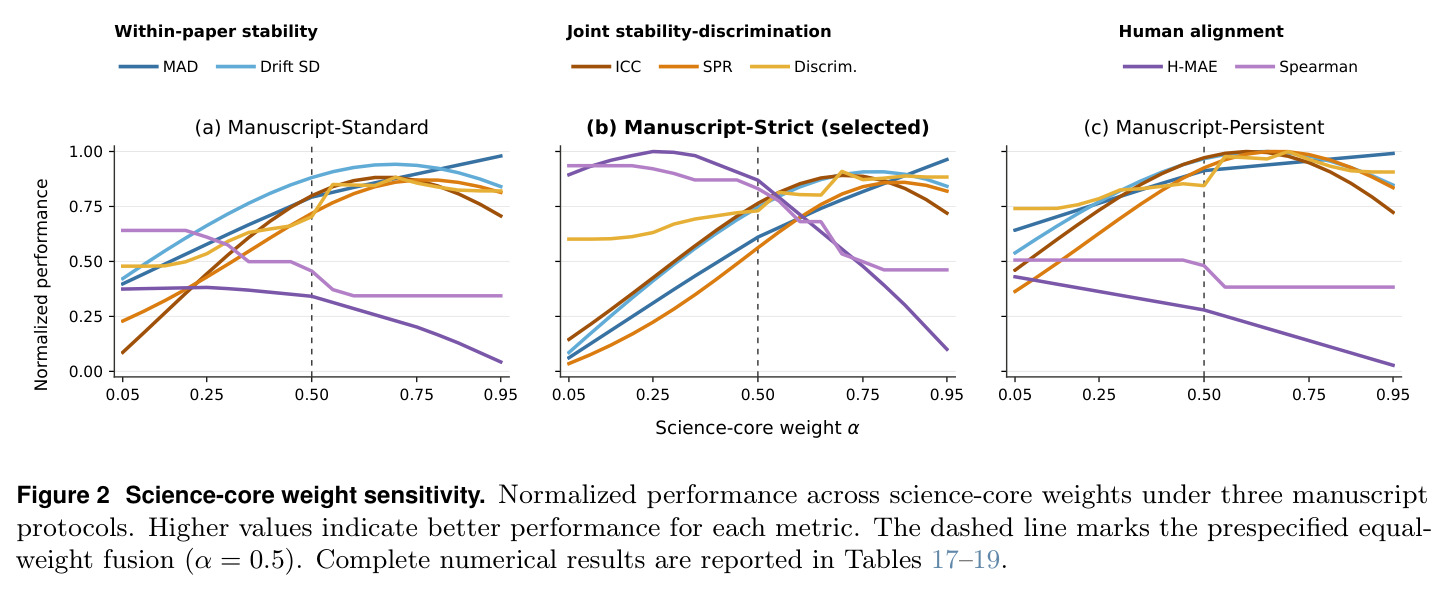
基准层面三个发现。其一,Persistent 内容导向提示不可靠:30 个配置中只有 GPT-5.5 在全部 5 个鲁棒性指标同时改善;Claude Sonnet 5 降 MAD(0.468→0.307)却降 ICC(0.579→0.489),GLM-5.2 全面恶化(MAD 1.500→1.932,Spearman 跌至 -0.190)。其二,伪鲁棒性普遍:Gemini-3.5-Flash-Lite Standard 的 MAD 最低(0.205)但 ICC 仅 0.199、判别力 0.511 接近随机;DeepReviewer 与 OpenJudge 的 ICC 仅 0.161/0.239;相反 GPT-5.5 Persistent(MAD 0.476)拥有基线中最强的 ICC 0.697、SPR 0.586、判别力 0.682。其三,人类一致性与鲁棒性排序不同:GPT-5.5 Strict 的 H-MAE=1.078、Spearman=0.529 为基线最佳,Persistent 则鲁棒性最佳,两维度偏好不同协议。SciCore 主结果:ICC 0.775、SPR 0.652、判别力 0.726 全场第一,H-MAE 1.072 全场最低,Spearman 0.488 第二;MAD 0.476、Drift SD 0.687 显著优于其稿件分支(0.766/1.202)。消融显示重建评审(MAD 0.651)不如直接评审内核,Core-Adapted 是最强单分支(MAD 0.292、ICC 0.751、SPR 0.710);5,000 次配对论文族 bootstrap 下融合相对 Manuscript-Strict 在全部 5 个鲁棒性指标显著改善。跨骨干迁移部分成立:GLM-5.2 七项全改善(Spearman -0.034→0.413),GPT-5-mini 混合,人类一致性不一致;权重扫描表明 $\alpha=0.5$ 处于鲁棒性-一致性过渡区且帕累托不被支配。
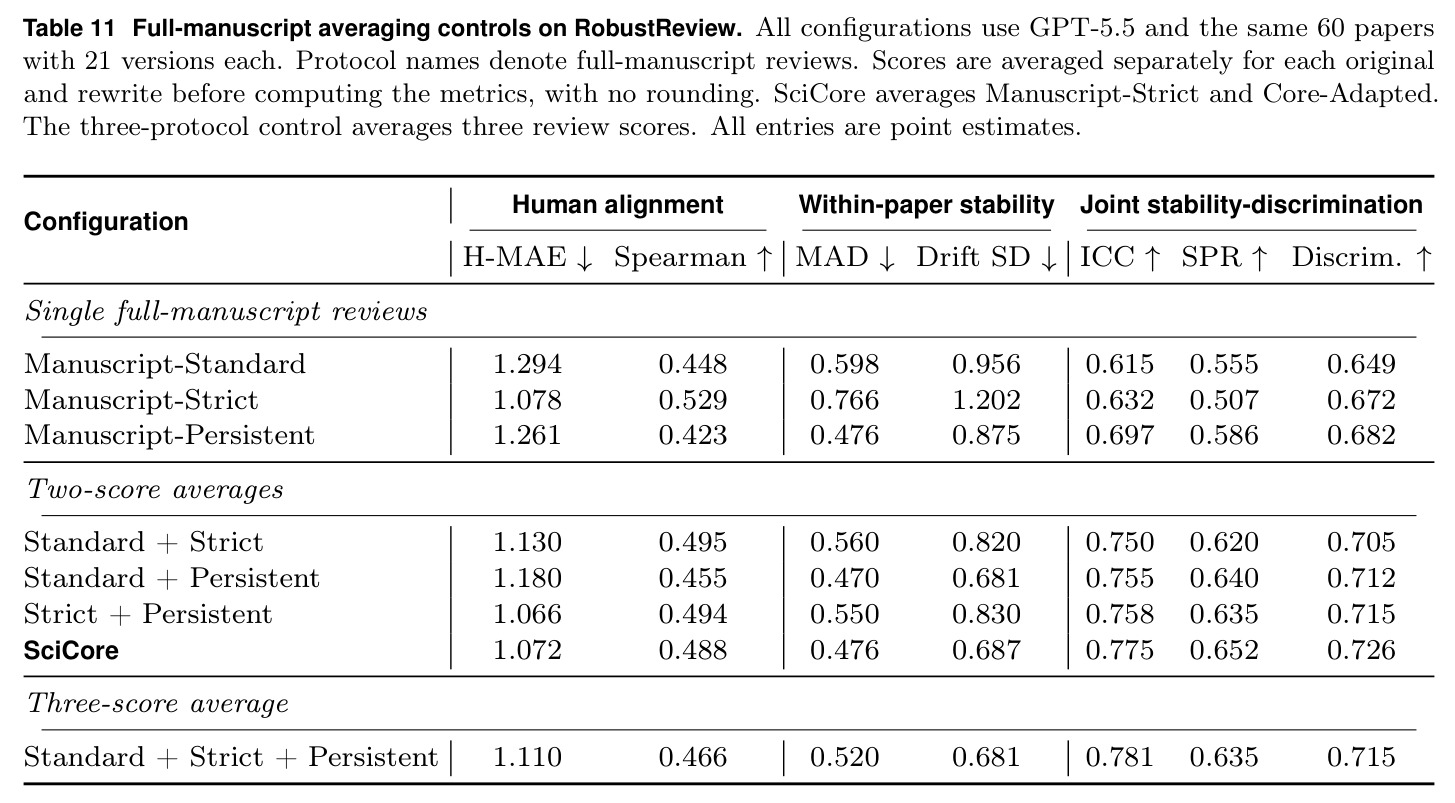
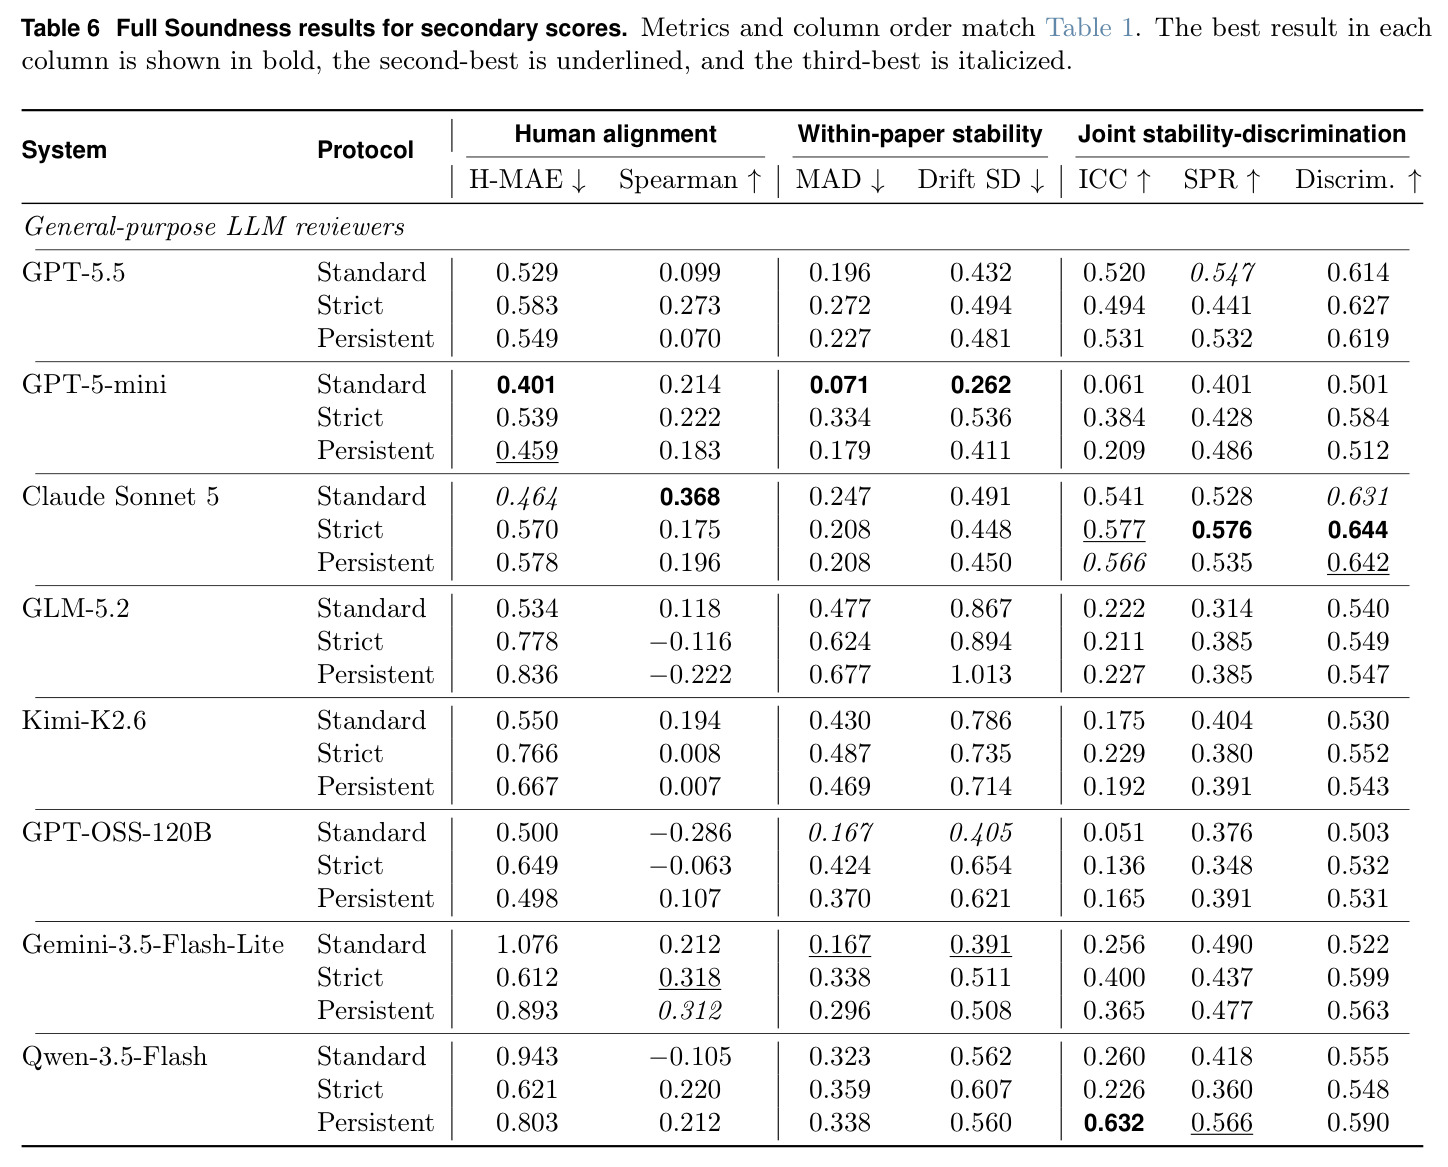
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 修辞鲁棒性(论文内一致性×论文间区分力) | ICC(A,1) | 0.775 | GPT-5.5 Persistent 0.697(30个基线配置中最高) | +0.078 |
| 修辞鲁棒性 | SPR(信号保持比) | 0.652 | GPT-5.5 Persistent 0.586 | +0.066 |
| 修辞鲁棒性 | 判别力(Discriminability) | 0.726 | GPT-5.5 Persistent 0.682 | +0.044 |
| 人类评分一致性 | Human MAE | 1.072 | GPT-5.5 Strict 1.078 | -0.006(全场最低,同时保持鲁棒性优势) |
| 修辞稳定性(相对自身稿件分支 Manuscript-Strict) | MAD | 0.476 | 0.766 | -0.290(降低约38%,配对bootstrap显著) |
| 修辞稳定性(相对 Manuscript-Strict) | Drift SD | 0.687 | 1.202 | -0.515(降低约43%,配对bootstrap显著) |
局限与改进
作者承认的局限:RobustReview 只覆盖 60 篇 ICLR 2026 投稿(须有匹配的 arXiv LaTeX 源码),对其他会议、领域和稿件格式的泛化未知;改写设计上保持内容但无法保证严格等价,自动审计也承认存在非零失配率,残余内容差异可能贡献了观察到的分数变化;人类均分只是有限的外部参照,未刻画审稿人之间的分歧;SciCore 融合只在 GPT-5.5 上完成端到端评估,跨骨干实验只测了内核分支且把抽取和评审两个阶段捆绑变化,无法归因性能瓶颈;科学内核抽取可能遗漏或误读细节且增加推理开销;等权融合默认两分支在共享量表上可比。我的补充观察:其一,整个流水线几乎完全依赖 GPT-5.5 家族(抽取、内核评审、稿件评审都用它),与单一供应商深度耦合;其二,保真度审计用 LLM 审 LLM 改写,审计器的系统性盲区可能与改写器的系统性偏差相关,导致失配率被低估;其三,基准只含 10 种良性修辞条件,没有自适应攻击者——专门针对抽取器优化的对抗改写(例如诱导抽取器丢失关键限定条件或负面结果)可能绕过 SciCore;其四,主实验每稿只评审一次,虽然审计显示条件级均值效应稳定(单次 vs 三次评审的条件效应 Pearson 0.975、Spearman 0.944),但单篇层面的稳定性指标仍受解码随机性影响。
独立分析的弱点
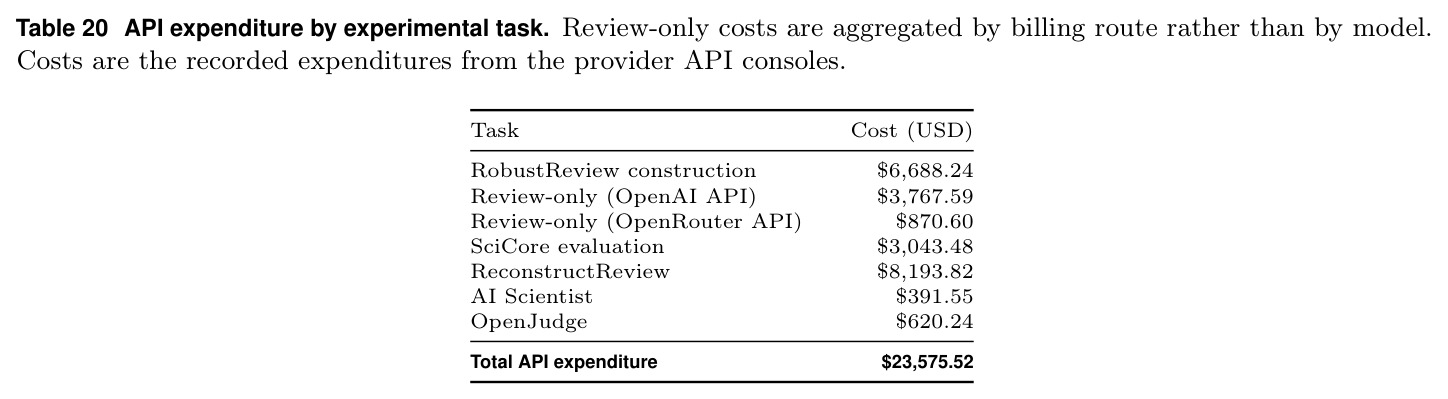
独立分析的弱点及改进方向。第一,规模与单一性:60 篇论文、单一会议,统计功效有限——SciCore 的 ICC 区间宽达 [0.667, 0.835];改进方向是把论文族构造做成可扩展的开源管线,纳入 NeurIPS、ACL 等不同评审文化。第二,抽取器是新的单点风险:内核由 LLM 抽取,若系统性丢失否定性结果或限定条件,内核分支会稳定但系统性偏乐观——Table 4 中 confidence 维度在 Core-Standard/Strict 下输出恒定(MAD=0、SPR=0)的坍缩正说明内核评审对协议敏感;改进方向是给抽取加数值/公式一致性校验器或要求输出原文证据链。第三,融合权重粗糙:$\alpha=0.5$ 只是帕累托不被支配的默认值,扫描显示 $\alpha\to 1$ 时 H-MAE 恶化到 1.461、Spearman 跌至 0.285,可在留出集学习 $\alpha$ 或按论文类型自适应门控。第四,成本:端到端每稿需一次抽取加两次评审,总 API 开销 23,575.52 美元,其中 ReconstructReview 消融占 8,193.82 美元;好在 Table 3 显示 GPT-5-mini 抽取相似度 0.975 与 GPT-5.5 的 0.978 几乎持平,抽取环节可用小模型降本。第五,未验证对抗适应场景,需专门红队评估针对抽取器的攻击。
未来方向
作者提出或可延伸的方向。第一,自适应红队:学习型改写攻击(如 Yang et al., 2026a 可针对特定裁判优化的意义保持风格编辑)能否攻破内核分支,是检验安全边界的自然下一步,也可催生抽取器的对抗训练。第二,把内容归一化评审推广到一般 LLM-as-a-Judge:凡评估对象存在合法表达变化的场景(重构后的等价代码、翻译改写)都可套用抽取内核再评审的范式,与长度控制评估(Dubois et al., 2024)、表示裁判(Li et al., 2026d)形成技术谱系。第三,理论落地:附录给出 Lipschitz MAD 界与 Blackwell 窬化论证,但未估计 Lipschitz 常数 $L$ 与表示距离 $d_Z$,实证刻画可把设计直觉变成可计算保证。第四,与缺陷检测互补:Dycke & Gurevych (2026) 改实质推理测缺陷检测,本文改修辞测不变性,两者结合可构造既检测实质缺陷又对修辞免疫的评估体系。第五,多分支扩展:在稿件与内核分支外增加证据核查分支(逐条验证主张与引用支撑)或复现性分支,融合从等权升级为学习加权或基于分支分歧的置信度门控。第六,在真实投稿流程中验证修辞鲁棒性指标与实际评审质量改善的相关性。
复现评估
复现条件中等偏上。开源情况:项目页 https://github.com/c-steve-wang/Robust_Review,附录完整给出采样程序(OpenReview API + arXiv 源码匹配,相似度阈值 0.8,固定种子 42)、10 种改写条件定义与提示词、四种评审协议、7 个指标的完整公式及执行设置,工程质量较高。数据:1,260 份稿件语料理论可由管线重建,但依赖 OpenReview 与 arXiv 源码可得性。算力与成本是主要门槛:论文报告总 API 开销 23,575.52 美元——基准构建 6,688.24 美元、评审 4,638.19 美元(OpenAI 3,767.59 + OpenRouter 870.60)、SciCore 评估 3,043.48 美元、ReconstructReview 消融 8,193.82 美元;三个专用评审模型(Llama-OpenReviewer-8B、CycleReviewer-ML-Llama-3.1-8B、DeepReviewer-14B)需本地 8 卡 A100 服务器,PDF 输入需经 Datalab OCR 转 Markdown。若只复现核心结论(SciCore 及其消融在 GPT-5.5 上),缩小规模后数千美元可行;完整复现 30 配置网格需上万美元预算,外加 LaTeX 编译、多 API 对接与结构校验的工程能力。
论文图表