Mid-Harness:在模型与执行框架之间扩展动作规模 Mid-Harness: Scaling Actions Between Model and Harness for Terminal Agents
在动作执行前采样并验证多个候选命令,把测试时计算投向模型与框架边界
前置知识
终端智能体与 Harness(执行框架)
终端智能体是在 shell 环境中通过执行命令完成软件工程任务的 LLM 系统。Harness(如 Vanillux2、Terminus-2)是包裹模型的工程脚手架:它把模型输出解析成可执行动作,在环境中执行,再把观察结果拼回对话历史,循环直到任务完成或超步数。模型权重和 harness 代码一起决定了智能体的行为。
本文的全部操作都发生在模型调用与 harness 执行之间的那个接口上(model-call wrapper),理解 harness 是什么才能理解'Mid-Harness'这个名字的含义。
测试时计算扩展(Test-time Compute Scaling)
指在推理阶段投入额外计算来换取更高成功率,而非训练更大的模型。常见手段包括多次采样(Best-of-N)、验证器挑选、搜索和顺序反思。已有工作大多在'完整轨迹'层面做文章,即跑多条完整任务轨迹再挑最好的输出。
论文提出'动作级扩展'是与轨迹级并行/顺序扩展正交的第三条扩展轴,并系统证明了两者可以组合获得更好的成本-成功率曲线。
Pass@1 与 Pass@3
Pass@1 是每个任务独立运行多次后平均的单次成功率,衡量稳定完成任务的能力;Pass@3 是三次运行中至少有一次成功的任务比例,衡量能力的上限。论文在 TerminalBench-Lite 等基准上每个任务跑 3 次来同时报告这两个指标。
论文所有实验结果都以这两个指标报告,两者的差值(如基线 50.00%/69.39%)也反映了动作随机性带来的不稳定性。
生成式验证器与成对比较(Pairwise Verification)
生成式验证器通过生成推理文本和分数来评判候选质量,而非只输出一个标量。成对比较机制每次只让验证器看两个候选并输出偏好(A/B/TIE),最后用 margin 加权胜率对所有候选排序。8 个候选两两比较需要 28 次调用,listwise 只需 1 次,pointwise 需 8 次。
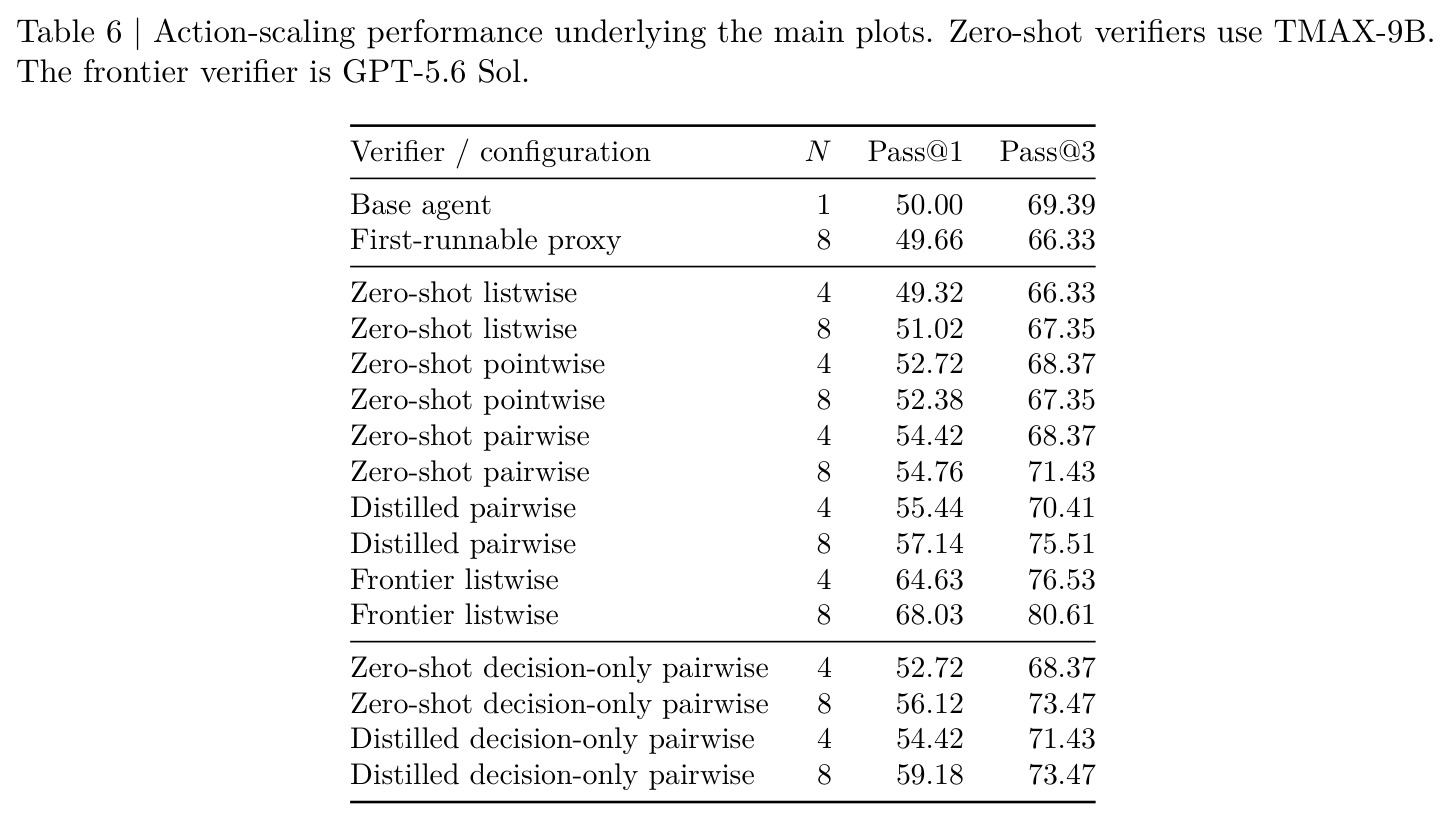
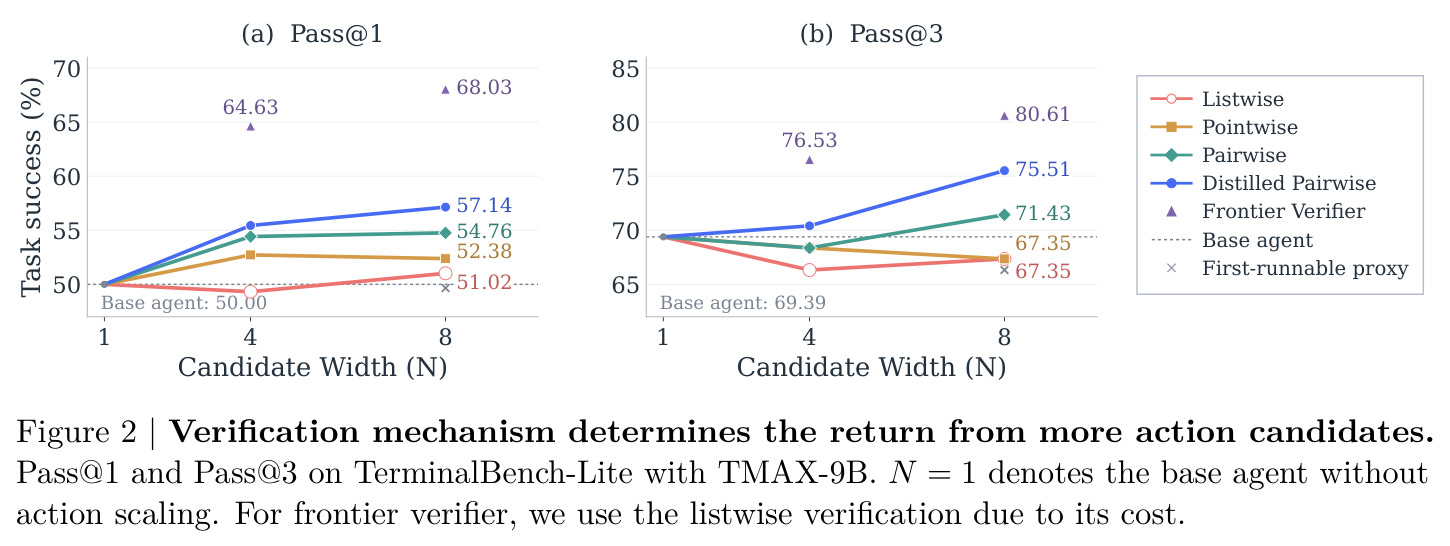
论文核心实证发现是:在同一模型作验证器的条件下,pairwise 机制效果最好(Pass@1 54.76% vs listwise/pointwise 约 51%),比较形式本身就是关键变量。
LoRA 蒸馏
LoRA(低秩适配)在冻结原模型权重的前提下训练少量低秩矩阵,实现参数高效微调。蒸馏指用强教师模型(GPT-5.6 Sol)的输出去训练弱学生模型,把教师能力迁移到学生身上。本文蒸馏的是验证器,生成器完全不动,LoRA 只在验证阶段激活。
验证器蒸馏是论文连接'强验证器上限'与'可部署的自验证'的桥梁,把 68.03% 的上限部分回收到了 57.14%。
研究动机
终端智能体的每一步动作都由模型随机采样生成,'能生成好动作'不等于'能可靠执行好动作'。一条坏命令(改错代码、装错包)会永久改变环境状态,让后续所有决策都建立在被污染的环境上,即使模型本来完全可以采样出更好的替代动作。这种随机性的后果在数据上很直观:TMAX-9B 在 TerminalBench-Lite 上 Pass@1 只有 50.00%,而 Pass@3 达 69.39%,说明同一模型、同一 harness 下有近 20 个百分点的任务'有时成有时败'。已有的测试时计算扩展大多在完整轨迹层面运作(如 Best-of-$T$ 需要跑 $T$ 条完整轨迹再挑最好),错误要到最后才被发现,且每条轨迹都要独占一个环境实例;对'动作执行前验证'的研究既少也缺乏系统性——增加候选数量到底有没有用、用什么机制比较候选、验证器能力多大才算够,这些问题没有清楚答案。
本文的目标是本文要回答两个核心问题:第一,在模型-harness 边界分配测试时计算,能否提升动作可靠性和轨迹成功率?第二,什么样的分配方式才是有效的?具体拆解为三个子问题:(1) 生成器是否已经在采样出有用的替代动作,只是没被识别出来;(2) 在不换验证器模型的前提下,listwise、pointwise、pairwise 哪种比较机制最能兑现候选的价值,蒸馏能否进一步缩小与前沿验证器的差距;(3) 动作级扩展与 Best-of-$T$、Sequential Refine 等轨迹级扩展是否互补,组合后的成本-收益曲线如何变化。整个过程要求生成器和 harness 完全不动,保证结论可归因到动作级扩展本身。
与已有工作不同的是,已有工作的切入点要么是模型侧(用 RL 和合成任务训练更强的终端模型,如 TMAX),要么是 harness 侧(上下文管理、自动化 harness 优化),要么是轨迹侧(Best-of-$T$、Sequential Refine 验证完整运行)。虽然有工作验证每步候选(LLM-as-a-Verifier)或用训练好的 critic 排序动作,但都停留在单一机制,没有回答'验证机制的形式本身在多大程度上决定收益'。本文的独特之处在于把动作级验证固化为一个可插拔的 model-call wrapper(Mid-Harness),在固定模型与 harness 的边界上系统变化候选宽度 $N$、比较机制和验证器能力三个变量,从而第一次把'动作规模'确立为一条可独立研究、可与其他扩展组合的测试时计算扩展轴。
核心方法
直觉是:与其花算力跑多条完整轨迹、最后才发现错误,不如在每一步执行前多采样几个候选命令、挑最好的执行——错误在最小代价处被拦截,且只需一个环境实例。技术上 Mid-Harness 的集成极其轻量:在 model-call wrapper 里把 `return await llm.generate(messages)` 改成先采样 N 个候选 `candidates = await llm.generate(messages, n=N)`,再调用 `verify(llm, messages, candidates)` 返回唯一被选中的动作,harness 主循环一行不改、模型权重不训练。形式化地,设生成器为 $\pi$,历史为 $h_t = (o_0, a_1, o_1, \ldots, a_{t-1}, o_{t-1})$,采样 $\mathcal{A}_t = (a_t^1, \ldots, a_t^N)$,$a_t^i \sim \pi(\cdot \mid h_t)$,由验证器选出 $a_t^\star = \text{Verify}_\psi(h_t, \mathcal{A}_t) \in \mathcal{A}_t$ 交给 harness 执行,其余候选丢弃。验证器只看任务、历史和候选动作,不看生成候选时的 推理。
核心创新是把'动作尺度'确立为独立于模型和 harness 的第三条测试时计算扩展轴,并用控制变量法回答了'什么时候有用'。与轨迹级验证(比较已完成的运行)的本质区别在于:同一历史下采出的候选可能在'目的'层面就不同——比如诊断失败原因还是盲目重试——在任务未完成前比较它们,既改善下一步动作,也改善后续会遇到的状态分布,还只需一个环境实例。论文最重要的实证洞察是'验证器质量决定采样收益':弱验证下把候选宽度从 $N=4$ 加到 $N=8$,Pass@1 只从 49.32% 涨到 51.02%;换上 GPT-5.6 Sol 作验证器,同样的生成器、同样的机制却达到 68.03%——说明瓶颈不在候选覆盖而在识别能力。第二层洞察是验证机制的形式本身很重要:同为 TMAX-9B 自验证,pairwise(54.76%)显著好于 listwise 和 pointwise(51.02%),因为它让每次比较聚焦在两个候选的具体差异上并共享参照物。
方法步骤详情
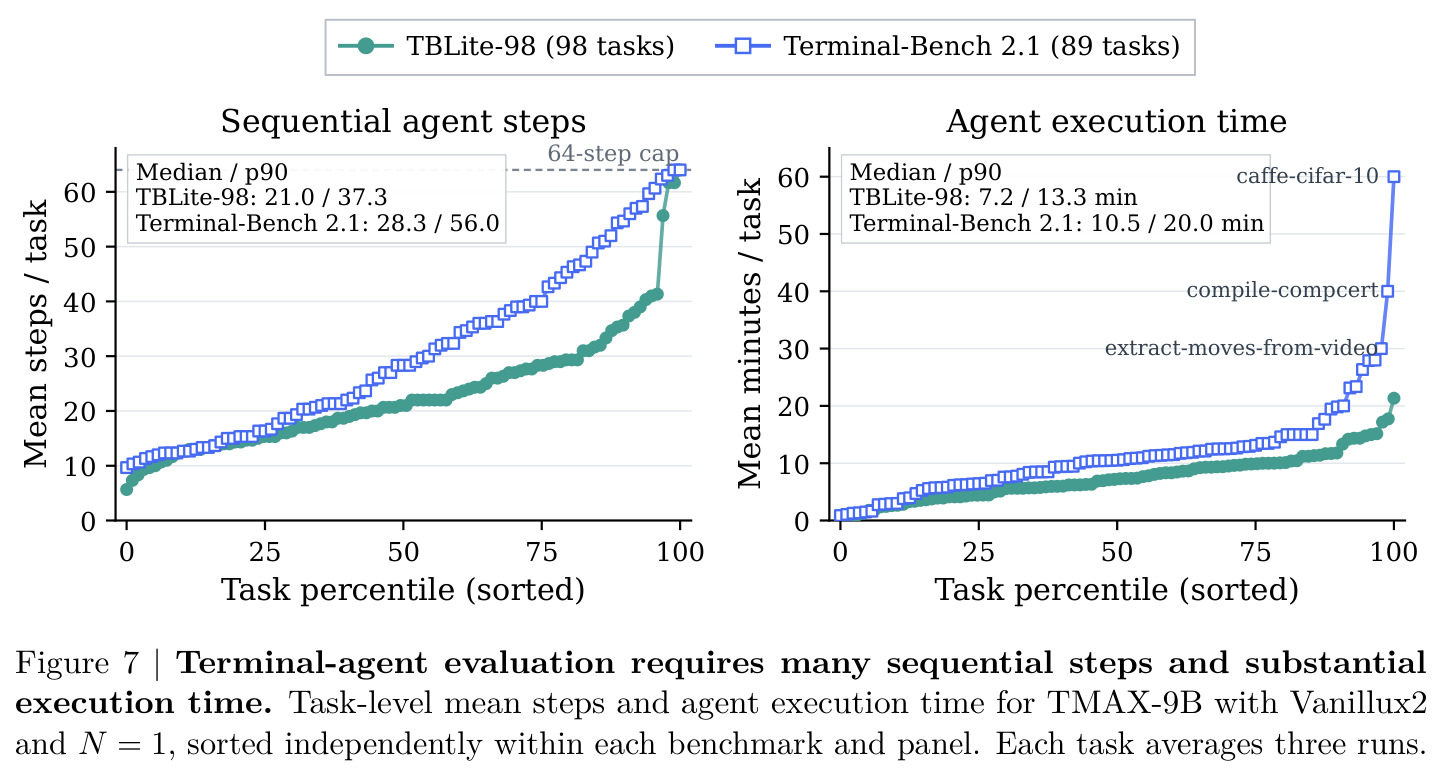
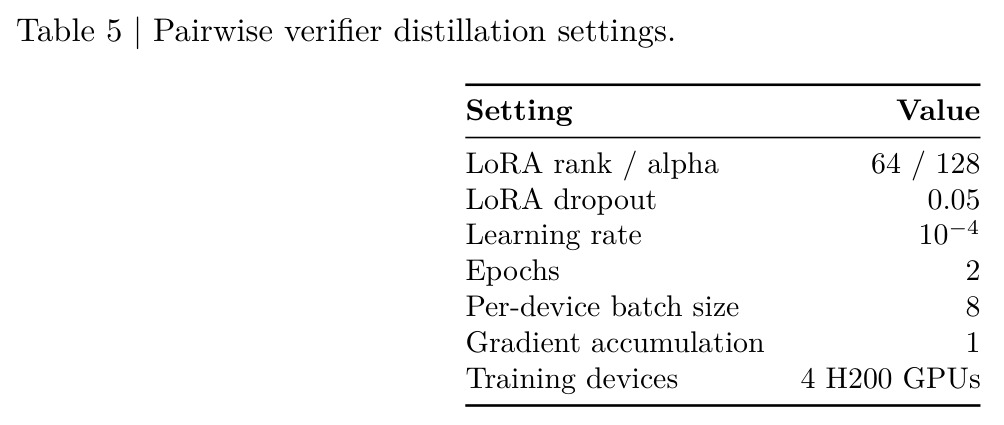
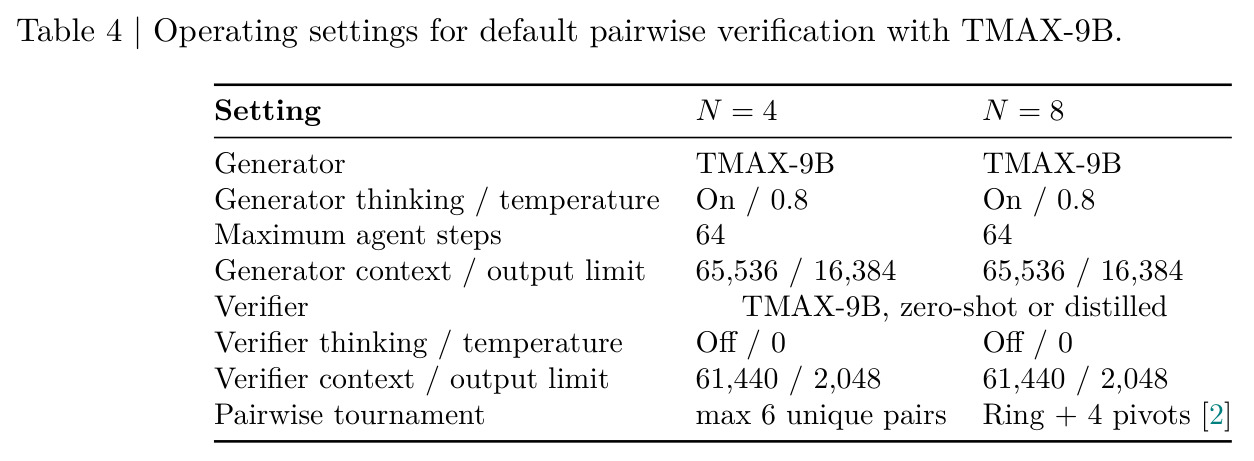
第一步,候选采样:harness 每次请求动作时,wrapper 用 temperature 0.8 从 $\pi(\cdot|h_t)$ 采 $N$ 个候选(主实验 $N \in \{4, 8\}$,最多 64 步、上下文 65,536 token、单步输出上限 16,384 token)。第二步,验证:三种机制任选——listwise 把全部候选放进一个 prompt 一次选出(1 次调用);pointwise 给每个候选独立打分 $q_i = \psi_{\text{point}}(h_t, a_t^i)$ 取 argmax($N$ 次调用);pairwise 对无序对生成偏好 $J_{ij} = \psi_{\text{pair}}(h_t, a_t^i, a_t^j)$,用 margin 加权胜率排序(8 候选 28 次调用)。第三步,执行:只有 $a_t^\star$ 被 harness 执行,得到 $o_t$,历史更新为 $h_{t+1} = (h_t, a_t^\star, o_t)$。第四步,验证器蒸馏:从 244 个困难 TMAX-15k 任务的 732 条轨迹收集 117k 条 GPT-5.6 Sol 的 pairwise 响应(推理、分数、偏好标签),用 LoRA 微调 TMAX-9B 作验证器,生成器不动。第五步,评估与成本核算:每任务跑 3 次报 Pass@1/Pass@3,用并行输出 token(POT)和验证器总输出 token 估算成本,蒸馏版按 OpenRouter 参考价折算美元。
技术新颖性
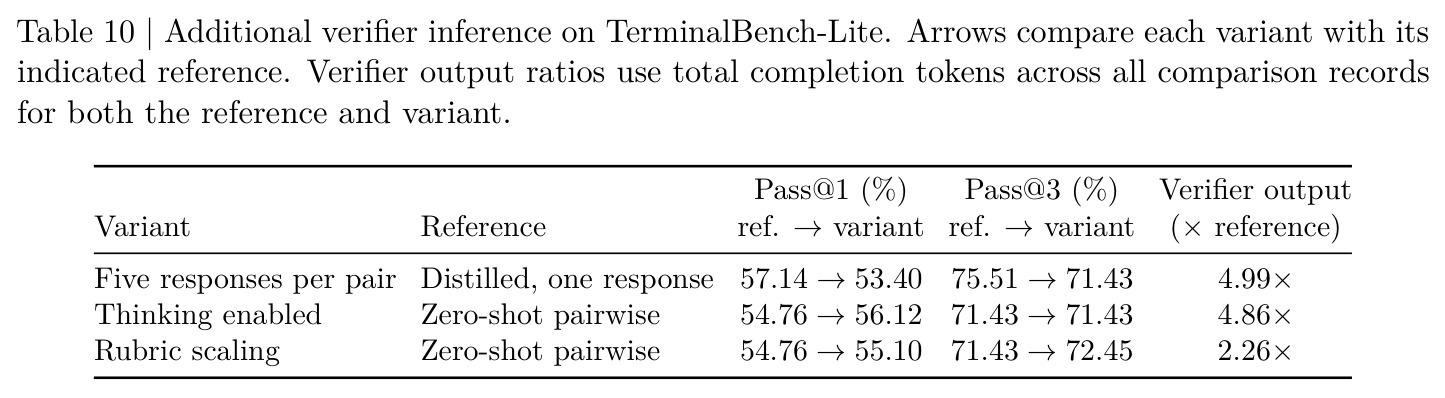
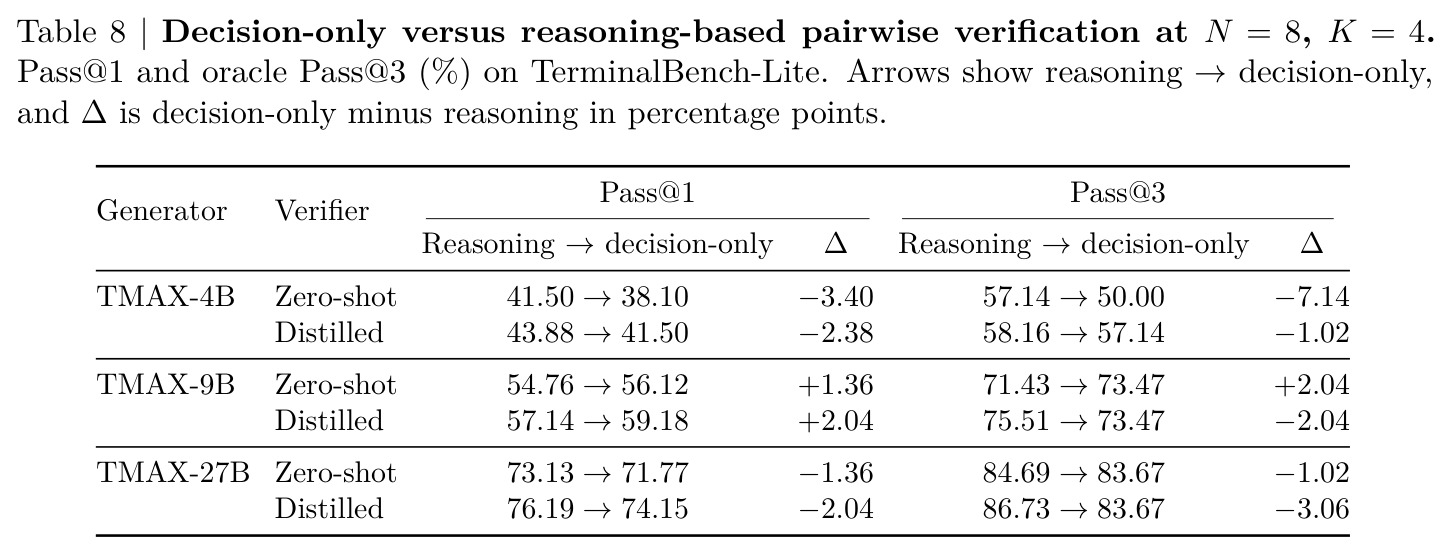
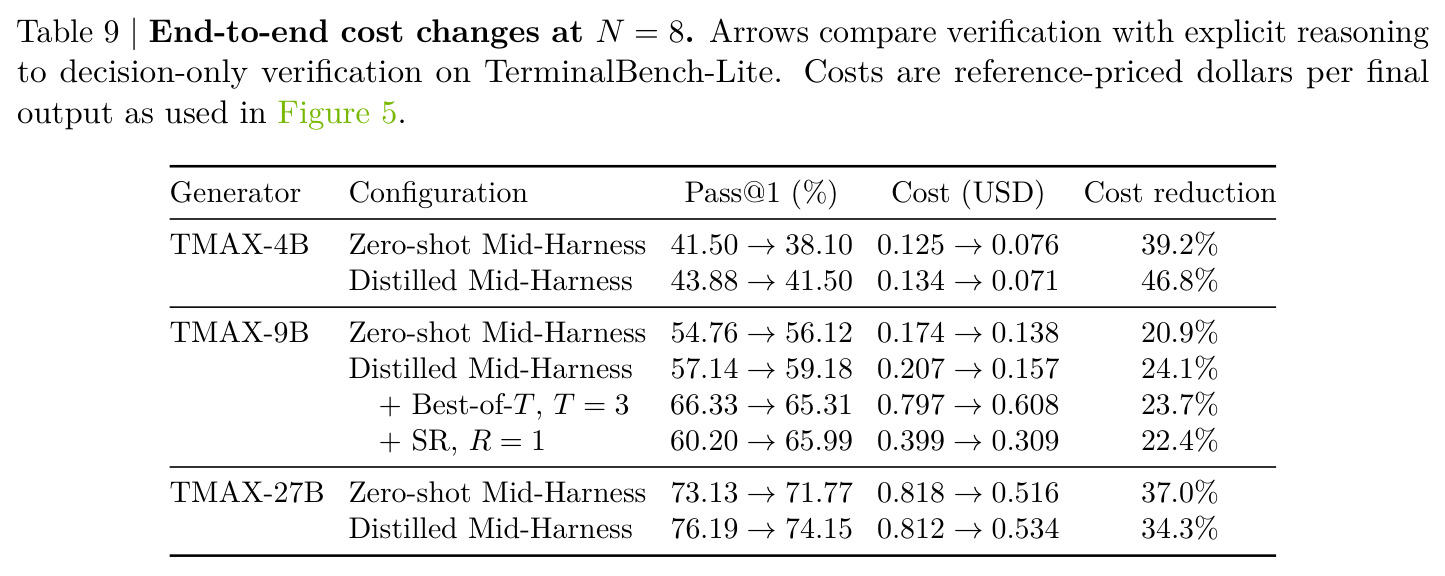
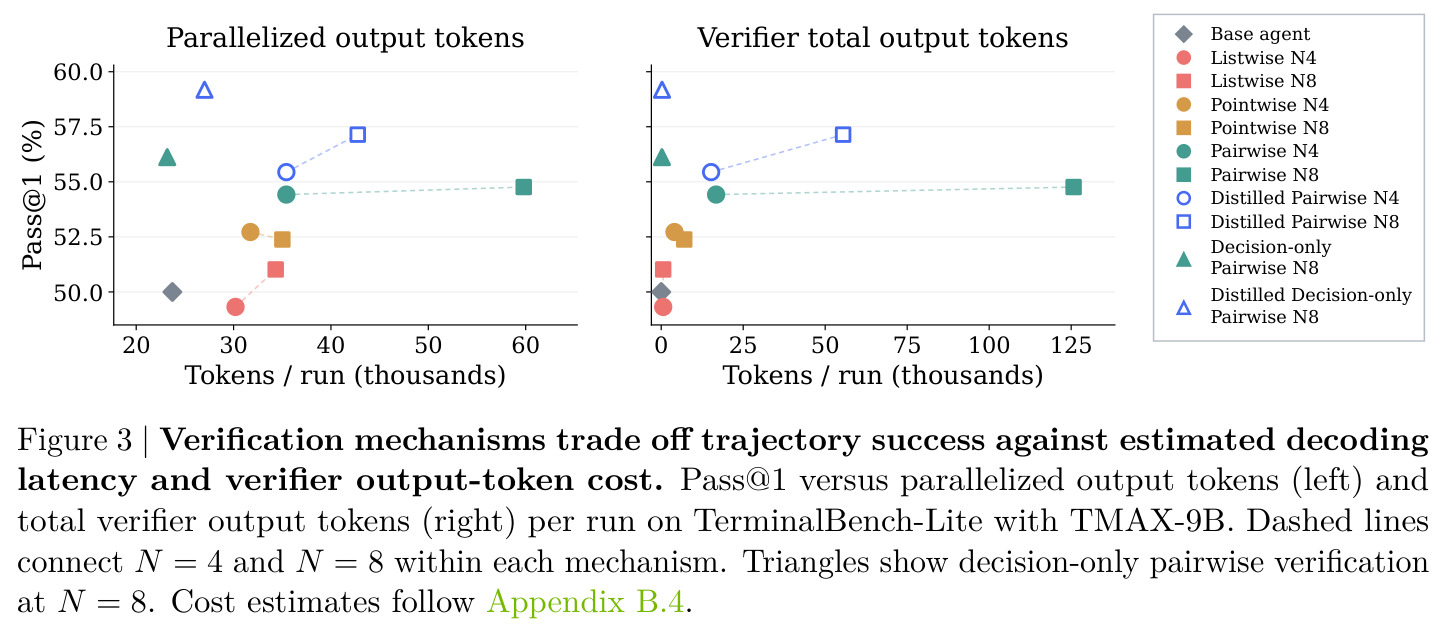
技术新颖性体现在四点。其一,Mid-Harness 作为 method 贡献本身:通过在 model-call wrapper 内实现(伪代码只加两行),与任何模型、任何 harness 正交组合,这使它成为研究工具而非绑定某个系统的方法。其二,对验证机制的系统比较是新的:先前工作用单一机制,本文证明 pairwise 在自验证下最优且解释了为什么(每次比较聚焦差异、共享参照),代价是 28 次调用带来 125.7k 验证器输出 token(listwise 仅 0.6k)。其三,decision-only 验证器的发现反直觉:去掉推理、直接输出 A/B 偏好的 pairwise 验证器在 TMAX-9B 上反而比带推理的更准(Pass@1 更高),同时按参考价降低 20.9%(零样本)和 24.1%(蒸馏)的 token 成本,说明动作验证与数学推理验证的规律不同。其四,蒸馏目标的选择:不蒸馏动作生成而是蒸馏 pairwise 验证行为,117k 条教师响应就让 Pass@1 从 54.76% 提到 57.14% 且不动生成器,这为'验证器与生成器解耦优化'提供了范式。
实验结果
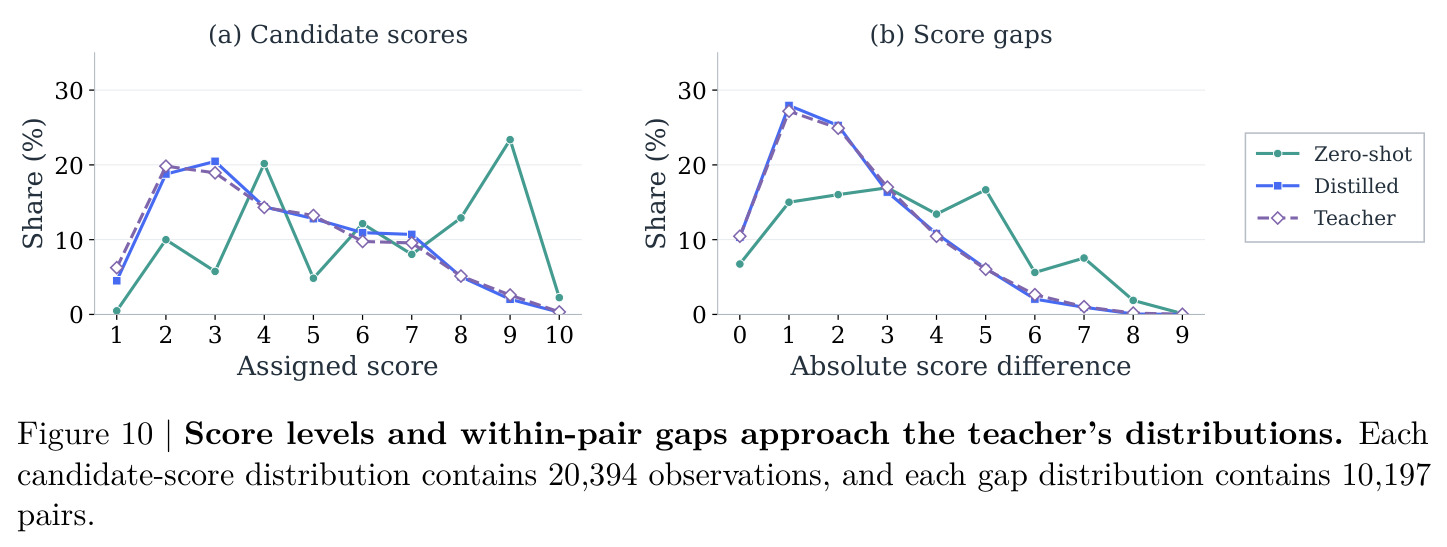
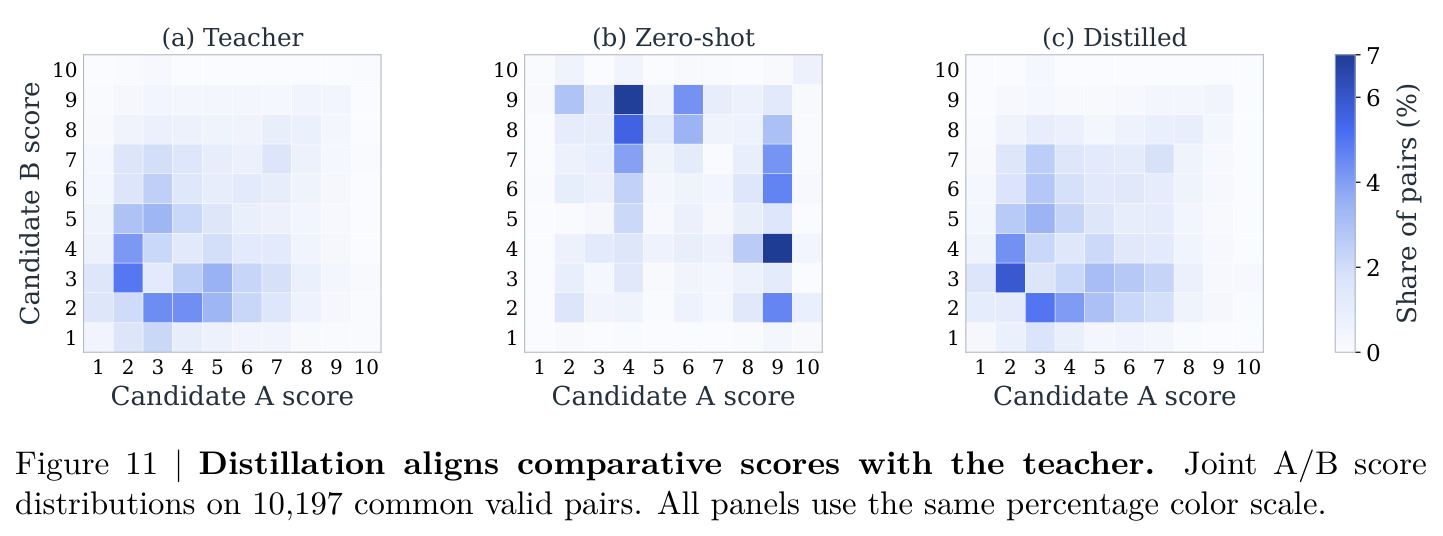
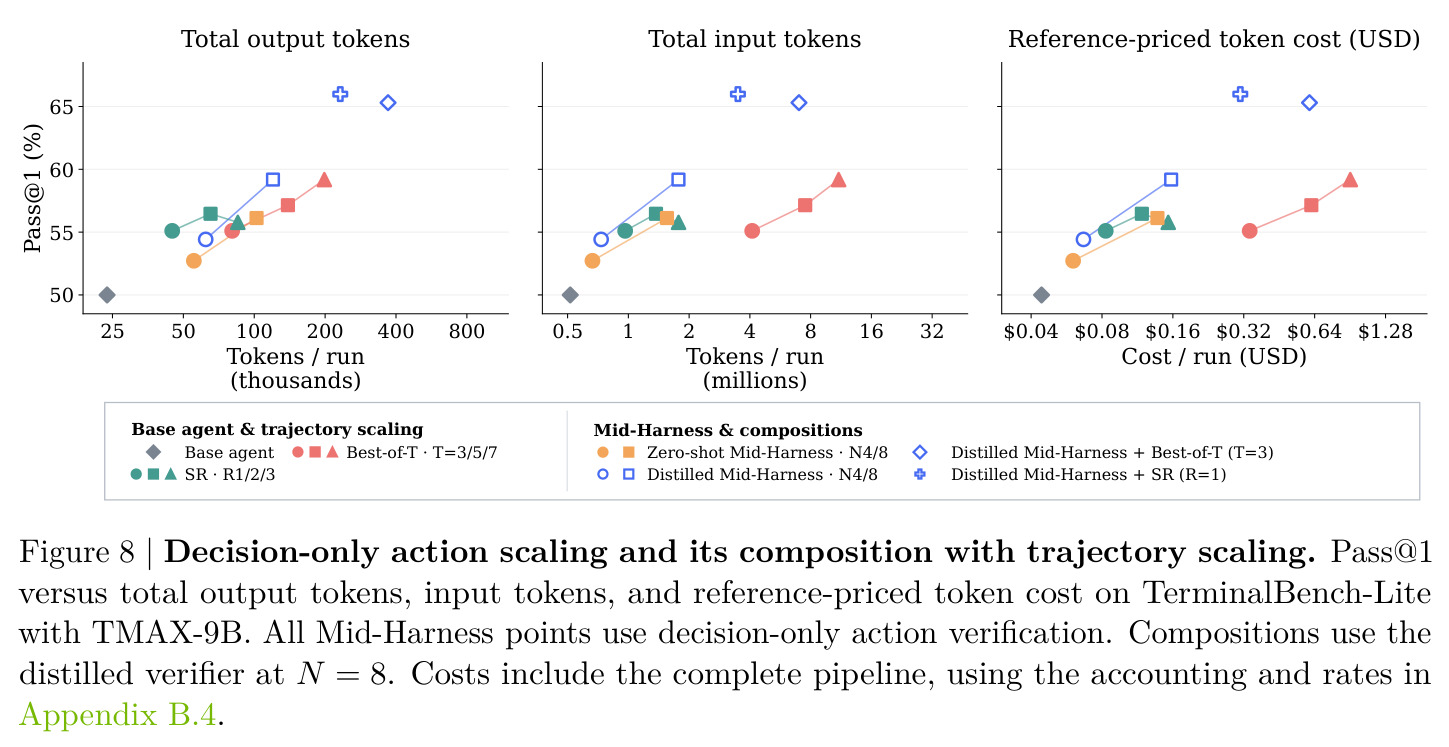
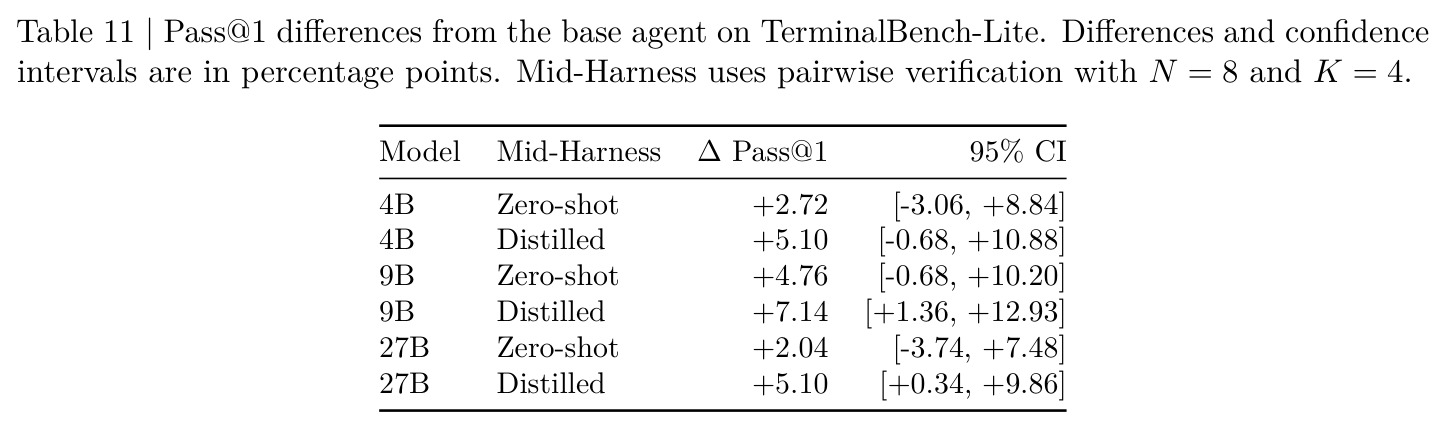
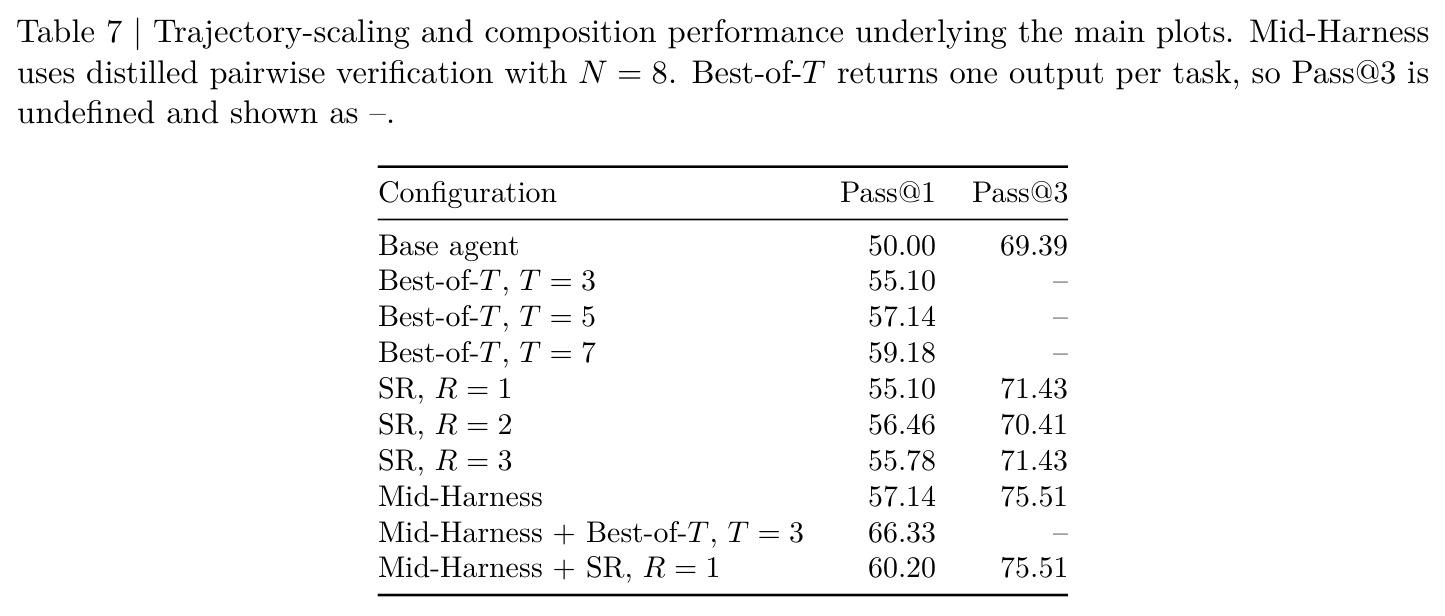
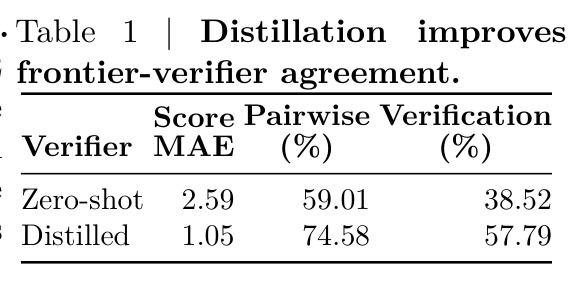
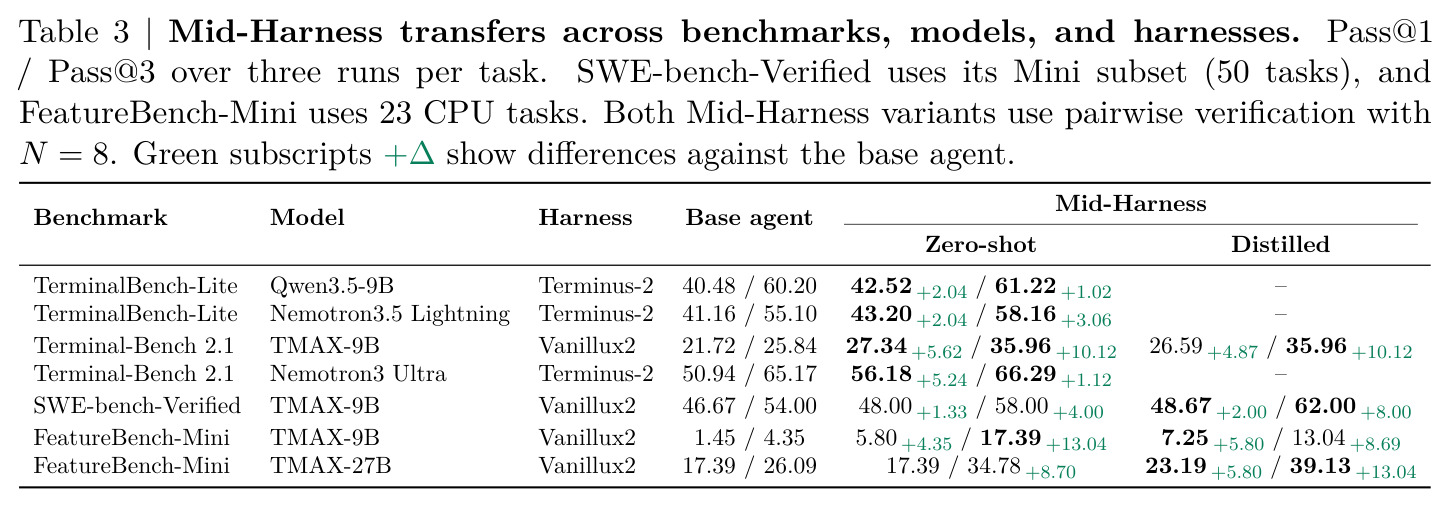
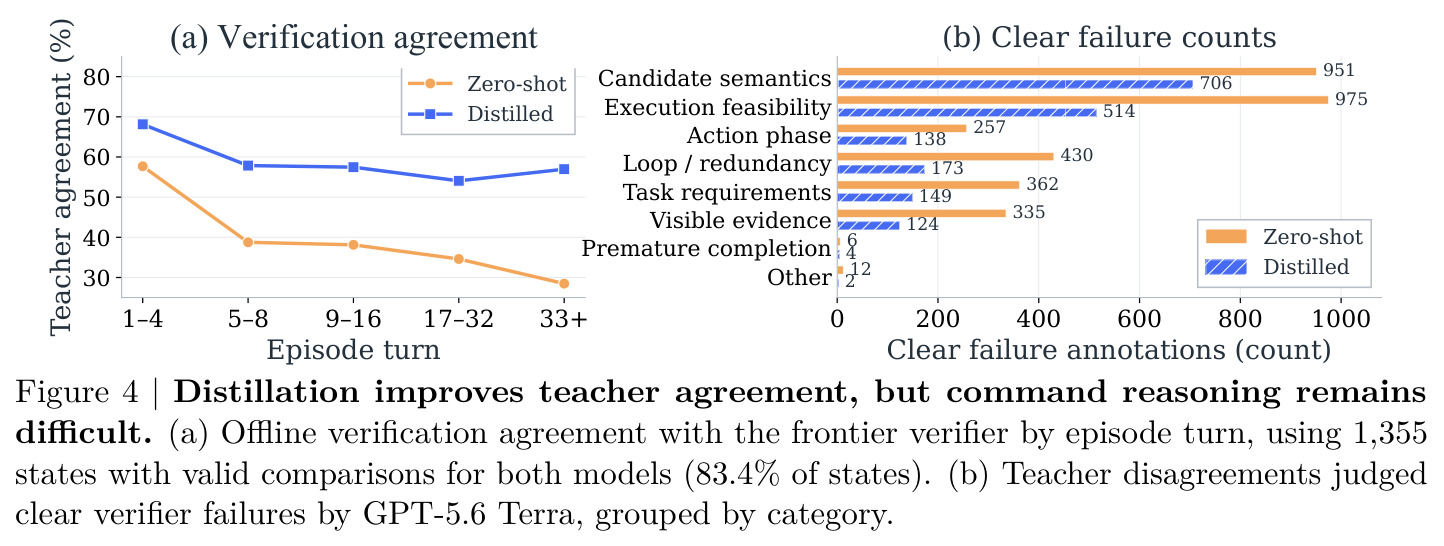
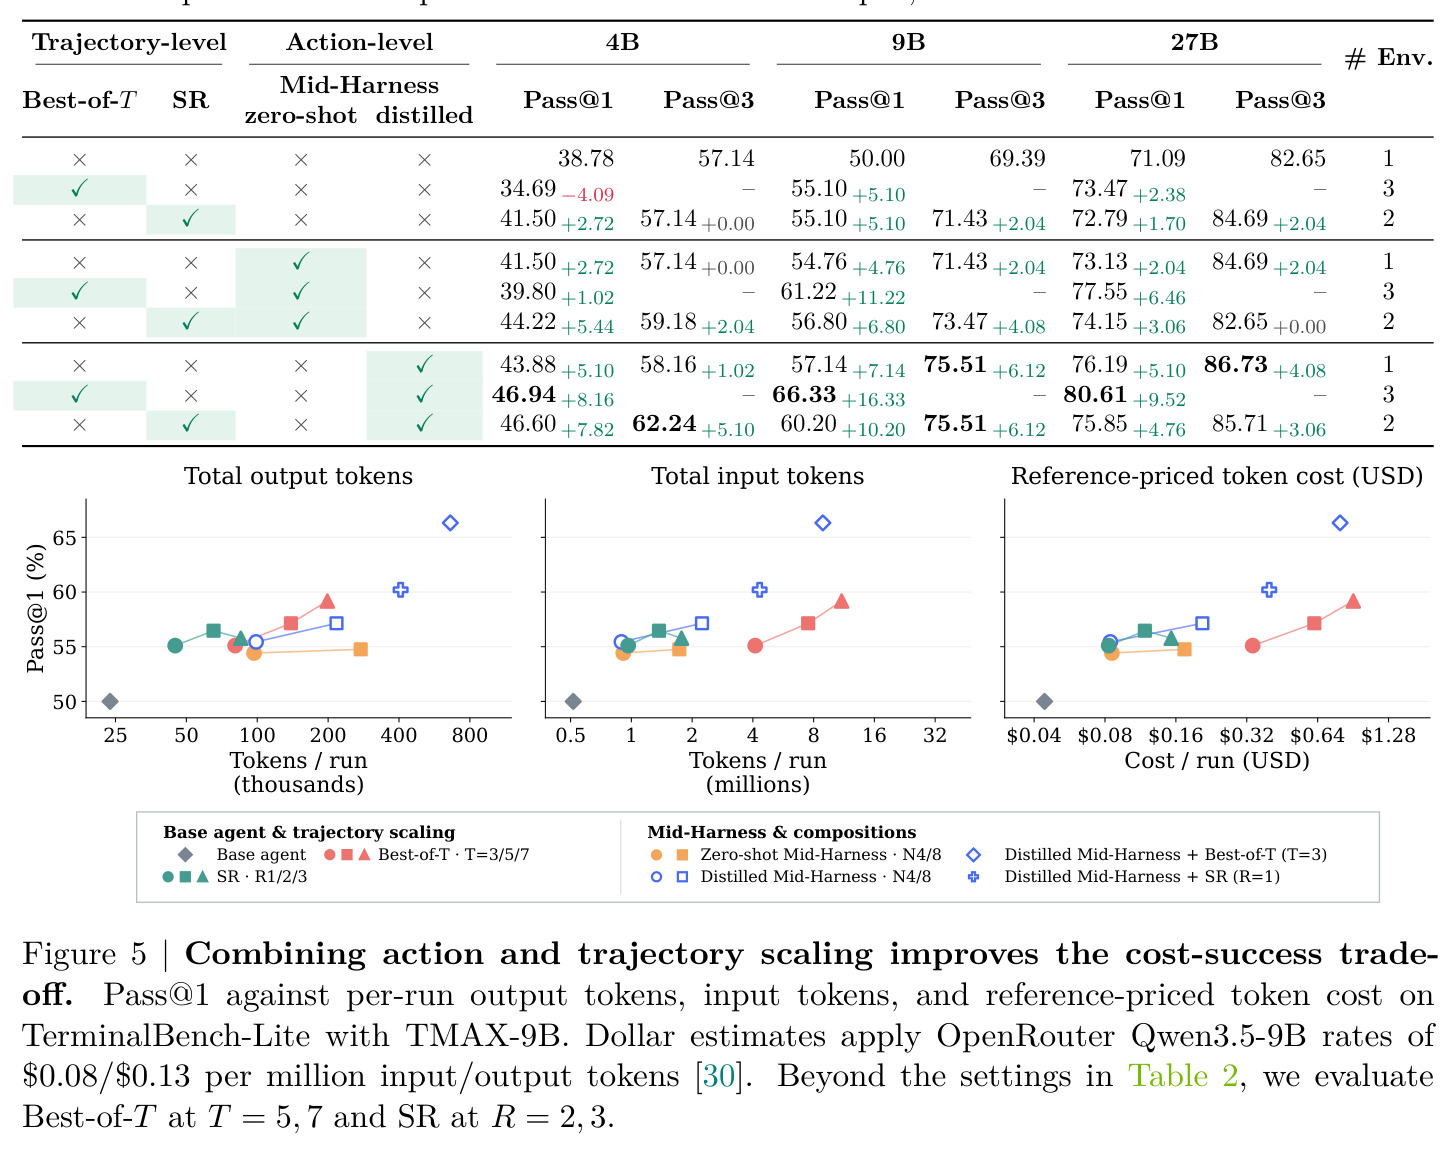
发现一(候选覆盖存在):固定 TMAX-9B 生成器,GPT-5.6 Sol 作验证器时 $N=4$ 达 64.63%、$N=8$ 达 68.03% Pass@1(基线 50.00%),证明生成器已采出有用替代。发现二(弱验证下加宽无用):零样本 listwise 从 $N=4$ 到 $N=8$,Pass@1 仅 49.32%→51.02%,与 frontier 同机制的 64.63% 形成鲜明对比。发现三(pairwise 最佳):$N=8$ 下 pairwise 达 54.76%/71.43%,优于 listwise/pointwise 的约 51%。发现四(蒸馏有效):LoRA 后 $N=8$ 升至 57.14%/75.51%;离线上分数 MAE 2.59→1.05,pairwise 一致性 59.01%→74.58%,验证一致性 38.52%→57.79%,残留失败中 67.4% 是候选语义与执行可行性判断。发现五(成本结构):pairwise $N=8$ 增加 26.6k POT,验证器总输出 125.7k(listwise/pointwise 仅 0.6k/7.0k);decision-only 变体更准且省 20.9%/24.1% 成本。发现六(与轨迹扩展组合):Best-of-$T$($T=3$)55.10% → 加蒸馏 MH 后 66.33%(同样 3 次环境执行);SR($R=1$)55.10% → 60.20%;蒸馏 MH+SR 超过 $T=7$ 的 59.18% 且成本不足其一半。发现七(迁移性):跨模型(4B-550B)、跨 harness、跨基准的 7 个设置中零样本 MH 全部改善 Pass@3,4B 到 27B 都有效(4B:38.78%→43.88%;27B:71.09%→76.19%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TerminalBench-Lite + TMAX-9B(frontier 验证器) | Pass@1($N=8$,listwise) | 68.03% | 50.00%(基线智能体) | +18.03 pp |
| TerminalBench-Lite + TMAX-9B(蒸馏 pairwise 自验证) | Pass@1 / Pass@3($N=8$) | 57.14% / 75.51% | 50.00% / 69.39%(基线) | +7.14 / +6.12 pp |
| Terminal-Bench 2.1 + TMAX-9B | Pass@1 / Pass@3(零样本 pairwise,$N=8$) | 27.34% / 35.96% | 21.72% / 25.84% | +5.62 / +10.12 pp |
| SWE-bench-Verified Mini(50 任务)+ TMAX-9B | Pass@1 / Pass@3(蒸馏 pairwise) | 48.67% / 62.00% | 46.67% / 54.00% | +2.00 / +8.00 pp |
| FeatureBench-Mini(23 CPU 任务)+ TMAX-9B | Pass@1 / Pass@3(零样本 pairwise) | 5.80% / 17.39% | 1.45% / 4.35% | +4.35 / +13.04 pp |
| FeatureBench-Mini + TMAX-27B | Pass@1 / Pass@3(蒸馏 pairwise) | 23.19% / 39.13% | 17.39% / 26.09% | +5.80 / +13.04 pp |
| TerminalBench-Lite + Best-of-T 组合(T=3) | Pass@1(蒸馏 Mid-Harness 参与生成) | 66.33% | 55.10%(纯 Best-of-T) | +11.23 pp(同样 3 次环境执行) |
局限与改进
作者承认的局限:蒸馏后验证一致性与 frontier 教师仍有约 42 个百分点差距(57.79%),残留分歧集中在命令语义和执行可行性这类需要'预演'动作效果的问题上;缺乏动作级金标签,只能通过轨迹成功率间接度量验证质量;decision-only 验证器只在 9B 上更好,4B/27B 上更便宜但 Pass@1 更低。我自己的观察:其一,pairwise 28 次调用带来 125.7k 验证器输出 token,论文用理想化并行(POT)和参考价近似成本,真实串行延迟和 API 限流下的墙钟时间未报告;其二,蒸馏数据全部来自 TMAX 生态(TMAX-15k 任务、Vanillux2),而蒸馏在 Terminal-Bench 2.1 上反而略差于零样本(26.59% vs 27.34%)、在 FeatureBench-Mini 9B 上 Pass@3 下降(13.04% vs 17.39%),提示蒸馏分布窄化风险;其三,每任务仅 3 次运行,对 FeatureBench-Mini 上 1.45% 这种极低成功率的估计方差很大;其四,'只需一个环境实例'的优势依赖动作可重复执行,对有副作用的不可逆操作不成立。
独立分析的弱点
弱点一:pairwise 验证的计算瓶颈。$N=8$ 需 28 次调用、125.7k 输出 token、26.6k POT,decision-only 变体虽省钱但在 27B/4B 上牺牲精度。改进方向:用锦标赛淘汰结构把比较次数从 $\binom{N}{2}$ 降到 $O(N)$,或训练单次前向的判别式打分模型。弱点二:验证器无法真正预演动作效果,残留分歧的 67.4% 集中在候选语义和执行可行性。改进方向:给验证器接入轻量沙箱 dry-run(shellcheck、pip --dry-run、git diff 静态检查)提供客观证据。弱点三:蒸馏泛化性不稳定,在分布外的 Terminal-Bench 2.1 和 FeatureBench-Mini 上零收益甚至回退。改进方向:混合多 harness、多任务家族的蒸馏数据,或用 RL(验证结果天然有环境回报信号)替代 SFT。弱点四:验证器看不到生成候选时的 推理,丢弃了可能最有价值的判别信息。改进方向:做推理可见性消融,或让生成器输出结构化的'动作意图摘要'。弱点五:评估粒度有限,3 runs 的 Pass@1 对低成功率任务置信区间很宽。改进方向:对低成功率基准增加运行次数并报告任务级 CI。
未来方向
作者明确提出的方向:用强化学习训练验证器(参考 $V^*$ 的 pairwise + tournament 路线)以进一步缩小与 frontier 验证器的差距;建立动作级金标签评测集,把验证正确性从轨迹成功率间接推断变为直接测量。基于本文成果可延伸:其一,验证信号反哺生成器——pairwise 验证产生的偏好数据天然构成 RLHF 式奖励,可用于对生成器做 RL 训练,形成'验证器教生成器'的闭环;其二,把动作级扩展推广到浏览器操作、机器人指令规划等动作会不可逆改变环境的智能体场景;其三,给验证器暴露环境状态差异、文件系统快照等结构化证据,而非纯黑盒比较;其四,动态候选宽度——论文固定 $N \in \{4, 8\}$,而早期回合(turns 1-4 一致性 68.13%)比后期(54.07%)更易验证,可按回合位置和动作风险自适应分配 $N$ 与验证预算;其五,在真实生产环境验证成本-收益,特别是墙钟延迟敏感的交互式场景。
复现评估
复现条件总体中等偏上。有利因素:附录 B.1-B.4 完整记录了评估任务与指标定义、三种验证机制的 prompt 与运行设置、蒸馏数据构造(244 个 TMAX-15k 任务、732 条轨迹、117k 条 GPT-5.6 Sol pairwise 响应、LoRA 配置)和成本核算公式;方法本身是纯推理时的 wrapper 改动,零样本结果无需训练即可复现;TerminalBench 系列基准公开,frontier 验证器部分用 API 即可复现。不利因素:论文项目页只有一个 'link' 占位符(文本中未给出实际 URL),代码、117k 蒸馏数据和 LoRA 权重是否开源不明确;TMAX 系列为 NVIDIA 模型,GPT-5.6 Sol/Terra 需相应 API 权限;自验证部分计算量不小(每任务 3 次运行 × 最多 64 步 × $N=8$ 候选 × 28 次 pairwise 调用),完整复现 9B 实验需多卡 GPU 或大量 API 配额;离线一致性分析还需 GPT-5.6 Terra 作仲裁标注。建议复现路径:先在单基准 × 零样本 listwise 上验证流程,再扩展到 pairwise 和蒸馏。
论文图表