Diptych:音乐制作参考听中范围可控、AI 解读的对比系统 Diptych: Scoped, AI-Interpreted Comparison for Reference Listening in Music Production
让用户自定义对比范围、以可查证据加AI解读辅助参考听,发现新差异而非替人下结论
前置知识
参考听(Reference Listening)
音乐制作中的标准工作方式:混音/母带工程师把自己的半成品与一首商业成品来回对照播放,通过听差异决定下一步改动,例如发现副歌没有像参考那样打开。工程师在比较之前已先决定了该把哪两段放在一起听,这个决定本身就是听的一部分。
本文的系统设计与用户研究全部围绕这一实践展开,理解它才能理解比较范围由谁决定为何是核心问题。
结构分段与自相似矩阵(SSM + Foote novelty)
用 chroma 特征构建时间×时间的自相似矩阵,相似段落在矩阵上呈块状;叠加 Foote 式棋盘核滑动计算新颖度曲线,峰值即疑似段落边界;再按位置与重复规则打上 Intro/Verse/Chorus 等标签。本文对短于约 8 秒的段做邻段合并。这是无训练的启发式算法。
DipTych 的时间线导航与按段比较都建立在这套分段之上,是用户选段交互的技术基础。
MIR 音频特征(LUFS、chroma、MFCC、H1-H2 等)
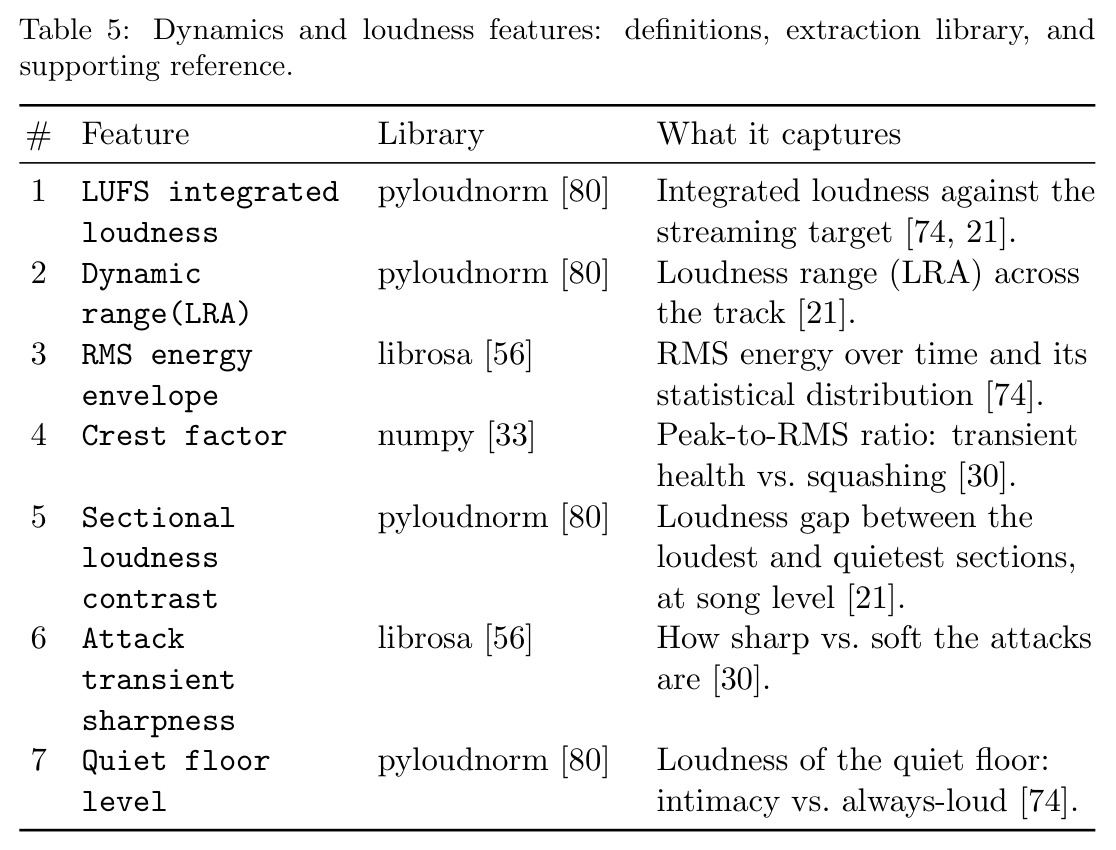
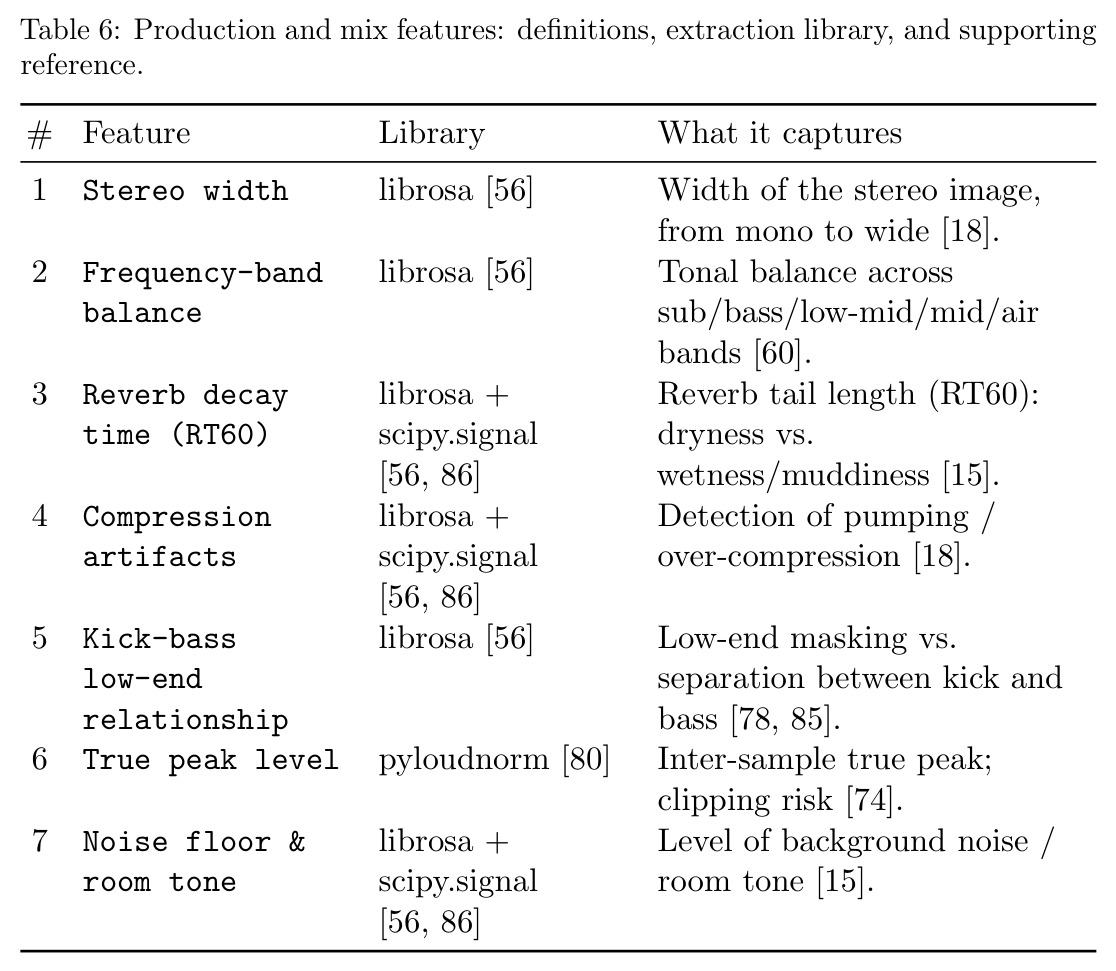
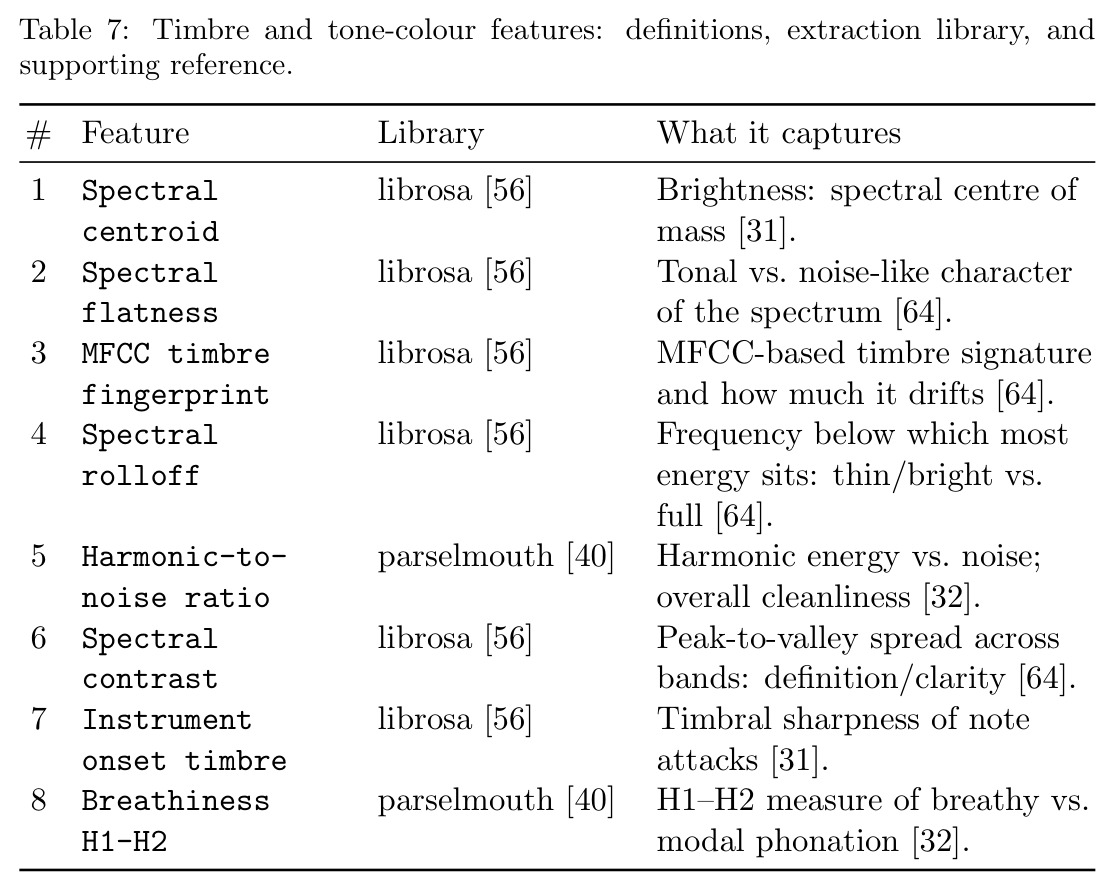
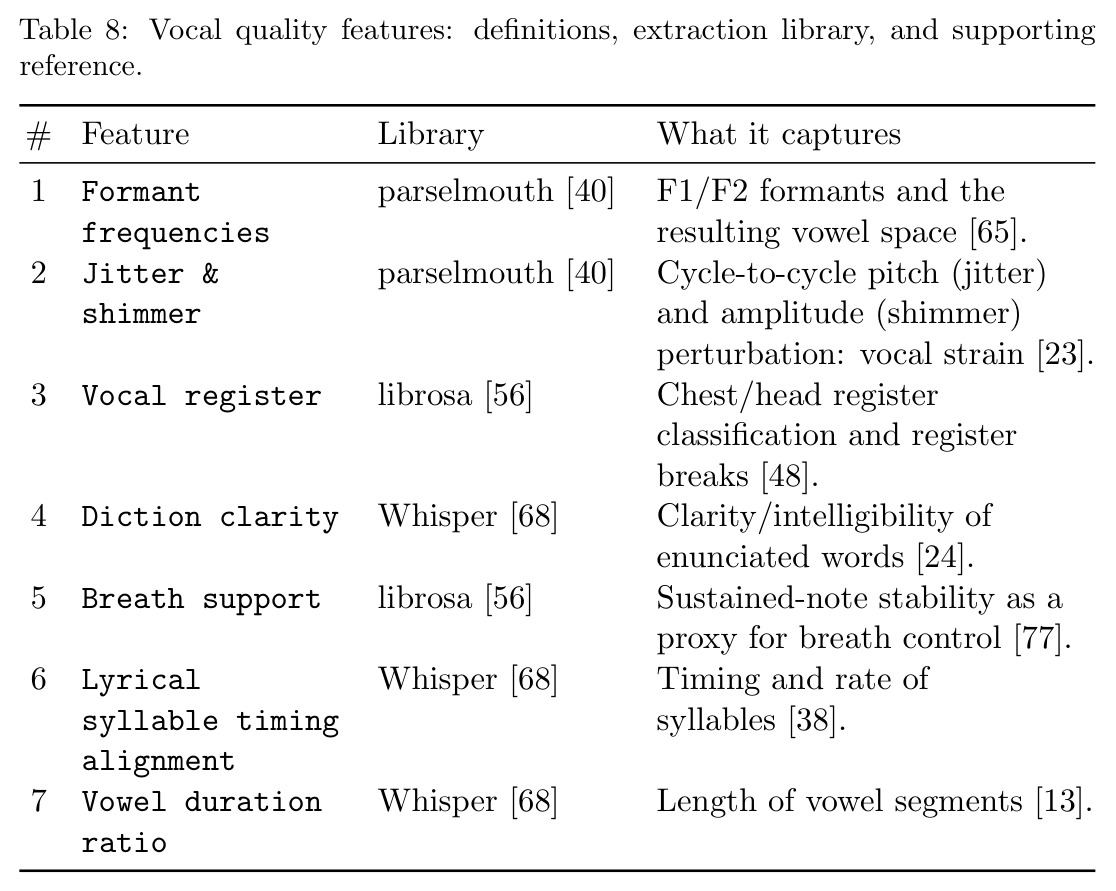
音乐信息检索领域把录音转成可比较数值的标准手段:LUFS 是广播级感知响度,chroma 表示 12 个音级的能量分布,MFCC 概括音色,H1-H2 衡量气声,jitter/shimmer 刻画嗓音稳定性,RT60 描述混响衰减。本文组装了 8 大类共 59 项此类特征。
系统的证据层就是这些特征,AI 解读的对象是它们的数值差异;研究中说的引用证据即指这些指标。
被试内设计与 SUS 量表
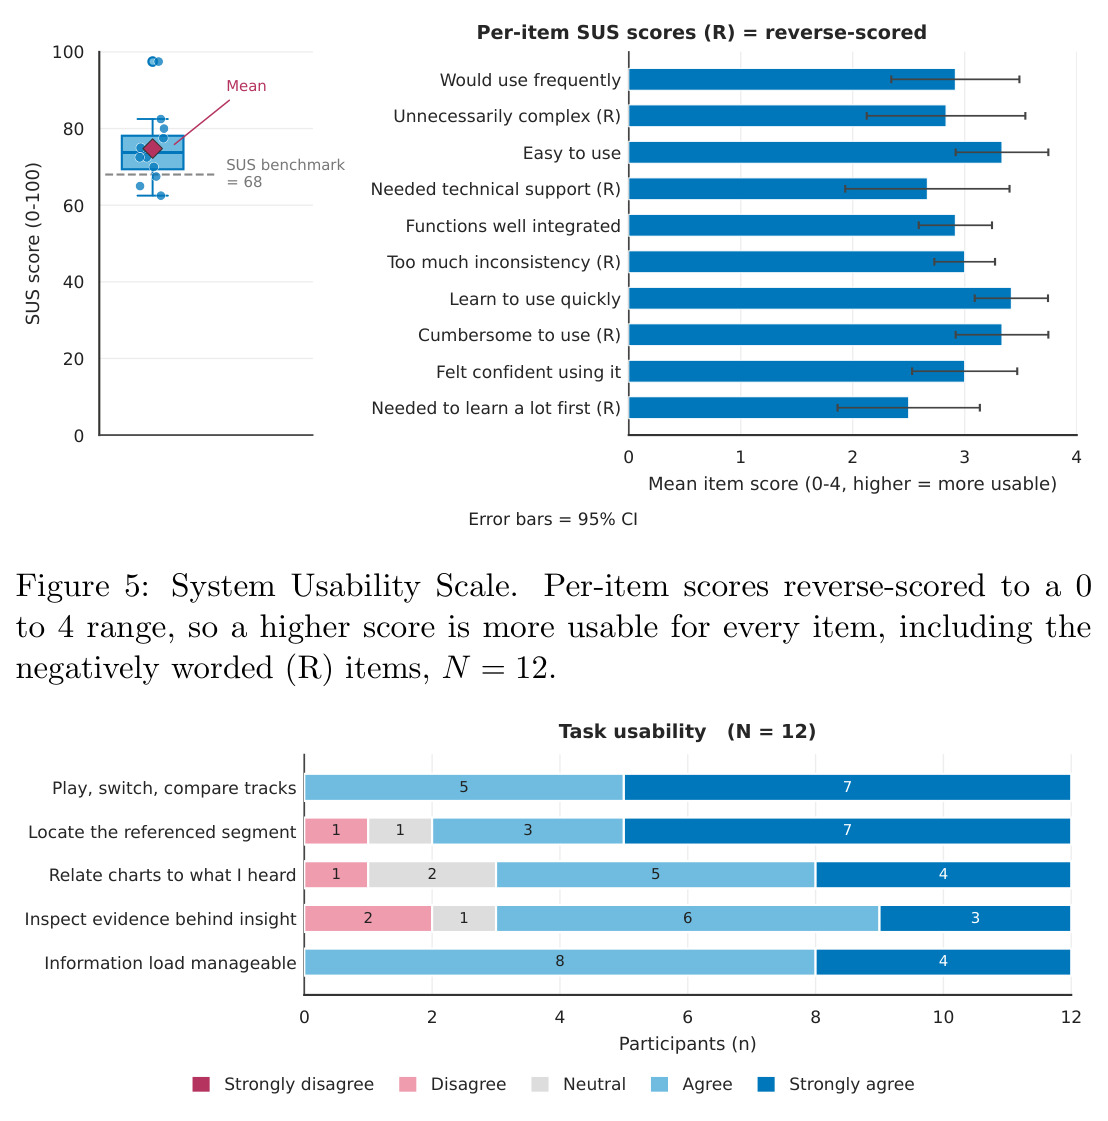
被试内设计让同一批参与者先后经历裸听与系统辅助两个阶段,以自己为对照;SUS(System Usability Scale)是 10 题标准可用性问卷,得分 0–100,68 分是常用的行业及格线。本文采用单会话、研究者引导的被试内流程。
论文结论(判断如何变化、可用性 74.79 分)的解读完全依赖这套方法,不清楚前测/后测设计容易误读结果。
源盲评(source-blinded rating)与专家感知参照
把参与者的判断切成匿名声明单元,交给未接触系统的专家按三级量规(完全支持/部分支持/不支持)独立评分,不告知每条声明来自裸听还是用系统之后;两位专家的分歧保留而不仲裁。专家只提供感知参照而非绝对真值。
这是检验系统到底帮了多少的关键设计,避免界面好感污染对判断质量的评价,是本文最有说服力的评测环节。
模式约束解码(schema-constrained decoding)
在 vLLM 等推理框架中限制大模型输出必须符合预定义 JSON 结构的解码技术,配合低采样温度可让模型稳定产出结构化的分类摘要与总评,前端无需解析自由文本即可直接渲染。
DipTych 的 AI 判断卡能稳定地并置在特征表旁,靠的就是这一工程手段。
研究动机
参考听是专业混音与母带流程的标准做法:工程师放一段自己的作品,再放参考唱片的同一位置,发现副歌没有打开,然后决定改什么。但现有对比工具几乎都在整轨层面工作(iZotope Ozone、Logic Pro 等报告全曲的频谱平衡、响度与立体声像),无法表达把我的副歌对着他们的副歌比这类请求。两首歌很少对齐:速度、编排、长度、结构都不同,一首的副歌可能在 2 分 10 秒处,另一首在 30 秒处且时长不同、结构权重不同,因此决定比较哪两段、在什么时间尺度上比,并不是听之前的一步,而是听本身的一部分。更麻烦的是,这种判断很难在工作记忆里保持:比较两段副歌意味着一边播放一段、一边回忆另一段正在消退的印象;而且音乐人常常听到说不出,把某种感觉不对劲变成可检验的具体判断(如参考曲第二段副歌里人声周围空间更大),本身就是专业训练的一部分,为声音品质建立可交流的共享词汇仍是开放的设计问题。
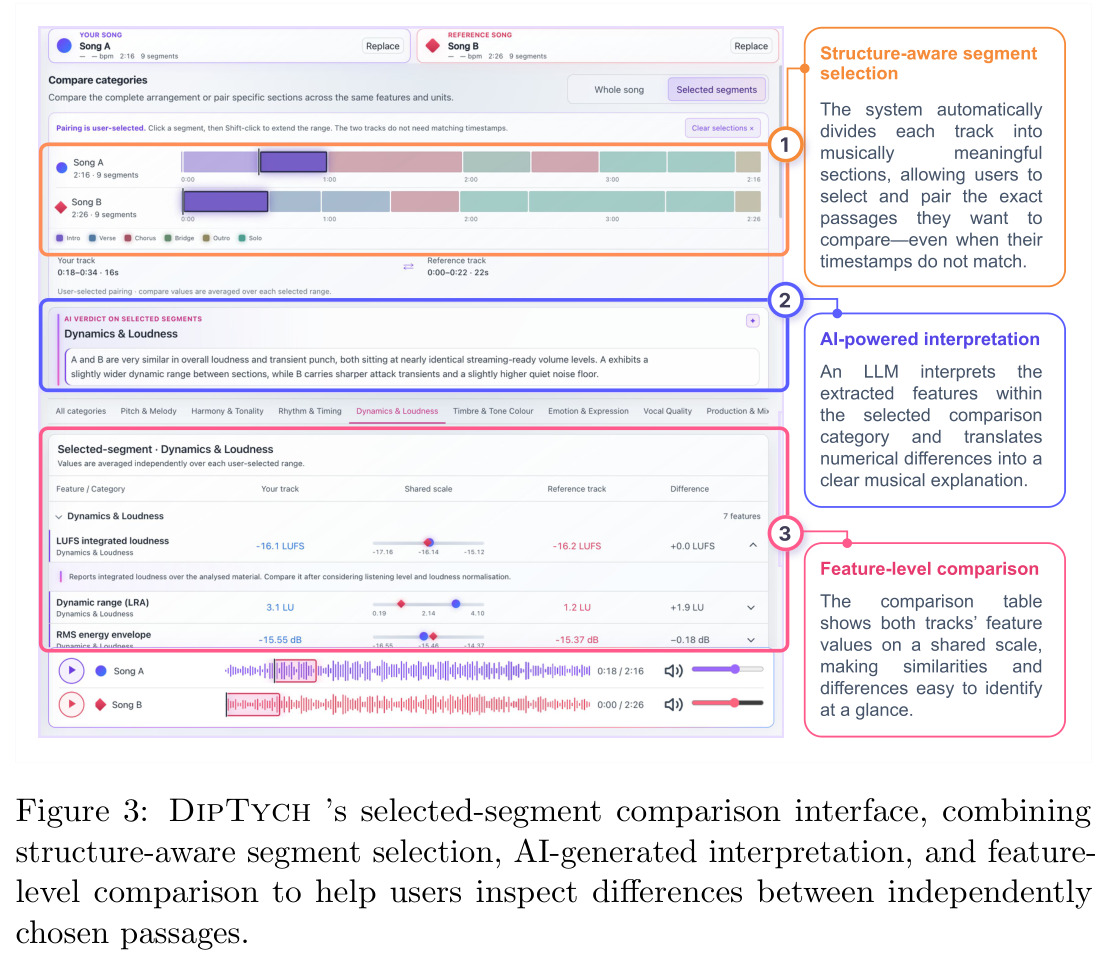
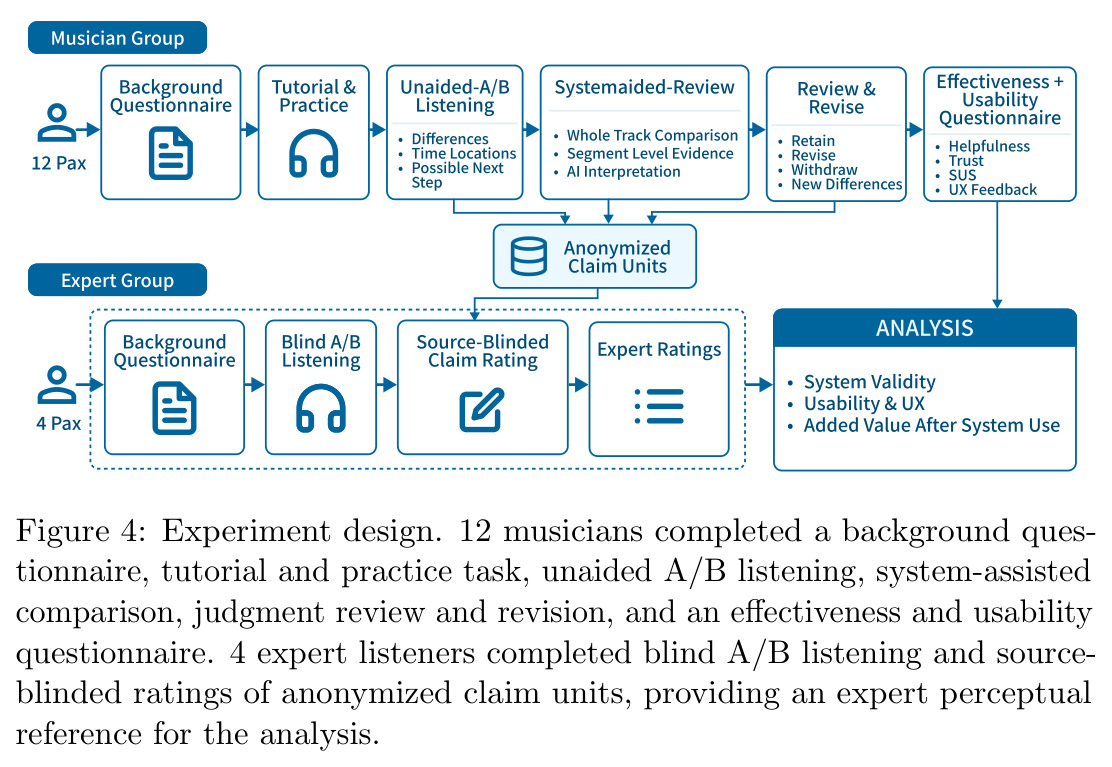
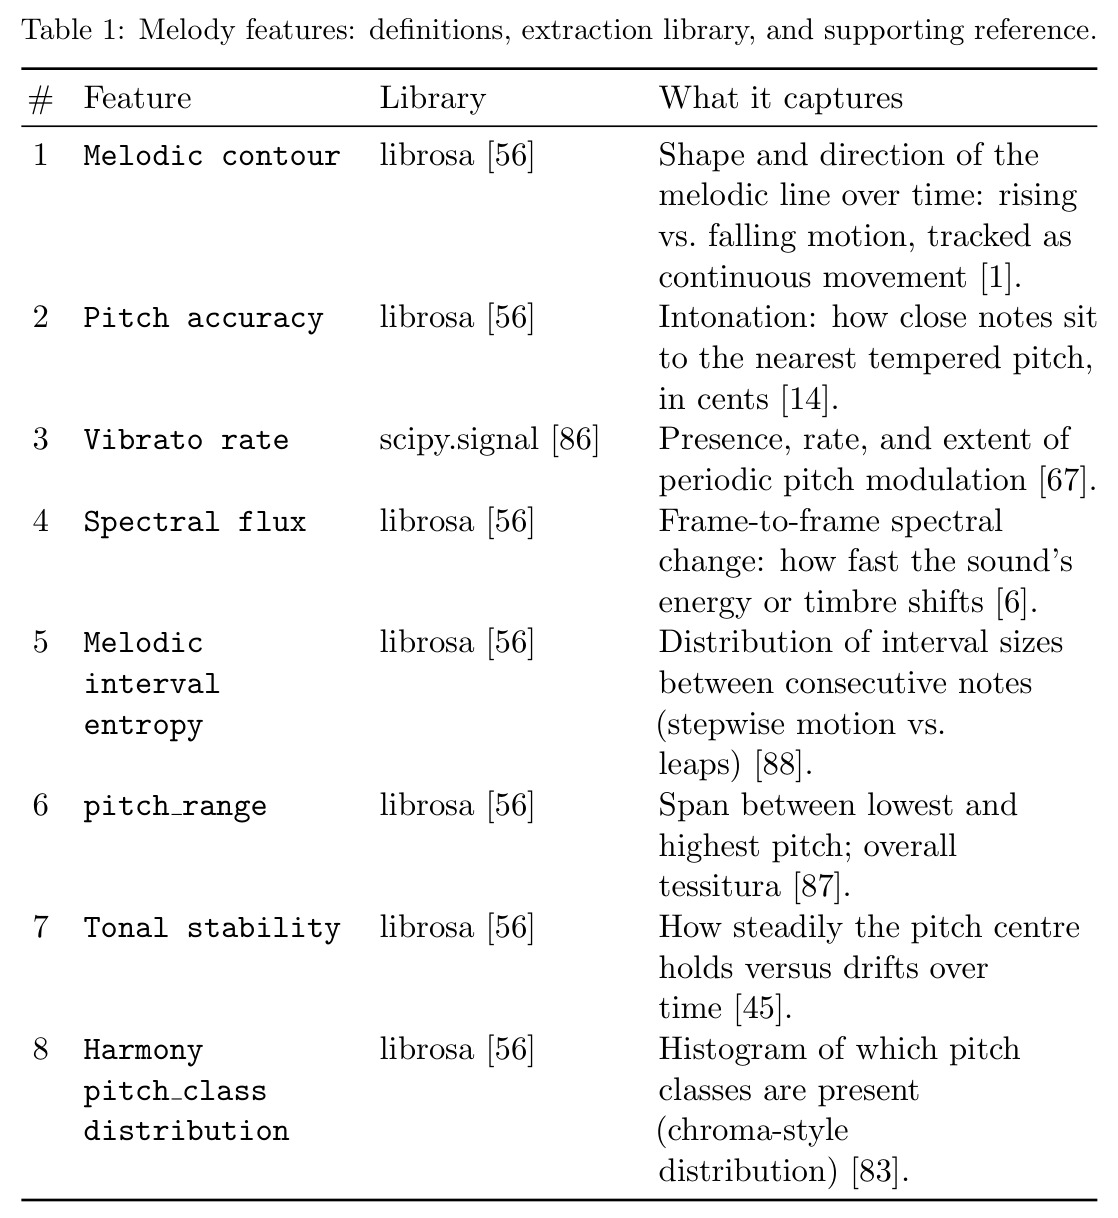
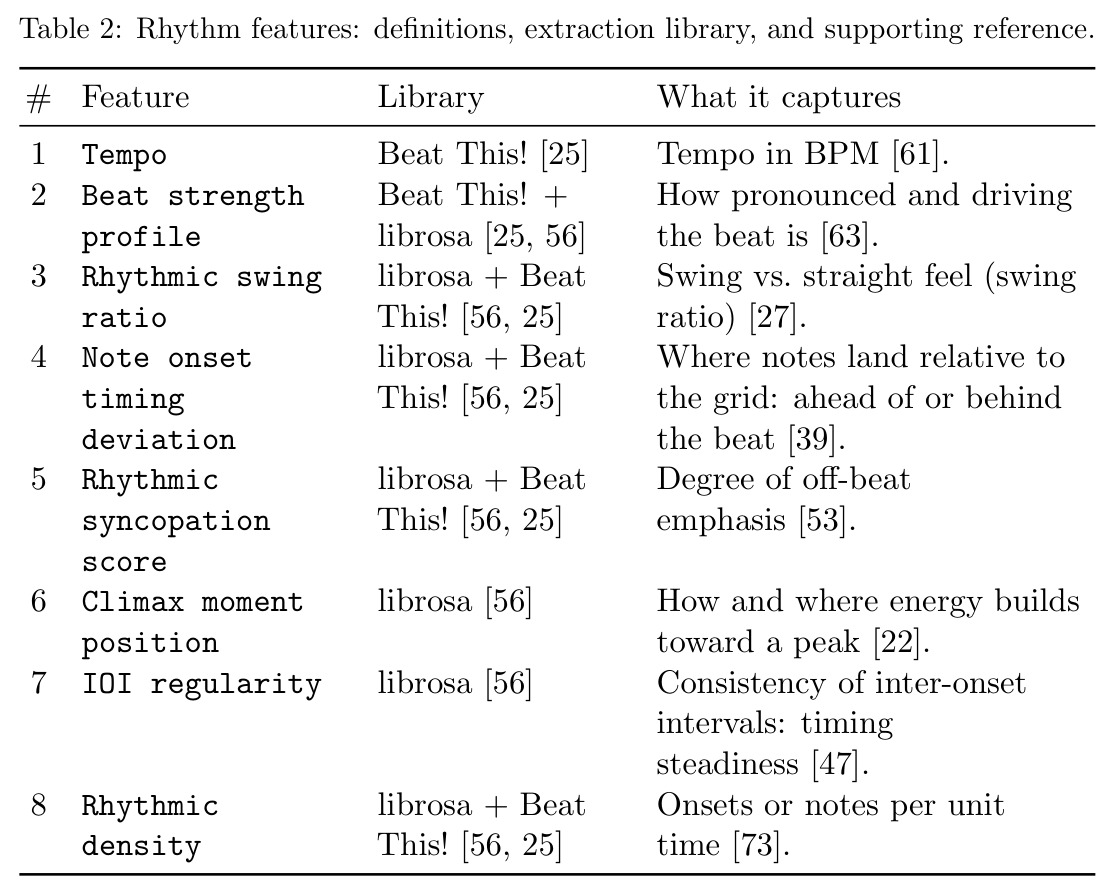
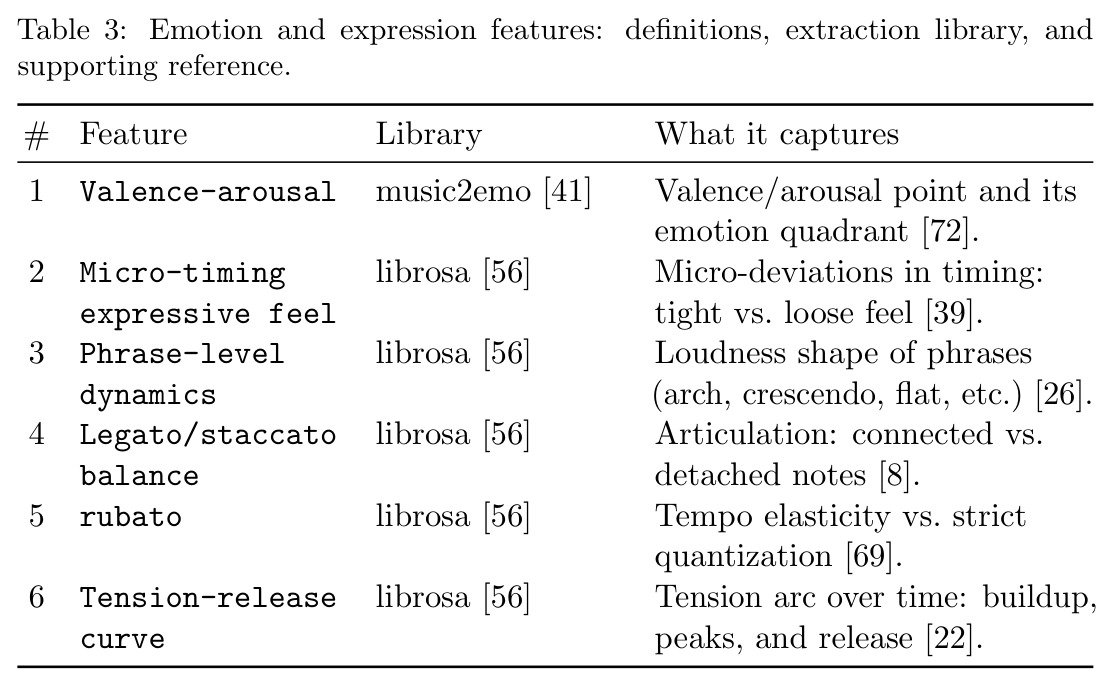
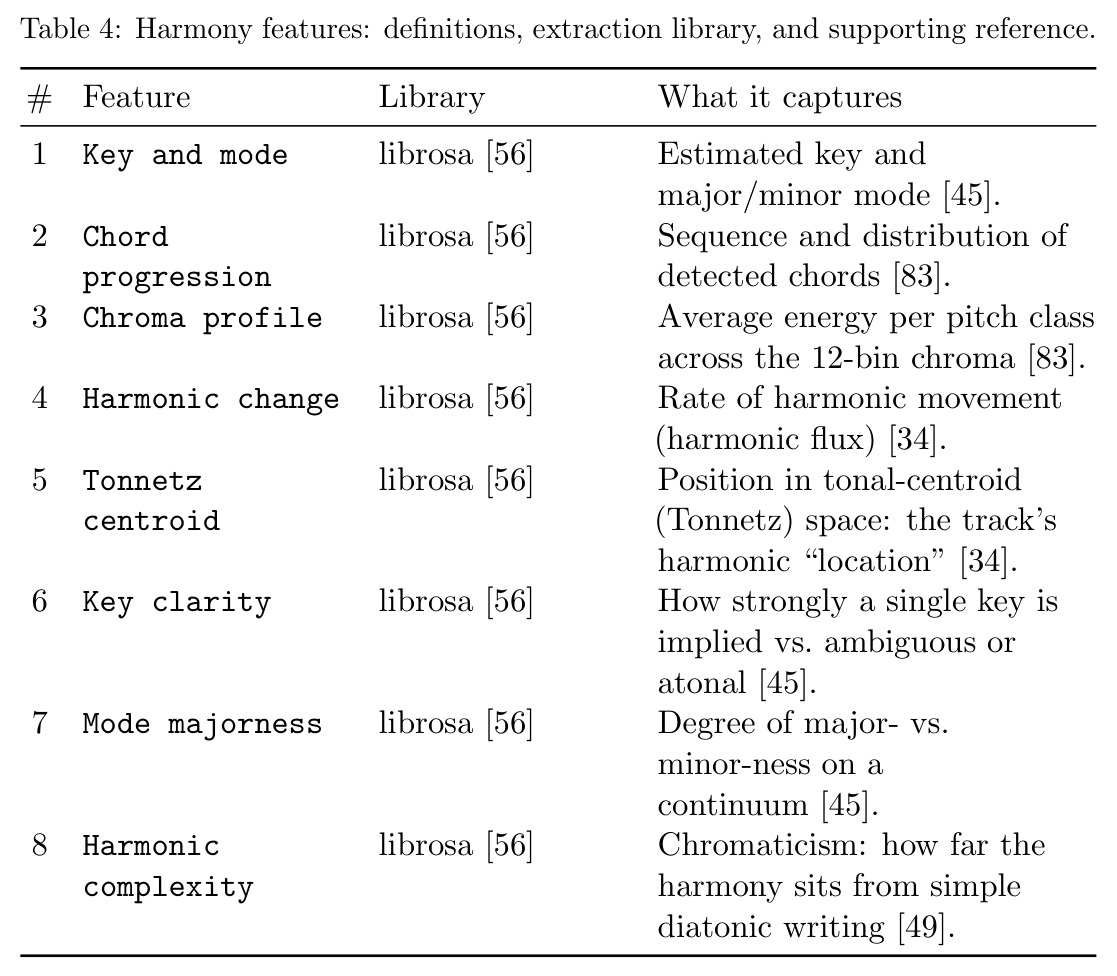
本文的目标是本文要构建一个把决定比较什么明确留给用户的 AI 辅助参考听系统 DipTych:用户既可以整轨比较(Whole Song 模式),也可以在两首歌里各自独立选段(Selected Segments 模式,不要求相同时间戳、相同长度或相同结构标签),系统在用户选定的范围内给出 8 大类 59 项结构化音频特征的数值对比,以及针对该范围的 AI 文字解读。作者的目标不止于做出一个能用的系统,而是借此回答一组面向整个社区的设计问题:比较范围由谁定、AI 解读如何与用户选定的范围绑定、原始证据与文字结论如何并置互查、以及究竟该把哪些特征摆到用户面前。最终通过 12 名音乐家的被试内实验加 4 名专家的源盲评,检验音乐人判断在用系统前后的变化、对系统解释的采纳与质疑,以及这些判断获得多少专家听感支持。
与已有工作不同的是,已有系统在范围决策上的位置各不相同,但没有一个把它交给用户。整轨分析工具(Ozone 类插件)不暴露局部比较范围,副歌位置不同就永远比不到一起;可微调音台、风格迁移和 Diff-MST 等系统直接用参考曲自动改写目标的输出,根本不向用户呈现比较;对话式混音建议模型虽能聊天,却仍由模型自己决定谈什么、在什么粒度谈。MERIT 证明了把旋律、节奏、音色拆成三个解耦嵌入能改善检索相似度,但返回的仍是检索用分数而非可核查的比较陈述。本文的独特切入是:把比较范围作为显式的用户选择——段与段之间可以起点不同、长度不同、标签不同,甚至拿 A 曲的 verse 对 B 曲的 chorus;同时用 8 个制作维度(而非单个相似度分数或原始信号)组织证据,把视觉比较研究中并置对象加可检查差异编码的设计模式首次系统地引入音频参考听场景。
核心方法
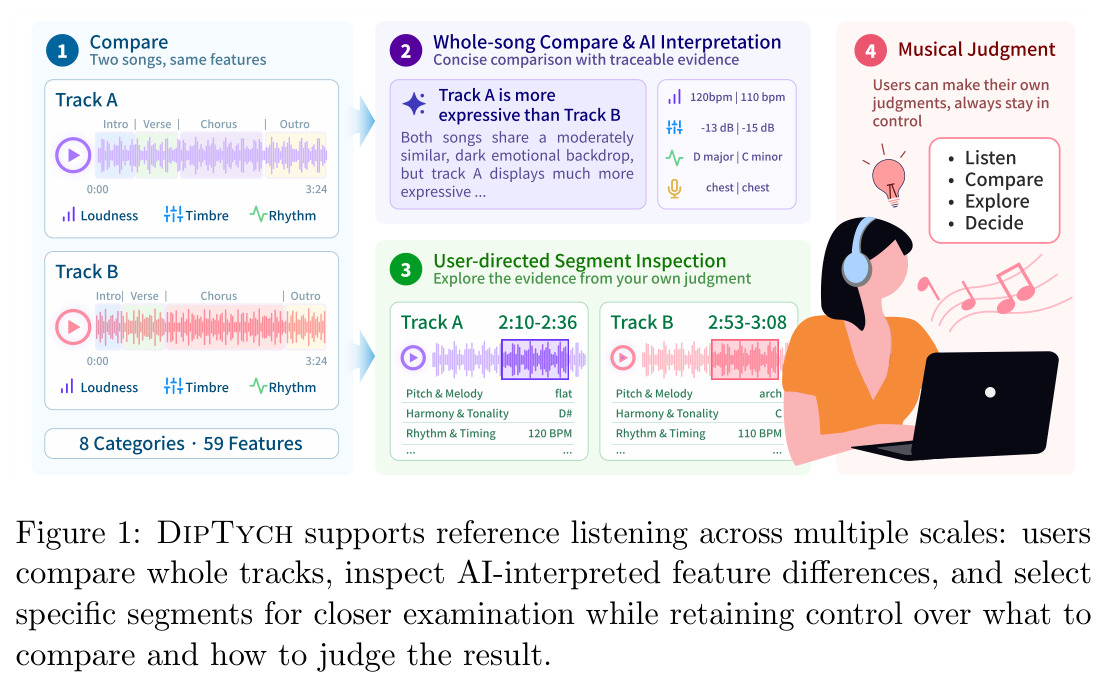
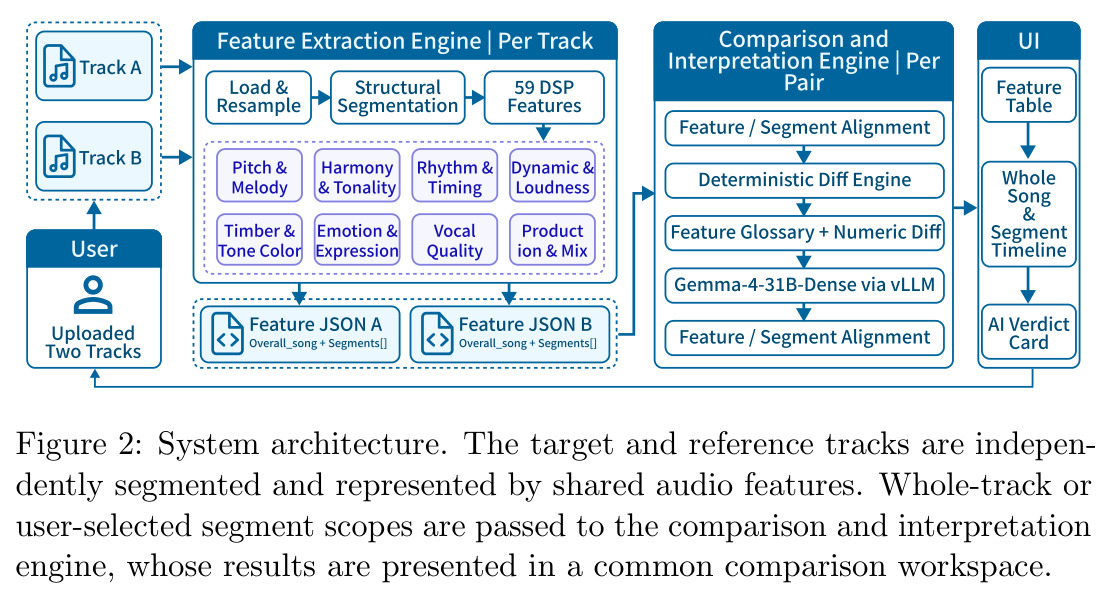
直觉上,一个有用的参考听工具应该帮用户读差异,而不是替用户决定比什么。DipTych 据此设计了两个比较模式:Whole Song 模式对两首完整曲目做整轨对比,适合回答响度、律动、音色平衡等整体问题;Selected Segments 模式让用户在两首歌的结构时间线(彩色标注 Intro/Verse/Chorus/Bridge/Outro/Solo)上各选一段,比较引擎只解读这两段。两种模式共用同一套 $8 \times 59$ 的特征展示,用户可以从整体印象下钻到局部证据再返回全曲,形成广—窄—广的循环。界面上特征表每行并排显示目标与参考的取值,旁边是 AI 判断卡;判断卡被明确定位为解读而非音乐质量的客观裁决,用户可以接受、修改或无视。架构上每条音轨独立经过加载重采样、结构分段与特征提取,比较与解读引擎按当前 scope 取差值并调用自托管 LLM 生成解读,结果呈现在统一的工作区里。
核心创新是把 comparison scope 变成显式的用户主权:系统提供结构分段作为导航地标,省去用户在脑中同时记住两首歌结构的负担,但哪两段构成一次公平比较由用户判断,两段允许不同起点、不同长度甚至不同标签。与已有工作的本质区别在于决策权的位置:Ozone 类插件固定整轨对齐;Diff-MST 等迁移系统用参考曲生成输出而不呈现比较;音频语言模型自己挑话题、自己定粒度。DipTych 让系统只在用户划定的范围内说话,并把证据(数值)与结论(文字)并排呈现供互查。另一个关键思想是把 AI 输出定位为帮助用户决定下一步的解释而非评分:判断卡不排名、不要求目标向参考看齐,用户始终可以基于自己的听感接受、修改或搁置它,呼应了 HCI 关于用户应能检查、纠正、拒绝系统输出的通用原则。
方法步骤详情
第一步,音频分析:每条音轨独立解码并重采样到 22.05 kHz(谱与和声分析)和 8 kHz(音高跟踪),以 librosa 为主、辅以 pyloudnorm、parselmouth、Whisper 和 Beat This!,提取共 59 项特征,涵盖 YIN/pYIN 音高、chroma、谱描述子、MFCC、onset 与节拍跟踪、RMS 与响度统计等;每轨输出一个 JSON 文件,含 overall_song 块与带时间边界的 segments 数组。第二步,结构分段:由 chroma 构建自相似矩阵,用 Foote 式棋盘核求 novelty 曲线、取峰为候选边界,短于约 8 秒的段并入邻段,再用位置与重复规则打结构标签——这只是导航线索,不是训练出来的曲式分类器。第三步,比较与解读:浏览器把所选 scope 发给确定性差值引擎,计算对应特征差值,连同特征词汇表经 vLLM 的 OpenAI 兼容端点送入自托管 Gemma-4-31B-Dense;模式约束解码固定输出格式、低温度限制波动,返回每类摘要加总评判断卡;scope 变化时特征复用,只重发起比较与模型请求。
技术新颖性
技术新颖性主要体现在三处。其一,范围主权的交互设计:先前没有系统同时支持整轨与任意两段比较且不要求时间对齐,两段可不同起点、不同时长、不同结构标签,填补了局部参考比较的空白。其二,8 类 59 项特征的组织方式有据可依:从业者词汇(工程师谈音色平衡、动态、空间)、MIR 分面传统、制作知识工程的分类学三条独立证据链收敛到同一划分,并把 vocal quality 单列(音乐理论研究认为嗓音音色携带一般谱描述覆盖不了的诠释与情感信息);相比 MERIT 的三个检索用解耦嵌入,这里把解耦原则推进为制作人可读、可查、可执行的用户范围级比较。其三,证据—解读并置的可核查架构:确定性数值 diff 与 LLM 文字结论并列展示,配合模式约束解码保证结构稳定,为解释可验证提供了工程模板;研究还把专家源盲评接入评测闭环,这在同类系统论文中少见。
实验结果
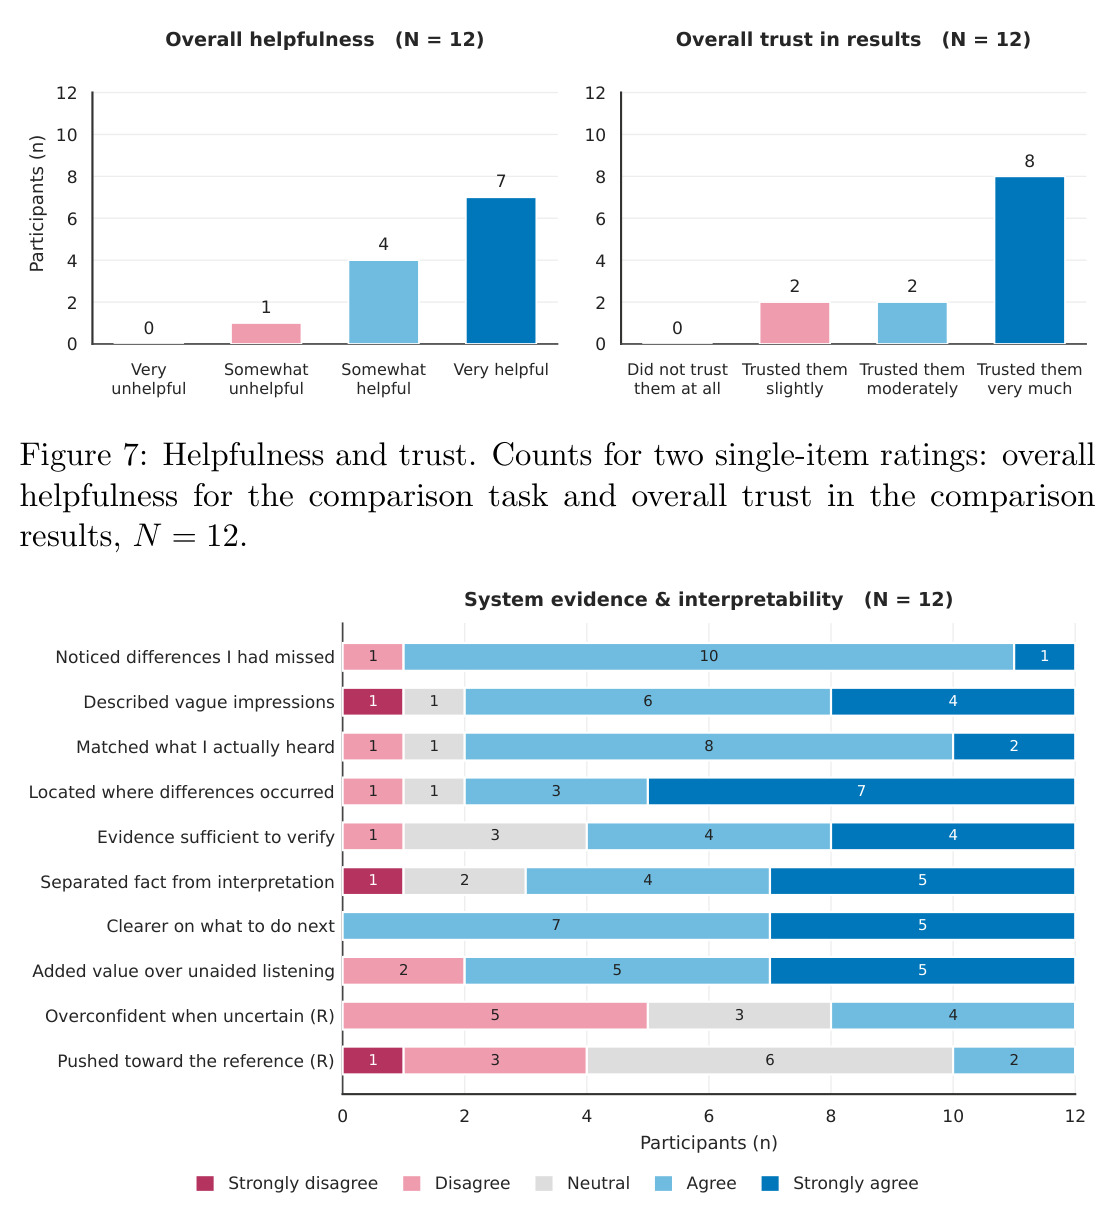
研究收集 44 条用前、39 条用后和 10 条新增判断,去重后共 89 个判断,双专家盲评共 178 个评分,主分析为 38 对前后匹配判断。既有判断的专家支持度基本没变:用前 24/38(63.2%)获双专家完全支持,用后 23/38(60.5%),仅 1 升 2 降;计入部分支持则两阶段均有 32 条(84.2%)获至少部分支持。系统帮用户发现了新差异:7 人新增的 10 条判断中 9 条获双专家至少部分支持(4 条完全支持),仅 1 条双不支持。主观体验也好:SUS 均值 74.79(SD 9.26)高于 68 分基准,12/12 报告对接下来查、试或不动什么更清楚,11/12 说注意到裸听漏掉的差异且认为系统有帮助,10/12 说能把模糊印象说具体并借分段标记定位差异。但信任与问题并存:8/12 非常信任结果,4/12 同意系统有时把证据不足的说法说得太自信,2/12 感到被推向参考轨;典型失败包括给器乐曲描述出人声、一条节奏读数失败;置信度上升(15 升 17 平 3 降)与专家支持度不对应,如 G1-P01 的调性判断置信度 75 升到 96,仍有一位专家评不支持。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 既有判断的听感正确性(38 对前后匹配判断) | 双专家完全支持比例 | 用系统后 23/38(60.5%) | 用系统前 24/38(63.2%) | -1 条(基本持平,无总体提升) |
| 新增差异发现(10 条新增判断) | 获双专家至少部分支持的比例 | 9/10(其中 4 条完全支持、5 条部分支持) | 这 10 条差异在裸听阶段均未被参与者记录 | 系统扩充了获专家认可的比较信息面 |
| 系统可用性 | SUS 得分(0-100) | 74.79(SD 9.26,范围 62.5-97.5,N=12) | 常用行业基准 68 | +6.79,高于基准 |
| 任务帮助性主观评价 | 评为 somewhat/very helpful 的人数 | 11/12 | 无外部基线(单系统研究) | 约 91.7% 正面评价 |
| 下一步行动清晰度 | 同意对查/试/不动什么更清楚的人数 | 12/12 | 无外部基线 | 100% 正面,是系统最一致的收益 |
局限与改进
作者承认的局限:其一,专家评估本身有主观空间,两位专家对措辞、情境与证据充分性的读法可能不同,评分只是本评估框架内的支持度而非录音真值,未获全支持不等于判断错误;其二,59 项特征来自标准工具,可靠性参差——研究中就出现了给器乐曲描述人声、节奏强度读数失败两个直接事故;其三,特征集选自文献而非与制作人的形成性共创,参与者质疑部分数字的用处并要求覆盖编曲与配器维度;其四,作者没有测量哪些特征真正承载比较价值。我自己的观察:样本很小(12 名音乐家、4 对曲目、每对仅 3 人),分析完全是描述性统计、无显著性检验;单会话、研究者引导的流程可能引入需求特征与顺序效应;前后测设计没有对照组,无法分离特征表与 AI 解读各自的贡献;给出 SUS 最高分且高信任的参与者恰是遇到人声幻觉的那位,提示流畅界面可能系统性掩盖输出可靠性问题;此外每条判断仅两位专家评分且分歧不做仲裁,跨曲目对的结论可比性也存疑。
独立分析的弱点
第一个弱点是判断卡可以编造测量之外的内容:系统给无歌声的曲目写出了嗓音与声区描述,专家还点出他们没有听到的 shuffle feel、临时转调和情绪属性。改进方向:每句结论强制绑定具体特征值,未检测到的维度保持沉默。第二个弱点是流利的技术词汇抬高的是听起来严谨而非更准确:用后判断更长、更多引用 BPM、立体声宽度、瞬态、压缩等术语,但专家支持度没涨,弱支撑反而更难被察觉。改进方向:在措辞旁并排显示证据强度与不确定性,让流利文字无法脱离证据单独成立。第三个弱点是证据可读性不足:仅 8/12 认为证据足以核验、9/12 能把图表对上听感,开放反馈抱怨术语和图表难懂、总结过于笼统、忽视编曲与配器差异。改进方向:分层解释、术语即时注释、按乐器与编曲粒度的对比。第四个弱点是特征集未经制作人共创、平均用力,用户不知道哪些数字值得关注。改进方向:与一线工程师共同筛选高价值特征并按任务场景裁剪面板。第五,对 feel、情绪这类主观维度,专家之间也互相分歧,系统却以同等确定口吻陈述。改进方向:区分可检验属性与审美解读,并给出不同的置信度标注。
未来方向
作者明确提出的主线是更好、更针对性的特征提取:逐项对照参考标注验证特征准确性;对困难情形(如不含人声的器乐曲)做更稳健的提取;并与制作人一起研究哪些特征真正值得展示、哪些可以裁掉。基于本文成果还可延伸多个方向:其一,把逐句证据链接做成一等公民——判断卡的每句话悬浮显示其依据的特征数值与片段时间戳,直接回应幻觉与过度自信问题;其二,做范围消融研究,比较用户定范围与 AI 建议范围对判断质量和信任的影响,直接检验本文的核心设计假设;其三,开展真实工作流中的纵向多会话研究:让参与者上传自己的项目、在 DAW 中迭代,观察参考听如何长期影响创作决策,而非单会话的固定曲目对;其四,把用户定范围、可查证据、可行动指引这套设计原则迁移到视频粗剪对比、范文对照写作等其他参考式创作场景;其五,评测方法上探索专家评分的一致性度量(如 Krippendorff $\alpha$)与多人仲裁机制,并把可靠性—证据质量—决策有用性三重加权的评估框架操作化为可复用基准。
复现评估
从工程角度看复现难度中等:特征提取栈完全开源(librosa、pyloudnorm、parselmouth、OpenAI Whisper、Beat This!),结构分段的自相似矩阵加 Foote 棋盘核是经典无训练算法,论文对规则(约 8 秒最短段、位置与重复标签规则)描述足够具体;最大的门槛是语言模型——自托管 Gemma-4-31B-Dense 通过 vLLM 的 OpenAI 兼容端点服务,31B 密集模型通常需要 40GB 以上显存的单卡(如 A100)或量化部署,不过任何开源 LLM 均可平替以验证流程。需要自行补齐的细节:论文未提及公开代码仓库,8 张特征表给出了名称、所用库与文献依据,但缺少每项特征的具体参数、阈值与差值归一化方式,实验曲目对也未公开。研究复现难度更高:需要招募 12 名不同背景的音乐家与 4 名专家、准备曲目对与三级评分量规并完成 IRB 审批;三级量规虽已公开,但专家个体差异会使支持度分布难以精确对齐。总体而言:系统原型可复建,特征实现需补细节,用户研究结论应视为方向性证据而非精确效应量。
论文图表
五个交互任务的同意度计数:播放/切换/比较音轨(7 人强烈同意、5 人同意,全体正面)、定位引用段落(7 同意 3 强烈同意)、把图表对应到听感(9 人正面 vs 3 人负面)、检查洞察背后的证据、信息负载可控(全体正面)。
把可用性拆到具体交互环节,显示导航类功能全票通过而图表解读是薄弱点,直接支撑讨论中指向比下结论更受信任的论点。
十个系统证据与可解释性条目的堆叠计数:注意到漏掉的差异 11 人正面;描述模糊印象 10 人;定位差异位置 10 人;下一步更清楚 12 人;证据足以核验仅 8 人;反向题中 4 人同意系统有时过于自信、2 人感到被推向参考轨。
论文最丰富的结果图:同时展示系统收益(发现差异、行动清晰)与代价(可验证性不足、过度自信、创作自主性压力),是结论的两面性证据。